VoiceNet-RAI; ses verilerinden cinsiyet ve yaş sınıflandırması yapmak için MFCC özelliklerini, çok dilli wav2vec 2.0 gömmelerini ve EfficientNet-Lite'ı entegre eder. Çerçeve, İngilizce dil alt kümesinde %97,87'ye varan bir doğruluk oranına ulaşır; konuşma tanıma, kimlik doğrulama ve dijital adli tıp alanlarındaki sorumlu uygulamaları destekler.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
VoiceNet: Cinsiyet ve Yaş Sınıflandırması için Sorumlu Bir Yapay Zeka Çok Dilli Konuşma Çerçevesi
127 görüntülenme
⸱
11 Eylül 2026
Bu makalede
Özet
Özet
Ses verilerinden doğru cinsiyet ve yaş sınıflandırması yapmak; kişiselleştirilmiş, güvenli ve etik insan-bilgisayar etkileşimi (HCI) için önemlidir. wav2vec 2.0 gibi önceden eğitilmiş geniş konuşma modellerinin kullanımının artmasıyla birlikte, bu temsillerden çok dilli ve gizlilik odaklı demografik çıkarımlar için sorumlu bir şekilde yararlanma ihtiyacı doğmuştur. Bu çalışma; çeşitli dilsel bağlamlarda doğru, adil ve şeffaf bir sınıflandırmayı desteklemek amacıyla Mel-Frekans Cepstral Katsayılarını (MFCC'ler), transformer tabanlı çok dilli wav2vec 2.0 gömmeleriyle (embeddings) bir EfficientNet-Lite mimarisi içinde entegre eden bir derin öğrenme (DL) çerçevesi olan VoiceNet-RAI'yi önermektedir. Bu çerçeve, değişken kayıt koşulları altında dayanıklılığı artırmak için bağlamsal ve spektral bilgileri birleştirir. 28 dili kapsayan çok dilli konuşma verileri üzerinde yapılan deneyler; İngilizce alt kümesinin %97,87 doğruluk, %98,61 kesinlik, %98,70 geri çağırma ve %98,65 F1-skoru elde etmesiyle güçlü bir sınıflandırma performansı sergilemiştir. Mozilla Common Voice veri seti kullanılarak yapılan dış doğrulama, cinsiyet sınıflandırması için %98,27 doğruluk oranı sağlayarak bağımsız bir veri setine genellenebilir olduğunu kanıtlamıştır. Ablasyon analizi, MFCC ve wav2vec 2.0 özelliklerinin birleştirilmesinin, ham verilere ve yalnızca MFCC temsillerine kıyasla performansı artırdığını göstermiştir. Bu bulgular, sağlam ve sorumlu cinsiyet ve yaş sınıflandırması için hibrit spektral-bağlamsal konuşma temsillerinin potansiyelini ortaya koymaktadır.
Giriş
Ses tanıma, bireylerin duygu, düşünce ve hedeflerini ifade ettikleri insan iletişiminin temel bir bileşenidir. İnsan sesleri, akciğerlerden dışarı verilen havanın dudaklar, dil ve dişler gibi eklemleme organları tarafından şekillendirilerek sese dönüştürüldüğü biyolojik bir süreçle üretilir1. Kulak, ses tanımlamada temel bir rol oynar ve ses seviyesi ile perde gibi özelliklere dayanarak erkek ve kadın seslerini ayırt edebilir. Erkekler ve kadınlar arasındaki vokal perdedeki önemli farklara katkıda bulunan özelliklerden biri cinsel dimorfizmdir2. Sesten yaş ve cinsiyet sınıflandırması; insan-makine etkileşimi, otomatik cinsiyet tanıma, kişiselleştirilmiş selamlamalar, konuşma duygusu ön sınıflandırması ve cinsiyete dayalı çağrı sınıflandırması dahil olmak üzere çok sayıda uygulama için önem taşımaktadır3.
Konuşma, insan etkileşiminin ayrılmaz bir parçasıdır. İnsan sesi, bireyler arasında farklılık gösteren ve duygusal ve zihinsel durumların yanı sıra yaş ve cinsiyet hakkında bilgi sağlayabilen birçok özellik içerir. Bu çok boyutlu özellikler, ses tabanlı güvenlik sistemleri ve konuşma odaklı Yapay Zeka (AI) asistanları gibi uygulamalarda kullanılabilir. Ses analizinin önemli olduğu diğer alanlar arasında Otomatik Konuşmacı Doğrulama (ASV) sistemleri ve duygu tabanlı AI sistemleri yer alır. Ses tabanlı giriş sistemleri ayrıca veri tabanlarındaki arama alanını da daraltabilir4,5. Ek olarak, AI tabanlı güvenlik sistemleri, kriminal soruşturmalar ve mağdur koruması gibi uygulamalar için ses verilerini kullanabilir. Erkek ve kadın sesleri, vokal kanalın rezonans özelliklerindeki farklılıklar nedeniyle farklı karakteristikler sergiler. Bu özellikler, konuşma sinyallerinden hesaplamalı işlemeye uygun bir formda çıkarılabilir ve böylece ses verilerinden cinsiyet sınıflandırması yapılabilir6,7. Bu nedenle, ses tabanlı cinsiyet sınıflandırması için etkili öğrenme algoritmalarına ihtiyaç duyulmaktadır. Derin Öğrenme (DL) algoritmaları, ses verilerinden karmaşık kalıpları öğrenebilme yetenekleri sayesinde özellikle konuşmayla ilgili sınıflandırmalar için oldukça uygundur. Bu modeller, mimariye bağlı olarak evrişimli, yinelemeli, zamansal-evrişimli veya tam bağlantılı katmanlar içerebilir. Bu katmanlar, ton ve perde dahil olmak üzere ilgili akustik özellikleri öğrenebilir. Eğitildikten sonra bir model, daha önce görülmemiş ses kayıtlarından cinsiyet sınıflandırması yapabilir8. Makine Öğrenmesi (ML) araştırmalarının bir diğer önemli alanı ise ses kayıtlarından yaş sınıflandırmasıdır. ML algoritmaları, yaşla ilgili kalıpları tanımlamak için perde, tını ve genlik gibi akustik özellikleri kullanabilir. Konuşma verilerinden bilgilendirici kalıplar çıkarmak ve potansiyel olarak sınıflandırma performansını artırmak için Temel Bileşen Analizi (PCA) gibi teknikler de uygulanabilir9.
DL; görüntü, duygu ve konuşma tanıma gibi uygulamalarda güçlü bir performans sergilemiştir. Özellikle Derin Sinir Ağları (DNN'ler), konuşma ile ilgili görevlerde yaygın olarak kullanılmaktadır. Bu çalışmada, DL tabanlı yaklaşımlar, yerleşik özellik çıkarma teknikleriyle kombinasyon halinde ses sınıflandırmasına uygulanmıştır. Mel-Frekans Cepstral Katsayıları (MFCC'ler), konuşma sinyallerinin ilgili spektral özelliklerini yakalar ve sonraki işlemler için verimli bir temsil sağlar. Çıkarılan özellikler daha sonra ses tabanlı cinsiyet ve yaş sınıflandırması için bir transfer öğrenme çerçevesine entegre edilmiştir10,1.
Son çalışmalar, konuşmacı öznitelik sınıflandırması için giderek daha fazla öz-denetimli ve Transformer tabanlı konuşma temsillerini benimsemiştir. Araştırmacılar, HuBERT ve wav2vec 2.0 gibi öz-denetimli konuşma modellerindeki cinsiyet ve yaş önyargıları da dâhil olmak üzere demografik önyargıları incelemiş ve hakkaniyet odaklı değerlendirmenin önemini vurgulamışlardır12. Daha yakın zamanda, Transformer tabanlı dil bağımsız yaklaşımlar, çok dilli ve gürültülü koşullar altında cinsiyet tanıma için öğrenilmiş bağlamsal konuşma temsillerinin etkinliğini kanıtlamıştır13. Sinha ve arkadaşları, yaş ve cinsiyet sınıflandırması için katman bazlı wav2vec 2.0 temsillerini daha ayrıntılı incelemiş ve farklı Transformer katmanlarının konuşmacı ile ilgili bilgilerin farklı seviyelerini yakaladığını göstermiştir14. Bu gelişmeler; geleneksel MFCC tabanlı spektral bilgileri, çok dilli ve Sorumlu Yapay Zekâ mülahazalarını bünyesine katarak bağlamsal wav2vec 2.0 temsilleriyle birleştiren önerilen VoiceNet-RAI çerçevesine temel oluşturmaktadır.
Güncel çalışmalar, konuşmacı yaşının ve cinsiyetinin hem geleneksel akustik özellikler hem de derin öğrenme tabanlı temsiller kullanılarak karakterize edilebileceğini göstermiştir. Akustik ve zamansal bilgileri birleştiren yaklaşımlar, tamamlayıcı konuşma özelliklerinin yaş ve cinsiyet sınıflandırma performansını artırabileceğini ortaya koymuştur15,16. İlgili araştırmalar ayrıca, derin darboğaz (bottleneck) temsilleri kullanılarak oluşturulan dönüştürülmüş konuşma özelliklerinin, konuşmacı yaşı ve cinsiyet sınıflandırma performansını iyileştirebileceğini göstermiştir17. Bu bulgular, konuşma ve konuşma kaynaklı sinyalleri içeren sınıflandırma görevleri için spektral, zamansal ve öğrenilmiş temsillerin daha geniş çaplı kullanımını desteklemektedir.
Makine öğrenimi ve derin öğrenme yaklaşımları kullanılarak konuşmadan yaş ve cinsiyet tanınması üzerine çeşitli çalışmalar yapılmıştır18,19,20,21,2,23,24,25,26,27,28,29,30. Daha güncel yaklaşımlar, konuşmacı yaş ve cinsiyet sınıflandırması için dönüştürülmüş MFCC temsillerini ve derin sinir ağlarını araştırmışken31, dayanıklı ses tabanlı demografik sınıflandırma sistemleri geliştirirken çok dilli ve dile bağlı değişkenlik önemli hususlar olmaya devam etmektedir. Telaffuz, fonetik yapı, konuşmacı özellikleri ve kayıt koşullarındaki farklılıklar, modellerin farklı diller ve popülasyonlar arasındaki genellenebilirliğini azaltabilir. Buna bağlı olarak, tamamlayıcı spektral ve bağlamsal konuşma temsillerinin kullanımı, çok dilli ortamlarda dayanıklılığı artırabilir.
Hibrit yaklaşımlar daha önce ses tabanlı demografik tanıma için birden fazla akustik özelliği veya topluluk sınıflandırıcılarını birleştirmiş olsa da, VoiceNet-RAI, tek bir çerçeve içinde iki tamamlayıcı konuşma temsili seviyesini entegre ederek farklılık göstermektedir. Spesifik olarak, geleneksel MFCC özellikleri yerelleştirilmiş spektral ve vokal özellikleri korurken, wav2vec 2.0 bir Transformer kodlayıcı kullanarak ham konuşmadan öğrenilen bağlamsal temsiller sağlar. VoiceNet-RAI, yalnızca el yapımı akustik tanımlayıcılara veya tek bir derin temsile güvenmek yerine, zamansal olarak toplulaştırılmış MFCC ve wav2vec 2.0 temsillerinin özellik düzeyinde füzyonunu gerçekleştirir ve ardından ortaya çıkan hibrit temsili EfficientNet-Lite kullanarak rafine eder. Dolayısıyla bilimsel yenilik; cinsiyet ve yaş sınıflandırması için spektral, öz-denetimli bağlamsal ve hafif derin temsillerin koordineli entegrasyonunun yanı sıra çok dilli değerlendirme, bağımsız veri seti doğrulaması ve alt grup hakkaniyet analizinde yatmaktadır. Bu kombinasyon, geleneksel hibrit konuşma sınıflandırma süreçlerini, yalnızca doğruluk odaklı özellik füzyonunun ötesine taşıyarak; temsil tamamlayıcılığını, hafif model tasarımını, genelleştirilebilirliği ve Sorumlu Yapay Zeka'yı (Responsible AI) eş zamanlı olarak değerlendiren bir çerçeveye dönüştürmektedir.
Bu araştırmanın temel katkıları arasında, MFCC ve wav2vec 2.0 özniteliklerinin EfficientNet-Lite ile entegrasyonu yoluyla ses verilerinden cinsiyet ve yaş tespiti yapmak için bir yaklaşımın geliştirilmesi yer almaktadır. 28 farklı dildeki ses kayıtlarından oluşan bir veri seti üzerinde kapsamlı deneyler yürütülmüş; orijinal öznitelikler, MFCC öznitelikleri, wav2vec 2.0 öznitelikleri ve bunların kombinasyonları ML ve DL modelleriyle değerlendirilmiştir. Model performansı, hem tam çok dilli veri seti hem de İngilizce alt küme kullanılarak analiz edilmiştir. Çerçeve ayrıca, cinsiyet ve dile özel alt grup analizleri, konuşmacıdan bağımsız değerlendirme ve Mozilla Common Voice veri seti kullanılarak yapılan doğrulama yoluyla çok dilli ve Sorumlu Yapay Zeka perspektiflerinden değerlendirilmiştir. Ek olarak, önerilen çerçevenin performansı mevcut literatürde bildirilen güncel yaklaşımlarla karşılaştırılmış ve çapraz doğrulama sonuçları sunulmuştur. İlgili konuda çok sayıda araştırma yürütülmüştür ve Tablo 1 , modelleri, veri setlerini ve bildirilen sonuçları içerecek şekilde bu çalışmaları özetlemektedir19,20,21,2,23,24,25,26,27,28,29,30,31.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışmada, doğrudan katılımcı katılımı olmaksızın halka açık BVC Challenging Voice Set ve Mozilla Common Voice veri kümeleri kullanılmıştır. Bu nedenle, kurumsal etik onay ve ek bilgilendirilmiş onam gerekmemiştir. Yalnızca cinsiyet ve yaş sınıflandırması için gerekli olan veriler işlenmiş ve bireysel konuşmacıların kimliklerini belirleme girişimi yapılmamıştır. Önerilen çerçevenin eksiksiz iş akışı metodolojisi Şekil 1'de paylaşılmıştır.
Veri toplama
Önerilen yaklaşımda kullanılan veri seti, Biometrics Vision and Computing (BVC) grubu tarafından geliştirilen ve GitHub'da barındırılan, kamuya açık bir ses veri seti olan BVC Challenging Voice Set'ten elde edilen .wav ses dosyalarından oluşmaktadır32. Veri seti, 36 erkek ve 190 kadın konuşmacı dahil olmak üzere 526 bireyden alınan ses kayıtlarını içermektedir. Her konuşmacıdan alınan tek ve çok cümleli kayıtlar dahil olmak üzere toplamda yaklaşık 3.964 kayıttan meydana gelmiştir. Tablo 2, önerilen VoiceNet-RAI çerçevesindeki konuşma veri setleri için kullanılan demografik özellikleri, dil kapsamını, kayıt özelliklerini, veri bölme stratejisini ve ön işleme ayarlarını özetlemektedir.
Öznitelik çıkarımı
Temel özelliklerin çıkarılması için ses dosyaları işlenmiş ve bu özellikler daha sonra bir CSV dosyasında saklanmıştır. Yaş, cinsiyet ve konuşmacı telaffuzu dahil olmak üzere üst veriler, ilgili README dosyalarından çıkarılmıştır. WAV dosyalarını işlemek ve ilgili özellikleri çıkarmak için Python ve SciPy paketi kullanılmıştır. Ses sinyallerini zaman domeninden frekans domenine dönüştürmek için NumPy’nin Hızlı Fourier Dönüşümü (FFT) ve frekans fonksiyonları kullanılmıştır. WAV dosyaları genliği zamanın bir fonksiyonu olarak temsil etmekteydi; ancak sınıflandırma görevi için erkek ve kadın seslerini ayırt edebilecek frekansla ilgili özellikler daha büyük önem taşımaktaydı3.
Ses sinyallerini frekans alanı temsillerine dönüştürmek için, FFT algoritması kullanılarak Ayrık Fourier Dönüşümü (DFT) uygulandı. Fourier dönüşümü, bir zaman alanı sinyalini frekans spektrumuna dönüştürür. Bu spektrum zamansal bilgiyi korumadığı için, ses sinyali örtüşen segmentlere ayrıldı ve her bir segmente Kısa Süreli Fourier Dönüşümü (STFT) yaklaşımı kullanılarak Fourier dönüşümü uygulandı. np.fft.fft fonksiyonu karmaşık frekans spektrumunu oluştururken, np.fft.fftfreq karşılık gelen örnekleme frekanslarını sağladı. Örnek dizinde, tek bir konuşmacı için 10 ses dosyası mevcuttu. Baskın frekansları çıkarmak için her bir WAV dosyası 20 ms'lik kayan pencereler kullanılarak işlendi. Örneğin, 4 saniyelik bir ses kaydı 20 frekans değerinden oluşan bir liste üretti. 10 kayıt içeren bir dizin için, her biri 20 frekans değeri içeren 10 karşılık gelen liste, listelerin bir listesi şeklinde birleştirildi. Frekanslar, 20 Hz ile 280 Hz arasındaki değerleri korumak için filtrelenirken, 50 Hz civarındaki potansiyel gürültüler hariç tutuldu.
Hibrit MFCC ve wav2vec 2.0 öznitelik temsili
Hem üst düzey bağlamsal konuşma temsillerini hem de alt düzey akustik özellikleri yakalamak için bu çalışmada, MFCC özelliklerini Transformer tabanlı wav2vec 2.0 gömmeleriyle entegre eden hibrit bir özellik çıkarma stratejisi uygulanmıştır.
MFCC öznitelik çıkarımı
Mel-Frekans Cepstral Katsayıları (MFCC'ler), özellikle konuşma tanıma ve konuşmacı kimliklendirme gibi uygulamalar için konuşma ve ses sinyali işlemede yaygın olarak kullanılan özelliklerdir34,35. Bu çalışmada MFCC çıkarımı, ses sinyallerini konuşmanın algısal olarak ilgili özelliklerini temsil eden özellik vektörlerine dönüştürmüştür. İşlem, yüksek frekanslı bileşenleri geliştirmek için ön-vurgulama ile başlamış, ardından sinyali kısa ve örtüşen çerçevelere bölmek için çerçeveleme ve pencereleme işlemleri uygulanmıştır. Her bir ses örneği önce 16 kHz değerine yeniden örneklendirilmiş ve 10-ms örtüşmeli 25-ms'lik çerçevelere bölünmüştür. Daha sonra, sinyali zaman düzleminden frekans düzlemine dönüştürmek için her bir çerçeveye Hızlı Fourier Dönüşümü uygulanmıştır.
Elde edilen frekans spektrumu, insan işitsel algısının doğrusal olmayan frekans yanıtını taklit eden bir dizi Mel filtre bankasından geçirilmiştir. Bu filtre bankaları, daha az bilgi içeren frekansların katkısını azaltırken algısal olarak daha ilgili frekansları vurgulamıştır. Ardından, insan işitmesinin ses şiddetine karşı logaritmik duyarlılığını taklit etmek amacıyla her bir filtre bankası çıktısının logaritması hesaplanmıştır. Katsayıları dekorele etmek ve ses sinyalinin kompakt bir temsilini oluşturmak için logaritmik filtre bankası enerjilerine Ayrık Kosinüs Dönüşümü (DCT) uygulanmıştır. MFCC'ler olarak bilinen sonuç katsayılar, konuşmanın önemli spektral özelliklerini yakalamıştır. MFCC'ler, sesleri bu özelliklere göre ayıran akustik karakteristikleri yakaladıkları için cinsiyet ve yaş sınıflandırması için kullanılmıştır.
wav2vec 2.0 gömme çıkarma
wav2vec 2.0 Base modeli, büyük ölçekli etiketlenmemiş konuşma korpusları üzerinde önceden eğitilmiştir. Model, ham dalga formu girdilerini işleyen ve bağlamsallaştırılmış konuşma gömmeleri (embeddings) üreten çok katmanlı bir Transformer kodlayıcısından oluşmaktadır36.
Girdi dalga formu x ∈ RT verildiğinde, wav2vec 2.0 modeli bir dizi gizli temsil üretmiştir:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
burada her bir gömme vektörü 768 boyutluluğa sahipti. Sınıflandırma için uygun, sabit uzunlukta bir temsil elde etmek amacıyla, tüm zaman adımları boyunca zamansal ortalama havuzlama işlemi uygulandı.
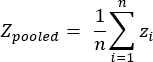 (2)
Öznitelik füzyon mekanizması
MFCC ve wav2vec 2.0 özellikleri, özellik düzeyinde birleştirme (concatenation) yoluyla harmanlanmıştır. Özellikle MFCC özellikleri, sabit uzunlukta bir vektör oluşturmak için öncelikle zamansal ortalama kullanılarak toplanmıştır.
m ∈ R40 (3)
Nihai hibrit özellik vektörü şu şekilde elde edilmiştir:
h = [m || zpooled] ∈ R808 (4)
burada || birleştirmeyi ifade eder. Bu füzyon, derin bağlamsal gömmeleri el yapımı spektral özelliklerle birleştirerek modelin hem üst düzey semantik bilgileri hem de ince taneli akustik örüntüleri yakalamasına olanak tanımıştır.
Tüm ses örnekleri önce 16 kHz değerine yeniden örneklendi. MFCC özellikleri çerçeve bazlı olarak hesaplandı ve sabit 40 boyutlu bir vektör üretmek için zamansal olarak ortalamaları alındı; wav2vec 2.0 gömmeleri ise 768 boyutlu bir temsil oluşturmak için zaman boyunca ortalama havuzlama (mean-pooling) işlemine tabi tutuldu. Her iki özellik seti de füzyondan önce sabit uzunluktaki vektörlere dönüştürüldüğü için çerçeve düzeyinde zamansal hizalamaya gerek duyulmadı. Elde edilen MFCC ve wav2vec temsilleri, sınıflandırma modeline aktarılmadan önce 808 boyutlu hibrit bir özellik vektörü şeklinde birleştirildi.
EfficientNet-Lite ile Entegrasyon
Birleştirilmiş öznitelik vektörü, h, öznitelik öğrenimine uygun bir formata yeniden şekillendirilmiş ve eğitim için EfficientNet-Lite modeline girdi olarak sağlanmıştır. Tam bağlı bir projeksiyon katmanı, önce 808 boyutlu vektörü daha yüksek boyutlu bir gizli uzaya eşlemiş, ardından EfficientNet-Lite blokları hiyerarşik öznitelikleri rafine etmiştir. Aşırı öğrenmeyi azaltmak ve model genellemesini iyileştirmek için toplu normalizasyon (batch normalization) ve dropout katmanları kullanılmıştır. Cinsiyet ve yaş sınıfları için nihai tahmin olasılıklarını üretmek amacıyla SoftMax aktivasyon fonksiyonu kullanılmıştır. Birleştirilmiş temsil, h ∈ R808, başlangıçta tek boyutlu bir öznitelik vektörü olarak ele alınmış ve onu 4.096 boyuta eşleyen tam bağlı bir projeksiyon katmanından geçirilmiştir. Projekte edilen temsil, EfficientNet-Lite mimarisine sunulmadan önce 1 × 64 × 64 boyutunda bir tensöre yeniden şekillendirilmiştir.
Geleneksel üç kanallı görüntü girişi yerine tek kanallı konuşma özelliği temsilcisine uyum sağlamak amacıyla, orijinal EfficientNet-Lite giriş evrişimli katmanı üç giriş kanalından bir giriş kanalına değiştirilmiştir. Geri kalan EfficientNet-Lite özellik çıkarma blokları, büyük mimari değişiklikler yapılmadan korunmuştur. Sabit uzunlukta bir temsil üretmek için son özellik haritalarına adaptif bir küresel ortalama havuzlama katmanı uygulanmıştır. Orijinal sınıflandırma başlığı, cinsiyet sınıflandırması için iki çıkış birimi ve önceden tanımlanmış yaş grupları için ilgili sayıda çıkış birimi içeren göreve özgü tam bağlantılı bir katmanla değiştirilmiştir. Son olarak, sınıf olasılıklarını oluşturmak için SoftMax aktivasyon fonksiyonu uygulanmıştır. Önerilen hibrit temsil, modern öz-denetimli konuşma gömmelerini geleneksel sinyal işleme özellikleriyle birleştirmiştir. wav2vec 2.0 gömmeleri bağlamsal bilgileri ve uzun menzilli bağımlılıkları yakalarken, MFCC özellikleri tamamlayıcı düşük seviyeli akustik bilgiler sağlamıştır. Bu temsillerin entegrasyonu, özellikle gürültülü ve çok dilli konuşma koşulları altında sınıflandırma performansını artırmıştır.
ML Sınıflandırıcı
Bu araştırmada, ses tabanlı cinsiyet ve yaş grubu sınıflandırması için birden fazla ML algoritmasının performansı analiz edilmiştir.
Rastgele Orman (Random Forest)
Tahmin doğruluğunu artırmak ve aşırı öğrenmeyi (overfitting) azaltmak için birden fazla Karar Ağacını (DT) birleştiren Random Forest (RF), güçlü bir Makine Öğrenmesi (ML) sınıflandırıcısı olarak kullanılmıştır. RF, nihai tahmini oluşturmak için birden fazla ağaçtan gelen tahminlerin toplandığı bir topluluk öğrenme (ensemble-learning) prosedürü aracılığıyla çalışmıştır37,38. Bu yaklaşım, RF'nin verilerdeki çeşitli örüntüleri yakalamasını sağlarken, tekil DT'lerle yaygın olarak ilişkilendirilen aşırı öğrenmeyi azaltmıştır. Ağaç kurulumu sırasında getirilen rastgelelik modelin genellenebilirliğini artırarak RF'yi ses verilerinden cinsiyet ve yaş sınıflandırması gibi sınıflandırma görevleri için uygun hale getirmiştir.
Lojistik Regresyon
Sınıflandırma için istatistiksel bir ML modeli olarak Lojistik Regresyon (LR) kullanılmıştır39. İkili sınıflandırmada LR, lojistik (sigmoid) fonksiyonunu kullanarak girdi özelliklerine dayalı bir sonucun olasılığını tahmin eder ve elde edilen olasılıklar sınıf tahminleri oluşturmak için kullanılır. LR ayrıca ikiden fazla sınıf içeren çok sınıflı sınıflandırma problemleri için de uygulanabilir durumdadır. Çok sınıflı sınıflandırma için LR, sınıflandırma ortamına bağlı olarak one-vs-rest veya SoftMax regresyonu gibi yaklaşımlar kullanmıştır.
Ekstra Ağaç Sınıflandırıcı
Tahminler oluşturmak için birden fazla DT'yi birleştiren bir topluluk öğrenme algoritması olarak Extra Trees Classifier (ETC) kullanılmıştır40,41. RF'den farklı olarak ETC, ağaç oluşturma sırasında aday özellikleri ve bölme eşiklerini rastgele seçerek ek bir rastgelelik getirir. Bu prosedür, birbiriyle daha az ilişkili ağaçlar oluşturmuş ve modelin bireysel özelliklere olan hassasiyetini azaltarak gürültüye karşı dayanıklılığı artırmıştır. Özellik önemini değerlendirmek ve verileri bölümlere ayırmak için bölme kriteri olarak Gini indeksi kullanılmıştır.
Destek Vektör Makinesi
Yüksek boyutlu bir özellik uzayında optimal bir karar sınırı belirlemek için bir ML sınıflandırıcısı olarak Destek Vektör Makinesi (SVM) kullanılmıştır42. Amaç, sınıflar arasındaki marjı maksimize eden bir hiper düzlem belirlemekti. Karar sınırı ile en yakın veri noktaları arasındaki daha geniş bir marj, genellikle daha iyi sınıf ayrımı ve genelleme sağlar. SVM; sınıflandırma, regresyon ve özellik tabanlı veri analizi dahil olmak üzere çeşitli ML görevlerinde uygulanabilir durumdadır.
Evrişimli Sinir Ağları
Görüntü ve ses verilerinin yapılandırılmış temsillerini içeren sınıflandırma görevleri için Derin Öğrenme (DL) modelleri olarak Evrişimli Sinir Ağları (CNN'ler) kullanılmıştır. Tek boyutlu CNN'ler (1D-CNN'ler) ayrıca sıralı ve metinsel verilere de yaygın olarak uygulanmıştır. CNN mimarileri, girdi verilerinden ayırt edici özellikler çıkarmak için evrişimli filtreler ve havuzlama işlemleri kullanmıştır43,4. Ses verilerinden cinsiyet ve yaş sınıflandırması yapmak için CNN'ler, perde, frekans, ton ve cinsiyet ile yaş gruplarını ayırt etmede ilgili diğer vokal özelliklerle ilişkili kalıpları öğrenmek amacıyla konuşmadan türetilen temsilere uygulanmıştır.
VGG19
Derin, nispeten tekdüze bir hiyerarşik özellik çıkarma yapısıyla karakterize edilen bir DL mimarisi olarak VGG19 kullanılmıştır45. Mimarisi, 19 katman boyunca küçük 3 × 3 konvolüsyonel filtreler kullanarak ayırt edici özelliklerin aşamalı olarak çıkarılmasını sağlamıştır. Konuşma kaynaklı temsillere uygulandığında VGG19, hem perde ve frekans varyasyonları gibi düşük seviyeli akustik örüntüleri hem de daha yüksek seviyeli ayırt edici özellikleri yakalamıştır. Derin mimarisi, cinsiyet ve yaşla ilişkili vokal özelliklerin modellenmesi için aşamalı özellik soyutlamasına olanak tanımıştır.
EfficientNet-Lite
Hesapsal olarak verimli bir DL mimarisi olarak EfficientNet-Lite kullanılmıştır46,47. Model, daha ağır DL mimarilerine kıyasla daha az hesaplama kaynağı gerektirirken güçlü bir sınıflandırma performansı elde etmek için dengeli bir ölçeklendirme stratejisi uygulamıştır. Bileşik ölçeklendirme yaklaşımı, verimli özellik çıkarımı sağlamak amacıyla model derinliğini, genişliğini ve giriş çözünürlüğünü birlikte değerlendirmiştir.
Hafif mimarisi, sınıflandırma performansı ve model karmaşıklığı arasındaki uygun dengesi nedeniyle, önerilen VoiceNet-RAI çerçevesi için EfficientNet-Lite seçilmiştir. Daha ağır mimarilerle karşılaştırıldığında, daha az parametre ve daha düşük hesaplama gereksinimleriyle etkili özellik öğrenimi gerçekleştirmek için verimli konvolüsyonel bloklar ve bileşik ölçeklendirme kullanmıştır. Bu özellikler, EfficientNet-Lite'ı önerilen konuşma sınıflandırma çerçevesi için uygun hale getirmiş ve kaynak kısıtlı ortamlarda dağıtım potansiyeli sağlamıştır.
MobileNet
MobileNet, mobil ve uç hesaplama ortamları dahil olmak üzere sınırlı hesaplama kaynaklarına sahip uygulamalar için hafif bir DL mimarisi olarak kullanılmıştır48. Hesaplama verimliliği, temel olarak, geleneksel evrişimli mimarilere kıyasla parametre sayısını ve hesaplama işlemlerini azaltan derinlemesine ayrıştırılabilir evrişimler (depthwise separable convolutions) aracılığıyla sağlanmıştır. Bu özellikler, MobileNet'i nispeten düşük hesaplama gereksinimlerini korurken ses verilerinden cinsiyet ve yaş sınıflandırmasını değerlendirmek için uygun hale getirmiştir.
InceptionV3
Konuşma kaynaklı temsillerden hiyerarşik özellikler çıkarmak için derin bir mimari olarak InceptionV3 kullanılmıştır49. Mimari, farklı soyutlama seviyelerinde özellikler çıkarmak için evrişimli, havuzlama ve karma işlemleri içermiştir. Ses verilerinden cinsiyet ve yaş sınıflandırması için InceptionV3, vokal özelliklerdeki varyasyonlarla ilişkili karmaşık akustik örüntüleri ve hiyerarşik temsilleri öğrenmek amacıyla kullanılmıştır.
Değerlendirme parametreleri
Doğruluk, sınıflandırma görevleri için en sık kullanılan değerlendirme metriklerinden biriydi50. Doğruluk, genel sınıflandırma performansı için yararlı bir ölçüm sağlasa da, özellikle dengesiz veri kümeleri için her zaman kapsamlı bir değerlendirme sunmuyordu. Bu nedenle, model performansını değerlendirmek için kesinlik, duyarlılık ve F1-skoru dahil olmak üzere ek metrikler kullanıldı. Bu metrikler, her sınıf için doğru ve yanlış tahminleri dikkate alarak daha kapsamlı bir değerlendirme sağladı.
Doğruluk, doğru sınıflandırılan gözlemlerin toplam gözlem sayısına oranı olarak tanımlanmıştır. Doğruluk, özellikle dengeli veri setleri için bilgilendirici olsa da, bu çalışmada kullanılan veri seti dengesizdir. Bu nedenle, sınıflandırma metrikleri hesaplanırken ve yorumlanırken Doğru Pozitifler (TP), Yanlış Pozitifler (FP), Doğru Negatifler (TN) ve Yanlış Negatifler (FN) dikkate alınmıştır. Aşağıdaki denklem, doğruluğun standart tanımını temsil etmektedir:
Doğruluk = (TP+TN)/(TP+TN+FP+FN)×10 (5)
Hassasiyet (precision), sınıflandırıcıların yalnızca ilgili örnekleri döndürme yeteneğini değerlendir:
Hassasiyet= TP/(TP+FP) ×10 (6)
Hassasiyet olarak da bilinen geri çağırma (recall), sınıflandırıcının ilgili tüm örnekleri tanımlama yeteneğini ölçer:
Duyarlılık (Recall)= TP/(FN+TP) × 10 (7)
F1-skoru, kesinlik (precision) ve duyarlılığı (recall) tek bir ölçüde birleştirir ve özellikle dengesiz veri setlerinde sınıflandırma performansını değerlendirmek için kullanışlıdır:
F1-Skoru =2 ×(PPV ×TPR)/(TPR+PPV) × 10 (8)
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Yaş ve cinsiyet sınıflandırmasına ilişkin deneysel sonuçlar, ML ve DL modelleri ile MFCC tabanlı ve hibrit öznitelik temsilleri kullanılarak değerlendirilmiştir. Veri seti, %80'i eğitim ve %20'si test için kullanılacak şekilde 80:20 oranında eğitim ve test setlerine ayrılmıştır. Aynı konuşmacıya ait kayıtların her iki sette de yer almasını önlemek amacıyla konuşmacı düzeyinde bölümlendirme uygulanmıştır.
Önerilen çerçevenin hiperparametreleri ve uygulama detayları Tablo 3'te ö...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Bu çalışma, MFCC özelliklerini ve wav2vec 2.0 gömmelerini EfficientNet-Lite ile entegre ederek ses verilerinden cinsiyet ve yaş sınıflandırması yapan otomatik bir çerçeve geliştirmiş ve değerlendirmiştir. İlk deneylerde EfficientNet-Lite, orijinal özellikleri kullanarak %83,48 doğruluk, %82,87 kesinlik, %84,28 duyarlılık ve %83,54 F1-skoru elde etmiştir. MFCC özelliklerinin entegrasyonunun ardından, 28 dilden oluşan veri setinde performans önemli ölçüde artarak %92,64 doğruluk, %93,79 kesinlik, %94,92 duyarlılık ve %94,8...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların açıklanacak herhangi bir çıkar çatışması yoktur.
Teşekkürler
Yazarlar, bu araştırmayı finanse ettikleri için Princess Nourah bint Abdulrahman University Araştırmacı Destek Projesi numara (PNURSP2026R748), Princess Nourah bint Abdulrahman University, Riyad, Suudi Arabistan'a teşekkür ederler.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| BVC Challenging Voice Set | Biometrics Vision and Computing Group / OgeNI | BVC Challenging Voice Set | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, kullanılan kesin varyant | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Grafik İşleme Birimi | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Mozilla Common Voice Veri Seti | Mozilla Foundation | Common Voice, deneylerde kullanılan versiyon | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | NumPy Developers | Deneylerde kullanılan kesin versiyon | https://numpy.org/ |
| İşlemci | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python Software Foundation | Deneylerde kullanılan kesin versiyon | https://www.python.org/ |
| PyTorch | PyTorch Foundation | Deneylerde kullanılan kesin versiyon | https://pytorch.org/ |
| Scikit-learn | Scikit-learn Developers | Deneylerde kullanılan kesin versiyon | https://scikit-learn.org/ |
| SciPy | SciPy Developers | Deneylerde kullanılan kesin versiyon | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 1 | Microsoft | Windows 11, mevcutsa kesin sürüm/yapı | https://www.microsoft.com/windows/windows-1 |
Kaynaklar
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.