Bu çalışma, entegre makine öğrenimi, tek hücreli RNA dizileme ve deneysel doğrulama yoluyla ülseratif kolitte kuproptoz ve ferroptoz ile ilişkili beş biyobelirteç belirleyerek, klinik tanı ve hedefe yönelik immünoterapi hakkında bilgiler sunmaktadır.
Bu içeriği görüntülemek için JoVE aboneliğiniz gereklidir. Giriş yapın veya ücretsiz denemenizi bugün başlatın.
Araştırma makalesi
Ülseratif Kolitte Ferroptozis ve Kuproptozis Hedeflemesi: Kapsamlı Biyoinformatik ve Deneysel Doğrulama Bulguları
Bu makalede
Özet
Özet
Ülseratif kolit (UK), patogenezi tam olarak tanımlanmamış olan ve yeni sanayileşmiş ülkelerde prevalansı ve hastaneye yatış oranları artan kalıcı bir bağırsak bozukluğudur. UK'de, aşırı bağırsak epitelyal hücre ölümü mukozal bariyeri bozar ve enflamatuar yanıtları tetikler. Ferroptozis ve kuproptozis, yakın zamanda tanımlanmış iki düzenli hücre ölümü biçimidir. UK üzerine yapılan çalışmaların çoğu bu süreçleri ayrı ayrı incelemiştir; ancak, UK progresyonundaki ortak rolleri yetersiz şekilde karakterize edilmiştir. UK patogenezindeki sinerjik rollerini araştırmak için, aday hedefleri belirlemek amacıyla geniş ölçekli transkriptomik profillemeyi ve ardından in vitro modellerde doğrulamayı içeren aşamalı bir yaklaşım kullandık. Diferansiyel olarak eksprese olan genler (DEG'ler), ferroptozisle ilişkili genler (FRG'ler) ve kuproptozisle ilişkili genler (CRG'ler) ile kesiştirildi. Örtüşen hedefler, makine öğrenimi algoritmaları konsensüsü ve ağırlıklı gen eş-ekspresyon ağ analizi (WGCNA) kullanılarak önceliklendirildi. Beş biyobelirteç — LCN2, IDO1, CXCL2, NOS2 ve CD274 — UK'de anlamlı düzeyde artış göstermiştir. Tek hücre analizi, bu belirteçlerin farklı hücre tipleri arasındaki ekspresyonunu karakterize etmiş ve LCN2 ile NOS2'nin öncelikle epitelyal hücrelerde zenginleştiğini göstermiştir. Bu belirteçlerin mekanistik ilişkisi, in vitro analizler yoluyla daha detaylı olarak değerlendirilmiştir. Ferroptozis veya kuproptozis inhibitörleri ile yapılan tedavi, Caco-2 hücre modellerinde UK ile ilişkili enflamasyonu hafifletmiş ve biyobelirteç ekspresyonunu modüle etmiştir. Bu bulgular, UK progresyonu ile ilişkili beş biyobelirteç tanımlamakta ve bunların klinik tanı ve terapötik müdahaledeki potansiyel uygulamalarını destekleyen deneysel kanıtlar sunmaktadır.
Giriş
Ülseratif kolit (UC), artan küresel yük ve önemli uzun vadeli tedavi maliyetleri ile ilişkili, nüks eden bir inflamatuar bağırsak hastalığıdır1,2. Aminosalisilatlar, kortikosteroidler, biyolojikler ve küçük moleküllü tedaviler tedavi seçeneklerini genişletmiş olsa da, birçok hasta için kalıcı remisyonu sağlamak hala zordur3,4. Bu karşılanmamış klinik ihtiyaç, daha erken tanıya ve mekanizma odaklı tedaviye destek sağlayabilecek tekrarlanabilir moleküler markerların ve yönetilebilir mekanizmaların belirlenmesinin önemini vurgulamaktadır5.
Ferroptoz; lipid peroksidasyonu, glutatyon tükenmesi ve bozulmuş GPX4 aktivitesi tarafından tetiklenen, demire bağımlı bir düzenlenmiş hücre ölümü biçimidir6. Ülseratif kolitte (UK) artan demir ve malondialdehit seviyeleri ferroptotik epiteliyal hasarla uyumludur; SLC7A11–GSH–GPX4 aksının deneysel aktivasyonu veya ferroptozun doğrudan inhibisyonu intestinal bariyeri koruyabilir7,8.
2022 yılında tanımlanan kuproptoz, bakırın lipoylanmış mitokondriyal proteinlere bağlanmasıyla tetiklenir; bu durum protein agregasyonuna ve proteotoksik strese yol açar9. Bağırsak, bakır yönetimi üzerinde merkezi bir rol oynadığından, bu yolaktaki bozulmalar ÜK'deki oksidatif ve inflamatuar epitelyal hasarı artırabilir10.
Ferroptoz ve kuproptoz; metal iyonu dengesizliği, mitokondriyal metabolizma, glutatyon tükenmesi ve oksidatif stres yoluyla ortak noktada buluşabilir11. Ancak, bu etkileşimin ÜK'de tekrarlanabilir bir moleküler imza oluşturup oluşturmadığı ve böyle bir imzanın yola özgü inhibisyona yanıt verip vermediği henüz çözülmemiştir.
Çalışma hipotezi, ÜK'de (ülseratif kolit) düzensizleşmiş ferroptoz-kuproptoz etkileşiminin, bulk ve tek hücreli transkriptomik veri setleri genelinde önceliklendirilebilen ve bir intestinal epitel hasarı modelinde yola özgü inhibisyonla hafifletilebilen, tekrarlanabilir bir biyobelirteç imzasına odaklandığı yönündeydi. Buna uygun olarak, aday biyobelirteçleri tanımlamak ve fonksiyonel olarak değerlendirmek için çok kohortlu biyoinformatik, makine öğrenimi, tek hücre analizi ve hedeflenmiş Caco-2 deneyleri entegre edilmiştir (Şekil 1).
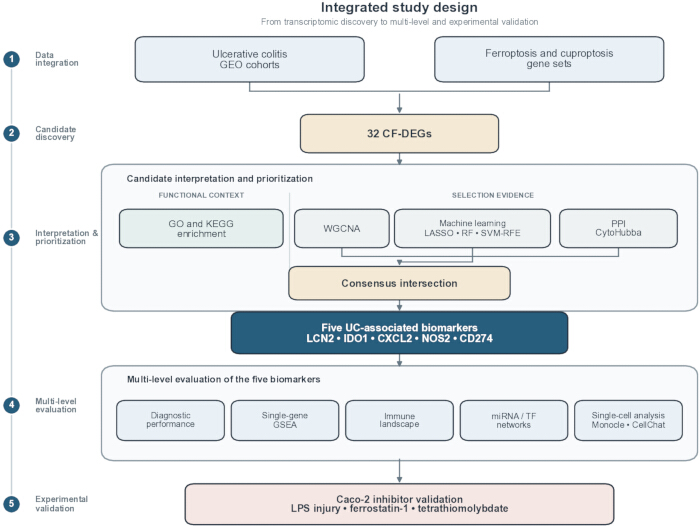
Şekil 1: Çalışma iş akışı. Çoklu kohort transkriptomik tarama, makine öğrenimi ve ağ tabanlı biyobelirteç önceliklendirmesi, tek hücre lokalizasyonu ve Caco-2 hücrelerinde inhibitör tabanlı doğrulama için entegre iş akışı. UC: ülseratif kolit; GEO: Gene Expression Omnibus; WGCNA: ağırlıklı gen eş-ekspresyon ağ analizi; PPI: protein-protein etkileşimi; ROC: alıcı işletim karakteristiği; GSEA: gen seti zenginleştirme analizi. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Protokol
Bu çalışmada halka açık veri setleri ve ticari olarak temin edilebilen insan hücre hatları kullanılmıştır. Herhangi bir insan katılımcı, yeni toplanmış insan dokusu veya omurgalı hayvan kullanılmadığı için kurumsal etik kurul onayı gerekmemiştir. Protokolde kullanılan araştırma araçları, yazılımlar ve çevrimiçi kaynaklar Materyal Tablosu'nda listelenmiştir.
1. Diferansiyel ekspresyon analizi için veri işleme
Transkriptomik keşif ve doğrulama kohortlarını oluşturmak için Gene Expression Omnibus (GEO) veri tabanında “ulcerative colitis” terimi kullanılarak arama yapılmıştır. GSE87466, GSE92415, GSE107499 ve GSE75214 olmak üzere dört veri seti eğitim seti olarak kullanılırken, GSE47908 harici doğrulama için ayrılmıştır. Eğitim veri setleri Sangerbox 3.0 içindeki ComBat kullanılarak normalize edilmiş ve grup etkisinden (batch effect) arındırılmış, doğrulama veri seti ise bağımsız olarak işlenmiştir.
Tek kaynak yanlılığını azaltmak amacıyla FerrDB'den toplam 583 ferroptozis ilişkili gen (FRG) elde edilmiş ve literatürde bildirilen genlerle desteklenmiştir12. Yayınlanmış çalışmalardan 96 kuproptozis ilişkili gen (CRG) içeren bir set derlenmiştir12,13,14. Diferansiyel ekspresyon analizi, |log₂ fold change| > 1 ve Benjamini-Hochberg düzeltmeli P < 0.05 eşik değerleri kullanılarak limma ile gerçekleştirilmiştir. Normalizasyon, grup düzeltmesi (batch correction), diferansiyel ekspresyon ve kümeleme analizlerine ait tanısal grafikler Ek Şekil 1'de sunulmuştur. Örnek kompozisyonu, platformlar ve kohort atamaları Ek Tablo 1'de verilmiştir.
2. UC'de CF-DEGs'lerin Belirlenmesi
Ortak eksprese edilen FRG'ler ve CRG'leri belirlemek amacıyla |r| > 0.5 ve P < 0.05 eşik değerleri kullanılarak Pearson korelasyon analizi gerçekleştirilmiştir. Elde edilen gen seti, kuproptoz-ferroptoz ortak eksprese edilen diferansiyel eksprese genleri (CF-DEG'ler) belirlemek için diferansiyel eksprese genler (DEG'ler) ile kesiştirilmiştir.
3. Zenginleştirme analizi
Gen Ontolojisi (GO) ve Kyoto Gen ve Genom Ansiklopedisi (KEGG) zenginleştirme analizleri, clusterProfiler ve Bioinformatics.com.cn platformu kullanılarak gerçekleştirilmiştir. Anlamlılık eşiği olarak Benjamini–Hochberg düzeltmeli P < 0.05 değeri kullanılmıştır. Zenginleştirme grafikleri Ek Şekil 2'de sunulmuştur.
4. Ağırlıklı gen ko-ekspresyon ağ analizi (WGCNA)
Gen ekspresyon profillerinin temelini oluşturan modüler yapı, ağırlıklı gen eş-ekspresyon ağ analizi (WGCNA) kullanılarak incelenmiştir. Anormal örnekler, hiyerarşik kümeleme ve goodSamplesGenes fonksiyonu kombinasyonuyla belirlenmiş ve analiz dışı bırakılmıştır. Ardından, ağ kurulumu için ölçeksiz topoloji kriterini karşılayacak uygun bir yumuşak eşikleme gücü (β) belirlenmiştir.
İşlenmiş ekspresyon verileri, gen ko-ekspresyon analizi için bir topolojik örtüşme matrisi (TOM) oluşturmak amacıyla kullanıldı. Dinamik ağaç kesme yaklaşımı kullanılarak, oldukça tutarlı ekspresyon modellerine sahip genler, her biri en az 100 gen içeren gen modülleri halinde organize edildi. Hastalık süreciyle ilişkili modülleri belirlemek ve ilgili gen setlerini çıkarmak için modül özgenleri (ME'ler) ve fenotipler arasındaki ilişkiler analiz edildi. WGCNA tarama tanıları Ek Şekil 3'te sunulmuştur.
5. Biyobelirteçlerin seçimi
Deneysel takip için adayları önceliklendirmek amacıyla, üç makine öğrenimi algoritması paralel olarak uygulanmıştır15. Özellik seçimi için en küçük mutlak küçültme ve seçme operatörü (LASSO) regresyonu, gen önem sırasını belirlemek için ntree = 500 ile rastgele orman (random forest) ve en düşük çapraz doğrulama hatasına sahip özellik alt kümesini tanımlamak için destek vektör makinesi-özyinelemeli özellik eleme (SVM-RFE) kullanılmıştır. Tam tarama tanıları Ek Şekil 5'te sunulmuştur.
Gen önemi, tekil genlerin sınıflandırma doğruluğuna olan katkısına göre değerlendirilmiş ve öncül bir gen seti oluşturmak için yüksek sıralamadaki genler toplanmıştır16. SVM-RFE algoritması, iteratif özellik elemesi yoluyla özellik taraması ve model optimizasyonu gerçekleştirerek sınıflandırma için optimal özellik alt kümesinin belirlenmesini sağlamıştır17. Üç algoritma arasında ortak olan genler, makine öğrenimi yoluyla belirlenen aday biyobelirteçler olarak kabul edilmiştir.
CF-DEG'ler bir protein-protein etkileşim (PPI) ağı oluşturmak için kullanılmış ve çekirdek düğümleri sıralamak için CytoHubba kullanılmıştır. Temel WGCNA modüllerinin, üç makine öğrenimi çıktısının ve PPI çekirdek setinin kesişimi; LCN2, IDO1, CXCL2, NOS2 ve CD274 olmak üzere beş entegre aday biyobelirteci tanımlamıştır. Bu genler, UC ile ilişkili tanı adayları olarak sınıflandırılmıştır. Müteakip inhibitör deneyleri, LCN2, IDO1, CXCL2 ve NOS2'yi ferroptoz inhibisyonuna yanıt veren belirteçler, CD274'ü ise kuproptoz inhibisyonuna yanıt veren bir belirteç olarak daha ileri düzeyde sınıflandırmıştır. Bu genler, her iki yolun da kanıtlanmış üst regülatörleri olarak değerlendirilmemiştir.
6. Öngörücü model geliştirme ve çok yöntemli değerlendirme
Belirlenen gen imzasının klinik translasyonel potansiyelini değerlendirmek amacıyla, tanısal performansı ölçmek için rms paketi kullanılarak bir nomogram oluşturulmuştur. Model performansı; bir kalibrasyon eğrisi, Hosmer–Lemeshow (HL) testi ve Harrell uyum indeksi (C-indeksi) kullanılarak değerlendirilmiştir.
Model kalibrasyonu, HL testi ve ortalama mutlak hata (MAE) kullanılarak değerlendirildi. Kabul edilebilir model uyumu ve doğruluğu için eşik değerleri sırasıyla P değeri > 0,05 ve MAE < 0,1 olarak belirlendi. Nomogramın UC için öngörücü performansını değerlendirmek amacıyla alıcı işletim karakteristik (ROC) eğrileri oluşturuldu ve eğri altında kalan alan (AUC) hesaplandı. Modelin genellenebilirliğini ve stabilitesini değerlendirmek için bağımsız bir veri seti kullanıldı.
7. Gen seti zenginleştirme analizi (GSEA)
Eğitim setinde, her bir biyobelirteç ile diğer tüm genler arasında Spearman korelasyon analizi gerçekleştirilmiştir. Korelasyon sonuçları, sıralı bir gen seti oluşturmak amacıyla derecelendirilmiştir. Referans olarak Molecular Signatures Database (MSigDB) bünyesindeki c2.cp.kegg_medicus.v2025.1.Hs.symbols gen seti kullanılarak Gen Seti Zenginleştirme Analizi (GSEA) yapılmıştır. P < 0.05 olan biyolojik yolaklar anlamlı düzeyde zenginleşmiş olarak kabul edilmiştir.
8. İmmün manzara analizi
Ekspresyon verilerinin dekonvolüsyon analizini gerçekleştirmek ve 22 immün hücre alt tipinin oranlarını tahmin etmek için CIBERSORT aracı ve LM22 imza matrisi kullanılmıştır. Beş biyobelirteç ile immün hücre alt tipleri arasındaki ilişkileri değerlendirmek için ardından Spearman korelasyon analizi yapılmıştır.
9. Düzenleyici ağ analizi
Genle ilişkili transkripsiyon faktörü (TF) ve mikroRNA (miRNA) regülasyonuna ilişkin bilgiler, NetworkAnalyst platformu aracılığıyla entegre ChEA3 ve TarBase 9.0 veri tabanlarından elde edilmiştir. En az iki düğümle ilişkili olan miRNA'lar regülasyon ağına dahil edilmiştir.
10. Tek hücreli RNA-seq
Üç sağlıklı ve üç UC örneğinden oluşan GSE116222 ile altı sağlıklı ve altı UC örneğinden oluşan GSE214695 UC tek hücre veri setleri entegre edildi. 200–5.000 arası saptanan gen, >1.000 benzersiz moleküler tanımlayıcı, < %30 mitokondriyal transkript, < %3 hemoglobin transkripti ve < %50 ribozomal transkript içeren hücreler tutuldu. Normalizasyon için NormalizeData fonksiyonu, kümeleme ve anotasyon öncesindeki grup düzeltmesi (batch correction) için ise Harmony kullanıldı.
Filtreleme işleminden sonra, veriler NormalizeData fonksiyonu kullanılarak normalize edildi. Örnekler arasındaki batch etkilerini minimize etmek için Harmony kullanıldı. Hücre popülasyonu içindeki lokal ve global yapıları karakterize etmek amacıyla boyut indirgeme ve hücre kümeleme için Uniform manifold approximation and projection (UMAP) ve t-distributed stochastic neighbor embedding (t-SNE) kullanıldı. Daha ileri analizler için toplam 31.712 yüksek kaliteli hücre tutuldu. Hücre tipleri, kanonik hücre belirteç genlerine göre tanımlandı.
UC dokularındaki epitelyal ve miyeloid hücrelerin durumlarındaki değişiklikleri incelemek için Monocle 2 kullanılarak psödozaman analizi gerçekleştirildi. Hücre gelişim yörüngeleri ve gruplar arası farklar değerlendirildi ve psödozaman yörüngesi boyunca biyobelirteç ekspresyon modelleri görselleştirildi.
Epitel ve miyeloid hücre alt kümeleri arasındaki hücre-hücre iletişimini değerlendirmek için CellChat kullanılmıştır. Epitel ve miyeloid hücreler arasındaki etkileşim olasılıklarını ve temel sinyal yolaklarını belirlemek ve potansiyel hücreler arası düzenleyici ağlarını karakterize etmek için alt popülasyona özgü ekspresyon paternleri entegre edilmiştir.
11. Hücre deneyleri
İnsan Caco-2 kolon adenokarsinom hücreleri; %10 fetal bovine serum, 100 U/mL penisilin ve 100 µg/mL streptomisin içeren Dulbecco’s modified Eagle besiyerinde, 37 °C sıcaklıkta ve %5 CO₂ ortamında kültüre edilmiştir. Caco-2 hücreleri, intestinal bariyer ve inflamatuar hasar analizleri için tekrarlanabilir bir epitelyal monolayer modeli olarak seçilmiştir; ancak, malign kökenleri bu sonuçların malign olmayan kolon epitelyumuna doğrudan genellenmesini sınırlar. Arşivlenmiş deneysel kayıtlarda pasaj bilgisine ulaşılamamıştır.
Hücrelerin 24 saat boyunca 1 µg/mL lipopolisakkarit (LPS) maruziyetine bırakılmasıyla bir in vitro inflamatuar hasar modeli oluşturuldu. Hücreler; eşleşmiş nihai çözücü konsantrasyonları ile bir dimetil sülfoksit taşıyıcı kontrol grubuna, yalnızca LPS grubuna, LPS + 4 µM ferrostatin-1 grubuna veya LPS + 40 µM tetratiyomolibdat grubuna ayrıldı. Yalnızca LPS grubuna, inhibitör kurtarma karşılaştırmaları için pozitif hasar/model kontrolü olarak hizmet edildi.
- Hücre canlılığı
Hücre canlılığı, üretici talimatlarına uygun olarak bir hücre canlılığı testi kullanılarak değerlendirilmiştir. Yaklaşık 2 saat boyunca 37 °C'de inkübasyon sonrası, 450 nm'deki absorbans bir mikroplaka okuyucu kullanılarak ölçülmüştür. - MDA ve Fe²⁺ seviyelerinin ölçümü
Hücre içi malondialdehit (MDA) ve Fe2⁺ seviyeleri, üretici talimatlarına uygun olarak ilgili analiz kitleri kullanılarak ölçülmüştür. Toplam protein miktarı bir bisinkoninik asit testi kullanılarak belirlenmiş ve her okuma, ilgili örneğin protein içeriğine göre normalize edilmiştir. - Bakır iyonu floresan prob analizi
Kültür ortamı uzaklaştırıldıktan sonra, 1 µM final konsantrasyonunda Cu2⁺-spesifik bir floresan prob eklenmiş ve 37 °C'de 30 dakika inkübe edilmiştir. Görüntüler, yıkama işlemi yapılmadan, sırasıyla 510 ve 578 nm eksitasyon ve emisyon dalga boylarında bir ters floresans mikroskobu kullanılarak anlık olarak elde edilmiştir. Görüntüleme ayarları tüm gruplar için sabit tutulmuş ve görüntü ölçek çubuğu 50 µm olarak kalibre edilmiştir. - RT-qPCR
Toplam RNA, fenol-guanidinyum tabanlı bir RNA ekstraksiyon reaktifi kullanılarak izole edilmiştir. Komplementer DNA, 1 µg RNA'dan bir birinci zincir komplementer DNA sentez kiti kullanılarak sentezlenmiş ve gerçek zamanlı PCR için SYBR Green tabanlı reaktifler kullanılmıştır. Her reaksiyon teknik olarak üç tekrarlı (triplicate) gerçekleştirilmiştir. Primer dizileri Ek Tablo 2'de verilmiş olup, göreceli haberci RNA bolluğu 2⁻ΔΔCt yöntemi kullanılarak hesaplanmıştır.
12. İstatistiksel analiz
Normallik ve varyans homojenliği, sırasıyla Shapiro-Wilk ve medyan merkezli Levene testleri kullanılarak değerlendirildi. Her iki varsayımı da karşılayan veriler, eşleşmemiş iki yönlü t-testi veya ardından Tukey'nin dürüst anlamlı fark testi ile tek yönlü varyans analizi kullanılarak analiz edildi. Varsayımlardan herhangi birinin karşılanmadığı durumlarda, Welch t-testi veya ardından Games-Howell karşılaştırmaları ile Welch varyans analizi kullanıldı.
Sonuçlar ortalama ± standart sapma olarak sunulmuştur. Gerçek biyolojik replika sayıları, kesin iki yönlü P değerleri ve varsayım kontrolleri Ek Tablo 3'te raporlanmıştır. Arşivlenen Şekil 13 kaynak sayfası, A (n = 4), C (n = 4) ve F (n = 2) panelleri için daha az kontrol replikası içerirken, diğer tüm panel/grup kombinasyonları n = 6 içermektedir.
Hesaplamalı analizler R ve limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat ve Cytoscape/CytoHubba iş akışları kullanılarak gerçekleştirilmiştir. Çevrimiçi kaynaklar arasında FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn ve Sangerbox 3.0 yer almıştır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Sonuçlar
Kuproptozis–ferroptozis ko-ekspresyon gösteren genlerin tanımlanması ve fonksiyonel anotasyonu
421 UC örneği ve 97 sağlıklı kontrolden oluşan dört eğitim veri seti entegre edildi. 362'si artmış ve 189'u azalmış olmak üzere toplam 551 diferansiyel ekspresyon gösteren gen tanımlandı. Korelasyon analizi sonucunda 444 ferroptoz-kuproptoz ile ilişkili gen elde edildi ve diferansiyel ekspresyon gösteren genlerle yapılan kesişim analizi, 32 kuproptoz-ferroptoz ko-eksprese diferansiye...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Tartışma
Bu çalışma, UC'deki ferroptozis–kuproptozis etkileşimini incelemek için toplu transkriptomik, makine öğrenimi, tek hücre analizi ve hedefli hücre deneylerini entegre etmiştir. UC ile ilişkili beş tanısal aday, keşif ve doğrulama kohortları genelinde tekrarlanabilir bulunmuş, temel olarak epitelyal ve miyeloid kompartmanlarda lokalize olmuş ve Caco-2 hücrelerinde yolak inhibisyonuna yanıt veren bir ekspresyon sergilemiştir. Bu bulgular, beş genin ferroptozis veya kuproptozisin yerleşik üst akış düzenleyicileri olduğu yönü...
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Açıklamalar
Yazarların beyan edecek herhangi bir çıkar çatışması yoktur.
Teşekkürler
Bu çalışma, Ulusal Geleneksel Çin Tıbbı İdaresi'nin Genç Qihuang Bilim İnsanı Projesi (Hibe No. 2022256) tarafından desteklenmiştir. Teknik destek ile veri kürasyonu ve biyoinformatik analizlerine katkıları için Liaoning Geleneksel Çin Tıbbı Üniversitesi ve Liaoning Geleneksel Çin Tıbbı Üniversitesi Üçüncü Bağlı Hastanesi'ndeki tüm araştırma ekibi üyelerine teşekkür edilir.
OpenAI Codex (OpenAI), revizyon sırasında yalnızca İngilizce dil düzenleme, belge biçimlendirme ve şekil kalitesi kontrollerine yardımcı olmak amacıyla kullanılmıştır. Tüm bilimsel içerik, analizler, atıflar ve nihai sunum, taslak metnin tüm sorumluluğunu üstlenen yazarlar tarafından incelenmiş ve doğrulanmıştır.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| BCA Protein Assay Kit | Beyotime Institute of Biotechnology | P0010 | Normalizasyon için protein nicelleştirmesi. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Çevrimiçi platform; 2026'da erişildi | GO/KEGG görselleştirme ve analiz platformu. |
| Caco-2 hücre hattı | ATCC | HTB-37 | Epitelyal hasar modeli için kullanılan insan kolorektal adenokarsinom hücre hattı. |
| Cell Counting Kit-8 | GLPBio | GK10001 | 450 nm'de ölçülen hücre canlılık analizi. |
| LM22 imzalı CIBERSORT | CIBERSORT geliştiricileri | LM22 | 22 immün hücre fraksiyonunun dekonvolüsyonu. |
| ChEA3 | Ma'ayan Laboratory | Çevrimiçi platform; 2026'da erişildi | Transkripsiyon faktörü zenginleştirme ve regülatör ağ tahmini. |
| CO2 inkübatörü | Kaydedilmedi | N/A | 37 °C ve %5 CO2'de kültür için kullanılan nemlendirilmiş inkübatör. |
| Cu2+ floresan probu | BIOFOUNT | CAS 98907-26-7 | Hücre içi Cu2+ floresans tespiti. |
| CytoHubba ile Cytoscape | Cytoscape Consortium | Versiyon kaydedilmedi | PPI görselleştirme ve çekirdek düğüm sıralaması. |
| Dulbecco modifiye Eagle ortamı | Gibco | 11965092 | Caco-2 hücre kültür ortamı. |
| Dimetil sülfoksit | Kaydedilmedi | N/A | Araç kontrolü. |
| Fetal sığır serumu | Kaydedilmedi | N/A | %10 oranında ortam takviyesi. |
| Fe2+ Analiz Kiti | Abcam | ab83366 | Hücre içi Fe2+ ölçümü. |
| FerrDB | FerrDB geliştiricileri | Çevrimiçi veri tabanı; 2026'da erişildi | Ferroptozla ilişkili genlerin kaynağı. |
| Ferrostatin-1 | Sigma-Aldrich | SML0583 | Ferroptoz inhibitörü; final konsantrasyonu 4 µM. |
| Harmony | Broad Institute/topluluk | Versiyon kaydedilmedi | Tek hücreli batch düzeltmesi. |
| Ters floresan mikroskobu | Olympus | IX71 | 510/578 nm eksitasyon/emisyon'da Cu2+ floresan görüntüleme. |
| Lipopolisakkarit | Kaydedilmedi | N/A | 24 sa boyunca 1 µg/mL oranında inflamatuar hasar stimulusu. |
| Malondialdehit Analiz Kiti | Beyotime Institute of Biotechnology | S0131S | Lipid peroksidasyonunun ölçümü. |
| Mikroplaka okuyucu | Kaydedilmedi | N/A | 450 nm'de absorbans ölçümü. |
| Monocle | Bioconductor/topluluk | Versiyon 2 | Tek hücreli psödozaman analizi. |
| Molecular Signatures Database | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | GSEA için referans gen seti. |
| NetworkAnalyst | NetworkAnalyst geliştiricileri | Çevrimiçi platform; 2026'da erişildi | Transkripsiyon faktörü ve miRNA ağlarının entegrasyonu. |
| Penisilin–streptomisin | Kaydedilmedi | N/A | 100 U/mL penisilin ve 100 µg/mL streptomisin. |
| R | R Foundation for Statistical Computing | Versiyon kaydedilmedi | Biyoenformatik analiz ortamı. |
| R paket seti | CRAN/Bioconductor | Paket sürümleri kaydedilmedi | limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC ve rms iş akışları. |
| Real-time PCR sistemi | Kaydedilmedi | N/A | SYBR Green RT-qPCR cihazı. |
| RevertAid First Strand cDNA Synthesis Kit | Thermo Fisher Scientific | K1622 | 1 µg RNA'dan birinci zincir cDNA sentezi. |
| Sangerbox | Sangerbox geliştiricileri | 3.0 | Normalizasyon ve ComBat batch düzeltmesi. |
| Seurat | Satija Lab/topluluk | Versiyon 4 | Tek hücreli kalite kontrol, normalizasyon, kümeleme ve görselleştirme. |
| İstatistiksel analiz yazılımı | Kaydedilmedi | N/A | Orijinal hücre deneylerinin istatistiksel analizi. |
| STRING | STRING Consortium | Çevrimiçi veri tabanı; 2026'da erişildi | Protein–protein etkileşim ağı oluşturma. |
| SYBR Green real-time PCR reaktifleri | Takara | RR820A | Kantitatif real-time PCR. |
| TarBase | DIANA Tools | 9.0 | Deneysel olarak desteklenen miRNA–gen etkileşimleri. |
| Tetratiyomolibdat | Sigma-Aldrich | 323446 | Bakır şelatörü; final konsantrasyonu 40 µM. |
| TRIzol reaktifi | Takara | 9108 | Toplam RNA ekstraksiyonu. |
Kaynaklar
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Erişim kısıtlı. Bu içeriği görüntülemek için lütfen giriş yapın veya deneme sürümünü başlatın.