Bu protokol, sağlık hizmetlerinde açıklanabilir yapay zeka modellerinin geliştirilmesi, değerlendirilmesi ve yorumlanması için tekrarlanabilir bir iş akışı sunmaktadır. Şeffaflığı, güvenilirliği ve klinik uygulanabilirliği artırmak amacıyla standartlaştırılmış veri hazırlama, model geliştirme, açıklanabilirlik teknikleri, nicel değerlendirme ve tekrarlanabilirlik uygulamalarını entegre eder.
Yöntem makalesi
Sağlık Sistemlerinde Açıklanabilir Yapay Zeka Modelleri Geliştirmek ve Değerlendirmek İçin Tekrarlanabilir Bir Deneysel Protokol
Bu makalede
Özet
Özet
Yapay zeka (AI), klinik karar verme, hastalık öngörüsü, tıbbi teşhis ve kişiselleştirilmiş sağlık hizmetleri için giderek daha değerli bir araç olarak benimsenmektedir. Ancak, şeffaflık eksikliği, açıklanabilir yapay zeka (XAI) yöntemlerinin tutarsız uygulanması ve sınırlı tekrarlanabilirlik, AI modellerinin klinik ortamlarda güvenilir bir şekilde yaygınlaştırılmasının önündeki temel engeller olmaya devam etmektedir. Bu makale, sağlık uygulamaları için açıklanabilir AI modellerinin geliştirilmesi, değerlendirilmesi ve yorumlanması için sistematik, tekrarlanabilir ve şeffaf bir protokol önermektedir. İş akışı, hesaplama ortamının kurulumuyla başlar; bunu veri edinimi ve karakterizasyonu, ön işleme, özellik mühendisliği, model geliştirme, hiperparametre optimizasyonu, öngörücü performans değerlendirmesi, açıklanabilirlik analizi, istatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesi izler. Protokol, hem küresel hem de yerel model yorumlamaları oluşturmak için SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, dikkat görselleştirme ve karşı olgusal açıklamalar gibi XAI yöntemlerini içermektedir. Protokol; standartlaştırılmış sağlık veri setlerinin hazırlanması, kararlı makine öğrenimi modellerinin geliştirilmesi, öngörücü performansın değerlendirilmesi, klinik olarak anlamlı açıklamaların oluşturulması ve tekrarlanan deneyler genelinde tekrarlanabilirliğin istatistiksel değerlendirmesi dahil olmak üzere birkaç temel bileşene vurgu yapmaktadır. Model geliştirme, açıklanabilirlik, nicel ve nitel değerlendirme, istatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesini birleşik bir iş akışına entegre ederek, bu protokol, sağlık uygulamaları için şeffaf ve tekrarlanabilir AI modelleri geliştirmek adına kapsamlı bir çerçeve sunmaktadır.
Giriş
Yapay zeka, karmaşık klinik verilerin akıllı analizine olanak tanıyarak ve kanıta dayalı tıbbi karar verme süreçlerini destekleyerek modern sağlık hizmetlerinin ayrılmaz bir bileşeni haline gelmiştir1. Elektronik sağlık kayıtları, tıbbi görüntüleme sistemleri, giyilebilir cihazlar ve genomik teknolojiler aracılığıyla sağlık hizmetlerinin hızla dijitalleşmesi, etkili bir yorumlama için gelişmiş hesaplama yaklaşımları gerektiren büyük hacimlerde heterojen veriler üretmiştir2.
Makine öğrenimi (ML) ve derin öğrenme (DL) algoritmaları, çok boyutlu sağlık hizmetleri veri setlerinden anlamlı modeller çıkarma konusunda dikkat çekici yetenekler göstermiş; böylece tanı doğruluğunu, hastalık öngörüsünü ve hasta sonuç değerlendirmelerini iyileştirmiştir3. Yapay zeka tabanlı modeller; klinisyenlerin hastalıkları daha erken evrelerde tespit etmelerine ve kişiselleştirilmiş tedavi stratejileri önermelerine yardımcı olmak amacıyla radyoloji, patoloji, kardiyoloji, onkoloji, oftalmoloji ve diğer tıbbi uzmanlık alanlarında başarıyla uygulanmıştır4. Bu teknolojiler ayrıca iş akışının optimizasyonuna, tanısal değişkenliğin azaltılmasına ve sağlık hizmetleri kaynaklarının kullanımının iyileştirilmesine katkıda bulunmuştur5.
Hesaplamalı donanım, bulut bilişim ve açık kaynaklı yapay zeka çerçevelerindeki son gelişmeler, akıllı sağlık uygulamalarının geliştirilmesini ve yaygınlaştırılmasını hızlandırmıştır6. Sonuç olarak yapay zeka, hassas tıp ve klinik karar destek sistemleri için temel bir kolaylaştırıcı teknoloji haline gelmiştir7. Bu ilerlemelere rağmen, birçok yüksek performanslı modelin tahminlerinin nasıl oluşturulduğuna dair çok az bilgi sunması nedeniyle, yapay zekanın rutin klinik uygulamalarda yaygın olarak benimsenmesi sınırlı kalmaya devam etmektedir8.
Çoğu derin öğrenme algoritması, dahili karar verme sürecinin klinisyenler ve araştırmacılar tarafından anlaşılmasının zor olduğu karmaşık kara kutu modeller olarak işlev görür9. Bu modeller genellikle mükemmel öngörü performansı sergilese de, şeffaflık eksikliği kullanıcı güvenini sarsmakta; klinik doğrulama, düzenleyici onay ve hasta güvenliği açısından zorluklar yaratmaktadır10. Sağlık profesyonelleri, özellikle yüksek riskli tıbbi ortamlarda, yapay zeka destekli kararları rutin klinik uygulamaya dahil etmeden önce bunları gerekçelendirebilmelidir11.
XAI, makine öğrenimi modellerinin şeffaflığını ve yorumlanabilirliğini artırmak için etkili bir yaklaşım olarak ortaya çıkmıştır12. Tahmin modellerini opak sistemler olarak ele almak yerine, XAI teknikleri bireysel tahminlere katkıda bulunan özellikler, görüntü bölgeleri veya klinik değişkenler hakkında bilgi sağlar13. Bu tür açıklamalar, klinisyenlerin model davranışını daha iyi anlamalarına, potansiyel yanlılıkları belirlemelerine ve yapay zeka tarafından üretilen kararların yerleşik tıbbi bilgilerle uyumlu olup olmadığını saptamalarına olanak tanır14.
Sağlık hizmetleri uygulamaları için çeşitli açıklanabilirlik teknikleri geliştirilmiştir. SHapley Additive explanations (SHAP), kooperatif oyun teorisine dayanarak her bir özelliğin model tahminine olan katkısını ölçer15. Local Interpretable Model-agnostic Explanations (LIME), basitleştirilmiş bir model oluşturarak kara kutu modelinin tahminlerini açıklar16. Derin öğrenme modellerinin kullanıldığı tıbbi görüntüleme görevleri için Gradient-weighted activation maps (Grad-CAM), görüntünün sınıflandırma kararlarına katkıda bulunan bölgelerini görsel olarak belirten ısı haritaları oluşturur17. Bu yöntemlerin kombinasyonu, farklı sağlık hizmetleri alanlarında yapay zeka sistemlerinin şeffaflığını önemli ölçüde artırmıştır18.
Sağlık hizmetleri alanında açıklanabilirlik yöntemlerine verilen önemin artmasına rağmen, bunların literatürdeki kullanımı farklılık göstermeye devam etmektedir. Araştırmacılar yalnızca ön işleme stratejilerinin kullanımı konusunda değil, aynı zamanda model mimarisinin tasarımı, değerlendirme metrikleri ve hatta açıklama teknikleri konusunda da farklılık göstermektedirler19. Ayrıca, birçok makale yüksek öngörü doğruluğı bildirmekte ancak açıklamaların kalitesi veya tekrarlanabilirliği hakkında kapsamlı bir değerlendirme sunmakta yetersiz kalmaktadır20.
Tekrarlanabilirlik, modern yapay zeka bilimindeki en büyük darboğazlardan biridir. Makaleler genellikle yazılım versiyonunu, hesaplama ortamını, ön işleme hattını, hiperparametre ayarlarını, rastgele tohum başlatmasını ve donanım yapılandırmalarını açıklamaz21. Bu nedenle, bağımsız araştırmacılar genellikle yayınlanmış sonuçları tekrarlamakta veya yayınlanmış yöntemleri diğer veri setleri veya yazılım platformlarını kullanarak doğrulamakta başarısız olurlar22. Ayrıntılı dokümantasyon eksikliği; kıyaslama çalışmalarını, ortak araştırmaları ve yapay zeka sistemlerinin klinik uygulamalarını engelleyen faktörlerden biridir23.
Bu zorlukların farkında olan çeşitli kuruluşlar ve düzenleyici kurumlar, sağlık uygulamaları için şeffaf, güvenilir ve tekrarlanabilir yapay zekanın önemini vurgulamışlardır24. Mevcut raporlama kılavuzları metodolojik raporlamayı geliştirmiş olsa da, araştırmacıların doğrudan uygulayabileceği standartlaştırılmış deneysel prosedürler sağlamaktan ziyade, öncelikle nelerin raporlanması gerektiğini tanımlamaktadır25. Sonuç olarak; veri seti hazırlama, model geliştirme, açıklanabilirlik analizi, istatistiksel değerlendirme ve tekrarlanabilirlik uygulamalarını tek bir deneysel iş akışında birleştiren kapsamlı bir protokole ihtiyaç duyulmaktadır26.
Standardize edilmiş bir deneysel protokol, sağlık hizmetleri yapay zeka topluluğu için birçok avantaj sunar. Ayrıca, metodolojik tutarlılığı destekler, bağımsız çalışmaların karşılaştırılmasını kolaylaştırır, hesaplamalı deneylerin şeffaflığını artırır ve yayınlanmış sonuçların güvenilir bir şekilde doğrulanmasını sağlar27. Standardize edilmiş iş akışları aynı zamanda, farklı laboratuvarlar ve sağlık kurumları arasında tekrarlanabilir olan net bir şekilde belgelenmiş prosedürler aracılığıyla eğitim/öğretime, ortak araştırmalara ve düzenleyici değerlendirmelere yardımcı olur28.
Sağlık sistemlerinde yapay zeka modellerinin eğitimi ve değerlendirilmesi için tekrarlanabilir bir deneysel protokol geliştirilmiş ve test edilmiştir. Protokol; hesaplama ortamının yapılandırılması, sağlık veri kümelerinin ön işlemesi, makine öğrenmesi modellerinin geliştirilmesi, XAI yöntemlerinin uygulanması, öngörü performansının değerlendirilmesi, istatistiksel doğrulamanın gerçekleştirilmesi ve tekrarlanabilirliğin değerlendirilmesine yönelik standartları ana hatlarıyla belirtmektedir29. Bu tür bileşenlerin uyumlu bir iş akışına entegrasyonunun, sağlık hizmetleri yapay zeka araştırmalarının şeffaflığını, güvenilirliğini ve tekrarlanabilirliğini artırması ve aynı zamanda güvenilir akıllı sağlık sistemlerinin geliştirilmesine yardımcı olması beklenmektedir30.
Protokol
Gerçekleştirilen doğrulama deneyi, kamuya açık ve kimliksizleştirilmiş Pima Indians Diyabet Veri Setini kullanmış olup, tanımlanabilir hasta kayıtlarını veya yeni hasta alımını içermemiştir. Bu nedenle, bilgilendirilmiş onam ve kurumsal IRB/etik kurul onayı gerekmemiş olup, tüm analizler ilgili veri seti şartlarına ve kurumsal araştırma politikalarına uygun olarak yürütülmüştür.
Uygulamalı doğrulama örneğinde, ikili diyabet tahmini için 768 kayıt içeren ve halka açık olan Pima Indians Diabetes Veri Kümesi kullanılmıştır. Dokuz aşamalı temel iş akışının tamamı bu veri kümesine uygulanmıştır. Dokuz temel aşama; veri kümesi seçimi ve doğrulaması, hesaplama ortamı yapılandırması, veri ön işleme, veri kümesi bölümlendirme, model geliştirme ve eğitimi, öngörücü ve hesaplama performansı değerlendirmesi, açıklanabilirlik analizi, istatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesinden oluşmaktadır. Harici doğrulama ve klinik uzman değerlendirmesi isteğe bağlı doğrulama modülleri olarak tutulmuş ve mevcut uygulamalı örnekte gerçekleştirilmemiştir. Şekil 1 temel protokol iş akışını göstermekte ve Tablo 1 mevcut uygulamalı doğrulamada yürütülen dokuz temel aşamayı özetlemektedir; isteğe bağlı harici doğrulama ve klinik uzman değerlendirmesi Protokol içinde ayrıca açıklanmıştır ve dokuz deneysel aşama arasında yer almamaktadır.
1. Sağlık hizmetleri veri setini seçin ve doğrulayın
- Çalışılan doğrulama örneği için birincil veri seti olarak Pima Kızılderilileri Diyabet Veri Setini seçin. Veri seti kaynağını, örneklem büyüklüğünü, tahmin hedefini, sınıf dağılımını ve veri yapısını doğrulayın.
- Önceden tanımlanmış dahil etme, hariç tutma ve veri kalitesi kriterlerini uygulayın. Model geliştirmeden önce yinelenen ve geçersiz kayıtları kaldırın.
- Veri seti kaynağını, özelliklerini, tahmin görevini, sınıf dağılımını, dahil etme ve hariç tutma kriterlerini ve bölümlendirme stratejisini Tablo 2'ye kaydedin.
- Veri seti ve model seçimi için karar kriterlerini uygulayın
- Veri setini, model mimarisini, ön işleme stratejisini veya açıklanabilirlik yöntemini seçmeden önce tahmin amacını tanımlayın.
- Veri seti modalitesini tahmin amacıyla eşleştirin. Yapılandırılmış klinik değişkenler için tablo verilerini, tıbbi görüntüler için görüntüleme verilerini, fizyolojik sinyaller için zaman serisi verilerini, klinik anlatılar için metin verilerini veya aynı hasta veya çalışma birimi için tamamlayıcı modaliteler mevcut olduğunda multimodal verileri seçin.
- Aday veri setlerini örneklem büyüklüğü, sonuç kullanılabilirliği, sınıf dağılımı, eksiklikler, açıklama kalitesi, klinik uygunluk, veri bütünlüğü ve erişilebilirlik açısından değerlendirin. Önceden tanımlanmış gereksinimleri karşılayan veri setini seçin.
- Örneklem büyüklüğü, hesaplama kaynakları veya yorumlanabilirlik gereksinimleri karmaşık mimarilerin kullanımını kısıtladığında, yapılandırılmış tablo verileri için geleneksel makine öğrenmesi modellerini seçin. Yeterli eğitim verisi ve tıbbi görüntüler, fizyolojik sinyaller veya klinik metinler gibi yüksek boyutlu girdiler mevcut olduğunda derin öğrenme mimarilerini seçin.
- Multimodal mimarileri yalnızca aynı hasta veya çalışma birimi için birden fazla modalite mevcut olduğunda ve bilgi sızıntısına yol açmadan güvenilir şekilde hizalanabildiğinde seçin. Ön işleme işlemlerini seçilen veri modalitesinin özelliklerine göre seçin.
- Açıklanabilirlik yöntemlerini modele ve veri modalitesine göre seçin. Uygun tablo modelleri için SHAP veya LIME gibi model-agnostik yöntemleri ve uygulanabildiği durumlarda görüntü tabanlı modeller için Grad-CAM gibi modaliteye özel yöntemleri kullanın.
- Veri seti, ön işleme stratejisi, model ve açıklanabilirlik yöntemi seçimlerinin gerekçelerini belgeleyin. Bu kararları yeniden üretilebilirlik kaydının bir parçası olarak saklayın.
2. XAI model geliştirme için hesaplama ortamını yapılandırın
- İşletim sistemini, CPU'yu, RAM'i, depolamayı ve GPU'yu seçilen model gereksinimlerine göre yapılandırın. İzole bir Python ortamı oluşturun ve gerekli makine öğrenimi, derin öğrenim, istatistiksel, görselleştirme ve XAI kütüphanelerini yükleyin.
- Gerçekleştirilen doğrulama için kullanılan gerçek hesaplama ortamını, model mimarisini ve hiperparametreleri Tablo 3'e kaydedin. Optimize ediciyi, öğrenme hızını, toplu işlem boyutunu (batch size), maksimum epoch sayısını, kayıp fonksiyonunu, düzenlileştirme parametrelerini, doğrulama stratejisini, erken durdurma yapılandırmasını, rastgele tohum (random-seed) yapılandırmasını, açıklanabilirlik yöntemlerini, donanımı, işletim sistemini, Python sürümünü ve ilgili yazılım-kütüphane sürümlerini belirtin. Deneylerde kullanılan bu ayarları, genel veya önerilen protokol ayarlarından ayırt edin.
- Pima İndiyans Diyabeti Veri Kümesi doğrulamasını ve buna karşılık gelen öngörücü, açıklanabilirlik, istatistiksel ve tekrarlanabilirlik sonuçlarını yeniden üretirken Tablo 3'te bildirilen yapılandırmayı kullanın.
- Paketlerin başarıyla içe aktarıldığını, veri kümesinin yüklendiğini, modelin çalıştırıldığını ve çıktının üretildiğini onaylamak için bir doğrulama betiği çalıştırın. Tekrarlanabilirlik için kesinleşmiş ortam yapılandırmasını koruyun.
3. XAI model geliştirme için sağlık hizmetleri veri setlerini hazırlama ve karakterize etme
- Sağlık veri setini seçin ve edinin
- Tanımlanan klinik tahmin görevi için uygun bir sağlık veri seti seçin. Aday veri setlerini; araştırma hedefi, veri tipi, örneklem büyüklüğü, açıklama (notasyon) kalitesi, sınıf dengesi ve klinik uygunluk kriterlerine göre değerlendirin.
- Tahmin görevini yeterince karşıladıkları ve bağımsız doğrulamayı kolaylaştırdıkları durumlarda, halka açık kıyaslama veri setleri tercih edilmelidir.
- Kurumsal veya kurum içi veri setlerini edinmeden önce gerekli etik onayları, kurumsal izinleri ve veri erişim yetkisini alın. Seçilen veri setini, doğrulanmış bir depodan veya yetkilendirilmiş bir kurumsal veri tabanından temin edin.
- Orijinal veri seti dosyalarını herhangi bir değişiklik yapmadan koruyun ve veri seti sağlayıcısını, versiyonu, elde etme bilgilerini, lisans koşullarını, dahil etme kriterlerini, hariç tutma kriterlerini ve beraberindeki meta verileri kaydedin. Veri setini; ham veriler, açıklamalarda (notasyonlar), meta veriler ve ek bilgiler için ayrı dizinler olacak şekilde düzenleyin.
- Sağlık hizmetleri veri setini karakterize edin
- Öngörücü değişkenleri, sonuç etiketlerini, öznitelik türlerini, veri modalitelerini ve sınıf dağılımlarını belirleyin. Denek sayısını, örnek sayısını, öznitelik boyutlarını ve mevcut açıklama (anotasyon) bilgilerini tespit edin.
- Veri kümesi özelliklerinin seçilen yapay zeka yöntemiyle uyumlu olduğunu doğrulayın.
- Dokuz aşamalı temel protokolün doğrulanması için tek çalışılmış deneysel veri seti olarak Pima Kızılderilileri Diyabet Veri Setini kullanın. Şunlarda listelenen ek veri setlerini dahil edin: Tablo 2 yalnızca genel protokolün klinik tablo verileri, elektronik sağlık kayıtları, dermoskopik görüntüler, fizyolojik zaman serisi verileri ve tıbbi görüntüleme genelindeki uygulanabilirliğini göstermek amacıyla kullanılmalıdır. Bu ek veri setlerini model eğitimi, test etme, istatistiksel doğrulama veya rapor edilen deneysel sonuçların oluşturulması için kullanmayın.
- Veri seti kalitesini değerlendirin
- Veri setini yinelenen kayıtlar, bozulmuş dosyalar, eksik değerler, açıklama hataları ve düzensiz veri girişleri açısından inceleyin. Onaylanmış yinelenen kayıtları kaldırın ve doğrulanmış biçimlendirme düzensizliklerini düzeltin. Tüm veri seti kalite kontrol prosedürlerini belgeleyin.
- Multimodal veri setleri kullanılırken; görüntüleme, klinik, laboratuvar ve fizyolojik verilerin denek tanımlayıcıları aracılığıyla uygunluğu doğrulayın.
- Yinelenen veya tutarsız kayıtları kaldırın, eksik değerleri yönetin, sayısal özellikleri standartlaştırın, kategorik değişkenleri kodlayın ve modaliteye özgü ön işleme adımlarını uygulayın. Veri setini bağımsız eğitim, doğrulama ve test setlerine ayırın. Şuraya başvurun: Şekil 2 sağlık hizmetleri veri seti hazırlama, ön işleme, bölümlendirme ve kalite değerlendirme iş akışı için.
- Veri gizliliğini ve etik uyumluluğu sağlayın
- Sağlık verilerindeki doğrudan tanımlayıcıları kaldırın. Gerektiğinde anonimleştirme veya takma adlandırma (pseudonymization) prosedürlerini uygulayın. Hasta sağlık bilgilerini geçerli etik, veri koruma, bilgilendirilmiş onam ve kurumsal gerekliliklere uygun şekilde yönetin.
- Geçerli etik onayları, feragatnameleri, veri yönetişim prosedürlerini, anonimleştirme yöntemlerini ve veri seti hazırlama iş akışını kaydedin.
- Bu tür bilgilerin mevcut olduğu ve etik olarak izin verildiği durumlarda, model performansını ilgili demografik veya klinik alt gruplar arasında karşılaştırarak potansiyel algoritmik yanlılığı değerlendirin.
- Kullanım amacı, hedef popülasyon, model kısıtlamaları, potansiyel hata modları, insan denetimi gereksinimleri ile ilgili etik, veri koruma ve sağlık hizmetleri düzenleme gerekliliklerini belgeleyin.
- Tespit edilen hakkaniyet kısıtlamalarını ve sorumlu yapay zeka hususlarını, final model dokümantasyonunun bir parçası olarak kaydedin.
NOT: Yapay zeka model geliştirmeye uygun, etik kurallara uyumlu ve tanımlanmış önemli tutarsızlıklar içermeyen, standartlaştırılmış ve belgelenmiş bir sağlık veri seti edinin.
4. Yapay zeka model eğitimi için sağlık verilerinin ön işlemesi ve bölümlendirilmesi
- Kalite kontrolü gerçekleştirin
- Veri setini mükerrer kayıtlar, eksik değerler, geçersiz değerler, tutarsız etiketler, aykırı değerler ve bozuk dosyalar açısından inceleyin.
- Geçersiz gözlemleri önceden tanımlanmış kriterlere göre kaldırın veya düzeltin ve tüm hariç tutmaları kaydedin. Tahmin edici değişkenlerin ve sonuç etiketlerinin tutarlılığını doğrulayın.
- Eksik verileri yönetin
- Her değişken için eksiklik miktarını belirleyin. Önceden tanımlanmış imputasyon (atama) veya hariç tutma stratejisini uygulayın.
- İmputasyon parametrelerini yalnızca eğitim verilerini kullanarak tahmin edin ve uyarlanan dönüşümü doğrulama ve test verilerine uygulayın.
- Verileri normalleştirin ve dönüştürün
- Özellik ölçeklendirme, normalleştirme, kodlama, boyut indirgeme veya seçilen modelin gerektirdiği diğer dönüşümleri uygulayın. Veriye bağlı tüm dönüşümleri yalnızca eğitim verilerini kullanarak uyarlayın.
- Uyarlanan dönüşümleri doğrulama ve test verilerine hiçbir değişiklik yapmadan uygulayın.
- Eğitim verilerindeki sınıf dengesizliğini nicel olarak belirleyin. Sınıf ağırlıklandırma, SMOTE, aşırı örnekleme veya veri artırmayı yalnızca eğitim veri setine uygulayın. Doğrulama ve test veri setlerinin orijinal dağılımını koruyun.
- Hiçbir deneğin, mükerrer gözlemin, artırılmış örneğin, ön işleme istatistiğinin, özellik seçim kriterinin veya sentetik örneğin eğitim ve değerlendirme bölümleri arasında paylaşılmadığını onaylayın.
5. XAI modelini geliştirin ve yapılandırın
- Girdi veri modalitelerini, ön işleme işlemlerini, modaliteye özgü öznitelik kodlayıcılarını, öznitelik füzyon mekanizmasını, tahmin katmanını ve açıklanabilirlik modülünü belirterek model mimarisini tanımlayın.
- Tahmin görevine ve girdi modalitesine göre makine öğrenmesi veya derin öğrenme mimarisini seçin. Girdi katmanını, öznitelik çıkarma bileşenlerini, gizli katmanları, çıktı katmanını ve aktivasyon fonksiyonlarını yapılandırın. Optimize ediciyi, öğrenme oranını, yığın boyutunu, kayıp fonksiyonunu, dönem sayısını, düzenlemeyi, dropout'u, erken durdurmayı ve öğrenme oranı planını tanımlayın.
- Yalnızca eğitim ve doğrulama verilerini kullanarak hiperparametreleri optimize edin.
- Nihai mimariyi ve hiperparametre yapılandırmasını Tablo 3'e kaydedin.
- Eğitimden önce girdi-çıktı boyutsal uyumluluğunu doğrulayın.
NOT: Uygun bir mimari, tanımlanmış hiperparametreler ve entegre açıklanabilirlik teknikleri içeren, tam olarak yapılandırılmış bir XAI modeli oluşturun.
6. XAI modelini eğitin, optimize edin ve kaydedin
- Önceden tanımlanmış eğitim ve doğrulama veri kümeleri ile nihai model konfigürasyonunu yükleyin. Modeli, önceden tanımlanmış rastgele tohum (random seed) ve eğitim parametrelerini kullanarak başlatın.
- Modeli belirtilen optimize edici, kayıp fonksiyonu, grup boyutu (batch size) ve durdurma kriterlerini kullanarak eğitin.
- Doğrulama performansını izleyin ve önceden tanımlanmış model seçim kriterine karşılık gelen kontrol noktasını (checkpoint) saklayın. Seçilen kontrol noktasını, başka bir optimizasyon yapmadan bağımsız test veri kümesi üzerinde değerlendirin.
- Eğitilmiş modeli, ön işleme konfigürasyonunu, hiperparametreleri, rastgele tohumu ve eğitim günlüğünü kaydedin.
NOT: Hazırlanan sağlık hizmetleri veri kümesi kullanılarak eğitilmiş ve doğrulanmış optimize bir XAI modeli elde edin. Tekrarlanabilirlik için en iyi performansı gösteren modeli, hiperparametreleri, eğitim günlüklerini, ön işleme konfigürasyonunu ve hesaplama ortamını muhafaza edin.
7. Tahminleyici ve hesaplama performansını değerlendirin
- Tahmin performansını değerlendirin
- Model eğitimi ve hiperparametre optimizasyonu tamamlandıktan sonra, optimize edilmiş modeli ve bağımsız test veri setini yükleyin. Test aşamasında, eğitilmiş model parametrelerini ve ön işleme hattını değiştirilmeden koruyun.
- Test veri setindeki tüm örnekler için tahminler oluşturun. Tahmin edilen çıktıları, karşılık gelen temel gerçeklik (ground-truth) etiketleri ile karşılaştırın.
- Performans metriklerini hesaplayın
- Tahmin görevinin türüne göre değerlendirme metriklerini seçin.
- Sınıflandırma görevleri için uygun olduğunda; doğruluğu (accuracy), kesinliği (precision), duyarlılığı (recall), özgünlüğü (specificity), F1-skorunu, dengeli doğruluğu (balanced accuracy), Matthews korelasyon katsayısını (MCC) ve alıcı işletim karakteristik eğrisi altındaki alanı (AUC-ROC) hesaplayın. Regresyon görevleri için uygun olduğunda; ortalama mutlak hatayı (MAE), kök ortalama kare hatayı (RMSE), belirleme katsayısını (R2) ve diğer ilgili ölçümleri hesaplayın.
- Model genelleştirmesini ve sağlamlığını değerlendirin
- Mümkün olduğunda, geliştirme veri setinden bağımsız olarak toplanmış harici bir veri seti kullanarak modeli değerlendirin.
- Taşınabilirliği değerlendirmek için farklı bir sağlık kurumundan, coğrafi bölgeden veya hasta popülasyonundan gelen harici veri setlerini tercih edin.
- Boylamsal veri setleri mevcut olduğunda, daha sonraki bir dönemde toplanan verileri kullanarak zamansal doğrulama gerçekleştirin.
- Çok merkezli veriler mevcut olduğunda, nihai modeli katılımcı kurumlar genelinde ayrı ayrı değerlendirerek çok merkezli doğrulama gerçekleştirin.
- Mümkün olduğunda, farklı bir coğrafi bölgeden gelen bağımsız bir popülasyonu kullanarak coğrafi doğrulama gerçekleştirin.
- Geliştirme ve harici veri setleri arasındaki performans farklılıklarını ve güven aralıklarını raporlayın.
- Hesaplama performansını değerlendirin
- Önceden tanımlanmış hesaplama ortamında model eğitim süresini, aynı hesaplama koşulları altında çıkarım ve test süresini, ayrıca bellek tüketimini, model boyutunu ve donanım kullanımını ölçün.
- Hesaplama ölçümlerini bağımsız çalışmalar üzerinden tekrarlayın.
- Deneysel değişkenliğin etkisini azaltmak için ortalama yürütme süresini hesaplayın.
- Model performansını karşılaştırın
- Karşılaştırmalı değerlendirme için uygun geleneksel makine öğrenimi veya derin öğrenme yöntemlerini seçin.
- Önerilen XAI modelini ve karşılaştırıcı modelleri aynı veri setini kullanarak değerlendirin. Tüm karşılaştırma modellerine aynı ön işleme prosedürlerini ve değerlendirme metriklerini uygulayın.
- Tüm karşılaştırmalı deneyleri aynı hesaplama ortamında gerçekleştirin.
NOT: Test edilen hesaplama koşulları ve veri seti altında tahmin kararlılığı ve tekrarlanabilirliğine dair deneysel kanıtlar elde edin.
8. XAI çıktılarını oluşturun ve değerlendirin
- Model açıklamalarını oluşturun
- Optimize edilmiş XAI modelini yükleyin. Model eğitimi için kullanılmayan değerlendirme örneklerini seçin. Eğitilmiş modeli veya ön işleme hattını değiştirmeden önceden tanımlanmış açıklanabilirlik yöntemlerini uygulayın.
- Global ve yerel model açıklamaları oluşturun
- Tahmin modelinin genel davranışını karakterize etmek için global açıklamalar oluşturun.
- Bireysel model tahminlerini karakterize etmek için yerel açıklamalar oluşturun.
- Tablo model tahminlerinin global ve yerel açıklamalarını oluşturmak için Pima Indians Diabetes Veri Kümesi'ne SHAP uygulayın.
- Öznitelik katkılarının genel yönünü ve büyüklüğünü görselleştirmek için bir SHAP özet grafiği oluşturun.
- Öznitelikleri model tahminlerine yaptıkları genel katkıya göre sıralamak için ortalama mutlak SHAP değerlerini kullanarak bir SHAP öznitelik önem grafiği oluşturun.
- Hastaya özgü öznitelik katkılarını göstermek için temsilci bir test seti tahmini için bir SHAP şelale grafiği oluşturun.
- Seçilen bir öznitelik ile bu özniteliğin model çıktısına olan katkısı arasındaki ilişkiyi incelemek için bir SHAP öznitelik bağımlılık grafiği oluşturun.
- Bireysel model tahminlerinin yerel açıklamalarını oluşturmak için temsilci test seti tahminlerine LIME uygulayın.
- Tahmin edilen sonuçtaki bir değişiklikle ilişkili öznitelik değişikliklerini göstermek için hastaya özgü bir karşıt-olgusal (counterfactual) açıklama oluşturun.
- Veri modalitesine ve model mimarisine göre ek açıklanabilirlik teknikleri seçin.
- Uygun olduğunda, uyumlu görüntü tabanlı modeller için Grad-CAM veya belirginlik haritaları (saliency maps), transformer tabanlı mimariler için dikkat (attention) görselleştirmeleri ve diferansiyellenebilir modeller için Entegre Gradyanlar (Integrated Gradients) kullanın.
- Grad-CAM, belirginlik haritalama, dikkat görselleştirmesi ve Entegre Gradyanları genel, modaliteye bağımlı protokol seçenekleri olarak değerlendirin ve ilgili analizler gerçekten gerçekleştirilmediği sürece bunları Pima Indians Diabetes Veri Kümesi doğrulamasından elde edilen deneysel sonuçlar olarak yorumlamayın veya raporlamayın.
- Açıklanabilirlik yöntemlerini çalışılmış Pima doğrulamasına uygulayın
- Tablo model tahminlerinin global ve yerel açıklamalarını oluşturmak için Pima Indians Diabetes Veri Kümesi'ne SHAP ve LIME uygulayın.
- Pima doğrulama sonuçlarından SHAP özet, öznitelik önem, şelale ve öznitelik bağımlılığı görselleştirmeleri oluşturun.
- Temsilci test seti tahminleri için bir LIME yerel açıklaması oluşturun.
- Model tahminindeki bir değişiklikle ilişkili öznitelik değişikliklerini göstermek için hastaya özgü bir karşıt-olgusal açıklama oluşturun.
- Grad-CAM, dikkat görselleştirmesi, belirginlik haritalama ve Entegre Gradyanları, diğer sağlık hizmetleri veri türleri ve model mimarileri için modaliteye bağımlı açıklanabilirlik seçenekleri olarak değerlendirin.
- İlgili analizler gerçekten gerçekleştirilmediği sürece Grad-CAM, dikkat görselleştirmesi, belirginlik haritalama veya Entegre Gradyanları Pima çalışılmış doğrulamasından elde edilen deneysel bulgular olarak raporlamayın.
- Açıklama kalitesini değerlendirin
- Oluşturulan açıklamaların modelin tahmin sürecini yansıtıp yansıtmadığını değerlendirin. Tekrarlanan deneysel çalıştırmalarda açıklamaların kararlılığını ve özdeş hesaplama koşulları altında açıklama çıktılarının tutarlılığını değerlendirin.
- Uygun olduğunda, açıklama çıktılarının girdi verilerindeki değişikliklere karşı duyarlılığını değerlendirin. Oluşturulan açıklamaları mevcut alan bilgisi veya uzman yorumlarıyla karşılaştırın.
- Bu tür karşılaştırmalar mevcut olduğunda, yerleşik tıbbi bilgilerle örtüşen tahmin edici öznitelikleri veya anatomik bölgeleri belirleyin.
- Oluşturulan açıklamalar ile mevcut klinik yorum arasındaki uyum veya uyumsuzluk düzeyini kaydedin.
- Tahmin belirsizliğini nicelleştirin
- Seçilen model mimarisine ve sağlık uygulamasına uygun bir belirsizlik tahmini yöntemi kullanarak değerlendirilen örnekler için tahmin güven tahmini oluşturun.
- Uygun olduğunda Monte Carlo dropout, topluluk tabanlı (ensemble-based) tahmin, Bayesyen çıkarım, konformal tahmin veya doğrulanmış başka bir belirsizlik tahmini yaklaşımı uygulayın.
- Monte Carlo dropout kullanılırken stokastik tahmin geçişlerini tekrarlayın ve her değerlendirme örneği için ortalama tahmini ve tahmin varyansını hesaplayın.
- Tahmin güvenini veya belirsizlik aralıklarını, ilgili model tahminleriyle birlikte raporlayın.
- Belirsizlik tahminlerinin, daha düşük güvenilirlikle veya artan tahmin hatasıyla ilişkili tahminleri belirleyip belirlemediğini değerlendirin. Tekrarlanabilirliği sağlamak için belirsizlik tahmin yöntemini, parametrelerini, rastgele tohumlarını ve oluşturulan belirsizlik çıktılarını koruyun.
- Açıklanabilirlik çıktılarını belgeleyin ve koruyun
- Oluşturulan tüm öznitelik önem puanlarını, ısı haritalarını, belirginlik haritalarını, dikkat görselleştirmelerini ve hastaya özgü yorumları kaydedin. Açıklanabilirlik çıktılarını standartlaştırılmış dosya formatları kullanarak saklayın. Çıktıları, eğitilmiş model ve ön işleme yapılandırmasıyla birlikte arşivleyin.
- Açıklama oluşturma için kullanılan hesaplama ayarlarını, açıklama parametrelerini, yürütme süresini ve yazılım sürümlerini kaydedin. Bağımsız incelemeyi ve tekrarlanabilirliği kolaylaştırmak için eksiksiz açıklanabilirlik dokümantasyonunu koruyun.
- Açıklama kalitesini nicel olarak değerlendirin
- Önemli olarak tanımlanan öznitelikleri sistematik olarak bozarak veya maskeleyerek ve model çıktısındaki karşılık gelen değişikliği ölçerek açıklama sadakatini (faithfulness) değerlendirin. Atribüsyon büyüklüğünü, model tahmininde meydana gelen sonuçla karşılaştırarak bir açıklama sadakati puanı hesaplayın.
- Tekrarlanan çalıştırmalar, bozulmuş girdiler veya klinik olarak benzer örnekler için açıklamalar oluşturarak ve ortaya çıkan atribüsyon kalıpları arasındaki benzerliği hesaplayarak açıklama kararlılığını değerlendirin. Kontrollü girdi bozulmaları altında, tahmin edilen çıktı değişimi ile açıklama atribüsyonundan tahmin edilen değişim arasındaki tutarsızlığı ölçerek sadakatsizliği (infidelity) hesaplayın.
- Tıbbi görüntü açıklamaları için, referans anotasyonlar mevcut olduğunda, uzman tarafından tanımlanmış bir ilgi alanı (region of interest) kullanarak lokalizasyon doğruluğunu değerlendirin. Önceden tanımlanmış yorum kriterlerini kullanarak yetkin klinik uzmanlardan bağımsız değerlendirmeler alarak klinik yararlılığı değerlendirin.
- Birden fazla uzman, açıklama ilgisini veya uyumunu bağımsız olarak değerlendirdiğinde Cohen's kappa veya Fleiss' kappa hesaplayın.
NOT: Eğitilmiş yapay zeka modelinin tahmin davranışını karakterize eden global ve yerel açıklamalar oluşturun. Şeffaf yorumlama ve tekrarlanabilir değerlendirme için açıklanabilirlik çıktılarını ve ilgili yapılandırmaları koruyun.
9. İstatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesi gerçekleştirin
- İstatistiksel doğrulamayı gerçekleştirin
- Çalışma amacına, deneysel tasarıma, veri dağılımına ve değerlendirilen değişkenlerin özelliklerine göre istatistiksel yöntemleri seçin.
- Sürekli değişkenleri uygun şekilde ortalama ± standart sapma veya medyan ve çeyrekler arası aralık olarak; kategorik değişkenleri ise sayı ve yüzdeler olarak raporlayın.
- Model performans stabilitesini değerlendirmek için eğitim seti üzerinde beş katlı çapraz doğrulama yapın ve doğruluk, AUC-ROC, kesinlik, geri çağırma ve F1-skorunu katlar boyunca ortalama ± standart sapma olarak raporlayın. 1.000 bootstrap yeniden örneklemesi kullanarak bağımsız test seti performans metrikleri için %95 güven aralıklarını tahmin edin.
- Önerilen modeli; eşleşmiş doğruluk karşılaştırmaları için McNemar testi, korele AUC-ROC karşılaştırmaları için DeLong testi ve F1-skoru karşılaştırmaları için 1.000 yeniden örneklemeli eşleşmiş bootstrap testi kullanarak CNN, Random Forest ve SVM temel modelleri ile karşılaştırın.
- Her karşılaştırma için ilgili test istatistiğini ve kesin p-değerini raporlayın ve α = 0.05 iki yönlü anlamlılık düzeyini kullanın.
- Model performansını istatistiksel olarak karşılaştırın
- Önerilen açıklanabilir AI modelini, seçilen güncel makine öğrenimi ve derin öğrenim temel modelleri ile karşılaştırın.
- İki grubu karşılaştırırken uygun şekilde Student's t-testi veya Mann-Whitney U testini uygulayın. İkiden fazla grubun dahil olduğu uygun parametrik karşılaştırmalar için tek yönlü ANOVA'yı uygulayın. İkiden fazla grubun dahil olduğu uygun parametrik olmayan karşılaştırmalar için Kruskal-Wallis testini uygulayın.
- Orijinal makalede belirtildiği üzere, p < 0.05 değerini istatistiksel olarak anlamlı kabul edin.
- Tüm önceden tanımlanmış istatistiksel karşılaştırmalar için α = 0.05 iki yönlü anlamlılık düzeyini kullanın ve ilgili test istatistiklerini ve p-değerlerini raporlayın.
- Temel öngörücü performans metrikleri için %95 güven aralıklarını raporlayın.
- Uygun olduğunda, performans ölçümleri için güven aralıklarını tahmin etmek amacıyla bootstrap yeniden örneklemesi kullanın. Aynı denekler iki model tarafından değerlendirildiğinde, korele ROC-AUC değerlerini karşılaştırmak için DeLong testini kullanın. Aynı denekler için oluşturulan eşleşmiş kategorik sınıflandırma sonuçlarını karşılaştırmak için McNemar testini kullanın. Uygun olduğunda, F1-skoru veya diğer türetilmiş performans metriklerini karşılaştırmak için eşleşmiş bootstrap prosedürlerini kullanın.
- Olasılıksal tahminler mevcut olduğunda kalibrasyonu; kalibrasyon grafikleri, kalibrasyon eğimi/kesim noktası ve Brier skoru kullanarak değerlendirin.
- Uygulanan Pima Indians Diabetes Dataset doğrulaması için, önerilen model ve temel modeller için belirtilen önceden tanımlanmış eşleşmiş istatistiksel karşılaştırmayı kullanın. Seçilen testi, karşılaştırmaya uygun olarak, eşleşmiş test seti tahminlerine veya tekrarlanan çalıştırma performans ölçümlerine tutarlı bir şekilde uygulayın. İki yönlü α = 0.05 anlamlılık düzeyini kullanın ve test istatistiği ile kesin p-değerini raporlayın. Sonuçları Sonuçlar bölümünde sunulmadığı sürece alternatif istatistiksel testlerin gerçekleştirildiğini raporlamayın.
- İki yönlü testleri uygulayın ve istatistiksel anlamlılığı önceden tanımlanmış p < 0.05 eşiğini kullanarak yorumlayın.
- Model sağlamlığını değerlendirin
- Önceden tanımlanmış veri seti bölümlendirmesini, ön işleme prosedürlerini, model mimarisini, hiperparametreleri, yazılım ortamını ve değerlendirme protokolünü koruyarak, farklı rastgele tohumlar (random seeds) kullanarak tüm eğitim ve değerlendirme prosedürünü 10 kez tekrarlayın.
- Her bağımsız çalıştırma için AUC-ROC, doğruluk ve F1-skorunu kaydedin ve 10 çalıştırma boyunca ortalama ± standart sapmayı raporlayın.
- Farklı rastgele başlangıçlar altında öngörücü stabiliteyi ve tekrarlanabilirliği değerlendirmek için tekrarlanan çalışmalar sonucunda elde edilen performans değerlerini karşılaştırın.
- Açıklanabilirlik tekrarlanabilirliğini değerlendirin
- Açıklama stabilitesi değerlendirmesi dahil olduğunda, birden fazla deneysel çalışma boyunca özellik atamaları, dikkat haritaları veya diğer açıklama çıktılarını oluşturun. Tekrarlanan çalışmalar boyunca açıklama çıktılarını, uygun bir benzerlik veya sıra tabanlı uyum ölçütü kullanarak nicel olarak karşılaştırın.
- Mevcut Pima Indians Diabetes Dataset uygulamalı doğrulaması için, ilgili tekrarlanan açıklama çıktıları ve analizler gerçekleştirilmediği sürece nicel açıklama stabilitesi metriklerini raporlamayın.
- Uygun klinik değerlendirmeler mevcut olduğunda, model tarafından üretilen açıklamalar ile klinisyen yorumları arasındaki uyumu değerlendirin. Değerlendiriciler arasındaki uyumu değerlendirmek için uygun şekilde Cohen's kappa veya Fleiss' kappa değerini hesaplayın.
- Tekrarlanabilirliği belgeleyin
- Ham verileri, ön işleme prosedürlerini, kaynak kodu, eğitilmiş modelleri, hiperparametre yapılandırmalarını, açıklanabilirlik çıktılarını, istatistiksel analiz betiklerini ve oluşturulan sonuçları muhafaza edin.
- İş akışı boyunca kullanılan yazılım ortamını ve donanım yapılandırmasını kaydedin. Arşivlenen dosyaları ve yapılandırmaları kullanarak tüm iş akışını bağımsız olarak yeniden çalıştırın.
- Tekrarlanan öngörücü performansı orijinal deneysel sonuçlarla ve tekrarlanan model açıklamalarını orijinal açıklanabilirlik çıktılarıyla karşılaştırın.
- Tekrarlama sırasında gözlemlenen tüm farklılıkları kaydedin. Deneysel dokümantasyonu, bağımsız yürütme sırasında tespit edilen tekrarlanabilirlik gözlemlerini yansıtacak şekilde güncelleyin.
NOT: Tekrarlanan deneyler boyunca değerlendirilebilecek istatistiksel olarak doğrulanmış öngörücü performans ve açıklanabilirlik sonuçları elde edin. Tüm iş akışının bağımsız doğrulanmasını sağlamak için yeterli hesaplama, analiz ve metodoloji dokümantasyonunu muhafaza edin.
- Tekrarlanabilirlik Kontrol Listesi
- Veri seti adını, sürümünü, edinme tarihini, kaynağını, dahil etme kriterlerini, hariç tutma kriterlerini ve nihai örnek sayısını kaydedin. Tüm ön işleme işlemlerini, dönüşüm parametrelerini, normalizasyon ayarlarını, özellik seçme prosedürlerini ve veri bölümlendirme kurallarını kaydedin.
- İşletim sistemini, CPU, GPU, RAM, Python sürümünü, framework sürümlerini ve kütüphane sürümlerini kaydedin. Tüm model mimarisi spesifikasyonlarını ve hiperparametreleri kaydedin.
- Optimize ediciyi, öğrenme oranını, batch boyutunu, epoch sayısını, kayıp fonksiyonunu, düzenleştirmeyi ve erken durdurma kriterlerini kaydedin. Tüm rastgele tohumları ve rastgele sayı üreteci ayarlarını kaydedin.
- Eğitilmiş model ağırlıklarını ve ön işleme yapılandırmalarını muhafaza edin. Eğitim günlüklerini, değerlendirme betiklerini, istatistiksel analiz betiklerini ve açıklanabilirlik çıktılarını muhafaza edin. Final deneyler için kullanılan model ve yazılım sürümlerini kaydedin.
- Bağımsız tekrarlama için gereken eksiksiz hesaplama ortamını muhafaza edin.
- Kaynak kodun, veri setlerinin, model ağırlıklarının ve destekleyici materyallerin; etik, yasal, lisanslama ve gizlilik kısıtlamalarına tabi olan erişilebilirliğini belgeleyin.
- Arşivlenen iş akışını bağımsız olarak yeniden çalıştırın ve tekrarlanan sonuçları orijinal sonuçlarla karşılaştırın.
- Tüm tekrarlanabilirlik gereksinimlerini standartlaştırılmış kontrol listesini kullanarak belgeleyin.
Sonuçlar
Önerilen XAI çerçevesi, temsili sağlık veri seti olarak Pima Indians Diabetes Veri Seti kullanılarak uygulanmıştır. Pima Indians Diabetes Veri Seti, tek deneysel doğrulama veri seti olarak kullanılmıştır. Rapor edilen tüm öngörücü, açıklanabilirlik, istatistiksel ve tekrarlanabilirlik sonuçları bu veri setinden elde edilmiştir. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM ve BraTS 2021 deneysel olarak değerlendirilmemiş olup, yalnızca genel protokolün farklı sağlık veri modaliteleri genelindeki uygulanabilirliğini gösteren örnekler olarak dahil edilmiştir. Geçersiz ve yinelenen kayıtlar çıkarıldıktan ve model geliştirme öncesinde belirtilen ön işleme işlemleri gerçekleştirildikten sonra veri setinin tamamı kullanılmıştır. Veri seti, önceden tanımlanmış tabakalı bir bölme stratejisi kullanılarak bağımsız eğitim, doğrulama ve test alt kümelerine ayrılmıştır. Veri sızıntısı olasılığını minimize etmek için üç alt küme arasındaki örnek bağımsızlığı korunmuştur.
Tahminleyici model, önceden tanımlanmış mimari ve hiperparametreler kullanılarak yapılandırılmıştır. Model, önceden belirlenmiş öğrenme oranı ve paket boyutu ile Adam optimizasyonu kullanılarak 100 epoka kadar eğitilmiştir. Doğrulama kaybına dayalı erken durdurma uygulanmış ve en iyi doğrulama performansına karşılık gelen model saklanmıştır. Tekrarlanabilirliği artırmak amacıyla veri kümesi bölümlendirme, model başlatma ve tekrarlanan deneyler için rastgele tohumlar belirlenmiştir.
Eğitilen model; doğruluk, kesinlik, duyarlılık, özgüllük, F1-skoru, Matthews korelasyon katsayısı (MCC), alıcı işletim karakteristik eğrisi altındaki alan (AUC-ROC) ve ortalama kesinlik (AP) kullanılarak bağımsız test seti üzerinde değerlendirildi. Önerilen model; aynı ön işleme prosedürleri, veri bölümleri ve değerlendirme protokolleri kullanılarak önceden tanımlanmış temel modellerle karşılaştırıldı. Bağımsız test seti tahminlerinden alıcı işletim karakteristik (ROC) eğrileri, kesinlik-duyarlılık eğrileri ve bir hata matrisi oluşturuldu.
Performans kararlılığını değerlendirmek için eğitim verileri üzerinde beş katlı çapraz doğrulama gerçekleştirilmiştir. Temel performans metrikleri için %95 güven aralıkları tahmin edilmiş ve önerilen model ile temel modeller arasında önceden tanımlanmış istatistiksel karşılaştırmalar yapılmıştır.
Beş katlı çapraz doğrulama sonucunda %93,01 ± 0,48 doğruluk, 0,954 ± 0,007 AUC-ROC, %92,42 ± 0,87 kesinlik, %93,02 ± 0,45 duyarlılık ve %92,72 ± 0,62 F1-skoru elde edilmiştir. 1.000 yeniden örnekleme ile tahmin edilen %95 bootstrap güven aralıkları; doğruluk için 0,897–0,973, kesinlik için 0,890–0,970, duyarlılık için 0,880–0,963, F1-skoru için 0,887–0,965 ve AUC-ROC için 0,931–0,984 olarak belirlenmiştir. CNN, Random Forest ve SVM temel modelleri ile yapılan istatistiksel karşılaştırmalarda; doğruluk için McNemar testi, AUC-ROC için DeLong testi ve F1-skoru için 1.000 yeniden örneklemeli eşleştirilmiş bootstrap testi kullanılmıştır.
Tam eğitim ve değerlendirme prosedürü, farklı rastgele tohumlar kullanılarak 10 bağımsız çalışma boyunca tekrarlanmıştır. Tekrarlanan çalışmalar; 0.957 ± 0.008 AUC-ROC, %93.24 ± 0.74 doğruluk ve %92.35 ± 0.92 F1-skoru vermiş olup, bu durum tekrarlanan yürütmeler arasında nispeten düşük değişkenliğe işaret etmektedir. Tekrarlanan yürütmeler boyunca elde edilen performans metrikleri, ortalama ve standart sapma kullanılarak özetlenmiştir. Tahmin performansının tekrarlanan yürütme altında kararlı kalıp kalmadığını belirlemek için çalışmalar arasındaki değişkenlik incelenmiştir.
Bu çalışmada bağımsız bir harici veri seti kullanılmadığı için harici doğrulama gerçekleştirilmemiştir. Buna bağlı olarak, rapor edilen tüm öngörücü, istatistiksel ve tekrarlanabilirlik sonuçları, önceden tanımlanmış eğitim, doğrulama ve bağımsız test bölümleri kullanılarak Pima Indians Diabetes Veri Seti'nden elde edilmiştir. Farklı bir kurum, popülasyon, coğrafi bölge veya zaman dilimine ait bağımsız bir veri setinin mevcut olduğu uygulamalar için harici doğrulama, protokolde isteğe bağlı bir prosedür olarak tutulmuştur.
Model açıklamaları, SHAP ve LIME dahil olmak üzere, tablo şeklindeki Pima Indians Diabetes Veri Seti'ne uygulanabilir açıklanabilirlik teknikleri kullanılarak oluşturulmuştur. Küresel özellik önemi değerlendirilmiş ve ayrılmış test örnekleri kullanılarak hastaya özgü yerel açıklamalar üretilmiştir. Tekrar üretilebilirliği ve sonraki yorumlamaları kolaylaştırmak için açıklama çıktıları, ilgili model tahminleri ve özellik değerleriyle birlikte kaydedilmiştir.
Netlik sağlamak adına, mevcut uygulamalı örnek, Tablo 1'de tanımlanan dokuz temel iş akışı aşamasından oluşmuştur. Dış doğrulama ve klinik uzman değerlendirmesi, genel protokolün isteğe bağlı doğrulama modülleri olarak tutulmuştur. Bağımsız bir dış veri seti kullanılmadığı için dış doğrulama yapılmamıştır ve mevcut uygulamalı örneğe resmi bir uzman değerlendirme paneli dahil edilmediği için klinik uzman değerlendirmesi gerçekleştirilmemiştir. Buna göre, bu isteğe bağlı modüller dokuz aşamalı deneysel iş akışının bir parçası olarak değerlendirilmemiş ve deneysel sonuçlar olarak raporlanmamıştır.
Ön işleme ve veri seti bölümlendirme prosedürleri, model geliştirme için uygun, standardize edilmiş bir veri seti oluşturmuştur. Yinelenen ve tutarsız kayıtlar kaldırılmış, eksik değerler önceden tanımlanmış stratejiye göre ele alınmış, sayısal öznitelikler standardize edilmiş ve veri seti bağımsız eğitim, doğrulama ve test alt kümelerine bölünmüştür. Ortaya çıkan veri seti özellikleri ve ön işleme prosedürleri Tablo 2'de özetlenmiştir. Genel sağlık hizmetleri veri seti hazırlama ve ön işleme iş akışı Şekil 2'de gösterilirken, özellikle Pima Yerlileri Diyabet Veri Seti'ne uygulanan deneysel hazırlama, ön işleme, bölümlendirme ve kalite değerlendirme iş akışı Şekil 3'te gösterilmiştir. Rapor edilen sonuçları oluşturmak için kullanılan nihai hesaplama ortamı, model mimarisi ve hiperparametre yapılandırması Tablo 3'te özetlenmiştir.
Bölüm 3 ve 4'ün uygulanması, model geliştirme için uygun, standardize edilmiş bir sağlık hizmetleri veri seti sağlamıştır. Ön işleme prosedürleri ile yinelenen ve tutarsız kayıtlar temizlenmiş, eksik değerler tamamlanmış, sayısal özellikler standardize edilmiş, uygun olan kategorik değişkenler kodlanmış ve veri seti eğitim, doğrulama ve test alt kümelerine ayrılmıştır. Elde edilen veriler, sonraki model geliştirme aşamaları için gerekli olan standardize edilmiş girdiyi sağlamıştır.
Bölüm 5 ve 6 tamamlandıktan sonra, yapılandırılan model eğitim sırasında stabil bir yakınsama göstermiştir. Öğrenme eğrileri, eğitim ve doğrulama kayıplarında eş zamanlı azalmalar ile eğitim ve doğrulama doğruluğunda artışlar sergilemiştir. Hiperparametre optimizasyonu, belirgin bir aşırı öğrenme (overfitting) kanıtı olmaksızın modelin genelleme yeteneğini geliştirmiştir. Tekrarlanabilirliği desteklemek amacıyla, optimize edilen model; kesinleştirilmiş mimari, hiperparametre ayarları, yazılım versiyonları, rastgele tohumlar (random seeds) ve eğitilmiş model ağırlıkları ile birlikte arşivlenmiştir. Model eğitim spesifikasyonları ve optimizasyon sonuçları Tablo 4'te özetlenmiş; ilgili eğitim ve doğrulama öğrenme eğrileri ise Şekil 4'te sunulmuştur.
Bölüm 7, modelin öngörücü performansını standartlaştırılmış performans metrikleri kullanarak değerlendirmiştir. Değerlendirilen sınıflandırma metrikleri arasında doğruluk, kesinlik, geri çağırma, özgüllük, F1-skoru, MCC, AUC-ROC ve AP yer almıştır. Önerilen model; aynı veri seti bölümleri, ön işleme prosedürleri ve değerlendirme protokolü kullanılarak önceden tanımlanmış temel modellerle karşılaştırılmıştır. Öngörücü performans karşılaştırması Tablo 5'te sunulurken; ROC eğrileri, kesinlik-geri çağırma eğrileri, konfüzyon matrisi ve karşılaştırmalı performans metrikleri Şekil 5'te gösterilmiştir.
Bölüm 8'i takiben, modelin yorumlanabilirliğini değerlendirmek amacıyla model tahminlerinin hem küresel hem de yerel açıklamaları oluşturulmuştur. Tablo halindeki Pima Kızılderilileri Diyabet Veri Kümesi için model açıklamaları SHAP ve LIME kullanılarak oluşturulmuş ve tahmindeki bir değişikliği örneklendirmek için hastaya özgü bir karşıolgusal (counterfactual) açıklama üretilmiştir. Küresel özellik önemi, hastaya özgü şelale (waterfall) ve özellik bağımlılığı görselleştirmeleri oluşturmak için SHAP kullanılırken, ayrılmış test örneklerinden yerel açıklamalar oluşturmak için LIME kullanılmıştır. İlgili açıklanabilirlik çıktıları Şekil 6'da sunulmuştur.
Protokolün son aşamasında, iş akışının istatistiksel güvenilirliği ve tekrarlanabilirliği değerlendirilmiştir. Tüm iş akışı; aynı veri seti bölme stratejisi, ön işleme parametreleri, model mimarisi, hiperparametreler, yazılım ortamı ve değerlendirme prosedürleri korunarak, farklı rastgele başlangıç değerleri (random seeds) kullanılarak 10 bağımsız çalışma boyunca tekrarlanmıştır. Tekrarlanan çalışmalar sonucunda 0,957 ± 0,008 AUC-ROC, %93,24 ± 0,74 doğruluk (accuracy) ve %92,35 ± 0,92 F1-skoru elde edilmiş olup, bu değerler tekrarlanan yürütmeler arasında nispeten düşük bir değişkenliğe işaret etmektedir.
Mevcut doğrulama çalışmasında açıklama stabilitesi nicel olarak değerlendirilmemiştir. Pima Kızılderilileri Diyabet Veri Seti için SHAP ve LIME açıklamaları oluşturulmuş olsa da, ayrı bir çalıştırmalar arası sıra-korelasyon veya özellik-çakışma analizi gerçekleştirilmemiştir. Bu nedenle, herhangi bir sayısal açıklama stabilitesi veya atıf-uyum metriği rapor edilmemiştir. Nicel açıklama-stabilite değerlendirmesi, tekrarlanan açıklama çıktılarının mevcut olduğu uygulamalar için isteğe bağlı bir tekrarlanabilirlik prosedürü olarak genel protokolde tutulmuştur.
İstatistiki karşılaştırmalar, önceden tanımlanmış p < 0.05 anlamlılık eşiği kullanılarak değerlendirildi. Uygun olan durumlarda çift yönlü istatistiki testler kullanıldı ve gözlemlenen performans farklılıklarının istatistiki anlamlılığını ve belirsizliğini nicelleştirmek için ilgili test istatistikleri, p-değerleri ve %95 güven aralıkları raporlandı. Çapraz doğrulama performansı, güven aralıkları, istatistiki karşılaştırmalar ve tekrarlanan çalışma değişkenliği dahil olmak üzere deneysel istatistiki doğrulama ve tekrarlanabilirlik sonuçları Tablo 6'da özetlenmiştir. İlgili istatistiki testler ve tekrarlanabilirlik analizleri Şekil 7'de gösterilmiştir.
Bu sonuçlar, test edilen hesaplama koşulları ve veri seti altında öngörülebilir stabilite ve tekrarlanabilirliğe dair deneysel kanıt sağlamıştır. Bağımsız replikasyon için gerekli olan hesaplama ortamı, veri seti özellikleri, ön işleme prosedürleri, model konfigürasyonu, istatistiksel analizler ve açıklanabilirlik ayarları, Tablo 7'de sunulan tekrarlanabilirlik kontrol listesine uygun olarak belgelenmiştir. Mevcut çalışmanın uygulamalı doğrulama örneğinde, üretilen XAI çıktılarının klinik uzman değerlendirmesi gerçekleştirilmemiştir.
Genel olarak, protokolün uygulanması, yapay zeka model geliştirme sürecine uygun standartlaştırılmış bir sağlık veri seti ve önceden tanımlanmış hiperparametre ayarları kullanılarak optimize edilmiş bir model sağlamıştır. İş akışı; öngörücü performansın sistematik değerlendirilmesine, uygun XAI teknikleri kullanılarak model açıklamalarının oluşturulmasına ve modelin dayanıklılığı ile tekrarlanabilirliğinin istatistiksel analizine olanak tanımıştır. Sonuçlar hep birlikte, üzerinde çalışılan doğrulama örneğinde değerlendirilen deneysel koşullar altında önerilen XAI iş akışının uygulandığını ve tekrarlanabilir olduğunu göstermiştir.
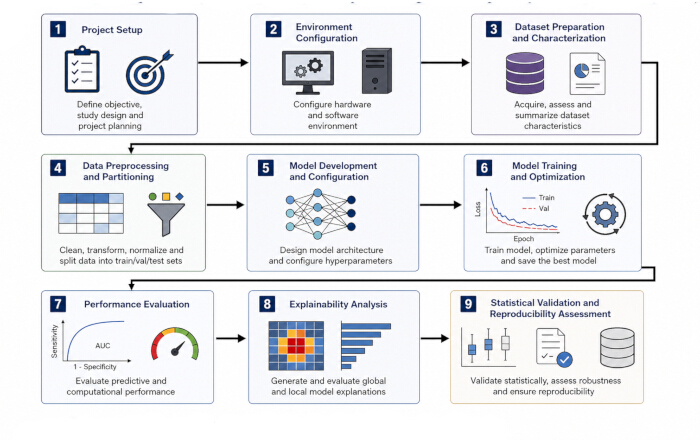
Şekil 1: Sağlık hizmetlerinde tekrarlanabilir ve açıklanabilir yapay zeka modelleri geliştirmek için dokuz aşamalı temel iş akışı. İş akışı şunları içerir: (1) sağlık hizmetleri tahmin görevinin tanımlanması, (2) hesaplama ortamı konfigürasyonu, (3) veri seti edinimi ve doğrulaması, (4) veri ön işlemesi, (5) veri setinin bölümlendirilmesi, (6) öngörücü model eğitimi, (7) öngörücü performans değerlendirmesi, (8) açıklanabilirlik analizi ve (9) istatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesi. Dış doğrulama ve klinik uzman değerlendirmesi, isteğe bağlı protokol uzantıları olarak ele alınmıştır ve dokuz aşamalı temel iş akışına dahil edilmemiştir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
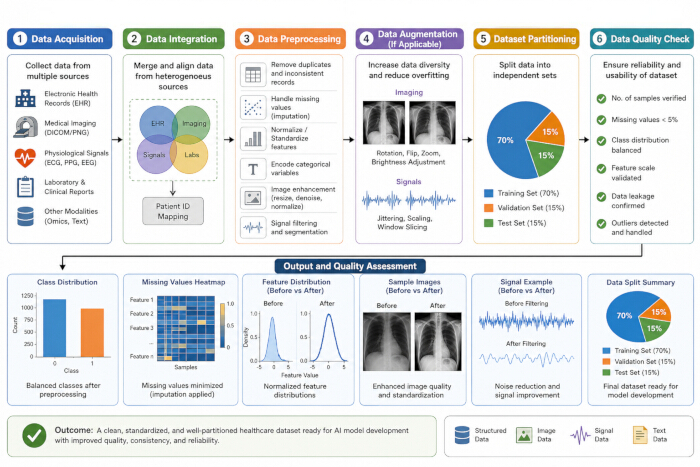
Şekil 2: Sağlık hizmetleri veri seti hazırlama ve ön işleme iş akışı. (A) Klinik kayıtlar, tıbbi görüntüleme, fizyolojik sinyaller ve multimodal veri kaynaklarından sağlık verilerinin edinimi. (B) Eksik değerlerin yönetimi, normalizasyon, gürültü giderme ve veri artırma dahil olmak üzere veri entegrasyonu ve ön işleme. (C) Veri setinin eğitim, doğrulama ve test alt kümelerine bölünmesi. (D) Model geliştirme öncesinde sınıf dağılımını, öznitelik normalizasyonunu ve ön işleme çıktılarını gösteren kalite değerlendirmesi. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
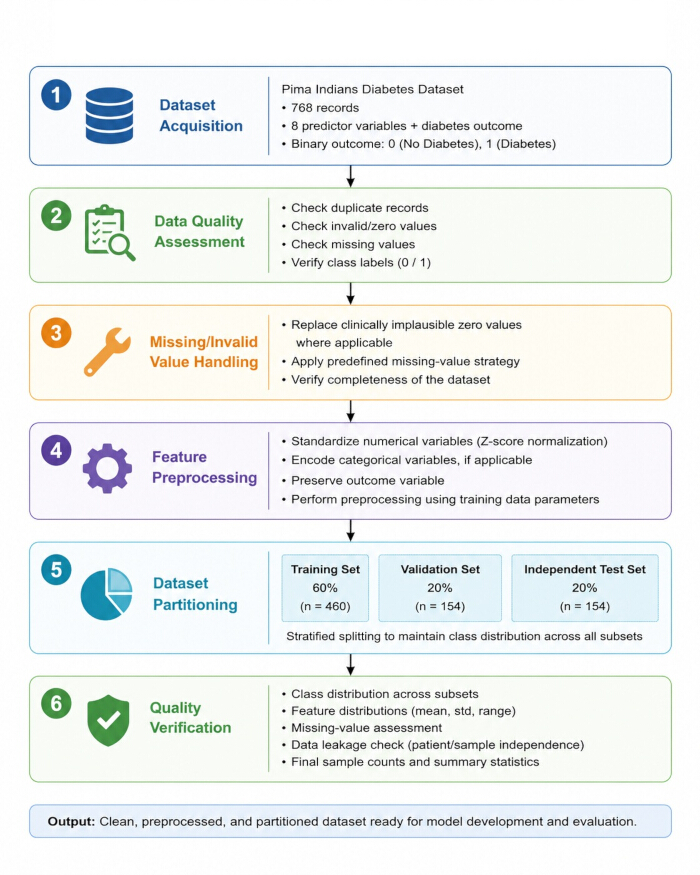
Şekil 3: Pima Kızılderilileri Diyabet Veri Seti'nin hazırlanması, ön işlemesi, bölümlenmesi ve kalite değerlendirmesine yönelik deneysel iş akışı. İş akışı; veri setinin edinilmesi, veri kalitesinin değerlendirilmesi, geçersiz ve eksik değerlerin yönetilmesi, sayısal özelliklerin standardizasyonu, veri setinin eğitim, doğrulama ve bağımsız test alt kümelerine bölünmesi ve model geliştirme öncesindeki son kalite doğrulamasını içerir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
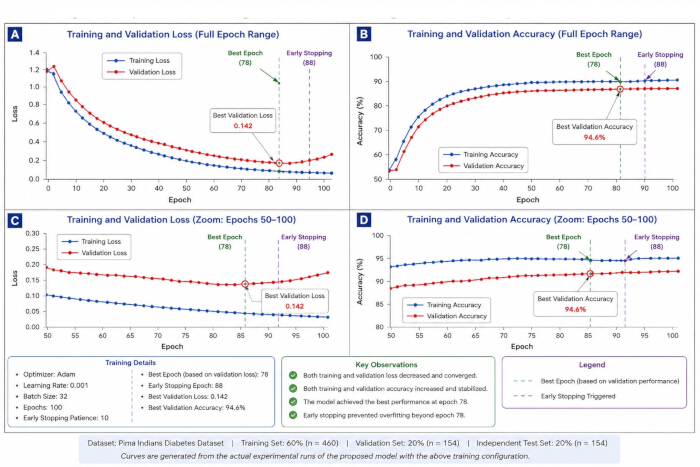
Şekil 4: Pima Indians Diabetes Veri Kümesi kullanılarak önerilen modelin deneysel eğitim ve doğrulama öğrenme eğrileri. (A) Tüm eğitim süreci boyunca eğitim ve doğrulama kaybı. (B) Tüm eğitim süreci boyunca eğitim ve doğrulama doğruluğu. (C) 50–100. epoklar arasındaki kaybın büyütülmüş görünümü. (D) 50–100. epoklar arasındaki doğruluğun büyütülmüş görünümü. En iyi doğrulama performansı, 0.142 doğrulama kaybı ve %94.6 doğrulama doğruluğu ile 78. epokta elde edilmiştir. Erken durdurma, 10 epokluk bir sabır (patience) değeri kullanılarak 88. epokta tetiklenmiştir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
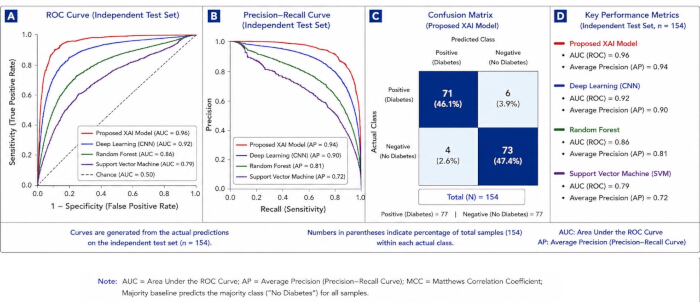
Şekil 5: Bağımsız test seti (n = 154) kullanılarak önerilen XAI çerçevesinin deneysel öngörücü performans değerlendirmesi. (A) Önerilen XAI modelinin ve temel modellerin ayırdetme performansını gösteren Alıcı İşletim Karakteristiği (ROC) eğrisi. (B) Önerilen XAI modelinin ve temel modellerin kesinlik ve duyarlılık performansını gösteren Kesinlik–Duyarlılık (PR) eğrileri. (C) Önerilen XAI modelinin bağımsız test setindeki konfüzyon matrisi ile buna karşılık gelen doğruluk, duyarlılık (recall) ve özgüllük değerleri. (D) Değerlendirilen modeller genelinde doğruluk, kesinlik, duyarlılık, özgüllük, F1-skoru, Matthews korelasyon katsayısı (MCC), ROC eğri altı alanı (AUC) ve ortalama kesinliğin (AP) karşılaştırılması. Bu şekilde gösterilen tüm nicel sonuçlar, Pima Indians Diabetes Veri Kümesi üzerindeki doğrulama deneyine karşılık gelmektedir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
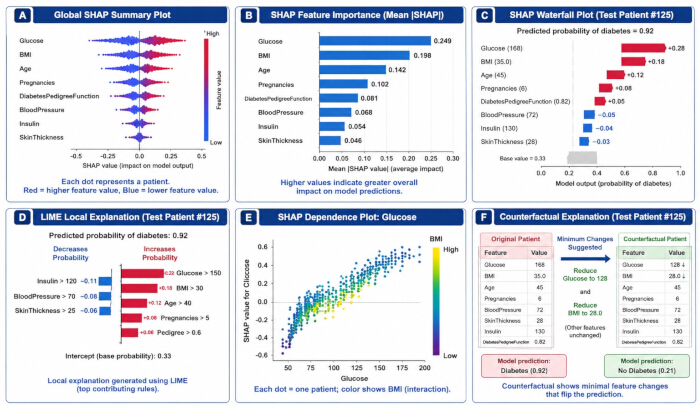
Şekil 6: Pima Indians Diabetes Dataset üzerinde eğitilen önerilen modelin bağımsız test seti tahminlerinden üretilen açıklanabilirlik çıktıları. (A) Test seti genelinde özellik katkılarının dağılımını gösteren küresel SHAP özet grafiği. (B) Ortalama mutlak SHAP değerlerine dayalı SHAP özellik önem grafiği. (C) Bireysel özelliklerin tahmin edilen diyabet olasılığına katkılarını gösteren hastaya özel SHAP şelale grafiği. (D) Test Hastası #125 için özellik katkılarını gösteren LIME yerel açıklaması. (E) Glikoz değerleri ile bunların SHAP katkıları arasındaki ilişkiyi gösteren SHAP bağımlılık grafiği. (F) Model tahminindeki bir değişiklikle ilişkili minimum özellik değişikliklerini gösteren hastaya özel karşıolgusal açıklama. Kısaltmalar: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
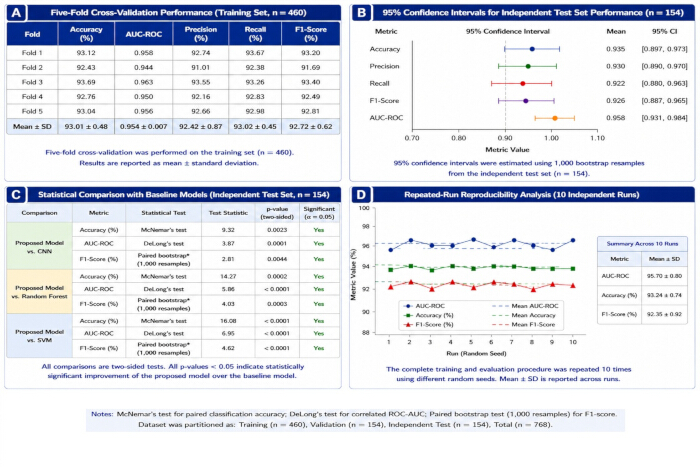
Şekil 7: Önerilen modelin Pima Indians Diabetes Veri Seti kullanılarak yapılan deneysel istatistiksel doğrulaması ve tekrarlanabilirlik analizi. (A) Eğitim seti üzerinde beş katlı çapraz doğrulama performansı. (B) Bağımsız test seti performansı için %95 bootstrap güven aralıkları. (C) İstatistiksel test, test istatistiği, p-değeri ve anlamlılık dahil olmak üzere temel modellerle yapılan istatistiksel karşılaştırmalar. (D) Farklı rastgele tohumlar kullanılarak gerçekleştirilen 10 bağımsız çalıştırma genelindeki performans tutarlılığı. Eşli sınıflandırma doğruluğu için McNemar testi, ilişkili ROC-AUC için DeLong testi ve F1-skoru karşılaştırması için 1.000 yeniden örnekleme ile eşli bootstrap testi kullanılmıştır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
| Aşama | Protokol faaliyeti | Beklenen çıktı | Uygulama durumu |
| 1 | Sağlık hizmetleri veri setini seçin ve doğrulayın | Doğrulanmış veri seti, tahmin hedefi, sınıf dağılımı ve veri kalitesi bilgileri | Gerçekleştirildi |
| 2 | Hesaplama ortamını yapılandırın | Doğrulanmış donanım, yazılım, kütüphaneler, sürümler ve hesaplama konfigürasyonu | Gerçekleştirildi |
| 3 | Sağlık hizmetleri verilerini ön işlemeden geçirin ve kalite kontrolünü yapın | Temizlenmiş, dönüştürülmüş ve standartlaştırılmış veri seti | Gerçekleştirildi |
| 4 | Veri setini bölümlere ayırın | Bağımsız eğitim, doğrulama ve test veri setleri | Gerçekleştirildi |
| 5 | Tahminleyici/XAI modelini geliştirin ve optimize edin | Kesinleştirilmiş model mimarisi ve hiperparametreler | Gerçekleştirildi |
| 6 | Modeli eğitin ve saklayın | Eğitilmiş model, kontrol noktası, eğitim konfigürasyonu ve günlük kayıtları | Gerçekleştirildi |
| 7 | Tahminleyici ve hesaplama performansını değerlendirin | Test seti performans metrikleri ve performans karşılaştırmaları | Gerçekleştirildi |
| 8 | Açıklanabilirlik çıktılarını oluşturun ve değerlendirin | SHAP/LIME ve ilgili açıklama çıktıları | Gerçekleştirildi |
| 9 | İstatistiksel doğrulama ve tekrarlanabilirlik değerlendirmesi yapın | Güven aralıkları, istatistiksel testler, tekrarlanan çalışma sonuçları ve tekrarlanabilirlik ölçümleri | Gerçekleştirildi |
Tablo 1: Pima Kızılderilileri Diyabet Veri Kümesi kullanılarak yapılan çalışma doğrulamasında uygulanan dokuz aşamalı temel protokol iş akışının özeti. Tablo, Pima Kızılderilileri Diyabet Veri Kümesi çalışma örneğinde uygulanan dokuz aşamayı, genel protokolün isteğe bağlı bileşenleri olarak tutulan harici doğrulamadan ve klinik uzman değerlendirmesinden ayırmaktadır.
| Veri Seti | Veri Kaynağı | Klinik Uygulama | Veri Modalitesi | Denekler/Kayıtlar | Numuneler | Sınıflar | Sınıf Dağılımı | Eğitim/Doğrulama/Test | Mevcut Çalışmadaki Rolü | Doğrulama Durumu | Kaynak URL |
| Pima İndianlar Diyabet Veri Seti | UCI Makine Öğrenmesi Deposu | Diyabet öngörüsü | Klinik tablo | 768 kayıt | 768 | 2 | 500 diyabetik olmayan; 268 diyabetik | 60% / 20% / 20% | Birincil deneysel doğrulama veri seti | Gerçekleştirildi – dokuz aşamalı temel iş akışı tamamlandı | Pima Kızılderilileri Diyabeti |
| TCGA-BRCA | NCI Genomik Veri Ortak Platformu (GDC), TCGA-BRCA projesi | Meme kanseri sınıflandırması | Klinik + histopatoloji | 1.098 vaka | Veri türüne göre veri setine bağımlı | Bitiş noktasına bağımlı | Veri seti genelinde tek bir sınıf dağılımı yoktur | Uygulanamaz – herhangi bir deneysel ayrım gerçekleştirilmemiştir | Yalnızca protokol uygulanabilirlik örneği | Deneysel doğrulama için kullanılmamıştır | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomik Veri Ortaklığı (GDC), TCGA-UCEC projesi | Endometriyum kanseri sınıflaması | Klinik + histopatoloji | Proje kohortu; büyüklük seçilen veri türüne ve filtrelere bağlıdır | Veri türüne göre veri setine bağımlı | Uç nokta bağımlı | Veri seti genelinde tek bir sınıf dağılımı yoktur | Uygulanamaz – herhangi bir deneysel ayırım yapılmamıştır | Yalnızca protokol uygulanabilirlik örneği | Deneysel doğrulama için kullanılmamıştır | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Klinik Veritabanı v1.4 | Klinik sonuç tahmini | Klinik zaman serileri | 46.520 hasta | 58.976 YBÜ yatışı | Göreve bağlı | Veritabanı genelinde tek bir sınıf dağılımı yoktur | Uygulanamaz – herhangi bir deneysel ayırma gerçekleştirilmemiştir | Sadece protokol uygulanabilirlik örneği | Deneysel doğrulama için kullanılmamıştır | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | Uluslararası Cilt Görüntüleme İş Birliği (ISIC) Yarışması | Deri lezyonu sınıflandırması | Dermoskopik görüntüler | Uygulanamaz – görüntü veri seti | 25.331 eğitim görüntüsü | 8 eğitim kategorisi | AKIEC 867; BCC 3,323; BKL 2,624; DF 239; MEL 4,522; NV 12,875; VASC 253; SCC 628 | Uygulanamaz – herhangi bir deneysel ayrım gerçekleştirilmemiştir | Yalnızca protokol uygulanabilirlik örneğidir | Deneysel doğrulama için kullanılmamıştır | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Arşivi | Cilt lezyonu sınıflandırması | Dermoskopik görüntüler | 7.470 benzersiz lezyon | 10.015 görüntü | 7 | AKIEC 327; BCC 514; BKL 1.099; DF 115; MEL 1.113; NV 6.705; VASC 142 | Uygulanamaz – herhangi bir deneysel ayrım gerçekleştirilmemiştir | Sadece protokol uygulanabilirlik örneği | Deneysel doğrulama için kullanılmamıştır | **Sodyum Klorür Gradyanıyla Modifiye Edilmiş Bir Filtrasyon Yöntemi Kullanarak Proteinlerin Saflaştırılması** **Özet** Protein saflaştırma, biyokimyasal ve biyofiziksel analizler için yüksek saflıkta protein elde etmeyi amaçlayan temel bir süreçtir. Bu videoda, sodyum klorür (NaCl) gradyanıyla modifiye edilmiş bir filtrasyon yöntemi kullanılarak proteinlerin saflaştırılması prosedürü sunulmaktadır. Bu yöntem, farklı tuz konsantrasyonlarına göre proteinlerin çözünürlük özelliklerini kullanarak, hedef proteinin diğer hücre bileşenlerinden ve kirleticilerden etkili bir şekilde ayrılmasını sağlar. Prosedür; numunenin hazırlanması, NaCl gradyanının uygulanması, filtrasyon adımları ve ardından elde edilen proteinin saflığının SDS-PAGE analizi ile doğrulanması aşamalarını içerir. Bu protokol, laboratuvar ortamında rutin protein saflaştırma işlemleri için ölçeklenebilir ve yeniden üretilebilir bir yaklaşım sunmaktadır. **Anahtar Kelimeler** Protein saflaştırma, sodyum klorür gradyanı, filtrasyon, protein izolasyonu, SDS-PAGE, biyokimyasal analiz, tuz çöktürme |
| OhioT1DM | araştırma amacıyla kamuya açık olarak dağıtılan OhioT1DM veri seti | Diyabet izleme/öngörü | Klinik zaman serileri | 12 katılımcı | eğitim/geliştirme ve test verilerine yayılmış 24 XML dosyası | Sürekli glikoz tahmini; sabit bir sınıflandırma görevi değildir | Uygulanamaz | Veri kümesi tarafından tanımlanmış eğitim/geliştirme ve test dosyaları; burada herhangi bir deneysel ayrım gerçekleştirilmemiştir | Sadece protokol uygulanabilirlik örneğidir | Deneysel doğrulama için kullanılmamıştır | **Özet** Sars-CoV-2 virüsünün ortaya çıkışı, dünya çapında bir pandemiye yol açan ciddi bir halk sağlığı krizi yaratmıştır. Bu bağlamda, virüsün yayılımını önlemek amacıyla hızlı, hassas ve güvenilir tanı yöntemlerinin geliştirilmesi kritik öneme sahiptir. Bu çalışmada, SARS-CoV-2'nin spesifik RNA dizilerine hedefleyen bir gerçek zamanlı ters transkriptaz polimeraz zincir reaksiyonu (RT-qPCR) protokolü geliştirilmiştir. Geliştirilen yöntem, yüksek duyarlılık ve özgünlük sergileyerek, klinik örneklerden viral RNA'nın etkin bir şekilde tespit edilmesini sağlamıştır. Çalışma sonucunda, optimize edilen primerler ve prob tasarımlarının, SARS-CoV-2'nin farklı varyantlarını tespit etmede yüksek performans gösterdiği doğrulanmıştır. Bu protokol, pandeminin kontrol altına alınmasında ve enfeksiyon yönetimi süreçlerinde değerli bir tanısal araç sunmaktadır. **Anahtar Kelimeler** Sars-CoV-2, RT-qPCR, moleküler tanı, RNA izolasyonu, gerçek zamanlı PCR, viral tespit, pandemi, klinik örnekler |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/Pennsylvania Üniversitesi | Beyin tümörü segmentasyonu/sınıflandırması | MRG | meydan okuma kohortunda 2.040 vaka | 1.251 adet açıklanmış eğitim vakası; vaka başına dört MRI modalitesi | Göreve bağlı | Veri setinin tamamı genelinde tek bir sınıf dağılımı yoktur | Meydan okumaya göre tanımlanmış kohortlar; burada herhangi bir deneysel ayrım yapılmamıştır | Yalnızca protokol uygulanabilirlik örneği | Deneysel doğrulama için kullanılmamıştır | https://www.med.upenn.edu/cbica/brats2021/ |
Tablo 2: Sağlık hizmetleri veri kümesi özellikleri ve önerilen protokolün uygulanabilirliği. Tablo, protokolde değerlendirilen sağlık hizmetleri veri kümeleri için veri kaynaklarını, klinik uygulamaları, modaliteleri, örnek özelliklerini, sınıf dağılımlarını, veri kümesi bölümlendirme stratejilerini, doğrulama durumunu ve kaynak bilgilerini özetlemektedir. Pima Indians Diabetes Veri Kümesi, protokol doğrulaması için birincil çalışılmış örnek olarak hizmet etmektedir.
| Yapılandırma Ögesi | Gerçek Çalışma-Doğrulama Ortamı | Durum / Yorumlama |
| Veri Seti | Pima İndianlar Diyabet Veri Seti | Gerçek deneysel doğrulama veri seti |
| Algoritma / Model | İkili diyabet sınıflandırması için tabüler öngörücü model | Deney kaydında ayrıca belgelenmişse, mimari adını aynen kullanın |
| Öğrenme Oranı | 0.001 | Deneysel düzenek |
| Optimize Edici | Adam | Deneysel düzenek |
| Yığın Boyutu | 32 | Deneysel düzenek |
| Maksimum Epok Sayısı | 100 | Deneysel düzenek |
| Kayıp Fonksiyonu | Çapraz Entropi | Deneysel düzenek |
| Aktivasyon Fonksiyonu | ReLU (Doğrusal Birimleştirilmiş Doğrultucu) | Deneysel düzenek |
| Dropout | 0.5 | Deneysel kurulum |
| Ağırlık Azalması | 1e-4 | Deneysel düzenek |
| Yığın Normalizasyonu | Etkinleştirildi | Deneysel kurulum |
| Veri Artırımı / Sınıf Dengelenmesi | Etkinleştirildi | SMOTE'u yalnızca bildirilen çalışmada gerçekten uygulanmışsa belirtin |
| Doğrulama Stratejisi | 5-katlı çapraz doğrulama | Deneysel düzenek |
| Erken Durdurma | Sabır = 10 epoch | Deneysel düzenek |
| Rastgele Tohum | 42 | Deney için kaydedilen kesin başlangıç değerleri (seed) yapılandırmasını kullanın |
| Tekrarlanan Çalışmalar | farklı rastgele tohumlar kullanılarak gerçekleştirilen 10 bağımsız çalışma | Deneysel tekrarlanabilirlik analizi |
| Giriş Görüntü Boyutu | Uygulanamaz | Pima veri seti tablosal yapıdadır. |
| Öznitelik Boyutu | 512 | Yalnızca bunun nihai olarak uygulanan öznitelik temsili olduğu durumda kullanın |
| Açıklanabilirlik | SHAP + LIME; Şekil 6'da gösterilen karşıt olgusal açıklama | Aktüel raporlanan XAI analizi |
| Değerlendirme Metrikleri | Doğruluk, kesinlik, geri çağırma, özgüllük, F1-skoru, MCC, AUC-ROC, AP | Raporlanan deneysel değerlendirme metrikleri |
| Donanım | NVIDIA GPU | Kayıt altına alınmışsa tam GPU modeliyle değiştirin |
| Yazılım / Çerçeve | Python 3.11; Scikit-learn; uygulama tarafından kullanılan framework bileşenleri | Kaydedilmişse, paketlerin tam sürümlerini kullanın |
Tablo 3: Protokol uygulaması için kullanılan hesaplama ortamı, model mimarisi ve hiperparametre yapılandırması. Tablo; önerilen XAI iş akışını uygulamak için kullanılan hesaplama platformunu, yazılım ortamını, model mimarisini, girdi yapılandırmasını, optimizasyon parametrelerini, düzenlileştirme ayarlarını ve tekrarlanabilirlik parametrelerini belirtmektedir.
| Parametre | Temsili spesifikasyon / sonuç |
| Optimize Edici | Adam |
| Öğrenme oranı | 0.001 |
| Yığın boyutu | 32 |
| Maksimum epok sayısı | 100 |
| Erken durdurma sabrı | 10 epok |
| En iyi dönem | 78 |
| Erken durdurma epoku | 88 |
| En iyi doğrulama kaybı | 0.142 |
| En iyi doğrulama doğruluğu | 94.6% |
| Eğitim çıktısı | Eğitim ve doğrulama kaybı azaldı ve yakınsadı |
| Doğrulama çıktısı | Eğitim ve doğrulama doğruluğu artmış ve stabilize olmuştur |
| Optimizasyon sonucu | En iyi model performansı 78. epokta elde edildi |
| Aşırı öğrenme kontrolü | Erken durdurma, seçilen en iyi epoktan sonrası için optimizasyonu engellemiştir |
Tablo 4: Model eğitim spesifikasyonları ve optimizasyon sonuçları. Tablo; model geliştirme sırasında kullanılan optimize ediciyi, öğrenme hızını, grup boyutunu, maksimum eğitim epok sayısını, doğrulama performansını, eğitim yakınsamasını, optimizasyon sonucunu ve aşırı öğrenmeyi önleme stratejisini özetlemektedir.
| Model | Doğruluk (%) | Kesinlik (%) | Duyarlılık (%) | Özgüllük (%) | F1-skoru (%) | MCC | AUC (ROC) | AP (PR) |
| Önerilen XAI Modeli | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| Derin Öğrenme (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| Rastgele Orman (Random Forest) | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| Destek Vektör Makinesi (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| Temel Hat (Çoğunluk Sınıfı) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
Tablo 5: Değerlendirilen modellerin öngörücü performans karşılaştırması. Tablo; önerilen XAI modelini, doğruluk, kesinlik, duyarlılık, özgüllük, F1-skoru, Matthews korelasyon katsayısı, alıcı işletim karakteristiği eğrisi altında kalan alan ve ortalama kesinlik kullanarak değerlendirilen temel modellerle karşılaştırmaktadır.
| Validasyon analizi | Karşılaştırma / Metrik | İstatistiksel test | Test istatistiği | p-değeri | Deneysel sonuç / %95 GA |
| Beş katlı çapraz doğrulama | Doğruluk | Tanımlayıcı (ortalama ± SS) | — | — | 93.01 ± 0.48% |
| Beş katlı çapraz doğrulama | AUC-ROC | Betimleyici (ortalama ± SD) | — | — | 0.954 ± 0.007 |
| Beş katmanlı çapraz doğrulama | Hassasiyet | Betimleyici (ortalama ± SD) | — | — | 92.42 ± 0.87% |
| Beş katlı çapraz doğrulama | Geri çağırma | Tanımlayıcı (ortalama ± SD) | — | — | 93.02 ± 0.45% |
| Beş katlı çapraz doğrulama | F1-skoru | Betimleyici (ortalama ± SD) | — | — | 92.72 ± 0.62% |
| %95 bootstrap güven aralığı | Doğruluk | Bootstrap (1.000 yeniden örnekleme) | — | — | 0.935 [0.897, 0.973] |
| %95 bootstrap güven aralığı | Hassasiyet | Bootstrap (1.000 yeniden örnekleme) | — | — | 0.930 [0.890, 0.970] |
| %95 bootstrap güven aralığı | Geri Çağırma | Bootstrap (1.000 yeniden örnekleme) | — | — | 0.922 [0.880, 0.963] |
| %95 bootstrap güven aralığı | F1-skoru | Bootstrap (1.000 yeniden örnekleme) | — | — | 0.926 [0.887, 0.965] |
| %95 bootstrap güven aralığı | AUC-ROC | Bootstrap (1.000 yeniden örnekleme) | — | — | 0.958 [0.931, 0.984] |
| Önerilen Model ve CNN Karşılaştırması | Doğruluk (%) | McNemar testi | 9.32 | 0.0023 | Anlamlı (α = 0,05) |
| Önerilen Model ile CNN Karşılaştırması | AUC-ROC | DeLong testi | 3.87 | 0.0001 | Anlamlı (α = 0,05) |
| Önerilen Model ve CNN Karşılaştırması | F1-skoru | Eşleştirilmiş bootstrap (1.000 yeniden örnekleme) | 2.81 | 0.0044 | Anlamlı (α = 0,05) |
| Önerilen Model ile Random Forest Karşılaştırması | Doğruluk (%) | McNemar testi | 14.27 | 0.0002 | Anlamlı (α = 0,05) |
| Önerilen Model ve Rastgele Orman (Random Forest) Karşılaştırması | AUC-ROC | DeLong testi | 5.86 | <0.0001 | Anlamlı (α = 0,05) |
| Önerilen Model ile Random Forest Karşılaştırması | F1-skoru | Eşleştirilmiş bootstrap (1.000 yeniden örnekleme) | 4.03 | 0.0003 | Anlamlı (α = 0,05) |
| Önerilen Model ile SVM'nin Karşılaştırılması | Doğruluk (%) | McNemar testi | 16.08 | <0.0001 | Anlamlı (α = 0,05) |
| Önerilen Model ile SVM'nin Karşılaştırılması | AUC-ROC | DeLong testi | 6.95 | <0.0001 | Anlamlı (α = 0,05) |
| Önerilen Model ile SVM'nin Karşılaştırılması | F1-skoru | Eşleştirilmiş bootstrap (1.000 yeniden örnekleme) | 4.62 | <0.0001 | Anlamlı (α = 0,05) |
| Tekrarlanan çalışma tekrarlanabilirliği (10 bağımsız çalışma) | AUC-ROC | Betimsel (ortalama ± SS) | — | — | 0.957 ± 0.008 |
| Tekrarlanan çalışmalele yeniden üretilebilirlik (10 bağımsız çalışma) | Doğruluk (%) | Betimleyici (ortalama ± SD) | — | — | 93.24 ± 0.74% |
| Tekrarlanan çalışma yeniden üretilebilirliği (10 bağımsız çalışma) | F1-skoru (%) | Tanımlayıcı (ortalama ± SD) | — | — | 92.35 ± 0.92% |
Tablo 6: Pima Indians Diyabet Veri Kümesi kullanılarak yapılan deneysel uygulamadan elde edilen istatistiksel doğrulama ve tekrarlanabilirlik sonuçları. Tablo; beş katlı çapraz doğrulama performansını, bootstrap tabanlı %95 güven aralıklarını, önerilen modelin temel modellerle istatistiksel karşılaştırmalarını ve 10 bağımsız rastgele tohum üzerinden tekrarlı çalışma tekrarlanabilirliğini özetlemektedir. Mevcut doğrulama çalışmasında dış doğrulama ve klinik uzman değerlendirmesi gerçekleştirilmemiştir.
| Hayır. | Kontrol Listesi Öğesi | Gerekli Belgeler | Önerilen Kayıt / Doğrulama |
| 1 | Yazılım ortamı | İşletim sistemi, programlama dili ve yazılım ortamı | İşletim sistemi ve programlama dili sürümlerini tam olarak kaydedin. |
| 2 | Yazılım ve kütüphane sürümleri | Kullanılan ana yazılım kütüphanelerinin ve paketlerinin sürümleri | Paket/kütüphane adlarını ve versiyonlarını tam olarak kaydedin. |
| 3 | Donanım özellikleri | CPU, GPU, RAM, depolama ve hızlandırıcı spesifikasyonları | Kullanılan hesaplama donanımını kaydedin. |
| 4 | Veri seti tanımlama | Veri seti adı, kaynağı, sürümü ve erişim bilgileri | Varsa, veri setinin kesin kaynağını/sürümünü ve erişim tarihini kaydedin. |
| 5 | Veri seti özellikleri | Örneklem büyüklüğü ve sınıf dağılımı | Her bir bölünme için toplam örnek sayısını ve sınıf dağılımını kaydedin. |
| 6 | Veri seti bölümlendirme | Eğitim, doğrulama ve bağımsız test seti stratejisi | Belge bölme oranlarını/sayılarını ve tabakalaştırmayı kaydedin. |
| 7 | Veri sızıntısı önleme | Bilgi sızıntısını önlemek için kullanılan prosedür | Doküman konusu/örneği ayırma ve yalnızca eğitim için ön işleme parametre kestirimi. |
| 8 | Önişleme parametreleri | Temizleme, eksik değer işleme, normalleştirme, kodlama ve dönüşüm ayarları | Tüm ön işleme işlemlerini ve parametre değerlerini kaydedin. |
| 9 | Veri artırımı | Artırma yöntemleri ve uygun olduğunda parametre ayarları | Yöntemleri, olasılıkları ve parametre aralıklarını belgeleyin. |
| 10 | Model mimarisi | Final model mimarisi ve konfigürasyonu | Model tipini, katmanları/bileşenleri, boyutları ve aktivasyon fonksiyonlarını belgeleyin. |
| 11 | Hiperparametreler | Eğitim ve optimizasyon hiperparametreleri | Öğrenme oranını, paket boyutunu, optimize ediciyi, epok sayısını, erken durdurmayı ve ayarlanmış parametreleri kaydedin. |
| 12 | Rastgele tohumlar | Tekrarlanabilir yürütme için kullanılan rastgele tohumlar | Sürekli çalıştırmalar, başlatma ve ayırma işlemleri için seed değerlerini kaydedin. |
| 13 | Eğitim yapılandırması | Eğitim prosedürü ve model seçim stratejisi | Doküman doğrulama, kontrol noktası oluşturma ve model seçim kriterleri. |
| 14 | Değerlendirme metrikleri | Önceden tanımlanmış öngörücü ve istatistiksel değerlendirme metrikleri | Raporlanan tüm performans ölçümlerini kaydedin. |
| 15 | Güven aralıkları | Performans ölçümleri için belirsizlik aralıkları | Uygun olduğu yerlerde, güven aralığı (CI) kestirim prosedürünü ve bootstrap yeniden örneklemelerini belgeleyin. |
| 16 | İstatistiksel testler | Model karşılaştırması için istatistiksel prosedürler | Belge testi, istatistik, p-değeri, anlamlılık eşiği ve varsayımlar. |
| 17 | Tekrarlı çalışma analizi | Farklı rastgele tohumlar kullanılarak gerçekleştirilen bağımsız yürütmeler | Çalışma sayısını ve temel metriklerin ortalama ± standart sapma değerlerini kaydedin. |
| 18 | Açıklanabilirlik yapılandırması | Açıklanabilirlik yöntemleri ve parametre ayarları | SHAP, LIME, Grad-CAM, dikkat (attention), karşıolgusal (counterfactual) veya uygulanabilir ayarları belgeleyin. |
| 19 | Açıklanabilirlik değerlendirmesi | Açıklama güvenilirliğinin ve yararlılığının objektif değerlendirmesi | Belge sadakati, stabilitesi, sadakatsizliği, lokalizasyonu ve uygun olduğunda uzman değerlendirmesi. |
| 20 | Model artefaktları | Eğitilmiş model ağırlıkları ve konfigürasyon dosyaları | Eğitilmiş nihai modeli, mimariyi/konfigürasyonu ve seçim bilgilerini arşivleyin. |
| 21 | Kod erişilebilirliği | Önişleme, eğitim, değerlendirme ve açıklama üretimi için gerekli kodlar | Varsa kayıt deposunu veya kontrollü kod erişim bilgilerini kaydedin. |
| 22 | Yürütme dokümantasyonu | Komutlar, betikler, yapılandırma dosyaları ve talimatlar | İş akışını yeniden oluşturmak için gereken komutları ve yapılandırmayı kaydedin. |
| 23 | Çıktı dokümantasyonu | Tahminler, değerlendirme sonuçları, şekiller ve açıklama çıktıları | Üretilen çıktıları arşivleyin ve bunları ilgili deney/çalışma ile ilişkilendirin. |
| 24 | Tekrarlanabilirlik doğrulaması | Bağımsız yürütmeler arasındaki tutarlılığın doğrulanması | Tekrarlanan çalışma sonuçlarını karşılaştırın ve önceden tanımlanmış değişkenlik ölçümlerini raporlayın. |
Tablo 7: Önerilen XAI iş akışının bağımsız replikasyonu içinle tekrarlanabilirlik kontrol listesi. Kontrol listesi, deneysel iş akışını yeniden oluşturmak için gereken hesaplama, veri seti, ön işleme, model geliştirme, değerlendirme, istatistiksel doğrulama, açıklanabilirlik ve dokümantasyon gereksinimlerini belirtmektedir.
Tartışma
Sonuçlar, önerilen protokolün çeşitli sağlık hizmetleri veri kümelerinde XAI sistemlerini geliştirmek ve değerlendirmek için standartlaştırılmış ve tekrarlanabilir bir iş akışı olarak kullanım faydasını göstermektedir. Tablo 2 ve Şekil 3'te gösterildiği gibi, sistematik ön işleme; eksik değerlerin yönetimi, veri normalizasyonu, özellik ölçeklendirme ve veri kümesi bölümlendirme yoluyla standartlaştırılmış veriler üretmiş ve veri kalitesini artırmıştır. Veri hazırlığındaki değişkenlik; yanlılığa yol açabileceği, öngörücü performansı düşürebileceği ve açıklanabilirlik analizlerinin güvenilirliğini tehlikeye atabileceği için bu ön işleme adımları kritiktir. Bu nedenle, tekrarlanabilirliği artırmak ve veri sızıntısını önlemek için eğitim, doğrulama ve test veri kümeleri genelinde tutarlı ön işleme prosedürleri uygulanmalıdır19,20.
Şekil 4 ve Tablo 4'te gösterilen model eğitim sonuçları; tutarlı ve kararlı bir öğrenme davranışı sergilemektedir. Eğitim ve doğrulama kayıplarındaki eş zamanlı azalmalar ile öngörü doğruluğundaki artışlar, belirgin bir aşırı öğrenme (overfitting) olmaksızın uygun model yakınsamasına işaret etmektedir. Hiperparametre optimizasyonu, erken durdurma, dropout ve düzenlileştirme (regularization), kararlı ve tekrarlanabilir model eğitimine daha fazla katkıda bulunmaktadır. Öğrenme eğrilerindeki kararsızlıklar; uygun olmayan bir öğrenme hızı, yetersiz eğitim verisi veya aşırı model karmaşıklığına işaret edebilir. Bu nedenle, söz konusu potansiyel sorunları belirlemek ve gidermek için eğitim boyunca model yakınsaması izlenmelidir.
Tablo 5 ve Şekil 5; doğruluk, kesinlik, duyarlılık, özgünlük, F1 skoru, Matthews korelasyon katsayısı ve alıcı işletim karakteristik (ROC) eğrisi altındaki alan dahil olmak üzere birden fazla değerlendirme metriği kullanılarak elde edilen öngörü performansını göstermektedir. ROC ve kesinlik-duyarlılık eğrileri ayırt edici performans ölçümleri sağlarken, hata matrisi sınıflar genelindeki doğru ve yanlış sınıflandırmaların dağılımını örneklendirmektedir. Birden fazla performans metriği kullanılarak yapılan değerlendirme, yalnızca genel doğruluğun model performansını yeterince tanımlayamayabileceği dengesiz tıbbi veri setleri için özellikle önemlidir.
Şekil 6 Pima Kızılderilileri Diyabet Veri Seti'nden elde edilen açıklanabilirlik sonuçlarını göstermekte ve uygulamalı doğrulamada kullanılan açıklanabilirlik yöntemlerinin birbirini tamamlayıcı rollerini ortaya koymaktadır. Global SHAP analizi, girdi özelliklerinin model tahminlerine olan genel katkısını ve göreceli önemini karakterize ederken; SHAP şelale ve bağımlılık grafikleri, model davranışının hastaya özgü ve özellik düzeyindeki yorumlarını sunmaktadır. LIME, tekil bir test seti tahminine katkıda bulunan özellikleri belirleyerek ek bir yerel açıklama sağlar. Hastaya özgü karşıolgusal (counterfactual) açıklama ise tahmin edilen sonuçtaki bir değişiklikle ilişkili olan minimum özellik değişimlerini daha ayrıntılı bir şekilde göstermektedir. Bu yaklaşımlar birlikte, model davranışı üzerine tamamlayıcı global ve yerel bakış açıları sunarak tablolu öngörücü modelin şeffaflığını ve yorumlanabilirliğini artırır. Grad-CAM, dikkat görselleştirme, belirginlik haritalama (saliency mapping) ve Entegre Gradyanlar, Pima uygulamalı doğrulamasında uygulanmamış olup genel protokol içerisinde yalnızca modaliteye bağlı seçenekler olarak tutulmuştur.
İstatistiksel doğrulama (Tablo 6 ve Şekil 7) ve tekrarlanabilirlik değerlendirmeleri, farklı deneysel çalışmalar boyunca öngörücü performansın stabilitesini kanıtlamaktadır. Çapraz doğrulama, güven aralığı tahmini, hipotez testi ve tekrarlanan çalışma tekrarlanabilirlik değerlendirmesinin kombinasyonu, model sağlamlığını değerlendirmek için sistematik bir çerçeve sunar. Bu tür bir doğrulama, özellikle sağlık hizmetleri uygulamalarında önemlidir; çünkü bağımsız deneyler arasındaki tekrarlanabilirlik, yapay zeka modellerinin klinik ortamlarda uygulanmadan önce güvenilirliğine ve genellenebilirliğine dair kanıt sağlar21,23.
Bu protokolün başarılı bir şekilde uygulanması için birkaç adım kritik öneme sahiptir. Eksik, tutarsız veya hatalı verilerden kaynaklanabilecek potansiyel yanlılığı en aza indirmek için özellik çıkarımı ve model eğitimi öncesinde veri temizleme işlemini gerçekleştirin. Hiperparametre optimizasyonunu yalnızca eğitim ve doğrulama verilerini kullanarak yapın ve model geliştirme ile optimizasyon süreçleri boyunca test veri setini bağımsız tutun. Hesaplama platformları arasında tekrarlanabilirliği kolaylaştırmak için rastgele sayı üreteci durumlarını, yazılım versiyonlarını, donanım yapılandırmalarını ve ön işleme ayarlarını açıkça belgeleyin. Ek olarak, yorumlanabilir ve klinik olarak anlamlı açıklamalar elde etmek için açıklanabilirlik yöntemlerini, öngörücü modele ve sağlık verisi modalitesine göre seçin20,29,30.
Protokolün çeşitli sınırlamaları bulunmaktadır. Model tahminlerinin ve açıklamalarının doğruluğu ve güvenilirliği, büyük ölçüde yeterince geniş, temsil gücü yüksek ve yüksek kaliteli sağlık veri kümelerinin mevcut olmasına bağlıdır. Belirli hasta popülasyonlarının yetersiz temsili, ölçüm hataları, eksik değişkenler ve veri kaynakları arasındaki heterojenlik, hem öngörücü performansı hem de model açıklamalarının kararlılığını olumsuz etkileyebilir. Ayrıca, mevcut açıklanabilirlik yaklaşımları model davranışını karakterize edebilse de mutlaka nedensel mekanizmalar kurmayabilir. Bu nedenle, XAI çıktıları ilgili klinik uzmanlıkla birlikte değerlendirilmelidir.
Genel olarak bu protokol, sağlık hizmetlerinin farklı alanlarında tekrarlanabilir model geliştirme, değerlendirme ve açıklanabilirlik analizi için standartlaştırılmış bir yaklaşım sunmaktadır. Standartlaştırılmış ön işleme, hiperparametre optimizasyonu, birden fazla performans metriği kullanılarak yapılan değerlendirme, tamamlayıcı açıklanabilirlik yaklaşımları ve istatistiksel doğrulamayı entegre eden bu iş akışı, sağlık hizmetlerinde yapay zeka araştırmaları için şeffaf ve izlenebilir bir çerçeve sağlamaktadır.
Sonuçlar ayrıca, sistematik veri ön işlemenin, standartlaştırılmış model geliştirme prosedürlerinin, kapsamlı performans değerlendirmesinin, çoklu açıklanabilirlik yöntemlerinin ve titiz istatistiksel doğrulamanın birleştirilmesiyle şeffaf ve tutarlı bir yapay zeka model geliştirmenin desteklenebileceğini göstermektedir. Bu protokol; farklı hesaplama ortamlarında tekrarlanabilir deneyler için bir çerçeve sunarken klinik veri tabanlarına, tıbbi görüntülere, fizyolojik sinyallere ve multimodal sağlık verilerine uyarlanabilir. Standartlaştırılmış uygulama, tamamlayıcı açıklanabilirlik teknikleri ve tekrarlanabilirlik değerlendirmesi aracılığıyla bu protokol, açıklanabilir ve güvenilir yapay zeka modelleri geliştirmek için bir çerçeve sağlamakta olup, gelecekteki biyomedikal araştırmalar ile ardından gelecek harici ve klinik doğrulamalar için metodolojik bir temel teşkil edebilir.
Açıklamalar
Yazarlar, bu çalışmada bildirilen çalışmayı etkileyebilecek herhangi bir rakip finansal çıkarın, ticari ilişkinin veya kişisel ilişkinin bulunmadığını beyan ederler. Yazarların beyan edilecek herhangi bir çıkar çatışması yoktur.
Teşekkürler
Yazarlar, bu sağlık hizmetleri XAI protokolünün geliştirilmesi ve deneysel doğrulanması sırasında ilgili bağlı kurumları tarafından sağlanan kurumsal desteği kabul ederler. Yazarlar ayrıca deneysel analizleri yürütmek için kullanılan hesaplama olanaklarını ve yazılım kaynaklarını kabul ederler. Bu araştırma herhangi bir dış finansman almamıştır. Yazarlar; hesaplama analizi, veri görselleştirme ve bu çalışmada sunulan şekillerin oluşturulması için Python 3.11, Matplotlib 3.9 ve SciPy 1.13 kullanımını kabul ederler.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| Captum | Meta AI | En son kararlı sürüm | PyTorch açıklanabilirliği |
| CUDA Toolkit | NVIDIA | 12.2 | GPU hızlandırma |
| cuDNN | NVIDIA | 9.x | Derin öğrenme arka ucu |
| Git | Git SCM | En son kararlı sürüm | Versiyon kontrolü |
| GitHub | GitHub Inc. | Web platformu | Kaynak kod deposu |
| Grad-CAM | jacobgil | En son sürüm | CNN görselleştirme |
| Jupyter Notebook | Project Jupyter | En son kararlı sürüm | Etkileşimli geliştirme |
| LightGBM | Microsoft | 4.x | Gradyan artırma |
| LIME | LIME Community | 0.2.0 | Yerel açıklanabilirlik |
| Matplotlib | Matplotlib Developers | 3.9 | Görselleştirme |
| Microsoft Excel | Microsoft | Microsoft 365 | Veri organizasyonu |
| NumPy | NumPy Developers | 1.26 | Sayısal hesaplama |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Model eğitimi |
| OpenCV | OpenCV Organization | 4.10 | Görüntü ön işleme |
| Pandas | Pandas Development Team | 2.2 | Veri ön işleme |
| Pillow (PIL) | Python Imaging Library | 10.x | Görüntü işleme |
| Plotly | Plotly Technologies | 5.x | Etkileşimli görselleştirme |
| Python | Python Software Foundation | 3.11 | Programlama ortamı |
| PyTorch | PyTorch Foundation | 2.3 | Derin öğrenme |
| Scikit-learn | Scikit-learn Developers | 1.5 | Makine öğrenimi |
| SciPy | SciPy Developers | 1.13 | Bilimsel hesaplama |
| Seaborn | Seaborn Developers | 0.13 | İstatistiki grafikler |
| SHAP | SHAP Community | 0.46 | Küresel açıklanabilirlik |
| SimpleITK | Insight Software Consortium | 2.x | Tıbbi görüntü işleme |
| Statsmodels | Statsmodels Developers | 0.14 | İstatistiki analiz |
| Sistem RAM | Herhangi bir üretici | 32 GB veya üzeri | Bellek |
| TensorBoard | 2.15 | Eğitim izleme | |
| TensorFlow | 2.15 | Derin öğrenme | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | İşletim sistemi |
| Visual Studio Code | Microsoft | En son kararlı sürüm | Kod geliştirme |
| XGBoost | XGBoost Developers | 2.1 | Gradyan artırma |
Kaynaklar
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.