Bu iş akışı, diyabetik ayak ülserinde MMP1'i önceliklendirmek için dökme (bulk) ve tek hücreli transkriptomiği, öncül hasta doku analizleri ile entegre etmektedir. MMP1, fibroblast merkezli bir ekspresyon paterni ve daha yüksek doku bolluğu göstermiş; bu durum matris yeniden şekillenmesi ile olan ilişkiyi desteklerken, nedensellik ve klinik fayda konusunu çözümsüz bırakmıştır.
Araştırma makalesi
Doku Doğrulamalı Bütünleşik Bulk ve Tek Hücre Transkriptomiği, Diyabetik Ayak Ülserinde MMP1'i Önceliklendirir
* These authors contributed equally
Bu makalede
Özet
Özet
Diyabetik ayak ülserinde (DFU) tekrarlanabilir transkriptomik değişikliklerin hücresel kaynakları henüz tam olarak tanımlanmamıştır. Bu çalışma; diferansiyel ekspresyon analizini, ağırlıklı gen eş-ekspresyon ağ analizi'ni (WGCNA), diyabetik periferik nöropati (DPN) gen taramasını, keşifsel makine öğrenimi özellik seçimini, iki harici bulk-transkriptomik veri setini, tek hücre analizini, geleneksel Çin tıbbı (TCM) ağ analizini ve hasta dokusu üzerinden kantitatif polimeraz zincir reaksiyonu (qPCR) ile western blotting yöntemlerini entegre etmiştir. GSE199939'da (10 DFU ve 11 kontrol örneği), 3.691 diferansiyel eksprese gen tanımlanmış ve WGCNA mavi modülünün DFU ile güçlü bir ilişkisi olduğu görülmüştür (r = 0,97, p = 5 × 10-13). Diferansiyel eksprese genlerin, mavi modül hub genlerinin ve 1.062 DPN ile ilişkili genin kesişimi 77 aday gen sağlamıştır. CCL7, CHEK1, MKI67, MMP1, MMP13 ve TRPV2, en az iki özellik seçimi yöntemiyle desteklenmiştir; destek vektör makinesi özyinelemeli özellik elemesindeki tam ayrım, keşif kohortunda aşırı öğrenme (overfitting) endişelerini artırmıştır. MMP1, keşif kohortunda en büyük ekspresyon değişikliğini göstermiştir (log2 kat değişimi = 9,854; düzeltilmiş p = 1,24 × 10⁻²⁹). Birleştirilmiş GSE68183/GSE80178 matrisinde, MMP1 0,0159 düzeltilmiş p değerine ve 0,981 alıcı işletim özelliği eğrisi altında kalan alan (AUC) değerine sahipti. GSE134431'de, MMP1 ekspresyonu DFU'da, ülserleşmemiş diyabetik ayak derisine göre nominal olarak daha yüksekti (p = 0,0225; düzeltilmiş p = 0,135; AUC = 0,808). 24 örnekten alınan 69.944 hücrenin analizi, en yüksek ortalama MMP1 ekspresyonunu fibroblastlarda göstermiş; DFU fibroblastları, keratinositleri ve endotel hücrelerinde örnek düzeyinde daha yüksek ekspresyon saptanmıştır. Hasta dokusu analizleri, dört eşleşmiş çiftte daha yüksek MMP1 mRNA bolluğu (ΔCq üzerinden eşli test, p = 3,04 × 10⁻⁵) ve üç eşleşmiş çiftte daha yüksek protein bolluğu (eşli p = 0,0107) göstermiştir. İstatistiksel replikasyon eksiktir. Bulgular; sayım tabanlı keşif analizindeki milyon başına transkript (TPM) girdileri, eksik tek hücre ön işleme kayıtları ve küçük doku analizi kohortlarından kaynaklanan kısıtlamalara tabi olmakla birlikte, fibroblast merkezli bir matriks yeniden şekillenme ilişkisine işaret etmektedir. Nedensellik ve klinik fayda henüz kanıtlanmamıştır.
Giriş
Diyabetik ayak ülseri; nöropati, tekrarlayan mekanik yüklenme, periferik arter hastalığı, enfeksiyon duyarlılığı ve bozulmuş doku onarımının birleşmesiyle ortaya çıkan, diyabetin ciddi ve tekrarlayıcı bir komplikasyonudur. Güncel tahminler, her yıl dünya çapında milyonlarca kişinin bundan etkilendiğini ve iyileşmenin genellikle uzun sürdüğünü; ayrıca nüks, hastaneye yatış, alt ekstremite amputasyonu ve ölüm gibi önemli risklerin bulunduğunu göstermektedir1. Bu nedenle önleme ve yönetim, yalnızca lokal yara bakımına değil, aynı zamanda koruyucu duyum kaybının belirlenmesine, plantar basıncın azaltılmasına, enfeksiyon ve iskeminin tedavi edilmesine ve sistemik risk faktörlerinin giderilmesine bağlıdır1,2. Diyabetik periferik nöropati özellikle önemlidir; çünkü ilerleyici duyusal disfonksiyon, basınca, travmaya ve doku yıkımına karşı farkındalığı azaltabilirken, motor ve otonom anomaliler ayak biyomekaniğini ve cilt bütünlüğünü daha da bozabilir2,3. Doku düzeyinde, nöropatik yaralanmaya nöroinflamasyon, mikrovasküler disfonksiyon, metabolik stres ve kusurlu onarım eşlik edebilir; bu da standart bakıma rağmen yaralanmanın devam ettiği bir yara ortamı oluşturur1,3.
Başarılı kutanöz iyileşme; koordine bir inflamasyon, re-epitelizasyon, anjiyogenez, fibroblast aktivasyonu, hücre dışı matriks (ECM) depolanması ve ardından gelen matris yeniden şekillenmesi gerektirir. Diyabette bu süreçler zamansal olarak düzensiz hale gelebilir: inflamatuar sinyaller aktif kalabilir, keratinosit migrasyonu bozulabilir, endotelyal yanıtlar yetersiz kalabilir ve fibroblastlar anormal bir matris üretebilir veya organize edebilir. Fibroblastlar; matris proteinlerini sentezledikleri, kollajen mimarisini düzenledikleri, immün ve epitelyal hücrelerle iletişim kurdukları ve yara kontraksiyonuna katkıda bulundukları için onarımın stromal fazının merkezinde yer alırlar. Hasta kaynaklı DFU fibroblastları kullanılarak yapılan çalışmalar, ECM ile ilişkili transkripsiyonda ve matris montajında kalıcı anomaliler olduğunu göstermiş ve fibroblast durumunun kronik yara biyolojisinin önemli bir bileşeni olduğu görüşünü desteklemiştir4. Matriks metalloproteinazları (MMP'ler), ECM substratlarını parçalayarak hücre migrasyonunu, doku döngüsünü ve yeniden şekillenmeyi sağlayarak bu sürece katılırlar; ancak etkileri konuma, zamana, substrat mevcudiyetine ve doku metalloproteinaz inhibitörleri (TIMP'ler) tarafından yapılan düzenlemeye bağlıdır5. Bu nedenle, proteoliz ve matris yenilenmesi arasındaki bir dengesizlik bozulmuş onarımla uyumlu olabilir, ancak tek bir MMP'nin artmış ekspresyonu tek başına zararlı veya faydalı bir rol belirlemez. Fibriler kollajen döngüsüne katılma yeteneğine sahip olan interstisyel bir kollajenaz olan Matriks metalloproteinaz 1'in (MMP1), DFU dokusunda değiştiği bildirilmiştir ve önceki klinik çalışmalar MMP/TIMP profillerini yara durumu veya iyileşme seyri ile ilişkilendirmiştir6,7. Bu gözlemler, DFU'da MMP1'in daha fazla araştırılmasını desteklemektedir.
Transkriptomik profilleme, DFU ile ilişkili moleküler programların tanımlanması için sistematik bir yaklaşım sunar, ancak bazı metodolojik sınırlamalar yorumlamayı zorlaştırmaktadır. Bulk doku veri setleri; keratinositler, fibroblastlar, endotel hücreler, immün hücreler ve diğer bölmeler arasındaki sinyalleri ortaladığından, bir adayın belirli bir hücre tipi içindeki değişmiş ekspresyonu mu, hücresel kompozisyondaki kaymaları mı yoksa her ikisini birden mi yansıttığını belirlemek güçleşmektedir. Veri setleri arasındaki karşılaştırılabilirlik; platform farklılıkları, normalizasyon stratejileri, doku örnekleme bölgeleri, ülser şiddeti, enfeksiyon durumu, hastalık evresi ve referans doku nedeniyle de azalabilmektedir. Önemli bir nokta olarak, ülserleşmemiş diyabetik ayak derisi, klinik olarak ilgili bir diyabetik doku karşılaştırıcısını temsil eder ancak sağlıklı deri ile birbirinin yerine kullanılamaz. Tek hücreli RNA dizileme, heterojen hücre popülasyonlarını ve bunların transkripsiyonel durumlarını çözümleyerek hücresel kaynak sorununu kısmen giderebilir. DFU üzerine yapılan önceki bir tek hücreli ve mekansal transkriptomik çalışma, belirgin fibroblast popülasyonlarını tanımlamış ve fibroblast programlarının yara bağlamına ve iyileşme durumuna göre farklılık gösterdiğini kanıtlamıştır8. Bu bulgular, bulk transkriptomik verileri tamamlamak için hücre çözünürlüklü analizin kullanımını desteklemektedir.
Özellik seçimi yöntemleri, yüksek boyutlu ekspresyon verilerindeki adayların önceliklendirilmesine yardımcı olabilir; ancak küçük örneklemli biyomedikal çalışmalar, özellikle iyimser tahminlere ve kararsız gen seçimine karşı savunmasızdır. Ölçülen değişken sayısı biyolojik örnek sayısını büyük ölçüde aştığında, genelleştirilebilir öngörücü bilgiler sınırlı olsa bile görünürde mükemmel bir ayrım gerçekleşebilir. Aynı gözlemlerin özellik seçimi, ince ayar ve performans değerlendirmesi için yeniden kullanılması AUC değerini daha da şişirmekte; bu durum, öngörücü performansı değerlendirmek için iç içe geçmiş çapraz doğrulama, kilitli modeller ve gerçekten bağımsız test kohortlarını zorunlu kılmaktadır9,10. Bu endişeler DFU çalışmaları için geçerlidir çünkü halka açık kohortlar genellikle küçük ve heterojendir. Geleneksel Çin tıbbı içerik-hedef-bitki veri tabanları ise ek olarak yalnızca hipotez oluşturmak için kullanılmıştır.
Bu çalışma; bulk transkriptomik, WGCNA, DPN ile ilişkili gen taraması, makine öğrenmesi özellik seçimi, harici veri seti değerlendirmesi, tek hücreli analiz, TCM ağ analizi ve hasta dokusu doğrulamasını entegre etmiştir. Keşif kohortunda belirlenen aday genler, ek transkriptomik veri setleri genelinde değerlendirilmiş ve en güçlü aday, tek hücreli veriler kullanılarak spesifik hücre tiplerine lokalize edilmiştir. Ardından MMP1, qPCR ve western blotting ile hasta dokusunda mRNA ve protein düzeylerinde incelenmiştir. Bu çerçeve, tekrarlanabilir bir DFU ile ilişkili aday belirlemek ve bunun hücresel ve biyolojik bağlamını karakterize etmek için tasarlanmıştır.
Protokol
Çalışma tasarımı ve veri kaynakları
qPCR ve western blot doğrulaması için hasta doku örneklerinin toplanmasını ve kullanımını içeren çalışma, Wuhan Dördüncü Hastanesi Etik Kurulu tarafından incelenmiş ve onaylanmıştır (onay No. KY2024-161-01). İnsan dokusu içeren tüm prosedürler, onaylanmış protokol ve geçerli etik ilkeler uyarınca yürütülmüştür. Çalışmanın transkriptomik bileşeninde, kamuya açık, kimlikten arındırılmış veri setleri kullanılmıştır. Deneysel doğrulama için doku örnekleri kullanılan tüm katılımcılardan yazılı bilgilendirilmiş onam alınmıştır. Kamuya açık transkriptomik veri setleri kimliksiz biçimde analiz edilmiş ve orijinal veri üreten çalışmaların onam prosedürleri ilgili kurumlar tarafından yürütülmüştür.
Bu çalışma; toplu transkriptomik, ağ analizi, özellik seçimi, tek hücre analizi, Geleneksel Çin Tıbbı (TCM) ağ tahmini ve hasta dokusu doğrulamasını entegre etmiştir. Keşif kohortu olarak Gene Expression Omnibus (GEO) veri seti GSE199939 (10 DFU ve 11 kontrol örneği) kullanılmıştır. Harici toplu transkriptomik değerlendirmeye, birleştirilmiş bir GSE68183/GSE80178 matrisi (9 DFU ve 6 kontrol örneği) ve GSE134431 (13 DFU ve 8 ülserleşmemiş diyabetik ayak derisi [DFS] örneği) dahil edilmiştir. Tek hücre analizinde, GSE165816'dan türetilen, ön işlemden geçirilmiş ve SingleR ile açıklanmış, 24 örnekten (14 DFU ve 10 kontrol) 69.944 hücreyi içeren bir Seurat nesnesi kullanılmıştır. Doku değerlendirmesi, geri kazanılan analiz kayıtlarına ve yazarlar tarafından onaylanan eşleştirmelere dayanarak, qPCR için dört eşleşmiş DFU–yara çevresi hasta çiftini ve western blotting için üç eşleşmiş çifti içermiştir. Bu çalışmada kullanılan tüm materyal ve ekipmanlar Materyaller Tablosu'nda listelenmiştir.
DPN ilişkili gen setinin oluşturulması
DPN ile ilişkili genler, rentrez kullanılarak National Center for Biotechnology Information (NCBI) Gen veri tabanından elde edilmiştir. Arama terimleri, Homo sapiens ile sınırlandırılarak “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy” ve “diabetic sensorimotor polyneuropathy” şeklinde belirlenmiştir. Elde edilen tanımlayıcılar resmi gen sembolleriyle eşleştirilmiş, büyük harflere dönüştürülmüş, temizlenmiş ve mükerrer kayıtlar ayıklanmıştır. Veri tabanından türetilen genler, literatürden derlenen bir DPN gen listesiyle birleştirilmiş ve tekrarlar giderilerek toplam 1.062 DPN ilişkili gen elde edilmiştir. Tam arama dizeleri ve tanımlayıcı temizleme kodu ekteki betiklerde yer almaktadır; bu betikler ayrıca diyabetik nöropatileri, diyabetle birlikte görülen distal simetrik/simetrik polinöropati veya periferik nöropatiyi ve "Diabetic Neuropathies" MeSH terimini de içermektedir. Literatürden türetilen bileşen hâlâ atıf düzeyinde kanıt gerektirmektedir.
Keşif kohortu ön işleme ve diferansiyel ekspresyon analizi
GSE199939 ekspresyon matrisi, örnek tanımlayıcıları üzerinden fenotip tablosu ile hizalandı. Yinelenen gen tanımlayıcıları tekilleştirildi. Arşivlenen keşif analizinde, ekspresyon değerleri yuvarlandı ve tasarım faktörü olarak grup, karşılaştırma olarak ise DFU ile kontrol grubu kullanılarak DESeq2 (versiyon 1.48.2) aracılığıyla negatif-binomal bir model uygulandı. Düzeltilmiş p değerleri eksik olan genler hariç tutuldu. Çoklu test düzeltmesi Benjamini-Hochberg (BH) prosedürü kullanılarak kontrol edildi. Arşivlenenle farklı ifade edilen gen (DEG) listesinde, 1'den büyük mutlak log2 kat değişim (fold change) ve BH-düzeltilmiş p < 0,05 kriterleri kullanıldı. Genel GEO kaynağı ile yapılan karşılaştırma, girdinin ham okuma sayıları yerine TPM olduğunu doğruladı. TPM değerlerinin yuvarlanması, DESeq2'nin ham sayı gereksinimini karşılamamaktadır. Orijinal tahminler korunmuş olsa da, keşif istatistiklerinin ve bunlara bağlı WGCNA ile özellik seçimi sonuçlarının geçerliliği, uygun bir yeniden analiz yapılana kadar belirsizliğini korumaktadır. Kaynak karşılaştırması ek arşivde belgelenmiştir.
Görselleştirme için, DESeq2 varyans sabitleme dönüşümü (VST), blind = FALSE parametresi ile uygulanmıştır. VST ekspresyon matrisi üzerinde temel bileşen analizi (PCA) gerçekleştirilmiştir. Isı haritasında, düzeltilmiş p değerleri en düşük olan 50 gen için satır bazlı z skorları kullanılmıştır. PCA uygulaması, prcomp fonksiyonu scale. = TRUE parametresi kullanılarak gen bazlı dönüştürülmüş değerleri merkezlemiş ve ölçeklendirmiştir.
Ağırlıklı gen eş-ifade ağ analizi
WGCNA için, en az üç GSE199939 örneğinde sayımları 5'ten büyük olan genler tutuldu. Boyut faktörleri DESeq2 ile tahmin edildi, blind = TRUE şeklinde VST uygulandı ve örnekler arası varyansı en yüksek olan 5.000 gen seçildi. Örnek ve gen kalitesi goodSamplesGenes kullanılarak değerlendirildi ve örnek düzeyindeki kalite değerlendirmesi için ortalama bağlantılı hiyerarşik kümeleme kullanıldı.
WGCNA (versiyon 1.74) kullanılarak imzalı bir ağ oluşturuldu. pickSoftThreshold kullanılarak 1–10 ve 2'şer artışlarla 12–30 arasındaki aday kuvvetler değerlendirildi; 0,85'lik bir ölçeksiz topoloji uyum hedefi kullanıldı ve seçilen yumuşak eşikleme kuvveti 18 olarak belirlendi. Modüller, imzalı komşuluk ve imzalı topolojik örtüşme matrisi, Pearson korelasyonu, 30'luk minimum modül boyutu, 0,25'lik birleştirme kesim yüksekliği, 1 × 10⁻⁶ yeniden atama eşiği, pamRespectsDendro = FALSE ve 10.000'lik maksimum blok boyutu kullanılarak blockwiseModules ile tanımlandı.
Modül eigengenleri ikili bir DFU özelliği ile korele edildi. |r| > 0,5 ve p < 0,05 olan gri olmayan modüller DFU ile ilişkili olarak kabul edildi. İlişkili her modül için gen anlamlılığı (GS), gen ekspresyonu ile DFU durumu arasındaki Pearson korelasyonu; modül üyeliği (MM) ise gen ekspresyonu ile ilgili modül eigengeni arasındaki Pearson korelasyonu olarak tanımlandı. Hub genler, |MM| > 0,8 ve |GS| > 0,5 kriterlerine göre belirlendi. DFU ile en güçlü pozitif ilişkiyi gösteren mavi modül seçilerek analizlere devam edildi. Bu modülün hub genleri, DEG'ler ve DPN ile ilgili gen seti ile kesiştirildi. Bu nedenle bildirilen hub eşiği, korelasyon işaretine bakılmaksızın hem MM hem de GS'nin mutlak değerlerini kullanmaktadır.
Makine öğrenimi tabanlı özellik önceliklendirme
DEG, mavi modül merkez gen ve DPN ile ilişkili gen setleri tarafından paylaşılan 77 gen GSE199939'da değerlendirildi. Yinelenen gen sembolleri, ortalama ekspresyonları ile birleştirildi. Maksimum değer 50'yi aştığında aday gen matrisi log2 dönüşümüne tabi tutuldu, sıfır varyanslı özellikler kaldırıldı ve elde kalan özellikler standardize edildi. Rastgele tohum olarak 123 kullanıldı. Uygulanan sıralama; kohort genelinde aday taraması, yinelenen sembollerin birleştirilmesi, koşullu log dönüşümü, sıfır varyans filtrelemesi, tam kohort merkezleme ve ölçeklendirme ile algoritmaya özgü özellik seçimi şeklinde gerçekleştirildi. DEG ve WGCNA taramaları, algoritma düzeyinde çapraz doğrulamadan önce tüm keşif kohortu üzerinde kullanıldı. Bu nedenle, rapor edilen iş akışı sızıntısız iç içe geçmiş bir doğrulama sağlamamaktadır ve iç AUC değerleri, kestirim performansının tarafsız tahminleri olarak kullanılamaz.
Üç özellik seçme prosedürü uygulanmıştır. İlk olarak, glmnet (versiyon 5.0) kullanılarak; binomial family, alpha = 1, çapraz doğrulama ölçütü olarak sınıflandırma hatası, ek standardizasyon olmaksızın ve küçük sınıf boyutuyla sınırlandırılmış beş katlı çapraz doğrulama ile en küçük mutlak büzülme ve seçme operatörü (LASSO) lojistik regresyonu uygulanmıştır. lambda.1se değerindeki özellikler seçilmiştir; lambda.min ise yalnızca lambda.1se hiçbir gen seçmediği takdirde kullanılmıştır. İkinci olarak, randomForest (versiyon 4.7-1.2) kullanılarak 1.000 ağaçlı bir rastgele orman (random forest) modeli kurulmuştur; ortalama Gini azalması, aday genler arasındaki ortalama önem derecesi kadar veya daha yüksek olan genler tutulmuştur. Üçüncü olarak, e1071 (versiyon 1.7-17) ile doğrusal destek vektör makinesi özyinelemeli özellik eleme (SVM-RFE) uygulanmış; özellikler, birini dışarıda bırakarak çapraz doğrulama (LOOCV) AUC ile giderek küçülen özellik alt kümeleri değerlendirilmeden önce, tüm kohort üzerindeki doğrusal ağırlığın karesine göre sıralanmıştır. Sıralama, her bir eğitim katlaması içinde yeniden hesaplanmamıştır. Doğrusal SVM kurulumunda, açık bir maliyet ayarlama ızgarası olmaksızın scale = FALSE ve probability = TRUE kullanılmıştır. LASSO ceza seçimi, ayrı bir dış değerlendirme döngüsü olmaksızın kendi dahili çapraz doğrulamasını kullanmış ve rastgele orman önemi tüm kohort üzerinden hesaplanmıştır.
Her üç yöntem tarafından da seçilen herhangi bir gen bulunmamıştır; bu nedenle, en az iki yöntem tarafından desteklenen genler tutulmuştur. SVM-RFE, değerlendirilen tüm alt küme boyutlarında 1,00'lık bir AUC üretmiş ve eşitlik durumundaki en küçük alt küme seçilmiştir. Bu tam ayrım, küçük keşif kohortunda aşırı öğrenme (overfitting) ve iyimser değerlendirme konusundaki endişeleri artırdığından, SVM-RFE AUC değeri klinik performansın bir tahmini olarak yorumlanmamıştır. Dış bir kohortta herhangi bir sabitlenmiş çoklu gen modeli test edilmemiştir; dış alıcı işletim karakteristiği (ROC) analizleri, bireysel aday gen ekspresyonlarını değerlendirmiştir. Analiz betiğinin incelenmesi, ön işlemenin ve SVM özellik sıralamasının yalnızca eğitim katlamalarıyla sınırlı olmadığını doğrulamıştır. Aynı LOOCV sonuçları, dış bir değerlendirme döngüsü olmaksızın alt küme boyutunu seçmek için kullanılmıştır. Sonuç olarak, bu iş akışı bilgi sızıntısı içermektedir ve yalnızca keşifsel özellik önceliklendirmesini desteklemektedir.
Fonksiyonel zenginleştirme analizi
Altı genlik panel üzerinde Gen Ontolojisi (GO) ve Kyoto Gen ve Genom Ansiklopedisi (KEGG) aşırı temsil analizleri gerçekleştirilmiştir. Gen sembolleri, org.Hs.eg.db (versiyon 3.21.0) kullanılarak Entrez tanımlayıcılarıyla eşleştirilmiştir. GO analizi; biyolojik süreç, hücresel bileşen ve moleküler fonksiyon ontolojileri genelinde clusterProfiler (versiyon 4.16.0) ile yapılmıştır. KEGG zenginleştirme analizinde insan organizma kodu (hsa) kullanılmıştır. Anlamlı terimler, nominal p < 0.05 ve BH-düzeltilmiş p < 0.05 olarak tanımlanmıştır. Sadece altı gen dahil edildiği için zenginleştirme analizi öncelikle fonksiyonel anotasyon amacıyla kullanılmıştır. KEGG betiği, enrichKEGG(use_internal_data = TRUE) ile yerel KEGG.db anotasyonlarını kullanmıştır; anotasyon sürümü belgelenmelidir. GO ve KEGG betikleri özel bir evren (universe) sağlamadığı için, varsayılan arka planlar anotasyon veri tabanları tarafından tanımlanmıştır.
Harici toplu transkriptomik değerlendirme
Birleştirilmiş GSE68183/GSE80178 matrisi için gen sembolleri standartlaştırılmış ve yinelenen semboller, eşleşen satırlar genelindeki ortalama ekspresyon kullanılarak birleştirilmiştir. Altı aday gen, fenotip dosyası ile hizalanmıştır. Mevcut dosyalar, üst aşamadaki birleştirme ve grup etkilerini giderme (batch-correction) prosedürünü tam olarak belgelemediği için, bu veri seti sağlandığı haliyle analiz edilmiş ve dikkatle yorumlanmıştır. Sonuç olarak, sağlanan işlem kaydından ne grup etkilerinin giderildiği ne de grup sinyalinin çalışma etkilerinden bağımsız olduğu kanıtlanabilmektedir. Bu matris, kesin bir tekrardan ziyade keşifsel veri seti içi destek sağlamaktadır.
GSE134431 için altı aday gen, milyon eşleşmiş okuma başına kilobaz başına okuma (RPKM) matrisinden çıkarılmış ve log2(RPKM + 1) olarak dönüştürülmüştür. Referans grup olarak DFS, karşılaştırma grubu olarak ise DFU kullanılmıştır. DFS, ülserleşmemiş diyabetik ayak derisini temsil etmektedir. Orijinal olarak sunulan Şekil 4C ham RPKM değerlerini grafiklemişti; revize edilen panel belirtilen log2(RPKM + 1) ölçeğini kullanmaktadır. Normal yaklaşım ve süreklilik düzeltmeli iki yönlü Wilcoxon testleri ile otomatik yönlendirilmiş ROC analizleri her iki ölçekte de doğrulanmış ve dönüşüm kesinlikle monotonik olduğu için aynı p değerlerini ve AUC'leri vermiştir.
Her bir dökme validasyon veri seti içinde, gruplar arası ekspresyon farkları iki yönlü Wilcoxon sıra toplamı testleri kullanılarak test edildi ve altı gen genelinde BH düzeltmesi uygulandı. ROC eğrileri, paket tarafından otomatik olarak seçilen yön kullanılarak pROC (versiyon 1.19.0.1) ile hesaplandı. Veri setleri genelindeki ayırıcı modelleri karşılaştırmak için AUC değerleri ve bunlara karşılık gelen %95 güven aralıkları (GAs) hesaplandı. Her bir değerlendirme veri setinden ROC yönünün otomatik olarak seçilmesi iyimser bir ayırım sağlayabilir; bu tek genli AUC değerleri tanımlayıcıdır ve önceden belirlenmiş bir klinik tahmin modelini valide etmez.
Tek hücre lokalizasyonu ve örnek düzeyinde analiz
Tek hücre analizi için, RNA assay'inde 22.889 gen ve 69.944 hücre içeren GSE165816'dan alınan biofsci_SingleR_annotated_MMP1_analyzed.rds isimli kayıtlı Seurat nesnesi kullanılmıştır. RNA assay'i, negatif olmayan tam sayı sayımları katmanını ve 10.000 ölçek faktörü ile LogNormalize ardından log1p dönüşümü ile oluşturulan bir veri katmanını korumuştur; ikincisi TPM değildir. Nesne, vst yöntemi (loess.span = 0.3; 20 eşit genişlikte bin) kullanılarak seçilen 2.000 değişken gen, korunan tüm genler için ölçeklendirilmiş ekspresyon (merkezleme ve ölçeklendirme etkin; scale.max = 10) ve değişken özelliklerden 42 seed değeri ile hesaplanan 50 temel bileşen içermektedir. Kaydedilen komut geçmişi, en yakın komşu inşası ve tekdüze manifold yaklaşımı ve izdüşümü (UMAP) için Harmony boyutları 1–20'yi kullanmıştır. Komşu ayarları k = 20, 50 ağaçlı Annoy ve Öklid mesafesi ile 1/15'lik bir paylaşılan en yakın komşu (SNN) budama eşiğini içermektedir. Kümeleme için çözünürlük 0.8, algoritma 1, n.start = 10, n.iter = 10 ve random.seed = 0 kullanılmıştır. UMAP, uwot uygulaması, 30 komşu, iki çıktı boyutu, kosinüs mesafe metriği, min.dist = 0.3, spread = 1, learning.rate = 1 ve 42 seed değeri kullanmıştır. Nesne bir Harmony indirgemesini korumuştur, ancak bu analiz edilmiş nesne için orijinal kalite kontrol kesme noktaları, batch kovaryantlarını içeren eksiksiz RunHarmony çağrısı ve SingleR referans ve anotasyon ayarları geri getirilememiştir. Hücre tipi etiketleri, grup etiketleri ve örnek tanımlayıcıları sırasıyla SingleR_label, Group ve orig.ident içinde saklanmıştır. On adet anotasyonlu hücre tipi korunmuştur: B hücreleri, CD8+ T hücreleri, endotel hücreler, epitelyal hücreler, fibroblastlar, hematopoetik kök hücreler, keratinositler, makrofajlar, monositler ve nöronlar.
MMP1 ekspresyonu hücre tipine göre özetlenmiştir. Normalize edilmiş MMP1 ekspresyonu sıfırdan büyük olan hücreler MMP1-pozitif olarak sınıflandırılmıştır. Örnek düzeyindeki analiz için, her bir örnek-hücre tipi kombinasyonu için ortalama normalize ekspresyon hesaplanmıştır. DFU ve kontrol örnekleri, her bir hücre tipi içinde çift taraflı Wilcoxon sıra toplamı testleri ve ardından tüm test edilen hücre tipleri genelinde BH düzeltmesi kullanılarak karşılaştırılmıştır. Bildirilen bu karşılaştırmalarda kullanılan birim, bireysel hücre yerine GEO örnek erişim numarasıdır. 24 erişim numarası, 24 bağımsız donörün kanıtı olarak değerlendirilmemiştir. Kaydedilen nesne doğrulanmış bir donör kimliği içermiyordu ve donörler içindeki tekrarlanan doku örneklemesi modellenmedi; bu nedenle örnek düzeyindeki testler keşifsel olarak yorumlanmıştır. Bu özetler, örnek ve hücre tipi içindeki normalize ekspresyonun ortalamasını almaktadır; bunlar sayım-toplamlı pseudobulk diferansiyel ekspresyon modelleri değildir.
On fonksiyonel gen seti Seurat AddModuleScore ile skorlandı. Hücre başına MMP1 ekspresyonu ile modül skorları arasındaki Spearman korelasyonları hesaplandı ve BH ile düzeltildi. Keşif amaçlı MMP1-yüksek analizi için, en az 50 hücre içeren hücre tipleri arasından ortalama MMP1 ekspresyonu en yüksek olan üç hücre tipi seçildi. 10'dan fazla pozitif hücre mevcut olduğunda, küresel eşik değeri MMP1-pozitif hücreler arasındaki medyan ekspresyon olarak tanımlandı; aksi takdirde betik, genel 75. persentili kullandı. Bu eşiğin üzerindeki hücreler MMP1-yüksek grubuna, geri kalan hücreler ise MMP1-düşük grubuna atandı. FindMarkers fonksiyonu için Wilcoxon testi, logfc.threshold = 0.25 ve min.pct = 0.1 değerleri kullanıldı. Düzeltilmiş p < 0.05 olan yukarı regüle genler, GO biyolojik süreç zenginleştirme analizine tabi tutuldu. Gruplar MMP1 ekspresyonuna göre tanımlandığı için, bu analiz MMP1-yüksek durumuyla ilişkili yolakları tanımlamak için kullanıldı. Örnek içi bağımlılık modellenmediği için hücre başına korelasyonlar, bunların düzeltilmiş p değerleri ve MMP1-yüksek ile MMP1-düşük karşılaştırmalı zenginleştirmeler betimleyici niteliktedir. Bireysel hücreler bağımsız biyolojik tekrarlar olarak yorumlanmamıştır.
Geleneksel Çin Tıbbı (TCM) bileşen-hedef-bitki tahmini
Önceliklendirilen altı gen, yerel Karşılaştırmalı Toksikogenomik Veritabanı (CTD) kimyasal-gen etkileşim tablosunun 4. sütunu ile eşleştirildi. Kayıtlar, 7. sütundaki Homo sapiens ile sınırlandırıldı. Eşleştirme için içerik isimleri kırpıldı ve küçük harfe dönüştürüldü; yinelenen içerik-hedef ve bitki-içerik eşleşmeleri kaldırıldı. İçerikler, bitki-içerik referans tablosu kullanılarak bitkilerle ilişkilendirildi. Veritabanı zenginleştirme işleminde nominal p < 0.05 ve düzeltilmiş p < 0.05 değerleri kullanıldı. Kapsama dayalı özetleme öncesinde yinelenen bitki-içerik-hedef kayıtları kaldırıldı. Bitki zenginleştirmesinde, nominal ve BH-düzeltmeli anlamlılık eşikleri uygulanmadan önce, bitki-içerik eşleşmesi TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 ve qvalueCutoff = 1 olacak şekilde clusterProfiler::enricher kullanıldı. Bu veritabanı bağlantıları, ekspresyon veya aktivitedeki değişiklikleri tanımlayabilir ve doğrudan bağlanmayı veya tek yönlü bir etkiyi kanıtlamaz.
Bitkiler, aşağıdaki kapsama puanı kullanılarak sıralanmıştır:
S = 3R + 5L +2T + 3C + 2I + N (1)
Burada, R MMP1 kayıt sayısı, L MMP1 ile bağlantılı bileşen sayısı, T kapsanan hedef sayısı, C çekirdek bileşen sayısı, I matris eksen göstergesi ve N toplam bileşen sayısıdır.
Temel bileşenler quercetin, luteolin ve berberine idi. Matris-eksen göstergesi, bir bitki hem MMP1 hem de MMP13'ü kapsadığında 1'e, aksi takdirde 0'a ayarlandı. Aday bitkilerin, en az bir MMP1 ile ilişkili kayıt ve beraberinde ya en az iki MMP1 ile ilişkili bileşen ya da en az dört hedef artı bir temel bileşen içermesi gerekiyordu. Puan, veri tabanı kapsamını özetlemek için kullanıldı ve farmakolojik bir etkinlik ölçütü olarak değerlendirilmedi. Katsayılar; MMP1 ile ilişkili kayıt ve bileşenleri, daha geniş hedef kapsamını, belirlenen üç bileşeni ve ortak MMP1/MMP13 kapsamını vurgulayan özel, sezgisel bir kapsam kuralını tanımlamaktadır. Bu katsayılar klinik sonuçlara göre uydurulmamış veya deneysel olarak doğrulanmamıştır ve alternatif ağırlıklandırmalar bitki sıralamalarını değiştirebilir.
Hasta doku toplama ve ön qPCR ve western blot değerlendirmesi
Wuhan Dördüncü Hastanesi'nde klinik olarak endike debridman veya cerrahi işlem uygulanmış, klinik olarak tanı konulmuş diyabetik ayak ülserli hastalar, ayak dokusu mevcut olduğunda ve yazılı bilgilendirilmiş onam alındığında çalışmaya uygun kabul edilmiştir. Dışlama kriterleri; örnekleme bölgesinde malignite, ülserin diyabet dışı bir nedene bağlı olması veya planlanan analizler için doku miktarının veya kalitesinin yetersiz olmasıydı. DFU dokusu ve yaranın çevresindeki ülserleşmemiş doku, onaylanmış çalışma protokolü kapsamında aynı hastadan alınmıştır. İkincisi, eşleştirilmiş bir yara çevresi karşılaştırıcısı olarak hizmet etmiştir; bu doku, sağlıklı diyabetik olmayan deri değildi. qPCR değerlendirmesi dört eşleştirilmiş çiftten (dört DFU örneği ve dört karşılık gelen yara çevresi örneği), western blotting ise üç eşleştirilmiş çiftten oluşmuştur. Eşleştirme, her analiz için yazarlar tarafından onaylanmıştır; analizler arası kimlik, istatistiksel karşılaştırmalarda kullanılmamıştır. Her bir hasta biyolojik birim olarak kabul edilmiş ve teknik PCR kuyucukları, bir örnek içindeki tekrarlanan ölçümler olarak değerlendirilmiştir. Bu ön analizler, MMP1'in doku düzeyindeki ekspresyonunu değerlendirmeyi amaçlamıştır; tanısal performans, nedensellik veya DFU fenotipleri genelinde genellenebilirlik oluşturmak için tasarlanmamıştır.
qPCR doğrulaması için, hasta kaynaklı doku örneklerinden toplam RNA, üretici talimatlarına uygun olarak bir toplam RNA ekstraksiyon reaktifi kullanılarak ekstre edilmiştir. RNA konsantrasyonu ve saflığı spektrofotometrik olarak değerlendirilmiş ve A260/A280 oranı 1,8–2,1 olan örnekler sonraki analizler için kullanılmıştır. Toplam RNA (1 µg), 20 µL'lik nihai reaksiyon hacminde bir Moloney murine leukemia virus (M-MLV) ters transkripsiyon kiti kullanılarak ters transkribe edilmiştir. Mevcut cihaz projesi bir real-time PCR sistemi tanımlamaktadır. Kantitatif PCR, 10 µL 2x SYBR Green master mix, 0,4 µL'şer ileri ve geri primer, 2 µL tamamlayıcı DNA (cDNA) ve 7,2 µL nükleazsız su içeren 20 µL'lik bir reaksiyonda 2x SYBR Green PCR master mix kullanılarak rapor edilmiştir. Amplifikasyon programı, 95 °C'de 30 saniye süren başlangıç denatürasyonunu ve ardından 95 °C'de 5 saniye ve 60 °C'de 30 saniye süren 40 döngüyü içermiştir. Amplifikasyon özgüllüğünü doğrulamak için bir erime eğrisi analizi gerçekleştirilmiştir. MMP1 transkript bolluğu, referans gen olarak β-actin (ACTB) kullanılarak ölçülmüştür. Primer dizileri Tablo 1'de listelenmiştir. Revize edilmiş eşli analiz için, her bir örnekteki hedef başına beş teknik kuyucuk ΔCq hesaplamasından önce ortalaması alınmış ve göreceli MMP1 ekspresyonu, ülserleşmemiş yara çevresi doku grubu kalibratör olarak kullanılarak 2-ΔΔCq yöntemi ile hesaplanmıştır. Geri kazanılan örnek çiftleri, yazarlar tarafından dört hasta-eşleşmiş çift olarak onaylanan NC–DFU, NC1–DFU1, NC2–DFU2 ve NC3–DFU3'tür. Önceki qPCR grafiği yalnızca NC ve DFU'dan gelen beş teknik kuyucuk değerini kullanmıştır; revize edilmiş grafik, dört çiftin her biri için teknik kuyucuklar ortalandıktan sonra örnek düzeyinde tek bir değer göstermektedir. Eşli çıkarım, kuyucuk düzeyindeki kat değişimi değerleri yerine ΔCq = ortalama Cq(MMP1) − ortalama Cq(ACTB) formülünü kullanmıştır. Arşivlenmiş cihaz projesi ayrıca rapor edilen reaksiyon hacmi ve döngü programından farklıdır ve grafiğe dökülen deneyle olan uyumu henüz çözülememiştir.
Western blot (WB) doğrulaması için doku örnekleri, proteaz inhibitörleri ile desteklenmiş buz gibi soğuk radyoimmünopresipitasyon deneyi tamponunda homojenize edildi. Lizatlar buz üzerinde 30 dk inkübe edildi ve 4 °C'de 12,000 x g hızda 15 dk santrifüj edildi. Süpernatantlar toplandı ve protein konsantrasyonları bisinkonininik asit deneyi kullanılarak belirlendi. Eşit miktardaki proteinler (hat başına 20 µg), %4–20 gradyan sodyum dodesil sülfat-poliakrilamid jellerde ayrıştırıldı ve 0,22 µm poliviniliden diflorür membranlara aktarıldı. Membranlar, %0,1 Tween-20 içeren Tris-tamponlu salin ile hazırlanmış %5 yağsız süt ile oda sıcaklığında 1 saat bloke edildi ve MMP1 poliklonal antikoru (1:1.000) ile kofilin poliklonal antikoru (1:6.000) ile 4 °C'de gece boyunca inkübe edildi. %0,1 Tween-20 içeren Tris-tamponlu salin ile üç kez yıkandıktan sonra membranlar, horseradish peroksidaz-konjuge keçi anti-tavşan immünoglobulin G (IgG) (1:5.000) ile oda sıcaklığında 1 saat inkübe edildi. Protein bantları, geliştirilmiş kemilüminesan substrat kullanılarak görselleştirildi ve görüntü metadata'sında kayıtlı olduğu üzere ilgili işletim yazılımı (versiyon 1.2.0) kullanılarak bir kemilüminesans görüntüleme sistemi ile görüntülendi. Bantlar ImageJ yazılımı kullanılarak nicelendirildi. Yükleme kontrolü olarak kofilin kullanıldı ve gruplar arası karşılaştırma için MMP1 protein bolluğu kofiline göre normalize edildi.
İstatistiki analiz ve yazılım
Aksi belirtilmedikçe tüm testler iki yönlü olarak yapılmıştır. Birincil çoklu test eşiği olarak BH-düzeltmeli p < 0.05 kullanılmıştır. Kesin örneklem büyüklükleri veri kümesine göre ve tek hücreli örnek düzeyindeki analiz için her örnekteki belirli bir hücre tipinin varlığına göre değişiklik göstermiştir. Sürekli ekspresyon özetleri, medyanı ve çeyrekler arası aralığı gösteren kutu grafikleriyle birlikte tekil gözlemler olarak sunulmuştur; bıyıklar, çeyrekler arası aralığın 1,5 katına kadar uzanmaktadır. Western blotting için, geri kazanılan altı MMP1/kofilin oranı, yazarlar tarafından onaylanmış üç hasta çifti üzerinde iki yönlü eşleştirilmiş t-testi kullanılarak analiz edilmiştir (df = 2; p = 0.0107). qPCR için, ΔCq hesaplamasından önce her örnek içindeki beş ACTB ve beş MMP1 Cq değerinin ortalaması ayrı ayrı alınmıştır. DFU ve eşleştirilmiş yara çevresi ΔCq değerleri, yazarlar tarafından onaylanmış dört hasta çifti üzerinden iki yönlü eşleştirilmiş t-testi ile karşılaştırılmıştır (df = 3; p = 3.04 × 10⁻⁵). Ortalama yara çevresi ΔCq, bağıl ekspresyon gösterimi için ortak kalibratör olarak kullanılmıştır. Hasta içi geometrik ortalama kat değişimi ve %95 GA, ortalama eşleştirilmiş ΔCq farkının ve buna bağlı t tabanlı GA'nın ters dönüştürülmesiyle elde edilmiştir. Bireysel biyolojik gözlemler, eşleştirilmiş dokuları birleştiren çizgilerle gösterilmiştir; teknik kuyucuklar biyolojik örneklem büyüklüğünü artırmamaktadır. Doku-deney p değerleri nominal ve keşifseldir. Üç veya dört hasta ile eşleştirilmiş farkların normalliği güvenilir bir şekilde değerlendirilemez ve analizler ön çalışma niteliğindedir. Biyoenformatik analizler ve şekil oluşturma işlemleri, Windows 11 üzerinde R 4.5.2 kullanılarak gerçekleştirilmiştir. Temel paket versiyonları arasında DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 ve ggplot2 4.0.3 yer almaktadır. Birleştirilmiş yazılım, veri tabanı ve parametre envanteri Ek Tablo 1'de sunulmuştur.
Sonuçlar
Keşif transkriptomiği, DFU ile ilişkili geniş bir ekspresyon programını tanımlar
Keşif kohortu olarak kullanılan GSE199939, 10 DFU ve 11 kontrol örneği içeriyordu (Şekil 1A). VST-normalize edilmiş ekspresyonun temel bileşen analizi, grupların net bir şekilde ayrıldığını göstermiştir; temel bileşen 1 ve 2, toplam varyansın sırasıyla %34,8'ini ve %15,1'ini açıklamıştır (Şekil 1B).
|log2 kat değişimi| > 1 ve BH-düzeltilmiş p < 0,05 kriterleri kullanılarak yapılan diferansiyel ekspresyon analizi, DFU'da yukarı regüle olmuş 1.247 gen ve DFU'da aşağı regüle olmuş 2.444 gen dahil olmak üzere toplam 3.691 DEG saptamıştır (Şekil 1C). En üstteki 50 DEG, güçlü bir grup yapılı ekspresyon paterni oluşturmuştur (Şekil 1D). Sonrasında seçilen altı gen arasında, MMP1 keşif kohortunda en büyük değişimi göstermiştir (log2 kat değişimi = 9,854; düzeltilmiş p = 1,24 × 10⁻²⁹).
DFU ile ilişkili bir ko-ekspresyon modülü, DEG'ler ve DPN ile ilişkili genlerle örtüşmektedir
WGCNA, en değişken 5.000 VST-transforme edilmiş gen üzerinde gerçekleştirilmiştir. Ölçeksiz topoloji uyumu ve bağlantısallığı dengelemek amacıyla, imzalı ağ için 18'lik bir yumuşak eşikleme gücü seçilmiştir (Şekil 2A). Hiyerarşik kümeleme ve dinamik modül tespiti, birden fazla ko-ekspresyon modülü belirlemiştir (Şekil 2B). Mavi modül, DFU ile en güçlü pozitif ilişkiye sahipti (Pearson r = 0.97, p = 5 × 10-13; Şekil 2C). İlgili örnek kümeleme ve modül boyutu kalite kontrol özetleri Ek Şekil 1A,B'de sunulmuştur.
Mavi modül içerisinde, 689 gen |MM| > 0.8 ve |GS| > 0.5 hub kriterlerini karşılamıştır (Şekil 2D). 3.691 DEG, 689 mavi modül hub geni ve 1.062 DPN ile ilişkili genin kesişimi, 77 ortak aday gen sağlamıştır (Şekil 2E). Mavi modül hub ağının seyreltilmiş bir görünümü ve en yüksek sıralamaya sahip hub istatistikleri Ek Şekil 2A,B'de gösterilmektedir.
Çok yöntemli özellik seçimi altı geni önceliklendirir ancak keşif kohortu aşırı öğrenmesi (overfitting) gösterir
Kesişen 77 gen; LASSO, rastgele orman ve SVM-RFE yöntemleri ile analiz edildi. LASSO, seçilen ceza değerinde yedi geni tuttu: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 ve CHEK1 (Şekil 3A). Rastgele orman filtrelemesi, önem düzeyi ortalama veya üzerinde olan 41 geni tuttu ve final panelinin beş üyesi en yüksek sıralamalı özellikler arasında yer aldı (Şekil 3B). SVM-RFE, değerlendirilen her iç içe geçmiş alt küme için 1,00'lık bir AUC değeri üretti; minimum boyut eşitlik kuralı uyarınca, tek genli alt küme olarak CHEK1 seçildi (Şekil 3C), bu durum keşif kohortunda aşırı uyum ve iyimser değerlendirme konusundaki endişeleri artırmıştır. İlgili keşif kohortu ekspresyon, ısı haritası ve ROC gösterimleri Ek Şekil 3A–C'de gösterilmiştir.
Her üç yöntem tarafından da seçilen herhangi bir gen bulunmadı. En az iki yöntem tarafından desteklenen genlerin tutulması sonucunda CCL7, CHEK1, MKI67, MMP1, MMP13 ve TRPV2 belirlendi (Şekil 3D). Bu altı genin GO anotasyonu; hücre dışı matris bozunumu, kolajen katabolik ve metabolik süreçleri, yoğunlaşmış kromozom ve metalloendopeptidaz ile ilişkili fonksiyonları ön plana çıkardı (tüm BH-düzeltilmiş p < 0.05; Şekil 3E). KEGG analizi, interlökin-17 (IL-17) sinyalleme yolunu (CCL7/MMP1/MMP13; düzeltilmiş p = 1.81 × 10⁻⁴) ve relaksin sinyalleme yolunu (MMP1/MMP13; düzeltilmiş p = 0.0175; Şekil 3F) tanımladı. Bu zenginleştirme sonuçları, altı genlik panel tarafından temsil edilen biyolojik fonksiyonları karakterize etmek için kullanıldı.
Veri kümeleri arası değerlendirme, MMP1 için heterojen bir destek olduğunu göstermektedir
Birleştirilmiş GSE68183/GSE80178 matrisinde (9 DFU ve 6 kontrol), altı gen üzerinden BH düzeltmesi yapıldıktan sonra CCL7, MMP1 ve MMP13 gruplar arasında farklılık gösterdi (düzeltilmiş p sırasıyla 0,0168, 0,0159 ve 0,0431; Şekil 4A). CHEK1, MKI67 ve TRPV2 düzeltilmiş anlamlılık eşiğine ulaşmadı (düzeltilmiş p = 0,259, 0,680 ve 0,259). Tek gen ROC analizi sonucunda AUC değerleri CCL7 için 0,944 (%95 GA, 0,825–1,000), CHEK1 için 0,704 (0,403–1,000), MKI67 için 0,574 (0,243–0,905), MMP1 için 0,981 (0,930–1,000), MMP13 için 0,870 (0,686–1,000) ve TRPV2 için 0,722 (0,447–0,997) olarak belirlendi (Şekil 4B). Üst aşamadaki birleştirme ve seri düzeltme prosedürü tam olarak belgelenmediği için bu ROC değerleri keşifsel olarak değerlendirildi.
GSE134431'de (13 DFU ve 8 ülserleşmemiş DFS örneği), nominal anlamlılık düzeyindeki Wilcoxon testine göre MMP1 ekspresyonu DFU'da DFS'den daha yüksek çıkmış olsa da (p = 0.0225), bu ilişki BH düzeltmesi sonrası anlamlılığını korumamıştır (düzeltilmiş p = 0.135; Şekil 4C). Diğer beş gen, gruplar arasında anlamlı bir fark göstermemiştir. MMP1 ayrıca 0,808'lik bir AUC ( %95 GA, 0,589–1,000) değeri ile en yüksek tanımlayıcı AUC'yi sergilemiş, diğer adayların AUC değerleri ise 0,529 ile 0,635 arasında değişmiştir (Şekil 4D). Genel olarak, altı aday arasında MMP1 en tutarlı tanımlayıcı paterni göstermiş, ancak istatistiksel tekrarlanabilirlik eksik kalmıştır.
Tek hücreli analiz, MMP1 'in ağırlıklı olarak fibroblastlarda lokalize olduğunu göstermektedir
Tek hücreli veri seti, 24 örnekten (14 DFU ve 10 kontrol) alınan 69.944 hücreyi içermekteydi ve 10 adet açıklanmış hücre tipinden oluşuyordu (Şekil 5A). UMAP özellik görselleştirmesi, MMP1 ekspresyonunun atlas genelinde tekdüze bir dağılım göstermek yerine, sınırlı hücresel bölgelerde lokalize olduğunu ortaya koymuştur (Şekil 5B). Genel olarak, 3.799 hücrenin (%5,43) normalize edilmiş MMP1 ekspresyonu sıfırdan büyüktü. Fibroblastlar en yüksek ortalama normalize ekspresyona (0,181) ve en büyük genel MMP1-pozitif fraksiyona (%7,88; Şekil 5C) sahipti.
Örnek düzeyinde, ortalama MMP1 ekspresyonu keratinositlerde, fibroblastlarda ve endotel hücrelerde DFU örneklerinde kontrol örneklerine göre daha yüksekti. Test edilen tüm hücre tipleri genelinde BH düzeltmesi yapıldıktan sonra, bu karşılaştırmaların her birinin düzeltilmiş p değeri 0,0214 idi (keratinositler: 9 kontrol ve 14 DFU örneği; fibroblastlar: 10 ve 14; endotel hücreler: 10 ve 14; Şekil 5D). MMP1-pozitif fraksiyonu fibroblastlarda %5,86'dan %9,29'a, keratinositlerde %0,026'dan %6,68'e ve endotel hücrelerde %0,29'dan %2,67'ye yükselmiştir (Şekil 5E).
Hücre başına modül puanı korelasyonları düşük düzeydeydi. En yüksek pozitif korelasyon, senesans/senesansla ilişkili sekresyon fenomeni (SASP) modül puanı için gözlemlenmiş (Spearman rho = 0.274), bunu hücre dışı matris yeniden şekillenmesi (rho = 0.240), ferroptozis (rho = 0.197) ve fibroblast aktivasyonu (rho = 0.170; Şekil 5F) takip etmiştir. MMP1-yüksek ve MMP1-düşük fibroblastların karşılaştırılması; hücre dışı matris organizasyonu, hücre dışı yapı organizasyonu, kolajen fibril organizasyonu, glikoprotein işlenmesi ve protein katlanması terimlerinde zenginleşme olduğunu göstermiştir (Şekil 5G). Bu tanımlayıcı bulgular, MMP1-yüksek fibroblast durumunu matris yeniden şekillenmesiyle ilgili süreçlerle ilişkilendirmiştir. Ek grup düzeyindeki UMAP, tüm hücre tipi örnek özetleri ve fonksiyonel puan bağlamı Ek Şekil 4A–C'de sunulmuştur. Tekil hücre ilişkileri, donörden bağımsız kanıtlar olarak değerlendirilmemiştir.
Ağ kapsamı, MMP1 ile bağlantılı bileşenlere ve aday bitkilere öncelik verir
Filtrelenmiş bitki-bileşen-hedef ilişkisi tablosu, 99 bitkiyi, 14 bileşeni ve altı aday hedeften beşini birbirine bağlayan 561 benzersiz kayıt içeriyordu. 156 kayıtla en sık rastlanan hedef MMP1 idi; bunu sırasıyla CHEK1 (120), MMP13 (102), MKI67 (100) ve TRPV2 (83; Şekil 6A) izledi. Bileşenler arasında quercetin ve luteolin en geniş bitki kapsamına sahipti ve sırasıyla 83 ve 62 bitkiyle ilişkilendirilmişti. Berberine 10 bitkiyle ilişkilendirilmişti; bu üç bileşen, önceliklendirme kuralında temel bileşenler olarak kullanıldı (Şekil 6B).
Kapsama puanı Guanhuangbo, Mahuang ve Niuxi'yi ortaklaşa en yüksek sıraya yerleştirmiştir (puan = her biri 38; Şekil 6C). Her biri mevcut beş hedefin tamamını kapsamakta ve iki MMP1 bağlantılı bileşen içermektedir. Bileşen-hedef matrisi, quercetin'in hedef paneli genelinde en geniş kapsamı sağladığını, luteolin ve berberine'in ise ek MMP1 merkezli bağlantı sunduğunu göstermiştir (Şekil 6D). Odaklanmış bir ağ, önde gelen bitkileri temsili bileşenlere ve mevcut beş hedefe bağlamıştır (Şekil 6E). Bu sonuçlar, daha ileri değerlendirmeler için yüksek veritabanı kapsamına sahip bitki-bileşen-hedef kombinasyonlarını belirlemiştir. Destekleyici bitki-hedef ve çekirdek-bileşen kapsam matrisleri Ek Şekil 5A,B'de gösterilmektedir.
Ön hazırlık aşamasındaki eşleştirilmiş doku analizleri, daha yüksek MMP1 mRNA ve protein bolluğu göstermektedir
Western blot değerlendirmesi, DFU örneklerinde MMP1 bolluğunun eşleşen ülserleşmemiş yara çevresi örneklerine göre daha yüksek olduğunu göstermiştir (Şekil 7A,B). Üç eşleşmiş çiftte, MMP1/kofilin oranındaki ortalama DFU-eksi-yaraçevresi farkı 0.3553 olarak bulunmuştur (95% CI, 0.1959–0.5147; çift yönlü eşleştirilmiş t-testi, t(2) = 9.592, p = 0.0107). Her bir hastanın eşleştirilmiş ölçümleri Şekil 7B'de gösterilmiştir. Örnek başına gen başına beş teknik kuyucuğun ortalaması alındıktan sonra, qPCR, dört DFU örneğinin her birinde normalize edilmiş MMP1 mRNA bolluğunun eşleşen yara çevresi örneğine göre daha yüksek olduğunu göstermiştir (Şekil 7C). Hasta içi ortalama DFU-eksi-yaraçevresi ΔCq farkı −2.6035 idi (95% CI, −2.8024 ile −2.4046 arası; çift yönlü eşleştirilmiş t-testi, t(3) = −41.663, p = 3.04 × 10⁻⁵), bu da geometrik ortalamada 6.08 katlık bir artışa (95% CI, 5.30–6.98) karşılık gelmektedir. Bu küçük örneklem gözlemleri öncül niteliktedir ve fonksiyonel bir etki kanıtlamamaktadır.
Keşif ve harici toplu veri setleri genelinde, MMP1 istatistiksel tekrarlanabilirlik tam olmasa da, önceliklendirilen altı gen arasında en tutarlı tanımlayıcı örüntüyü sergilemiştir. Tek hücre özetleri, fibroblastlarda en yüksek ortalama ekspresyonu göstermiş; üç hastadan alınan eşleşmiş WB ölçümleri ve dört hastadan alınan eşleşmiş qPCR ölçümleri ise daha yüksek MMP1 bolluğu ortaya koymuştur. Bu gözlemler, MMP1'in daha ileri araştırmalar için DFU ile ilişkili bir aday olduğu görüşünü desteklemektedir. Genel hesaplamalı-doku değerlendirme iş akışı şurada özetlenmiştir: Ek Şekil 6.
VERİ KULLANILABİLİRLİĞİ:
Kamuya açık transkriptomik veri setleri, GSE199939, GSE68183, GSE80178, GSE134431 ve GSE165816 erişim numaralarıyla NCBI Gene Expression Omnibus üzerinden temin edilebilir. Mevcut analiz ve şekil oluşturma betikleri, işlenmiş ekspresyon ve sonuç tabloları, kantitatif şekil kaynak tabloları, istatistiksel çıktı tabloları, orijinal qPCR çalışma kitabı ve cihaz projesi ile sağlanan kırpılmamış western blot görüntüleri Ek Dosya 1 içerisinde yer almaktadır. Arşiv ayrıca, kurtarılan tek hücre nesnesinden elde edilen hücre meta verilerini ve komut geçmişini, matris tipi doğrulama raporlarını ve bir dosya manifestosunu içermektedir. Ek Dosya 1, tarihsel kaynak dosyalarını muhafaza eder ve revize edilmiş eşleşmiş analiz kaynak tablolarını, istatistiksel çıktıları, şekil oluşturma kodlarını ve düzeltilmiş parametre envanterini içeren bir R2_Updates klasörünü kapsar. Tam analiz edilmiş Seurat RDS, arşiv dokümantasyonunda belirtilmiştir ancak bu ek ZIP dosyasının içine gömülmemiştir. Toplu birleştirme geçmişinin tamamı, orijinal tek hücre filtreleme ve anotasyon ayarları ile orijinal blot arka plan çıkarma ve şeritten kantifikasyona kadar olan detaylar tamamen mevcut değildir; bu kısıtlamalar protokol ve tartışma bölümlerinde açıklanmıştır. Yerel olarak kurtarılan RDS, kamuya açık bir veri deposuna gönderilmemiştir.
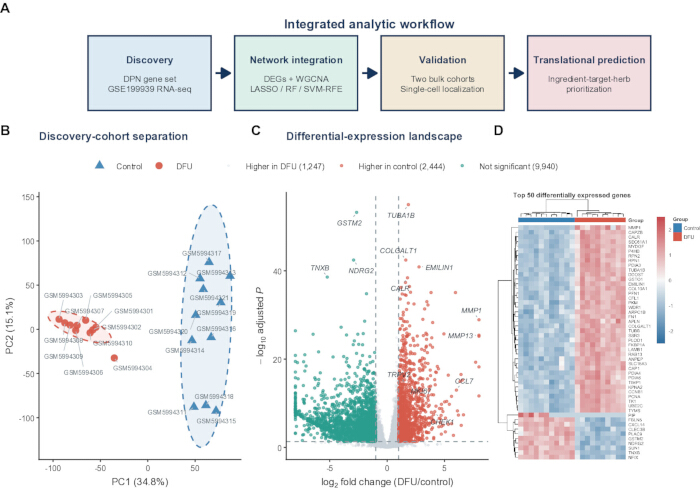
Şekil 1: Keşif transkriptomiği, DFU ile ilişkili bir ekspresyon programı tanımlar. (A) DPN gen seti oluşturma ve GSE199939 keşif analizi, ağ ve makine öğrenimi entegrasyonu, bulk ve tek hücreli değerlendirme ile TCM bileşen-hedef-bitki tahminini içeren hesaplama iş akışının genel görünümü. (B) 10 DFU ve 11 kontrol örneğinden alınan varyans stabilize edilmiş GSE199939 ekspresyon profillerinin temel bileşen analizi. Elipsler %90 grup bölgelerini göstermekte; yüzdeler her bir bileşen tarafından açıklanan varyansı belirtmektedir. (C) DFU ile kontrolün karşılaştırıldığı DESeq2 diferansiyel ekspresyon sonuçlarının yanardağ grafiği. Kırmızı ve turkuaz noktalar, sırasıyla |log2 fold change| > 1 ve BH-düzeltilmiş p < 0.05 kullanılarak DFU ve kontrolde yukarı regüle edilen genleri göstermektedir; gri noktalar her iki eşik değerini de karşılamamıştır. (D) En düşük düzeltilmiş p değerlerine sahip 50 genin satır bazlı z-skoru ısı haritası. Sütunlar biyolojik örneklerdir ve açıklama çubuğu grubu belirtir. DEGs, diferansiyel eksprese edilen genler; DFU, diyabetik ayak ülseri; DPN, diyabetik periferik nöropati; VST, varyans stabilize edici transformasyon. Final deneysel değerlendirmesi protokolde ve Şekil 7'de açıklanmıştır. qPCR, kantitatif polimeraz zincir reaksiyonu; TCM, geleneksel Çin tıbbı; RF, rastgele orman; LASSO, en küçük mutlak küçültme ve seçim operatörü; SVM-RFE, destek vektör makinesi özyinelemeli özellik eliminasyonu. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayınız.
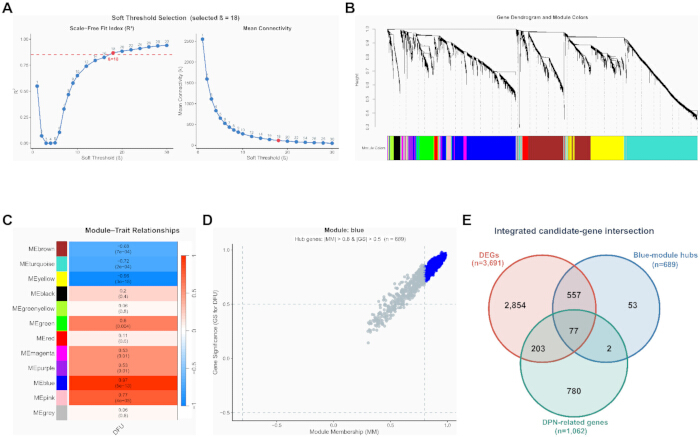
Şekil 2: WGCNA ve önceki DPN bilgileri 77 aday gen üzerinde birleşiyor. (A) En değişken 5.000 VST dönüştürülmüş gen için imzalı-ağ yumuşak eşik değerlendirmesi. Seçilen güç beta = 18'dir; kesikli çizgi 0,85'lik hedef ölçeksiz topoloji uyumunu işaret eder. (B) Dinamik modül renk atamalarıyla birlikte ortalama bağlantılı gen dendrogramı. (C) Modül özgenleri ile ikili DFU özelliği arasındaki Pearson korelasyonları. Her hücre korelasyon katsayısını ve karşılık gelen iki yönlü p değerini gösterir; renk yönü ve büyüklüğü belirtir. (D) Mavi modüldeki DFU için gen anlamlılığı ile modül üyeliği arasındaki ilişki. Mavi noktalar |modül üyeliği| > 0,8 ve |gen anlamlılığı| > 0,5 şartlarını karşılar; n = 689 hub gen. (E) 3.691 DEG, 689 mavi modül hub geni ve 1.062 DPN ile ilişkili genin üçlü küme kesişimi, 77 ortak aday verir. DFU, diyabetik ayak ülseri; DPN, diyabetik periferik nöropati; GS, gen anlamlılığı; MM, modül üyeliği; WGCNA, ağırlıklı gen ko-ekspresyon ağ analizi. Keşif kohortu 21 örnek (10 DFU ve 11 kontrol) içeriyordu. Şekil 2D açıklaması, orijinal seçim kodunda doğrulanan mutlak değer kriterine uygun olarak |MM| > 0,8 ve |GS| > 0,5 değerlerini kullanır. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
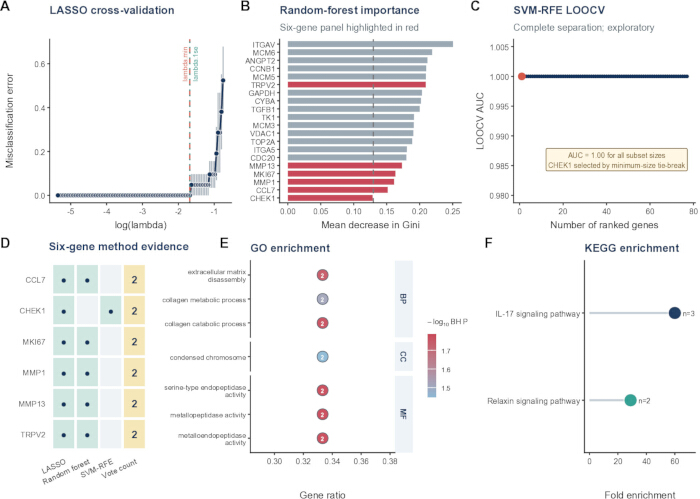
Şekil 3: Çok yöntemli özellik önceliklendirmesi altı genlik bir panel sağlar. (A) Binomial LASSO regresyonu için beş katlı çapraz doğrulama eğrisi. Dikey kesikli çizgiler lambda.min ve lambda.1se değerlerini belirtir; seçilen sıfır olmayan özellikler, bu ceza hiçbir özellik sağlamadığı sürece lambda.1se değerinde alınmıştır. (B) 1.000 ağaçlı bir modelden elde edilen, en yüksek sıralamaya sahip 20 gen için Random-forest Gini'deki ortalama azalma. Kırmızı çubuklar finaldeki altı genlik panelin üyelerini tanımlar; kesikli çizgi, tüm aday seti genelinde tutma eşiği olarak kullanılan ortalama önemi işaretler. (C) İç içe geçmiş özellik alt kümeleri genelinde Doğrusal SVM-RFE LOOCV AUC değerleri. Tüm alt küme boyutları AUC = 1.00 üretmiştir; CHEK1 minimum boyut beraberlik kuralı ile seçilmiştir, bu da keşif kohortunda aşırı öğrenmeye (overfitting) işaret eder. (D) CCL7, CHEK1, MKI67, MMP1, MMP13 ve TRPV2 için yöntem destek matrisi. Noktalar LASSO, random forest veya SVM-RFE tarafından seçimi belirtir; son sütun destekleyen yöntemlerin sayısını verir. (E) Altı gen arasında zenginleşen seçilmiş Gen Ontolojisi terimleri. Nokta konumu gen oranını, nokta etiketleri eşlenen gen sayısını, renk -log10 BH-düzeltilmiş p değerini ve yan şerit ontolojiyi gösterir. (F) Eşlenen genler arasında zenginleşen KEGG yolları. Nokta konumu kat kat zenginleşmeyi (fold enrichment), nokta boyutu etiketleri eşlenen gen sayısını gösterir ve renk yolları birbirinden ayırır. Zenginleşme için nominal p < 0.05 ve BH-düzeltilmiş p < 0.05 gereklidir. AUC, alıcı işletim karakteristik eğrisi altındaki alan; BH, Benjamini-Hochberg; BP, biyolojik süreç; CC, hücresel bileşen; KEGG, Kyoto Gen ve Genom Ansiklopedisi; LOOCV, birini dışarıda bırakarak çapraz doğrulama; MF, moleküler fonksiyon; SVM-RFE, destek vektör makinesi özyinelemeli özellik eleme. LASSO, en küçük mutlak büzülme ve seçme operatörü. A–D panelleri 21 keşif örneğini (10 DFU ve 11 kontrol) kullanmaktadır. A panelinde, hata çubukları çapraz doğrulama hatasının standart hatasını belirtir. Lütfen bu şeklin daha büyük bir versiyonunu görüntülemek için buraya tıklayın.
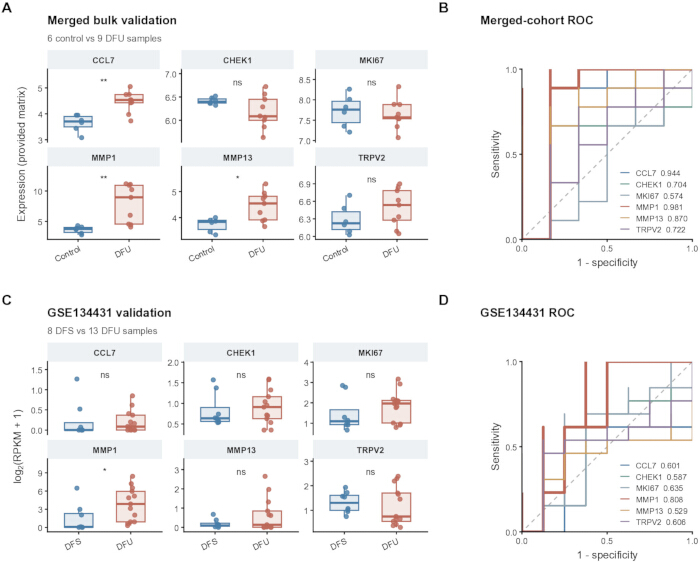
Şekil 4: Altı genli panelin veri kümeleri arası bulk-transkriptomik değerlendirmesi. (A) Birleştirilmiş GSE68183/GSE80178 matrisindeki altı genin ekspresyonu (6 kontrol ve 9 DFU örneği). (B) AUC değerleri ile ilgili tek genli ROC eğrileri; %95 güven aralıkları kaynak veri tablosunda sunulmuştur. Üst akış birleştirme ve grup etkisinin düzeltilmesi (batch correction) tam olarak belgelenmediği için, bu sonuçlar keşifsel olarak yorumlanmıştır. (C) GSE134431'deki log2(RPKM + 1) ekspresyonu (8 ülserleşmemiş DFS ve 13 DFU örneği). (D) İlgili tek genli ROC eğrileri ve AUC değerleri. (A) ve (C) bölümlerinde, kutular medyanı ve çeyrekler arası aralığı göstermekte, bıyıklar çeyrekler arası aralığın 1,5 katına kadar uzanmakta ve noktalar biyolojik örnekleri temsil etmektedir. Yıldızlar, iki yönlü Wilcoxon sıra toplamı testlerinden elde edilen nominal anlamlılığı belirtir (*p < 0.05, **p < 0.01); altı gen genelindeki BH-düzeltmeli p değerleri metinde ve kaynak veri tablosunda raporlanmıştır. ROC yönü pROC tarafından otomatik olarak seçilmiştir. AUC, alıcı işletim karakteristiği eğrisi altındaki alan; DFS, ülserleşmemiş diyabetik ayak derisi; DFU, diyabetik ayak ülseri; RPKM, milyon eşleşmiş okuma başına kilobaz başına okuma sayısı; ROC, alıcı işletim karakteristiği. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
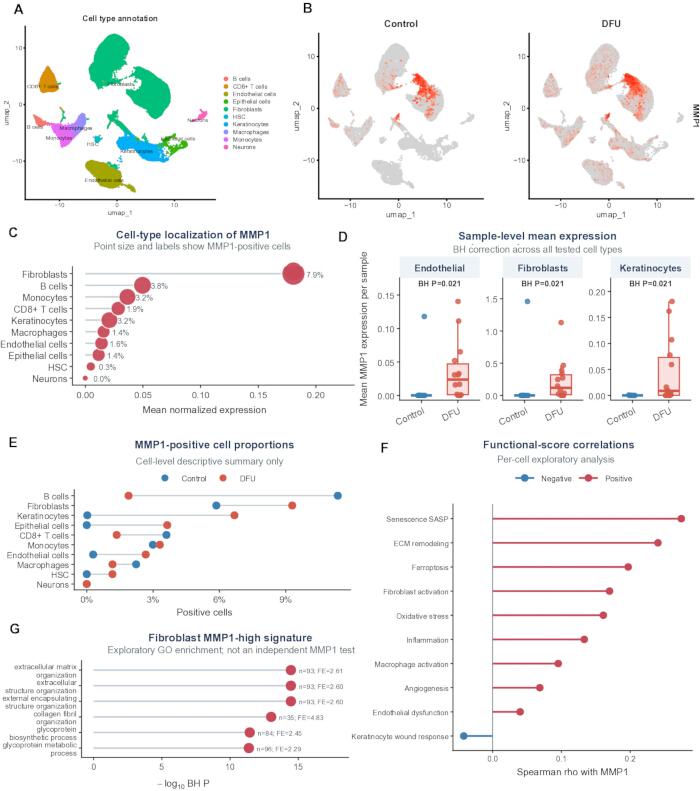
Şekil 5: Tek hücreli lokalizasyon, MMP1'i fibroblast ve matriks yeniden şekillendirme sinyalleriyle ilişkilendirir. (A) 24 örnekten (10 kontrol ve 14 DFU örneği) alınan 69.944 hücrenin, 10 SingleR kaynaklı hücre tipi anotasyonuna göre renklendirilmiş UMAP grafiği. (B) Kontrol ve DFU hücrelerinde normalize edilmiş MMP1 ekspresyonunu gösteren UMAP özellik grafikleri. (C) Ortalama normalize edilmiş MMP1 ekspresyonunun hücre tipi özeti; nokta boyutu ve etiketler, normalize ekspresyon > 0 olarak tanımlanan genel MMP1-pozitif fraksiyonu belirtir. (D) Endotelyal hücreler, fibroblastlar ve keratinositlerde örnek düzeyindeki ortalama MMP1 ekspresyonu. Kutular medyanı ve çeyrekler arası aralığı; noktalar biyolojik örnekleri göstermektedir. İki yönlü Wilcoxon sıra toplamı testleri, test edilen tüm hücre tipleri genelinde BH düzeltmesi ile takip edilmiştir. Mevcut örnek sayıları endotelyal hücreler ve fibroblastlar için 10 kontrol ve 14 DFU, keratinositler için ise 9 kontrol ve 14 DFU'dur. (E) Grup ve hücre tipine göre MMP1-pozitif hücre fraksiyonları. (F) MMP1 ekspresyonu ile fonksiyonel modül skorları arasındaki hücre başına Spearman korelasyonları. (G) MMP1-yüksek ile MMP1-düşük fibroblastlarda yukarı regüle edilen genler arasındaki GO biyolojik süreç zenginleşmesi. BH, Benjamini-Hochberg; DFU, diyabetik ayak ülseri; ECM, hücre dışı matriks; GO, Gen Ontolojisi; HSC, hematopoetik kök hücreler; UMAP, tekbiçimli manifold yaklaşık ve projeksiyonu. F ve G panellerindeki hücre başına korelasyonlar ve ekspresyon koşullu zenginleşmeler, donör farkındalığı olan doğrulayıcı çıkarımlar olmaksızın keşifsel tanımlamalardır. Örnek düzeyindeki bağımsızlık, donör tanımlayıcılarının doğrulanmasını gerektirir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
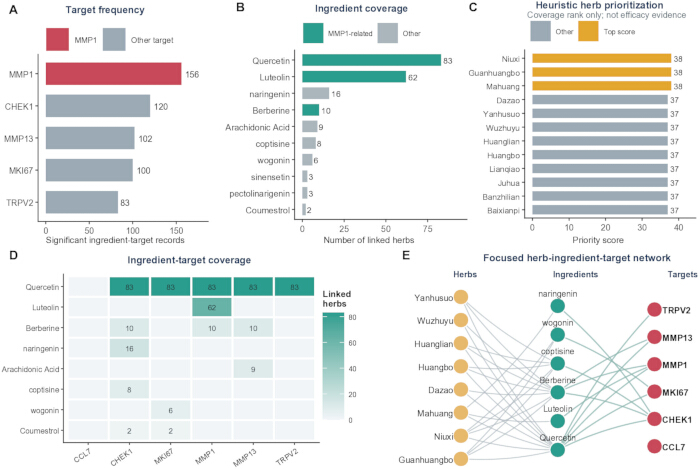
Şekil 6: MMP1 odaklı, kapsama dayalı TCM bileşen-hedef-bitki tahmini. (A) Mevcut her bir aday hedef için filtrelenmiş veritabanı bitki-bileşen-hedef kayıtlarının sayısı. (B) En sık rastlanan bileşenler için bağlantılı bitki sayısı; turkuaz renk MMP1 ile bağlantılı bileşenleri belirtir. (C) Kapsama puanına göre sıralanmış önde gelen bitkiler; altın rengi çubuklar en yüksek üç ortak puanı işaret eder. (D) Temsili yüksek kapsamlı bileşenler için bileşen-hedef matrisi. Hücre değerleri bağlantılı bitki sayısını gösterir; boş hücreler filtrelenmiş ilişki tablosunda kayıt olmadığını belirtir. (E) Temsili yüksek sıralamalı bitkileri, bileşenleri ve aday hedefleri birbirine bağlayan odaklanmış ağ. Düğüm rengi varlık tipini belirtir; gri bitki-bileşen kenarları içeriği ve turkuaz bileşen-hedef kenarları veritabanı bağlantılarını ifade eder. Filtrelenmiş ilişki tablosu 561 benzersiz kayıt, 99 bitki, 14 bileşen ve uygun bağlantıları olan beş hedef içeriyordu; CCL7 izole altıncı aday düğüm olarak görüntülenmiştir. TCM, geleneksel Çin tıbbı. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
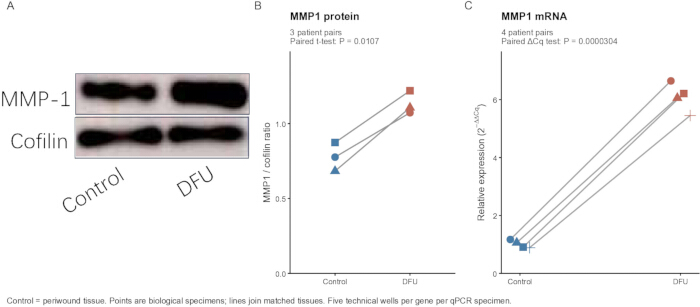
Şekil 7DFU'da MMP1 ekspresyonunun hasta dokusunda ön qPCR ve western blot değerlendirmesi. (A) Yükleme kontrolü olarak kofilin ile birlikte, ülserleşmemiş yara çevresi ve DFU dokusundaki MMP1 protein bolluğunu gösteren, daha önce sunulmuş temsilci western blot. (B) Orijinal çizim projesinden elde edilen MMP1/kofilin oranları. Semboller, üç hasta çiftinden alınan bireysel biyolojik ölçümleri göstermektedir; çizgiler, eşleştirilmiş yara çevresi ve DFU örneklerini birbirine bağlamaktadır. İki yönlü eşli Lütfen çevrilmesini istediğiniz metni sağlayın.-testi verdi t(2) = 9,592 ve p = 0.0107. (C) Göreceli MMP1 Yazar tarafından doğrulanmış dört eşleştirilmiş hasta çiftindeki mRNA bolluğu: NC–DFU, NC1–DFU1, NC2–DFU2 ve NC3–DFU3. Beş teknik ACTB kuyucuklar ve beş teknik MMP1 kuyucuklar, her bir örnek içinde ayrı ayrı ortalandıktan sonra ΔCq hesaplaması. Rölatif ekspresyon 2 yöntemine göre hesaplanmıştır.−ΔΔCq ortalama yara çevresi kullanılan yöntem ΔYaygın bir kalibratör olarak Cq. Her sembol bir biyolojik örneği temsil eder; çizgiler eşleşmiş dokuları birbirine bağlar. İki yönlü eşleştirilmiş t-testte kullanılan örnek düzeyinde ΔCq değerleri (t(3) = −41.663; p = 3.04 × 10⁻⁵), teknik kuyucuk kat değişimi değildir. Anlamlılık yıldızları kullanılmamıştır. Teknik kuyucuklar biyolojik tekrarlar değildir. Kontrol, ülserleşmemiş yara çevresi dokusunu ifade eder. Cq, kantifikasyon döngüsü. Doku-deneyi p değerler nominal ve keşifseldir. Bu şeklin daha büyük bir versiyonunu görüntülemek için lütfen buraya tıklayın.
| Gen | RefSeq erişim numarası | İleri primer 5' uçtan 3' uca | Geri primer 5' uçtan 3' uca |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tablo 1: MMP1'in kantitatif PCR doğrulaması için primer dizileri. İnsan MMP1 (NM_002421) ve ACTB (NM_001101.5) için ileri ve geri oligonükleotid dizileri (5′–3′) ve NCBI RefSeq transkript erişim numaraları verilmiştir. Rölatif MMP1 ekspresyonu için referans gen olarak ACTB (β-aktin) kullanılmıştır.
Ek Şekil 1: WGCNA kalite kontrol özetleri. (A) En değişken 5.000 varyans-stabilize edilmiş gene dayalı olarak GSE199939 örneklerinin ortalama bağlantılı hiyerarşik kümelemesi. Örnek etiketleri gruplara göre renklendirilmiştir; kesikli yatay çizgi, görsel aykırı değer değerlendirmesi için kullanılan 95. persentil dendrogram yüksekliği kılavuzudur. (B) Her bir WGCNA modülüne atanan gen sayısı. Turkuaz çubuklar DFU-ilişkisi kriterini karşılayan sekiz gri olmayan modülü; gri çubuklar diğer modülleri belirtir. DFU, diyabetik ayak ülseri; VST, varyans-stabilize edici dönüşüm; WGCNA, ağırlıklı gen ko-ekspresyon ağı analizi. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 2: Mavi modül ko-ekspresyon desteği. (A) En yüksek sıralamaya sahip 25 mavi modül hub geninin basitleştirilmiş ko-ekspresyon ağı. |r| > 0.70 olan ikili korelasyonlar arasında, gösterilen ağ her bir genin en güçlü iki bağlantısının birleşimini içerir. Düğüm boyutu, bu gösterilen seyreltilmiş ağ içindeki dereceyi, düğüm dolgusu ise DFU için gen anlamlılığını belirtir. (B) En yüksek sıralamaya sahip 15 hub için gen anlamlılığı ve mavi modül üyeliği. Kenar alt kümesi okunabilirlik için seçilmiştir ve uygun olan tüm korelasyonları temsil etmemektedir. DFU, diyabetik ayak ülseri; GS, gen anlamlılığı; MM, modül üyeliği. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Şekil 3: Dahili keşif kohortu makine öğrenimi gösterimleri. (A) GSE199939 keşif kohortunda CCL7, CHEK1, MKI67, MMP1, MMP13 ve TRPV2 genlerinin ölçeklendirilmiş ekspresyonları. Kutular medyanı ve çeyrekler arası aralığı göstermekte, noktalar ise biyolojik örnekleri temsil etmektedir. (B) Aynı altı genin örnek düzeyindeki satır-z-skoru ısı haritası. Kısa örnek etiketleri, kaynak veri anahtarındaki GEO tanımlayıcılarıyla eşleştirilmiştir. (C) Uydurulmuş çok genli keşif kohortu modelinin ROC eğrisi. 1,00'lık AUC değeri, modelin aynı 21 örnek üzerinde uydurulması ve değerlendirilmesiyle elde edilmiştir; bu durum keşif kohortunda aşırı öğrenme (overfitting) olduğunu göstermektedir. AUC, alıcı işletim karakteristik eğrisi altındaki alan; ROC, alıcı işletim karakteristiği. Keşif kohortu 21 örnek (10 DFU ve 11 kontrol) içermektedir. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 4: Tek hücreli ekspresyon bağlamı. (A) Kontrol ve DFU grubuna göre renklendirilmiş 69.944 hücrenin UMAP görüntüsü. (B) 10 hücre tipi anotasyonunun tamamında biyolojik örnek düzeyindeki ortalama MMP1 ekspresyonu; noktalar örnekleri temsil etmekte olup x-ekseni görüntüleme için karekök dönüşümü kullanmaktadır. (C) Her bir anotasyonlu hücre tipi içindeki hücreler genelinde özetlenen ve her bir modül içinde standardize edilen fonksiyonel modül skorlarının ısı haritası. DFU, diyabetik ayak ülseri; UMAP, tekdüzeli manifold yaklaşımı ve projeksiyonu. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Şekil 5: Destekleyici TCM kapsama matrisleri. (A) MMP1 ile bağlantılı kapsama özelliğine sahip en yüksek sıralamalı 18 bitki için veri tabanı bitki-hedef kayıt sayıları ve filtrelenmiş ilişki tablosunda temsil edilen beş aday hedef. (B) Aynı bitkileri temel bileşenler quercetin, luteolin ve berberine ile ilişkilendiren veri tabanı kayıt sayıları. Hücre değerleri, tekilleştirme sonrası benzersiz veri tabanı kayıtlarını belirtmektedir. TCM, geleneksel Çin tıbbı. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Şekil 6: Hesaplamalı ve doku değerlendirme iş akışı. Şema; keşif girdisini, DEG/WGCNA kesişimini, keşifsel özellik seçimini, harici bulk değerlendirmeyi, tek hücreli bağlamı, TCM genişletmesini ve eşleştirilmiş doku-ekspresyon değerlendirmesini özetlemektedir. qPCR için dört eşleştirilmiş hasta çifti ve western blotting için üç eşleştirilmiş hasta çifti kullanılmıştır. Aday sayıları ve raporlanan hesaplamalı sonuçlar orijinal analizden alınmıştır. Sayım tabanlı keşif iş akışındaki TPM girdisi, eksik orijinal tek hücreli ön işleme kayıtları ve küçük doku-analiz kohortları sınırlılıklar olarak kalmaktadır. Şema, keşif analizlerinin yeniden doğrulandığı anlamına gelmemektedir. Lütfen bu dosyayı indirmek için buraya tıklayın.
Ek Tablo 1: Analiz yazılımı, veri tabanı, parametre ve kısıtlamalar envanteri. Bu çalışma kitabı; analiz adımı, araç veya veri tabanı, bildirilen versiyon, girdi, temel parametreler, çıktı ve eksik bilgiler veya kısıtlamalarla birlikte 26 analiz adımını belgelemektedir. Keşif transkriptomiği, WGCNA, gen tarama ve özellik seçimi, zenginleştirme, harici bulk ve tek hücre analizleri, TCM ağ analizi ve doku-deney raporlamasını kapsamaktadır. Tablo, mevcut metodolojik bilgileri kaydetmekte olup tek başına bağımsız tekrarlanabilirlik sağlamaz. Bu dosyayı indirmek için lütfen buraya tıklayın.
Ek Dosya 1: Veri, analiz kodu, şekil kaynağı ve assay kaynağı arşivi. Bu arşiv; mevcut analiz ve şekil oluşturma betiklerini, işlenmiş ekspresyon ve sonuç tablolarını, kantitatif şekilleri ve istatistiksel kaynak verilerini, orijinal qPCR çalışma kitabını ve cihaz projesini, sağlanan kırpılmamış western blot görüntülerini, çıkarılmış tek hücreli meta verileri ve komut geçmişini, matris tipi doğrulama raporlarını ve bir dosya manifestosunu içerir. Geçmiş dosyalar korunmuştur; R2_Updates klasörü düzeltilmiş eşleştirilmiş assay analizini, güncellenmiş şekil kaynaklarını ve revize edilmiş parametre envanterini sağlar. Bu dosyayı indirmek için lütfen buraya tıklayın.
Tartışma
Bu bütünleşik iş akışında; toplu transkriptomik, WGCNA, DPN ile ilişkili gen taraması ve keşifsel özellik seçimi yoluyla MMP1 önceliklendirilmiş, ardından hücresel bağlamı ve doku ekspresyonu incelenmiştir. Altı gen, en az iki seçim yöntemi tarafından desteklenmiş ve MMP1 keşif kohortunda en büyük ekspresyon değişimini göstermiştir. Harici kanıtlar heterojen seyretmiştir: MMP1, birleştirilmiş GSE68183/GSE80178 matrisinde anlamlılığını korurken, GSE134431'deki ilişkisi nominal kalmış (p = 0.0225) ve BH düzeltmesinden sonra anlamlılığını yitirmiştir (düzeltilmiş p = 0.135). GSE134431'deki 0.808'lik AUC değeri, özellikle ROC yönü değerlendirme veri seti içinde seçildiği için tanımlayıcıdır. Buna göre, "en tutarlı" ifadesi altı aday arasında gözlemlenen örüntüyü tanımlamakta olup, tam bir istatistiksel tekrarlanabilirliği veya doğrulanmış bir tanısal biyobelirteci ifade etmemektedir.
Aday panel; kolajen döngüsü, ECM sökülmesi, metalloendopeptidaz aktivitesi ile IL-17 ve relaksin sinyallezmesi ile ilişkilendirilmiştir. Bu açıklamalar kronik yara biyolojisi ile uyumludur ancak yalnızca birkaç geni kapsamaktadır. Daha önceki insan çalışmaları, diyabetik yaralarda değişmiş MMP ve inhibitör profilleri bildirmiş6, prospektif bir DFU çalışması ise daha yüksek bir MMP1/doku metalloproteinaz inhibitörü 1 (TIMP1) oranını iyileşme ile ilişkilendirmiştir7. Bu nedenle, artan MMP1 ekspresyonu her zaman zararlı bir etkiye işaret etmek zorunda değildir; önemi onarım evresine, substrat mevcudiyetine ve inhibitör dengesine bağlı olabilir. MMP13, CCL7 ve IL-17 ile ilgili deneysel gözlemler ek bağlam sağlamaktadır11,12,13,14, ancak bu genlerin işlevlerinin insan DFU'larında da eşdeğer olduğu varsayılamaz.
Tek hücre özetleri, en yüksek ortalama MMP1 ekspresyonunu fibroblastlarda saptamış olup, DFU fibroblastları, keratinositler ve endotelyal hücrelerde örnek düzeyinde daha yüksek ekspresyon görülmüştür. Bu örüntü, DFU kaynaklı fibroblastlarda değişmiş ECM organizasyonu4, tek hücreli ve mekansal çalışmalarda heterojen fibroblast durumları8 ve makrofajla ilişkili iyileşme fibroblast programları15 hakkındaki raporlarla uyumludur. Bununla birlikte, örnek tanımlayıcıları donör düzeyinde doğrulamaya gereksinim duymaktadır ve donör içi bağımlılık modellenmediği için hücre düzeyi modül puan korelasyonları ve ekspresyon koşullu zenginleştirmeler tanımlayıcı düzeyde kalmaktadır. Epitelyal ve endotelyal popülasyonlardan gelen katkılar da yalnızca fibroblast otonom bir mekanizma olasılığına karşı argüman sunmaktadır. Mekansal transkriptomik, RNA in situ hibridizasyon veya immün boyama, tamamlayıcı lokalizasyon sağlayacaktır16.
Metodolojik değer; adayların önceliklendirilmesi için diferansiyel ekspresyon, ko-ekspresyon, önceden edinilmiş gen bilgisi, hücre çözünürlüklü özetler ve bağımsız analiz modalitelerinin birleştirilmesinde yatmaktadır. Değer, keşif kohortu öngörü doğruluğunda değildir. Kohort genelindeki tarama, algoritma düzeyindeki çapraz doğrulamadan önce gerçekleşmiştir ve 1,00'lik tek tip SVM-RFE AUC değeri; sızıntı, aşırı uyum ve iyimser değerlendirme konularında endişeler uyandırmaktadır. Bu nedenle panel, bir özellik önceliklendirme sonucu olarak kalmalıdır. Öngörücü değerlendirme için, tam iç içe geçmiş ön işleme, seçim ve ince ayarı takip eden kilitli bir bağımsız test gerekecektir9,10. Keşif girdisinin, sayım tabanlı bir modelde kullanılmasına rağmen TPM olduğu doğrulanmıştır; bu nedenle, ortaya çıkan keşif istatistikleri ve sonraki seçimler, uygun yeniden analiz yapılana kadar doğrulanmamış olarak kalmaktadır. Birleştirilmiş dökme (bulk) matrisi, eksiksiz ön işleme geçmişinden yoksundur. Geri kazanılan Seurat nesnesi; normalleştirme, değişken özellik seçimi, PCA, komşu, kümeleme ve UMAP ayarlarını sağlamaktadır, ancak orijinal filtrelemesi, tam Harmony çağrısı ve anotasyon referansı eksik belgelenmiş durumdadır. Kaynak verilerden harmonize edilmiş yeniden işleme, belgelenmiş grup etkisi (batch-effect) değerlendirmesi ve donör farkındalıklı psödobulk veya karma model analizleri, daha ileri değerlendirmeler için alternatif yaklaşımlardır.
Hasta doku analizleri, daha yüksek MMP1 bolluğuna dair öncül ortogonal kanıtlar sağlamaktadır. Karşılaştırma grubu, aynı hastalardan alınan ülsere olmamış yara çevresi dokusudur; dolayısıyla kontrast, sağlıklı ciltle yapılan bir karşılaştırmadan ziyade, diyabetik doku içindeki ülserle ilişkili yerel farklılıkları yansıtmaktadır. Üç eşleştirilmiş hasta çiftinden elde edilen WB ölçümleri ve yazarlar tarafından onaylanmış dört eşleştirilmiş çiftten alınan qPCR ölçümleri, bireysel biyolojik gözlemler gösterilerek eşli testler kullanılarak analiz edilmiştir. qPCR için, her örnek içindeki teknik kuyucukların ortalaması alınmış ve çıkarımlar için ΔCq kullanılmıştır; teknik kuyucuklar biyolojik örnek boyutunu artırmamıştır. Eşli gözlemlerin tutarlı yönü, öncül bir ekspresyon karşılaştırmasını desteklemektedir ancak küçük kohortlar genellenebilirliği kanıtlayamaz veya dağılım varsayımlarını güvenilir bir şekilde değerlendiremez. Toplu doku bolluğu; hücresel protein lokalizasyonunu, enzimatik aktiviteyi veya iyileşme üzerindeki nedensel bir etkiyi kanıtlamaz. Klinik olarak karakterize edilmiş daha büyük kohortlara ihtiyaç vardır. Diğer sınırlamalar arasında eksik klinik kovaryantlar, farklı karşılaştırma dokuları, literatürden türetilmiş ve eksik belgelenmiş bir DPN gen seti ve eksik orijinal blot arka plan çıkarma kayıtları yer almaktadır. Sağlıklı doku, çalışma tarafından tanımlanmış kontrol dokusu ve ülsere olmamış diyabetik ayak derisi birbirinin yerine kullanılabilir olarak değerlendirilmemelidir.
TCM ağı, hipotez üreten bir genişletmedir. Özel ağırlıkları, hedef etkileşimi veya etkinliğinden ziyade veri tabanı kapsamını özetler ve sıralamalar veri tabanı içeriği ile ağırlık seçimlerine göre değişebilir. Kuersetin ve berberin ayrıca değişken veya sınırlı sistemik maruziyete sahiptir17,18. Bu nedenle, aday bileşenler ve bitkiler için doğrudan hedef, doz-yanıt, farmakokinetik, toksisite ve fonksiyonel testler gereklidir. Gelecekteki çalışmalar, iyi belgelenmiş bağımsız kohortları; primer fibroblastlarda veya çok hücreli yara modellerinde mekansal lokalizasyon ve MMP1 perturbasyonu ile birleştirmelidir. Mevcut bulgular, nedensellik veya klinik fayda belirlemeksizin, fibroblast merkezli bir matriks yeniden şekillenme bağlamında MMP1'i DFU ile ilişkili bir aday olarak desteklemektedir.
Açıklamalar
Yazarlar herhangi bir çıkar çatışması beyan etmemektedir.
Teşekkürler
Bu araştırma, Wuhan Belediye Sağlık Komisyonu tarafından yönetilen Wuhan Belediye Tıbbi Bilimsel Araştırma Projesi (Rehber Proje, Hibe No. WX23Z77) tarafından desteklenmiştir.
Yazarlar, bu çalışma için doku örnekleri sağlayan katılımcılara ve halka açık veri setlerini oluşturup NCBI Gene Expression Omnibus'a yükleyen araştırmacılara teşekkür ederler.
Malzemeler
| Ad | Şirket | Katalog numarası | Yorumlar |
|---|---|---|---|
| 0,2 mL ince duvarlı şeffaf PCR 8'li tüp şeritleri | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| 1,000-μL steril filtreli pipet uçları | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| 1,5 mL steril mikrosantrifüj tüpleri, DNaz/RNaz içermeyen | Solarbio Life Sciences | YA0430 | Ürün Adı: Huminex-II'de kullanılan Human Serum Albumin (HSA) Sıra No: SB0201 Ürün açıklaması: HSA, plazma proteinlerinin en önemlisi olup, plazma proteinlerinin yaklaşık %60'ını oluşturur. Kandaki ozmotik basıncın düzenlenmesinde ve çeşitli hormonların, ilaçların, yağ asitlerinin ve kalsiyumun taşınmasında önemli bir rol oynar. Ürün özellikleri: Katalog No: SB0201 Ürün ismi: Human Serum Albumin (HSA) Kaynağı: İnsan Saflık: $\geq$ 98% (SDS-PAGE) Yükleme: 1 mg/ml Formül: Lyophilized powder (Liyofilize toz) Saklama koşulları: -20°C'de saklayınız. Uygulama: Huminex-II'de kullanılır. |
| 10-μL steril filtreli pipet uçları | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR Mastermix | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 Ürün Adı: Protein A/G Agaroz Boncuklar Katalog Numarası: SB0411 Boyut: 5 mg Ürün Özellikleri: Protein A/G Agaroz Boncuklar, Protein A ve Protein G'nin rekombinant formlarının agaroz boncuklara bağlanmasıyla elde edilen bir karışımıdır. Bu ürün, IgG'lerin yüksek verimle ve spesifiteyle saflaştırılması için tasarlanmıştır. Protein A ve G'nin kombinasyonu, tek başına Protein A veya G'nin bağlanamadığı veya düşük bağlanma gösterdiği çeşitli türlerin IgG'lerini yakalama kapasitesini artırır. Uygulama Alanları: - IgG'lerin saflaştırılması - İmmünokomplekslerin izolasyonu - Antikorların konsantrasyonu ve değişimi Ürün Avantajları: - Geniş tür kapsamı: Protein A ve G'nin sinerjik etkisi sayesinde birçok farklı memeli türünden IgG'lere karşı yüksek afinite sağlar. - Yüksek bağlanma kapasitesi: Optimize edilmiş ligand yoğunluğu ile maksimum protein geri kazanımı sunar. - Düşük arka plan: Yüksek saflıktaki agaroz matrisi, minimum non-spesifik bağlanma sağlar. - Kullanım kolaylığı: Standart protein saflaştırma protokollerine uygundur. Saklama Koşulları: 2-8°C'de saklayınız. Dondurmayınız. Sipariş Bilgileri: Katalog No: SB0411 Miktar: 5 mg |
| 20× Tris-tamponlu salin | Solarbio Life Sciences | T1080 | Ürün Adı: Rabbit Anti-Human CD163 Antibody Katalog No: RBC0133 Sinyal Yolu: CD163 Tür: Tavşan (Rabbit) Yönelim: IgG1 Klon: Poliklonal Antijen: Human CD163 Uygulama: WB, IHC, ELISA Sıvı hacmi: 100 μg/ml Kullanım: 1:100 - 1:1000 Hücre Tipi: Hücre hattı, doku Depolama: -20°C Sertifika: COA, MSDS Ürün Özellikleri: CD163, makrofajların hücre yüzeyinde yüksek düzeyde eksprese edilen bir glikoprotein olan skavenger reseptör sınıfı bir proteinidir. CD163'ün temel fonksiyonu, hemoglobin-haptoglobin kompleksini temizleyerek hemoglobinin neden olabileceği doku hasarını ve oksidatif stresi önlemektir. CD163 ekspresyonu, makrofajların polarizasyon durumunu (M2 tipi makrofajlar) belirlemek için yaygın olarak kullanılan bir markördür ve çeşitli inflamatuar hastalıklarda ve kanserlerde ekspresyon seviyeleri değişkenlik gösterir. Bu ürün, insan CD163 proteinine karşı yüksek özgünlük ve hassasiyetle üretilmiş bir tavşan anti-insan CD163 antikorudur. Western Blot (WB), İmmünohistokimya (IHC) ve ELISA gibi farklı analiz yöntemlerinde etkili bir şekilde kullanılabilir. Ürün Parametreleri: - Hedef: Human CD163 - Konakçı: Rabbit - Antikor Tipi: Poliklonal - Uygulama: WB, IHC, ELISA - Konsantrasyon: 100 μg/ml - Depolama: -20°C'de saklayınız. Sipariş ve Teknik Destek: Detaylı bilgi ve sipariş için lütfen web sitemizi ziyaret edin veya teknik destek ekibimizle iletişime geçin. |
| 200-μL steril filtreli pipet uçları | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| ACTB qPCR primer çifti | Solarbio Life Sciences (özel oligonükleotid sentezi) | Özel | RefSeq NM_001101.5; İ: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, İsveç | Amersham Imager 600 | Sağlanan 22 TIFF dosyasının tamamında kaydedilmiş model; operasyon yazılımı Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Bicinkoninik asit protein analiz kiti | Solarbio Life Sciences | PC0020 | **Ürün Adı:** Human soluble IL-2 receptor (sIL-2R) ELISA Kiti **Ürün Tanımı:** Bu ELISA kiti, insan serum, plazma ve hücre üstü sıvısındaki çözünür interlökin-2 reseptörünün (sIL-2R) miktarını belirlemek için tasarlanmış yüksek hassasiyetli ve spesifik bir kantitatif analiz kitidir. **Ürün Özellikleri:** * **Yüksek Hassasiyet:** Çok düşük konsantrasyonlardaki sIL-2R düzeylerini tespit edebilir. * **Yüksek Özgünlük:** Hedef antijene karşı yüksek spesifite sağlar; çapraz reaksiyon minimum düzeydedir. * **Kolay Kullanım:** Optimize edilmiş protokol ile hızlı ve güvenilir sonuçlar sunar. * **Geniş Uygulama Alanı:** Klinik araştırmalarda ve biyomedikal çalışmalarda kullanımı uygundur. **Kullanım Alanları:** Sıvı örneklerdeki sIL-2R düzeylerinin ölçümü, bağışıklık sistemi aktivasyonunun izlenmesi ve ilgili patolojik durumların değerlendirilmesi için kullanılır. **Kit İçeriği:** * Kaplanmış Mikroplaka * Sinyal Antikoru (HRP ile konjuge) * Saptama Antikoru * Standart Çözeltiler * Yıkama Tamponu * Substrat * Durdurma Çözeltisi **Depolama Koşulları:** 2-8°C'de saklanmalıdır. Işıktan koruyunuz. |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Sürüm 4.16.0 |
| Kofilin poliklonal antikoru (tavşan anti-Kofilin) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Çin) | 10960-1-AP | Bu çalışmada kullanılan WB dilüsyonu: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Karşılaştırmalı Toksikogenomik Veritabanı | Ortak Teknik Doküman | https://ctdbase.org/ | Bileşen-hedef kaynağı |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Sürüm 1.48.2 |
| DNase/RNase içermeyen su | Solarbio Life Sciences | R1600 | Ürün Adı: Human IGF-1 (1-76) Katalog No: SR1085 Boyut: 100 µg Özet: İnsülin benzeri büyüme faktörü 1 (IGF-1), insülin benzeri büyüme faktörü bağlanma proteinleri (IGFBPs) ile etkileşime giren ve insülin reseptörleri aracılığıyla hücre proliferasyonu, farklılaşması ve sağkalımını düzenleyen etkili bir polypeptide hormondur. SolarBio tarafından sunulan Human IGF-1 (1-76), yüksek saflıkta ve biyolojik aktivitede sentezlenmiş olup, endokrinoloji, onkoloji ve hücre biyolojisi araştırmalarında kullanımı için optimize edilmiştir. Ürün Özellikleri: - Kaynak: Sentetik (İnsan) - Moleküler Ağırlık: Yaklaşık 7,6 kDa - Saflık: ≥%95 (HPLC ile belirlenmiştir) - Formülasyon: Liyofilize toz - Depolama Koşulları: -20°C'de saklayınız. Uygulama Alanları: - Hücre kültürü çalışmalarında mitojenik etkilerin incelenmesi. - IGF-1 reseptör bağlanma kinetiği analizleri. - Sinyal iletim yollarının (PI3K/Akt ve MAPK) araştırılması. - İlaç geliştirme ve biyokimyasal deneyler. Saklama ve Stabilite: Ürün liyofilize formda teslim edilir. Çözüldükten sonra, tekrarlanan donma-çözülme döngülerinden kaçınmak için uygun hacimlerde aliquots (paylar) haline getirilmesi ve -20°C ile -80°C arasında saklanması önerilir. Sipariş ve Teknik Destek: Detaylı teknik spesifikasyonlar ve güvenlik veri sayfaları (MSDS) için lütfen SolarBio müşteri hizmetleri ile iletişime geçiniz. |
| Lütfen çevirmem için kaynak metni sağlayın. | CRAN / e1071 yazarları | https://cran.r-project.org/package=e1071 | Sürüm 1.7-17 |
| ECL Plus kemilüminesans substratı | Solarbio Life Sciences | PE0010 | Sıvı Azot Tankı Kullanım Kılavuzu Sıvı azot tankları, biyolojik örneklerin, hücrelerin, dokuların ve genetik materyallerin uzun süreli kriyoprezervasyonu için tasarlanmış yüksek vakumlu, çift cidarlı kaplardır. Bu kılavuz, güvenli kullanım, bakım ve operasyonel prosedürler hakkında temel bilgiler sağlamaktadır. 1. Güvenlik Önlemleri Sıvı azot (-196°C) aşırı derecede soğuktur ve ciddi donuk yanıklarına neden olabilir. Ayrıca, buharlaştığında oksijeni yerinden ederek boğulma riski oluşturabilir. Kişisel Koruyucu Ekipman (KKE): - Kriyojenik eldivenler (Sıvı azota dayanıklı, gevşek oturan eldivenler) - Koruyucu gözlük veya yüz siperliği - Kapalı ayakkabılar - Laboratuvar önlüğü Havalandırma: - Tanklar yalnızca iyi havalandırılan alanlarda kullanılmalıdır. Kapalı alanlarda azot gazı birikimi boğulma tehlikesi yaratır. 2. Tank Özellikleri Sıvı azot tankları, ısı transferini minimize etmek için "Dewar" prensibine göre imal edilmiştir. Dış kap ve iç kap arasındaki vakum boşluğu, ısı sızıntısını önleyerek sıvı azotun buharlaşma hızını düşürür. 3. Kullanım Talimatları Sıvı Azotun Doldurulması: - Tankın ağzının temiz ve kuru olduğundan emin olun. - Sıvı azotu yavaşça ve dikkatle dökün. Hızlı döküm, aşırı sıçramalara ve ani gaz çıkışına neden olabilir. - Tankı tamamen doldurmayın; üst kısımda bir miktar boşluk bırakın. Örneklerin Yerleştirilmesi: - Örnekler, kriyotüpler veya özel saklama kapları içinde, tankın içindeki kanisterlere (sepetlere) yerleştirilmelidir. - Örneklerin sıvı azota daldırılması veya buhar fazında tutulması, seçilen saklama protokolüne göre yapılmalıdır. 4. Bakım ve Saklama - Tankın dış yüzeyinde buzlanma oluşursa, bunu nazikçe temizleyin. - Sıvı azot seviyesini düzenli olarak kontrol edin ve seviye düştüğünde takviye yapın. - Tankın sarsılmasını veya devrilmesini önlemek için düz ve sabit bir zemine yerleştirildiğinden emin olun. 5. Sorun Giderme Soru: Sıvı azot neden hızla buharlaşıyor? Cevap: Tank kapağının tam oturmamış olması veya vakum izolasyonunun bozulması buharlaşma hızını artırabilir. Soru: Tankın dış kısmında yoğunlaşma/buzlanma neden olur? Cevap: Bu durum genellikle normaldir, ancak aşırı buzlanma vakum kaybına işaret edebilir. Sıvı azot ile çalışırken her zaman yerel güvenlik yönetmeliklerine ve kurumunuzun biyogüvenlik protokollerine uyunuz. |
| Gene Expression Omnibus: GSE134431 | Ulusal Biyoteknoloji Bilgi Merkezi | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | Ulusal Biyoteknoloji Bilgi Merkezi | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | Ulusal Biyoteknoloji Bilgi Merkezi | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | Ulusal Biyoteknoloji Bilgi Merkezi | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gen İfade Veri Tabanı (Gene Expression Omnibus): GSE80178 | Ulusal Biyoteknoloji Bilgi Merkezi | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gen Ontolojisi | Gen Ontolojisi Konsorsiyumu | https://geneontology.org/ | GO |
| ggplot2 | ggplot2 geliştiricileri | https://ggplot2.tidyverse.org/ | Sürüm 4.0.3 |
| glmnet | CRAN / glmnet yazarları | https://cran.r-project.org/package=glmnet | Sürüm 5.0 |
| Bitki içeriği referans tablosu | Kaynak makalede bildirilmemiştir | Rapor edilmedi | Belgelenmemiş: kesin veri tabanı/dosya adı, versiyon/tarih ve halka açık erişim URL'si |
| HRP-konjuge keçi anti-tavşan IgG (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Çin) | SA00001-2 | Bu çalışmada kullanılan WB dilüsyonu: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| İnsan diyabetik ayak ülseri doku örnekleri | Wuhan Dördüncü Hastanesi, Wuhan, Çin | Lütfen çevrilecek metni sağlayın. | Hasta ile eşleştirilmiş DFU örnekleri; qPCR n=4 örnek; WB n=3 örnek; onaylı protokol KY2024-161-01 |
| İnsan non-ülserasyonlu yara çevresi doku örnekleri | Wuhan Dördüncü Hastanesi, Wuhan, Çin | Sistemde herhangi bir girdi bulunmamaktadır. Lütfen çevrilmesini istediğiniz kaynak metni sağlayınız. | Hasta ile eşleştirilmiş yara çevresi karşılaştırıcı; qPCR n=4 örnek; WB n=3 örnek; onaylanmış protokol KY2024-161-01 |
| ImageJ | Ulusal Sağlık Enstitüleri | https://imagej.net/ij/ | Sürüm belgelenmedi |
| Kyoto Genler ve Genomlar Ansiklopedisi | KEGG | https://www.genome.jp/kegg/ | İnsan organizma kodu hsa |
| Literatürden derlenmiş DPN gen listesi | Literatür kaynaklı bileşen; gen düzeyindeki kaynak tablosu tam olarak belgelenmemiş | Rapor edilmedi | Gen düzeyindeki köken bilgisi tam olarak belgelenmemiştir |
| Mikrohacimli UV-görünür bölge spektrofotometresi | Üretici/model makalede bildirilmemiştir | Raporlanmadı | Belgelenmemiş: kesin üretici, model ve ürün URL'si; bildirilen kullanım: RNA konsantrasyonu ve A260/A280 değerlendirmesi |
| MMP1 poliklonal antikoru (tavşan anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, Çin) | 10371-2-AP | Bu çalışmada kullanılan WB dilüsyonu: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| MMP1 qPCR primer çifti | Solarbio Life Sciences (özel oligonükleotid sentezi) | Özel | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | Ulusal Biyoteknoloji Bilgi Merkezi | https://www.ncbi.nlm.nih.gov/gene/ | İnsan Gen Veritabanı |
| Yağsız kuru süt, bloklama reaktifi | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Sürüm 3.21.0 |
| Hazır dökümlü SDS-PAGE jeli, %4–%20 gradyan | Solarbio Life Sciences | PG42010-S | **Ürün Adı:** Lipopolisakkarit (LPS) - *Escherichia coli* kaynaklı **Katalog Numarası:** LPS100 **Ürün Açıklaması:** Lipopolisakkarit (LPS), Gram-negatif bakterilerin dış membranının temel bileşenidir ve güçlü bir endotoksindir. LPS, makrofajlar ve diğer immün hücreler üzerindeki Toll benzeri reseptör 4'e (TLR4) bağlanarak sitokin üretimini ve inflamatuar yanıtları tetikler. Bu ürün, hücre içi sinyal yolaklarının, inflamasyon modellerinin ve immünolojik yanıtların incelenmesi için optimize edilmiştir. **Ürün Özellikleri:** * **Kaynak:** *Escherichia coli* * **Saflık:** $\geq$ 98% (HPLC ile belirlenmiş) * **Aktivite:** $\geq$ 10 $\mu$g/mg (limulus amebosit lizat testi ile belirlenmiş) * **Form:** Liyofilize toz **Depolama Koşulları:** -20°C'de saklayınız. Nemden koruyunuz. **Kullanım Alanları:** * TLR4 aktivasyon çalışmaları * Sitokin salınımı analizleri * İnflamasyon ve sepsis modelleri * İmmünomodülatör ilaçların test edilmesi **Hazırlama ve Uygulama:** LPS'yi steril distile su veya uygun bir tampon çözelti (örneğin PBS) ile çözerek stok çözelti hazırlayınız. Stok çözeltiyi küçük alikotlara ayırarak -20°C'de saklayınız ve tekrarlanan donma-çözülme döngülerinden kaçınınız. Uygulama öncesinde çözeltiyi oda sıcaklığına getiriniz ve hafifçe vorteksleyiniz. |
| pROC | CRAN / pROC yazarları | https://cran.r-project.org/package=pROC | Sürüm 1.19.0.1 |
| Proteaz inhibitör karışımı, 100× | Solarbio Life Sciences | P6730 | Ürün Adı: Bakteri-Mantar Seçici Besiyeri (Selective Medium for Bacteria and Fungi) Katalog No.: SB0336 Sınıflandırma: Besiyeri / Kültür Ortamı Sertifika: ISO 9001:2015 Ürün Açıklaması: Bakteri-Mantar Seçici Besiyeri, bakteri ve mantarların ayrıştırılması ve seçici kültürü için tasarlanmış yüksek kaliteli bir besiyeridir. Bu besiyeri, spesifik besin bileşenleri ve seçici ajanlar içererek, hedef mikroorganizmaların büyümesini desteklerken istenmeyen flora türlerini inhibe eder. Standardize edilmiş bileşimi sayesinde, mikrobiyolojik analizlerde tutarlı, tekrarlanabilir ve güvenilir sonuçlar sağlar. Kullanım Alanları: Çevresel örneklemeden, klinik tanıya ve gıda güvenliği testlerine kadar geniş bir yelpazede, örneklerdeki bakteri ve mantar kontaminasyonunun tespitinde ve izolasyonunda kullanılır. Ürün Özellikleri: * Yüksek seçicilik: Bakteri ve mantarların büyümesini ayırt eden optimize edilmiş formülasyon. * Stabilite: Uzun raf ömrü ve depolama stabilitesi. * Hızlı sonuçlar: Hedef organizmaların kolonizasyonu için optimize edilmiş besin içeriği. Saklama Koşulları: 2-8°C'de saklayınız. İçindekiler: Bu ürün, toz formunda hazır bir besiyeri karışımıdır. Hazırlama talimatları için lütfen ürünle birlikte gelen kullanım kılavuzuna bakınız. |
| Protein transfer sistemi | Üretici/model makalede bildirilmemiştir | Rapor edilmedi | Belgelenmemiş: kesin üretici, model ve ürün URL'si; bildirilen kullanım: 0,22-μm filtreye aktarmaμm PVDF membran |
| PVDF membran, 0.22 μm | Solarbio Life Sciences | YA1690 | **Ürün Adı:** Protein A/G Affinite Kolon Kiti **Ürün Açıklaması:** Protein A/G Affinite Kolon Kiti, antikorların yüksek saflıkta ve verimle izole edilmesi için geliştirilmiş, yüksek performanslı bir kit setidir. Bu kit, Protein A ve Protein G'nin yüksek afinite ile bağlanan bölgelerini içeren hibrit bir ligand kullanır, böylece farklı türden IgG'lerin (fare, tavşan, keçi, koyun ve insan gibi) tek bir kolonla optimize edilmiş düzeyde temizlenmesi sağlanır. Bu ürün, düşük hacimli örneklerle çalışmaya uygun olup, antikorların saflaştırılması ve konsantrasyonu için idealdir. **Ürün Özellikleri:** * **Yüksek Afinite:** Protein A ve G'nin avantajlarını birleştirerek geniş bir tür yelpazesine sahip antikorlar için maksimum bağlama kapasitesi sunar. * **Yüksek Saflık:** Spesifik bağlama ve optimize edilmiş yıkama adımları sayesinde yüksek saflıkta antikor eldesi sağlar. * **Kolay Kullanım:** Hazır kolon formatı ile karmaşık hazırlık süreçlerini ortadan kaldırır ve hızlı sonuç verir. * **Geniş Uygulama Alanı:** Farklı türlerin IgG antikorlarının saflaştırılması için uygundur. **Kit İçeriği:** * Protein A/G Affinite Kolonu * Yıkama Tamponu * Elüsyon Tamponu * Kullanım Kılavuzu **Kullanım Alanları:** * Monoklonal ve poliklonal antikorların saflaştırılması. * Serum veya hücre kültür süpernatantlarından antikor izolasyonu. * Antikorların konsantrasyonu ve tampon değişimi. **Saklama Koşulları:** 4°C'de saklayınız. |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Sürüm 4.5.2 |
| rastgeleOrman | CRAN / randomForest yazarları | https://cran.r-project.org/package=randomForest | Versiyon 4.7-1.2 |
| Gerçek zamanlı PCR cihazı | Roche Diagnostics | LightCycler 96 | yazılım versiyonu onaylanmadı. Proje hacmi/döngüsü bildirilen protokolden farklıdır; kesin deney bağlantısının kontrol edilmesi gerekmektedir. |
| Soğutmalı mikro santrifüj | Üretici/model makalede belirtilmemiştir | Raporlanmadı | Belgelenmemiş: kesin üretici, model ve ürün URL'si; bildirilen kullanım: 12.000 × 15 dakika boyunca ... g'de santrifüjleyin 4 °C |
| girin | CRAN / rentrez yazarları | https://cran.r-project.org/package=rentrez | Sürüm 1.2.4 |
| RIPA lizis tamponu, yüksek konsantrasyonlu | Solarbio Life Sciences | R0010 | Ürün Adı: Total RNA İzolasyon Kiti (Sütun Temizleme Yöntemi) Katalog No: RS2010 Ürün Tanımı: Bu kit, çeşitli hücre tiplerinden ve dokulardan toplam RNA'yı izole etmek için tasarlanmıştır. Kit, yüksek kaliteli ve RNAz'dan arındırılmış toplam RNA elde etmek için spin kolon temizleme teknolojisini kullanır. Kullanım Alanları: - Memeli hücreleri, dokuları ve organları - Bakteriyel hücreler - Bitki dokuları ve hücreleri - Virüsle enfekte olmuş hücreler Ürün Özellikleri: 1. Hızlı ve kolay işlem: Basit bir protokol ile kısa sürede yüksek verim sağlar. 2. Yüksek saflık: RNAz kontaminasyonunu minimize eden ve yüksek saflıkta RNA sağlayan etkin bir temizleme süreci sunar. 3. Geniş uygulanabilirlik: Çeşitli biyolojik örneklerden RNA izolasyonu için uygundur. 4. Güvenli ve etkili: Toksik organik çözücülerin kullanımını minimize eder. Kit İçeriği: - Lysis Buffer (Lizis Tamponu) - DNAse I (Opsiyonel) - Spin Column (Spin Kolon) - Collection Tube (Toplama Tüpü) - Washing Buffer (Yıkama Tamponu) - Elution Buffer (Elüsyon Tamponu) Saklama Koşulları: Oda sıcaklığında saklayınız. Kullanım Talimatları: 1. Örnek Hazırlama: Hücreleri veya dokuları uygun lizis tamponu ile homojenize edin. 2. Bağlama: Karışımı spin kolona aktarın ve santrifüjleyin. 3. Yıkama: RNA'yı saflaştırmak için yıkama tamponu ile ardışık yıkama adımlarını uygulayın. 4. Elüsyon: Elüsyon tamponu kullanarak saflaştırılmış toplam RNA'yı geri kazanın. |
| SDS-PAGE elektroforez sistemi | Üretici/model makalede belirtilmemiştir | Rapor edilmedi | Belgelenmemiş: kesin üretici, model ve ürün URL'si; bildirilen kullanım: %4'lük protein ayrımı–%20 gradyanlı jeller |
| Seurat | Satija Laboratuvarı / Seurat geliştiricileri | Seurat, tek hücre düzeyindeki RNA dizileme (scRNA-seq) verilerinin analizini gerçekleştirmek için tasarlanmış, R dilinde yazılmış kapsamlı bir paket ve araç setidir. Seurat; hücre kümelerinin tanımlanması, hücre tipi sınıflandırması, farklılaşma yollarının analizi ve farklı örnekler arasındaki karşılaştırmalı analizler için gelişmiş yöntemler sunar. Temel özellikleri arasında yüksek boyutlu verilerin boyut indirgeme yöntemleri (örneğin PCA), grafik tabanlı kümeleme algoritmaları ve çok örneklü veri setlerinin entegrasyonu yer alır. Seurat, araştırmacıların karmaşık tek hücre veri setlerinden biyolojik içgörüler elde etmelerini sağlayan esnek ve modüler bir yapıya sahiptir. | Sürüm 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Sürüm 2.10.0 |
| Doku homojenizatörü | Üretici/model makalede bildirilmemiştir | Rapor edilmedi | Belgelenmemiş: kesin üretici, model ve ürün URL'si; bildirilen kullanım: buz gibi soğuk lizis tamponu içinde doku homogenizasyonu |
| TriQuick Reagent toplam RNA ekstraksiyon reaktifi | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | Ürün Adı: Protein Analiz Kiti (BCA Yöntemi) Ürün Özeti: Bu kit, protein konsantrasyonunu belirlemek için bikarbonatyla uyumlu protein analiz yöntemi (BCA) kullanan yüksek hassasiyetli bir kitdir. BCA yöntemi, proteinlerin bakır (II) iyonlarını (Cu2+) bakır (I) iyonlarına (Cu1+) indirgediği ve ardından Cu1+ iyonlarının bikarbonatyla kompleks oluşturarak mor renkli bir çözelti meydana getirdiği prensibine dayanır. Oluşan kompleksin absorbansı 562 nm'de ölçülür ve protein konsantrasyonu standart protein eğrisi ile belirlenir. Özellikler: - Yüksek hassasiyet ve geniş doğrusal aralık. - Çeşitli protein türleri için uyumluluk. - Hızlı ve kolay uygulama süreci. - Stabil ve güvenilir sonuçlar. Kit İçeriği: - BCA Çalışma Çözeltisi - Protein Standartı (BSA) - Talimatlar Uygulama Adımları: 1. Standart hazırlığı: Farklı konsantrasyonlarda BSA standart çözeltileri hazırlayın. 2. Örnek hazırlığı: Analiz edilecek protein örneklerini uygun tampon çözeltilerde seyreltin. 3. Reaktif ekleme: Standartlara ve örneklere belirli oranda BCA Çalışma Çözeltisi ekleyin. 4. İnkübasyon: Karışımları oda sıcaklığında veya 37°C'de belirtilen süre boyunca inkübe edin. 5. Ölçüm: 562 nm dalga boyunda absorbansı ölçün. 6. Hesaplama: Standart eğrisini kullanarak örnekteki protein konsantrasyonunu hesaplayın. Saklama Koşulları: - Kit içeriğini 2-8°C'de saklayın. - Işıktan koruyun. Kullanım Alanları: Bu kit; biyokimya, moleküler biyoloji ve hücre biyolojisi araştırmalarında protein miktarının tayini için yaygın olarak kullanılır. |
| 0,2 mL'lik PCR tüp şeritleri için ultra şeffaf düz kapaklar | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Evrensel RT-PCR Kiti (M-MLV) | Solarbio Life Sciences | RP1100 | Ürün Adı: Protein Konsantrasyonu Belirleme Kiti (BCA Yöntemi) Ürün Özellikleri: Protein konsantrasyonu, biyokimyasal araştırmalarda yaygın olarak kullanılan bir parametredir. Bicinchoninate Acid (BCA) yöntemi, protein miktarını belirlemek için kullanılan en yaygın ve hassas yöntemlerden biridir. Bu kit, yüksek doğruluk ve tekrarlanabilirlik sağlayan, kullanımı kolay bir protein miktar tayini çözümü sunar. Çalışma Prensibi: BCA yöntemi, iki ardışık reaksiyona dayanır: 1. Proteinlerin peptit bağlarındaki azotun ve belirli amino asitlerin (sistein, sistein, triptofan ve tiron) $\text{Cu}^{2+}$ iyonlarını $\text{Cu}^{+}$ iyonlarına indirgemesi (Biuret reaksiyonu). 2. $\text{Cu}^{+}$ iyonlarının, alkali ortamda iki adet BCA molekülü ile kompleks oluşturarak yoğun mor renkli bir yapı oluşturması. Oluşan bu kompleksin absorbansı 562 nm dalga boyunda ölçülür ve renk yoğunluğu protein konsantrasyonu ile doğrudan orantılıdır. Ürün Avantajları: - Yüksek Hassasiyet: Düşük protein konsantrasyonlarını bile etkili bir şekilde tespit eder. - Geniş Lineer Aralık: Geniş bir konsantrasyon aralığında doğru sonuçlar verir. - Tolerans: Birçok deterjan ve tampon çözeltisinin etkilerine karşı dayanıklıdır. - Hızlı ve Kolay: Basit protokolü sayesinde kısa sürede sonuç alınmasını sağlar. Kit İçeriği: - BCA Çalışma Çözeltisi A (Sodyum Karbonat, BCA) - BCA Çalışma Çözeltisi B ($\text{CuSO}_4$) - Standart Protein (BSA - Sığır Serumu Albumini) - Kullanım Kılavuzu Uygulama Alanları: - Hücre lizatları ve doku ekstrelerindeki toplam protein miktarının belirlenmesi. - Saflaştırılmış proteinlerin konsantrasyon tayini. - Western Blot ve ELISA gibi analizler öncesinde örneklerin standardize edilmesi. Saklama Koşulları: $-20\text{°C}$'de saklayınız. |
| Ağırlıklı Gen Co-ekspresyon Ağ Analizi (WGCNA) | CRAN / WGCNA yazarları | https://cran.r-project.org/package=WGCNA | Versiyon 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Kaynaklar
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.