本文介绍了一种用于多种流体流动的定量三维(3D)成像技术。基于光场成像领域的原理,我们从图像阵列中重建三维体积。我们的三维结果涵盖广泛,包括速度场和多相气泡尺寸分布。
本文内容
摘要
摘要
在流体力学领域,计算方法的分辨率已超过实验技术,导致流体流动中预测现象与观测现象之间的差距日益扩大。因此,亟需一种能够针对多种问题解析三维(3D)数据集的便捷方法。我们提出一种新颖的技术,可用于对多种类型的流场进行定量三维成像。该三维技术能够用于研究复杂的速度场和含气泡流动。对这类流动的测量给仪器带来了诸多挑战。例如,由于气泡遮挡了对感兴趣区域内部的光学通路,传统的无创流动测量技术难以对光学密度高的多相气泡流进行有效成像。通过使用光场成像技术,我们能够对相机阵列所捕获的图像进行重新参数化,从而在存在部分遮挡的情况下,重建出每个时间点的三维体数据图。该技术采用一种称为合成孔径(SA)重聚焦的算法,通过在捕获后整合多个相机的图像,生成一个三维焦栈1。光场成像能够获取光线的角度信息和空间信息,从而实现三维场景的重建。随后,可通过多种处理算法从三维重建结果中提取定量信息。特别是,我们已基于光场成像技术开发了若干测量方法,用于实现三维粒子图像测速(PIV)、提取三维流场中的气泡以及追踪闪烁火焰的边界。本文以我们用于对通过一组合成声带的气流进行3DPIV测量的实验装置为例,阐述光场成像方法的基本原理,并展示该技术在含气泡冲击射流中的典型应用结果。
方案
1. 三维光场成像系统设置
- 首先确定待研究流体流动实验所需的测量体积大小,以及时间分辨率和空间分辨率。
- 估算实验中将存在的光学密度,以确定生成具有高信噪比(SNR)的重聚焦图像所需的相机数量1, 2(例如,对于粒子图像测速(PIV),应计算每像素的粒子数)。在本文所展示的基于合成声带的三维层析PIV(3D SAPIV)实验中,我们使用8台相机,预计实现每像素0.05–0.1个粒子的示踪粒子密度(ppp)。随着相机数量增加,性能提升逐渐趋于平缓,约在13台相机时达到极限;当相机数量少于5台时,信噪比会迅速下降。
- 将相机以阵列形式安装在支架上,使每台相机能够从不同视角观测测量体积。
- 将相机连接至中央计算机,用于数据采集与实时查看。
- 选择合适焦距的镜头,以满足所需的放大倍率和光学工作距离。通常,每台相机安装相同类型的定焦镜头,以使各图像的放大倍率保持一致。
- 在测量体积中心放置一个视觉标定目标(如标定网格)。
- 以相机阵列中心相机的图像作为参考,整体移动相机阵列支架,使其靠近或远离测量体积,以达到所需的放大倍率。
- 接下来,调整阵列中其余相机之间的间距。增大相机间距可提高深度方向的空间分辨率,但会减小可分辨的总深度范围1。注:本文中“深度”指Z方向,其正方向朝向相机(见图1)。深度与平面内分辨率之比近似由以下公式给出:
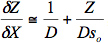 ,其中Z为测量体积中的深度,so为相机到测量体积前端的距离,D为相机间距与so的比值。
- 调节所有相机的角度,使测量体积中心的视觉标定目标在每台相机的图像中大致居中。
- 将每台相机镜头的光圈完全打开,对每台相机进行对焦,使其聚焦于视觉标定目标。
- 在测量体积后端放置一个标定目标。确保该目标位于每台相机的视场范围内;若未完全覆盖,则需调整相机与测量体积之间的距离和/或相机间距(参见步骤1.7–1.8)。
- 逐步缩小每台相机的光圈,直至标定目标在每台相机中均清晰对焦。
- 将标定目标移至测量体积前端,重复步骤1.11–1.12。每次调整后,各相机中的标定目标图像应与图2所示相似。
2. 体积照明装置设置
- 根据应用于流场的具体测量方法,确定照亮测量区域的合适方式。对于粒子图像测速(PIV),需使用激光照明体积。
- 选择脉冲频率能够达到所需时间分辨率的激光器。该激光器可采用单脉冲模式用于时间分辨测量,或双脉冲模式用于跨帧测量3。
- 使用光学透镜将激光束整形为覆盖整个测量区域的照明体积。
- 向流场中引入适用于PIV测量的示踪粒子3。流体中的粒子浓度应足够高,以实现所需的空间分辨率,但又不能过高,以免导致SA重聚焦图像的信噪比(SNR)降至可接受水平以下。参考文献1对可实现的粒子 seeding 密度进行了系统研究,但通常经验法则是:在使用8台或更多相机的大多数实验中,每像素0.05–0.15个粒子(ppp)的图像密度较为合适。在相机数量固定的情况下,随着测量体积深度尺寸的增加,每像素的粒子数会相应减少。
3. 相机阵列校准
- 校准需要在每个相机中拍摄一系列图像,校准目标(例如 棋盘格,见图2)需在测量体积内的多个位置放置。首先,在两种校准方法中选择一种:多相机自校准方法,或成像一个已知的校准目标并将其精确地移动通过感兴趣区域。
- 在测量体积内建立一个参考坐标系。该坐标系通常根据实验需求进行选择(例如 与圆柱轴线对齐,原点位于平板前缘等)。此处我们选择将网格放置在X-Y平面,并沿Z轴上的点对齐(图1)。
- 如果使用多相机自校准算法4, 5,则校准目标的位置可以是随机的,但其中有一个位置必须在参考坐标系中精确定位。该精确定位目标上的校准点位置必须具有很高的精度。在每个相机中,拍摄目标在每个位置的图像,如图2所示。
- 如果不使用多相机自校准算法,则必须将校准目标精确放置在测量体积内的多个位置,使得目标在参考坐标系中的方向具有高精度的已知信息。在每个相机中,拍摄目标在每个位置的图像。
- 在每个相机的每幅图像中识别目标上的点。对于自校准,需要所有相机之间的图像点对应关系5,但仅对精确定位目标生成的点需要明确的参考坐标系到图像点的对应关系。对于精确移动的校准方法,所有相机中所有点均需要明确的参考坐标系到图像点的对应关系。
- 应用所选的校准算法对所有相机进行校准。此处我们选择使用多相机自校准算法4, 5(开源http://cmp.felk.cvut.cz/~svoboda/SelfCal/),所得相机相对于感兴趣平面的位置如图3所示。
4. 时间控制、触发与数据采集
- 定量、时间分辨的光场成像需要所有相机和照明光源与相关实验事件精确同步。
- 使用外部脉冲发生器来触发相机曝光和照明序列。在脉冲发生器上编程设置适当的时序脉冲序列。对于声带实验,我们采用跨帧序列,即激光脉冲接近一个相机曝光周期的末尾,同时靠近下一个曝光周期的开始3。
- 如果从实验事件触发,请确保生成相应的信号并输入至脉冲发生器。
- 如果采用手动触发,需做好触发脉冲发生器的准备。
- 通过选定的触发方式启动相机采集和照明序列,开始实验数据采集。
- 尽管这听起来微不足道,但在进行多相机光场成像实验并获取大量数据时,建立良好的文件命名规范至关重要。在制定命名规范时,应充分考虑数据从采集到最终分析的整个使用流程。
5. 合成孔径重聚焦
- 现在我们将生成一组三维焦平面图像堆栈,以生成合成重聚焦的体数据。首先,定义用于合成重聚焦体数据中各焦平面之间的间距以及整体重聚焦深度 1, 7。通常,焦平面间距设为深度分辨率的一半,而总重聚焦深度由所有相机视场重叠的区域决定。这些焦平面将垂直于参考坐标系的 Z 轴。
- 定义在将图像重投影到测量体积时所应用的缩放比例。该比例应与原始图像的放大倍数一致,以避免重投影图像出现显著的过采样或欠采样。
- 建立每个相机图像平面与每个合成焦平面之间的变换关系。
- 进行图像预处理,以去除背景噪声并校正图像间强度差异 1, 7。
- 将图像重投影到合成焦平面上,应用缩放比例并对图像进行重采样。给定平面到平面的变换关系后,可使用一组内置的 Matlab 函数(图像处理工具箱 a)完成这些任务。
- 在每个合成焦平面上,应用加性或乘性 SA 重聚焦算法 1, 7。在三维 SAPIV 应用中,我们发现加性 SA 效果良好(如本文中对声带的应用)。对于背光气泡图像,乘性 SA 取得了更优的结果。作为验证步骤,可将重聚焦算法应用于一组校准图像的单个平面上,检查重建结果是否符合预期。
6. 体积后处理
- 要估计生成光场的体积中原始物体,需要一个称为重建的处理步骤。现有的算法包括从简单的强度阈值法1、基于梯度的聚焦度量方法7,到更复杂的三维去卷积算法8。应根据具体应用选择合适的重建算法。在粒子图像测速(PIV)中,我们已成功应用了强度阈值法和三维去卷积法。本文采用强度阈值法生成焦栈。对时间1(t1)和时间2(t2)的两个焦栈进行互相关运算,以生成矢量场。三维光场成像方法本身会导致物体在深度方向上出现拉伸,这可能影响PIV的准确性;良好的重建算法应尽量减轻这种拉伸效应。
- 完成重建步骤后,可能需要从体积数据中提取特征,以便测量尺寸、形状等参数。用于特征提取的算法多种多样,取决于具体应用7。例如,提取气泡需要能够定位气泡特征并定义其尺寸的方法。在PIV应用中,我们通常不显式提取粒子,因此该步骤可省略。
- 对于三维标量辅助粒子图像测速(3D SAPIV)应用,需将重建后的体积数据划分为更小的 interrogation 体积,并应用适当的基于互相关的PIV算法来测量矢量场1, 3。
a maketform:构建一个平面到平面的变换;imtransform:基于 maketform 生成的变换对图像进行映射和重采样。
结果
高质量的原始PIV图像中,粒子在黑色背景上均匀分布,并具有高对比度(图4a)。为了补偿图像中光照不均匀的问题,可对图像进行预处理,以去除亮区、调整对比度,并对所有相机采集的全部图像进行强度直方图归一化(图4b)。当实验粒子 seeding 密度适中且完成了精确校准时,SA 重聚焦图像将在每个深度平面上清晰显示处于焦点上的粒子(图5)。如果测量体积内粒子密度过高,重聚焦图像中的信噪比(SNR)将降低,从而难以重建粒子。对于信噪比较高的SA重聚焦图像,可通过设定阈值保留各深度平面上处于焦点的粒子。图6展示了在 Z = -10.6 mm 深度平面上两个时间步长的阈值处理后图像。随后,将阈值化后的体数据划分为若干 interrogation 体积,每个体积包含足够数量的粒子以进行PIV计算3。对划分后的体数据应用3DPIV算法,可得到如图7所示的流体速度场;本例中,该流场是由模型声带所诱导产生的。射流外部区域的流速非常小,因此该区域几乎看不到矢量。在 t = 0 毫秒时,声带处于闭合状态,流场中速度极低。在 t = 1 毫秒时,射流中最大速度沿正y方向运动,并从 t = 2 至 4 毫秒逐渐减弱。在 t = 5 毫秒时,声带再次闭合,射流速度降低,随后周期重复。这些图像的平滑程度不如许多先前研究者9所呈现的结果,因为此前的研究通常将多达100帧图像进行平均,而本文每一流场仅代表一个单一的时间快照。作为参考,以往的模拟研究表明,各速度分量的计算速度误差通常在5–10%左右,其中包括PIV算法本身的误差1;对于本研究采用的算法(为3D适配的MatPIV11),已知其误差相对于其他代码较大。
气泡流是另一个可受益于光场成像三维能力的科学研究领域。图8a 所示为采用漫射白光背光替代激光照明所获得的气泡流场图像,其中气泡边缘在白色背景上呈现为暗色。经过自校准后,可应用SA算法的乘法变体生成一个焦点堆栈,使气泡在其对应深度平面清晰聚焦,而在其他平面则模糊不可见,如图8b-d7所示。简单的阈值分割方法不足以有效提取气泡,因此需采用一系列先进的特征提取算法,具体细节见文献7。

图1. 带有标注和坐标系的摄像机与声带图像。

图2. 从全部8个相机视角观察到的 Z = 0 mm 处的校准网格。

图 3. 多相机自校准输出结果的相机布局顶视图。相机 1-8 以数字和圆圈标示位置,其大致观测方向由线条表示。靠近原点的红色斑点实际上是校准网格在每个 Z 深度处的 400 多个点,相对于相机在三维空间中的投影。

图4. 在时间点 t1 和 t2 从相机#6 观察到的颗粒场原始图像 (a & b)。相同图像经预处理后的结果 (c & d)。

图5. 从左至右:在深度 (a) Z = -5.9 mm、(b) -10.6 mm 和 (c) -15.3 mm 处获取的原始重聚焦SAPIV图像。

图6. 在 Z = -10.6 mm 处的时间步长 (a) t1 和 (b) t2 的阈值化图像。

图7. 合成声带产生的射流在6个时间步长下的三维矢量场。左侧显示整个三维速度场的等轴测视图。如每列上方所示,通过声带中心对x-y平面和y-z平面进行切片。

图8. 从左到右:来自相机阵列的气泡流场原始图像,以及在深度 (b) Z = -10 mm、(c) 0 mm 和 (d) 10 mm 处重新聚焦的图像。圆圈标示了一个位于 Z = -10 mm 深度平面上的气泡,在其他平面上则不可见。气泡实验的详细信息见文献4。
讨论
正确执行光场成像实验有几个关键步骤。应仔细选择镜头并合理布置相机位置,以在测量体积内实现最高的分辨率。校准可能是最关键的一步,因为若校准不准确,SA重聚焦算法将无法生成清晰对焦的图像。幸运的是,多相机自校准方法能够在相对较低的工作量下实现精确校准。此外,所有图像中均需提供均匀照明,使目标物体与背景之间具有良好的对比度,尽管图像处理可在一定程度上对图像进行归一化。
在对包含运动物体的体积进行SA时,时间同步也非常重要。如果每个相机未在同一时刻触发拍摄图像,图像重建结果显然会不准确。在本文的实验中,我们采用了图7所示的时间序列。
本文介绍的三维光场成像应用存在空间分辨率上的权衡。例如,三维SAPIV能够从光学上密集的粒子图像中重建粒子体积,但这些粒子分布在一个(可能很大)的体积空间内。而在二维PIV中,粒子分布于一个薄片状区域,因此具有相同粒子密度的图像在测量体积内对应的实际粒子密度要高得多。尽管如此,三维SAPIV方法所允许的示踪粒子密度仍远高于其他三维PIV方法1。另一个可能的限制因素是光场成像方法所涉及的较高计算强度;这种计算复杂性在基于图像的三维重建方法(如层析PIV)中较为典型10。
本实验采用8台Photron SA3相机,配备Sigma 105 mm微距镜头,以及一台Quantronix Dual Darwin Nd:YLF激光器(532 nm,200 mJ)。相机与激光器通过Berkley Nucleonics 575 BNC数字延时/脉冲发生器进行同步。流体流动中加入了Expancel氦气填充的玻璃微球作为示踪粒子,微球平均直径为70 μm,密度为0.15 g/cc。我们通过网站http://www.3dsaimaging.com/向学术界提供本文所用代码的开源版本,欢迎用户反馈意见,并参与改进和提供适用于定量光场成像领域的实用代码。
披露
我们没有需要披露的内容。
致谢
我们感谢美国国家科学基金会(NSF)授予的CMMI #1126862项目资助,用于资助杨百翰大学(BYU)的设备采购及合成孔径算法的开发;感谢海军水下作战中心纽波特分部(NUWC Newport)的内部实验室独立研究(ILIR)基金(由Tony Ruffa博士监督)对设备和开发工作的资助;感谢美国国立卫生研究院耳聋与其他沟通障碍研究所(NIH/NIDCD)R01DC009616项目对SLT、DJD和JRN以及与声带实验相关数据的资助;感谢德国埃尔朗根大学先进光学技术研究生院(SAOT)对SLT的部分支持。最后,感谢落基山NASA空间资助联盟对JRN的资助。
参考文献
- Belden, J., Truscott, T. T., Axiak, M., Techet, A. H. Three-dimensional synthetic aperture particle imaging velocimetry. Measurement Science and Technology. 21 (12), 125403(2010).
- Wilburn, B., Joshi, N., Vaish, V., Talvala, E. -V., Antunez, E., Barth, A., Adams, A., Horowitz, M., Levoy, M. High performance imaging using large camera arrays. ACM Trans. Graph. 24, 765-776 (2005).
- Raffel, M., Willert, C., Wereley, S., Kompenhaus, J. Particle image velocimetry - A Practical Guide. , Springer-Verlag. Berlin. (2007).
- Belden, J. Auto-Calibration of Multi-Camera Systems with Refractive Interfaces. Experiments in Fluids. , In Review (2013).
- Svoboda, T., Martinec, M., Pajdla, T. A convenient multi-camera self-calibration for virtual environments. PRESENCE: Teleoperators and Virtual Environments. 14 (4), 407-422 (2005).
- Synthetic aperture focusing using a shear-warp factorization of the viewing transfor. Vaish, V., Garg, G., Talvala, E., Antunez, E., Wilburn, B., Horowitz, M., Levoy, M. 3, 129(2005).
- Belden, J., Ravela, S., Truscott, T. T., Techet, A. H. Three-Dimensional Bubble Field Resolution Using Synthetic Aperture Imaging: Application to a Plunging Jet. Experiments in Fluids. , Accepted (2012).
- Levoy, M., Ng, R., Adams, A., Footer, M., Horowitz, M. Light field microscopy. ACM Transactions on Graphics. 25 (3), (2006).
- Triep, M., Brücker, C. Three-dimensional nature of the glottal jet. Journal of the Acoustical Society of America. 127, 1537-1547 (2008).
- Elsinga, G., Scarano, F., Wieneke, B., van Oudheusden, B. Tomographic particle image velocimetry. Experiments in Fluids. 41, 933-947 (2006).
- MatPIV [Internet]. , Available from: http://folk.uio.no/jks/matpiv/index2.html (2004).
重印与许可
