用于定位的方法 在体 蛋白质-DNA 相互作用对于基因组研究的各个方面正变得至关重要,但这类实验通常耗时、费力且成本高昂。本文介绍了一种市售的自动化液体处理系统,可实现染色质免疫沉淀的自动化操作,用于绘制 体内 使用有限数量的细胞研究蛋白质-DNA相互作用的方法被介绍。
本文内容
摘要
摘要
染色质免疫沉淀联合高通量测序(ChIP-seq)是研究蛋白质-DNA相互作用的首选技术。ChIP-seq已被广泛用于绘制蛋白质-DNA相互作用图谱以及定位组蛋白修饰。该实验流程繁琐且耗时,其主要局限之一是需要大量的起始材料,通常需数百万个细胞。当实验基于磁珠法进行时,染色质免疫沉淀的自动化成为可能。已有研究专门在一种 commercially available 的机器人液体处理系统上设计出成功的自动化染色质免疫沉淀及文库构建方案,该系统主要用于自动化表观遗传学检测。首先,已证实使用靶向多种组蛋白修饰的抗体进行自动化ChIP-seq检测的可行性,随后对该自动化流程进行了优化,使其能够从极低数量的细胞起始完成染色质免疫沉淀及文库构建。这些实验的目标是为未来特定细胞类型、细胞亚群以及活检样本的表观遗传学分析提供一种有价值的工具。
引言
随着下一代测序(NGS)技术的广泛应用和普及,全基因组范围内蛋白质-DNA相互作用的主要研究方法现已发展为染色质免疫沉淀联合NGS检测(ChIP-seq),该方法可用于发现转录因子结合位点或组蛋白修饰模式。ChIP-seq的优势在于能够提供全基因组的高通量数据,通过检测富集的DNA片段,实现对蛋白质-DNA相互作用的定性和定量分析。然而,标准ChIP-seq实验也存在一些局限性,例如难以获得足够的材料构建测序文库。
染色质免疫沉淀(ChIP)实验分为六个基本步骤,包括:1)交联蛋白质-DNA结合区域;2)样品制备,包括细胞裂解及通过超声处理剪切染色质;3)免疫复合物的形成;4)免疫复合物的沉淀;5)免疫复合物的洗涤;以及6)富集物质的洗脱,并通过qPCR和NGS进行分析。
ChIP 实验的成功取决于三个主要因素:良好的染色质制备、原始样品中抗原的含量,以及抗体对其对应抗原的特异性和亲和力。一个主要的限制是需要大量的起始细胞数量,以获得足够的富集 DNA 用于构建测序文库。对于使用有限样品量进行研究的科研人员,例如活检样本或细胞亚群,ChIP-seq 实验极具挑战性。最近的研究表明,在起始细胞数量较少的情况下仍可进行 ChIP-seq 实验1, 2。Diagenode 开发了一种可完全自动化 ChIP-seq 实验的机器人液体处理系统,适用于起始细胞数量有限的情况。
自动化相比手动制备ChIP-seq样品具有多种优势,可减少人为误差、降低实验变异性,并降低实验成本。已有研究报道了染色质免疫沉淀及文库构建的半自动化方案,但这些研究均未展示在使用少量细胞时的实验数据3, 4, 5, 6。
本文介绍了一种完全自动化的实验流程,适用于染色质免疫沉淀和文库构建实验,该流程在基于磁珠技术的液体处理机器人系统中进行,可针对实验方案优化中的多个参数进行操作。在此,研究人员成功利用有限数量的细胞进行了自动化的ChIP-seq实验,旨在简化操作、实现标准化,并为研究小规模细胞群体中的表观遗传谱提供可靠的解决方案。本文所述的自动化ChIP方案使用特定的组蛋白抗体和试剂在HeLa细胞上进行了优化,但该流程可通过相应的实验优化,适配于其他细胞系和抗体。
方案
1. 标准 ChIP 实验
- 细胞收集与DNA-蛋白质交联
- 将HeLa-S3细胞培养至80%-90%融合度。移除培养基,用10 ml 1×磷酸盐缓冲液(PBS)洗涤培养皿两次,向培养板中加入胰蛋白酶-EDTA(1×)。孵育最多2分钟,使细胞从培养皿上脱落。收集细胞,并用10 ml PBS洗涤两次。
注意:孵育时间过长会导致细胞损伤。 - 在500 × g条件下离心细胞5分钟,用20 ml PBS重悬细胞。随后进行细胞计数。
- 在500 × g条件下于4 °C离心5分钟,弃去上清液,加入500 μl PBS。固定步骤的最佳细胞数量为每500 μl PBS中含1000万个细胞。
- 向每份500 μl细胞悬液中加入13.5 μl新鲜的37%甲醛。在室温下固定细胞8分钟。
- 加入57 μl 1.25 M甘氨酸溶液以终止固定反应。在室温下轻轻涡旋混合,持续孵育5分钟。自此步骤起,所有操作均需在冰上进行。
- 在4 °C、500 × g条件下离心5分钟,弃去上清液,注意不要扰动细胞沉淀。
- 用1 ml PBS洗涤细胞两次。小心弃去上清液,将细胞沉淀置于冰上保存。
- 将HeLa-S3细胞培养至80%-90%融合度。移除培养基,用10 ml 1×磷酸盐缓冲液(PBS)洗涤培养皿两次,向培养板中加入胰蛋白酶-EDTA(1×)。孵育最多2分钟,使细胞从培养皿上脱落。收集细胞,并用10 ml PBS洗涤两次。
- 细胞裂解与染色质剪切
- 向细胞沉淀中加入10 ml预冷的裂解缓冲液iL1(最佳比例为每100万个细胞加入1 ml裂解缓冲液)。用移液器轻轻吹打数次,在4 °C下轻柔混匀并孵育10分钟。
- 在4 °C、500 × g条件下离心裂解物5分钟,弃去上清液。
- 向沉淀中加入10 ml预冷的裂解缓冲液iL2,通过上下吹打轻轻混匀。在4 °C下孵育裂解物10分钟。
- 在4 °C、500 × g条件下离心5分钟,弃去上清液。
- 通过向iS1剪切缓冲液中加入200×蛋白酶抑制剂混合物(PIC)配制完整的剪切缓冲液。将缓冲液置于冰上5分钟,之后所有操作均在冰上进行。每1000万个细胞沉淀中加入1 ml完整的iS1剪切缓冲液,通过上下吹打轻轻混匀。超声处理前,将样品在冰上孵育10分钟以降低样品黏度。
- 使用水浴超声仪对300 µl染色质分装样品进行超声剪切,进行2至3轮,每轮10个循环。每个循环包括30秒“开启”和30秒“关闭”,设置为高功率。或者,可使用Pico超声设备,缩短超声时间为5至10个循环,每个循环同样为30秒“开启”和30秒“关闭”。每次超声运行之间短暂涡旋并离心管体。若使用其他类型的超声仪,请遵循相应制造商关于染色质剪切的操作说明。
- 在16,000 × g条件下离心剪切后的染色质10分钟,收集上清液,立即用于后续免疫沉淀(IP)步骤。或者,可将染色质在-80 °C保存,最长可达2个月,以备后续使用。
- 在免疫沉淀步骤之前,使用1-1.5% TAE琼脂糖凝胶或生物分析仪检测染色质剪切效率。理想的染色质片段大小应在100-600 bp之间。
2. 低细胞量 ChIP 实验
- 细胞收集与 DNA-蛋白质交联
- 将 HeLa-S3 细胞培养至 80%–90% 汇合度。移除培养基,用 10 ml 1× 磷酸盐缓冲液 (PBS) 洗涤培养皿两次,向培养板中加入 1× 胰蛋白酶-EDTA。孵育最多 2 分钟,使细胞从培养皿上脱落。
注意:孵育时间过长会导致细胞损伤。 - 加入含血清的 1 ml 培养基至 1 ml 离心管中收集细胞。计数细胞。
- 以 500 × g 离心 5 分钟。将细胞浓度调整为每毫升培养基含 10,000 个细胞,用于固定。
- 向每管中加入 27 μl 新鲜配制的 36.5% 甲醛溶液进行固定。轻轻倒置混匀 2–3 次,室温孵育 10 分钟。
- 向样品中加入 115 μl 1.25 M 甘氨酸溶液,倒置混匀 2–3 次,室温孵育 5 分钟。此后所有操作均需在冰上进行。
- 在 4 °C 下以 300 × g 离心 10 分钟。缓慢弃去上清液。
- 用含蛋白酶抑制剂混合物 (PIC, 200×, 最终浓度为 1×) 的 1 ml 冰冷 HBSS 洗涤细胞。倒置混匀 2–3 次以重悬细胞,在 4 °C 下以 300 × g 离心 10 分钟。轻柔弃去上清液,将细胞沉淀置于冰上保存。
- 将 HeLa-S3 细胞培养至 80%–90% 汇合度。移除培养基,用 10 ml 1× 磷酸盐缓冲液 (PBS) 洗涤培养皿两次,向培养板中加入 1× 胰蛋白酶-EDTA。孵育最多 2 分钟,使细胞从培养皿上脱落。
- 细胞裂解与染色质剪切
- 每 10,000 个细胞加入 25 μl 完全裂解缓冲液 tL1 (裂解缓冲液 tL1 + PIC),手动振荡管底以重悬细胞。冰上孵育 5 分钟。
- 向每份含 10,000 个细胞的样品中加入 75 μl 完全 HBSS 缓冲液 (HBSS + PIC)。
- 对含 10,000 个细胞的 100 μl 样品进行超声剪切,共 5 组,每组 5 个循环。每个循环包括高功率设置下 30 秒“开启”和 30 秒“关闭”。或者,使用微孔超声设备,以更短的超声时间进行剪切(5 个循环,每个循环 30 秒“开启”,30 秒“关闭”)。最佳染色质片段大小应在 100–600 bp 范围内。需注意,不同染色质制备样品、细胞类型及超声设备需分别优化剪切条件。
- 以 14,000 × g 离心 10 分钟,去除不溶性物质,收集上清液并立即用于免疫沉淀步骤。或者,可将染色质在 -80 °C 保存最多 2 个月以备后续使用。
- 在进行免疫沉淀前,使用 1–1.5% TAE 琼脂糖凝胶或生物分析仪检测染色质剪切效率。在进行琼脂糖凝胶分析前,需用 RNase 处理样品,以提高对剪切效果的视觉评估。最佳染色质片段大小应在 100–600 bp 范围内。
3. 染色质免疫沉淀与文库制备
- 用于标准的自动化染色质免疫沉淀实验
- 添加 120 μl ChIP缓冲液H(ChIP缓冲液H + PIC)的 100 μl 剪切后的染色质。使用 200 μl 用于免疫沉淀并保存 2 μl 至 20 μl 作为输入样本。
- 选择自动化 ChIP 200 μl 自动化仪器中的实验方案。该方案每次运行可处理1至16个样本。
- 使用对应于100万至200万细胞的染色质,运行一次自动化的ChIP实验,2 μg 抗H3K79me3、-H3K27me3、-H3K4me3、-H3K4me2、-H3K9ac、-H3K9/14ac、-H3K36me3和H3K9me3的ChIP-seq级兔多克隆抗体。最佳抗体用量因组蛋白修饰类型及相应抗体的亲和力与特异性而异。
- 使用等量的非免疫兔IgG作为同型对照抗体。或者,使用未包被的磁珠或特异性封闭的抗体作为ChIP对照。添加 20 μl 每反应使用蛋白A包被的磁珠
- 使用自动化组蛋白ChIP-seq试剂盒试剂,采用抗H3K79me3和H3K4me2多克隆抗体进行自动化ChIP实验。使用理想的ChIP-seq试剂盒试剂,采用抗H3K27me3、H3K4me3、H3K9ac、H3K9/14ac、H3K36me3和H3K9me3抗体进行ChIP实验。
- 根据自动化设备中预设的软件指令选择自动化的ChIP程序。将ChIP实验参数设置为:抗体包被步骤4小时,免疫沉淀步骤15小时。逆转交联步骤在自动化仪器中进行 65 °C 4小时
- 在自动化系统上纯化反向交联的DNA。选择基于磁珠法DNA纯化的自动化DNA纯化方案或试剂盒的相应程序。用洗脱液洗脱DNA 25 μl 的水。
- 通过提取免疫沉淀DNA的10%来定量。免疫沉淀DNA的得率取决于染色质和抗体的质量、细胞类型以及目标组蛋白修饰。根据制造商说明书,使用试剂盒对DNA进行定量。
- 使用针对至少1个阳性对照和1个阴性对照基因组区域的引物,通过定量PCR分析免疫沉淀DNA的质量。用于评估ChIP富集度的免疫沉淀DNA总量不得超过10%。
- 配制qPCR反应体系。加入 10 μl 2x SyberGreen qPCR 预混液 1 μl 引物混合物,1-5 μl 免疫沉淀或输入DNA以及无菌水,补至 20 µl 最终反应体系体积。qPCR 程序包括初始变性步骤,于 95 °C 根据所选引物设定退火温度,Taq 聚合酶的延伸时间应依据供应商建议设定,通常为 5–10 分钟。
- 使用与市售Illumina ChIP-seq文库制备试剂兼容的自动化文库构建方案,利用同一染色质样品的ChIP DNA以及保存的input DNA分别构建文库。每种抗体的免疫沉淀DNA使用10–20 ng用于文库构建。每次运行最多可制备16个自动化文库。
- 根据Illumina制造商的说明对文库进行测序并生成簇。进行初级生物信息学分析(簇过滤、碱基识别, 等等。按照标准的Illumina流程,使用ELAND比对程序将测序读段过滤并比对至最新的人类基因组组装版本(当前版本为GRCh38)。使用SICER7 或 MACS8 用于峰区识别,并使用Homer对峰区进行下游分析9,BEDTools10 或首选软件。
- 适用于低细胞数量的自动化ChIP实验
- 添加 120 μl 加入完整的ChIP缓冲液tC1(ChIP Buffer tC1 + PIC) 100 μl 剪切后的染色质。使用 200 μl 用于免疫沉淀并保存 20 μl 作为输入。
- 选择自动化染色质免疫沉淀(ChIP) 200 μl 自动化系统中的实验方案。该方案每次运行可处理1至16个样本。
- 使用经优化可用于低量染色质的自动化 ChIP 试剂和 ChIP 级抗体,开展自动化 ChIP-seq 实验。分别使用相当于 10,000 个细胞和 100,000 个细胞的染色质进行实验。 0.5 μg 抗H3K27me3 0.25 μg -H3K4me3, 0.1 μg - H3K27ac 0.25 μg -H3K9me3兔源Premium ChIP-seq级别兔多克隆抗体。最佳抗体用量因组蛋白修饰类型及相应抗体的亲和力和特异性而异。
- 使用等量的非免疫兔IgG作为同型对照抗体。或者,使用未包被的磁珠或特异性封闭的抗体作为ChIP对照。添加 10 μl 每反应使用蛋白A包被的磁珠。
- 根据自动化设备中实施的软件说明选择自动化的ChIP程序。将ChIP实验参数设置为:抗体包被步骤4小时,免疫沉淀步骤15小时。逆转交联步骤在自动化仪器中进行,于 65 °C 4小时。
- 使用离心柱按照制造商说明书纯化反向交联的DNA,并用指定体积洗脱 6 μl 到 25 μl 水。
- 使用商业试剂盒定量DNA。利用针对阳性和阴性对照区域的引物,通过qPCR分析结果,以评估ChIP质量。
- 使用经过优化的文库制备试剂盒对低量DNA进行文库构建。文库制备时分别使用30 pg和300 pg的ChIP DNA(分别对应10,000和100,000个细胞的实验)。采用与文库制备试剂兼容的自动化流程进行文库构建。自动化文库制备通量为每轮运行可处理1至48个文库。
- 双链DNA模板末端修复后,连接含有测序引物位点的可切割茎环接头。DNA延伸步骤完成后,按照文库构建试剂盒说明书中的高保真扩增方法对样本进行扩增。
- 文库扩增后,根据文库制备试剂盒的说明书对文库进行定量和纯化。注意:纯化后的片段大小选择步骤并非必需。
- 按照制造商的说明对文库进行测序并生成簇。进行初级生物信息学分析(簇过滤、碱基识别, 等等。按照标准的制造商流程进行过滤,并使用ELAND将测序读段比对至最新的人类基因组组装版本(当前为GRCh38)7 校准器。使用 SICER8 或 MACS9 用于峰识别,并使用 Homer 和 BEDTools 进行峰的下游分析10或任何其他首选软件。
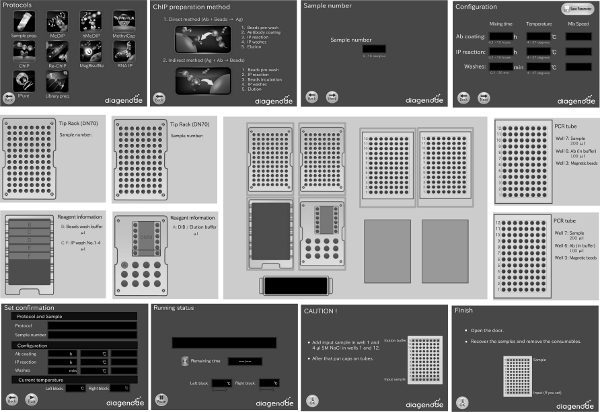
图1. 软件截图,展示如何在IP-Star Compact中设置自动化的ChIP实验。 该软件可灵活选择每次运行的样本数量,并可根据研究人员的需求调整关键实验参数(抗体包被、免疫沉淀及洗涤步骤)。自动化程序支持并行测试不同条件。即同一次实验中,不同类型的抗体、不同数量的抗体、不同类型的细胞、不同数量的细胞,甚至不同类型的磁珠和不同数量的磁珠。 请点击此处以查看此图的放大版本。
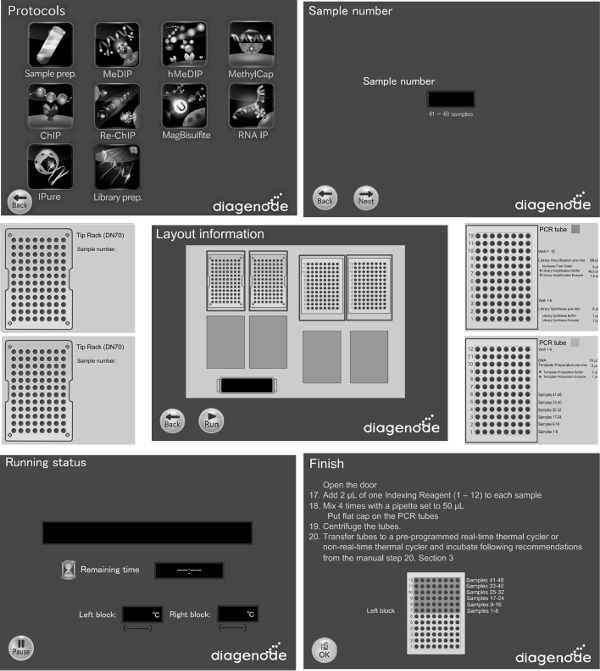
图2. 软件界面截图,展示如何在自动化系统中使用文库构建试剂盒设置下一代测序的自动化文库制备流程。 请点击此处查看该图的放大版本。
结果
针对八种不同组蛋白标记优化自动化 ChIP-seq 实验
为了成功开发和验证自动化ChIP方案,选择了先前在手动ChIP-Seq实验中已验证过的ChIP-seq级别抗体(数据未显示)。本研究选用的ChIP-seq级别抗体包括:抗H3K79me3、-H3K27me3、-H3K4me3、-H3K4me2、-H3K9ac、-H3K9/14ac、-H3K36me3和-H3K9me3。所有ChIP-seq级别抗体的特异性此前均已通过点印迹、肽阵列和Western Blot实验确认(数据未显示)。通过使用不同抗体用量进行预实验ChIP-qPCR,以确定抗体的灵敏度(图3)。分析至少两个阳性与两个阴性对照靶点的qPCR结果,阳性靶点富集程度高于阴性靶点五倍以上的样本方可用于测序实验。进行ChIP和ChIP-seq实验时,必须使用高质量的剪切染色质。本出版物中展示的所有ChIP实验均使用新鲜制备的染色质完成。也可将固定后的细胞在-80 °C下冷冻保存,并于另一天继续进行染色质提取和剪切。然而,由冷冻固定细胞制备的染色质可能与新鲜制备的染色质行为不同,因此每次染色质制备可能需要优化超声处理条件。在处理不同细胞类型时,可使用含有不同去垢剂成分(SDS)的剪切缓冲液。例如,原代细胞系或悬浮培养细胞属于较难剪切的细胞类型,需要较高浓度的SDS(1%),而易于剪切的细胞系(如HeLa细胞)则仅需较低浓度的SDS(0.1%)即可满足剪切需求。
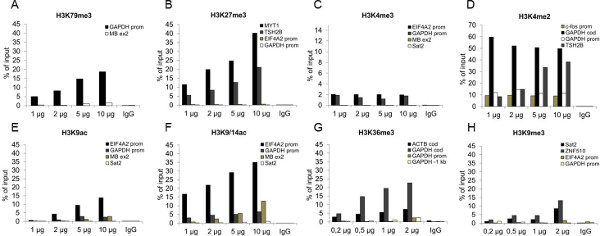
图3. 使用自动化系统验证适用于ChIP实验的抗体。 针对不同的组蛋白修饰,在100万个HeLa-S3细胞来源的剪切染色质上,分别使用抗H3K79me3、-H3K27me3、-H3K4me3、-H3K4me2、-H3K9ac、H3K9/14ac、-H3K36me3和-H3K9me3兔多克隆抗体进行ChIP实验。抗体滴定实验采用自动化仪器中工作体积为200 µl的自动ChIP方案。每个ChIP实验测试了1、2、5和10 μg的抗体用量,每个实验均以2 μg IgG作为阴性对照。通过qPCR评估富集程度。结果以输入DNA的百分比表示(即qPCR分析后,免疫沉淀DNA相对于输入DNA的相对量)。请点击此处查看该图的放大版本。
在验证并确定自动化系统中ChIP级抗体的最佳使用量后,进行了自动化的ChIP-seq实验,以生成每种组蛋白修饰的测序谱图(图4)。
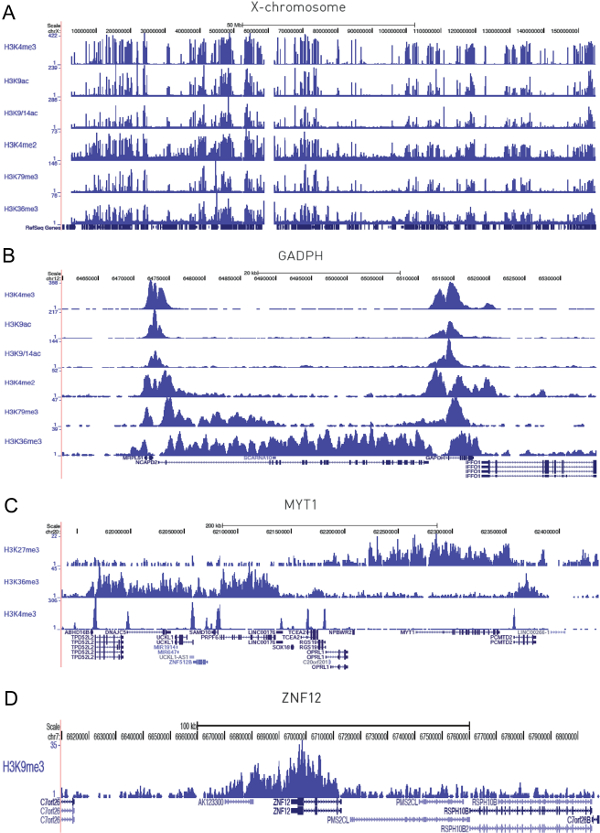
图 4. 由自动化 ChIP-seq 实验生成的组蛋白 ChIP-seq 谱图。 该图展示了 H3K4me3、H3K9ac 和 H3K9/14acH3K4me2、H3K79me3 以及 H3K36me3 在不同基因组区域的 ChIP-seq 谱图。4A 显示了沿整个 X 染色体的峰分布,4B 显示了围绕 GAPDH 基因的 75 kb 区域内的分布情况。4C 显示了围绕 MYT1 基因的 500 kb 区域内 H3K27me3、H3K36me3 和 H3K4me3 的谱图,4D 显示了围绕 ZNF12 基因的 200 kb 区域内 H3K9me3 的分布情况。请点击此处查看该图的放大版本。
生成了与基因表达相关的六种不同组蛋白修饰的组蛋白表观遗传谱(H3K4me3、H3K9ac、H3K9/14ac、H3K4me2、H3K79me3 和 H3K36me3)。图4A展示了不同组蛋白标记沿X染色体的ChIP-seq谱图。六种不同组蛋白谱图之间观察到的高度峰相关性,表明该自动化系统具备生成准确且可靠数据的能力。图4B、图4C和图4D展示了不同组蛋白修饰在特定基因组区域的峰分布情况。
低至200个细胞的自动化染色质免疫沉淀实验
ChIP 实验中可使用的最低细胞数量取决于染色质的质量、抗体的特异性和灵敏度,以及所研究的组蛋白修饰或蛋白质的丰度。在样本量有限的情况下,选择优质的 ChIP-seq 级抗体至关重要,同时选用最佳试剂和不同载体可提高 DNA 回收效率,有助于 ChIP 实验的成功。为了确定自动化 ChIP 流程可处理的最低细胞数量,使用 IP-Star 自动化系统测试了不同数量的染色质、抗体和磁珠,所用 ChIP 试剂已专门优化,适用于低量染色质的实验条件。
首先,按照方案所述对10,000个细胞的染色质进行超声处理。染色质免疫沉淀(ChIP)结果通过qPCR验证(图5A),显示H3K4me3抗体在阳性对照区域有显著富集,而在阴性对照区域信号可忽略不计。为进行比较并证明结果的一致性,还提供了使用10,000个细胞并分别采用H3K27ac、H3K9me3和H3K27me3抗体获得的额外数据。
随后进行了自动化的染色质免疫沉淀(ChIP)实验,以验证该自动化系统在使用相同H3K4me3抗体的情况下,能够有效处理少量细胞的能力。自动化ChIP实验结果良好,连续进行的十次免疫沉淀(IP)反应显示出良好的可重复性,并且与手动ChIP结果高度一致(图5B)。通过开展手动与自动化实验,发现自动化方案的优势在于可显著降低实验间变异(图5C)。
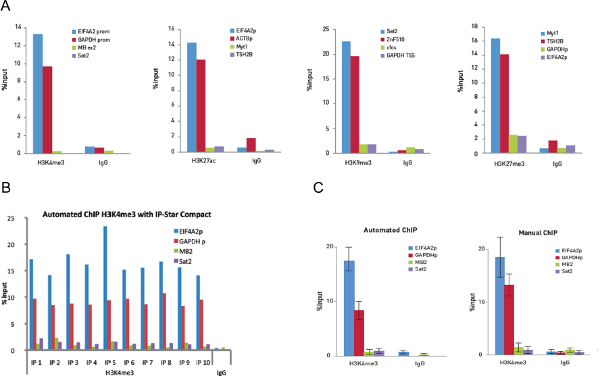
图5. 在10,000个细胞上优化ChIP与自动ChIP实验 在10,000个细胞上进行手动ChIP实验,使用0.25 μg H3K4me3、0.1 μg H3K27ac、0.5 μg H3K9me3和0.25 μg H3K27me3抗体。使用相同数量的兔IgG作为对照。qPCR使用针对每个ChIP实验的两个阳性位点和两个阴性位点的引物进行。图5A 显示回收率,以输入量的百分比表示(qPCR分析后,免疫沉淀DNA相对于输入DNA的相对量)。图5B 显示在IP-Star Compact仪器上运行的10次ChIP反应,使用0.25 μg H3K4me3多克隆抗体和0.25 μg兔IgG作为阴性对照抗体。随后使用针对EIF4A2启动子和GAPDH转录起始位点(TSS)的阳性位点引物,以及针对肌红蛋白exon2和Sat2的阴性位点引物进行qPCR分析。该图显示回收率,以输入量的百分比表示(qPCR分析后,免疫沉淀DNA相对于输入DNA的相对量)。图5C 显示10次手动ChIP实验与10次自动化ChIP实验的H3K4me3 ChIP数据比较。误差线代表十次重复实验的标准偏差。请点击此处查看该图的放大版本。
为了了解自动化ChIP方案的灵敏度,实验中使用的细胞数量从每IP 100,000个细胞逐步减少至200个细胞。实验采用抗H3K27me3抗体,因为这是一种非常常见的组蛋白修饰。使用其他组蛋白或非组蛋白抗体时,所需细胞数量可能更多或更少,具体取决于表位的丰度及抗体的质量。实验通过定量PCR进行验证,结果表明,通过减少实验中磁珠和抗体的用量,可降低背景信号,从而在低至200个细胞的情况下仍能获得成功的ChIP-qPCR结果(图6)。
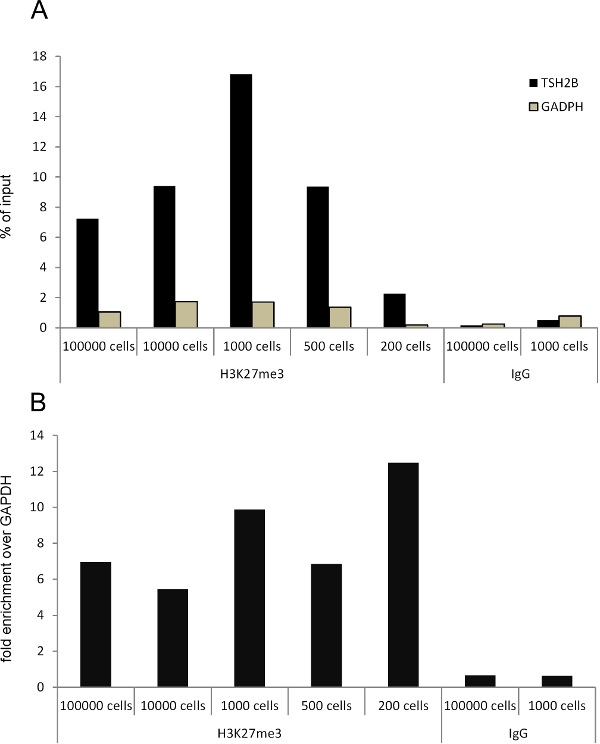
图6. 在200个细胞上进行的自动化ChIP实验。使用HeLa-S3细胞及靶向H3K27me3的抗体。染色质来源于100万个细胞,并对这些染色质进行系列稀释(相当于10万至200个细胞的数量),用于每项ChIP反应。在10万细胞实验中使用1 µg H3K27me3抗体和10 μl蛋白A包被的磁珠;在1万和1千细胞实验中使用0.5 µg H3K27me3抗体和10 µl磁珠;在500和200细胞实验中使用0.25 µg H3K27me3抗体和5 µl磁珠。分别在10万细胞和1千细胞实验中使用1 µg和0.5 µg兔IgG作为阴性对照抗体。6A显示TSH2B和GAPDH基因相对于输入DNA的结合占有率(%)。6B显示TSH2B相对于阴性对照基因组区域GAPDH的相对结合占有率。
基于10,000个细胞的ChIP-seq结果的下游分析
为了评估起始细胞数量较少时自动化 ChIP-seq 实验的整体质量,使用 10,000 个 HeLa 细胞和 0.25 µg H3K4me3 抗体进行了自动化 ChIP-seq 检测,同时以 100,000 个 HeLa-S3 细胞的 ChIP 实验作为该实验的阳性对照。自动化文库的构建采用 MicroPlex 文库构建试剂盒的试剂,该试剂盒已针对低量 DNA 样本的文库制备进行了优化。需要注意的是,尽管使用少于 10,000 个细胞仍可成功完成自动化 ChIP 实验,但所获得的 DNA 量不足以使用该试剂盒的试剂进行文库构建。簇生成和测序均按照制造商的说明进行。测序后的生物信息学分析显示,低细胞数量的 ChIP 样本获得了出色的结果。30 pg 数据集(对应于 10,000 个细胞的起始材料)背景噪声低,富集峰高度可靠,且该结果在 300 pg 数据集(对应于 100,000 个细胞的起始材料)以及由 Broad 研究所为 ENCODE 项目生成的 H3K4me3 数据集中得到了验证,后者被用作外部参考。需要特别指出的是 Top 40 重叠率数据,这是 ENCODE11 项目中使用的一种标准方法:当比较两个数据集时,若按显著性评分排序的前 40% 峰中至少有 80% 的重叠,则认为 ChIP-seq 实验具有可重复性。30 pg 数据集在与 300 pg 数据集(考虑其全部峰,而不仅是前 40% 的峰)以及 Broad 研究所数据进行比较时均满足该标准(表 1)。300 pg 数据集与 Broad 研究所数据的峰几乎完全一致,Top 40 重叠率达到 98%(图 7)。
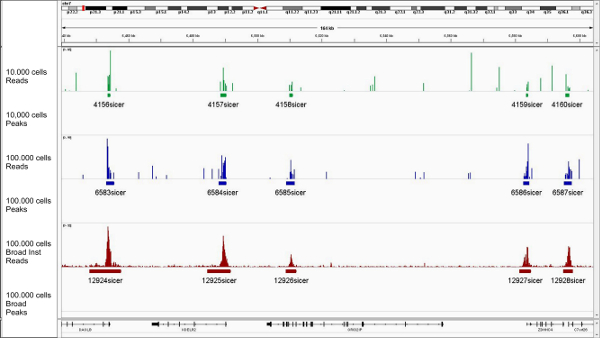
图7. 在10,000个细胞上进行的ChIP实验及文库构建 使用H3K4me3抗体(0.25 µg/µl)在10,000和100,000个HeLa-S3细胞上进行了ChIP-seq实验。将35 bp的标签通过ELAND比对工具比对至人类基因组。在后续的峰识别分析中,SICER能够可靠地从少量细胞以及数百万细胞中识别出富集区域。这些数据集相互之间进行了分析和比较,并与Broad研究所生成的参考数据进行了比对。低细胞数量样本的结果具有一致性且高度相似。30 pg样本满足ENCODE标准11(前40%的峰中至少有80%应相互重叠)。请点击此处查看该图的放大版本。
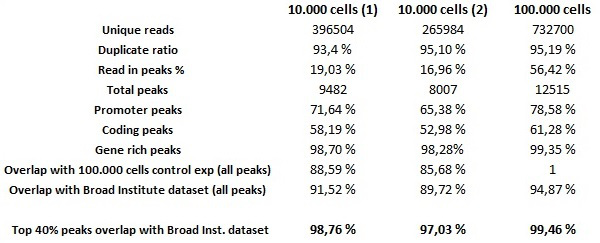
表 1.
讨论
染色质免疫沉淀结合测序现已成为一项标准实验流程。本文介绍了一种自动化 ChIP-seq 方案,仅需 10,000 个起始细胞即可生成染色质表观遗传学图谱。
自动化ChIP及文库制备实验可实现ChIP优化流程的标准化,并降低实验变异性。本文介绍的液体处理系统消除了与ChIP相关的大量手动操作,将实际操作时间缩短至仅30分钟,最大限度减少样品损失,并仅需数皮克的文库投入量即可实现精确的ChIP-seq。为了成功开展自动化的ChIP-seq实验,每次实验中使用高质量的剪切染色质样品以及适用于ChIP-seq级别的抗体也至关重要。该系统采用基于磁珠的技术,具有灵活性,可调整主要实验参数,例如抗体包被和免疫沉淀步骤的孵育时间,或洗涤条件的修改,使研究人员能够完成ChIP-seq优化所需的所有必要实验。该自动化系统是一个“开放”平台,允许并行比较多种试剂,以针对每种特定细胞系和抗体优化实验条件,同时能够直接比较不同类型和浓度的染色质、不同抗体,甚至不同类型的磁珠。
自动化系统的一个局限性在于需要将所有实验方案的体积范围在5 μl至200 μl之间实现自动化。然而,该自动化平台的实验微型化也有助于节省试剂成本。
除了本研究中描述的实验方案外,该系统还具有适应性,可自动化完成多种其他基于磁珠的应用,如免疫沉淀、甲基化DNA的捕获(MeDIP和MethylCap技术)、羟甲基化DNA的免疫沉淀(hMEDIP)、连续染色质免疫沉淀(ReChIP)、RNA免疫沉淀(RNA-IP)、亚硫酸氢盐转化以及DNA纯化检测。
披露
本文作者在撰写本文时受雇于 Diagenode S.A. 和 Diagenode, Inc.,即文中所述自动化系统的制造商。
致谢
本工作由欧盟BLUERPINT资助项目(BLUEPRINT——造血表观基因组蓝图)资助。我们还感谢瓦隆大区(DG06)提供的资金支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| PBS | Life technologies | 14190-094 | |
| 胰蛋白酶-EDTA | Sigma | T3924-100ML | |
| 37% 甲醛 | Sigma | F8775-25 | |
| 1.25 M 甘氨酸溶液 | Diagenode | C01020010 | ideal ChIP-seq 试剂盒的组分 |
| 裂解缓冲液 iL1 | Diagenode | C01020010 | ideal ChIP-seq 试剂盒的组分 |
| 裂解缓冲液 iL2 | Diagenode | C01020010 | ideal ChIP-seq 试剂盒的组分 |
| 剪切缓冲液 iS1 | Diagenode | C01020010 | ideal ChIP-seq 试剂盒的组分 |
| 蛋白酶抑制剂混合物 (200x) | Diagenode | C01010130 | Auto True Micro ChIP 试剂盒的组分 |
| HBSS(无钙、无镁、无酚红) | Life technologies | 14175-053 | |
| 裂解缓冲液 tL1 | Diagenode | C01010130 | Auto True Micro ChIP 试剂盒的组分 |
| ChIP 缓冲液 tC1 | Diagenode | C01010130 | Auto True Micro ChIP 试剂盒的组分 |
| ideal ChIP-seq 试剂盒 | Diagneode | C01010051 | |
| ChIP-缓冲液 H | Diagenode | C01010020 | Auto Histone ChIP-seq 试剂盒的组分 |
| Auto Histone ChIP-seq 试剂盒 | Diagenode | C01010020 | |
| Auto True Micro ChIP 试剂盒 | Diagenode | C01010130 | |
| H3K79me3 多克隆抗体-经典型 | Diagenode | C15310068 | |
| H3K27me3 多克隆抗体-经典型 | Diagenode | C15410069 | |
| H3K4me3 多克隆抗体-经典型 | Diagenode | C15410030 | |
| H3K4me2 多克隆抗体-经典型 | Diagenode | C15410035 | |
| H3K9ac 多克隆抗体-优质型 | Diagenode | C15410004 | |
| H3K9/14ac 多克隆抗体-优质型 | Diagenode | C15410200 | |
| H3K36me3 多克隆抗体-优质型 | Diagenode | C15410058 | |
| H3K9me3 多克隆抗体-优质型 | Diagenode | C15410193 | |
| 兔 IgG | Diagenode | C15410206 | |
| 蛋白A包被的顺磁珠 | Diagenode | C01010020 | |
| Auto IPure | Diagenode | C03010010 | |
| MicroChIP DiaPure 柱 | Diagenode | C03040001 | |
| 通用 SyberGreenMaster Mix 1.25 ml | Diagenode | DMMLD2D100 | |
| Quant-IT dsDNA | Invitrogen | Q32854 | |
| 基因组 DNA 的 Illumina 样品制备试剂盒 | Illumina | FC-121-3001 | |
| Illumina True-seq ChIP 文库制备试剂盒 | Illumina | IP-202-1012 | |
| MicroPlex 文库制备试剂盒 | Diagenode | C05010010 | |
| Agencourt AMPure XP 磁珠 | Beckman Coulter | A63881 | |
| Illumina 文库制备定量试剂盒 | Kapa Biosystems | KK4844 | |
| IP-Star Compact 自动化系统 | Diagenode | B03000002 | |
| Bioruptor Plus | Diagenode | B01020001 | |
| Bioruptor Pico | Diagenode | B01060001 | |
| Qubit 系统 | Invitrogen | Q32857 | |
| Illumina Hiseq 系统 | Illumina |
参考文献
- Dahl, J. A., Collas, P. A rapid micro chromatin immunoprecipitation assay (microChIP). Nature Protocols. 3, 1032-1045 (2008).
- Adli, M., Bernstein, B. E. Whole-genome chromatin profiling from limited numbers of cells using nano-ChIP-seq. Nature Protocols. 6, 1656-1668 (2011).
- Blecher-Gonen, R., et al. High-throughput chromatin immunoprecipitation for genome-wide mapping of in vivo protein-DNA interactions and epigenomic states. Nature Protocols. 8, 539-554 (2013).
- Aldridge, S., et al. AHT-ChIP-seq: a completely automated robotic protocol for high-throughput chromatin immunoprecipitation. Genome Biology. 14, 124(2013).
- Farias-Hesson, E., et al. Semi-automated library preparation for high-throughput DNA sequencing platforms. Journal of Biomedicin., & Biotechnology. 2010, (2010).
- Callejas, S., Alvarez, R., Benguria, A., Dopazo, A. AG-NGS: a powerful and user-friendly computing application for the semi-automated preparation of next-generation sequencing libraries using open liquid handling platforms. BioTechniques. 56, 28-35 (2014).
- Zang, C., et al. A clustering approach for identification of enriched domains from histone modification ChIP-Seq data. Bioinformatics. 25, Oxford, England. 1952-1958 (2009).
- Zhang, Y., et al. Model-based analysis of ChIP-Seq (MACS). Genome Biology. 9, 137(2008).
- Heinz, S., et al. Simple combinations of lineage-determining transcription factors prime cis-regulatory elements required for macrophage and B cell identities. Molecular Cell. 38, 576-589 (2010).
- Quinlan, A. R., Hall, I. M. BEDTools: a flexible suite of utilities for comparing genomic features. Bioinformatics (Oxford, England). 26, 841-842 (2010).
- Landt, S. G., et al. ChIP-seq guidelines and practices of the ENCODE and modENCODE consortia. Genome Research. 22, 1813-1831 (2012).
重印与许可
