本方案概述了一种比较方法 从头合成 面向初学者的生物信息学转录组组装与注释工作流程。该工作流程完全通过 CyVerse 免费提供,并通过数据存储系统进行连接。流程中使用命令行和图形用户界面,但所需全部代码均可直接复制粘贴使用。
本文内容
摘要
摘要
该工作流程可使初级研究人员利用云计算等先进计算资源开展成对比较转录组学分析,同时也可作为生物学家培养数据科学家所需计算技能的入门指南。 例如 执行 bash 命令、大规模数据集的可视化与管理。所有命令行代码以及每条命令或步骤的进一步说明均可在 wiki 上找到https://wiki.cyverse.org/wiki/x/dgGtAQ)。Discovery Environment 平台与 Atmosphere 平台通过 CyVerse 数据存储系统相互连接。因此,一旦原始测序数据上传完成,便无需再通过互联网传输大型数据文件,从而最大限度地减少了开展分析所需的时间。本实验方案仅适用于分析两种实验处理或条件。差异基因表达分析通过成对比较进行,不适合用于检验多个因素。该工作流程设计为手动操作而非自动化流程。用户必须亲自执行并检查每一步操作,从而更深入地理解数据和分析结果,进而获得更优的分析成效。完成本方案后,将获得 从头合成 为缺乏研究资源的非模式生物组装转录组,无需比对到先前已组装的参考基因组(此类参考基因组在缺乏研究资源的生物中通常不可获得)。这些 从头合成 转录组进一步用于成对差异基因表达分析,以研究两种实验条件下存在差异的基因。随后对差异表达基因进行功能注释,以理解生物体对实验条件产生的遗传响应。总体而言,本方案所获得的数据可用于检验有关非模式生物生物学响应的假设。
引言
Homo sapiens 以及若干关键的模式动物物种,例如 Drosophila melanogaster、Mus musculus 和 Danio rerio,代表了当前及以往大部分功能基因组学的研究工作。然而,随着高通量测序技术成本的迅速降低,非模式(又称"被忽视的"或"研究不足的")动物物种的功能基因组学研究正迎来新的机遇1。这一转变在基因组学领域具有重要意义,因为非模式生物常常代表具有重要经济价值的物种(例如牡蛎、虾、蟹),并为探索超出模式物种范围的新表型和生物系统提供了可能。
尽管非模式生物为研究独特的生物系统提供了极具吸引力的机会,但研究人员在进行生物信息学分析时仍面临诸多挑战。其中一些挑战源于大规模数据集的处理本身,而另一些则是因为研究这些非模式生物的科研人员缺乏可用的遗传资源,例如参考基因组、物种特异的本体数据库等(etc.)。与数据分析的挑战相比,核酸提取和测序过程往往已属常规操作;因此,生物信息学分析通常成为测序项目中最被低估的成本2。例如,一项基础的高通量测序生物信息学分析可能包括以下步骤:对原始测序读长进行质量过滤和修剪,将短读长拼接成更长的连续序列片段,以及通过注释和/或与其他系统比较以获得生物学意义。尽管看似简单,但这一示例性工作流程需要具备专业领域的知识和超出普通实验台计算机能力的计算资源,使得许多从事非模式生物研究的科学家难以开展此类分析。
先天性挑战可能源于基础设施或知识层面。典型的基础设施挑战是难以获得适当的计算资源。例如,基因组组装与注释依赖于计算密集型算法,需要配备大量内存(256 GB–1 TB)和多个处理器/核心的高性能计算机或计算机集群才能运行。然而,许多研究人员要么无法获得此类计算资源,要么缺乏操作这些系统所需的知识。另一些研究人员虽可通过其大学或机构获得高性能计算集群的使用权限,但对这些资源的访问可能受到限制,有时还需按计算时长付费。 即 CPU 处理器数量乘以实时数量 "时钟小时" 这些处理器正在运行。利用由美国国家科学基金会资助的网络基础设施系统(如CyVerse)3 为美国及全球研究人员提供免费计算资源访问权限的平台,可帮助缓解基础设施方面的挑战,这一点将在下文得到证实。
典型的基于知识的挑战之一是理解完成完整分析所需的软件。为了有效开展基于测序的研究项目,研究人员需要熟悉为生物信息学分析而开发的大量软件工具。学习每一个软件包本身已属不易,而由于这些软件包不断升级、重新发布、整合为新的工作流程,有时还因新许可证的限制而无法自由使用,这一难度进一步加剧。此外,连接这些工具的输入与输出有时需要转换数据类型以确保兼容性,从而不得不在工作流程中额外引入其他工具。最后,确定哪个软件包在特定分析中“最佳”也十分困难,通常在特定实验条件下选择最优软件依赖于细微的差异。在某些情况下,虽然已有相关的软件综述可供参考,但由于新版本和新软件选项持续发布,这些综述很快就会过时。
对于研究非模式生物的研究人员而言,这些内在挑战之外,还需面对在新物种中分析数据的相关难题。这些与非模式生物相关的特有挑战在基因注释过程中表现得尤为突出。例如,非模式生物通常缺乏亲缘关系较近的模式生物,因而难以合理地用于鉴定基因的直系同源关系及其功能例如 海洋无脊椎动物和 果蝇)。许多生物信息学工具还要求 "训练" 以识别可用于确定基因功能的结构基序。然而,训练数据通常仅适用于模式生物,且训练隐马尔可夫模型(HMMs)超出了生物学家甚至许多生物信息学家的专业范畴。最后,即使能够利用模式生物的数据进行注释,当考虑到非模式生物的生物学特性与自然史时,某些与模式生物相关的基因本体(gene ontologies)可能并不适用。例如,将信息从 果蝇 对虾
鉴于这些挑战,需要开发供研究人员使用的生物信息学资源 从头合成 特别关注非模式生物的分析。未来几年的功能基因组学测序项目将有助于缩小模式生物与非模式生物之间的差距。https://genome10k.soe.ucsc.edu/),但仍需开发大量工具以应对上述挑战。CyVerse 致力于构建互操作性生态系统,通过连接现有的网络基础设施和第三方应用程序,为生命科学家提供数据管理、生物信息学分析工具和数据可视化服务。互操作性通过提供可扩展的计算资源,减少生物信息学应用与平台之间的文件格式转换及跨平台数据传输量,从而简化各应用与平台间的过渡流程。CyVerse 提供多个平台,包括发现环境(Discovery Environment, DE)4, 大气5,以及数据存储3. DE 是基于网络的,且将许多常用的生物信息学分析工具转换为用户友好的点击式操作格式(称为 "应用程序"),是数据存储库(Data Store)的图形用户界面(GUI),用于管理大型数据集(即 原始测序数据、组装基因组)的存储与管理。Atmosphere 是一项云计算服务,为研究人员提供使用虚拟机计算资源的更高灵活性,其预装了多种生物信息学工具。这两个平台均与数据存储库(Data Store)相连接,可结合使用以构建如本文所述的工作流程。本报告重点介绍一种 从头合成 转录组组装与差异基因表达分析的工作流程,并进一步探讨了开展生物信息学分析时相关的一些最佳实践。对CyVerse更广泛使命的说明http://www.cyverse.org/about) 以及详细的平台描述(http://www.cyverse.org/learning-center)是公开可获取的。本文所述的所有分析均使用 Discovery Environment 进行4 (DE)与大气5,并以适合所有计算水平研究人员使用的方式呈现。DE工作流程和Atmosphere镜像可通过URL直接引用,以确保其长期的来源可追溯性、可重用性与可重复性。
方案
注意:整个实验方案的编号将根据步骤1.2中创建并命名的文件夹进行。图1 和 2)。本方案代表了一种标准的比较方法 从头合成 转录组分析,此处详述的每一步骤并非对所有研究人员都必要。该工作流程在配套的教学维基中有详细记录,其中还包含所有附加文件及相关的文档链接3rd 每个分析软件包的开发人员表1)。本方案中将提供指向该资料的链接,以便用户便捷访问相关信息。最佳实践是以注释形式向用户提供的建议,旨在说明完成任务的最佳方法或供用户考虑的事项,这些内容将以注释形式在方案中予以传达。示例数据输入与分析输出的文件夹已向用户公开提供,并按照本方案中建议的方式进行组织(从头合成 转录组组装与分析
1. 建立项目、上传原始测序读段并使用 FastQC 评估读段质量
- 获取 Atmosphere 和 Discovery Environment 的访问权限。
- 通过访问注册页面申请免费的 CyVerse 账户(例如 person@institution.edu
- 填写所需信息并提交。
- 访问主网页(http://www.cyverse.org/),在顶部工具栏中选择“登录”。选择“Cyverse 登录”,并使用您的 CyVerse 凭据登录。
- 导航至应用程序 & 服务选项卡,申请访问 Atmosphere。Discovery Environment 的访问权限将自动授予。
- 建立项目并将数据移至数据存储区。
- 登录 Discovery Environment(https://de.iplantcollaborative.org/de)。选择“Data”选项卡,以显示数据存储中所有文件夹的菜单。
- 创建一个主项目文件夹,用于存放与该项目相关的所有数据。在数据窗口顶部找到工具栏,选择“文件 | 新建文件夹”。文件夹名称以及任何输入/输出文件的名称中均不得使用空格或特殊字符。 例如 "!@#()[]{}:;$%^&_ 或 - 即 “_”或“-”(视情况而定)。
- 在主项目文件夹中创建五个文件夹以组织分析工作(图1将文件夹命名为以下名称,不要使用逗号或引号:“1_Raw_Sequence”、“2_High_Quality_Sequence”、“3_Assembly”、“4_Differential_Expression”、“5_Annotated_Assembly”。每个主项目文件夹中将包含相应的子文件夹。图2).
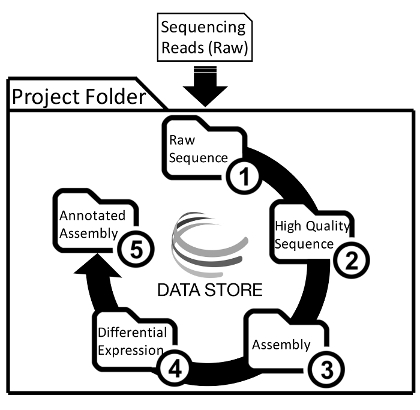
图1:从头转录组组装与分析工作流程及项目文件夹组织的总体概述。用户需将原始测序读段上传至数据存储区的主项目文件夹中,随后将每一步骤的结果分别存入不同的子文件夹。请点击此处查看该图的放大版本。
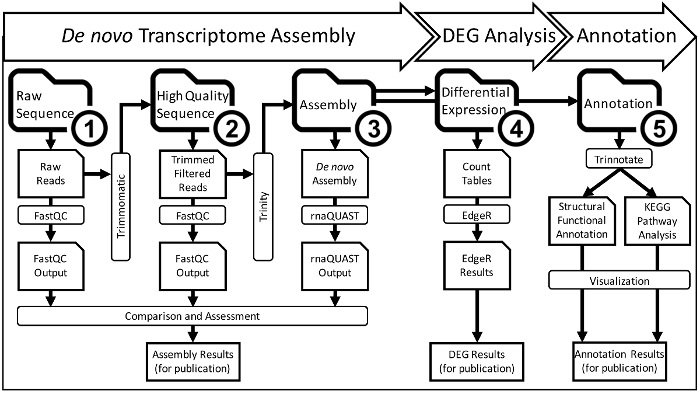
图2:在 CyVerse 网络基础设施内进行的从头转录组组装与分析工作流程的详细概述。整个组装与分析工作流程将分为五个步骤完成,每个步骤对应一个独立的文件夹(加粗、编号的文件夹图标)。这五个编号的工作流程步骤文件夹各自包含有生物信息学分析结果的子文件夹(文件夹图标)。分析的输入数据来自某一子文件夹,经分析程序处理后(矩形框),结果转入另一个文件夹。前三个步骤的最终数据将被比较并整理,以备发表。最终,该方案生成一个主项目文件夹,其中包含逐步的分析内容,便于合作者和/或论文审稿人快速理解工作流程,并在必要时通过各个文件重复该流程。请点击此处查看该图的放大版本。
- 使用以下三种方法之一,将原始 FASTQ 序列文件上传至名为“1_Raw_Sequence”的文件夹中的子文件夹“A_Raw_Reads”内。
- 使用 Data Store 的简单上传功能:在主 DE 桌面点击数据按钮,进入 Data 窗口工具栏,选择“上传 | 从桌面简单上传”。点击“浏览”按钮,定位到本地计算机上的原始 FASTQ 测序文件。此方法仅适用于小于 2 GB 的文件。
- 点击屏幕底部的“上传”按钮以提交上传任务。上传提交后,DE 右上角的铃铛图标处将显示通知;上传完成后,会再次弹出通知。
- 或者,使用 Cyberduck 传输较大的文件(https://wiki.cyverse.org/wiki/x/pYcVAQ)。安装 Cyberduck 后,在本地计算机桌面上作为程序运行。
- 最后,根据说明下载 iCommands 并安装到本地计算机(https://wiki.cyverse.org/wiki/display/DS/Using+iCommands)。
- 在 DE 中使用 FastQC 工具评估已上传的原始测序读段。
- 在主 DE 桌面点击“Apps”按钮,打开一个包含 DE 中所有可用分析工具的窗口。
- 在窗口顶部的搜索工具栏中搜索并打开 FastQC 工具窗口。若存在多个 FASTQ 文件,请打开多文件版本。选择“文件 | 新建文件夹”,创建名为“B_FastQC_Raw_Reads”的文件夹,并将其选为输出文件夹。
- 将 FASTQ 读段文件加载到名为“选择输入数据”的工具窗口中,然后选择“启动分析”。
- 分析完成后,打开 .html 或 .pdf 文件查看结果。FastQC 会运行多项分析,检测读段文件的不同方面(图 3)。
2. 修剪并质控过滤原始读段以获得高质量序列
注意:使用 Trimmomatic 应用程序或 Sickle 应用程序。
- 在 DE 中搜索可编程的 Trimmomatic 应用程序,并像之前一样打开。
- 将原始 FASTQ 读段文件夹上传到“Settings”部分。
- 选择测序文件是单端还是双端。
- 通过点击浏览按钮并粘贴 /iplant/home/shared/Trinity_transdecoder_trinotate_databases 到“Viewing:”框中,选择系统提供的标准控制文件。选择名为 Trimmomaticv0.33_control_file 的文件并启动分析。该文件可被下载,编辑设置后,再上传至第二个项目文件夹以创建自定义剪切脚本。
- 可选:如果 FastQC 分析识别出接头序列,请使用 ILLUMINACLIP 设置来剪切 Illumina 接头。如上所述,在文件夹 /iplant/home/shared/Trinity_transdecoder_trinotate_databases 中选择适当的接头文件。
- 使用 Sickle 对序列读段进行质量剪切。
- 在 DE 中搜索并打开 Sickle 应用程序。选择已剪切的 FASTQ 读段作为输入读段,并重命名输出文件。在选项中包含质量参数设置。典型设置包括:质量格式:illumina、sanger、solexa;质量阈值:20;最小长度:50。
- 将所有输出移至剪切和过滤后的文件夹(2_High_Quality_Sequence)。
- 使用 FastQC 评估最终读段,并与之前的 FastQC 报告进行比较。选择 .html 文件以打开包含所有结果的网页。如果无法查看,可选择输出中提供的图像文件夹(.png 文件)。
3. 从头合成 使用 Trinity 在 Atmosphere 中进行转录组组装
- 通过访问维基页面(https://wiki.cyverse.org/wiki/x/dgGtAQ)打开最新版本的 Atmosphere 实例。选择 Trinity 和 Trinotate 镜像的最新版本链接。或者,在 Atmosphere 镜像搜索工具中搜索“Trinotate”(https://atmo.iplantcollaborative.org/application/images),以显示所有版本的 Trinity 和 Trinotate 镜像。
- 点击“登录以启动”按钮,然后为 Atmosphere 实例命名。
- 选择实例大小为“medium3”(CPU:4,内存:32 GB)或“large3”(CPU:8,内存:64 GB)。启动实例并等待其构建完成。在极少数情况下,CyVerse 会进行平台维护更新。在此期间已有实例仍可使用,但可能无法创建新实例。请访问 CyVerse 状态页面以查看任一平台的当前状态(http://status.cyverse.org/)。
- 实例准备就绪后,点击其名称,然后在右侧菜单底部选择“远程桌面”以打开实例。如果提示,请允许 Java 和 VNC 查看器运行。在 VNC 查看器窗口中点击“连接”按钮,然后选择“继续”。
- 登录后将打开一个独立窗口,该窗口即为新的云计算实例。
- 使用步骤 1.3.1 至 1.3.4 中描述的三种方法之一,将经过修剪和/或过滤的 FASTQ 读段文件移入实例。可使用浏览器访问发现环境(DE)并下载文件,操作方式与在本地计算机上相同。或者使用镜像中已安装的 iCommands 工具快速传输大型数据集。
- 运行 Trinity 以组装高质量读段。
- 在 Atmosphere 实例上设置分析文件夹。使用发现环境中的脚本(/iplant/home/shared/Trinity_transdecoder_trinotate_databases),或从维基页面(https://wiki.cyverse.org/wiki/x/dgGtAQ)复制粘贴命令。所有命令的说明均可在维基页面上找到。
- 在分析文件夹和 Trinotate 数据库建立完成后,使用上述命令运行 Trinity 组装程序。程序将生成多个输出文件,其中最重要的是名为“Trinity.fasta”的最终组装文件。在将该 FASTA 文件移入数据存储区(文件夹 3_Assembly)之前,应将其重命名为能唯一标识该生物体及其处理条件的名称,以尽量减少潜在混淆。
注意:将用于差异基因表达分析的输出计数表放入文件夹(4_Differential_Expression)中。
- 使用 rnaQUAST 评估组装结果(图 4)。
- 将 Trinity 输出文件移入发现环境中的“3_Assembly”文件夹,并将该文件夹标记为“A_Trinity_de_novo_assembly”。为每个组装的转录组在“A_Trinity_de_novo_assembly”文件夹内创建一个子文件夹,子文件夹名称应包含生物体的学名及其对应的处理条件,并确保名称唯一。在“3_Assembly”文件夹中再创建一个名为“B_rnaQUAST_Output”的子文件夹。
- 打开名为“rnaQUAST 1.2.0 (denovo based)”的应用程序,为分析命名,并选择“B_rnaQUAST_Output”作为输出文件夹。
- 在“Data Input”部分添加从头组装的 FASTA 文件。在“Data Output”部分,为该从头组装输入一个唯一名称。这将在“B_rnaQUAST_Output”文件夹内生成一个包含 rnaQUAST 输出文件的文件夹。
- 在“GenemarkS-T Gene Prediction”、“BUSCO”和“Parameters”部分选择附加选项。
- 如果目标生物体为原核生物,请在“GenemarkS-T Gene Prediction”部分选择“prokaryote”。
- 运行 BUSCO 时,点击浏览按钮,将路径 iplant/home/shared/iplantcollaborative/example_data/BUSCO.sample.data 复制到“Viewing:”框中并按回车键。选择适用于该生物体的最具体的 BUSCO 文件夹。
注意:BUSCO 将评估组装结果中谱系特异性核心基因的存在情况,并输出检测到的核心基因百分比。存在通用文件夹(例如 eukaryote)以及更具体的谱系文件夹(例如 arthropoda)。
- 在发现环境中搜索“Transcript decoder”,并对从头组装的 Trinity 输出 FASTA 文件运行 Transdecoder。
- 将生成的 .pep 文件移入从头组装文件夹(3_Assembly),供步骤 5 注释使用。
4. 在差异表达分析中使用 DESeq2 进行成对差异表达
- 按照之前所述,在DE中打开DESeq2应用程序。为分析命名,并将输出文件夹选择为4_Differential_Expression。
- 在“Inputs”(输入)部分,选择来自Trinity组装运行的计数表文件,以及该计数表中包含contig名称的列。
- 输入计数数据表文件中的列标题,以确定哪些列将被比较。各条件之间需用逗号分隔。包含contig名称的第一列标题不得包括在内。
- 对于重复样本,重复使用相同的名称(e.g.,Treatment1rep1、Treatment1rep2、Treatment1rep3应写为Treatment1、Treatment1、Treatment1)。在第二行中,提供要比较的两个条件的名称(e.g.,Treatment1, Treatment2)。该名称需与第一行中提供的列标题名称相对应。
注意:这些列标题必须为字母数字组合,不能包含任何特殊字符。
5. 使用 Trinotate 进行注释
- 在 Atmosphere 云计算实例中运行 Trinotate 的各个模块。注意:Bash 命令已提供在 txt 文件中,可复制、粘贴并在 DE 系统(/iplant/home/shared/Trinity_transdecoder_trinotate_databases)或维基页面(https://wiki.cyverse.org/wiki/x/dgGtAQ)上修改后执行。若需对多个转录本组装结果进行注释,应逐个完成每个组装的注释,随后将已完成的注释文件转移回“5_Annotation”文件夹,并为每个组装创建对应的唯一子文件夹存放其注释结果。
- 运行用于搜索 Trinity 转录本的 bash 命令。将线程数更改为与实例上的 CPU 数量相匹配。 即 中等配置有4个CPU,大型配置有8个CPU。更多细节请参见步骤3.1.2。修改命令Trinity.fasta以匹配组装得到的FASTA文件名。
注意:BLAST+ 搜索将耗时最长,可能需要数天才能完成。可在 Atmosphere 中检查云计算机的运行状态,而无需启动 VNC Viewer。 - 运行 bash 命令以搜索 Transdecoder 预测的蛋白质。与之前相同,根据 5.2.1 中的条件修改线程数和文件名。
- 运行 HMMER 的 bash 命令,并按上述方法更改线程数。
- 如有需要,运行 signalP 和 tmHMM 的 bash 命令。signalP 用于预测信号肽,tmHMM 用于预测跨膜蛋白基序。
- 运行用于搜索 Trinity 转录本的 bash 命令。将线程数更改为与实例上的 CPU 数量相匹配。 即 中等配置有4个CPU,大型配置有8个CPU。更多细节请参见步骤3.1.2。修改命令Trinity.fasta以匹配组装得到的FASTA文件名。
- 将结果加载到 SQLite 数据库中
- 完成上述所有分析后,运行 bash 命令将输出文件加载至最终的 SQLite 注释数据库中。移除未执行分析的相关命令。
- 将SQLite数据库导出为.xls文件,以便在常用的表格查看器中查看。
结果
项目组织文件创建完成后(图 1 和 图 2),该工作流程中的第一步是评估原始测序文件,然后通过剪切和质量过滤对其进行清洗。FastQC 将生成关于 FASTQ 文件格式中序列质量得分和长度的人类可读摘要统计信息。随后比较剪切前后的 FastQC 图表,以评估最终的读段是否为高质量,从而适合用于组装。“每个碱基的序列质量”显示了测序中每个碱基位置上读段的平均质量。在 FastQC 图表中,Phred 质量得分最好高于 20–28,该范围由颜色指示。“每个序列的质量得分”用于判断是否需要对读段进行质量过滤。如果过多读段的平均得分低于 20–25,则可能需要基于平均读段质量进行过滤。“每个碱基的序列组成”应显示四种核苷酸碱基之间的均匀分布。如果显示出核苷酸组成的偏倚,则可能需要剪切末端。“每个碱基的 GC 含量”也应在所有位置上保持均匀。如果出现波动,则可能需要像 1.4.4.3 节所述那样对读段进行剪切。“每个序列的 GC 含量”应呈正态分布。接头序列或聚合酶链式反应(PCR)产物可能污染测序文库并使正态分布发生偏移。在这种情况下,可能需要进行接头剪切。“序列长度分布”提供所有读段的平均长度。通常会过滤掉短于 35–45 个碱基对的读段。“序列重复水平”显示特定读段序列在文库中出现的频率。高度重复的读段序列及其数量将在“过表达序列”部分中列出。FastQC 还会尝试识别这些重复读段是否为接头序列,或与测序平台相关的其他已知序列。“无匹配”标签表示应进一步使用 NCBI BLAST6 对该序列进行分析,以确定其是否为具有生物学意义的序列,或是否应予以去除。DE 平台还提供多个版本的 BLAST 工具。DE BLASTn 应用程序地址为:https://de.iplantcollaborative.org/de/?type=apps&app-id=6f94cc92-6d28-45c6-aef1-036be697671d。
在对原始测序数据进行筛选以获得高质量的测序读段后,需要将这些读段进行拼接以生成连续序列(contigs)。简而言之,拼接过程是通过比对所有短序列读段来寻找相似序列。当相似序列区域的长度超过某一特定阈值时,即被视为同一序列,因为随机出现如此长度的相似序列的概率几乎为零。Trinity 将输出拼接过程中每一步的日志文件和 fasta 文件。然而,最重要的输出是包含 contigs 的最终拼接文件,该文件被命名为“Trinity.fasta”,位于主文件夹中。此文件包含了所有拼接得到的 contigs,其本身并不具备实际意义上的“可读性”。因此,可以使用 rnaQUAST 工具对拼接结果进行更深入的理解。rnaQUAST 工具将生成一系列图表,帮助用户比较不同拼接结果,以判断其完整性(图 4)。有关 rnaQUAST 输出的每张图表的更多详细信息,可参见其 wiki 页面(https://wiki.cyverse.org/wiki/x/fwuEAQ)。如果运行了 BUSCO7,则需特别关注 specificity.txt 文件,该文件显示了完整和部分 BUSCO 基因的数量,以及 GeneMarkS-T 基因预测的数量。BUSCO 基因是一组经过审编的、在某一类生物中普遍存在的基因集合,可用于评估拼接结果对预期存在于特定生物类群中的基因集合的捕获程度,其评估依据为系统发育分支。此外,CyVerse 数据环境(DE)中也提供独立的 BUSCO 应用程序(https://de.iplantcollaborative.org/de/?type=apps&app-id=112b8a52-efd8-11e5-a15c-277125fcb1b1)。
差异基因表达分析可识别在不同处理条件下表达模式存在差异的转录本,其数据来源于每条组装转录本的简单计数表。DESeq2 采用广义线性模型(GLM)来确定相对于标准化均值的变异情况。建议实验设置重复样本,以便 DESeq2 算法能够对测序过程中的技术性变异进行标准化处理。DESeq2 差异表达基因(DEG)分析将生成图表及一个 .html 报告文件,其中包含所有输出图表及其说明。或者,也可使用 EdgeR 替代 DESeq2,此时将生成包含 EdgeR 可视化结果的相同格式 .html 报告。研究人员可根据需要同时运行 DESeq2 和 EdgeR,以筛选在特定实验中被两种算法共同识别出的差异表达基因。Trinotate 将生成一个输出的 .xls 文件,可在任意电子表格软件中打开。这些差异表达基因的 .txt 文件以及注释用的 .xls 文件,均可在 CyVerse 平台之外的多种下游分析与可视化应用中进一步处理。
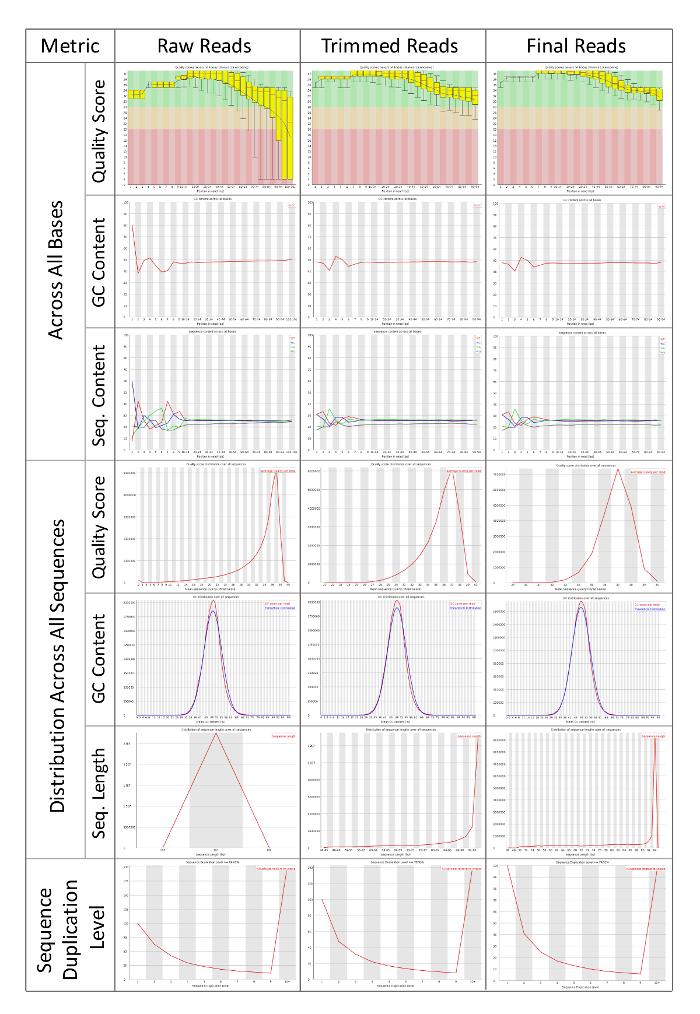
图3:原始测序读段、修剪后读段以及最终修剪和过滤后读段的FastQC报告。 系统比较各预处理步骤后的测序读段。高质量读段是实现组装的必要条件 从头合成 转录组。FastQC 可帮助研究人员了解测序数据的初始质量,并追踪读段预处理的效率。FastQC 的结果取决于正在测序的生物体和样本,但对于后续比较的所有样本而言,实现数据间的一致性是读段预处理的主要目标。FastQC 的作者和开发人员提供了教程视频和相关文档。 请点击此处以查看此图的放大版本。
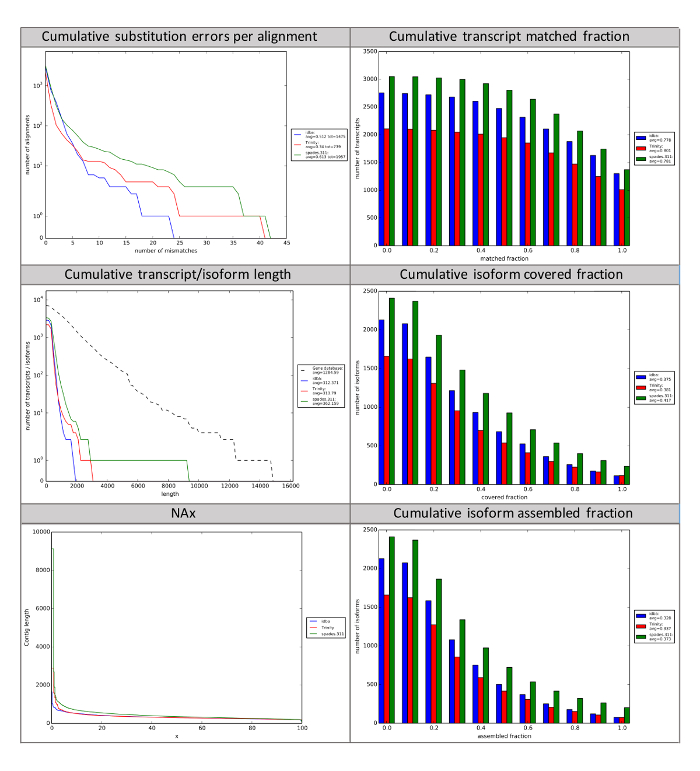
图 4:三个独立组装结果的 rnaQUAST 报告。rnaQUAST 可用于比较使用相同组装软件的多个读段组装结果,或使用相同初始读段的多个不同组装软件的结果。rnaQUAST 利用 BUSCO,基于分类群中已知的核心基因生成关于组装结果的汇总统计信息。每条转录本的错配数量以及与经典基因匹配的转录本比例(即匹配比例)可反映组装工具的准确性。此处展示的最后四个子图提供了关于重叠群(contig)和异构体长度以及预期异构体覆盖情况的汇总统计信息。NAx 表示长度超过 y 轴所示长度(bp)的重叠群所占的百分比(x)。组装比例是指最长的单条组装转录本与其全长的比值。覆盖比例是指根据 BUSCO 提供的核心原核或真核基因预期的完整组装转录本/异构体所占的百分比。有关 rnaQUAST 生成的所有图表的详细说明,请参见(https://wiki.cyverse.org/wiki/x/fwuEAQ)。请点击此处查看该图的放大版本。
| 应用程序名称 | CyVerse 平台 | 第三方文档 | CyVerse 文档 | 样本数据集的预计运行时间 | 链接到应用程序 |
| FastQC | 德国 | http://www.bioinformatics. babraham.ac.uk/projects/fastqc/ https://www.youtube.com/watch?v=bz93ReOv87Y | https://wiki.cyverse.org/wiki/pages/viewpage.action?pageId=9316768 | 15 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=112b9aa8-c4a7-11e5-8209- 5f3310948295 |
| Trimmomatic v0.33 | 德国 | https://github.com/timflutre/trimmomatic | https://wiki.cyverse.org/wiki/display/DEapps/Trimmomatic-可编程-0.33 | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=9c2a30dc-028d 11e6-a915-ab4311791e69 |
| 镰状 | 德国 | https://github.com/najoshi/sickle | https://wiki.cyverse.org/wiki/display/DEapps/Sickle-基于质量的修剪 | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=68b278f8-d4d6-414d-9a64-b685a7714f7c |
| Trinity | 大气 | https://github.com/trinityrnaseq/trinityrnaseq/wiki | https://pods.iplantcollaborative. org/wiki/display/atmman/Trinity - Trinotate Atmosphere 镜像 | 1 周 | https://atmo.iplantcollaborative. org/application/images/1261 |
| 德国 | https://wiki.cyverse.org/wiki/display/DEapps/Trinity-64GB-2.1.1 | 2-5天 | https://wiki.cyverse.org/wiki/display/DEapps/Trinity-64GB-2.1.1 | ||
| rnaQUAST v1.2.0 | DE,大气 | http://spades.bioinf.spbau.ru/rnaquast/release1.2.0/manual.html | https://pods.iplantcollaborative. org/wiki/display/TUT/rnaQUAST 1.2.0(基于denovo)使用DE | 30 min | https://de.iplantcollaborative. org/de/?type=apps&app-id=980dd11a-1666 11e6-9122-930 ba8f23352 |
| Transdecoder | 德国 | https://transdecoder.github.io | https://wiki.cyverse.org/wiki/display/DEapps/转录解码器 2.0 | 2-3 小时 | https://de.iplantcollaborative. org/de/?type=apps&app-id=5a0ba87e-b0fa-4994-92a2- 0d48ee881179 |
| DESeq2 | 德国 | https://bioconductor.org/packages/release/bioc/html/DESeq2.html | https://pods.iplantcollaborative. org/wiki/pages/viewpage.action?pageId=28115142 | 2-3 小时 | https://de.iplantcollaborative. org/de/?type=apps&app-id=9574e87c-4f90- 11e6-a594-008 cfa5ae621 |
| EdgeR | 德国 | https://bioconductor.org/packages/release/bioc/vignettes/edgeR/inst/doc/edgeR.pdf | https://wiki.cyverse.org/wiki/pages/viewpage.action?pageId=28115144 | 2-3 小时 | https://de.iplantcollaborative. org/de/?type=apps&app-id=4a08ceda-54fe 11e6-862f-008 cfa5ae621 |
| Trinotate | 大气 | https://trinotate.github.io/ | https://pods.iplantcollaborative. org/wiki/display/atmman/Trinity - Trinotate Atmosphere 镜像 | 1 周 | https://atmo.iplantcollaborative. org/application/images/1261 |
表1:分析程序、可用平台以及按首次出现顺序列出的各工作流程的附加资源。 所有软件包版本均截至2016年4月。
讨论
本实验方案包含五个关键步骤,每一步都会在主项目文件夹内创建一个独立的子文件夹(图1 和 图2)。所有原始测序数据均为不可更改的原始资料:应将其上传并保存在标记为 "1_Raw_Sequence" 的第一个文件夹中,且不得以任何形式修改。数据可通过以下三种方式之一上传:DE 界面可用于直接上传文件,这是最简便的方法,但数据传输耗时最长;Cyberduck 提供图形化界面,允许用户通过拖放文件的方式向 DE 传输数据;iCommands 是一种命令行工具,可用于在数据存储库之间传输数据、创建目录和管理数据集,通常是传输数据文件最快的方式。数据存储库中的所有数据均可与其他 CyVerse 用户共享(https://wiki.cyverse.org/wiki/display/DEmanual/Sharing+Data+Files+and+Folders+Via+the+Discovery+Environment),也可通过生成的 URL 设为公开访问(https://wiki.cyverse.org/wiki/display/DEmanual/Sharing+Data+Files+Via+Public+Links),或作为公开且匿名(无需用户名)的社区数据进行托管(http://data.iplantcollaborative.org;http://mirrors.cyverse.org)。在该文件夹内,原始序列读段将使用 FastQC(http://www.bioinformatics.bbsrc.ac.uk/projects/fastqc/)进行分析,以评估如何修剪和过滤读段,从而获得高质量的读段数据。在完成修剪和质量过滤后,建议比较 FastQC 的输出结果,以判断读段质量是否有所改善,同时确保未丢失重要信息(图3)。需注意,FastQC 的横坐标并非线性,而是对多个输出图进行了分箱处理,这可能导致结果被误读。经过修剪和过滤的读段随后将用于在 Atmosphere 云计算实例上进行 de novo 转录组组装。该云计算机使用本地计算机的屏幕、键盘和鼠标,但拥有独立的软件(Trinity 和 Trinotate)和硬件配置。在云计算机实例上运行程序不会对本地计算机造成任何影响。De novo 组装及其后续注释很可能是本工作流程中耗时最长的两个步骤。因此,这些步骤在 Atmosphere 上完成,以避免因实验室共用计算机可能出现的断电、深夜自动更新后的重启或其他用户操作导致的系统崩溃等问题而中断分析。Trinotate 注释使用了 BLAST+8、HMMER9、tmHMM10 和 PFAM11。注释的最终输出结果为一个 SQLite 数据库和一个 .xls 文件。这些输出结果可在 CyVerse 之外的下游分析平台(如 KEGG12,13)中使用。
该工作流程可直接在 DE 和 Atmosphere 中使用,无需花费时间安装、配置和排查每个分析软件包及其所需的各种依赖工具。这简化了研究人员的分析过程,最大限度减少了重复劳动,并降低了众多科研人员的使用门槛。本工作流程专门用于组装来自 Illumina 测序平台的单端或双端测序读长,但 DE 和 Atmosphere 中还提供多种工具以支持其他类型的测序技术。该工作流程中的工具可轻松替换为相应的替代工具,以处理任意类型的输入测序数据。对于分析工具的新版本或全新的工具,同样适用此替换原则。
该工作流程专门设计用于每次仅组装、比较和注释少数几个转录组。因此,用户在为比较群体遗传学研究组装多个转录组时,可能会发现此过程耗时较长。面向群体遗传学用户的分析流程将在不久的将来上线,相关链接可在维基页面 ( https://wiki.cyverse.org/wiki/x/dgGtAQ) 上找到。差异基因表达分析步骤可处理重复样本,但其为成对比较,无法准确评估多个因素(例如,随时间变化的条件、超过两种的处理方式)。对于具有参考基因组的生物体,已有自动化工作流程可用(例如,TRAPLINE14)。尽管自动化工作流程对初学者而言最容易使用,但从头组装需要对本文所述的每一步骤进行评估和考量。此外,用户必须按照既定结构使用自动化流程,因此其本身在灵活性上存在局限,难以满足用户不断变化的需求。
由于本方案的大部分操作均通过互联网进行,用户可能会遇到浏览器设置相关的问题。首先,弹出窗口拦截器可能会阻止窗口打开,或需在浏览器中授予 CyVerse 权限后才能打开窗口。Atmosphere 使用 VNC 访问远程桌面,但也可使用其他软件。本方案全程在 Firefox 版本 45.0.2 中完成,应可在所有主流互联网浏览器中正常运行,但可能出现某些不一致情况。随着 Trinity 发布新版本,该工作流程将进行更新(https://github.com/trinityrnaseq/trinityrnaseq/wiki)。有关该工作流程的最新版本和最新信息,请参见维基教程页面(表 1,https://wiki.cyverse.org/wiki/x/dgGtAQ)。用户可直接联系技术支持,或在 Ask CyVerse(ask.cyverse.org/)上提问,以解决工作流程中的任何问题。
在发现环境(DE)中,存在多个应用程序可用于完成本方案的各个步骤。例如,用户可能希望使用 Scythe(https://github.com/najoshi/sickle)替代 Trimmomatic15 进行测序读段修剪,或使用 EdgeR16 替代 DESeq17,18 进行差异表达分析。尽管这些内容超出了本文的范围,但用户可以复制、编辑并发布现有的 DE 应用程序(https://wiki.cyverse.org/wiki/display/DEmanual/Creating,+Copying,+and+Editing+DE+Apps),或添加新的应用程序(https://wiki.cyverse.org/wiki/display/DEmanual/Dockerizing+Your+Tools+for+the+CyVerse+Discovery+Environment)。此外,Atmosphere 镜像也可被修改并重新生成,以创建更符合用户特定需求的新工作流程或改进型工作流程(https://wiki.cyverse.org/wiki/x/TwHX)。本研究旨在介绍如何使用命令行移动数据和执行分析。用户可进一步考虑利用更高级的命令行资源,例如 CyVerse 应用编程接口(APIs)(http://www.cyverse.org/science-apis),或自行设计 DE 应用程序,这需要掌握分析工具在命令行中的具体运行方式(https://wiki.cyverse.org/wiki/display/DEmanual/Creating+a+New+App+Interface)。
披露
作者无任何利益冲突需要披露。
致谢
作者感谢美国农业部国家食品与农业研究所(USDA-NIFA)资助项目 2013-00984、美国国家科学基金会(NSF)资助项目 IOS - 1339156、IOS - 1444490 以及 CyVerse(NSF:DBI - 1265383)提供的经费支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Trimmomatic v0.33 | USADELLAB.org | https://github.com/timflutre/trimmomatic | https://de.iplantcollaborative.org/de/?type=apps&app-id=9c2a30dc-028d-11e6-a915-ab4311791e69 |
| Sickle | Joshi 和 Fass | https://github.com/najoshi/sickle | https://de.iplantcollaborative.org/de/?type=apps&app-id=68b278f8-d4d6-414d-9a64-b685a7714f7c |
| Trinity | 布罗德研究所和耶路撒冷希伯来大学 | https://github.com/trinityrnaseq/trinityrnaseq/wiki | https://atmo.iplantcollaborative.org/application/images/1261 |
| rnaQUAST v1.2.0 | 俄罗斯科学院圣彼得堡学术大学算法生物学实验室 | http://spades.bioinf.spbau.ru/rnaquast/release1.2.0/manual.html | https://de.iplantcollaborative.org /de/?type=apps&app- id=980dd11a-1666-11e6-9122- 930ba8f23352 |
| Transdecoder | 布罗德研究所和英联邦科学与工业研究组织 | https://transdecoder.github.io | https://de.iplantcollaborative.org/de/?type=apps&app-id=5a0ba87e-b0fa-4994-92a2-0d48ee881179 |
| EdgeR | Robinson 等,2010 年 | https://bioconductor.org/packages/release/bioc/vignettes/edgeR/inst/doc/edgeR.pdf | https://de.iplantcollaborative.org/de/?type=apps&app-id=5aa9e294-6f95-42f9-98e9-c9c96b44f499 |
| Trinotate | 布罗德研究所和耶路撒冷希伯来大学 | https://trinotate.github.io/ | https://atmo.iplantcollaborative.org/application/images/1261 |
参考文献
- Hasselmann, M., Ferretti, L., Zayed, A. Beyond fruit-flies: population genomic advances in non-Drosophila arthropods. Brief. Funct. Genomics. 14 (6), 424-431 (2015).
- Scholz, M. B., Lo, C. -C., Chain, P. S. Next generation sequencing and bioinformatic bottlenecks: the current state of metagenomic data analysis. Anal. Biotech. 23 (1), 9-15 (2012).
- Merchant, N., et al. The iPlant Collaborative: Cyberinfrastructure for Enabling Data to Discovery for the Life Sciences. PLoS Biol. 14 (1), e1002342(2016).
- Oliver, S. L., Lenards, A. J., Barthelson, R. A., Merchant, N., McKay, S. J. Using the iPlant collaborative discovery environment. Cur. Protoc. Bioinformatics. , 1-22 (2013).
- Skidmore, E., Kim, S., Kuchimanchi, S., Singaram, S., Merchant, N., Stanzione, D. iPlant atmosphere: a gateway to cloud infrastructure for the plant sciences. Proc. 2011 ACM. , 59-64 (2011).
- Altschul, S. F., Gish, W., Miller, W., Myers, E. W., Lipman, D. J. Basic local alignment search tool. J. Mol. Bio. 215 (3), 403-410 (1990).
- Simão, F. A., Waterhouse, R. M., Ioannidis, P., Kriventseva, E. V., Zdobnov, E. M. BUSCO: assessing genome assembly and annotation completeness with single-copy orthologs. Bioinformatics. , (2015).
- Camacho, C., et al. BLAST+: architecture and applications. BMC Bioinformatics. 10, 421(2009).
- Eddy, S. R. Profile hidden Markov models. Bioinformatics. 14 (9), 755-763 (1998).
- Krogh, A., Larsson, B., von Heijne, G., Sonnhammer, E. L. Predicting transmembrane protein topology with a hidden markov model: application to complete genomes. J. Mol. Biol. 305 (3), 567-580 (2001).
- Finn, R. D., Coggill, P., et al. The Pfam protein families database: towards a more sustainable future. Nucleic Acids Res. 44 (D1), D279-D285 (2016).
- Kanehisa, M., Sato, Y., Kawashima, M., Furumichi, M., Tanabe, M. KEGG as a reference resource for gene and protein annotation. Nucleic Acids Res. 44 (D1), D457-D462 (2016).
- Kanehisa, M., Goto, S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 28 (1), 27-30 (2000).
- Wolfien, M., et al. TRAPLINE: a standardized and automated pipeline for RNA sequencing data analysis, evaluation and annotation. BMC Bioinformatics. 17, 21(2016).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30 (15), 2114-2120 (2014).
- Robinson, M. D., McCarthy, D. J., Smyth, G. K. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 26 (1), 139-140 (2010).
- Anders, S. Analysing RNA-Seq data with the DESeq package. Mol. Biol. 43 (4), 1-17 (2010).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Bio. 15 (12), 1-21 (2014).
重印与许可
