本文介绍一种可在单核苷酸分辨率下对高度完整的DNA中的核糖核苷酸进行同时定量和全基因组定位的方法,该方法结合了基因组DNA的酶切、碱性水解以及后续的5´端测序。
本文内容
摘要
摘要
已有的估算基因组中核糖核苷酸数量的方法主要局限于利用短链合成DNA片段或质粒作为模板,定量整合进入的核糖核苷酸,再将结果外推至整个基因组。另一种方法是使用碱性凝胶或Southern印迹法来估算基因组中核糖核苷酸的数量。较新 体内 这些方法采用下一代测序技术,可实现核糖核苷酸的全基因组定位,从而确定嵌入核糖核苷酸的位置及其种类。然而,这些方法无法定量测定整合到基因组中的核糖核苷酸数量。本文描述了如何同时定位并定量整合到人线粒体DNA中的核糖核苷酸数量 体内 通过下一代测序技术进行检测。我们使用高度完整的DNA,并通过内切核酸酶消化在特定位点引入序列特异性的双链断裂,随后用碱处理水解掺入的核糖核苷酸。将产生的末端与接头连接,并在下一代测序仪上对这些末端进行测序。核糖核苷酸的绝对数量可通过计算每个识别位点区域外的读段数与识别位点平均读段数的比值得出,该识别位点对应于序列特异性内切核酸酶的识别序列。本方案也可用于绘制并定量DNA中的游离切口,并可进一步拓展用于绘制其他可被加工为5´-羟基末端或5´-磷酸末端的DNA损伤位点。此外,只要具备合适的参考基因组,该方法可应用于任何生物体。因此,本方案为研究DNA复制、5´-末端加工、DNA损伤及DNA修复提供了重要的工具。
引言
在真核细胞中,核糖核苷三磷酸(rNTPs)的浓度远高于脱氧核糖核苷三磷酸(dNTPs)的浓度1DNA聚合酶对核糖核苷酸具有识别和排斥作用,但这种识别并非完全有效,因此在DNA复制过程中,核糖核苷酸可能被错误地掺入基因组中,取代脱氧核糖核苷酸。核糖核苷酸可能是基因组中掺入的最常见非经典核苷酸2这些核糖核苷酸大多在冈崎片段成熟过程中被去除,其途径包括由RNase H2启动的核糖核苷酸切除修复(RER)或拓扑异构酶1介导的机制(详见参考文献)3)。无法被移除的核糖核苷酸将稳定地整合在DNA中2,4 并且可能以有害和有益的方式影响它(综述见综述)5)。除了能够作为正向信号发挥作用外,例如在交配型转换中 裂殖酵母(Schizosaccharomyces pombe)6 并在错配修复(MMR)过程中标记新生DNA链7,8,核糖核苷酸影响结构9 由于核糖的2´-羟基团对周围DNA的稳定性和结构的影响10,导致复制应激和基因组不稳定性11基因组DNA(gDNA)中核糖核苷酸的丰度及其在复制和修复机制中的作用,以及对基因组稳定性的潜在影响,促使人们有必要以全基因组范围的方式深入研究其精确发生位置和出现频率。
人类线粒体中未发现RNase H2活性,因此线粒体DNA(mtDNA)中的核糖核苷酸无法被有效清除。多种途径参与向人类线粒体供应核苷酸的过程。为了研究线粒体核苷酸池的紊乱是否会导致人类mtDNA中核糖核苷酸数量增加,我们开发了一种方案,用于绘制并定量分析从成纤维细胞、HeLa细胞及患者细胞系中分离出的人类mtDNA中的这些核糖核苷酸12。
大多数 体外 方法(详见综述)13) 用于测定DNA聚合酶对核糖核苷三磷酸(rNTPs)选择性的方法,主要基于单个核糖核苷酸插入或引物延伸实验,反应体系中加入竞争性rNTPs,从而可在短DNA模板中鉴定或相对定量核糖核苷酸的掺入情况。针对短序列的定量方法可能无法反映细胞内脱氧核糖核苷三磷酸(dNTP)和rNTP的实际浓度比例,因此虽有助于了解聚合酶的选择性,但在全基因组层面的意义有限。已有研究表明,在较长DNA模板(如质粒)复制过程中掺入的核糖核苷酸相对含量,可通过使用放射性标记的dNTPs并在碱性条件下水解DNA后,在测序凝胶上进行可视化分析。14此外,gDNA在碱性水解后通过Southern印迹进行分析,可实现链特异性探针杂交,并确定核糖核苷酸掺入的绝对速率。 体内15这些方法能够对掺入频率进行相对比较,但无法提供有关掺入核糖核苷酸位置或身份的信息。近年来分析基因组DNA中核糖核苷酸含量的新方法 体内,类似于 HydEn-Seq16,核糖测序17,Pu-Seq18,或 emRiboSeq19利用嵌入的核糖核苷酸对碱性条件或RNase H2处理的敏感性,并结合下一代测序技术实现全基因组范围内核糖核苷酸的鉴定。这些方法无法提供所检测到的核糖核苷酸绝对掺入频率的信息。通过在HydEn-seq流程中增加序列特异性酶切步骤,本文所述方法可便捷地扩展测序技术所获得的信息,实现嵌入性核糖核苷酸的同步定位与定量分析12该方法几乎适用于任何生物体,前提是能够获得高度完整的DNA提取物,并且存在合适的参考基因组。该方法还可经改造用于定量并确定任何可被核酸酶切割且留下5´-磷酸或5´-羟基末端的损伤位点的位置。
为了定位并定量基因组DNA中的核糖核苷酸,该方法结合了序列特异性内切酶的切割和碱性水解,从而在内切酶特异性识别序列所在位点产生5´-磷酸末端,而在核糖核苷酸所在位置产生5´-羟基末端。由于生成的游离末端随后将连接接头并通过高通量测序进行测序,因此在DNA提取和文库构建过程中使用高度完整的DNA并避免随机断裂至关重要。通过将检测到的读段数据归一化至内切酶切割位点处的读段,可实现对所检测核糖核苷酸的定位与定量分析。在对照实验中,以KCl处理替代DNA的碱性水解,用于检测游离的5´-末端。所获得的数据可揭示核糖核苷酸的位置与数量,并支持针对核糖核苷酸含量及其掺入频率的进一步分析。
方案
该方案如图1所示,包括基因组DNA(gDNA)的分离、使用限制性内切酶进行消化以定量整合到gDNA中的核糖核苷酸数量、用碱处理以水解整合到gDNA中的核糖核苷酸的磷酸二酯键、游离5´-OH末端的磷酸化、接头的单链DNA连接、第二条链的合成,以及测序前的PCR扩增。
1. 接头与索引引物
- 获取ARC49、ARC140寡核苷酸、ARC76/77、接头以及ARC78-ARC107索引引物(见表1)。
注意:寡核苷酸应经过HPLC纯化。ARC76/77需订购为双链形式。 - 使用Tris-EDTA(TE)缓冲液(见材料表)配制每种寡核苷酸的100 µM储存液,并于-20 °C保存。
- 使用洗脱缓冲液(EB;见材料表)稀释,配制10 µM的ARC67/77溶液以及2 µM的ARC49和索引引物溶液。于-20 °C保存。
2. 细胞的培养与收获
- 在250 mL旋转瓶中,将HeLa细胞培养于70 mL添加了10%胎牛血清的杜氏改良伊格尔培养基(DMEM)中,37 °C条件下培养。
- 计数细胞,取5×10⁶个细胞置于50 mL离心管中,以200 × g离心5分钟,弃去上清液。
- 用20 mL 1× PBS洗涤细胞,以200 × g离心5分钟,弃去上清液。
- 将细胞沉淀在-20 °C下冷冻保存,或继续进行DNA纯化。
3. DNA 纯化与定量
- 采用以下所述的苯酚-氯仿抽提法纯化基因组DNA(gDNA)。
- 将细胞重悬于2 mL裂解缓冲液(见材料表)中,在加热块上42 °C孵育30分钟。
注意:裂解缓冲液含有危险成分。SDS溶液具有刺激性,蛋白酶K具有致敏性、刺激性和毒性。请穿戴防护服和手套。 - 将样品分装至两个2 mL离心管中,每管加入1体积(V)苯酚-氯仿-异戊醇(25:24:1)。
注意:苯酚-氯仿-异戊醇具有毒性、致突变性、腐蚀性,并对水生环境有害。应在通风橱中操作,穿戴防护服和手套,并将其弃置于专用的苯酚-氯仿废液容器中。 - 轻轻颠倒混匀30–60秒,在室温下以15,000 × g离心5分钟。
注意:避免使用涡旋振荡器混匀DNA,以防引入随机链断裂,从而影响实验结果。 - 将上层水相转移至新的2 mL离心管中,加入1体积苯酚-氯仿-异戊醇(25:24:1)。
- 轻轻颠倒混匀,在4 °C、15,000 × g条件下离心5分钟。
- 将上层水相转移至新的2 mL离心管中,加入20 µL NaCl(5 M)和1体积预冷的异丙醇。
注意:异丙醇易燃、具有刺激性和毒性。应储存于通风柜中,穿戴防护服和手套,并远离火源。 - 轻轻颠倒混匀,在-20 °C孵育至少1小时。
- 在4 °C、15,000 × g条件下离心20分钟,弃去上清液。
- 用200 µL预冷的70%乙醇洗涤DNA沉淀,在4 °C、15,000 × g条件下离心20分钟,弃去上清液。
注意:70%乙醇易燃且具有刺激性。工作液应保存在-20 °C;若常温储存,应置于通风柜中,穿戴防护服和手套,并远离火源。 - 将DNA沉淀在室温下干燥20–25分钟。
- 将DNA沉淀溶解于100 µL TE缓冲液中,并将所有样品合并至同一离心管中。
- 将细胞重悬于2 mL裂解缓冲液(见材料表)中,在加热块上42 °C孵育30分钟。
- 根据制造商说明书,使用双链DNA定量试剂测定DNA浓度(见材料表)。
注意:应使用双链DNA定量试剂,因为分光光度法DNA定量可能受到残留苯酚的干扰。 - 将DNA储存于-20 °C,或直接进行HincII酶切处理。
4. HincII 处理与碱性水解
- 在反应体系中消化 1 µg DNA,反应体系包含 5 µL 10x buffer 3.1、1 µL(10 U)HincII 和无核酸酶的 H2O,最终体积为 50 µL。
注意:为了在连接、第二链合成和 PCR 扩增中实现最佳条件,如果预计 DNA 中核糖核苷酸数量非常少,则可能需要增加输入 DNA 的量。同样,如果核糖核苷酸数量非常高,则可能需要减少输入 DNA 的量。 - 在 37 °C 下孵育 30 分钟。
- 使用磁性磁珠纯化经 HincII 处理的 DNA。
注意:在接下来的步骤中,请保持管盖打开,以避免因打开管盖而扰动沉淀。- 向每个样品中加入 1.8 V 的磁性磁珠,用移液器小心混匀,并在室温下孵育 10 分钟。
- 使用磁力架将磁珠沉淀 5 分钟,然后移除并弃去上清液。
- 用 150 µL 70% 乙醇(室温)洗涤沉淀约 30 秒,然后移除并弃去上清液。
- 用 200 µL 70% 乙醇(室温)洗涤沉淀约 30 秒,然后移除并弃去上清液。
注意:残留的乙醇可用 10 µL 移液器去除。滴液可在之前短暂离心沉降。 - 在室温下干燥样品约 15–20 分钟。
注意:确切时间取决于磁珠体积和沉淀形状,因此应目视检查沉淀状态。 - 将管子从磁力架上取下,用 45 µL EB 洗脱沉淀,并用移液器小心混匀。
- 孵育 5 分钟后,将磁珠在磁力架上沉淀,并在步骤 4.4 中使用 45 µL 纯化后的 DNA。
- 向 DNA 中加入 5 µL KOH(3 M)或 KCl(3 M),使总体积达到 50 µL。
警告:3 M KOH 溶液具有腐蚀性。请穿戴防护服和手套。 - 在杂交炉中 55 °C 孵育 2 小时,随后在冰上放置 5 分钟。
注意:建议在烘箱中进行 KOH 处理,而不是使用加热块,以确保管内均匀加热并防止管盖上产生冷凝水。 - 通过加入 10 µL 乙酸钠(3 M,pH = 5.2)和 125 µL 冷的 100% 乙醇沉淀 DNA,在冰上孵育 5 分钟。
警告:100% 乙醇易燃且具刺激性。应储存在通风柜中,穿戴防护服和手套,并远离火源。 - 在 4 °C 下以 21,000 x g 离心 5 分钟使基因组 DNA 沉淀,并弃去上清液。
- 用 250 µL 冷的 70% 乙醇洗涤 DNA 沉淀,在 4 °C 下以 21,000 x g 离心 5 分钟,并弃去上清液。
注意:为去除液滴,可再次短暂离心,然后用 10 µL 移液器移除上清液。 - 将沉淀在敞口管中干燥约 5–10 分钟,直至所有可见液体蒸发。
- 将 DNA 沉淀在 20 µL EB 中室温溶解 30 分钟。
5. 5´ 端磷酸化
- 预先为每个样品配制反应混合液,包含 2.5 µL 10x T4 多核苷酸激酶反应缓冲液、1 µL(10 U)3´-磷酸酶缺失型 T4 多核苷酸激酶和 2.5 µL ATP(10 mM)。
- 将每个 DNA 样品转移 19 µL 至新的 200 µL 管中,并在热循环仪中于 85 °C 变性 3 分钟。
- 将 DNA 样品置于冰上冷却,然后向每个样品中加入 6 µL 反应混合液。
- 在 37 °C 下孵育反应混合液 30 分钟,随后在 65 °C 下孵育 20 分钟以终止反应。
- 按照 4.3 节所述方法纯化 DNA,使用 1.8 倍体积的顺磁性磁珠,但用 14 µL EB 洗脱。
6. 单链DNA连接
- 预先为每个样品配制反应混合液,包含 0.5 µL ATP (2 mM)、5 µL 10x T4 RNA 连接酶反应缓冲液、5 µL CoCl3(NH3)6 (10 mM)、0.5 µL ARC140 (100 µM) 和 25 µL 50% PEG 8000。用移液器充分混匀。
注意:CoCl3(NH3)6 具有致癌性、致敏性,并对水生环境有害。操作时需穿戴防护服和手套。 - 将步骤 5.5 中纯化的 13 µL DNA 转移至新的 200 µL 管中,在热循环仪中于 85 °C 变性 3 分钟。
- 将 DNA 在冰上冷却,向每个样品中加入 36 µL 反应混合液,用移液器混匀后短暂离心。
- 向每管反应体系中加入 1 µL (10 U) T4 RNA 连接酶,用移液器混匀后短暂离心。
- 将样品在室温避光条件下孵育过夜。
7. 第二链合成
- 按照4.3节所述纯化连接后的DNA,但使用0.8体积的磁性 beads,将beads离心沉淀10分钟,并用20 µL EB洗脱。
注意:由于连接反应混合物的黏度较高,第一次沉淀步骤时间需延长。 - 将20 µL DNA样品转移至新的200 µL PCR管中。按照制造商说明书,使用0.8体积的磁性beads重复纯化步骤,并用14 µL EB洗脱。
- 预先为每个样品配制反应混合液,包含2 µL 10x T7 DNA聚合酶反应缓冲液、2 µL ARC76/77(2 µM)、2 µL dNTPs(2 mM)和0.8 µL BSA(1 mg/mL)。
- 将12.8 µL纯化后的DNA转移至新的200 µL PCR管中,在热循环仪中于85 °C变性3分钟。
- 将DNA置于冰上冷却,向每个样品中加入6.8 µL反应混合液,用移液器吹打混匀,短暂离心,然后在室温下孵育5分钟。
- 向每个反应体系中加入0.4 µL(4 U)T7 DNA聚合酶,在室温下孵育5分钟。
- 按照4.3节所述方法纯化DNA,使用0.8体积的磁性beads,并用11 µL EB洗脱。
8. PCR 扩增与文库定量
- 为每个样本预先在新的 200 µL 离心管中配制反应体系,包含 7.5 µL ARC49(2 µM)、7.5 µL index 引物(2 µM,每个样本唯一)和 25 µL 2x 热启动预混液。
- 向每管反应体系中加入 10 µL DNA 样本。使用以下条件扩增文库:95 °C 变性 45 秒,随后进行 18 个循环(98 °C 15 秒、65 °C 30 秒、72 °C 30 秒),最后在 72 °C 延伸 2 分钟。扩增结束后将样本置于 4 °C 保存。
- 按照 4.3 节所述方法,使用 0.8 V 的顺磁性磁珠纯化文库,并用 20 µL TE 缓冲液洗脱。
- 根据生产商说明书(见材料表),使用双链 DNA 定量试剂对文库进行定量。
- 将样本储存于 -20 °C,或继续进行文库分析。
9. 文库分析与合并
- 使用数字电泳系统测定每个文库的质量,并估算平均片段大小。
注意:平均片段大小通过估算电泳图谱曲线下的面积被平分的位置来确定,忽略标记物产生的峰。经KOH或KCl处理后合格文库的代表性结果见图2A。 - 按以下公式计算文库的浓度(nM):
(c/103)/(p*650)]*109
其中c为文库浓度,单位为ng/µL,p为平均片段大小,单位为bp,按步骤9.1估算。 - 将使用不同索引引物扩增的最多24个文库按等摩尔量混合。加入TE缓冲液,使终体积为25 µL,浓度为10 nM。
注意:根据混合文库的数量,调整每个文库的DNA用量。如果在步骤9.1中检测到约130 bp的明显引物二聚体峰,则文库混合物的终体积可超过25 µL,因为需按照步骤4.3重复纯化步骤,使用0.8 V的顺磁性磁珠,并将DNA洗脱于25 µL TE缓冲液中。- 根据制造商说明书,使用双链DNA定量试剂测定新文库混合物的浓度,并如上所述确定平均峰大小。随后进行测序和数据分析(第10和第11节)。
10. 测序
- 对文库混合样本进行75碱基的双端测序12。
11. 数据分析
- 去除接头序列,对所有测序读段进行质量过滤和长度筛选。
注意:可使用 cutadapt 1.2.1 完成此步骤20 使用命令 `cutadapt -f fastq --match-read-wildcards --quiet -m 15 -q 10 -a NNNNNNN` <文件>,其中 NNNNNNN 被替换为实际的接头序列 <文件> 被替换为 fastq 文件的文件名。 - 使用自定义脚本去除在上一步中被丢弃的读段的配对读段。
- 将剩余配对中的 Mate 1 与包含文库构建所用全部寡核苷酸序列的索引进行比对(例如, 使用 Bowtie 0.12.821 并使用命令行选项 -m1 -v2)。丢弃所有比对成功的配对。
- 使用 Bowtie 将剩余的配对序列比对到生物体参考基因组,命令行参数为 -v2 -X10000 --best。
- 通过使用Bowtie(命令行选项为-v2)比对所有未比对读段对的Mate 1,将跨越线粒体分子起始与末端的读段进行定位。
- 确定所有单端和成对末端比对的5´端计数。将这些位置向其上游一个碱基的位置移动,以对应水解的核糖核苷酸所在的位置。
- 使用自定义脚本将bowtie文件格式的数据导出为bedgraph文件格式,以便在常见的基因组浏览器中进行可视化。将每条链的读段数标准化为每百万读段数(reads per million)。
- 根据 bedgraph 文件中的位置和计数信息,比对生物体基因组序列以确定所掺入核糖核苷酸的身份。
注意:对于人类线粒体基因组,应排除每条链上 16,200-300 和 5,747-5,847 区域的读段,因为这些区域含有大量与DNA聚合酶γ掺入核糖核苷酸无关的游离5´-末端。 - 将总数的读段(不包括11个HincII位点处的读段)除以每个HincII位点的平均读段数,得到每个单链断裂处的核糖核苷酸数目,即 每个线粒体分子中的核糖核苷酸数量)
结果
为说明上述方法,本研究以HeLa细胞中的人类线粒体DNA为样本生成了代表性数据12。图2B展示了经KCl处理后,在人线粒体DNA的重链(HS)和轻链(LS)上所有HincII位点处测得的序列读数汇总情况(左图)。约70%的检测到的5´-末端定位于切割位点,表明HincII酶切效率很高。若在建库过程中使用KOH水解嵌入的核糖核苷酸,则HincII位点处的读数数量下降至约40%(图2B,右图),这一结果符合预期,因为在核糖核苷酸插入位点会产生大量新的5´-末端,这也表明文库质量足够高。图2C展示了经KCl处理后检测到的5´-末端(绿色)以及经KOH处理后通过HydEn-seq检测到的读数(品红色)在人线粒体DNA上的定位与频率,后者可同时检测游离5´-末端及经碱性水解在核糖核苷酸处生成的末端。左图显示定位于重链(HS)的游离5´-末端和核糖核苷酸,右图显示定位于轻链(LS)的对应信号。图2D上图和下图分别展示了在线粒体DNA的重链与轻链上,核糖核苷酸位点和HincII位点处原始读数的相对数量,结果显示轻链的覆盖深度比重链分别高出14倍和31倍,而在核DNA中未观察到类似链偏好性。这种链偏向性可能源于两条链之间显著不同的碱基组成,也凸显了以HincII位点读数作为标准化参照的重要性。
将读数归一化至 HincII 可定量测定每个线粒体基因组中的核糖核苷酸数量图 3A)。如图所示 图3B经KOH处理后,每种核糖核苷酸的测序读段经各链序列组成归一化后的比值不同于1,表明读段分布非随机,提示存在特异的核糖核苷酸分布模式且文库质量较高。该比值在经HincII预先消化后保持不变,验证了该酶的切割特异性。将嵌入性核糖核苷酸位点的读段数相对于HincII切割位点以及基因组核苷酸含量进行归一化,可定量计算每1,000个互补碱基中掺入的各种核糖核苷酸的数量。图 3C).
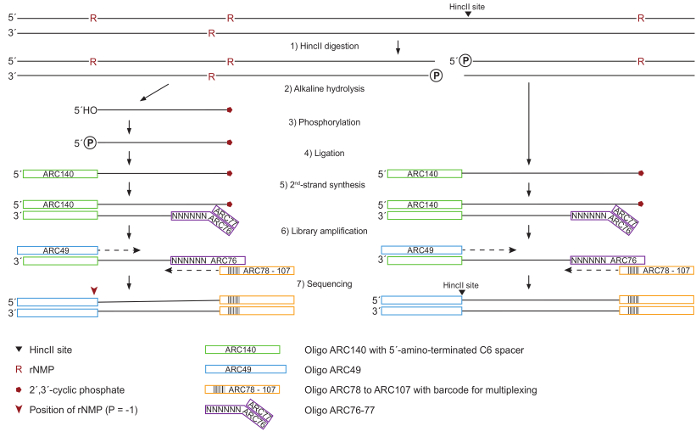
图1:DNA处理与文库构建示意图。 (1)全基因组DNA通过HincII酶切以实现后续核糖核苷酸定量的标准化,在HincII位点处产生平末端(黑色箭头)。(2)DNA经KOH处理,在核糖核苷酸位点发生水解,从而在3´端形成2´,3´-环状磷酸(红色五边形),同时释放出5´-OH自由端。(3)使用T4多核苷酸激酶(不含3´-磷酸酶活性)对5´-OH末端进行磷酸化。(4)利用T4 RNA连接酶将所有携带磷酸基团的5´末端与ARC140寡核苷酸连接。(5)使用T7 DNA聚合酶以及含有随机N6序列的ARC76-77寡核苷酸合成第二条链。(6)采用高保真DNA聚合酶,通过ARC49引物和一条带有唯一条形码用于多重分析的索引引物(ARC78至ARC107之一)扩增文库。(7)通过双端测序确定5´末端的位置。请点击此处查看此图的放大版本。
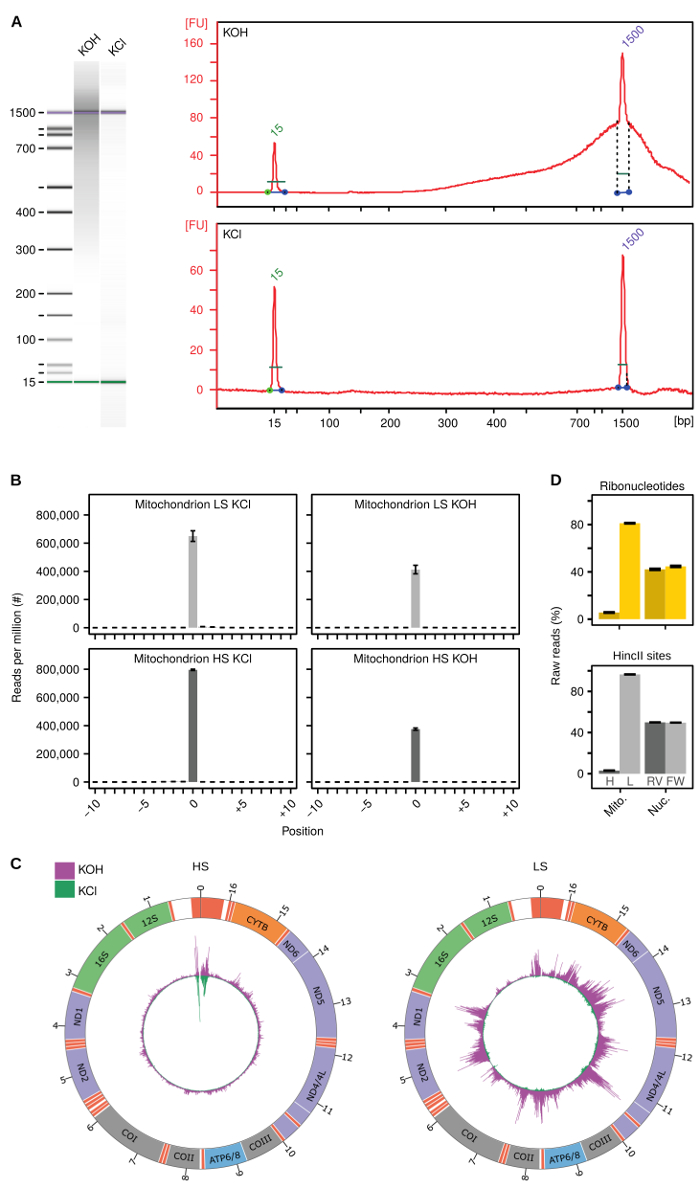
图2:方法验证。(A)使用自动电泳系统生成的代表性电泳图谱,用于评估经KOH或KCl处理后所构建文库的质量。(B)经KCl(左图)或KOH(右图)处理后,人线粒体DNA重链(HS)和轻链(LS)中HincII位点的信号汇总。(C)人线粒体DNA重链(HS,左图)和轻链(LS,右图)中游离5′-末端(绿色)及HydEn-Seq检测到的游离5′-末端与核糖核苷酸(紫红色)的Circos图。峰高经标准化为每百万条读段,且最高峰调整为HydEn-seq文库中最大读段数。(D)人线粒体DNA(Mito.)重链(H)和轻链(L)中核糖核苷酸位点(上图)和HincII位点(下图)的原始读段汇总,以及核DNA(Nuc.)反向(RV)和正向(FW)链中的相应数据。图B、C和D改编自参考文献12。误差棒表示均值的标准误。请点击此处查看该图的放大版本。
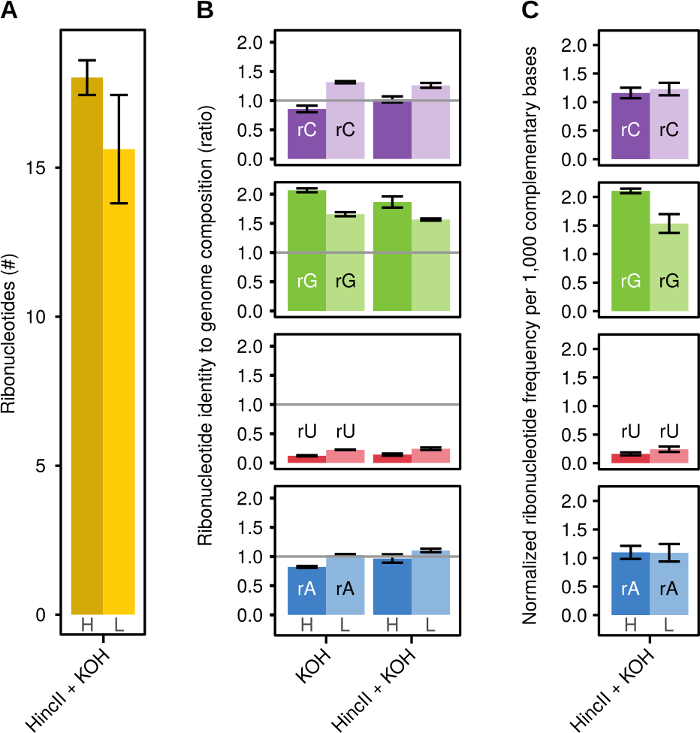
图3:代表性结果。 (A)经KOH处理的文库中,以HincII位点的测序读数归一化的重链(H)或轻链(L)上核糖核苷酸的相对数量。(B)经KOH处理(KOH)以及经HincII切割并KOH处理(HincII+KOH)的文库中,线粒体DNA(mtDNA)重链(H)或轻链(L)上核糖核苷酸种类比例与mtDNA基因组组成的比例。(C)经HincII和KOH处理的文库中,线粒体DNA(mtDNA)重链(H)或轻链(L)上每1,000个互补碱基归一化的核糖核苷酸频率。图示改编自参考文献12。误差线表示平均值的标准误差。 请点击此处查看该图的放大版本。
| 名称 | 序列 | |||
| ARC49 | AATGATACGGCGACCACCGAGATCTACACTCTTTCCCTACACGACGCTCTTCCGATCT | |||
| ARC76 | GTGACTGGAGTTCAGACGTGTGCTCTTCCGATCTNNNN*N*N | |||
| ARC77 | AGATCGGAAGAGCACACGTCTGAACTCCAGTC*A*C | |||
| ARC78 | CAAGCAGAAGACGGCATACGAGATCGTGATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC84 | CAAGCAGAAGACGGCATACGAGATACATCGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC85 | CAAGCAGAAGACGGCATACGAGATGCCTAAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC86 | CAAGCAGAAGACGGCATACGAGATTGGTCAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC87 | CAAGCAGAAGACGGCATACGAGATCACTGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC88 | CAAGCAGAAGACGGCATACGAGATATTGGCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC89 | CAAGCAGAAGACGGCATACGAGATGATCTGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC90 | CAAGCAGAAGACGGCATACGAGATTCAAGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC91 | CAAGCAGAAGACGGCATACGAGATCTGATCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC93 | CAAGCAGAAGACGGCATACGAGATAAGCTAGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC94 | CAAGCAGAAGACGGCATACGAGATGTAGCCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC95 | CAAGCAGAAGACGGCATACGAGATTACAAGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC96 | CAAGCAGAAGACGGCATACGAGATTGTTGACTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC97 | CAAGCAGAAGACGGCATACGAGATACGGAACTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC98 | CAAGCAGAAGACGGCATACGAGATTCTGACATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC99 | CAAGCAGAAGACGGCATACGAGATCGGGACGGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC100 | CAAGCAGAAGACGGCATACGAGATGTGCGGACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC101 | CAAGCAGAAGACGGCATACGAGATCGTTTCACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC102 | CAAGCAGAAGACGGCATACGAGATAAGGCCACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC103 | CAAGCAGAAGACGGCATACGAGATTCCGAAACGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC104 | CAAGCAGAAGACGGCATACGAGATTACGTACGGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC105 | CAAGCAGAAGACGGCATACGAGATATCCACTCGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC106 | CAAGCAGAAGACGGCATACGAGATATATCAGTGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC107 | CAAGCAGAAGACGGCATACGAGATAAAGGAATGTGACTGGAGTTCAGACGTGTGCTCTTCCGATCT | |||
| ARC140 | /5AmMC6/ACACTCTTTCCCTACACGACGCTCTTCCGATCT | |||
表1:寡核苷酸。列出了用于HydEn-Seq的寡核苷酸。 加粗表示索引序列。* 表示硫代磷酸键。ARC140含有一个5´-氨基基团而非5´-羟基基团,并结合C6连接子。该修饰可减少连接过程中ARC140串联多聚体的形成。
讨论
本文介绍了一种通过在基因组特定位点引入DNA切割,从而对基因组DNA(尤其是线粒体DNA)中的核糖核苷酸进行同步定位与定量的技术,该技术是在已建立的HydEn-seq方法基础上的改进。尽管本研究聚焦于人类线粒体DNA,但最初的HydEn-seq方法是在Saccharomyces cerevisiae中开发的,表明该方法可推广应用于其他生物体12,16。
为获得本方法的可靠结果,需注意以下关键步骤:(A)由于测序接头会连接到所有可用的5´端,因此必须使用高度完整的DNA。DNA分离后应尽快进行文库构建,或在-20 °C下保存。不建议将DNA长期存放于冰箱中,或反复冻融。(B)为使用该方法生成合适的文库,必须在恒温培养箱中进行DNA的KOH处理,而非使用加热块,以确保整个样品均匀受热并实现定量水解。(C)此外,在文库混合与测序前,必须严格控制文库质量。应使用自动化电泳系统对DNA进行定量和分析,以确认文库DNA的充足含量、片段大小合适,并检测是否存在引物二聚体。
为了进行有意义的数据分析,还需注意,该方法的信息价值依赖于适当的对照,以评估背景计数以及序列或链偏好性。在仅使用序列特异性内切核酸酶消化的情况下,我们通常在KCl样品中达到接近70%的比对效率。图2B,左侧面板)。此外,通过比较经 HincII 处理与未经处理的样本,确认内切酶处理未影响掺入的核糖核苷酸的整体检测至关重要(图3B). 在这些实验中,我们使用了HincII来引入特定位点的切割,但也可使用其他高保真度的限制性内切酶。
该方案可进行调整,用于研究其他可被加工为5´-磷酸或5´-羟基末端的DNA损伤类型。结果的准确性取决于加工过程的特异性,因此需要设置适当的对照(例如,野生型或未经处理的样本)以进行验证。此外,在将本方法应用于其他研究场景或不同生物体时,需注意当前实验设置中每轮文库构建约需1 µg DNA。由于末端数量取决于DNA中嵌入的核糖核苷酸数目,而该数目因生物体或突变体的不同而有所差异,因此含有较少核糖核苷酸的样本需要增加起始DNA投入量,以在后续文库构建中产生足够数量的末端。相反,若DNA样本中核糖核苷酸含量显著较高,则应减少起始DNA投入量,以获得连接反应、第二链合成及PCR扩增的最佳条件。值得注意的是,本方案所述的文库构建方法同样可获得覆盖核基因组的数据(如图2D所示),仅在数据分析阶段聚焦于线粒体DNA。这表明,该方法也适用于捕获核苷酸频率中等偏低的较大基因组。
在考虑本方法时,应注意某些局限性:尽管该方法理论上几乎适用于任何生物体,但需要有合适的参考基因组才能进行测序读段的比对。此外,本实验方案所获得的结果代表了大量细胞的读段信息,因此无法识别特定细胞亚群中核糖核苷酸的掺入模式。若在核糖核苷酸数量极少的大基因组中进行核糖核苷酸定位,可能难以将其与随机的DNA切口区分开来,因此需要设置适当的对照。
我们在此描述的方法拓展了现有的 体内 HydEn-Seq 等技术16,核糖测序17,Pu-Seq18,或 emRiboSeq19这些方法分别利用嵌入的核糖核苷酸对碱性处理或RNase H2处理的敏感性,结合下一代测序技术实现全基因组范围内核糖核苷酸的识别,从而实现其定位及相对掺入水平的比较。通过如上所述在嵌入的核糖核苷酸位点发生特异性DNA序列切割以及碱性水解,可将核糖核苷酸的测序读段归一化至这些切割位点,不仅能够实现核糖核苷酸的识别与定位,还可对每条DNA分子中的核糖核苷酸进行定量。本技术在与DNA复制、DNA修复及跨损伤合成(TLS)相关疾病背景下的应用,有望加深对核糖核苷酸在分子机制及基因组完整性维持中作用的理解。
披露
作者声明不存在任何竞争性经济利益。
致谢
本研究得到了瑞典研究理事会(www.vr.se)向ARC提供的资助(项目编号:2014-6466)以及瑞典战略研究基金会(www.stratresearch.se)向ARC提供的资助(项目编号:ICA14-0060)。在本研究工作期间,查尔姆斯理工大学为MKME提供了财政支持。资助方在研究设计、数据收集与分析、发表决定或稿件撰写过程中均未发挥任何作用。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 10x T4 多核苷酸激酶反应缓冲液 | New England Biolabs | B0201S | |
| 10x T4 RNA 连接酶反应缓冲液 | New England Biolabs | B0216L | |
| 1x PBS | Medicago | 09-9400-100 | 将1片溶解于H2O中,定容至1 L |
| 2-丙醇 | Sigma-Aldrich | 33539-1L-GL-R | |
| 2100 生物分析仪 | Agilent Technologies | G2940CA | |
| 50 mL 离心管 | VWR | 525-0610 | |
| 腺苷-5'-三磷酸(ATP,10 mM) | New England Biolabs | P0756S | 用EB稀释至2 mM |
| Agilent DNA 1000 试剂盒 | Agilent Technologies | 5067-1504 | |
| BSA,分子生物学级(20 mg/mL) | New England Biolabs | B9000S | 用无核酸酶H2O稀释至1 mg/mL |
| 缓冲液EB | QIAGEN | 19086 | 简称EB |
| CleanPCR 顺磁性磁珠 | CleanNA | CPCR-0050 | |
| 脱氧核苷三磷酸(dNTP)溶液混合物(各10 mM) | New England Biolabs | N0447L | 用EB稀释至2 mM |
| DMEM,高糖,含GlutaMAX补充剂 | Gibco | 61965026 | |
| DynaMag 96 侧磁架 | Thermo Fisher | 12331D | |
| 乙醇 99.5%,分析纯 | Solveco | 1395 | 用milliQ水稀释至70% |
| 乙二胺四乙酸溶液(EDTA,0.5 M) | Sigma-Aldrich | 03690-100ML | |
| 胎牛血清 | Gibco | 10500056 | |
| HEPES 缓冲液 pH 8.0(1 M),无菌BC | AppliChem | A6906,0125 | |
| 六氨合钴(III)氯化物(CoCl3(NH3)6) | Sigma-Aldrich | H7891-5G | 溶于无核酸酶H2O中配制成10 M溶液,经无菌过滤。注意:具有致癌性、致敏性,对水生环境有害。 |
| HincII | New England Biolabs | R0103S | 随NEBuffer 3.1提供 |
| 杂交仪HB-1D | Techne | FHB4DD | |
| KAPA HiFi HotStart ReadyMix(2X) | Kapa Biosystems | KK2602 | |
| 裂解缓冲液 | 50 mM EDTA,20 mM HEPES,75 mM NaCl,蛋白酶K(200 µg/mL),1% SDS | ||
| 微量离心管 1.5 mL | Sarstedt | 72.690.001 | |
| 微量离心机 5424R | Eppendorf | 5404000014 | |
| 微型离心机 MiniStar silverline | VWR | 521-2844 | |
| Multiply µStripPro 0.2 mL 管 | Sarstedt | 72.991.992 | |
| 无核酸酶水 | Ambion | AM9937 | |
| 苯酚 – 氯仿 – 异戊醇(25:24:1) | Sigma-Aldrich | 77617-500ML | |
| 氯化钾(KCl) | VWR | 26764.232 | 溶于无核酸酶H2O中配制成3 M溶液,经无菌过滤 |
| 氢氧化钾(KOH) | VWR | 26668.296 | 溶于无核酸酶H2O中配制成3 M溶液,经无菌过滤 |
| 蛋白酶K | Ambion | AM2546 | |
| Qubit 3.0 荧光计 | Invitrogen | Q33216 | |
| Qubit 检测管 | Invitrogen | Q32856 | |
| Qubit dsDNA BR 检测试剂盒 | Invitrogen | Q32850 | 注意:含有易燃和有毒组分 |
| Qubit dsDNA HS 检测试剂盒 | Invitrogen | Q32851 | 注意:含有易燃和有毒组分 |
| 冷冻离心机 4K15 | Sigma Laboratory Centrifuges | No. 10740 | |
| SDS 溶液,10% | Invitrogen | 15553-035 | |
| 乙酸钠缓冲液,pH 5.2,3 M(NaAc) | Sigma-Aldrich | S7899 | |
| 氯化钠(NaCl) | VWR | 27810.295 | 溶于无核酸酶H2O中配制成5 M溶液,经无菌过滤 |
| T100 梯度PCR仪 | Bio-Rad | 1861096 | |
| T4 多核苷酸激酶(3'磷酸酶缺失型) | New England Biolabs | M0236L | |
| T4 RNA 连接酶1(ssRNA连接酶) | New England Biolabs | M0204L | 随PEG 8000(50%)提供 |
| T7 DNA 聚合酶(未修饰) | New England Biolabs | M0274S | 随10x T7 DNA 聚合酶反应缓冲液提供 |
| TE 缓冲液 | Invitrogen | 12090015 | |
| ThermoMixer F2.0 | Eppendorf | 5387000013 |
参考文献
- Traut, T. W. Physiological Concentrations of Purines and Pyrimidines. Mol. Cell. Biochem. 140, 1-22 (1994).
- McElhinny, S. A. N., et al. Abundant ribonucleotide incorporation into DNA by yeast replicative polymerases. Proc. Natl. Acad. Sci. USA. 107, 4949-4954 (2010).
- Williams, J. S., Lujan, S. A., Kunkel, T. A. Processing ribonucleotides incorporated during eukaryotic DNA replication. Nat. Rev. Mol. Cell Biol. 17, 350-363 (2016).
- Clausen, A. R., Zhang, S., Burgers, P. M., Lee, M. Y., Kunkel, T. A. Ribonucleotide incorporation, proofreading and bypass by human DNA polymerase delta. DNA Repair. 12, 121-127 (2013).
- Potenski, C. J., Klein, H. L. How the misincorporation of ribonucleotides into genomic DNA can be both harmful and helpful to cells. Nucleic Acids Res. 42, 10226(2014).
- Vengrova, S., Dalgaard, J. Z. RNase-sensitive DNA modification(s) initiates S. pombe mating-type switching. Gene. Dev. 18, 794-804 (2004).
- Lujan, S. A., Williams, J. S., Clausen, A. R., Clark, A. B., Kunkel, T. A. Ribonucleotides Are Signals for Mismatch Repair of Leading-Strand Replication Errors. Mol. Cell. 50, 437-443 (2013).
- Ghodgaonkar, M. M., et al. Ribonucleotides Misincorporated into DNA Act as Strand-Discrimination Signals in Eukaryotic Mismatch Repair. Mol. Cell. 50, 323-332 (2013).
- DeRose, E. F., Perera, L., Murray, M. S., Kunkel, T. A., London, R. E. Solution Structure of the Dickerson DNA Dodecamer Containing a Single Ribonucleotide. Biochemistry. 51, 2407-2416 (2012).
- Li, Y. F., Breaker, R. R. Kinetics of RNA degradation by specific base catalysis of transesterification involving the 2 '-hydroxyl group. J. Am. Chem. Soc. 121, 5364-5372 (1999).
- McElhinny, S. A. N., et al. Genome instability due to ribonucleotide incorporation into DNA. Nat. Chem. Biol. 6, 774-781 (2010).
- Berglund, A. K., et al. Nucleotide pools dictate the identity and frequency of ribonucleotide incorporation in mitochondrial DNA. Plos Genet. 13, (2017).
- Brown, J. A., Suo, Z. C. Unlocking the Sugar "Steric Gate" of DNA Polymerases. Biochemistry. 50, 1135-1142 (2011).
- Sparks, J. L., et al. RNase H2-Initiated Ribonucleotide Excision Repair. Mol. Cell. 47, 980-986 (2012).
- Miyabe, I., Kunkel, T. A., Carr, A. M. The Major Roles of DNA Polymerases Epsilon and Delta at the Eukaryotic Replication Fork Are Evolutionarily Conserved. Plos Genet. 7, (2011).
- Clausen, A. R., et al. Tracking replication enzymology in vivo by genome-wide mapping of ribonucleotide incorporation. Nat. Struct. Mol. Biol. 22, 185-191 (2015).
- Koh, K. D., Balachander, S., Hesselberth, J. R., Storici, F. Ribose-seq: global mapping of ribonucleotides embedded in genomic DNA. Nat. Methods. 12, 251(2015).
- Keszthelyi, A., Daigaku, Y., Ptasinska, K., Miyabe, I., Carr, A. M. Mapping ribonucleotides in genomic DNA and exploring replication dynamics by polymerase usage sequencing (Pu-seq). Nat. Protoc. 10, 1786-1801 (2015).
- Ding, J., Taylor, M. S., Jackson, A. P., Reijns, M. A. M. Genome-wide mapping of embedded ribonucleotides and other noncanonical nucleotides using emRiboSeq and EndoSeq. Nat. Protoc. 10, 1433-1444 (2015).
- Martin, M. Cutadapt removes adapter sequences from high-throughput sequencing reads. EMBnet.journal. 17, 10-12 (2011).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biol. 10, (2009).
重印与许可
