本文介绍了蛋白质基因组学工具 PoGo,以及将通过质谱鉴定的肽段快速、定量地映射到参考基因组的实验方案,该方案支持翻译后修饰和变异位点的识别。该工具可用于整合和可视化蛋白质基因组学及个体化蛋白质组学研究,并与正交基因组学数据进行关联分析。
本文内容
摘要
摘要
基因、转录本与蛋白质之间的相互作用是细胞响应的关键;因此,对分子层面的研究正逐渐从孤立分析扩展到整合性研究,以更深入地理解细胞内的分子动态。目前用于蛋白质组学与其他组学数据集可视化和整合的工具,在大规模研究中仍显不足,且仅能捕捉基本的序列匹配信息,无法保留翻译后修饰和定量数据。为解决这些问题,我们开发了 PoGo 工具,可将带有翻译后修饰和定量信息的肽段映射到参考基因组注释上。此外,该工具还支持将来自定制化序列数据库(包含单氨基酸变异)鉴定出的肽段进行映射。尽管 PoGo 本身是一个命令行工具,但其图形化界面 PoGoGUI 使非生物信息学背景的研究人员也能轻松地将肽段映射到 Ensembl 基因组注释支持的 25 个物种上。生成的输出结果采用基因组学领域通用的文件格式,因此可在大多数基因组浏览器中进行可视化。对于大规模研究,PoGo 还可通过 TrackHubGenerator 支持创建可在线访问的基因组映射数据存储库,便于蛋白质基因组学数据的共享。该工具仅需少量操作,即可在数分钟内将数百万条肽段映射到参考基因组上,性能优于其他现有的基于序列一致性的工具。本实验方案通过公开的定量蛋白质组学、磷酸化蛋白质组学数据以及大规模研究数据,展示了利用 PoGo 进行蛋白质基因组学映射的最佳实践方法。
引言
在细胞中,基因组、转录组和蛋白质组相互影响,以调节对内外刺激的响应,并通过相互作用执行特定功能,从而影响健康与疾病状态。因此,对基因、转录本和蛋白质进行表征与定量,对于全面理解细胞过程至关重要。新一代测序(NGS)是鉴定和定量基因及转录本表达最常用的方法之一。然而,蛋白质表达通常通过质谱(MS)进行评估。过去十年中,质谱技术的显著进步使得蛋白质组的鉴定与定量更加全面,从而使数据可与转录组学数据相比较1。将NGS与MS数据整合的蛋白质基因组学(proteogenomics)和多组学(multi-omics)方法已成为在多个分子层面上评估细胞过程的有力手段,可用于识别癌症亚型并发现潜在的新型药物靶点2,3。需要指出的是,蛋白质基因组学最初被用于为基因和转录本注释提供蛋白质组学证据4。近年来,基于大规模的人体组织数据集,一些先前被认为是非编码的基因已重新受到审视5,6,7。此外,蛋白质组学数据已成功用于支持非模式生物中的基因注释工作8,9。然而,蛋白质基因组学数据的整合仍可进一步挖掘,以结合基因组特征揭示蛋白质表达情况,并通过建立联合参考系统及共可视化方法,阐明转录本与蛋白质之间的相互调控关系。
为了为蛋白质组学、转录组学和基因组学数据提供一个共同的参考体系,已开发出多种工具,用于将通过质谱(MS)鉴定出的肽段映射到基因组坐标上10,11,12,13,14,15,16,17。这些方法在参考体系、对基因组浏览器的支持程度以及与其他蛋白质组学工具的整合程度等方面各不相同,如图1所示。部分工具将反向翻译得到的肽段映射到基因组上16,而另一些工具则利用搜索引擎标注的蛋白质位置及基因注释信息,重建肽段的核苷酸序列15。还有一些工具采用基因组的三框或六框翻译结果进行肽段比对11,13。最后,若干工具跳过核苷酸序列,转而使用来自RNA测序比对转录本的氨基酸序列翻译结果作为中间媒介,将肽段映射至相应的基因组坐标10,12,14,17。然而,核苷酸序列的翻译过程较为耗时,且自定义数据库容易出错,这些错误会进一步传递至肽段映射结果中。因此,为了实现快速、高通量的映射,一个小型而全面的参考体系至关重要。一个具备相应基因组坐标的标准化蛋白质参考数据库,是实现准确肽段到基因组映射的关键。近年来,蛋白质基因组学中的新方向,如整合序列变异和翻译后修饰(PTMs)2,3,正受到越来越多关注。然而,如图1所示,当前大多数蛋白质基因组映射工具通常不支持这些功能。为提升映射的速度与质量,PoGo 工具被开发出来,该工具可实现肽段到基因组的快速定量映射18。此外,PoGo 还支持包含最多两个序列变异以及带有注释的翻译后修饰的肽段映射。
PoGo 的开发旨在应对捕获蛋白质组及全局修饰的定量高分辨率数据集的快速增长,为大规模分析(如个体差异和精准医学)提供核心工具。本文描述了该工具在可视化翻译后修饰与基因组特征之间关系中的应用。此外,本文还强调了通过比对肽段识别可变剪接事件,以及将通过自定义变异数据库鉴定出的肽段映射到参考基因组的方法。本实验方案采用从 PRIDE 数据库公开获取的数据集19,以演示 PoGo 的上述功能。同时,本方案还介绍了使用 TrackHubGenerator 创建可在线访问的肽段基因组比对中心,用于大规模蛋白质基因组学研究。
方案
1. 准备、下载和设置
注意:文件和文件夹路径示例采用 Windows 格式,以便标准用户方便访问。PoGo 和 PoGoGUI 也适用于 macOS 和 Linux 操作系统。
- 从 GitHub 下载 PoGo 和 PoGoGUI
- 打开网页浏览器,访问 GitHub 上的 PoGo(http://github.com/cschlaffner/PoGo/),然后选择 发布版本 并下载最新发布的 zip 压缩文件。将压缩文件解压至 executables 文件夹中(例如,C:\PoGo\executables\)。
- 在网页浏览器中访问 GitHub 上的 PoGoGUI(http://github.com/cschlaffner/PoGoGUI/),然后选择 发布版本 并下载最新版本的 jar 文件(例如, “PoGoGUI-v1.0.2.jar”)。将该 jar 文件存储至 executables 文件夹中。
- 下载基因组注释和翻译的蛋白质编码序列
注意:从 GENCODE 下载所支持物种的基因组注释和翻译后的蛋白质编码序列7 (www.gencodegenes.org)或 Ensembl20 (www.ensembl.org) 的通用转录格式(GTF)以及FASTA格式的蛋白质序列。- 在网页浏览器中,访问 www.gencodegenes.org 并选择 数据 | 人类 | 当前版本. 下载 全面的基因注释 通过 GTF 链接并将 gz 压缩文件解压至 data 文件夹(例如,C:\PoGo\Data\) 使用解压缩程序(例如,7-Zip)
- 下载 蛋白质编码转录本的翻译序列 通过 FASTA 链接获取并解压 gz 压缩文件至上一步生成的数据文件夹中。
- 或者,在网页浏览器中访问 www.ensembl.org 并选择 下载量 随后 通过 FTP 下载数据. 查找支持的物种(例如,人类)。使用 GTF 链接下载用于转录本注释的最新版本文件 基因集 列。选择文件名结构为“species.release.gtf.gz”的文件,并将该gz压缩文件解压至数据文件夹中。
- 使用 FASTA 链接下载最新版本的蛋白质编码转录本翻译序列 蛋白质序列(FASTA) 列。选择文件名结构为“species.release.pep.all.fa.gz”的文件,并将该gz压缩文件解压至数据文件夹中。
- 准备肽段鉴定文件
注意:PoGo 仅支持包含样本标识符、肽段序列、肽谱匹配数(PSMs)和定量值的四列格式。然而,PoGoGUI 支持标准化的鉴定文件格式 mzIdentML、mzid 和 mzTab,并使用公开可用的框架 ms-data-core-api 将其转换为 PoGo 的四列格式。21.mzIdentML、mzid 或 mzTab 格式的文件可从 PRIDE 仓库下载19或者,数据可以以制表符分隔的文件格式(扩展名为 .tsv 或 .pogo)提供。该格式包含 4 列,列标题分别为:样本标识符(Sample)、肽段序列(Peptide)、肽谱匹配数(PSMs)和肽段定量值(Quant)。示例如下所示: 图2.- 从PRIDE数据库下载一份关于人类睾丸的蛋白质组学研究的mzTab格式示例文件19 (https://www.ebi.ac.uk/pride/archive/projects/PXD006465/files22).
- 将压缩的 gz 文件保存并解压到步骤 1.2.1 中创建的数据文件夹中。
注意: 或者,可从 PRIDE 数据库下载使用 MaxQuant 搜索的人类磷酸化蛋白质组学示例数据(文件“Traktman_2013_MaxQuantOutput-full.zip”,网址:https://www.ebi.ac.uk/pride/archive/projects/PXD005246/files)23). - 将压缩的 zip 文件保存并解压至步骤 1.2.1 中创建的数据文件夹中。
- 打开一个空白电子表格,使用导入功能从文件夹 C:/PoGo/Data/Traktman_2013_MaxQuantOutput-full/combined/txt/ 中导入 peptides.txt 文件 数据 | 来自文本/CSV在打开的窗口中,单击 编辑.
- 保留“Sequence”、“Experiment BR1”、“Experiment BR2”、“Experiment BR3”、“Ratio H/L normalized BR1”、“Ratio H/L normalized BR2”和“Ratio H/L normalized BR3”列,其余所有列均删除。
- 选择“Ratio H/L normalized BR1”、“Ratio H/L normalized BR2”和“Ratio H/L normalized BR3”各列,然后单击 转换 | 取消透视列选择“Experiment BR1”、“Experiment BR2”和“Experiment BR3”列,然后重复执行逆透视操作。
- 选择结果列“Attribute”,并使用以下方法拆分其内容 变换 | 拆分列 | 按分隔符选择 太空 在下拉菜单中选择“分隔符”。对“Attribute.1”列重复此操作。
- 移除生成的列“Attribute.1.1”、“Attribute.2”、“Attribute.3”和“Attribute.1.1.1”。
- 使用以下方法添加一列 添加列 | 自定义列 选项。调整自定义列公式以表示以下内容:“=[Attribute.4]=[Attribute.1.2]”。
- 对生成的自定义列应用筛选器,排除所有包含“FALSE”的行;仅保留包含“TRUE”的行。
- 移除“Attribute.1.2”和“Custom”两列,并将剩余列的顺序调整为:“Attribute.4”、“Sequence”、“Value.1”和“Value”。
- 将列名称分别更改为“实验”、“肽段”、“PSM”和“定量”。使用以下方法加载文件 首页 | 关闭&Load.
- 将文件另存为制表符分隔的文件,使用 文件 | 另存为 选择“文本(制表符分隔)(*.txt)”类型。将文件名更改为“peptides_pogo.txt”,并保存至 C:/PoGo/Data 文件夹中。
2. 绘制带有注释的翻译后修饰肽段图谱及包含定量信息的可视化
注意:生成的输出文件可在任何支持浏览器可扩展数据(BED)格式的基因组浏览器中加载。可选的浏览器包括整合基因组浏览器(IGV)24(下文将使用该浏览器)、UCSC基因组浏览器25和Ensembl基因组浏览器20。需要注意的是,用于PoGo比对的注释GTF文件和蛋白质FASTA文件的版本必须与基因组浏览器中所用基因组的版本相匹配。对于人类Ensembl 57-75版本以及GENCODE 3d-19版本,应使用GRCh37/hg19;对于Ensembl 76及以上版本或GENCODE 20及以上版本,应使用GRCh38/hg38。对于小鼠Ensembl 74及以上版本或GENCODE M2及以上版本,应使用GRCm38。
- 使用 PoGoGUI 映射肽段(见图 3)。
- 转到可执行文件夹,通过双击图标启动程序 PoGoGUI-vX.X.X.jar.
注意:图形用户界面将启动,可直观便捷地选择各项选项。 - 使用 选择 按钮,然后进入可执行文件文件夹中的相应操作系统子文件夹(例如,C:\PoGo\Executables\Windows\)。选择 PoGo 的可执行文件(例如,PoGo.exe)并通过点击确认其选择 开放 按钮。
- 单击以选择用于蛋白质序列的参考输入文件 选择. 导航至数据文件夹并选择翻译后的FASTA文件。通过单击确认选择该文件 开放 按钮
- 使用以下步骤选择转录本注释文件 选择 按钮。导航至数据文件夹并选择注释GTF文件。通过点击确认选择 开放 按钮。
- 添加肽段鉴定文件——支持多文件选择——通过使用 添加 “肽段文件”旁边的按钮。选择支持格式的文件,如 mzTab、mzIdentML 或 mzid,或选择在步骤 1.3 中下载并准备好的以制表符分隔的四列格式文件。
- 取消勾选输出格式选项中 BED 和 GTF 旁边的复选框,仅保留 PTM BED 和 GCT 为勾选状态。
- 从下拉菜单中选择与数据对应的物种。FASTA 文件、GTF 文件以及下拉菜单中的选择必须为同一物种。
- 开始映射,点击 开始 按钮
注意:如有需要,PoGoGUI 将把输入文件转换为 pogo 格式,同时在相同文件夹中生成 pogo 文件以便后续使用,并启动比对流程。在开始比对前,单个在步骤 1.3.1 中下载的 mzTab 文件的转换过程将持续 10 至 20 分钟。
- 转到可执行文件夹,通过双击图标启动程序 PoGoGUI-vX.X.X.jar.
- 在整合基因组学查看器中进行可视化
注意:参见 图4.- 通过 IGV 加载以“_ptm.bed”结尾的 PoGo 输出文件 文件 | 从文件加载 并选择文件。
注意:由于文件较大,某些文件可能需要生成索引以快速重新加载基因组区域。IGV 将自动提示用户进行索引生成,请按照所显示的说明操作。 - 对以“_noptm.bed”结尾的文件重复上述加载步骤。该文件包含所有未发现有任何修饰的肽段。
- 请注意,每个加载的文件将显示为独立的轨道,并以文件名标识该轨道。通过拖放操作,可将轨道在列表中重新排序至所需位置。
- 注意,每条轨道最初均以折叠形式显示。要展开它们,可右键单击轨道名称,然后选择“expanded”以完整显示肽段(包括序列),或选择“squished”以堆叠形式显示。
- 重复对以“.gct”结尾的文件进行加载操作。该文件包含每个注释样本的肽段定量数据。
- 与上述加载的文件不同,每个带注释的样本将作为独立的轨道加载。通过拖放操作重新排列样本。
- 通过下拉菜单选择染色体、输入基因组坐标、搜索基因符号,或单击并按住染色体的某一片段以放大查看,从而在基因组中进行导航。
- 通过 IGV 加载以“_ptm.bed”结尾的 PoGo 输出文件 文件 | 从文件加载 并选择文件。
3. 将通过自定义变异数据库鉴定出的肽段比对至参考基因组
注意:PoGo 比对可通过图形用户界面(GUI)或命令行界面进行,二者可互换使用。在本实验方案的此部分中,采用命令行界面以突出其可互换性。本节方案的第二部分需要使用软件工具 R26。请确保该软件包已安装。
- 将参考肽段比对到参考基因组。
- 打开命令提示符(cmd),并导航至 PoGo 的可执行文件夹(例如,C:\PoGo\Executables\)。
- 输入以下命令:
PoGo.exe -gtf \PATH\TO\GTF -fasta \PATH\TO\FASTA -in \PATH\TO\IN -format BED -species MYSPECIES- 将 \PATH\TO\GTF、\PATH\TO\FASTA 和 \PATH\TO\IN 分别替换为注释 GTF 文件、蛋白质序列 FASTA 文件以及肽段鉴定文件(四列格式,文件扩展名为 “.tsv” 或 “.pogo”)的路径。同时将 MYSPECIES 替换为与数据一致的物种(例如,Human)。
- 按“Enter”键确认执行。等待执行完成后再进行后续操作。
注意:此过程可能需要几分钟。生成的文件将保存在肽段输入文件所在的同一文件夹中,在下文中将被视为 \PATH\TO\OUT.pogo.bed。
- 从输入文件中仅提取变异肽段。
- 打开 R,并使用以下命令加载输入文件 \PATH\TO\IN:
inputdata <- read.table(“PATH/TO/IN”,header=TRUE,sep=”\t”) - 使用以下命令加载已比对的肽段:
mappedpeptides <- read.table(“PATH/TO/OUT.pogo.bed”,sep=”\t”,header=FALSE) - 从 inputdata 中移除已被比对的肽段:
peptidesnotmapped <- inputdata[!(inputdata$Peptide %in% mappedpeptides$V4),] - 将未比对的肽段输出为新的输入文件:
write.table(peptidesnotmapped, “PATH\TO\IN.notmapped.pogo”, header=FALSE, sep=”\t”, col.names=TRUE,row.names=FALSE,quote=FALSE)
- 打开 R,并使用以下命令加载输入文件 \PATH\TO\IN:
- 允许错配的情况下,将剩余肽段比对到参考基因组。
- 与步骤 3.1 相同,打开命令提示符并导航至 PoGo 的可执行文件夹。
- 输入以下命令,允许 1 个氨基酸错配,并将 \PATH\TO\GTF、\PATH\TO\FASTA 和 \PATH\TO\IN.notmapped.pogo 分别替换为注释 GTF 文件、蛋白质序列 FASTA 文件以及步骤 3.2 中生成的肽段鉴定文件的路径。同时将 MYSPECIES 替换为与数据一致的物种(例如,Human)。
- PoGo.exe -gtf \PATH\TO\GTF -fasta \PATH\TO\FASTA -in \PATH\TO\IN -format BED -species MYSPECIES -mm 1
- 按“Enter”键确认命令执行。等待执行完成后再进行后续操作。
注意:此过程可能需要几分钟。生成的文件将保存在肽段输入文件所在的同一文件夹中,在下文中将被视为 \PATH\TO\OUT.pogo_1MM.bed。
- 按照步骤 2.2 中所述,在 IGV 中可视化无错配和允许错配情况下比对的肽段。
4. 使用多个文件进行比对及为大型数据集生成轨迹中心
- 使用 PoGoGUI 从多个文件中映射肽段
- 导航至可执行文件夹,并通过运行启动程序的图形用户界面 PoGoGUI-vX.X.X.jar.
- 选择适用于当前操作系统的 PoGo 可执行文件(此处为 Linux),以及如步骤 2.1.2 - 2.1.4 所述的参考输入蛋白质序列 FASTA 文件和注释 GTF 文件。
- 使用肽段鉴定文件进行添加 添加 “肽段文件”旁边的按钮;支持多文件选择,以及拖放至“肽段文件”下方的空白区域。
- 取消勾选输出格式部分中 PTM BED、GTF 和 GCT 旁边的复选框,仅保留 BED 处于勾选状态。
- 选择选项 将多个输入文件合并为单个输出文件.
注意:选中此选项将生成单个输出文件,其中包含所有输入文件的肽段。若不选择此选项,则程序将对每个输入文件依次单独执行。 - 从下拉菜单中选择与FASTA和GTF文件一致的适当物种。
- 开始映射,点击 开始 按钮。如有必要,程序会将输入文件转换为 pogo 格式,此过程可能需要一定时间。在此期间,请下载用于生成 track hub 所需的工具和脚本。
- 准备生成轨迹中心
- 打开网页浏览器,访问 https://github.com/cschlaffner/TrackHubGenerator,下载文件“TrackHubGenerator.pl”,并将该文件保存至可执行文件夹中。
- 在网页浏览器中,访问 www.hgdownload.soe.ucsc.edu/admin/exe/,选择与当前操作系统对应的文件夹(此处为 Linux),下载该工具 bedToBigBed 以及脚本 fetchChromSizes 到可执行文件夹中27.
- 由比对肽段生成轨迹中心
注意:PoGoGUI 完成肽段比对后,可自动为存储在同一文件夹中所有 BED 格式的输出文件生成轨道中心(track hub)。- 打开终端窗口并输入以下命令:
Perl TrackHubGenerator.pl 路径/到/名称 基因组版本 FBED UCSC 电子邮箱- 将 PATH/TO/NAME 替换为轨道中心的文件路径和名称(例如,~/PoGo/Data/Mytrackhub),ASSEMBLY 为注释所基于的基因组组装版本(例如,人类基因组hg38),FBED为包含将用于构建track hub的BED文件的文件夹路径(例如,~/PoGo/Data/),UCSC 替换为存储从 UCSC 下载工具的文件夹路径(例如、~/PoGo/Executables/)以及负责该轨道枢纽的人员的电子邮件地址(EMAIL)。
- 按“Enter”键确认执行;执行过程只需很短时间即可完成。
- 转移生成的track hub(即将创建的文件夹 ~/PoGo/Data/Mytrackhub/ 及其所有内容上传至可通过网络访问的 FTP 服务器。
注意:建议使用带有相关联 Web 服务器的 FTP 服务器,以便通过 ftp 和 http 协议访问 track hub。 代码托管平台 GitHub(github.com)和 Figshare(figshare.com)支持此类访问,可替代 FTP 服务器使用。
- 打开终端窗口并输入以下命令:
- 在 UCSC 基因组浏览器中可视化 track hub
- 在网页浏览器中,访问 https://genome.ucsc.edu/ 并选择 我的数据 | 轨道中心. 点击该标签页 我的中心.
- 将 track hub 的 URL 复制到文本框中。
注意:URL 由服务器地址、track hub 位置和名称以及 hub.txt 文件组成(例如http://ngs.sanger.ac.uk/production/proteogenomics/WTSI_proteomics_PandeyKusterCutler_tissues_hi/hub.txt - 单击以加载轨迹中心 添加集线器.
注意:中心将被加载,并会显示一条简短消息,说明该轨迹中心的详细信息,例如其名称、负责该轨迹中心的人员的联系方式以及所使用的基因组组装版本。网站将返回主页面。 - 选择 基因组浏览器 进入浏览器视图。
注意:自定义轨道集线器将显示在列表顶部。如果多个 BED 文件构成了该轨道集线器的基础,则每个文件将在集线器内显示为一个独立的轨道。
结果
PoGo 在常规蛋白质组学工作流程中所发挥作用的图示说明18 应用以及下游可视化选项如图所示 图5. 鸟枪法蛋白质组学(即蛋白质的酶解消化结合液相色谱-串联质谱分析是蛋白质组-基因组关联图谱构建的一个前驱步骤。通常会将获得的串联质谱图与源自蛋白质序列数据库的理论谱图进行比较。蛋白质组-基因组学研究将具有编码潜力的新型转录本翻译序列以及非同义单核苷酸变异引入数据库,这使得难以将这些信息直接关联回参考基因组。8PoGo 图形用户界面(PoGoGUI)支持用于标准化报告质谱实验中肽段鉴定结果的文件格式,并将其转换为简化的 4 列 pogo 格式。PoGoGUI 封装了命令行工具 PoGo,从而能够利用通常以 GTF 格式提供的蛋白质编码基因参考注释以及 FASTA 格式的翻译转录本序列,将肽段比对到基因组坐标上。PoGo 可生成多种输出格式,用于可视化质谱鉴定出的肽段的不同特征,包括翻译后修饰和肽段水平的定量信息。生成的 BED 格式输出文件可进一步转换并整合为可在线访问的目录,称为 track hub。单个输出文件以及 track hub 均可在 UCSC 基因组浏览器等浏览器中进行可视化。25,Ensembl 基因组浏览器20,IGV24和 Biodalliance28 (参见 图5 底部。
我们应用 PoGo 对在 Wright 描述的高显著性水平下筛选的人类蛋白质组草图图谱进行了重新分析 等7 并与另外两种用于蛋白质基因组学作图的工具 iPiG 进行了比较14 和 PGx10该数据集包含来自59种成人和胎儿组织的233,055个独特肽段,总计超过300万条序列。如图所示,PoGo在运行时间(分别快6.9倍和96.4倍)和内存使用(分别减少20%和60%的内存)方面均优于这些工具。 图618成功比对的肽段示例如下所示 图7.
尽管 PoGo 在速度和内存使用方面显著优于其他工具,但它还能够将与肽段相关的翻译后修饰和定量信息映射到基因组上。 图8A 示意图展示了 BED 格式在基因组浏览器中对映射到单个外显子及跨越剪接位点的肽段的可视化效果。PoGo 利用着色选项,直观地辅助判断肽段在基因组中映射的唯一性。红色映射表示该肽段唯一对应于单个转录本,黑色表示映射至单个基因,但该肽段在不同转录本之间共享;灰色映射则表示该肽段在多个基因之间共享。例如,后两种情况在基因定量分析中可靠性较低,或在判断基因表达时可信度较差。PoGo 的 PTM BED 选项重新定义了颜色编码,以区分不同类型的翻译后修饰,如图所示。 图 8B此外,翻译后修饰以粗块表示(见 图8B一种类型的单个翻译后修饰由修饰氨基酸残基位置上的粗块表示,而同一类型的多个翻译后修饰则由从第一个修饰氨基酸到最后一个修饰氨基酸的粗块横跨表示。
我们对包含全蛋白质组和磷酸化蛋白质组的50种结直肠癌细胞系数据集应用了PoGo,随后应用了TrackHubGenerator29。虽然在UCSC基因组浏览器中加载的track hub展示了映射到基因组的肽段,并突出了映射的唯一性以及磷酸化位点(见图9),但补充文件夹中还提供了额外数据。GCT文件可用于在基因组背景下可视化肽段和磷酸化肽段的定量信息。然而,GCT文件无法直观展示跨越剪接位点的肽段(见图10顶部)。跨越剪接位点的肽段会被拆分为各自对应外显子的片段。尽管可以通过外显子映射的相同定量值来识别剪接肽段,但加载基于序列的映射文件(如通过细线连接外显子以跨越内含子的BED或GTF文件)有助于结果解读(见图10底部)。
为了突出变体启用映射(variant enabled mapping)的应用价值,我们采用多酶策略,将 PoGo 以两种配置应用于人类睾丸蛋白质组数据集,并在 neXtProt 数据库中搜索以寻找缺失蛋白质22。neXtProt 除包含参考蛋白质序列外,还涵盖超过 500 万个单氨基酸变体30。目前其他映射工具尚不支持对含有单氨基酸变体的肽段进行映射。共鉴定出 177,012 个唯一肽段,其中 99.8%(176,694)的肽段在不允许错配的情况下首次成功映射。从已鉴定肽段列表中去除这些肽段后,剩余 0.2%(318)的肽段在允许一个氨基酸替换的条件下实现了映射。这使得 162 个原本无法通过任何其他现有工具映射到参考基因组的肽段实现了共计 3,446 次映射。尽管包含错配的映射次数平均较高,但其中有 62 个肽段仅映射到单一基因位点,表明其为真实的变体序列。在 图 11 中突出显示了一个通过单氨基酸替换实现映射的肽段示例,包括其序列及对应的基因组翻译序列。

图 1. 不同肽段-基因组比对工具的可视化比较。 本图从多个方面对各类工具进行了比较,包括比对参考序列、与分析框架的整合程度,以及对在线和离线浏览器的支持情况。此外,还单独列出了蛋白质基因组学中的新特性及其功能支持情况。与其他工具相比,PoGo 唯一缺乏的是直接比对到基因组序列的能力;然而,PoGo 支持所有其他大多数工具尚不支持的新功能。请点击此处查看本图的放大版本。

图 2. 用于肽段比对的示例输入文件。 PoGo 接受以制表符分隔的四列格式输入数据。第一行的列标题为“Experiment”、“Peptide”、“PSMs”和“Quant”,分别对应后续各行中的实验或样本标识符、肽段序列、肽谱匹配数以及肽段的定量值。支持的文件扩展名为 *.txt、*.tsv 和 *.pogo。请点击此处查看该图的放大版本。

图 3. PoGoGUI 界面,突出显示文件选择和参数选项的步骤。 该图展示了选择并上传所有必需文件的步骤,以及将带有翻译后修饰的肽段比对到人类参考基因组的选项设置。 请点击此处查看此图的放大版本。

图 4. 综合基因组浏览器(IGV)数据上传过程的截图。 该图突出展示了在IGV浏览器中上传PoGo输出文件的步骤。此外,还显示了扩展已比对肽段轨道的选项,以突出显示比对位置和序列信息。 请点击此处查看此图的放大版本。

图5. 从LC-MS/MS到基因组浏览器可视化步骤的简化工作流程。 PoGo比对在串联质谱中鉴定出的肽段之后进行。为实现向基因组的比对,PoGo利用以基因组注释(GTF)和转录本翻译序列(FASTA)形式提供的参考注释。生成多种输出格式,可分别加载至基因组浏览器中。此外,BED格式的文件可整合为track hub,以支持大规模数据集的可视化。请点击此处查看该图的放大版本。

图 6. PoGo 与 PGx 和 iPiG 的性能基准测试。PoGo 在基准测试中优于其他工具。 对跨越 59 种成体和胎儿组织的 233,055 条独特肽段进行比对,共产生超过 300 万条序列,PoGo 的运行速度分别比 PGx 和 iPiG 快 6.9 倍和 96.4 倍。此外,PoGo 所需内存分别比 PGx 和 iPiG 减少 20% 和 60%。在测试中,PoGo 和 PGx 成功完成任务,而 iPiG 在内存达到 16 GB 时出现内存错误。请点击此处查看此图的放大版本。

图7. UCSC基因组浏览器中肽段定位结果的示例视图。 该图显示了定位到mTOR基因的肽段。在整合轨道中,肽段跨越剪接位点,并仅与一个外显子及其相关序列对应;而在组织特异性轨道中,仅以压缩格式突出显示其定位区域。请点击此处查看该图的放大版本。

图 8. 映射可视化与颜色编码示意图。 (A)在标准的 BED 输出文件中,映射到外显子的肽段显示为单个方块(左),而跨越多个外显子的肽段则以外显子覆盖部分显示为多个方块(右)。内含子以细的连接线表示。PoGo 采用三级系统对肽段映射的唯一性或基因与转录本的映射进行颜色编码。(B)除了 BED 格式的方块结构外,PTM BED 输出将翻译后修饰的位置以粗方块突出显示。单个类型修饰的存在以粗方块标示修饰的氨基酸残基,而同一类型修饰的多个位点则合并为从第一个到最后一个修饰位点的长方块。肽段映射进一步按 PTM 类型划分,并根据修饰类型进行颜色编码。请点击此处查看此图的放大版本。

图9. 结直肠癌蛋白质组和磷酸化蛋白质组数据在UCSC基因组浏览器中的轨道枢纽视图。 该轨道枢纽包含完整的蛋白质组数据以及磷酸化蛋白质组数据。蛋白质组和磷酸化蛋白质组轨道中的红色表示唯一映射到SFN单个转录本的序列,而以_ptm结尾的轨道则显示肽段内的磷酸化位点。此处红色表示修饰类型为磷酸化。仅鉴定出两个肽段,每个肽段均显示一个单独的磷酸化位点(粗块表示)。请点击此处查看该图的放大版本。

图10. 在IGV中查看结直肠癌磷酸化肽段及其定量结果。 该图展示了50种癌细胞系的一个子集。图中还显示了四列不同深浅的浅红色方块,颜色表示相对丰度,从低(白色)到高(红色)。尽管四列方块可能最初让人误以为存在4种肽段,但结合相应的基于序列的GTF输出文件可以明确,实际上只有两种肽段,每种均跨越一个剪接位点。请点击此处查看该图的放大版本。
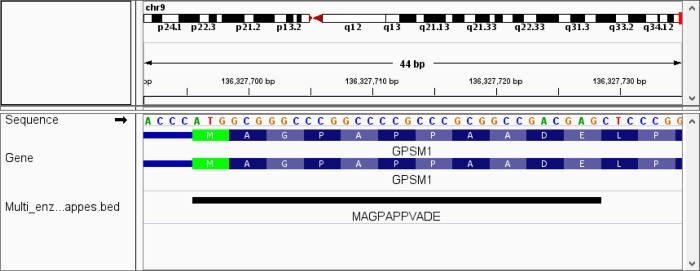
图11. IGV中含氨基酸变异的肽段视图。 该图显示了一条单氨基酸变异的肽段,已比对至GPSM1基因翻译起始位置的参考基因组。该变异位于第8位氨基酸残基,导致丙氨酸被缬氨酸取代(A→V)。注释转录本(蓝色)的翻译序列与肽段序列相比,突显了该变异位点。请点击此处查看此图的放大版本。
讨论
本方案描述了软件工具 PoGo 及其图形用户界面 PoGoGUI 如何实现将肽段快速比对到基因组坐标上。该工具提供了独特的功能,例如利用参考注释实现定量、翻译后修饰和基因变异支持的基因组比对。本文在一个大规模的蛋白质基因组学研究中演示了该方法,并强调了其相较于其他现有工具在速度和内存效率方面的优势18。结合可生成在线可访问的基因组及基因组关联数据枢纽的工具 TrackHubGenerator,PoGo 及其图形用户界面使大规模蛋白质基因组学研究能够快速在基因组背景下可视化其数据。此外,我们还通过针对变异数据库搜索的数据集以及定量磷酸化蛋白质组学数据集,展示了 PoGo 的独特功能22,29。
单个文件(如 GCT 文件)可为肽段特征与基因组位点之间的关联提供有价值的可视化信息和链接。然而需要注意的是,仅依赖这些文件进行解读可能困难或产生误导,因为它们仅涵盖蛋白质基因组学的某些单一层面,例如唯一性、翻译后修饰和定量数值。因此,针对具体的蛋白质基因组学问题,谨慎选择合适的输出文件、选项及其组合并进行相应调整至关重要。例如,关于某个肽段唯一映射至特定基因组位点的信息,可能在基因组特征注释中具有重要价值。7,而不同样本间的定量可能更适合于将基因组特征与蛋白质丰度变化相关联的研究29输出应由 PoGo 为每个设置生成。如果未生成输出,或输出文件夹中显示为空文件,建议检查输入文件的内容是否符合要求以及文件格式是否正确。当文件格式或内容不符合 PoGo 的预期时(例如,FASTA 文件本应包含转录本的翻译序列,但实际上却包含了转录本的核苷酸序列),错误提示将要求用户检查输入文件。
该方案及工具的局限性主要源于基因组学中常用文件格式的重复利用。将基因组学中的文件格式重新用于蛋白质基因组学应用时,会带来特定的限制。这些限制源于以基因组为中心的基因组和蛋白质基因组数据可视化在需求上的差异,例如需要可视化蛋白质组学数据中的翻译后修饰。而基因组学文件格式中对单一特征的使用限制了这一需求的实现。已有多种方法和工具被开发用于蛋白质组学中,以高置信度定位肽段序列内的翻译后修饰31,32,33,34。然而,由于基因组文件格式的结构限制,难以在基因组上以唯一且可区分的方式可视化多个修饰。因此,同一类型的多个翻译后修饰以单一块状形式可视化,并非表示修饰位点存在歧义,而是源于基因组学领域通常仅需同时可视化单一特征的需求。尽管如此,PoGo 的优势在于能够将翻译后修饰映射到基因组坐标上,从而支持聚焦于基因组特征(如单核苷酸变异)对翻译后修饰影响的研究。使用 PoGo 进行变异映射可增加总的映射数量。然而,通过映射肽段独特的颜色编码,可以区分可靠与不可靠的映射结果。来自已知单核苷酸变异的变异肽段的映射,可结合以 VCF 格式展示的变异位点及其对应肽段的可视化。在这种情况下,若存在已知的核苷酸变异,则可覆盖颜色编码所提示的变异肽段不可靠映射的判断。
使用 PoGo 的一个关键步骤是正确使用文件和格式。主要标准是使用翻译后的转录本序列作为蛋白质序列,并配合 GTF 格式的注释文件。另一个在考虑使用 PoGo 映射含有氨基酸错配的肽段时的关键因素是内存消耗。尽管在标准应用中 PoGo 具有较高的内存效率,但当允许一个或两个错配时,可能的映射数量会显著且呈指数级增长,从而导致内存使用量同样呈指数级上升18。我们建议采用本方案中所述的分阶段映射策略:首先将无错配的肽段进行映射,并从集合中移除;随后对之前未映射的肽段使用允许一个错配的方式进行映射,并可对仍未能映射的肽段重复该过程,允许两个错配进行再次映射。
近年来,质谱分析的通量显著提高,基因组学与蛋白质组学数据整合的研究也日益增多,因此,能够便捷地将这两类数据在同一坐标系下进行整合的工具变得愈发不可或缺。本文介绍的工具可通过将肽段映射到参考注释上,帮助整合基因组与蛋白质组数据,从而促进对小规模和大规模数据集的综合研究,加深对其理解。值得欣喜的是,PoGo 已被应用于将肽段映射到以参考注释相同格式提供的基因候选区域,以支持人类睾丸中表达的新基因的注释工作35。本文所述方法不依赖于用于肽段鉴定的数据库。该实验方案可能通过使用来自翻译序列的改良输入文件以及 RNA-seq 实验相关的 GTF 文件,辅助识别和可视化新的翻译产物。
已有多种方法和工具被提出,用于将肽段映射到基因组坐标,其应用场景广泛,涵盖从直接将肽段比对至基因组序列到基于RNA测序引导的映射等多种策略10,11,12,13,14,15,16,17。然而,当存在翻译后修饰时,这些方法可能无法正确映射肽段;此外,RNA测序读段比对过程中存在的错误也可能传递至肽段层面。PoGo的开发旨在专门克服上述障碍,并应对定量高分辨率蛋白质组数据集的快速增长,以实现与正交基因组平台的整合。本文所述工具可整合至高通量工作流程中。通过图形化界面PoGoGUI,该工具操作简便,无需专业的生物信息学培训。
披露
作者无任何利益冲突需要披露。
致谢
本工作由惠康信托基金(WT098051)和美国国立卫生研究院资助(U41HG007234)支持,资助对象为GENCODE项目。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| PoGo(软件) | NA | NA | https://github.com/cschlaffner/PoGo |
| PoGoGUI(软件) | NA | NA | https://github.com/cschlaffner/PoGoGUI |
| TrackHubGenerator(软件) | NA | NA | https://github.com/cschlaffner/TrackHubGenerator |
| 整合基因组浏览器(软件) | NA | NA | http://software.broadinstitute.org/software/igv/ |
| UCSC 基因组浏览器(网站) | NA | NA | https://genome.ucsc.edu/ |
| GENCODE(网站) | NA | NA | http://gencodegenes.org |
| Ensembl(网站) | NA | NA | http://ensembl.org |
| bedToBigBed(软件) | NA | NA | http://hgdownload.soe.ucsc.edu/admin/exe/ |
| fetchChromSizes.sh(软件) | NA | NA | http://hgdownload.soe.ucsc.edu/admin/exe/ |
参考文献
- Aebersold, R., Mann, M. Mass-spectrometric exploration of proteome structure and function. Nature. 537 (7620), 347-355 (2016).
- Mertins, P., et al. Proteogenomics connects somatic mutations to signalling in breast cancer. Nature. 534 (7605), 55-62 (2016).
- Zhang, H., et al. Integrated proteogenomic characterization of human high-grade serous ovarian cancer. Cell. 166 (3), 755-765 (2016).
- Jaffe, J. D., Berg, H. C., Church, G. M. Proteogenomic mapping as a complementary method to perform genome annotation. Proteomics. 4 (1), 59-77 (2004).
- Wilhelm, M., et al. Mass-spectrometry-based draft of the human proteome. Nature. 509 (7502), 582-587 (2014).
- Kim, M. S., et al. A draft map of the human proteome. Nature. 509 (7502), 575-581 (2014).
- Wright, J. C., et al. Improving GENCODE reference gene annotation using a high-stringency proteogenomics workflow. Nature Communications. 7, 11778(2016).
- Nesvizhskii, A. I. Proteogenomics: concepts, applications and computational strategies. Nature Methods. 11 (11), 1114-1125 (2014).
- Armengaud, J., et al. Non-model organisms, a species endangered by proteogenomics. Journal of Proteomics. 105, 5-18 (2014).
- Askenazi, M., Ruggles, K. V., Fenyo, D. PGx: putting peptides to BED. Journal of Proteome Research. 15 (3), 795-799 (2016).
- Choi, S., Kim, H., Paek, E. ACTG: novel peptide mapping onto gene models. Bioinformatics. 33 (8), 1218-1220 (2017).
- Ghali, F., et al. ProteoAnnotator-open source proteogenomics annotation software supporting PSI standards. Proteomics. 14 (23-24), 2731-2741 (2014).
- Has, C., Lashin, S. A., Kochetov, A. V., Allmer, J. PGMiner reloaded, fully automated proteogenomic annotation tool linking genomes to proteomes. Journal of Integrative Bioinformatics. 13 (4), 293(2016).
- Kuhring, M., Renard, B. Y. iPiG: integrating peptide spectrum matches into genome browser visualizations. PLoS One. 7 (12), e50246(2012).
- Pang, C. N., et al. Tools to covisualize and coanalyze proteomic data with genomes and transcriptomes: validation of genes and alternative mRNA splicing. Journal of Proteome Research. 13 (1), 84-98 (2014).
- Sanders, W. S., et al. The proteogenomic mapping tool. BMC Bioinformatics. 12 (115), (2011).
- Wang, X., et al. ProBAMsuite, a bioinformatics framework for genome-based representation and analysis of proteomics data. Molecular & Cellular Proteomics. 15 (3), 1164-1175 (2016).
- Schlaffner, C. N., Pirklbauer, G. J., Bender, A., Choudhary, J. S. Fast, quantitative and variant enabled mapping of peptides to genomes. Cell Systems. 5 (2), 152-156 (2017).
- Vizcaino, J. A., et al. The PRoteomics IDEntifications (PRIDE) database and associated tools: status in 2013. Nucleic Acids Research. 41, D1063-D1069 (2013).
- Aken, B. L., et al. Ensembl 2017. Nucleic Acids Research. 45 (D1), D635-D642 (2017).
- Perez-Riverol, Y., et al. Ms-data-core-api: an open-source, metadata-oriented library for computational proteomics. Bioinformatics. 31 (17), 2903-2905 (2015).
- Wang, Y., et al. Multi-protease strategy identifies three PE2 missing proteins in human testis tissue. Journal of Proteome Research. , (2017).
- Greseth, M. D., Carter, D. C., Terhune, S. S., Traktman, P. Proteomic screen for cellular targets of the vaccinia virus F10 protein kinase reveals that phosphorylation of mDia regulates stress fiber formation. Molecular & Cellular Proteomics. 16 (4 Suppl 1), S124-S143 (2017).
- Thorvaldsdottir, H., Robinson, J. T., Mesirov, J. P. Integrative genomics viewer (IGV): high-performance genomics data visualization and exploration. Briefings in Bioinformatics. 14 (2), 178-192 (2013).
- Kent, W. J., et al. The human genome browser at UCSC. Genome Research. 12 (6), 996-1006 (2002).
- The R Development Core Team. R: A Language and Environment for Statistical Computing. , R Foundation for Statistical Computing. Vienna, Austria. (2008).
- Kent, W. J., Zweig, A. S., Barber, G., Hinrichs, A. S., Karolchik, D. BigWig and BigBed: enabling browsing of large distributed datasets. Bioinformatics. 26 (17), 2204-2207 (2010).
- Down, T. A., Piipari, M., Hubbard, T. J. Dalliance: interactive genome viewing on the web. Bioinformatics. 27 (6), 889-890 (2011).
- Roumeliotis, T. I., et al. Genomic determinants of protein abundance variation in colorectal cancer cells. Cell Reports. 20 (9), 2201-2214 (2017).
- Gaudet, P., et al. The neXtProt knowledgebase on human proteins: 2017 update. Nucleic Acids Research. 45, D177-D182 (2017).
- Fermin, D., Walmsley, S. J., Gingras, A. C., Choi, H., Nesvizhskii, A. I. LuciPHOr: algorithm for phosphorylation site localization with false localization rate estimation using modified target-decoy approach. Molecular & Cellular Proteomics. 12 (11), 3409-3419 (2013).
- Fermin, D., Avtonomov, D., Choi, H., Nesvizhskii, A. I. LuciPHOr2: site localization of generic post-translational modifications from tandem mass spectrometry data. Bioinformatics. 31 (7), 1141-1143 (2015).
- Hansen, T. A., Sylvester, M., Jensen, O. N., Kjeldsen, F. Automated and high confidence protein phosphorylation site localization using complementary collision-activated dissociation and electron transfer dissociation tandem mass spectrometry. Analytical Chemistry. 84 (22), 9694-9699 (2012).
- Taus, T., et al. Universal and confident phosphorylation site localization using phosphoRS. Journal of Proteome Research. 10 (12), 5354-5362 (2011).
- Weisser, H., Wright, J. C., Mudge, J. M., Gutenbrunner, P., Choudhary, J. S. Flexible data analysis pipeline for high-confidence proteogenomics. Journal of Proteome Research. 15 (12), 4686-4695 (2016).
重印与许可
