通过测序实现的相互半合子化(RH-seq)是一种强大的新方法,可用于定位物种间性状差异的遗传基础。该方法利用转座子诱变生成半合子池,并通过高通量测序结合竞争性生长来追踪其适合度。对所得数据的分析可精确定位控制该性状的基因。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
现代遗传学的一个核心目标是理解野生生物在表型上存在差异的原因和机制。迄今为止,该领域的发展主要依赖于连锁分析和关联作图方法,这些方法通过分析同一物种内个体杂交后产生的重组子代中DNA序列变异与表型之间的关系来推进研究。尽管这些方法十分强大,却不适用于生殖隔离物种之间的性状差异研究。本文介绍一种可用于不相容物种的全基因组水平解析自然性状变异的新方法。我们的策略——RH-seq,是全基因组范围实施的互惠半合子检验。我们利用该方法鉴定了导致酵母菌Saccharomyces cerevisiae相较于其姐妹种S. paradoxus具有显著高温生长能力的相关基因。RH-seq利用转座子诱变构建一组互惠半合子文库,并通过高通量测序追踪这些半合子在高温环境下的竞争表现。本文所描述的RH-seq工作流程为解析芽殖酵母类群中古老的复杂性状提供了一种严谨且无偏倚的方法,但需注意该方法需要投入大量资源进行深度测序,以确保遗传作图所需的基因组覆盖度。随着测序成本的降低,该方法在未来有望广泛应用于真核生物的研究中。
引言
自遗传学领域诞生以来,理解野生个体间变异的机制基础一直是核心目标。当我们定位到与特定性状相关的基因座时,所发现的基因可立即作为诊断和药物研发的靶点,并有助于揭示进化的基本原理。目前业界普遍采用的方法是通过连锁分析或关联分析,在群体中检测基因型与表型之间的关系1。尽管这些方法非常强大,但仍存在一个关键局限——它们依赖于可育个体杂交后产生的大量重组子代。因此,对于那些根本无法交配产生后代的物种,这些方法完全无法应用。正因如此,该领域长期以来难以对生殖隔离物种之间的性状差异进行无偏性的解析2。
在本研究中,我们报道了一种新方法RH-seq3的技术基础,该方法可用于在基因组尺度上系统调查物种间性状变异的遗传基础。该方法是互惠半合子检测法4,5的大规模并行版本,后者最初被提出用于评估在特定基因座上,两个遗传背景不同的个体之间等位基因差异对表型效应的影响(图1A)。在此方案中,首先将两个遗传差异显著的个体杂交,产生一个杂合子后代,其基因组的一半来自各自的亲本。在此杂合背景下,构建多个菌株,每个菌株均含有其中一个亲本等位基因被中断或删除的拷贝。这些菌株被称为半合子,因为其基因组除目标基因座外均为二倍体,而在该基因座上则为单倍体;同时被称为互惠半合子,因为每个菌株仅缺失一个亲本的等位基因,而保留的等位基因来自另一亲本。通过比较这些互惠半合子菌株的表型,可以判断在该基因座上的DNA序列变异是否对目标性状产生影响,因为在互惠半合子菌株之间,该基因座的遗传变异是唯一的遗传差异。通过这种方式,可以在一个严格控制的实验体系中,将物种间的遗传差异与表型差异直接关联起来。迄今为止,该检测方法的应用主要局限于候选基因框架,即研究者已预先假设某个候选基因座上的自然变异可能影响特定性状的情形。
下文阐述了利用酵母作为模式系统进行全基因组规模的反向半合子筛选实验方案。本方法通过在物种间产生可存活且不育的F1代杂交子代,并对其进行转座子诱变,从而构建一套基因组范围的半合子突变体集合。我们将这些半合子突变体混合,通过基于测序的检测手段测定其表型,并分析混合群体中携带某一特定基因两个亲本等位基因的克隆频率是否存在差异。最终获得一份目录,列出在不同物种间影响目标性状的遗传位点。我们应用RH-seq工作流程,以解析两种约在500万年前分化出的芽殖酵母——Saccharomyces cerevisiae 和 S. paradoxus 之间热耐受性差异的遗传基础6。
访问受限。请登录或开始试用以查看此内容。
方案
1. 用于转化的含 piggyBac 质粒的制备
- 将含有质粒 pJR487 的 E. coli 菌株划线接种至 LB + 羧苄青霉素琼脂平板上,以获得单菌落。在 37 °C 下培养 1 夜,或直至单菌落出现。
注意:关于质粒 pJR487 克隆方法的描述可参见我们之前的研究3。 - 在 2 L 玻璃烧瓶中,用 1 L 含 100 μg/mL 羧苄青霉素的 LB 培养基接种一个含有 pJR487 的 E. coli 单菌落。在 37 °C、200 rpm 振荡条件下过夜培养,直至培养物饱和(OD600 ≥ 1.0)。
- 按照制造商公布的说明书,使用大提质粒试剂盒从上述培养物中纯化质粒 DNA(详见材料表)。在 37 °C 预热的 5 mL 洗脱缓冲液中孵育 10 分钟后洗脱 DNA。
- 使用分光光度计测定质粒 DNA 的浓度和纯度(详见材料表)。
- 重复步骤 1.2 – 1.4,直至获得至少 11 mg 的质粒 DNA,且其 A260:A280 比值不低于 1.8。根据提取效率不同,可能需要进行数次提取。
- 将所有质粒提取物合并至同一离心管中,并用洗脱缓冲液或水将总体积调至 20 mL。再次使用分光光度计测定最终的浓度和纯度。在此 20 mL 体积中,质粒浓度应至少为 538 ng/μL。若浓度高于 538 ng/μL,需用洗脱缓冲液或水稀释至 538 ng/μL。质粒可在 4 °C 下保存数周,直至使用。
2. 构建全基因组范围非靶向反向半合子文库
- 杂交酵母细胞转化前的制备
- 从 -80 °C 甘油菌种中划线接种 JR50780 °C 将冻存菌株划线接种于YPD琼脂平板上,获得单菌落。置于 26 °C 持续培养2天,或直至菌落出现。
注意:JR507 是通过单细胞交配 S. cerevisiae DBVPG1373 和 S. paradoxus Z1 的单倍体孢子(使用四分体解剖显微镜)获得的杂交菌株3. - 在250 mL玻璃锥形瓶中加入100 mL液体YPD培养基,接种一株JR507单菌落,并振荡培养 28 °C,200 转/分钟,培养 24 小时,或直至达到稳定期。
- 第二天,测定 600 nm 处的光密度(OD600) 的过夜培养物。取部分过夜培养物,用新鲜液体YPD培养基反向稀释,转入一个新的1 L玻璃锥形瓶中,配制新培养物至OD600 0.2 和 500 mL 的体积。
注意:若过夜培养物的OD值为例,反向稀释的计算示例600 5.0,其中 C 为光密度,V 为体积:
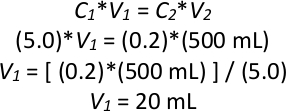
因此,将20 mL过夜饱和培养液加入480 mL液体YPD培养基中,总体积为500 mL,此时OD值为600 0.2。 - 重复步骤 2.1.3 三次,共制备四份 500 mL 培养物,其 OD600 0.2,置于四个1 L的玻璃烧瓶中,并对所有四个新培养物使用同一批过夜培养物。将它们全部在 28 °C 振荡培养6小时(2-3个世代),转速为200 rpm。
- 将两份500 mL的培养物混合,制成1 L培养物。将剩余的两份500 mL培养物混合,制成另一份1 L培养物。此时共有两份1 L培养物。在后续步骤中,每份1 L培养物将分别用于pJR487的转化。
- 从 -80 °C 甘油菌种中划线接种 JR50780 °C 将冻存菌株划线接种于YPD琼脂平板上,获得单菌落。置于 26 °C 持续培养2天,或直至菌落出现。
- 将 pJR487 转化至杂交酵母细胞
- 将每份1 L培养物均分为20份,每份50 mL,分装至20个塑料锥形管中,共40个管。先将其中20管暂存备用,其余20管每次处理一组,进行以下步骤。
- 将二十个试管中的每一个在1,000 x g条件下离心3分钟 g 离心沉淀酵母细胞,弃去上清液。
- 将每个沉淀物用 25 mL 无菌 H2O通过涡旋振荡。在1,000 x g下离心3分钟 g弃去上清液。
- 用5 mL 1× TE、0.1 M LiOAc缓冲液重悬每个沉淀,涡旋混匀。在1,000 × g条件下离心3分钟 g弃去上清液。
- 重复步骤2.2.4。在细胞离心的同时,准备至少120 mL含39.52%聚乙二醇、0.12 M LiOAc和1.2×Tris-EDTA缓冲液(12 mM Tris-HCl和1.2 mM EDTA)的溶液,置于冰上保存。
- 为准备用于转化的质粒DNA,首先将4 mL鲑鱼精子DNA煮沸 100 °C 5分钟,然后立即在冰上冷却5分钟。随后,加入20 μL浓度为538 ng/μL的pJR487(来自第1节)混合μL 加入4 mL冷却的鲑鱼精子DNA,总体积为24 mL。置于冰上保存,直至使用。
- 添加 600 μL 加入含有鲑鱼精子DNA的质粒DNA混合物至每个细胞沉淀上。暂时不要重悬。
- 向每个沉淀中加入 3 mL 步骤 2.2.5 制备的 PEG-LiOAc-TE 溶液。通过移液吹打并涡旋振荡重悬沉淀。
- 将每支试管在室温下孵育10分钟。
- 将每支试管在设定为 26 分钟的水浴中进行热激 39 °C.
注意:每隔几分钟轻轻倒置每根试管,以防止细胞沉降到管底。 - 每管离心3分钟,1,000 x g g弃去上清液,每份沉淀物用10 mL YPD培养基通过涡旋重新悬浮。将全部二十支试管的菌液合并至一个新的玻璃烧瓶中,细胞总体积约为200 mL。
- 将66.6 mL细胞转移至一个新的1 L玻璃烧瓶中,并用液体YPD定容至500 mL。重复此操作两次,以用尽全部200 mL转化后的细胞。测定OD600 每次新培养500 mL培养液的OD值(预计OD)600 约0.35-4
- 摇动所有三个烧瓶 28 °C 2小时以恢复(<1 代)在 200 rpm 条件下培养。
- 向三个培养瓶中各加入0.5 mL的300 mg/mL G418,使其终浓度达到 300 μg/mL G418 并重新置于摇床中继续振荡 28 °C,200 rpm。
注意:在此步骤之前,转化后的杂交细胞已从转化过程中恢复。加入G418后,可筛选出含有质粒pJR487的细胞。任何在转化过程中未摄取该质粒的细胞将开始死亡。 - 用剩余的20个细胞锥形管重复步骤2.2.2–2.2.14。此时应有六个1 L玻璃烧瓶,每个烧瓶中含有500 mL添加了G418的细胞。
- 将全部六个细胞培养瓶置于培养箱中孵育 28 °C,以200 rpm振荡培养约2天,或直至OD600 当每个烧瓶中的 OD 值达到约 2.3 时,将全部六个烧瓶中的培养物合并为一个培养体系。
注意:尽管该培养物中的所有细胞不会都用于后续步骤,但使用如此大体积的目的是尽可能产生更多的独特转化事件,并通过将所有转化产物混合在一起,消除单次转化过程中可能存在的偏差。 - 使用2.2.16中制备的培养物接种两个新的1 L锥形瓶,每瓶含500 mL YPD + G418300 μg/mL) 至 OD600 0.2。会有剩余的培养物,可将其丢弃。
- 将两个1 L烧瓶置于培养条件下孵育 28 °C 过夜,200 rpm 摇床振荡,直至每个样本达到 OD600 约 2.2(约 3.5 代)。将两种培养物合并为一种培养物,并测定 OD600 再次进行混合培养。
注意:此时培养物中的细胞应几乎全部含有质粒 pJR487。在部分细胞群体中,PiggyBac 转座子已通过质粒表达的转座酶从质粒转座至基因组中。然而,转座酶的持续表达可能导致在筛选过程中发生进一步转座,从而模糊基因型与表型之间的关系。接下来几个步骤的目标是针对质粒的存在进行反向筛选,以确保转座酶不再表达。最终获得的细胞群体为基因组中整合或未整合转座子的混合物,但在后续的定位步骤中仅能检测到含有转座子的细胞。在转化过程中,转座酶表达的时间长短(即编码转座酶的质粒丢失前的持续时间)可能影响经诱变后单个克隆携带多个转座子插入事件的概率。可通过诱变后挑取确定数量的菌落,合并其 DNA 并通过测序确认池中独立插入位点的数量,以此估算此类事件的频率;这些事件在单个基因分析中表现为“次要”突变。 - 将 25 mL 该培养物在 1,000 x g 条件下离心 3 分钟 g. 计算总光密度(OD)数值600 处于25 mL中的细胞单位数(参见下方示例计算)。弃去上清液,并用足量H重新悬浮2O 以制备 OD 值为 1.85 的细胞悬液600/mL,涡旋混匀。
注意:若在水中重悬细胞的OD计算示例600 联合培养的比例为2.2:
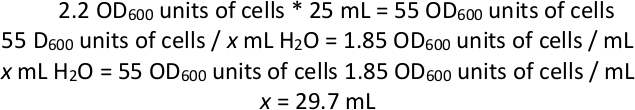
因此,在离心25 mL细胞培养液并弃去上清液后,加入足量的H2O 加入细胞中,使细胞和水的总体积达到约 29.7 mL(由于细胞沉淀也占有体积,因此加入的 H₂O 体积应少于 29.7 mL)2O). - 使用玻璃珠,将1 mL重悬于水中的细胞均匀涂布于12块含5-FOA的大型方形完全合成琼脂平板上。将每块平板在 28 °C 培养1-2天,或直至平板上形成菌苔。
- 使用无菌的小刮刀将6个培养皿中的细胞刮下,并收集到含有35 mL无菌水的离心管中。对另外6个培养皿重复此操作,共获得两管细胞悬液。将所有细胞悬液合并至同一离心管中。测定OD600 使用水作为空白对照,测定该悬浮液的 OD600/mL 细胞浓度至 44.4 OD600 单位/mL,用水稀释。根据我们的经验,转座效率(KAN+细胞中URA-细胞的比例)平均为50%。
- 确定 - 的数量80 °C 用于储存的细胞冻存管。每个 aliquot 可在未来用于单次实验。
注意:由于文库构建耗时较长,建议储存多个冻存管,以防意外损耗或用于重复实验。保存20-30个备份管是较为合理的数量。 - 每管冻存菌液含有 40 OD600 1 mL 含 10% DMSO 的细胞单位。加入 900 μL 细胞的 100 μL DMSO。对所制备的全部冻存管重复此步骤。每管储存于-80 °C 以备将来使用。
3. 混合格式中互惠半合子的筛选
- 从 -80 °C 将第2节中混合的相互半合子样品单份 aliquot 在室温下从冷冻保存中取出。
注意:一旦解冻,切勿将分装样品在室温下放置过久,应立即使用。 - 使用全部1 mL等分试样接种于250 mL玻璃锥形瓶中的150 mL液体YPD培养基中。测定OD600 该培养物,并在 28 °C,以200 rpm振荡培养约7小时,或直至培养物经历2-3次群体倍增。此时,该培养物即可用于接种正在经历筛选的培养物。
注意:示例计算:如果 OD600 原培养瓶的OD值为0.25时,继续培养至达到目标OD值600 至少为1.0。若需在“零时间点”(T-0)取样以分析选择前的半合子群体,可立即通过离心5–10 mL培养物(每管)获得细胞沉淀,离心条件为1,000 x g 3 分钟,弃去上清液,并在 -80 °C. - 使用已培养的半合子群体以合适的重复方案接种培养物,进行高温(39 °C)和允许温度(28 °C)。每个温度下至少设置三个生物学重复的选择培养,共六个选择培养。
- 在2 L玻璃烧瓶中加入500 mL液体YPD培养基,制备每份筛选培养物,并接种至OD600 0.02。将每次筛选培养物在100 rpm条件下振荡培养 28 °C 或 39 °C 直到发生 6-7 次群体倍增(对应于 OD600 约 1.28–2.56)。应尽可能接近最终 OD 值600 所有筛选培养物。
注意:选择性培养条件在 28 °C 将比选择性培养物生长得更快 39 °C. 因此,选择性培养物在 39 °C 将在培养箱中孵育更长时间。每个培养瓶一旦准备就绪,即按以下步骤操作,无需考虑其在培养箱中的总孵育时长。根据我们的经验,培养物在 28 °C 或 39 °C 分别需要约12小时或18小时达到OD值约2.0。较长的筛选时间虽有可能放大微小的适应性效应,但也允许从头产生背景突变,从而在任一基因/等位基因的转座子突变体间的最终适应性分布中引入噪声。因此,在RH-seq实验中限制筛选时间至关重要。
- 在2 L玻璃烧瓶中加入500 mL液体YPD培养基,制备每份筛选培养物,并接种至OD600 0.02。将每次筛选培养物在100 rpm条件下振荡培养 28 °C 或 39 °C 直到发生 6-7 次群体倍增(对应于 OD600 约 1.28–2.56)。应尽可能接近最终 OD 值600 所有筛选培养物。
- 从每种筛选培养物中收集细胞沉淀。计算获得 7 OD 所需的体积600 细胞单位,于1,000 x g离心 g 至少从每种筛选培养物中制备四个该体积的技术重复样本,用于文库构建和测序(见下文第4和第5节)。弃去上清液,并于-80 °C保存细胞沉淀。80 °C.
注意:例如,如果一个筛选培养瓶的最终 OD600 2.0:
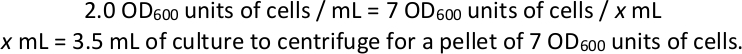
4. 转座子测序文库构建及Illumina测序以确定转座子突变半合子的丰度
- 将第3节中每个待测序的细胞沉淀物在冰上解冻。
- 使用酵母基因组DNA(gDNA)纯化试剂盒,按照制造商说明书从每个细胞沉淀物中提取总基因组DNA(gDNA)。用预热至65 °C的50 μL洗脱缓冲液重悬DNA。
- 使用荧光计测定每个沉淀物中gDNA的含量。为使用以下方法构建用于Tn-seq的下一代测序(NGS)文库,每个细胞沉淀物所需的gDNA最低总量为1 μg。
注意:可使用少于1 μg的gDNA构建文库,但最终文库的产量和质量将受到影响。 - 按照已建立的方案构建Tn-seq文库7。请注意本方案特有的以下相关信息:
- 在gDNA片段化、末端修复和接头连接后,通过PCR扩增含有转座子的gDNA片段。该PCR反应中使用以下正向和反向引物,分别特异性针对PiggyBac转座子和NGS接头:
正向引物(N – 随机核苷酸)
5’ ATGATACGGCGACCACCGAGATCTACACTCTTTCCCTACACGACG
CTCTTCCGATCTNNNNNNAGCAATATTTCAAGAATGCATGCGTCAAT 3’
反向引物(连续的N代表用于多重测序的唯一6 bp索引。索引的进一步信息见下文)
5’ CAAGCAGAAGACGGCATACGAGATNNNNNNGTGACTGGAGTTCAG
ACGTGTGCTCTTCCGATCT 3’ - 使用配套的纯化步骤及大小选择磁珠,以最大限度减少最终文库中因片段过短而无法比对到基因组序列的克隆片段比例。
注意:若此前选择培养物已满足最低重复数要求,则共有24个独立的gDNA样本需要测序。鉴于当前测序成本,不太可能将每个样本单独运行。为在同一测序通道中合并多个样本,应设计多个反向引物,每个引物包含一个独特的6碱基对索引。带有不同索引的样本可混合在同一测序通道中,后续通过计算方法进行区分。
- 在gDNA片段化、末端修复和接头连接后,通过PCR扩增含有转座子的gDNA片段。该PCR反应中使用以下正向和反向引物,分别特异性针对PiggyBac转座子和NGS接头:
- 使用NGS技术对每个文库进行单端150 bp测序,共使用八个测序通道。
注意:所需测序读长的数量在很大程度上取决于前一步骤中构建的文库质量(即文库中实际含有转座子DNA的比例,这些DNA来源于双互补半合子细胞)。影响该比例的主要因素有两个。首先,由于在构建文库池时未对未整合转座子的细胞进行反向筛选,因此每个培养物均为含有和不含转座子的细胞混合物。其次,即使在含有转座子的双互补半合子细胞基因组中,大部分基因组区域并不包含转座子序列,而这些gDNA不可避免地会进入文库构建过程。最终PCR扩增含转座子DNA的目的在于提高含转座子DNA相对于上述两类背景gDNA的比例。该扩增效率越高,可用于下游分析的有效测序读长比例就越高。文库质量越低,所需测序量就越大,因为越来越多的读长将不包含转座子DNA而无法使用。在上述条件下,八个测序通道的测序量已能够较为合理地追踪双互补半合子的丰度变化。更高的测序深度将支持更深入的分析。
5. 绘制转座子插入位点位置及RH-seq分析
注意:以下数据分析使用自定义的 Python 脚本完成(在线获取地址:https://github.com/weiss19/rh-seq),但也可使用其他脚本语言重新实现。下文概述了该流程中的主要步骤。除非特别注明需合并数据,否则应对每个独立的重复测序文件分别执行以下步骤。
- 切除读段中的接头序列,并根据索引将各重复样本的读段分开。
- 查找包含转座子-基因组连接区域的测序读段。为此,需在每条读段中搜索转座子的最后20个碱基序列 CAGACTATCTTTCTAGGGTTAA。剔除所有不包含该序列的读段。
注:根据我们的经验,比对到转座子末端的读段比例为83-95%。 - 将剩余的、含有转座子的读段修剪,使其仅保留转座子3’端下游的序列。通过将该序列比对至酵母基因组,确定每条读段中转座子插入的基因组背景(如下步骤5.4所述)。
- 使用 BLAT 或等效的比对工具,将转座子下游的序列比对至 S. cerevisiae DBVPG1373 x S. paradoxus Z1 杂交基因组(脚本名称:map_and_pool_BLAT.py)
- 丢弃转座子3’端下游可用序列少于50个碱基的读段,因为短序列难以唯一比对。
- 若使用 BLAT,请采用以下参数:identity = 95,tile size = 12。
- 通过连接酿酒酵母 S288c 和奇异酵母 CBS432 的最新版本参考基因组,构建一个基础的杂合基因组用于比对。
注意:可在上述 Github 仓库中找到描述杂合基因组中各个基因基因组边界的注释文件(文件名:YS2+CBS432+plasmid_clean)。仅使用比对到杂合基因组中单一位置的测序读段(即特异性属于酿酒酵母或异常毕赤酵母的读段)。预期基因组中插入事件的发生频率是均匀的;插入位点在基因组中的分布情况已在其他文献中报道3.
- 统计比对到每个独特转座子插入位点的读段总数,我们推断这些读段均来源于单个转座子插入突变克隆的细胞。单个文库中所有此类数值的总和称为该文库的比对读段总数。
- 在多个插入位点相互距离不超过3个碱基对的情况下,将所有这些插入位点合并为一个单一插入位点,并将所有读段分配至其中读段数最多的单一位置。该值,n插入,表示该插入克隆在提取基因组DNA的细胞沉淀物中的丰度。此时,将得到若干个列表,其中 n插入每份细胞沉淀物测序对应一个列表,记录各自唯一比对的转座子插入丰度。
注意:PiggyBac 转座子插入基因组中的 TTAA 序列,该序列为 4 个碱基对。因此,我们推断在彼此 3 个碱基对范围内比对到的插入位点必然来源于同一个 TTAA 位点。 - 由于每个测序文库产生的总读长数量略有不同,需对 n 进行归一化处理插入 若要比较所有文件的数值,需通过制表列出各个文库的比对 reads 总数 n 来实现沉淀物,并取所有 n 的平均值沉淀物 在所有文库中 <n沉淀物>. 将每个 n 相乘插入 通过单个文库数据中的比率 <n沉淀物> /n沉淀物 用于计算 a插入给定转座子插入克隆的标准化丰度。
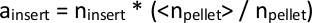
或者,可以使用现有的工具(如 DESeq2)来估计文库大小8 (脚本名称:total_reads_and_normalize.py) - 汇总所有文库中比对到的所有插入序列。对于在部分文库中发现但其他文库中未发现的插入序列,设定一个插入 = 1,用于后续计算。
- 根据注释文件筛选出位于基因内部的插入序列(脚本名称:remove_NC_and_plasmid_inserts.py)。
- 对于每一次独特的插入,计算每个筛选条件下(每种培养物在任一时间点)技术重复间的平均丰度 28 °C 或 39 °C), <a插入>技术性的 (脚本名称:combine_tech_reps_V2.py)
- 针对每个独特的插入序列,计算各温度条件下生物学重复样本中丰度的平均值, <a插入>总计,通过计算所有数据的平均值 <a插入>技术的 在每个温度下。同时,计算每次插入的变异系数 CV插入,总计 跨越 <a插入>技术的 (脚本名称:combine_bio_reps.py)
注意:在此阶段,针对每个温度, 28 °C 和 39 °C,列出了独特的转座子插入位点、每个插入位点的平均丰度以及各生物学重复之间的变异系数。本实验的这些数据已在其他地方报道3. - 筛选所有插入序列,保留其中在任一端具有 28 °C 或 39 °C, <a插入>总计 > 1.1 和 CV插入,总计 ≤ 1.5(脚本名称:filter_inserts.py)
- 对于每个独特的插入事件,计算其对数值2(<a插入>总计,28 °C / <a插入t>总计,39 °C)。该数值代表了特定转座子插入突变体克隆的“热耐受性”(脚本名称:fitness_ratios.py)。
- 按基因和等位基因对所有独特的插入进行排序S. cerevisiae 或 S. paradoxus),并统计每个等位基因中的插入数量。筛选基因,仅分析每个等位基因中至少有5个插入的基因(脚本名称:organize_and_filter_genes.py)。
注意:每个等位基因上存在多个独特插入可更准确地测量该反向半合子的耐热性。虽然可以降低每个等位基因所需的插入数量,但这会降低测量的准确性,并因允许检测更多基因而增加多重检验负担。此外,过滤掉每个等位基因插入数量过少的基因,有助于减少个别半合子克隆携带的次要位点突变(导致表型差异极大)对检测结果的影响。 - 对于数据集经上述筛选后保留的每个基因,比较其耐热性(log2 所有插入片段的比率) S. cerevisiae 等位基因与那些在 S. paradoxus 使用Mann-Whitney U检验分析等位基因。或者,可采用基于DESeq2的回归模型8 (脚本名称:mann_whitney_u.py)
- 正确 p使用 Benjamini-Hochberg 方法对多次检验进行校正。
- 显著基因 p-值(例如 ≤ 0.01)是两种物种间耐热性差异相关重要基因的候选指标。
访问受限。请登录或开始试用以查看此内容。
结果
我们将酿酒酵母(S. cerevisiae)与奇异酵母(S. paradoxus)杂交,获得一种不育的杂交子,随后对该杂交子进行转座子诱变。每个诱变克隆均为半合子,即二倍体杂交子中某一基因的一个等位基因被破坏(图 1A, 图 2)。我们通过在 39 °C 条件下共同培养这些半合子进行竞争实验,并在另一独立实验中以 28 °C 作为对照条件(图 1B),随后从每种培养物中提取 DNA。为评估各半合子的适合度,我们采用大规模测序方法定量其丰度,具体方案为:将 DNA 片段化后连接接头,再扩增转座子插入位点(图 1C)。若该扩增所用引物与方案中提供的引物不同或效率较低,则测序数据中将出现大量背景读段,导致可用读段减少,从而降低适合度估计的准确性。若测序文库构建过程中 DNA 起始投入量过低,也可能引发类似的质控问题。
访问受限。请登录或开始试用以查看此内容。
讨论
与以往的统计遗传学方法相比,RH-seq 具有多重优势。与连锁分析和关联分析不同,RH-seq 能够实现单基因水平的定位分辨率;因此,即使在研究特定物种个体间性状变异或种间差异时,该方法也可能具有重要应用价值。此外,以往的全基因组范围的互惠半合子分析尝试依赖于基因缺失突变体文库,其中部分突变体携带继发性突变,可能导致假阳性结果9,10。RH-seq 策略通过依次对每个基因产生并表征多个半合子突变体,使得单个突变克隆的遗传背景对最终结果的影响微乎其微,从而规避了这一问题。理论上,RH-seq 还可用于研究非编码位点,但在本研究中我们仅专注于基因。
RH-seq 存在一些生物学和技术上的特殊性,成功的实践者需要提前解决这些问题,以最大化该方法的实用性并加速获得最佳结果。从生物学角度来看,只有当两个目标物种能够杂交形成稳定且可存活的杂合子,并能进行遗传操作时,RH-seq 才具有技术意义。因此,我们无法将 RH-seq 应用于那些亲缘关系过于遥远、无法融合形成核型稳定...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
致谢
感谢 J. Roop、R. Hackley、I. Grigoriev、A. Arkin 和 J. Skerker 对原始研究的贡献,感谢 F. AlZaben、A. Flury、G. Geiselman、J. Hong、J. Kim、M. Maurer 和 L. Oltrogge 提供的技术支持,感谢 D. Savage 在显微镜资源方面的慷慨支持,感谢 B. Blackman、S. Coradetti、A. Flamholz、V. Guacci、D. Koshland、C. Nelson 和 A. Sasikumar 参与讨论;同时感谢 J. Dueber(加州大学伯克利分校生物工程系)提供 PiggyBac 质粒。本研究由美国国立卫生研究院资助项目 R01 GM120430-A1 以及美国能源部联合基因组研究所(DOE Office of Science 用户设施)社区测序项目 1460(资助对象 RBB)支持。后者的相关工作由美国能源部科学办公室根据合同号 DE-AC02-05CH11231 提供支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 1-2 种质粒Gigaprep试剂盒 | Zymo Research | D4204 | 所需试剂盒数量取决于每个试剂盒中提取的效率。该试剂盒包含5个独立的质粒提取柱。每个提取柱通过1 L饱和的大肠杆菌(E. coli)培养液,因为每柱使用超过1 L可能导致提取滤膜堵塞,从而导致DNA得率低和质量差。 |
| 10X Tris-EDTA(TE)缓冲液(100 mM Tris-HCl 和 10 mM EDTA) | 任意品牌 | N/A | 使用前通过0.22 μm滤膜过滤除菌。 |
| 1M LiOAc | 任意品牌 | N/A | 使用前通过0.22 μm滤膜过滤除菌。 |
| 300 mg/mL Geneticin(G418) | Gibco | 11811023 | |
| 52% 聚乙二醇(PEG)3350 | Sigma | 1546547 | 溶于水后,使用前通过0.22 μm滤膜过滤除菌。1X 转化混合液(trafo mix):228 μL 52% PEG,36 μL 1M LiOAc,36 μL 10X TE缓冲液 |
| 高压灭菌的LB液体培养基 | BD Difco | 244620 | 使用任意品牌的粉末和milliQ水配制LB液体培养基,使用前进行高压灭菌。 |
| 水中的羧苄青霉素储备液(100 mg/mL) | 任意品牌 | N/A | 使用前通过0.22 μm滤膜过滤除菌。 |
| 含5-氟乳清酸(5-FOA)的完全合成琼脂平板(24.1 cm × 24.1 cm)[0.2% 缺陷型氨基酸混合物(不含尿嘧啶或酵母氮源基础,YNB), 0.005% 尿嘧啶, 2% D-葡萄糖, 0.67% 不含氨基酸的YNB, 0.075% 5-FOA] | 5-FOA:Zymo Research,缺陷型混合物:US Biological,尿嘧啶:Sigma,D-葡萄糖:Sigma,YNB:Difco | 5-FOA:F9001-5,缺陷型混合物:D9535,尿嘧啶:U0750,D-葡萄糖:G8270,YNB:DF0919 | |
| DMSO | 任意品牌 | N/A | |
| 携带pJR487质粒(CEN-/ARS+ 含piggyBac的质粒)的大肠杆菌菌株 | N/A | N/A | 向Brem实验室申请获取。 |
| 杂合酵母菌株JR507(酿酒酵母DBVPG1373 × 奇异酵母Z1,URA-/URA-) | N/A | N/A | 向Brem实验室申请获取。 |
| Illumina Hiseq 2500 | 用于SE-150测序读长 | ||
| 带可变温度设置的大型摇床培养箱 | 任意品牌 | N/A | |
| 含羧苄青霉素的LB琼脂平板(100 μg/mL) | 琼脂:BD Difco | 琼脂:214010 | 正常制备LB琼脂平板,并在凝固前加入羧苄青霉素至终浓度100 μg/mL。 |
| Nanodrop分光光度计 | Thermo Scientific | ND-2000 | |
| Qubit荧光计 | Thermo Scientific | Q33240 | |
| 鲑鱼精子DNA | Invitrogen | 15632011 | |
| 39°C水浴 | 任意品牌 | N/A | |
| 酵母真菌基因组DNA提取试剂盒 | Zymo Research | D6005 | |
| 酵母蛋白胨葡萄糖(YPD)液体培养基 | BD Difco | 蛋白胨:211677,酵母提取物:212750 | 高压灭菌后,加入过滤除菌的D-葡萄糖至终浓度2%。 |
| 含G418的YPD琼脂平板(300 μg/mL) | 琼脂:BD Difco | 琼脂:214010 | 正常制备YPD琼脂平板,并在凝固前加入G418至终浓度300 μg/mL。 |
| YPD琼脂平板 | 琼脂:BD Difco | 琼脂:214010 |
参考文献
- Flint, J., Mott, R. Finding the molecular basis of quantitative traits: successes and pitfalls. Nature Reviews Genetics. 2, 437-445 (2001).
- Allen Orr, H. The genetics of species differences. Trends in Ecology and Evolution. 16, 343-350 (2001).
- Weiss, C. V., et al. Genetic dissection of interspecific differences in yeast thermotolerance. Nature Genetics. 50, 1501-1504 (2018).
- Stern, D. L. Identification of loci that cause phenotypic variation in diverse species with the reciprocal hemizygosity test. Trends in Genetics. 30, 547-554 (2014).
- Steinmetz, L. M., et al. Dissecting the architecture of a quantitative trait locus in yeast. Nature. 416, 326-330 (2002).
- Scannell, D. R., et al. The Awesome Power of Yeast Evolutionary Genetics: New Genome Sequences and Strain Resources for the Saccharomyces sensu stricto Genus. G3 (Bethesda). 1, 11-25 (2011).
- Wetmore, K. M., et al. Rapid quantification of mutant fitness in diverse bacteria by sequencing randomly bar-coded transposons. MBio. 6, e00306-e00315 (2015).
- Love, M. I., Huber, W., Anders, S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biology. 15, 550(2014).
- Wilkening, S., et al. An evaluation of high-throughput approaches to QTL mapping in Saccharomyces cerevisiae. Genetics. 196, 853-865 (2014).
- Kim, H. S., Huh, J., Riles, L., Reyes, A., Fay, J. C. A noncomplementation screen for quantitative trait alleles in saccharomyces cerevisiae. G3 (Bethesda). 2, 753-760 (2012).
访问受限。请登录或开始试用以查看此内容。
重印与许可
