内在无序结构域对致癌融合转录因子的功能具有重要作用。为了靶向治疗这些蛋白,需要更深入地理解这些结构域所采用的调控机制。本文中,我们利用转录组学方法,绘制尤因肉瘤中内在无序的 EWS 结构域的重要结构特征。
本文内容
摘要
摘要
许多癌症的特征是染色体易位,从而导致致癌融合转录因子的表达。通常,这些蛋白包含一个内在无序结构域(IDD),并与另一个蛋白的DNA结合结构域(DBD)融合,进而协调广泛的转录改变以促进恶性转化。这些融合往往是其所致癌症中唯一反复出现的基因组异常,因此成为极具吸引力的治疗靶点。然而,靶向致癌转录因子需要更深入地理解低复杂性IDD在其功能中所起的分子机制。EWSR1的N端结构域是一个参与多种致癌融合转录因子的IDD,包括EWS/FLI、EWS/ATF和EWS/WT1。本文中,我们利用RNA测序技术研究EWS结构域中对Ewing肉瘤中EWS/FLI转录功能至关重要的结构特征。首先,在Ewing肉瘤细胞中通过shRNA敲低内源性融合蛋白,并同时异位表达多种EWS突变体构建体。随后利用RNA测序分析表达这些构建体的细胞转录组,以表征EWS结构域突变所导致的功能缺陷。通过将转录组分析结果与先前已发表的关于EWS/FLI DNA结合基序、基因组定位以及转化能力的功能实验数据相结合,我们成功鉴定了EWS/FLI在致癌过程中起关键作用的结构特征,并定义了一组对Ewing肉瘤至关重要的新型EWS/FLI靶基因。本研究展示了RNA测序作为一种研究致癌转录因子内在无序结构域结构-功能关系的有效方法。
引言
某些癌症(包括许多儿童和青少年恶性肿瘤)的特征是存在染色体易位,从而产生新的融合癌基因1,2,3,4,5,6。所产生的融合蛋白通常作为致癌性转录因子发挥作用,通过协调转录调控的广泛改变来促进肿瘤发生7,8。具有此类易位的癌症通常具有相对静止的突变图谱,除特征性的融合基因外,很少出现其他反复发生的基因组异常4,9。因此,直接靶向融合蛋白成为治疗这些疾病的一种理想治疗策略。然而,这些致癌性转录因子通常由一个低复杂性、内在无序且具有转录激活功能的结构域与一个DNA结合结构域(DBD)融合而成10,11,12,13,14。这些蛋白的内在无序结构域(IDDs)和DNA结合结构域(DBDs)均已被证明难以用传统的药物手段进行靶向干预。因此,开发新的治疗方法需要更深入地了解这些融合蛋白在异常调控基因表达过程中所采用的分子机制。
在癌症中,EWSR1 的 N 端 IDD 区域通常与一个 DNA 结合结构域(DBD)发生融合,例如尤文肉瘤中的 EWS/FLI、弥漫性小圆细胞肿瘤中的 EWS/WT1,以及软组织透明细胞肉瘤中的 EWS/ATF110。目前对这些融合蛋白中 EWS IDD 的具体作用机制仍不完全清楚。其中研究最为深入的是 EWS/ETS 家族融合蛋白,尤其是 EWS/FLI。EWS/FLI 可协调全基因组范围内的表观遗传学和转录调控变化,导致数千个基因的激活或抑制7,11,15,16。研究表明,IDD 区域在招募转录共激活因子(如 p300、WDR5 和 BAF 复合物)以及共抑制因子(如 NuRD 复合物)方面具有重要作用11,15,17。EWS IDD 与 FLI1 的 C 端区域融合后,赋予 FLI1 的 ETS DBD 新的 DNA 结合特异性,使得该融合癌蛋白(EWS/FLI)不仅能结合经典的 ETS 共识序列,还能结合基因组中的重复 GGAA 微卫星区域18,19,20。结合其招募共激活因子的功能,EWS/FLI 这种新获得的 DNA 结合活性可促进在远离转录起始位点(TSS)的 GGAA 微卫星区域形成新的增强子(“类增强子”微卫星),并在靠近 TSS 的 GGAA 微卫星区域招募 RNA 聚合酶 II 以促进转录(“类启动子”微卫星)11,15,16,21。
综合这些数据,我们提出假设:EWS 结构域内的特定元件可能有助于将不同的共调节因子招募到 EWS/FLI 的不同结合位点。然而,由于该结构域具有高度重复性和无序性,识别 EWS/FLI 中 EWS 区段内的这些功能元件及其作用机制一直存在困难。本文中,我们利用尤文肉瘤细胞中已发表的敲低-回补系统,对 EWS IDD 区域内的这些功能元件进行功能性定位。在该系统中,使用靶向 FLI1 基因 3'非翻译区(3’UTR)的短发夹 RNA(shRNA)来耗竭 EWS/FLI 表达,并通过表达缺失 3’UTR 的不同 EWS/FLI 突变体 cDNA 构建体实现功能回补7,17,22。这些实验主要采用含有不同缺失片段的构建体,以解析 EWS IDD 与关键致癌表型之间的结构-功能关系,包括激活 GGAA 微卫星报告基因构建体、集落形成实验,以及对 EWS/FLI 激活和抑制基因的靶向验证7,17,22。然而,这些研究未能在 EWS/FLI 的 EWS IDD 区域内鉴定出对激活或抑制功能具有独特重要性的离散亚结构域。所有测试的构建体要么能够同时激活和抑制特定靶基因并有效形成集落,要么完全无法调控任何 EWS/FLI 靶基因,导致集落形成能力丧失7,17,22。
转录组分析得益于下一代测序技术的广泛应用,现已成为比较两种条件下基因表达特征的常用方法,通常用于筛选性或描述性研究。然而,我们希望利用RNA测序(RNA-seq)获取全基因组表达数据的能力,来解析内在无序结构域(IDDs)在转录因子功能中的作用。在此案例中,RNA-seq与基因敲低-回补系统相结合,用于探究EWS结构域的结构-功能关系。该方法同样适用于其他融合型转录因子,包括其他EWS融合蛋白,或功能尚未明确的野生型转录因子,并且相较于用于功能定位研究的其他检测方法(如报告基因检测或靶向qRT-PCR),具有多项优势。这些优势包括:能够在相关的染色质环境中检验功能的结构决定因素;在单次实验中同时检测多种类型的反应元件(例如激活型和抑制型元件、GGAA微卫星及非微卫星元件等);以及更有效地检测部分功能的能力。
成功实施该方法依赖于一个能够捕获目标表型的细胞体系(本例中为通过shRNA介导EWS/FLI耗竭的A673细胞),以及一组适用于该细胞体系的突变体表达载体(本例中为pMSCV-hygro载体,携带不同3x-FLAG标记的EWS/FLI突变体,通过逆转录病毒转导递送)。建议采用病毒转导方式,结合CRISPR介导的敲低构建体、shRNA介导的敲低构建体或cDNA表达构建体,并进行适当筛选以建立稳定细胞系,而非使用瞬时转染。当转录组学数据可与转录因子定位信息及其他可用的表型读数结果相互印证时,下游结果的解释将更具说服力。
在本研究中,我们应用该方法来表征EWS/FLI的DAF突变体的活性14。DAF突变体在EWS/FLI的EWS IDD重复区域中存在17个酪氨酸到丙氨酸的突变14。此前已有报道指出,该特定的EWS突变体在与ATF1 DNA结合结构域(DBD)融合时无法激活报告基因的表达14。然而,初步的qRT-PCR数据表明,该突变体仍能够激活EWS/FLI靶基因NR0B1的转录23。本文所述的转录组学方法成功检测到了DAF突变体的部分功能。通过将这些转录组数据与EWS/FLI结合位点及识别基序的信息相结合,我们进一步证明DAF突变体在GGAA微卫星重复序列上仍保留功能。这些结果表明DAF是首个具有部分功能的EWS/FLI突变体,并强调了非微卫星基因上的功能在肿瘤发生中的重要性(如文献23所报道)。这展示了该转录组结构-功能关联分析方法在揭示致癌转录因子功能方面的强大能力。
方案
1. 建立体外构建体组合
注意:此步骤将根据待分析的具体蛋白质而有所不同。
- 根据需要制备用于耗竭和表达构建体的病毒分装样品。
- 在10 cm组织培养皿中接种3-5 × 10⁵个细胞6 用于病毒转导的每种构建体所需的 HEK293-EBNA 或 HEK293T 细胞。将细胞接种于添加了 10% 胎牛血清(FBS)、青霉素/链霉素/谷氨酰胺(P/S/Q)和 0.3 mg/mL G418 的杜尔贝科改良伊格尔培养基(DMEM)中,过夜贴壁培养。
注意:建议使用 HEK293-EBNA 和 HEK293T 细胞进行病毒生产,因为这些细胞易于培养,转染效率高,并能高效表达附加体质粒中的重组蛋白。转染当天,细胞融合度应保持在 50–70% 之间。 - 为每种病毒转导构建体制备转染混合物。将2 mL低血清培养基与90 µL转染试剂混合。
注意:建议预先加温无血清培养基。 - 向转染混合物中加入各10 µg的病毒包装质粒(如gag-pol)、病毒包膜质粒(如VSV-G)以及以下之一:基于CRISPR的敲低质粒、基于shRNA的敲低质粒或cDNA表达载体(如pMKO或pMSCV)。用移液器轻轻吹打充分混匀。
- 将转染混合物在室温下静置 20 分钟。弃去组织培养皿中的 HEK293-EBNA 生长培养基,每皿加入 3 mL 添加了 10% FBS、P/S/Q 和 10 mM 丙酮酸钠的 DMEM 培养基。向每皿中逐滴加入 2 mL 转染混合物。将细胞置于含 37 ˚C 和 5% CO₂ 的培养箱中,在转染培养基中孵育过夜。2.
- 次日早晨,加入 20 mL 含 10% 胎牛血清、P/S/Q 添加剂和 10 mM 丙酮酸钠的 DMEM 培养基。将细胞置于 37 ˚C、5% CO₂ 条件下培养2 过夜。
- 次日早晨,将培养基更换为5 mL病毒收集培养基(VCM)(DMEM,添加10%热灭活FBS、P/S/Q和20 mM HEPES)。
- 4小时后,从培养板中收集VCM,置于冰上,并在4 °C下储存于50 mL锥形管中。更换为5 mL新鲜VCM。
- 孵育4小时后,将培养板中的VCM收集至同一个50 mL锥形管中,置于冰上4 °C保存。更换为8 mL新鲜VCM,用于过夜收集。
- 清晨从培养板中收集VCM,置于冰上4 °C保存于50 mL锥形管中。更换为5 mL新鲜VCM。
- 4小时后,从培养板中收集VCM,置于冰上,并储存在4°C的50 mL锥形管中。更换为5 mL新鲜VCM。再经过4小时后,从培养板中收集VCM,并加入至同一4°C保存的50 mL锥形管中。
- 将50 mL离心管中的样品经0.45 µm滤膜过滤后,分装至冻存管中(每份2 mL)。病毒分装液于-80 °C保存,直至使用。
注意:此处可暂停实验流程,病毒分装样品可保存至准备使用时。
- 在10 cm组织培养皿中接种3-5 × 10⁵个细胞6 用于病毒转导的每种构建体所需的 HEK293-EBNA 或 HEK293T 细胞。将细胞接种于添加了 10% 胎牛血清(FBS)、青霉素/链霉素/谷氨酰胺(P/S/Q)和 0.3 mg/mL G418 的杜尔贝科改良伊格尔培养基(DMEM)中,过夜贴壁培养。
- 在10 cm组织培养皿中以适当密度接种细胞,目标为50%汇合度。将培养皿置于含5% CO₂的37 ˚C培养箱中过夜,使细胞贴壁。2.
注意:对于 A673 细胞,此数值为 5 x 10⁶ 在含10%胎牛血清、P/S/Q补充剂和10 mM丙酮酸钠的10 mL DMEM培养基中培养细胞。具体培养条件可能因所用细胞的生长速率而异。 - 耗尽内源性目标因子。若无需耗尽细胞中的内源性目标蛋白,可跳过此步骤,直接进行步骤1.4。
- 解冻用于转导靶向目标蛋白的shRNA或CRISPR载体的病毒分装液。将冷冻分装液在37 °C水浴中快速解冻。
- 向每份病毒分装液中加入 2.5 µL 的 8 mg/mL 多聚素(polybrene),并用移液器轻轻吹打混匀。吸去细胞培养板中的培养基,沿培养板壁轻轻加入病毒分装液至 10 cm 培养板中。轻轻摇动培养板,使 2 mL 病毒液均匀分布。
- 在37 °C的组织培养孵育箱中孵育2小时。每隔30分钟轻轻摇动培养板,以防止培养板局部区域干燥。
- 加入5 mL含10% FBS、P/S/Q补充剂和10 mM丙酮酸钠的DMEM培养基,以及5 µL 8 mg/mL的polybrene。将细胞置于其中过夜孵育。
- 早上更换细胞培养基,并将细胞传代至含有筛选试剂的培养基中。传代细胞时,以适当密度接种,使其能够生长 48–72 小时并达到 50% 汇合度。
注意:对于转染了pSRP-iEF-2的A673细胞,以1:5比例传代接种,并用2 µg/mL嘌呤霉素筛选72小时。
- 转导cDNA表达载体。
- 检查细胞以确认融合度为50-70%。
- 解冻用于转导目的cDNA构建体的病毒分装液。将冷冻的分装液在37 °C水浴中快速解冻。向每份病毒分装液中加入2.5 µL的8 mg/mL聚凝胺,轻轻吹打混匀。
- 移除培养皿中细胞的培养基,沿培养皿壁轻轻加入病毒分装液至10 cm培养皿中。轻轻晃动培养皿,使2 mL病毒分装液均匀分布。
- 在37 °C的组织培养孵育箱中孵育2小时。每隔30分钟轻轻摇动培养板,以防止培养板局部区域干燥。
- 加入5 mL含10% FBS、P/S/Q补充剂和10 mM丙酮酸钠的DMEM培养基,以及5 µL 8 mg/mL的polybrene。将细胞置于其中过夜孵育。
- 第二天早上移除细胞培养基,将细胞传代至双筛选培养基中。根据需要培养并传代细胞 7–10 天,以实现双筛选及 cDNA 表达载体的表达。
注意:此传代比例可能需要根据不同细胞系进行优化。对于含有 pSRP-iEF-2 和 pMSCV-hygro 载体的 A673 细胞,将细胞以不稀释的方式传代至含 2 µg/mL 嘌呤霉素和 100 µg/mL 潮霉素的培养基中。
2. 收集细胞,验证载体表达,并建立相关表型检测方法
- 在双重筛选7-10天后,将细胞收集至15 mL圆锥形离心管中。使用血细胞计数板对收集的细胞进行计数。分装部分细胞用于RNA测序及验证cDNA表达载体的表达情况。
注意:应根据所研究的科学问题设置所需的关联性表型检测方法。菌落形成实验即为本研究中使用的一种关联性表型检测示例。- 收集 5 x 10⁶ 至 1 x 10⁷ 个细胞5 和 1 × 10⁶ 用于RNA测序的细胞及2 x 10⁶ 用于蛋白质提取的细胞。在1,000 × g下离心收集细胞沉淀。 x g 4 °C 下离心 5 分钟,弃去上清液。
- 用1 mL冷PBS洗涤沉淀物,于1,000 × g离心收集沉淀 x g 4 °C 下离心 5 分钟,弃上清液。将沉淀物在液氮中速冻,于 -80 °C 保存。
- 利用剩余细胞建立任何相关的检测方法。
注意:此处可暂停实验流程,将收集的样品保存在 -80 °C 冰箱中。
- 验证目标蛋白的敲低效果(如使用)及各构建体的表达情况。
- 将用于蛋白质提取的细胞沉淀置于冰上解冻。用500 µL预冷的核提取缓冲液(20 mM HEPES pH 7.9,140 mM NaCl,10%甘油,1.5 mM MgCl₂,1% NP-40)重悬细胞2,1 mM EDTA,1 mM DTT,1% IGEPAL)并加入蛋白酶抑制剂。冰上静置5分钟。
- 通过离心沉淀细胞核,离心条件为1,000 × g x g 4 °C 下离心 5 分钟,弃上清。用 500 µL 冰冷的核提取缓冲液(20 mM HEPES pH 7.9,140 mM NaCl,10% 甘油,1.5 mM MgCl₂)洗涤核2,1 mM EDTA,1 mM DTT,1% IGEPAL),并加入蛋白酶抑制剂。
- 通过离心沉淀细胞核,离心条件为1,000 × g x g 4 °C 下离心 5 分钟,弃上清液。用 200 µL 冷的含蛋白酶抑制剂的 RIPA 缓冲液重悬细胞核(根据沉淀物大小调整 RIPA 缓冲液体积)。冰上孵育 45–60 分钟,每 15 分钟剧烈涡旋振荡一次。
- 通过离心沉淀细胞碎片,离心条件为16,000 × g x g 4 °C 下孵育 45–60 分钟。保留上清液并转移至预冷的新离心管中
- 将5–10 µg蛋白质与1×上样缓冲液混合,煮沸5分钟,制备SDS-PAGE电泳样品。根据目标蛋白的需要,进行SDS-PAGE凝胶电泳。
- 根据目标蛋白的需要,将其转移至硝酸纤维素膜或PVDF膜。封闭后,使用相应的特异性一抗和二抗进行免疫印迹,以验证内源性蛋白的敲低效果(如使用)以及cDNA表达载体的外源表达情况。
注意:此处可暂停本实验方案。
- 提取RNA。评估RNA的质量和数量。
- 将细胞沉淀置于冰上解冻。根据试剂盒说明书,使用基于硅胶柱的总RNA提取试剂盒提取总RNA。
- 简而言之,使用试剂盒中的裂解缓冲液裂解细胞。将裂解液加入硅胶离心柱中,短暂离心。 >13000 rpm 离心 30-60 秒,或通过将裂解液上样至gDNA去除柱并短暂离心以去除gDNA >13000 rpm 离心 30-60 秒。
- 如果裂解液直接上样至硅胶离心柱,则在柱上进行DNA消化。若使用基因组DNA去除柱,请将洗脱液加入硅胶离心柱中,短暂离心 >13000 rpm,离心30-60秒。
- 按照制造商说明书洗涤柱上的RNA。用30 µL洗脱缓冲液洗脱RNA。
- 使用荧光计或任何其他可比仪器评估RNA的质量和数量。确保260/280比值接近2,并提供至少2.5 µg的RNA用于测序。
注意:在收集重复样本时,每个重复样本必须采用相同的RNA提取方案进行处理。 - 如有需要,可取少量RNA通过qRT-PCR检测目标蛋白的稳定敲低效果。剩余RNA样品储存于-80 °C。
- 通过重复步骤1-2,收集3-4组完整的RNA样本作为生物学重复。确保每个重复样本均表现出cDNA载体的充分表达以及内源蛋白的稳定敲低(如适用)。
3. 下一代测序
- 将提取的RNA提交至下一代测序平台进行测序,目标为获得5000万条150个碱基对(bp)的双端测序读长。遵循样品处理机构的操作说明。选择性富集带有聚腺苷酸尾的RNA,并进行链特异性测序。
4. 比对与转录本计数流程
注意:本方案假设在样本提交与处理后,每个样本将返回一组配对的 FASTQ 文件。这些文件通常以“fastq.gz”为后缀进行压缩。对这些 FASTQ 文件的进一步分析需要使用运行 Linux 操作系统的高性能计算(HPC)平台。
- 传输文件
- 使用 PuTTY 打开通往高性能计算(HPC)环境的终端。创建一个名为“project”的分析目录。
- 导航至“path_to/project”目录,并创建一个用于存放压缩的原始 fastq.gz 文件的新目录,命名为“fastq”。同时创建一个名为“trimmed”的目录。如下所示 图 S1A-C.
- 使用 WinSCP 或类似程序,将压缩的原始 fastq.gz 文件从本地存储转移至“path_to/project/fastq/”目录。检查每个样本是否均包含“R1”和“R2”文件,如图所示。 图 S1B.
- 可选:如有需要,安装 TrimGalore。在 Linux 系统中,将包含 trim_galore 可执行文件的目录设置到 PATH 环境变量中。
注意:使用 TrimGalore 去除低质量读段和接头序列。TrimGalore 可在 https://github.com/FelixKrueger/TrimGalore 获取。 - 可选:导航至下载的软件包目录(例如“path_to/software”)。使用命令“curl -fsSL https://github.com/FelixKrueger/TrimGalore/archive/[version].tar.gz -o trim_galore-[version].tar.gz”下载最新版本的 TrimGalore 软件包。
- 可选:解压 tar.gz 文件。使用命令“tar -xvzf trim_galore-[version_number].tar.gz”。
- 可选:将 TrimGalore 设为可执行文件。使用命令“chmod a+x path_to/software/TrimGalore-[version]/trim_galore”。确保该新目录已包含在 PATH 中。使用命令“export PATH=path_to/software/TrimGalore-[version]:$PATH”。
- 导航至 path_to/project/fastq/ 路径。使用以下所示命令,通过 TrimGalore 对 fastq.gz 文件中的低质量序列进行修剪。 图 S1C.
注意:此命令的其他参数可能相关,可在此处查看:https://github.com/FelixKrueger/TrimGalore/blob/master/Docs/
Trim_Galore_用户指南.md - 检查 path_to/project/trimmed 目录中的修剪后 fastq.gz 文件,确保其命名为 sample1_R1_val_1.fq.gz 和 sample1_R2_val_2.fq.gz
- 使用 STAR 将经修剪的 FASTQ 文件比对并生成转录本计数。
注意:STAR 可在 https://github.com/alexdobin/STAR 获取- 可选:安装 STAR 2.6 或更高版本,并将 STAR 可执行文件路径添加至环境变量。
- 可选:导航至已下载软件包的目录(例如“path_to/software”)。
- 可选:使用命令“curl -SLO https://github.com/alexdobin/STAR/archive/[version].tar.gz”下载 STAR 软件包。解压 tar.gz 文件。
- 可选:使用命令“tar -xzf [version].tar.gz”。使 STAR 可执行。使用命令“chmod a+x path_to/software/STAR-[version]/bin”。
- 可选:确保此新目录已添加至路径中。使用命令“export PATH=path_to/software/STAR-[version_number]/bin/linux_x86_64_static:$PATH”。
注意:STAR 手册可从以下网址获取:(https://github.com/alexdobin/STAR/blob/master/doc/STARmanual.pdf)。 - 确保有可用于STAR的基因组索引文件,并将其放置在与path_to/project/目录不同的独立目录中。如果先前实验已生成过索引文件,可直接使用该文件。或者,可从此处获取合适的预生成索引:http://refgenomes.databio.org/。若无可用索引,则根据STAR用户手册中的说明,使用“STAR --runMode genomeGenerate”命令构建新的基因组索引。
注意:在本实验方案的其余部分,STAR索引的路径将简称为“path_to/STAR_index”。 - 导航至 path_to/project/ 目录。创建一个名为“STAR_output”的新目录,如下所示 图 S1D.
- 导航至 path_to/project/trimmed/ 目录。使用如下所示的命令 图 S1D 使用STAR对修剪后的fastq.gz文件进行比对。
注意:此步骤的计算量最大,建议在具有多线程的高性能计算集群上执行(即 >16)用于比对任务。根据样本数量和可用的计算资源,此步骤可能需要数小时至数天。 - 在以下路径中查找后续步骤所需的输出文件,该文件包含每个转录本的计数:path_to/project/STAR_output/sampleN_ReadsPerGene.out.tab。
注意:在 ReadsPerGene.out.tab 文件中,第 1 列包含被计数特征的信息,第 2 列包含无链特异性(unstranded)的读段计数,第 3 列包含正向链特异性(forward stranded)的读段计数,第 4 列包含反向链特异性(reverse stranded)的读段计数。该文件的前四行包含未比对到单一基因的比对读段的相关信息。本实验方案需要使用无链特异性的读段计数。 - 使用 RStudio(推荐)或 HPC 环境中的 R,对每个样本的第 1 和第 2 列中第 5 行及以下的数据进行整合。在 R 中将工作目录设置为“project”。
- 使用以下命令读取每个 ReadsPerGene.out.tab 文件中的数据 图 S2A对于第一列,仅保留“Ensembl gene ID”列中“.”之前的字符,以便于后续处理。
- 使用以下命令将所有样本的计数结果整合到一个名为“totcts”的数据框中 图 S2B. 如需将此新的原始计数数据表保存为制表符分隔的 .txt 文件(例如 sample_counts.txt),可使用“write.table”命令.
注意:Ensembl 基因 ID 在所有样本的 ReadsPerGene.out.tab 文件中的顺序均相同。
5. 差异表达与下游分析
- 使用ComBat校正样本间的批次效应。
注意:存在两种可能解释基因表达变化的变量,第一种是所使用的构建体(即样本),第二种是与细胞传代时间相关的外部因素(即批次)。建议使用R软件包ComBat对样本进行批次间变异的标准化处理。- 如有需要,请安装并加载sva、DESeq2、AnnotationDBI、org.Hs.eg.db、pheatmap、RColorBrewer、genefilter、Cairo、ggplot2、ggbiplot、rgl和reshape2等软件包的库,如图S2C所示。安装时可依据各软件包的文档使用“install.packages”命令或Bioconductor进行。
- 首先将数据过滤为仅保留每个读段至少有一个计数的基因。将此新表格保存,以表示已完成过滤,如图S2D所示。
注意:通常许多基因的读段计数非常低或为零。 - 准备一个用于批次标准化的第二个表格,命名为“vars”,如图S2E所示。将行名设置为每个样本的唯一名称,列名设置为“sample”、“batch”和“construct”。
- 在“sample”列中为所有样本分配从1到n的唯一编号,其中n为样本总数。在“batch”列中为所有样本分配批次编号,使得condition-a_1和condition-b_1均被赋值为1,condition-a_2和condition-b_2均被赋值为2。在“construct”列中为所有样本分配实验条件标识,使得condition-a样本均为“A”,condition-b样本均为“B”。
- 同时定义批次变量,并为ComBat构建一个特定的空模型矩阵,如图S2F所示。使用图S2F中定义的命令运行ComBat。
- 进一步整理数据,将数值四舍五入至最接近的整数,并移除表达值为负的基因。使用图S3A中所示的命令。
注意:批次标准化的输出结果可能包含非整数的读段计数以及部分基因的负值。此步骤是必要的,因为下游的差异表达分析不支持负的读段计数。 - 使用DESeq2为每种构建体定义差异表达谱。
- 输入DESeq2的实验设计,如图S3B所示。使用DESeqDataSetFromMatrix函数构建DESeqDataSet(dds),估计大小因子,并运行DESeq2,如图S3B所示。
注意:输入“condition”列的数据顺序必须与计数矩阵中的列顺序一致。 - 为了评估分析质量,提取DESeq2使用的rlog标准化计数,如图S3B所示。
注意:在分析过程中,DESeq2通过“正则化对数”(rlog)变换对计数进行转换,以压缩低计数(信息量低)基因的样本间差异,从而保留高计数基因在不同样本间的差异(信息量高)。 - 从DESeq2结果中提取每种转录谱的结果时,以敲低条件或基础空载体为参照进行成对比较,如图S3C所示。进一步使用HGNC基因符号对此结果进行注释,如图S3D所示。
- 如图S3E所示,从DESeq2结果中提取数据。导出为单个文件,包含Ensembl基因ID、HGNC基因符号、基础平均表达量,以及所有构建体的差异表达数据(包括log2FoldChange、原始p值和校正后p值)。
注意:推荐以校正后p值< 0.05作为差异表达的阈值。 - 评估批次标准化的效果及样本内相似性。使用rlog标准化计数,结合图S4A-B中所示代码,绘制主成分分析(PCA)图和样本间距离图以检查样本聚类情况。
- 输入DESeq2的实验设计,如图S3B所示。使用DESeqDataSetFromMatrix函数构建DESeqDataSet(dds),估计大小因子,并运行DESeq2,如图S3B所示。
- 利用差异表达谱,使用图S4C中的代码生成火山图,评估不同构建体间基因表达的变化。
- 结合rlog标准化计数和层次聚类,识别不同构建体特有的基因特征。使用图S4D中所示代码。
- 从所有构建体中提取变异最大的1000个基因,组成矩阵。使用pheatmap基于这些基因对样本进行无监督的层次聚类。
- 通过观察树状图中感兴趣簇出现的层级,从中提取感兴趣的基因簇。将“k”设为该层级上的簇数量。重新绘制按簇排序的热图,以确定哪些簇为感兴趣簇,如图S5所示。
- 导出与每个簇相关的基因列表,如表S1所示。利用该信息确定感兴趣簇中的基因。
- 识别不同基因簇的生物学功能,并在各类别之间进行比较。此分析可通过多种生物信息学工具完成。本文使用ToppGene24,该工具可在线免费获取。
注意:目前有许多免费工具只需将基因列表复制粘贴至网页中的输入框即可进行分析。应根据研究问题选择最合适的分析工具。 - 可选步骤:若有关于转录因子在基因组上结合位点驱动转录输出的数据,可比较不同结合元件相关基因的转录响应,以进一步评估突变体功能。
6. 与相关表型的比较
- 将相关表型与生成的转录组谱数据进行比较,并作出相应解释。
结果
初步qRT-PCR数据显示,一种称为DAF的EWS/FLI突变体(在EWS的重复且无序区域中存在特定的酪氨酸到丙氨酸突变)仍具备激活EWS/FLI靶基因的能力,但无法抑制关键的靶基因23为了更好地理解EWS结构域中这些残基与EWS/FLI功能之间的关系,采用上述方案并按以下步骤进行: 图1 使用了靶向3’UTR的shRNA,通过病毒转导A673尤因肉瘤细胞 FLI1,导致内源性EWS/FLI耗竭。经过四天筛选后,通过病毒转导表达不同3XFLAG标签的EWS/FLI突变体构建体以恢复EWS/FLI功能,空载体作为无功能恢复的对照。一种缺失EWS结构域的非功能性突变体,称为 Δ22 用作阴性对照,野生型 EWS/FLI(称为 wtEF)用作阳性对照(图2A)。使用DAF作为测试载体,但也可根据需要使用一种以上的测试载体。细胞继续筛选额外10天,以使载体表达趋于稳定,随后收集细胞用于RNA(含基因组DNA去除步骤)、蛋白质及克隆形成实验。共收集四份重复样本,代表性qRT-PCR和Western印迹结果展示了有效的基因敲低与功能回补。 图2B-D需要注意的是,DAF 救援的细胞无法形成菌落,如图所示。 图2E,表明癌性转化能力受损。
在完成重复验证和表型实验后,将RNA送至全美儿童医院基因组医学研究所进行文库制备,并通过下一代测序获得约5000万条150 bp的双端测序读长。测序数据以fastq.gz文件形式返回。使用TrimGalore对这些文件中的低质量读段进行修剪,并利用STAR将读段比对至人类基因组hg19,同时对每个基因的读段进行计数。为与后续分析中使用的其他经人工整理的EWS/FLI数据集保持兼容,本研究采用hg19作为参考基因组。所有样本的读段计数结果被整合为一个统一的计数矩阵,其前6行数据如图3所示。
最初使用 DESeq2 进行计数分析时未进行批次标准化,但通过对样本间距离的可视化检查发现可能存在混杂的批次效应,如图4A中红色箭头所示。这可能是由于细胞在培养传代过程中引入的生物学变异以及各批次处理之间的差异所致。因此,推荐使用 ComBat 对批次效应进行标准化校正。经批次标准化后的样本间距离如图4B所示。在完成批次标准化后,使用 DESeq2 生成三种构建体(wtEF、Δ22 和 DAF)相对于基线的转录谱。需要注意的是,尽管差异分析中包含了“亲本”A673 细胞(空载敲低和空载挽救,此处称为“iLuc”),但本实验的参照样本是 EWS/FLI 耗尽的细胞,即 iEF 细胞。此处可通过比较 iLuc 样本与 iEF 样本来生成内源蛋白的转录谱,这对于理解挽救系统的作用机制可能具有研究价值,但这并非本次分析的目标。为突变体生成的转录谱包括相对于 iEF 的阳性(wtEF)和阴性(Δ22)对照,这些对照可作为其他突变体分析的基准。这一点非常重要,因为在本示例中,阳性对照并未完全重现内源性 EWS/FLI 的功能,这一点在其他研究中已有讨论7,23。
主成分分析(PCA)在 图5 表明 DAF 的转录谱介于 wtEF 与 Δ22,证实其部分功能。此外,对各样本中变异最大的1000个基因进行层次聚类分析显示,DAF未能抑制EWS/FLI靶基因的表达,且仅部分保留了基因激活活性,如图所示 图6A 和 图 S5ToppGene 分析表明,DAF 激活的基因类别在功能上不同于 EWS/FLI 激活但 DAF 无功能的靶基因图 6B有趣的是,由wtEF恢复功能的激活基因,而非DAF,其功能似乎与转录调控和染色质调控相关。根据集落形成实验的结果,该核心基因特征中的基因应进一步分析其在EWS/FLI介导的肿瘤发生中的作用。EWS/FLI介导的基因抑制的重要性此前已有报道。17.
已知EWS/FLI对GGAA微卫星重复元件具有独特的结合亲和力19,22,且在这些元件上的结合可驱动下游基因的调控11,15,18,20,22。这些微卫星元件已被归类为与激活或抑制相关,并根据其与转录起始位点(TSS)的距离分为近端(< 5 kb)或远端(> 5 kb)25。此外,还存在一些受EWS/FLI调控且在TSS近端含有高亲和力(HA)ETS基序的基因23。为了进一步分析DAF功能的特征及其能够挽救的EWS/FLI激活基因类型,研究人员分析了与这些不同类别相关的基因的差异表达情况。有趣的是,DAF最能挽救由GGAA微卫星激活的基因,但无法挽救靠近HA位点的激活基因,如图7所示。与层次聚类结果一致,DAF在各类基序中均未能挽救EWS/FLI介导的基因抑制。这些数据表明,DAF保留了EWS足够的结构特征,能够结合并从TSS近端和远端的GGAA微卫星元件启动基因激活。这可能源于其完整的SYGQ结构域,该结构域被认为在EWS/FLI于GGAA重复序列处发挥功能中具有重要作用11。这些结果还提示,DAF中发生突变的特定酪氨酸残基在HA位点介导的基因激活以及基因抑制过程中发挥着重要但尚未明确的功能,提示该领域值得进一步深入研究。
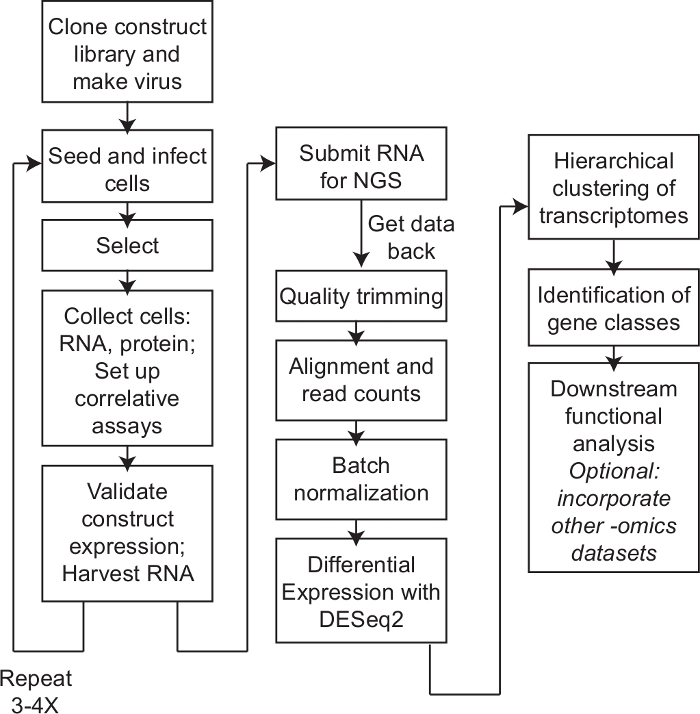
图1:实验流程。 转录组学用于结构-功能映射的逐步操作示意图。首先制备细胞以表达进行结构-功能映射所需的全套构建体。表达完成后,收集细胞用于提取RNA和蛋白质,并检测相关表型。验证构建体的表达情况,并重复此过程3-4次以获得独立的生物学重复样本。随后将RNA送交进行高通量测序(NGS)。收到数据后,对数据进行质量剪裁、序列比对,并计算每条转录本的读数。通过DESeq2软件校正批次效应,并确定转录组特征及差异表达。可进一步结合层次聚类分析及其他组学数据集、通路或功能分析进行下游整合分析。请点击此处查看该图的放大版本。
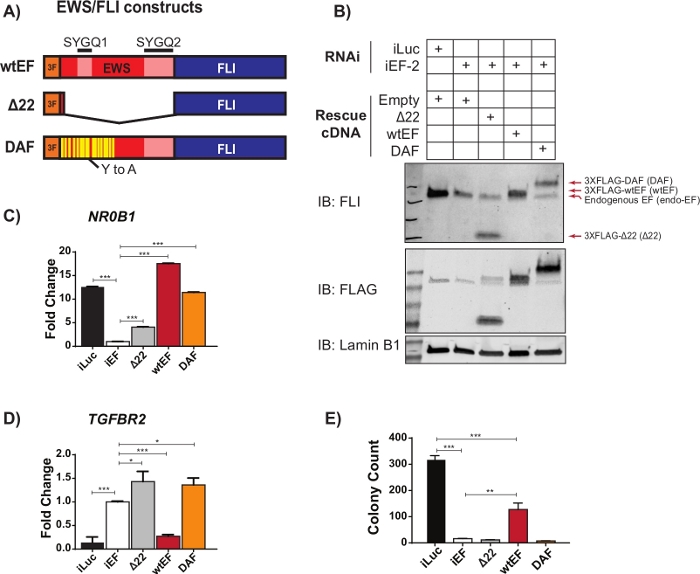
图2:构建体表达的验证及相关检测。 (A) 本示例中测试的构建体示意图。B) 通过免疫印迹验证内源性 EWS/FLI 的敲低及 3X-FLAG 标签构建体的表达。C,D) EWS/FLI 位点验证构建体活性C) 激活的靶基因, NR0B1,以及(D) 抑制靶基因, TGFBR2,通过qRT-PCR检测。数据以均值±标准差表示。P值采用Tukey's honestly significant difference检验计算。* p < 0.05,** p < 0.01,*** p < 0.001 < 0.05,** p < 0.01,*** p < 0.005(E)通过软琼脂集落形成实验评估构建体的转化活性所得的集落数量。P值采用Tukey多重比较检验(Tukey’s honest significance test)计算。* p < 0.05,** p < 0.01,*** p < 0.005。该图改编自 Theisen 等人。23 请点击此处以查看此图的放大版本。
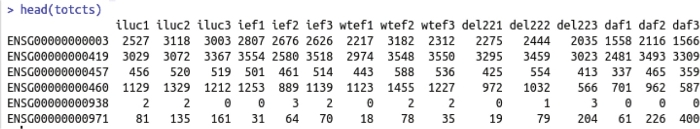
图3:用于分析的最终汇总计数数据。 显示计数文件前6行的截图,包含所有待进行批次标准化和分析的样本的基因计数。 请点击此处查看此图的放大版本。
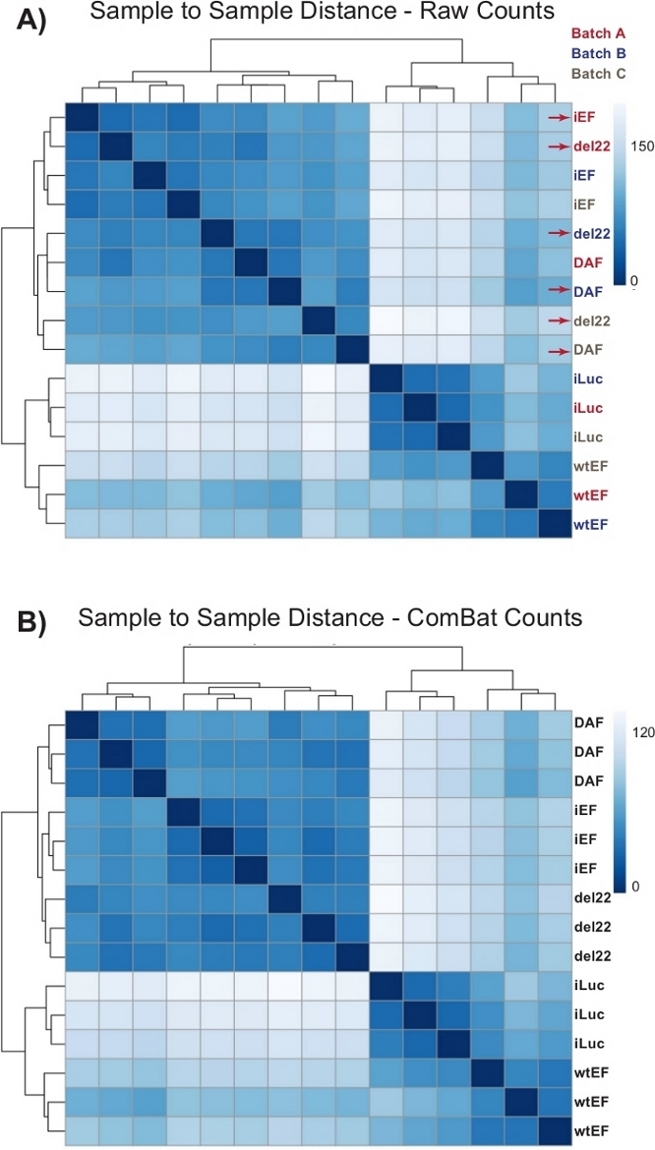
图 4:样本间距离热图。 (A)显示原始计数数据样本聚类情况的样本间距离图。由批次和样本共同导致的聚类样本以红色箭头标示。(B)使用 ComBat 进行批次标准化后的样本间距离图。在此,所有重复样本的聚类彼此靠近,且与批次无关。请点击此处查看该图的高清版本。
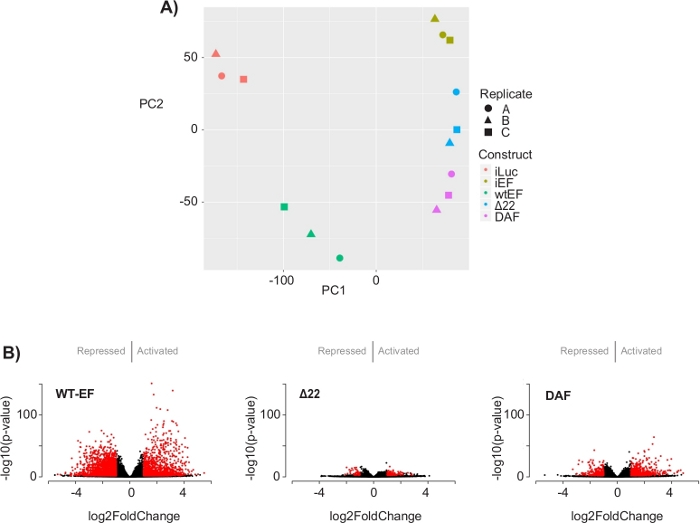
图5:差异表达分析结果。 (A) 对所有样本生成的转录组特征进行主成分分析(PCA)的结果显示,样本内部聚类明显,并表明DAF介于阳性对照(wtEF)与阴性对照(Δ22)之间。(B) 火山图展示了各构建体中基因的 -log(p值) 与 log2FoldChange 的关系。调整后p值 < 0.05 且 |log2(FoldChange)| > 1 的基因被视为显著差异表达,以红色显示。图5B改编自Theisen等人的研究23 请点击此处查看此图的放大版本。
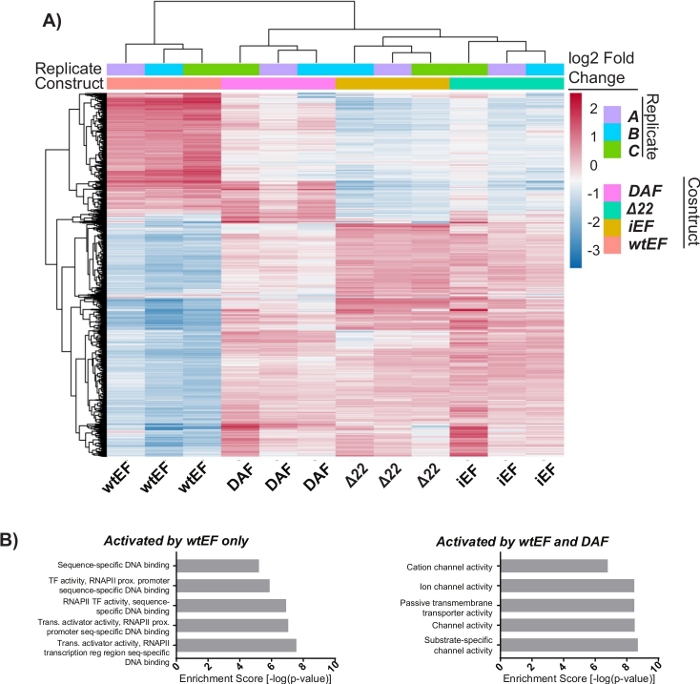
图6:通过层次聚类鉴定基因类别。 (A)对所有构建体及基线iEF中变异程度最高的前1000个基因进行层次聚类,结果显示DAF部分恢复了EWS/FLI介导的基因激活。(B)通过ToppGene获得的基因本体(分子功能)分析结果,展示在DAF作用下被EWS/FLI激活且被部分恢复或未被恢复的基因的功能富集情况。图6B改编自Theisen等人的研究23 请点击此处查看该图的放大版本。
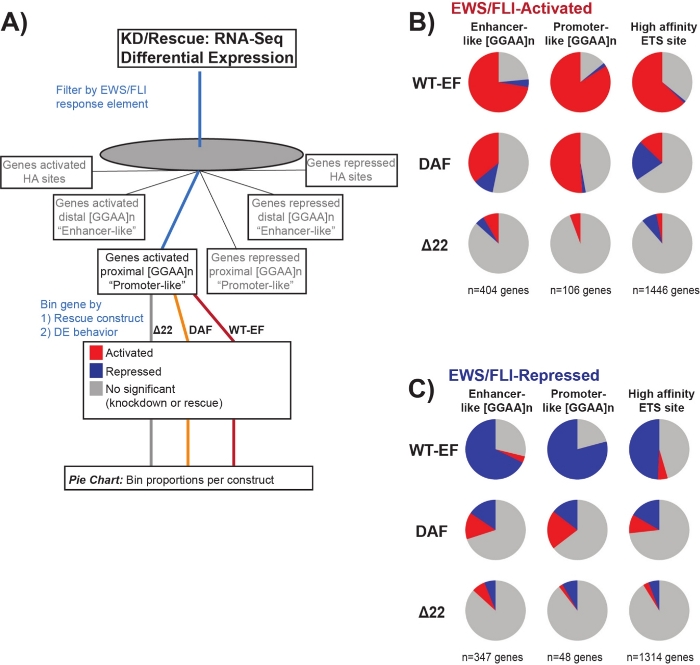
图7:不同转录因子反应元件对不同构建体的详细分析: (A)示意图展示如何整合本研究中的转录组谱与其它可用数据集,以生成(B)和(C)图。 (B,C)汇总结果显示不同类别的直接受EWS/FLI调控的靶基因在(B)激活和(C)抑制情况下的恢复效果。所包含的基因仅限于由内源性EWS/FLI可检测到差异表达的基因。在每个饼图中,灰色部分表示未被该构建体恢复的基因比例,红色部分表示差异激活的基因比例,蓝色部分表示差异抑制的基因比例。该图改编自Theisen等23 请点击此处查看此图的放大版本。
图S1:将fastq.gz文件加载到HPC环境、剪切和比对。 请点击此处下载该图。
图S2:在样本间整合读段计数并使用ComBat进行批次标准化。 请点击此处下载该图。
图 S3:运行 DESeq2 并提取差异表达分析结果。 请点击此处下载该图。
图S4:分析输出结果。 请点击此处下载该图。
图S5:通过层次聚类识别基因类别: 对所有构建体及基线iEF中变异程度最高的前1000个基因进行层次聚类,并将其划分为k个类群。本例中k=7,但该参数由用户设定,如图S4D所示。请点击此处下载该图。
表 S1:具有聚类注释的基因列表(Ensembl 基因 ID)。 请点击此处下载该表格。
讨论
研究致癌转录因子的生化机制对于理解其引发的疾病并设计新的治疗策略至关重要。这一点在由染色体易位导致融合转录因子产生的恶性肿瘤中尤为突出。这些嵌合蛋白所包含的结构域可能缺乏与野生型蛋白中存在的调控结构域之间的有效相互作用,从而使得在融合蛋白背景下解读结构与功能关系变得复杂26,27,28。此外,许多此类致癌性融合蛋白具有低复杂性且本质上无序的结构域10,13,29,30。
EWS 结构域就是一个典型的内在无序结构域,参与多种致癌性融合事件10。由于其内在无序性和重复序列特性,解析 EWS 结构域所采用的分子机制一直存在困难。以往对结构-功能关系的研究大多依赖于在报告基因检测中使用不同的突变体,或在无法模拟相关细胞环境的细胞背景下进行实验,或者所采用的突变体缺乏能够产生有意义部分功能的结构变异11,17,25。本文所提出的方法解决了上述问题。结构-功能作图在与疾病相关的细胞环境中进行,同时利用下一代测序技术实现转录组分析,从而在天然染色质背景下评估转录因子的功能。以 EWS/FLI 的 DAF 突变体为例,已有研究报道,DAF 在使用孤立应答元件的报告基因检测中活性较低,但在完整基因启动子背景下(无论是在报告基因检测中还是在天然染色质中)均表现出活性,提示其具有有趣的表型特征23。采用本文所述方法可更直接地回答在疾病状态下,基因组中哪类调控元件最具响应性。通过在天然染色质环境中同时检测所有候选靶基因,转录组学方法更有可能识别出具有部分功能的构建体。
使用与疾病相关的细胞背景这一内在优势,可能也是该技术最大的局限性。其中最重要的因素之一是为这些实验选择合适的细胞体系。许多来源于具有典型诊断性转录因子的恶性肿瘤的细胞系,难以耐受该转录因子的敲低;而在许多情况下,特别是对于儿童癌症,其真正的起源细胞仍存在争议,且在其他细胞背景下表达该癌基因可能具有严重毒性31,32。在这些情况下,可在不同的细胞背景下开展实验,但研究人员在解释结果时必须谨慎,并应在更贴近疾病状态的细胞类型中对任何相关发现进行适当验证。
至关重要的是,必须仔细验证癌基因表达的稳定性和表型效应,并且仅对符合严格标准的样本进行测序。在此,需通过蛋白质印迹法(Western blot)确认基因敲低和回补效果,并通过少量已知靶基因的定量反转录 PCR(qRT-PCR)来验证阳性对照(图 2)。同样重要的是,应尽可能减少批次间的变异,为此需在每一批次中尽可能以一致的方式进行细胞和RNA的制备操作。
当本方法与能够反映所研究转录因子全基因组功能的其他类型基因组数据相结合时,其优势尤为显著。未来此类结构-功能分析的发展方向将扩展至包括 ChIP-seq 和 ATAC-seq,以确定转录因子的结合位点及其诱导的染色质可及性变化。综合来看,这类数据有助于揭示致癌性转录因子的不同结构域如何分别参与功能的不同方面(例如:DNA 结合、染色质修饰或共调节因子招募)。总体而言,利用基于高通量测序(NGS)的方法来绘制融合型转录因子的结构-功能关系图谱,可揭示这些蛋白致癌功能背后的生化决定因素,从而加深我们对相关疾病机制的理解,并推动新型治疗策略的开发。
披露
SLL 宣布存在利益冲突,其担任 Salarius Pharmaceuticals 的顾问委员会成员并持有该公司股权。SLL 还是美国专利号 US 7,393,253 B2(“尤文肉瘤的诊断和治疗方法及组合物”)和美国专利号 US 8,557,532(“耐药性尤文肉瘤的诊断与治疗”)的列名发明人。上述情况不会影响我们遵守 JoVE 有关数据和材料共享的政策。
致谢
本研究得到了全美儿童医院阿比盖尔·韦克斯纳研究所高性能计算设施的支持。本工作获得了美国国立卫生研究院国家癌症研究所 [U54 CA231641 资助 SLL,R01 CA183776 资助 SLL]、亚历克斯柠檬水募捐基金会 [ERT 青年研究者奖]、Pelotonia [ERT 博士后奖学金] 以及澳大利亚国家健康与医学研究委员会 CJ Martin 海外生物医学奖学金 [APP1111032 资助 KIP] 的资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 湿实验试剂 | |||
| 抗FLI兔多克隆抗体 | Abcam | ab15289 | 1:500 |
| 抗lamin B1兔多克隆抗体 | Abcam | ab16048 | 1:2000 |
| 用于导入突变体构建物的基于细胞的系统 | 根据所用细胞系统确定 | ||
| 冻存管 | 用于病毒分装 | ||
| DMEM | Corning Cellgro | 10-013-CV | 用于病毒生产 |
| 胎牛血清 | Gibco | 16000-044 | 用于病毒生产 |
| G418 | ThermoFisher | 10131027 | 用于病毒生产 |
| HEK293-EBNA细胞 | ATCC | CRL-10852 | 用于病毒生产 |
| HEPES | Gibco | 15630106 | |
| 潮霉素B | ThermoFisher | 10687010 | |
| M2抗FLAG小鼠单克隆抗体 | Sigma | F3165 | 1:2000 |
| 近红外二抗 | Li-Cor | ||
| Opti-MEM | Gibco | 31985062 | 用于病毒生产 |
| 青霉素/链霉素/谷氨酰胺 | Gibco | 10378-016 | 用于病毒生产 |
| Polybrene | Sigma | TR-1003-G | 用于病毒转导 |
| 嘌呤霉素 | Sigma | P8833 | 以2 mg/mL母液储存 |
| RNeasy Plus试剂盒 | Qiagen | 74136 | 含gDNA去除柱 |
| 筛选试剂 | 根据所用细胞系统确定 | ||
| 丙酮酸钠 | Gibco | 11360-070 | 用于病毒生产 |
| 组织培养基 | 根据所用细胞系统确定 | ||
| TransIT-LT1 | Mirus | MIR 2304 | 用于病毒生产 |
| 软件 | |||
| 高性能计算环境访问权限 | |||
| AnnotationDbi | 1.38.2 | ||
| Cairo | 1.5-10 | ||
| DESeq2 | 1.16.1 | ||
| genefilter | 1.58.1 | ||
| ggbiplot | 0.55 | ||
| ggplot2 | 3.1.1 | ||
| org.Hs.eg.db | 3.4.1 | ||
| pheatmap | 1.0.12 | ||
| PuTTY | |||
| R | 3.4.0 | ||
| RColorBrewer | 1.1-2 | ||
| reshape2 | 1.4.3 | ||
| rgl | 0.100.19 | ||
| RStudio | |||
| STAR | 版本2.6或更高 | ||
| sva | 3.24.4 | ||
| TrimGalore! | |||
| WinSCP |
参考文献
- Miettinen, M., et al. New fusion sarcomas: histopathology and clinical significance of selected entities. Human Pathology. 86, 57-65 (2019).
- Knott, M. M. L., et al. Targeting the undruggable: exploiting neomorphic features of fusion oncoproteins in childhood sarcomas for innovative therapies. Cancer and Metastasis Reviews. 38, 625-642 (2019).
- Yoshihara, K., et al. The landscape and therapeutic relevance of cancer-associated transcript fusions. Oncogene. 34, 4845-4854 (2015).
- Duesberg, P. H. Cancer genes generated by rare chromosomal rearrangements rather than activation of oncogenes. Medical Oncology and Tumor Pharmacotherapy. 4, 163-175 (1987).
- Dupain, C., Harttrampf, A. C., Urbinati, G., Geoerger, B., Massaad-Massade, L. Relevance of Fusion Genes in Pediatric Cancers: Toward Precision Medicine. Molecular Therapy - Nucleic Acids. 6, 315-326 (2017).
- Mitelman, F., Johansson, B., Mertens, F. The impact of translocations and gene fusions on cancer causation. Nature Reviews Cancer. 7, 233-245 (2007).
- Smith, R., et al. Expression profiling of EWS/FLI identifies NKX2.2 as a critical target gene in Ewing's sarcoma. Cancer Cell. 9, 405-416 (2006).
- Davicioni, E., et al. Identification of a PAX-FKHR gene expression signature that defines molecular classes and determines the prognosis of alveolar rhabdomyosarcomas. Cancer Research. 66, 6936-6946 (2006).
- Gröbner, S. N., et al. The landscape of genomic alterations across childhood cancers. Nature. 555, 321-327 (2018).
- Kim, J., Pelletier, J. Molecular genetics of chromosome translocations involving EWS and related family members. Physiological Genomics. 1, 127-138 (1999).
- Boulay, G., et al. Cancer-Specific Retargeting of BAF Complexes by a Prion-like Domain. Cell. 171, 163-178 (2017).
- Lessnick, S. L., Braun, B. S., Denny, C. T., May, W. A. Multiple domains mediate transformation by the Ewing’s sarcoma EWS/FLI-1 fusion gene. Oncogene. 10, 423-431 (1995).
- Leach, B. I., et al. Leukemia fusion target AF9 is an intrinsically disordered transcriptional regulator that recruits multiple partners via coupled folding and binding. Structure. 21, 176-183 (2013).
- Ng, K. P., et al. Multiple aromatic side chains within a disordered structure are critical for transcription and transforming activity of EWS family oncoproteins. Proceedings of the National Academy of Sciences U.S.A. 104, 479-484 (2007).
- Riggi, N., et al. EWS-FLI1 Divergent Chromatin Remodeling Mechanisms to Directly Activate or Repress Enhancer Elements in Ewing Sarcoma. Cancer Cell. 26, 668-681 (2014).
- Tomazou, E. M., et al. Epigenome Mapping Reveals Distinct Modes of Gene Regulation and Widespread Enhancer Reprogramming by the Oncogenic Fusion Protein EWS-FLI1. Cell Reports. 10, 1082-1095 (2015).
- Sankar, S., et al. Mechanism and relevance of EWS/FLI-mediated transcriptional repression in Ewing sarcoma. Oncogene. 32, 5089-5100 (2013).
- Gangwal, K., et al. Microsatellites as EWS/FLI response elements in Ewing's sarcoma. Proceedings of the National Academy of Sciences U.S.A. 105, 10149-10154 (2008).
- Gangwal, K., Close, D., Enriquez, C. A., Hill, C. P., Lessnick, S. L. Emergent Properties of EWS/FLI Regulation via GGAA Microsatellites in Ewing's Sarcoma. Genes & Cancer. 1, 177-187 (2010).
- Guillon, N., et al. The Oncogenic EWS-FLI1 Protein Binds In Vivo GGAA Microsatellite Sequences with Potential Transcriptional Activation Function. PLoS One. 4, 4932(2009).
- Chong, S., et al. Imaging dynamic and selective low-complexity domain interactions that control gene transcription. Science. 361, (2018).
- Johnson, K. M., et al. Role for the EWS domain of EWS/FLI in binding GGAA-microsatellites required for Ewing sarcoma anchorage independent growth. Proceedings of the National Academy of Sciences U.S.A. 114, 9870-9875 (2017).
- Theisen, E. R., et al. Transcriptomic analysis functionally maps the intrinsically disordered domain of EWS/FLI and reveals novel transcriptional dependencies for oncogenesis. Genes & Cancer. 10, 21-38 (2019).
- Chen, J., Bardes, E. E., Aronow, B. J., Jegga, A. G. ToppGene Suite for gene list enrichment analysis and candidate gene prioritization. Nucleic Acids Research. 37, 305-311 (2009).
- Johnson, K. M., Taslim, C., Saund, R. S., Lessnick, S. L. Identification of two types of GGAA-microsatellites and their roles in EWS/FLI binding and gene regulation in Ewing sarcoma. PLOS One. 12, 0186275(2017).
- Kim, P., Ballester, L. Y., Zhao, Z. Domain retention in transcription factor fusion genes and its biological and clinical implications: a pan-cancer study. Oncotarget. 8, 110103-110117 (2017).
- de Mendíbil, I. O., Vizmanos, J. L., Novo, F. J. Signatures of Selection in Fusion Transcripts Resulting from Chromosomal Translocations in Human Cancer. PLOS One. 4, 4805(2009).
- Frenkel-Morgenstern, M., Valencia, A. Novel domain combinations in proteins encoded by chimeric transcripts. Bioinformatics. 28, 67-74 (2012).
- Hegyi, H., Buday, L., Tompa, P. Intrinsic Structural Disorder Confers Cellular Viability on Oncogenic Fusion Proteins. PLoS Computational Biology. 5, 1000552(2009).
- Latysheva, N. S., Babu, M. M. Discovering and understanding oncogenic gene fusions through data intensive computational approaches. Nucleic Acids Research. 44, 4487-4503 (2016).
- Deneen, B., Denny, C. T. Loss of p16 pathways stabilizes EWS/FLI1 expression and complements EWS/FLI1 mediated transformation. Oncogene. 20, 6731-6741 (2001).
- Kendall, G. C., et al. PAX3-FOXO1 transgenic zebrafish models identify HES3 as a mediator of rhabdomyosarcoma tumorigenesis. eLife. 7, 33800(2018).
重印与许可
