本实验方案为生物信息学初学者提供了一个入门级的CUT&RUN分析流程,帮助用户完成CUT&RUN测序数据的初步分析与验证。完成此处描述的分析步骤,并结合后续的峰注释分析,用户可深入理解染色质调控的分子机制。
本文内容
摘要
摘要
CUT&RUN 技术有助于检测全基因组范围内的蛋白质-DNA 相互作用。CUT 的典型应用&RUN 包括组蛋白尾部修饰变化的分析或转录因子染色质占位的定位。CUT 的广泛应用&RUN 的应用在一定程度上得益于其相较于传统 ChIP-seq 的技术优势,包括更低的细胞起始量需求、更低的测序深度要求,以及由于无需使用交联剂(此类试剂可能遮蔽抗体表位)而带来的背景信号降低和灵敏度提升。CUT 的广泛应用&RUN 还得益于 Henikoff 实验室慷慨分享试剂,以及商业试剂盒的开发,从而加快了初学者对该技术的采用。随着 CUT&RUN 增加,CUT&RUN测序分析与验证已成为主要瓶颈,必须克服这些障碍才能实现以湿实验为主的团队对CUT的全面采用&RUN分析通常从对原始测序读长进行质量控制检查开始,以评估测序深度、读长质量及潜在的偏差。随后将读长比对至参考基因组序列组装,再利用多种生物信息学工具对蛋白质富集的基因组区域进行注释,确认数据的可解释性,并得出生物学结论。尽管存在多种 计算机模拟 分析流程已开发用于支持 CUT&RUN 数据分析中,由于其复杂的多模块结构以及使用多种编程语言,这些平台对于缺乏多种编程语言背景但希望理解 CUT 的生物信息学初学者而言较为困难&RUN 分析流程并自定义其分析流程。在此,我们提供一种单语言逐步的 CUT&适用于各种生物信息学经验水平用户的RUN分析流程方案。本方案包括完成关键的质量控制检查,以验证测序数据是否适合进行生物学解释。我们预期,结合本文提供的入门级方案及后续的峰注释分析,用户能够从自身的CUT&RUN 数据集
引言
测量蛋白质与基因组DNA之间相互作用的能力,对于理解染色质调控的生物学机制至关重要。能够有效检测特定蛋白质在染色质上占据情况的实验方法,至少可提供两方面的关键信息:i)基因组定位位置;ii)特定基因组区域中该蛋白质的丰度。追踪目标蛋白质在染色质上的招募过程及其定位变化,有助于揭示该蛋白质的直接靶位点,并阐明其在基于染色质的生物学过程中(如转录调控、DNA修复或DNA复制)所发挥的分子机制作用。目前可用的蛋白质-DNA相互作用分析技术,使研究人员能够以前所未有的分辨率探索基因调控机制。这些技术进步得益于新型染色质分析技术的出现,其中包括Henikoff实验室开发的“靶位切割与核酸酶释放技术”(Cleavage Under Targets and Release Using Nuclease, CUT&RUN)。与传统的染色质免疫沉淀(ChIP)技术相比,CUT&RUN具有多项技术优势,包括更低的细胞用量需求、更低的测序深度要求,以及更高的灵敏度和更低的背景信号——这主要归因于该方法无需使用交联剂,从而避免了交联剂对抗体表位的遮蔽效应。采用该技术研究染色质调控,需要深入理解其技术原理,并掌握CUT&RUN数据的分析、验证与解读方法。
CUT&RUN 实验流程首先将细胞与刀豆球蛋白A(Concanavalin A)偶联的磁珠结合,从而在整个实验过程中实现对少量细胞的操作。分离的细胞通过温和去污剂进行通透化处理,以促进靶向目标蛋白的抗体进入。随后,利用与微球菌核酸酶(MNase)相连的Protein A或Protein A/G标签,将MNase招募至已结合的抗体处。加入钙离子以启动酶活性。MNase消化产生单核小体DNA-蛋白复合物。接着通过螯合钙离子终止消化反应,从细胞核中释放出MNase消化产生的短DNA片段,随后进行DNA纯化、文库构建以及高通量测序1(图1)。
计算机模拟 用于绘制和量化全基因组范围内蛋白质占据情况的方法,随着用于富集DNA-蛋白相互作用的湿实验技术的发展而并行进步。识别信号富集区域(峰)是生物信息学分析中最关键的步骤之一。早期的ChIP-seq分析方法采用了MACS等算法2 和 SICER3,采用统计模型来区分 真正有效的 从背景噪声中分辨出蛋白质-DNA结合位点。然而,CUT的背景噪声更低且分辨率更高&RUN 数据使得某些在 ChIP-seq 分析中使用的峰识别程序不适用于 CUT&RUN 分析4这一挑战凸显了开发更适用于CUT分析的新工具的必要性&RUN 数据。SEACR4 代表一种近期开发的工具,可用于从CUT中进行峰呼叫&RUN 数据,同时克服通常用于 ChIP-seq 分析工具的局限性。
对 CUT&RUN 测序数据的生物学解释来源于分析流程中峰识别(peak calling)下游的输出结果。可采用多种功能注释程序,以预测 CUT&RUN 数据中识别出的峰所对应的潜在生物学意义。例如,基因本体(Gene Ontology, GO)项目为感兴趣的基因提供了公认的功能注释5,6,7。目前已有多种软件工具和资源可支持 GO 分析,用于揭示在 CUT&RUN 峰区域中富集的基因及基因集合8,9,10,11,12,13,14。此外,Deeptools15、整合基因组学浏览器(Integrative Genomics Viewer, IGV)16 和 UCSC 基因组浏览器(UCSC Genome Browser)17 等可视化软件可用于在全基因组范围内对目标区域的信号分布和模式进行可视化展示。
从 CUT&RUN 数据中得出生物学结论的能力在很大程度上依赖于对数据质量的验证。需要验证的关键环节包括:i) CUT&RUN 文库测序质量的评估,ii) 重复样本之间的一致性,以及 iii) 峰中心处信号分布情况。完成上述三个方面的验证对于确保 CUT&RUN 文库样本的可靠性及后续分析结果的准确性至关重要。因此,建立入门级的 CUT&RUN 分析指南,使生物信息学初学者和湿实验研究人员能够在标准的 CUT&RUN 分析流程中执行这些验证步骤,具有重要意义。
随着湿实验CUT&RUN技术的发展,已开发出多种计算机模拟的CUT&RUN分析流程,例如CUT&RUNTools 2.018,19、nf-core/cutandrun20和CnRAP21,以支持CUT&RUN数据的分析。这些工具为分析单细胞和批量CUT&RUN及CUT&Tag数据集提供了强大的方法。然而,这些分析流程通常具有相对复杂的模块化程序结构,且需要掌握多种编程语言,这可能会阻碍生物信息学初学者对CUT&RUN分析步骤的深入理解以及自定义分析流程的需求。克服这一障碍需要一种全新的入门级CUT&RUN分析流程,该流程应以简单单一的编程语言编写成逐步脚本,便于初学者使用。
本文介绍了一种简单且基于单一语言的 CUT&RUN 分析流程方案,提供了配有详细说明的逐步操作脚本,帮助新用户和初学者开展 CUT&RUN 测序分析。该流程中所使用的程序均由原始开发团队公开提供。本方案涵盖的主要步骤包括:序列比对、峰识别、功能分析,以及最关键的验证步骤——用于评估样本质量,以确定数据是否适用于生物学解释及其可靠程度(图2)。此外,该流程还为用户提供机会,将其分析结果与公开可用的 CUT&RUN 数据集进行交叉比对。最终,该 CUT&RUN 分析流程方案可作为生物信息学分析初学者及湿实验研究人员的入门指南和参考依据。
方案
注意:GSE126612 中 CUT&RUN fastq 文件的信息见表1。本研究中所用软件的相关信息列于材料表中。
1. 从其 Github 页面下载 Easy-Shells_CUTnRUN 流程
- 从操作系统中打开终端。
注意:如果用户不确定如何在 macOS 和 Windows 中打开终端,请查阅此网页(https://discovery.cs.illinois.edu/guides/System-Setup/terminal/)。对于 Linux 系统,请查阅此网页(https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/)。 - 在终端中输入以下命令,从 Github 下载压缩的分析流程:wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip。
- 下载完成后,在终端中输入以下命令解压下载的 zip 文件:unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/。
- 解压完成后,在终端中输入 rm ~/Desktop/Easy-Shells_CUTnRUN.zip 删除 zip 文件,并输入 mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN 修改文件夹名称。
- 删除压缩文件后,在终端中输入 chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh,为工作目录下的所有 shell 脚本设置可执行权限。此后,只需在终端中输入这些脚本的路径和名称,或将脚本拖入终端后回车,即可运行这些 shell 脚本。
注意:Bash shell 通常已预装在大多数 Linux 发行版中。然而,较新的 macOS 版本不再预装 Bash shell。如果系统中没有 Bash,请先安装 Bash shell。请访问以下链接获取在 Linux 操作系统(https://ioflood.com/blog/install-bash-shell-linux/)和 macOS(https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:)中安装 Bash shell 的操作说明。这些逐步执行的 shell 脚本旨在创建一个文件夹 ~/Desktop/GSE126612,以便在该目录内完成大部分 CUT&RUN 分析,无需进行任何修改。如果用户理解如何使用这些 shell 脚本,可对其进行修改和自定义,以分析其他 CUT&RUN 数据集,并根据具体项目需求调整参数选项。如需查看和编辑这些 shell 脚本,建议使用 Visual Studio Code(https://code.visualstudio.com/)作为跨主流操作系统的易用程序之一。
2. 安装 Easy Shells CUTnRUN 所需的程序
- 在名为 Script_01_installation_***.sh 的 Shell 脚本中,找出脚本名称包含用户系统操作系统的那一个。目前,Easy Shells CUTnRUN 支持 macOS、Debian/Ubuntu 以及 CentOS/RPM 系统的安装脚本。
- 打开终端,输入 echo $SHELL 以检查当前终端的默认 Shell。如果 Bash Shell 是当前终端的默认 Shell,用户将在终端中看到类似 /path/to/bash 或 /bin/bash 的提示信息。
- 如果默认 Shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash Shell 设置为默认 Shell。若终端已使用 Bash Shell 作为默认 Shell,则跳过此步骤。
- 在终端中,通过输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh 来运行安装脚本,或将该 Shell 脚本文件拖入终端后回车执行。
- 阅读 /path/to/SEACR-1.3/Testfiles 文件夹中的 Test_README.md 文件。按照 README 文件中的说明,确认用户系统中的 SEACR 是否正常工作。
注意:使用 SEACR 官方 GitHub 页面提供的测试文件验证 SEACR 功能至关重要,以确保能够从 CUT&RUN 数据中获得正确的峰识别结果。因此,在完成 SEACR 安装后,请立即遵循 /path/to/SEACR-1.3/Testfiles 目录下的 Test_README.md 文件中的说明进行验证。尽管 Easy Shells CUTnRUN 为部分操作系统提供了安装脚本,但这些脚本可能无法在所有用户的系统上成功安装 Easy Shells CUTnRUN 所需的全部程序。如果安装过程中出现问题,请查阅未成功安装程序的原始网站,或通过 Easy Shells CUTnRUN 的 GitHub Issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)请求帮助。
3. 从序列读取档案库(SRA)下载公开可用的CUT&RUN数据集
- 打开终端并输入 echo $SHELL,以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户将在终端中看到类似以下内容的信息:/path/to/bash(或类似 /bin/bash 的消息)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本将执行以下操作:(i) 创建一个文件夹(~/Desktop/GSE126612/fastq),并在该 fastq 文件夹内下载一个文本文件中列出的 SRA 文件列表(~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt)。例如,SRR_list.txt 包含 GSE126612 CUT&RUN 样本子集的 fastq 文件。(ii) 在 fastq 文件夹内下载原始 fastq 文件。(iii) 创建一个文件夹(~/Desktop/GSE126612/log/fastq),并在该日志文件夹中生成一个日志文件(download-fastq_log.txt)和一个已下载样本信息文件(SRR_list_info.txt)。 - 运行脚本后,请检查日志文件。如果日志文件中存在任何错误信息,请修正错误后重新执行步骤 3.3。若遇到无法解决的问题,请访问 Easy Shells CUTnRUN 的 GitHub issues 页面寻求帮助(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)。
注意:为便于练习本 CUT&RUN 分析流程,以下公开可用样本已从 SRA 获取:一组模拟对照(IgG)样本、三组染色质结构与转录因子蛋白(CTCF)样本、四组对应“活性”组蛋白修饰标记(H3K27Ac)的样本,以及三组对应 RNA 聚合酶 II(RNAPII-S5P)标记的转录起始区域的样本。测序采用双端测序(paired-end),因此每个样本包含两个配对的文件。
4. 原始测序文件的初步质量检查
- 打开终端,输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户将在终端中看到类似 /path/to/bash 或 /bin/bash 的信息。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh,或将该 shell 脚本拖入终端后回车执行。
注意:该 shell 脚本将执行以下操作:(i) 对 ~/Desktop/GSE126612/fastq 文件夹中的所有原始 fastq 文件运行 FastQC 程序,并将质量检测报告文件保存至 ~/Desktop/GSE126612/fastqc.1st 文件夹;(ii) 每次 FastQC 运行后生成一个日志文件(fastqc.1st.log.SRR-number.txt),并存入日志文件夹(~/Desktop/GSE126612/log/fastqc.1st)。 - 完成脚本运行后,请查看日志文件以确认运行是否成功。若日志文件中存在任何错误信息,请修正错误后重复步骤 4.3。若遇到无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:在输出文件中,fastqc.html 文件包含易于解读的质量检测结果。若发现严重的质量问题,请与生物信息学同事讨论以评估数据是否适用于下游分析。类似的质控报告也可用于确认接头序列修剪后的数据质量是否改善。若将此脚本用于其他数据集,需根据用户需求修改工作目录和输出目录的路径。与 ChIP-seq 读段相比,解读 CUT&RUN 质控结果时一个显著区别在于:CUT&RUN 中的重复读段不一定代表 PCR 重复。这是因为招募的 MNase 会在实验组内相同或相似的位置进行切割。
5. 原始测序文件的质量和接头修剪
- 打开终端并输入 echo $SHELL,以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户将在终端中看到类似以下内容:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh,或将 Script_04_trimming.sh 脚本拖入终端后回车执行。
注意:该 shell 脚本将执行以下操作:(i) 对 ~/Desktop/GSE126612/fastq 目录下的所有原始 fastq 文件运行 Trim-Galore 程序,进行接头序列去除和质量修剪;(ii) 创建一个文件夹(~/Desktop/GSE126612/trimmed),并将 Trim-Galore 的输出文件保存在该 trimmed 文件夹中;(iii) 创建一个日志文件夹(~/Desktop/GSE126612/log/trim_galore),每次运行 Trim-Galore 时生成一个日志文件 trim_galore_log_RSS-number.txt。 - 运行完成后,请仔细检查日志文件。若日志文件中存在任何错误信息,请修正错误后重复步骤 5.3。若遇到无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
- 此流程完成后,将生成的 .html 输出文件与步骤 4.3 中创建的 fastqc.html 文件进行比较。如需对其他位置的 fastq 文件执行修剪步骤,请修改输入和输出目录的路径。
6. 下载参考基因组的 bowtie2 索引文件,用于实际样本和内参对照样本
- 打开终端,输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到如下内容:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh,或将该 shell 脚本拖入终端后回车执行。
注意:该脚本将执行以下操作:(i) 下载实际样本参考基因组(人类;hg19;原始文献22中使用)和 spike-in 对照参考基因组(酿酒酵母;R64-1-1)的 Bowtie2 索引文件至 bowtie2-index 文件夹(~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index);(iii) 在日志目录(~/Desktop/GSE126612/log/bowtie2-index)中生成日志文件(bowtie2-index-log.txt)。 - 运行完成后,请检查日志文件。若存在任何错误信息,请修正错误后重复步骤 6.3。如遇无法解决的问题,可通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)请求协助。
注意:目前,Bowtie2 官方网站(https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml)已提供多种参考基因组的 Bowtie2 索引文件。用户可编辑 Script_05_bowtie2-index.sh 脚本以下载所需的 Bowtie2 索引文件。若用户无法找到目标参考基因组的 Bowtie2 索引,可从以下来源获取参考基因组序列的 fasta 文件:- Ensembl FTP(https://ftp.ensembl.org/pub/current_fasta/)
- UCSC 网站(https://hgdownload.soe.ucsc.edu/downloads.html)
- 或其他物种特异性数据库。
找到参考基因组序列的 fasta 文件后,请参照 Bowtie2 官方网站中的“The bowtie2-build indexer”部分(https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer)创建所下载参考基因组的 Bowtie2 索引。
7. 将经修剪的 CUT&RUN 测序读段比对至参考基因组
- 打开终端,输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到如下信息:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。如果终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该 shell 脚本将执行以下操作:(1) 运行 bowtie2 程序,将所有经过接头和质量修剪的 fastq 文件分别独立比对至实验参考基因组(人源;hg19)和内参对照基因组(芽殖酵母;R64-1-1);(ii) 调用 samtools view 功能,将比对后的读段文件压缩为 bam 格式;(iii) 创建一个文件夹(~/Desktop/GSE126612/bowtie2-mapped),并将压缩后的比对读段文件保存在 bowtie2-mapped 文件夹中;(iv) 创建一个文件夹(~/Desktop/GSE126612/log/bowtie2-mapped),并将比对过程的日志记录为文本文件,分别命名为 bowtie2_log_hg19_SRR-number.txt(对应比对至 hg19 参考基因组的读段)和 bowtie2_log_R64-1-1_SRR-number.txt(对应比对至 R64-1-1 参考基因组的读段),以反映比对效率,并保存在 bowtie2-mapping 日志文件夹中。 - 运行完成后,请检查日志文件。如果日志文件中存在任何错误信息,请修正错误后重新运行该 shell 脚本。若遇到无法解决的问题,可通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)请求协助。
注意:该 shell 脚本使用 bowtie2 的特定参数运行,用于比对双端测序数据,筛选片段长度在 10 bp 至 700 bp 范围内的共线性比对读段。可通过在终端输入 bowtie2 --help 或访问 bowtie2 官方网站(https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner)查看各选项说明,根据需要理解并修改参数设置。通过更改脚本中 fastq 文件的路径、文件名格式以及 Bowtie2 索引路径,可使用该脚本比对其他 fastq 文件。
8. 对比对后的读段序列文件进行排序和过滤
- 打开终端并输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到如下内容:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入“chsh -s $(which bash)”将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本将执行以下操作:(i) 对 ~/Desktop/GSE126612/bowtie2-mapped 文件夹中所有压缩的比对读段成对文件运行 samtools view 功能,以过滤掉比对到非经典染色体区域、公共注释的黑名单区域以及 TA 重复区域的读段对;(ii) 执行 samtools sort 功能,在同一目录下按片段名称或坐标对过滤后的 bam 文件进行排序;(iii) 在 ~/Desktop/GSE126612/log/filter-sort-bam 目录中为每个输入的 bam 文件生成一个日志文件。 - 运行完成后,请仔细检查日志文件。若日志文件中存在任何错误信息,请修正错误后重新运行该 shell 脚本。如遇无法解决的问题,可通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)请求协助。
注意:按片段名称排序后的 bam 文件(输出结果)将作为输入文件用于生成片段 BED 文件和原始读段计数 bedGraph 文件;按坐标排序的 bam 文件将作为输入文件用于生成片段 BEDPE 文件。所有 BED、bedGraph 和 BEDPE 文件将在后续分析中用于峰识别(peak calling)和可视化。用于经典染色体区域(chr1~22、chrX、chrY 和 chrM)、公共注释的黑名单区域23 以及 TA 重复区域18 的所有注释 bed 文件均位于 ~/Desktop/Easy-Shells_CUTnRUN/blacklist 目录中。如有需要,可使用此目录添加额外的黑名单文件。通过修改 bam 文件的路径和文件名,可使用该 shell 脚本对其他比对读段成对 bam 文件执行相同功能。在终端中输入 samtools view --help 和 samtools sort --help 可获取有关这些功能的更多说明。
9. 将比对上的读段对转换为片段 BEDPE、BED 和原始读段计数 bedGraph 文件
- 打开终端并输入 echo $SHELL,以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到如下内容:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本将执行以下操作:(i) 运行 macs3 filterdup 和 awk 函数,将按坐标排序的 bam 文件转换为片段长度小于 1 kb 的 fragment BEDPE 文件,并将 BEDPE 文件保存至 ~/Desktop/GSE126612/BEDPE 目录;(ii) 创建一个日志目录(~/Desktop/GSE126612/log/bam-to-BEDPE),并为每个比对读段片段文件生成一个日志文件;(iii) 运行 bedtools bamtobed 以及 awk, cut, sort 函数,将按片段名称排序的 bam 文件转换为片段长度小于 1 kb 的 fragment BED 文件;(iv) 创建一个文件夹(~/Desktop/GSE126612/bam-to-bed),并将 fragment BED 文件保存在该文件夹内;(v) 将每个比对读段片段 BED 文件的日志文件写入日志目录(~/Desktop/GSE126612/log/bam-to-bed);(vi) 执行 bedtools genomecov 函数,利用 fragment BED 文件生成原始读段计数的 bedGraph 文件,并保存至一个文件夹(~/Desktop/GSE126612/bedGraph)中。 - 运行完成后,请仔细检查日志文件。如遇任何问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:输出的原始读段计数 bedGraph 文件将作为第 12 节中 SEACR 峰识别程序(使用归一化选项)以及第 10 节中缩放分数读段计数(SFRC)归一化22的输入文件。fragment BED 文件将作为第 10 节中 spike-in 归一化的每百万比对读段数(SRPMC)归一化24,25的输入文件。为仅捕获染色质相关因子 CUT&RUN 数据中的短片段(>100 bp),可修改该脚本中的片段过滤步骤后再进行归一化处理。若需在同一份样本中比较短片段与常规大小片段的 CUT&RUN 信号,SFRC 归一化有助于减少仅捕获短片段可能引起的下采样效应。可通过修改 bam 和 bed 文件的路径及命名格式,使用该 shell 脚本对其他成对末端测序的排序 bam 文件执行相同流程。
10. 将原始读段计数 bedGraph 文件转换为标准化的 bedGraph 和 bigWig 文件
- 打开终端并输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到如下内容:/path/to/bash(或类似信息,例如 /bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh,或将 shell 脚本文件拖入终端后回车执行。
注意:该脚本的功能包括:(i) 使用 awk 函数运行 for 循环,基于 ~/Desktop/GSE126612/bedGraph 目录中的原始读段计数 bedGraph 文件,生成 SFRC 标准化的 bedGraph 文件;(ii) 执行 bedGraphToBigWig 函数,将 SFRC 标准化的 bedGraph 文件转换为压缩格式(.bw),并保存至 ~/Desktop/GSE126612/bigWig 目录;(iii) 生成一个日志文件,记录每次运行中用于 SFRC 计算的标准化因子,并将日志文件保存在 ~/Desktop/GSE126612/log/SFRC 目录中。 - 运行完成后,检查日志文件。若存在任何错误信息,请修正错误后重新运行该 shell 脚本。如遇无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:在 GSE126612 CUT&RUN 数据集的原始发表文献22中采用了比例分数读段计数(scaled fractional readcount)标准化方法。该方法在 第 i 个 bin 的标准化公式如下:
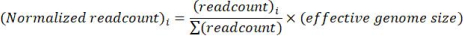
由于该标准化方法未包含针对阴性对照(例如 IgG 样本)或 spike-in 对照的校正,因此可能不适合用于观察样本间的全基因组信号差异。然而,由于该方法在理论上与其它基于总读段数的标准化方法(例如每百万映射读段计数,Count Per Million)相似,因此足以用于观察样本间的局部信号差异。 - 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh,或将 shell 脚本文件拖入终端后回车执行。
注意:该脚本将执行以下操作:(i) 使用 bedtools genomecov 函数运行 for 循环,基于 ~/Desktop/GSE126612/bam-to-bed 目录中的片段 BED 文件,在 ~/Desktop/GSE126612/bedGraph 目录中生成 SRPMC 标准化的 bedGraph 文件;(ii) 生成日志文件,记录每次运行中用于 SRPMC 标准化的标准化因子,并保存至 ~/Desktop/GSE126612/log/SRPMC 目录;(iii) 执行 bedGraphToBigWig 函数,将标准化后的 bedGraph 文件转换为压缩格式(.bw),并将生成的标准化 bigWig 文件保存至 ~/Desktop/GSE126612/bigWig 目录。 - 运行完成后,请仔细审阅日志文件。若日志文件中存在任何错误信息,请修正错误后重新运行该 shell 脚本。如遇无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:SRPMC 标准化方法的公式旨在通过结合 RPM(每百万映射读段数)标准化因子、RPS(每 spike-in 读段的读段比率)以及相对于对照的信号比率24,25,对实际样本的读段数进行标准化,同时纳入阴性对照(例如 IgG 样本)和 spike-in 对照。RPS 的定义如下:

通过将 RPS 分别应用于实际样本和阴性对照样本,可计算实际样本相对于对照的相对信号比率(RS),公式如下:
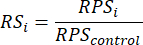
RPM 标准化因子(RPM:NF)的定义如下:
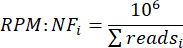
由此,SRPMC 标准化因子(SRPMC:NF)通过将 RS 与 RPM:NF 结合得出:
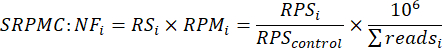
该公式可简化为:

因此,SRPMC 方法通过 (1) 对照与样本之间 spike-in 读段的比率,以及 (2) RPM 标准化的对照读段数对读段进行标准化。由于该标准化因子考虑了 spike-in 读段,并使不同样本间的对照读段具有可比性,因此该方法适用于观察样本间的全基因组差异,并减少不同批次实验中实际样本与对照总读段数的批次效应。这些标准化后的 bedGraph 文件将作为第 11 节中使用 SEACR 召集峰(call peaks)的输入文件。而这些标准化后的 bigWig 文件将用于通过 IGV 进行基因组位点可视化,以及通过 Deeptools 生成热图和平均信号图。强烈建议使用基因组浏览器,在代表性基因组区域利用标准化后的 bigWig 文件可视化 CUT&RUN 数据集的信号分布模式,以评估数据质量。若 CUT&RUN 样本的背景噪声信号模式与 IgG 对照相似,则建议在后续分析中排除这些样本。可通过修改输入和输出 bed 及 bedGraph 文件的路径与文件名,使用这些 shell 脚本对其他读段 bed 文件和原始读段计数 bedGraph 文件进行标准化。也可通过修改脚本中的因子和公式,将这些脚本应用于其他标准化计算。
11. 验证片段大小分布
- 打开终端并输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户可能会在终端中看到类似以下内容:/path/to/bash(或类似 /bin/bash 的消息)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。如果终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本的功能包括:(i) 使用位于 ~/Desktop/GSE126612/filtered-bam 文件夹中的比对后双端测序 BAM 文件,运行 picard.jar CollectInsertSizeMetrics 功能,以确定插入片段大小分布;(ii) 创建一个新文件夹(~/Desktop/GSE126612/insert-size-distribution),并将插入片段大小分布分析结果保存至该文件夹中;(iii) 为每个输入的 BAM 文件在 ~/Desktop/GSE126612/log/insert-size-distribution 文件夹中生成一个日志文件。 - 运行完成后,请仔细检查日志文件。如果日志文件中存在任何错误信息,请修正错误后重新运行该 shell 脚本。若遇到无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:通常情况下,CUT&RUN 样本的插入片段大小分析结果(输出)会在单核小体(100–300 bp)和双核小体(300–500 bp)大小范围内出现主要峰。技术性误差或局限性(例如在 CUT&RUN 样本制备过程中 MNase 消化过度或不足,或文库构建过程中的片段大小选择不当)可能导致三核小体及以上(500–700 bp)或亚核小体(<100 bp)片段富集。有时,单核小体大小峰的缺失,同时伴随长片段(>500 bp)和短片段(<100 bp)的富集,可能是由于湿实验阶段选择的文库片段大小范围或测序深度不足所致。建议结合测序深度(“总测序碱基数” / “参考基因组总大小”)、第 10 节中归一化读段计数生成的 bigWig 文件对基因组景观的总体评估,以及插入片段大小分布模式,综合判断处理后的 CUT&RUN 样本质量。直方图中的虚线表示插入片段大小大于或等于横轴所示值的读段所占的“累积比例”。该虚线有助于识别输入比对文件中读段插入片段大小的分布情况。横轴从左至右表示插入片段大小逐渐增加。虚线显示了输入 BAM 文件中插入片段大小至少达到横轴对应位置所示数值的比对读段对所占的比例。因此,解释时从左侧的 1 开始,表示所有读段的插入片段大小均大于或等于最小尺寸,随着插入片段大小的增加,比例逐渐下降至 0。
12. 使用 MACS2、MACS3 和 SEACR 进行峰呼叫
- 打开终端并输入 echo $SHELL 检查当前终端中的默认 shell。如果当前终端的默认 shell 是 Bash shell,用户可能会看到以下内容: /path/to/bash (或类似提示信息,例如 /bin/bash在终端中。
- 如果默认 shell 不是 Bash,请通过输入以下命令将 Bash shell 设为默认 shell chsh -s $(which bash) 在终端中。如果终端默认使用 Bash shell,则跳过此步骤。
- 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh 在终端中输入,或将 shell 脚本文件拖入终端后回车。
注意:本实验方案旨在:(i)运行 macs2 callpeak 和 macs3 callpeak 使用和不使用IgG对照的fragment BEDPE文件进行峰呼叫,并将峰呼叫结果保存到输出目录中(~/Desktop/GSE126612/MACS2 和 ~/Desktop/GSE126612/MACS3)。(ii) 将这些峰值信号的记录写入日志目录中的文本文件~/Desktop/GSE126612/log/MACS2 和 ~/Desktop/GSE126612/log/MACS3) - 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh 在终端中输入,或直接将 shell 脚本文件拖入终端并回车。
注意:本实验方案旨在:(i)运行 SEACR_1.3.sh 使用IgG对照和无IgG对照的脚本,结合严格和宽松参数,利用原始读段计数bedGraph文件和标准化bedGraph文件进行峰呼叫。(ii)创建输出目录~/Desktop/GSE126612/SEACR-峰)并使用 SEACR 保存峰识别结果。(iii)将这些峰识别的日志记录为文本文件,保存至日志目录(~/Desktop/GSE126612/log/SEACR). - 运行完 shell 脚本后,仔细检查日志文件。如果日志文件中存在任何错误信息,应首先纠正错误。某些程序可能无法同时使用 IgG 对照选项对 IgG 对照样本进行峰识别,因此可忽略有关 IgG 对照样本与 IgG 对照选项的错误信息。若遇到无法解决的问题,请通过 Easy Shells CUTnRUN GitHub 问题页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:这两个 shell 脚本用于执行 CUT 的峰识别&使用三种峰值识别工具(MACS2、MACS3 和 SEACR),结合多种参数设置进行样本分析:包含或不包含 IgG 对照选项,使用原始读段计数 bedGraph 文件并启用峰值识别工具的归一化选项,或使用已归一化的读段计数 bedGraph 文件并关闭峰值识别工具的归一化选项,以及采用严格和宽松的 SEACR 峰值识别参数。由于峰值识别工具输出的文件无法直接用于下游分析,Easy Shells CUTnRUN 提供了一个脚本,用于处理这些已识别的峰值输出文件,生成包含染色体、起始位置、终止位置和峰值名称的新峰值文件。通过系统性的多种峰值识别策略,Easy Shells CUTnRUN 为用户提供了选择最适合自己 CUTnRUN 实验数据的峰值识别程序的机会。&通过比较三种峰检测工具所识别的峰来运行 RUN 项目。此外,该 CUT&RUN分析流程还为用户提供了选择最适合其CUT的峰检测选项的机会&RUN 项目。这些比较将通过维恩图进行,并以热图和平均值图的形式进行可视化。
13. 创建已识别峰的 bed 文件
- 打开终端并输入 echo $SHELL 检查活动终端中的默认 shell。如果当前终端的默认 shell 为 Bash shell,用户可能会看到以下内容: /path/to/bash (或类似提示信息,例如 /bin/bash在终端中。
- 如果默认 shell 不是 Bash,请通过输入以下命令将 Bash shell 设为默认 shell chsh -s $(which bash) 在终端中。如果终端默认使用 Bash shell,则跳过此步骤。
- 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh 在终端中输入,或将 shell 脚本文件拖入终端后回车。
注意:本实验方案旨在:(i)运行 awk 使用 bed 文件进行功能分析 ~/Desktop/GSE126612/SEACR 文件夹以创建两种类型的 SEACR 峰 bed 文件 ~/Desktop/GSE126612/peak-bed_SEACR 文件夹中,完整的峰床文件包含每个峰的起始和终止位置,而聚焦的峰床文件则包含每个峰内信号最强的bin的起始和终止位置。(ii)运行 awk 使用功能 ***_peaks.xls 文件在 ~/Desktop/GSE126612/MACS2 和 ~/Desktop/GSE126612/MACS3 文件夹,用于创建完整的峰床文件,其中包含由 MACS2 和 MACS3 调用的每个峰的起始和终止位置 ~/Desktop/GSE126612/peak-bed_MACS2 和 ~/Desktop/GSE126612/peak-bed_MACS3 文件夹。(iii)运行 awk 功能使用 ***_summits.bed 文件在 ~/Desktop/GSE126612/MACS2 和 ~/Desktop/GSE126612/MACS3 创建包含每个峰内最显著区段的起始和终止位置的聚焦峰床文件夹。(iv)日志文件以文本文件格式写入 ~/Desktop/GSE126612/log/peak-bed 文件夹 - 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh 在终端中输入,或直接将 shell 脚本文件拖入终端并回车。
注意:本实验方案旨在:(i)运行 bedtools intersect 使用不带IgG对照选项的峰床文件进行功能分析,以去除与IgG对照峰重叠的峰。(ii) 过滤后的峰床文件保存在 ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3,以及 ~/Desktop/GSE126612/peak-bed-filtered_SEACR 文件夹。(iii)日志文件 log_filter-peak.txt 在……中创建 ~/Desktop/GSE126612/log/filter-peaks 文件夹 - 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh 在终端中输入,或直接将 shell 脚本文件拖入终端并回车。
注意:本实验方案旨在:(i)运行 猫 和 分选 将各重复样本的 MACS2 和 MACS3 全基因组峰 bed 文件合并为一个峰 bed 文件,并对合并后的峰 bed 文件进行排序 ~/Desktop/GSE126612/用于比较的bed文件 文件夹。(ii) 运行 bedtools merge 使用合并的全峰bed文件来整合相互重叠的峰。(iii) 一个日志文件 log_cat-合并峰-bed_MACS.txt 记录在日志文件夹中 ~/Desktop/GSE126612/log/cat-merged-peak-bed. - 类型 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh 在终端中输入,或将 shell 脚本文件拖入终端后回车。
注意:本实验方案旨在:(i)运行 猫 和 排序 将各重复样本的 SEACR 全基因组峰 bed 文件合并为一个峰 bed 文件,并对合并后的峰 bed 文件进行排序 ~/Desktop/GSE126612/bed用于比较 文件夹。(ii) 运行 bedtools merge 使用合并的全峰bed文件来整合相互重叠的峰。(iii) 一个日志文件 log_cat-合并峰-bed_SEACR.txt 记录在日志文件夹中 ~/Desktop/GSE126612/log/cat-merged-peak-bed. - 运行结束后,仔细检查 shell 脚本生成的日志文件。若日志文件中存在任何错误信息,需修正错误后重新运行脚本。若遇到无法解决的问题,请通过 Easy Shells CUTnRUN 的 GitHub 问题页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:整个峰区的峰bed文件将用作维恩图分析的输入文件,以比较不同峰检测选项、峰检测方法、重复样本以及峰区附近基因组特征观察结果之间的相似性。合并后的全峰区bed文件将用于利用deeptools进行主成分(PC)分析和皮尔逊相关系数分析。聚焦的峰bed文件将用于利用Deeptools进行热图和平均信号图分析。
14. 使用皮尔逊相关性和主成分(PC)分析验证重复样本之间的相似性。
- 打开终端并输入 echo $SHELL,以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,用户将在终端中看到类似 /path/to/bash 或 /bin/bash 的提示信息。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。若终端已使用 Bash shell 作为默认 shell,则跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本的功能包括:(i) 使用已按坐标排序的重复样本 bam 文件,以及合并后的 CTCF、H3K27Ac 和 RNAPII-S5P 全基因组峰区域 bed 文件,调用 multiBamSummary BED-file 功能,在 Desktop/GSE126612/deeptools_multiBamSummary 文件夹中生成用于 Pearson 相关性分析的矩阵文件;(ii) 使用生成的矩阵文件调用 plotCorrelation 功能,计算 Pearson 相关系数并进行热图聚类,结果保存至 ~/Desktop/GSE126612/deeptools_plotCorrelation 文件夹;(iii) 在 ~/Desktop/GSE126612/log/correlation 目录下生成日志文件 log_plotCorrelation.txt。 - 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本的功能包括:(i) 使用已按坐标排序的 bam 文件,以及包含所有 CTCF、H3K27ac 和 RNAPII-S5P 峰区域的合并峰 bed 文件,调用 multiBamSummary BED-file 功能,在 Desktop/GSE126612/deeptools_multiBamSummary 文件夹中生成用于主成分分析(PCA)的矩阵文件;(ii) 使用矩阵文件调用 plotPCA 功能执行 PCA 分析,并将结果保存至 ~/Desktop/GSE126612/deeptools_plotPCA 文件夹;(iii) 在 ~/Desktop/GSE126612/log/correlation 目录下生成日志文件 log_plotPCA.txt。 - 完成 shell 脚本运行后,请检查日志文件。若存在错误信息,需修正错误后重新运行脚本。如遇无法解决的问题,可通过 Easy Shells CUTnRUN 的 GitHub issues 页面(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)寻求帮助。
注意:原则上,正确制备和处理的重复样本应在同一聚类组内表现出较高的 Pearson 相关系数,并在主成分分析图中位置相近。若某个重复样本的 Pearson 相关系数较低,且在主成分图中与其他重复样本距离较远,则可能为潜在的离群样本。该 shell 脚本适用于任何以 bam 格式比对的测序数据。用户可根据具体项目需求修改路径及文件名。
15. 使用维恩图验证重复样本、峰识别方法及参数选项之间的相似性
- 打开终端并输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,则终端中可能会显示类似 /path/to/bash 的内容(例如,/bin/bash)。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。如果终端已使用 Bash shell 作为默认 shell,可跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本用于:(i) 使用完整的峰区域 peak bed 文件运行 intervene venn 功能,以分析不同峰识别选项(是否使用 IgG 对照、是否进行标准化处理,以及 SEACR 的严格/宽松峰识别参数)所识别出的峰之间的重叠情况;(ii) 创建一个文件夹(~/Desktop/GSE126612/intervene_methods),并将 Venn 图分析结果保存在该文件夹中;(iii) 在 ~/Desktop/GSE126612/log/intervene 文件夹中生成一个日志文件 log_intervene_methods.txt。 - 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh,或将该 shell 脚本文件拖入终端后回车执行。
注意:该脚本用于:(i) 使用完整的峰区域 peak bed 文件运行 intervene venn 功能,以分析不同重复样本之间峰的重叠情况;(ii) 创建一个文件夹(~/Desktop/GSE126612/intervene_replicates),并将 Venn 图分析结果保存在该文件夹中;(iii) 在 ~/Desktop/GSE126612/log/intervene 文件夹中生成一个日志文件 log_intervene_replicates.txt。 - 运行完 shell 脚本后,请检查日志文件。若存在任何错误信息,请修正错误后重新运行脚本。若在使用 Easy Shells CUTnRUN 分析流程时遇到问题,可访问 Easy Shells CUTnRUN 的 GitHub issues 页面寻求帮助(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)。
注意:这些 Venn 图分析结果有助于为后续分析选择最合适的峰识别参数、方法及具有高重复性的生物学重复样本。建议优先选择那些识别出峰数量较多,且与其他峰识别方法和参数具有良好重叠性的峰识别方案。
16. 分析热图和平均图以可视化已识别的峰。
- 打开终端并输入 echo $SHELL 以检查当前终端中的默认 shell。如果 Bash shell 是当前终端的默认 shell,则终端中可能会显示类似 /path/to/bash(例如,/bin/bash)的内容。
- 如果默认 shell 不是 Bash,请在终端中输入 chsh -s $(which bash) 将 Bash shell 设置为默认 shell。如果终端已使用 Bash shell 作为默认 shell,可跳过此步骤。
- 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh,或将该 shell 脚本文件拖入终端后回车。
注意:该脚本用于执行以下操作:(i) 使用标准化的 bigWig 文件和聚焦峰 bed 文件,在 ~/Desktop/GSE126612/deeptools_computeMatrix 文件夹中运行 computeMatrix reference-point 功能,生成聚焦峰中心处的标准化读段计数矩阵;(ii) 使用标准化读段计数矩阵运行 plotHeatmap 功能,生成热图和平均图,以可视化聚焦峰位置处的标准化读段计数分布模式;(iii) 创建一个文件夹(~/Desktop/GSE126612/deeptools_plotHeatmap),并将 plotHeatmap 的输出文件保存在该文件夹中;(iv) 在 ~/Desktop/GSE126612/log/plotHeatmap 文件夹中生成一个日志文件 log_plotHeatmap_focused.txt。 - 在终端中输入 ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh,或将该 shell 脚本文件拖入终端后回车。
该脚本用于执行以下操作:(i) 使用标准化的 bigWig 文件和全峰 bed 文件,在 ~/Desktop/GSE126612/deeptools_computeMatrix 文件夹中运行 computeMatrix reference-point 功能,生成全峰中心处的标准化读段计数矩阵;(ii) 使用标准化读段计数矩阵运行 plotHeatmap 功能,生成热图和平均图,以可视化全峰位置处的标准化读段计数分布模式;(iii) 创建一个文件夹(~/Desktop/GSE126612/deeptools_plotHeatmap),并将 plotHeatmap 的输出文件保存在该文件夹中;(iv) 在 ~/Desktop/GSE126612/log/plotHeatmap 文件夹中生成一个日志文件 log_plotHeatmap_whole.txt。 - 运行完 shell 脚本后,请检查日志文件。如果出现任何错误信息,请修正错误后重新运行脚本。如果在使用 Easy Shells CUTnRUN 分析流程时遇到问题,可访问 Easy Shells CUTnRUN 的 GitHub issues 页面寻求帮助(https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues)。
注意:理想情况下,MACS2/3 峰的峰顶位置和 SEACR 聚焦峰的位置应在图谱中心呈现出尖锐且集中的信号分布。然而,如果峰识别算法对 CUT&RUN 数据处理不当,则图谱中可能出现较弥散的“噪声”信号分布。因此,结合所识别峰的数量以及输出图谱中的峰信号分布模式,有助于判断峰的有效性,从而指导后续包括下游峰注释在内的 CUT&RUN 分析。
结果
质量过滤与接头修剪可保留高测序质量的读段
高通量测序技术容易产生测序错误,例如读段中的序列“突变”。此外,由于文库构建过程中接头去除不充分,测序数据中可能富集接头二聚体。过多的测序错误,如读段突变、产生短于有效比对所需长度的读段,以及接头二聚体的富集,会增加读段比对时间,并可能导致假阳性比对结果,从而干扰下游生物信息学分析。因此,必须进行质量过滤和接头修剪,以保留高质量读段用于后续分析与解读。
为了在分析中保留高质量的测序读段,本 CUT&RUN 分析流程(图2)采用了 FastQC26 和 Trim Galore27。shell 脚本“Script_03_fastQC.sh”会对工作目录中的所有 fastq 文件运行 FastQC。使用来自 GSE126612(SRR8581589)的公开 CTCF CUT&RUN 数据集进行该步骤的结果(图3)显示,部分读段存在碱基质量评分较低的情况(图3A、C),以及序列的 GC 含量分布与理论估计值之间存在一定程度的偏差(图3E)。
成功执行“Script_04_trimming.sh”脚本可有效去除低质量碱基(修剪前质量值低于20,见图3A)以及修剪前明显存在的低平均序列质量的测序读段(图3B-D)。此外,“Script_04_trimming.sh”还能成功消除“修剪前”GC分布图中显示的约55~60%平均GC含量富集现象(图3E,F)。这些结果表明,该CUT&RUN分析流程能够筛选出高质量的测序读段,从而促进测序读段快速、准确地比对至参考基因组。
插入片段大小分布可用于评估峰识别结果
由于CUT&RUN中使用了MNase(图1),比对后的CUT&RUN读段在插入片段大小分布图中预期会呈现出单核小体(~200 bp)和双核小体(~350 bp)DNA片段大小的峰值(图4)。某些靶标的检测问题可能导致出现较短的插入片段(< 100 bp)(图4C)。大量短读段会减少可用于高置信度峰识别的读段数量,从而降低峰的数量并影响下游分析。在此CUT&RUN分析流程中,“Script_10_insert-size-analysis.sh”调用“picard.jar CollectInsertSizeMetrics”功能进行插入片段大小分布分析,并输出直方图为可视化结果(图2)。在输出图(图4A-C)中,横轴表示插入片段大小范围,纵轴左侧及填充的直方图表示具有对应横轴数值的插入片段数量,纵轴右侧则用虚线表示插入片段大小等于或大于横轴数值的累积比例。因此,虚线斜率变化最显著处与直方图峰值相交的横轴位置,即可确定为样本中的主要插入片段大小。在比对到目标参考基因组(人,hg19)的读段中,H3K27Ac(活性组蛋白标记)样本片段表现出典型的CUT&RUN插入片段大小分布,具有明显的单核小体大小峰值以及可检测到的双核小体大小峰值(图4B)。CTCF样本片段在100~200 bp片段长度区域显示出额外的峰群(图4A)。总体而言,该CUT&RUN分析流程提供了易于使用的shell脚本,可在将读段比对至参考基因组后执行插入片段大小分布分析。这些分析在评估下游分析前峰识别效率时具有重要意义。
Easy Shells CUTnRUN 分析流程提供了过滤和标准化选项,以生成可靠的读段计数
CUT&RUN 分析的一个关键环节是通过从初始比对结果中过滤掉存在问题的读段对,并采用特定的标准化计算方法对过滤后的比对读段计数进行标准化,从而获得准确的比对读段对,满足用户分析的目标和需求。本研究中讨论的 CUT&RUN 分析流程包含“Script_07_filter-sort-bam.sh”脚本,用于去除那些通过“Script_06_bowtie2-mapping.sh”使用 bowtie2 比对后,映射到非经典染色体、公共注释的黑名单区域23以及 TA 重复区域18,22的读段对。这些过滤步骤对于去除可能在下游分析中产生假阳性、异常尖峰信号以及错误峰调用的读段对至关重要(图5;黄色框区域)。
除了过滤步骤外,采用正确的标准化方法也是准确可视化样本间信号差异的重要因素。因此,CUT&RUN 分析流程包括 "Script_09_normalization_SFRC.sh" 和 "Script_09_normalization_SRPMC.sh" 提供两种公开验证的标准化方法——缩放分数读数计数(SFRC)的脚本22 以及阴性对照中经加标归一化的每百万比对读段数(SRPMC)24,25 (图 5A-D)。由于SFRC在公式中未包含对照(例如IgG)或内参样品,因此SFRC标准化适用于不包含任何对照样品,或仅在局部区域存在信号差异而无全基因组范围差异的样品。经CUT处理的SFRC标准化样品&RUN 分析流程图 5A-D;红色轨迹)产生的信号分布模式与来自 GEO 的公开可用的比对读段相同图 5A-D;黑色轨迹),表明该流程能够重现已发表的结果。
SRPMC 方法适用于标准化包含对照样本和加标样本、且预期样本间存在全局信号差异的情况(图 5A-D;绿色轨迹)。由于一个 H3K27Ac 样本(SRR8581599)的“(实际 CUT&RUN 读段数)/(加标读段数)”比值(样本 RPS;997)远高于其他重复样本(237、175 和 161),在 SFRC 和 SRPMC 标准化的样本中,H3K27Ac 信号在重复样本间的相对强度表现不同(图 5A-D;所有轨迹间比较 H3K27Ac)。RNAPII-S5P 样本的样本 RPS(1.7、0.8、2.1)相对低于 IgG 对照(259),因此在经过 SRPMC 标准化后,RNAPII-S5P 样本的信号低于 IgG 对照(图 5A-D;所有轨迹间比较 RNAPII-S5P)。因此,本文讨论的 CUT&RUN 分析流程建议仅在实验样本的读段数相对于 IgG 对照和加标对照读段数均足够时,才使用 SRPMC 方法。
维恩图比较可为选择更优的峰识别方法和参数提供参考
多种峰识别程序可用于鉴定基因组上蛋白质占据显著富集的区域。目前用于CUT&RUN分析的主要程序包括MACS系列程序2和SEACR4。然而,对于生物信息学初学者而言,为特定的CUT&RUN项目确定最合适的峰识别方法和参数可能具有挑战性。因此,CUT&RUN分析流程中包含了维恩图分析步骤,使用户能够比较不同峰识别参数(Script_17_intervene-options)以及不同峰识别程序(Script_19_intervene_methods.sh)所得结果之间的相似性与差异(图6A-H)。
通过比较在峰识别步骤中使用和不使用IgG对照选项所鉴定出的合并CTCF、H3K27ac和RNAPII-S5P峰,发现MACS2和MACS3在使用IgG对照选项时识别出更多的峰(图6A),而SEACR在严格和宽松两种条件下,不使用IgG对照选项时识别出更多的峰(图6B-D)。因此,CUT&RUN分析流程建议:(1)对MACS2和MACS3使用IgG对照选项;(2)分别对实验组CUT&RUN样本和IgG对照样本进行峰识别,随后使用SEACR峰识别工具时再将IgG峰过滤去除。在MACS2与MACS3之间,MACS3识别出的峰略多(图6A)。
此外,比较使用IgG对照选项的MACS2和MACS3与未使用IgG对照选项的SEACR所识别的峰发现,采用严格参数设置的SEACR识别峰与MACS2和MACS3的峰重叠程度高于采用宽松参数设置的SEACR识别峰(图6E,F)。因此,CUT&RUN 分析流程的输出结果表明,严格选项可使 SEACR 与 MACS 峰值识别结果的一致性达到最大化。最后,通过维恩图比较 SEACR 在对原始读段数进行标准化后所识别峰与 CUT&RUN bedGraph 文件,且不进行标准化处理的标准化读段计数 CUT&RUN bedGraph 文件显示,在使用严格选项时,SEACR 的 SFRC 与 SRPMC 方法之间无差异。SFRC 峰在归一化选项下表现出更高的峰数量,并与归一化选项峰(“norm”)具有更好的重叠性 图6) 而使用宽松参数时,SEACR 的 SRPMC 峰值图6G,H).
重复样本与样品间的统计学比较
在多个重复样本之间得出准确结论,需要对重复样本的相似性进行评估。本研究所采用的 CUT&RUN 分析流程利用 Deeptools215 进行基于统计学的相关系数计算、热图聚类以及主成分分析(PCA),以帮助识别适用于有效下游分析的样品和重复样本。基于皮尔逊相关系数的热图聚类显示,在 CTCF、H3K27Ac 和 RNAPII-S5P 的峰区域中,各重复样本之间具有统计学意义的相关性(图 7A–C)。然而,主成分分析表明,在所有 CTCF、H3K27Ac 和 RNAPII-S5P 的峰区域中,CTCF 的一个样本(SRR8581590)和 H3K27Ac 的一个样本(SRR8581608)与其他重复样本相比位置相对较远(图 7D)。
根据Venn图对重复样本间的峰进行比较,CTCF(SRR8581590)峰在三种峰识别工具的结果中与其他重复样本的重叠度最低(图7E-G);H3K27Ac(SRR8581608)峰在SEACR峰识别结果中与其他重复样本的重叠度最低(图7F)。然而,在MACS2和MACS3的峰识别结果中,H3K27Ac(SRR8581608)峰并未表现出与其他重复样本最低的重叠度(图7F),这可能表明PCA图中样本间的距离不足以定义异常值样本。因此,CUT&RUN分析流程建议将异常值重复样本定义为“在热图聚类中显示较低皮尔逊相关系数、在PCA图中与其他重复样本距离较远、且在重复样本间峰重叠度最低的样本”。
峰识别有助于CUT&RUN数据的可视化与解读
本研究中详述的CUT&RUN分析流程采用了两类公开可用的峰识别工具:MACS系列和SEACR。为了优化识别出的峰的可视化效果,该流程在热图和平均图分析中选择信号最强的区域作为峰中心。所有由MACS3和SEACR峰识别工具识别出的CTCF、H3K27Ac和RNAPII-S5P峰,在信号最高区域中心处呈现出比整个峰区域中心更尖锐的峰分布模式(图8A-F,“focused”图)(图8A-F,“whole”图)。经Easy Shells CUTnRUN分析流程并采用SFRC标准化处理的CUT&RUN样本(图8 A-F,“SFRC”图),在分析流程识别出的峰位置上,其信号分布模式与在GEO数据库中公开的原始比对读段数据经SFRC标准化后的样本高度相似(图8A-F,“public”图)。因此,该CUT&RUN分析流程能够成功复现已发表的研究结果。

图1CUT 示意图&RUN 实验步骤。 CUT&RUN 是一种基于酶学的方法,用于检测全基因组范围内的蛋白质-DNA 相互作用。CUT&RUN 实验流程首先将细胞(或分离的细胞核)与连接了磁珠的刀豆蛋白 A(Concanavalin A)结合,从而在整项操作中实现对少量细胞的有效分离与操控。分离后的细胞通过温和去垢剂进行通透化处理,以促进靶向目标蛋白的抗体进入。随后将连接有微球菌核酸酶(Micrococcal nuclease, MNase)的 Protein A 或 Protein A/G 标签引入通透化细胞中。利用 Protein A 或 Protein A/G 标签,pA-MNase(或 pAG-MNase)被招募至已结合的抗体位置。当 MNase 定位于目标位点后,通过加入钙离子短暂激活核酸酶活性,从而消化目标蛋白周围的 DNA。MNase 消化产生单核小体 DNA-蛋白复合物。随后通过螯合钙离子终止消化反应,并经短暂孵育从细胞核中释放 MNase 消化所得的短片段 DNA 37°C,然后进行DNA纯化、文库构建和高通量测序1. 请点击此处以查看此图的放大版本。

图 2:Easy-Shell CUT&RUN 分析流程示意图。 Easy-Shell CUT&RUN 分析流程分为三个主要部分——(1) 原始读段文件的质量控制与比对(左侧;紫色),(2) 比对后读段的标准化与读段计数及峰识别(中间;绿色),以及 (3) 比对读段与识别峰的验证(右侧;粉色)。每一步均提供了对应的 shell 脚本编号、简要说明以及该步骤所使用的程序工具(括号内)。实线箭头表示步骤间的直接流程。该 CUT&RUN 分析流程提供了两种读段标准化方法,可满足有或无对照读段用户的需要,包含多层级验证流程以识别适合下游分析的正确重复样本,并实现聚焦的峰识别,从而生成高度集中的热图和平均图输出。该分析流程以易于使用的 shell 脚本形式逐步编写,使生物信息学初学者能够通过阅读和编辑脚本本身来学习和实践基本的 CUT&RUN 数据分析。请点击此处查看该图的放大版本。

图3: 质量控制检查在质量修剪前与修剪后的结果比较。从 FastQC 选择的质量控制报告输出结果展示了使用 SRR8581589(GSM3609748,CTCF)测序读段进行质量修剪的效果。显示的输出结果包括:(A)修剪前各碱基位置的质量得分分布。(B)与 A 相同的读段在修剪后的结果。(C)修剪前所有序列的整体质量得分分布。(D)与 C 相同的读段在修剪后的结果。(E) 修剪前所有序列的 GC 含量分布。(F)与 E 相同的读段在修剪后的结果。在质量修剪后,测序读段中每个位置的最低质量得分(A、B)以及序列的最低平均质量得分(C、D)均有所提高。此外,该步骤可通过去除碱基错配率较高的成对读段,减小理论 GC 分布与读段中实际每碱基 GC 含量之间的差异(E、F)。请点击此处查看该图的放大版本。

图 4:插入片段大小分布分析。插入片段大小直方图显示(A)CTCF、(B)H3K27Ac 和(C)丝氨酸5磷酸化的RNA聚合酶II(RNAPII-S5P)的结果。直方图展示了各样本间插入片段大小分布的相对差异。直方图中的虚线表示插入片段大小大于或等于横轴所示数值的测序读段所占的累积比例。n:过滤后每样本中唯一比对的一致性读段数量。FR:片段。请点击此处查看该图的放大版本。

图5:CUT&RUN 样本的全基因组景观概览。 公开可用的 CUT&RUN 映射读段经缩放分数计数(SFRC)标准化后未进行额外过滤的结果(黑色轨迹)、经 Easy Shells CUTnRUN 分析流程处理并采用 SFRC 标准化的 CUT&RUN 样本结果(红色轨迹),以及“阴性对照中每百万映射读段经内参标准化的读段数(SRPMC;绿色轨迹)”分别展示于(A)组蛋白基因簇区域,以及(B-D)另外三个由 MACS2、MACS3 和 SEACR 三种峰识别算法共同识别出 CTCF、H3K27Ac 和 RNAPII-S5P 峰的区域。黄色框标示了在 Easy Shells CUTnRUN 分析流程的过滤步骤中被滤除的内参信号位置。请点击此处查看该图的放大版本。

图6:通过不同峰识别工具及峰识别参数识别出的峰之间的维恩图比较。(A)在峰识别过程中使用或不使用IgG输入选项时,MACS2与MACS3识别出的峰之间的比较。(B-D)使用SEACR识别峰时,使用或不使用IgG输入选项、“严格”与“宽松”选项,以及使用原始读段对文件进行归一化处理(B)、不使用归一化选项而使用经SFRC归一化的读段计数文件(C)或经SRPMC归一化的读段计数文件(D)之间的比较。(E,F)使用IgG输入选项的MACS2、MACS3与使用严格(E)或宽松(F)选项的SEACR所识别峰之间的比较。(G,H)不使用IgG输入选项的SEACR与使用严格(G)或宽松(H)选项的SEACR所识别峰之间的比较。w/ IgG:使用IgG输入选项识别出的峰。w/o IgG:不使用IgG输入选项识别出的峰。norm:使用归一化选项识别出的峰。non:未使用归一化选项识别出的峰。SFRC:使用经“比例分数计数(SFRC)”方法归一化的读段计数文件识别出的峰。SRPMC:使用经“阴性对照中每百万比对读段的内参归一化读段数(SRPMC)”方法归一化的读段计数文件识别出的峰。请点击此处查看该图的放大版本。

图7:皮尔逊相关性分析、主成分分析和维恩图用于验证重复样本之间的相似性。 (A-C) 使用 Pearson 相关系数进行热图聚类,显示 MACS2 调用的峰处重复样本间的相似程度A),MACS3(B)以及 SEACR(C)。Pearson 相关系数的取值范围为 -1 到 1。Pearson 相关系数的绝对值越大,表示两个变量之间的相关性越强;正值表示正相关,即两个变量变化方向相同。因此,相似性越高的样本在热图聚类中表现出更近的亲缘关系,且 Pearson 相关系数值更高。D主成分分析(PCA)展示了在由 MACS2(左)、MACS3(中)和 SEACR(右)鉴定出的所有 CTCF、H3K27Ac 和 RNAPII-S5P 峰区范围内,重复样本与样品之间的相似程度。在 PCA 图中,相似性较高的样本彼此位置更接近。E-G) 使用 MACS2 比较各重复样本中检测到的峰的维恩图分析E),MACS3(F),以及 SEACR(G). Easy-Shell CUT&RUN 分析流程建议同时应用全部三种方法,以鉴定具有高度相似性的重复样本,这些样本可能适合合并所识别的峰用于下游分析。 请点击此处以查看此图的放大版本。

图8:峰信号分布的热图与元图可视化。 热图和元图展示了使用不同峰识别工具所识别出的峰中心周围富集信号的分布情况。(A,B)利用MACS3(A)和SEACR(B)从一个重复样本(SRR8581589)中识别出的CTCF CUT&RUN峰。(C,D)利用MACS3(C)和SEACR(D)从一个重复样本(SRR8581607)中识别出的H3K27Ac CUT&RUN峰。(E,F)利用MACS3(E)和SEACR(F)从一个重复样本(SRR8581589)中识别出的RNAPII CUT&RUN峰。在进行“比例分数计数”(SFRC)标准化后,比较了公开可用的比对读段对(图8中的“Public”)与Easy Shells CUTnRUN分析流程比对得到的片段(图8中的“SFRC”)。峰识别采用MACS3并选择IgG输入选项(图8中的“MACS3 w/ IgG”),以及采用SEACR在严格模式下不使用IgG输入且不进行标准化选项,基于SFRC标准化后的读段计数文件进行识别(图8中的“SEACR w/o IgG non SFRC stringent”)。对识别出的峰生成了两种版本的坐标文件:一种为从峰的起始位置到终止位置的完整区域(图8中的“whole”),另一种为峰内信号最强的bin位置(即MACS3识别峰中的峰顶位置,图8中的“focused”)。请点击此处查看该图的放大版本。
表1:GSE126612中CUT&RUN fastq文件的信息。 本表列出了包含在GSE126612中的所有原始CUT&RUN fastq文件,这些文件被选作Easy Shells CUTnRUN分析流程的示例数据集。“文件名”列显示了原始CUT&RUN测序数据fastq文件的名称,这些文件在运行“Script_02_download-fastq.sh”后将出现在“~/Desktop/GSE126612/fastq”目录中。“md5sum”列提供了示例数据集的MD5(消息摘要算法5)校验值,可用于在运行“Script_02_download-fastq.sh”下载数据集后验证文件的完整性。最后一列描述了每个样本对应的CUT&RUN靶标。请点击此处下载该表格。
讨论
绘制蛋白质在染色质上占据情况的能力对于开展染色质生物学领域的机制研究至关重要。随着实验室采用新的湿实验技术对染色质进行分析,对这些湿实验产生的测序数据进行分析的能力已成为湿实验科研人员常见的瓶颈。因此,我们描述了一项入门级的分步操作方案,旨在帮助生物信息学初学者克服分析瓶颈,启动对其自身CUT&RUN测序数据的分析及质量控制检查。
本CUT&RUN分析方案描述了多个步骤的应用,以确保对真实信号进行定量。从原始测序数据中去除低质量读段和接头序列是质量控制的首要步骤之一,也是获得准确分析结果最关键的步骤之一。因此,本分析流程包含了使用Trim-galore程序进行简便的质量和接头序列修剪的步骤27。鉴于该步骤的重要性,本分析流程还包含了在修剪处理前(步骤4.3)和修剪处理后(步骤5.3)比较结果质量的步骤(步骤5.5)。除了质量与接头序列修剪外,本分析流程还去除了非典型染色体读段、TA重复区域以及黑名单区域,这些因素可能引入GC含量偏差或导致假阳性峰(称为峰)。这些过滤步骤为生物信息学初学者提供了一个合适的入门流程,有助于理解CUT&RUN数据分析中的关键质量控制环节。
过滤步骤完成后,该 CUT&RUN 分析流程提供两种标准化方法:“标准化分数读段数 (scaled fractional readcount, SFRC)22”和“基于内参对照每百万比对读段数的 spike-in 标准化方法 (Spike-in normalized Reads Per Million mapped reads in the negative Control, SRPMC)24,25”,用于生成下游峰识别和可视化所需的输入文件。如果 CUT&RUN 数据集预期仅揭示局部差异,而样本间不存在全基因组范围的信号差异,则标准化分数读段数(即计数分数乘以参考基因组大小)可能已足以满足下游分析需求。然而,若 CUT&RUN 样本之间可能存在全局性信号强度差异,用户可选择 SRPMC 方法,该方法综合考虑 spike-in 与样本(包括实验性 CUT&RUN 样本和阴性对照样本)之间的读段比例,并结合阴性对照读段的每百万读段数 (RPM) 标准化,从而使不同样本间的阴性对照读段具有可比性。由于 SRPMC 提供的是相对于标准化后阴性对照读段的归一化读段数,该方法可最大限度地减少阴性对照信号的影响,实现不同批次和分组间数据集的比较。
CUT中的一个重要因素&RUN 样本峰检测正在消除假阳性 CUT&RUN 在期间达到峰值 计算机模拟 分析部分通过纳入IgG样本实现,具体而言,该分析流程为不同的峰值识别工具提供了峰值 calling 方法,以剔除假阳性的CUT&RUN 峰检测。对于 MACS2/3 峰检测工具,我们的分析流程在峰检测过程中使用 IgG 模拟测序数据作为输入样本。对于 SEACR,本分析流程建议首先独立检测实验样本和阴性对照样本的峰,然后去除实验样本与阴性对照样本之间重叠的峰,因为在实验样本峰检测过程中同时提供阴性对照可能导致 SEACR 丢失大部分峰。经筛选后的峰在不同峰检测工具及重复样本之间表现出可比的相似性。图5)。综上所述,去除低质量、非经典染色体、黑名单区域和TA重复序列的reads,剪切接头序列, spike-in DNA标准化,以及在峰识别(peak calling)步骤中对阴性对照进行恰当处理,可为用户提供适用于下游分析的准确readcount文件。结合高质量的标准化测序文件和经过审慎识别的峰区域,用户可进一步比较重复样本间的相似性,并生成背景信号极干净的热图(heatmaps)和平均信号图(metaplots),以验证峰识别的有效性。
使用高质量的测序数据进行峰区识别,标志着从CUT&RUN数据中开展生物学解释的起点。本方案描述了如何将信号最强或统计学显著性最高的位置指定为峰区中心,从而在热图和元图中获得聚焦清晰的峰信号。某些峰区识别方法并未将其峰中心定位在信号最强或统计学显著性最高的位置。因此,将每个峰区的中心重新定义为信号最强或统计学显著性最高的位置,是生成中心信号高度集中的可视化数据结果的重要步骤。原始峰区调用生成的bed文件将予以保留,用于后续的峰区注释及功能相关性分析,这些分析将在本方案所述步骤完成后进行。
尽管本 CUT&RUN 分析流程包含了所需程序安装步骤的说明,但生物信息学初学者在安装分析工具时仍可能遇到困难。因此,已建立一个相关的 Github 问题页面,以提供更详细的程序安装分步说明,并促进用户在自身系统中安装程序时的技术支持与交流。在本文所述方案基础上,CUT&RUN 分析流程的后续步骤还包括峰注释、识别不同类型识别峰之间的重叠区域,以及对识别峰进行功能注释。完成本方案中描述的质量控制和峰识别步骤,并结合下游的峰注释分析,将使用户能够从其 CUT&RUN 数据中获得生物学意义。
本 CUT&RUN 分析流程旨在为批量 CUT&RUN 分析提供通用的入门级分步指南。该流程存在一些局限性。首先,尽管本分析流程尝试通过过滤黑名单区域(包括“高信号伪影区域”、“伪影重复区域”和 TA 重复区域)上的读段来处理由 GC 含量差异引起的影响,但这种方法可能不足以应对某些基因组中具有独特 GC 含量的生物。因此,如果用户关注任何由 GC 含量引起的偏差,可考虑增加一步对已比对读段进行校正。对于生物信息学初学者,Deeptools 中的 'computeGCBias' 和 'correctGCBias' 可作为实现此目标的选项。其次,本分析流程在同一文件中同时处理常规插入片段大小(100 bp–1 kb)和小插入片段大小的读段(< 100 bp),后者可能是某些染色质相关蛋白的真实读段。由于本分析流程采用 shell 脚本编写,用户可在生成比对读段的 bed 文件步骤中修改“Script_08_bam-to-BEDPE-BED-bedGraph.sh”,以将短插入片段大小的读段与常规片段大小的读段分别提取出来。随后,短插入片段大小的读段 bed 文件可独立于常规插入片段大小的比对读段进行标准化,以最小化其对整体信号的压缩效应。第三,为了降低分析流程的复杂性,Easy Shells CUTnRUN 未包含对 CUT&RUN 样本测序深度进行均一化的下采样步骤。然而,用户可在使用 samtools view28 或 PositionBasedDownsampleSam(Picard)29 过滤 bam 文件后,自行添加下采样步骤。
本方案中的所有分析步骤均以 shell 脚本编写,旨在帮助生物信息学初学者通过查阅脚本学习 CUT&RUN 分析的基础知识。我们期望用户能够在终端中依次运行每个 shell 脚本,逐步实践生物信息学分析。此外,本 CUT&RUN 分析流程所提供的 shell 脚本简洁明了,便于用户修改和定制,从而将该分析流程应用于自身的 CUT&RUN 数据。最终,我们希望该 CUT&RUN 分析流程能够减少 CUT&RUN 数据分析过程中的常见瓶颈,助力湿实验研究人员和生物信息学初学者从自身的 CUT&RUN 测序数据中得出生物学结论。
披露
作者声明无利益冲突。
致谢
所有插图均使用 BioRender.com 制作。CAI 感谢卵巢癌研究联盟早期职业研究者奖、Forbeck 基金会加速器资助以及明尼苏达卵巢癌联盟国家早期检测研究奖提供的支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | 将读取计数 bedGraph 压缩并转换为 bigWig 的软件 |
| bedtools-2.31.1 | 犹他大学 Quinlan 实验室 | https://bedtools.readthedocs.io/en/latest/index.html | 用于处理 bam/bed/bedGraph 文件的软件 |
| bowtie2 2.5.4 | 约翰斯·霍普金斯大学 | https://bowtie-bio.sourceforge.net/bowtie2/index.shtml | 用于构建bowtie索引并执行比对的软件 |
| CollectInsertSizeMetrics(Picard) | 布罗德研究所 | https://github.com/broadinstitute/picard | 用于插入片段大小分布分析的软件 |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/zh/stable/index.html | 用于执行接头序列修剪的软件 |
| Deeptoolsv3.5.1 | 马克斯·普朗克研究所 | https://deeptools.readthedocs.io/en/develop/index.html | 用于执行皮尔逊相关系数分析、主成分分析以及热图/平均值图分析的软件 |
| FastQC 版本 0.12.0 | 巴布拉汉生物信息学 | https://github.com/s-andrews/FastQC | 检查 fastq 文件质量的软件 |
| Intervene v0.6.1 | 计算生物学 &基因调控 - Mathelier 小组 | https://intervene.readthedocs.io/en/latest/index.html | 用于使用峰文件进行维恩图分析的软件 |
| MACSv2.2.9.1 | 陈-扎克伯格倡议 | https://github.com/macs3-project/MACS/tree/macs_v2 | 用于识别峰的软件 |
| MACSv3.0.2 | 陈-扎克伯格倡议 | https://github.com/macs3-project/MACS/tree/master | 用于识别峰的软件 |
| Samtools-1.21 | 威康桑格研究所 | https://github.com/samtools/samtools | 处理 sam/bam 文件的软件 |
| SEACRv1.3 | 霍华德·休斯医学研究所 | https://github.com/FredHutch/SEACR | 用于识别峰的软件 |
| SRA Toolkit 版本 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | 从 GEO 下载 SRR 的软件 |
| Trim_Galore v0.6.10 | 巴布拉汉生物信息学 | https://github.com/FelixKrueger/TrimGalore | 用于执行质量控制和接头序列修剪的软件 |
参考文献
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
重印与许可
