本文介绍了RUGGED(基于图引导可解释疾病区分的检索),该方法将大语言模型(LLM)推理与检索增强生成(RAG)相结合。它从专家整理的生物医学知识库和同行评审的生物医学出版物中提取证据,利用最新信息综合新知识,识别具有可解释性和可操作性的预测结果,并确定假设驱动研究的潜在方向。
本文内容
摘要
摘要
生物医学知识的规模涵盖了科学文献和 curated 知识库,这给研究人员在有效处理、评估和解读研究发现方面带来了重大挑战。大型语言模型(LLMs)已成为应对这一复杂知识格局的有力工具,但可能产生幻觉式响应。检索增强生成(Retrieval-Augmented Generation, RAG)对于识别相关信息以提高准确性和可靠性至关重要。本实验方案介绍了 RUGGED(Retrieval Under Graph-Guided Explainable disease Distinction),这是一个旨在支持知识整合、减少偏倚并探索和验证新研究方向的综合工作流程。通过文本挖掘关联分析和可解释图谱预测模型,整合并分析来自出版物和知识库的生物医学信息,以揭示潜在的药物-疾病关系。这些发现连同源文本语料库和知识库被纳入一个框架中,该框架采用 RAG 增强的 LLM,使用户能够探索假设并深入研究潜在机制。一个临床应用案例展示了 RUGGED 在评估和推荐心律失常性心肌病(Arrhythmogenic Cardiomyopathy, ACM)与扩张型心肌病(Dilated Cardiomyopathy, DCM)治疗方案方面的能力,分析已开具药物的分子相互作用及潜在的新用途。该平台减少了 LLM 的幻觉现象,突出了可操作的洞察,并简化了对新型治疗手段的探究过程。
引言
在生物医学研究中,假设探索过程对于揭示疾病发病机制背后的新分子-药物-疾病相互依赖关系并释放治疗潜力至关重要1,2。该过程依赖于现有的生物医学知识,通过整合同行评审文献中蕴含的逻辑线索(例如,来自PubMed的>36篇报告),综合新发现,并融合来源于生物医学知识库中的高可信度 curated 证据。近年来的技术进步通过在文献语料库上应用文本挖掘3,4,5,以及采用基于图谱的分析方法6,7,8,9,来合成相关信息并发现新的研究路径,从而减少了繁琐的人工工作。尽管如此,由于数据碎片化,现有方法通常难以支持深入的上下文理解。此外,它们缺乏基于证据进行推断以及交互式探索新假设的能力。
大型语言模型(LLMs)的最新进展为应对这些挑战提供了新的视角,通过在跨多个学科的海量信息上进行训练,展现出高水平的上下文理解能力10,11,12。在生物医学领域,LLMs 已显示出在提取患者信息13和通用临床问题回答14,15方面的应用潜力,而其在特定领域问题回答16及初级临床护理中的实际应用17仍有待进一步探索。这些模型具备从复杂数据集中进行推理和推断的能力,使其可能适用于开展假设探索与知识整合。此外,部分模型具备类似对话的交互功能,可促进用户参与并实现对主题的动态探索,突破了传统基于查询的搜索引擎和知识库的局限18,19。
除了这些潜力之外,大语言模型(LLM)还面临诸多重大挑战,例如可能产生信息幻觉、对潜在不准确的解释表现出不当的自信、缺乏可解释性,以及容易生成带有偏见或不适当的内容20,21,22,23,24。若将LLM直接应用于指导临床决策,其所生成的回答与预测具有重大影响;任何错误都可能导致昂贵的实验室实验,或对患者的健康进程产生负面影响25,26。因此,可靠且可信的LLM响应至关重要,其建议必须严格基于科学证据。在这些情境下,可解释性并非附加优势,而是理解模型为何做出特定预测的必要条件。
为此,检索增强生成(Retrieval-Augmented Generation, RAG)是一种旨在减少大语言模型(LLM)产生幻觉的系统,通过将LLM的响应建立在证据基础之上,以提高其准确性和可靠性27,28。该方法通常涉及检索相关文本段落,例如将LLM(如ChatGPT)与PubMed集成,从而识别出与用户查询相关的引文29,30。检索不仅限于文本,知识图谱(Knowledge Graphs, KGs)上的检索在LLM中的应用也展现出潜力,可用于事实核查31,32,33、透明推理34,35,36、知识编码37、提升问答性能38以及知识图谱补全39等任务。通过编码来自权威来源的事实信息,KGs能够增强LLM响应的准确性、透明度和可靠性。这些图谱中的链接预测技术利用深度学习来识别分子、药物与疾病之间先前未被发现的关系5,40,41。近年来可解释人工智能预测技术的进步进一步提升了这些链接预测任务的透明性和可解释性,为解释生物医学假说提供了可行的研究路径,并具有潜在支持作用42,43,44。这些进展确保了LLM生成的响应是平衡的且基于证据的,显著提升了其在生物医学领域的适用性。
本方案介绍了RUGGED(基于图引导可解释性疾病的检索,Retrieval Under Graph-Guided Explainable disease Distinction)作为一种便捷且高效的流程,用于探索和验证临床治疗见解图1)。该工作流程利用生物医学文献和知识库的丰富资源,提取并验证相关信息,从而实现针对查询的定制化检索过程(图2采用可解释的人工智能预测模型,从现有生物医学知识中挖掘可解释且可操作的洞察,从而提升预测模型的透明度与实用性。完整的流程简化了知识图谱与模型预测的探索过程。 通过 RAG增强的大型语言模型,为研究人员、临床医生及临床专业人员提供直观且信息丰富的交互体验。
本部分为该实验方案奠定基础,后续章节将详细描述实施该方法的具体步骤。接着,通过一个具有转化意义的临床应用实例,展示该方法在心血管药物分子相互作用评估及治疗策略研究中的应用。最后,讨论该实验方案的意义及其相关问题。
方案
本方案使用 Python 3.10 开发,并在 Windows 系统中以 Docker 容器形式实现。所提供的命令基于 Docker 容器内的 Unix 环境。该软件可在 https://github.com/pinglab-utils/RUGGED 获取。表1列出了本方案中所有步骤的计算时间估算。
1. 安装软件
- 按照材料表中的说明安装先决条件软件。
注意:本方案需要版本控制、容器化、图数据库以及大语言模型(LLM)服务。版本控制和容器化为可选项,但可简化设置过程;若用户具备相应技术能力,图数据库和LLM服务可用类似工具替代。- 配置容器间网络。将Docker容器配置为与设备上的其他服务(例如其他Docker容器)连接。在终端中输入以下命令:docker network create rugged_network
- 设置大语言模型(LLMs)服务。根据使用场景选择合适的LLM服务,可选商业LLM服务或在用户设备上运行的本地模型服务。至少需指定一个LLM服务,但可混合搭配不同代理以利用不同模型。
- 启动本地LLM服务。若使用Ollama并采用图形用户界面(GUI),运行GUI可执行文件(例如 ollama.exe)。若使用Docker,请运行:`docker run -name ollama --net rugged_network d -v ollama:/root/.ollama -p 11434:11434 ollama/ollama`。若使用支持GPU加速的Docker,请确保已安装GPU驱动程序,并运行:`docker run -name ollama --net rugged_network -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 ollama/ollama`。
- 初始化本地LLM模型。从支持的模型中确定要使用的模型(例如推荐:llama3、mistral、mixtral)。若使用Docker,在命令行中输入 'docker exec run ollama run <MODEL_NAME>';若使用Ollama GUI,则输入 `ollama run <MODEL_NAME>`,并将 <MODEL_NAME> 替换为具体模型名称。
- 启动图数据库服务。在Docker容器、桌面应用程序或在线网络服务中选择一种图数据库服务。按照补充材料中的安装说明完成设置。
- 设置RUGGED环境。通过输入docker images验证已下载的Docker镜像,确保上一步中的所有Docker镜像均已列出。在终端中运行以下命令以下载RUGGED的Docker镜像和代码:
docker pull pinglabutils/rugged:latest
注意:git clone https://github.com/pinglab-utils/RUGGED- 配置商业LLM服务。若使用商业LLM服务,请确保账户及关联的API密钥有足够的资金。通过编辑 `RUGGED/config/openai_key.txt` 配置文件并将API密钥添加至该文件来修改RUGGED配置。
- 配置商业代理。确定RUGGED系统中哪些LLM代理将使用此服务。修改 `RUGGED/config/llm_agents.json` 配置文件,并更新代理字段以指定模型版本。推荐模型:gpt-3.5-turbo、gpt-4o。
- 配置本地LLM服务。若使用的Ollama服务端点不同于默认端点 `http://localhost:11434`,请修改并更新 `RUGGED/config/ollama_config.json` 配置文件中的 `OLLAMA_URI` 字段。
- 配置本地LLM代理。确定RUGGED系统中哪些LLM代理将使用此服务。修改 `RUGGED/config/llm_agents.json` 配置文件,并更新代理字段,将所选模型指定为 `ollama`。
- 配置图数据库端点。若Neo4j的默认用户名和密码已被修改,请编辑 `RUGGED/config/neo4j_config.json` 配置文件,更新 `uri`、`username` 和 `password` 字段。
- 通过运行以下命令启动RUGGED服务:
docker run --name rugged -it --net rugged_network --gpus=all -v <PATH_TO_FOLDER>\RUGGED\:/data ping-lab-
utils:RUGGED /bin/bash
注意:为验证服务是否正常运行,请进入RUGGED目录并在该终端窗口中执行步骤1.4.1至步骤1.4.4。- 验证LLM服务功能。进入RUGGED目录下的test文件夹,并执行以下命令以验证OpenAI和/或Ollama服务是否正常工作:
python test_openai.py
python test_ollama.py - 验证命名实体识别服务功能。执行 `test_ner.py` 以验证用户查询命名实体识别代码是否正常运行。
- 验证Neo4j服务功能。通过输入 `python test_neo4j.py` 执行测试脚本,验证Neo4j服务是否按预期运行。
- (可选)验证对图数据库的HTTP访问。打开网页浏览器并访问Neo4j用户界面。
注意:对于Docker或桌面版Neo4j,默认URL为 `http://localhost:7474`;对于Neo4j AuraDB,请使用设置期间提供的链接。
- 验证LLM服务功能。进入RUGGED目录下的test文件夹,并执行以下命令以验证OpenAI和/或Ollama服务是否正常工作:
- (可选)排查问题。确保在软件设置过程中验证支持RUGGED的服务,以提前发现潜在问题。对步骤1.4中未通过的测试进行故障排查。若存在问题,请根据测试脚本报告的错误信息进行处理。
- 验证Docker容器。在终端中使用 `docker ps` 确认所有Docker容器正在运行,包括RUGGED Docker容器、Neo4j Docker容器(可选)和Ollama Docker容器(可选)。
- 验证网络端口。对于Docker服务,确保正确端口已打开,并使用 `docker logs neo4j` 或 `docker logs ollama` 查看日志。
注意:默认情况下,Neo4j使用7474端口用于HTTP通信,7687端口用于其Bolt接口;Ollama使用11434端口。 - 验证服务应用程序。对于直接安装在设备上的应用程序(例如Ollama和Neo4j Desktop),打开应用程序以确认其正在运行。
- 验证网络服务。对于Neo4j AuraDB,请登录网站并确认服务正在运行。
- 验证防火墙规则。修改设备防火墙规则,确保防火墙未阻止任何外部服务。
- 重启设备。若问题仍未解决,请重启设备并从步骤1.5.1重新尝试。
- 提交问题。若问题持续存在,请在RUGGED GitHub页面(https://github.com/pinglab-utils/RUGGED)提交问题报告。
2. 获取生物医学知识与信息提取
注意:这些步骤概述了构成 RUGGED 系统中检索增强生成(Retrieval Augmented Generation, RAG)的两个知识提取流程:(1)CaseOLAP LIFT 生物医学文本挖掘流程5 和(2)Know2BIO 知识图谱构建工作流程9。若要使用自定义数据运行 RUGGED,请继续执行步骤 4。
- 提取生物医学文献。利用CaseOLAP LIFT(一种通过生物医学文献文本挖掘来研究亚细胞蛋白及其与疾病关联的计算方案),识别相关文献及高层次的蛋白质-疾病关系。完成此步骤,以从这些报告中获取有针对性的见解,为后续的RAG工作流程提供必要信息。
- 运行CaseOLAP LIFT文本挖掘分析。访问CaseOLAP LIFT JoVE方案(本分析无需执行步骤4-5)。
- 移动已处理的文本文件。确保步骤3中解析后的生物医学文献文件(pubmed.json)及其全文内容(pmid2full_text_sections.json)已位于CaseOLAP LIFT的数据文件夹中。使用以下命令将这些文件移至RUGGED数据文件夹:
mv <PATH_TO_FOLDER>/caseolap_lift/caseolap_lift_shared_folder/data/pubmed.json <PATH_TO_FOLDER>/RUGGED/data/text_corpus
mv <PATH_TO_FOLDER>/caseolap_lift/caseolap_lift_shared_folder/data/ pmid2full_text_sections.json <PATH_TO_FOLDER>/RUGGED/data/text_corpus - 移动文本挖掘结果。确认在result/kg文件夹中已生成包含蛋白质-疾病关联的知识图谱文件(merged_edge_list.tsv)。根据步骤1-3所选设置,检查关联数量是否符合预期(示例见表2)。将该文件移至RUGGED的数据文件夹:
mv <PATH_TO_FOLDER>/caseolap_lift/caseolap_lift_shared_folder/result/graph_data/ merged_edge_list.tsv <PATH_TO_FOLDER>/RUGGED/data/knowledge_graph
- 提取生物医学知识。使用Know2BIO软件构建生物医学知识图谱,该软件整合了来自30个生物医学知识库的数据。完成此步骤,以确保这些生物医学关系和多模态数据得到处理,从而支持下游的RAG工作流程。
- 克隆Know2BIO代码仓库。在命令行中输入以下命令克隆代码仓库,并进入Know2BIO仓库目录。
git clone https://github.com/Yijia-Xiao/Know2BIO.git。 - 准备数据与许可。进入dataset文件夹,并按照`README.md`文件中的说明操作。完成必要的用户账户创建,以访问各种在线资源(例如UMLS词库、Drug Bank)。
- 下载知识库资源。执行`python create_edge_files.py`脚本,并监控知识图谱提取流程的进度。确保在`Know2BIO/dataset/output`文件夹中已生成表示生物医学关系的.csv文件。
- 构建知识图谱。执行`python prepare_kgs.py`脚本,整合上一步提取的信息,自动将提取的关系合并为统一的知识图谱,并按数据来源和领域对图谱进行格式化。
- 验证输出结果。检查`Know2BIO/dataset/know2bio_dataset`目录下的`whole_kg.txt`文件是否已完整生成。确认文件中的边数符合预期;参见表3,其结果包含超过600万条边。继续执行下一步,本分析无需完成Know2BIO README中的其余步骤。
注:表3中Know2BIO的关系来源于31个资源,包括ATC(世界卫生组织)、Bgee45、CTD46、ClinGen47、ClinVar48、DOID49、DisGeNET50、DrugBank51、GRNdb52、Gene Ontology53、HGNC54、Hetionet3、Inxight Drugs55、KEGG56、MeSH57、Mondo58、MyChem.info59、MyDisease.info59、MyGene.info59、OMIM60、PathFX61、PharmGKB62、PubMed、Reactome63、SIDER64、SMPDB65、STRING66、TTD67、UMLS68、Uberon69和UniProt70。 - 移动知识图谱结果。将文件移至RUGGED目录下的`/data/knowledge_graph/`文件夹。
mv <PATH_TO_FOLDER>/Know2BIO/dataset/know2bio/whole_kg.txt <PATH_TO_FOLDER>/RUGGED/data/knowledge_graph
- 克隆Know2BIO代码仓库。在命令行中输入以下命令克隆代码仓库,并进入Know2BIO仓库目录。
- 构建综合知识图谱。将上一步生成的图谱与步骤2.1中通过文本挖掘获得的高层次蛋白质-疾病关系整合为一个统一的知识图谱。
- 验证RUGGED目录中的结果。确认知识图谱构建结果文件(whole_kg.txt)和文本挖掘关系结果(merged_edge_list.tsv)均位于data文件夹内的knowledge_graph目录中。
- 整合结果。执行`combine_kg_results.py`脚本,将文本挖掘分析和知识图谱构建中提取的关系与实体合并为一个连贯统一的知识图谱。参考以下示例命令:
python rugged/knowledge_graph/combine_kg_results.py ./data/knowledge_graph/merged_edge_list.tsv ./data/knowledge_graph/whole_kg.txt --output_dir ./data/rugged_knowledge_graph
- 过滤知识图谱。(可选)对知识图谱进行子集采样,用于预测分析。此步骤仅保留密切相关的关系,以减少执行深度学习预测所需的计算资源。
- 识别相关节点。通过查阅知识图谱并定位相关节点,确定步骤3中预测分析所关注的生物医学实体。
注:本方案重点关注心律失常性心肌病(ACM)和扩张型心肌病(DCM)的疾病节点,即MeSH_Disease: D019571 和 MeSH_Disease: D002311。目标节点应根据具体应用场景进行调整。 - 从知识图谱中采样。使用`filter.py`脚本提取从所选关注节点出发、k跳范围内可达的知识图谱子图。参考以下示例命令,该命令从选定的疾病节点出发,提取2跳范围内的图谱:
python ./rugged/knowledge_graph/kg_filter.py --k 2 --disease “MeSH_Disease:D019571,MeSH_Disease:D002311" --input_file ./data/rugged_knowledge_graph/rugged_knowledge_graph_edges.csv —output_dir ./data/rugged_knowledge_graph/filtered_kg/.
注:增加k跳值(--k)可扩大预测分析所覆盖的图谱数据范围,但同时会增加计算资源需求。
- 识别相关节点。通过查阅知识图谱并定位相关节点,确定步骤3中预测分析所关注的生物医学实体。
3. 可解释性预测分析
注意:在图卷积网络模型上执行 GNNExplainer44,以预测知识图谱中潜在的边(关系),并揭示先前未知的关联。
- 确保 RUGGED Docker 容器正在运行。如果之前的终端窗口已关闭,请使用命令 `docker exec --it rugged /bin/bash` 连接到 Docker 容器。连接到 Docker 容器后,导航至 RUGGED 目录。
- 确定要预测的边。以节点对的形式在 .txt 文件中提供待预测的边(例如,edges_to_predict.txt)。知识图谱中已存在的边将从预测结果中被过滤掉。
- 运行 预测分析 脚本。通过命令行参数指定待预测的边和输入的知识图谱。关键参数包括:-p(边文件路径)、-i(输入知识图谱)、-o(输出目录)、-n(前 n 个预测结果,例如 5)、-k(用于可视化的前 k 条边,例如 10)。示例命令:
python rugged/predictive_analysis/generate_explainable_prediction.py -o output -n 5 -k 10 -p ./output/edges_to_predict.txt -i ./data/rugged_knowledge_graph/filtered_kg/filtered_k2_edges.csv - 评估模型性能。检查上一步生成的终端输出或 `output.log` 文件,基于将过滤后的知识图谱按 85:5:10 的比例划分为训练集、验证集和测试集的结果,评估模型性能。如果性能未达预期,可参考 表 4 调整模型参数。
- 确认结果已生成至输出文件夹。检查 `prediction_results.csv` 中的模型结果,并查看输出文件夹中的前 n 个预测结果。针对每个预测结果,图形可视化展示了对预测贡献最大的相关边及其相对重要性得分。
- 移动预测分析结果。当对预测分析结果满意后,将结果移至 RUGGED 目录下的 `data/predictions/` 文件夹中。
4. 假设生成
- 连接到 RUGGED Docker 容器。
- 确保 RUGGED Docker 容器正在运行。如果之前的终端窗口已关闭,请重新连接到 Docker 容器。
- 导航至 RUGGED 目录。连接后,输入 cd /workspace/RUGGED 进入该目录。在当前命令行窗口中执行后续所有步骤。
- 验证支持服务是否正在运行。如果在 Docker 中使用 Ollama 和 Neo4j,请通过输入 `docker ps` 命令确认容器正在运行。重复步骤 1.7 以验证服务是否正常运行,如有问题则执行步骤 1.4 进行故障排查。
- 准备 RAG 数据。为检索准备知识图谱和文本语料库。
注意:可通过将用户自定义数据分别放入 `data/knowledge_graph/` 和 `data/text_corpus/` 目录中来替换这些数据。这些数据必须遵循 GitHub 仓库(https://github.com/pinglab-utils/RUGGED/tree/main/data)中的格式。- 验证资源。确保文本语料库位于 `data/text_corpus/` 目录中,包含文本挖掘预测结果的文件位于 data/knowledge_graph/ 目录中,预测结果位于 data/predictions/ 目录中(分别来自步骤 2.1.2、2.3.2 和 3.5)。
- 填充图数据库。执行命令 `python ./neo4j/prepare_neo4j.py` 以创建必要的节点、边和节点特征。
- 索引文本语料库。执行命令 `python ./text/prepare_corpus.py` 以索引文本语料库,并通过将文档分块为每段 500 个 token 的片段,使用 BART71 构建向量数据库,使 RUGGED 能够根据用户查询检索相关文本文档。
- (可选)测试图数据库检索。向 Neo4j 数据库发送测试查询,以确保数据库已正确填充并能返回预期结果。验证输出是否与数据库中预期的节点和关系一致。示例命令:
python ./test/test_neo4j_retrieval.py --query "MATCH (n) RETURN n LIMIT 5" - (可选)测试 RAG 语料库检索。向 RAG 文本语料库发送测试查询,以确保文本检索系统正常工作。检查检索到的文档是否与查询相关,且嵌入向量是否按预期运行。示例命令: python ./test/test_literature_retrieval.py --query "哪些文档与使用β受体阻滞剂治疗心血管疾病相关?"
- 与 RUGGED 交互。在命令行界面中启动 RUGGED 并与系统进行交互。执行命令 `python rugged.py`。使用特定命令查询系统,以从知识图谱和文本语料库中检索相关信息。
- 查询知识图谱。以自然语言提出问题,以关键词 "query" 开头,从知识图谱中提取特定信息。例如:
query “目前被归类为β受体阻滞剂、抗心律失常药物和抗纤维化药物的处方药有哪些?" - 探索预测结果。探索步骤 3 中的链接预测分析,使用关键词 "predict" 查询特定关系。例如:
predict, “这些药物中哪些可能可用于治疗目前尚未知晓的 ACM 和/或 DCM?" - 探索文献检索。探索步骤 2 中与特定生物医学主题相关的文档。以自然语言提出问题,以关键词 "search" 开头。例如:
search, "有哪些文献证据支持这些预测药物可用于治疗 ACM 和/或 DCM 的说法?" - 迭代并优化查询。在命令行中直接响应,利用 RUGGED 的类聊天界面迭代并优化查询。参考之前的用户-系统对话,修改和精炼提问内容。
- 在 Neo4j 中重新运行 Cypher 命令。(可选)通过调整用于检索信息的 Cypher 命令来优化知识图谱查询结果。访问步骤 1.4.4 中的 Neo4j 浏览器界面(例如,在 http://localhost:7474),粘贴并按需修改 Cypher 命令,以优化查询并获得更具体的洞察。
- 总结对话。查看检索到的信息,并与 RUGGED 总结本次交互。输入关键词 summarize,将交互摘要输出到文本文件以供后续分析。完整文本响应将在终端中显示。
- 进行人机协同审查,通过检查和修改系统响应以提高输出的准确性,确保内容可读且简洁,再最终确定摘要。
- 查看聊天日志。检查 RUGGED 日志文件夹中的完整交互文本。保留 RUGGED 内部 LLM 代理之间的中间命令和对话,以便于故障排查和结果复现。
- 查询知识图谱。以自然语言提出问题,以关键词 "query" 开头,从知识图谱中提取特定信息。例如:
- 关闭和重启 RUGGED。
- 获取 Docker 容器 ID。使用命令 `docker ps` 列出所有正在运行的容器,并获取 RUGGED、Neo4j 和 Ollama 的容器 ID。在以下所有命令中,将 <container_id_for_rugged>、<container_id_for_neo4j> 和 <container_id_for_ollama> 替换为实际的容器 ID。
- 停止 Docker 容器。使用容器 ID 关闭 RUGGED 及其关联的 Docker 容器。
docker stop <container_id_for_rugged>
docker stop <container_id_for_neo4j>
docker stop <container_id_for_ollama>
注意:建议在关闭设备前停止这些容器,以防止潜在的数据丢失,并确保所有进程正确关闭。 - 重启 Docker 容器。要重新启动 RUGGED 系统,请使用容器 ID 启动必要的 Docker 容器。
docker start <container_id_for_rugged>
docker start <container_id_for_neo4j>
docker start <container_id_for_ollama> - 重新连接到 Docker 网络。如有需要,使用以下命令将容器重新连接到网络。
docker network connect rugged_network <container_id_for_rugged>
docker network connect rugged_network <container_id_for_neo4j>
docker network connect rugged_network <container_id_for_ollama> - 验证服务功能。重启后,重复步骤 1.4–1.5,确保软件按预期运行。
结果
这些代表性结果是通过遵循本实验方案中所述步骤获得的。根据 CaseOLAP LIFT 方案5,使用默认参数进行了文本挖掘关联分析,研究了八类广泛的心血管疾病72 与其线粒体蛋白(GO:0005739)之间的关联。截至2024年5月,共确定635,696份报告与这些疾病相关;其中识别出4,655个高置信度的蛋白质-疾病关联,用于支持后续分析。使用 Know2BIO 的软件代码并采用2024年5月的默认设置构建了生物医学知识图谱9。所生成的知识图谱包含219,450个节点、6,323,257条边,以及针对189,493个节点的节点特征,包括节点描述、蛋白质/基因序列、化学结构等(如可获取)。本方案中所有步骤的计算时间估计见表1。
通过构建知识图谱节点和特征以及心血管疾病相关出版物的向量数据库,初始化了RUGGED系统。所有知识图谱的节点、边和节点特征均使用BART71嵌入模型,以20个token的分块大小进行处理,以准备RAG向量搜索。类似地,原始研究论文和综述文章使用500个token的分块大小及BART嵌入模型进行处理,以准备RAG向量搜索。在文献检索中,对于超过500个token的全文出版物,BART嵌入模型根据出版物的各个部分对其进行分层摘要。系统中其余的LLM代理均采用GPT-4o模型。
这些代表性结果展示了一个用于研究致心律失常性心肌病(Arrhythmogenic Cardiomyopathy, ACM)和扩张型心肌病(Dilated Cardiomyopathy, DCM)潜在药物治疗方案的示例应用场景,二者在医学主题词(MeSH)中分别标识为 MeSH_Disease: D019571 和 MeSH_Disease: D002311。一系列查询流程如图3所示,模型响应的典型示例见图4,完整响应结果见补充文件1,A部分。查询方向根据经研究者验证的响应结果进行调整,并基于前序响应结果设计后续查询。分析共发现11种被归类为β受体阻滞剂和抗心律失常药物的候选药物。通过图卷积神经网络链接预测模型,在完整知识图谱的一个子集上评估了新的治疗途径,该子集包括研究疾病节点和药物节点的一跳邻域(1-hop)及其相互连接关系,评估指标见表4。针对模型预测结果中的每一条预测,其排名前10的相关边进一步通过图可解释性模块GNNExplainer44进行分析,以分别识别对各预测贡献最大的关键节点和边。本案例中,使用商业大语言模型(LLM)执行RUGGED协议全部步骤的预计总成本在撰写本文时约为1.50美元。
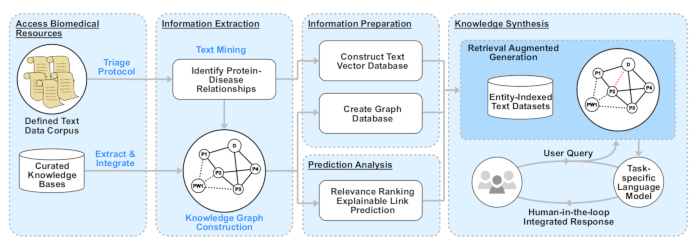
图1:基于图谱引导的可解释疾病区分检索(RUGGED)工作流程。RUGGED 包含四个主要组成部分:(1)整合并处理来自符合伦理规范且专业管理的资源(例如 PubMed 和人工整理的生物医学知识库)的数据,(2)将同行评审的研究成果整合为统一的知识图谱,(3)在数据库服务中对文本和图谱数据进行结构化处理,(4)在知识图谱中对生物医学实体间的可解释关系进行建模与预测,以及(5)通过检索增强生成(Retrieval Augmented Generation, RAG)工作流程(图2)检索并综合知识,以验证复杂的分子关系并探索由人工智能驱动的疾病预测。用户可引入人工参与的审核步骤,以提高输出结果的准确性。请点击此处查看该图的高清版本。
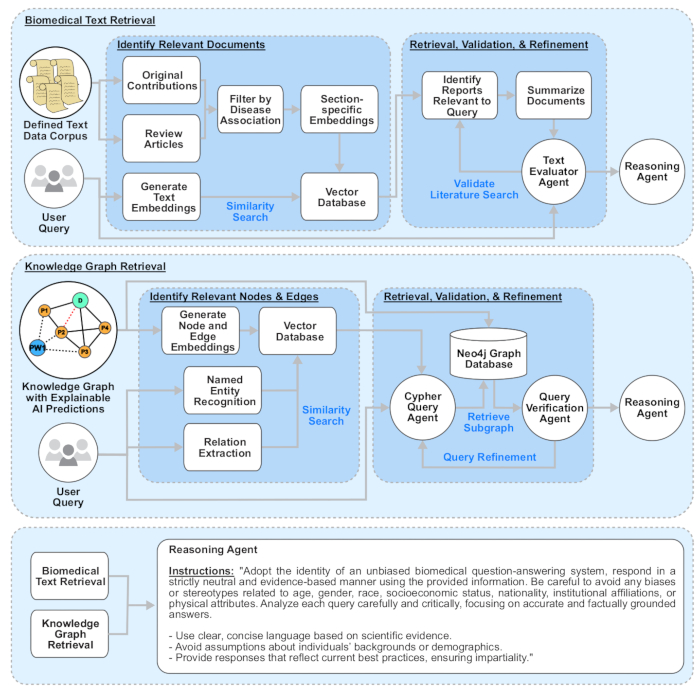
图2:检索架构与偏差缓解工作流程。 检索增强生成(Retrieval Augmented Generation, RAG)框架采用多个大语言模型(LLM)代理,每个代理执行特定任务,以根据用户查询支持获取相关信息。该系统为面向用户的基于GPT的推理代理提供有据可查的证据,促进用户与代理之间的交互及知识整合。(1)生物医学文本检索:根据文献对理解疾病关联的相关性,筛选经过同行评审的原创性研究和综述文章。构建向量数据库,其中作者和编辑验证的文本证据根据出版物相应部分加权:摘要占70%,结果占10%,元数据占10%,其余各子章节合计占10%。通过关键词搜索和用户查询文本嵌入的相似性搜索共同识别相关文档。使用基于BERT的摘要器生成每篇文档的摘要,并由基于GPT的文本评估代理进一步优化搜索,以验证查询与文档的相关性。(2)知识图谱检索:基于BERT的命名实体识别模块和基于GPT的关系抽取模块将用户查询连接至知识图谱中的相关实体。在向量数据库中进行相似性搜索,识别出相关的节点和边。由基于GPT的Cypher查询代理生成并经查询验证代理优化后的Cypher查询语句,从Neo4j数据库中检索数据。(3)来自生物医学文本检索或知识图谱检索流程的独立响应被提交给推理代理,该代理综合生成针对用户查询的简洁且偏差最小的回答。该系统旨在确保在呈现事实信息时保持准确性和中立性。请点击此处查看该图的放大版本。
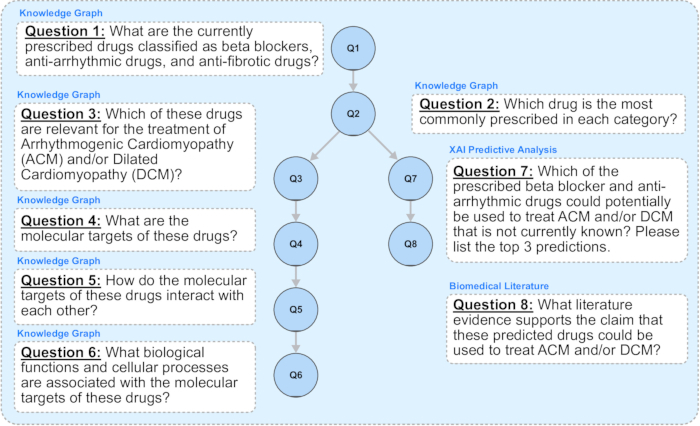
图3:通过分层查询级联实现知识整合与假设探索的应用场景 via tiered query cascade. 本图展示了一个重点应用场景,聚焦于研究者和/或医疗专业人员可能向RUGGED系统提出的一系列相互关联的问题与概念。用户的查询按数字顺序提交给系统,箭头表示各问题之间推断出的逻辑关系和领域特定的推理过程。系统从隐含且相关的信息中进行检索(来源以蓝色显示),并对查询作出响应。系统响应的示例如图4所示。请点击此处查看该图的放大版本。
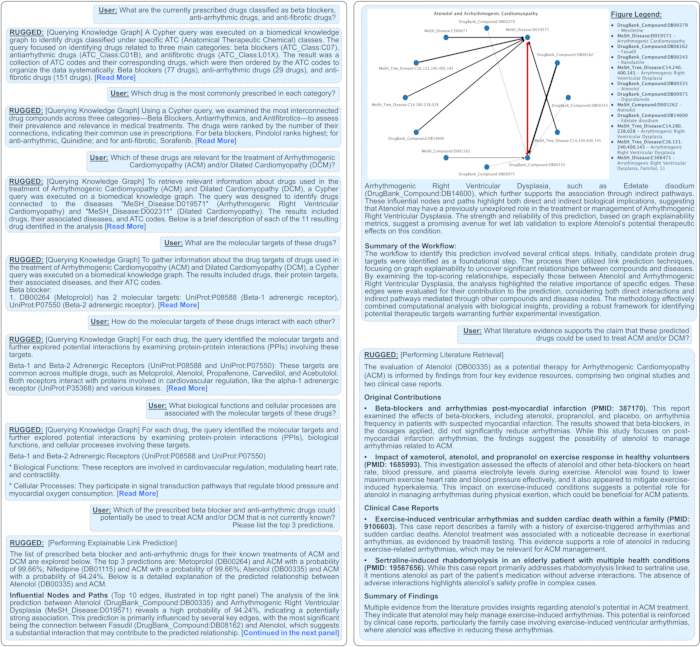
图4:心血管病理学应用案例:阐明心血管疾病(CVD)的发病机制。 展示了用户与RUGGED系统之间的查询-响应对。在左上方面板中,问题1-6通过从知识图谱数据库中提取信息,生成基于证据的响应。问题7采用可解释的图谱链接预测方法,识别得分最高的潜在治疗手段。该查询触发预测分析,由系统自动执行和处理,并对关键发现进行简明总结。问题8评估从定义的文本数据语料库中检索到的相关文献证据,以验证、确认和佐证预测结果。系统响应已通过人工参与的审查流程进行审核,并为提高可读性和简洁性进行了修改。这些发现的完整记录详见补充文件1。请点击此处查看该图的放大版本。
| 步骤 | 描述 | 时间 |
| 获取生物医学知识 | 总计30% | |
| 准备生物医学文献语料库 | 连接至PubMed和PubMed Central,下载并解析出版物数据以用于下游任务。 | 20% |
| 准备知识库数据 | 连接至生物医学知识库,下载并解析下游任务所需的信息。 | 5% |
| 信息提取 | 总计30% | |
| CaseOLAP LIFT文本挖掘分析 | 在生物医学文本语料库中识别高层次的疾病-蛋白质关系。 | 25% |
| 知识图谱构建 | 整合来自不同生物医学知识库的信息,构建统一的知识图谱。 | 5% |
| 预测分析 | 总计10% | |
| 训练图神经网络 | 利用生物医学知识图谱数据训练模型,以学习图中的潜在模式。 | 5% |
| 相关性排序分析 | 应用可解释性模块,突出显示与研究疾病最相关的节点和边。 | 2.5% |
| 链接预测 | 利用可解释性模块识别对新预测边有贡献的关键节点和边。 | 2.5% |
| 假设生成和/或验证 | 总计30% | |
| 用于检索增强生成的数据库设置 | 初始化图数据库以查询知识图谱,并初始化向量数据库以进行文本检索。 | 25% |
| 假设探索 | 支持用户与RUGGED交互,访问和审查相关信息以进行假设探索。 | 5% |
表1:工作流程与限速步骤。 本表提供了完成工作流程各阶段所需计算时间的粗略估计。限速步骤包括获取、提取和索引用于检索增强生成的生物医学知识。假设探索可连续重复进行,无需重新执行限速步骤。
| 疾病类别 | MeSH 树编号 | # PMIDs | # 原创性研究 | # 综述文章 |
| 心肌病(CM) | C14.280.238 | 132,531 | 102,337 | 19,942 |
| C14.280.434 | ||||
| 心律失常(ARR) | C14.280.067 | 125,286 | 92,374 | 13,854 |
| C23.550.073 | ||||
| 先天性心脏病(CHD) | C14.280.400 | 82,006 | 54,023 | 6,379 |
| 心脏瓣膜病(VD) | C14.280.484 | 72,016 | 50,119 | 5,743 |
| 心肌缺血(IHD) | C14.280.647 | 256,986 | 210,042 | 30,223 |
| 心脏传导系统疾病(CCD) | C14.280.123 | 53,050 | 35,399 | 4,363 |
| 心室流出道梗阻(VOO) | C14.280.955 | 22,244 | 15,504 | 1,686 |
| 其他心脏病(OTH) | C14.280.195 C14.280.282 C14.280.383 C14.280.470 C14.280.945 C14.280.459 C14.280.720 | 114,085 | 77,302 | 11,799 |
| 总计 | 635,696 | 478,404 | 69,690 |
表2:生物医学文献统计信息。 本表列出了研究疾病类别及其对应的MeSH树编号,以及截至2024年5月从PubMed检索到的文献数量,这些文献构成文本挖掘的语料库。其中一部分出版物(包括原创性研究论文和综述文章)被索引至向量数据库中,供RUGGED在假设生成过程中进行检索。
| 类别 | 节点数量 | 边数量 | 数据来源 |
| 解剖结构 | 5,049 | 122,533 | Bgee, PubMed, MeSH, Uberon, |
| 生物过程 | 27,047 | 108,106 | 基因本体(Gene Ontology) |
| 细胞组分 | 4,057 | 52,238 | 基因本体(Gene Ontology) |
| 化合物 | 27,278 | 3,292,028 | DrugBank, MeSH, CTD, UMLS, KEGG, TTD, SIDER, Inxight Drugs, Hetionet, PathFX, MyChem.info |
| 疾病 | 21,938 | 311,773 | PubMed, MeSH, DisGeNET, SIDER, ClinVar, ClinGen, PharmGKB, MyDisease.info, PathFX, UMLS, OMIM, Mondo, DOID, KEGG |
| 药物类别 | 5,721 | 8,283 | ATC |
| 基因 | 29,810 | 943,419 | HGNC, GRNdb, KEGG, ClinVar, ClinGen, |
| 分子功能 | 11,151 | 47,086 | SMPDB, DisGENET, PharmGKB, MyGene.info |
| 通路 | 52,012 | 234,944 | 基因本体(Gene Ontology) |
| 蛋白质 | 20,740 | 1,074,809 | Reactome, KEGG, SMPDB |
| 反应 | 14,647 | 128,038 | UniProt, Reactome, TTD, SMPDB, STRING, HGNC |
| 小计 | 219,450 | 6,323,257 | Reactome |
| 文本挖掘关联 | 8 | 4,670 | |
| 总计 | 219,458 | 6,327,927 |
表3:知识图谱统计信息。 该表格详细列出了构建的Know2BIO知识图谱所包含的11个广泛的生物医学类别,这些类别通过文本挖掘分析和预测分析获得的额外边关系进行了丰富。最终生成的知识图谱及预测结果由Neo4j图数据库进行管理,供RUGGED在假设生成过程中检索使用。
| 准确率 | 精确率 | 召回率 | F1分数 | AUROC | AUPRC | |
| 验证集 | 0.7158 | 0.6639 | 0.8743 | 0.7547 | 0.8437 | 0.8637 |
| 测试集 | 0.703 | 0.6367 | 0.9455 | 0.761 | 0.8961 | 0.9094 |
表4:可解释性人工智能模型评估。 本表报告了使用双层图卷积神经网络进行知识图谱链接预测的评估指标。通过将图边划分为85%训练集、5%验证集和10%测试集来评估各项指标。准确率(Accuracy)表示正确分类预测所占的比例。精确率(Precision)表示在所有阳性预测中正确阳性预测所占的比例。召回率(Recall)衡量在实际阳性边中正确阳性预测所占的比例。F1分数(F1-score)是精确率和召回率的调和平均数,用于平衡这两个指标。AUROC评估模型区分阳性与阴性预测的能力。AUPRC量化在不同阈值下精确率与召回率之间的权衡关系。所有指标中,数值越高表示模型性能越好。
补充文件 1:本文件详细展示了 RUGGED 的完整模型响应,并与 GPT-4o 进行了对比。第 A 部分呈现了与 RUGGED 完整的人机交互过程,扩展了图 3中概述的查询链方法,并提供了比图 4中突出显示的摘要更完整的响应内容。第 B 部分在无检索条件下评估 GPT-4o 的响应与 RUGGED 的响应,评估属性包括精确性、深度、置信度评分、证据可靠性以及成本。请点击此处下载该文件。
讨论
RUGGED 协议利用具有最新信息的现代语言模型,使研究人员能够动态探索不断发展的生物医学领域并发现新知识。这种人机交互推动了一种创新流程,体现了机器(RUGGED)的高效性以及研究人员的专业知识与判断力。本协议应按照规定的顺序执行。第 1 步详细说明软件安装过程;第 2 步和第 3 步对于准备生物医学文献和资源至关重要,而 第 4 步则对这些信息进行索引,以支持检索增强生成及用户与大语言模型(LLM)系统的交互。耗时较长的步骤可并行或串行运行。例如,Neo4j 图谱的构建(第 4.2.2 步)可在预测分析(第 3 步)期间开始,而索引过程可在知识图谱构建(第 2.3 步)和文本挖掘(第 2.1 步)完成后启动。必须重复执行这些步骤,才能将中间结果最终转化为完整成果。尽管本协议旨在用于生物医学信息检索,但经过少量修改后,也可处理其他类型的文本和图数据,例如内部数据、临床记录或电子健康档案。数据格式化的具体细节见第 4.2 步。
该平台的运行依赖于多种技术的正确安装与相互连接,包括语言模型、图数据库和向量数据库(参见材料表)。为验证这些服务是否已正确安装并连接,GitHub 仓库中的 `test` 文件夹提供了测试脚本。外部服务可能产生费用,价格由供应商决定并可能变动。这些可选服务也存在本地部署的替代方案,仅需具备足够的计算资源即可运行。然而,这些替代方案可能会影响模型性能和/或使用便利性,因此在某些应用场景下可能不适用。
随着大语言模型(LLM)领域的快速发展,新的里程碑式模型和面向特定任务的模型正被定期发布。在本报告撰写之时,已针对具体任务选择了最合适的模型。用户可通过相应地更新配置文件来选择所使用的LLM(参见步骤1.3.2–1.3.4)。模型的选择取决于其与特定应用场景的相关性。例如,将专注于确保模型响应具有公平性、经过审查且不含仇恨言论的模型73,74,75,76,77,78引入该工作流程,对于伦理考量至关重要。此外,提示工程对于引导LLM表现出可靠且负责任的行为至关重要79,80,81,82。为RUGGED工作流程设计的提示已针对所采用的模型和当前应用场景进行了定制。若需针对不同的应用场景对提示进行微调,用户可在RUGGED工作流程的 `configuration` 文件夹内的 `prompts.json` 文件中编辑相应提示。
尽管RAG系统旨在通过将大语言模型(LLM)的响应建立在证据基础上以减少幻觉现象,但这些模型仍可能导致信息不准确,或生成普遍正确但缺乏具体性的回答。RUGGED与GPT-4o的基准对比结果见补充文件1的B部分。当检索到的信息超出模型的上下文窗口时,常会出现模型幻觉,这种情况类似于因记忆丢失而无法定位数据内容的痴呆症,从而导致回应不准确83,84,85。选择合适的LLM模型有助于缓解这一问题。例如,GPT-4o的上下文长度限制为128k个token,远高于GPT-3.5 Turbo的16k token限制,尽管其使用成本更高。此外,使用特定领域知识进行微调的LLM有望提高在生物医学应用中响应的准确性与特异性86,87,88。尽管采取了上述措施,在开展成本较高的湿实验之前,仍必须对所得信息进行交叉验证。
RUGGED 在 RAG 流程中利用可解释的人工智能技术来审阅链接预测,识别出可靠关系以及先前未发现的关联。传统 RAG 系统依赖基于整体相似性的检索,而该方法将可解释性与针对性的响应增强相结合。表 4 突出了模型的出色表现,显示出高召回率(验证集:0.975,测试集:0.976)和均衡的 F1 分数(验证集:0.796,测试集:0.797),表明模型在识别真阳性方面具有可靠性,尽管假阳性率相对较高。模型的稳健性进一步由其 AUROC(验证集:0.963,测试集:0.964)和 AUPRC(验证集:0.971,测试集:0.972)值所支持。然而,精确率(验证集:0.673,测试集:0.674)仍有提升空间,可通过阈值调优、引入更详细的节点特征或改进类别不平衡的处理方式来优化。模型的有效性高度依赖于输入知识图谱的质量;在较小图谱上存在过拟合风险,而较大图谱则需要更高的计算资源。然而,任何基于 RAG 的方法都严重依赖于检索所依据数据的质量。例如,由于原始图谱中固有的噪声,构建知识图谱通常耗时且劳动密集。这需要人工进行去噪和标注,同时数据库的维护与更新也带来持续的成本。
RUGGED 的主要用途在于知识整合与假设探索。通过研究各种潜在关系(如疾病机制和药物治疗),RUGGED 能够高效地进行文献筛选。为减轻计算负担,大多数应用可部署在服务器(例如 AWS 或计算服务器)上,并配置为定期更新以获取最新信息。此外,该工作流程可进行调整以实现特定领域的应用,例如作为整合患者数据与本地模型的平台,以保障安全性、隐私性和保密性。除生物医学研究外,RUGGED 的模块化设计使其能够通过定制面向目标领域的 RAG 管道和提示工程策略,支持信息检索、推理和摘要生成等任务。成功实现适应性扩展需要仔细考虑特定领域的挑战,例如多样化数据格式的预处理,以及针对任务和领域需求选择合适的模型。
披露
作者无任何利益冲突需要披露。
致谢
作者谨感谢 Alex Bui 博士提供的指导和富有见地的讨论。此外,感谢 Ding Wang 博士的有益交流。本研究部分由美国国立卫生研究院(NIH)资助项目 1U54HG012517-01(资助对象:P.P.、K.W. 和 W.W.);NIH T32 HL13945(资助对象:A.R.P.);美国国家科学基金会研究培训项目(NRT)1829071(资助对象:A.R.P.);以及加州大学洛杉矶分校(UCLA)的 TC Laubisch 基金(资助对象:P.P.)支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 硬件/软件 - 显卡及驱动程序 | Nvidia | https://www.nvidia.com | 强烈推荐使用显卡及其配套的驱动软件,以显著缩短计算密集型任务(如本地大语言模型和预测分析)的运行时间。对于配备 NVIDIA RTX GPU 的设备,请从 NVIDIA 官网(https://developer.nvidia.com/cuda-downloads)下载并安装必要的驱动程序和 CUDA 工具包。 |
| 软件 - 商用大语言模型服务 | OpenAI | https://openai.com | RUGGED 支持 OpenAI API,包括 GPT-3.5 和 GPT-4o 等模型。若要使用 OpenAI 模型,首先需获取 OpenAI API 密钥。请访问 OpenAI 官网(https://openai.com/blog/openai-api)注册账户、充值并获取 API 密钥。该 API 密钥是启用 RUGGED 使用 OpenAI 模型所必需的。请根据其文档(https://platform.openai.com/docs/models)确定 RUGGED 系统中哪些 LLM 代理将使用 OpenAI 模型。 注意:OpenAI API 为付费服务。在本文发表时,GPT-4o 的使用费用为每百万输入 token 5.00 美元,每百万输出 token 2.50 美元(更多详情请访问 https://openai.com/pricing)。 |
| 软件 - 容器化技术 | Docker | https://www.docker.com | Docker 有助于保持一致的计算运行环境,简化在不同机器上的软件安装与执行流程。要安装 Docker,请访问 Docker 官网(https://www.docker.com/),点击“开始使用”,下载并安装适用于操作系统的版本。在终端中输入 `docker --version` 以验证安装;若成功安装,将显示已安装的 Docker 版本。 |
| 软件 - 图数据库 | Neo4j | https://neo4j.com | Neo4j 是一种图数据库软件,可高效管理和查询基于图的节点与关系。RUGGED 支持多种形式的 Neo4j:Docker 容器、Neo4j Desktop 或 Neo4j AuraDB 在线服务器。请根据具体应用场景选择最合适的选项。 将 Neo4j 配置为 Docker 容器。运行以下命令在 Docker 中设置 Neo4j,其中文件夹路径(例如 /Users/username/RUGGED)用 'PATH_TO_FOLDER' 表示。有关故障排除的更多详情,请参阅 Neo4j Docker 官网(https://hub.docker.com/_/neo4j)。 docker pull neo4j docker run –name neo4j --net rugged_network --publish=7474:7474 --publish=7687:7687 -d -v 'PATH_TO_FOLDER'\neo4j\data:/data neo4j 注意:首次在 Docker 中初始化 Neo4j 时需设置用户名和密码。可通过运行 neo4j_setup.py 脚本(例如 python neo4j_setup.py)或通过 http://localhost:7474 的网页界面完成初始化。 配置 Neo4j Desktop。若使用 Neo4j Desktop,请从 Neo4j 官网(https://neo4j.com/)下载并安装。点击“新建”创建新项目,然后点击“添加”创建新的数据库管理系统(DBMS)。选择“本地 DBMS”,设置密码,点击“创建”,然后点击“启动”。“ACTIVE”显示为绿色表示正在运行。"""""""""""" 配置 Neo4j AuraDB。访问 Neo4j 官网(https://neo4j.com/cloud/aura-free/)创建账户并登录。选择“新建实例”以创建一个空实例,并保存用于访问 bolt 接口的 URI 和初始密码(例如 bolt://myurl.neo4j.com)。点击播放按钮启动实例,信息框中将显示连接 URI。"" 注意:Neo4j AuraDB 提供免费层级,最多支持 200,000 个节点和 400,000 个关系。对于更大规模的图,请访问 Neo4j 定价页面(https://neo4j.com/pricing)。 |
| 软件 - 本地大语言模型服务 | Ollama | https://ollama.com | RUGGED 支持使用 Ollama 运行本地模型(例如 Llama3)。要启用此功能,首先需在设备上安装 Ollama 或下载其 Docker 容器。要安装 Ollama,请访问 Ollama 官网(https://ollama.com/download)并按照安装说明操作。要在 Docker 中安装 Ollama,请运行以下命令: docker pull ollama/ollama 注意:在本文发表时,Ollama 尚未发布适用于 Windows 操作系统的稳定版本。 |
| 软件 - 版本控制 | Git | https://www.git-scm.com | 版本控制软件可实现软件的高效安装与更新。要安装 Git,请访问 Git 官网(https://www.git-scm.com/),点击“下载”,下载并安装适用于操作系统的版本。在终端中输入 `git --version` 以验证安装;若成功安装,将显示已安装的 Git 版本。 |
参考文献
- Wooller, S. K., Benstead-Hume, G., Chen, X., Ali, Y., Pearl, F. M. G. Bioinformatics in translational drug discovery. Biosci Rep. 37 (4), BSR20160180(2017).
- Sadybekov, A. V., Katritch, V. Computational approaches streamlining drug discovery. Nature. 616 (7958), 673-685 (2023).
- Himmelstein, D. S., et al. Systematic integration of biomedical knowledge prioritizes drugs for repurposing. eLife. 6, e26726(2017).
- Gutiérrez-Sacristán, A., et al. Text mining and expert curation to develop a database on psychiatric diseases and their genes. Database (Oxford). 2017, bax043(2017).
- Pelletier, A. R., et al. A knowledge graph approach to elucidate the role of organellar pathways in disease via biomedical reports. J Vis Exp. (200), e65084(2023).
- Santos, A., et al. A knowledge graph to interpret clinical proteomics data. Nat Biotechnol. 40 (5), 692-702 (2022).
- Zheng, S., et al. PharmKG: A dedicated knowledge graph benchmark for bomedical data mining. Briefings in Bioinformatics. 22 (4), bbaa344(2021).
- Soman, K., et al. Biomedical knowledge graph-optimized prompt generation for large language models. Bioinformatics. 40 (9), btae560(2023).
- Xiao, Y., et al. Know2BIO: A comprehensive dual-view benchmark for evolving biomedical knowledge graphs. ArXiv. , (2023).
- Thirunavukarasu, A. J., et al. Large language models in medicine. Nat Med. 29 (8), 1930-1940 (2023).
- Lehman, E., et al. Do we still need clinical language models. ArXiv. , (2023).
- Singhal, K., et al. Large language models encode clinical knowledge. Nature. 620, 172-180 (2022).
- Agrawal, M., Hegselmann, S., Lang, H., Kim, Y., Sontag, D. Large language models are few-shot clinical information extractors. ArXiv. , (2022).
- Johnson, D., et al. Assessing the accuracy and reliability of AI-generated medical responses: An evaluation of the Chat-GPT model. Res Sq. , (2023).
- Evaluation of ChatGPT on biomedical tasks: A zero-shot comparison with fine-tuned generative transformers. Jahan, I., Laskar, M. T. R., Peng, C., Huang, J. The 22nd Workshop on Biomedical Natural Language Processing and BioNLP Shared Tasks, , 326-336 (2023).
- Samaan, J. S., et al. Assessing the accuracy of responses by the language model ChatGPT to questions regarding bariatric surgery. Obes Surg. 33 (6), 1790-1796 (2023).
- Thirunavukarasu, A. J., et al. Trialling a large language model (ChatGPT) in general practice with the applied knowledge test: observational study demonstrating opportunities and limitations in primary care. JMIR Med Educ. 9, e46599(2023).
- Sun, W., et al. Is ChatGPT Good at search? Investigating large language models as re-ranking agents. ArXiv. , (2023).
- Xu, R., Feng, Y., Chen, H. ChatGPT vs. Google: A comparative study of search performance and user experience. ArXiv. , (2023).
- TruthfulQA: Measuring how models mimic human falsehoods. Lin, S., Hilton, J., Evans, O. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers, , 3214-3252 (2022).
- Manakul, P., Liusie, A., Gales, M. J. F. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. ArXiv. , (2023).
- FActScore: Fine-grained atomic evaluation of factual precision in long form text generation. Min, S., et al. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, , 12076-12100 (2023).
- Zhang, J., et al. Is ChatGPT fair for recommendation? Evaluating fairness in large language model recommendation. Proceedings of the 17th ACM Conference on Recommender Systems. , 993-999 (2023).
- Sankar, B. S., et al. Building an ethical and trustworthy biomedical AI ecosystem for the translational and clinical integration of foundation models. Bioengineering. 11 (10), 984(2024).
- Shen, Y., et al. ChatGPT and Other large language models are double-edged swords. Radiology. 307 (2), e230163(2023).
- Li, H., et al. Ethics of large language models in medicine and medical research. Lancet Digit Health. 5 (6), e333-e335 (2023).
- Lewis, P., et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. ArXiv. , (2020).
- Gao, Y., et al. Retrieval-augmented generation for large language models: A survey. ArXiv. , (2023).
- Wei, C. -H., Allot, A., Leaman, R., Lu, Z. PubTator central: Automated concept annotation for biomedical full text articles. Nucleic Acids Res. 47 (W1), W587-W593 (2019).
- Wei, C. -H., et al. PubTator 3.0: An AI-powered literature resource for unlocking biomedical knowledge. ArXiv. , (2024).
- Comparative Reasoning for knowledge graph fact checking. Liu, L., Ji, H., Xu, J., Tong, H. 2022 IEEE International Conference on Big Data (Big Data), , 2309-2312 (2022).
- Knowledge Graph reasoning and its applications. Liu, L., Tong, H. Proceedings of the 29th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, , 5813-5814 (2023).
- Liu, L., et al. Logic query of thoughts: Guiding large language models to answer complex logic queries with knowledge graphs. ArXiv. , (2024).
- Barack's wife hillary: Using Knowledge graphs for fact-aware language modeling. Logan, R., Liu, N. F., Peters, M. E., Gardner, M., Singh, S. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, , 5962-5971 (2019).
- Sun, J., et al. Think-on-graph: Deep and responsible reasoning of large language model on knowledge graph. ArXiv. , (2024).
- Wen, Y., Wang, Z., Sun, J. MindMap: Knowledge Graph prompting sparks graph of thoughts in large language models. ArXiv. , (2024).
- Wang, C., Liu, X., Song, D. Language models are open knowledge graphs. ArXiv. , (2020).
- QA-GNN: Reasoning with Language Models and Knowledge Graphs for Question Answering. Yasunaga, M., Ren, H., Bosselut, A., Liang, P., Leskovec, J. Proceedings of the 2021 Conference of the North American Chapter of the, , 535-546 (2021).
- SimKGC: Simple contrastive knowledge graph completion with pre-trained language models. Wang, L., Zhao, W., Wei, Z., Liu, J. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers, , 4281-4294 (2022).
- Lazar, A. Graph neural networks for link prediction. FLAIRS. 36, (2023).
- Zhang, M., Chen, Y. Link prediction based on graph neural networks. ArXiv. , (2018).
- XGNN: Towards model-level explanations of graph neural networks. Yuan, H., Tang, J., Hu, X., Ji, S. Proceedings of the 26th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, , (2020).
- CFGExplainer: Explaining graph neural network-based malware classification from control flow graphs. Herath, J. D., Wakodikar, P., Yang, P., Yan, G. 2022 52nd Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN), , 172-184 (2022).
- Ying, R., Bourgeois, D., You, J., Zitnik, M., Leskovec, J. GNNExplainer: Generating explanations for graph neural networks. Adv Neural Inf Process Syst. 32, 9240-9251 (2019).
- Bastian, F. B., et al. The Bgee suite: Integrated curated expression atlas and comparative transcriptomics in animals. Nucleic Acids Res. 49 (D1), D831-D847 (2021).
- Davis, A. P., et al. Comparative Toxicogenomics Database (CTD): Update 2023. Nucleic Acids Res. 51 (D1), D1257-D1262 (2023).
- Rehm, H. L., et al. ClinGen - The clinical genome resource. N Engl J Med. 372 (23), 2235-2242 (2015).
- Landrum, M. J., et al. ClinVar: Improvements to accessing data. Nucleic Acids Res. 48 (D1), D835-D844 (2020).
- Schriml, L. M., et al. The human disease ontology 2022 update. Nucleic Acids Res. 50 (D1), D1255-D1261 (2022).
- Piñero, J., Saüch, J., Sanz, F., Furlong, L. I. The DisGeNET cytoscape app: Exploring and visualizing disease genomics data. Comput Struct Biotechnol J. 19, 2960-2967 (2021).
- Knox, C., et al. DrugBank 6.0: The DrugBank knowledgebase for 2024. Nucleic Acids Res. 52 (D1), D1265-D1275 (2024).
- Fang, L., et al. GRNdb: Decoding the gene regulatory networks in diverse human and mouse conditions. Nucleic Acids Res. 49 (D1), D97-D103 (2021).
- Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 49 (D1), D325-D334 (2021).
- Seal, R. L., et al. Genenames.org: The HGNC resources in 2023. Nucleic Acids Res. 51 (D1), D1003-D1009 (2023).
- Siramshetty, V. B., et al. NCATS Inxight Drugs: A comprehensive and curated portal for translational research. Nucleic Acids Res. 50 (D1), D1307-D1316 (2022).
- Kanehisa, M., Furumichi, M., Tanabe, M., Sato, Y., Morishima, K. KEGG: New perspectives on genomes, pathways, diseases and drugs. Nucleic Acids Res. 45 (D1), D353-D361 (2017).
- Lipscomb, C. E. Medical Subject Headings (MeSH). Bull Med Libr Assoc. 88 (3), 265-266 (2000).
- Vasilevsky, N. A., et al. Mondo: Unifying diseases for the world, by the world. medRxiv. , (2022).
- Lelong, S., et al. BioThings SDK: A toolkit for building high-performance data APIs in biomedical research. Bioinformatics. 38 (7), 2077-2079 (2022).
- Amberger, J. S., Bocchini, C. A., Scott, A. F., Hamosh, A. OMIM.org: Leveraging knowledge across phenotype-gene relationships. Nucleic Acids Res. 47 (D1), D1038-D1043 (2019).
- Wilson, J. L., et al. PathFX provides mechanistic insights into drug efficacy and safety for regulatory review and therapeutic development. PLoS Comput Biol. 14 (12), e1006614(2018).
- Gong, L., Whirl-Carrillo, M., Klein, T. E. PharmGKB, an Integrated resource of pharmacogenomic knowledge. Curr Protoc. 1 (8), e226(2021).
- Gillespie, M., et al. The reactome pathway knowledgebase 2022. Nucleic Acids Res. 50 (D1), D687-D692 (2022).
- Kuhn, M., Letunic, I., Jensen, L. J., Bork, P. The SIDER database of drugs and side effects. Nucleic Acids Res. 44 (D1), D1075-D1079 (2016).
- Jewison, T., et al. SMPDB 2.0: Big improvements to the small molecule pathway database. Nucleic Acids Res. 42 (Database issue), D478-D484 (2014).
- Szklarczyk, D., et al. STRING v11: Protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 47 (D1), D607-D613 (2019).
- Zhou, Y., et al. Therapeutic target database update 2022: Facilitating drug discovery with enriched comparative data of targeted agents. Nucleic Acids Res. 50 (D1), D1398-D1407 (2022).
- Bodenreider, O. The Unified Medical Language System (UMLS): Integrating biomedical terminology. Nucleic Acids Res. 32 (Database issue), D267-D270 (2004).
- Haendel, M. A., et al. Unification of multi-species vertebrate anatomy ontologies for comparative biology in Uberon. J Biomed Semantics. 5, 21(2014).
- UniProt Consortium. UniProt: the Universal Protein Knowledgebase in 2023. Nucleic Acids Res. 51 (D1), D523-D531 (2023).
- Denoising sequence-to-sequence pre-training for natural language generation, translation, and comprehension. Lewis, M., et al. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, , 7871-7880 (2020).
- Sigdel, D., et al. Cloud-based phrase mining and analysis of user-defined phrase-category association in biomedical publications. J Vis Exp. (144), e59108(2019).
- Ferrara, E. Should ChatGPT be biased? Challenges and risks of bias in large language models. FM. ArXiv. , (2023).
- Gallegos, I. O., et al. Bias and fairness in large language models: A Survey. ArXiv. , (2023).
- Hosseini, M., Horbach, S. P. J. M. Fighting reviewer fatigue or amplifying bias? Considerations and recommendations for use of ChatGPT and other large language models in scholarly peer review. Res Integr Peer Rev. 8 (1), 4(2023).
- Kotek, H., Dockum, R., Sun, D. Gender bias and stereotypes in Large Language Models. Proceedings of The ACM Collective Intelligence Conference, , 12-24 (2023).
- Kamruzzaman, M., Kim, G. L. Prompting techniques for reducing social bias in LLMs through System 1 and System 2 Cognitive Processes. ArXiv. , (2024).
- Raza, S., Raval, A., Chatrath, V. MBIAS: Mitigating bias in large language models while retaining context. ArXiv. , (2024).
- Chen, B., Zhang, Z., Langrené, N., Zhu, S. Unleashing the potential of prompt engineering in Large Language Models: A comprehensive review. ArXiv. , (2023).
- White, J., et al. A prompt pattern catalog to enhance prompt engineering with ChatGPT. ArXiv. , (2023).
- Meskó, B. Prompt engineering as an important emerging skill for medical professionals: Tutorial. J Med Internet Res. 25, e50638(2023).
- Wang, J., et al. Prompt Engineering for Healthcare: Methodologies and applications. ArXiv. , (2023).
- Luo, Y., et al. An empirical study of catastrophic forgetting in large language models during continual fine-tuning. ArXiv. , (2023).
- Xu, P., et al. Retrieval meets Long Context Large Language Models. ArXiv. , (2023).
- Chen, S., Wong, S., Chen, L., Tian, Y. Extending context window of Large Language Models via positional interpolation. ArXiv. , (2023).
- Labrak, Y., et al. BioMistral: A collection of open-source pretrained large language models for medical domains. ArXiv. , (2024).
- Luo, R., et al. BioGPT: Generative pre-trained transformer for biomedical text generation and mining. Brief Bioinform. 23 (6), bbac409(2022).
- Wang, C., et al. A survey for large language models in biomedicine. ArXiv. , (2024).
重印与许可
