本方案概述了利用通过Python脚本结合宏函数自动生成的数据集,构建用于焊接模拟的人工神经网络的一般工作流程。该工作流程通过单道直线焊接的基准案例进行了验证。代理模型的预测精度与有限元模拟结果表现出高度一致。
本文内容
摘要
摘要
制造业广泛依赖焊接工艺来连接材料,从而在各个领域形成关键部件。诸多因素会影响焊缝质量,并最终影响焊接接头的结构完整性。焊接过程中因热循环而产生的残余应力,会显著影响焊接构件的结构完整性和服役性能。理解和预测此类残余应力对于提高焊接结构的可靠性与耐久性至关重要。然而,在数字实验中快速评估焊接配置面临重大挑战,因为传统仿真可能耗时较长。本研究提出一种工作流程,用于构建基于人工神经网络的替代模型,以预测焊接诱导的残余应力。该模型通过基于宏函数的 Python 脚本自动从有限元仿真中生成的数据构建而成。与依赖人工预处理和有限元仿真的传统方法不同,该方法显著减少了仿真设置和数据提取所需的时间与工作量,提高了整体效率。通过宏函数确保所有仿真步骤的一致执行,该方法消除了人为引入的变异性,从而提升了可重复性。此外,数据生成的自动化使得构建机器学习模型训练所需的大量数据集成为可能,克服了传统技术劳动密集型的局限性。该工作流程包含四个主要步骤:建立标准焊接有限元仿真模型,并将有限元仿真结果与实验数据进行验证;开发用于大规模数据集生成的脚本,该脚本基于记录有限元仿真前后处理步骤的宏函数;利用脚本生成所需数据;构建替代模型并测试其性能。人工神经网络在预测应力水平方面表现出高精度,在测试数据集上的预测结果与仿真结果高度一致,相对均方根误差为 0.0024。
引言
在进行焊接实践的数字实验时,残余应力是一个关键结果,因为它是结构完整性评估中的一个重要方面。焊接引起的残余应力是由高温、快速冷却以及焊接过程中由此产生的非均匀热梯度和机械约束共同作用所致1。即使内部温度梯度消退后,由于塑性变形和外部夹紧的作用,金属仍会保持应力。残余应力对构件的行为和性能具有显著影响,特别是那些承受循环载荷或高应力的构件。它可能导致裂纹2,3,并影响整体的疲劳寿命4。
为了提高焊接残余应力分布表征的可靠性,诸如欧洲结构完整性中子技术标准化网络(European Network on Neutron Techniques Standardization for Structural Integrity, NeT)5等研究团队开展了一系列比对实验活动,针对不同的焊接场景进行了实验研究,并实施了有限元(FE)模拟,例如单道堆焊6和多道填缝焊7,8。多种实验测量技术被用于量化焊接引起的残余应力,包括中子衍射9、轮廓法、X射线衍射、深孔钻法10和增量中心孔钻法11。除了实验测量外,有限元模拟也被用于重构残余应力场。Gilles 等人12在有限元模型中采用表面热源模型模拟堆焊过程,并对网格设计和热源模型进行了敏感性分析。Shan 等人13开展了热-力顺序耦合分析,以预测焊后残余应力分布;他们采用移动热源模型结合单元生死技术来表征热流分布。Bate 等人14描述了如何在试样的简化二维模型上进行热源模型校准,以确保焊接热分析的可靠性。Coules 等人15提出了一种通过结合多个邻近区域的测量数据来重构不兼容区域残余应力场的方法。该论文强调了该方法在提高残余应力测量精度方面的潜力,特别是在目标区域无法直接测量的情况下。Bouchard6提出了堆焊模拟的基准案例,并定义了可用于评估焊接模拟方法的热场与残余应力性能目标。Smith 等人16综述了不同的焊接模拟建模方法,并对多个焊接模拟参数进行了敏感性分析,包括网格设计、热源特性、热输入量以及本构模型。模拟结果的准确性在很大程度上取决于分析人员的假设与简化。此外,先前发表的论文中一些模拟设置的细节常被忽略,导致模拟难以复现。
除了有限元模拟外,还实施了一系列用于应力预测的机器学习算法,包括模糊神经网络17、支持向量回归18,19,20、自适应神经模糊推理系统21,22以及人工神经网络23。与有限元分析相比,使用预训练的机器学习算法可显著缩短应力预测所需的时间。替代模型的开发无需基于数学和物理建模并求解微分方程,而是直接建立输入与输出之间的关系。然而,这种数据驱动的方法通常需要大量训练数据。尽管存在这一需求,目前仍缺乏详细阐述如何自动化生成此类数据过程的公开研究。
本研究的总体目标是建立一个简化的流程,以实现从有限元仿真中自动生数据,并利用生成的数据训练基于机器学习的代理模型(如人工神经网络,ANN),用于预测复杂物理过程中的关键结果。图1展示了一个高层次的流程图,概括了该流程中的各个步骤。本文提供了在 Abaqus 中进行热-力耦合焊接仿真的全部设置。通过使用宏记录功能,有限元仿真中的所有前处理和后处理操作均被记录为脚本,从而实现了数据生成过程的自动化。本文还描述了如何利用生成的数据训练人工神经网络代理模型。
方案
1. 构建并记录标准模型
- 打开 Abaqus,点击 文件 > 设置工作目录 以设定工作目录。点击 文件 > 宏管理器 > 工作,创建一个名为 Thermal_recording 的工作宏。
- 按以下说明进行热分析设置。
- 创建焊接试样的模型。此处以单道焊珠-板结构的基准案例为例;矩形基板、焊珠及网格细化区域的尺寸见表1。
- 点击 部件 > 创建部件。在 XY 平面上绘制一个正方形草图,并根据表1中给出的几何参数拉伸,创建试样的三维可变形半模型。
- 点击 部件 > 创建基准平面:从主平面偏移。根据表1中给出的焊珠长度,通过指定相对于 YZ 平面的偏移量,创建两个基准平面,用于定义焊接的起始点和终点。根据表1中给出的焊珠深度和宽度,通过指定相对于 XY 平面和 XZ 平面的偏移量,创建两个基准平面,用于定义焊接的焊珠深度和宽度。焊珠位于顶面中心,其长度方向与试样纵向对齐。
- 点击 部件 > 单元分割:使用基准平面。使用步骤 1.2.1.2 中创建的四个基准平面,对试样进行单元分割。
- 点击 部件 > 创建切割:拉伸。在已创建的某个基准平面上,通过指定一段圆弧(arc-1)和两条直线,绘制焊珠位于试样顶面以下部分的草图。焊珠的尺寸见表1。通过拉伸该草图,创建深度等于焊珠长度的切割。
- 点击 部件 > 创建实体:拉伸。在已创建的某个基准平面上,通过指定两条圆弧(arc-1 和 arc-2)和一条直线,绘制焊珠的草图。选择保留内部边界,并按焊珠长度拉伸该草图以创建焊珠实体。
- 点击 部件 > 创建基准平面:从主平面偏移。根据网格细化区域的几何参数,创建四个基准平面,用于定义精细网格区域。精细网格区域位于试样顶部中心。
- 点击 部件 > 单元分割:使用基准平面。使用步骤 1.2.1.6 中创建的四个基准平面,对试样进行单元分割。
- 在“属性”模块中根据表2定义不锈钢 AISI 316LN 的材料属性。
- 点击 属性 > 创建材料。在“通用”菜单中定义密度。在“热”菜单中使用温度相关数据定义导热系数和比热容。
- 按以下说明为模型分配材料。
- 点击 属性 > 创建截面。使用步骤 1.2.2 中定义的材料创建一个均质实体截面。
- 点击 属性 > 分配截面。使用步骤 1.2.3.1 中定义的截面对模型进行分配。
- 在“分析步”模块中按以下说明定义分析步。
- 点击 分析步 > 创建分析步。创建一个热传递分析步(不考虑几何非线性),命名为 welding,时间周期为 26.43,时间增量固定为 0.1。
- 创建一个热传递分析步(不考虑几何非线性),命名为 Cooling-1,时间周期为 70,时间增量自适应,初始、最小和最大增量分别为 0.1、0.05 和 5。
- 创建一个热传递分析步(不考虑几何非线性),命名为 Cooling-2,时间周期为 2000,时间增量自适应,初始、最小和最大增量分别为 5、1 和 100。
注:冷却分析步的时间跨度选择对模拟至关重要,应由分析人员仔细确定。
- 按以下说明设置模型属性。
- 点击 模型 > 编辑属性。将绝对零度温度设为 -273.15。将斯特藩-玻尔兹曼常数设为 5.67E-11。
- 点击 分析步> 创建场输出,为整个模型设置节点温度输出请求。点击 装配 > 创建实例,创建一个从属实例。
- 在“相互作用”模块中创建相互作用。
- 点击 相互作用 > 创建相互作用 > 表面膜条件。在模型所有表面(对称面除外)上创建表面膜条件相互作用,膜系数为 15,介质温度为 20。将起始分析步设为 welding。
- 点击 相互作用 > 创建相互作用 > 表面辐射。在模型所有表面(对称面除外)上创建表面辐射相互作用,发射率为 0.7,环境温度为 20。将起始分析步设为 welding。
- 在“载荷”模块中定义载荷。
- 点击 载荷 > 创建载荷 > 热 > 体积热流。从 welding 分析步创建用户自定义的体积热流载荷,并在两个冷却分析步中将其设为非活动状态。
- 点击 载荷 > 创建预设场 > 其他 > 场。创建一个从初始步开始的预设温度场,表示 20 的室温。
- 在网格模块中按以下说明创建网格。
注:单元类型、全局网格尺寸和精细网格尺寸应根据每次分析的具体要求确定。- 点击 网格 > 对象:部件 > 部件播种。以 0.0024 的全局尺寸对部件进行网格播种。点击 网格 > 边播种。以数量 3 对焊珠深度和宽度的边进行播种。
- 以数量 3 对 arc-2 的边进行播种。以尺寸 0.0015 对焊珠长度的边进行播种。
- 点击 网格 > 指定网格控制。在焊珠区域使用四面体单元和自由划分技术。点击 网格 > 指定单元类型。将单元类型设为 DC3D10 并划分部件网格。
- 点击 网格 > 边播种。在精细网格区域内,对与 X 轴共线的边以 0.0015 的尺寸进行播种;对与 Y 轴共线的边以 0.0011 的尺寸进行播种;对与 Z 轴共线的边以 0.00075 的尺寸进行播种。
- 点击 网格 > 指定网格控制。为其余区域指定网格控制。使用六面体单元和扫掠技术。点击 网格 > 指定单元类型。将单元类型设为 DC3D20 并划分部件网格。
- 点击 作业 > 创建作业。创建一个名为 Thermal_analysis 的作业,并附加 DFLUX 用户子程序。
- 停止宏录制。工作目录中将生成一个名为 Thermal_recording.py 的 Python 文件。
- 点击 作业 > 作业管理器 > 提交。提交作业。将生成一个名为 Thermal_analysis.odb 的结果文件。
- 创建焊接试样的模型。此处以单道焊珠-板结构的基准案例为例;矩形基板、焊珠及网格细化区域的尺寸见表1。
- 点击 文件 > 宏管理器 > 工作。打开宏管理器,创建一个名为 Mechanical_recording 的工作宏。
- 按以下说明进行力学分析设置。
- 重复步骤 1.2.1,创建焊缝试样的模型几何。
- 在属性模块中根据表2和表3定义不锈钢 AISI 316LN 的材料属性。
- 点击 属性 > 创建材料。在“通用”菜单中定义密度。在“力学”菜单中使用温度相关数据定义弹性属性。
- 在“力学”菜单中使用温度相关数据定义塑性属性。选择组合硬化模型,并选择参数类型为数据。将背应力数量和场变量数量分别设为 2 和 0。
- 添加退火温度子选项。将退火温度设为 1050。在“力学”菜单中使用温度相关数据定义各向同性膨胀。
- 重复步骤 1.2.3,为模型分配材料。
- 在“分析步”模块中按以下说明定义分析步。
- 点击 分析步 > 创建分析步。创建一个静态分析步(考虑几何非线性),用于焊接,时间周期为 26.43,时间增量固定为 0.1。
- 创建一个静态分析步(考虑几何非线性),用于 Cooling-1,时间周期为 70,时间增量自适应,初始、最小和最大增量分别为 0.1、0.05 和 5。
- 创建一个静态分析步(考虑几何非线性),用于 Cooling-2,时间周期为 2000 s,时间增量自适应,初始、最小和最大增量分别为 5、1 和 100。
- 点击 分析步 > 创建场输出。为整个模型设置应力分量和不变量输出请求。点击 装配 > 创建实例。创建一个从属实例。
- 按以下说明设置边界条件。
- 点击 载荷 > 创建边界条件 > 力学 > 位移/转角。将对称面上且位于顶面的左侧顶点约束在 U1 和 U3 方向。
- 将对称面上且位于顶面的右侧顶点约束在 U3 方向。
- 点击 载荷 > 创建边界条件 > 力学 > 对称/反对称/固支。将对称条件施加到对称面上。
- 按以下说明设置预设场。
- 点击 载荷 > 创建预设场。创建一个从初始步开始的预设温度场,表示 20 的室温。
- 创建一个从 welding 分析步开始的预设温度场。分布资源来自结果或输出数据库文件。将根目录设为步骤 1.2.12 中生成的结果文件,并将起始分析步、起始增量和结束分析步分别设为 1、1、1。
- 创建一个从 Cooling-1 分析步开始的预设温度场。分布资源来自结果或输出数据库文件。将根目录设为步骤 1.2.12 中生成的结果文件,并将起始分析步、起始增量和结束分析步分别设为 2、1、2。
- 创建一个从 Cooling-2 分析步开始的预设温度场。分布资源来自结果或输出数据库文件。将根目录设为步骤 1.2.12 中生成的结果文件,并将起始分析步、起始增量和结束分析步分别设为 3、1、3。
- 重复步骤 1.2.9,但将单元类型指定为 C3D8R。创建一个名为 Mechanical_analysis 的作业。停止宏录制。工作目录中将生成一个名为 Mechanical_recording.py 的 Python 文件。
- 提交作业。将生成一个名为 Mechanical_analysis.odb 的结果文件。
- 按以下说明进行后处理。
注:在后处理阶段,提取物理场结果并与实验结果进行比较。具体提取过程取决于可用的实验数据。本研究展示了温度场、熔合边界和应力场的提取,这些结果可分别与热电偶读数、焊珠形貌测量和残余应力数据进行对比。详细的对比结果见相关出版物24。- 按以下说明提取热分析结果。
- 点击 文件 > 打开数据库。打开 Thermal_analysis.odb。点击 插件 > 工具 > 查找最近节点。使用插件中的查找最近节点工具,查找热电偶 5 和热电偶 9 的节点标签。
注:热电偶 5 位于试样顶面与中截面交线处,距离对称面 11.5 mm。热电偶 9 位于底面、对称面和中截面的交点处。 - 点击 可视化 > 创建 XY 数据 > ODB 场输出。提取唯一的节点温度历史数据。
- 点击 可视化 > 激活/取消激活视图切割。激活 X 平面的切割视图。调整帧选择器,并在熔合边界达到最大时捕获熔合截面。
- 点击 文件 > 打开数据库。打开 Thermal_analysis.odb。点击 插件 > 工具 > 查找最近节点。使用插件中的查找最近节点工具,查找热电偶 5 和热电偶 9 的节点标签。
- 按以下说明提取力学分析结果。
- 打开宏管理器,创建一个名为 data_extracting 的工作宏。打开 Mechanical_analysis.odb。
- 点击 工具 > 路径 > 创建 > 节点列表。为 BD 线(BD 线穿过样品中截面的厚度方向)创建路径。
- 点击 可视化 > 创建 XY 数据 > 路径。基于未变形模型形状的路径创建 XY 数据。
- 停止宏录制。工作目录中将生成一个名为 data_extracting.py 的 Python 文件。
- 将热分析和力学分析结果与实验数据进行比较。模拟和实验均使用相同的参数和设置。
- 按以下说明提取热分析结果。
2. 模型的脚本编写
注意:此处对三个焊接参数进行参数化,分别为焊接速度、行走长度和净能量输入速率。
- 根据敏感性分析简化模型。
注意:根据是否在模型中包含焊缝余高高度的敏感性分析结果,在模型中包含或排除焊缝余高高度对BD线上的应力分布无显著影响。因此,可省略在仿真中创建焊缝的步骤。 - 打开 Thermal_recording.py 文件。通过搜索 HeatTransferStep 找到定义分析步的代码。将焊接步骤中的具体时间值替换为表达式 bead_length/welding_speed。
- 找到创建输入文件的代码。将具体文件名替换为表达式 T-Heat_input-welding_speed-travel_length。
- 打开 Mechanical_recording.py 文件。通过搜索 HeatTransferStep 找到定义分析步的代码。将焊接步骤中的具体时间值替换为表达式 bead_length/welding_speed。
- 找到创建输入文件的代码。将具体文件名替换为表达式 M-Heat_input-welding_speed-travel_length。
- 使用所附的 补充代码文件1 中第1–408行代码,合并用于生成热分析和力学分析输入文件的代码。
- 使用所附的 补充代码文件1 中第410–459行代码,定义参数列表格式,并调用生成热分析和力学分析输入文件的函数。所有热分析的输入文件将存储在工作目录下的 Thermal_input_files 文件夹中,所有力学分析的输入文件将存储在 Mechanical_input_files 文件夹中。
- 生成最终的 Python 文件(补充代码文件1)。
注意:为提高脚本的鲁棒性,所有用于选择集合的默认函数(名为 getSequenceFromMask)均已替换为基于坐标的集合选择函数 findAt。
3. 数据生成
- 在 Abaqus 命令行中运行补充代码文件 1,以生成热分析和力学分析的输入文件。将补充代码文件 2和补充代码文件 3复制到 Thermal_input_files 文件夹中。
- 在命令行中输入 qsub Run_thermal,以运行 shell 脚本,根据不同的焊接输入文件名修改 DFLUX 子程序并提交作业。
- 将补充代码文件 4复制到 Mechanical_input_files 文件夹中。在命令行中输入 qsub Run_mechanical,以根据不同的焊接输入文件名修改力学分析的输入文件并提交作业。
- 将补充代码文件 5复制到 Mechanical_input_files 文件夹中,并在命令行中运行该脚本。然后生成包含目标线上各点应力值的 csv 文件。
4. 代理模型开发
- 使用 补充代码文件6 中包含的第1-17行加载库。使用 补充代码文件6 中的第378行固定随机种子。
- 使用 补充代码文件6 中的第381-382行指定训练数据集和测试数据集的路径。
- 使用 补充代码文件6 中的第385行对数据集进行预处理。预处理包括均匀间隔采样、归一化以及训练集与测试集的划分。
- 使用 补充代码文件6 中的第387-397行,通过贝叶斯优化进行超参数调优(可选)。
- 使用 补充代码文件6 中的第399-401行,结合GridsearchCV与交叉验证进行超参数调优(可选)。
- 使用 补充代码文件6 中的第404-405行构建代理模型,并对测试数据集进行预测。
- 使用 补充代码文件6 中的第406-410行计算并输出预测结果的均方误差(MSE)。
- 使用 补充代码文件6 中的第414-416行保存代理模型。
- 使用 补充代码文件6 中的第419-420行绘制测试数据集上人工神经网络(ANN)预测结果与模拟数据的对比图。
- 使用 补充代码文件6 中的第423行绘制测试数据集上的总体性能图。
结果
采用不同的电弧移动长度、电弧前进速度和净能量输入速率组合进行了一系列有限元(FE)模拟。对于训练集,电弧移动长度的取值范围为 40 mm、50 mm、60 mm、70 mm 和 80 mm;电弧前进速度的取值范围为 2 mm/s、2.5 mm/s、3 mm/s、3.5 mm/s 和 4 mm/s;净能量输入速率的取值范围为 1000 W、1500 W、2000 W、2500 W 和 3000 W。对于测试集,电弧移动长度的取值范围为 40 mm、50 mm、60 mm、70 mm 和 80 mm;电弧前进速度的取值范围为 2.25 mm/s、2.75 mm/s、3.25 mm/s 和 3.75 mm/s;净能量输入速率的取值范围为 1250 W、1750 W、2250 W 和 2750 W。这 205 次模拟中沿 BD 线的纵向应力被收集并展示在图 2中。该结果此前已发表于25。特别是,该研究利用案例分析结果来验证工作流程的有效性。本研究在先前研究的基础上进一步拓展,全面解释了焊接模拟中所采用的具体设置,并详细描述了用于通用焊接模拟的 Python 脚本方法。
将所开发的ANN模型应用于测试集进行预测。模型预测结果与有限元模拟结果之间的差异如图3所示。在1680个测试点中,有限元分析模拟值与ANN预测应力值之间的大多数差异(759次)落在0–2 MPa范围内,占数据总量的45.2%。随着差异增大,出现频率逐渐降低,差异超过10 MPa的数据点极少。图图4展示了箱型图,用于显示在不同模拟应力水平下,模拟应力与预测应力之间绝对差异的分布情况。每个箱体表示在特定模拟应力水平区间内残差的四分位距,箱内线条表示中位数。次y轴上的直方图显示了每个应力水平区间内的训练数据点数量,提供了模型训练所用数据分布的额外信息。如图所示,训练数据点较少的应力水平区间在测试数据集中往往表现出更高的最大差异。通过增加这些应力水平下的训练数据量,有望改善模型在这些区域的性能。
采用均方误差(MSE)来量化预测性能,MSE性能指标的表达式为:
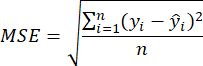
其中,yi 表示第 i 个样本点在逆标准化前的应力值, 表示第 i 个样本在逆标准化前的预测应力值,n 为样本总数。
人工神经网络(ANN)对应力的预测结果与有限元(FE)模拟结果非常接近,均方误差(MSE)为0.0024。四个选定测试案例的预测结果如图5所示;这四个测试案例的热输入量分别为333 J/mm、538 J/mm、692 J/mm和1222 J/mm。在这四个案例中,ANN的预测结果总体上与有限元模拟结果吻合良好。然而,在焊接速度为2.25 mm/s、行程长度为50 mm、净能量输入速率为2750 W,或焊接速度为3.75 mm/s、行程长度为40 mm、净能量输入速率为1250 W的情况下,在BD线底部(约17 mm深度处)观察到相对较大的偏差。这些偏差可能归因于该区域所遵循规律的复杂性增加,导致在特定参数空间区域内的流形结构更加复杂。一种可能的解决方案是提高该区域训练数据集的密度。

图1:工作流程。 所提出的工作流程包含四个步骤(以蓝色模块表示):基线有限元模型构建、脚本编写、数据生成和代理模型开发。橙色模块表示每个步骤的输入,绿色模块表示每个步骤的输出。请点击此处查看此图的放大版本。
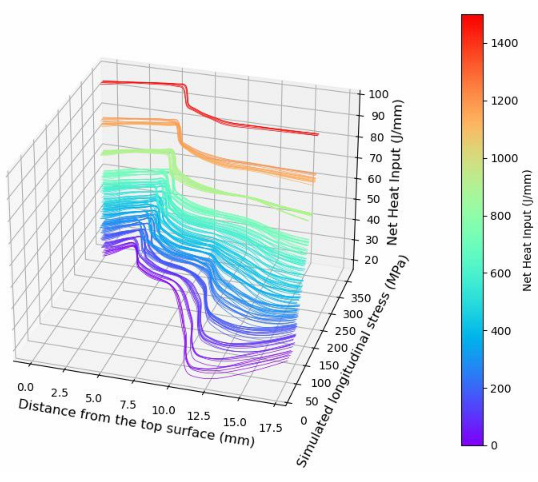
图 2:生成的数据集。共展示了205组纵向应力数据,每组数据对应于不同的焊道长度、净能量输入速率和焊接速度的唯一组合。在每组数据中,沿BD线的不同节点绘制了20个数据点。为区分各数据组,每组采用不同颜色表示,颜色对应其净热输入速率。该值可通过将净能量输入速率除以焊接速度计算得到。本图经修改自25。请点击此处查看此图的放大版本。
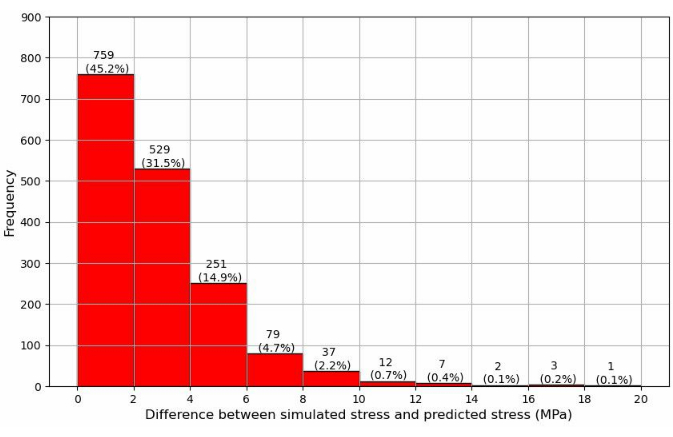
图3:有限元模拟结果与人工神经网络预测结果之间差异的频率分布。 测试数据集中有限元模拟结果与人工神经网络预测结果之间的差异被分为10个等级。图中注释标明了每类差异在测试案例中出现的频次及所占百分比。请点击此处查看该图的放大版本。
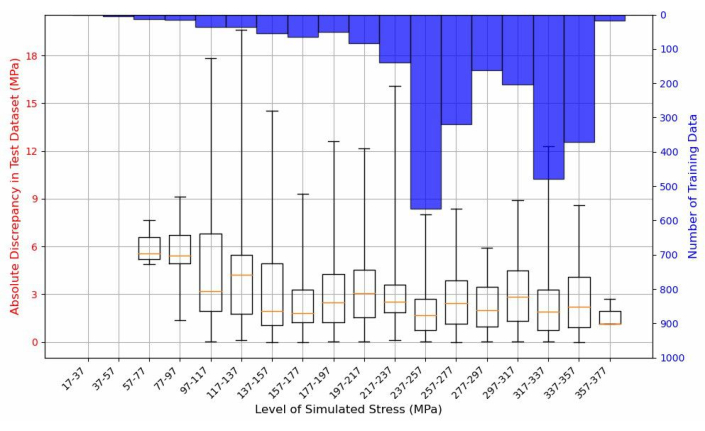
图 4:不同应力水平下平均绝对残差与训练数据集的分布情况。箱线图描述了模拟应力与预测应力之间的绝对偏差在不同模拟应力水平下的分布情况。每个箱体内的橙色线表示中位数,代表绝对偏差的中间值。每个箱体的高度对应四分位距,覆盖数据中间50%的部分(从第25百分位到第75百分位),反映偏差的离散程度。须线从箱体延伸,显示偏差的最小值和最大值。蓝色直方图显示训练数据集中每个应力水平对应的数据点数量。请点击此处查看该图的放大版本。
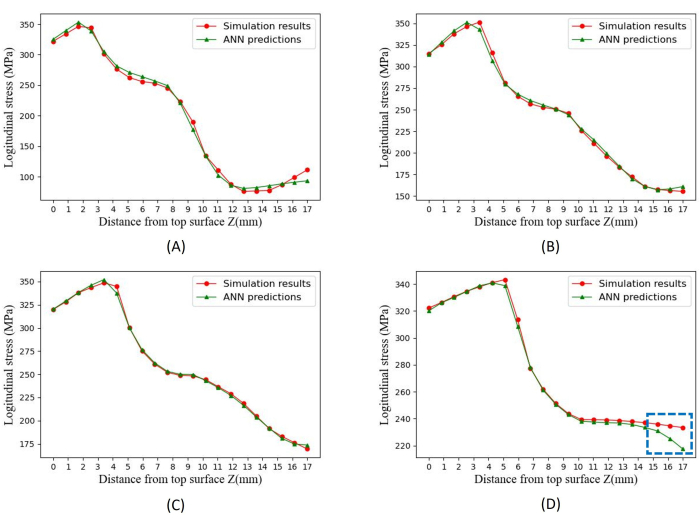
图 5:仿真结果与人工神经网络(ANN)预测结果的对比。本图展示了四个测试案例,其中(A)焊接速度为 3.75 mm/s,行走长度为 40 mm,净能量输入速率为 1250 W;(B)焊接速度为 3.25 mm/s,行走长度为 60 mm,净能量输入速率为 1750 W;(C)焊接速度为 3.25 mm/s,行走长度为 50 mm,净能量输入速率为 2250 W;以及(D)焊接速度为 2.25 mm/s,行走长度为 50 mm,净能量输入速率为 2750 W。所有测试案例中最显著的差异以蓝色框标出,出现在测试案例(D)中距顶表面深度 17 mm 处,差值为 19.4 MPa。请点击此处查看该图的放大版本。
表1:焊缝试样、细化网格区域和焊道的几何信息。 表中列出了矩形焊缝试样和细化网格区域的长度、宽度和深度。焊道的尺寸通过示意图进行说明。在建模过程中,由于仅创建了模型的一半,因此宽度应取表中数值的一半。请点击此处下载该表格。
表2:AISI 316LN的材料属性14。密度和泊松比被视为与温度无关,其他物理属性则被视为与温度相关。请点击此处下载该表格。
表3:AISI 316LN塑料力学性能24。 AISI 316LN不锈钢随温度变化的力学性能;零塑性应变下的屈服应力;随动强化参数(C1、Gamma 1、C2、Gamma 2);等向强化参数(Q-inf);以及强化参数(b)。请点击此处下载该表格。
补充代码文件 1:Create_input_files.py 请点击此处下载该文件。
补充代码文件 2:Run_thermal 请点击此处下载该文件。
补充代码文件 3:DFLUX.for 请点击此处下载该文件。
补充代码文件 4:Run_Mechanical 请点击此处下载该文件。
补充代码文件 5:extract_data.py 请点击此处下载该文件。
补充代码文件 6:ANN_development.py 请点击此处下载该文件。
讨论
本研究提出了一种自动化生成有限元仿真数据并训练基于机器学习的代理模型(如人工神经网络)以预测焊接过程中关键结果的工作流程。首先,该方案包括构建标准的焊接有限元仿真,以建立一个一致的框架来获得可靠的结果。通过与实验数据对比,对仿真结果进行分析和验证,以确保其准确性。其次,基于使用宏功能记录的脚本,开发用于仿真预处理和后处理的脚本。第三,利用所生成的脚本批量生成大规模数据集。最后,构建并测试代理模型,结果表明其具有优异的性能。该方法显著提高了数据集生成过程的效率,避免了重复的手动设置。鉴于数据集生成在数据驱动型代理模型开发中的关键作用,所提出的工作流程有助于加快代理模型的开发进程。因此,该方法为推动焊接仿真领域中数据驱动型代理模型的发展提供了有价值的工具。
在该方案中,若干关键步骤显著影响最终代理模型的性能。在步骤 1.2.9 中,必须确保焊缝模型包含足够精细的网格单元,以实现稳定的收敛性和准确的模拟结果。在步骤 1.5.3 中,校准标准有限元模型有助于合理选择热源模型参数,并提高模拟的准确性。在步骤 4.4 和 4.5 中,恰当的超参数调优对于确定最优模型配置至关重要,从而提升代理模型的性能。
对所开发的ANN代理模型的性能进行了评估,结果表明该模型整体表现良好。本文所开发的代理模型的准确性高于以往基于非常有限数据的研究尝试19,23。在本案例研究中,所开发的代理模型专门用于预测单道焊 bead-on-plate 构型中的纵向应力,模型中纳入了三个关键焊接参数:焊接速度、行走长度和净能量输入速率。需要注意的是,该模型的输入和输出均具有高度可扩展性。例如,可将更多的焊接参数或材料属性加入输入变量中,输出也可扩展至包含所有残余应力分量或位移,从而为更广泛的应用提供了一个灵活通用的框架。
关于构建代理模型所使用的算法,也可根据具体任务进行调整。人工神经网络(ANNs)在外推方面存在一定的局限性。与之相比,其他机器学习算法(如支持向量机(SVMs))不受训练数据结构的限制,具有更强的外推能力。已有研究18,19,20尝试采用支持向量机预测残余应力,并取得了一定成效。然而需要注意的是,支持向量机的超参数调优可能更具挑战性,且在插值任务中,其表现可能不如人工神经网络。人工神经网络的另一局限在于,直接使用ANN无法生成置信区间,而这正是工程师所关注的问题。因此,可考虑采用其他算法,如高斯过程回归26和贝叶斯神经网络27。此外,尽管人工神经网络模型在预测残余应力方面表现良好,但其可解释性较差。在工程应用中,若需理解模型的决策过程,则这一缺陷可能成为限制因素。通过引入更具解释性的模型(如决策树),可提升模型的可解释性。
综上所述,本研究提出的流程能够快速、简便地生成数据集,从而显著加快通用或特定焊接模拟代理模型的开发进程。
披露
作者无任何利益冲突需要披露。
致谢
本项目得到了英国原子能机构通过聚变产业计划提供的支持。聚变产业计划正在推动英国聚变生态系统的发展,并为其未来参与全球聚变电站市场做好准备。有关聚变产业计划的更多信息可在线获取: https://ccfe.ukaea.uk/programmes/fusion-industry-programme/。作者衷心感谢曼彻斯特大学研究信息技术部门(Research IT)在访问该校计算共享设施方面所提供的支持。A.N. Vasileiou 承认获得了由英国工程与物理科学研究委员会(EPSRC)资助的“SINDRI - 信息学与数据中心完整性工程的协同利用”项目(资助编号:EP/V038079/1)以及曼彻斯特大学达爾顿核研究所(Dalton Nuclear Institute)的支持。作者谨此感谢欧洲网络 NeT(NeT-European NeTwork)以及来自欧洲委员会联合研究中心(JRC)的 Carsten Ohms 提供 NeT-TG1 基准数据。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Abaqus | Dassault Systems | 2020 | |
| Intel Fortran Compiler | Intel Corporation | 17.0.7 | |
| Keras | 开源 | 2.6.0 | |
| Python | 开源 | 3.8.18 |
参考文献
- Francis, J. A., Bhadeshia, H., Withers, P. J. Welding residual stresses in ferritic power plant steels. Mater Sci Technol. 23 (9), 1009-1020 (2007).
- Withers, P. J. Residual stress and its role in failure. Rep Prog Phys. 70 (12), 2211(2007).
- Hornbach, D. J., Preve´y, P. S. The effect of prior cold work on tensile residual stress development in nuclear weldments. J. Press Vessel Technol. 124 (3), 359-365 (2002).
- Zondi, M. C. Factors that affect welding-induced residual stress and distortions in pressure vessel steels and their mitigation techniques: a review. J Press Vessel Technol. 136 (4), 040801(2014).
- Ohms, C., Wimpory, R. C., Katsareas, D. E., Youtsos, A. G. NET TG1: Residual stress assessment by neutron diffraction and finite element modeling on a single bead weld on a steel plate. Int J Press Vessels Piping. 86 (1), 63-72 (2009).
- Bouchard, P. J. The NeT bead-on-plate benchmark for weld residual stress simulation. Int J Press Vessel Piping. 86 (1), 31-42 (2009).
- Hofmann, M., Wimpory, R. C. NET TG1: Residual stress analysis on a single bead weld on a steel plate using neutron diffraction at the new engineering instrument 'STRESS-SPEC'. Int J Press Vessels Piping. 86 (1), 122-125 (2009).
- Smith, M. C., Smith, A., Ohms, C., Wimpory, R. A review of the NeT TG4 international weld residual stress benchmark. ASME Press Vessels Piping Conf 2015. 6B, (2015).
- Akrivos, V., Smith, M. C. Material characterization on the nickel-based alloy 600/82 NeT-TG6 benchmark weldments. Proc ASME Press Vessels Piping Conf 2019. Uddin, M., Brongers, M., Messner, M. 6B, (2019).
- Wimpory, R. C., Ohms, C., Hofmann, M., Schneider, R., Youtsos, A. G. Statistical analysis of residual stress determinations using neutron diffraction. Int J Press Vessels Piping. 86 (1), 48-62 (2009).
- Ficquet, X., Smith, D. J., Truman, C. E., Kingston, E. J., Dennis, R. J. Measurement and prediction of residual stress in a bead-on-plate weld benchmark specimen. Int J Press Vessels Piping. 86 (1), 20-30 (2009).
- Gilles, P., El-Ahmar, W., Jullien, J. F. Robustness analyses of numerical simulation of fusion welding NeT-TG1 application:"Single weld-bead-on-plate.". Int J Press Vessels Piping. 86 (1), 3-12 (2009).
- Shan, X., Davies, C. M., Wangsdan, T., O'dowd, N. P., Nikbin, K. M. Thermo-mechanical modelling of a single-bead-on-plate weld using the finite element method. Int J Press Vessels Piping. 86 (1), 110-121 (2009).
- Bate, S. K., Charles, R., Warren, A. Finite element analysis of a single bead-on-plate specimen using SYSWELD. Int J Press Vessels Piping. 86 (1), 73-78 (2009).
- Coules, H. E., Smith, D. J., Venkata, K. A., Truman, C. E. A method for reconstruction of residual stress fields from measurements made in an incompatible region. Int J Solids Str. 51 (10), 1980-1990 (2014).
- Smith, M. C., Smith, A. C., Wimpory, R., Ohms, C. A review of the NeT Task Group 1 residual stress measurement and analysis round robin on a single weld bead-on-plate specimen. Int J Press Vessels Piping. 120, 93-140 (2014).
- Na, M. G., Kim, J. W., Lim, D. H. Prediction of residual stress for dissimilar metals welding at nuclear power plants using fuzzy neural network models. Nucl Eng Technol. 39 (4), 337-348 (2007).
- Na, M. G., Kim, J. W., Lim, D. H., Kang, Y. J. Residual stress prediction of dissimilar metals welding at NPPs using support vector regression. Nucl Eng Design. 238 (7), 1503-1510 (2008).
- Edwin Raja Dhas, J., Kumanan, S. Evolutionary fuzzy SVR modeling of weld residual stress. Appl Soft Comput J. 42, 423-430 (2016).
- Koo, Y. D., Yoo, K. H., Na, M. G. Estimation of residual stress in welding of dissimilar metals at nuclear power plants using cascaded support vector regression. Nucl Eng Technol. 49 (4), 817-824 (2017).
- Kitano, H., Nakamura, T. Predicting residual weld stress distribution with an adaptive neuro-fuzzy inference system. Int J Automat Technol. 12 (3), 290-296 (2018).
- Mathew, J., Griffin, J., Alamaniotis, M., Kanarachos, S., Fitzpatrick, M. E. Prediction of welding residual stresses using machine learning: Comparison between neural networks and neuro-fuzzy systems. Appl Soft Comput J. 70, 131-146 (2018).
- Liu, F., et al. Prediction of welding residual stress and deformation in electro-gas welding using artificial neural network. Mater Today Comm. 29 (May), 102786(2021).
- Muransky, O., Hamelin, C. J., Smith, M. C., Bendeich, P. J., Edwards, L. The effect of plasticity theory on predicted residual stress fields in numerical weld analyses. Computat Mater Sci. 54, 125-134 (2012).
- Miao, Z., Margetts, L., Vasileiou, A. N., Yin, H. Surrogate model development using simulation data to predict weld residual stress: A case study based on the NeT-TG1 benchmark. Int J Press Vessels Piping. 206, 105014(2023).
- Seeger, M. Gaussian processes for machine learning. Int J Neural Sys. 14 (02), 69-106 (2004).
- Chen, S. J., Zhang, Z. K. Temperature prediction of friction stir welding based on Bayesian neural network. Appl Mech Mater. 48, 1208-1212 (2011).
重印与许可
