本研究提出了一种空间Trekker–CUT&Tag多组学方案,将组织切片的直接空间条形码技术与单细胞多组学分析相结合。该方法能够同时实现基因表达和组蛋白H3K27ac修饰的空间解析单细胞谱型分析,为在组织微解剖背景下理解基因调控机制提供了深入见解。
本文内容
摘要
摘要
空间多组学技术与单细胞分析相结合,为揭示复杂组织的分子与细胞结构提供了前所未有的机遇。将基于包埋于最佳切割温度(OCT)冷冻介质的组织块制备的冷冻切片中细胞核进行空间条形码标记,与单细胞多组学检测相结合,形成一种简便高效的实验流程,有助于对各类组织中的细胞进行注释及空间分辨的分子分析。本研究报道了一种靶向切割下的空间分析方法 & 片段化(CUT&Tag) 多组学方法,可在单个冷冻脑切片中同时分析组蛋白H3K27ac修饰和基因表达。在完成空间条形码标记后,分离单个细胞核并进行CUT&Tag,结合标签化DNA、RNA和空间条形码的联合捕获、文库构建及测序。该工作流程可从同一细胞核中生成带有空间注释的表观基因组和转录组谱,实现将多组学信息定位至组织解剖坐标。整合表观基因组信息与空间转录组数据可提高细胞类型鉴定的准确性,并揭示完整组织中具有空间特异性的调控程序及细胞间相互作用。
引言
空间生物学是一个快速发展的领域,旨在绘制分子、细胞和组织在其原生环境中的位置、结构及相互作用1,2,3。与需要组织解离并导致位置信息丢失的整体或传统单细胞方法不同,空间分析技术能够保留分析物或细胞/细胞核的物理坐标,从而直接研究组织结构如何影响细胞身份、细胞间通讯以及生物学功能4,5,6,7。尽管目前空间转录组学和空间蛋白质组学是应用最广泛的技术,但该领域正迅速向空间多组学分析扩展3,8,9。在同一组织中联合分析基因表达与表观基因组状态尤其具有强大优势,因为它能将转录输出直接与调控机制(如染色质可及性和组蛋白修饰)联系起来,而这些机制控制着基因活性,并且已知在不同空间区域中存在差异10,11,12。因此,整合的空间表观基因组与转录组分析将为调控程序如何塑造细胞身份和组织结构提供关键见解。
目前已开发出多种空间多组学策略,以实现表观基因组和转录组的同步分析。组织测序中的确定性条形码技术(DBiT-seq)利用微流控通道将空间条形码直接递送至组织切片,或通过凝胶板印迹间接递送,从而实现对分析物的空间注释。该方法支持表观基因组和转录组特征的空间分辨共分析12,13,14,15。Slide-tag方法(已作为Takara Trekker平台商业化)在组织解离前直接将空间条形码引入完整组织中,使得具有空间索引的细胞核可采用标准单细胞流程进行处理,并通过计算方法回溯至其原始组织坐标16。相比之下,结合测序技术的空间可及染色质、细胞谱系与基因表达分析方法(SPACE-seq)采用“靶向外”策略,即在空间转录组芯片上的poly-dT捕获序列上同时捕获带有poly(A)尾的表观遗传靶标和mRNA17。
靶位点切割与标签化(Cleavage under targets & tagmentation,CUT&Tag)是一种强大的技术,可用于从极低起始量的样本中绘制DNA与组蛋白或非组蛋白之间相互作用的图谱18。CUT&Tag依赖于Tn5转座酶介导的染色质片段化和DNA标签化(即“标签化切割”,tagmentation),利用抗体引导的、蛋白A偶联的Tn5转座酶实现位点特异性的切割和分子标记。尽管传统的CUT&Tag实验包含多个孵育和洗涤步骤,但本研究采用了一种简化且流程优化的CUT&Tag工作流程,以提高其在下游单细胞多组学应用中的效率19。
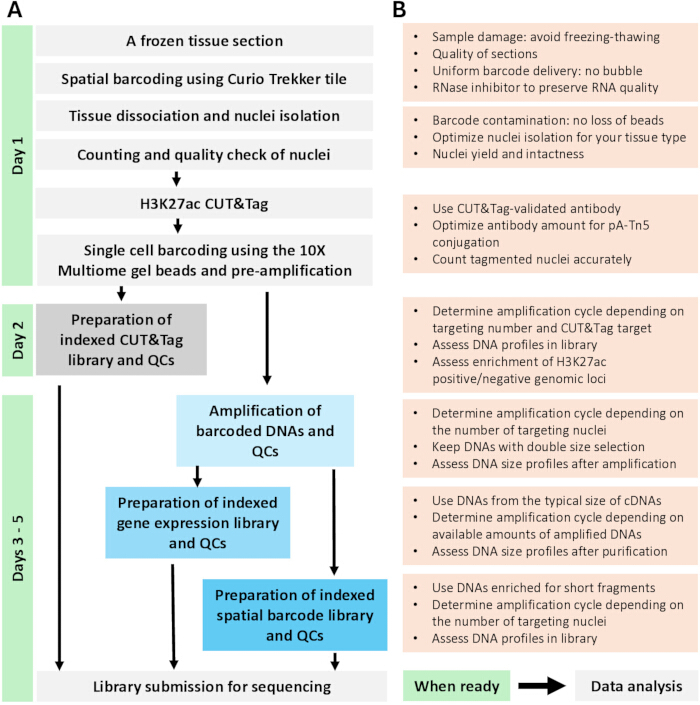
图 1:空间 Trekker–CUT&Tag 多组学检测的工作流程与质量控制概览。(A) 空间 Trekker–CUT&Tag 多组学工作流程示意图。将新鲜冷冻的小鼠脑组织冠状切片固定在 Trekker 空间芯片上,并进行空间条形码标记。组织裂解后,分离细胞核并评估其产量与质量。取约 50,000 个细胞核用于 H3K27ac CUT&Tag 反应,经标签化(tagmented)的细胞核在计数后通过 10x Genomics Chromium 多组学凝胶珠进行单细胞条形码标记。单细胞条形码化的 DNA 经预扩增后分为两部分。CUT&Tag 文库通过加索引引物的 PCR 直接生成;而对于基因表达文库和空间条形码文库,预扩增后的 DNA 需进一步扩增并进行片段大小筛选。其中,具有典型 cDNA 大小的片段用于构建基因表达文库,较短的 DNA 片段则用于构建空间条形码文库。文库构建完成后,依据 10x Genomics 和 Curio Trekker 的指南进行测序与比对。左侧显示了预期的实验时间线。(B) 工作流程中关键的质量控制(QC)节点及重要注意事项。细胞核的质量控制包括对产量、完整性、聚集情况和碎片含量的评估;测序前的质量控制则包括对所有文库的 DNA 片段大小分布及引物二聚体污染的检测。CUT&Tag 文库的特异性通过定量 PCR(qPCR)进行评估,检测目标基因组区域相对于背景信号的富集程度。请点击此处查看该图的放大版本。
本研究介绍了一种空间 Trekker CUT&Tag 多组学检测方法,可同时对新鲜冷冻组织切片中与活性顺式调控元件相关的组蛋白 H3K27ac 修饰及基因表达进行分析。本方案提供了 Takara Trekker 空间条形码标记、组织解离与细胞核分离、细胞核计数与质量控制、低起始量 CUT&Tag 检测 H3K27ac 修饰、10x Genomics 单细胞多组学凝胶珠对分子靶标的捕获以及文库构建的逐步操作流程。该工作流程以小鼠脑组织的冠状切片为例进行了验证。与标准的 10x Genomics 多组学流程(通过高通量测序检测转座酶可及染色质(ATAC-seq)来测量染色质可及性)不同,本方案使用 CUT&Tag 来源的 DNA 片段替代 ATAC 片段,从而实现对组蛋白修饰图谱的单细胞分辨率直接分析。为将 Trekker 空间条形码与 10x Genomics 单细胞条形码关联,多组学凝胶珠上的 poly-dT 序列同时捕获带 poly(A) 尾的空间条形码和 mRNA 转录本,而 CUT&Tag DNA 片段则由间隔序列捕获。这种双重捕获策略使得从同一单个细胞核中可同时获取表观基因组、转录组和空间信息。据我们所知,这是首个将 Trekker 空间注释中的条形码直接整合到单细胞多组学检测中的空间多组学工作流程,可共同分析组蛋白标记的全基因组分布与转录组。所获得的具有空间分辨率的多组学图谱,整合了 H3K27ac 占有度与基因表达数据,能够将单细胞分析结果回溯至其原始组织坐标,从而在完整组织结构背景下,建立表观基因组调控机制与转录程序之间的直接关联。
方案
成年小鼠通过 CO₂ 处死2 吸入麻醉(IACUC编号:A48315-15-R24)后取组织。取出脑组织 整体上 矢状颅骨切开并移除半侧颅盖后。所用试剂和设备列于下文 材料表.
1. 将组织切片固定到 Trekker 条形码芯片上以进行空间条形码标记
- 开始前准备以下事项。
- 在切片前,将包埋于最佳切割温度(OCT)介质中的组织块在冷冻切片机中平衡。准备好用于紫外光解、组织解离和细胞核分离的缓冲液。
注意:切片的最佳温度可能因组织类型而异。 - 进行细胞核分离时,提前将配有摆动吊篮的离心机预冷至 4 °C(适用于 1.5 mL 离心管)。将带有 Trekker O 形圈的 12 孔板置于冰上预冷。
- 将紫外光强度计设置为最大电流限制(1.2 A)和最大功率。
- 在切片前,将包埋于最佳切割温度(OCT)介质中的组织块在冷冻切片机中平衡。准备好用于紫外光解、组织解离和细胞核分离的缓冲液。
- 记录将要使用的 Trekker 芯片的空间条形码瓦片编号(例如 U0001_001)。
注意:每张 Trekker 芯片包含唯一的条形码坐标。该芯片编号用于获取正确的空间条形码映射文件,以解析测序数据。 - 对组织进行切片。在约 bregma -1 mm 位置进行冠状切面,厚度为 25 µm,在 −18 °C 条件下完成(图 1A)。
注意:当处理细胞密度较低的组织时,厚度可增加至 30 µm。 - 将切片(或感兴趣区域)放置到空间芯片上,并通过轻轻用手指触碰载玻片底部使其融化贴合。
警告:如有必要,可通过使用 Trekker 培训芯片进行细胞核质量控制检测来确认操作流程是否正确。 - 用镊子将芯片从透明粘附层上取下,放入置于冰上、带有 Trekker O 形圈的 12 孔细胞培养板的一个孔中。立即加入 30 µL Trekker 紫外光解缓冲液至芯片上,确保整个组织被缓冲液覆盖。
- 将紫外灯(设定为 1.2 A)放置在板上对应孔的正上方。保持所有组件处于冰上,照射 1 分钟以释放条形码。
警告:使用紫外灯时需佩戴防紫外护目镜。 - 关闭紫外灯,将芯片在冰上孵育 7.5 分钟。孵育期间,取出一个 Trekker 10 x 10 清洗室,并在冰上向 1 号和 2 号腔室各加入 400 µL 冷的 Trekker 细胞核清洗缓冲液。
- 用镊子小心夹起芯片,避免接触微珠,先在 1 号腔室中清洗 5 秒,再在 2 号腔室中清洗 5 秒。然后小心地将芯片放回冰上的 12 孔板孔中。此时组织切片应呈蓝色,清晰可见。
2. 组织解离与细胞核分离
- 将175 µL Invent Minute缓冲液A滴加至组织表面,共重复4次,总计700 µL。每次滴加时应针对芯片的不同区域,以使整个组织从芯片上脱离。
注意:避免因刮擦芯片或珠子脱落而造成珠子污染。 - 通过从孔的侧壁吸出缓冲液并将其重新滴加到芯片上被组织覆盖的区域,继续使组织从芯片上解离,操作过程中尽可能将板保持在冰上。重复此步骤直至芯片上无残留组织。当所有组织均从芯片上移除后,小心使用镊子将芯片转移至一个空的孔中。
- 使用P1000移液器在同一孔中通过反复吹打进行机械性解离细胞核。重复操作直至无可见的组织碎片存在。
- 小心将细胞核悬液转移至Invent Minute神经组织/细胞单细胞核分离试剂盒中的滤芯离心管中。将管子开盖置于–20 °C孵育10分钟。盖上滤芯管盖,立即在预冷的微量离心机中以13,000 x g离心30秒。
- 弃去滤芯,通过轻柔吹打10–20次重悬沉淀。将离心管放入预冷的带摆动桶转子的离心机中,以600 x g离心5分钟。小心移除上清液,并将沉淀重悬于200 µL Trekker缓冲液C中。
- 在1.5 mL低吸附Eppendorf管中加入1 mL冷的Invent Minute缓冲液B,然后小心地将200 µL细胞核悬液沿管壁缓慢铺加在缓冲液B上方,避免两层液体混合。将管子放入预冷的带摆动桶转子的离心机中,以500 x g离心10分钟。小心移除乳白色层及上清液。
- 用24 µL Trekker缓冲液C轻柔重悬细胞核,随后进行分离细胞核的质量控制检测。
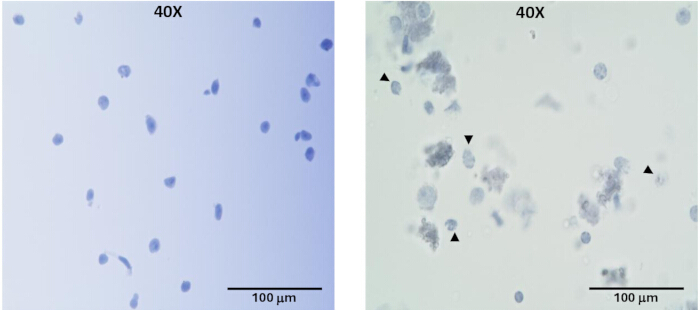
图2:分离细胞核的质量控制评估。从小鼠脑组织中分离出的细胞核的代表性明场图像。细胞核经0.4%台盼蓝染色后在40倍放大倍数下成像,以评估细胞核完整性及碎片的存在情况。左侧所示的细胞核制备物显示为高质量、完整的细胞核,适用于后续检测;而右侧所示的制备物则显示为低质量细胞核,伴有部分裂解的组织聚集体。破损或破裂的细胞核由实心箭头指示。比例尺为100 µm。 请点击此处查看该图的高清版本。
3. 分离细胞核的计数与质量控制检测
- 进行细胞核计数时,取 2 µL 细胞核悬液加入 8 µL Trekker 缓冲液 C 中。将 10 µL 稀释后的细胞核悬液与 10 µL AO/PI 染色液混合,按照制造商说明书进行细胞核计数。
- 为评估分离细胞核的质量,取 2 µL 细胞核悬液加入 8 µL 4% 台盼蓝溶液中稀释。在荧光显微镜下以 40 倍放大倍数观察细胞核,检查核膜形态是否完整以及非细胞核碎片含量(图 2)。
- 立即进行单细胞核 CUT&Tag 多组学分析(H3K27ac 的 CUT&Tag + 基因表达检测)。
注意:若回收到至少 30,000 个高质量细胞核,方可进行后续步骤。
4. 在分离的细胞核上进行CUT&Tag标签化反应
- 制备 CUT&标签孵育缓冲液 I。置于冰上。
- 制备由向导激活的初级抗体与转座酶(TAG)酶偶联物。
- 加入 46.23 µL 的 CUT&将标签结合缓冲液 I 和 1.33 µL TAG 酶加入预冷的 PCR 管中。向管中加入优化量的一抗。用移液器缓慢吹打混匀 10 次。
注意:向反应体系中加入 2.43 µL 抗 H3K27ac 抗体。该批次抗体已针对大规模及 原位 CUT&标签检测。通过大量检测优化用于TAG酶偶联的抗体用量。最佳抗体浓度定义为在阳性与阴性靶位点通过qPCR测定达到最大信噪比时的最低浓度。 - 短暂离心,将离心管置于18 rpm的旋转仪上。室温孵育1小时。所得混合物可预先配制,并置于冰上保存最多5小时。
注意:抗体-TAG 孵育可与细胞核分离同时进行,或在其之前提前完成。
- 加入 46.23 µL 的 CUT&将标签结合缓冲液 I 和 1.33 µL TAG 酶加入预冷的 PCR 管中。向管中加入优化量的一抗。用移液器缓慢吹打混匀 10 次。
- 分离细胞核与抗体-TAG酶偶联物的孵育。
- 将分离的细胞核管(步骤 2.7)放入预冷的带有摆桶转子的离心机中,在 500 x g 10 分钟。去除上清液时不要扰动沉淀,残留约 5 µL 上清液。
- 加入25 µL的CUT&标记孵育缓冲液 I(步骤 4.1),通过轻轻吹打 10 次重悬。使用同一枪头将细胞核转移至含有抗体-TAG 偶联物的离心管(步骤 4.2.2)中。轻轻吹打 10 次混匀,并将离心管置于轻柔旋转仪上。
- 4 ˚C 下孵育过夜。
- 第二天(第2天),制备1X CUT&标记细胞核缓冲液,置于冰上。
- CUT&标签片段化
- 从旋转仪中取出反应管(步骤 4.3.3)。加入 5 µL CUT&标记激活剂并将混合物转移至新的1.5 mL离心管中。在ThermoMixer中37 ˚C、550 rpm条件下孵育1小时。
- 取出试管,加入 20 µL CUT&加入淬灭缓冲液,用移液器轻轻吹打10次以混匀反应体系。将离心管放入预冷的带有摆桶转子的离心机中,在500 x g 10分钟。移除上清液,注意不要扰动细胞核沉淀,管底保留约5 µL上清液。
- 加入 100 µL 1X CUT&标记细胞核缓冲液,轻轻吹打10次重悬细胞核。将离心管放入预冷的带摆桶转子的离心机中,500 x g 孵育10分钟。移除85 µL上清液,保留约15 µL。轻轻缓慢吹打10次,重悬细胞核。
- 计数经标签化处理的细胞核及靶向数的确定
- 将1 µL转座处理的细胞核悬液加入9 µL磷酸盐缓冲液中,再与10 µL AO/PI染色液混合。按照步骤3.1所述方法计数转座处理的细胞核。
- 为获得目标数量的捕获细胞核,在单细胞GEM生成过程中应使用目标细胞核数量1.6倍的细胞核。
- 将离心管放入预冷的带有摆桶转子的离心机中,在500 x g 10 分钟,小心移除上清液,保留终体积为 8 µL。
5. 标记片段化细胞核的单细胞条形码及条形码化DNA的预扩增
- 向含有预期靶向细胞核数量的8 µL转座后细胞核中加入7 µL ATAC缓冲液B。
注意:有关反应体系设置和Chromium X仪器操作的更多详细信息,请参见《Chromium Next GEM单细胞多组学ATAC + 基因表达试剂盒用户指南》(CG000338 Rev G)中的“GEM生成与加标签”方案。 - 使用Chromium X仪器进行GEM生成与加标签。
- 向含有转座后细胞核的管中加入60 µL GEM主混合液。用移液器轻轻混匀,并加载至Chromium Next GEM芯片J的第1行。
- 准备单细胞多组学凝胶珠,将50 µL凝胶珠加入第2行。向第3行的孔中分配45 µL分隔油。
- 将装配好的芯片J连同垫圈放入Chromium X仪器的托盘中,并运行仪器。
- 从顶部第3行回收孔的最低点缓慢吸取100 µL GEMs。将移液器吸头紧贴新PCR管内壁,缓慢将GEMs排入置于冰上的新PCR管中。
- 将收集的GEMs在热循环仪中孵育(盖温为50 °C),程序如下:37 °C孵育45分钟(1个循环),25 °C孵育30分钟(1个循环),最后4 °C保存。
- 加入5 µL终止试剂,用移液器缓慢吹打混匀10次。
- GEM孵育后纯化及DNA纯化
注意:更多细节请参见《Chromium Next GEM单细胞多组学ATAC + 基因表达试剂盒用户指南》(CG000338 Rev G)中的“GEM孵育后纯化”方案。- 在室温下向管中加入125 µL粉红色回收试剂,轻轻翻转混匀10次。短暂离心。从管底缓慢吸出并弃去125 µL回收试剂/分隔油(粉红色)。
- 向管中加入200 µL Dynabeads纯化混合液,用移液器吹打混匀10次。室温孵育10分钟。将管置于磁力架上直至溶液澄清。弃去上清液。
- 向沉淀中加入300 µL新鲜配制的80%乙醇,孵育30秒后弃去上清液。再向沉淀中加入200 µL 80%乙醇,孵育30秒后弃去上清液。短暂离心,再置于磁力架上。弃去残留上清液。
- 将管从磁力架上取下。立即加入50.5 µL洗脱液I。用移液器吹打混匀,室温孵育1分钟。短暂离心后置于磁力架上,直至溶液澄清。将50 µL澄清溶液转移至新管中。
- 使用磁性磁珠进行DNA纯化
- 向每个样品中加入90 µL磁性磁珠(1.8X),彻底吹打混匀。室温孵育5分钟。短暂离心后置于磁力架上,直至溶液澄清。弃去上清液。
- 向沉淀中加入200 µL 80%乙醇,孵育30秒后弃去乙醇。重复此步骤一次。
- 短暂离心后置于磁力架上。弃去残留上清液。
- 将管从磁力架上取下。加入46.5 µL EB缓冲液,用移液器吹打混匀。室温孵育2分钟。离心后置于磁力架上,直至溶液澄清。
- 将46 µL纯化后的DNA转移至新管中。
- 加标签DNA的预扩增。
- 向每个样品中加入54 µL预扩增混合液。用移液器混匀后短暂离心。
- 在热循环仪中孵育(盖温为105 °C),程序如下:72 °C孵育5分钟(1个循环);98 °C孵育3分钟(1个循环);随后进行共7个循环:98 °C变性20秒,63 °C退火30秒,72 °C延伸1分钟;再进行72 °C延伸1分钟(1个循环);最后4 °C保存。样品可在4 °C保存过夜。
- 次日(第3天),按照步骤5.3.5所述方法,使用磁性磁珠(1.6X)纯化预扩增DNA。向管中加入80.5 µL EB缓冲液,用移液器混匀。22 °C(室温)孵育2分钟。短暂离心后置于磁力架上,直至溶液澄清。
- 将80 µL预扩增DNA转移至新管中。取其中40 µL用于构建CUT&Tag文库。将剩余的预扩增DNA在4 °C保存。
注意:后续将使用剩余的40 µL预扩增DNA构建基因表达和空间条形码文库。
CUT&Tag、基因表达和空间条形码的文库构建
- scCUT&Tag 文库的制备
- 将 40 µL 预扩增的 DNA 转移至新管中,并加入 60 µL 样本指数 PCR 混合液。用移液器吹打混匀,短暂离心。
- 在热循环仪中(盖子温度为 105 °C)按照以下程序孵育:98 °C 45 秒,1 个循环;总共 12 个循环:98 °C 20 秒,67 °C 30 秒,72 °C 20 秒;72 °C 1 分钟,1 个循环;4 °C 保存。
注意: 最佳循环数取决于起始细胞核数量以及所检测的组蛋白修饰类型。本实验中 H3K27ac 修饰使用了 12 个扩增循环。 - 通过磁性珠进行双轮大小筛选和 DNA 纯化(0.6X, 1.55X)
- 向每个样本中加入 60 µL 磁性珠(0.6X),充分吹打混匀。室温孵育 5 分钟。短暂离心后将管子置于磁力架上,直至溶液澄清。
- 将 150 µL 上清液转移至新管。向每个样本(上清液)中加入 95 µL 磁性珠(1.55X),吹打混匀。室温孵育 5 分钟。将管子置于磁力架上,直至溶液澄清。弃去上清液。
- 向沉淀中加入 300 µL 80% 乙醇。静置 30 秒。弃去乙醇。重复一次。短暂离心后将管子置于磁力架上。弃去残留上清液。
- 将管子从磁力架上取下。向管中加入 20.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。离心后置于磁力架上,直至溶液澄清。
- 将 20 µL 纯化并加索引的 CUT&Tag 文库转移至新管中。
- CUT&Tag 文库的质量控制检测
- 文库中 DNA 片段大小分布分析
- 将 1 µL 纯化后的文库 DNA 与 1 µL 低 TE 缓冲液混合。
- 将稀释后的 DNA 与 Fragment Analyzer 工作缓冲液混合,并使用 High-sensitivity HS NGS Fragment Kit (1-6000bp) 在仪器上运行(图 3A)。
- 在测序和比对前评估 H3K27ac 阳性基因组位点的富集情况。
- 将 1 µL 纯化后的文库 DNA 与 4 µL 无核酸酶水混合。取 1 µL 稀释后的文库 DNA 用于三个基因组位点的 qPCR 检测。
注意:对于 H3K27ac CUT&Tag,阳性引物设计自 Actb-TSS 位点,而靶向 T1-TSS 和一个基因间区位点的引物作为阴性对照20(表 1)。小鼠基因组 DNA 用作输入对照以校正 PCR 效率(图 3B)。 - 按如下方式配制总共 20 µL 的反应体系:1 µL 稀释后的文库 DNA,2 µL 10 µM 引物混合液,10 µL 2X SYBR Green Master Mix,7 µL 无核酸酶水。
- 使用 CFX Opus 实时荧光定量 PCR 系统,按照 SYBR Green 检测的适当循环程序运行 qPCR 板。
- 将 1 µL 纯化后的文库 DNA 与 4 µL 无核酸酶水混合。取 1 µL 稀释后的文库 DNA 用于三个基因组位点的 qPCR 检测。
- 文库中 DNA 片段大小分布分析
- cDNA 和空间条形码 DNA 的扩增
- 将 35 µL 预扩增 DNA(步骤 5.4.4)转移至新管,加入 65 µL cDNA 扩增反应混合液。吹打混匀,短暂离心。用于 cDNA 和空间条形码 DNA 扩增的引物为 Feature cDNA Primers 2。
- 在热循环仪中(盖子温度为 105 °C)按照以下程序孵育:98 °C 45 秒,1 个循环;总共 8 个循环:98 °C 20 秒,63 °C 30 秒,72 °C 1 分钟;72 °C 1 分钟,1 个循环;4 °C 保存。
注意:最佳循环数必须根据细胞类型、RNA 含量和起始细胞核数量确定。本实验中进行了 8 个扩增循环。 - 扩增后 cDNA 的纯化
- 按照步骤 6.1.3 所述方法进行双轮大小筛选和磁性珠纯化(0.6X, 2.0X)。向每个样本中加入 60 µL 磁性珠(0.6X),吹打混匀。室温孵育 5 分钟。将磁力架置于管旁,直至溶液澄清。
- 将 75 µL 上清液转移并保存至新管中,避免扰动沉淀。保持室温。
警告:请勿丢弃上清液,其中含有富集的小片段 DNA,将用于构建空间条形码文库。 - 弃去沉淀中的剩余上清液。按照步骤 6.1.3 所述方法用 80% 乙醇洗涤两次。
- 向管中加入 40.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。短暂离心后置于磁力架上,直至溶液澄清。
- 将 40 µL 扩增后的 cDNA 转移至新管。置于冰上保存,用于制备加索引的基因表达文库。
注意: 该组分富集了典型长度的 cDNA 片段。
- 扩增后空间条形码 DNA 的纯化
- 向先前保存的 75 µL 上清液(步骤 6.3.3.2)中加入 70 µL 磁性珠(2.0X)。吹打混匀,短暂离心。室温孵育 5 分钟。将管子置于磁力架上,直至溶液澄清。弃去上清液。
- 按照步骤 6.1.3 所述方法用 80% 乙醇洗涤两次。
- 向管中加入 40.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。短暂离心后置于磁力架上,直至溶液澄清。
- 将 40 µL 扩增并纯化的空间条形码 DNA 转移至新管。于 −20 °C 保存,用于后续构建加索引的空间条形码文库。
- 使用 Fragment Analyzer 分析 cDNA 片段大小。将 1 µL 扩增后的 cDNA 与 1 µL 低 TE 缓冲液混合。按照步骤 6.2.1 所述方法运行稀释后的 DNA 样品。
- 加索引基因表达文库的制备
- 将 10 µL 扩增后的 cDNA(步骤 6.3.3.5)转移至新管。加入 25 µL EB 缓冲液和 15 µL 片段化混合液。在冰上吹打混匀。短暂离心后将管子放入预冷至 4 °C 的热循环仪中。
- 在热循环仪中(盖子温度为 65 °C)启动以下程序:32 °C 5 分钟,1 个循环;65 °C 30 分钟,1 个循环;4 °C 保存。
- 按照步骤 6.1.3 所述方法进行双轮大小筛选和磁性珠纯化(0.6X, 0.8X)。加入 50.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。短暂离心后置于磁力架上,直至溶液澄清。
- 将 50 µL 样本转移至新管。加入 50 µL 接头连接混合液,吹打混匀。短暂离心。在热循环仪中(盖子温度为 30 °C)按照以下程序孵育:20 °C 15 分钟,1 个循环;4 °C 保存。
- 按照步骤 5.3.5 所述方法进行磁性珠纯化(0.8X)。加入 30.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。短暂离心后置于磁力架上,直至溶液澄清。将 30 µL 样本转移至新管。
- 基因表达文库的加索引 PCR。加入 50 µL 扩增混合液,并向每个样本中加入 20 µL 个体化双索引 TT Set A。
- 在热循环仪中(盖子温度为 105 °C)按照以下程序孵育:98 °C 45 秒,1 个循环;总共 11 个循环:98 °C 20 秒,54 °C 30 秒,72 °C 20 秒;72 °C 1 分钟,1 个循环;4 °C 保存。
注意:最佳循环数需根据细胞类型、RNA 含量和起始细胞核数量确定。本实验中总共使用了 11 个扩增循环。 - 按照步骤 6.1.3 所述方法进行双轮大小筛选和磁性珠纯化(0.6X, 0.8X)。向管中加入 35.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。短暂离心后置于磁力架上,直至溶液澄清。
- 将 35 µL 纯化并加索引的基因表达文库转移至新管。
- 基因表达文库中 DNA 片段大小分布分析。将 1 µL 文库 DNA 与 1 µL 低 TE 缓冲液混合。按照步骤 6.2.1 所述方法运行稀释后的 DNA(图 3A)。
- 加索引空间条形码文库的制备
- 按如下方式配制总共 100 µL 样本指数 PCR 混合液:50 µL Amp Mix(来自 GEM-X 单细胞 3' 特征条形码试剂盒),25 µL EB 缓冲液,20 µL 来自 Dual Index Plate TT Set A 的引物,以及 1 µL 经 EB 缓冲液稀释至 4 µL 的纯化空间条形码 DNA(步骤 6.3.4.4)。
- 在热循环仪中(盖子温度为 105 °C)按照以下程序孵育:98 °C 45 秒,1 个循环;总共 7 个循环:98 °C 20 秒,54 °C 30 秒,72 °C 20 秒;72 °C 1 分钟;4 °C 保存。
- 按照步骤 5.3.5 所述方法进行磁性珠纯化(1.2X)。向管中加入 35.5 µL EB 缓冲液,吹打混匀。室温孵育 2 分钟。将管子置于磁力架上,直至溶液澄清。
- 将 35 µL 纯化并加索引的空间条形码文库 DNA 转移至新管。可于 4 °C 保存最多 72 小时,或于 −20 °C 长期保存。
- 检测加索引空间条形码文库中 DNA 片段大小分布。将 1 µL 纯化后的文库 DNA 与 1 µL 低 TE 缓冲液混合。按照步骤 6.2.1 所述方法使用 Fragment Analyzer 运行稀释后的 DNA(图 3A)。
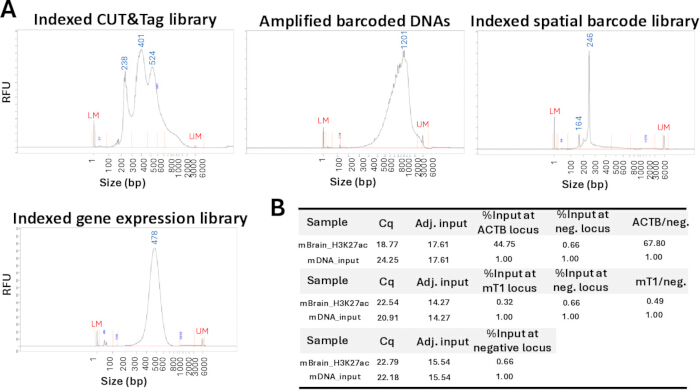
图3:带索引文库的质量控制评估。(A)扩增后DNA和带索引文库的片段大小分布。使用片段分析仪对DNA进行分析,以评估DNA的质量和片段大小分布。图中显示了带索引的CUT&Tag文库、用于基因表达和空间条形码文库构建的扩增DNA、带索引的基因表达文库以及带索引的空间条形码文库的代表性谱型。(B)通过qPCR分析CUT&Tag文库,以评估H3K27ac阳性基因组区域(即ACTB)相对于H3K27ac阴性背景信号(即T1和一个基因间区域)的富集程度。阳性与阴性区域之间的倍数差异被计算为富集倍数21。在此检测中,富集倍数大于10被视为理想结果20。 请点击此处查看该图的放大版本。
7. 文库测序
- 对 Trekker 空间条形码文库进行测序,每个捕获的细胞核测序深度为 5,000 对读长。
- 对 H3K27ac CUT&Tag 文库进行测序,每个捕获的细胞核测序深度为 25,000 对读长。
- 对基因表达文库进行测序,每个捕获的细胞核测序深度至少为 20,000 对读长。
8. 生物信息学与数据分析
- 使用 Cell Ranger ARC v2.0.2 处理基因表达和 CUT&Tag 测序数据,参数设置为 --min-atac-count=100 和 --min-gex-count=1000。利用 Trekker pipeline v1.3.0(默认参数)将 Cell Ranger ARC 输出结果与 Trekker 条形码信息整合,以分配空间位置。
- 使用 Signac 进行质量控制。满足以下任一条件的细胞将被排除在后续分析之外:对于 CUT&Tag 数据,总片段数 ≥ 1,000,000 或 ≤ 100,且 TSS 富集度 ≤ 2;对于基因表达数据,总 UMI 数 ≥ 100,000 或 ≤ 1,000,以及检测到的基因总数 ≥ 10,284 或 ≤ 200。
- 使用 scDblFinder 对基因表达数据、AMULET 对 CUT&Tag 数据去除双细胞。满足以下任一条件的细胞被归类为双细胞:(1) scDblFinder 评分 ≥ 0.6;(2) scDblFinder 评分 ≥ 0.3 且 AMULET ≤ 0.01;(3) 位于双细胞比例较高的聚类中。
- 采用 LogNormalize 方法对基因表达数据进行归一化,采用 TF-IDF 方法对 CUT&Tag 数据进行归一化。计算 RNA 的主成分分析(PCA)和 CUT&Tag 的潜在语义索引(LSI)嵌入,其中染色质模态使用 LSI 的第 2 至第 50 个维度。使用 FindMultiModalNeighbors 构建加权最近邻图,并基于多模态邻近图生成 UMAP 嵌入。
- 基于 FindTransferAnchors 和 PCA 投影映射策略(默认参数),使用 Seurat 标签转移方法对质控后 Trekker 数据进行注释。参考数据来自 ABC Atlas(版本 20230630)的单细胞 RNA 测序数据。在人工审校过程中,剔除了与已知组织解剖结构不一致的细胞类型预测结果。
注:生物信息学分析脚本可在 GitHub 获取:https://github.com/Liuy12/Mouse_Brain_Trekker_Multiome_Cuttag
结果
使用新鲜冷冻的小鼠脑组织冠状切片(厚度为 25 µm,覆盖约 10 × 10 mm 空间区域的 70%),本文所述的工作流程稳定获得了 50,100 个高质量细胞核(标准差 = 12,200,n = 8),足以用于后续的单细胞多组学分析(图 1)。在对组织切片进行 Trekker 空间条形码标记后,通过温和的组织解离方法分离细胞核,并使用 Invent 单细胞核提取试剂盒进一步纯化。该过程产生的碎片极少,细胞核聚集程度低,所得细胞核样品适用于单细胞检测。分离得到的细胞核代表性图像见图 2。
对于后续的单细胞核分析,包括CUT&Tag多组学检测(CUT&Tag + 基因表达),通常在此处理约50,000个细胞核。为了最大化细胞核回收率,采用了一种简化且高效的低起始量CUT&Tag方案,通过直接使用抗体–pA/Tn5靶向结合与标签化反应,从而最大限度地缩短孵育时间和洗涤步骤19。采用该方法,可回收约25,000个完成标签化反应的细胞核,平均回收率为48.3%(标准差 = 6.1,n = 3)。这些细胞核随后用于10x Genomics Chromium多组学凝胶珠进行单细胞条形码标记。在GEM生成过程中,目标输入约为15,000个细胞核,预计经过质量过滤后可回收约10,000个具有空间索引的细胞核。根据Trekker空间条形码解码结果,在单细胞数据集中,81.3%的细胞核(标准差 = 9,n = 3)可被明确分配至芯片内的空间位置。
空间Trekker–CUT&Tag多组学工作流程生成三个带索引的文库:CUT&Tag文库、基因表达文库和空间条形码文库。预扩增的条形码DNA被分为两部分,每部分根据凝胶微珠上靶标的捕获化学方法用于文库构建。CUT&Tag文库直接从预扩增DNA中扩增获得,其片段大小分布呈现CUT&Tag标签化反应的典型特征,对应无核小体和含核小体的DNA区域(图3A)。该文库在H3K27ac阳性Actb位点上的富集效果良好,显著高于H3K27ac阴性基因组位点20,21(即68倍差异,超过此前染色质免疫沉淀测序分析H3K27ac所确立的10倍截断值20)(图3B)。对于基因表达文库和空间条形码文库,预扩增DNA首先按照10x Genomics的cDNA扩增方案进行扩增,随后通过磁性微珠纯化根据片段大小分离为两部分。带索引的空间条形码文库由富含较短片段的部分构建而成,在预期片段大小处呈现明显的尖锐峰。基因表达文库则显示出以扩增后cDNA片段为中心的典型大小分布(图3A)。
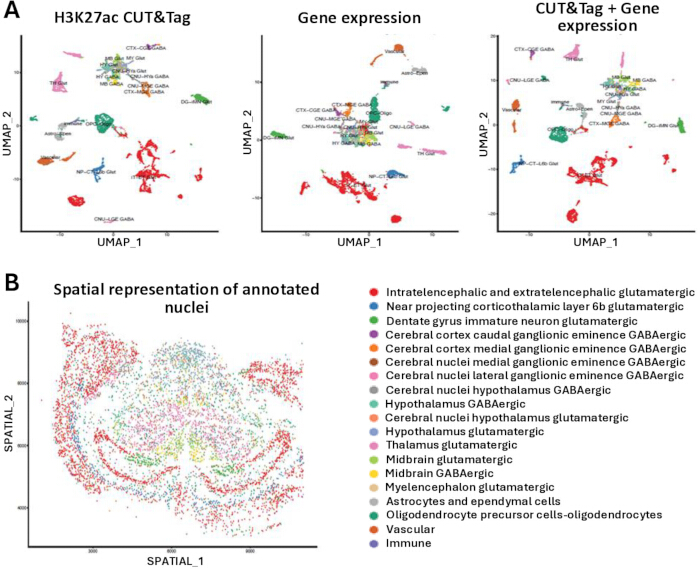
图 4:空间 Trekker–CUT&Tag 多组学检测在小鼠脑组织中的单细胞和空间表征。(A)通过单细胞分析鉴定细胞类型。均匀流形近似与投影(UMAP)图展示了仅基于 H3K27ac CUT&Tag、仅基于基因表达以及整合后的多组学数据集(CUT&Tag + 基因表达)所注释的细胞群体。 (B)空间 Trekker–CUT&Tag 多组学数据的空间表征。利用 Trekker 条形码将整合多组学数据集中的细胞核分配至空间坐标,揭示了小鼠脑组织切片中细胞类型解剖学上的有序分布。请点击此处查看该图的放大版本。
CUT&Tag 和基因表达文库的测序与比对采用 Cell Ranger ARC v2.0.2 软件,遵循 10x Genomics 的操作指南;空间条形码文库则使用 Trekker v1.3.0 软件,按照 Takara Trekker 的推荐方案进行处理。CUT&Tag 文库采用了建议的单细胞 ATAC-seq 比对参数。分别生成了仅包含 CUT&Tag、仅包含基因表达以及联合多组学(CUT&Tag + 基因表达)的单细胞核数据集。根据 Signac22 的标准,过滤掉 CUT&Tag 总 UMI 数 ≥ 1,000,000 或 ≤ 100,或基因表达总 UMI 数 ≥ 100,000 或 ≤ 1,000 的细胞。双细胞(doublet)预测结合使用 scDblFinder23(用于基因表达数据)和 AMULET24(用于 CUT&Tag 数据)进行。满足以下任一条件的细胞被剔除:1)scDblFinder.score > 0.6;2)scDblFinder.score 在 0.3 至 0.6 之间,且 amulet.score < 0.01。细胞类型注释基于 Allen 脑细胞图谱的参考数据26,使用 Seurat 的 FindTransferAnchors 方法完成25。本研究中,基因表达文库的每个细胞中位 UMI 数为 15,378,每个细胞中位基因数为 4,378。对于 CUT&Tag 文库,共检测到 11,860 个细胞,每个细胞中位高质量片段数为 6,631,TSS 富集得分为 7.66。对于 Trekker 空间条形码文库,92.43% 的细胞核被分配了空间位置,其中 51.54% 的细胞核被唯一确定至单一空间位置。原始测序数据及二次分析处理后的数据可通过 GEO 数据库获取,登录号为 GSE327406。最终经过质控后注释的 Seurat 对象可在 Zenodo 上获取,登录号为 19475899。带有细胞类型注释的代表性 UMAP 降维图见图 4A。通过将单细胞条形码与空间条形码关联,将各个细胞核回溯至其在组织中的原始空间位置,从而生成空间分布图(图 4B)。该图谱与相邻组织切片中观察到的解剖特征高度一致,并与 Allen 脑图谱27 中的小鼠脑冠状切面标准参考图谱相吻合。在单细胞分辨率下对空间基因表达和 H3K27ac 谱型进行联合分析,实现了主要脑细胞类型的鉴定,并揭示了组织切片中细胞分布的解剖学有序模式。
讨论
本方案描述了一种空间Trekker–CUT&Tag多组学工作流程,该流程整合了空间条形码技术、低起始量的H3K27ac CUT&Tag分析、在10x Genomics单细胞多组学凝胶珠上同时捕获多个分子靶标,以及后续用于Illumina测序的文库构建。通过将空间索引与单细胞表观基因组和转录组读数相结合,该方法解决了传统单细胞多组学检测中缺乏天然组织背景这一根本性局限。本研究成功证明了空间CUT&Tag多组学联合分析(H3K27ac CUT&Tag与基因表达)的可行性,并为基因表达与调控靶标(如组蛋白修饰和染色质相关蛋白)的空间共分析奠定了基础。
在整个工作流程的多个阶段实施严格的质控,对于成功执行该工作流程至关重要(图1)。尽管本文所述操作从切片后的步骤开始,但组织切片本身的质量对获得最佳结果极为关键。切片厚度应根据组织类型和预期细胞密度进行调整。在组织解离和细胞核分离过程中,最大限度地提高细胞核得率,同时保持细胞核完整性,对于基于Trekker的单细胞多组学检测的整体性能至关重要。细胞核得率偏低可能源于组织解离不充分、细胞核分离效率低下或切片过薄。细胞核完整性差可能由过度机械破坏、处理时间过长或过度裂解所致。细胞核分离是成功实施基于Trekker的单细胞多组学工作流程中的一个主要排查环节。因此,强烈建议在启动基于Trekker的单细胞多组学检测前,针对特定组织优化细胞核分离方案。分离得到的细胞核应进行定量和定性评估。使用细胞核染料进行计数可估算得率,而显微镜检查则可用于评估细胞核膜完整性、聚集情况以及非细胞核碎片的存在。文库构建完成后,应对所有文库检测片段大小分布及是否存在接头二聚体。对于CUT&Tag文库,应通过定量PCR评估目标基因组区域相对于背景的富集程度,从而在测序前初步判断检测的特异性和文库整体质量。测序后的质量控制对于准确解读空间多组学数据同样重要。应依据10x Genomics和Takara Trekker的推荐指南,评估诸如比对率、每个细胞核的片段数、转录起始位点富集度、CUT&Tag的峰内片段得分、基因复杂度以及每个细胞的测序深度等指标。对表观基因组和转录组两种模态数据的这些指标进行联合评估,有助于识别技术性假象,并确保空间、表观遗传和转录信息的可靠整合。
尽管本研究证明了基于Trekker的条形码标记方法结合单细胞CUT&Tag多组学检测的可行性,但该方法也存在局限性。例如,该技术目前仅限于新鲜冷冻组织,且仅在单一组织类型(小鼠脑组织)中针对单一组蛋白修饰(H3K27ac)进行了验证,尚未设置生物学重复。此外,该方法依赖于两个专有的商业化平台(Takara Trekker 和 10x Genomics Next GEM Chromium Single Cell Multiome)。为了全面评估该技术的适用范围、性能、普适性及可重复性,还需在多种组织类型中对更多表观遗传标记进行进一步验证。
综上所述,本文介绍的空间 Trekker–CUT&Tag 多组学方案展示了对表观基因组和转录组特征进行空间分辨单细胞共分析的能力。该方法通过将空间条形码技术与成熟的单细胞多组学化学反应相结合,能够在完整组织结构中开展基因调控机制的研究,为未来空间生物学应用提供了一个强大的平台。其潜在的重要应用包括评估各种实验和环境刺激对特定细胞类型中基因表达表观遗传调控的影响——例如,可在中枢和外周神经系统中的特定神经元类型中分析神经刺激的作用,或在炎症性疾病和癌症中揭示浸润性促炎和抗炎免疫细胞对邻近细胞的影响。
披露
作者无任何利益冲突需要披露。
致谢
本工作部分得到了美国国立卫生研究院基金R01 DK142826(T.O.)、R01 DK121766(Y.H.)、R01 DK126827(T.O.)、R01 DK131455(T.O.;MPI)、P30 DK084567(T.O.:表观基因组学与空间生物学核心,梅奥诊所胃肠道细胞信号研究中心)以及梅奥诊所总统战略倡议基金(T.O.)的支持。资助机构在研究设计、数据分析或稿件撰写过程中未发挥任何作用。本文内容仅由作者负责。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 0.4% 台盼蓝 | Invitrogen | T10282 | 由 4% 台盼蓝溶液(Invitrogen,T10282)稀释而成 |
| 10% 吐温 20 | Bio-Rad | 1662404 | |
| 10X Genomics Chromium X 仪器 | 10X Genomics | 1000331 | RRID:SCR_024537 |
| 12 孔板 | Thermo Fisher | 150200 | |
| 1X CUT&Tag 细胞核缓冲液 | 10x Genomics | 制备自 20X 细胞核缓冲液 | 配制总体积为 110 µL 的溶液,混合 5.5 µL 20X 细胞核缓冲液(10X Genomics)+ 8.25 µL RNase 抑制剂 + 1.1 µL 100 mM DTT + 95.15 µL 无核酸酶水 |
| 20X 细胞核缓冲液 | 10x Genomics | 2000207 | |
| 4% 台盼蓝溶液 | Invitrogen | T10282 | |
| 5200 片段分析仪 | Advanced Analytical | M5310AA | |
| ABC 图谱 | 开源 | N/A | 开发者:艾伦脑科学研究所(西雅图,华盛顿州) RRID:SCR_024440 |
| 激活剂 | Epigenome Technology | CF1006 | |
| 接头连接混合液 | 10X Genomics | 由连接缓冲液、酶和寡核苷酸制备 | 配制总体积为 50 µL 的接头连接混合液,混合 20 µL 连接缓冲液 + 10 µL DNA 连接酶 + 20 µL 接头寡核苷酸 |
| 接头寡核苷酸 | 10X Genomics | 2000094 | |
| 扩增混合液 | 10X Genomics | 2000047 | |
| Amulet | 开源 | N/A | 开发者:Ucar 实验室(杰克逊实验室) RRID: N/A |
| 抗 H3K27ac 抗体 | EpiCypher | 13-0059 | 该抗体批次已验证适用于批量及原位 CUT&Tag 检测 RRID:AB_3712075 |
| ATAC 缓冲液 B | 10X Genomics | PN-2000193 | |
| Buffer EB | Qiagen | 19086 | |
| cDNA 扩增反应混合液 | 10X Genomics | 由预扩增混合液和引物 2 制备 | 配制总体积为 65 µL 的 cDNA 扩增混合液,混合 50 µL 扩增混合液 + 15 µL 特征 cDNA 引物 2 |
| Cell Ranger Arc v2.0.2 | 10X Genomics | N/A | RRID:SCR_023897 |
| CFX Opus 实时荧光定量 PCR 系统 | Bio-Rad | 12011319 | |
| Chromium Next GEM 芯片 J | 10X Genomics | PN 2000264 | |
| Chromium Next GEM 单细胞多组学凝胶珠试剂盒 | 10X Genomics | PN-1000231 | |
| Chromium Next GEM 单细胞多组学 GEM 试剂盒 | 10X Genomics | PN-1000232 | 该试剂盒包含以下组分:条形码试剂混合液、条形码酶混合液、模板转换寡核苷酸、还原剂 B、清洗缓冲液和淬灭剂 |
| Chromium 回收试剂 | 10X Genomics | 220016 | |
| 清洗缓冲液 | 10X Genomics | 2000088 | |
| 冷冻切片机 | Leica Biosystem | CM1860 | |
| DNA 连接酶 | 10X Genomics | 220110 | |
| DNA LoBind 1.5 mL 管 | Eppendorf | 22431021 | |
| 双索引 TT 集合 A | 10X Genomics | PN-3000431 | |
| Dynabeads™ MyOne™ SILANE(用于制备 Dynabeads 清洗混合液) | 10X Genomics | PN-2000048 | 配制总体积为 200 µL 的 Dynabeads 清洗混合液,混合 182 µL 清洗缓冲液 + 13 µL Dynabeads Myone SILANE + 5 µL 还原剂 B |
| 洗脱液 I | 10X Genomics | 由 Buffer EB 制备 | 配制总体积为 100 µL 的洗脱液 I,混合 98 µL Buffer EB + 1 µL 10% 吐温 20 + 1 µL 还原剂 B |
| 特征 cDNA 引物 2 | 10X Genomics | 2000097 | |
| 片段化缓冲液 | 10X Genomics | 2000091 | |
| 片段化酶 | 10X Genomics | 2000090 | |
| 片段化混合液 | 10X Genomics | 由片段化缓冲液和酶制备 | 配制总体积为 15 µL 的片段化混合液,混合 5 µL 片段化缓冲液 + 10 µL 片段化酶 |
| 垫圈,6 件装 | 10X Genomics | 370017 | |
| GEM 主混合液 | 10X Genomics | PN-1000232 | 来自 Chromium Next GEM 单细胞多组学 GEM 试剂盒(PN-1000232)。配制总体积为 60 µL 的 GEM 主混合液,混合 49.5 µL 条形码试剂混合液 + 1.1 µL 模板转换寡核苷酸 + 1.9 µL 还原剂 B + 7.5 µL 条形码酶混合液 |
| GEM-X 单细胞 3' 特征条形码试剂盒 | 10X Genomics | PN 2000047 | |
| 高灵敏度 NGS 片段分析试剂盒 | Advanced Analytical | DNF-474 | |
| 孵育缓冲液 | Epigenome Technology | CF1001 | 配制总体积为 100 µL 的 CUT&Tag 孵育缓冲液 I,混合 90.5 µL 孵育缓冲液(CF1001,Epigenome Technology)+ 1.5 µL 通透剂 + 0.5 µL 稳定剂 + 7.5 µL RNase 抑制剂 |
| Invent Minute 缓冲液 A | Invent Biotechnologies, Inc | BN-020 | 来自 Minute 单核分离试剂盒 (货号 BN-020)。配制总体积为 800 µL 的 Minute 缓冲液 A,混合 786.4 µL Minute 缓冲液 A + 13.6 µL RNase 抑制剂(Takara Bio) |
| Invent Minute 缓冲液 B | Invent Biotechnologies, Inc | BN-020 | 来自 Minute 单核分离试剂盒 (货号 BN-020) |
| KEYENCE 荧光显微镜 | KEYENCE CORPORATION | BZ-X810 | RRID:SCR_025160 |
| 连接缓冲液 | 10X Genomics | 2000092 | |
| 低 TE 缓冲液(10 mM Tris-HCl pH 8.0,0.1 mM EDTA) | Thermo Fisher Scientific | 12090-015 | |
| Minute 过滤柱/收集管 | Invent Biotechnologies, Inc | BN-020 | 来自 Minute 单核分离试剂盒 (货号 BN-020) |
| 神经组织/细胞 Minute 单核分离试剂盒 | Invent Biotechnologies, Inc | BN-020 | 该试剂盒包含以下组分:Minute 缓冲液 A、Minute 缓冲液 B、Minute 过滤柱/收集管 |
| Nexcelom Cellometer K2 | Revvity | CMT-K2-MX-150 | RRID:SCR_025529 |
| 无核酸酶水 | Thermo Fisher Scientific | AM9937 | |
| 最佳切割温度(OCT)包埋剂 | Sakura Finetek USA | 4583 | |
| 分区油 | 10X Genomics | 2000190 | |
| 通透剂 | Epigenome Technology | CR1003 | |
| 预扩增混合液 | 10X Genomics | 2000270 | |
| 预扩增引物 | 10X Genomics | 2000271 | |
| 预扩增混合液 | 10X Genomics | 由预扩增混合液和引物制备 | 配制总体积为 54 µL 的预扩增混合液,混合 50 µL 预扩增混合液 + 4 µL 预扩增引物 |
| 淬灭缓冲液 | Epigenome Technology | CF1007 | |
| 淬灭剂 | 10X Genomics | PN-2000269) | |
| 还原剂 B | 10X Genomics | 2000087 | |
| CUT&Tag 文库样本索引 PCR 混合液 | 10X Genomics | 由预扩增混合液、SI-PCR 引物 B 和索引 N 制备 | 配制总体积为 60 µL 的样本索引 PCR 混合液,混合 50 µL 预扩增混合液 + 7.5 µL SI-PCR 引物 B + 2.5 µL 个体样本索引 N,集合 A(PN-3000427) |
| 空间条形码文库的样本索引 PCR 混合液 | 10X Genomics | 由预扩增混合液和索引板 TT 集合 A 制备 | 配制总体积为 75 µL 的样本索引 PCR 混合液,混合 50 µL 扩增混合液 + 25 µL Buffer EB + 1 μL 扩增条形码 DNA + 20 μL 双索引板 TT 集合 A(PN-3000431) |
| 样本索引板 N,集合 A | 10X Genomics | 3000427 | |
| scDblFinder | 开源 | N/A | 开发者:Germain 实验室(苏黎世联邦理工学院/苏黎世大学) RRID:SCR_022700 |
| Seurat | 开源 | N/A | 开发者:Satija 实验室(纽约基因组中心) RRID:SCR_016341 |
| SI-PCR 引物 B | 10X Genomics | 2000128 | |
| Signac | 开源 | N/A | 开发者:Satija 实验室(纽约基因组中心) RRID:SCR_021158 |
| SPRIselect 试剂盒,顺磁珠 | Beckman Coulter | B23318 | |
| SsoAdvanced™ Universal SYBR® Green Supermix | Bio-Rad | 1725271 | |
| 稳定剂 | Epigenome Technology | CR1005 | |
| T100 热循环仪 | Bio-Rad | 1861096 | |
| TAG 酶 | Epigenome Technology | CR1018 | |
| Trekker 10x10 O 型环 | Takara Bio | LC036 | |
| Trekker 10x10 试剂袋 | Takara Bio | K009 | RNase 抑制剂 |
| Trekker 10x10 瓷片遮蔽贴 | Takara Bio | LC023 | |
| Trekker 10x10 洗涤槽 | Takara Bio | RC002 | |
| Trekker 缓冲液 C(1 X PBS 含 5% BSA) | Takara Bio | K008 | 来自试剂盒 1(货号 K008)。配制总体积为 300 µL 的 Trekker 缓冲液 C,混合 245.7 µL 1X PBS + 50 µL 30% BSA + 4.3 µL RNase 抑制剂(Takara Bio) |
| Trekker 核洗缓冲液 | Takara Bio | K008 | 来自试剂盒 1(货号 K008) |
| Trekker 分析流程 v1.3.0 | Curio Bioscience | N/A | 开发者:Ucar 实验室(杰克逊实验室) RRID: N/A |
| Trekker 试剂盒 1 | Takara Bio | K008 | 试剂盒 1 包含以下组分:核分离缓冲液、核洗缓冲液、BSA |
| Trekker 初学者套件捆绑包(紫外灯) | Takara Bio | K011A | |
| Trekker U 10x10 瓷片 | Takara Bio | UP008 | |
| Trekker UV 裂解缓冲液 | Takara Bio | K008 | 配制总体积为 36 µL 的 UV 裂解缓冲液,混合 27 µL 核洗缓冲液(盒 1)+ 9 µL 0.4% 台盼蓝 |
| ViaStain AOPI 染色液 | Revvity | CS2-0106 | |
| 自定义引物序列 | 备注/说明 | 名称 | |
| 5'-CCCGGCAAGCCGAATAGGCA-3' | H3K27ac 阳性 | Ch-mActb-F | |
| 5'-ACCAGACGCTACGATCACGCC-3' | Ch-mActb-R | ||
| 5'-GAGACGCCGATCCGCCGAAG-3' | H3K27ac 阴性 | Ch-mT1-F | |
| 5'-ACTCTCCACTCCCACGCGCT-3' | Ch-mT1-R | ||
| 5'-CCTGCTGCCTTGTCTCTCTC -3' | H3K27ac 阴性 | Ch-mInter-neg-F | |
| 5'-ATGGCCTAGGGATTCCAGCA -3' | Ch-mInter-neg-R |
参考文献
- Ståhl, P. L., et al. Visualization and analysis of gene expression in tissue sections by spatial transcriptomics. Science. 353 (6294), 78-82 (2016).
- Asp, M., et al. Spatial detection of fetal marker genes expressed at low level in adult human heart tissue. Sci Rep. 7 (1), 12941 (2017).
- Larsson, L., Frisén, J., Lundeberg, J. Spatially resolved transcriptomics adds a new dimension to genomics. Nat Methods. 18 (1), 15-18 (2021).
- Rodriques, S. G., et al. Slide-seq: A scalable technology for measuring genome-wide expression at high spatial resolution. Science. 363 (6434), 1463-1467 (2019).
- Moffitt, J. R., et al. Molecular, spatial, and functional single-cell profiling of the hypothalamic preoptic region. Science. 362 (6416), eaau5324 (2018).
- Kleshchevnikov, V., et al. Cell2location maps fine-grained cell types in spatial transcriptomics. Nat Biotechnol. 40 (5), 661-671 (2022).
- Liu, X., et al. Spatial multi-omics: deciphering technological landscape of integration of multi-omics and its applications. J Hematol Oncol. 17 (1), 72 (2024).
- Marx, V. Method of the Year: spatially resolved transcriptomics. Nat Methods. 18 (1), 9-14 (2021).
- Zhu, C., Preissl, S., Ren, B. Single-cell multimodal omics: the power of many. Nat Methods. 17 (1), 11-14 (2020).
- Klemm, S. L., Shipony, Z., Greenleaf, W. J. Chromatin accessibility and the regulatory epigenome. Nat Rev Genet. 20 (4), 207-220 (2019).
- Mimitou, E. P., et al. Scalable, multimodal profiling of chromatin accessibility, gene expression, and protein levels in single cells. Nat Biotechnol. 39 (10), 1246-1258 (2021).
- Deng, Y., et al. Spatial-CUT&Tag: Spatially resolved chromatin modification profiling at the cellular level. Science. 375 (6581), 681-686 (2022).
- Liu, Y., et al. High-Spatial-Resolution Multi-Omics Sequencing via Deterministic Barcoding in Tissue. Cell. 183 (6), 1665-1681.e18 (2020).
- Zhang, D., et al. Spatial epigenome-transcriptome co-profiling of mammalian tissues. Nature. 616 (7955), 113-122 (2023).
- Lee, C. N., Fu, H., Cardilla, A., Zhou, W., Deng, Y. Spatial joint profiling of DNA methylome and transcriptome in tissues. Nature. 646 (8087), 1261-1271 (2025).
- Russell, A. J. C., et al. Slide-tags enable single-nucleus barcoding for multimodal spatial genomics. Nature. 625 (7993), 101-109 (2024).
- Huang, Y. H., et al. Unified molecular approach for spatial epigenome, transcriptome, and cell lineages. Proc Natl Acad Sci U S A. 122 (16), e2424070122 (2025).
- Kaya-Okur, H. S., et al. CUT&Tag for efficient epigenomic profiling of small samples and single cells. Nat Commun. 10 (1), 1930 (2019).
- Xie, Y., et al. Droplet-based single-cell joint profiling of histone modifications and transcriptomes. Nat Struct Mol Biol. 30 (10), 1428-1433 (2023).
- Caride, A., et al. Titration-based normalization of antibody amount improves consistency of ChIP-seq experiments. BMC Genomics. 24 (1), 171 (2023).
- Zhong, J., et al. Enhanced and controlled chromatin extraction from FFPE tissues and the application to ChIP-seq. BMC Genomics. 20 (1), 249 (2019).
- Stuart, T., Srivastava, A., Madad, S., Lareau, C. A., Satija, R. Single-cell chromatin state analysis with Signac. Nat Methods. 18 (11), 1333-1341 (2021).
- Germain, P. L., Lun, A., Garcia Meixide, C., Macnair, W., Robinson, M. D. Doublet identification in single-cell sequencing data using scDblFinder. F1000Res. 10, 979 (2021).
- Thibodeau, A., et al. AMULET: a novel read count-based method for effective multiplet detection from single nucleus ATAC-seq data. Genome Biol. 22 (1), 252 (2021).
- Butler, A., Hoffman, P., Smibert, P., Papalexi, E., Satija, R. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 36 (5), 411-420 (2018).
- Yao, Z., et al. A high-resolution transcriptomic and spatial atlas of cell types in the whole mouse brain. Nature. 624 (7991), 317-332 (2023).
- Wang, Q., et al. The Allen Mouse Brain Common Coordinate Framework: A 3D Reference Atlas. Cell. 181 (4), 936-953.e20 (2020).
重印与许可
