针对法律文本碎片化和医疗人工智能(AI)偏见溯源问题,本研究构建了法律知识图谱,并采用关系感知的图卷积进行语义对齐。通过基于梯度的反向传播识别偏见来源,实验指标表现良好,可支持合规的医疗AI应用。
本文内容
摘要
摘要
在医疗人工智能(AI)法律合规性分析中,本文针对多源异构法律文本语义碎片化导致的责任认定模糊以及算法偏见追溯困难等问题,构建了一种基于图神经网络的知识图谱构建与偏见传播路径检测方法。对四类异构节点——法律条款、医疗行为、算法模块和责任主体——进行结构化编码,并基于“违反”、“依据”、“触发”和“归责”四类法律语义关系构建有向图。随后,采用结合边类型特异性权重与注意力机制的关系感知图卷积网络,实现跨模态法律语义的多层特征对齐。接着,利用基于梯度的反向传播识别对偏见贡献显著的边,构建偏见传播子图,并通过社区发现定位根节点簇。最后,将实时决策流映射至临时节点,通过嵌入相似性验证合规性,同时监测关键边权重的动态变化,以预警系统性偏见积累。实验结果表明,在语义对齐准确性方面,所提方法在不同知识图谱密度梯度下,实体对齐平均准确率达到至少0.92,关系保持完整性平均达到至少0.88。在偏见定位能力方面,根节点召回率达到0.95±±0.02,传播路径精确率达到0.93±±0.03。本研究在一定程度上实现了法律逻辑与算法行为的深度耦合,为医疗AI的可信部署提供了一个可解释且可验证的合规支持系统。
引言
医学人工智能在诊断与治疗支持、资源分配和风险评估中的深度参与,使其决策与法律责任的承担紧密关联1,2。法律规范具有高度结构化特征,但其语义分布广泛,而人工智能系统的行为可能呈现“黑箱”特性,二者之间缺乏语义上可对齐且可追溯的接口3。在此背景下,构建一种能够捕捉算法行为序列中法律因果链条的共性表征框架,已成为实现责任细粒度归因与动态合规的必要前提4,5。本研究不仅关乎技术系统的法律检验,更涉及医疗公平性、算法公平性与制度信任的深层维护,因而具有重大的理论意义与现实紧迫性。
当前医疗人工智能法律合规性分析中的根本问题,在于法律语义与算法行为之间缺乏可计算的关联结构6,7。法律文件以纯文本形式存在,段落之间的关系交织着依赖、冲突和例外,导致在将其拆分为机器可解释的逻辑单元时面临困难8,9。尽管人工智能系统的决策过程被封装在数据驱动的黑箱中,但其输出的任何变化均无法追溯到特定的法律义务违反行为或责任划分节点10,11。此类脱节现象(例如训练数据偏见、模型设计缺陷或法律规范的语义解释问题)无法通过实验手段进行隔离分析,因而难以识别偏见来源,也无法明确开发者、部署者或使用者的法律责任12,13。更为严重的是,现有的合规检查流程仅验证最终输出是否符合固定规范,而未考虑偏见在“法律-技术”交互网络中的传播路径或放大效应14,15。当医疗人工智能同时受多项法律规定约束,且因对某一条款的误读引发一系列错误时,传统方法无法追踪该错误如何通过其他相关条款扩散并最终导致责任产生16,17。此外,系统实时决策流与现有法律知识图谱之间缺乏动态关联机制,导致系统运行过程中的合规性评估滞后,从而无法主动监测偏见累积的趋势18,19。上述问题共同导致责任认定的不确定性、归责机制脆弱以及监管干预延迟,严重阻碍了高风险医疗人工智能系统的可信部署及法律责任机制的有效实施。
首先,传统研究以结构化形式分析法律文本,并利用本体或规则构建特定领域的知识库,以支持合规性问答或风险提示20,21。尽管这些方法能够捕捉部分法律概念的表征,但它们往往预设法律内部逻辑具有一致性和静态性,难以应对跨司法管辖区的不一致、例外情况或模糊表述。后续研究引入了自然语言处理技术,利用预训练语言模型提取法律实体及其关系,提升了知识抽取的覆盖广度22,23,但仍停留在浅层语义层面,未能建立法律行为与技术行为之间的映射接口。在算法偏见治理方面,研究主要集中在公平性约束的设计24,25,其评估指标通常基于人口统计学变量,缺乏与法律归责原则的对齐。尽管部分研究尝试将法律规则编码为约束条件并嵌入模型训练过程26,27,但由于规则表达的刚性和粗粒度,难以适应复杂的临床情境。总体而言,现有研究将法律合规视为一种外部验证任务,而非系统架构中内在可计算的属性,导致法律逻辑与算法逻辑并行运行,无法支持对偏见传播路径的联合推理与动态干预。
近年来,由于图神经网络在关系结构显式建模方面具有优势,其逐渐被引入医学领域28,29。一些研究利用异质图整合判例、法律条文和当事人信息,通过节点嵌入支持案件推荐或量刑预测30,31,从而验证了图结构在捕捉法律关联方面的有效性。另一些工作将算法组件抽象为图节点,利用边表示数据流或调用关系,以追踪错误传播路径32,33。这些探索表明,图结构可作为法律要素与技术要素的共通载体。然而,现有图模型普遍存在三方面局限:其一,仅限于单一类型的边关系,无法区分法律语义中的规范性、因果性与归因性差异;其二,特征聚合过程忽略了边类型的语义权重,导致不同的法律逻辑路径被同等对待;其三,缺乏可微分的偏见传播追踪机制,难以定位高贡献度的边并重构责任路径。本文构建了一种关系感知的图卷积网络,通过为每种法律语义边类型分配专用的变换矩阵,并引入注意力机制动态调节跨类型信息流,解决了语义异质性融合问题。此外,结合梯度反向传播与子图提取,实现了从宏观层面合规性判断到微观层面偏见溯源的可解释性跃迁,突破了传统图模型仅支持静态推理的瓶颈。
在医学领域之外,基于图的方法和进化方法的最新进展已展现出在结构化知识处理中的广泛应用前景。例如,Xue 等人提出了一种多层混合遗传编程方法,用于本体匹配中的自适应相似性特征构建,在异构知识图谱间实现了鲁棒的对齐34。Cheng 等人系统综述了图卷积网络在图像复原中的应用,对去噪、超分辨率和去模糊等方法进行了分类归纳35。Li 等人从自动化机器学习的视角,全面综述了进化深度学习的研究进展,涵盖了其基本原理、算法、应用及开放性挑战36。Ma 等人开发了一种用于不确定性条件下缺陷识别的模糊神经架构搜索框架,验证了进化搜索在处理模糊数据方面的有效性37。这些研究凸显了将图结构表示与进化优化相结合在复杂决策任务中的潜力。
本文的核心目标是建立一个端到端可解释的医疗人工智能法律合规性分析框架,在三个层面实现了创新。在知识表示层面,首次将法律条款、医疗实践、算法模块和责任主体建模为四类异质节点。基于法律实践,提取出“违反”、“依据”、“触发”和“归责”四类有向关系,构建具有法律因果逻辑的有向知识图谱,为合规性分析提供结构化的语义基础。在偏见溯源层面,提出一种基于梯度敏感性的边贡献量化方法。通过反向传播,找出使输出偏见最大化的边集合,再应用社区发现算法对高贡献节点进行聚类,将“黑箱偏见”转化为“白箱责任聚类”,从而基于可操作的证据链实现归责。在实时动态监测层面,开发了一种临时决策节点嵌入机制,将人工智能的实时输出映射到知识图谱空间。通过嵌入相似度的比较,量化规范偏离程度,并监测关键法技关联边的权重变化,以预警系统性偏见的累积。该范式同时解决了语义碎片化与可追溯性难题,将法律合规从事后验证转变为事前治理,为高风险人工智能系统的责任透明化提供了可扩展的技术路径。
方案
医学人工智能法律知识图谱的图神经网络构建
如图1所示,所提出的框架包含三个主要模块。输入层通过多模态实体编码和有向边建模,将多源数据整合为异构图。随后,关系感知的GCN层通过类型特异性权重和注意力机制进行跨模态语义对齐,生成统一的节点嵌入。最后,这些嵌入支持偏差溯源(通过梯度反向传播和社区检测)和动态合规性监测(通过实时节点映射和边权重追踪),输出可为监管机构提供可解释的归因证据和风险预警。
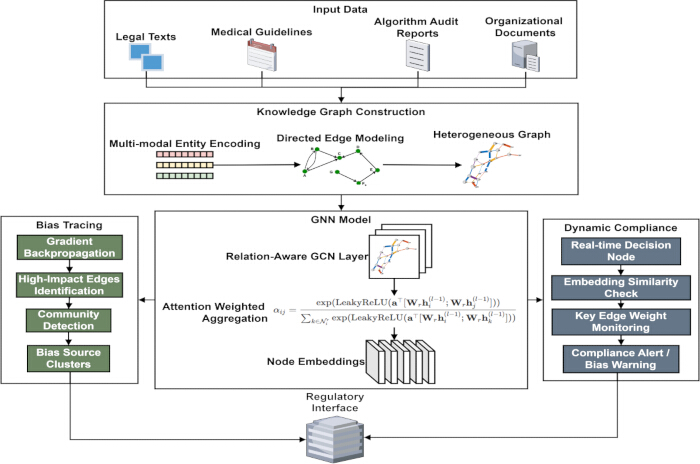
图1:面向医疗人工智能的法律知识图谱与偏见溯源架构。 该示意图展示了所提出框架的整体工作流程。输入层融合多源异构数据(法律文本、临床指南、算法审计报告),将其编码为四类实体(法律条款、医疗行为、算法模块、责任主体),并通过四种有向的法律-语义关系(违反、依据、触发、归责)进行连接。关系感知的图卷积网络(GCN)层通过类型特定的权重和注意力机制实现跨模态语义对齐。偏见溯源模块利用梯度反向传播识别高贡献度的边,随后应用社区检测定位根节点簇。动态合规监控模块将实时决策映射为临时节点,评估其嵌入表示与法律条款的相似性,并追踪边权重的演化以实现预警。输出内容包括可解释的归因证据和风险警报。请点击此处查看该图的高清版本。
法律实体及其关系的异质图结构化编码
从医疗人工智能监管法规、临床实践指南和算法审计报告中, consistently 提取出四类基本实体:法律条款、医疗操作、算法模块和责任主体。针对每种类型的实体,分别提出独立的特征表示学习模型,以实现语义上的可区分性。法律条款节点包含法律条款的编号,并将其作为该法律条款的唯一标识符(ID)。同时,定义了一个处罚严重性量化指标,用于表示与该条款相关的法律责任程度,进而建立特征向量。
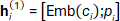 (1)
ci 是条目编号,Emb(·)表示低维嵌入映射,且[·;·] 表示向量拼接操作。该表示方法既保留了法律文本的形式结构,又保留了其惩罚的严厉程度,支持跨语句推理。
医疗行为节点基于临床操作分类系统进行标准化和编码,提取其风险等级 rj ∈ {1,2,3} 以及适用场景标签集合 sj ⊂ S,其中 S 为预定义场景类别的完整集合。使用多热编码对标签集合进行处理,并将其与风险等级嵌入向量拼接,形成初始表示:
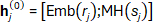 (2)
该策略确保不同类型的医疗行为在向量空间中具有可度量的距离关系,从而支持跨场景的比较。文本嵌入函数 Emb(·) 采用预训练的中文法律语言模型 Lawformer 实现(该模型在大规模中文法律语料库上进行预训练),输出维度固定为 768。
根据实体之间的逻辑依赖关系和法律约束关系,建立了四种有向语义关系:“违反”、“依据”、“触发”和“归责”,每种关系对应不同的法律因果模式。每条边 eij ⊂ E 被赋予一种标签类型 tij ⊂ T = {violate, base, trigger, attribute},用于后续的关系感知消息传递。边的构建严格遵循领域规则匹配机制:当医疗行为偏离规范要求时,建立从行为节点指向相关法律条款的“违反”边;当法律条款作为某项操作的技术合规依据时,建立“依据”边;若算法模块的输出直接触发特定医疗行为的执行,则连接“触发”边;责任归属关系根据组织的责任文件和审计结论建立,在责任方与违规行为或算法缺陷之间建立“归责”边。
所有节点初始化后,形成一个异质图(V, E, H0),其中 V 为节点集合,E 为带有类型标签的有向边集合,H0 为初始特征矩阵。为了增强图结构的语义区分能力,对节点特征进行归一化处理:
 (3)
μk 和 σk 分别表示训练集上第 k 个节点特征的均值和标准差,∈ 是一个用于防止除零的小常数。归一化确保多源异构特征在统一尺度上参与图卷积运算,避免数值主导效应干扰语义学习。所得到的结构化图模型完整地承载了医疗人工智能系统中法律、行为、技术与责任四个维度要素之间的关系拓扑,为后续的偏差传播分析提供了可计算的图基础。
用于跨模态法律语义的图卷积对齐增强
一种关系感知的图卷积网络38,39被用于在初始异构图的多层结构中传播特征,该网络扩展了关系图卷积网络(Relational Graph Convolutional Network, R-GCN)框架。尽管R-GCN为一般性关系数据引入了按关系划分的变换矩阵,但我们的方法进一步引入了可学习的注意力机制,以动态加权邻居节点的贡献,并定义了四种特定的法律语义关系类型(违规、依据、触发、归属),专门用于医疗AI合规性分析。每一层的操作均根据边的语义类型独立参数化其变换过程。对于任意目标节点,其邻域信息按照连接边的类型进行分组和聚合。每种关系类型均配备专用的线性变换矩阵,以区分沿不同法律语义路径传输的特征40,41。若法律条款节点与医疗行为节点之间的边属于“依据”类型,则当法律条款节点接收来自医疗行为节点的消息时,将应用相应的权重矩阵,对邻居节点的特征进行空间映射。同理,当医疗行为节点通过“触发”类型的边集成方案模块向算法模块发送输出时,将调用与此关系关联的触发参数矩阵并执行特征变换。该机制模拟了不同类型法律逻辑的流动性,使不同逻辑层在信息传递过程中保持语义独立性,避免跨模态噪声干扰。聚合操作定义如下:
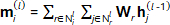 (4)
mi(l) 表示节点 i 在第 l 层收集的综合信息,Nil 是其在关系 r 下的邻居节点集合,Wr 是线性变换矩阵,hj(l−1) 是前一层中邻居节点的嵌入表示。
在消息聚合过程中引入了一种可学习的注意力机制,用于动态调整不同邻近节点对目标节点表示更新的影响强度42,43。注意力系数基于节点属性相似性和法律重要性双重因素生成,无需依赖固定的先验权重。对于法律条款节点,在接收邻近的医疗行为特征时,注意力评分依据后者相关处罚强度的量化值进行计算;当算法模块节点融合医疗行为信息时,其关注操作风险等级较高的邻近节点。注意力权重按如下方式计算:
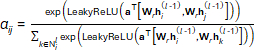 (5)
αij 是节点 j 对节点 i 的注意力系数,a 是可学习的注意力向量。该模型能够在端到端训练过程中自动识别高风险或高约束的连接路径,并为其分配更高的注意力权重。最终更新的节点嵌入由加权消息和残差连接共同决定。
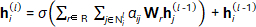 (6)
σ 是激活函数,残差设计缓解了深度传播中的梯度消失问题,并在存在多重语义冲突的情况下保证了稳定性。经过 L = 3 层图卷积层(每层具有 256 的隐藏维度和 ReLU 激活函数)后,所有节点的嵌入向量无缝融合了跨模态上下文信息,形成了具备合法语义区分能力的统一表示。
两种替代性的医疗人工智能法律合规性分析图如图所示 图 2,旨在揭示法律关系类型及偏见传播路径的可视化方法,指明该决策过程中潜在的偏见来源。 图 2A 展示了各种法律语义关系的影响,其中四种关系类型以不同颜色编码,每种类型的关系边由特定颜色区分。边的粗细对应于该特定关系的注意力权重,即该关系对人工智能决策的贡献程度。较粗的边表明该法律关系在决策中占据主导地位,在此情况下足以推动案件结果的形成。节点的大小由其对违规行为的贡献程度决定:较大的节点表示行为与特定法律条款之间的关联更强,因而具有更高的潜在风险。上述可视化呈现了一个清晰的法律语义层,使我们能够识别人工智能决策中最强且风险最高的法律路径。 图2B 还通过突出显示高贡献度的路径(对偏差传播的贡献),强调决策过程中具有高贡献度的边,这些边以加粗线条和虚线(例如 B1-B3)表示。这些边宽度的加倍反映了其在传播系统性偏差方面的重要性。哪些法律规则与技术行为的组合导致了偏差的这种放大效应,如图所示。 图2该分析不仅揭示了偏差传播的路径,还有助于确定偏差的来源,进而为人工智能工具的合规审计与责任认定提供依据。
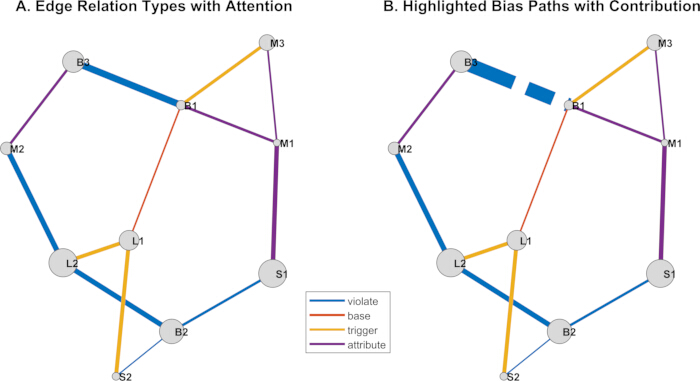
图2:医疗人工智能中法律合规性与偏见传播的分析(示意图)。(A)颜色编码的法律语义关系:违规(红色)、依据(蓝色)、触发(绿色)、归因(橙色)。边的粗细与注意力权重成正比,表示每种关系对人工智能决策的影响程度。节点大小与其违规贡献度成正比,突出显示高风险实体。(B)偏见传播子图:高贡献边以粗虚线表示(例如 B1-B3);双倍宽度的边表示系统性偏见的放大。该可视化有助于识别主要法律路径、偏见来源以及进行合规性审计。由于本图为示意图,不涉及测量尺度或误差线。请点击此处查看此图的放大版本。
用于偏差传播路径的子图回溯机制
本研究中,“偏倚”(bias)定义为人工智能系统输出相对于临床和法律预期决策的系统性偏离,通过模型预测的风险评分与真实合规标签之间的差异进行度量。偏倚信号通过算法最终输出与合规性二元指示符(合规为1,不合规为0)之间的交叉熵损失来量化,并在一批次内所有决策实例上进行汇总。
图神经网络训练完成后,利用其可微性对输出层中的偏差信号执行反向传播分析。从检测异常的算法决策节点出发,计算损失函数相对于每条连接边的梯度大小,以量化各条边对偏差形成所作的贡献。该过程通过自动微分框架实现,沿图结构中的有向边逐层反向追溯,获得每条边参数变换对最终输出变化的影响强度。梯度的绝对值越高,表明该边所承载的法律-技术关系在偏差传播中越占主导地位。边的贡献定义为:
 (7)
Lbias 是为有偏行为定义的可微损失,wi 是对应边类型的权重向量。该梯度值反映了特定语义关系在当前关联偏倚中的参与程度。在对所有边进行上述评分后,设定一个动态阈值 τ,以筛选出贡献度超过 gij > τ 的高贡献边集合 Ehigh,从而构成初始的偏倚传播子图 Gbias = (Vbias, Ehigh)。具体而言,τ 被设定为每个训练周期中所有边的绝对梯度值的第85百分位数,确保仅保留影响最大的前15%的边用于子图构建。该子图聚焦于最可能驱动系统性偏倚的关键连接路径,压缩搜索空间,提升溯源效率。
在构建的偏置传播子图中,执行基于谱聚类的社区检测算法,以识别高度一致的节点簇结构。该过程基于子图的归一化拉普拉斯矩阵分解,将节点嵌入映射到低维谱空间,并在该空间中采用感知密度的聚类策略,确保功能上紧密相关的跨类型节点(如法律条款与算法模块)被划分至同一簇中。每个识别出的社区代表一个潜在的功能回路或职责聚合单元。社区划分结果由以下优化目标驱动:
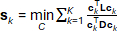 (8)
L=D−A 是子图的拉普拉斯矩阵,A 为邻接矩阵,D 为度矩阵,ck 是第 k 个社区的指示向量,K 为预设的社区数量。该准则通过最大化社区间的最小割差异,确保社区内部连接紧密。
现在,对每个社区进行基于跨层复合的分析。如果一个社区包含法律条款节点和算法模块节点,则将其标记为潜在的偏见来源。为了检验其因果性,进行干预测试:暂时从图中移除该区域内的所有边,再次执行相同的决策过程,并观察偏见度量指标的差异。因果有效性度量定义如下:
 (9)
B原始 和 B面罩 分别表示原始模型的偏差强度以及遮蔽后的偏差强度。如果因果有效性度量显著高于预设阈值,则表明该节点簇已被识别为可解释的偏差来源,这将为后续的合规性校正和责任归因提供指导。
法律约束的动态合规性验证
在医疗人工智能系统运行过程中出现的实时决策实例被引入作为瞬态节点,并嵌入到已学习的知识图谱空间中。每个节点通过读取其输入上下文、输出行为以及算法状态,生成一个初始特征向量。随后,该向量被输入至一个具有冻结参数的图神经网络,进行单层前向传播,从而得到与知识图谱对齐的嵌入表示,同时不改变原始图结构。因此,该方法使得瞬态节点与法律条款节点能够在统一的语义空间中进行比较。
然后计算瞬态节点与每个合法条款节点之间的余弦相似度:
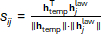 (10)
htemp 是临时节点的嵌入表示,hjlaw 是第 j 个法律条款节点的嵌入表示。相似度值实质上反映了当前决策与各法律约束之间的语义匹配程度。基于历史合规样本的相似度分布,设定一个动态合规阈值 θ,以适应不同应用场景下的判断边界。具体而言,θ = µ - 2σ,其中 µ 和 σ 是根据包含 500 个已知合规决策实例的验证集计算得到的余弦相似度分布的均值和标准差。
如果余弦相似度得分低于动态合规阈值,则视为违反相应的法治规则,从而触发合规告警机制。通知中还包括最小匹配法律条款编号、相似度值以及偏离分析的方向,这些信息足以使监管人员及时采取行动。该方法提供了一种从不透明的决策过程到法律语义空间的可解释性映射,有助于实时合规性检查。
在连续运行过程中,跟踪偏见传播子图中关键法律-技术关联边的权重变化趋势。重点关注连接算法模块节点与法律条款节点的边,因为这些边直接表征了技术行为对特定法规的响应强度。在推理过程中记录每个目标边的变换矩阵参数,并将其范数提取为二者之间关联强度演化的动态指标。定义边强度序列为:
 (11)
wt 表示与时间戳 t 时边 eij 相关的权重矩阵的弗罗贝尼乌斯范数,而 Wkl(t) 是模型在该时刻实际使用的参数矩阵。该指标反映了模型的学习深度或对合法约束的依赖程度。
对序列进行滑动窗口单调性检验,并采用改进的符号检验方法判断是否存在显著上升趋势。如果连续 N 个时间步长的增量满足正向主导条件,则认为该边表现出异常增强现象。进一步结合历史梯度贡献数据,若该边在上一轮溯源分析中已被识别为高影响路径,则启动系统性偏差累积预警流程。
最后,生成一份溯源报告,包含目标边两端节点的信息、权重变化曲线、相关决策频率的统计结果以及潜在的归因建议。该机制实现了从静态合规判断到动态风险预测的跨越,支持对潜在的机构偏差进行主动干预。
实验数据与设计
为验证所提出框架的有效性,本文构建了一个融合真实法规与模拟数据的多源异构数据集,并设计了严格的对照实验。数据来源包括国家医疗人工智能监管法规、临床诊疗指南、开源算法审计报告以及模拟决策日志。经过预处理后,构建了一个包含285个节点(85条法律条款、120项医疗行为、42个算法模块和38个责任主体)及1247条有向边的基准异构知识图谱,如图3所示。
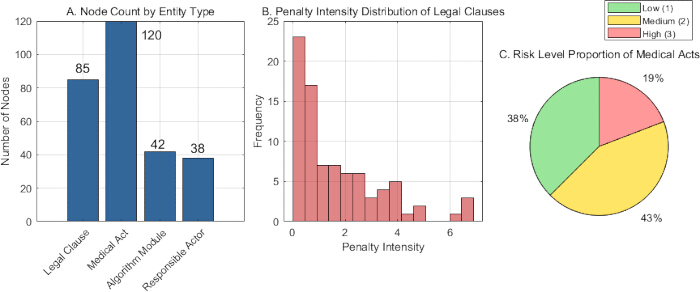
图3:异质性实体类型的分布与特征。(A)各类实体对应的节点数量柱状图:法律条款(85个)、医疗行为(120个)、算法模块(42个)、责任主体(38个)。(B)法律条款节点的处罚强度直方图,按低(0‑0.33)、中(0.34‑0.66)、高(0.67‑1.0)三类分组;纵轴表示频数。(C)医疗行为节点风险等级分布的饼图:低风险(19%)、中等风险(43%)、高风险(38%)。所有数值均为绝对计数或百分比;由于这些是数据集的描述性统计结果,未显示误差线。请点击此处查看该图的放大版本。
图3展示了异构知识图谱中实体节点的分布与特征。图3A显示了四类实体节点的数量分布,其中“医疗行为”节点数量最多(120个),其次为“法律条款”(85个),而“算法模块”(42个)和“责任主体”(38个)相对较少。这是因为该图谱在结构设计上以行为与规则为基础。图3B展示了代表唯一法律条款的节点的处罚强度分布,其中强度用于衡量法律责任的严重程度。数据表明,高处罚强度的条款相对较少,大多数处于中低强度区间,这与现实法律体系中仅有少数严重违规条款的情况一致。图3C展示了医疗行为节点的风险等级分布,其中中等风险行为占比最高(43%),低风险行为占比最低(19%),这表明医疗场景通常处于正常操作状态,而高风险操作在图谱中受到更严格的关联约束。这些统计结果共同验证了知识图谱构建中所采用的实体消歧编码方案,为后续的图卷积对齐提供了特征支持。
整个数据集按照节点类型和关系分布进行分层,随机划分为训练集(70%)、验证集(10%)和测试集(20%),以在每次划分中保持整体图结构的一致性。所有基线方法均使用相同的划分方式,以确保比较的公平性。除了这一基础划分外,上述三种知识图谱密度梯度(稀疏、中等、密集)以及三种跨司法管辖区复杂性设置(单边、双边、多边)作为独立的实用测试平台,共同评估该方法在不同数据完整性与监管重叠条件下的鲁棒性。为构建偏差定位评估的真值标签,我们采用两步策略:(1)专家标注——三名法律与医学领域专家独立审阅决策日志,识别每条记录的合规违规事件中的根本原因节点及其传播路径,分歧通过多数投票解决;(2)模拟注入——为实现受控测试,我们通过扰动知识图谱中的边权重,向20条随机选择的决策路径中人工注入偏差信号,确保真实源节点及受影响边在实验前已知。
对于所有基线方法(TransE、ComplEx、图神经网络(GNN)解释器、KG-BERT 和 Node2Vec),我们采用了与本方法相同的训练配置(Adam 优化器,学习率 1 × 10⁻³,批量大小 64,100 个训练轮次)和相同的数据划分,以确保公平比较。对于 TransE 和 ComplEx,嵌入维度设置为 256,边界值为 1.0;对于 KG-BERT,我们使用了预训练的 BERT-base 模型,批量大小为 16,最大序列长度为 128;对于 GNNExplainer,我们采用了一个 3 层 GCN,隐藏层维度同样为 256;对于 Node2Vec,我们设置游走长度为 80,每个节点的游走次数为 10,嵌入维度为 256。
为了确保公平比较,我们将所有基线方法均调整至相同的偏见定位任务,即根节点识别和传播路径重建。对于本身不具备可解释性的 TransE、ComplEx 和 Node2Vec,我们计算了偏见损失相对于每个节点嵌入的梯度,并以梯度幅值作为节点重要性评分;通过设定阈值筛选出根节点,并保留梯度贡献最大的边来重建传播路径。对于 GNNExplainer,我们直接使用其内置的边重要性评分和节点掩码机制来获取根节点及子图。对于基于三元组操作的 KG-BERT,我们将图中的每条边转换为文本形式的三元组,并利用模型对实体的注意力权重推导节点重要性,随后采用相同的阈值策略进行路径重建。通过上述调整,每种基线方法均可输出根节点预测结果和传播路径预测结果,从而实现对所有方法的统一评估。
评估围绕四个基本能力展开:语义对齐的准确性、偏见定位能力、问责效率以及跨领域的泛化能力。同时引入了三个重要的控制变量,以模拟真实世界的复杂性。
1)知识图谱密度梯度:为了评估该方法在不同信息完整度水平下的表现,采用随机删除边的策略,从基线完整图谱(密度 D = 1.0)中构建两个子集,具体如下:
稀疏图(D ~ 0.3):随机保留30%的边,模拟早期知识构建阶段大量信息缺失的情况。
中等密度图(D ~ 0.6):随机保留60%的边,模拟知识结构部分已知的典型情况。
密集图(D = 1.0):使用全部1247条边,对应知识相对完整的最佳情况。
2)医疗人工智能决策频率情况:设置三种人工决策流程负载,以测试动态合规性监控的实时性能:
低频10 Hz:平均每秒生成10个决策事件,用于模拟对小规模或单站点系统的监控。
中频 50 Hz:每秒 50 次决策事件,模拟区域或中等规模医疗机构的 AI 系统负载。
高频 100 Hz:每秒 100 次决策事件,模拟大型医院或云平台中部署的 AI 服务所面临的高并发压力场景。
3) 跨司法管辖区复杂性梯度:为了检验法律约束建模的可迁移性,构建了三个基于复杂性的测试集:
单一司法管辖区:仅包含当前中国规范医疗人工智能的法律法规。
双边司法管辖区:涵盖中国和欧盟的监管制度,约有15%的规则存在冲突和重叠。
多边司法管辖区:在前两个基础上,进一步整合了美国《健康保险可携性和责任法案》(HIPAA)的隐私与安全规则,构建了一个三大法律体系相互交织的测试环境,使规则冲突率提高至约25%。
定量评估采用以下关键指标:
1)语义对齐准确性:衡量图谱对法律实体与技术实体之间关系的建模能力。
实体对齐准确率:
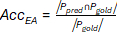 (12)
Ppred 是模型预测的对齐实体对集合,而 Pgold 是由专家标注的黄金对齐集合。
关系保持完整性:
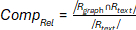 (13)
Rgraph 是图中重建的关系集合,而 Rtext 是从原始法律文本中提取的显式关系集合。
2)偏见定位能力:评估追溯偏见的根本原因及其传播路径的有效性。
根节点召回率:
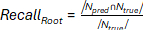 (14)
Npred 是模型识别出的偏倚源节点集合,Ntrue 是由专家标注的真实源节点集合。
传播路径准确性:
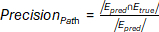 (15)
Epred 是模型推断出的偏差传播子图中的边集,而 Etrue 是真实的偏差传播边集。
3)可追溯性追踪效率:测试系统在实时监控场景下的性能表现。
平均追踪延迟:
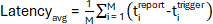 (16)
M 表示请求的总数,titrigger 和 tireport 分别表示第 i 次偏差触发的时间戳和源报告生成的时间戳。
系统通量:
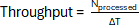 (17)
Nprocessed 表示在时间窗口 ΔT 内成功处理的并发追踪请求数量。
4) 跨领域泛化能力:验证该方法对不同法律体系的适应性。
管辖范围:
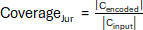 (18)
Cencoded 表示成功编码到图中的不同司法条款的数量,Cinput 表示输入条款的总数。
约束冲突检测率:
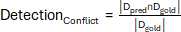 (19)
Dpred 是模型检测到的合法逻辑矛盾集合,而 Dgold 是由专家标注的所有矛盾对的集合。
所有实验均使用配备多核处理器和图形处理器的工作站进行;完整的硬件规格见材料表。
该方法的主要超参数及其取值列于表1中,涵盖模型结构、训练配置以及关键阈值,例如嵌入维度、卷积层数量、学习率和批量大小。所有参数均通过网格搜索基于验证集进行调优,训练后的模型已稳定收敛,且性能达到最优。部分阈值结合领域标准共同设定,以满足医学人工智能合规性检查对高可靠性的要求。
| 参数 | 数值 | 描述 |
| 嵌入维度 | 128 | 节点嵌入的特征维度大小 |
| 卷积层数 | 3 | 关系感知图卷积网络的深度 |
| 学习率 | 0.001 | Adam优化器的初始学习率 |
| 批量大小 | 32 | 每批次处理的子图数量 |
| Dropout率 | 0.1 | 训练过程中应用于节点特征的Dropout概率 |
| 注意力头数量 | 8 | 多头注意力机制中的头数 |
| L2正则化系数 | 5 × 10⁻⁴ | 参数正则化的权重衰减系数 |
| 相似性阈值 | 0.75 | 合规性验证所需的最小嵌入相似度 |
| 梯度贡献阈值 | 0.01 | 偏置子图构建中选择高影响边的阈值 |
| 监控窗口大小 | 10 | 用于跟踪边权重动态的时间步数 |
表1:主要参数设置。 实验中使用的关键超参数列表:嵌入维度(256)、GCN层数(3)、隐藏层维度(256)、学习率(1 × 10⁻³)、批量大小(64)、注意力向量维度、边贡献阈值(梯度幅值的第85百分位数)、动态合规性阈值(µ‑2σ,其中µ和σ来自包含500个合规实例的验证集)、社区数量K(由谱聚类确定)以及优化器(Adam)。这些数值通过在验证集上进行网格搜索选定。
结果
医疗人工智能法律知识图谱中偏见溯源性能验证
关系感知图卷积的性能
通过训练一种关系感知的图卷积网络,计算了不同卷积层中法律条款节点与医疗行为节点之间的嵌入相似性,并记录了每一层的对齐效果。其次,对训练后赋予四种法律语义关系的注意力权重进行统计分析,以量化每种关系类型在特征聚合中的重要性。最后,分析了邻近节点影响随距离衰减的模式。通过计算具有不同跳跃距离的节点对中心节点特征更新的贡献,量化了影响传播强度,并评估了消息传递机制的有效范围。整个评估过程基于对模型内部参数和激活状态的定量分析,以确保结果的客观性与可重复性。
图4展示了关系感知图卷积网络在跨模态法律语义对齐中的性能表现。图4A描绘了随着卷积层数增加,节点嵌入相似度的变化趋势,其值从第1层的0.12逐步上升至第4层的0.68。这一渐进趋势源于法律条款空间与医疗行为空间在多层消息传递过程中逐渐形成的共存关系。深层卷积层能够学习到跨模态语义关联的复杂模式。图4B展示了四种法律语义关系类型的注意力权重分布,“违规”关系获得了最高的权重0.35,这与法律合规性分析的基本原则一致,表明模型通过关注与违规相关的关联来支持有效的风险控制。图4C展示了邻居节点的多跳影响累积模式。测得的影响强度从1跳时的0.15单调递增至8跳时的0.92,表明中心节点的嵌入表示逐步融合了来自更远距离节点的更广泛结构信息。这种出乎意料的增长实际上捕捉到了中心节点对远距离节点的间接依赖性。当以更大的跳数距离观察节点时,可以获得更多的全局结构信息,但同时也会引入更多噪声和冗余信息。因此,在实际应用中,需要在感受野大小与信息质量之间取得平衡。整体数据变换过程表明,关系感知机制在处理异构法律文本与技术行为之间的关联方面是有效的,并且通过差异化的论据设计能够准确建模法律语义。
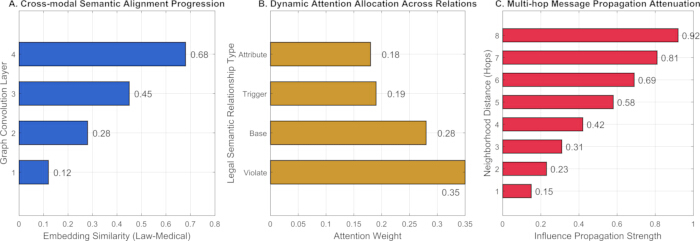
图4:关系感知图卷积网络的跨模态语义对齐性能。(A) 节点嵌入相似性(余弦相似性)随图卷积网络(GCN)层数(1至4层)的变化,显示法律与医学行为空间之间的对齐程度逐渐增强。(B) 四种关系类型(违规、依据、触发、归因)上的注意力权重分布,其中“违规”获得最高权重(0.35)。(C) 邻居节点影响强度随跳数距离(1至8跳)的变化,量化了多跳结构信息的累积效应。所有数值均为30次独立运行的平均值;误差条(为清晰起见未显示)在所有情况下标准差均低于0.05,且趋势呈单调性。请点击此处查看该图的放大版本。
为了理解关系感知图卷积网络中不同类型法律语义关系的参数优化过程及其性能特征,通过参数优化计算了每种关系类型的权重矩阵的平均幅值,并通过反向传播确认了参数学习的收敛性。在特征聚合质量方面,采用余弦相似度来评估跨类型节点嵌入的一致性。收敛速率通过每轮训练中损失函数的下降程度进行计算,以确保每种关系类型在训练过程中保持稳定。注意力稳定性通过计算不同训练阶段注意力权重的标准差进行评估。计算效率指标基于浮点运算次数进行标准化,以确保比较的公平性。所有指标均在相同的测试集上运行30次,每次使用不同的随机种子,以确保统计显著性。对于本方法与各基线方法之间的成对比较,我们进行了自由度为29的配对t检验。
图5展示了关系感知图卷积网络中参数优化效果及各类法律语义关系的性能特征。图5A显示了四种关系类型专用权重矩阵的幅值分布,纵轴表示关系类型,横轴表示学习得到的参数矩阵的幅值。其中“违反”关系达到最高的幅值0.78,表明该语义类型在模型中占主导地位,反映了法律合规性分析对识别违规行为的侧重。图5B比较了不同关系类型下的特征聚合质量评分,纵轴表示关系类型,横轴表示聚合效果得分。结果显示,“违反”关系在特征融合质量上表现最佳,得分为0.89。图5C描绘了各类关系的收敛速度性能,纵轴表示关系类型,横轴表示每轮训练的损失下降率。各关系按顺序对应的数值分别为:违反(0.023)、基础(0.031)、触发(0.028)和归因(0.035)。结果表明,“归因”关系收敛较慢,但最终保持稳定。图5D 展示了训练过程中三个阶段注意力权重的方差变化,纵轴表示训练阶段(早期、中期和晚期),横轴从左到右表示注意力权重的方差值。对应数值分别为0.18(早期)、0.12(中期)和0.08(晚期),表明模型在训练过程中逐步将注意力稳定在显著的关系上。图5E展示了不同关系在计算效率上的权衡情况,纵轴对应关系类型,横轴对应归一化执行时间,定义为完成特定任务所消耗的计算资源。各关系对应的数值分别为:违反(0.42)、基础(0.39)、触发(0.43)和归因(0.38)。各类别之间的分布较为均衡,表明关系感知机制在不降低性能的前提下实现了良好的资源分配。
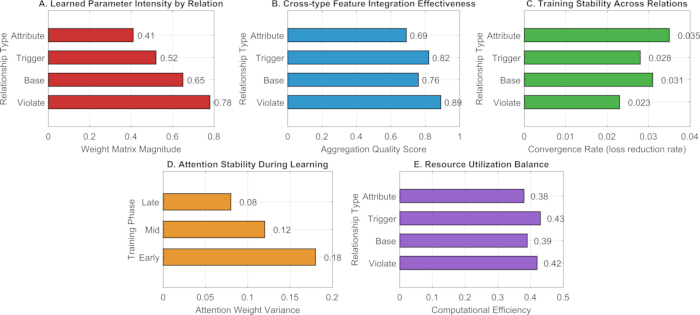
图5:卷积参数优化及关系感知图的性能分析。(A)每种关系类型专用权重矩阵的模(Frobenius 范数)。(B)每种关系类型的特征聚合质量评分(余弦相似性一致性)。(C)每种关系类型的收敛速率(每个训练周期的损失下降程度)。(D)在训练早期、中期和晚期阶段注意力权重的方差,显示其趋于稳定。(E)每种关系类型的归一化执行时间(相对计算成本)。所有指标均为 30 次运行的平均值;误差线表示标准差(在可辨识时显示)。违反关系表现出最高的模值和聚合质量,而归属关系收敛较慢但仍保持稳定。请点击此处查看该图的放大版本。
语义对齐准确性
以实体对齐准确率和关系保持完整性作为核心指标。在知识图谱密度梯度(稀疏/中等/密集)条件下,将所提出的方法与TransE、ComplEx、GNNExplainer、KG-BERT和Node2Vec进行比较。所有方法均运行30次,取平均值和标准差以消除随机性影响。
图6展示了所提出方法在不同知识图谱密度下与多种基准方法在实体对齐准确率和关系保持完整性这两个关键指标上的性能比较。图6A和6B中,横轴表示不同方法,纵轴分别表示实体对齐准确率和关系保持完整性。
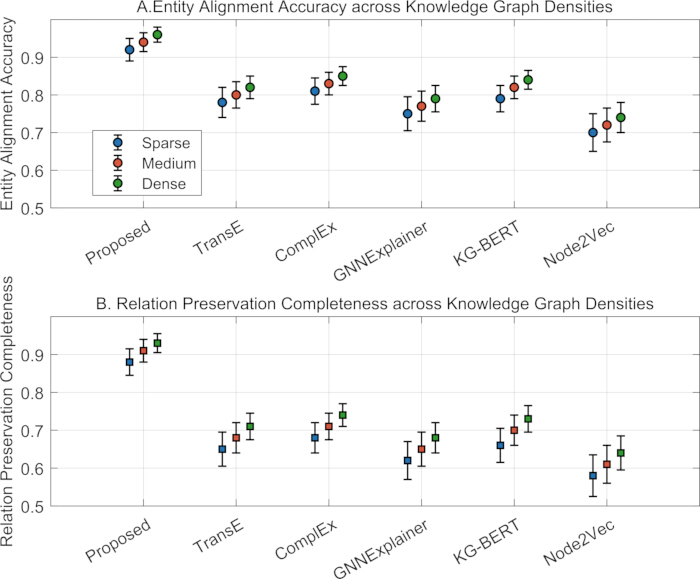
图6:在不同图密度下的语义对齐性能。(A)实体对齐准确率(公式12),以及(B)关系保持完整性(公式13),比较了所提出方法与TransE、ComplEx、GNNExplainer、KG‑BERT和Node2Vec的性能。柱状图高度表示30次运行的平均值;误差线表示标准差。所提出的方法在所有密度下均达到至少0.92的准确率和0.88的完整性,优于所有基线方法。请点击此处查看该图的放大版本。
从实体对齐准确率的角度来看,所提出的方法在不同密度条件下均表现出色,实体对齐平均准确率不低于0.92,达到最高水平,尤其在密集图中表现突出。这表明所构建的关系感知图卷积网络能够有效捕捉异质节点之间的语义关联,并通过边类型特异性权重和注意力机制实现跨模态特征的有效对齐。相比之下,传统方法(尤其是TransE和Node2Vec)由于缺乏对法律语义关系的显式建模,表现较差。所提出方法的优势也通过关系保持完整性结果得到验证,其平均关系保持完整性不低于0.88,表明该方法能够在不同图密度下较好地重建原始法律文本中的显式关系。这种稳健性能得益于异质图结构化编码与多层消息传递机制,能够全面捕捉法律条款、医疗行为、算法模块与责任主体之间的复杂关系。尽管GNNExplainer和KG-BERT展现出一定的关系建模能力,但在应用于法律规范语义时仍存在局限性,其性能不及所提出的方法。
偏倚定位能力的比较
偏差定位评估通过一个双质量协同验证框架进行,该框架基于根本原因节点的事实召回率和传播路径的精确度,关注源点追溯的完整性和路径的准确性。所有对比方法均在相同的图结构输入上执行,并采用相同的偏差模拟注入协议和评估接口定义,以确保测试的公平性。每次实验重复30次,使用不同的随机种子,以减少随机波动的影响。结果以均值形式呈现 ±± 标准差和配对 t 检验用于计算 p 值(相对于本文方法),以确保评估结论的统计严谨性和可比性。p 值由具有 29 个自由度的配对 t 检验得出(基于 30 次独立运行)。本方法与各基线方法比较的 t 统计量介于 7.82 至 12.45 之间,对应于所报告的 p 值。
表2展示了不同方法在偏见定位能力方面的定量评估结果,性能的两个核心指标分别为根节点召回率和传播路径精确率。在根节点召回率方面,本文提出的方法显著优于所有基线方法,达到了0.95 ±± 0.02的最高召回率,明显优于第二好的GNNExplainer方法(0.82 ±± 0.03),并显著优于其他方法。这一优势归因于本文提出的梯度感知量化机制,该机制能够精确追踪图中偏见信号的传播路径,并有效识别出贡献度高的源节点。相比之下,经典方法TransE和Node2Vec无法捕捉边类型的语义差异,因而难以清晰区分偏见传播路径与常规关系,其召回率分别仅为0.75 ±± 0.04和0.72 ±± 0.05。尽管KG-BERT引入了预训练语言模型,但其在图结构内的信息流动受到限制,召回率为0.70 ±± 0.04。
| 方法 | 根节点召回率 | p值(根节点召回率) | 传播路径精确率 | p值(传播路径精确率) |
| 本文提出方法 | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
表2:根节点召回率与传播路径精确率。 所有方法在偏差定位性能上的比较。数值以均值报告 ±± 30 次独立运行的标准差。展示了根节点召回率(公式 14)和传播路径精确率(公式 15)。所提出方法实现了最高的召回率(0.95 ±± 0.02)和精确度(0.93 ±± 0.03),显著优于基线方法(配对 t 检验,p < 所有比较的 P 值均小于 0.001。
该方法在传播路径准确性方面也表现最佳,其值为0.93 ±± 0.03,优于其他方法。这证明了所提出的子图回溯方法能够成功消除噪声边并识别出真实的偏差传播路径。p值分析进一步验证了性能上的显著差异;所有基线方法与所提出方法之间的差异均具有极显著统计学意义(p < 0.001),表明本文提出的方法在偏差定位问题中具有较强的鲁棒性和有效性。ComplEx 和 GNNExplainer 相对较好的表现可能说明复杂关系结构以及图神经网络可解释性在检测偏差中的重要性,但它们仍无法与本文提出的端到端解决方案相媲美。
问责追溯效率评估
评估基于问责追溯系统的实时响应能力,以平均追溯延迟和并发请求吞吐量作为两个关键效率指标。实验在三种医疗人工智能决策频率(低频、中频和高频)下进行。为确保公平比较,所有方法均输入相同的输入流,并执行完整的追溯流程。
图7比较了在不同医疗人工智能决策频率下,各方法在追溯责任方面的效率。结果从左到右依次对应所考虑的方法:线条分别标注为低频、中频和高频医疗人工智能决策。
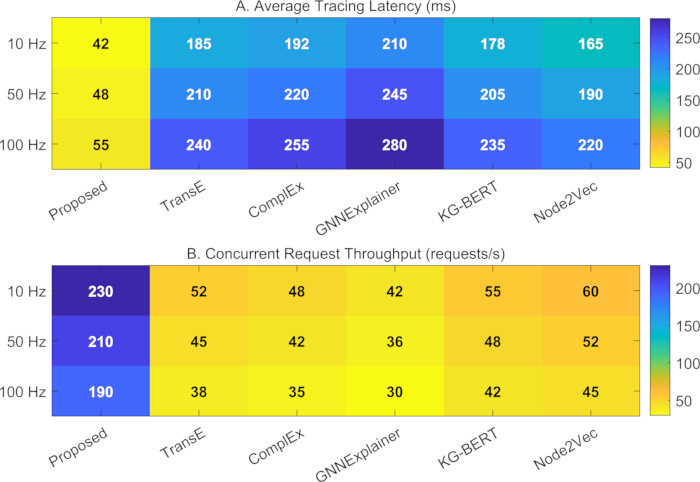
图7:平均源追踪延迟与并发请求处理吞吐量。(A)每种方法的平均追踪延迟(ms);(B)每种方法的吞吐量(请求/秒)。线条连接30次运行的平均值;误差条(如显示)表示标准偏差。所提出的方法在所有频率下均保持最低延迟(42–55 ms)和最高吞吐量(190–230 req/s),表现出更优的实时性能。请点击此处查看此图的放大版本。
在平均追踪延迟方面,所提出方法在所有频率条件下均表现最佳,且其他所有方法的延迟均显著高于我们的方法。所有方法的追踪延迟总体上均随决策频率的增加而增长,但我们的方法增长平缓:在低频条件下为42毫秒,在高频条件下为55毫秒。这一优势得益于该方法基于一种具有感知关系的图卷积网络,能够为不同类型的合法语义关系分配不同的权重矩阵,从而避免了传统方法在高并发情况下共享通用参数所带来的计算开销。相比之下,基于张量分解的TransE和ComplEx在高频条件下性能急剧下降。它们无法有效处理法律-技术关系之间长距离交互的非线性变换,导致延迟更高。在请求对处理时间方面,本文提出的方法同样表现更优。在低频设置下,其吞吐量达到230请求/秒,远高于其他方法。随着频率升高,吞吐量有所下降,但下降幅度可控,即使在高频场景下仍可维持在190请求/秒。这种鲁棒性归因于本方法中采用的临时节点嵌入策略以及梯度反向传播路径的并行设计,能够在高效批量处理请求的同时保证批量追踪的准确性。通用方法由于未针对此类场景进行专门优化,一旦面对并发查询,性能显著下降,因此不适用于实时监控。
法律约束覆盖跨域泛化能力的验证
评估过程从法律约束建模的跨领域能力角度进行,量化指标包括司法管辖区覆盖率和约束冲突检测率。实验设计了三种类型的跨司法管辖区复杂性,即单一司法管辖区、双边司法管辖区和多边司法管辖区。为消除由架构差异引入的评估偏差,对所有对比方法均重复实验30次,并报告平均结果,以公平比较其泛化能力。
如表3所示,该方法在三种法律管辖区复杂性条件下均持续优于所有基线方法,且性能下降更为平缓。在单一法律管辖区场景下,其冲突检测率达到近89%,法律覆盖率达到94%。当推广至多边法律管辖区时,仍可实现87%的覆盖率和81%的冲突检测率。相比之下,传统嵌入方法(如TransE和Node2Vec)在多边环境下覆盖率下降至约60%,且冲突检测率普遍较低,表明其难以应对跨法律管辖区的语义异质性。尽管KG-BERT和GNNExplainer通过引入额外的预训练语言模型或解释模块表现出一定改进,但在法律管辖区重叠的情况下,其性能仍出现显著下降。
| 方法 | 司法管辖区设置 | 法律领域覆盖率 | 约束冲突检测率 |
| 本文提出方法 | 单边 | 0.94 ± 0.02 | 0.89 ± 0.03 |
| 双边 | 0.91 ± 0.03 | 0.85 ± 0.04 | |
| 多边 | 0.87 ± 0.04 | 0.81 ± 0.05 | |
| TransE | 单边 | 0.76 ± 0.05 | 0.52 ± 0.06 |
| 双边 | 0.68 ± 0.06 | 0.45 ± 0.07 | |
| 多边 | 0.61 ± 0.07 | 0.38 ± 0.08 | |
| ComplEx | 单边 | 0.79 ± 0.04 | 0.55 ± 0.05 |
| 双边 | 0.72 ± 0.05 | 0.48 ± 0.06 | |
| 多边 | 0.65 ± 0.06 | 0.41 ± 0.07 | |
| GNNExplainer | 单边 | 0.82 ± 0.04 | 0.61 ± 0.05 |
| 双边 | 0.75 ± 0.05 | 0.54 ± 0.06 | |
| 多边 | 0.68 ± 0.06 | 0.47 ± 0.07 | |
| KG-BERT | 单边 | 0.80 ± 0.04 | 0.58 ± 0.05 |
| 双边 | 0.73 ± 0.05 | 0.51 ± 0.06 | |
| 多边 | 0.66 ± 0.06 | 0.44 ± 0.07 | |
| Node2Vec | 单边 | 0.74 ± 0.05 | 0.49 ± 0.06 |
| 双边 | 0.66 ± 0.06 | 0.42 ± 0.07 | |
| 多边 | 0.59 ± 0.07 | 0.36 ± 0.08 |
表3:司法管辖区覆盖范围与约束冲突检测率。 在单一、双边及多边法律管辖区下的跨域泛化结果。司法管辖区覆盖范围(公式18)和约束冲突检测率(公式19)以30次运行的均值±标准差(mean ± SD)表示。所提出的方法即使在最复杂的多边情境下仍保持较高的覆盖(≥87%)和检测性能(≥81%),而基线方法则显著下降。
这种差异源于完全不同的底层建模过程。现有的知识图谱嵌入方法(例如 TransE、ComplEx)利用静态向量空间中的几何关系进行建模,但从未区分“禁止”和“允许”等二元法律语义,这导致它们无法处理不同法律体系下同一医疗行为的细微规定。尽管 KG-BERT 能够捕捉文本上下文,但其缺乏显式的结构化推理能力,在处理条款间的规范依赖关系和冲突约束时存在困难。相比之下,所提出的模型通过引入四种类型的法律语义边(“违反”、“基础”、“触发”和“归属”),构建了一个有向异质图,并将关系感知的图卷积与梯度反向传播相结合。因此,该模型不仅保持了法律逻辑的因果方向性,还能动态对齐语义上平行的条款,并在法律领域多源输入中检测相互矛盾的规则。因此,在涉及多边法律体系中义务频繁冲突、责任重叠或适用优先级不确定等复杂场景下,该方法能够以结构化的方式精确定位矛盾来源,并将其转化为具有高覆盖度和准确性的跨领域推断。
消融研究
为了分离出每个核心组件的贡献,我们在密集图(D = 1.0)设置下,通过移除或替换框架中的关键模块进行了消融研究。具体而言,我们将完整模型与以下三种变体进行了比较:(1)无关系感知卷积(w/o relation-aware convolution),其中所有边类型共享一个变换矩阵;(2)无注意力机制(w/o attention mechanism),其中邻居节点的贡献被均匀平均;(3)无梯度反向追踪(w/o gradient backtracking),其中偏差源通过简单的节点度数启发式方法识别,而非基于梯度的子图重构方法。
表4展示了消融实验结果,揭示了各个组件的不同贡献。移除关系感知卷积导致性能下降最为显著,根节点召回率从0.95降至0.81,路径精确率从0.93降至0.78。这证实了针对特定类型边的建模对于捕捉法律关系的语义多样性至关重要,因为在所有关系类型间共享单一变换矩阵会导致跨模态对齐过程中大量信息丢失。注意力机制也有显著贡献;移除该机制后,根节点召回率降至0.88,路径精确率降至0.85,表明对邻居节点消息的动态加权有助于提升模型识别关键法律路径的能力,尽管其重要性次于关系感知机制。移除梯度回溯所导致的召回率下降最小(0.91),但路径精确率下降最大(0.76),说明尽管简单的启发式方法可部分识别源节点,但传播结构的精确重建在很大程度上依赖于基于梯度的敏感性分析。总体而言,这三个组件均对框架的偏差定位性能具有重要意义,其中关系感知卷积最为关键,而梯度回溯对于路径级别的准确性不可或缺。
| 模型变体 | 根召回率 | 路径精确率 |
| 完整模型 | 0.95 ± 0.02 | 0.93 ± 0.03 |
| 无关系感知卷积 | 0.81 ± 0.03 | 0.78 ± 0.04 |
| 无注意力机制 | 0.88 ± 0.02 | 0.85 ± 0.03 |
| 无梯度反向追踪 | 0.91 ± 0.03 | 0.76 ± 0.05 |
表4:稠密图(D = 1.0)上的消融研究结果。 移除关键组件的影响:(无关系感知卷积)、(无注意力机制)和(无梯度回溯)。指标(根召回率和路径精确率)为均值 ±± 30 次运行的标准差。完整模型表现最优,证实每个组件均具有显著贡献,其中关系感知卷积最为关键。
数据可用性:
本研究生成并分析的结构化异质知识图谱数据集,包括所有节点和边数据(涵盖四种实体类型共285个节点,以及具有四种合法语义关系的1,247条有向边),已存入Figshare数据库,DOI编号为:https://doi.org/10.6084/m9.figshare.33117644。该数据自本文发表之日起可公开获取。相应的数据集文件也作为补充文件1提供。
补充文件 1:本研究中使用的数据集文件。请点击此处下载该文件。
讨论
将医学人工智能整合到临床决策中,在责任归属方面引发了法律挑战,其障碍在于非结构化法律文本与黑箱算法之间的语义鸿沟。为弥合这一鸿沟,我们提出了一种基于图神经网络(GNN)的知识图谱,该图谱将法律条款、医疗行为、算法模块和责任主体建模为异质节点,并通过四种有向的法律语义关系(违反、依据、触发、归责)进行连接。该结构为跨模态对齐和偏见追溯提供了可计算的接口。
本方法在所有指标上均表现出更优的性能。在不同图密度下,实体对齐准确率(≥0.92)和关系保持性(≥0.88)均优于TransE、ComplEx和KG‑BERT。偏差定位的根召回率为0.95 ±± 0.02,路径精确率为0.93 ±± 0.03,显著超过GNNExplainer。动态监控保持较低延迟(42–55 ms)和高吞吐量(190–230 req/s),而跨司法管辖区测试显示较强的覆盖能力(≥87%)和冲突检测能力(≥81%)。这些结果证实了本方法在可解释的偏差追踪中有效弥合了法律与技术语义之间的鸿沟。
我们的成功基于三项创新:(1)类型化的法律-语义边能够捕捉因果关系和规范性差异,而这些差异常常被统一嵌入方法所忽略20,21;(2)针对每种关系类型配备专用变换矩阵的关系感知卷积,在保留语义特异性的同时支持跨类型信息交换38,39;(3)基于梯度的贡献量化与社区引导的聚类方法,将全局偏差转化为局部来源识别,从而克服了事后解释方法的局限性32,33。这使得合规性分析从静态的规则检查迈向动态的、结构感知的推理。
局限性包括依赖人工定义的关系抽取以及难以处理模糊条款。未来的工作将整合法律逻辑形式化方法(例如,可废止逻辑26,27)和在线学习以应对不断演变的法规,并扩展至其他高风险领域(如自动驾驶、金融)。用户参与的反馈机制将进一步优化归因结果。这些研究方向将巩固基于图的、可解释的人工智能作为可信智能系统基础的地位。
披露
该稿件尚未在任何其他期刊上发表,也未处于其他期刊的审稿过程中。所有作者均已批准本文的内容。作者声明不存在任何财务利益冲突。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| ComplEx | 开源实现(例如 OpenKE) | Version 1.0 | 用于知识图谱比较的复数嵌入基线方法 |
| GNNExplainer | 开源实现(https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | 用于偏差追踪的图神经网络可解释性基线方法 |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | 用于模型训练和数据预处理的中央处理器 |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | 基于 Transformer 的知识图谱嵌入基线方法,用于语义对齐 |
| Node2Vec | 开源实现(https://github.com/aditya-grover/node2vec) | Version 1.0 | 基于随机游走的节点嵌入基线方法 |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | 高性能 GPU,用于加速图神经网络训练 |
| 本研究方法(关系感知的 GCN) | 基于 PyTorch 的自定义实现 | PyTorch 1.12.0 | 提出的方法框架,包含按关系变换、注意力机制和梯度反向追踪 |
| TransE | 开源实现(例如 OpenKE) | Version 1.0 | 用于知识图谱比较的平移嵌入基线方法 |
参考文献
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.