本方案介绍了三流解耦网络(TDE-Net),这是一种结合了互补脑电图(EEG)表征、双空间视觉对齐和扩散解码的脑电到图像重建框架。
本文内容
摘要
摘要
从非侵入性脑电图(EEG)重建视觉刺激需要在空间采样有限的情况下,将短暂且含噪声的神经响应映射到有意义的视觉表征。现有的EEG到图像重建方法采用了多种神经表征和生成策略,因此需要可重复的工作流程来解耦结构和语义的贡献。本实验方案介绍了三通路解耦网络(TDE-Net),一种基于EEG的图像重建计算框架。该方案使用预处理的THINGS-EEG2记录数据,将EEG信息组织为原始EEG锚点、样本特异性功能图通路和多尺度时间语义通路。图通路通过图卷积和跨试验对比学习捕捉EEG通道间的频域关系,而语义通路则通过自适应空间加权和多尺度时间卷积提取任务相关特征。结构和语义特征被分别映射到变分自编码器(VAE)和对比语言-图像预训练(CLIP)的潜在空间,利用开发集选定的融合权重进行组合,并通过Stable UnCLIP进行解码。在10名参与者中,TDE-Net实现了平均CLIP成对识别准确率为0.8135,辅以其他指标验证了结构与特征空间的一致性。消融实验和表征层级分析进一步阐明了各通路的独立贡献。本方案为研究互补性EEG表征及基于扩散模型的视觉重建提供了可重复的框架。
引言
视觉感知解码是脑机接口(BCIs)与认知神经科学领域中的一个交叉学科研究方向。功能磁共振成像(fMRI)已实现真实图像的重建1,2,3,4,但其成本高昂、便携性受限以及血流动力学延迟,限制了部分应用场景。脑电图(EEG)具有毫秒级的时间分辨率,且设备相对易于获取,但其信噪比较低、空间采样能力有限,使得从EEG信号重建图像面临较大挑战。
方法复杂性的解释应结合普遍存在的偏差-方差权衡进行理解5。早期的视觉解码方法采用浅层或线性表示,而后续研究引入了紧凑的卷积、基于图结构以及基于注意力机制的编码器6,7,8,9,10,11。跨模态对齐方法也已从多模态特征学习12,13 发展到潜在扩散模型和大型视觉编码器14,15,16。这些方法建立了有用的基线,但它们的输入表示、潜在目标和解码器各不相同,因此结果应在其各自的实验设置下进行解读。
TDE-Net 的目标是提供一个模块化的 EEG 到图像重建框架,该框架将脑电图(EEG)的结构表征与语义表征分离,分别与互补的视觉潜在空间对齐,并融合这些预测结果以实现基于扩散模型的图像重建。近期的 EEG-视觉解码研究已提出基于 Transformer 的 EEG 引导生成方法(EEG-CLIP17)、结合动态脑网络的前景感知对齐方法(FSDBN18)、基于信息约束对齐的认知引导自适应模糊方法19,以及多层级双向仿生学习方法20。相关的 EEG 到图像重建流程,包括基于 EEG 嵌入的感知图(Perceptogram)和引导扩散模型,为潜在空间预测提供了额外参考21,22。TDE-Net 在模型结构上有所不同:它明确分离了原始 EEG 锚点、样本特异的功能图谱表征和时间语义表征,并在融合前分别对 VAE 空间和 CLIP 空间执行非对称对齐。这种结构设计使得可通过潜在空间和图像层级的分析,独立考察结构与语义成分的贡献。相比单一表征或直接对齐的 EEG 到图像方法,该模块化设计提供了独立的结构与语义通路,在潜在空间预测过程中保留了线性的 EEG 参考,并可通过消融实验和潜在空间分析独立评估每种表征的贡献。
TDE-Net 适用于具有配对的脑电图(EEG)响应和视觉刺激、充足的训练条件,以及以语义重建为主要目标的短刺激后时间窗的实验。其分阶段的结构支持对特征提取、潜在空间对齐、融合和扩散解码进行独立分析。对于极小规模的数据集或强调模型复杂度最低的应用场景,线性映射仍然适用;而当具备大规模任务特异性数据集并需要实现实时部署时,端到端神经解码器可能更为理想。
本方案在 THINGS-EEG2 快速序列视觉呈现(RSVP)环境下评估所提出的配置。主要贡献包括一种三流 EEG 表征方法,由原始线性锚点、样本特异性功能图流和多尺度时间语义流组成。这些互补的表征被映射到 VAE 和 CLIP 潜在空间,并在扩散解码前融合相应的预测结果。该框架在全部 10 名 THINGS-EEG2 受试者上进行评估,采用个体水平的重构度量、消融实验与时间窗分析,以及表征层级的可视化方法,其中空间注意力图被解释为头皮通道(地形图)分析。
方案
该方案包含六个连续阶段:脑电图(EEG)试验与图像潜在特征的准备;图结构流的构建;语义脑电编码器的训练;CLIP/VAE映射的拟合;潜在预测结果的融合,随后进行图像解码;以及对图像层面和表征层面结果的评估(图1)。
1. 准备脑电图试验和图像嵌入
- 记录源队列及采集方案。
注意:源队列包括10名健康成年人(平均年龄28.5岁,标准差4.0;女性8名,男性2名),视力正常或矫正至正常。参与者均签署书面知情同意书,获得经济补偿,并在柏林自由大学教育与心理学系伦理委员会批准下完成原始方案,符合《赫尔辛基宣言》23。- 使用公开的THINGS-EEG2数据集作为二次分析资源。
- 使用从THINGS中提取的源划分,包含1,654个训练概念和200个无重叠的测试概念,两个划分中27个高级别类别的比例保持平衡。为每个训练概念选择10张自然背景图像,为每个测试概念选择1张图像,共生成16,540个训练条件和200个保留测试条件。
注意:在本研究中,目标检测任务使用了独立的Buzz Lightyear捕捉图像,这些图像未纳入当前的重建分析23。 - 在解释脑电数据片段(epochs)时,遵循原始快速序列视觉呈现方案的时间参数。
注意:每个序列以750 ms的空白间隔开始,随后呈现20张中心图像。每张图像占据7度的视觉角度,显示100 ms,刺激起始异步间隔为200 ms,对应每秒5张图像。在序列前有一个750 ms的空白间隔,随后是长达2 s的反应期,参与者在此期间先眨眼,然后报告是否出现目标图像。在整个序列过程中,中央的靶心注视点始终可见23。 - 在组织数据集时,考虑原始记录会话的结构。使用每位参与者完成的四次记录会话数据,每次会话包括四次测试运行和约5分钟的15次训练运行。保留每个训练条件的四次重复和每个测试条件的80次重复,对应每位参与者分析82,160个非目标图像试验23。
- 使用原始THINGS-EEG2记录配置采集的脑电图(EEG)数据。这些记录以1,000 Hz采样,使用按照国际10-10系统排列的64通道EASYCAP和BrainVision actiCHamp放大器采集,Fz作为在线参考电极,并采用0.1–100 Hz的在线带通滤波器。
- 使用已发布的预处理数据,这些数据相对于图像起始时间从-200到800 ms进行分段,使用刺激前区间进行基线校正,下采样至100 Hz,限制为17个顶枕通道,剔除目标试验,并在每次记录会话内独立进行多变量噪声归一化23。
- 准备脑电试验张量
- 加载所有10名参与者的已发布预处理THINGS-EEG2张量。从每个源片段中选取刺激后0–800 ms的时间区间和17个顶枕通道,保持100 Hz的采样率,以获得每次试验80个时间点。保留每位参与者的16,540个训练图像条件和200个保留测试图像条件的源划分23(图2)。
- 为图流预训练,保留每个图像条件的四次独立训练重复,并从中采样两次重复以形成正样本对。对于原始流和语义流,将四次训练重复取平均,并对每个条件可用的80次测试重复取平均。
- 使用原始MVNN流程生成的预处理THINGS-EEG2张量;在每个实现的特征提取器内,在特征计算前应用文档中所述的文件级Z分数标准化。
注意:这种对重复的非对称使用是有意设计的:重复试验为图流对比预训练提供正样本对,而原始流和语义流使用条件级平均值进行监督映射。由此产生的设计将结构流中的重复级不变性学习与原始流和语义流中的条件级潜在预测相结合。
- 准备配对图像潜在表示
- 使用1,024维的CLIP视觉编码器和与sd2-community/stable-diffusion-2-1-unclip关联的VAE编码器提取配对图像目标。将VAE输入图像调整为768 x 768像素,将VAE后验模式存储为36,864维向量(4 x 96 x 96),并保持图像-条件顺序。
- 保存三种输入形式:用于图对比学习的重复试验张量、用于原始流和语义流的平均脑电张量,以及用于监督映射的配对CLIP/VAE图像潜在表示。
- 标准化并缓存输入
- 以固定的条件顺序缓存预处理的脑电张量、提取的图特征和语义特征,以及配对的图像潜在表示。
- 在岭映射过程中,从训练输入中估计特征级标准化参数,并将这些参数应用于开发和测试输入。
2. 构建图结构流
- 根据重复的训练试验构建图流,并在对比预训练后导出节点级特征。在测试特征提取过程中使用相同的图构建规则,在特征计算期间不使用测试图像的潜在表示。
- 将脑电图(EEG)试验转换为频域图输入
- 对每次试验进行80点快速傅里叶变换(FFT),保留前40个非负频率区间,在100 Hz采样率下覆盖0 Hz–48.75 Hz范围。使用对数幅度谱作为17 × 40的节点特征矩阵X。对于每个EEG样本,计算17个通道特征向量之间每一对的C_ij = |corr(X_i, X_j)|。
- 在每一行中保留对角线上的自相关以及三个最强的非对角线相关性(每行保留k = 4个条目,包含自相关),然后对保留的矩阵进行对称化,以定义样本特异的加权功能邻接矩阵A。在图卷积前应用对称度归一化。
- 在训练和测试过程中均使用此构建方法;不使用电极的物理坐标来定义固定图。
注意:保留自连接可维持每个节点的信号,而将通道间连接限制为每行三个可控制对称化前的图密度。频域表示为图构建提供了基于幅度的紧凑描述,但不保留相位信息或所有精细的锁相事件相关电位(ERP)时间信息;这些时间特征仍保留在原始锚定和语义时间流中。
- 结合电极拓扑结构与谱图卷积
- 应用一个五层图卷积网络(GCN)24,每层包含80个隐藏单元,采用ReLU激活函数、0.3的dropout率、对称度归一化以及均值图池化。
- 为对比学习目标使用一个80维的双层投影头,并导出17 × 80的节点级表示用于结构融合。对依赖输入的邻接矩阵应用谱图卷积;不引入独立的动态卷积操作符。
- 使用跨试验对比学习训练图流
- 在训练划分中,从相同图像条件下随机选择两次重复作为正样本对,并将批次中其他条件的表示视为负样本。使用温度参数τ = 0.5,优化InfoNCE对比目标25,批大小为32,采用学习率为5 × 10⁻⁴的Adam优化器,训练20个epoch,使用余弦退火至eta_min = 10–6,随机种子设为42。
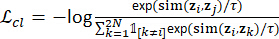 (1)
- 在对比目标中定义余弦相似性,并使用指示函数识别配对重复。保持投影维度为80,并在对比损失的两个方向上应用相同的温度参数。
- 在训练划分中,从相同图像条件下随机选择两次重复作为正样本对,并将批次中其他条件的表示视为负样本。使用温度参数τ = 0.5,优化InfoNCE对比目标25,批大小为32,采用学习率为5 × 10⁻⁴的Adam优化器,训练20个epoch,使用余弦退火至eta_min = 10–6,随机种子设为42。
- 导出节点级图特征用于早期融合
- 预训练完成后冻结图编码器,并导出每个节点具有80维的17通道节点特征。将这些特征与沿特征维度平均的原始EEG信号拼接,以获得用于VAE映射的“原始+图”结构输入。
- 保存生成的“原始+图”特征张量,并仅将其作为VAE回归分支的结构输入。
3. 训练语义 EEG 编码器
- 在平均的17通道、80个时间点的EEG张量上训练语义EEG编码器。
- 使用AdamW优化余弦嵌入损失(学习率5 × 10⁻⁴;权重衰减0.01),批量大小为64,训练50个周期,采用余弦退火至eta_min = 10–6,随机种子设为42,输出维度为1,024。
- 应用数据驱动的自适应空间滤波
- 对输入EEG张量应用可学习的张量积通道加权操作,并将表示扩展至深度9。将此操作视为一种数据驱动的通道加权层,而非经典共空间模式(Common Spatial Pattern, CSP)空间滤波器的实现26。
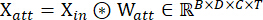 (2)
- 利用学习到的通道加权操作生成九个特征图,然后将其传递至多尺度时间卷积模块。
- 对输入EEG张量应用可学习的张量积通道加权操作,并将表示扩展至深度9。将此操作视为一种数据驱动的通道加权层,而非经典共空间模式(Common Spatial Pattern, CSP)空间滤波器的实现26。
- 在多个尺度上建模时间感受野
- 应用三个并行的时间卷积,卷积核大小分别为5、15和31个采样点,使用等长填充。将三个输出拼接以获得24个时间特征通道,并进行批归一化和GELU激活。
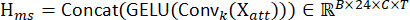 (3)
注:这些卷积在更广泛的时间卷积建模框架内提供了多尺度的时间感受野27。 - 将这三个卷积核大小作为多尺度时间滤波器;将其输出解释为学习到的信号表示,而非直接对应特定事件相关电位(ERP)成分。
- 应用三个并行的时间卷积,卷积核大小分别为5、15和31个采样点,使用等长填充。将三个输出拼接以获得24个时间特征通道,并进行批归一化和GELU激活。
- 重新校准任务相关特征通道
- 对时间维度应用深度注意力机制,采用自适应平均池化,后接一个卷积核大小为7的卷积层和Softmax归一化,符合通道重校准原则28。将得到的注意力权重与多尺度特征张量进行逐元素相乘。
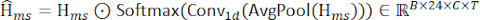 (4)
- 将注意力输出作为空间卷积模块的输入,且不将学习到的权重解释为因果性的神经定位。
- 对时间维度应用深度注意力机制,采用自适应平均池化,后接一个卷积核大小为7的卷积层和Softmax归一化,符合通道重校准原则28。将得到的注意力权重与多尺度特征张量进行逐元素相乘。
- 导出全局语义EEG特征
- 依次应用1 × 1卷积、覆盖17个电极通道的逐通道深度卷积、批归一化、GELU激活、池化因子为2的平均池化以及dropout(p = 0.5)。将结果展平并投影至1,024维的语义特征向量。
- 为每个平均后的EEG样本保存一个1,024维的语义特征向量。
4. 将脑电图特征映射到CLIP和VAE潜在空间
- 将每个 EEG 特征张量与具有相同条件索引的图像潜在表示配对。分别为 CLIP 和 VAE 目标拟合独立的映射关系,并确保训练分区中的所有图像条件与保留的测试分区中的条件互不重叠。
- 使用截距项并设置最多 50,000 次迭代进行岭回归29。对于原始信号到 CLIP 和语义到 CLIP 的映射,使用 λCLIP = 1,000;对于原始信号到 VAE 的锚定映射,使用 λVAE = 0;对于结构流到 VAE 的映射,使用 λVAE, struct = 1,000。使用训练分区的统计量对映射输入进行标准化。
注意:结构流是原始 EEG 和图特征的拼接;语义流包含语义编码器的输出,不与原始特征拼接。 - 将结构特征映射到 VAE 潜在空间
- 使用 λVAE,struct = 1,000 拟合结构流到 VAE 的岭映射,并预测 36,864 维的 VAE 潜在表示。该分支接收原始 EEG 和图表示的拼接结果;这是唯一明确拼接原始特征的非线性分支。
- 将语义特征映射到 CLIP 潜在空间
- 使用 λCLIP = 1,000 拟合语义流到 CLIP 的岭映射,并预测 1,024 维的 CLIP 表示。语义输入不与原始 EEG 拼接。
注意:本文中,λ 表示岭正则化参数,α 表示潜在融合权重。 - 使用样本级别的皮尔逊相关系数(PCC)评估潜在空间的对齐程度。使用开发条件选择融合权重,并仅在映射关系和融合权重固定后,评估 200 个保留的测试条件。
- 使用 λCLIP = 1,000 拟合语义流到 CLIP 的岭映射,并预测 1,024 维的 CLIP 表示。语义输入不与原始 EEG 拼接。
5. 融合潜在预测并运行扩散重建
- 仅基于16,540个训练条件中的条件级开发集划分来选择αVAE和αCLIP。以随机种子42为准,对全部10名受试者使用相同的90%拟合索引和10%开发索引;200个独立保留的测试条件不参与此过程。
注意:岭回归惩罚项和结构保持系数在最终的独立保留评估之前已作为配置值固定,未针对200个测试条件进行调优。 - 对每位受试者及每个候选α值({0.00, 0.05, ..., 1.00}),在拟合子集上拟合目标监督编码器和岭映射,并在开发子集上计算样本级别的潜变量皮尔逊相关系数(PCC)均值。
- 在10名受试者之间以相等权重平均各受试者级别的PCC值,并根据跨受试者平均值的最大值独立选择CLIP空间和VAE空间的权重。在重新拟合最终训练模型并评估独立保留测试条件之前,冻结这两个值。
注意:本流程选定αCLIP = 0.55,αVAE = 0.65。 - 对于VAE空间,将融合预测定义为原始到VAE锚点与结构流VAE预测的加权和:
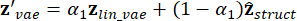 (5)
- 设定αVAE = 0.65,使原始到VAE锚点贡献0.65,结构流预测贡献0.35。该值在所有受试者和测试条件下保持固定。
- 对于CLIP空间,将融合预测定义为原始到CLIP锚点与语义流CLIP预测的加权和:
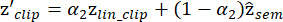 (6)
- 设定αCLIP = 0.55,使原始到CLIP锚点贡献0.55,语义流预测贡献0.45。该值在所有受试者和测试条件下保持固定。
注意:将融合操作解释为潜变量预测在集成组合一般意义上的固定加权集成30。不得将其描述为对过拟合的保证性降低,或在所有指标下均最优的解决方案。 - 从sd2-community/stable-diffusion-2-1-unclip加载冻结的Stable UnCLIP图像到图像流程,并使用fp16变体权重。将融合后的CLIP嵌入作为语义条件,融合后的VAE潜变量作为结构初始化。
注意:解码器遵循去噪扩散与无分类器引导原则31,32。 - 对扩散潜变量应用含噪结构初始化。将每个36,864维的VAE预测重塑为4 × 96 × 96,遵循变分自编码器潜变量的公式设定33,在将结构潜变量乘以结构尺度系数gamma = 0.02后添加高斯噪声。使用扩散训练步数T_diff = 1,000,并为报告的重建过程固定扩散种子为0。
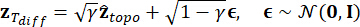 (7)
- 在含噪初始化中将结构保持系数gamma设为0.02,并在所有测试条件下保持该值不变。将生成的潜变量传递给解码器,不使用真实图像信息。
- 应用交叉注意力引导并解码图像潜变量。将融合后的1,024维CLIP向量与流程中使用的1,024维条件扩展向量拼接,为无分类器引导(CFG)前置一个零负条件向量,并以引导尺度7.5进行解码。采用流程默认的20个去噪步数,每个测试条件保存一张PNG图像。
- 以原始测试条件索引保存重建图像,并在后续所有指标计算中保留相同索引。
注意:表1总结了报告工作流程中所使用的数据划分、预处理、图构建、模型训练、潜变量映射、融合及解码设置。配套的工作表以机器可读格式提供了相同的参数汇总。
6. 评估重建与表示层对齐
- 通过像素相关性(PixCorr)和结构相似性(SSIM)计算低层次保真度。计算 AlexNet 第2层、AlexNet 第5层、Inception-v3 和 OpenAI CLIP ViT-L/14 的成对识别准确率;计算 EfficientNet(EffNet)和 SwAV 的相关性距离,其中较低的值表示更接近的特征表示。
- 对于 CLIP 分析,构建从 200 张重建图像中提取的特征与对应的 200 张真实图像之间的相关性矩阵。对每一张重建图像,将其与正确图像的相关性与其余 199 张图像的相关性进行比较,并对由此产生的 200 × 199 个二元比较结果取平均,以获得 CLIP 成对识别准确率。
- 对于结束于第 8、16、…、80 个时间点的扩展时间窗,拟合原始 EEG 岭映射模型,并在 200 个 sub-01 测试条件下,计算预测的与真实 CLIP 和 VAE 潜在变量之间按样本平均的皮尔逊相关系数(PCC)。以全时间窗仅语义流的 CLIP 和 VAE 预测结果作为虚线参考基准。
- 使用余弦相似性,基于 L2 归一化的 CLIP 特征构建表征相似性矩阵(RSMs)。两个矩阵均按照真实 CLIP 嵌入向量的欧氏距离进行 Ward 层次聚类排序。
- 在二维可视化中,从真实嵌入向量中提取五个 k-means 聚类,并对真实特征与预测特征共同应用一个联合的 PCA-50 加 t-分布随机邻域嵌入(t-SNE)投影;t-SNE 仅用于定性可视化。
- 以标注的通道、明确的颜色标尺和可重复的排序规则可视化白化的 EEG 模式和头皮通道模型权重。将这些图示解释为对测量的头皮信号和模型参数的辅助分析,而非皮层源定位、解剖激活或因果关系的证据。
结果
TDE-Net 从六个互补的角度进行了评估:重建性能、代表性视觉结果、组件贡献、时间依赖性、语义表征结构以及头皮通道注意力。低层次保真度采用 PixCorr 和 SSIM 进行评估,特征空间对齐程度通过 AlexNet、Inception-v3、CLIP、EffNet 和 SwAV 指标进行评估,个体层面的性能则基于全部 10 名 THINGS-EEG2 受试者的结果进行分析。除非另有说明,每个定性分析图均标明了对应的受试者及测试条件子集。
重建性能与代表性结果
作为内部参考模型,我们还实现了一个轻量级的卷积-注意力 EEG 编码器基线模型。该模型从每次试验中提取一个 1024 维的 EEG 表示,并独立地将其映射到 CLIP 和 VAE 潜在空间,采用与所提出方法相同的岭回归和扩散解码协议。在下文各节中,该模型记为基线模型(Baseline)。该编码器采用本地实现中使用的 LMDA 风格卷积-注意力语义参考,包含 373,950 个可训练参数,输出维度为 1,024。
表2比较了TDE-Net与内部卷积注意力基线模型以及代表性基于脑电图(EEG)的图像重建方法在各项报告指标上的表现。为确保评估的一致性,所有方法均在统一的实验框架下实现,采用相同的THINGS-EEG2数据划分、17通道输入、预处理流程、留出测试条件和指标定义,同时保留各自方法特定的网络架构。在十名受试者的汇总结果中,TDE-Net在像素相关性(PixCorr)上达到0.2531 ± 0.0138的均值±标准差,在结构相似性(SSIM)上为0.3388 ± 0.0025,在AlexNet第2层特征相似性上为0.8777 ± 0.0115,在AlexNet第5层为0.9153 ± 0.0116,在Inception-v3为0.7606 ± 0.0213,在CLIP成对识别准确率上为0.8135 ± 0.0074,在EffNet距离上为0.8285 ± 0.0122,在SwAV距离上为0.5085 ± 0.0101。受试者层面的汇总结果补充了单个受试者的定性示例。
CLIP 值表示成对识别准确率,而非余弦相似性或通用的 CLIP 特征评分。由于语义分支被训练以达到 CLIP 空间的目标,该指标同时反映了语义重建效果以及与一个分支目标的对齐程度。因此,它需与 PixCorr、SSIM、AlexNet、Inception-v3、EffNet 和 SwAV 一同考虑,这些指标分别表征了低层次保真度和特征空间一致性方面的互补特性。
为了评估被试个体层面的表现,我们对被试 sub-01 至 sub-10 应用了完整的 TDE-Net 测试流程,每位被试均使用相同的 200 个保留图像条件。表3 报告了每位被试在全部八项评估指标上的结果,以及被试间的均值和样本标准差(SD)。CLIP 成对识别准确率的均值为 0.8135(标准差为 0.0074)。PixCorr 和 SSIM 的均值分别为 0.2531 和 0.3388。AlexNet 第2层和第5层的准确率均值分别为 0.8777 和 0.9153,Inception-v3 的准确率均值为 0.7606。EffNet 和 SwAV 距离(数值越低越好)的均值分别为 0.8285 和 0.5085。这些指标在被试个体间变异较小,表明 10 名 THINGS-EEG2 被试在定量重建表现上具有一致性。
图3展示了所有10名受试者在相同的7个被保留的条件索引(1、32、62、86、87、108和175;基于零的文件编号)下的重建结果。第一行显示真实刺激图像,后续各行分别显示受试者sub-01至sub-10对应的重建结果。重建图像保留了刺激图像中共有的语义类别和典型的视觉特征,但在精细的物体身份、形状和局部纹理上因受试者而异。该布局为表3中总结的跨受试者结果提供了定性补充。
图4展示了六种特定的子-01测试条件下的定性重建结果。每一行分别显示了真实刺激、由我们本地实现生成的Perceptogram比较器21以及TDE-Net的重建结果。这些示例突出了各类方法在物体类别、形状、颜色和背景属性方面的保留情况,而在细粒度身份识别和背景细节方面则存在差异。
补充图1展示了从THINGS-EEG223的200个被试01测试条件中选出的最佳、中等和最差重建组。这些条件按照冻结融合EEG预测的CLIP嵌入与相应真实图像CLIP嵌入之间的余弦相似度进行排序。所展示的各组说明了该被试在语义一致性方面观察到的范围。
组分贡献与融合行为
表4展示了基于相同评估程序下获得的被试间平均值,对结构流和语义流进行的逐步消融分析。线性锚点(Linear Anchor)通过岭回归直接从预处理的脑电图(EEG)数据中预测CLIP和VAE潜在表示,作为消融研究的受控起点。该方法遵循先前EEG到图像研究(包括Perceptogram21)中所采用的通用线性潜在映射原则,同时使用本研究流程中的预处理、正则化、解码和评估设置。此设计使得结构流、语义流以及双空间融合能够相对于一个共同的线性基准进行考察。
从线性锚点模型出发,加入结构流后,SSIM 从 0.331 提升至 0.339,AlexNet 第5层准确率从 0.913 提高到 0.932,尽管 AlexNet 第2层准确率略有下降,从 0.889 降至 0.886。改为加入语义流则获得了最高的 PixCorr 值(0.237),同时保持了较高的 AlexNet 第2层准确率(0.888),并将 EffNet 和 SwAV 距离分别降低至 0.865 和 0.531。当通过双空间融合同时引入两个分支时,TDE-Net 实现了最高的 Inception-v3(0.761)和 CLIP 成对识别准确率(0.814),同时取得了最低的 EffNet(0.829)和 SwAV(0.509)距离。其 AlexNet 第2层准确率(0.878)仍低于线性锚点模型,SSIM(0.339)也略低于仅含结构流的配置。总体而言,跨被试消融实验结果表明,结构流和语义流分别影响重建的不同方面,而两者的融合主要增强了语义识别能力和深层特征空间的一致性。
图5 显示在该范围内,开发集对两个融合权重的敏感性 α 0.00–1.00,以0.05为增量。CLIP空间曲线在最大值处达到峰值 αCLIP = 0.55,而VAE空间曲线在其最大值处达到峰值 αVAE = 0.65。邻近候选值的PCC值相似,而两个潜在空间的最大值出现在不同的权重下。
脑电图信号的时间贡献
图6展示了被试sub-01(n = 200个测试条件)在8、16、...、80个时间点结束的原始脑电窗口中,各条件下的平均潜在皮尔逊相关系数(PCC)。CLIP和VAE曲线随着分析窗口的扩大而上升,并在较晚的时间窗口趋于平稳。虚线表示相应的全窗口仅语义流参考值。该分析描述了在所报告的映射协议下,结果对时间窗口的依赖性。
语义对齐与表征层级分析
图7 比较了在200种sub-01测试条件下,样本层面的CLIP潜在PCC在原始CLIP锚点与冻结融合CLIP预测之间的表现。高斯核密度估计采用Scott带宽,垂直虚线表示样本均值。融合分布相对于原始锚点的PCC均值提高了约0.013。图像层面的CLIP成对识别准确率在表2中单独报告。
图8 对比了真实图像CLIP嵌入与融合EEG预测CLIP嵌入的余弦相似性RSM。两个矩阵共享相同的数据范围,并基于真实CLIP嵌入之间的欧氏距离采用Ward聚类排序。残差图显示了预测RSM减去真实RSM的结果,其对称尺度由最大绝对残差定义,用于可视化表征一致性。
补充图2展示了200个真实标签和200个由脑电图(EEG)预测的CLIP嵌入向量的联合投影。通过对L2归一化的真实标签嵌入向量进行k均值聚类(n_init = 50;随机种子 = 7)获得五个聚类标签。将真实标签与预测特征拼接后,通过主成分分析(PCA)降维至50维,并使用t-SNE进行联合投影(困惑度 = 28,欧氏距离,随机种子 = 12)。该投影定性地呈现了两组表征的组织结构。
脑电图模式与空间注意力可解释性
补充图3 使用明确的概念-标签映射,将测试概念分为动物、食物/植物相关概念以及其他物体三类。在每一组内,行的顺序由经白化处理的真实CLIP嵌入向量的Ward聚类结果确定,并为保证可读性,每组最多均匀采样30个概念。热图显示的是经截断、归一化和白化处理的脑电振幅,其范围为-1至1;CLIP嵌入向量仅用于确定组内顺序。
补充图4展示了在选定的17个电极上归一化后的绝对语义流通道权重的标准10–20头皮拓扑图。该图总结了测量所得头皮通道间模型权重的相对分布,可解释为通道水平的模型权重可视化图。
本研究是对去标识化的 THINGS-EEG2 数据集进行的二次计算分析。原始脑电图记录、预处理后的脑电图数组、刺激元数据与图像以及静息态文件可通过 THINGS-EEG2 项目在 https://osf.io/3jk45/ 和 Figshare+(https://doi.org/10.25452/figshare.plus.18470912)获取。原始数据采集与预处理软件可在 https://github.com/gifale95/eeg_encoding 获取。脑电数据和刺激图像的访问与再使用需遵循源存储库规定的许可协议和署名要求。
TDE-Net 的实现,包括配准、融合、重建、评估和可视化脚本,可在 https://github.com/Yuan-ui198/TDE-Net 获取。与本论文对应的版本固定于提交版本 c99325d7f9e090ddd7cd5816aeabda7a9b9364da(https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da)。本研究未收集任何新的可识别参与者数据。
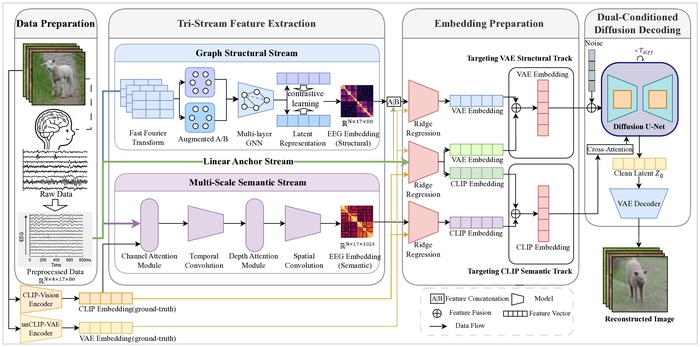
图1:TDE-Net 示意图。 该图展示了原始 EEG 锚点、样本特异性功能图流、语义时间流、到 VAE 和 CLIP 的双空间映射、加权融合以及双条件 Stable UnCLIP 解码过程。适用处标明了张量维度。 请点击此处查看此图的放大版本。
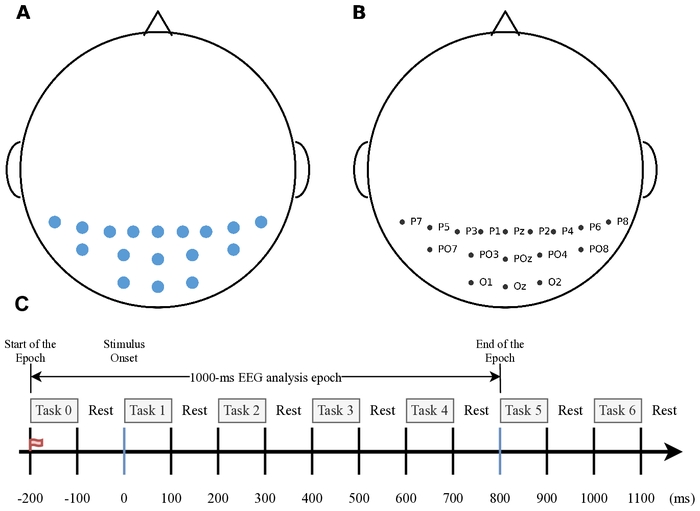
图2:脑电图电极选择与实验时间安排。 (A)从原始64通道记录中选出的17个顶-枕区电极的空间分布。(B)电极标签:Pz、P3、P7、O1、Oz、O2、P4、P8、P1、P5、PO7、PO3、POz、PO4、PO8、P6 和 P2。(C)快速序列视觉呈现(RSVP)的时间安排及脑电图片段定义示意图。图中“任务”表示图像呈现的时间间隔,“休息”表示图像之间的间隔;编号的任务区块表示连续的呈现时段,而非不同的实验条件。每张图像呈现时间为100 ms,刺激起始异步间隔为200 ms。脑电图片段从刺激开始前200 ms至刺激开始后800 ms,对应一个总长为1000 ms的脑电图分析时段。 请点击此处查看该图的放大版本。
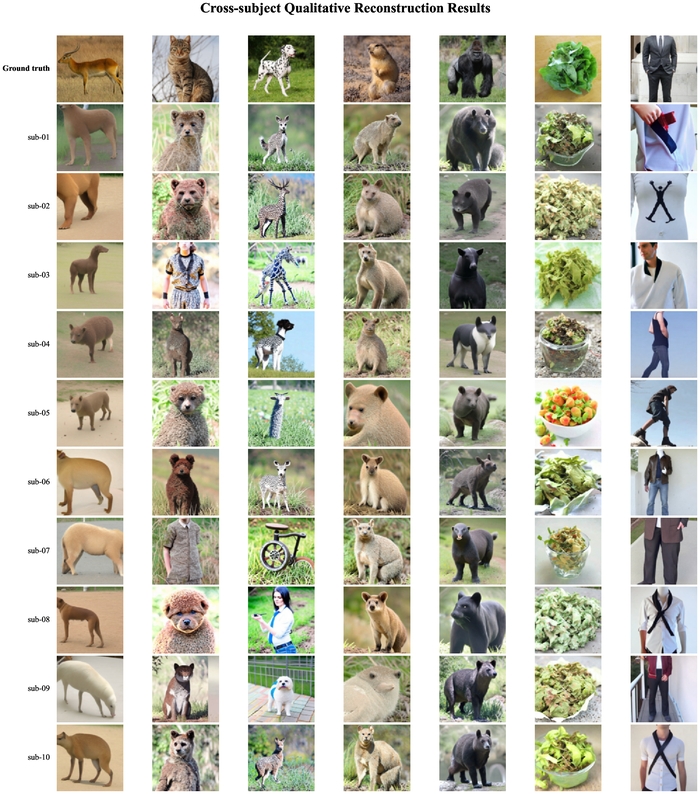
图3:七个保留图像条件的跨被试定性重建结果。 被试 sub-01 至 sub-10 使用相同的从零开始的条件索引(1、32、62、86、87、108 和 175)。第一行显示来自 THINGS-EEG2 测试集的相应真实图像样本,这些图像选自 THINGS 图像数据库34,其余各行则显示每位被试的 TDE-Net 重建结果。该图展示了常见的语义内容以及被试层面的变异;定量的跨被试结果见表3。请点击此处查看该图的高清版本。
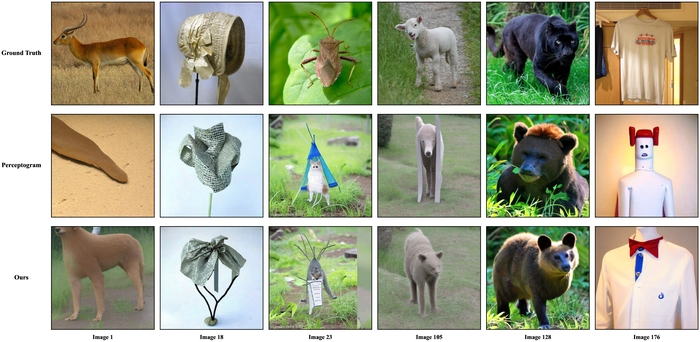
图4:六种指定的 sub-01 测试条件下的定性重建结果对比。 每行分别显示真实刺激图像、由本地实现生成的对比重建结果以及 TDE-Net 的重建结果;每列对应各个独立的条件编号。真实图像样本选自 THINGS 图像数据库34。 请点击此处查看此图的放大版本。
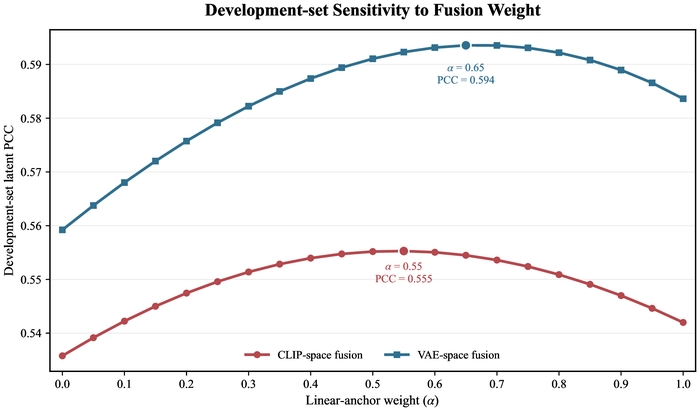
图5潜变量融合权重在开发集上的敏感性。 横轴表示线性锚定权重 α,互补流权重为 1 - α,纵轴表示开发集上的潜在PCC。候选值范围从0.00到1.00,以0.05为增量。CLIP和VAE空间权重通过10名受试者中受试者水平PCC的等权重均值最大化独立选择,得到 αCLIP = 0.55 且 αVAE = 0.65。PCC,Pearson 相关系数。 请点击此处以查看此图的放大版本。
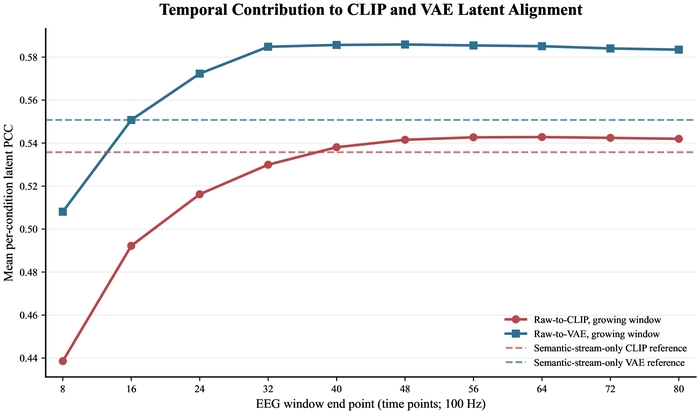
图6:被试 sub-01 潜在对齐的时间窗分析(n = 200 个保留条件)。 实线表示当 EEG 时间窗终点从 8 个时间点扩展至 80 个时间点(采样频率为 100 Hz)时,原始数据对 CLIP 和原始数据对 VAE 的岭回归预测在样本层面的平均皮尔逊相关系数(PCC)。虚线表示全时间窗仅语义流的 CLIP 和 VAE 参考值。PCC:皮尔逊相关系数。请点击此处查看该图的放大版本。
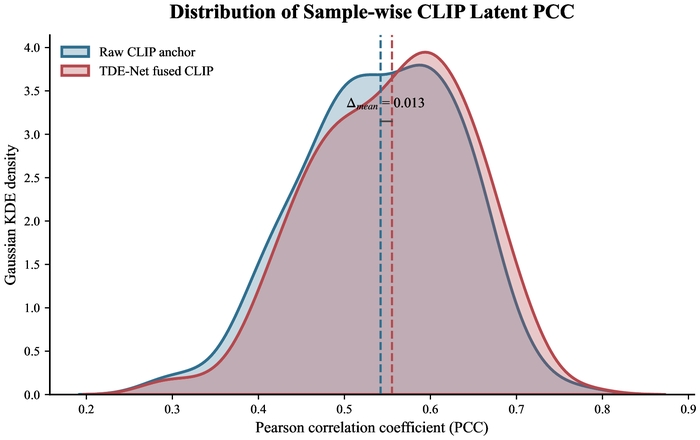
图7:子样本01中按样本划分的CLIP潜在对齐分布(n = 200个保留条件)。 曲线为原始CLIP锚点与冻结TDE-Net融合CLIP预测结果的高斯核密度估计(采用Scott带宽)。垂直虚线表示样本均值,注释标明其差值。PCC,Pearson相关系数;KDE,核密度估计。 请点击此处查看该图的放大版本。
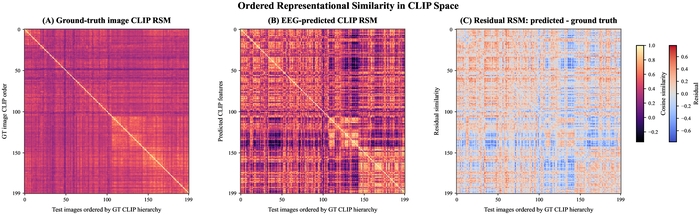
图8:被试 sub-01 在 CLIP 空间中的有序表征相似性(n = 200 个保留条件)。 (A)L2 归一化的真实图像 CLIP 嵌入向量的余弦相似性 RSM。(B)融合 EEG 预测的 CLIP 嵌入向量的余弦相似性 RSM,采用与 A 图相同的排序和颜色标度显示。(C)残差 RSM,计算方式为预测值减去真实值,使用由最大绝对残差定义的对称标度显示。排序基于真实 CLIP 嵌入向量的欧氏距离和 Ward 连接法获得。RSM,表征相似性矩阵。请点击此处查看该图的放大版本。
| 组件 | 参数 | 设置 |
| 数据与预处理 | 数据集划分 | 16,540 个训练样本和 200 个保留测试条件;拟合/开发集按 90%/10% 划分(随机种子 42) |
| 脑电输入 | 17 个顶枕通道;0–800 毫秒;100 Hz;80 个时间点 | |
| 频谱表示 | 80 点 FFT;40 个正频率 bins;0–50 Hz 对数幅度谱 | |
| 结构流 | 图构建 | 样本特异性绝对 Pearson 相关系数;每个节点加权 top-k = 4 个邻居;对称化与自连接 |
| GCN 架构 | 5 层;80 个隐藏单元;ReLU;dropout 0.3;对称度归一化;均值池化 | |
| 对比目标 | 80 维投影头;InfoNCE 温度 τ = 0.5 | |
| 训练 | Adam;学习率 5 × 10⁻⁴;批量大小 32;20 轮;余弦退火;最小学习率 10⁻⁶;随机种子 42 | |
| 语义流 | 架构 | 时间卷积核大小 5/15/31;深度 9;24 个特征通道;dropout 0.5;输出维度 1,024 |
| 训练 | AdamW;学习率 5 × 10⁻⁴;权重衰减 0.01;批量大小 64;50 轮;余弦退火;最小学习率 10⁻⁶;随机种子 42 | |
| 潜在映射 | 岭回归 | 拟合截距项;最大迭代次数 50,000;输入使用拟合划分集的统计量进行标准化 |
| 正则化 | CLIP 惩罚项 λ = 1,000;原始 VAE 惩罚项 λ = 0;结构 VAE 惩罚项 λ = 1,000 | |
| 目标维度 | CLIP:1,024;VAE:36,864 | |
| 融合与解码 | 融合权重 | CLIP 锚定权重 α = 0.55;VAE 锚定权重 α = 0.65;在开发数据上选定并在测试前固定 |
| 扩散模型 | sd2-community/stable-diffusion-2-1-unclip;结构缩放系数 γ = 0.02;扩散步数 T = 1,000 | |
| 采样 | 20 次去噪步骤;引导尺度 7.5;扩散随机种子 0 |
表1:TDE-Net 的整合参数汇总。 该表格列出了在报告的实验中所使用的数据划分、预处理、功能邻接矩阵构建、图与语义编码器设置、潜在映射惩罚、融合权重以及扩散解码设置。
| 方法 | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| 基线 | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| EEGImageDecode | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptogram (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (本文方法) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
表2:定量重建结果。 对比方法、内部卷积注意力基线模型(Baseline)和TDE-Net均在相同的实验框架下进行评估,使用相同的THINGS-EEG2数据划分、17通道输入、预处理流程、保留的测试条件和指标定义,同时保留各方法特定的网络结构。当前模型的结果以10名受试者的均值±标准差(mean ± SD)形式汇总。PixCorr、SSIM、AlexNet第2层、AlexNet第5层、Inception-v3和CLIP为数值越高越优的指标;EffNet和SwAV为相关性距离,数值越低越优。CLIP列报告的是使用OpenAI CLIP ViT-L/14模型计算的成对识别准确率。
| 受试者 | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| sub-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| sub-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| sub-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| sub-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| sub-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| sub-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| sub-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| sub-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| sub-10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| 平均值 | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| 平均值 ± 标准差 | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| 95% 置信区间 | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
表3:TDE-Net的跨被试定量结果。 每位被试贡献200个保留的测试条件。该表报告了被试sub-01至sub-10的八项指标,随后为跨被试的均值、样本标准差(SD)及95%置信区间(CI)。CLIP表示OpenAI CLIP ViT-L/14的成对识别准确率;EffNet和SwAV为越低越优的相关性距离。
| 方法 | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| 线性锚点 | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| 线性 + 结构流 | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| 线性 + 语义流 | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net(本文方法) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
表4:根据第6节实验方案中描述的评估程序报告的消融实验结果,以受试者间均值表示。 线性锚点(Linear Anchor)是一种局部评估的内部直接脊映射参考;结构、语义和完整配置使用相同的条件指数和度量定义。PixCorr、SSIM、AlexNet第2层、AlexNet第5层、Inception-v3 和 CLIP 为数值越高越优的指标;EffNet 和 SwAV 为数值越低越优的相关性距离。数值保留三位小数。
补充图1:被试sub-01在CLIP一致性范围内的代表性重建案例。 200个预留条件按融合EEG预测结果与真实CLIP嵌入向量之间的余弦相似度排序;展示相似度最高的6个、中等的6个以及最低的6个案例。每列将THINGS-EEG2测试集中的一幅真实图像样本与其对应的TDE-Net重建结果配对。真实图像来源于THINGS图像数据库34。 请点击此处下载该文件。
补充图 2:被试 sub-01 中真实情况与基于脑电图预测的 CLIP 表征的联合可视化(每种表征包含 n = 200 个条件)。(A)真实 CLIP 表征。(B)基于脑电图预测的 CLIP 表征。颜色表示对 L2 归一化的真实 CLIP 嵌入向量拟合的五个 k-均值聚类结果(k = 5,n_init = 50,随机种子 = 7)。这些聚类为数据驱动的分组,不对应于预定义的语义类别。真实与预测的嵌入向量被拼接后,通过主成分分析(PCA)降维至 50 维,再共同使用 t-SNE 进行投影(困惑度 = 28,学习率 = 自动,欧氏距离度量,随机种子 = 12)。PCA,主成分分析;t-SNE,t-分布随机邻域嵌入。 请点击此处下载该文件。
补充图 3:按广泛图像概念类别分组的受试者 sub-01 的脑电图(EEG)模式。 概念被归类为动物、与食物/植物相关的概念或其他物体。在每个类别中,行按照白化处理的真实 CLIP 嵌入向量的 Ward 层次聚类顺序排列,并为便于阅读均匀采样至最多 30 个概念。列显示 17 个 EEG 通道,每个通道包含 80 个时间点。颜色标尺(-1 到 1)表示经截断、归一化和白化处理后的 EEG 振幅。 请点击此处下载该文件。
补充图4:语义流头皮通道注意力拓扑图。 颜色表示在标准10–20头皮投影中选定的17个电极上学习到的通道权重参数的归一化相对幅值;电极点及其标签标识了测量位置。该标度范围为0到1,总结了模型学习得到的通道间相对权重分布。 请点击此处下载该文件。
讨论
本研究提出了一种模块化的计算工作流程,将脑电图(EEG)预处理、结构与语义表征学习、CLIP/VAE 潜在空间映射、特征融合以及扩散解码过程分离开来。这种分阶段的结构使得中间输出能够独立于生成图像进行分析,并遵循了从紧凑型 EEG 编码器到跨模态及基于扩散的重建方法的总体发展趋势6,11,12,13,14,15,16,,17,18,19,20,21,22。跨被试分析报告了每个被试的个体数值,以及十名留出被试评估结果的组间均值和样本标准差(SD)。结合表4中的逐步消融实验,该分析量化了所报道流程中各数据流的特异性效应以及被试间的变异程度。
关键步骤与故障排除
最重要的实现控制措施包括分区隔离、一致性归一化、条件索引保持以及独立的 CLIP/VAE 映射。融合权重必须根据开发条件进行选择,并在测试重建前冻结。当性能意外偏低时,应首先验证数组顺序和维度,然后检查原始及分支特异性的潜在空间 PCC、融合元数据以及图像层级的指标输出。潜在空间对齐失败表明上游映射存在问题,而潜在空间稳定但图像表现多变的情况可能反映随机性或依赖解码器的行为。14,21,22,29.
改变电极蒙太奇、采样率或时间窗口需要相应地调整图构建、谱特征和时间核。应使用互补的低层次和语义度量来评估重建质量,因为单一指标无法同时反映像素保真度、结构相似性以及对象层面的一致性6,11,21,22,23。本文所用的CLIP度量为成对识别准确率,而图7和图8使用的是潜在层的PCC;这两个量不可互换。
TDE-Net 的模块化结构为研究互补的脑电图(EEG)表征是否对视觉重建的结构和语义方面产生不同贡献提供了一个框架。该方法可能有助于系统地比较 EEG 特征表征、潜在目标以及生成式解码器,而不仅仅依赖于最终重建的图像。其他替代方法包括直接的线性 EEG 到潜在空间映射、单通路卷积或基于注意力机制的编码器、基于图的表征,以及端到端神经解码框架6,7,8,9,10,11,17,18,19,20,21,22。当前的工作流程可能特别适用于视觉感知解码、神经表征分析以及无创脑机接口的研究,在这些研究中,分离中间的 EEG 到潜在空间的预测有助于明确哪些组分对重建性能产生贡献。
局限性
主要局限性包括固定的 THINGS-EEG2 RSVP 采集方式、选定的 17 个顶枕通道、受试者特异性的映射关系、单一的扩散解码器,以及定性化的可解释性分析21,22,23。对 10 名受试者的汇总分析探讨了数据集内部的受试者间变异性,但未建立跨数据集或跨范式的迁移能力。生成的图像可能包含看似合理但并未得到 EEG 输入支持的细节,而 RSM、t-SNE、EEG 模式和注意力视图均无法确立因果性的神经机制。逐步消融实验在共享的原始 EEG 锚点、潜在目标、扩散解码器和评估协议下,刻画了结构流、语义流以及双空间融合的各自贡献。
未来方向
在这些限制条件下,结果支持在扩散解码之前,在独立的语义空间和图像潜在空间中评估互补的脑电图表征。未来的研究应测试独立的数据集、受试者适应性、不确定性估计、替代的导联组合以及对不支持的视觉细节具有更强控制能力的解码器14,15,16,17,18,19,20,21,22,23。在将当前发现推广到更广泛的神经科学或脑机接口场景之前,必须开展此类研究。
结论:
TDE-Net 结合原始 EEG 锚点与结构和语义 EEG 表征,分别将其与 VAE 和 CLIP 的潜在空间对齐,并在扩散解码前整合所得预测结果。在 10 名 THINGS-EEG2 参与者中,重建图像在像素级、结构和语义层面均与所观察的刺激保持可测量的一致性,而逐步消融实验则区分了结构通路、语义通路及双空间融合各自的影响。通过展示中间 EEG 特征、潜在预测、融合输出及最终重建结果,该方案为基于 EEG 的视觉重建研究提供了可重复的框架,并可用于评估其未来在独立数据集和采集条件下的扩展应用。
披露
作者声明不存在可能影响本工作的竞争性财务利益或个人关系。作者声明在手稿撰写、代码编写、数据分析或图表准备过程中未使用任何生成式人工智能工具。
致谢
本研究由国家自然科学基金(项目编号:62433002)和(项目编号:62476014)、国家科技重大专项(编号:2021ZD0113703)、北京市社会科学基金年度规划项目(编号:23GLB014)、北京市属高校高水平创新团队建设与支持项目(项目编号:BPHR20220104)以及北京学者计划(项目编号:099)资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 加速库 | Hugging Face | 0.30.1 | 扩散模型管道设备管理;https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14;openai-clip 1.0.1 | 用于语义目标和 CLIP 成对识别的图像特征编码器;https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Stable UnCLIP 管道实现;https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib 开发团队 | 3.10.6 | 科学图表生成;https://matplotlib.org/ |
| MNE-Python | MNE 开发者 | 1.11.0 | 标准 10-20 导联布局与头皮通道拓扑图;https://mne.tools/ |
| NumPy | NumPy 开发者 | 2.3.4 | EEG 数组、潜在嵌入、融合及度量聚合;https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB;驱动程序 595.97 | 用于本地编码器训练和扩散重建的 GPU。 |
| Pillow | Python 图像库分支 | 11.1.0 | 图像加载、缩放与导出;https://python-pillow.org/ |
| Python | Python 软件基金会 | 3.12.12 | 主要运行环境;https://www.python.org/ |
| PyTorch | PyTorch 基金会 | 2.9.1+cu128 | EEG 编码器训练与神经网络推理;https://pytorch.org/ |
| scikit-image | scikit-image 开发者 | 0.25.2 | SSIM 与图像处理工具;https://scikit-image.org/ |
| scikit-learn | scikit-learn 开发者 | 1.7.2 | 岭回归、k 均值、PCA 与 t-SNE;https://scikit-learn.org/ |
| SciPy | SciPy 开发者 | 1.16.3 | 相关性、统计距离与层次聚类;https://scipy.org/ |
| Seaborn | Seaborn 开发者 | 0.13.2 | 高斯核密度可视化;https://seaborn.pydata.org/ |
| 语义流 EEG 编码器 | TDE-Net 作者;改编自 LMDA-Net | 代码仓库提交 c99325d | 多尺度时间语义表示;实现代码与检查点元数据均提供于代码仓库中。 |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 社区 | sd2-community/stable-diffusion-2-1-unclip | 冻结的扩散解码器;https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| 结构流 EEG 编码器 | TDE-Net 作者 | 代码仓库提交 c99325d | 自监督图表示;原始 EEG 与图特征仅在 VAE 空间结构映射中进行拼接。 |
| TDE-Net 对齐、融合、评估与可视化脚本 | Yuan-ui198 | 提交 c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| THINGS 数据库 | Hebart 等 | doi:10.1371/journal.pone.0223792 | 自然物体刺激源;https://things-initiative.org/ |
| THINGS-EEG2 数据集 | Gifford 等 | doi:10.1016/j.neuroimage.2022.119754 | 来自 10 名受试者的 64 导 EEG;本研究选取 17 个顶枕通道;https://osf.io/anp5v/ |
| timm | Ross Wightman 及贡献者 | 1.0.22 | 特征评估所用的预训练视觉模型工具;https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch 基金会 | 0.24.1+cu128 | AlexNet、Inception-v3 与 EfficientNet 评估主干网络;https://pytorch.org/vision/ |
| tqdm | tqdm 开发者 | 4.67.1 | 特征提取、重建与评估过程中的进度报告;https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | 预训练模型组件的接口;https://github.com/huggingface/transformers |
参考文献
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
重印与许可
本文已发表
视频即将推出