Dieses Protokoll führt Bioinformatik-Einsteiger durch eine einführende CUT&RUN-Analysepipeline, die es den Benutzern ermöglicht, eine erste Analyse und Validierung von CUT&RUN-Sequenzierungsdaten durchzuführen. Das Abschließen der hier beschriebenen Analyseschritte in Kombination mit der nachgeschalteten Peak-Annotation ermöglicht es den Benutzern, mechanistische Einblicke in die Chromatinregulation zu gewinnen.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Methodenartikel
Einführende Analyse und Validierung von CUT&RUN-Sequenzierungsdaten
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die CUT&RUN-Technik erleichtert den Nachweis von Protein-DNA-Wechselwirkungen im gesamten Genom. Typische Anwendungen von CUT&RUN sind die Profilierung von Änderungen in Histonschwanzmodifikationen oder die Kartierung der Chromatinbelegung des Transkriptionsfaktors. Die weit verbreitete Einführung von CUT&RUN ist zum Teil auf technische Vorteile gegenüber herkömmlichem ChIP-seq zurückzuführen, zu denen geringere Anforderungen an den Zelleinsatz, geringere Anforderungen an die Sequenzierungstiefe und eine erhöhte Empfindlichkeit mit reduziertem Hintergrundsignal gehören, da es an Vernetzungsmitteln mangelt, die sonst Antikörper-Epitope maskieren. Die breite Akzeptanz von CUT&RUN wurde auch durch die großzügige gemeinsame Nutzung von Reagenzien durch das Henikoff-Labor und die Entwicklung kommerzieller Kits erreicht, um die Einführung für Anfänger zu beschleunigen. Mit zunehmender technischer Einführung von CUT&RUN werden die CUT&RUN-Sequenzierungsanalyse und -validierung zu kritischen Engpässen, die überwunden werden müssen, um eine vollständige Einführung durch überwiegend nasse Laborteams zu ermöglichen. Die CUT&RUN-Analyse beginnt in der Regel mit einer Qualitätskontrolle der Rohsequenzierungs-Reads, um die Sequenzierungstiefe, die Read-Qualität und mögliche Verzerrungen zu bewerten. Die Reads werden dann mit einer Referenzgenomsequenz-Assemblierung abgeglichen, und mehrere bioinformatische Werkzeuge werden anschließend eingesetzt, um genomische Regionen der Proteinanreicherung zu annotieren, die Interpretierbarkeit der Daten zu bestätigen und biologische Schlussfolgerungen zu ziehen. Obwohl mehrere In-silico-Analysepipelines entwickelt wurden, um die CUT&RUN-Datenanalyse zu unterstützen, machen ihre komplexe Multi-Modul-Struktur und die Verwendung mehrerer Programmiersprachen die Plattformen für Bioinformatik-Anfänger schwierig, die möglicherweise nicht mit mehreren Programmiersprachen vertraut sind, aber das CUT&RUN-Analyseverfahren verstehen und ihre Analysepipelines anpassen möchten. Hier stellen wir ein einsprachiges Schritt-für-Schritt-Analyse-Pipeline-Protokoll für CUT&RUN zur Verfügung, das für Benutzer mit jeder Erfahrung in der Bioinformatik entwickelt wurde. Dieses Protokoll umfasst die Durchführung kritischer Qualitätsprüfungen, um zu bestätigen, dass die Sequenzierungsdaten für die biologische Interpretation geeignet sind. Wir gehen davon aus, dass das Befolgen des in diesem Artikel vorgestellten Einführungsprotokolls in Kombination mit der Downstream-Peak-Annotation es den Nutzern ermöglicht, biologische Erkenntnisse aus ihren eigenen CUT&RUN-Datensätzen zu gewinnen.
Einleitung
Die Fähigkeit, Wechselwirkungen zwischen Proteinen und genomischer DNA zu messen, ist von grundlegender Bedeutung für das Verständnis der Biologie der Chromatinregulation. Effektive Assays, die die Chromatinbelegung für ein bestimmtes Protein messen, liefern mindestens zwei Schlüsselinformationen: i) die genomische Lokalisierung und ii) die Proteinhäufigkeit in einer bestimmten genomischen Region. Die Verfolgung der Rekrutierungs- und Lokalisierungsänderungen eines Proteins von Interesse im Chromatin kann direkte Zielloci des Proteins aufdecken und mechanistische Rollen dieses Proteins in chromatinbasierten biologischen Prozessen wie der Regulation der Transkription, der DNA-Reparatur oder der DNA-Replikation aufdecken. Die heute verfügbaren Techniken zur Profilierung von Protein-DNA-Wechselwirkungen ermöglichen es Forschern, die Regulation mit beispielloser Auflösung zu erforschen. Solche technischen Fortschritte wurden durch die Einführung neuer Chromatin-Profiling-Techniken ermöglicht, zu denen auch die Entwicklung von Cleavage Under Targets und Release Using Nuclease (CUT&RUN) durch das Henikoff-Labor gehört. CUT&RUN bietet mehrere technische Vorteile gegenüber der herkömmlichen Chromatin-Immunpräzipitation (ChIP), darunter geringere Anforderungen an den Zelleinsatz, geringere Anforderungen an die Sequenzierungstiefe und eine erhöhte Empfindlichkeit mit reduziertem Hintergrundsignal aufgrund eines Mangels an Vernetzungsmitteln, die sonst Antikörper-Epitope maskieren. Die Anwendung dieser Technik zur Untersuchung der Chromatinregulation erfordert ein gründliches Verständnis des Prinzips, das der Technik zugrunde liegt, und ein Verständnis dafür, wie CUT&RUN-Daten analysiert, validiert und interpretiert werden.
Das CUT&RUN-Verfahren beginnt mit der Bindung von Zellen an Concanavalin A, das an magnetische Kügelchen konjugiert ist, um eine Manipulation geringer Zellzahlen während des gesamten Verfahrens zu ermöglichen. Isolierte Zellen werden mit einem milden Detergens permeabilisiert, um die Einführung eines Antikörpers zu erleichtern, der auf das gewünschte Protein abzielt. Die Mikrokokken-Nuklease (MNase) wird dann mit Hilfe eines Protein-A- oder Protein-A/G-Tags, das an das Enzym gebunden ist, an den gebundenen Antikörper rekrutiert. Kalzium wird eingeführt, um die enzymatische Aktivität zu initiieren. Der MNase-Verdau führt zu mononukleosomalen DNA-Protein-Komplexen. Anschließend wird Calcium chelatisiert, um die Verdauungsreaktion zu beenden, und kurze DNA-Fragmente aus dem MNase-Verdau werden aus den Zellkernen freigesetzt und dann einer DNA-Reinigung, einer Bibliotheksvorbereitung und einer Hochdurchsatzsequenzierungunterzogen 1 (Abbildung 1).
In-silico-Ansätze zur Kartierung und Quantifizierung der Proteinbelegung im gesamten Genom haben sich parallel zu den Nasslaboransätzen entwickelt, die zur Anreicherung dieser DNA-Protein-Wechselwirkungen verwendet werden. Die Identifizierung von Regionen angereicherter Signale (Peaks) ist einer der wichtigsten Schritte in der bioinformatischen Analyse. Erste ChIP-seq-Analysemethoden verwendeten Algorithmen wie MACS2 und SICER3, die statistische Modelle verwendeten, um Bona-fide-Protein-DNA-Bindungsstellen aus dem Hintergrundrauschen zu unterscheiden. Das geringere Hintergrundrauschen und die höhere Auflösung der CUT&RUN-Daten machen jedoch einige Peak-Calling-Programme, die in der ChIP-seq-Analyse verwendet werden, für die CUT&RUN-Analyse ungeeignet4. Diese Herausforderung unterstreicht den Bedarf an neuen Werkzeugen, die besser für die Analyse von CUT&RUN-Daten geeignet sind. SEACR4 stellt ein solches Tool dar, das kürzlich entwickelt wurde, um Spitzenaufrufe von CUT&RUN-Daten zu ermöglichen und gleichzeitig die Einschränkungen zu überwinden, die mit Tools verbunden sind, die typischerweise für die ChIP-seq-Analyse eingesetzt werden.
Biologische Interpretationen aus CUT&RUN-Sequenzierungsdaten werden aus den Ausgängen nach dem Peak-Aufruf in der Analysepipeline gezogen. Es können verschiedene funktionale Annotationsprogramme implementiert werden, um die potentielle biologische Relevanz der aufgerufenen Peaks aus CUT&RUN-Daten vorherzusagen. Zum Beispiel bietet das Projekt Gene Ontology (GO) eine gut etablierte funktionelle Identifizierung von Genen von Interesse 5,6,7. Verschiedene Software-Tools und Ressourcen erleichtern die GO-Analyse, um Gene und Gensätze aufzudecken, die unter den CUT&RUN-Peaks 8,9,10,11,12,13,14 angereichert sind. Darüber hinaus ermöglichen Visualisierungssoftware wie Deeptools15, Integrative Genomics Viewer (IGV)16 und UCSC Genome Browser17 die Visualisierung von Signalverteilung und -mustern in interessanten Regionen des Genoms.
Die Fähigkeit, biologische Interpretationen aus CUT&RUN-Daten zu ziehen, hängt entscheidend von der Validierung der Datenqualität ab. Zu den kritischen Komponenten, die validiert werden müssen, gehören die Bewertung von: i) der Qualität der CUT&RUN-Bibliothekssequenzierung, ii) der Replikatähnlichkeit und iii) der Signalverteilung in den Peakzentren. Der Abschluss der Validierung aller drei Komponenten ist entscheidend, um die Zuverlässigkeit der CUT&RUN-Bibliotheksproben und der nachgelagerten Analyseergebnisse zu gewährleisten. Daher ist es wichtig, einführende CUT&RUN-Analyseleitfäden zu erstellen, die es Bioinformatik-Anfängern und Nasslaborforschern ermöglichen, solche Validierungsschritte als Teil ihrer Standard-CUT&RUN-Analysepipelines durchzuführen.
Neben der Entwicklung des CUT&RUN-Experiments im Nasslabor wurden verschiedene in silico CUT&RUN-Analysepipelines wie CUT&RUNTools 2.018,19, nf-core/cutandrun 20 und CnRAP21 entwickelt, um die CUT&RUN-Datenanalyse zu unterstützen. Diese Werkzeuge bieten leistungsstarke Ansätze für die Analyse von Einzelzell- und Massen-CUT&RUN- und CUT&Tag-Datensätzen. Die relativ komplexe modulare Programmstruktur und die erforderliche Vertrautheit mit mehreren Programmiersprachen zur Durchführung dieser Analysepipelines können jedoch die Einführung durch Bioinformatik-Anfänger behindern, die die CUT&RUN-Analyseschritte gründlich verstehen und ihre eigenen Pipelines anpassen möchten. Um diese Barriere zu umgehen, ist eine neue einführende CUT&RUN-Analysepipeline erforderlich, die in einfachen Schritt-für-Schritt-Skripten bereitgestellt wird, die mit einer einfachen Programmiersprache codiert sind.
In diesem Artikel beschreiben wir ein einfaches, einsprachiges CUT&RUN-Analyse-Pipeline-Protokoll, das Schritt-für-Schritt-Skripte mit detaillierten Beschreibungen bereitstellt, um neuen und unerfahrenen Benutzern die Durchführung von CUT&RUN-Sequenzierungsanalysen zu ermöglichen. Programme, die in dieser Pipeline verwendet werden, sind von den ursprünglichen Entwicklergruppen öffentlich verfügbar. Zu den wichtigsten Schritten, die in diesem Protokoll beschrieben werden, gehören das Read-Alignment, das Peak-Calling, die Funktionsanalyse und vor allem Validierungsschritte zur Bewertung der Probenqualität, um die Eignung und Zuverlässigkeit der Daten für die biologische Interpretation zu bestimmen (Abbildung 2). Darüber hinaus bietet diese Pipeline den Nutzern die Möglichkeit, Analyseergebnisse mit öffentlich zugänglichen CUT&RUN-Datensätzen zu vergleichen. Letztendlich dient dieses CUT&RUN-Analyse-Pipeline-Protokoll als Einführungsleitfaden und Referenz für Einsteiger in die bioinformatische Analyse und Nasslaborforscher.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
HINWEIS: Informationen zu CUT&RUN fastq-Dateien in GSE126612 finden Sie in Tabelle 1. Informationen zu den in dieser Studie verwendeten Softwareanwendungen sind in der Materialtabelle aufgeführt.
1. Herunterladen der Easy-Shells_CUTnRUN-Pipeline von der Github-Seite
- Öffnen Sie das Terminal über das Betriebssystem.
HINWEIS: Wenn der Benutzer nicht sicher ist, wie das Terminal unter macOS und Windows geöffnet werden soll, lesen Sie diese Webseite (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Für Linux lesen Sie bitte diese Webseite (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Laden Sie die komprimierte Analysepipeline von GitHub herunter, indem Sie wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip in das Terminal eingeben.
- Nachdem Sie die ZIP-Datei heruntergeladen haben, dekomprimieren Sie die heruntergeladene ZIP-Datei, indem Sie unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ in das Terminal eingeben.
- Löschen Sie nach der Dekomprimierung die Zip-Datei, indem Sie rm ~/Desktop/Easy-Shells_CUTnRUN.zip in das Terminal eingeben, und ändern Sie den Ordnernamen, indem Sie mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN eingeben.
- Nachdem Sie die gezippte Datei entfernt haben, geben Sie chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh in das Terminal ein, um die ausführbare Berechtigung für alle Shell-Skripte im Arbeitsverzeichnis festzulegen. Geben Sie von nun an einfach den Pfad und den Namen dieser Shell-Skripte in das Terminal ein oder ziehen Sie die Skripte in das Terminal und geben Sie ein, um diese Shell-Skripte im Terminal auszuführen.
HINWEIS: Die Bash-Shell ist in der Regel auf den meisten Linux-Distributionen vorinstalliert. Neuere macOS-Versionen bieten jedoch keine vorinstallierte Bash-Shell mehr. Wenn das System nicht über Bash verfügt, installieren Sie zuerst die Bash-Shell. Unter den folgenden Links finden Sie Anweisungen, die beschreiben, wie Sie die Bash-Shell unter Linux OS (https://ioflood.com/blog/install-bash-shell-linux/) und macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:) installieren. Diese Schritt-für-Schritt-Shell-Skripte sind so geschrieben, dass sie einen Ordner ~/Desktop/GSE126612 erstellen, um den größten Teil dieser CUT&RUN-Analyse in diesem Verzeichnis durchzuführen, ohne dass Änderungen erforderlich sind. Wenn der Benutzer versteht, wie diese Shell-Skripte verwendet werden, kann er diese Shell-Skripte überarbeiten und anpassen, um andere CUT&RUN-Datensätze zu analysieren und Optionen gemäß den projektspezifischen Anforderungen zu ändern. Um diese Shellskripts zu lesen und zu bearbeiten, sollten Sie Visual Studio Code (https://code.visualstudio.com/) als eine Option für ein benutzerfreundliches Programm verwenden, das für die wichtigsten Betriebssysteme verfügbar ist.
2. Installation der für Easy Shells CUTnRUN benötigten Programme
- Unter den Shell-Skripten mit dem Namen Script_01_installation_***.sh finden Sie das Shell-Skript heraus, dessen Name den Betriebssystemtyp des Benutzersystems enthält. Derzeit unterstützt Easy Shells CUTnRUN das Installationsskript für macOS-, Debian/Ubuntu- und CentOS/RPM-basierte Systeme.
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Führen Sie im Terminal das Installations-Shell-Skript aus, indem Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh eingeben oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
- Lesen Sie Test_README.md im Ordner /path/to/SEACR-1.3/Testfiles. Befolgen Sie die Anweisungen in der README-Datei, um zu klären, ob der SEACR im System des Benutzers ordnungsgemäß funktioniert.
HINWEIS: Es ist wichtig, die SEACR-Funktion mit Testdateien zu validieren, die von der SEACR-Github-Seite bereitgestellt werden, um korrekte Spitzenaufrufergebnisse aus CUT&RUN-Daten zu erhalten. Befolgen Sie daher unmittelbar nach der SEACR-Installation die Anweisungen von Test_README.md in /path/to/SEACR-1.3/Testfiles . Obwohl Easy Shells CUTnRUN Installations-Shell-Skripte für einige Betriebssysteme bereitstellt, funktionieren diese Skripte auf den Systemen einiger Benutzer möglicherweise nicht, um alle für Easy Shells CUTnRUN erforderlichen Programme zu installieren. Wenn bei der Installation ein Problem auftritt, überprüfen Sie die ursprüngliche Website des deinstallierten Programms, oder fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
3. Herunterladen des öffentlich zugänglichen CUT&RUN-Datensatzes aus dem Sequence Read Archive (SRA)
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS:Dieses Skript wird: (i) Erstellen Sie einen Ordner (~/Desktop/GSE126612/fastq) und laden Sie eine Liste von SRA-Dateien herunter, die in einer Textdatei (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) innerhalb des fastq-Ordners geschrieben wurden. Das SRR_list.txt enthält beispielsweise die fastq-Dateien einer Teilmenge von GSE126612 CUT&RUN-Beispielen. (ii) Laden Sie die rohen fastq-Dateien im fastq-Ordner herunter. (iii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/log/fastq) und notieren Sie eine Protokolldatei (download-fastq_log.txt) und eine heruntergeladene Beispielinformationsdatei (SRR_list_info.txt) in diesem Protokollordner. - Überprüfen Sie nach dem Ausführen des Skripts die Protokolldatei. Wenn in der Protokolldatei eine Fehlermeldung angezeigt wird, beheben Sie den Fehler, und wiederholen Sie Schritt 3.3. Wenn es ein Problem gibt, um das Problem zu lösen, bitten Sie um Hilfe auf der Easy Shells CUTnRUN Github Issues Webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
HINWEIS: Um das Üben dieser CUT&RUN-Analysepipeline zu erleichtern, werden die folgenden öffentlich zugänglichen Proben aus SRA entnommen: eine Probe aus der Mock-Control (IgG), drei Proben eines Chromatinarchitektur- und Transkriptionsfaktor-Proteins (CTCF), vier Proben, die einer "aktiven" Histonmarkierung (H3K27Ac) entsprechen, und drei Proben, die Regionen mit transkriptioneller Initiation entsprechen, die durch RNA-Polymerase II (RNAPII-S5P) markiert sind. Die Sequenzierung wurde als Paired-End durchgeführt, d.h. es werden zwei Dateien pro Sample gepaart.
4. Erste Qualitätsprüfung für die Rohsequenzierungsdateien
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh in das Terminal ein oder ziehen Sie das Shell-Skript in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Shell-Skript wird: (i) Führen Sie das FastQC-Programm für alle unformatierten Fastq-Dateien im Ordner ~/Desktop/GSE126612/fastq aus und speichern Sie die Dateien des Qualitätsprüfungsberichts im Ordner ~/Desktop/GSE126612/fastqc.1st . (ii) Notieren Sie eine Protokolldatei (fastqc.1st.log.SRR-number.txt) pro FastQC-Ausführung in einen Protokollordner (~/Desktop/GSE126612/log/fastqc.1st). - Überprüfen Sie nach Abschluss der Ausführung des Shellskripts die Protokolldatei, um den Erfolg der Ausführung zu klären. Wenn in der Protokolldatei eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler und wiederholen Sie Schritt 4.3. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Unter den Ausgabedateien enthalten fastqc.html Dateien benutzerfreundliche Ergebnisse der Qualitätsprüfung. Wenn es schwerwiegende Qualitätsprobleme gibt, besprechen Sie dies mit Bioinformatik-Kollegen, um die Eignung der Daten für die nachgelagerte Analyse zu bestimmen. Ähnliche Qualitätskontrollberichte werden verwendet, um eine verbesserte Datenqualität nach dem Trimmen des Adapters zu bestätigen. Wenn Sie dieses Skript für andere Datasets verwenden möchten, bearbeiten Sie den Pfad des Arbeits- und Ausgabeverzeichnisses entsprechend den Anforderungen des Benutzers. Ein bemerkenswerter Unterschied bei der Interpretation der QC von CUT&RUN im Vergleich zu ChIP-seq-Reads besteht darin, dass doppelte Reads in CUT&RUN nicht unbedingt auf PCR-Duplikate hinweisen. Dies liegt daran, dass rekrutierte MNase innerhalb von Versuchsgruppen an denselben oder ähnlichen Stellen verdaut wird.
5. Qualität und Adaptertrimmen für Rohsequenzdateien
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh in das Terminal ein oder ziehen Sie das Script_04_trimming.sh Skript in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Shell-Skript wird: (i) das Programm Trim-Galore für alle rohen fastq-Dateien in ~/Desktop/GSE126612/fastq ausführen, um das Adapter- und Qualitätstrimmen durchzuführen. (ii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/trimmed) und speichern Sie die Trim-Galore-Ausgabedateien im getrimmten Ordner. (iii) Erstellen Sie einen Protokollordner (~/Desktop/GSE126612/log/trim_galore) und notieren Sie sich eine Protokolldatei , die pro Trim-Galore-Ausführung trim_galore_log_RSS-number.txt. - Überprüfen Sie die Protokolldatei nach Abschluss der Ausführung sorgfältig. Wenn in der Protokolldatei eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und wiederholen Sie Schritt 5.3. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
- Vergleichen Sie nach Abschluss dieses Vorgangs die .html Ausgabedateien mit den fastqc.html Dateien, die in Version 4.3 erstellt wurden. Überarbeiten Sie den Pfad der Eingabe- und Ausgabeverzeichnisse, um den Trimmschritt für alle fastq-Dateien auszuführen, die sich an einer anderen Stelle befinden.
6. Herunterladen des Bowtie2-Index für die Referenzgenome für tatsächliche und Spike-in-Kontrollproben
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh in das Terminal ein oder ziehen Sie das Shell-Skript in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird: (i) Bowtie2-Indizes für tatsächliche Proben-Referenzgenome (Mensch; hg19; verwendet in der Originalpublikation22) und Spike-in-Kontroll-Referenzgenome (knospende Hefe; R64-1-1) in den bowtie2-index-Ordner (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Schreiben Sie eine Protokolldatei (bowtie2-index-log.txt) in ein Protokollverzeichnis (~/Desktop/GSE126612/log/bowtie2-index). - Überprüfen Sie nach Abschluss des Laufs die Protokolldatei. Wenn eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler und wiederholen Sie Schritt 6.3. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Derzeit werden Bowtie2-Indizes für verschiedene Referenzgenome auf der Bowtie2-Website (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml) bereitgestellt. Benutzer können Script_05_bowtie2-index.sh bearbeiten, um einen beliebigen Bowtie2-Index herunterzuladen, um die Anforderungen des Benutzers zu erfüllen. Wenn der Benutzer den Bowtie2-Index des Referenzgenoms von Interesse nicht finden kann, suchen Sie die Fasta-Dateien der Referenzgenomsequenz aus:- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- UCSC-Webseite (https://hgdownload.soe.ucsc.edu/downloads.html)
- oder andere artspezifische Datenbanken.
Nachdem Sie die Fasta-Dateien der Referenzgenomsequenz gefunden haben, erstellen Sie einen Bowtie2-Index für das heruntergeladene Referenzgenom, indem Sie dem Abschnitt "Der bowtie2-build-Indexer" (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) auf der Bowtie2-Website folgen.
7. Mapping getrimmter CUT&RUN-Sequenzierungs-Reads auf die Referenzgenome
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Shell-Skript wird: (1) Führen Sie das Programm bowtie2 aus, um alle Adapter- und qualitätsgetrimmten Fastq-Dateien sowohl der experimentellen (Mensch; hg19) als auch der Spike-in-Kontrolle (knospende Hefe; R64-1-1) Referenzgenome unabhängig voneinander. (ii) Führen Sie die samtools-Ansichtsfunktion aus, um die zugeordneten Lesepaardateien im bam-Format zu komprimieren. (iii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/bowtie2-mapped) und speichern Sie die komprimierte Datei mit zugeordneten Lesepaaren im Ordner bowtie2-mapped. (iv) Erstellen Sie einen Ordner (~/Desktop/GSE126612/log/bowtie2-mapped) und notieren Sie das Protokoll des Mapping-Prozesses als Textdatei bowtie2_log_hg19_SRR-number.txt für Lesepaare , die auf dem hg19-Referenzgenom abgebildet sind, und bowtie2_log_R64-1-1_SRR-number.txt für Lesepaare, die auf R64-1-1 kartiert sind), um die Mapping-Effizienz im bowtie2-mapping-Protokollordner anzuzeigen. - Überprüfen Sie nach Abschluss des Laufs die Protokolldatei. Wenn in der Protokolldatei eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und führen Sie das Shell-Skript erneut aus. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Dieses Shell-Skript führt bowtie2 mit Optionen zum Mappen von Paired-End-Sequenzdateien aus, um übereinstimmend zugeordnete Lesepaare mit einer Fragmentlänge von 10 bp bis 700 bp zu finden. Entdecken Sie Optionsbeschreibungen, indem Sie bowtie2 --help in das Terminal eingeben oder die bowtie2-Website (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) besuchen, um die Optionen zu verstehen und bei Bedarf zu ändern. Verwenden Sie dieses Shell-Skript, um andere fastq-Dateien zuzuordnen, indem Sie den Pfad und das Namensformat der fastq-Dateien und Bowtie2-Indizes ändern.
8. Sortieren und Filtern der zugeordneten Lesepaardateien
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie "chsh -s $(which bash)" in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird: (i) die samtools-Ansichtsfunktion für alle komprimierten zugeordneten Lesepaardateien im Ordner ~/Desktop/GSE126612/bowtie2-mapped ausführen, um Lesepaare herauszufiltern, die in nicht-kanonischen Chromosomenregionen, öffentlich annotierten Blacklist- und TA-Wiederholungsregionen zugeordnet sind. (ii) Führen Sie die samtools-Sortierfunktion aus, um die gefilterten BAM-Dateien nach Fragmentnamen oder Koordinaten innerhalb desselben Verzeichnisses zu sortieren. (iii) Schreiben Sie eine Protokolldatei pro Eingabe-BAM-Datei in das Verzeichnis ~/Desktop/GSE126612/log/filter-sort-bam . - Überprüfen Sie nach Abschluss der Ausführung die Protokolldateien sorgfältig. Wenn in den Protokolldateien eine Fehlermeldung angezeigt wird, beheben Sie den Fehler, und versuchen Sie erneut, das Shell-Skript auszuführen. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Die resultierenden BAM-Dateien (Ausgabe), sortiert nach Fragmentnamen, dienen als Eingabedateien zum Erstellen von Fragment-BED- und Raw-Readcounts-bedGraph-Dateien. Die nach Koordinaten sortierten bam-Dateien dienen als Eingabedateien zum Generieren von Fragment-BEDPE-Dateien. Alle BED, bedGraph und BEDPE werden für den Peak-Aufruf und die Visualisierung in der Downstream-Analyse verwendet. Alle Annotationsbett-Dateien für kanonische Chromosomenregionen (chr1~22, chrX, chrY und chrM), öffentlich annotierte Blacklist-Regionen23 und TA-Wiederholungsregionen18 befinden sich im Verzeichnis ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Verwenden Sie bei Bedarf dieses Verzeichnis, um weitere Blacklist-Dateien hinzuzufügen. Verwenden Sie dieses Shell-Skript, um dieselben Funktionen für andere zugeordnete Lesepaare von BAM-Dateien auszuführen, indem Sie den Pfad und den Namen der BAM-Dateien ändern. Geben Sie samtools view --help und samtools sort --help in das Terminal ein, um weitere Informationen zu diesen Funktionen zu erhalten.
9. Konvertieren Sie zugeordnete Lesepaare in Fragment-BEDPE-, BED- und Raw-Readcounts-bedGraph-Dateien
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird: (i) Führen Sie die macs3 filterdup - und awk-Funktionen aus, um BAM-Dateien, sortiert nach Koordinaten, in Fragment-BEDPE-Dateien zu konvertieren, deren Fragmentlänge kürzer als 1 KB ist, und speichern Sie die BEDPE-Dateien in ~/Desktop/GSE126612/BEDPE. (ii) Erstellen Sie ein Protokollverzeichnis (~/Desktop/GSE126612/log/bam-to-BEDPE) und notieren Sie eine Protokolldatei pro zugeordneter Lesefragmentdatei. (iii) Führen Sie die Funktionen bedtools bamtobed und awk, cut, sort aus, um bam-Dateien, sortiert nach Fragmentnamen, in Fragment-BED-Dateien zu konvertieren, deren Fragmentlängen kürzer als 1 kb sind. (iv) Erstellen Sie einen Ordner (~/Desktop/GSE126612/bam-to-bed) und speichern Sie die Fragment-BED-Dateien im bam-to-bed-Ordner. (v) Schreiben Sie eine Protokolldatei pro zugeordneter BED-Datei mit Lesefragmenten in ein Protokollverzeichnis (~/Desktop/GSE126612/log/bam-to-bed). (vi) Führen Sie die genomecov-Funktion von bedtools aus, um rohe Readcounts-bedGraph-Dateien unter Verwendung des Fragments BED-Dateien in einem Ordner (~/Desktop/GSE126612/bedGraph) zu generieren. - Überprüfen Sie nach Abschluss des Laufs die Protokolldateien sorgfältig. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Die ausgegebenen bedGraph-Rohdateien werden als Eingabedateien für das SEACR-Peak-Caller-Programm mit der Normalisierungsoption in Abschnitt 12 und der Normalisierung von Scaled Fractional Readcount (SFRC)22 in Abschnitt 10 verwendet. Die Fragment-BED-Dateien dienen als Eingabedateien für die Spike-in normalized Reads Per Million mapped reads in the negative Control (SRPMC) Normalisierung24,25 im Abschnitt 10.To Erfassung kurzer Fragmente (>100 bp) nur für CUT&RUN-Daten von Chromatin-assoziierten Faktoren, Ändern des Fragmentfiltrationsschritts in diesem Skript und Fahren Sie mit dem Normalisierungsschritt fort. Um die CUT&RUN-Signale zwischen kurzen und normal großen Fragmenten innerhalb derselben Stichprobe zu vergleichen, kann die SFRC-Normalisierung hilfreich sein, um den potenziellen Down-Sampling-Effekt zu reduzieren, der durch die ausschließliche Erfassung kurzer Fragmente verursacht wird. Verwenden Sie dieses Shell-Skript, um die gleichen Prozesse für andere sortierte BAM-Dateien mit sequenzierten Paaren auszuführen, indem Sie das Pfad- und Namensformat von BAM- und BED-Dateien ändern.
10. Konvertieren von rohen Readcounts-bedGraph-Dateien in normalisierte bedGraph- und bigWig-Dateien
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Führen Sie die for-Schleife mit der awk-Funktion aus, um SFRC-normalisierte bedGraph-Dateien unter Verwendung von rohen readcounts-bedGraph-Dateien in ~/Desktop/GSE126612/bedGraph zu erstellen. (ii) Führen Sie die Funktion bedGraphToBigWig aus, um ein komprimiertes Format (.bw) der SFRC-normalisierten bedGraph-Dateien in ~/Desktop/GSE126612/bigWig zu erstellen. (iii) Notieren Sie sich eine Protokolldatei, um den Normalisierungsfaktor aufzuzeichnen, der für die SFRC-Berechnung pro Lauf verwendet wird, und speichern Sie die Protokolldatei unter ~/Desktop/GSE126612/log/SFRC. - Überprüfen Sie nach Abschluss des Laufs die Protokolldateien. Wenn eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und führen Sie das Shell-Skript erneut aus. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Die skalierte Normalisierung der fraktionierten Leseanzahl wurde in der ursprünglichen Veröffentlichung22 GSE126612 CUT&RUN-Datensatzes verwendet. Die Formel der Normalisierung bei bin i ist die gleiche wie folgt: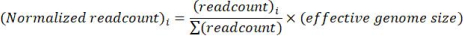
Da diese Normalisierungsmethode weder eine Normalisierung mit Negativkontrolle (z. B. IgG-Probe) noch eine Spike-in-Kontrolle umfasst, ist dieser Ansatz möglicherweise nicht ideal, um den genomweiten Signalunterschied zwischen den Proben zu beobachten. Da diese Methode jedoch theoretisch mit anderen auf Total Readcounts basierenden Normalisierungen (z. B. Count Per Million) vergleichbar ist, wäre es ausreichend, den lokalen Signalunterschied zwischen den Stichproben zu beobachten. - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird: (i) Führen Sie die for-Schleife mit der genomecov-Funktion von bedtools aus, um SRPMC-normalisierte Bedgraph-Dateien in ~/Desktop/GSE126612/bedGraph unter Verwendung von Fragment-BED-Dateien in ~/Desktop/GSE126612/bam-to-bed zu erstellen. (ii) Notieren Sie sich eine Protokolldatei, um die Normalisierungsfaktoren aufzuzeichnen, die für die SRPMC-Normalisierung pro Ausführung in ~/Desktop/GSE126612/log/SRPMC verwendet werden. (iii) Führen Sie die Funktion bedGraphToBigWig aus, um ein komprimiertes Format (.bw) der normalisierten bedGraph-Dateien zu erstellen und die normalisierten bigWig-Dateien im Ordner ~/Desktop/GSE126612/bigWig zu speichern. - Überprüfen Sie nach Abschluss der Ausführung die Protokolldateien sorgfältig. Wenn in den Protokolldateien eine Fehlermeldung angezeigt wird, beheben Sie den Fehler, und führen Sie das Shell-Skript erneut aus. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Die Formel der SRPMC-Normalisierung wurde entwickelt, um die tatsächlichen Probenlesezahlen sowohl mit Negativkontrolle (z. B. IgG-Probe) als auch mit Spike-in-Kontrolle zu normalisieren, indem der Normalisierungsfaktor RPM (Reads Per Million Mapped Reads), RPS (Ratio Reads Per Spike-in Read) und das relative Signalverhältnis zur Kontrolle24,25 kombiniert werden. Die Definition von RPS ist die gleiche wie folgt:
Durch Anwendung von RPS sowohl für die tatsächliche Probe als auch für die negative Kontrollprobe kann das relative Signalverhältnis (RS) zur Kontrolle für die tatsächliche Probe wie folgt berechnet werden: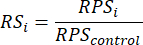
Und die Definition des RPM-Normalisierungsfaktors (RPM:NF) ist die gleiche wie unten: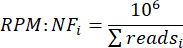
Von hier aus hat sich der SRPMC-Normalisierungsfaktor (SRPMC:NF) ergeben, indem RS und RPM:NF miteinander kombiniert wurden: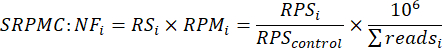
Und diese Formel kann wie folgt vereinfacht werden:
Daher normalisiert die SRPMC-Methode die Lesevorgänge anhand des (1) Verhältnisses der Spike-in-Lesevorgänge zwischen Kontrolle und Probe und (2) der RPM-normalisierten Kontrolllesevorgänge. Da dieser Normalisierungsfaktor Spike-in-Reads berücksichtigt und Kontroll-Reads zwischen Proben zusammen vergleichbar macht, wäre diese Methode geeignet, um genomweite Unterschiede zwischen Proben zu beobachten und den Batch-Effekt bei den Gesamt-Reads von tatsächlichen Proben und Kontrollen in verschiedenen Batch-Experimenten zu reduzieren. Diese normalisierten bedGraph-Dateien werden zu Eingabedateien, um Peaks mit SEACR in Abschnitt 11 aufzurufen. Und diese normalisierten bigWig-Dateien werden für die Loci-Visualisierung durch IGV und die Erstellung von Heatmaps und Durchschnittsdiagrammen mit Deeptools verwendet. Es wird dringend empfohlen, einen Genome-Browser zu verwenden, um das Landschaftsmuster des CUT&RUN-Datensatzes unter Verwendung der normalisierten bigWig-Dateien in repräsentativen genomischen Regionen zu visualisieren, um die Datenqualität zu bewerten. CUT&RUN-Proben, die verrauschte Hintergrundsignalmuster aufweisen, die der IgG-Steuerung ähneln, sollten für nachgelagerte Analysen wahrscheinlich weggelassen werden. Verwenden Sie diese Shell-Skripte, um andere Read-Bed-Dateien und Raw-Readcounts-bedGraph-Dateien zu normalisieren, indem Sie den Pfad und die Dateinamen für Eingabe- und Ausgabe-Bed- und BedGraph-Dateien ändern. Bearbeiten Sie diese Skripts, um andere Normalisierungsberechnungen anzuwenden, indem Sie die Faktoren und die Formel in diesem Skript ändern.
11. Validierung der Fragmentgrößenverteilung
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird für Folgendes geschrieben: (i) Führen Sie picard.jar Funktion CollectInsertSizeMetrics mit zugeordneten Lesepaaren Bam-Dateien im Ordner ~/Desktop/GSE126612/filtered-bam aus, um die Verteilung der Einfügegröße zu identifizieren. (ii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/insert-size-distribution) und speichern Sie die Analyseergebnisse der insert-Größenverteilung im erstellten Ordner. (iii) Notieren Sie sich eine Protokolldatei pro Eingabe-BAM-Datei im Ordner ~/Desktop/GSE126612/log/insert-size-distribution . - Überprüfen Sie nach Abschluss des Laufs die Protokolldateien sorgfältig. Wenn in den Protokolldateien eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und versuchen Sie erneut, das Shell-Skript auszuführen. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Im Allgemeinen zeigt die Insert-Größenanalyse (Ausgabe) für CUT&RUN-Proben große Peaks in den nukleosomalen Größenbereichen von Mono- (100-300 bp) und Di- (300-500 bp). Technische Fehler/Einschränkungen (z. B. Über-/Unterverdauung von MNase während der CUT&RUN-Probenvorbereitung oder falsche Größenauswahl während der Bibliotheksvorbereitung) können dazu führen, dass gleiche oder größere als trinukleosomale (500-700 bp) und gleiche oder kürzere als subnukleosomale (<100 bp) Fragmente angereichert werden. Manchmal kann das Fehlen von mononukleosomalen Größenspitzen bei der Anreicherung der langen (>500 bp) und kurzen Fragmente (<100 bp) auf die Auswahlbereiche der Bibliotheksgröße zurückzuführen sein, die in der Nasslaborphase gewählt wurden, oder auf eine geringe Sequenzierungstiefe. Vergleichen Sie die Sequenzierungstiefe ("Gesamtzahl der sequenzierten Basen" / "Gesamtgröße des Referenzgenoms"), die Übersicht über die genomische Landschaft unter Verwendung normalisierter Readcounts-BigWig-Dateien in Abschnitt 10 und das Verteilungsmuster der Insert-Größe, um die Qualität der verarbeiteten CUT&RUN-Proben zu verdeutlichen. Die gestrichelten Linien in den Histogrammen stellen den "kumulativen Anteil" von Lesevorgängen dar, deren Einfügegröße größer oder gleich dem Wert auf der x-Achse ist. Diese gestrichelte Linie ermöglicht die Identifizierung der Verteilung der Einfügegrößen in der Eingabe-Mapped-Reads-Datei. Der Verlauf entlang der x-Achse ist mit zunehmender Wendeplattengröße verbunden. Die gestrichelte Linie gibt den Anteil der zugeordneten Lesepaare in der BAM-Eingabedatei an, deren Einfügegröße mindestens so groß ist, wie an der sich schneidenden Position der X-Achse angegeben. Daher beginnt die Interpretation bei 1 auf der linken Seite, was bedeutet, dass alle Lesevorgänge eine Einfügegröße größer oder gleich der kleinsten Größe haben, und nimmt mit zunehmender Einfügegröße in Richtung 0 ab.
12. Aufrufen von Spitzen mit MACS2, MACS3 und SEACR
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wurde für Folgendes geschrieben: (i) Ausführen der macs2 callpeak - und macs3 callpeak-Funktionen mit und ohne IgG-Steuerung unter Verwendung von Fragment-BEDPE-Dateien zum Aufrufen von Spitzen und Speichern der Spitzenaufrufergebnisse in Ausgabeverzeichnissen (~/Desktop/GSE126612/MACS2 und ~/Desktop/GSE126612/MACS3). (ii) Notieren Sie das Protokoll dieser Spitzenrufe als Textdatei im Protokollverzeichnis (~/Desktop/GSE126612/log/MACS2 und ~/Desktop/GSE126612/log/MACS3) - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Ausführen SEACR_1.3.sh Skripts mit und ohne IgG-Steuerung, mit stringenten und gelockerten Optionen unter Verwendung von rohen readcounts bedGraph- und normalisierten bedGraph-Dateien, um Peaks aufzurufen. (ii) Erstellen Sie ein Ausgabeverzeichnis (~/Desktop/GSE126612/SEACR-peaks) und speichern Sie die Ergebnisse der Spitzenaufrufe per SEACR. (iii) Notieren Sie das Protokoll dieser Spitzenrufe als Textdatei im Protokollverzeichnis (~/Desktop/GSE126612/log/SEACR). - Überprüfen Sie nach Abschluss des Ausführens von Shell-Skripten die Protokolldateien sorgfältig. Wenn in den Protokolldateien eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler zuerst. Einige Programme rufen Peaks für die IgG-Kontrollprobe mit der IgG-Steuerungsoption möglicherweise nicht zusammen auf, daher wird die Fehlermeldung bezüglich der IgG-Kontrollprobe mit der IgG-Steuerungsoption weggelassen. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Diese beiden Shell-Skripte führen Peak-Calls für CUT&RUN-Samples mit drei Peak-Caller (MACS2, MACS3 und SEACR) mit verschiedenen Optionen durch: mit/ohne IgG-Steuerungsoption, unter Verwendung von bedGraph-Rohdateien mit der Normalisierungsoption von Peak-Caller oder normalisierten Readcounts-bedGraph-Dateien ohne Normalisierungsoption von Peak-Caller und stringenten und gelockerten SEACR-Peak-Calling-Optionen. Da die Ausgabedateien, die den Peak aufrufen, nicht ausreichen, um direkt in nachgelagerten Analysen verwendet zu werden, enthält Easy Shells CUTnRUN ein Skript, um diese sogenannten Peak-Ausgabedateien zu verarbeiten und neue Peak-Dateien zu erstellen, die Chromosom, Start, Ende und Name der Peaks enthalten. Durch intensive Peak-Calling-Ansätze bietet Easy Shells CUTnRUN die Möglichkeit, das für das CUT&RUN-Projekt eines Benutzers am besten geeignete Peak-Calling-Programm auszuwählen, indem die Peaks von drei Peak-Anrufern verglichen werden. Darüber hinaus bietet diese CUT&RUN-Analysepipeline auch die Möglichkeit, die für das CUT&RUN-Projekt eines Benutzers am besten geeigneten Optionen für Spitzenanrufe auszuwählen. Diese Vergleiche werden durch ein Venn-Diagramm und eine Visualisierung als Heatmap und Durchschnittsdiagramm durchgeführt.
13. Erstellen von aufgerufenen Peakbett-Dateien
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben in: (i) Führen Sie die awk-Funktion mit Bettdateien im Ordner ~/Desktop/GSE126612/SEACR aus, um zwei Arten von SEACR-Spitzenbettdateien ~/Desktop/GSE126612/peak-bed_SEACR Ordner zu erstellen. Die gesamten Peakbett-Dateien enthalten den Anfang und das Ende jedes Peaks, und die fokussierten Peakbett-Dateien enthalten den Anfang und das Bett des höchsten Signalbins innerhalb jedes Peaks. (ii) Führen Sie die awk-Funktion mit _peaks.xls Dateien in den Ordnern ~/Desktop/GSE126612/MACS2 und ~/Desktop/GSE126612/MACS3 aus, um ganze Peakbettdateien zu erstellen, die den Anfang und das Ende jedes von MACS2 und MACS3 aufgerufenen Peaks in den Ordnern ~/Desktop/GSE126612/peak-bed_MACS2 und ~/Desktop/GSE126612/peak-bed_MACS3 enthalten. (iii) Führen Sie die awk-Funktion mit _summits.bed-Dateien in den Ordnern ~/Desktop/GSE126612/MACS2 und ~/Desktop/GSE126612/MACS3 aus, um fokussierte Peak-Bettdateien zu erstellen, die den Anfang und das Ende des wichtigsten Bins innerhalb jedes Peaks enthalten. (iv) Protokolldateien werden im Textdateiformat im Ordner ~/Desktop/GSE126612/log/peak-bed geschrieben. - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wurde für Folgendes geschrieben: (i) Führen Sie die Funktion bedtools intersect mit Peak-Bed-Dateien aus, die ohne IgG-Steuerungsoption aufgerufen werden, um Peaks zu entfernen, die sich mit IgG-Kontrollpeaks überlappen. (ii) Die gefilterten Peak-Bed-Dateien werden in den Ordnern ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 und ~/Desktop/GSE126612/peak-bed-filtered_SEACR gespeichert. (iii) Eine Protokolldatei log_filter-peaks.txt im Ordner ~/Desktop/GSE126612/log/filter-peaks erstellt wird. - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird für Folgendes geschrieben: (i) Führen Sie die cat - und sort-Funktionen aus, um die gesamten MACS2- und MACS3-Peakbettdateien der Replikate als eine Peakbettdatei zu verketten, und sortieren Sie die verkettete Peakbettdatei im Ordner ~/Desktop/GSE126612/bed-for-comparison . (ii) Führen Sie die Merge-Funktion bedtools mit den verketteten ganzen Peakbettdateien aus, um Peaks zusammenzuführen, die sich überlappen. (iii) Eine Protokolldatei log_cat-merged-peak-bed_MACS.txt die in den Protokollordner ~/Desktop/GSE126612/log/cat-merged-peak-bed geschrieben wird. - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird für Folgendes geschrieben: (i) Ausführen der cat - und sort-Funktionen , um die gesamten SEACR-Peakbettdateien der Replikate als eine Peakbettdatei zu verketten, und Sortieren der verketteten Peakbettdatei im Ordner ~/Desktop/GSE126612/bed-for-comparison . (ii) Führen Sie die Merge-Funktion bedtools mit den verketteten ganzen Peakbettdateien aus, um Peaks zusammenzuführen, die sich überlappen. (iii) Eine Protokolldatei log_cat-merged-peak-bed_SEACR.txt die in den Protokollordner ~/Desktop/GSE126612/log/cat-merged-peak-bed geschrieben wird. - Überprüfen Sie nach Abschluss des Ausführens der Shellskripts die Protokolldateien sorgfältig. Wenn in den Protokolldateien eine Fehlermeldung angezeigt wird, beheben Sie den Fehler, und führen Sie die Skripts erneut aus. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Die Dateien des gesamten Peakbetts der Peakregionen werden als Eingabedateien für die Venn-Diagrammanalyse verwendet, um die Ähnlichkeit zwischen Peak-Calling-Optionen, Peak-Calling-Methoden, Replikationen und genomischen Landschaftsbeobachtungen in der Nähe von Peak-Regionen zu vergleichen. Die zusammengeführten Dateien des Peakbetts der gesamten Peakregionen werden für die Analyse der Hauptkomponente (PC) und der Korrelationsanalyse des Pearson-Koeffizienten mit Deeptools verwendet. Die fokussierten Peakbett-Dateien werden für die Heatmap- und Average-Plot-Analyse mit Deeptools verwendet.
14. Validierung der Ähnlichkeit zwischen Replikaten unter Verwendung der Pearson-Korrelation und der Hauptkomponentenanalyse (PC).
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, wird Benutzern möglicherweise Folgendes angezeigt: /path/to/bash (oder eine ähnliche Meldung wie /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal standardmäßig die Bash-Shell verwendet, überspringen Sie diesen Schritt.
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Führen Sie die BED-Dateifunktion multiBamSummary mit den BAM-Dateien der Replikate aus, die nach Koordinaten sortiert wurden, und führen Sie ganze Peak-Bed-Dateien für CTCF, H3K27Ac und RNAPII-S5P zusammen, um Matrixdateien für die Pearson-Korrelationsanalyse im Ordner Desktop/GSE126612/deeptools_multiBamSummary zu generieren. (ii) Führen Sie die Funktion plotCorrelation unter Verwendung der Matrixdateien aus, um die Berechnung des Pearson-Korrelationskoeffizienten und das Heatmap-Clustering durchzuführen, und speichern Sie das Ergebnis im Ordner ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Notieren Sie sich eine Protokolldatei log_plotCorrelation.txt im Ordner ~/Desktop/GSE126612/log/correlation . - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Führen Sie die BED-Dateifunktion multiBamSummary mit den bam-Dateien aus, die nach Koordinaten sortiert wurden, und führen Sie ganze Peakbettdateien aus, die alle CTCF-, H3K27ac- und RNAPII-S5P-Peaks enthalten, um Matrixdateien für die Hauptkomponentenanalyse (PCA) im Ordner Desktop/GSE126612/deeptools_multiBamSummary zu generieren. (ii) Führen Sie die plotPCA-Funktion mit den Matrixdateien aus, um PCA durchzuführen, und speichern Sie das Ergebnis im Ordner ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Notieren Sie sich eine Protokolldatei log_plotPCA.txt im Ordner ~/Desktop/GSE126612/log/correlation . - Überprüfen Sie nach Abschluss des Ausführens von Shell-Skripten die Protokolldateien. Wenn eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und führen Sie die Shell-Skripts erneut aus. Wenn es ein Problem gibt, das Problem zu lösen, fordern Sie Hilfe über die Easy Shells CUTnRUN github issues webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) an.
HINWEIS: Grundsätzlich weisen ordnungsgemäß vorbereitete und verarbeitete Replikate höhere Pearson-Korrelationskoeffizientenwerte innerhalb derselben Clustering-Gruppe und eine enge Positionierung in der Hauptkomponentenanalyse auf. Jedes Replikat, das einen niedrigeren Pearson-Korrelationskoeffizienten und einen großen Abstand zu anderen Replikaten im Hauptkomponentendiagramm aufweist, kann einen potenziellen Ausreißer unter den Replikaten darstellen. Dieses Shell-Skript ist für alle gelesenen Daten im BAM-Format anwendbar. Ändern Sie den Pfad und den Dateinamen von Bigwig-Dateien, um projektspezifische Anforderungen zu erfüllen.
15. Validierung der Ähnlichkeit zwischen Replikaten, Peak-Calling-Methoden und Optionen mithilfe des Venn-Diagramms
- Öffnen Sie das Terminal, und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, befindet sich möglicherweise etwas wie /path/to/bash (z. B. /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal die Bash-Shell als Standard-Shell verwendet, sollten Sie diesen Schritt überspringen
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Führen Sie die Funktion intervene venn unter Verwendung von Peak-Bettdateien für die gesamte Peakregion aus, um Überlappungen zwischen den Peaks zu finden, die von verschiedenen Optionen aufgerufen werden (mit/ohne IgG-Steuerungsoption, mit/ohne Normalisierung und stringenten/gelockerten Peak-Calling-Optionen für SEACR). (ii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/intervene_methods) und speichern Sie die Ergebnisse der Venn-Diagrammanalyse in diesem Ordner. (iii) Notieren Sie sich eine Protokolldatei log_intervene_methods.txt im Ordner ~/Desktop/GSE126612/log/intervene . - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wird geschrieben für: (i) Führen Sie die Funktion intervene venn mit den Peakbettdateien der gesamten Peakregion aus, um Überlappungen zwischen den Peaks der Replikate zu finden. (ii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/intervene_replicates) und speichern Sie die Ergebnisse der Venn-Diagrammanalyse in diesem Ordner. (iii) Notieren Sie sich eine Protokolldatei log_intervene_replicates.txt im Ordner ~/Desktop/GSE126612/log/intervene . - Überprüfen Sie nach Abschluss der Ausführung der Shellskripts die Protokolldateien. Wenn eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und führen Sie die Shell-Skripts erneut aus. Wenn es ein Problem bei der Verwendung der Easy Shells CUTnRUN-Analysepipeline gibt, wenden Sie sich an die Hilfe auf der Easy Shells CUTnRUN Github Issues Webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
HINWEIS: Diese Analyseergebnisse des Venn-Diagramms geben Aufschluss über die Auswahl der am besten geeigneten Peak-Calling-Optionen, -Methoden und -Replikate mit hoher Reproduzierbarkeit für die Downstream-Analyse. Es kann bevorzugt sein, die Peak-Calling-Optionen und -Methoden zu wählen, die die höchsten angerufenen Peak-Zahlen mit guter Überlappung mit anderen Peak-Calling-Methoden und -Optionen anzeigen.
16. Analyse von Heatmaps und Durchschnittsdiagrammen zur Visualisierung sogenannter Peaks.
- Öffnen Sie das Terminal und geben Sie echo $SHELL ein, um die Standard-Shell im aktiven Terminal zu überprüfen. Wenn die Bash-Shell die Standard-Shell im aktuellen Terminal ist, befindet sich möglicherweise etwas wie /path/to/bash (z. B. /bin/bash) im Terminal.
- Wenn die Standard-Shell nicht Bash ist, legen Sie die Bash-Shell als Standard-Shell fest, indem Sie chsh -s $(which bash) in das Terminal eingeben. Wenn das Terminal die Bash-Shell als Standard-Shell verwendet, sollten Sie diesen Schritt überspringen
- Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
HINWEIS: Dieses Skript wurde geschrieben für: (i) Führen Sie die computeMatrix-Referenzpunktfunktion mit normalisierten bigWig-Dateien und fokussierten Peakbettdateien aus, um normalisierte Leseanzahlmatrizen in der Mitte der fokussierten Peaks im Ordner ~/Desktop/GSE126612/deeptools_computeMatrix zu erstellen. (ii) Führen Sie die plotHeatmap-Funktion unter Verwendung der normalisierten Readcounts-Matrix aus, um Heatmaps und Durchschnittsdiagramme zu generieren, die das Verteilungsmuster der normalisierten readcounts an den fokussierten Peak-Positionen visualisieren. (iii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/deeptools_plotHeatmap) und speichern Sie die plotHeatmap-Ausgabedateien in diesem Ordner. (iv) Notieren Sie sich eine Protokolldatei log_plotHeatmap_focused.txt im Ordner ~/Desktop/GSE126612/log/plotHeatmap . - Geben Sie ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh in das Terminal ein oder ziehen Sie die Shell-Skriptdatei in das Terminal und geben Sie die Eingabetaste ein.
Dieses Skript ist geschrieben für: (i) Führen Sie die computeMatrix-Referenzpunktfunktion mit normalisierten bigWig-Dateien und ganzen Peakbettdateien aus, um normalisierte Readcounts-Matrizen in der Mitte der gesamten Peaks im Ordner ~/Desktop/GSE126612/deeptools_computeMatrix zu erstellen. (ii) Führen Sie die plotHeatmap-Funktion mit der normalisierten Readcounts-Matrix aus, um Heatmaps und Durchschnittsdiagramme zu generieren, die das Verteilungsmuster der normalisierten readcounts an den gesamten Peak-Positionen visualisieren. (iii) Erstellen Sie einen Ordner (~/Desktop/GSE126612/deeptools_plotHeatmap) und speichern Sie die plotHeatmap-Ausgabedateien in diesem Ordner. (iv) Notieren Sie sich eine Protokolldatei log_plotHeatmap_whole.txt im Ordner ~/Desktop/GSE126612/log/plotHeatmap . - Überprüfen Sie nach Abschluss der Ausführung der Shellskripts die Protokolldateien. Wenn eine Fehlermeldung angezeigt wird, korrigieren Sie den Fehler, und führen Sie die Shell-Skripts erneut aus. Wenn es ein Problem bei der Verwendung der Easy Shells CUTnRUN-Analysepipeline gibt, wenden Sie sich an die Hilfe auf der Easy Shells CUTnRUN Github Issues Webpage (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
HINWEIS: Im Idealfall weisen die Gipfelpositionen der MACS2/3-Gipfel und die fokussierten Gipfelpositionen der SEACR-Gipfel eine scharfe und fokussierte Signalverteilung in der Mitte der Diagramme auf. Wenn der Peak-Calling-Algorithmus jedoch für CUT&RUN-Daten nicht richtig funktioniert, kann es zu einer weniger fokussierten "verrauschten" Signalverteilung in den Diagrammen kommen. Daher wird die Verwendung der Anzahl der aufgerufenen Peaks und der Peaksignalverteilungsmuster der Ausgabediagramme die Bestimmung der Peakvalidität für weitere CUT&RUN-Analysen leiten, die auch die Downstream-Peak-Annotation beinhalten.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Qualität und Adaptertrimmung behalten Lesevorgänge mit hoher Sequenzierungsqualität bei
Hochdurchsatz-Sequenzierungstechniken sind anfällig für Sequenzierungsfehler wie Sequenzierungsmutationen in Reads. Darüber hinaus können Sequenzierungsadapter-Dimere in Sequenzierungsdatensätzen angereichert werden, da der Adapter während der Bibliotheksvorbereitung schlecht entfernt wird. Übermäßige Sequenzierungsfehler, wie z. B. Read-Mutationen, die Generierung von Reads, die kürzer als für ein ordnungsgemäßes ...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die Fähigkeit, die Proteinbelegung auf dem Chromatin zu kartieren, ist von grundlegender Bedeutung für die Durchführung mechanistischer Studien auf dem Gebiet der Chromatinbiologie. Da Labore neue Nasslabortechniken zur Profilierung des Chromatins einführen, wird die Fähigkeit, Sequenzierungsdaten aus diesen Nasslaborexperimenten zu analysieren, zu einem häufigen Engpass für Nasslaborwissenschaftler. Daher beschreiben wir ein einführendes Schritt-für-Schritt-Protokoll, das es Bioinformat...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären keine Offenlegungen.
Danksagungen
Alle abgebildeten Figuren sind mit BioRender.com entstanden. Das CAI würdigt die Unterstützung durch einen Ovarian Cancer Research Alliance Early Career Investigator Award, einen Forbeck Foundation Accelerator Grant und den Minnestoa Ovarian Cancer Alliance National Early Detection Research Award.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Software zum Komprimieren und Konvertieren von readcounts bedGraph in bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ the U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Software zur Verarbeitung von bam/bed/bedGraph-Dateien |
| bowtie2 2.5.4 | Johns Hopkins Universität | https://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Software zur Erstellung des Bowtie-Index und zur Durchführung der |
| Ausrichtung CollectInsertSizeMetrics (Picard) | Broad Institute | https://github.com/broadinstitute/picard | Software zur Durchführung von Analysen der Wendeplattengrößenverteilung |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Software zur Durchführung des Adaptertrimms |
| Deeptoolsv3.5.1 | Max-Planck-Institut | https://deeptools.readthedocs.io/en/develop/index.html | Software zur Durchführung von Pearson-Koeffizienten-Korrelationsanalysen, Hauptkomponentenanalysen und Heatmap-/Durchschnittsdiagrammanalysen |
| FastQC Version 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Software zur Überprüfung der Qualität der Fastq-Datei |
| Intervenev0.6.1 | Computational Biology & Genregulation - Mathelier-Gruppe | https://intervene.readthedocs.io/en/latest/index.html | Software zur Durchführung von Venn-Diagramm-Analysen mit Peak-Dateien |
| MACSv2.2.9.1 | Chan Zuckerberg-Initiative | https://github.com/macs3-project/MACS/tree/macs_v2 | Software zum Aufrufen von Peaks |
| MACSv3.0.2 | Chan Zuckerberg-Initiative | https://github.com/macs3-project/MACS/tree/master | Software zum Aufrufen von Peaks |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Software zur Verarbeitung von sam/bam-Dateien |
| SEACRv1.3 | Howard Hughes Medial Institute | https://github.com/FredHutch/SEACR | Software zum Aufrufen von Peaks |
| SRA Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | Software zum Herunterladen von SRR von GEO |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | Software zur Durchführung von Qualitäts- und Ataptertrimmungen |
Referenzen
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Nachdrucke und Genehmigungen
