Diese bibliometrische Analyse nutzte CiteSpace, VOSviewer und Scimago Graphica, um Publikationstrends, Kooperationsnetzwerke und aufkommende Forschungshotspots in der T-Lymphozyten-Metabolisch-Reprogrammierungsforschung von 2016 bis 2025 zu bewerten.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Bibliometrische Analyse der metabolischen Reprogrammierung in T-Lymphozyten zeigt Forschungstrends und entstehende Hotspots, 2016–2025
* These authors contributed equally
In diesem Artikel
Zusammenfassung
Zusammenfassung
T-Lymphozyten sind zentrale Regulatoren der Immunantworten, und aktuelle Studien haben gezeigt, dass Stoffwechselprozesse die Aktivierung, Differenzierung und Effektorfunktion von T-Lymphozyten bei Krebs und Autoimmunerkrankungen beeinflussen. Diese Studie führte eine bibliometrische Analyse von Publikationen vom 1. Januar 2016 bis zum 31. Dezember 2025 durch, die aus der Web of Science Core Collection abgerufen wurde. CiteSpace wurde für Co-Occurrence-, Co-Citation- und Clustering-Analysen von Referenzen und Schlüsselwörtern genutzt. VOSviewer wurde eingesetzt, um Zeitschriften, Autoren, Referenzen, Länder und Institutionen zu analysieren, während Scimago Graphica nationale Kollaborationsnetzwerke visualisierte und Excel zur Bewertung jährlicher Publikationstrends verwendet wurde. Insgesamt wurden 1.882 Publikationen einbezogen. Die jährliche Publikationsproduktion stieg stetig, mit bemerkenswertem Wachstum in den Jahren 2021 und 2025. China steuerte das höchste Publikationsvolumen bei, während die Vereinigten Staaten einen größeren Zitationseffekt zeigten. Frontiers in Immunology war die produktivste Zeitschrift, während Nature den höchsten Zitationseinfluss aufwies. Keyword-Clustering und Zitationsanalysen identifizierten sich entwickelnde Forschungshotspots, die sich auf die T-Lymphozyten-Stoffwechselreprogrammierung, den Glukose- und Aminosäurestoffwechsel sowie das aufkommende Interesse an Immun-Zell-Stoffwechselwirkungen konzentrierten. Insgesamt zeigt diese bibliometrische Analyse eine fortschreitende Ausweitung der Forschung zum T-Lymphozyten-Immunstoffwechsel und hebt aufkommende thematische Richtungen hervor, darunter die interzelluläre Stoffwechselregulation und den Lipidstoffwechsel.
Einleitung
Naive T-Lymphozyten sind hauptsächlich auf mitochondriale oxidative Phosphorylierung (OXPHOS) angewiesen, um ihren ruhigen und energiearmen Stoffwechselzustandaufrechtzuerhalten. Bei Antigenstimulation hingegen durchlaufen aktivierte T-Lymphozyten eine Stoffwechselverschiebung hin zur aeroben Glykolyse, um eine schnelle Proliferation und Effektorfunktionzu unterstützen 2. Effektor-T-Lymphozyten, insbesondere zytotoxische Teilgruppen, sind auf Glykolyse angewiesen, um den erhöhten bioenergetischen und biosynthetischen Bedarf zu decken, der mit der Zytokinproduktion und Zellexpansion verbundenist 3. Obwohl die Glykolyse pro Glukosemolekül weniger Adenosintriphosphat (ATP) produziert als OXPHOS, unterstützt ihre schnelle Stoffwechselrate die funktionellen Anforderungen aktiverter Immunzellen4. Übermäßige glykolytische Aktivität kann ebenfalls zu schädlichen Auswirkungen im Immunmikroumfeld beitragen. Die Laktatanreicherung kann die glukosebasierte Serinsynthese beeinträchtigen und das intrazelluläre Redoxgleichgewicht verändern, wodurch die Proliferation und Funktion der T-Lymphozyten unterdrücktwerden. Darüber hinaus stören erhöhte Laktatspiegel die glykolyseabhängigen Migrationswege und verringern die Motilität der CD4⁺- und CD8⁺-T-Lymphozyten6,7.
Der zelluläre Stoffwechsel passt sich dynamisch an Umwelt- und physiologische Reize an, durch einen Prozess, der als metabolische Umprogrammierung 8,9 bekannt ist. Zunehmende Belege deuten darauf hin, dass die metabolische Umprogrammierung eine zentrale Rolle bei der Regulation der Aktivierung, Differenzierung und funktionellen Plastizität von T-Lymphozyten spielt10,11. Diese metabolischen Veränderungen sind besonders relevant bei Krebs- und Autoimmunerkrankungen, bei denen Veränderungen im Immunmikroumfeld die Funktion des T-Lymphozyten und die Immunregulation beeinflussen12,13. Obwohl mehrere bibliometrische Studien den Immunstoffwechsel in breiteren Kontexten bewertet haben, darunter Krebs-Immunstoffwechsel und krankheitsassoziierter Immunstoffwechsel, konzentrieren sich diese Analysen hauptsächlich auf generalisierte immun-metabolische Interaktionen und nicht auf T-lymphozytenspezifische metabolische Reprogrammierung14,15. Eine umfassende bibliometrische Evaluation, die speziell dem T-Lymphozyten-Immunmetabolismus gewidmet ist, bleibt begrenzt, insbesondere im Hinblick auf Forschungstrends, Kooperationsnetzwerke und sich entwickelnde thematische Hotspots in diesem Fachgebiet.
Um diese Lücke zu schließen, führte diese Studie eine bibliometrische Analyse der Publikationen durch, die vom 1. Januar 2016 bis zum 31. Dezember 2025 in der Web of Science Core Collection (WOScc) indexiert sind. CiteSpace, VOSviewer und Scimago Graphica wurden verwendet, um Publikationsoutput, Kollaborationsmuster, Co-Zitationsbeziehungen und thematische Evolution in der Forschung zur metabolischen Umprogrammierung von T-Lymphozyten quantitativ zu analysieren. Im Gegensatz zu traditionellen narrativen Reviews bietet bibliometrische Analyse einen strukturierten und datenbasierten Überblick über die wissenschaftliche Landschaft durch Zitation, Clustering und Keyword-Analysen. Ziel dieser Studie war es, globale Forschungstrends und aufkommende Hotspots im T-Lymphozyten-Immunmetabolismus systematisch zu charakterisieren und einen organisierten Überblick über die aktuelle Wissenslandschaft in diesem sich schnell entwickelnden Bereich zu geben.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie analysierte ausschließlich bibliografische Daten, die aus öffentlich zugänglichen Datenbanken abgerufen wurden, und betraf weder menschliche Teilnehmer, Tiere noch identifizierbare personenbezogene Daten; daher waren keine institutionelle ethische Zustimmung und informierte Zustimmung erforderlich.
Datenerfassung und Suchstrategie
Die Daten wurden am 27. Januar 2026 aus dem WoSCC (https://www.webofscience.com/wos/woscc/) extrahiert. Die ausgewählten Datenbankausgaben waren der Science Citation Index Expanded (SCI-EXPANDED) und der Social Sciences Citation Index innerhalb des WoSCC. Die Suche wurde über die erweiterte Suchoberfläche durchgeführt. Die Suchstrategie wurde im Feld "Thema (TS)" angewendet, und die vollständige Suchanfrage sowie die resultierenden Datensätze werden in Tabelle 1 dargestellt. Der Suchzeitraum war auf Publikationen beschränkt, die zwischen dem 1. Januar 2016 und dem 31. Dezember 2025 mit dem WoSCC-"Timespan"-Filter indexiert wurden. Nur Originalforschungsartikel und Übersichtsartikel wurden mit dem Filter "Dokumententypen" aufgenommen. Die Sprache war auf Englisch beschränkt, und es gab keine Einschränkungen hinsichtlich Land, Institution oder Forschungsgebiete. Alle Datensätze wurden im Klartextformat exportiert, wobei während des Exports "Vollständiger Datensatz und zitierte Quellen" ausgewählt wurde. Wenn die Anzahl der abgerufenen Datensätze 500 überstieg, wurden Datensätze in mehreren Chargen heruntergeladen und anschließend vor der Analyse zu einem einzigen Datensatz zusammengeführt. Nach dem Abruf wurden alle Datensätze in CiteSpace zur Vorverarbeitung und bibliometrischen Analyse importiert. Doppelte Datensätze wurden mithilfe der integrierten Deduplizierungsfunktion in CiteSpace identifiziert und entfernt, basierend auf bibliografischen Metadaten, einschließlich Titel, Autoren, Veröffentlichungsjahr und Quellenzeitschrift. Wenn potenzielle Unstimmigkeiten oder unvollständige bibliografische Datensätze festgestellt wurden, wurde zusätzlich eine manuelle Überprüfung durchgeführt, um die Datengenauigkeit und -konsistenz vor der Analyse sicherzustellen.
| Set | Ergebnisse | Suchanfrage |
| #1 | 252,461 | TS= ("T-Zelle*" ODER "T-Zelle*" ODER "T-Lymphozyt*" ODER "T-Lymphozyt*" ODER "CD4+ T-Zelle*" ODER "CD8+ T-Zelle*" ODER "zytotoxische T-Zelle*" ODER "regulatorische T-Zelle*" ODER "T-Helfer*" ODER "Th-Zelle*" ODER "naive T-Zelle*" ODER "Gedächtnis-T-Zelle*" ODER "Effektor-T-Zelle*") |
| #2 | 13,799 | TS=("metabolisches Reprogramm*" ODER "metabolisches Remodel*" ODER "metabolisches Rewiring") |
| #3 | 1,882 | #1 UND #2 |
Tabelle 1: Web of Science Core Collection Suchstrategie für bibliometrische Datenabrufe. Die Tabelle fasst die detaillierte Suchstrategie, Schlüsselwortkombinationen, Boolesche Operatoren und endgültige Abrufzahlen zusammen, die für die Literatursammlung aus dem WoSCC verwendet werden. Die Suchanfragen wurden über das Feld "Thema (TS)" in der erweiterten Suchoberfläche durchgeführt. Joker (*) wurden verwendet, um mehrere Wortendungen und verwandte Terminologie abzurufen. Der endgültige Datensatz bestand aus Publikationen, die zwischen dem 1. Januar 2016 und dem 31. Dezember 2025 nach Anwendung von Sprach- und Dokumenttypfiltern indexiert wurden.
Analytische Ansätze
Ein multitool-bibliometrischer Ansatz wurde systematisch für die Datenanalyse implementiert. Die Analyse wurde in einer Windows-10-Betriebssystemumgebung durchgeführt. CiteSpace (v.5.7.R2) wurde verwendet, um Referenzen und Schlüsselwörter zu analysieren, indem TXT-Format-Daten verarbeitet wurden, die aus WoSCC exportiert wurden. Die CiteSpace-Parameter waren wie folgt konfiguriert: (1) Die Zeitplanung wurde von 2016 bis 2025 mit einem Jahr pro Schnitt festgelegt; (2) die Auswahlkriterien wurden mit dem g-Index konfiguriert (k = 25); (3) Pruning-Methoden umfassten Pathfinder, Pruning Sliced Networks und Pruning the Merged Network, um Netzwerkstrukturen zu vereinfachen und gleichzeitig wichtige Beziehungen zu erhalten; und (4) die Clustering-Analyse wurde mit dem Log-Likelihood-Ratio-Algorithmus16 durchgeführt. Diese Analyse erzeugte Kozitationsnetzwerke, Clustering-Karten, Zeitlinienvisualisierungen und Burst-Erkennungskarten sowohl für Referenzen als auch für Schlüsselwörter. In den Visualisierungskarten stellte die Knotengröße die Häufigkeit dar, die Verbindungsdicke die Ko-Vorkommensstärke, und violette Ringe stellten eine hohe Zwischenzentralität dar. Burst-Knoten spiegelten einen plötzlichen Anstieg der Zitations- oder Schlüsselworthäufigkeit im Laufe der Zeit wider.
Anschließend wurden die exportierten Dateien in der UTF-8-Codierung mit Windows Notepad neu gespeichert und in VOSviewer (Version 1.6.20) importiert, um bibliometrische Kartierungen zu ermöglichen, einschließlich Co-Autoren-, Co-Citation- und Co-Occurrence-Analysen über Autoren, Zeitschriften, Institutionen und Länderhinweg 17. Die Vollzählmethode wurde angewandt, und die Normalisierung erfolgte mit der Assoziationsstärke-Methode. Minimale Vorkommensschwellenwerte wurden entsprechend der Datensatzgröße festgelegt (Autoren ≥ 5 Publikationen; Schlüsselwörter ≥ 5 Vorkommnisse; Institutionen ≥ 3 Publikationen). Die Netzwerkvisualisierung basierte auf Item-Gewicht und Gesamtlinkstärke. Für die Analyse der Zusammenarbeit auf Länderebene wurden GML-Dateien, die aus VOSviewer exportiert wurden, in Scimago Graphica (Version 1.0.53) importiert, wo die Knoten Länder repräsentierten. Netzwerkvisualisierung und Clustering wurden mit dem Standard-Force-Directed Layout-Algorithmus generiert, um räumliche Beziehungen und Kollaborationsmuster zwischen Ländern darzustellen. WPS Excel wurde für eine beschreibende statistische Analyse jährlicher Publikationstrends und zur grundlegenden Datenzusammenfassung verwendet. Die Ergebnisse wurden mithilfe von Balkendiagrammen, Säulendiagrammen und Liniendiagrammen visualisiert.
Eine ergänzende zeitliche Analyse wurde mit derselben oben beschriebenen Suchstrategie durchgeführt, wobei die Suche auf Publikationen beschränkt ist, die zwischen dem 1. Januar 2025 und dem 31. Dezember 2025 indexiert sind. Innerhalb desselben WoSCC-Abfragerahmens und analytischen Umfelds wurden aktuelle Veröffentlichungen und konferenzbezogene Ergebnisse zu kontextuellen und beschreibenden Zwecken abgerufen. Dieses Verfahren wurde vollständig innerhalb der integrierten analytischen Schnittfläche des WoSCC durchgeführt. Es wurde kein unabhängiger Datensatz erstellt, und die abgerufenen Informationen wurden weder in den primären bibliometrischen Datensatz integriert noch für quantitative Analysen verwendet. Das gesamte Studiendesign und der bibliometrische Analyse-Workflow werden in einem Flussdiagramm zusammengefasst (Abbildung 1).
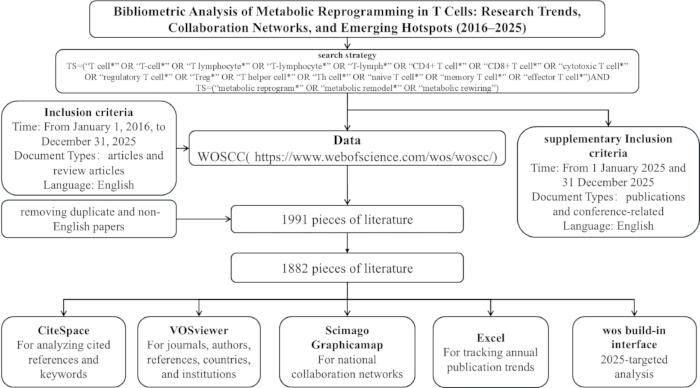
Abbildung 1. Arbeitsablauf der bibliometrischen Analyse der T-Lymphozyten-Stoffwechselreprogrammierungsforschung. Schematischer Überblick über das Studiendesign und den analytischen Workflow, der in dieser bibliometrischen Analyse verwendet wird. Publikationen wurden aus der Web of Science Core Collection (WoSCC) unter Verwendung vordefinierter Suchstrategien und Einschlusskriterien abgerufen. Abgerufene Datensätze wurden im Klartext exportiert und einer Vorverarbeitung unterzogen, einschließlich Duplikatentfernung und bibliografischer Datenstandardisierung. Bibliometrische Analysen wurden mit CiteSpace für Ko-Zitation, Schlüsselwort-Ko-Vorkommen, Clustering und Burst-Erkennung durchgeführt, sowie mit VOSviewer für Analysen von Kollaborationsnetzwerken zwischen Autoren, Institutionen, Ländern und Zeitschriften. Scimago Graphica wurde verwendet, um internationale Kollaborationsnetzwerke zu visualisieren, und WPS Excel wurde verwendet, um jährliche Publikationstrends und beschreibende Statistiken zu analysieren. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Publikationsoutput und zeitliche Trends
Um die zeitliche Entwicklung der Forschungstätigkeit in diesem Bereich zu charakterisieren, wurde eine bibliometrische Analyse mit Publikationen durchgeführt, die im WoSCC indexiert sind. Insgesamt wurden in den letzten zehn Jahren zunächst 1.991 Datensätze geborgen. Nach der Entfernung von doppelten und nicht-englischen Unterlagen wurden letztlich 1.882 Publikationen aufgenommen und analysiert, darunter 1.046 Originalforschungs...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Unsere bibliometrische Analyse der metabolischen Umprogrammierung in T-Zellen zeigte einen anhaltenden Anstieg der Forschungsergebnisse über die Zeit. Im Jahr 2020 gab es einen deutlichen Anstieg der Publikations- und Zitationszahlen mit 40 weiteren Publikationen und 1.989 zusätzlichen Zitationen im Vergleich zu 2019. Dieser Anstieg fiel zeitlich mit mehreren hochzitierten Publikationen zusammen, darunter Glutamine blockade induces divergent metabolic programs to overcome tumor immun...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Interessenkonflikte:
Die Autoren geben keine Interessenkonflikte im Zusammenhang mit diesem Werk an.
Autorenargumente:
Datenerhebung und Literaturabruf wurden von Yi Liu durchgeführt. Datenvorverarbeitung und bibliometrische Analysen wurden von Yinping Yang durchgeführt. Visualisierung und Figurenvorbereitung wurden von Xinyue Yang und Jinquan Li durchgeführt. Der erste Entwurf des Manuskripts wurde von Yi Liu und Weihong Li verfasst. Alle Autoren trugen zur Überarbeitung des Manuskripts bei und genehmigten die endgültig eingereichte Version.
Danksagungen
Die Autoren erkennen die finanzielle Unterstützung aus den Fundamental Research Funds for the Central Universities (2022-JYB-JBZR-037) dankbar an.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| CiteSpace | Drexel University | v.5.7.R2 | SCR_025121 |
| Microsoft Excel | Microsoft Corporation | v.2604 Build 16.0.19929.20136 | SCR_016137 (Microsoft Excel) |
| WPS Excel | Kingsoft Office | v.12.1.0.26375 | |
| Scimago Graphica | Scimago Lab | v.1.0.53 | Nicht verfügbar |
| VOSviewer | Leiden University | v.1.6.20 | SCR_023516 |
| Web of Science Core Collection | Clarivate Analytics | Zugriff am 27. Januar 2026; Version nicht zutreffend | Nicht verfügbar |
| Windows-Betriebssystem | Microsoft Corporation | Windows 10 | Nicht verfügbar |
Referenzen
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
- Wang R, et al. The transcription factor Myc controls metabolic reprogramming upon T-lymphocyte activation. Immunity. 2011;35(6):871-82.
- Shyer JA, et al. Metabolic signaling in T cells. Cell Res. 2020;30(8):649-59.
- Gubser PM, et al. Rapid effector function of memory CD8+ T cells requires an immediate-early glycolytic switch. Nat Immunol. 2013;14(10):1064-72.
- Yuan Q, et al. Enhancing intracellular NADPH bioavailability through improving pentose phosphate pathway flux and its application in biocatalysis asymmetric reduction reaction. J Biosci Bioeng. 2022;134(6):528-33.
- Quinn WJ III, et al. Lactate limits T-cell proliferation via the NAD(H) redox state. Cell Rep. 2020;33(11):108500.
- Pucino V, et al. Lactate buildup at the site of chronic inflammation promotes disease by inducing CD4+ T-cell metabolic rewiring. Cell Metab. 2019;30(6):1055-74.e8.
- O'Neill LAJ, et al. A guide to immunometabolism for immunologists. Nat Rev Immunol. 2016;16(9):553-65.
- Almeida L, et al. Metabolic pathways in T-cell activation and lineage differentiation. Semin Immunol. 2016;28(5):514-24.
- Haas R, et al. Lactate regulates metabolic and pro-inflammatory circuits in control of T-cell migration and effector functions. PLoS Biol. 2015;13(7):e1002202.
- Chang CH, Pearce EL. Emerging concepts of T-cell metabolism as a target of immunotherapy. Nat Immunol. 2016;17(4):364-68.
- Ho PC, et al. Reenergizing T-cell anti-tumor immunity by harnessing immunometabolic checkpoints and machineries. Curr Opin Immunol. 2017;46:38-44.
- Von Meyenn L, et al. Targeting T-cell metabolism in inflammatory skin disease. Front Immunol. 2019;10:2285.
- Zhu H, et al. Trends and hotspots in research related to tumor immune escape: bibliometric analysis and future perspectives. Front Immunol. 2025;16:1604216.
- Zhang B, et al. Mapping research trends in immune-cell metabolic reprogramming in breast cancer: a parallel dual-database bibliometric study. Discov Oncol. 2026;17:724.
- Chen G, et al. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-27.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-71.
- Leone RD, et al. Glutamine blockade induces divergent metabolic programs to overcome tumor immune evasion. Science. 2019;366(6468):1013-21.
- Watson MJ, et al. Metabolic support of tumour-infiltrating regulatory T cells by lactic acid. Nature. 2021;591(7851):645-51.
- Xia L, et al. The cancer metabolic reprogramming and immune response. Mol Cancer. 2021;20(1):28.
- Miao S, et al. tRNA m1A modification regulates cholesterol biosynthesis to promote antitumor immunity of CD8+ T cells. J Exp Med. 2025;222(3):e20240559.
- Angelin A, et al. Foxp3 reprograms T-cell metabolism to function in low-glucose, high-lactate environments. Cell Metab. 2017;25(6):1282-93.e7.
- Huang SC, et al. Metabolic reprogramming mediated by the mTORC2-IRF4 signaling axis is essential for macrophage alternative activation. Immunity. 2016;45(4):817-30.
- Nakaya M, et al. Inflammatory T-cell responses rely on amino acid transporter ASCT2 facilitation of glutamine uptake and mTORC1 kinase activation. Immunity. 2014;40(5):692-705.
- Ma EH, et al. Serine is an essential metabolite for effector T-cell expansion. Cell Metab. 2017;25(2):345-57.
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.