Dieses Protokoll beschreibt die Implementierung einer interoperablen Webplattform, die FHIR-basierte klinische Daten mit Retrieval-Augmented Generation und Multi-Agent-Modellen mit großer Sprachkapazität für die klinische Entscheidungsunterstützung verbindet. Der Arbeitsablauf ermöglicht eine reproduzierbare Bereitstellung, standardisierte Datenintegration und die Bewertung der Analyse medizinischer Daten mit Unterstützung durch künstliche Intelligenz (AI).
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
Interoperable Web-Plattform auf Basis großer Sprachmodelle zur medizinischen Datenanalyse: Ein Protokoll zur Unterstützung klinischer Entscheidungen
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die klinische Entscheidungsfindung wird häufig durch fragmentierte elektronische Patientenakten und eingeschränkte Interoperabilität zwischen heterogenen Gesundheitsinformationssystemen erschwert. Dieser Artikel stellt ein Schritt-für-Schritt-Protokoll zur Implementierung einer interoperablen Webplattform vor, die klinische Daten über den Standard Fast Healthcare Interoperability Resources (FHIR) integriert und dabei Retrieval-Augmented Generation (RAG), große Sprachmodelle (LLMs) sowie einen mehragentenbasierten klinischen Schlussfolgerungsrahmen nutzt, um die medizinische Datenanalyse und die klinische Entscheidungsunterstützung zu fördern. Das Protokoll beschreibt den gesamten Arbeitsablauf, einschließlich der Konfiguration der Rechenumgebung, der Vorverarbeitung klinischer Datensätze, der datenintegration auf Basis von FHIR, der Erstellung einer Vektordatenbank, der Konfiguration des Abrufs, des Prompt-Engineerings, der Koordination mehrerer Agenten und der Systemevaluierung. Beispiele für Ergebnisse zeigen die Fähigkeit der Plattform, klinisch relevante und kontextuell konsistente Antworten zu generieren, während gleichzeitig die semantische Interoperabilität zwischen heterogenen Datenquellen verbessert wird. Die Systemleistung wurde anhand komplementärer quantitativer und semantischer Metriken bewertet, darunter BLEU, ROUGE, BERTScore und Kosinus-Ähnlichkeit. Eine qualitative Bewertung erfolgte unter Verwendung öffentlich zugänglicher, vollständig anonymisierter Benchmark-Datensätze zur Beurteilung der Reproduzierbarkeit des vorgeschlagenen methodischen Workflows. Die vorgeschlagene Architektur kombiniert standardisierte Gesundheits-Interoperabilität mit abrufverstärkten Sprachmodellen, um kontextuelles Schlussfolgern zu verbessern, Halluzinationen zu reduzieren und reproduzierbare, KI-gestützte klinische Workflows zu unterstützen. Dieses Protokoll bietet einen skalierbaren und reproduzierbaren Rahmen für Forschende und Entwickler, die interoperable, datenschutzfreundliche und intelligente Gesundheitssysteme für die klinische Entscheidungsunterstützung, medizinische Datenanalyse und zukünftige translationale Forschung implementieren möchten.
Einleitung
Gesundheitsinformationen werden routinemäßig in Krankenhäusern, Diagnosezentren, Laboren und ambulanten Kliniken generiert und verbleiben dabei oft in heterogenen Informationssystemen verteilt. Diese Fragmentierung begrenzt die Interoperabilität und erschwert den zeitnahen Zugriff auf umfassende Patientenakten, was nachhaltige Herausforderungen für die klinische Versorgung, die Datenintegration und das Gesundheitsmanagement schafft1,2,3,4.
Die Folgen dieser Fragmentierung werden besonders deutlich in klinischen Arbeitsabläufen, die auf einen zeitnahen Zugriff auf Patienteninformationen angewiesen sind. Wenn medizinisches Fachpersonal nicht vollständige und integrierte Krankenakten abrufen kann, erschwert dies die klinische Beurteilung, erhöht das Risiko unvollständiger Entscheidungsfindung und verringert die Effizienz der Patientenversorgung, insbesondere in Notfallsituationen5,6.
Neuere Entwicklungen in der Künstlichen Intelligenz (KI), insbesondere große Sprachmodelle (Large Language Models, LLMs), haben das Spektrum der verfügbaren rechnergestützten Ansätze für Anwendungen im Gesundheitswesen erweitert. Diese Modelle wurden für Aufgaben wie die Unterstützung bei Diagnosen, die klinische Einordnung von Patienten und die Entscheidungsunterstützung untersucht. Beispielsweise bewerteten Jahan et al.5 den Einsatz von LLMs in biomedizinischen Aufgaben, während Taylor et al.7 feinabgestimmte Modelle für die digitale psychische Gesundheitsvorsorge untersuchten und ermutigende Ergebnisse in spezialisierten klinischen Umgebungen berichteten.
Die Anwendung von LLMs hat sich außerdem auf spezialisiertere klinische Bereiche ausgeweitet. Song et al. 49untersuchten deren Einsatz bei der Diagnose von Pneumokoniosen, während Chien et al.8 diese Modelle zur Analyse von Arbeitsbelastungsmustern bei informellen Pflegepersonen anwandten. In der Augenheilkunde schlugen Xue et al.9 ein Frage-Antwort-System für die Glaukomdiagnose vor, während Tan et al.3 und Wu et al.10 den Einsatz von LLMs in hybriden Diagnosesystemen und bei Beratungen zur traditionellen chinesischen Medizin berichteten.
Die Verwendung von LLMs beschränkt sich nicht auf direkte klinische Anwendungen. Zhang et al.11 untersuchten ihre Anwendung zur Erkennung von Emotionen in psychischen Gesundheitskontexten, während Sarzaeim et al.12 intelligente Polizeisysteme erforschten, die ebenfalls zur Analyse gesundheitsrelevanter Aspekte in der Öffentlichkeit beitragen könnten. Diese Studien verdeutlichen die breite Anwendbarkeit von auf LLMs basierenden Ansätzen in verschiedenen gesundheitsbezogenen Bereichen.
Obwohl große Sprachmodelle die Möglichkeiten für Anwendungen im Gesundheitswesen erweitert haben, ist ihre Integration in klinische Umgebungen weiterhin mit wichtigen technischen, organisatorischen und regulatorischen Herausforderungen verbunden. Eine praktische Implementierung erfordert geeignete Recheninfrastrukturen, effektives Datenmanagement sowie die Einhaltung regulatorischer Rahmenbedingungen wie der Datenschutz-Grundverordnung (DSGVO) und dem brasilianischen Allgemeinen Datenschutzgesetz (LGPD). Diese Rahmenbedingungen legen Anforderungen an die sichere und ethische Verarbeitung sensibler Gesundheitsdaten fest und behandeln dabei Fragen im Zusammenhang mit Datenschutz, Zuverlässigkeit und algorithmischer Voreingenommenheit in KI-gestützten Gesundheitssystemen13,14 .
Die Interoperabilität zwischen heterogenen Gesundheitsdatenquellen, einschließlich elektronischer Patientenakten (EHRs), medizinischen Bildgebungssystemen und Geräten des Internet der Dinge (IoT), stellt weiterhin eine große technische Herausforderung für die Implementierung von KI-gestützten Gesundheitslösungen dar. In diesem Zusammenhang bieten standardisierte Interoperabilitätsrahmenwerke wie HL7 FHIR einen strukturierten Mechanismus zum Austausch klinischer Informationen zwischen verschiedenen Systemen, wobei die semantische Konsistenz erhalten bleibt und eine skalierbare Integration ermöglicht wird.
Diese Arbeit stellt eine interoperable Webplattform vor, die große Sprachmodelle mit Standards für die Interoperabilität im Gesundheitswesen integriert, um die medizinische Datenanalyse in heterogenen klinischen Umgebungen zu unterstützen. Die vorgeschlagene Architektur kombiniert die datenbasierte Integration nach HL7 FHIR mit abrufverstärkter Generierung (Retrieval-Augmented Generation, RAG) und einem Multi-Agenten-Verarbeitungsframework, um kontextbewusste, KI-gestützte Analysen bereitzustellen und gleichzeitig die Einhaltung geltender Datenschutzanforderungen sicherzustellen, darunter das brasilianische Allgemeine Datenschutzgesetz (LGPD).
Dieses Protokoll beschreibt eine interoperable Architektur zur Integration heterogener klinischer Daten mithilfe etablierter Interoperabilitätsstandards im Gesundheitswesen. Außerdem werden die Implementierung einer mehrstufigen Agenten-Verarbeitungspipeline auf der Grundlage großer und kleiner Sprachmodelle (LLMs und SLMs) sowie ein Bewertungsrahmen erläutert, der quantitative Metriken und qualitative Analysen kombiniert, um das Verhalten der vorgeschlagenen Plattform zu beurteilen.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
Diese Studie umfasste weder die Rekrutierung von menschlichen Probanden noch den Zugriff auf identifizierbare Patientenakten oder Tierversuche. Das Protokoll wurde ausschließlich anhand öffentlich zugänglicher und vollständig anonymisierter Datensätze zur methodischen Validierung entwickelt und evaluiert. Es erfolgte kein Zugriff auf persönliche Gesundheitsdaten. Daher war keine Genehmigung durch eine zuständige Ethikkommission (IRB oder Research Ethics Committee) erforderlich. Das Protokoll wurde unter Einhaltung geltender Datenschutzgrundsätze, einschließlich des brasilianischen Allgemeinen Datenschutzgesetzes (LGPD), erstellt, um zukünftige Anwendungen mit klinischen Daten zu unterstützen.
Auswahl und Vorverarbeitung des Datensatzes
Das vorgeschlagene Protokoll wurde anhand öffentlich verfügbarer und vollständig anonymisierter klinischer Datensätze evaluiert, die strukturierte Elektronische Patientenakten (EHRs), Daten für klinische Frage-Antwort-Systeme sowie medizinische Bilddatensätze für die methodische Validierung umfassen. Vor der Integration in die Plattform durchliefen die Datensätze standardisierte Vorverarbeitungsschritte, einschließlich Datennormalisierung, Entfernung inkonsistenter oder unvollständiger Einträge, Zuordnung zu HL7 FHIR-Ressourcen, Textbereinigung, Segmentierung in Abrufblöcke und Erzeugung von Einbettungen für die Vektorindizierung. Diese Vorverarbeitungsschritte gewährleisteten semantische Konsistenz über heterogene Datenquellen hinweg, förderten die Interoperabilität und ermöglichten die Reproduzierbarkeit des vorgeschlagenen Workflows, wobei die Einhaltung geltender Datenschutzprinzipien sichergestellt blieb.
Die Datensätze wurden aus öffentlich zugänglichen Benchmark-Repositories bezogen, die üblicherweise in der Forschung zu künstlicher Intelligenz und digitaler Gesundheit verwendet werden. Sie wurden ausgewählt, um heterogene klinische Informationen darzustellen, einschließlich strukturierter Elektronischer Gesundheitsakten (EHRs), unstrukturierter klinischer Texte, klinischer Frage-Antwort-Aufgaben sowie Metadaten zu medizinischen Bildgebungsverfahren. Anstatt eine bestimmte klinische Kohorte zu evaluieren, konzentriert sich das Protokoll auf die Demonstration eines reproduzierbaren Implementierungsworkflows, der an verschiedene Datensätze im Gesundheitswesen angepasst werden kann. Die Vielfalt dieser Benchmark-Datensätze ermöglicht die Validierung der Interoperabilitätspipeline, der Retrieval-Augmented Generation (RAG) sowie des Multi-Agenten-Reasoning-Frameworks über mehrere klinische Datenmodi hinweg.
Konfiguration der experimentellen Umgebung
Die experimentelle Umgebung wurde eingerichtet, um die interoperable Plattform unter kontrollierten und reproduzierbaren Bedingungen zu evaluieren. Die Architektur umfasst Module für die Datenaufnahme, Interoperabilitätsebenen, große Sprachmodelle (LLMs) und Evaluierungskomponenten, die zu einer einzigen Verarbeitungspipeline für die Analyse medizinischer Daten zusammengefasst sind. Abbildung 1 veranschaulicht den gesamten Workflow, von der Aufnahme klinischer Daten bis hin zur Generierung diagnostischer Ergebnisse.
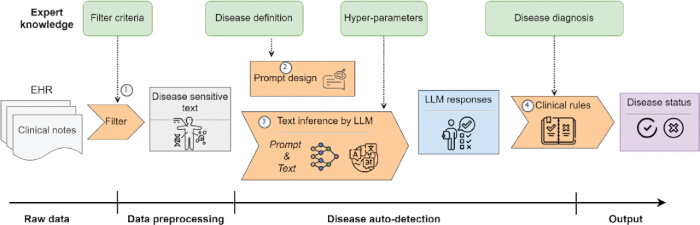
Abbildung 1: Übergreifender Systemarbeitsablauf, der die Verarbeitungspipeline von rohen klinischen Daten bis zur Ausgabe des Krankheitsstatus veranschaulicht. Der Prozess beginnt mit der Erfassung elektronischer Gesundheitsakten (EHR), gefolgt von einer Datenfilterung und -vorverarbeitung, um krankheitssensitive Informationen zu extrahieren. In einer Phase der strukturierten Prompt-Entwicklung werden Expertenwissen, Krankheitsdefinitionen und Hyperparameter integriert, um eine effektive Interaktion mit dem großen Sprachmodell (LLM) zu ermöglichen. Das LLM führt eine Textinferenz durch, um kontextbezogene Antworten zu generieren, die anschließend mithilfe klinischer Regeln bewertet werden, um den endgültigen Krankheitsstatus zu bestimmen. Der Arbeitsablauf verdeutlicht die Integration von Datenvorverarbeitung, wissensbasiertem Prompting und KI-gestützter Inferenz zur Unterstützung klinischer Entscheidungsfindung. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Architektur der Gesundheitsversorgungs-Interoperabilität
Die Backend-Infrastruktur verwendet eine modulare Architektur auf Basis von RESTful-APIs, um die Kommunikation zwischen den Plattformkomponenten zu unterstützen (Abbildung 2). Diese Architektur ermöglicht die Verarbeitung heterogener klinischer Informationen, einschließlich strukturierter Elektronischer Gesundheitsakten (EHRs), Arztnotizen und Metadaten aus medizinischen Bildgebungssystemen. Da diese Daten aus mehreren Quellen und Formaten stammen, wird Interoperabilität durch standardisierte Datenmodelle erreicht, insbesondere durch den Fast-Healthcare-Interoperability-Resources-(FHIR-)Standard15,16,17. Die Verwendung von FHIR unterstützt den Austausch strukturierter Informationen und bewahrt gleichzeitig Skalierbarkeit und Flexibilität in verteilten Gesundheitsumgebungen. HL7-basierte Kommunikationsmechanismen wurden ebenfalls integriert, um die Anbindung an bestehende klinische Systeme zu erleichtern, die nach wie vor in vielen Gesundheitseinrichtungen weit verbreitet sind16,17.
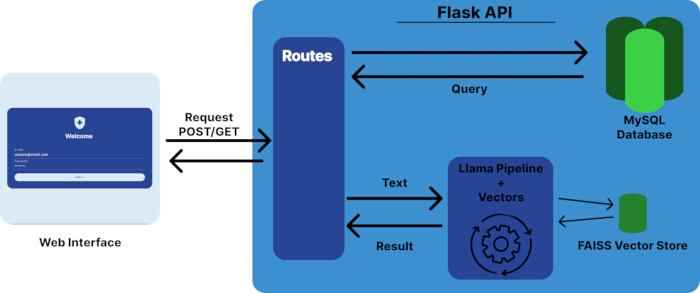
Abbildung 2: Systemarchitektur der vorgeschlagenen interoperablen Plattform. Die Web-Oberfläche kommuniziert über eine Flask-API mittels HTTP-POST/GET-Anfragen mit dem Backend. Die API übernimmt das Routing, die Abfrageverarbeitung sowie die Interaktion mit strukturierten und unstrukturierten Datenquellen. Eine MySQL-Datenbank speichert die strukturierten klinischen Daten, während ein auf FAISS basierender Vektor-Speicher die Ähnlichkeitssuche für Abrufoperationen unterstützt. Die auf LLaMA basierende Pipeline verarbeitet textuelle Eingaben und erzeugt Antworten mithilfe von Vektorrepräsentationen, wodurch Generierung mit Abrufunterstützung (Retrieval-Augmented Generation, RAG) ermöglicht wird. Die Architektur verdeutlicht die Integration von Webdiensten, Datenbankverwaltung, Vektorabruf und Inferenz großer Sprachmodelle in einem einheitlichen System. Bitte klicken Sie hier, um eine vergrößerte Darstellung dieser Abbildung anzusehen.
Konfiguration eines Multi-Agenten-Workflows
Die Multi-Agenten-Architektur ist in spezialisierte funktionale Agenten unterteilt, die für unterschiedliche Phasen des Arbeitsablaufs verantwortlich sind. Ein Vorverarbeitungs-Agent führt die Daten-Normalisierung und FHIR-Zuordnung durch, gefolgt von einem Abruf-Agenten, der für die semantische Suche innerhalb der Vektordatenbank zuständig ist. Ein Schlussfolgerungs-Agent integriert den abgerufenen Kontext mit dem LLM, um Antworten zu generieren, während ein Validierungs-Agent die Konsistenz und Formatierung der Ausgabe überprüft, bevor die endgültige Antwort zurückgegeben wird. Die Koordination der Agenten folgt einer sequenziellen Orchestrierungsstrategie, bei der die Ausgabe jedes Agenten als Eingabe für die nachfolgende Phase dient, um eine reproduzierbare und modulare Implementierung sicherzustellen.
Klinische Datenintegration
Die Datenebene zur Integration aggregiert Informationen aus mehreren klinischen Quellen und bereitet sie für die nachgeschaltete Verarbeitung auf. Die Vorverarbeitung umfasst die Normalisierung der Daten, die Tokenisierung und die Entitätsabstimmung, um die semantische Konsistenz über heterogene Datensätze hinweg zu verbessern. Da klinische Informationen in Struktur und Qualität variieren, tragen diese Schritte dazu bei, Störungen zu reduzieren und die Interaktion mit KI-Modellen zu erleichtern. Zudem wurden strukturierte Zuordnungsstrategien angewandt, um unterschiedliche Datenformate zu harmonisieren und die Kompatibilität mit der Verarbeitungspipeline sicherzustellen, wie in Abbildung 315,16,17 veranschaulicht.
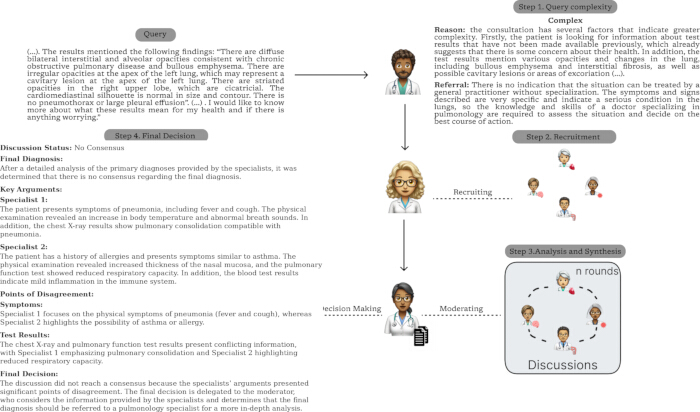
Abbildung 3: Detailliertes Beispiel des klinischen Multi-Agenten-Schlussfolgerungsprozesses. Die Abbildung veranschaulicht, wie eine klinische Anfrage in mehreren Stufen analysiert wird, einschließlich der Bewertung der Komplexität, der Rekrutierung von Spezialisten, der kollaborativen Diskussion und der endgültigen Entscheidungsfindung. Dieser Prozess zeigt die Fähigkeit des Systems, Schlussfolgerungsstrategien dynamisch an die Komplexität der Anfrage anzupassen, wodurch sowohl die Effizienz als auch die diagnostische Genauigkeit in Szenarien der klinischen Entscheidungsunterstützung verbessert werden. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Konfigurieren der Retrieval-Augmented-Generation-Pipeline
Die Abrufverstärkte Generierung (Retrieval-Augmented Generation, RAG) wird integriert, um eine kontextbewusste Analyse zu ermöglichen, indem die Informationsabrufung mit den generativen Fähigkeiten großer Sprachmodelle kombiniert wird. Benutzeranfragen werden mithilfe von Embedding-Modellen in Vektorrepräsentationen umgewandelt und mittels semantischem Ähnlichkeitssuchverfahren mit der Vektordatenbank abgeglichen, um die relevantesten kontextuellen Textpassagen abzurufen. Die abgerufenen Dokumente werden anschließend vor der Inferenz durch das große Sprachmodell (LLM) mit der ursprünglichen Anfrage kombiniert. Diese Strategie trägt dazu bei, während der Antwortgenerierung kontextuelle Informationen bereitzustellen, und wurde mit verbesserter Faktentreue sowie einer Verringerung von Halluzinationen in wissensintensiven Anwendungen, einschließlich des Gesundheitswesens18,19., in Verbindung gebracht. Abbildung 1 und Abbildung 3 veranschaulichen den gesamten Abrufarbeitsablauf und den entsprechenden Schlussfolgerungsprozess.
Für jede Benutzeranfrage wird der endgültige Prompt dynamisch erstellt, indem die ursprüngliche Anfrage mit den relevantesten kontextuellen Passagen kombiniert wird, die aus der Vektordatenbank abgerufen wurden. Die abgerufenen Informationen werden als kontextuelle Belege vor der Inferenz eingefügt, wodurch das Sprachmodell Antworten erzeugen kann, die auf dem abgerufenen medizinischen Wissen basieren, wobei die semantische Konsistenz erhalten bleibt und unbegründete Aussagen reduziert werden.
Generierung von Prompts und mehrstufige Schlussfolgerungen
Das Protokoll beinhaltet strukturierte Aufforderungsstrategien, um die kontextuelle Interpretation während der Antwortgenerierung zu verbessern. Diese Aufforderungstechniken, zusammen mit fortschrittlichen Schlussfolgerungsmechanismen, unterstützen den Schlussfolgerungsprozess in komplexen klinischen Szenarien und entsprechen jüngsten Entwicklungen, die in der Literatur berichtet wurden20.
Die Architektur umfasst ein Multi-Agenten-Framework, das aus spezialisierten Modulen besteht, welche im Verarbeitungspipeline unterschiedliche Funktionen ausführen, darunter Datenvalidierung, Kontextfilterung, Unterstützung klinischer Schlussfolgerungen und Überprüfung der Ausgabe. Die modulare Organisation ermöglicht die sequenzielle oder parallele Ausführung von Aufgaben und bietet somit Flexibilität für verschiedene Verarbeitungsanforderungen (Abbildung 4). Die Verteilung dieser Aktivitäten auf mehrere Agenten verringert die Abhängigkeit von einem einzelnen Sprachmodell und unterstützt einen robusteren Verarbeitungsablauf. Diese architektonische Strategie entspricht aktuellen Entwicklungen im Bereich der verteilten künstlichen Intelligenz und des Designs intelligenter Systeme21,22.
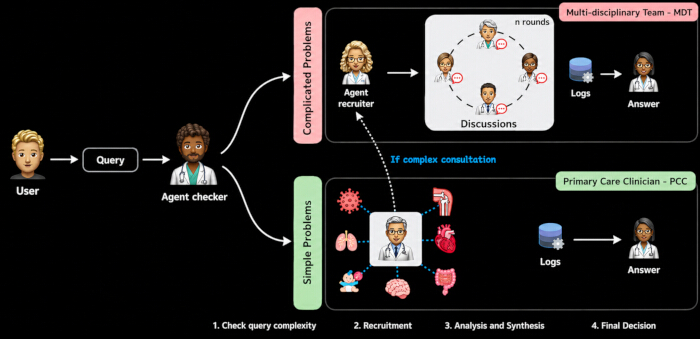
Abbildung 4: Entscheidungsrahmen mit mehreren Agenten für klinisches Denken. Der Prozess beginnt mit einer Nutzeranfrage, die von einem Agentenprüfer bewertet wird, der für die Einschätzung der Komplexität der Anfrage zuständig ist. Bei komplexen Fällen rekrutiert das System dynamisch ein fachübergreifendes Team (MDT) spezialisierter Agenten, das mehrere Diskussionsrunden durchführt, um das Problem zu analysieren und Wissen zu integrieren, bevor eine endgültige Entscheidung getroffen wird. Einfachere Fälle werden von einem Hausarztagenten (PCC) bearbeitet, wodurch schnellere Antwortgenerierung ermöglicht wird. Diese adaptive Architektur sorgt für ein Gleichgewicht zwischen Effizienz und analytischer Tiefe und verbessert so die Entscheidungsqualität sowie die Skalierbarkeit des Systems in medizinischen Anwendungen. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Leistungsbeurteilung
Die Systemleistung wurde mithilfe komplementärer Metriken bewertet, die sowohl die sprachliche Qualität als auch die semantische Konsistenz der erzeugten Ausgaben erfassen. BLEU wurde angewandt, um die syntaktische Ähnlichkeit basierend auf dem Überlappungsgrad von n-Grammen zu messen23, während ROUGE Rückrufrate und Inhaltsabdeckung bewertete, insbesondere bei Aufgaben wie Textzusammenfassung und Informationsgewinnung24. Die semantische Ähnlichkeit wurde mit BERTScore analysiert, der kontextuelle Embeddings aus transformerbasierten Modellen nutzt, um erzeugte und Referenztexte zu vergleichen25. Zusätzliche Analysen umfassten die Perplexität und die Kosinus-Ähnlichkeit, um jeweils das Modellvertrauen und die semantische Kohärenz zu untersuchen26,27.
Die ausgewählten Evaluierungsmetriken bieten komplementäre Perspektiven auf die Systemleistung, indem sie lexikalische und semantische Analysen kombinieren. Diese Kombination ist besonders relevant für Anwendungen im Gesundheitswesen, bei denen die kontextuelle Interpretation ebenso wichtig ist wie die lexikalische Ähnlichkeit. Die Plattform wurde in einer kontrollierten rechnergestützten Umgebung evaluiert, die sowohl cloudbasierte als auch lokale Bereitstellung unterstützt. Die lokale Ausführung von LLMs wurde als Option einbezogen, um die Anforderungen an den Datenschutz zu erfüllen und die Abhängigkeit von externen Diensten bei der Verarbeitung sensibler klinischer Informationen zu verringern. Diese Bereitstellungsstrategie ist mit Datenschutzrahmenwerken kompatibel und kann an verschiedene betriebliche Umgebungen angepasst werden4.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Die Systemleistung wurde mithilfe ergänzender quantitativer Metriken sowie einer qualitativen Analyse bewertet, um sowohl die sprachliche Genauigkeit als auch die semantische Konsistenz der erzeugten Ausgaben zu überprüfen. Diese Evaluationsstrategie kombiniert lexikalische und semantische Maße, um ein umfassenderes Bild des Modellverhaltens bei sprachgenerierenden Aufgaben im Gesundheitswesen zu erhalten.
Tabelle 1 zeigt die quantitativen Ergebnisse, die mit BLEU, ROUGE und B...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Die in dieser Studie vorgestellte Bewertung stellt eine methodische Validierung dar, die anhand öffentlich zugänglicher und vollständig anonymisierter Benchmark-Gesundheitsdatensätze durchgeführt wurde. Es erfolgte keine prospektive klinische Validierung mit Gesundheitsfachkräften oder Patientenrekrutierung, da das Ziel dieser Arbeit darin besteht, ein reproduzierbares Implementierungsprotokoll und nicht die klinische Wirksamkeit zu demonstrieren.
Die Ergebnisse dieser Studie deuten darauf hin...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren erklären, dass keine konkurrierenden finanziellen Interessen oder persönliche Beziehungen bestehen, die die in diesem Manuskript beschriebene Arbeit beeinflusst haben könnten. Generative KI-Tools (künstliche Intelligenz) wurden ausschließlich zur Unterstützung bei der Sprachbearbeitung, Grammatikkorrektur und Verbesserung der Lesbarkeit des Manuskripts eingesetzt. Alle wissenschaftlichen Inhalte, die Studiendurchführung, die Methodik, die Datenanalyse, die Ergebnisinterpretation sowie redaktionelle Entscheidungen wurden von den Autoren entwickelt, überprüft und genehmigt, die die vollständige Verantwortung für den Inhalt dieses Manuskripts übernehmen.
Danksagungen
Die Autoren möchten dem Labor für eingebettete und verteilte Systeme (LESC) der Bundesuniversität von Ceará (UFC) für die Bereitstellung der Forschungsumgebung und technischer Diskussionen danken, die die Entwicklung dieser Arbeit unterstützt haben. Die Autoren danken außerdem den Entwicklern und Betreuern der Open-Source-Software, Interoperabilitätsstandards und öffentlich zugänglichen Datensätze, die in dieser Studie verwendet wurden.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Vektorbasierte Datenbank zur Ähnlichkeitssuche in der Retrieval-Augmented-Generation-(RAG-)Pipeline. |
| FHIR-Standard | HL7 International | Release 4 (R4) | Gesundheitsinteroperabilitätsstandard für den strukturierten Austausch klinischer Daten. |
| Flask | Pallets Projects | Version 3.0.3 | Python-Webframework zur Implementierung der RESTful-Backend-API. |
| HL7-Standard | HL7 International | Version 2.x | Veralteter Nachrichtenprotokollstandard für die Interoperabilität mit Krankenhausinformationssystemen. |
| HTTP-REST-API | Individuelle Implementierung | Nicht zutreffend | RESTful-Kommunikationsschicht zwischen Frontend, Backend, Datenbank und KI-Diensten. |
| LangChain | LangChain Inc. | Version 0.3.x | Framework zur Integration von LLMs, Prompt-Engineering und Retrieval-Augmented-Generation-Workflows. |
| LangGraph | LangChain Inc. | Version 0.2.x | Framework zur Orchestrierung des mehrstufigen klinischen Schlussfolgerungs-Workflows. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Großes Sprachmodell für klinische Schlussfolgerungen und natürlichsprachliche Generierung. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Relationale Datenbank zur Speicherung strukturierter klinischer Daten. |
| Ollama | Ollama Inc. | Version 0.9.x | Lokale Inferenz-Engine zur Ausführung großer Sprachmodelle unter Wahrung der Patientenprivatsphäre. |
| Python | Python Software Foundation | Version 3.11 | Programmiersprache zur Implementierung der gesamten Plattform. |
| PyTorch | Linux Foundation | Version 2.4 | Tiefenlern-Framework für die Inferenz großer Sprachmodelle. |
| Retrieval-Augmented-Generation-(RAG-)Pipeline | Individuelle Implementierung | Nicht zutreffend | KI-Framework, das semantisches Retrieval mit LLM-Inferenz zur kontextbezogenen Antwortgenerierung kombiniert. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Embedding-Modell zur Erzeugung dichter Vektorrepräsentationen für die semantische Dokumentensuche. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Betriebssystem für Entwicklung und experimentelle Evaluation. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Integrierte Entwicklungsumgebung für Softwareimplementierung und Debugging. |
Referenzen
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.