Diese Studie untersucht Elektroenzephalographie-Biomarker zur Unterscheidung von Alzheimer-Krankheit, frontotemporaler Demenz und gesunden Kontrollpersonen. Random-Forest-Modelle, die auf Wurzel-des-mittleren-Quadrats, spektraler Leistungsdichte und Entropie-Merkmalen basieren, wurden mithilfe erklärbarer künstlicher Intelligenz und Effektgrößen-Analyse interpretiert. Das Entfernen von Entropie-Merkmalen mit geringer Aussagekraft verbesserte die Klassifizierungsleistung und erreichte eine Testgenauigkeit von 94 %.
Forschungsartikel
Multidimensionale Elektroenzephalografie-Biomarker-Fusion für die maschinell lernende Demenzklassifikation
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Elektroenzephalographie (EEG) wurde als nichtinvasive Methode zur Charakterisierung der Gehirnaktivität bei neurodegenerativen Erkrankungen untersucht. In dieser Studie wurde evaluiert, ob multimodale EEG-Biomarker Alzheimer-Krankheit (AD), frontotemporale Demenz (FTD) und gesunde Kontrollpersonen (HC) voneinander unterscheiden können. Der öffentlich zugängliche Datensatz enthielt EEG-Aufzeichnungen im Ruhezustand mit geschlossenen Augen von 88 Probanden, darunter 36 mit AD, 23 mit FTD und 29 gesunden Kontrollen. Multimodale EEG-Biomarker und demografische Merkmale wurden zur maschinellen Klassifizierung extrahiert. Zu den aus dem EEG abgeleiteten Merkmalen gehörten der Effektivwert (RMS), die Leistungsspektraldichte (PSD) und Entropiemaße. Ein Random-Forest-Klassifikator wurde unter Verwendung des kombinierten Merkmalsatzes trainiert und mithilfe erklärbarer künstlicher Intelligenz interpretiert. Zur Bewertung der Merkmalsbeiträge wurden Analysen zur Merkmalsstabilität und zum Effektgrößenmaß nach Cohen’s d durchgeführt, gefolgt von einer Ablationsanalyse. Entropiebasierte Merkmale zeigten den geringsten Beitrag zur Klassifizierung. Das vollständige multimodale Modell erreichte eine Trainingsgenauigkeit von 96 % und eine Testgenauigkeit von 92 %. Nach Entfernung der Entropiemerkmale stieg die Testgenauigkeit auf 94 %. Diese Ergebnisse beschreiben die Klassifizierungsleistung der ausgewählten multimodalen EEG- und demografischen Merkmale im Rahmen des Random-Forest-Modells.
Einleitung
Die Alzheimer-Krankheit (AD) ist eine progrediente neurologische Erkrankung, die mit einem Rückgang kognitiver und motorischer Funktionen einhergeht. Ihre Prävalenz steigt deutlich mit dem Alter an, und Demenz ist eine wesentliche Ursache für Morbidität und Mortalität bei älteren Erwachsenen1,2,3,4,5. Da Diagnose und Klassifizierung der Erkrankung weiterhin herausfordernd sind, wurde die Analyse von Hirnsignalen als Methode untersucht, um neurophysiologische Veränderungen im Zusammenhang mit Demenz zu charakterisieren.
Die Elektroenzephalographie (EEG) ist eine nichtinvasive Methode zur Aufzeichnung der elektrischen Aktivität des Gehirns und wurde bereits bei Alzheimer-Krankheit und anderen neurologischen Erkrankungen untersucht6,7,8,9,10,11. EEG-Signale spiegeln elektrische Potentiale wider, die durch neuronale Aktivität erzeugt werden, und werden nichtinvasiv an mehreren Stellen der Kopfhaut aufgezeichnet12,13,14. Die Gehirnaktivität wird üblicherweise anhand der Frequenzbänder Delta, Theta, Alpha, Beta und Gamma charakterisiert15. Mit der Alzheimer-Krankheit wurden eine Verlangsamung des EEG, eine verminderte Signalkomplexität sowie veränderte Synchronisation in Verbindung gebracht16. Spektralanalysen berichteten über eine erhöhte Delta- und Theta-Aktivität sowie eine verminderte Alpha- und Beta-Aktivität bei Personen mit AD im Vergleich zu gesunden Kontrollpersonen17,18,19. Frühere EEG-Klassifizierungsstudien berichteten über hohe Leistungsfähigkeit bei der Unterscheidung von AD und gesunden Kontrollen (HC) sowie von frontotemporaler Demenz (FTD) und HC. Im Gegensatz dazu erwies sich die Differenzierung zwischen AD und FTD im Allgemeinen als schwieriger10,11.
Methoden des maschinellen Lernens wurden verwendet, um Muster in EEG-Signalen zu identifizieren, die mit neurologischen Erkrankungen assoziiert sind20,21. Die Merkmalsextraktion ist daher eine wichtige Komponente der auf EEG basierenden Klassifizierung. Frühere Studien haben spektrale, zeitliche, Komplexitäts- und funktionelle Konnektivitätsmerkmale in Kombination mit Modellen des maschinellen Lernens untersucht3,15,22,23. Spektrale Merkmale sind besonders relevant, da sie frequenzabhängige Veränderungen der Hirnaktivität quantifizieren, einschließlich der bei AD berichteten verminderten Alpha-Aktivität und erhöhten Theta-Aktivität23,24,25,26.
Mehrere auf EEG basierende Studien haben verschiedene Kombinationen von Merkmalen, Klassifizierern und Validierungsstrategien untersucht. Die analysebasierte Untersuchung der funktionellen Konnektivität wurde verwendet, um AD, FTD und gesunde Kontrollen (HC) voneinander zu unterscheiden, wobei die berichtete Klassifizierungsleistung je nach Vergleich und Verfahren zur Merkmalsauswahl variierte27. Fourier-basierte Merkmale wurden ebenfalls zur Unterscheidung von AD, leichter kognitiver Beeinträchtigung (MCI) und gesunden Kontrollpersonen evaluiert, wobei jedoch Einschränkungen wie unzureichende Vorverarbeitung und mögliche Überanpassung aufgrund der Validierungsstrategie bestanden28. Nichtlineare EEG-Komplexitätsmaße haben ein diskriminierendes Potenzial für die Klassifizierung von AD gezeigt, wobei einige hohe Genauigkeit, Sensitivität und Spezifität erreichten, ihre Anwendbarkeit auf die Unterscheidung von MCI und Krankheitsstadien jedoch weiterhin begrenzt bleibt21.
Tiefenlernverfahren, die auf zeitfrequenten EEG-Darstellungen basieren, wurden ebenfalls für die multiklassige Klassifizierung von AD, MCI und HC29 untersucht. Obwohl eine hohe Klassifizierungsleistung berichtet wurde, umfassen die Einschränkungen kleine oder selektierte Kohorten, Klassenungleichgewicht, heterogene Krankheitsschweregrade, fehlende externe Validierung und eingeschränkte Modellinterpretierbarkeit29. Die Validierungsstrategie ist ebenfalls eine wichtige methodische Überlegung. Unabhängige Ansätze auf Teilnehmerbasis haben gezeigt, dass die herkömmliche, auf Epochen basierende Kreuzvalidierung die Leistung überschätzen kann, wenn Epochen desselben Teilnehmers sowohl in Trainings- als auch in Testmengen enthalten sind30. Dieser Nachteil ist besonders relevant, wenn Klassifizierungsergebnisse zwischen Studien verglichen werden, die unterschiedliche Validierungsschemata verwenden.
Komplexitäts- und Konnektivitätsmaße wurden ebenfalls mithilfe von Support-Vektor-Maschinen-Klassifizierern evaluiert, wobei die phasenbasierte Konnektivität und die multiscale Entropie unterschiedliche Diskriminierungsleistungen zeigten31,32. Andere Arbeiten, die auf Fourier- und Wavelet-basierten Merkmalen beruhen, berichteten über variable Leistungen bei Vergleichen zwischen AD, MCI und HC, wobei die Multiklassenklassifizierung im Allgemeinen schwieriger bleibt als die binäre Klassifizierung14. Ansätze, die auf Entropie und Synchronität basieren, konnten zusätzlich eine Unterscheidung zwischen AD- und Kontrollgruppen zeigen, obwohl die Merkmale der Kontrollpopulation die beobachtete Effektgröße beeinflussen können2.
Die vorliegende Studie evaluiert einen multimodalen Merkmalssatz, der aus dem Effektivwert (RMS), der Leistungsspektraldichte (PSD) und Entropiemaßen, die aus EEG-Frequenzbändern extrahiert wurden, sowie dem Alter als demografische Variable besteht. RMS repräsentiert die Signalamplitude innerhalb jedes Frequenzbands, während PSD die Leistung im Frequenzbereich angibt. Die Entropie wird als Maß für die Signalkomplexität einbezogen. Diese Merkmale liefern komplementäre Beschreibungen der EEG-Aktivität und werden mithilfe eines Random-Forest-Klassifikators bewertet. Die Studie untersucht außerdem die Bedeutung der Merkmale, deren Stabilität, erklärbares künstliches Intelligenzverfahren und Effektgrößenanalysen, um den relativen Beitrag der extrahierten Merkmale zu beurteilen. Die vorliegende Arbeit untersucht die Wirksamkeit multimodaler EEG-Merkmale, einschließlich spektraler, zeitlicher und komplexitätsbasierter Maße, um mittels maschinellen Lernens Alzheimer-Krankheit (AD), frontotemporale Demenz (FTD) und gesunde Kontrollpersonen (HC) voneinander zu unterscheiden. Zudem wird geprüft, welche Merkmale aus EEG-Frequenzbändern am stärksten zur Klassifizierung beitragen, wenn Leistungsspektraldichte (PSD), Effektivwert (RMS) und Entropiemaße verwendet werden. Außerdem werden die Beiträge leistungsbasierter Merkmale, einschließlich PSD und RMS, mit denen entropiebasierter Merkmale verglichen und der Einfluss des Alters auf das Klassifizierungsmodell bewertet.
Protokoll
Eine schematische Übersicht des EEG-Präprozessings, der Merkmalsextraktion und des Klassifizierungsworkflows ist in Abbildung 1 dargestellt. Die in der Studie verwendeten Materialien und Software sind in der Tabelle der Materialien aufgelistet.
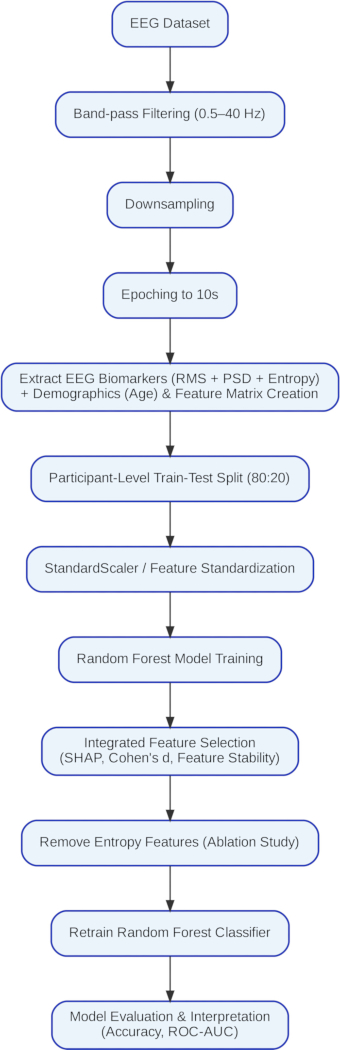
Abbildung 1: Ablaufschema der EEG-Vorverarbeitung, Merkmalsextraktion und Klassifizierung. Schematische Übersicht über den Studienablauf, einschließlich Überprüfung der EEG-Daten, Bandpassfilterung und Neubezug, Extraktion der Merkmale quadratischer Mittelwert (RMS), spektrale Leistungsdichte (PSD) und Entropie, Hinzufügen des Alters, Aufteilung in Trainings- und Testdatensatz, Entwicklung eines Random-Forest-Modells, Analyse der Merkmalstabilität, SHAP-Analyse, Effektgrößenanalyse nach Cohens d, integrierte Merkmalsauswahl, Abtragungsentropie-Analyse, erneutes Training des Modells und Leistungsbewertung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
1. Datenerfassung
Der öffentlich zugängliche Ruhezustand-EEG-Datensatz wurde aus dem OpenNeuro-Repository bezogen (Datensatz ds004504, Version 1.0.9)33. Teilnehmerbezeichnungen und demografische Informationen wurden überprüft. Der Datensatz umfasste 88 Teilnehmer, darunter 36 Teilnehmer mit Alzheimer-Krankheit (AD), 23 mit frontotemporaler Demenz (FTD) und 29 gesunde Kontrollpersonen (HC).
2. Import der EEG-Aufzeichnung
Für jeden Teilnehmer wurde die EEG-Aufzeichnung mithilfe der MNE-Python-Bibliothek geladen. Jede EEG-Datei wurde überprüft, um sicherzustellen, dass sie zugänglich war, erfolgreich importiert werden konnte und eine gültige Identifikationsnummer des Teilnehmers enthielt. Aufzeichnungen mit fehlenden oder beschädigten Dateien wurden ausgeschlossen. Die ursprüngliche EEG-Abtastrate von 500 Hz wurde in diesem Schritt beibehalten. Die Signale wurden heruntergetastet, um den Rechenaufwand zu verringern, dabei aber alle klinisch relevanten EEG-Informationen für diese Studie erhalten.
3. Bandpass-Filterung
Die kontinuierlichen EEG-Aufzeichnungen wurden mit einem Bandpass-Filter vierter Ordnung gefiltert, das eine untere Grenzfrequenz von 0,5 Hz und eine obere Grenzfrequenz von 40 Hz aufweist.
4. Gemeinsame Durchschnittsreferenzierung und Epochierung
Auf die gefilterten EEG-Aufzeichnungen wurde die gemeinsame Durchschnittsreferenzierung (CAR) angewendet. Für jede Zeitstichprobe wurde das durchschnittliche Signal über alle verfügbaren EEG-Kanäle berechnet und von jedem Kanal subtrahiert. Die referenzierten EEG-Signale wurden für die anschließende Analyse beibehalten. Jede referenzierte EEG-Aufzeichnung wurde mithilfe der Funktion make_fixed_length_epochs() in MNE-Python in Epochen fester Länge unterteilt. Dabei wurde eine Epochenlänge von 10 s mit 0 s Überlappung verwendet.
5. Epoche-Validierung
Für jeden Teilnehmer wurden nur vollständige 10-s-Epochen beibehalten. Alle verbleibenden EEG-Segmente, die am Ende einer Aufnahme kürzer als 10 s waren, wurden verworfen. Jede beibehaltene Epoche wurde anschließend als individuelle Probe für die Merkmalsextraktion verwendet.
6. Merkmalsvorbereitung
Obwohl Mini-Mental-State-Examination-(MMSE)-Daten im Quelldatensatz verfügbar waren, wurden sie von der vorliegenden Analyse ausgeschlossen. Die extrahierten EEG-Merkmale wurden mit dem demografischen Teilnehmerinformationen wie Alter und diagnostischen Kennzeichnungen zusammengeführt, die aus der Metadatendatei participants.csv stammten. Als gemeinsamer Schlüssel diente die Teilnehmerkennung, und es wurden nur Teilnehmer beibehalten, für die sowohl EEG-Merkmalsdatensätze als auch entsprechende demografische Informationen vorlagen.
Die mehrdimensionale Merkmalsmatrix enthielt fünf Root-Mean-Square-Merkmale (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms und gamma_rms), fünf Leistungsdichtespektrum-Merkmale (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd und gamma_psd) sowie fünf Entropie-Merkmale (delta_entropy, theta_entropy, alpha_entropy, beta_entropy und gamma_entropy). Das Alter wurde als ergänzende demografische Variable hinzugefügt. Da sich die Altersverteilungen zwischen den diagnostischen Gruppen unterscheiden können, ließ sich eine demografische Verwechslung nicht vollständig ausschließen. Die diagnostische Gruppe, definiert als AD, HC oder FTD, wurde als Zielkennzeichnung festgelegt.
7. Daten-Vorverarbeitung und Aufteilung in Trainings- und Testdatensatz
Während der Vorverarbeitung wurden die Aufzeichnungen von 500 Hz auf 250 Hz heruntergetastet, um den Rechenaufwand zu verringern, während gleichzeitig die interessierenden EEG-Frequenzinformationen erhalten blieben.
Der Datensatz wurde auf Ebene der Versuchspersonen mithilfe einer gruppierten Aufteilungsstrategie in Trainings- (80 %) und Testteilmenge (20 %) unterteilt. Probandenbezogene Vorhersagen wurden anschließend durch Mehrheitsabstimmung über die den einzelnen Teilnehmern zugehörigen vorhergesagten Epochen gewonnen. Die primäre Bewertung erfolgte mittels einer gruppierten Aufteilung in Trainings- und Testmenge auf Ebene der Versuchspersonen, um sicherzustellen, dass Epochen ein und desselben Teilnehmers nicht in beiden Teilmengen enthalten waren. Probandenbezogene Vorhersagen wurden durch Mehrheitsabstimmung über die den einzelnen Teilnehmern zugehörigen vorhergesagten Epochen ermittelt. Der Datensatz wurde auf fehlende Werte überprüft, und fehlende Beobachtungen wurden gegebenenfalls entfernt oder durch Imputation ersetzt. Diagnosekategorien wurden kodiert. Ein StandardScaler wurde an den Trainingsdaten angepasst und anschließend sowohl auf die Trainings- als auch auf die Testdatensätze angewandt.
8. Entwicklung des Random-Forest-Modells
Ein Random-Forest-Klassifikator wurde mit 80 Bäumen, einer maximalen Baumtiefe von 10, maximal vier Merkmalen, einem Minimum von fünf Stichproben pro Blatt und einem Zufallszustand von 42 initialisiert. Der Klassifikator wurde mit dem standardisierten Trainingsdatensatz trainiert.
9. Modellbewertung
Es wurden Klassenbezeichnungen sowohl für die Trainings- als auch für die Testdatensätze vorhergesagt. Eine Konfusionsmatrix wurde erstellt, und Genauigkeit (Accuracy), Präzision, Sensitivität (Recall) sowie der F1-Score wurden gemeinsam mit dem Klassifizierungsbericht berechnet. Die Genauigkeiten für das Training und das Testen wurden dokumentiert.
Stellen Sie für die teilnehmerweise Auswertung sicher, dass alle Epochen eines bestimmten Teilnehmers ausschließlich entweder dem Trainings- oder dem Testdatensatz zugeordnet wurden. Der Random-Forest-Klassifikator wurde mit denselben Hyperparametern wie in der primären Analyse trainiert.
10. Kreuzvalidierung
Als zusätzliche Modellbewertungsmethode wurde eine fünffache stratifizierte Kreuzvalidierung mit shuffle = True und random_state = 30 durchgeführt. Die mittlere Genauigkeit und die Standardabweichung über die fünf Folds wurden berechnet. Diese Analyse wurde separat von der primären Holdout-Evaluation auf Ebene der Versuchspersonen betrachtet.
11. Analyse der Merkmalsstabilität
Die Merkmalsstabilität wurde überprüft, indem das Random-Forest-Training 10-mal mit Zufallszahlen von 0 bis 9 als Startwerten wiederholt wurde. Für jeden Durchlauf wurden die Testgenauigkeit und die Werte für die Merkmalswichtigkeit aufgezeichnet. Der Mittelwert und die Standardabweichung des Wichtigkeitswerts jedes Prädiktors wurden über die 10 Durchläufe berechnet, und die Prädiktoren wurden entsprechend ihrer Stabilität gerankt. Diese Analyse diente dazu, die Konsistenz der Rangfolge der Merkmale zu bewerten, und nicht, um die primäre subjektorientierte Auswertung zu ersetzen.
12. Erklärbare KI-Analyse
Der SHAP TreeExplainer wurde auf das trainierte Random-Forest-Modell angewendet. SHAP-Werte wurden berechnet, um den Beitrag jeder Merkmalsgröße für die Modellvorhersagen abzuschätzen. Der mittlere absolute SHAP-Wert wurde für jedes Merkmal ermittelt, und die Merkmale wurden entsprechend ihrer SHAP-Beiträge ranggeordnet. Merkmale mit durchgängig niedrigen SHAP-Werten wurden identifiziert und mit den Ergebnissen der Merkmalsstabilitäts- und Cohen’s-d-Analysen verglichen. Merkmale mit durchgängig geringen Beiträgen wurden für die anschließende Ablation und erneute Modelltrainierung ausgewählt.
13. Statistische Effektgrößenanalyse
Cohens d wurde für jeden EEG-Biomarker für die Vergleiche AD gegenüber HC, AD gegenüber FTD sowie FTD gegenüber HC berechnet. Die Größe der Effektstärken wurde anhand von Schwellenwerten von 0,20 für einen kleinen Effekt, 0,50 für einen mittleren Effekt und 0,80 für einen großen Effekt interpretiert.
14. Integrierte Merkmalsauswahl
Die Ergebnisse der Random-Forest-Merkmalswichtigkeitsanalyse, der SHAP-Analyse und der Cohen’s-d-Analyse wurden verglichen. Vorhersagevariablen, die durchgängig eine geringe Merkmalswichtigkeit, einen geringen SHAP-Beitrag und kleine Effektstärken aufwiesen, wurden als Kandidaten für das Entfernen identifiziert.
15. Merkmalsablation
Entropiemerkmale wurden in einer explorativen Ablationsanalyse bewertet, und eine reduzierte Merkmalsmatrix, die RMS, PSD und Alter enthielt, wurde erstellt. Der Random-Forest-Klassifikator wurde mit denselben Hyperparametern erneut trainiert. Modelltraining, Test, Kreuzvalidierung und Receiver-Operating-Characteristic-(ROC)-Analyse wurden mit dem reduzierten Merkmalssatz wiederholt.
16. ROC-Analyse
Die Klassenwahrscheinlichkeiten wurden aus dem optimierten Random-Forest-Klassifikator erhalten. Multiklassen-ROC-Kurven wurden unter Verwendung eines One-gegenüber-Reststrategie. Klassenspezifische Werte für die Fläche unter der Kurve (AUC) sowie die durchschnittliche AUC wurden berechnet.
17. Leistungsvergleich
Die Leistung des vollständigen Merkmalmodells wurde mit der des reduzierten Merkmalmodells verglichen, das nach der Entropie-Merkmals-Ablation erhalten wurde.
Ergebnisse
Das Random-Forest-Modell erreichte eine Genauigkeit von 96 % bei der Trainingserfassung und von 92 % bei der Testphase. Die makrodurchschnittliche F1-Score betrug 92 %, ebenso wie die gewichtete durchschnittliche F1-Score, was auf eine vergleichbare Leistung über die drei Klassen hinweg hindeutet, während die gewichtete durchschnittliche F1-Score ebenfalls 92 % betrug. Die Klassifikationsleistung war für die Klasse Alzheimer-Krankheit (AD) am höchsten, während die Klasse frontotemporale Demenz (FTD) vergleichsweise geringere Leistung zeigte, wie in Tabelle 1 dargestellt.
Die Analyse der Receiver-Operating-Characteristic (ROC) wurde verwendet, um die Klassentrennung anhand unterschiedlicher Klassifizierungsschwellenwerte zu bewerten. Wie in Abbildung 2 gezeigt, lag die Fläche unter der ROC-Kurve (AUC) für alle drei Klassen über 0,98, was auf eine hohe Trennbarkeit zwischen den Gruppen Alzheimer-Demenz (AD), frontotemporale Demenz (FTD) und gesunde Kontrollpersonen (HC) hinweist.
Die SHAP-Analyse mithilfe von TreeExplainer wurde durchgeführt, um den Beitrag der Merkmale für das Random-Forest-Klassifizierungsmodell zu bewerten. Das zusammenfassende Balkendiagramm in Abbildung 3 zeigt den relativen Beitrag der spektralen Leistungsdichte (PSD), des Effektivwerts (RMS), der Entropie sowie demografischer Merkmale. Merkmale mit höheren absoluten SHAP-Werten trugen stärker zu den Modellvorhersagen bei, während entropiebezogene Merkmale vergleichsweise geringe Beiträge aufwiesen.
Die Analyse der Merkmalsstabilität wurde durchgeführt, indem das Random-Forest-Training über die angegebenen Zufallsseeds hinweg wiederholt wurde. Für jeden Durchlauf wurden die Testgenauigkeit und die Werte für die Wichtigkeit der Merkmale erfasst, und der Mittelwert sowie die Standardabweichung der Merkmalswichtigkeit wurden berechnet. Das Modell erreichte bei dieser Analyse eine durchschnittliche Klassifizierungsgenauigkeit von 95 % bei einer Standardabweichung von 0,17 %. Diese wiederholten Durchläufe dienten hauptsächlich zur Beurteilung der Konsistenz der Rangfolge der Merkmale und wurden separat von der primären holdout-Überprüfung auf Ebene der Versuchspersonen betrachtet. Das Merkmal „Alter“ war in der Analyse der Merkmalsstabilität hochrangig, wie in Tabelle 2 dargestellt. Auch die Merkmale theta_psd und theta_rms waren hochrangig, während alpha_psd, alpha_rms, beta_psd und beta_rms eine moderate Wichtigkeit der Merkmale aufwiesen.
Cohens d wurde berechnet, um die Stärke der Gruppenunterschiede zu bewerten, wie in Tabelle 3 dargestellt. Die stärksten Unterschiede zwischen Teilnehmern mit AD und gesunden Kontrollpersonen zeigten sich bei der Dämpfung des Alpha-Bandes (alpha_rms, d = 0,97; alpha_psd, d = 0,87) sowie bei erhöhter Theta-Aktivität (theta_rms, d = 0,72). Diese Befunde stimmen mit der kortikalen Verlangsamung überein, die in EEG-Studien zur Demenz berichtet wurde34. Entropiebasierte Merkmale wiesen vergleichsweise geringere Effektstärken auf. Die Vergleiche zwischen AD und FTD ergaben überwiegend kleine bis moderate Effektstärken.
Alpha-Band-Merkmale zeigten große Effektstärken bei den Vergleichen AD-gegenüber-HC und FTD-gegenüber-HC. Für AD gegenüber HC betrugen die berichteten Effektstärken −0.87 für alpha_psd und −0.97 für alpha_rms. Bei FTD gegenüber HC betrug die Alpha-Band-Abschwächung −0.73. Das Merkmal theta_psd zeigte eine Effektstärke von 0,61 für AD gegenüber HC, während theta_rms eine Effektstärke von 0,72 aufwies. Kleinere Unterschiede wurden bei AD gegenüber FTD beobachtet.
Merkmale im Beta-Band zeigten vorwiegend kleine bis moderate Gruppeneffektgrößen. Die Effektgrößen für beta_psd betrugen −0,35 für AD versus HC und −0,41 für AD versus FTD, während beta_rms überwiegend kleine Effekte aufwies. Merkmale im Gamma-Band zeigten bei einigen Vergleichen moderate Effekte. Die Effektgröße für gamma_psd betrug 0,47 für FTD versus HC und 0,20 für AD versus HC, während gamma_rms eine Effektgröße von 0,50 für FTD versus HC zeigte.
Delta-PSD und RMS zeigten kleine positive Effektgrößen für AD gegenüber HC (0,29 bzw. 0,34) und FTD gegenüber HC (0,25 bzw. 0,25). Die Effektgrößen für AD gegenüber FTD lagen nahe bei null. Delta-Entropie zeigte bei allen drei Vergleichen kleine Effektgrößen (0,08, 0,20 und −0,11).
Die Analysen zur Merkmalstabilität, SHAP und Effektgröße wiesen auf vergleichsweise geringe Beiträge der Entropie-Merkmale hin. Daher wurde eine Ablationsanalyse durchgeführt, bei der die Entropie-Merkmale ausgeschlossen und RMS, PSD sowie das Alter beibehalten wurden. Nach der Merkmalsablation erreichte das Random-Forest-Modell eine Trainingsgenauigkeit von 96 % und eine Testgenauigkeit von 94 %. Dieses Ergebnis wurde als explorativer Vergleich innerhalb des bewerteten Frameworks zur Merkmalsauswahl interpretiert. Präzision, Rückruf, F1-Score und Support für die Klassen AD, HC und FTD sind in Tabelle 4 dargestellt.
Die Leistung vor und nach der Ablation der Entropie-Merkmale wird in Tabelle 5 verglichen. Die Testgenauigkeit stieg von 92 % auf 94 %, nachdem die Entropie entfernt wurde. Klassenspezifische Änderungen sind in Tabelle 6 dargestellt. Bei FTD stieg die Präzision um 4 % und der F1-Score um 2 %. Die Sensitivität (Recall) der HC-Gruppe stieg um 4 %, während die Präzision um 2 % abnahm. Makro- und gewichtete Durchschnittsleistungen verbesserten sich nach der Merkmalsablation um etwa 1 %–2 %.
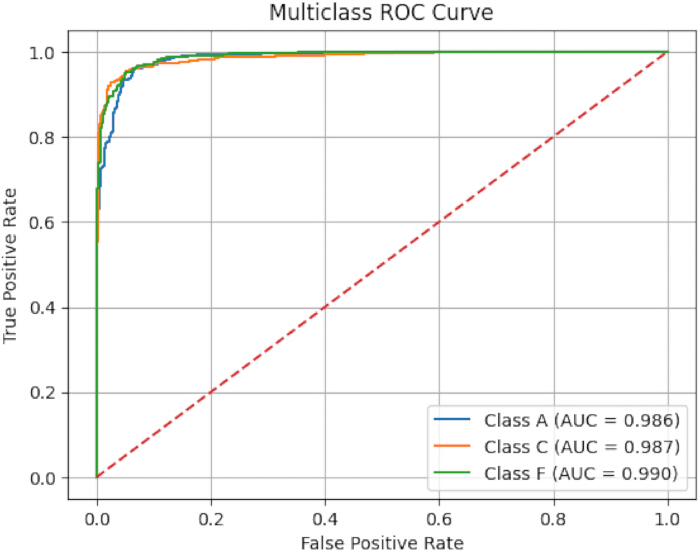
Abbildung 2: Receiver-Operating-Characteristic-Kurven für Alzheimer-Erkrankung, frontotemporale Demenz und gesunde Kontrollen. Multiklassen-Receiver-Operating-Characteristic (ROC)-Kurven, erzeugt mithilfe der One-gegenüber-Rest-Strategie für Alzheimer-Krankheit (Klasse A), frontotemporale Demenz (Klasse F) und gesunde Kontrollen (Klasse C). Die Fläche unter der Kurve (AUC) wurde für jede Klasse berechnet. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
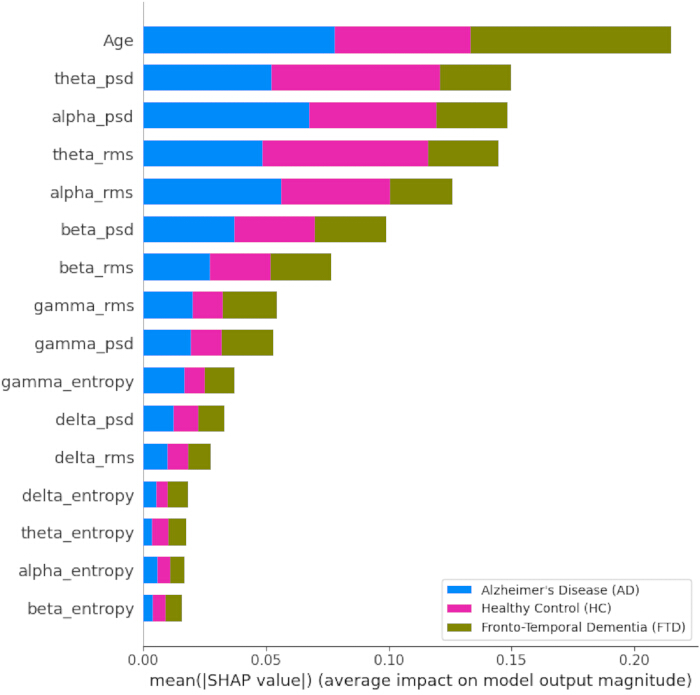
Abbildung 3: SHAP-Zusammenfassungsanalyse des trainierten Random-Forest-Modells. Zusammenfassendes Balkendiagramm, das den relativen Beitrag von EEG-abgeleiteten und demografischen Merkmalen für das Random-Forest-Klassifizierungsmodell zeigt. Die mittleren absoluten SHAP-Werte wurden verwendet, um die Beiträge der Merkmale Effektivwert (RMS), spektrale Leistungsdichte (PSD), Entropie und Alter zu bewerten. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Präzision | Recall | F1-Score | Support | |
| Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Kontrolle | 0.93 | 0.92 | 0.93 | 480 |
| Frontotemporale Demenz | 0.93 | 0.87 | 0.9 | 314 |
| Macro-Durchschnitt | 0.93 | 0.92 | 0.92 | 1373 |
| Gewichteter Durchschnitt | 0.93 | 0.92 | 0.92 | 1373 |
Tabelle 1: Klassifizierungsbericht für Testdaten. Präzision, Rückstellrate, F1-Score und Support für die Klassen Alzheimer-Erkrankung, gesunde Kontrolle und frontotemporale Demenz im Testdatensatz sowie makro- und gewichtet-gemittelte Leistungskennzahlen.
| Merkmal | Mittelwert | Standardabweichung |
| Alter | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tabelle 2: Rangfolge der Merkmalsstabilität des Random-Forest-Modells. Mittlere Werte der Merkmalswichtigkeit und die entsprechende Variabilität, ermittelt aus wiederholten Random-Forest-Trainings mit Zufallszahlen von 0 bis 9. Die Merkmale wurden nach ihrer Stabilität über die Durchläufe hinweg sortiert.
| Merkmal | AD gegenüber HC | AD gegenüber FTD | FTD gegenüber HC |
| Delta PSD | 0.293 | -0.069 | 0.253 |
| Theta PSD | 0.612 | 0.23 | 0.355 |
| Alpha PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| Delta Entropie | 0.081 | 0.199 | -0.111 |
| Theta Entropie | 0.208 | 0.033 | 0.163 |
| Alpha Entropie | -0.061 | 0.071 | -0.137 |
| Beta Entropie | -0.37 | -0.042 | -0.332 |
| Gamma Entropie | -0.338 | 0.047 | -0.391 |
| Delta RMS | 0.342 | 0.041 | 0.251 |
| Theta RMS | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
Tabelle 3: Cohen’s d Effektgrößenvergleich über die diagnostischen Gruppen hinweg. Cohen’s d-Werte für EEG-Biomarker über den Verlauf der Alzheimer-Krankheit gegenüber gesunde Kontrolle, Alzheimer-Krankheit gegenüber frontotemporale Demenz, und frontotemporale Demenz gegenüber Vergleiche mit gesunden Kontrollen
| Präzision | Recall | F1-Score | Support | |
| Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Kontrolle | 0.91 | 0.96 | 0.94 | 480 |
| Frontotemporale Demenz | 0.97 | 0.89 | 0.92 | 314 |
| Makro avg | 0.94 | 0.93 | 0.93 | 1373 |
| Weighted avg | 0.94 | 0.94 | 0.94 | 1373 |
Tabelle 4: Klassifizierungsbericht nach Merkmalsablation. Präzision, Sensitivität, F1-Score und Support für die Klassen Alzheimer-Erkrankung, gesunde Kontrolle und frontotemporale Demenz nach Entfernung der Entropie-Merkmale und erneutem Training des Random-Forest-Modells.
| Metrik | Vor der Ablation | Nach der Ablation | Änderung |
| Trainingsgenauigkeit | 0.96 | 0.96 | 0% Änderung |
| Testgenauigkeit | 0.92 | 0.94 | +2% Verbesserung |
| Macro-Präzision | 0.93 | 0.94 | +1% Verbesserung |
| Macro-Recall | 0.92 | 0.93 | +1% Verbesserung |
| Macro-F1-Score | 0.92 | 0.93 | +1% Verbesserung |
| Gewichtete Präzision | 0.93 | 0.94 | +1% Verbesserung |
| Gewichtetes Recall | 0.92 | 0.94 | +2% Verbesserung |
| Gewichteter F1-Score | 0.92 | 0.94 | +2% Verbesserung |
Tabelle 5: Leistungsvergleich vor und nach der Ablation von Merkmalen. Vergleich der Modellleistungsmetriken für den vollständigen multidomänalen Merkmalsatz und den reduzierten Merkmalsatz nach Entfernung der Entropie-Merkmale.
VERFÜGBARKEIT VON DATEN:
Der aufbereitete CSV-Datensatz, der für die Modellentwicklung und -analyse verwendet wurde, ist als Zusatzdatei 1 verfügbar. Der Code für die Vorverarbeitung ist in einem Python-Notebook unter https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing verfügbar, und der Code für den Modellaufbau und die Analyse ist unter https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing verfügbar. Der aufbereitete CSV-Datensatz kann außerdem mithilfe des bereitgestellten Vorverarbeitungscodes neu generiert werden.
| Klasse | Metrik | Vorher | Nachher | Änderung |
| Alzheimer | Präzision | 0.92 | 0.94 | 0.02 |
| Recall | 0.95 | 0.95 | Keine Änderung | |
| F1-Score | 0.94 | 0.94 | Keine Änderung | |
| Kontrolle | Präzision | 0.93 | 0.91 | −2% |
| Recall | 0.92 | 0.96 | 0.04 | |
| F1-Score | 0.93 | 0.94 | 0.01 | |
| FTD | Präzision | 0.93 | 0.97 | 0.04 |
| Recall | 0.87 | 0.89 | 0.02 | |
| F1-Score | 0.9 | 0.92 | 0.02 |
Tabelle 6: Klassenweise Leistungsänderungen vor und nach der Merkmalsablation. Änderungen der Präzision, Rückrufquote und F1-Score für die Klassen Alzheimer-Erkrankung, gesunde Kontrolle und frontotemporale Demenz nach dem Entfernen der Entropie-Merkmale.
Zusatzdatei 1: Verarbeiteter, auf Epochen-Ebene basierender EEG-Merkmalsdatensatz, verwendet für Modellentwicklung und Analyse. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Der Random-Forest-Klassifikator wurde verwendet, um Elektroenzephalographie-(EEG-)Proben anhand multimodaler Merkmale, einschließlich der Leistungsspektraldichte (PSD), des Effektivwerts (RMS) und Entropiemaße, in die Gruppen Alzheimer-Krankheit (AD), frontotemporale Demenz (FTD) und gesunde Kontrolle (HC) einzuteilen. Das Alter wurde als ergänzende demografische Variable einbezogen. Da sich die Altersverteilungen zwischen den diagnostischen Gruppen unterscheiden könnten, konnte eine demografische Verzerrung nicht vollständig ausgeschlossen werden, sodass die berichtete Leistung daher den kombinierten Einfluss demografischer und elektrophysiologischer Informationen widerspiegelte. Die Analyse untersuchte die Fähigkeit multimodaler EEG-Merkmale, zwischen den Gruppen AD, FTD und HC zu unterscheiden, und bewertete den Beitrag der Merkmale aus dem Delta-, Theta-, Alpha-, Beta- und Gamma-Band zur Klassifizierung35. Analysen zur Stabilität der Merkmale und zur Effektgröße zeigten, dass leistungsbasierte Merkmale, einschließlich PSD und RMS, stärker beitrugen als entropiebasierte Merkmale. Die extrahierten EEG-Biomarker spiegelten zudem Muster wider, die mit einer Verlangsamung der Rhythmen und einer verminderten Alpha-Aktivität assoziiert sind.
Frühere Studien haben mithilfe verschiedener maschineller Lernverfahren EEG-Merkmale auf Basis von Entropie, Leistungsspektraldichte (PSD) und Effektivwert (RMS) untersucht2,14,27,28,36,37. Die Entropie wurde verwendet, um die Komplexität und Irregularität des EEG zu charakterisieren, während die PSD zur Quantifizierung spektraler Eigenschaften herangezogen wurde2,14,27,28,36. RMS wurde zudem als Merkmal einzelner Frequenzbänder untersucht37. Unter Verwendung desselben Datensatzes wurde in früherer Arbeit eine PSD-basierte binäre Klassifizierung mit Leave-one-Subject-out-Validierung durchgeführt33. Die vorliegende Analyse kombinierte stattdessen RMS, Entropie und PSD über die Alpha-, Beta-, Gamma-, Theta- und Delta-Bänder hinweg innerhalb eines Multiklassen-Klassifizierungsansatzes. Ein leichtgewichtiger EEG-Transformer wurde auf demselben Datensatz mit einer Leave-one-Subject-out-Strategie für die binäre Klassifizierung evaluiert. Ein leichtgewichtiger EEG-Transformer, der auf demselben Datensatz mit einer Leave-one-Subject-out-Strategie für die binäre Klassifizierung evaluiert wurde, erzielte eine Genauigkeit von 83,28 %. Ein direkter numerischer Vergleich mit den vorliegenden Ergebnissen sollte vorsichtig interpretiert werden, da sich die Klassifizierungsaufgabe und die Validierungsverfahren unterschieden38.
Alpha-Band-Merkmale zeigten die größten Effektstärken bei der Unterscheidung von AD von HC und FTD von HC, und eine erhöhte Theta-Aktivität trug ebenfalls zur Differenzierung von AD von HC bei. Beta-Band-Merkmale zeigten über alle Gruppen hinweg geringere Effekte, während entropiebasierte Merkmale einen vergleichsweise begrenzten diskriminativen Nutzen aufwiesen. Gamma-Band-Merkmale zeigten bei einigen Vergleichen, einschließlich FTD versus HC, mittlere Effekte. Frühere Studien berichteten über eine verminderte Alpha-Leistung und veränderte Theta-Aktivität bei AD und verwandten diagnostischen Vergleichen23,25,39. Entropie wurde ebenfalls als potenziell aussagekräftiger Biomarker bei neurodegenerativen Erkrankungen beschrieben36, was darauf hindeutet, dass ihr Beitrag je nach Datensatz, Merkmalsdefinition und analytischer Herangehensweise variieren kann.
Stützvektormaschinen wurden in früheren EEG-Klassifizierungsstudien häufig verwendet3,21,24,37. Der im vorliegenden Analyseansatz verwendete Random-Forest-Klassifikator lieferte Schätzungen zur Merkmalswichtigkeit und eignete sich für den strukturierten Merkmalsatz, der in dieser Studie verwendet wurde40,41. Nach dem Entfernen der Entropie-Merkmale wurden Trainings- und Testgenauigkeiten von 96 % bzw. 94 % erzielt. Die Eliminierung der Entropie-Merkmale ging mit einer verbesserten Modellleistung einher, was die geringere relative Bedeutung dieser Merkmale in den Analysen zur Stabilität, SHAP und Effektgröße unterstützt. Tiefes Lernen und auf Transformatoren basierende Ansätze wurden ebenfalls auf die EEG-Klassifizierung angewandt, obwohl solche Ansätze in der Regel größere Datensätze erfordern und für hochdimensionale oder sequenzielle Darstellungen konzipiert sind27,39,42,43,44,45.
EEG-Signale sind verrauscht und nichtstationär, und Ensemble-Tree-basierte Modelle können bei der Analyse strukturierter Merkmalsdarstellungen Robustheit bieten. In der vorliegenden Studie wurden RMS, PSD, Entropie und Alter als ergänzende Eingaben für das Random-Forest-Modell evaluiert. RMS repräsentierte die Signalamplitude innerhalb der Frequenzbänder, PSD die spektrale Leistung und Entropie die Signalkomplexität. Die Ergebnisse zeigten, dass PSD und RMS stärker zur Klassifizierung im untersuchten Framework beitrugen als die Entropie. Auch das Alter trug zum Modell bei, obwohl seine Einbeziehung die Möglichkeit demografischer Störvariablen mit sich brachte. Künftige Untersuchungen könnten zusätzliche demografische Variablen sowie alternative maschinelle Lern- oder Deep-Learning-Ansätze in größeren Datensätzen evaluieren, um die Generalisierbarkeit und Klassifizierungsleistung weiter zu bewerten.
Offenlegungen
Es wurden keine bekannten wettbewerbsrelevanten finanziellen Interessen, persönlichen Beziehungen, finanziellen Beziehungen oder sonstigen Aktivitäten angegeben, die die in dieser Studie beschriebene Arbeit beeinflusst haben könnten.
Danksagungen
Es wird anerkannt, dass der öffentlich zugängliche EEG-Datensatz, der in dieser Studie verwendet wurde, sowie die Beiträge der Forscher, die den Datensatz für Forschungszwecke verfügbar gemacht haben, gewürdigt werden. Es wurden keine spezifischen Mittel von öffentlichen, kommerziellen oder gemeinnützigen Förderorganisationen eingeworben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Cloud-basierte Rechenumgebung zur Ausführung der Analyse-Notebooks | |
| MNE-Python | MNE-Python project | 1.12.1 | Wird für die EEG-Vorverarbeitung, Referenzierung, Filterung und Epochensegmentierung verwendet |
| NumPy | NumPy project | (2.0.2) | Wird für numerische und arraybasierte Berechnungen verwendet |
| OpenNeuro EEG-Datensatz | OpenNeuro | ds004504, (1.0.9) | Öffentlich zugänglicher Ruhezustand-EEG-Datensatz mit Aufzeichnungen von AD, FTD und HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Programmierumgebung für die Datenverarbeitung und Modellentwicklung |
| scikit-learn | scikit-learn project | 1.6.1 | Wird für die Vorverarbeitung, gruppierte Datenaufteilung, Random-Forest-Klassifizierung und Leistungsbewertung verwendet |
| SciPy | SciPy project | (1.16.3) | Wird für Signalverarbeitung und statistische Berechnungen verwendet |
| SHAP | SHAP project | 0.52.0 | Wird für die erklärbarkeitsbasierte KI-Analyse mit TreeExplainer verwendet |
Referenzen
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379