Um Probleme der Fragmentierung rechtlicher Texte und der Verfolgung von Voreingenommenheit in der medizinischen künstlichen Intelligenz (KI) anzugehen, konstruiert diese Studie einen Rechts-Wissensgraphen und verwendet eine relationsbewusste Graph-Faltung zur semantischen Ausrichtung. Sie identifiziert voreingenommene Quellen mittels gradientenbasierter Rückwärtspropagierung, mit günstigen experimentellen Kennzahlen zur Unterstützung einer konformen medizinischen KI-Anwendung.
Forschungsartikel
Konstruktion rechtlicher Wissensgraphen und Rückverfolgung von Bias in der medizinischen künstlichen Intelligenz auf Basis von Graph Neural Networks
In diesem Artikel
Zusammenfassung
Zusammenfassung
In der rechtlichen Compliance-Analyse für medizinische künstliche Intelligenz (KI) behandelt dieser Artikel die Unklarheiten bei der Haftungsbestimmung, die durch die semantische Fragmentierung mehrquelliger, heterogener Rechtstexte und durch Schwierigkeiten bei der Rückverfolgung algorithmischer Verzerrungen entstehen. Es wird eine Methode zur Erstellung eines Wissensgraphen und zur Erkennung von Verzerrungsweiterleitungs-Pfaden basierend auf graphbasierten neuronalen Netzen vorgestellt. Vier Arten heterogener Knoten – rechtliche Klauseln, medizinische Handlungen, Algorithmusmodule und verantwortliche Parteien – werden strukturiert und kodiert, und ein gerichteter Graph wird basierend auf vier Arten rechtlicher semantischer Beziehungen aufgebaut: „Verstoß“, „Grundlage“, „Auslöser“ und „Zuweisung“. Anschließend wird ein relationsbewusstes Graph-Convolutional-Netzwerk, kombiniert mit kantentypspezifischen Gewichtungen und einem Attention-Mechanismus, verwendet, um eine mehrschichtige Merkmalsausrichtung für querschnittliche rechtliche Semantik zu erreichen. Danach werden gradientenbasierte Rückpropagation eingesetzt, um Kanten zu identifizieren, die wesentlich zur Verzerrung beitragen, einen Verzerrungsweiterleitungs-Teilgraphen zu konstruieren und mithilfe von Community-Erkennung Wurzelknoten-Cluster zu lokalisieren. Schließlich werden Echtzeit-Entscheidungsflüsse auf temporäre Knoten abgebildet, die Compliance durch Einbettungsähnlichkeit überprüft und die Dynamik der Schlüsselkanten-Gewichte überwacht, um vor einer systematischen Anhäufung von Verzerrungen zu warnen. Experimente zeigen, dass die vorgeschlagene Methode hinsichtlich der semantischen Ausrichtungsgenauigkeit eine durchschnittliche Genauigkeit bei der Entitätszuordnung von mindestens 0,92 und eine durchschnittliche Vollständigkeit bei der Beziehungserhaltung von mindestens 0,88 über verschiedene Dichte-Gradienten des Wissensgraphen hinweg erreicht. Hinsichtlich der Fähigkeit zur Lokalisierung von Verzerrungen liegt die Recall-Rate der Wurzelknoten bei 0,95±±0,02 und die Präzision des Weiterleitungs-Pfads bei 0,93±±0,03. Diese Studie erreicht gewissermaßen eine tiefe Kopplung zwischen rechtlicher Logik und algorithmischem Verhalten und stellt damit ein erklärbares und verifizierbares Compliance-Unterstützungssystem für den vertrauenswürdigen Einsatz medizinischer KI bereit.
Einleitung
Die tiefgreifende Einbindung von medizinischer KI in Diagnose und Therapieunterstützung, Ressourcenallokation sowie Risikobewertung hat ihre Entscheidungsfindung mit der Zuschreibung rechtlicher Verantwortung verknüpft1,2. Die rechtlichen Normen sind hochgradig strukturiert, jedoch semantisch verteilt, und das Verhalten von KI-Systemen kann als Black-Box vorliegen, ohne dass eine semantisch verknüpfbare und nachvollziehbare Schnittstelle zwischen beiden existiert3. Vor diesem Hintergrund hat sich die Entwicklung eines gemeinsamen Repräsentationsrahmens, der rechtliche Kausalzusammenhänge innerhalb algorithmischer Verhaltenssequenzen erfasst, als notwendige Voraussetzung für eine feingliedrige Zuschreibung von Verantwortung und dynamische Einhaltung von Vorschriften erwiesen4,5. Diese Studie betrifft nicht nur die rechtliche Prüfung von Technologiensystemen, sondern betrifft auch die umfassende Sicherstellung medizinischer Fairness, algorithmischer Fairness und institutionellen Vertrauens und besitzt daher große theoretische Bedeutung sowie praktische Dringlichkeit.
Das grundlegende Problem bei der rechtlichen Konformitätsanalyse medizinischer KI-Systeme liegt heute in dem Mangel an einer berechenbaren Verbindung zwischen rechtlicher Semantik und algorithmischem Verhalten6,7. Rechtsdokumente liegen als reiner Text vor, und die Beziehungen zwischen Absätzen sind durch Abhängigkeiten, Widersprüche und Ausnahmen verflochten, was Probleme verursacht, wenn sie in logische Einheiten zerlegt werden sollen, die von Maschinen interpretiert werden können8,9. Obwohl die Entscheidungsfindung des KI-Systems in einer datengetriebenen Black-Box enthalten ist, können keinerlei Ausgabeveränderungen auf konkrete Verstöße gegen rechtliche Pflichten oder Knoten zur Haftungszuweisung zurückgeführt werden10,11. Eine solche Diskrepanz (beispielsweise durch Verzerrungen in Trainingsdaten, Designfehler des Modells oder die semantische Interpretation rechtlicher Normen) kann experimentell nicht isoliert werden, um die Quelle der Verzerrung zu identifizieren oder die rechtlichen Pflichten für Entwickler, Anbieter oder Nutzer zu klären12,13. Noch problematischer ist, dass bestehende Konformitätsverfahren lediglich überprüfen, ob eine finale Ausgabe einer festgelegten Spezifikation entspricht, ohne den Ausbreitungsweg oder die Verstärkung von Verzerrungen im Interaktionsnetzwerk von „Recht und Technologie“ zu berücksichtigen14,15. Wenn medizinische KI gleichzeitig mehreren rechtlichen Vorschriften unterliegt und das System aufgrund einer fehlerhaften Interpretation einer Klausel eine Kette von Fehlern erzeugt, können herkömmliche Ansätze nicht nachvollziehen, wie sich der Fehler durch andere verwandte Vorschriften fortpflanzt und schließlich zur Haftung führt16,17. Zudem fehlt eine dynamische Korrelationsmechanismus zwischen dem Echtzeit-Entscheidungsfluss und dem bestehenden Wissensgraphen des Rechts, was zu verzögerten Konformitätsbewertungen während des Systembetriebs führt und somit eine proaktive Überwachung der Akkumulationstendenz von Verzerrungen verhindert18,19. Diese Probleme führen gemeinsam zu Unsicherheiten bei der Haftungsbestimmung, instabiler Zuweisung und verzögerter regulatorischer Intervention, was die vertrauenswürdige Einführung von KI-Systemen im Hochrisikobereich Gesundheitswesen sowie die Anwendung rechtlicher Verantwortlichkeit erheblich behindert.
Vor allem untersuchen traditionelle Forschungsarbeiten rechtliche Texte in strukturierter Form und erstellen Wissensbasen spezifischer Bereiche mithilfe von Ontologien oder Regeln, um die Beantwortung von Compliance-Fragen oder Risikohinweisen zu unterstützen20,21. Obwohl diese Ansätze Darstellungen einiger juristischer Konzepte erfassen können, gehen sie meist davon aus, dass die innere Logik des Rechts kohärent und statisch sei, was die Handhabung interjurisdiktioneller Widersprüche, Ausnahmen oder vager Formulierungen erschwert. Spätere Arbeiten führten Technologien der natürlichen Sprachverarbeitung ein und nutzten vortrainierte Sprachmodelle zur Extraktion rechtlicher Entitäten und Beziehungen, wodurch die Breite der Wissensgewinnung verbessert wurde22,23, jedoch auf einem flachen semantischen Niveau verblieb, ohne eine Schnittstelle zwischen rechtlichem und technischem Verhalten zu schaffen. Im Bereich der Governance algorithmischer Voreingenommenheit konzentrierte sich die Forschung hauptsächlich auf die Entwicklung von Fairness-Bedingungen24,25, deren Evaluierungskriterien gewöhnlich auf demografischen Variablen basieren und an rechtlichen Zurechnungsprinzipien fehlen. Obwohl einige Studien versucht haben, rechtliche Regeln als Zwänge zu kodieren und in das Modelltraining einzubetten26,27, sind diese aufgrund der Starrheit und groben Granularität der Regelrepräsentation schwer an komplexe klinische Situationen anpassbar. Im Allgemeinen behandelt die bestehende Forschung rechtliche Konformität als externe Überprüfungsaufgabe statt als intrinsisches, berechenbares Merkmal der Systemarchitektur. Dies führt dazu, dass rechtliche und algorithmische Logik parallel verlaufen, ohne gemeinsames Schließen und dynamische Eingriffe bei Pfaden der Bias-Verbreitung zu ermöglichen.
In den letzten Jahren wurden graphbasierte neuronale Netze aufgrund ihrer expliziten Modellierungsfähigkeit relationaler Strukturen schrittweise in den medizinischen Bereich eingeführt28,29. Einige Studien nutzen heterogene Graphen, um Rechtsprechung, gesetzliche Bestimmungen und Parteieninformationen zu integrieren, und unterstützen Fall-Empfehlungen oder Strafvorhersagen durch Knoteneinbettungen30,31, wodurch die Wirksamkeit von Graphstrukturen bei der Erfassung rechtlicher Verbindungen nachgewiesen wird. Andere Arbeiten abstrahieren algorithmische Komponenten als Graphknoten und verwenden Kanten, um Datenflüsse oder Aufrufbeziehungen zur Verfolgung von Fehlerausbreitungen darzustellen32,33. Diese Untersuchungen zeigen, dass Graphstrukturen als gemeinsame Träger von rechtlichen und technologischen Elementen dienen können. Bestehende Graphmodelle weisen jedoch drei wesentliche Einschränkungen auf: Erstens beschränken sie sich auf einen einzigen Kantentyp und können daher normative, kausale und attributive Unterschiede in der juristischen Semantik nicht unterscheiden; zweitens bleibt bei dem Prozess der Merkmalsaggregation die semantische Gewichtung der Kantentypen unberücksichtigt, wodurch unterschiedliche rechtliche Logikpfade gleich behandelt werden; drittens fehlt ihnen ein differenzierbarer Mechanismus zur Verfolgung von Bias-Ausbreitung, wodurch eine Lokalisierung der Kanten mit hohem Beitrag und eine Rekonstruktion von Verantwortungspfaden unmöglich wird. In dieser Arbeit wird ein relationsbewusstes Graph-Convolutional-Netzwerk konstruiert, das das Problem der semantischen Heterogenitätsfusion adressiert, indem jeder Art von juristischer semantischer Kante eine dedizierte Transformationsmatrix zugewiesen wird und ein Aufmerksamkeitsmechanismus eingeführt wird, um den informationsfluss zwischen verschiedenen Typen dynamisch anzupassen. Darüber hinaus ermöglicht die Kombination von Gradient-Backpropagation und Subgraph-Extraktion einen interpretierbaren Sprung von der makroebenen Konformitätsbewertung zur mikroebenen Bias-Verfolgung und überwindet so die Engpässe traditioneller Graphmodelle, die lediglich statische Schlussfolgerungen unterstützen.
Jenseits des medizinischen Bereichs haben neuere Fortschritte bei graphbasierten und evolutionären Methoden eine breite Anwendbarkeit bei der Verarbeitung strukturierter Kenntnisse gezeigt. Xue et al. schlugen beispielsweise einen mehrschichtigen hybriden Ansatz des genetischen Programmierens zur adaptiven Konstruktion von Ähnlichkeitsmerkmalen beim Ontologiematching vor und erreichten dadurch eine robuste Alignierung heterogener Wissensgraphen34. Cheng et al. lieferten eine umfassende Übersicht über Anwendungen von Graph-Convolutional-Networks in der Bildrestaurierung und kategorisierten systematisch Methoden zur Rauschunterdrückung, Super-Resolution und Entunschärfung35. Li et al. präsentierten eine ausführliche Übersicht zum Thema evolutionäres Deep Learning aus der Perspektive des automatisierten maschinellen Lernens, wobei sie Prinzipien, Algorithmen, Anwendungen und offene Herausforderungen abdeckten36. Ma et al. entwickelten ein Framework für die Suche nach einer unscharfen neuronalen Architektur zur Defekterkennung unter Unsicherheit und demonstrierten damit die Wirksamkeit evolutionärer Suchverfahren bei der Verarbeitung mehrdeutiger Daten37. Diese Studien verdeutlichen das Potenzial der Integration graphbasierter Repräsentationen und evolutionärer Optimierung für komplexe Entscheidungsaufgaben.
Das zentrale Ziel dieser Arbeit besteht darin, einen durchgängig interpretierbaren Rahmen für die Analyse der rechtlichen Konformität medizinischer KI zu schaffen, mit Innovationen auf drei Ebenen. Auf der Ebene der Wissensrepräsentation modelliert sie erstmals rechtliche Klauseln, medizinische Praktiken, Algorithmusmodule und verantwortliche Parteien als vier Arten heterogener Knoten. Basierend auf der juristischen Praxis extrahiert sie vier Arten gerichteter Beziehungen: „Verstoß“, „Grundlage“, „Auslöser“ und „Zuweisung“, wodurch ein gerichteter Wissensgraph mit juristischer Kausallogik konstruiert wird, der eine strukturierte semantische Grundlage für die Konformitätsanalyse bietet. Auf der Ebene der Herkunftssuche von Bias schlägt sie eine auf Gradientensensitivität basierende Methode zur Quantifizierung des Kantenbeitrags vor. Durch Backpropagation identifiziert sie die Menge der Kanten, die die Ausgabeverzerrung maximieren, und wendet anschließend einen Community-Erkennungsalgorithmus an, um Knoten mit hohem Beitrag zu gruppieren, wodurch „Black-Box-Bias“ in „White-Box-Verantwortlichkeitscluster“ umgewandelt wird, was eine Zuweisung basierend auf einer nachvollziehbaren Beweiskette ermöglicht. Auf der Ebene der Echtzeit-Dynamiküberwachung entwickelt sie einen temporären Entscheidungs-Knoten-Embedding-Mechanismus, der Echtzeit-AI-Ausgaben in den Wissensgraph-Raum abbildet. Basierend auf dem Vergleich der Embedding-Nähe quantifiziert sie das Ausmaß der Normabweichung und überwacht die Gewichtsänderung jener wesentlichen rechtlich-technischen Kanten, um die Anhäufung systemischer Verzerrungen frühzeitig zu signalisieren. Dieses Paradigma löst sowohl semantische Fragmentierung als auch Nachverfolgbarkeitsprobleme und verwandelt rechtliche Konformität von einer ex-post-Überprüfung in eine ex-ante-Steuerung, wodurch ein skalierbarer technischer Weg zur Transparenz der Verantwortlichkeit in KI-Systemen mit hohem Risiko eröffnet wird.
Protokoll
Aufbau eines graphbasierten neuronalen Netzwerks für einen Wissensgraphen zu medizinischer KI und Recht
Wie in Abbildung 1 gezeigt, besteht der vorgeschlagene Rahmen aus drei Hauptmodulen. Die Eingabeschicht integriert Daten aus mehreren Quellen in einen heterogenen Graphen mittels multimodaler Entitätskodierung und Modellierung gerichteter Kanten. Die relationsbewusste GCN-Schicht führt anschließend eine semantische Quermodulabstimmung durch typspezifische Gewichtungen und Aufmerksamkeit durch und erzeugt so einheitliche Knoteneinbettungen. Schließlich unterstützen diese Einbettungen die Rückverfolgung von Verzerrungen (mittels Gradienten-Rückpropagation und Community-Erkennung) und die dynamische Einhaltungsüberwachung (mittels Echtzeit-Knotenabbildung und Verfolgung der Kantengewichte), wobei die Ausgabe interpretierbare Zuordnungsnachweise und Risikowarnungen für Aufsichtsbehörden liefert.
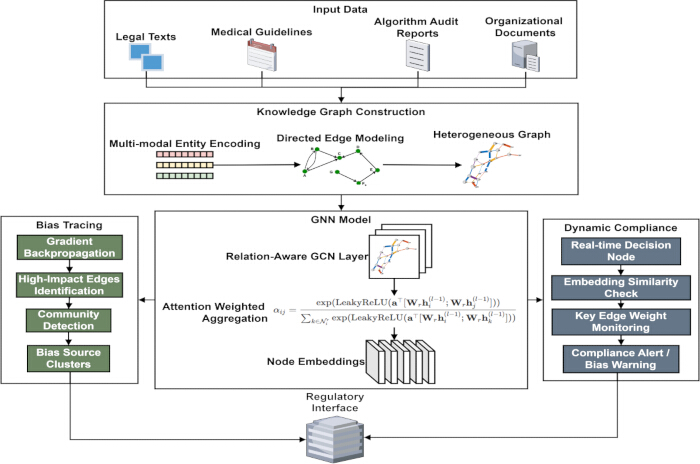
Abbildung 1: Rechtlicher Wissensgraph und Architektur zur Verfolgung von Verzerrungen für medizinische KI. Dieses Diagramm veranschaulicht den gesamten Arbeitsablauf des vorgeschlagenen Frameworks. Die Eingabeschicht fusioniert heterogene Daten aus mehreren Quellen (rechtliche Texte, klinische Leitlinien, Berichte über Algorithmusprüfungen), die in vier Entitätstypen (rechtliche Klauseln, medizinische Handlungen, Algorithmusmodule, verantwortliche Parteien) kodiert und durch vier gerichtete rechtlich-semantische Beziehungen (Verstoß, Grundlage, Auslöser, Zurechnung) verknüpft werden. Die beziehungsbezogene GCN-Schicht führt eine semantische Quermodalitätsausrichtung mittels typspezifischer Gewichte und Aufmerksamkeit durch. Das Modul zur Verfolgung von Verzerrungen nutzt Gradienten-Rückpropagation, um Kanten mit hohem Beitrag zu identifizieren, und wendet anschließend Community-Erkennung an, um Cluster von Ursprungsknoten zu lokalisieren. Der dynamische Konformitätsmonitor ordnet Echtzeitentscheidungen temporären Knoten zu, bewertet die Ähnlichkeit der Einbettungen gegenüber rechtlichen Klauseln und verfolgt die Entwicklung der Kantengewichte zur Früherkennung. Die Ausgaben umfassen interpretierbare Zurechnungsnachweise und Risikowarnungen. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Heterogene grafische Strukturkodierung von juristischen Personen und Beziehungen
Vier grundlegende Entitäten werden konsequent aus medizinischen KI-Regulierungsgesetzen, klinischen Leitlinien und Algorithmus-Auditberichten abgeleitet: rechtliche Klauseln, medizinische Verfahren, Algorithmus-Module und verantwortliche Entitäten. Für jeden Entitätstyp wird ein separates Modell zum Lernen von Merkmalsdarstellungen vorgeschlagen, um semantische Unterscheidbarkeit zu gewährleisten. Die Knoten der rechtlichen Klauseln sind so organisiert, dass sie die Nummer der jeweiligen rechtlichen Klausel enthalten, die als eindeutige ID (Identifikator) für die Klausel dient. Gleichzeitig wird ein Index zur Quantifizierung der Sanktionshärte definiert, um das Ausmaß der mit der Klausel verbundenen rechtlichen Verantwortung anzugeben, woraus folglich ein Merkmalsvektor aufgebaut wird.
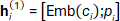 (1)
ci ist die Eintragsnummer, Emb(·) repräsentiert die niedrigdimensionale Einbettungsabbildung und [·;·] repräsentiert die Vektorverkettungsoperation. Diese Darstellung bewahrt sowohl die formale Struktur als auch die Schwere der Strafe des rechtlichen Textes und unterstützt die Schlussfolgerung über mehrere Aussagen hinweg.
Medizinische Verhaltensknoten werden standardisiert und basierend auf einem Klassifikationssystem für klinische Operationen codiert, wobei ihr Risikograd rj ∈ {1,2,3} und die Menge der anwendbaren Szenariokennzeichnungen sj ⊂ S extrahiert werden, wobei S die vollständige Menge vordefinierter Szenariokategorien darstellt. Zur Verarbeitung der Kennzeichnungsmenge wird eine Multi-Hot-Codierung verwendet, die mit dem Embedding des Risikograds verknüpft wird, um eine initiale Darstellung zu bilden:
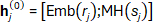 (2)
Diese Strategie stellt sicher, dass verschiedene Arten medizinischen Verhaltens im Vektorraum messbare Distanzbeziehungen aufweisen, was den Vergleich über verschiedene Szenarien hinweg ermöglicht. Die Text-Einbettungsfunktion Emb(·) wird mithilfe des vortrainierten chinesischen Rechtssprachmodells Lawformer (vortrainiert auf einem umfangreichen chinesischen Rechtskorpus) implementiert, wobei die Ausgabedimension fest auf 768 eingestellt ist.
Basierend auf den logischen Abhängigkeiten und rechtlichen Rahmenbedingungen zwischen Entitäten werden vier Arten gerichteter semantischer Beziehungen festgelegt: „Verstoß“, „Grundlage“, „Auslöser“ und „Zuweisung“, wobei jede einem anderen rechtlichen Kausalzusammenhang entspricht. Jede Kante eij ⊂ E erhält einen Labeltyp tij ⊂ T = {violate, base, trigger, attribute}, um im weiteren Verlauf die Nachrichtenübertragung zur Beziehungserkennung zu ermöglichen. Die Kantenkonstruktion folgt strikt dem domänenspezifischen Regelausprägungsmechanismus: Weicht ein medizinisches Verhalten von den normativen Vorgaben ab, wird eine „Verstoß“-Kante vom Verhaltensknoten zur betreffenden Rechtsnorm hin eingerichtet; dient die Rechtsnorm als technische Konformitätsgrundlage für eine Maßnahme, wird eine „Grundlage“-Kante gebildet; ergibt die Ausgabe des Algorithmusmoduls direkt die Durchführung eines bestimmten medizinischen Verhaltens, wird eine „Auslöser“-Kante verbunden; die Zuweisung von Verantwortungsbeziehungen basiert auf den Verantwortungsdokumenten der Organisation und den Prüfungsergebnissen und führt zur Einrichtung einer „Zuweisung“-Kante zwischen der verantwortlichen Partei und dem Verstoß beziehungsweise dem Algorithmusdefekt.
Nachdem alle Knoten initialisiert wurden, wird ein heterogener Graph (V, E, H0) gebildet, wobei V die Menge der Knoten, E die Menge der gerichteten Kanten mit Typbezeichnungen und H0 die initiale Merkmalsmatrix ist. Um die semantische Unterscheidungsfähigkeit der Graphstruktur zu verbessern, werden die Knotenmerkmale normalisiert:
 (3)
μk und σk sind der Mittelwert und die Standardabweichung der k-ten Knotenmerkmals auf dem Trainingsdatensatz, jeweils, und ∈ ist eine kleine Konstante, um eine Division durch null zu vermeiden. Die Normalisierung stellt sicher, dass heterogene Merkmale aus mehreren Quellen bei Graph-Faltungsvorgängen in einem einheitlichen Maßstab berücksichtigt werden, wodurch numerische Dominanzeffekte, die das semantische Lernen stören könnten, vermieden werden. Das resultierende strukturierte Graphmodell trägt vollständig die relationale Topologie der vierdimensionalen Elemente Recht, Verhalten, Technologie und Verantwortung im medizinischen KI-System und bietet eine berechenbare Graphenbasis für die anschließende Analyse der Bias-Ausbreitung.
Verbesserung der Graphfaltungskartierung für multimodale juristische Semantik
Ein bezugsbewusstes Graph-Convolutional-Netzwerk38,39, das das Framework des Relationalen Graph-Convolutional-Netzwerks (R-GCN) erweitert, wird verwendet, um Merkmale über mehrere Schichten des ursprünglichen heterogenen Graphen zu propagieren. Während R-GCN transformationsbasierte Matrizen pro Relation für allgemeine relationale Daten einführt, integriert unser Ansatz zusätzlich einen lernbaren Aufmerksamkeitsmechanismus, um die Beiträge der Nachbarn dynamisch zu gewichten, und definiert vier spezifische rechtlich-semantische Relationstypen (Verstoß, Grundlage, Auslöser, Zuschreibung), die auf die Compliance-Analyse von medizinischer KI zugeschnitten sind. Die Operation jeder Schicht parametrisiert den Transformationsprozess unabhängig basierend auf dem semantischen Typ der Kanten. Für jeden Zielknoten werden die Informationen aus der Nachbarschaft entsprechend den Typen der verbindenden Kanten gruppiert und aggregiert. Jeder Relationstyp verfügt über eine dedizierte lineare Transformationsmatrix, um die entlang unterschiedlicher rechtlich-semantischer Pfade übertragenen Merkmale zu differenzieren40,41. Wenn die Kante zwischen dem Rechtsnorm-Knoten und dem medizinischen-Verhalten-Knoten vom Typ „Grundlage“ ist, wendet der Rechtsnorm-Knoten beim Empfang einer Nachricht von einem medizinischen-Verhalten-Knoten die entsprechende Gewichtsmatrix an, um die Merkmale des Nachbarn räumlich abzubilden. In ähnlicher Weise transformiert ein medizinisches-Verhalten-Knoten beim Senden einer Ausgabe über den Kantenintegrations-Schemaknoten „Auslöser“ an ein Algorithmusmodul die Merkmale mithilfe der mit dieser Relation assoziierten und ausgelösten Parametermatrix. Dies bildet die Fluidität verschiedener Arten von rechtlicher Logik ab und realisiert bzw. informiert unterschiedliche Logikschichten, um semantische Unabhängigkeit während des Informationsflusses ohne störende Quermodalitäten zu gewährleisten. Die Aggregation ist wie folgt definiert:
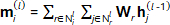 (4)
mi(l) steht für die umfassenden Informationen, die vom Knoten i in der Schicht l gesammelt wurden, Nil ist seine Nachbarmenge bezüglich der Relation r, Wr ist die lineare Transformationsmatrix und hj(l−1) ist die Einbettungsdarstellung des Nachbarknotens in der vorherigen Schicht.
Ein lernbarer Aufmerksamkeitsmechanismus wird während der Nachrichtenaggregation eingeführt, um die Einflussstärke verschiedener benachbarter Knoten auf die Aktualisierung der Zielknotendarstellung dynamisch anzupassen42,43. Der Aufmerksamkeitskoeffizient wird auf Grundlage der beiden Faktoren Knotenattribut-Ähnlichkeit und rechtliche Bedeutung erzeugt, ohne auf feste Vorwahlgewichte angewiesen zu sein. Bei rechtlichen Klauselknoten wird, wenn benachbarte Merkmale medizinischen Verhaltens empfangen werden, der Aufmerksamkeitswert anhand des quantifizierten Strafschweregrads, der mit letzteren verknüpft ist, berechnet; wenn der Algorithmusmodulknoten Informationen zu medizinischem Verhalten fusioniert, konzentriert er sich auf Nachbarn mit höheren operationellen Risikostufen. Das Aufmerksamkeitsgewicht wird folgendermaßen berechnet:
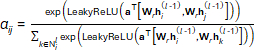 (5)
αij ist der Aufmerksamkeitskoeffizient des Knotens j gegenüber dem Knoten i, und a ist der lermbare Aufmerksamkeitsvektor. Dieses Modell ermöglicht die automatische Identifizierung von verbindenden Pfaden mit hohem Risiko oder hohen Einschränkungen während des End-to-End-Trainings, denen eine höhere Aufmerksamkeit zugewiesen wird. Das endgültig aktualisierte Knoten-Embedding wird durch gewichtete Nachrichten und Residualverbindungen bestimmt.
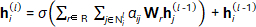 (6)
σ ist die Aktivierungsfunktion, und das Residualdesign verringert das Problem des verschwindenden Gradienten bei tiefer Ausbreitung und gewährleistet Stabilität angesichts mehrfacher semantischer Konflikte. Nach L = 3 graphenförmigen Faltungsschichten (jeweils mit einer verborgenen Dimension von 256 und ReLU-Aktivierung) integrieren die Einbettungen aller Knoten nahtlos kontextuelle Informationen aus verschiedenen Modalitäten und werden zu einheitlichen Darstellungen mit legalen Fähigkeiten zur semantischen Unterscheidung.
Zwei alternative Diagramme zur rechtlichen Compliance-Analyse für KI im Gesundheitswesen sind in Abbildung 2 dargestellt, um die Visualisierung von Arten rechtlicher Beziehungen und Wegen der Bias-Verbreitung zu ermöglichen und potenzielle Bias-Quellen dieser Entscheidungsfindung aufzuzeigen. Abbildung 2A zeigt den Einfluss verschiedener rechtlicher semantischer Beziehungen, wobei vier Beziehungstypen farblich codiert sind und für jeden Typ die Kanten durch eine unterschiedliche Farbe hervorgehoben werden. Die Dicke der Kante entspricht dem Aufmerksamkeitsgewicht dieser spezifischen Beziehung, also dem Maß, in dem diese Beziehung zur KI-Entscheidung beiträgt. Eine dicke Kante weist im Wesentlichen auf eine dominante rechtliche Beziehung in der Entscheidung hin und hat in diesem Fall das Ergebnis des Falls ausreichend begründet. Die Knotengröße wird anhand ihres Beitrags zu Verstößen bemessen: größere Knoten deuten auf eine stärkere Verbindung zwischen dem Verhalten und bestimmten rechtlichen Klauseln hin und damit auf ein höheres Risikopotenzial. Die obige Visualisierung liefert eine klare rechtliche semantische Ebene, die es uns ermöglicht, die stärksten und risikoreichsten rechtlichen Pfade in der KI-Entscheidungsfindung zu identifizieren. Abbildung 2B zeigt ebenfalls Pfade mit hohem Beitrag (zur Bias-Verbreitung), wobei besonderer Schwerpunkt auf Kanten mit hohem Beitrag liegt, die fett hervorgehoben und durch gestrichelte Linien (z. B. B1–B3) im Entscheidungsprozess begleitet werden. Eine Verdopplung der Breite dieser Kanten verdeutlicht ihre Bedeutung bei der Verbreitung systemischer Verzerrungen. Welche Kombinationen aus rechtlichen Vorschriften und technischen Verhaltensweisen zu dieser Verstärkungswirkung bei Bias führen, ist in Abbildung 2 dargestellt. Diese Analyse offenbart nicht nur den Pfad der Bias-Verbreitung, sondern erleichtert auch die Identifizierung der Bias-Ursachen, auf deren Grundlage die Compliance-Prüfung und die Verantwortlichkeit des KI-Tools festgelegt werden können.
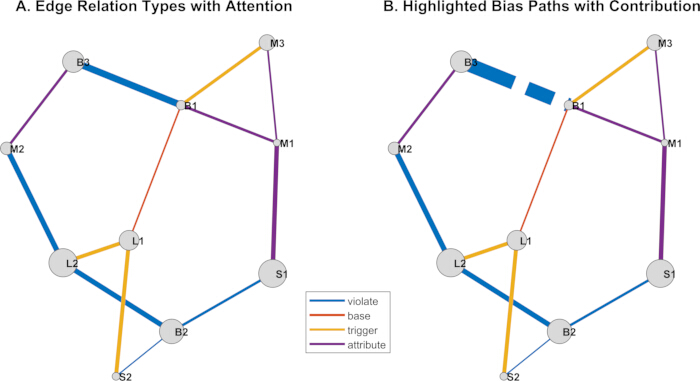
Abbildung 2: Analyse der rechtlichen Konformität und der Weitergabe von Bias in KI-Systemen im Gesundheitswesen (veranschaulichendes Beispiel). (A) Farbkodierte rechtliche semantische Beziehungen: Verstoß (rot), Grundlage (blau), Auslöser (grün), Zuschreibung (orange). Die Kantendicke entspricht dem Aufmerksamkeitsgewicht und zeigt den Einfluss jeder Beziehung auf die KI-Entscheidung an. Die Knotengröße ist proportional zum Beitrag zum Verstoß und hebt risikobehaftete Entitäten hervor. (B) Teilgraph der Bias-Weitergabe: Kanten mit hohem Beitrag sind fett und gestrichelt dargestellt (z. B. B1–B3); doppelt breite Kanten zeigen eine Verstärkung systemischer Verzerrungen an. Diese Visualisierung unterstützt die Identifizierung dominanter rechtlicher Pfade, der Ursprünge von Bias und die Prüfung der Compliance. Keine Maßstabsangaben oder Fehlerbalken sind anwendbar, da es sich um eine schematische Darstellung handelt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Teilgraph-Backtracking-Mechanismus für die Bias-Ausbreitungsstrecke
In dieser Studie wird „Bias“ definiert als die systematische Abweichung der Ausgabe eines KI-Systems von der klinisch und rechtlich erwarteten Entscheidung, gemessen anhand der Diskrepanz zwischen dem vom Modell vorhergesagten Risikoscore und dem korrekten Konformitätslabel. Das Bias-Signal wird als Kreuzentropie-Verlust zwischen der endgültigen Ausgabe des Algorithmus und einem binären Indikator für Konformität (1 bei Konformität, 0 bei Nichtkonformität) quantifiziert und über alle Entscheidungsinstanzen eines Batches aggregiert.
Nachdem das Graph-Neuronale-Netzwerk trainiert wurde, wird seine Differenzierbarkeit genutzt, um eine Backpropagation-Analyse des Bias-Signals in der Ausgabeschicht durchzuführen. Ausgehend vom Algorithmus-Entscheidungsknoten, der Anomalien erkennt, wird die Gradientenstärke der Verlustfunktion bezüglich jeder verbindenden Kante berechnet, um den Beitrag jeder Kante zur Bias-Bildung zu quantifizieren. Dieser Prozess wird mithilfe eines automatischen Differenzierungs-Frameworks implementiert, das Schicht für Schicht entlang der gerichteten Kanten in der Graphstruktur zurückverfolgt, um die Einflussstärke jeder Kantentransformation auf die finale Ausgabeveränderung zu ermitteln. Je höher der absolute Wert des Gradienten ist, desto dominanter ist die durch diese Kante vermittelte rechtlich-technische Beziehung bei der Bias-Weiterleitung. Der Beitrag einer Kante wird definiert als:
 (7)
Lbias ist der differenzierbare Verlust, der für verzerrtes Verhalten definiert ist, und wi ist der Eintrags-Gewichtungsvektor, der dem Kanten-Typ entspricht. Dieser Gradientenwert spiegelt das Ausmaß der Beteiligung einer bestimmten semantischen Beziehung an der gegenwärtigen Assoziationsverzerrung wider. Nachdem alle Kanten auf diese Weise bewertet wurden, wird eine dynamische Schwelle τ festgelegt, um die Menge der Kanten mit hohem Beitrag Ehigh herauszufiltern, deren Beitrag gij > τ übersteigt, wodurch der anfängliche Bias-Propagations-Teilgraph Gbias = (Vbias, Ehigh) entsteht. Insbesondere wird τ als das 85. Perzentil der absoluten Gradientenwerte über alle Kanten in jeder Trainingsphase bestimmt, wodurch sichergestellt wird, dass nur die einflussreichsten 15 % der Kanten für die Teilgraphen-Konstruktion beibehalten werden. Dieser Teilgraph konzentriert sich auf die wichtigsten Verbindungspfade, die am ehesten systematische Verzerrungen verursachen, reduziert den Suchraum und verbessert die Effizienz der Quellverfolgung.
Innerhalb des konstruierten Bias-Propagations-Teilgraphen wird ein spektralgeführter Algorithmus zur Erkennung von Gemeinschaftsstrukturen ausgeführt, um hochgradig kohärente Knotencluster zu identifizieren. Dieser Prozess basiert auf der faktorisierten Form der normalisierten Laplace-Matrix des Teilgraphen, wodurch Knoteneinbettungen in einen niederdimensionalen Spektralraum abgebildet werden. Anschließend wird in diesem Raum eine dichteadaptive Clusterstrategie angewendet, um sicherzustellen, dass Knoten unterschiedlichen Typs (wie beispielsweise juristische Klauseln und Algorithmusmodule) in denselben Cluster gruppiert werden, wenn sie funktional eng miteinander verbunden sind. Jede identifizierte Gemeinschaft repräsentiert eine potenzielle funktionale Schleife oder eine Einheit zur Aggregation von Verantwortlichkeiten. Die Ergebnisse der Community-Zerlegung werden durch die folgenden Optimierungsziele gesteuert:
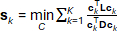 (8)
L=D−A ist die Laplace-Matrix des Teilgraphen, A ist die Adjazenzmatrix, D ist die Gradmatrix, ck ist der Indikatorvektor der k-ten Community und K ist die vorgegebene Anzahl an Communities. Dieses Kriterium maximiert die minimale Schnittdifferenz zwischen den Communities und gewährleistet somit enge interne Verbindungen.
Nun wird eine analysebasierte Querschichtverbundanalyse für jede Community durchgeführt. Wenn eine Community Knoten mit rechtlichen Bestimmungen und Knoten mit Algorithmusmodulen aufweist, wird sie als potenzielle Bias-Quelle markiert. Um deren Kausalität zu überprüfen, wird ein Intervenktionstest durchgeführt: Alle Kanten in diesem Bereich werden vorübergehend aus dem Graphen entfernt, derselbe Entscheidungsprozess erneut ausgeführt, und Unterschiede in den Bias-Messungen werden festgestellt. Das Maß für die kausale Gültigkeit ist definiert als:
 (9)
Borig und Bmask repräsentieren die Bias-Stärke des ursprünglichen Modells bzw. des Bias nach der Maskierung. Wenn das Maß für die kausale Gültigkeit deutlich über der vorbestimmten Schwelle liegt, impliziert dies, dass der Knotencluster als erklärbarer Ursprung des Bias identifiziert wurde, was die spätere Korrektur hinsichtlich der Konformität und die Zuweisung von Fehlern leiten wird.
Dynamische Überprüfung der Einhaltung rechtlicher Vorgaben
Echtzeit-Entscheidungsinstanzen, die während des Betriebs eines medizinischen KI-Systems auftreten, werden als transiente Knoten eingeführt und in einen erlernten Wissensgraphen-Raum eingebettet. Jeder Knoten erzeugt einen initialen Merkmalsvektor, indem er seinen Eingabekontext, das Ausgabeverhalten und den Zustand des Algorithmus ausliest. Anschließend wird dieser Vektor in ein Graph-Neuronales-Netzwerk mit fixierten Parametern eingespeist, um eine einlagige Vorwärtsausbreitung durchzuführen, wodurch eine Einbettung entsteht, die mit dem Wissensgraphen ausgerichtet ist, ohne die ursprüngliche Graphstruktur zu verändern. Dadurch können transiente Knoten und Knoten mit rechtlichen Klauseln in einem gemeinsamen semantischen Raum verglichen werden.
Berechnen Sie dann die Kosinus-Ähnlichkeit zwischen dem transienten Knoten und jedem der legalen Klauselknoten:
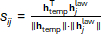 (10)
htemp ist die Einbettung des temporären Knotens und hjlaw die Einbettung des j-ten Rechtsklausel-Knotens. Der Ähnlichkeitswert spiegelt praktisch das semantische Übereinstimmungsmaß zwischen der aktuellen Entscheidung und jeder rechtlichen Vorgabe wider. Eine dynamische Konformitätsschwelle θ wird basierend auf der Ähnlichkeitsverteilung historischer Konformitätsbeispiele festgelegt, um die Entscheidungsgrenze an verschiedene Anwendungsszenarien anzupassen. Konkret gilt: θ = µ – 2σ, wobei µ und σ der Mittelwert und die Standardabweichung der Kosinus-Ähnlichkeitsverteilung sind, berechnet anhand eines Validierungssatzes von 500 bekannten konformen Entscheidungsinstanzen.
Wenn ein Kosinus-Ähnlichkeitswert unterhalb der dynamischen Compliance-Schwelle liegt, wird die entsprechende Rechtsnorm als verletzt betrachtet, wodurch der Compliance-Warnmechanismus ausgelöst wird. Die Benachrichtigung enthält außerdem die minimale übereinstimmende Rechtsnormnummer, den Ähnlichkeitswert und die Richtung der Divergenzanalyse, was für die Regulierungsbehörden ausreichen sollte, um umgehend zu handeln. Dieser Ansatz ermöglicht eine interpretierbare Abbildung von undurchsichtigen Entscheidungsprozessen in den Bereich der juristischen Semantik und erleichtert die Echtzeit-Compliance-Prüfung.
Während des kontinuierlichen Betriebs wird der Gewichtsänderungstrend der entscheidenden Rechts-Technologie-Verbindungskanten im Bias-Propagations-Teilgraphen verfolgt. Besonderes Augenmerk liegt auf den Kanten, die Algorithmusmodulknoten mit Rechtsklauselknoten verbinden, da sie direkt die Reaktionsstärke technischen Verhaltens auf bestimmte Vorschriften widerspiegeln. Die Parameter der Transformationsmatrix für jede Zielkante werden während der Inferenz aufgezeichnet, und ihre Norm wird als dynamischer Indikator für die Entwicklung der Korrelationsstärke zwischen beiden extrahiert. Die Kantenstärkesequenz wird definiert als:
 (11)
wt stellt die Frobenius-Norm der Gewichtungsmatrix dar, die der Beziehung zwischen der Kante eij zum Zeitpunkt t entspricht, und Wkl(t) ist die Parametermatrix, die im Modell zu diesem Zeitpunkt tatsächlich verwendet wird. Dieser Indikator spiegelt die Lernvertiefung des Modells oder seine Abhängigkeit von der legalen Einschränkung wider.
An der Sequenz wird ein Monotonietest mit gleitendem Fenster durchgeführt, und ein verbesserter Vorzeichentest wird verwendet, um zu bestimmen, ob ein signifikanter Aufwärtstrend vorliegt. Wenn die Zuwächse über N aufeinanderfolgende Zeitschritte die Bedingung der positiven Dominanz erfüllen, gilt die Kante als ein Phänomen abnormaler Verstärkung aufweisend. Unter zusätzlicher Einbeziehung historischer Daten zur Gradientenbeitragsanalyse wird ein Frühwarnverfahren für die akkumulierte systemische Verzerrung eingeleitet, falls die Kante in der vorherigen Runde der Quellenverfolgungsanalyse bereits als Pfad mit hoher Wirkung identifiziert wurde.
Abschließend wird ein Quellnachverfolgungsbericht erstellt, der Informationen über die Knoten an beiden Enden der Zielkante, Gewichtsänderungskurven, Statistiken zur Häufigkeit verwandter Entscheidungen sowie potenzielle Zuordnungsempfehlungen enthält. Dieser Mechanismus ermöglicht einen Sprung von der statischen Konformitätsbewertung hin zur dynamischen Risikovorhersage und unterstützt proaktive Eingriffe bei potenziellen institutionellen Abweichungen.
Experimentelle Daten und Versuchsdesign
Um die Wirksamkeit des vorgeschlagenen Frameworks zu überprüfen, konstruiert diese Arbeit einen multimodalen heterogenen Datensatz, der reale Vorschriften und Simulationsdaten integriert, und entwirft strenge Kontrollexperimente. Zu den Datenquellen zählen nationale Vorschriften zur medizinischen KI-Regulierung, klinische Behandlungsleitlinien, Open-Source-Berichte über Algorithmusprüfungen sowie Simulations-Entscheidungsprotokolle. Nach der Vorverarbeitung wird ein Benchmark-Heterogenes Wissensgraph mit 285 Knoten (85 rechtliche Bestimmungen, 120 medizinische Handlungen, 42 Algorithmusmodule und 38 verantwortliche Entitäten) und 1247 gerichteten Kanten erstellt, wie in Abbildung 3 dargestellt.
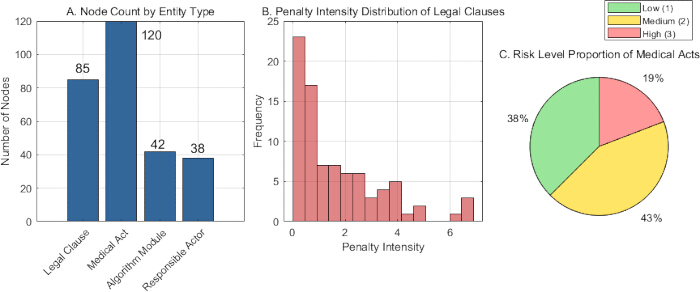
Abbildung 3: Verteilung und Merkmale heterogener Entitätstypen. (A) Balkendiagramm der Knotenanzahl pro Entitätstyp: rechtliche Klauseln (85), medizinische Verhaltensweisen (120), Algorithmusmodule (42), verantwortliche Parteien (38). (B) Histogramm der Sanktionsintensität für Knoten rechtlicher Klauseln, eingeteilt in die Kategorien niedrig (0‑0,33), mittel (0,34‑0,66) und hoch (0,67‑1,0); die vertikale Achse zeigt die Anzahl. (C) Kreisdiagramm der Verteilung der Risikoniveaus bei Knoten medizinischer Verhaltensweisen: niedrig (19 %), mittel (43 %), hoch (38 %). Alle Werte entsprechen absoluten Häufigkeiten oder Prozentangaben; Fehlerbalken sind nicht dargestellt, da es sich um deskriptive Statistiken des Datensatzes handelt. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Abbildung 3 veranschaulicht die Verteilung und Merkmale der Entitätsknoten im heterogenen Wissensgraphen. Abbildung 3A zeigt die Verteilung der Anzahl von vier Arten von Entitätsknoten, wobei „medizinische Verhaltensweisen“ die häufigsten Knoten sind (120), gefolgt von „rechtlichen Klauseln“ (85), während „Algorithmusmodule“ (42) und „verantwortliche Entitäten“ (38) vergleichsweise seltener vorkommen. Dies liegt daran, dass der Graph strukturell auf Verhalten und Regeln basierend konzipiert ist. Abbildung 3B stellt die Verteilung der Sanktionsintensitäten für Knoten dar, die eine eindeutige rechtliche Klausel repräsentieren, wobei die Intensität die Schwere der rechtlichen Haftung misst. Die Daten zeigen, dass es relativ wenige Bestimmungen mit hoher Sanktionsintensität gibt, während die meisten in einer mittleren bis niedrigen Intensitätsklasse liegen, was mit der Realität übereinstimmt, dass es in realen Rechtssystemen nur wenige Klauseln für schwere Verstöße gibt. Abbildung 3C veranschaulicht die Verteilung des Risikoniveaus bei Knoten medizinischer Verhaltensweisen, wobei Verhaltensweisen mit mittlerem Risiko den größten Anteil mit 43 % haben, während Verhaltensweisen mit niedrigem Risiko den geringsten Anteil mit 19 % aufweisen. Dies zeigt, dass medizinische Szenarien normalerweise ablaufen und dass hochriskante Abläufe im Graphen strengeren assoziativen Beschränkungen unterliegen. Diese Statistiken rechtfertigen gemeinsam das bei der Konstruktion des Wissensgraphen verwendete Kodierungsschema zur Entitätsdisambiguierung, um Merkmalunterstützung für die anschließende graphbasierte Faltungsalignmentierung bereitzustellen.
Der gesamte Datensatz wurde zufällig in Trainings- (70 %), Validierungs- (10 %) und Testmengen (20 %) aufgeteilt, wobei eine Schichtung nach Knotentyp und Relationsverteilung erfolgte, um die gesamte Graphstruktur in jeder Aufteilung beizubehalten. Dieselbe Aufteilung wurde für alle Baseline-Methoden konsistent verwendet, um einen fairen Vergleich zu gewährleisten. Zusätzlich zu dieser Grundaufteilung dienen die drei Dichte-Gradienten des Wissensgraphen (spärlich, mittel, dicht) und die drei grenzüberschreitenden Komplexitätseinstellungen (einseitig, bilateral, multilateral), die oben beschrieben wurden, als unabhängige praktische Testumgebungen, die gemeinsam die Robustheit der Methode unter wechselnden Bedingungen hinsichtlich Datenvervollständigung und regulatorischer Überlappung evaluieren. Zur Erstellung von Ground-Truth-Labels für die Evaluierung der Bias-Lokalisierung verfolgten wir eine zweistufige Strategie: (1) Expertenannotation – drei Rechts- und Medizinexperten prüften unabhängig voneinander die Entscheidungsprotokolle und identifizierten die Ursachenknoten und Ausbreitungspfade für jede dokumentierte Compliance-Verletzung, wobei Unstimmigkeiten durch Mehrheitsentscheidung aufgelöst wurden; (2) Simulierte Injektion – für kontrollierte Tests wurden künstlich Bias-Signale in 20 zufällig ausgewählte Entscheidungspfade eingefügt, indem die Kantengewichte im Wissensgraphen verändert wurden, wodurch sichergestellt wurde, dass die tatsächlichen Quellknoten und betroffenen Kanten a priori bekannt waren.
Für alle Basismethoden (TransE, ComplEx, Graph Neural Networks (GNN) Explainer, KG-BERT und Node2Vec) verwendeten wir dieselbe Trainingskonfiguration (Adam-Optimierer, Lernrate 1 × 10⁻³, Batch-Größe 64, 100 Epochen) und dieselben Datenaufteilungen wie bei unserer Methode, um einen fairen Vergleich zu gewährleisten. Bei TransE und ComplEx wurde die Einbettungsdimension auf 256 mit einem Margin von 1,0 festgelegt; bei KG-BERT nutzten wir das vortrainierte BERT-base-Modell mit einer Batch-Größe von 16 und einer maximalen Sequenzlänge von 128; bei GNNExplainer verwendeten wir einen dreischichtigen GCN mit derselben verborgenen Dimension von 256; und bei Node2Vec setzten wir die Walk-Länge auf 80, die Anzahl der Walks pro Knoten auf 10 und die Einbettungsdimension auf 256.
Um einen fairen Vergleich sicherzustellen, haben wir alle Basisverfahren an dieselben Aufgaben zur Lokalisierung von Bias angepasst, und zwar an die Identifizierung von Wurzelknoten und die Rekonstruktion von Ausbreitungspfaden. Bei TransE, ComplEx und Node2Vec, die von Natur aus nicht erklärbar sind, berechneten wir den Gradienten des Bias-Verlusts in Bezug auf das Embedding jedes Knotens und verwendeten den Betrag des Gradienten als Wichtigkeitsscore für den Knoten; Wurzelknoten wurden durch Schwellenwertbildung dieser Scores ausgewählt, und die Ausbreitungspfade wurden rekonstruiert, indem Kanten mit den höchsten Gradientenbeiträgen beibehalten wurden. Bei GNNExplainer nutzten wir direkt dessen integrierte Mechanismen zur Kantenwichtigkeit und Knotenmaske, um sowohl Wurzelknoten als auch Teilgraphen zu erhalten. Bei KG-BERT, das auf Tripeln operiert, wandelten wir jede Graphkante in ein textuelles Tripel um und verwendeten die Aufmerksamkeitsgewichte des Modells über den Entitäten, um die Knotenwichtigkeit abzuleiten, gefolgt von derselben Schwellenwertstrategie zur Pfadrekonstruktion. Durch diese Anpassungen liefern alle Basisverfahren sowohl Vorhersagen für Wurzelknoten als auch für Ausbreitungspfade, was eine einheitliche Bewertung aller Verfahren ermöglicht.
Die Bewertung konzentriert sich auf vier grundlegende Fähigkeiten: Genauigkeit der semantischen Ausrichtung, Fähigkeit zur Lokalisierung von Verzerrungen, Effizienz der Verantwortlichkeit und Verallgemeinerungsfähigkeit über verschiedene Bereiche hinweg. Außerdem werden drei wichtige Kontrollvariablen eingeführt, die die Komplexität der realen Welt widerspiegeln.
1) Dichtegradient des Wissensgraphen: Um zu bewerten, wie sich die Methode bei unterschiedlichen Vollständigkeitsgraden der Information verhält, werden zwei Teilmengen aus dem vollständigen Basisgraphen (Dichte D = 1,0) basierend auf einer zufälligen Kantenlöschstrategie wie folgt erstellt:
Dünner Graph (D ~ 0,3): 30 % der Kanten werden zufällig beibehalten, was dem Stadium des frühen Wissensaufbaus mit vielen fehlenden Informationen entspricht.
Graph mit mittlerer Dichte (D ~ 0,6): 60 % der Kanten werden zufällig beibehalten, was einem typischen Szenario einer teilweise bekannten Wissensstruktur entspricht.
Dichter Graph (D = 1,0): Verwendung aller 1247 Kanten, was einem Best-Case-Szenario einer relativ vollständigen Kenntnis entspricht.
2) Situation der Entscheidungshäufigkeit bei medizinischer KI: Es werden drei künstliche Entscheidungsflüsse festgelegt, um die Echtzeitleistung der dynamischen Compliance-Überwachung zu testen:
Niedrige Frequenz 10 Hz: Im Durchschnitt werden 10 Entscheidungsereignisse pro Sekunde erzeugt, was der Überwachung von kleineren oder Einzelstandort-Systemen entspricht.
Mittlere Frequenz 50 Hz: 50 Entscheidungsereignisse pro Sekunde zur Simulation der KI-Systemlast regionaler oder mittelgroßer medizinischer Einrichtungen.
Hohe Frequenz von 100 Hz: 100 Entscheidungsereignisse pro Sekunde simulieren Szenarien mit hohem Parallelitätsdruck für KI-Dienste, die in einem großen Krankenhaus oder auf einer Cloud-Plattform bereitgestellt werden.
3) Querjurisdiktionaler Komplexitätsgradient: Um die Übertragbarkeit der Modellierung rechtlicher Einschränkungen zu testen, wurden drei testbasierte Komplexitätsstufen konstruiert:
Einzelne Rechtsordnung: Umfasst ausschließlich die geltenden chinesischen Gesetze und Vorschriften zur Regulierung von medizinischer KI.
Bilaterale Zuständigkeit: Beinhaltet die regulatorischen Systeme von China und der Europäischen Union, wobei etwa 15 % der Vorschriften widersprüchlich und überlappend sind.
Multilaterale Zuständigkeit: Aufbauend auf den ersten beiden integriert es zudem Datenschutz- und Sicherheitsvorschriften des US-amerikanischen HIPAA (Health Insurance Portability and Accountability Act), wodurch ein Testumfeld entsteht, in dem die Rechtssysteme der drei Rechtsordnungen miteinander verflochten sind und die Regelkonfliktrate auf etwa 25 % ansteigt.
Die folgenden Schlüsselindikatoren wurden für die quantitative Bewertung verwendet:
1) Genauigkeit der semantischen Ausrichtung: Misst die Fähigkeit des Graphen, die Beziehungen zwischen rechtlichen und technischen Entitäten abzubilden.
Genauigkeit der Entitätsausrichtung:
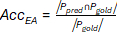 (12)
Ppred ist die Menge der vom Modell vorhergesagten ausgerichteten Entitätspaare, und Pgold ist die Menge der von Experten annotierten goldenen Ausrichtungen.
Integrität der Erhaltung von Beziehungen:
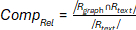 (13)
Rgraph ist die rekonstruierte Menge von Beziehungen im Graphen, und Rtext ist die Menge der expliziten Beziehungen, die aus dem ursprünglichen juristischen Text extrahiert wurden.
2) Fähigkeit zur Lokalisierung von Bias: Bewertung der Wirksamkeit bei der Rückverfolgung der Ursachen und Ausbreitungswege von Bias.
Erinnerungsrate der Wurzelknoten:
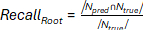 (14)
Npred ist die Menge der vom Modell identifizierten Bias-Quellknoten, und Ntrue ist die Menge der von Experten gekennzeichneten tatsächlichen Quellknoten.
Genauigkeit der Ausbreitungsstrecke:
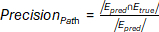 (15)
Epred ist die Kantenmenge im durch das Modell inferierten Bias-Propagations-Teilgraphen, und Etrue ist die tatsächliche Kantenmenge der Bias-Propagations.
3) Effizienz der Rückverfolgbarkeit: Testen Sie die Leistung des Systems in Echtzeit-Überwachungsszenarien.
Durchschnittliche Latenzzeit der Verfolgung:
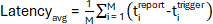 (16)
M steht für die Gesamtanzahl der Anfragen, und titrigger sowie tireport sind die Zeitstempel des i-ten Bias-Triggers und der Erstellung des Quellenberichts, respectively.
Systemdurchsatz:
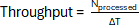 (17)
Nprocessed steht für die Anzahl gleichzeitiger Verfolgungsanfragen, die innerhalb des Zeitfensters ΔT erfolgreich verarbeitet wurden.
4) Fähigkeit zur Übertragung auf andere Domänen: Überprüfung der Anpassungsfähigkeit der Methode an verschiedene Rechtssysteme.
Räumliche Zuständigkeit:
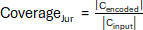 (18)
Cencoded steht für die Anzahl der verschiedenen juristischen Klauseln, die erfolgreich in den Graphen codiert wurden, und Cinput steht für die Gesamtanzahl der Eingabeklauseln.
Erkennungsrate von Zwangsbedingungs-Konflikten:
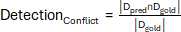 (19)
Dpred ist die Menge der vom Modell erkannten zulässigen logischen Widersprüche, und Dgold ist die Menge aller von Experten annotierten Widerspruchspaare.
Alle Experimente wurden an einer Workstation mit einem Multicore-Prozessor und einer Grafikverarbeitungseinheit durchgeführt; die vollständigen Hardware-Spezifikationen sind in der Tabelle der Materialien angegeben.
Die wichtigsten Hyperparameter dieses Ansatzes und ihre Werte sind in Tabelle 1 aufgeführt und umfassen die Modellstruktur und Trainingskonfiguration sowie entscheidende Schwellenwerte wie Einbettungsdimension, Anzahl der Faltungsschichten, Lernrate und Batch-Größe. Alle Parameter wurden anhand des Validierungssets mittels Gittersuche optimiert, das trainierte Modell hat stabil konvergiert, und die Leistung ist optimal. Einige Schwellenwerte wurden gemeinsam mit fachlichen Kriterien festgelegt, um die Anforderungen an die hohe Zuverlässigkeit der medizinischen KI-Konformitätsprüfung zu erfüllen.
| Parameter | Wert | Beschreibung |
| Einbettungsdimension | 128 | Größe der Merkmalsdimension für Knoteneinbettungen |
| Anzahl der Faltungsschichten | 3 | Tiefe des relationserkennenden Graph-Faltungssnetzes |
| Lernrate | 0.001 | Anfängliche Lernrate für den Adam-Optimierer |
| Stapelgröße | 32 | Anzahl der pro Batch verarbeiteten Teilgraphen |
| Abbruchrate | 0.1 | Ausschaltwahrscheinlichkeit, die während des Trainings auf Knotenmerkmale angewendet wird |
| Anzahl der Attention-Heads | 8 | Anzahl der Köpfe im Multi-Head-Attention-Mechanismus |
| L2-Regularisierungskoeffizient | 5 × 10⁻⁴ | Koeffizient für die Gewichtsregularisierung |
| Ähnlichkeitsschwelle | 0.75 | Minimale Einbettungsähnlichkeit zur Überprüfung der Konformität |
| Schwellenwert für den Gradientbeitrag | 0.01 | Schwellenwert zur Auswahl von Kanten mit hohem Einfluss bei der Konstruktion von Bias-Subgraphen |
| Überwachungsfenstergröße | 10 | Zeitschritte zur Verfolgung der Dynamik der Kantengewichte |
Tabelle 1: Hauptparameter-Einstellungen. Liste der wichtigsten Hyperparameter, die in den Experimenten verwendet wurden: Einbettungsdimension (256), Anzahl der GCN-Schichten (3), verborgene Dimension (256), Lernrate (1 × 10⁻³), Batch-Größe (64), Dimension des Aufmerksamkeitsvektors, Schwellwert für Kantenbeitrag (85. Perzentil der Gradientenbeträge), dynamischer Konformitätsschwellwert (µ‑2σ, wobei µ und σ aus dem Validierungsset von 500 konformen Instanzen stammen), Anzahl der Communities K (bestimmt durch spektrales Clustering) und Optimierer (Adam). Diese Werte wurden mittels Gittersuche auf dem Validierungsset ausgewählt.
Ergebnisse
Leistungsüberprüfung der Verzerrungsursprungsrückverfolgung im medizinischen KI-Rechts-Wissensgraphen
Leistung der beziehungsorientierten Graph-Faltung
Durch das Training eines relationsempfindlichen Graph-Convolutional-Networks wurden die Ähnlichkeiten der Einbettungen zwischen juristischen Klauseln und Knoten medizinischen Verhaltens über verschiedene Faltungsschichten hinweg berechnet und der Alignierungseffekt jeder Schicht erfasst. Zweitens wurden die nach dem Training zugewiesenen Attention-Gewichte für die vier juristischen semantischen Beziehungen statistisch analysiert, um die Bedeutung jedes Beziehungstyps bei der Merkmalsaggregation zu quantifizieren. Schließlich wurde das Abklingverhalten des Einflusses benachbarter Knoten mit zunehmender Distanz untersucht. Durch die Berechnung der Beiträge von Knoten mit unterschiedlichen Sprungdistanzen zur Merkmalsaktualisierung des zentralen Knotens wurde die Stärke der Einflussausbreitung quantifiziert und die effektive Reichweite des Message-Passing-Mechanismus bewertet. Der gesamte Evaluierungsprozess basierte auf der quantitativen Analyse der internen Parameter und Aktivierungszustände des Modells, um Objektivität und Reproduzierbarkeit der Ergebnisse sicherzustellen.
Abbildung 4 veranschaulicht die Leistungsfähigkeit von relationsempfindlichen Graph-Convolutional-Networks bei der multimodalen semantischen Zuordnung im juristischen Bereich. Abbildung 4A zeigt den Trend der Ähnlichkeit von Knoteneinbettungen, während die Anzahl der konvolutionellen Schichten zunimmt, wobei diese sich schrittweise von 0,12 in Schicht 1 auf 0,68 in Schicht 4 erhöht. Dieser fortschreitende Verlauf resultiert aus dem allmählichen Zusammenbestehen des Raums der juristischen Klauseln und des Raums medizinischen Handelns entlang des mehrschichtigen Nachrichtenaustauschs. Die tieferen konvolutionellen Schichten können die komplexen Muster multimodaler semantischer Assoziationen lernen. Die Relation „Verstoß“ erhält in Abbildung 4B, die die Verteilung der Aufmerksamkeitsgewichte für vier Arten juristischer semantischer Relationen zeigt, das höchste Gewicht von 0,35. Dies entspricht den zugrundeliegenden Prinzipien der Analyse juristischer Konformität, da das Modell Assoziationen mit Verstößen besonders berücksichtigt, um eine fundierte Risikosteuerung zu ermöglichen. Abbildung 4C zeigt das Muster der mehrstufigen Einflussakkumulation benachbarter Knoten. Die gemessene Einflussstärke steigt monoton von 0,15 bei 1 Hop auf 0,92 bei 8 Hops an, was darauf hinweist, dass die Einbettung des zentralen Knotens schrittweise umfassendere strukturelle Informationen von entfernteren Knoten integriert. Dieser unerwartete Anstieg erfasst tatsächlich die indirekte Abhängigkeit zentraler Knoten von entfernten Knoten. Wenn Knoten über größere Hop-Distanzen betrachtet werden, können sie zwar mehr globale strukturelle Informationen erhalten, jedoch auch mehr Rauschen und redundante Informationen. Daher ist es in praktischen Anwendungen notwendig, einen Kompromiss zwischen der Größe des Rezeptionsfelds und der Informationsqualität zu finden. Die gesamte Datenverarbeitung zeigte, dass der relationsempfindliche Mechanismus effektiv bei der Behandlung der Verbindungen zwischen heterogenen juristischen Texten und technologischen Handlungen ist und dass die juristischen Semantiken mittels eines differenzierten Argumentdesigns präzise modelliert werden können.
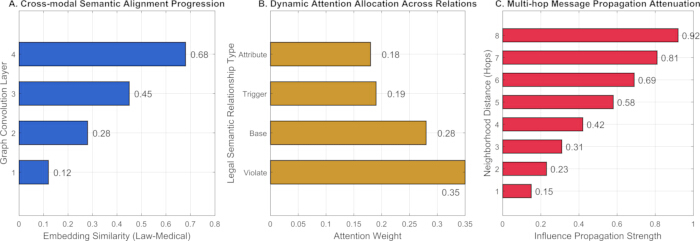
Abbildung 4: Leistung der semantischen Quermodalitätsausrichtung des relationsbewussten Graph Convolutional Network.(A) Ähnlichkeit der Knoteneinbettungen (Kosinusähnlichkeit) in Abhängigkeit von der Anzahl der GCN-Schichten (1 bis 4), die eine zunehmende Ausrichtung zwischen juristischen und medizinischen Verhaltensräumen zeigt. (B) Verteilung der Aufmerksamkeitsgewichte auf die vier Relationstypen (Verstoß, Grundlage, Auslöser, Zuschreibung), wobei Verstoß das höchste Gewicht (0,35) erhält. (C) Einflussstärke benachbarter Knoten in Abhängigkeit von der Hop-Distanz (1 bis 8), zur Quantifizierung, wie sich strukturelle Informationen über mehrere Hops hinweg ansammeln. Alle Werte wurden über 30 unabhängige Durchläufe gemittelt; Fehlerbalken (der Übersichtlichkeit halber nicht dargestellt) lagen in allen Fällen unter einer Standardabweichung von 0,05, und die Trends sind monoton. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Um den Parameter-Optimierungsprozess und die Leistungsmerkmale verschiedener Arten rechtlicher semantischer Beziehungen im relationsempfindlichen Graph-Convolutional-Network zu verstehen, wurde die mittlere Größe der Gewichtungsmatrix für jeden Beziehungstyp durch Parameteroptimierung berechnet, und es wurde bestätigt, dass das Parameterlernen durch Backpropagation konvergierte. Zur Bewertung der Qualität der Merkmalsaggregation wurde die Kosinusähnlichkeit verwendet, um die Konsistenz der knoteninternen Einbettungen über verschiedene Typen hinweg zu prüfen. Die Konvergenzrate wurde anhand des Rückgangs der Verlustfunktion in jeder Trainingsrunde berechnet, um sicherzustellen, dass jeder Beziehungstyp während des Trainings stabil blieb. Die Stabilität der Aufmerksamkeitsmechanismen wurde durch Berechnung der Standardabweichung der Aufmerksamkeitsgewichte in verschiedenen Trainingsphasen bewertet. Metriken zur rechnerischen Effizienz wurden anhand der Anzahl der Gleitkommaoperationen standardisiert, um Vergleiche unter gleichen Bedingungen zu ermöglichen. Alle Metriken wurden 30-mal auf demselben Testdatensatz mit unterschiedlichen Zufallszahlen durchgeführt, um statistische Signifikanz sicherzustellen. Für paarweise Vergleiche zwischen unserer Methode und jeder Baseline führten wir gepaarte t-Tests mit 29 Freiheitsgraden durch.
Abbildung 5 veranschaulicht die Auswirkungen der Parameteroptimierung und die Leistungsmerkmale verschiedener rechtlicher semantischer Beziehungen im relationsempfindlichen Graphen-Faltungsnetzwerk. Abbildung 5A zeigt die Größenverteilung der dedizierten Gewichtsmatrizen für die vier Beziehungstypen, wobei die vertikale Achse den Beziehungstyp und die horizontale Achse die Größenwerte der erlernten Parametermatrizen darstellt. Die Beziehung „Verstoß“ erreicht den höchsten Größenwert von 0,78, was darauf hinweist, dass dieser semantische Typ das Modell dominiert und den Schwerpunkt der Rechtskonformitätsanalyse auf die Identifizierung von Verstößen widerspiegelt. Abbildung 5B vergleicht die Bewertungen der Merkmalsaggregation unter verschiedenen Beziehungstypen, wobei die vertikale Achse den Beziehungstyp und die horizontale Achse die Bewertung der Aggregationseffizienz darstellt. Es zeigt sich, dass die Beziehung „Verstoß“ auch bei der Qualität der Merkmalsfusion am besten abschneidet (0,89). Abbildung 5C zeigt die Konvergenzratenleistung verschiedener Beziehungen, wobei die vertikale Achse den Beziehungstyp und die horizontale Achse die Verlustreduktionsrate pro Trainingsrunde darstellt. Die Werte in Reihenfolge lauten: Verstoß, Basis, Auslöser und Zuschreibung: 0,023, 0,031, 0,028 und 0,035. Das Ergebnis ist, dass die Beziehung „Zuschreibung“ langsamer konvergiert, aber stabil bleibt. Abbildung 5D zeigt die Varianz der Aufmerksamkeitsgewichte über drei Trainingsphasen hinweg. Die y-Achse repräsentiert die Trainingsphase (früh, mittel und spät), und die x-Achse zeigt von links nach rechts die Varianz der Aufmerksamkeitsgewichte. Die entsprechenden Zahlen lauten 0,18 (früh), 0,12 (mittel) und 0,08 (spät) und deuten darauf hin, dass das Modell im Laufe des Trainings seine Fokussierung auf bedeutende Beziehungen schrittweise stabilisiert. Abbildung 5E zeigt den Kompromiss hinsichtlich der Recheneffizienz für verschiedene Beziehungen. Die y-Achse entspricht dem Beziehungstyp, während die x-Achse die normalisierte Ausführungszeit darstellt, definiert als der Verbrauch an Rechenressourcen zur Erledigung der jeweiligen Aufgabe. Die Zahlen lauten 0,42 (Verstoß), 0,39 (Basis), 0,43 (Auslöser) und 0,38 (Zuschreibung). Die Verteilung zwischen den Klassen ist ausgewogen, was darauf hindeutet, dass der relationsempfindliche Mechanismus eine gute Ressourcenallokation ermöglicht, ohne die Leistung zu beeinträchtigen.
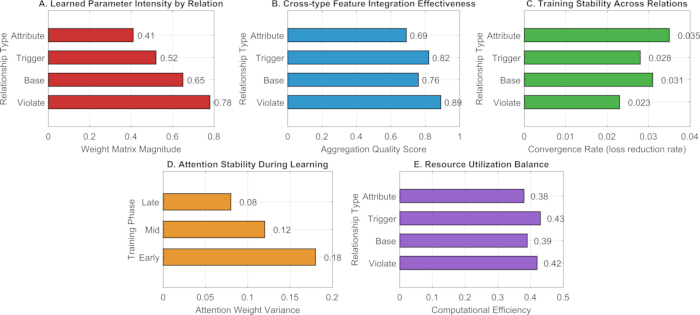
Abbildung 5: Optimierung der Faltungparameter und Leistungsanalyse des relationsbewussten Graphen. (A) Betrag (Frobenius-Norm) der spezifischen Gewichtungsmatrizen für jeden Relationstyp. (B) Qualitätsscore der Merkmalsaggregation (Kosinus-Ähnlichkeitskonsistenz) pro Relationstyp. (C) Konvergenzrate (Verlustreduktion pro Trainingsepisode) pro Relationstyp. (D) Varianz der Aufmerksamkeitsgewichte in frühen, mittleren und späten Trainingsphasen, was eine Stabilisierung zeigt. (E) Normalisierte Ausführungszeit (relative Rechenkosten) pro Relationstyp. Alle Metriken basieren auf dem Mittelwert von 30 Durchläufen; Fehlerbalken zeigen die Standardabweichung (soweit sichtbar). Die Verletzungsrelation weist den höchsten Betrag und die höchste Aggregationsqualität auf, während die Attributionsrelation langsamer konvergiert, aber stabil bleibt. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
Genauigkeit der semantischen Ausrichtung
Die Genauigkeit der Entitätsausrichtung und die Integrität der Beziehungserhaltung werden als zentrale Indikatoren verwendet. Unter den Bedingungen des Dichte-Gradienten des Wissensgraphen (spärlich/mittel/dicht) wird die vorgeschlagene Methode mit TransE, ComplEx, GNNExplainer, KG-BERT und Node2Vec verglichen. Alle Methoden werden 30-mal ausgeführt, und der Mittelwert sowie die Standardabweichung werden ermittelt, um den Einfluss von Zufälligkeit auszuschließen.
Abbildung 6 zeigt den Leistungsvergleich der vorgeschlagenen Methode mit mehreren Benchmark-Methoden bei unterschiedlichen Dichten von Wissensgraphen hinsichtlich der Genauigkeit der Entitätsausrichtung und der Integrität der Beziehungserhaltung, zwei zentralen Metriken. In Abbildungen 6A und 6B steht die horizontale Achse für verschiedene Methoden und die vertikale Achse repräsentiert jeweils die Genauigkeit der Entitätsausrichtung und die Integrität der Beziehungserhaltung.
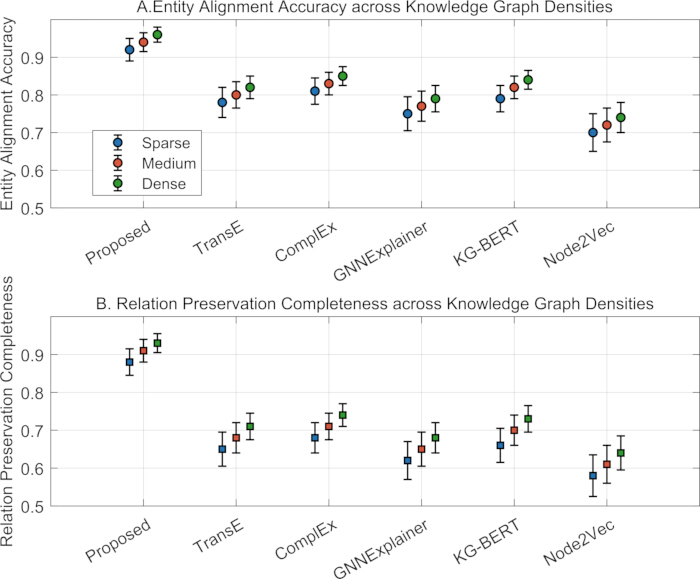
Abbildung 6: Semantische Ausrichtungsleistung bei unterschiedlichen Graphdichten. (A) Genauigkeit der Entitätsausrichtung (Gleichung 12) und (B) Integrität der Beibehaltung von Beziehungen (Gleichung 13) im Vergleich der vorgeschlagenen Methode mit TransE, ComplEx, GNNExplainer, KG‑BERT und Node2Vec. Die Balkenhöhen zeigen die Mittelwerte über 30 Durchläufe an; Fehlerbalken repräsentieren die Standardabweichung. Die vorgeschlagene Methode erreicht bei allen Dichten mindestens eine Genauigkeit von 0,92 und eine Integrität von 0,88 und übertrifft damit alle Vergleichsmethoden. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Aus Sicht der Genauigkeit der Entitätenzuordnung erzielt die vorgeschlagene Methode unter verschiedenen Dichtebedingungen hervorragende Ergebnisse, wobei die durchschnittliche Genauigkeit der Entitätenzuordnung nicht unter 0,92 liegt und insbesondere bei dichten Graphen das höchste Niveau erreicht. Dies zeigt, dass das konstruierte relationsempfindliche Graph-Convolutional-Netzwerk die semantischen Assoziationen zwischen heterogenen Knoten effektiv erfassen kann und durch kantentypspezifische Gewichtungen und Attention-Mechanismen eine effektive Zuordnung der multimodalen Merkmale erreicht. Im Gegensatz dazu schneiden traditionelle Methoden, insbesondere TransE und Node2Vec, aufgrund des Fehlens einer expliziten Modellierung rechtlicher semantischer Relationen schlechter ab. Die Überlegenheit des vorgeschlagenen Ansatzes wird auch durch die Ergebnisse zur Integrität der Relationserhaltung bestätigt, wobei die durchschnittliche Integrität der Relationserhaltung nicht unter 0,88 liegt. Dies weist darauf hin, dass der Ansatz in der Lage ist, die expliziten Relationen im ursprünglichen rechtlichen Text bei unterschiedlichen Graphdichten gut zu rekonstruieren. Diese robuste Leistung beruht auf der kodierten heterogenen Graphstruktur und dem mehrschichtigen Nachrichtenübertragungsansatz, die die komplexen Beziehungen zwischen rechtlichen Klauseln, medizinischen Handlungen, algorithmischen Modulen und verantwortlichen Akteuren umfassend erfassen. Während GNNExplainer und KG-BERT gewisse Fähigkeiten zur Modellierung von Relationen aufweisen, sind beide bei der Anwendung auf normative Semantik im Recht eingeschränkt, sodass ihre Leistung hinter der des vorgeschlagenen Verfahrens zurückbleibt.
Vergleich der Fähigkeiten zur Lokalisierung von Bias
Die Bewertung der Bias-Lokalisierung erfolgt über einen zweistufigen kollaborativen Verifizierungsansatz, der auf der Faktenerinnerung an Ursachenknoten und der Präzision der Ausbreitungspfade basiert und somit die Vollständigkeit der Quellverfolgung sowie die Genauigkeit der Pfade berücksichtigt. Alle Vergleichsmethoden werden auf derselben Graphstruktur-Eingabe unter Verwendung desselben Bias-Simulationsinjektionsprotokolls und derselben Evaluierungsschnittstellendefinition durchgeführt, um einen fairen Vergleich zu gewährleisten. Jedes Experiment wird 30-mal mit unterschiedlichen Zufallszahlen wiederholt, um zufällige Schwankungen zu minimieren. Die Ergebnisse werden als Mittelwert ± Standardabweichung angegeben, und gepaarte t-Tests werden verwendet, um die p-Werte (gegenüber der in dieser Arbeit vorgestellten Methode) zu bestimmen, was die statistische Aussagekraft und Vergleichbarkeit der Bewertungsschlussfolgerungen sicherstellt. Die p-Werte werden aus gepaarten t-Tests mit 29 Freiheitsgraden (basierend auf 30 unabhängigen Durchläufen) abgeleitet. Die t-Statistiken für den Vergleich unserer Methode mit den jeweiligen Baseline-Methoden liegen zwischen 7,82 und 12,45 und entsprechen den angegebenen p-Werten.
Tabelle 2 zeigt die Ergebnisse der quantitativen Bewertung der Fähigkeit verschiedener Methoden zur Lokalisierung von Bias, gemessen an zwei zentralen Leistungsindikatoren: dem Recall der Wurzelknoten und der Präzision des Ausbreitungspfads. Hinsichtlich des Recall der Wurzelknoten schneidet die vorgeschlagene Methode deutlich besser ab als alle Baseline-Verfahren und erreicht einen maximalen Recall von 0,95 ±± 0,02, was signifikant über dem zweitbesten Verfahren GNNExplainer (0,82 ±± 0,03) liegt und deutlich besser ist als bei den übrigen Methoden. Dieser Vorteil ist auf den in dieser Arbeit vorgeschlagenen gradientenbasierten Quantifizierungsmechanismus zurückzuführen, der den Ausbreitungspfad von Bias-Signalen im Graphen präzise verfolgen und die am stärksten beitragenden Quellknoten effektiv identifizieren kann. Im Gegensatz dazu erzielen die klassischen Ansätze TransE und Node2Vec, die keine Möglichkeit besitzen, semantische Unterschiede zwischen Kantentypen zu erfassen und daher Ausbreitungspfade von Bias nicht klar von regulären Beziehungen unterscheiden können, lediglich Recall-Werte von 0,75 ±± 0,04 bzw. 0,72 ±± 0,05. Obwohl KG-BERT ein vortrainiertes Sprachmodell verwendet, ist es in Bezug auf den Informationsfluss innerhalb der Graphstruktur eingeschränkt und erreicht einen Recall-Wert von 0,70 ±± 0,04.
| Methode | Rückruf der Wurzelknoten | p-Wert (Rückruf der Wurzelknoten) | Präzision des Ausbreitungspfads | p-Wert (Präzision des Ausbreitungspfads) |
| Vorgeschlagen | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
Tabelle 2: Rückrufrate der Wurzelknoten und Präzisionsrate des Ausbreitungspfads. Leistungsvergleich zur Bias-Lokalisierung über alle Methoden hinweg. Die Werte sind als Mittelwert ± Standardabweichung über 30 unabhängige Durchläufe angegeben. Die Rückrufrate des Wurzelknotens (Gleichung 14) und die Präzision des Ausbreitungspfads (Gleichung 15) sind dargestellt. Die vorgeschlagene Methode erreicht die höchste Rückrufquote (0,95 ± 0,02) und Präzision (0,93 ± 0,03) und übertrifft damit signifikant die Baseline-Methoden (gepaarter t-Test, p < 0,001 für alle Vergleiche).
Diese Methode ist auch hinsichtlich der Genauigkeit des Ausbreitungspfads am besten mit einem Wert von 0,93 ± 0,03 und übertrifft damit andere Methoden. Dies beweist, dass die von ihr vorgeschlagene Teilgraph-Rückverfolgungsprozedur erfolgreich geräuschbehaftete Kanten eliminieren und den tatsächlichen Bias-Ausbreitungspfad identifizieren kann. Die p-Wert-Analyse untermauert die signifikanten Leistungsunterschiede; alle Baseline-Methoden weisen äußerst signifikante Unterschiede zur vorgeschlagenen Methode auf (p < 0,001), was die Robustheit und Wirksamkeit der vorgeschlagenen Methode beim Problem der Bias-Lokalisierung sicherstellt. Die vergleichsweise starke Leistung von ComplEx und GNNExplainer könnte auf die Bedeutung komplexer Beziehungsstrukturen und der Erklärbarkeit von Graph-Neuronalen-Netzwerken bei der Erkennung von Bias hinweisen, doch halten sie dem End-to-End-Ansatz, der in dieser Arbeit vorgestellt wird, nicht stand.
Auswertung der Effizienz der Rückverfolgbarkeit von Verantwortlichkeiten
Die Bewertung erfolgt anhand der Echtzeitreaktion des Verantwortungsverfolgungssystems, wobei die durchschnittliche Verfolgungslatenz und der Durchsatz gleichzeitiger Anfragen als die beiden wichtigsten Effizienzindikatoren dienen. Experimente wurden bei drei Frequenzen medizinischer KI-Entscheidungsfindung (niedrige Frequenz, mittlere Frequenz und hohe Frequenz) durchgeführt. Zu einem fairen Vergleich erhielten alle Ansätze denselben Eingabestrom und führten das gesamte Verfolgungsverfahren durch.
Abbildung 7 vergleicht die Effizienz der Verantwortungsverfolgung zwischen verschiedenen Methoden bei unterschiedlichen Frequenzen medizinischer KI-Entscheidungen. Die Ergebnisse beziehen sich auf die von links nach rechts betrachteten Methoden: Die Linien sind als niedrige, mittlere und hohe Frequenz medizinischer KI-Entscheidungen beschriftet.
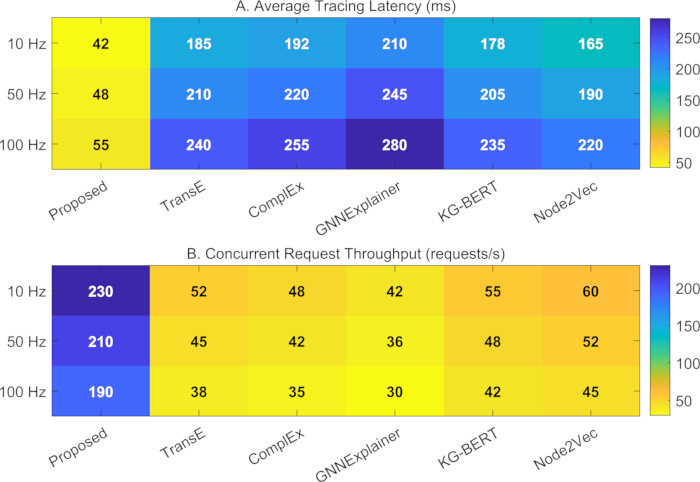
Abbildung 7: Durchschnittliche Latenzzeit der Quellverfolgung und Durchsatz bei gleichzeitiger Anfrageverarbeitung. (A) Durchschnittliche Latenzzeit (ms) pro Methode; (B) Durchsatz (Anfragen/Sekunde) pro Methode. Linien verbinden die Mittelwerte aus 30 Durchläufen; Fehlerbalken (falls dargestellt) zeigen die Standardabweichung. Die vorgeschlagene Methode weist bei allen Frequenzen die niedrigste Latenz (42–55 ms) und den höchsten Durchsatz (190–230 Anfragen/Sekunde) auf und zeigt somit eine überlegene Echtzeit-Performance. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
Was die durchschnittliche Ablaufverzögerung betrifft, so gilt auch hier unter allen Frequenzbedingungen, dass unsere vorgeschlagene Methode die beste ist, und außerdem weisen alle anderen Verfahren eine deutlich höhere Latenz als unseres auf. Alle Methoden weisen eine Ablaufverzögerung auf, die im Allgemeinen mit der Entscheidungshäufigkeit ansteigt, doch das Wachstum bei unserem Verfahren ist gleichmäßig: 42 Millisekunden bei niedriger Frequenz und 55 Millisekunden bei hoher Frequenz. Dieser Vorteil ergibt sich daraus, dass es sich bei dieser Methode um ein bewusst-relational basiertes Graph-Convolutional-Network handelt, das unterschiedlichen Arten rechtlicher semantischer Beziehungen verschiedene Gewichtungsmatrizen zuweist, um den rechentechnischen Overhead zu vermeiden, der bei klassischen Ansätzen durch das Teilen allgemeiner Parameter unter hoher Parallelität entsteht. Im Gegensatz dazu verschlechtern sich TransE und ComplEx, die auf Tensorzerlegung basieren, bei hohen Frequenzen drastisch. Sie können die nichtlineare Transformation von Wechselwirkungen über große Distanzen zwischen rechtlich-technischen Beziehungen nicht effizient verarbeiten, was zu höherer Latenz führt. Hinsichtlich der Zeit für Anforderungspaare schneidet auch hier die in dieser Arbeit vorgestellte Methode besser ab. Unter niedriger Frequenz erreicht ihr Durchsatz 230 Anfragen/Sekunde, was deutlich über den anderen Ansätzen liegt. Mit steigender Frequenz sinkt der Durchsatz, doch der Rückgang bleibt kontrollierbar, sodass selbst im Hochfrequenzszenario noch immer ein Durchsatz von 190 Anfragen/Sekunde erreicht wird. Diese Robustheit ist auf die temporäre Knoteneinbettungsstrategie und das gradientenbasierte, pfadparallele Backpropagation-Design dieses Ansatzes zurückzuführen, die gleichzeitig die Genauigkeit der Batch-Ablaufverfolgung sicherstellen und Anfragen effizient im Batch verarbeiten können. Allgemeine Ansätze, die nicht speziell optimiert sind, verschlechtern sich signifikant in der Leistung, sobald sie gleichzeitigen Abfragen gegenüberstehen, und sind daher für die Echtzeitüberwachung ungeeignet.
Überprüfung der Fähigkeit zur Übertragung über Domänen hinweg bei der Abdeckung rechtlicher Einschränkungen
Das Bewertungsverfahren wird aus der Perspektive der über Domänen hinweg bestehenden Fähigkeit zur Modellierung rechtlicher Einschränkungen durchgeführt, wobei die beiden Indikatoren zur Quantifizierung die gerichtliche Zuständigkeit und die Erkennungsrate von Regelungskonflikten sind. Für das Experiment wurden drei Arten übergerichtlicher Komplexität konzipiert, nämlich einseitige Zuständigkeit, beidseitige Zuständigkeit und mehrseitige Zuständigkeit. Um Bewertungsverzerrungen, die durch architektonische Unterschiede entstehen, auszuschließen, werden alle vergleichbaren Methoden 30-mal wiederholt und die durchschnittlichen Ergebnisse zur fairen Beurteilung der Verallgemeinerungsfähigkeit berichtet.
Wie in Tabelle 3 gezeigt, erzielt dieser Ansatz in drei Szenarien mit unterschiedlicher Komplexität rechtlicher Zuständigkeiten durchgängig bessere Ergebnisse als alle Baseline-Methoden, wobei der Leistungsabfall zudem geringer ausfällt. Er ermöglicht eine Konflikterkennungsrate von nahezu 89 % bei einem Rechtsabdeckungsgrad von 94 % in einem Szenario mit nur einer rechtlichen Zuständigkeit. Bei Verallgemeinerung auf mehrseitige rechtliche Zuständigkeiten bietet er immer noch eine Abdeckung von 87 % bei einer Konflikterkennungsrate von 81 %. Im Vergleich dazu weisen traditionelle Einbettungsmethoden (z. B. TransE und Node2Vec) in mehrseitigen Umgebungen einen Rückgang der Abdeckung auf etwa 60 % auf sowie generell niedrigere Konflikterkennungsraten, was darauf hindeutet, dass sie für die Bewältigung semantischer Heterogenität über rechtliche Zuständigkeiten hinweg ungeeignet sind. KG-BERT und GNNExplainer zeigen hingegen einige Verbesserungen durch zusätzliche vortrainierte Sprachmodelle oder Interpretationsmodule, leiden jedoch weiterhin unter einem starken Leistungsabfall in Situationen mit überlappenden rechtlichen Zuständigkeiten.
| Methode | Jurisdiktionseinstellung | Abdeckung des Rechtsbereichs | Erkennungsrate für Regelkonflikte |
| Vorgeschlagen | Einseitig | 0.94 ± 0.02 | 0.89 ± 0.03 |
| Zweiseitig | 0.91 ± 0.03 | 0.85 ± 0.04 | |
| Mehrseitig | 0.87 ± 0.04 | 0.81 ± 0.05 | |
| TransE | Einseitig | 0.76 ± 0.05 | 0.52 ± 0.06 |
| Zweiseitig | 0.68 ± 0.06 | 0.45 ± 0.07 | |
| Mehrseitig | 0.61 ± 0.07 | 0.38 ± 0.08 | |
| ComplEx | Einseitig | 0.79 ± 0.04 | 0.55 ± 0.05 |
| Zweiseitig | 0.72 ± 0.05 | 0.48 ± 0.06 | |
| Mehrseitig | 0.65 ± 0.06 | 0.41 ± 0.07 | |
| GNNExplainer | Einseitig | 0.82 ± 0.04 | 0.61 ± 0.05 |
| Zweiseitig | 0.75 ± 0.05 | 0.54 ± 0.06 | |
| Mehrseitig | 0.68 ± 0.06 | 0.47 ± 0.07 | |
| KG-BERT | Einseitig | 0.80 ± 0.04 | 0.58 ± 0.05 |
| Zweiseitig | 0.73 ± 0.05 | 0.51 ± 0.06 | |
| Mehrseitig | 0.66 ± 0.06 | 0.44 ± 0.07 | |
| Node2Vec | Einseitig | 0.74 ± 0.05 | 0.49 ± 0.06 |
| Zweiseitig | 0.66 ± 0.06 | 0.42 ± 0.07 | |
| Mehrseitig | 0.59 ± 0.07 | 0.36 ± 0.08 |
Tabelle 3: Abdeckung von Rechtsgebieten und Erkennungsrate von Regelkonflikten. Ergebnisse zur Generalisierung über Domänen hinweg unter einzelnen, bilateralen und multilateralen Rechtsgebieten. Die Abdeckung der Rechtsgebiete (Gleichung 18) und die Erkennungsrate von Regelkonflikten (Gleichung 19) werden als Mittelwert ±± SD über 30 Durchläufe angegeben. Die vorgeschlagene Methode weist selbst im komplexesten multilateralen Szenario eine hohe Abdeckung (≥87 %) und Erkennungsrate (≥81 %) auf, während die Baseline-Methoden deutlich schlechter abschneiden.
Dieser Unterschied resultiert aus den vollständig unterschiedlichen zugrundeliegenden Modellierungsprozessen. Bestehende Ansätze zur Einbettung von Wissensgraphen (z. B. TransE, ComplEx) nutzen geometrische Beziehungen in einem statischen Vektorraum für die Modellierung und unterscheiden dabei niemals binäre rechtliche Semantiken wie „Verbot“ und „Erlaubnis“, wodurch sie außerstande sind, die differenzierten Regelungen derselben medizinischen Maßnahme in verschiedenen Rechtssystemen zu verarbeiten. Obwohl KG-BERT den textuellen Kontext erfassen kann, fehlt ihm eine explizite strukturelle Schlussfolgerungsfähigkeit und er hat Schwierigkeiten, mit normativen Abhängigkeiten und widersprüchlichen Beschränkungen zwischen Klauseln zu schlussfolgern. Stattdessen konstruiert das vorgeschlagene Modell einen gerichteten heterogenen Graphen, indem es vier Arten rechtlicher semantischer Kanten („Verstoß“, „Grundlage“, „Auslöser“ und „Zuweisung“) erweitert und eine relationsbewusste Graph-Faltung mit Gradienten-Rückpropagation kombiniert. Dadurch erhält das vorgeschlagene Modell nicht nur die kausale Richtung der juristischen Logik bei, sondern bringt auch semantisch parallele Klauseln dynamisch in Übereinstimmung und erkennt widersprüchliche Regeln in mehrquelligen Eingaben des juristischen Bereichs. Folglich bietet die Methodik unter komplexen Szenarien mit häufigen Konflikten von Verpflichtungen, überlappenden Zuständigkeiten oder unklaren Prioritäten innerhalb eines multilateralen Rechtssystems einen Weg, die Ursachen von Widersprüchen strukturiert genau zu identifizieren und sie in querschnittliche Schlussfolgerungen mit hoher Abdeckung und Genauigkeit zu überführen.
Ablationsstudie
Um den Beitrag jeder Kernkomponente zu isolieren, führten wir eine Ablationsstudie durch, bei der wir Schlüsselmodule in unserem Framework im Szenario des dichten Graphen (D = 1,0) entfernten oder ersetzten. Insbesondere verglichen wir das vollständige Modell mit drei Varianten: (1) ohne relationsempfindliche Faltung, bei der alle Kantentypen eine einzige Transformationsmatrix teilen; (2) ohne Aufmerksamkeitsmechanismus, bei dem die Beiträge der Nachbarn gleichmäßig gemittelt werden; und (3) ohne Gradienten-Backtracking, bei dem Bias-Quellen mithilfe einer einfachen Heuristik basierend auf dem Knotengrad anstelle einer gradientenbasierten Teilgraph-Rekonstruktion identifiziert werden.
Tabelle 4 zeigt die Ablationsergebnisse und verdeutlicht die unterschiedlichen Beiträge der einzelnen Komponenten. Der Wegfall der relationsbewussten Faltung führte zum stärksten Leistungseinbruch, wobei die Wurzel-Recall von 0,95 auf 0,81 und die Pfadpräzision von 0,93 auf 0,78 fiel. Dies bestätigt, dass die typspezifische Kantenmodellierung entscheidend ist, um die semantische Vielfalt rechtlicher Beziehungen abzubilden, da die gemeinsame Nutzung einer einzigen Transformationsmatrix für alle Relationstypen zu erheblichem Informationsverlust während der multimodalen Ausrichtung führt. Der Aufmerksamkeitsmechanismus leistet ebenfalls einen bemerkenswerten Beitrag; sein Entfall reduziert die Wurzel-Recall auf 0,88 und die Pfadpräzision auf 0,85, was darauf hinweist, dass die dynamische Gewichtung von Nachrichten benachbarter Knoten die Fähigkeit des Modells verbessert, einflussreiche rechtliche Pfade zu unterscheiden, auch wenn sein Einfluss hinter dem der Relationsbewusstheit zurückbleibt. Der Wegfall des Gradienten-Backtrackings führte zum geringsten Rückgang bei der Recall (0,91), aber zum stärksten Einbruch bei der Pfadpräzision (0,76), was darauf hindeutet, dass einfache Heuristiken zwar teilweise Quellknoten identifizieren können, die präzise Rekonstruktion der Ausbreitungsstruktur jedoch stark auf der gradientenbasierten Sensitivitätsanalyse beruht. Insgesamt tragen alle drei Komponenten wesentlich zur Bias-Lokalisierungsleistung des Frameworks bei, wobei die relationsbewusste Faltung am wichtigsten ist und das Gradienten-Backtracking für die Genauigkeit auf Pfadebene unverzichtbar ist.
| Modellvariante | Wurzel-Recall | Pfad-Präzision |
| Vollständiges Modell | 0.95 ± 0.02 | 0.93 ± 0.03 |
| ohne relationsbewusste Faltung | 0.81 ± 0.03 | 0.78 ± 0.04 |
| ohne Aufmerksamkeitsmechanismus | 0.88 ± 0.02 | 0.85 ± 0.03 |
| ohne Gradienten-Backtracking | 0.91 ± 0.03 | 0.76 ± 0.05 |
Tabelle 4: Ergebnisse der Ablationsstudie an dichtem Graphen (D = 1.0). Auswirkung des Entfernens zentraler Komponenten: (ohne relationsempfindliche Faltung), (ohne Aufmerksamkeitsmechanismus) und (ohne Gradientenrückverfolgung). Die Metriken (Wurzel-Recall und Pfad-Präzision) geben den Mittelwert ±± SD über 30 Durchläufe an. Das vollständige Modell erzielt die besten Ergebnisse, was bestätigt, dass jede Komponente einen wesentlichen Beitrag leistet, wobei die relationsempfindliche Faltung die wichtigste ist.
VERFÜGBARKEIT VON DATEN:
Der strukturierte, heterogene Wissensgraph-Datensatz, der in dieser Studie erstellt und analysiert wurde, einschließlich aller Knoten- und Kanten-Daten (285 Knoten über vier Entitätstypen und 1.247 gerichtete Kanten mit vier zulässigen semantischen Beziehungen), wurde im Figshare-Repository unter der DOI: https://doi.org/10.6084/m9.figshare.33117644 hinterlegt. Die Daten sind ab dem Veröffentlichungsdatum dieses Artikels öffentlich zugänglich. Die entsprechenden Datensatzdateien werden außerdem als Zusatzdatei 1 bereitgestellt.
Zusatzdatei 1: Datensatzdateien, die in dieser Studie verwendet wurden.Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Die Integration medizinischer KI-Systeme in klinische Entscheidungen wirft rechtliche Herausforderungen bei der Zuschreibung von Verantwortung auf, was durch die semantische Kluft zwischen unstrukturierten rechtlichen Texten und Black-Box-Algorithmen erschwert wird. Um diese zu überbrücken, schlagen wir ein auf GNN basierendes Wissensgraphmodell vor, das rechtliche Klauseln, medizinisches Handeln, Algorithmusmodule und verantwortliche Parteien als heterogene Knoten darstellt, die über vier gerichtete rechtlich-semantische Beziehungen (Verstoß, Grundlage, Auslöser, Zuschreibung) miteinander verbunden sind. Diese Struktur bietet eine berechenbare Schnittstelle für die multimodale Abstimmung und Nachverfolgung von Verzerrungen.
Unsere Methode erzielt eine überlegene Leistung bei allen Metriken. Bei variierenden Graphdichten überbieten die Genauigkeit der Entitätsausrichtung (≥0,92) und die Erhaltung von Beziehungen (≥0,88) TransE, ComplEx und KG‑BERT. Die Lokalisierung von Bias ergibt eine hohe Rückrufquote der Ursachen (0,95 ±± 0,02) und Pfadpräzision (0,93 ±± 0,03), was deutlich über GNNExplainer liegt. Die dynamische Überwachung gewährleistet geringe Latenz (42–55 ms) und hohe Durchsatzrate (190–230 Anfragen/s), während Quervergleiche über verschiedene Rechtsräume hinweg eine robuste Abdeckung (≥87 %) und Konflikterkennung (≥81 %) zeigen. Diese Ergebnisse bestätigen eine effektive Verknüpfung juristischer und technischer Semantik mit interpretierbarer Bias-Verfolgung.
Drei Innovationen stehen hinter unserem Erfolg: (1) typisierte rechtlich-semantische Kanten erfassen kausale und normative Unterscheidungen, die durch einheitliche Einbettungen oft übersehen werden20,21; (2) relationsspezifische Faltung mit dedizierten Transformationsmatrizen pro Relationstyp erhält die semantische Spezifität und ermöglicht gleichzeitig den Austausch zwischen verschiedenen Typen38,39; und (3) die quantitativen Beitragsanalysen auf Grundlage von Gradienten sowie die clustergestützte, communitygeleitete Gruppierung verwandeln globale Verzerrungen in eine lokale Quellenidentifikation und überwinden damit die Grenzen nachträglicher Erklärungsverfahren32,33. Dadurch wird Compliance von einer statischen Regelprüfung hin zu einer dynamischen, strukturbewussten Schlussfolgerung weiterentwickelt.
Zu den Einschränkungen zählen die Abhängigkeit von manuell definierten Relationsextraktionen und Schwierigkeiten bei vagen Formulierungen. Zukünftige Arbeiten werden formale Ansätze der juristischen Logik (z. B. abschließbare Logik26,27) und Online-Lernen für sich weiterentwickelnde Vorschriften integrieren und sich auf andere risikoreiche Bereiche (autonomes Fahren, Finanzen) ausdehnen. Die Einbindung von Nutzerfeedback wird die Zuweisung weiter verfeinern. Diese Ansätze werden graphenbasierte, erklärbare KI als Fundament für vertrauenswürdige intelligente Systeme weiter festigen.
Offenlegungen
Der Artikel wurde weder zuvor veröffentlicht noch wird er von einer anderen Zeitschrift in Betracht gezogen. Alle Autoren haben den Inhalt des Artikels genehmigt. Die Autoren erklären, dass sie keine finanziellen Interessenkonflikte haben.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| ComplEx | Open-Source-Implementierung (z. B. OpenKE) | Version 1.0 | Komplexe Einbettungs-Baseline für den Vergleich von Wissensgraphen |
| GNNExplainer | Open-Source-Implementierung (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Baseline für die Interpretierbarkeit von GNNs zur Verfolgung von Verzerrungen |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Zentralprozessor für Modelltraining und Datenvorverarbeitung |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Transformatorbasierte Einbettungs-Baseline für die semantische Ausrichtung |
| Node2Vec | Open-Source-Implementierung (https://github.com/aditya-grover/node2vec) | Version 1.0 | Baseline für Knoteneinbettungen basierend auf zufälligen Spaziergängen |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | Leistungsstarke GPU zur Beschleunigung des Trainings von Graph-Neuronalen-Netzen |
| Eigener Ansatz (Relation-aware GCN) | Eigene Implementierung in PyTorch | PyTorch 1.12.0 | Vorgeschlagenes Framework mit transformationsbasierten Relationen, Aufmerksamkeitsmechanismus und Gradienten-Rückverfolgung |
| TransE | Open-Source-Implementierung (z. B. OpenKE) | Version 1.0 | Translationsbasierte Einbettungs-Baseline für den Vergleich von Wissensgraphen |
Referenzen
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.