Dieses Protokoll stellt das Tri-Stream-Disentangled-Netzwerk (TDE-Net) vor, einen EEG-zu-Bild-Rekonstruktionsansatz, der komplementäre EEG-Darstellungen, die visuelle Ausrichtung im Dualraum und die Diffusionsdecodierung kombiniert.
Methodenartikel
Tri-Stream-Disentangled-Netzwerk mit adaptiver Dual-Space-Fusion für die auf Elektroenzephalographie basierende Bildrekonstruktion auf THINGS-EEG2
In diesem Artikel
Zusammenfassung
Zusammenfassung
Die Rekonstruktion visueller Reize aus nichtinvasiver Elektroenzephalographie (EEG) erfordert die Abbildung kurzer, verrauschter neuronaler Antworten auf aussagekräftige visuelle Darstellungen, trotz begrenzter räumlicher Abtastung. Bestehende EEG-zu-Bild-Ansätze nutzen vielfältige neuronale Repräsentationen und generative Strategien, was reproduzierbare Arbeitsabläufe notwendig macht, die strukturelle und semantische Beiträge voneinander trennen. Dieses Protokoll stellt das Tri-Stream-Disentangled-Netzwerk (TDE-Net) vor, einen rechnergestützten Rahmen für die EEG-basierte Bildrekonstruktion. Das Protokoll verwendet vorverarbeitete THINGS-EEG2-Aufzeichnungen und organisiert die EEG-Informationen in einen rohen EEG-Anker, einen versuchsspezifischen funktionalen Graph-Stream und einen mehrskaligen zeitlichen Semantik-Stream. Der Graph-Stream erfasst frequenzbereichsbezogene Beziehungen zwischen EEG-Kanälen mittels Graph-Faltung und kontrastiver Lernmethode über Versuche hinweg, während der Semantik-Stream aufgabenrelevante Merkmale mittels adaptiver räumlicher Gewichtung und mehrskaliger zeitlicher Faltungen extrahiert. Strukturelle und semantische Merkmale werden separat auf latente Räume des Variational Autoencoder (VAE) und des Contrastive Language-Image Pre-training (CLIP) abgebildet, mithilfe von auf einem Entwicklungssatz ausgewählten Fusionsgewichten kombiniert und mittels Stable UnCLIP decodiert. Bei 10 Probanden erreichte TDE-Net eine mittlere CLIP-Paarvergleichs-Identifikationsgenauigkeit von 0,8135, wobei ergänzende Metriken strukturelle und merkmalsraumbasierte Übereinstimmungen belegten. Ablations- und darstellungsebenebezogene Analysen charakterisierten zudem die Beiträge der einzelnen Ströme. Dieses Protokoll bietet einen reproduzierbaren Rahmen zur Untersuchung komplementärer EEG-Repräsentationen und diffusionsbasierter visueller Rekonstruktion.
Einleitung
Die Dekodierung der visuellen Wahrnehmung ist ein interdisziplinäres Forschungsgebiet in der Schnittstelle von Gehirn-Computer-Schnittstellen (BCIs) und kognitiver Neurowissenschaft. Mittels funktioneller Magnetresonanztomographie (fMRT) wurde bereits die Rekonstruktion realistischer Bilder ermöglicht1,2,3,4, doch ihre Kosten, eingeschränkte Portabilität und der hämodynamische Verzögerungseffekt beschränken bestimmte Anwendungen. Die Elektroenzephalographie (EEG) liefert zeitlich auf der Millisekundenskala präzise Messungen mit vergleichsweise zugänglicher Messtechnik, doch ihr geringes Signal-Rausch-Verhältnis und die begrenzte räumliche Abtastung erschweren die Rekonstruktion von Bildern aus EEG-Signalen.
Die Komplexität der Methode sollte im Hinblick auf den allgemeinen Bias-Varianz-Trade-off5 interpretiert werden. Frühe Methoden zur visuellen Decodierung verwendeten flache oder lineare Repräsentationen, während spätere Studien kompakte faltungs-basierte, graphenbasierte und aufmerksamkeitsbasierte Encoder einführten6,7,8,9,10,11. Die Quermodalitäts-Abstimmung hat sich ebenfalls von multimodalen Merkmalslernverfahren12,13 hin zu latenten Diffusionsmodellen und großen visuellen Encodern weiterentwickelt14,15,16. Diese Ansätze liefern nützliche Referenzwerte, doch da sich ihre Eingangsrepräsentationen, latenten Zielgrößen und Decoder unterscheiden, sollten die Ergebnisse jeweils im Kontext der entsprechenden experimentellen Rahmenbedingungen interpretiert werden.
Das Ziel von TDE-Net ist es, einen modularen EEG-zu-Bild-Rekonstruktionsrahmen bereitzustellen, der strukturelle und semantische EEG-Darstellungen trennt, diese mit komplementären visuellen latenten Räumen ausrichtet und diese Vorhersagen für die diffusionsbasierte Bildrekonstruktion integriert. Aktuelle Studien zur EEG-Visuell-Decodierung haben die transformerbasierte, EEG-gesteuerte Generierung in EEG-CLIP17, die vordergrundbezogene Ausrichtung mit dynamischen Gehirnnetzwerken in FSDBN18, die kognitiv gesteuerte adaptive Unschärfung mit informationsbeschränkter Ausrichtung19 sowie das biomimetische Lernen auf mehreren Ebenen mit bidirektionaler Kopplung20 eingeführt. Verwandte EEG-zu-Bild-Pipelines, darunter Perceptogram und die gesteuerte Diffusion basierend auf EEG-Embeddings, liefern zusätzliche Referenzen für die latente Vorhersage21,22. TDE-Net unterscheidet sich in seiner Modellarchitektur: Es trennt explizit eine rohe EEG-Ankerdarstellung, eine probenspezifische funktionelle Graphdarstellung und eine zeitliche semantische Darstellung und führt anschließend eine asymmetrische Ausrichtung zu den VAE- und CLIP-Räumen durch, bevor die Fusion erfolgt. Diese Architektur ermöglicht es, die strukturellen und semantischen Beiträge separat durch Analysen im latenten Raum und auf Bildniveau zu untersuchen. Im Vergleich zu Ansätzen mit nur einer Darstellung oder direkter EEG-zu-Bild-Ausrichtung bietet dieses modulare Design separate strukturelle und semantische Signalwege, bewahrt einen linearen EEG-Bezug während der latenten Vorhersage und ermöglicht die unabhängige Bewertung des Beitrags jeder Darstellung durch Ablations- und latente-Raum-Analysen.
TDE-Net ist für Experimente mit gepaarten EEG-Antworten und visuellen Reizen, ausreichenden Trainingsbedingungen sowie einem kurzen poststimulativen Zeitfenster konzipiert, in dem die semantische Rekonstruktion das primäre Ziel darstellt. Die stufenweise Organisation ermöglicht eine getrennte Untersuchung von Merkmalsextraktion, latenter Ausrichtung, Fusion und Diffusionsdecodierung. Lineare Abbildungen eignen sich weiterhin für sehr kleine Datensätze oder Anwendungen, bei denen minimale Modellkomplexität im Vordergrund steht, während End-to-End-Neuronale-Decodierer vorzuziehen sein können, wenn umfangreiche aufgabenspezifische Datensätze und eine Echtzeitanwendung verfügbar sind.
Das vorliegende Protokoll evaluiert die vorgeschlagene Konfiguration im THINGS-EEG2-Szenario der schnellen seriellen visuellen Präsentation (RSVP). Die Hauptbeiträge umfassen ein dreistrahlige EEG-Darstellungsschema, das aus einem rohen linearen Anker, einem probeenspezifischen funktionalen Graphenstrom und einem mehrskaligen zeitlichen semantischen Strom besteht. Diese komplementären Darstellungen werden auf VAE- und CLIP-Latenzräume abgebildet, und die entsprechenden Vorhersagen werden vor der Diffusionsdecodierung kombiniert. Das Framework wird an allen 10 THINGS-EEG2-Teilnehmern mittels rekonstruktionsbasierter Maße auf Teilnehmerebene, Ablations- und Zeitfensteranalysen sowie Visualisierungen auf Darstellungsebene evaluiert, wobei räumliche Aufmerksamkeitskarten als topografische Analysen der Scalp-Kanäle interpretiert werden.
Protokoll
Das Protokoll umfasst sechs aufeinanderfolgende Schritte: Vorbereitung der EEG-Versuche und Bild-Latenzen; Aufbau des graphbasierten Strukturstroms; Training des semantischen EEG-Encoders; Anpassung der CLIP/VAE-Abbildungen; Fusion der latenten Vorhersagen, gefolgt von der Bilddekodierung; sowie die Bewertung der Ergebnisse auf Bild- und Repräsentationsebene (Abbildung 1).
1. EEG-Versuche und Bild-Embeddings vorbereiten
- Dokumentieren Sie die Quellkohorte und den Erhebungsprotokoll.
ANMERKUNG: Die Quellkohorte bestand aus 10 gesunden Erwachsenen (mittleres Alter 28,5 Jahre, SD 4,0; acht weiblich und zwei männlich) mit normalem oder korrigiertem Normalsichtigkeit. Die Teilnehmer gaben schriftlich informierte Einwilligung, erhielten eine finanzielle Vergütung und absolvierten das ursprüngliche Protokoll mit Genehmigung durch den Ethikausschuss des Fachbereichs Erziehungswissenschaft und Psychologie der Freien Universität Berlin gemäß der Deklaration von Helsinki23.- Verwenden Sie den öffentlich zugänglichen Datensatz THINGS-EEG2 als Ressource für die Sekundäranalyse.
- Verwenden Sie die Quellpartition mit 1.654 Trainingskonzepten und 200 nicht überlappenden Testkonzepten aus THINGS, wobei die Anteile von 27 übergeordneten Kategorien zwischen den Partitionen ausgeglichen sind. Wählen Sie zehn Bilder mit natürlichem Hintergrund für jedes Trainingskonzept und ein Bild für jedes Testkonzept, um 16.540 Trainingsbedingungen und 200 zurückgehaltene Testbedingungen zu erhalten.
ANMERKUNG: In der vorliegenden Studie wurden für die Zielentdeckungsaufgabe separate Buzz-Lightyear-„Catch“-Bilder verwendet, die von der aktuellen Rekonstruktionsanalyse ausgeschlossen wurden23. - Befolgen Sie beim Interpretieren der Epochen die zeitliche Abfolge des ursprünglichen Rapid-Seriel-Visual-Präsentationsprotokolls.
ANMERKUNG: Jede Sequenz begann mit einer 750 ms langen leeren Phase, gefolgt von 20 zentral dargestellten Bildern. Jedes Bild nahm einen Sehwinkel von 7 Grad ein, blieb 100 ms auf dem Bildschirm sichtbar und hatte eine Stimulus-Onset-Asynchronie von 200 ms, was einer Rate von 5 Bildern/s entspricht. Eine zweite 750 ms lange leere Phase ging einer Antwortphase von bis zu 2 s voraus, in der die Teilnehmer zuerst blinzelten und anschließend angaben, ob ein Zielfoto erschienen war. Ein zentrales Fixationsziel (Bull’s-Eye) blieb während der gesamten Sequenz sichtbar23. - Berücksichtigen Sie beim Organisieren des Datensatzes die ursprüngliche Struktur der Aufnahmesitzungen. Verwenden Sie Daten aus den vier Aufnahmesitzungen, die jeder Teilnehmer absolvierte, wobei jede Sitzung aus vier Testdurchläufen und 15 Trainingsdurchläufen mit jeweils etwa 5 Minuten Dauer bestand. Behalten Sie vier Wiederholungen für jede Trainingsbedingung und 80 Wiederholungen für jede Testbedingung bei, was 82.160 analysierte Nicht-Ziel-Bild-Versuche pro Teilnehmer entspricht23.
- Verwenden Sie die EEG-Daten, die mit der ursprünglichen THINGS-EEG2-Aufnahmekonfiguration erfasst wurden. Diese Aufnahmen wurden mit 1.000 Hz mittels eines 64-Elektroden-EASYCAP gemäß dem internationalen 10-10-System und eines BrainVision actiCHamp-Verstärkers aufgezeichnet, wobei Fz als Online-Referenz und ein Online-Bandpassfilter von 0,1–100 Hz verwendet wurde.
- Verwenden Sie die veröffentlichten vorgeverarbeiteten Daten, die relativ zum Bildbeginn von -200 bis 800 ms epochiert, mittels des prästimulativen Intervalls basiskorrigiert, auf 100 Hz heruntergerechnet, auf 17 parieto-okzipitale Kanäle beschränkt, von Zielversuchen befreit und innerhalb jeder Aufnahmesitzung unabhängig einer multivariaten Rauschnormalisierung unterzogen wurden23.
- Bereiten Sie EEG-Versuchstensoren vor
- Laden Sie die veröffentlichten vorgeverarbeiteten THINGS-EEG2-Tensoren für alle 10 Teilnehmer. Wählen Sie aus jeder Quellepoche das poststimulative Intervall von 0–800 ms und die 17 parieto-okzipitalen Kanäle aus und behalten Sie die Abtastrate von 100 Hz bei, um 80 Zeitpunkte pro Versuch zu erhalten. Behalten Sie die Quellpartition mit 16.540 Trainingsbildbedingungen und 200 zurückgehaltenen Testbildbedingungen für jeden Teilnehmer bei23 (Abbildung 2).
- Behalten Sie für das Graph-Stream-Vortraining die vier unabhängigen Trainingswiederholungen für jede Bildbedingung bei und wählen Sie zwei Wiederholungen aus, um ein positives Paar zu bilden. Für die Roh- und Semantik-Streams mitteln Sie die vier Trainingswiederholungen und die 80 verfügbaren Testwiederholungen für jede Bedingung.
- Verwenden Sie die vorgeverarbeiteten THINGS-EEG2-Tensoren, die durch die ursprüngliche MVNN-Pipeline erzeugt wurden; wenden Sie innerhalb jedes implementierten Merkmalsextraktors die dokumentierte Z-Standardisierung auf Dateiebene vor der Merkmalsberechnung an.
ANMERKUNG: Diese asymmetrische Nutzung von Wiederholungen ist beabsichtigt: Wiederholte Versuche liefern positive Paare für das kontrastive Vortraining im Graph-Stream, während die Roh- und Semantik-Streams bedingungsweise gemittelte Daten für die überwachte Abbildung verwenden. Das resultierende Design kombiniert Lernen invarianter Merkmale auf Ebene der Wiederholungen im strukturellen Stream mit latenter Vorhersage auf Bedingungsebene in den Roh- und Semantik-Streams.
- Bereiten Sie gepaarte Bild-Latenzen vor
- Verwenden Sie den 1.024-dimensionalen CLIP-Vision-Encoder und den VAE-Encoder, der mit sd2-community/stable-diffusion-2-1-unclip assoziiert ist, um gepaarte Bildziele zu extrahieren. Skalieren Sie die VAE-Eingabebilder auf 768 x 768 Pixel, speichern Sie den posterior-Modus des VAE als 36.864-dimensionalen Vektor (4 x 96 x 96) und bewahren Sie die Reihenfolge der Bildbedingungen.
- Speichern Sie drei Eingabeformen: Tensoren mit wiederholten Versuchen für das kontrastive Lernen im Graph-Stream, gemittelte EEG-Tensoren für die Roh- und Semantik-Streams sowie gepaarte CLIP/VAE-Bild-Latenzen für die überwachte Abbildung.
- Normalisieren und zwischenspeichern Sie die Eingaben
- Speichern Sie die vorgeverarbeiteten EEG-Tensoren, extrahierten Graph- und Semantik-Merkmale sowie die gepaarten Bild-Latenzen mit fester Bedingungsreihenfolge im Cache.
- Schätzen Sie während der Ridge-Abbildung die merkmalsweise Standardisierungsparameter aus den Trainingsdaten und wenden Sie diese Parameter auf die Entwicklungs- und Testeingaben an.
2. Konstruieren Sie den graphbasierten Strukturstream
- Konstruieren Sie den Graph-Stream aus wiederholten Trainingsdurchläufen und exportieren Sie die Merkmale auf Knotenebene nach dem kontrastiven Pre-Training. Verwenden Sie dieselbe Graph-Konstruktionsregel für die Merkmalsextraktion beim Testen, ohne latente Testbildmerkmale während der Merkmalsberechnung zu verwenden.
- Transformieren Sie EEG-Durchläufe in frequenzbasierte Graph-Eingaben
- Transformieren Sie jeden Durchlauf mittels einer 80-Punkt-Schnellen Fourier-Transformation (FFT) und behalten Sie die ersten 40 Nicht-Negativ-Frequenzbänder im Bereich von 0 Hz–48,75 Hz bei einer Abtastrate von 100 Hz. Verwenden Sie das Logarithmus-Amplitudenspektrum als eine 17 × 40 große Knoten-Merkmalsmatrix X. Berechnen Sie für jede EEG-Stichprobe C_ij = |Korr(X_i, X_j)| zwischen jedem Paar der 17 Kanal-Merkmalsvektoren.
- Behalten Sie in jeder Zeile die diagonale Selbstkorrelation und die drei stärksten außerdiagonalen Korrelationen (k = 4 behaltene Einträge inklusive Selbstkorrelation) bei, symmetrisieren Sie anschließend die behaltene Matrix, um die spezifische gewichtete funktionelle Adjazenz A zu definieren. Wenden Sie eine symmetrische Grad-Normalisierung vor der Graph-Faltung an.
- Verwenden Sie diese Konstruktion während Training und Test; physische Elektrodenkoordinaten werden nicht zur Definition eines festen Graphen herangezogen.
HINWEIS: Die Beibehaltung der Selbstverbindungen erhält das Signal jedes Knotens, während die Begrenzung der Kanal-übergreifenden Verbindungen auf drei pro Zeile die Graphdichte vor der Symmetrisierung kontrolliert. Die frequenzbasierte Darstellung liefert eine kompakte, amplitudenbasierte Beschreibung für die Graph-Konstruktion, behält jedoch weder die Phase noch alle feinkörnigen phasengekoppelten ERP-Zeitinformationen bei; diese zeitlichen Aspekte bleiben im rohen Anker- und im semantischen zeitlichen Stream erhalten.
- Aggregieren Sie die Elektroden-Topologie mittels spektraler Graph-Faltung
- Wenden Sie ein fünfschichtiges graphenbasiertes Faltungssnetzwerk (GCN)24 mit je 80 versteckten Neuronen pro Schicht, ReLU-Aktivierungen, 0,3 Dropout, symmetrischer Grad-Normalisierung und mittlerer Graph-Pooling an.
- Verwenden Sie einen zweischichtigen Projektionskopf mit 80 Dimensionen für das kontrastive Ziel und exportieren Sie die 17 × 80 große Knoten-Merkmalsdarstellung für die strukturelle Fusion. Wenden Sie spektrale Graph-Faltung auf die eingangsabhängige Adjazenzmatrix an; führen Sie keinen separaten dynamischen Faltungsoperator ein.
- Trainieren Sie den Graph-Stream mit kontrastivem Lernen über verschiedene Durchläufe hinweg
- Wählen Sie innerhalb des Trainingsabschnitts zufällig zwei Wiederholungen derselben Bildbedingung als positives Paar aus und behandeln Sie Darstellungen aus anderen Bedingungen im Batch als negative Beispiele. Optimieren Sie die kontrastive InfoNCE-Zielfunktion25 mit Temperatur τ = 0,5, Batch-Größe 32, Adam mit Lernrate 5 × 10⁻⁴, 20 Epochen, kosinusförmiger Abkühlung bis eta_min = 10–6 und Zufallsstartwert 42.
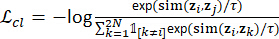 (1)
- Definieren Sie die Kosinus-Ähnlichkeit in der kontrastiven Zielfunktion und verwenden Sie die Indikatorfunktion, um gepaarte Wiederholungen zu identifizieren. Halten Sie die Projektionsdimension bei 80 und wenden Sie dieselbe Temperatur auf beide Richtungen des kontrastiven Verlusts an.
- Wählen Sie innerhalb des Trainingsabschnitts zufällig zwei Wiederholungen derselben Bildbedingung als positives Paar aus und behandeln Sie Darstellungen aus anderen Bedingungen im Batch als negative Beispiele. Optimieren Sie die kontrastive InfoNCE-Zielfunktion25 mit Temperatur τ = 0,5, Batch-Größe 32, Adam mit Lernrate 5 × 10⁻⁴, 20 Epochen, kosinusförmiger Abkühlung bis eta_min = 10–6 und Zufallsstartwert 42.
- Exportieren Sie Knoten-Merkmale für die frühe Fusion
- Fixieren Sie den Graph-Encoder nach dem Pre-Training und exportieren Sie die 17-Kanal-Knotenmerkmale mit jeweils 80 Dimensionen pro Knoten. Konkatenieren Sie diese Merkmale mit dem gemittelten rohen EEG entlang der Merkmalsdimension, um die strukturelle Eingabe „roh-plus-Graph“ für die VAE-Abbildung zu erhalten.
- Speichern Sie den resultierenden „roh-plus-Graph“-Merkmals-Tensor und verwenden Sie ihn ausschließlich als strukturelle Eingabe für den VAE-Regressionszweig.
3. Trainieren Sie den semantischen EEG-Encoder
- Trainieren Sie den semantischen EEG-Encoder mit den gemittelten 17-Kanal-, 80-Punkt-EEG-Tensoren.
- Optimieren Sie den Kosinus-Einbettungsverlust mit AdamW (Lernrate 5 × 10⁻⁴; Gewichtsverlust 0,01), Batch-Größe 64, 50 Epochen, Kosinus-Annealing bis eta_min = 10–6, Zufallsseed 42 und einem 1.024-dimensionalen Ausgang.
- Wenden Sie eine datengesteuerte adaptive räumliche Filterung an
- Wenden Sie eine lernbare Tensorprodukt-Kanal-Gewichtungsoperation auf den Eingangs-EEG-Tensor an und erweitern Sie die Darstellung auf eine Tiefe von 9. Behandeln Sie diese Operation als eine datengesteuerte Kanal-Gewichtungsschicht, nicht als Implementierung des klassischen räumlichen Filters „Common Spatial Pattern“ (CSP)26.
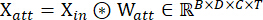 (2)
- Verwenden Sie die gelernte Kanal-Gewichtungsoperation, um neun Merkmalskarten zu erzeugen, und leiten Sie diese an den Multiskalen-Zeit-Konvolutionsblock weiter.
- Wenden Sie eine lernbare Tensorprodukt-Kanal-Gewichtungsoperation auf den Eingangs-EEG-Tensor an und erweitern Sie die Darstellung auf eine Tiefe von 9. Behandeln Sie diese Operation als eine datengesteuerte Kanal-Gewichtungsschicht, nicht als Implementierung des klassischen räumlichen Filters „Common Spatial Pattern“ (CSP)26.
- Modellieren Sie zeitliche Rezeptivfelder auf mehreren Skalen
- Wenden Sie drei parallele zeitliche Faltungen mit Kernelgrößen von 5, 15 und 31 Abtastwerten an, unter Verwendung von Padding gleicher Länge. Verketten Sie die drei Ausgaben, um 24 zeitliche Merkmalskanäle zu erhalten, und wenden Sie Batch-Normalisierung und GELU-Aktivierung an.
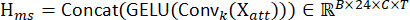 (3)
HINWEIS: Die Faltungen stellen mehrskalige zeitliche Rezeptivfelder innerhalb des umfassenderen zeitlichen faltenden Modellierungsansatzes bereit27. - Verwenden Sie die drei Kernelgrößen als Multiskalen-Zeitfilter; interpretieren Sie deren Ausgabe als gelernte Signaldarstellungen, nicht als direkte Zuordnungen zu spezifischen ERP-Komponenten.
- Wenden Sie drei parallele zeitliche Faltungen mit Kernelgrößen von 5, 15 und 31 Abtastwerten an, unter Verwendung von Padding gleicher Länge. Verketten Sie die drei Ausgaben, um 24 zeitliche Merkmalskanäle zu erhalten, und wenden Sie Batch-Normalisierung und GELU-Aktivierung an.
- Rekalibrieren Sie aufgabenspezifische Merkmalskanäle
- Wenden Sie Tiefen-Attention mit adaptiver Durchschnittspooling auf die zeitliche Dimension sowie eine Faltung mit Kernelgröße 7 gefolgt von Softmax-Normalisierung an, im Einklang mit den Prinzipien der Kanal-Rekalibrierung28. Multiplizieren Sie die resultierenden Attention-Gewichte elementweise mit dem Multiskalen-Merkmals-Tensor.
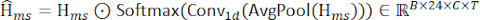 (4)
- Verwenden Sie die Attention-Ausgabe als Eingabe für den räumlichen Faltungsblock und interpretieren Sie die gelernten Gewichte nicht als kausale neuronale Lokalisation.
- Wenden Sie Tiefen-Attention mit adaptiver Durchschnittspooling auf die zeitliche Dimension sowie eine Faltung mit Kernelgröße 7 gefolgt von Softmax-Normalisierung an, im Einklang mit den Prinzipien der Kanal-Rekalibrierung28. Multiplizieren Sie die resultierenden Attention-Gewichte elementweise mit dem Multiskalen-Merkmals-Tensor.
- Exportieren Sie das globale semantische EEG-Merkmal
- Wenden Sie eine 1 × 1-Faltung gefolgt von einer tiefenbezogenen Faltung über die 17 Elektrodenkanäle, Batch-Normalisierung, GELU-Aktivierung, Durchschnittspooling mit Faktor 2 und Dropout p = 0,5 an. Glätten Sie das Ergebnis und projizieren Sie es auf einen 1.024-dimensionalen semantischen Merkmalsvektor.
- Speichern Sie einen 1.024-dimensionalen semantischen Merkmalsvektor für jede gemittelte EEG-Stichprobe.
4. EEG-Merkmale auf latente Räume von CLIP und VAE abbilden
- Koppeln Sie jeden EEG-Merkmalstensor mit dem Bild-Laten, das denselben Bedingungsindex aufweist. Passen Sie separate Abbildungen für CLIP- und VAE-Ziele an, und stellen Sie sicher, dass alle Bildbedingungen in der Trainingspartition von denen in der separaten Testpartition disjunkt sind.
- Passt eine Ridge-Regression29 mit einem Achsenabschnitt und maximal 50.000 Iterationen an. Verwenden Sie λCLIP = 1.000 für die Abbildungen von Rohdaten zu CLIP und von Semantik zu CLIP, λVAE = 0 für die Verankerung von Rohdaten zu VAE und λVAE, struct = 1.000 für die Abbildung des Strukturstroms zu VAE. Standardisieren Sie die Eingaben für die Abbildung anhand der Statistiken der Anpasspartition.
ANMERKUNG: Der Strukturstrom ist die Konkatenation aus rohen EEG-Daten und Graph-Merkmalen; der Semantikstrom enthält die Ausgabe des semantischen Encoders ohne Konkatenation roher Merkmale. - Abbildung der strukturellen Merkmale in den VAE-Latenzraum
- Passen Sie die Ridge-Abbildung des Strukturstroms zu VAE mit λVAE,struct = 1.000 an und prognostizieren Sie das 36.864-dimensionale VAE-Laten. Dieser Zweig erhält die konkatenierten Repräsentationen aus rohen EEG-Daten und Graphen; es ist der einzige nichtlineare Zweig, der rohe Merkmale explizit konkateniert.
- Abbildung der semantischen Merkmale in den CLIP-Latenzraum
- Passen Sie die Ridge-Abbildung des Semantikstroms zu CLIP mit λCLIP = 1.000 an und prognostizieren Sie die 1.024-dimensionale CLIP-Repräsentation. Die semantische Eingabe wird nicht mit rohen EEG-Daten konkateniert.
ANMERKUNG: In diesem Artikel bezeichnet λ die Ridge-Regularisierung und α das Gewicht einer Latentfusion. - Beurteilen Sie die Ausrichtung im Latenzraum mithilfe des Pearson-Korrelationskoeffizienten (PCC) pro Stichprobe. Verwenden Sie Entwicklungsbedingungen zur Auswahl der Fusionsgewichte und bewerten Sie die 200 separaten Testbedingungen erst, nachdem die Abbildungen und Fusionsgewichte festgelegt wurden.
- Passen Sie die Ridge-Abbildung des Semantikstroms zu CLIP mit λCLIP = 1.000 an und prognostizieren Sie die 1.024-dimensionale CLIP-Repräsentation. Die semantische Eingabe wird nicht mit rohen EEG-Daten konkateniert.
5. Fusionieren Sie latente Vorhersagen und führen Sie die Diffusionsrekonstruktion durch
- Wählen Sie αVAE und αCLIP anhand einer bedingungsbasierten Entwicklungsaufteilung aus, die ausschließlich aus den 16.540 Trainingsbedingungen abgeleitet wurde. Verwenden Sie mit Zufallsstartwert 42 dieselben 90 % Anpassungsindizes und 10 % Entwicklungsindezes für alle 10 Probanden; die 200 zurückgehaltenen Testbedingungen liegen außerhalb dieses Verfahrens.
ANMERKUNG: Die Ridge-Strafen und der Koeffizient zur Erhaltung der Struktur wurden vor der endgültigen Auswertung auf den zurückgehaltenen Daten als Konfigurationswerte festgelegt und nicht anhand der 200 Testbedingungen optimiert. - Passt für jeden Probanden und jeden Kandidaten α aus {0,00; 0,05; ..., 1,00} den zielüberwachten Encoder und die Ridge-Abbildungen auf den Anpassungsteil an und berechnen Sie den mittleren latenten PCC pro Stichprobe auf dem Entwicklungsteil.
- Mitteln Sie die PCC-Werte auf Probandenebene mit gleicher Gewichtung über die 10 Probanden und wählen Sie die Gewichte für den CLIP- und VAE-Raum unabhängig nach dem maximalen mittleren Wert über alle Probanden aus. Fixieren Sie beide Werte, bevor Sie die endgültigen Trainingsmodelle erneut anpassen und die zurückgehaltenen Testbedingungen auswerten.
ANMERKUNG: Dieses Verfahren wählte αCLIP = 0,55 und αVAE = 0,65. - Definieren Sie für den VAE-Raum die fusionierte Vorhersage als gewichtete Summe aus dem Roh-zu-VAE-Anker und der VAE-Vorhersage des Strukturstroms:
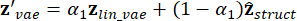 (5)
- Setzen Sie αVAE = 0,65, sodass der Roh-zu-VAE-Anker 0,65 und die Vorhersage des Strukturstroms 0,35 beiträgt. Behalten Sie diesen Wert für jeden Probanden und jede Testbedingung bei.
- Definieren Sie für den CLIP-Raum die fusionierte Vorhersage als gewichtete Summe aus dem Roh-zu-CLIP-Anker und der CLIP-Vorhersage des Semantikstroms:
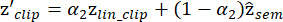 (6)
- Setzen Sie αCLIP = 0,55, sodass der Roh-zu-CLIP-Anker 0,55 und die Vorhersage des Semantikstroms 0,45 beiträgt. Behalten Sie diesen Wert für jeden Probanden und jede Testbedingung bei.
ANMERKUNG: Interpretieren Sie die Fusionsoperation allgemein als festgewichtete Ensemble-Kombination latenter Vorhersagen im Sinne von Ensemble-Methoden30. Beschreiben Sie sie nicht als garantierte Verringerung von Überanpassung oder als einheitlich optimale Lösung über alle Metriken hinweg. - Laden Sie die fixierte Stable UnCLIP Bild-zu-Bild-Pipeline von sd2-community/stable-diffusion-2-1-unclip mit fp16-Variationsgewichten. Verwenden Sie das fusionierte CLIP-Embedding als semantische Bedingung und das fusionierte VAE-Latenz als strukturelle Initialisierung.
ANMERKUNG: Der Decoder folgt den Prinzipien der Denoising-Diffusion und der klassifikatorfreien Steuerung31,32. - Wenden Sie eine verrauschte strukturelle Initialisierung auf die Diffusionslatenzen an. Formen Sie jede 36.864-dimensionale VAE-Vorhersage zu 4 × 96 × 96 um, gemäß der Formulierung latenter Variabler Autoencoder33, und addieren Sie Gaußsches Rauschen, nachdem Sie die strukturelle Latente mit dem strukturellen Skalierungsfaktor Gamma = 0,02 multipliziert haben. Verwenden Sie für das Diffusionstraining T_diff = 1.000 Zeitschritte und einen festen Diffusionsstartwert von 0 für das berichtete Rekonstruktionsverfahren.
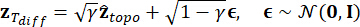 (7)
- Setzen Sie den Koeffizienten zur Erhaltung der Struktur (gamma) in der verrauschten Initialisierung auf 0,02 und behalten Sie diesen Wert für alle Testbedingungen bei. Leiten Sie die resultierende Latente an den Decoder weiter, ohne Informationen aus dem Originalbild zu verwenden.
- Wenden Sie Cross-Attention-Steuerung an und dekodieren Sie die Bildlatente. Konkatenieren Sie den fusionierten 1.024-dimensionalen CLIP-Vektor mit dem 1.024-dimensionalen Bedingungserweiterungsvektor, der von der Pipeline verwendet wird, fügen Sie einen Null-Vektor als negative Bedingung für die klassifikatorfreie Steuerung (CFG) voran und dekodieren Sie mit einem Steuerungsmaßstab von 7,5. Verwenden Sie den Pipeline-Standard von 20 Denoising-Schritten und speichern Sie ein PNG-Bild pro Testbedingung.
- Speichern Sie das rekonstruierte Bild mit dem ursprünglichen Index der Testbedingung und behalten Sie denselben Index für alle nachfolgenden Metrikberechnungen bei.
ANMERKUNG: Tabelle 1 fasst die im beschriebenen Workflow verwendeten Einstellungen zur Datenaufteilung, Vorverarbeitung, Graphenkonstruktion, Modelltrainierung, latenten Abbildung, Fusion und Dekodierung zusammen. Die beigefügte Arbeitsmappe enthält dieselbe Parameterzusammenfassung im maschinenlesbaren Format.
6. Rekonstruktion und Alignment auf Repräsentationsebene evaluieren
- Berechnen Sie die niedrigstufige Treue mithilfe der Pixelkorrelation (PixCorr) und der strukturellen Ähnlichkeit (SSIM). Berechnen Sie die paarweisen Identifikationsgenauigkeiten für AlexNet-Schicht 2, AlexNet-Schicht 5, Inception-v3 und OpenAI CLIP ViT-L/14; berechnen Sie außerdem die Korrelationsdistanzen für EfficientNet (EffNet) und SwAV, wobei niedrigere Werte engere Merkmalsrepräsentationen anzeigen.
- Bei der CLIP-Analyse bilden Sie die Korrelationsmatrix zwischen den Merkmalen, die aus 200 rekonstruierten Bildern extrahiert wurden, und den entsprechenden 200 Originalbildern. Vergleichen Sie für jede Rekonstruktion die Korrelation mit dem korrekten Bild mit den Korrelationen zu den anderen 199 Bildern und mitteln Sie die resultierenden 200 × 199 binären Vergleiche, um die CLIP-paarweise Identifikationsgenauigkeit zu erhalten.
- Für expandierende Fenster, die bei 8, 16, ..., 80 Zeitpunkten enden, passen Sie die rohen EEG-Ridge-Abbildungen an und berechnen Sie die mittlere pro Stichprobe ermittelte PCC zwischen vorhergesagten und tatsächlichen CLIP- und VAE-Latenzwerten über die 200 Testbedingungen für Subjekt 01. Verwenden Sie die Vorhersagen für das gesamte Fenster ausschließlich für den semantischen Datenstrom als gestrichelte Referenzwerte.
- Erstellen Sie Matrizen der repräsentativen Ähnlichkeit (RSMs) aus L2-normalisierten CLIP-Merkmalen mithilfe der Kosinusähnlichkeit. Ordnen Sie beide Matrizen basierend auf einer hierarchischen Ward-Clusterung der CLIP-Einbettungen der Originalbilder, unter Verwendung des euklidischen Abstands.
- Für die zweidimensionale Visualisierung leiten Sie fünf k-Means-Cluster aus den Einbettungen der Originalbilder ab und wenden eine gemeinsame PCA-50 sowie eine t-verteilte stochastische Nachbarn-Einbettung (t-SNE) auf die Einbettungen der Original- und vorhergesagten Merkmale an; verwenden Sie t-SNE ausschließlich für qualitative Visualisierungen.
- Visualisieren Sie weißgefilterte EEG-Muster und Modellgewichte an den Kopfkanälen mit beschrifteten Kanälen, expliziten Farbskalen und reproduzierbaren Ordnungsregeln. Interpretieren Sie diese Darstellungen als ergänzende Analysen der gemessenen Kopfkanal-Signale und Modellparameter, nicht als Beleg für kortikale Quellenlokalisation, anatomische Aktivierung oder Kausalität.
Ergebnisse
TDE-Net wurde aus sechs komplementären Perspektiven bewertet: Rekonstruktionsleistung, repräsentative visuelle Ergebnisse, Beitrag der Komponenten, zeitliche Abhängigkeit, semantische Repräsentationsstruktur und Aufmerksamkeit bezüglich der Scalp-Kanäle. Die Detailgenauigkeit auf niedriger Ebene wurde mithilfe von PixCorr und SSIM bewertet, die Ausrichtung im Merkmalsraum anhand von AlexNet, Inception-v3, CLIP, EffNet und SwAV-Maßen, und die Leistung auf Ebene der Versuchspersonen anhand der Ergebnisse aller 10 THINGS-EEG2-Teilnehmer. Sofern nicht anders angegeben, identifiziert jede qualitative Abbildung den entsprechenden Probanden und Teilmengen der Testbedingungen.
Rekonstruktionsleistung und repräsentative Ergebnisse
Als internes Referenzmodell haben wir zusätzlich eine leichte faltungs-basierte EEG-Codierungs-Baseline mit Aufmerksamkeitsmechanismus implementiert. Dieses Modell extrahiert eine einzelne 1024-dimensionale EEG-Repräsentation aus jedem Durchlauf und bildet sie unabhängig in die latente CLIP- und VAE-Räume ab, wobei das gleiche Verfahren der Ridge-Regression und der Diffusionsdecodierung wie bei der vorgeschlagenen Methode verwendet wird. In den folgenden Abschnitten wird dieses Modell als Baseline bezeichnet. Der Encoder entspricht dem im lokalen Ansatz verwendeten semantischen Referenzmodell vom Typ LMDA mit faltungs-basierten Aufmerksamkeitsmechanismen, weist 373.950 trainierbare Parameter auf und liefert eine 1.024-dimensionale Ausgabe.
Tabelle 2 vergleicht TDE-Net mit dem internen faltungs-basierten Attention-Baseline-Verfahren und repräsentativen EEG-basierten Methoden zur Bildrekonstruktion anhand der angegebenen Metriken. Zur konsistenten Bewertung wurden die Verfahren innerhalb eines einheitlichen experimentellen Rahmens implementiert, der dieselbe THINGS-EEG2-Aufteilung, 17-Kanal-Eingabe, Vorverarbeitung, ausgesparte Testbedingungen und Metrikdefinitionen nutzt, wobei die methodenspezifischen Architekturen beibehalten wurden. In der Zusammenfassung über zehn Probanden erreichte TDE-Net Mittelwerte ± Standardabweichung von 0,2531 ± 0,0138 für PixCorr, 0,3388 ± 0,0025 für SSIM, 0,8777 ± 0,0115 für AlexNet-Schicht 2, 0,9153 ± 0,0116 für AlexNet-Schicht 5, 0,7606 ± 0,0213 für Inception-v3, 0,8135 ± 0,0074 für die CLIP-paarweise Identifikationsgenauigkeit, 0,8285 ± 0,0122 für die EffNet-Distanz und 0,5085 ± 0,0101 für die SwAV-Distanz. Die pro-subjekt-Zusammenfassung ergänzt die qualitativen Beispiele auf Einzelprobandenebene.
Der CLIP-Wert bezeichnet die paarweise Identifikationsgenauigkeit und nicht die Kosinusähnlichkeit oder eine generische CLIP-Funktionsbewertung. Da der semantische Datenstrom auf ein Ziel im CLIP-Raum trainiert wird, spiegelt dieses Maß sowohl die semantische Rekonstruktion als auch die Ausrichtung an einem Zielzweig wider. Es wird daher gemeinsam mit PixCorr, SSIM, AlexNet, Inception-v3, EffNet und SwAV betrachtet, die komplementäre Aspekte der niedrigstufigen Treue und Übereinstimmung im Merkmalsraum charakterisieren.
Um die Leistung auf Ebene der Versuchspersonen zu charakterisieren, wandten wir das vollständige TDE-Net-Testverfahren auf sub-01 bis sub-10 an, wobei dieselben 200 zurückgehaltenen Bildbedingungen für jede Versuchsperson verwendet wurden. Tabelle 3 gibt alle acht Evaluierungsmaße für jede Versuchsperson sowie den Mittelwert und die Stichproben-Standardabweichung über alle Versuchspersonen hinweg an. Die mittlere CLIP-Paarvergleichs-Identifikationsgenauigkeit betrug 0,8135 (SD: 0,0074). Die mittleren Werte für PixCorr und SSIM lagen bei 0,2531 bzw. 0,3388. Die Genauigkeiten in AlexNet-Schicht 2 und Schicht 5 lagen durchschnittlich bei 0,8777 und 0,9153, und die Inception-v3-Genauigkeit betrug im Mittel 0,7606. Die EffNet- und SwAV-Distanzen, bei denen niedrigere Werte besser sind, lagen durchschnittlich bei 0,8285 bzw. 0,5085. Die geringe Streuung zwischen den Versuchspersonen bei diesen Maßen deutet auf ein vergleichbares quantitatives Rekonstruktionsverhalten über alle 10 THINGS-EEG2-Versuchspersonen hin.
Abbildung 3 zeigt Rekonstruktionen für dieselben sieben ausgeschlossenen Bedingungsindizes (1, 32, 62, 86, 87, 108 und 175; nummeriert ab null) über alle 10 Probanden hinweg. Die oberste Zeile zeigt die tatsächlichen Stimuli, die folgenden Zeilen zeigen die entsprechenden Rekonstruktionen für sub-01 bis sub-10. Die Rekonstruktionen bewahren gemeinsame semantische Kategorien und charakteristische visuelle Merkmale der Stimuli, während die feinkörnige Objektidentität, Form und lokale Textur zwischen den Probanden variieren. Diese Darstellung bietet eine qualitative Ergänzung zu den in Tabelle 3 zusammengefassten Ergebnissen über die Probanden hinweg.
Abbildung 4 zeigt qualitative Rekonstruktionen für sechs festgelegte Sub-01-Testbedingungen. In den Zeilen sind der tatsächliche Reiz, ein Vergleichs-Perceptogram, das durch unsere lokale Implementierung erzeugt wurde21, und die TDE-Net-Rekonstruktion dargestellt. Die Beispiele verdeutlichen, dass die Merkmale der Objektkategorie, Form, Farbe und des Hintergrunds erhalten bleiben, während feinkörnige Identität und Hintergrunddetails je nach Methode variieren.
Abbildung 1 (Zusatzmaterial) zeigt die beste, mittlere und schlechteste Rekonstruktionsgruppe, ausgewählt aus den 200 Testbedingungen von Subjekt 01 in THINGS-EEG223. Die Bedingungen sind nach dem Kosinus-Übereinstimmungsmaß zwischen dem fixierten, fusionierten, EEG-basiert vorhergesagten CLIP-Embedding und dem entsprechenden CLIP-Embedding des Originalbildes geordnet. Die dargestellten Gruppen veranschaulichen die Bandbreite der beobachteten semantischen Übereinstimmung für dieses Subjekt.
Beitrag der Komponenten und Fusionsverhalten
Tabelle 4 zeigt eine schrittweise Ablation der strukturellen und semantischen Datenströme basierend auf mittleren Werten über die Probanden hinweg, die unter demselben Evaluierungsverfahren gewonnen wurden. Der lineare Anker (Linear Anchor) prognostiziert direkt die CLIP- und VAE-Latenzen aus den vorverarbeiteten EEG-Daten mittels Ridge-Regression und dient als kontrollierter Ausgangspunkt für die Ablationsstudie. Er folgt dem allgemeinen linearen Prinzip der Latentenabbildung, das in früheren EEG-zu-Bild-Studien verwendet wurde, beispielsweise im Perceptogram21, und nutzt dabei die Vorverarbeitung, Regularisierung, Dekodierung und Evaluierungseinstellungen der vorliegenden Pipeline. Dieser Aufbau ermöglicht es, den strukturellen Datenstrom, den semantischen Datenstrom und die Fusion im Dualraum in Bezug auf einen gemeinsamen linearen Referenzpunkt zu untersuchen.
Ausgehend vom linearen Anker erhöhte die Hinzunahme des strukturellen Stroms den SSIM-Wert von 0,331 auf 0,339 und die Genauigkeit der AlexNet-Schicht 5 von 0,913 auf 0,932, wobei die Genauigkeit der AlexNet-Schicht 2 leicht von 0,889 auf 0,886 abnahm. Die alleinige Hinzunahme des semantischen Stroms führte hingegen zur höchsten PixCorr (0,237), bewahrte eine hohe Genauigkeit der AlexNet-Schicht 2 (0,888) und verringerte die EffNet- und SwAV-Distanzen auf 0,865 bzw. 0,531. Bei Integration beider Ströme mittels Dual-Raum-Fusion erreichte TDE-Net die höchsten Genauigkeiten bei der paarweisen Identifikation mit Inception-v3 (0,761) und CLIP (0,814) sowie die niedrigsten EffNet- (0,829) und SwAV-Distanzen (0,509). Die Genauigkeit der AlexNet-Schicht 2 (0,878) blieb unterhalb des Werts des linearen Ankers, und der SSIM-Wert (0,339) lag leicht unter dem der Konfiguration mit strukturellem Strom. Insgesamt zeigen die Ablationsresultate über verschiedene Probanden hinweg, dass der strukturelle und der semantische Strom unterschiedliche Aspekte der Rekonstruktion beeinflussen, wohingegen ihre Fusion vor allem die semantische Identifikation und die Konsistenz im tiefen Merkmalsraum verstärkt.
Abbildung 5 zeigt eine Empfindlichkeit gegenüber den beiden Fusionsgewichtungen im überprüften Bereich α = 0,00–1,00 in Schritten von 0,05. Die CLIP-Raumkurve erreicht ihr Maximum bei αCLIP = 0,55, während die Kurve des VAE-Raums ihr Maximum erreicht bei αVAE = 0,65. Für benachbarte Kandidaten wurden ähnliche PCC-Werte beobachtet, wobei die Maxima bei unterschiedlichen Gewichtungen für die beiden latenten Räume auftraten.
Zeitlicher Beitrag von EEG-Signalen
Abbildung 6 zeigt die mittlere latente PCC pro Bedingung für rohe EEG-Fenster, die bei 8, 16, ..., 80 Zeitpunkten enden, für sub-01 (n = 200 Testbedingungen). Die Kurven für CLIP und VAE steigen an, während sich das Analysefenster vergrößert, und erreichen bei späteren Fenstern ein Plateau. Gestrichelte Linien zeigen die entsprechenden Referenzwerte für die vollständige semantische Datenübertragung an. Diese Analyse beschreibt die Abhängigkeit von der Zeitfensterlänge gemäß dem berichteten Abbildungsprotokoll.
Semantische Ausrichtung und Analyse auf der Repräsentationsebene
Abbildung 7 vergleicht die paarweise CLIP-latente PCC-Werte für den rohen CLIP-Anker und die gefrorene fusionierte CLIP-Vorhersage über 200 Sub-01-Testbedingungen hinweg. Die Schätzungen der Gaußschen Kerndichteschätzung verwenden die Scottsche Bandbreite, und gestrichelte vertikale Linien kennzeichnen die Stichprobenmittelwerte. Die fusionierte Verteilung weist eine mittlere Erhöhung des PCC um etwa 0,013 im Vergleich zum rohen Anker auf. Die Bild-Ebene CLIP-Paar-Identifikationsgenauigkeit wird separat in Tabelle 2 angegeben.
Abbildung 8 vergleicht Kosinus-Ähnlichkeits-RSMs für CLIP-Embeddings von Ground-Truth-Bildern und fusionierten, aus EEG vorhergesagten CLIP-Embeddings. Beide Matrizen teilen sich einen gemeinsamen Datenbereich und eine Ward-Ordnung, die aus euklidischen Abständen zwischen den CLIP-Embeddings des Ground Truth abgeleitet ist. Das Residuenfeld zeigt die Differenz zwischen vorhergesagtem RSM und Ground-Truth-RSM auf einer symmetrischen Skala, die durch den maximalen absoluten Residuenwert definiert ist, und ermöglicht so eine Visualisierung der Übereinstimmung der Repräsentationen.
Abbildung 2, Zusatzmaterial zeigt eine gemeinsame Projektion von 200 tatsächlichen und 200 EEG-basiert vorhergesagten CLIP-Embeddings. Fünf Labels werden durch K-Means-Clustering der auf L2 normalisierten tatsächlichen Embeddings ermittelt (n_init = 50; seed = 7). Die zusammengefügten tatsächlichen und vorhergesagten Merkmale werden mittels PCA auf 50 Dimensionen reduziert und gemeinsam mittels t-SNE mit einer Perplexität von 28, euklidischer Distanz und seed 12 projiziert. Die Projektion veranschaulicht qualitativ die Struktur beider Repräsentationsmengen.
EEG-Muster und räumliche Aufmerksamkeitsinterpretierbarkeit
Abbildung 3, Zusatzmaterial gruppiert Testkonzepte in Tiere, Lebensmittel-/Pflanzenbezogene Konzepte und Sonstige Objekte mithilfe einer expliziten Zuordnung von Konzepten zu Kategorien. Innerhalb jeder Gruppe sind die Zeilen nach einer Ward-Clusterung weißgefilterter, tatsächlicher CLIP-Embeddings geordnet und auf maximal 30 Konzepte pro Gruppe gleichmäßig abgetastet, um die Lesbarkeit zu gewährleisten. Die Heatmap zeigt begrenzte, normalisierte, weißgefilterte EEG-Amplituden auf einer Skala von -1 bis 1 an; die CLIP-Embeddings werden ausschließlich zur Bestimmung der Reihenfolge innerhalb jeder Gruppe verwendet.
Abbildung 4, Zusatzmaterial zeigt eine standardmäßige 10–20-Kopfbedeckung mit normalisierten absoluten Gewichten der Kanäle des semantischen Stroms über die ausgewählten 17 Elektroden. Die Karte fasst die relativen Modellgewichtungen über die gemessenen Kopfkanäle zusammen und wird als Visualisierung der Modellgewichtung auf Kanälebene interpretiert.
Diese Studie ist eine sekundäre computergestützte Analyse des anonymisierten THINGS-EEG2-Datensatzes. Die ursprünglichen EEG-Aufzeichnungen, vorverarbeiteten EEG-Arrays, Stimulus-Metadaten und -bilder sowie Dateien des Ruhezustands sind über das THINGS-EEG2-Projekt unter https://osf.io/3jk45/ und Figshare+ (https://doi.org/10.25452/figshare.plus.18470912) verfügbar. Die ursprüngliche Erfassungs- und Vorverarbeitungssoftware ist verfügbar unter https://github.com/gifale95/eeg_encoding. Der Zugriff auf und die Wiederverwendung der EEG-Daten und Stimulus-Bilder unterliegen den Lizenzen und Namensnennungsanforderungen, die von den jeweiligen Quell-Repositories festgelegt wurden.
Die Implementierung des TDE-Net, einschließlich Skripte für Ausrichtung, Fusion, Rekonstruktion, Evaluierung und Visualisierung, ist unter https://github.com/Yuan-ui198/TDE-Net verfügbar. Die Version, die diesem Manuskript entspricht, ist auf den Commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da festgelegt (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Für die vorliegende Studie wurden keine neuen identifizierbaren Teilnehmerdaten erhoben.
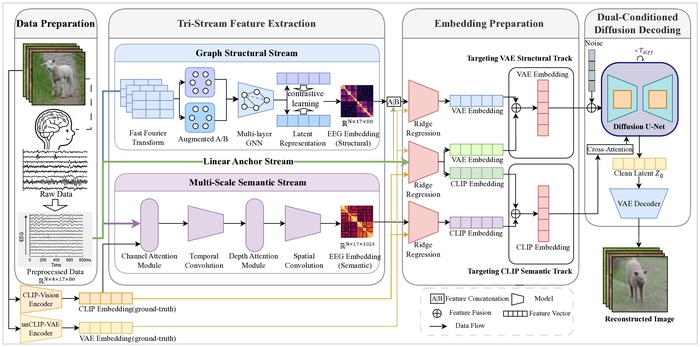
Abbildung 1: Schematische Darstellung des TDE-Net. Das Diagramm zeigt den rohen EEG-Anker, den funktionalen Graph-Stream für jede Probe, den semantischen zeitlichen Stream, die Abbildung in den dualen Raum zu VAE und CLIP, die gewichtete Fusion sowie die dualbedingte Decodierung mittels Stable UnCLIP. Tensor-Dimensionen sind dort angegeben, wo zutreffend. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
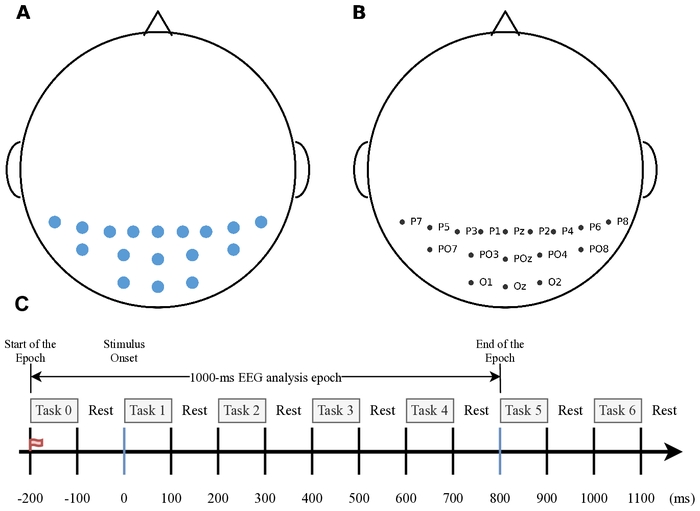
Abbildung 2: Auswahl der EEG-Elektroden und experimentelle Zeitplanung. (A) Räumliche Verteilung der ausgewählten 17 parieto-okzipitalen Elektroden aus der ursprünglichen 64-Kanal-Aufnahme. (B) Elektrodenbezeichnungen: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 und P2. (C) Schematische Darstellung der RSVP-Zeitplanung und Definition der EEG-Epoche. Im Schema bezeichnet „Aufgabe“ ein Bildpräsentationsintervall, während „Pause“ das Intervall zwischen den Bildern darstellt; die nummerierten Aufgabenblöcke zeigen aufeinanderfolgende Präsentationsintervalle an und nicht unterschiedliche experimentelle Bedingungen. Jedes Bild wurde 100 ms lang mit einer Stimulus-Onset-Asynchronie von 200 ms präsentiert. Die EEG-Epoche erstreckte sich von -200 bis 800 ms relativ zum Stimulusbeginn, was einer 1000-ms-EEG-Analyseepoche entspricht. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
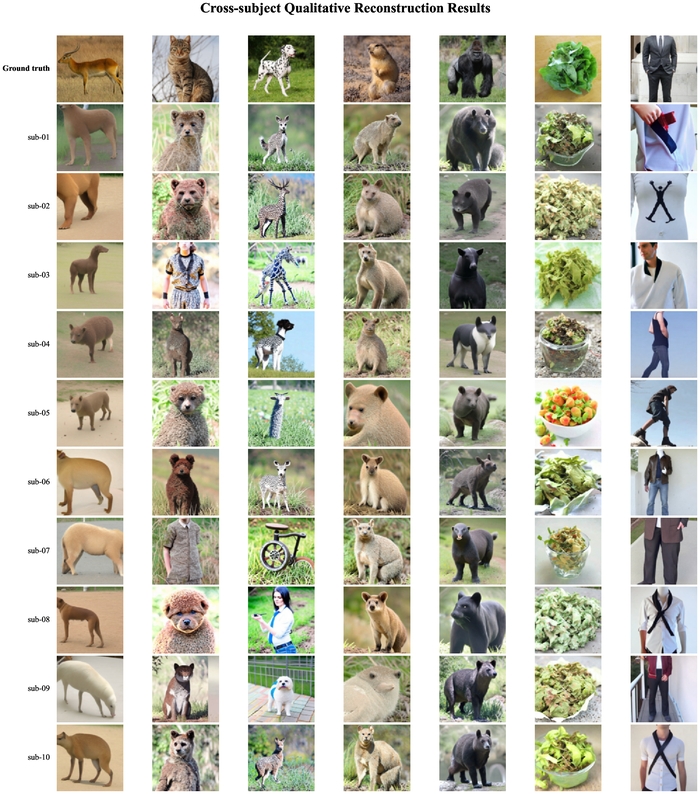
Abbildung 3: Qualitative Rekonstruktionsergebnisse über Probanden hinweg für sieben ausgesparte Bildbedingungen. Die gleichen nullbasierten Bedingungsindizes (1, 32, 62, 86, 87, 108 und 175) werden für sub-01 bis sub-10 verwendet. Die oberste Zeile zeigt die entsprechenden Originalbildbeispiele aus dem THINGS-EEG2-Testdatensatz, deren Bilder der THINGS-Bilddatenbank entnommen wurden34, während die übrigen Zeilen TDE-Net-Rekonstruktionen für jeden Probanden zeigen. Die Abbildung veranschaulicht gemeinsame semantische Inhalte sowie variationsbedingte Unterschiede auf Probandenebene; quantitative Ergebnisse über Probanden hinweg sind in Tabelle 3 angegeben. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
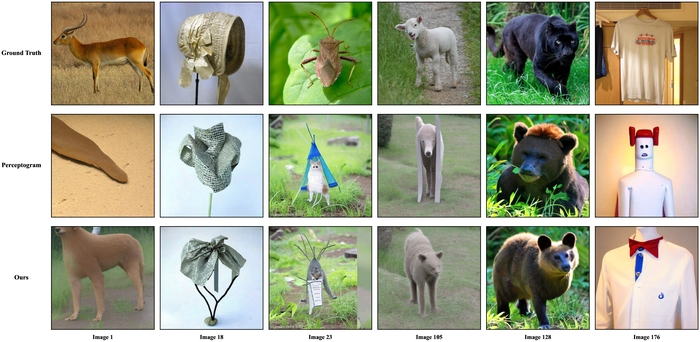
Abbildung 4: Qualitativer Vergleich der Rekonstruktionen für sechs festgelegte Sub-01-Testbedingungen. Die Zeilen zeigen den tatsächlichen Stimulus, eine Vergleichsrekonstruktion, die durch die lokale Implementierung erzeugt wurde, sowie die TDE-Net-Rekonstruktion; die Spalten entsprechen einzelnen Bedingungsindizes. Die Originalbildbeispiele stammten aus der THINGS-Bilddatenbank34. Bitte klicken Sie hier, um eine größere Version dieser Abbildung anzusehen.
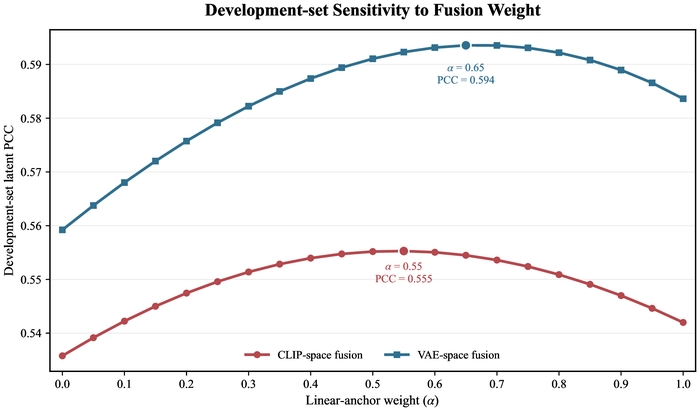
Abbildung 5: Sensitivität der Latent-Fusion-Gewichte am Entwicklungssatz. Die horizontale Achse bezeichnet das lineare-Anker-Gewicht α, das komplementäre Stromgewicht ist 1 - α, und die vertikale Achse bezeichnet den latenten PCC am Entwicklungssatz. Die untersuchten Werte reichen von 0,00 bis 1,00 in Schritten von 0,05. Die Gewichte im CLIP- und VAE-Raum werden unabhängig voneinander anhand des maximalen, gleichgewichteten mittleren PCC auf Subjektebene über 10 Probanden ausgewählt, was αCLIP = 0,55 und αVAE = 0,65 ergibt. PCC, Pearson-Korrelationskoeffizient. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
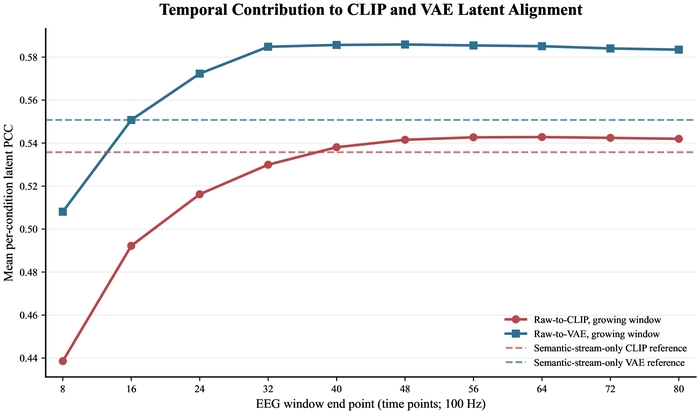
Abbildung 6: Zeitliche-Fenster-Analyse der latenten Alignment bei sub-01 (n = 200 ausgelassene Bedingungen). Durchgezogene Kurven zeigen die mittlere stichprobenweise PCC für Raw-to-CLIP- und Raw-to-VAE-Ridge-Vorhersagen, während sich das EEG-Fensterende von 8 auf 80 Zeitpunkte bei 100 Hz ausdehnt. Gestrichelte Linien zeigen Referenzwerte für ausschließlich semantische Datenströme über das gesamte Fenster (CLIP und VAE). PCC, Pearson-Korrelationskoeffizient. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
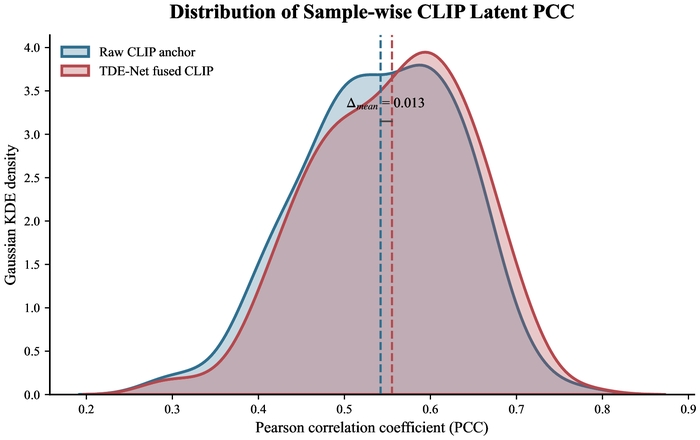
Abbildung 7: Verteilung der bedingungsspezifischen CLIP-Latent-Alignment in Subjekt-01 (n = 200 ausgesonderte Bedingungen). Die Kurven zeigen Gaußsche Kerndichteschätzungen mit Scotts Bandbreite für die rohen CLIP-Anker und die vorab festgelegte TDE-Net-gekoppelte CLIP-Vorhersage. Gestrichelte vertikale Linien kennzeichnen die Stichprobenmittelwerte, und die Anmerkung zeigt deren Differenz an. PCC, Pearson-Korrelationskoeffizient; KDE, Kerndichteschätzung. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
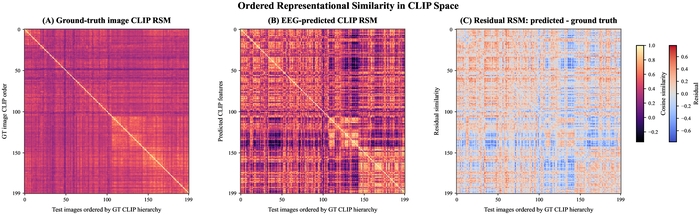
Abbildung 8: Geordnete repräsentationale Ähnlichkeit im CLIP-Raum für Subjekt 01 (n = 200 ausgesparte Bedingungen). (A) Kosinus-Ähnlichkeits-RSM von L2-normalisierten CLIP-Embeddings der Ground-Truth-Bilder. (B) Kosinus-Ähnlichkeits-RSM der fusionierten EEG-prädiktierten CLIP-Embeddings, dargestellt mit derselben Reihenfolge und Farbskala wie in Panel A. (C) Residuales RSM, berechnet als Differenz zwischen Prädiktion und Ground-Truth, dargestellt auf einer symmetrischen Skala, die durch das maximale absolute Residuum definiert ist. Die Reihenfolge wurde mittels euklidischem Abstand und Ward-Verknüpfung der CLIP-Embeddings der Ground-Truth ermittelt. RSM, repräsentationale Similaritätsmatrix. Bitte klicken Sie hier, um eine vergrößerte Version dieser Abbildung anzusehen.
| Komponente | Parameter | Einstellung |
| Daten und Vorverarbeitung | Datensatz-Aufteilung | 16.540 Trainings- und 200 zurückgehaltene Testbedingungen; 90 %/10 % Aufteilung für Anpassung/Entwicklung (Zufallszahlensamen 42) |
| EEG-Eingabe | 17 parieto-okzipitale Kanäle; 0–800 ms; 100 Hz; 80 Zeitpunkte | |
| Spektrale Darstellung | 80-Punkt-FFT; 40 positiv-frequente Bins; 0–50 Hz Logarithmus-Amplitudenspektrum | |
| Struktureller Datenstrom | Graph-Konstruktion | Stichprobenspezifische absolute Pearson-Korrelation; gewichtete top-k = 4 Nachbarn pro Knoten; Symmetrisierung und Selbstschleifen |
| GCN-Architektur | 5 Schichten; 80 versteckte Einheiten; ReLU; Dropout 0,3; symmetrische Gradnormalisierung; Mittelwert-Pooling | |
| Kontrastives Ziel | 80-dimensionaler Projektionskopf; InfoNCE-Temperatur τ = 0,5 | |
| Training | Adam; Lernrate 5 × 10⁻⁴; Batch-Größe 32; 20 Epochen; Kosinus-Annealing; minimale Lernrate 10⁻⁶; Zufallszahlensamen 42 | |
| Semantischer Datenstrom | Architektur | Zeitliche Kerne 5/15/31; Tiefe 9; 24 Merkmalskanäle; Dropout 0,5; Ausgabedimension 1.024 |
| Training | AdamW; Lernrate 5 × 10⁻⁴; Gewichtsverfall 0,01; Batch-Größe 64; 50 Epochen; Kosinus-Annealing; minimale Lernrate 10⁻⁶; Zufallszahlensamen 42 | |
| Latente Abbildung | Ridge-Regression | Achsenabschnitt geschätzt; maximale Iterationen 50.000; Eingaben standardisiert mit Statistiken aus dem Anpassungsteil |
| Regularisierung | CLIP-Strafe λ = 1.000; rohe VAE-Strafe λ = 0; strukturelle VAE-Strafe λ = 1.000 | |
| Zieldimensionen | CLIP: 1.024; VAE: 36.864 | |
| Fusion und Dekodierung | Fusionsgewichte | CLIP-Anker-Gewicht α = 0,55; VAE-Anker-Gewicht α = 0,65; basierend auf Entwicklungsdaten ausgewählt und vor dem Testen fixiert |
| Diffusionsmodell | sd2-community/stable-diffusion-2-1-unclip; strukturelle Skalierung γ = 0,02; Diffusionszeitschritte T = 1.000 | |
| Stichprobenziehung | 20 Entrauschungsschritte; Guidance-Skala 7,5; Diffusions-Zufallszahlensamen 0 |
Tabelle 1: Zusammengefasste Parameterübersicht für TDE-Net. Die Tabelle listet die Datenpartition, Vorverarbeitung, Konstruktion der funktionalen Nachbarschaft, Einstellungen für Graph- und Semantik-Encoder, Latent-Mapping-Strafen, Fusionsgewichte sowie Einstellungen zur Diffusions-Decodierung auf, die in den beschriebenen Experimenten verwendet wurden.
| Methode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Baseline | 0,141 | 0,321 | 0,823 | 0,878 | 0,704 | 0,739 | 0,898 | 0,564 |
| EEGImageDecode | – | 0,345 | 0,776 | 0,866 | 0,734 | 0,786 | – | 0,582 |
| Perceptogram (unCLIP) | 0,223 | 0,370 | 0,875 | 0,915 | 0,749 | 0,806 | 0,870 | 0,530 |
| TDE-Net (unseres) | 0,253 ± 0,014 | 0,339 ± 0,003 | 0,878 ± 0,012 | 0,915 ± 0,012 | 0,761 ± 0,021 | 0,814 ± 0,007 | 0,829 ± 0,012 | 0,509 ± 0,010 |
Tabelle 2: Ergebnisse der quantitativen Rekonstruktion. Die verglichenen Methoden, die interne konvolutionale-attentionale Baseline und TDE-Net wurden innerhalb eines gemeinsamen experimentellen Rahmens bewertet, wobei dieselbe THINGS-EEG2-Partition, ein 17-Kanal-Eingang, die Vorverarbeitung, ausgesparte Testbedingungen und Metrikdefinitionen verwendet wurden, während die methodenspezifischen Architekturen beibehalten wurden. Das aktuelle Modell ist als Mittelwert ± SD über 10 Probanden angegeben. PixCorr, SSIM, AlexNet-Schicht 2, AlexNet-Schicht 5, Inception-v3 und CLIP sind Maße, bei denen höhere Werte besser sind; EffNet und SwAV sind Korrelationsdistanzen, bei denen niedrigere Werte besser sind. Die CLIP-Spalte gibt die paarweise Identifikationsgenauigkeit unter Verwendung des OpenAI CLIP ViT-L/14-Modells an.
| Proband | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0,2260 | 0,3361 | 0,8831 | 0,9203 | 0,7533 | 0,8120 | 0,8567 | 0,5285 |
| sub-02 | 0,2488 | 0,3378 | 0,8699 | 0,9053 | 0,7268 | 0,8074 | 0,8335 | 0,5167 |
| sub-03 | 0,2564 | 0,3397 | 0,8728 | 0,9070 | 0,7658 | 0,8143 | 0,8268 | 0,5096 |
| sub-04 | 0,2420 | 0,3356 | 0,8598 | 0,9034 | 0,7854 | 0,8112 | 0,8255 | 0,5091 |
| sub-05 | 0,2499 | 0,3385 | 0,8760 | 0,8963 | 0,7251 | 0,8016 | 0,8394 | 0,5189 |
| sub-06 | 0,2621 | 0,3395 | 0,8910 | 0,9331 | 0,7818 | 0,8215 | 0,8202 | 0,5009 |
| sub-07 | 0,2489 | 0,3378 | 0,8643 | 0,9185 | 0,7704 | 0,8200 | 0,8222 | 0,5017 |
| sub-08 | 0,2786 | 0,3425 | 0,8951 | 0,9216 | 0,7524 | 0,8245 | 0,8214 | 0,5010 |
| sub-09 | 0,2609 | 0,3370 | 0,8775 | 0,9238 | 0,7662 | 0,8055 | 0,8250 | 0,5009 |
| sub-10 | 0,2571 | 0,3433 | 0,8871 | 0,9240 | 0,7792 | 0,8175 | 0,8140 | 0,4977 |
| Mittelwert | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7606 | 0,8135 | 0,8285 | 0,5085 |
| Mittelwert ± SD | 0,2531 ± 0,0138 | 0,3388 ± 0,0025 | 0,8777 ± 0,0115 | 0,9153 ± 0,0116 | 0,7606 ± 0,0213 | 0,8135 ± 0,0074 | 0,8285 ± 0,0122 | 0,5085 ± 0,0101 |
| 95 % KI | 0,2432–0,2630 | 0,3370–0,3406 | 0,8695–0,8859 | 0,9070–0,9236 | 0,7454–0,7759 | 0,8082–0,8189 | 0,8198–0,8372 | 0,5013–0,5157 |
Tabelle 3: Quantitative Ergebnisse über Probanden hinweg für TDE-Net. Jeder Proband trägt 200 zurückgehaltene Testbedingungen bei. Die Tabelle zeigt die acht Metriken für sub-01 bis sub-10 sowie den Mittelwert über alle Probanden, die Stichproben-Standardabweichung (SD) und das 95 %-Konfidenzintervall (CI). CLIP bezeichnet die paarweise Identifikationsgenauigkeit von OpenAI CLIP ViT-L/14; EffNet und SwAV sind Korrelationsdistanzen, bei denen niedrigere Werte besser sind.
| Methode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Linearer Anker | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Linear + Struktur-Stream | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Linear + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (unseres) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tabelle 4: Ablationsergebnisse, angegeben als mittlere Werte über alle Probanden hinweg gemäß dem in Protokollabschnitt 6 beschriebenen Evaluierungsverfahren. Der Lineare Anker ist ein lokal evaluiertes internes direktes Ridge-Mapping-Referenzverfahren; die strukturellen, semantischen und vollständigen Konfigurationen verwenden dieselben Bedingungsindizes und metrischen Definitionen. PixCorr, SSIM, AlexNet-Schicht 2, AlexNet-Schicht 5, Inception-v3 und CLIP sind Maße, bei denen höhere Werte besser sind; EffNet und SwAV sind Korrelationsdistanzen, bei denen niedrigere Werte besser sind. Die Werte sind auf drei Dezimalstellen angegeben.
Zusatzabbildung 1: Repräsentative Rekonstruktionsfälle über den gesamten CLIP-Übereichsbereich für sub-01. Die 200 zurückgehaltenen Bedingungen sind nach Kosinus-Ähnlichkeit zwischen den fusionierten, aus EEG vorhergesagten und den tatsächlichen CLIP-Embeddings sortiert; jeweils sechs der besten, mittleren und schlechtesten Fälle werden gezeigt. Jede Spalte stellt eine Paarung eines Originalbildes aus dem THINGS-EEG2-Testdatensatz mit seiner TDE-Net-Rekonstruktion dar. Die Originalbilder stammen aus der THINGS-Bilddatenbank.34. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 2, Zusatzmaterial: Gemeinsame Visualisierung der Ground-Truth- und EEG-basiert vorhergesagten CLIP-Darstellungen bei sub-01 (n = 200 Bedingungen pro Darstellung). (A) Ground-Truth-CLIP-Darstellungen. (B) EEG-basiert vorhergesagte CLIP-Darstellungen. Die Farben kennzeichnen fünf K-Means-Cluster, die an L2-normalisierte Ground-Truth-CLIP-Embeddings angepasst wurden (k = 5, n_init = 50, seed = 7). Die Cluster sind datengetriebene Gruppen und entsprechen nicht vordefinierten semantischen Kategorien. Ground-Truth- und vorhergesagte Embeddings wurden zusammengeführt, mittels PCA auf 50 Dimensionen reduziert und gemeinsam mittels t-SNE projiziert (Perplexität = 28, Lernrate = auto, euklidischer Abstand, seed = 12). PCA, Hauptkomponentenanalyse; t-SNE, t-verteilte stochastische Nachbarn-Einbettung. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Abbildung 3 (Zusatzmaterial): EEG-Muster, gruppiert nach allgemeinen Bildkonzept-Kategorien für Probanden sub-01. Die Konzepte sind den Kategorien Tiere, ernährungs-/pflanzenbezogene Konzepte oder sonstige Objekte zugeordnet. Innerhalb jeder Kategorie folgen die Zeilen der hierarchischen Ordnung nach Ward der weißgefilterten CLIP-Embeddings des Ground-Truth und wurden zur besseren Lesbarkeit gleichmäßig auf maximal 30 Konzepte heruntergefiltert. Die Spalten zeigen 17 EEG-Kanäle mit jeweils 80 Zeitpunkten pro Kanal. Die Farbskala (-1 bis 1) repräsentiert begrenzte, normalisierte und weißgefilterte EEG-Amplituden. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Erweiterte Abbildung 4: Topographie der skalpenkanalbezogenen Aufmerksamkeit im semantischen Strom. Die Farben zeigen die normalisierten relativen Größen der gelernten Kanalgewichtungsparameter über die ausgewählten 17 Elektroden in einer standardmäßigen 10–20-Skalpenprojektion; die Elektrodenpunkte und -beschriftungen kennzeichnen die Messpositionen. Die Skala reicht von 0 bis 1 und fasst die vom Modell gelernte relative Kanalgewichtung zusammen. Bitte klicken Sie hier, um diese Datei herunterzuladen.
Diskussion
Diese Studie stellt einen modularen, rechnergestützten Arbeitsablauf vor, der die EEG-Präprozessierung, das strukturelle und semantische Repräsentationslernen, die CLIP/VAE-Latenzabbildung, die Fusion und die Diffusionsdecodierung voneinander trennt. Diese stufenweise Organisation ermöglicht es, Zwischenergebnisse unabhängig von den erzeugten Bildern zu untersuchen, und folgt dem allgemeineren Fortschritt von kompakten EEG-Encodern hin zu multimodalen und diffusionsbasierten Rekonstruktionsverfahren6,11,12,13,14,15,16,,17,18,19,20,21,22. Die Analyse über mehrere Probanden hinweg gibt wertebasierte Angaben auf Probandenebene zusammen mit dem Mittelwert und der Stichproben-Standardabweichung (SD) über alle Probanden für die Evaluierung mit zehn ausgesparten Probanden an. Zusammen mit der schrittweisen Ablationsstudie in Tabelle 4 quantifiziert diese Analyse die auswirkungen spezifischer Datenströme sowie die Variation zwischen Probanden innerhalb der beschriebenen Pipeline.
Wichtige Schritte und Fehlerbehebung
Die wichtigsten Implementierungsmaßnahmen sind die Partitionsisolierung, konsistente Normalisierung, Erhaltung der Bedingungsindizes und separate CLIP/VAE-Abbildungen. Die Fusiongewichte müssen anhand von Entwicklungsbedingungen ausgewählt und vor der Testrekonstruktion fixiert werden. Wenn die Leistung unerwartet gering ausfällt, überprüfen Sie zuerst die Reihenfolge und Dimensionen der Arrays und untersuchen Sie anschließend die rohen und branchenspezifischen latenten PCC-Werte, die Fusion-Metadaten sowie die metrischen Ergebnisse auf Bildebene. Ein Versagen der latenten Ausrichtung weist auf ein upstream liegendes Abbildungsproblem hin, während variable Bilder mit stabilen latenten Darstellungen stochastisches Verhalten oder von Decoder-abhängiges Verhalten widerspiegeln können14,21,22,29.
Eine Änderung der Elektrodenmontage, Abtastrate oder des zeitlichen Fensters erfordert entsprechende Anpassungen bei der Graphenkonstruktion, spektralen Merkmalen und zeitlichen Kernen. Die Rekonstruktionsqualität sollte anhand komplementärer Maße auf niedriger Ebene und semantischer Maße bewertet werden, da kein einzelner Wert die Übereinstimmung hinsichtlich Pixelgenauigkeit, Struktur und objektbasierter Übereinstimmung vollständig erfasst6,11,21,22,23. Das hier verwendete CLIP-Maß ist die paarweise Identifikationsgenauigkeit, während Abbildung 7 und Abbildung 8 den latenten PCC verwenden; diese Größen sind nicht austauschbar.
Die modulare Organisation des TDE-Net bietet einen Rahmen, um zu untersuchen, ob komplementäre EEG-Darstellungen unterschiedlich zu strukturellen und semantischen Aspekten der visuellen Rekonstruktion beitragen. Dieser Ansatz könnte den systematischen Vergleich von EEG-Merkmalsdarstellungen, latenten Zielgrößen und generativen Decodern erleichtern, ohne sich ausschließlich auf die endgültig rekonstruierten Bilder zu stützen. Alternative Ansätze umfassen die direkte lineare Abbildung von EEG auf latente Räume, einsträngige faltungs-basierte oder auf Attention basierende Encoder, graphenbasierte Darstellungen sowie End-to-End-Neuronale-Decodier-Frameworks6,7,8,9,10,11,17,18,19,20,21,22. Der vorliegende Arbeitsablauf kann besonders nützlich für Forschungsvorhaben zur Decodierung der visuellen Wahrnehmung, zur Analyse neuronaler Repräsentationen und zu nicht-invasiven Brain-Computer-Schnittstellen sein, da die Trennung der Zwischenprognosen von EEG zu latenten Variablen helfen kann, zu charakterisieren, welche Komponenten zur Rekonstruktionsleistung beitragen.
Einschränkungen
Die wichtigsten Einschränkungen liegen in der festgelegten THINGS-EEG2-RSVP-Akquisition, den ausgewählten 17 parieto-okzipitalen Kanälen, individuenspezifischen Zuordnungen, einem einzigen Diffusions-Decoder sowie qualitativen Interpretierbarkeitsanalysen21,22,23. Die Zusammenfassung über 10 Versuchspersonen berücksichtigt die Variabilität innerhalb des Datensatzes, begründet jedoch keine Übertragbarkeit auf andere Datensätze oder Paradigmen. Generierte Bilder können plausible Details enthalten, die durch die EEG-Eingabe nicht gestützt werden, und RSM-, t-SNE-, EEG-Muster- sowie Aufmerksamkeitsdarstellungen belegen keine kausalen neuronalen Mechanismen. Die schrittweise Ablation charakterisiert die Beiträge des strukturellen Stroms, des semantischen Stroms und der Fusion im dualen Raum unter Verwendung eines gemeinsamen Ankers aus rohem EEG, latenten Zielgrößen, eines Diffusions-Decoders und eines einheitlichen Evaluierungsprotokolls.
Zukünftige Richtungen
Unter diesen Einschränkungen unterstützen die Ergebnisse die Bewertung komplementärer EEG-Darstellungen in separaten semantischen und bildlatenzraumbasierten Räumen vor der Diffusionsdekodierung. Zukünftige Arbeiten sollten unabhängige Datensätze, Anpassungen an Probanden, Unsicherheitsschätzungen, alternative Kanal-Montagen sowie Dekodierer mit stärkeren Kontrollen über nicht belegte visuelle Details testen14,15,16,17,18,19,20,21,22,23. Solche Studien sind erforderlich, bevor die vorliegenden Befunde auf weiterreichende neurowissenschaftliche Fragestellungen oder Anwendungen in Gehirn-Computer-Schnittstellen übertragen werden können.
Schlussfolgerung:
TDE-Net kombiniert einen Roh-EEG-Anker mit strukturellen und semantischen EEG-Darstellungen, bringt diese getrennt mit den latenten Räumen von VAE und CLIP in Übereinstimmung und integriert die resultierenden Vorhersagen vor der Diffusionsdecodierung. Bei 10 Teilnehmern aus THINGS-EEG2 wiesen die rekonstruierten Bilder messbare Übereinstimmungen auf Pixel-, Struktur- und Semantikebene mit den dargestellten Reizen auf, während die schrittweise Ablation die Effekte des strukturellen Pfads, des semantischen Pfads und der Dualraum-Fusion differenzierte. Indem es Zwischenstufen der EEG-Merkmale, latenten Vorhersagen, Fusionsausgaben und endgültigen Rekonstruktionen offenlegt, bietet das Protokoll einen reproduzierbaren Rahmen zur Untersuchung der EEG-basierten visuellen Rekonstruktion sowie zur Bewertung künftiger Erweiterungen auf unabhängige Datensätze und Aufnahmebedingungen.
Offenlegungen
Die Autoren erklären, dass keine konkurrierenden finanziellen Interessen oder persönlichen Beziehungen bestehen, die diese Arbeit hätten beeinflussen können. Die Autoren erklären, dass keine generativen KI-Tools bei der Erstellung des Manuskripts, des Codes, der Datenanalyse oder der Abbildungsvorbereitung verwendet wurden.
Danksagungen
Diese Forschung wurde von der Nationalen Natürlichen Wissenschaftsstiftung Chinas unter (Förderkennzeichen Nr. 62433002) und (Förderkennzeichen Nr. 62476014), dem Nationalen Wissenschafts- und Technologiemajorprojekt (Nr. 2021ZD0113703), dem Jahresplanungsprojekt der Sozialwissenschaftsstiftung der Stadt Peking (Nr. 23GLB014), dem Projekt zum Aufbau und zur Förderung hochrangiger innovativer Teams an Institutionen der Stadt Peking unter (Förderkennzeichen Nr. BPHR20220104) sowie dem Pekinger Gelehrtenprogramm unter (Förderkennzeichen Nr. 099) finanziert.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| Beschleunigen | Hugging Face | 0.30.1 | Verwaltung der Diffusions-Pipeline-Geräte; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Bild-Merkmals-Encoder zur semantischen Zielbestimmung und CLIP-Paarweisen-Identifikation; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementierung der Stable UnCLIP-Pipeline; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib-Entwicklungsteam | 3.10.6 | Erzeugung wissenschaftlicher Abbildungen; https://matplotlib.org/ |
| MNE-Python | MNE-Entwickler | 1.11.0 | Standard-10-20-Montage und topografische Darstellung der Kopfkanäle; https://mne.tools/ |
| NumPy | NumPy-Entwickler | 2.3.4 | EEG-Arrays, latente Einbettungen, Fusion und Metriken-Aggregation; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; Treiber 595.97 | GPU zur lokalen Encoder-Training und Diffusions-Rekonstruktion. |
| Pillow | Python Imaging Library Fork | 11.1.0 | Bildlade-, Größenänderungs- und Exportfunktionen; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Primäre Laufzeitumgebung; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | EEG-Encoder-Training und neuronale Netzwerk-Inferenz; https://pytorch.org/ |
| scikit-image | scikit-image-Entwickler | 0.25.2 | SSIM- und Bildverarbeitungshilfsprogramme; https://scikit-image.org/ |
| scikit-learn | scikit-learn-Entwickler | 1.7.2 | Ridge-Regression, k-Means, PCA und t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy-Entwickler | 1.16.3 | Korrelation, statistische Distanz und hierarchische Clusterung; https://scipy.org/ |
| Seaborn | Seaborn-Entwickler | 0.13.2 | Visualisierung der Gaußschen Kernel-Dichteschätzung; https://seaborn.pydata.org/ |
| Semantischer EEG-Encoder | Autoren von TDE-Net; angepasst von LMDA-Net | Repository-Commit c99325d | Mehrskalige zeitliche semantische Repräsentation; Implementierung und Checkpoint-Metadaten sind im Code-Repository enthalten. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | Gefrorener Diffusions-Decoder; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Struktureller EEG-Encoder | Autoren von TDE-Net | Repository-Commit c99325d | Selbstüberwachte Graph-Repräsentation; Roh-EEG- und Graph-Merkmale werden nur für die strukturelle Abbildung im VAE-Raum konkateniert. |
| TDE-Net-Ausrichtungs-, Fusions-, Evaluierungs- und Visualisierungsskripte | Yuan-ui198 | Commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| THINGS-Datenbank | Hebart et al. | doi:10.1371/journal.pone.0223792 | Natürliche Objekt-Stimulusquelle; https://things-initiative.org/ |
| THINGS-EEG2-Datensatz | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | 64-Kanal-EEG von 10 Probanden; diese Studie wählt 17 parieto-okzipitale Kanäle aus; https://osf.io/anp5v/ |
| timm | Ross Wightman und Mitwirkende | 1.0.22 | Vorab trainierte Werkzeuge für Bildmodelle, verwendet bei der Merkmalsbewertung; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | AlexNet-, Inception-v3- und EfficientNet-Evaluierungsgrundlagen; https://pytorch.org/vision/ |
| tqdm | tqdm-Entwickler | 4.67.1 | Fortschrittsanzeige für Merkmalsextraktion, Rekonstruktion und Evaluierung; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Schnittstellen für vortrainierte Modulkomponenten; https://github.com/huggingface/transformers |
Referenzen
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Nachdrucke und Genehmigungen
Dieser Artikel wurde veröffentlicht
Video demnächst verfügbar