VoiceNet-RAI integriert MFCC-Merkmale, mehrsprachige wav2vec-2.0-Embeddings und EfficientNet-Lite zur Geschlechts- und Altersklassifizierung anhand von Sprachdaten. Das Framework erreicht eine Genauigkeit von bis zu 97,87 % bei der englischsprachigen Teildatensammlung und unterstützt verantwortungsvolle Anwendungen in der Spracherkennung, Authentifizierung und digitalen Forensik.
Ein Abonnement von JoVE ist erforderlich, um diesen Inhalt anzuzeigen. Melden Sie sich an oder beginnen Sie noch heute mit einer kostenlosen Testphase.
Forschungsartikel
VoiceNet: Ein verantwortungsbewusstes, mehrsprachiges Framework für künstliche Intelligenz zur Geschlechts- und Altersklassifizierung von Sprache
127 Aufrufe
⸱
11. September 2026
In diesem Artikel
Zusammenfassung
Zusammenfassung
Eine genaue Geschlechts- und Altersklassifizierung anhand von Sprachdaten ist wichtig für personalisierte, sichere und ethische Mensch-Computer-Interaktionen (HCI). Angesichts der zunehmenden Nutzung großer vortrainierter Sprachmodelle wie wav2vec 2.0 besteht die Notwendigkeit, diese Repräsentationen verantwortungsvoll für mehrsprachige und datenschutzkonforme demografische Schlussfolgerungen zu nutzen. Diese Studie schlägt VoiceNet-RAI vor, ein Deep-Learning-(DL-)Framework, das Mel-Frequenz-Cepstrum-Koeffizienten (MFCCs) mit transformerbasierten mehrsprachigen wav2vec-2.0-Embeddings in einer EfficientNet-Lite-Architektur kombiniert, um eine genaue, faire und transparente Klassifizierung in unterschiedlichen sprachlichen Kontexten zu ermöglichen. Das Framework verbindet kontextuelle und spektrale Informationen, um die Robustheit unter variablen Aufnahmebedingungen zu verbessern. Experimente mit mehrsprachigen Sprachdaten, die 28 Sprachen umfassen, zeigen eine hohe Klassifizierungsleistung, wobei die englische Teildatensatz 97,87 % Genauigkeit, 98,61 % Präzision, 98,70 % Sensitivität und einen F1-Score von 98,65 % erreicht. Eine externe Validierung anhand des Mozilla-Common-Voice-Datensatzes ergab eine Genauigkeit von 98,27 % bei der Geschlechtsklassifizierung und belegt damit die Übertragbarkeit auf einen unabhängigen Datensatz. Eine Ablationsanalyse zeigte zudem, dass die Kombination von MFCC- und wav2vec-2.0-Merkmalen die Leistung im Vergleich zu Rohdaten und reinen MFCC-Darstellungen verbessert. Diese Ergebnisse verdeutlichen das Potenzial hybrider spektral-kontextueller Sprachrepräsentationen für robuste und verantwortungsvolle Geschlechts- und Altersklassifizierung.
Einleitung
Die Spracherkennung ist ein zentraler Bestandteil der menschlichen Kommunikation, über die Individuen ihre Gefühle, Gedanken und Ziele ausdrücken. Menschliche Stimmen entstehen durch einen biologischen Prozess, bei dem Luft aus der Lunge ausgeatmet und durch artikulatorische Organe wie Lippen, Zunge und Zähne zu Schall geformt wird1. Das Ohr spielt eine wesentliche Rolle bei der Stimmerkennung und kann anhand von Merkmalen wie Lautstärke und Tonhöhe zwischen männlichen und weiblichen Stimmen unterscheiden. Ein Merkmal, das zu erheblichen Unterschieden in der Stimmtonhöhe zwischen Männern und Frauen beiträgt, ist der sexuelle Dimorphismus2. Die Klassifizierung von Alter und Geschlecht anhand der Stimme ist für zahlreiche Anwendungen relevant, darunter die Mensch-Maschine-Interaktion, die automatisierte Geschlechtsidentifikation, personalisierte Begrüßungen, die Vor-Klassifizierung von Emotionen in der Sprache und die geschlechtsbasierte Klassifizierung von Anrufen3.
Sprache ist ein wesentlicher Bestandteil der menschlichen Interaktion. Die menschliche Stimme weist mehrere Merkmale auf, die zwischen Individuen variieren und Informationen über emotionale und mentale Zustände sowie über Alter und Geschlecht liefern können. Diese vielschichtigen Merkmale können in Anwendungen wie sprachbasierten Sicherheitssystemen und auf Sprache ausgerichteten Künstlichen Intelligenzen (KI) genutzt werden. Weitere Bereiche, in denen die Stimmanalyse wichtig ist, umfassen Systeme zur automatischen Sprechererkennung (ASV) und emotionssensitive KI-Systeme. Sprachbasierte Eingabesysteme können zudem den Suchraum in Datenbanken verringern4,5. Außerdem können KI-basierte Sicherheitssysteme Sprachdaten für Anwendungen wie kriminalistische Ermittlungen und den Schutz von Opfern verwenden. Männliche und weibliche Stimmen weisen aufgrund von Unterschieden in den Resonanzeigenschaften des Stimmtrakts unterschiedliche Merkmale auf. Diese Merkmale können aus Sprachsignalen in einer Form extrahiert werden, die für die computergestützte Verarbeitung geeignet ist, wodurch eine Geschlechtsklassifizierung anhand von Stimmdaten ermöglicht wird6,7. Daher sind effektive Lernalgorithmen für die geschlechtsspezifische Klassifizierung anhand der Stimme erforderlich. Tiefenlern-Algorithmen (DL) eignen sich besonders gut für sprachbezogene Klassifizierungen, da sie komplexe Muster aus Audiodaten lernen können. Solche Modelle können je nach Architektur faltende, rekurrente, zeitlich-faltende oder vollständig vernetzte Schichten enthalten. Diese Schichten können relevante akustische Merkmale wie Klangfarbe und Tonhöhe lernen. Nach dem Training kann ein Modell das Geschlecht anhand zuvor unbekannter Audioaufnahmen klassifizieren8. Ein weiterer wichtiger Bereich der Forschung im Maschinellen Lernen (ML) ist die Altersklassifizierung anhand von Sprachaufnahmen. ML-Algorithmen können akustische Merkmale wie Tonhöhe, Klangfarbe und Amplitude nutzen, um altersbezogene Muster zu identifizieren. Techniken wie die Hauptkomponentenanalyse (PCA) können ebenfalls angewendet werden, um aussagekräftige Muster aus Sprachdaten zu extrahieren und möglicherweise die Klassifizierungsleistung zu verbessern9.
DL hat eine starke Leistung bei Anwendungen wie Bild-, Emotions- und Spracherkennung gezeigt. Tiefere Neuronale Netze (DNNs) werden insbesondere häufig für sprachbezogene Aufgaben eingesetzt. In dieser Studie werden DL-basierte Ansätze in Kombination mit etablierten Verfahren zur Merkmalsextraktion für die Stimmklassifizierung angewendet. Mel-Frequenz-Cepstrum-Koeffizienten (MFCCs) erfassen relevante spektrale Eigenschaften von Sprachsignalen und liefern eine effiziente Darstellung für die anschließende Verarbeitung. Die extrahierten Merkmale werden anschließend in ein Transfer-Learning-Modell zur geschlechts- und altersbasierten Klassifizierung anhand der Stimme integriert10,11.
Aktuelle Studien verwenden zunehmend selbstüberwachte und auf Transformatoren basierende Sprachrepräsentationen für die Klassifizierung von Sprechereigenschaften. Forschende haben demografische Verzerrungen, einschließlich Geschlechts- und Altersverzerrungen, in selbstüberwachten Sprachmodellen wie HuBERT und wav2vec 2.0 untersucht und dabei die Bedeutung einer bewussten Bewertung hinsichtlich Fairness hervorgehoben12. Kürzlich haben sprachunabhängige, auf Transformatoren basierende Ansätze die Wirksamkeit gelernter kontextueller Sprachrepräsentationen für die Geschlechtsklassifizierung unter mehrsprachigen und verrauschten Bedingungen gezeigt13. Sinha et al. untersuchten zudem schichtweise wav2vec-2.0-Repräsentationen hinsichtlich Alters- und Geschlechtsklassifizierung und zeigten, dass verschiedene Transformer-Schichten unterschiedliche Ebenen an sprecherbezogenen Informationen erfassen14. Diese Entwicklungen motivieren das vorgeschlagene VoiceNet-RAI-Framework, das konventionelle, auf MFCC basierende spektrale Informationen mit kontextuellen wav2vec-2.0-Repräsentationen kombiniert und dabei mehrsprachige Aspekte sowie Grundsätze der verantwortungsvollen Künstlichen Intelligenz (Responsible AI) berücksichtigt.
Neuere Studien haben gezeigt, dass das Sprecheralter und das Geschlecht anhand herkömmlicher akustischer Merkmale sowie repräsentationsbasierter Deep-Learning-Verfahren charakterisiert werden können. Ansätze, die akustische und zeitliche Informationen kombinieren, haben belegt, dass komplementäre Sprachmerkmale die Leistung bei der Klassifizierung von Alter und Geschlecht verbessern können15,16. In verwandten Untersuchungen wurde außerdem nachgewiesen, dass transformierte Sprachmerkmale, die mithilfe tiefer Bottleneck-Repräsentationen generiert werden, die Klassifizierungsleistung hinsichtlich Sprecheralter und -geschlecht verbessern können17. Diese Ergebnisse stützen die breitere Anwendung spektraler, zeitlicher und gelernter Repräsentationen für Klassifizierungsaufgaben, die Sprache und davon abgeleitete Signale betreffen.
Mehrere Studien haben die Alters- und Geschlechtsklassifizierung anhand von Sprache mithilfe von maschinellem Lernen und Deep-Learning-Ansätzen untersucht18,19,20,21,22,23,24,25,26,27,28,29,30. Neuere Ansätze haben transformierte MFCC-Darstellungen und tiefe neuronale Netze für die Klassifizierung von Sprecheralter und -geschlecht erforscht31, wobei multilinguale und sprachabhängige Variabilität wichtige Aspekte bei der Entwicklung robuster, auf der Stimme basierender demografischer Klassifizierungssysteme bleiben. Unterschiede in der Aussprache, der phonetischen Struktur, den Sprechereigenschaften und den Aufnahmebedingungen können die Generalisierbarkeit von Modellen über verschiedene Sprachen und Populationen hinweg beeinträchtigen. Daher könnte die Verwendung komplementärer spektraler und kontextueller Sprachdarstellungen die Robustheit in multilingualen Szenarien verbessern.
Obwohl hybride Ansätze zuvor mehrere akustische Merkmale oder Ensemble-Klassifikatoren für die demografische Erkennung anhand der Stimme kombiniert haben, unterscheidet sich VoiceNet-RAI durch die Integration zweier komplementärer Ebenen der Sprachrepräsentation innerhalb eines einheitlichen Frameworks. Konventionelle MFCC-Merkmale bewahren dabei lokalisierte spektrale und stimmliche Eigenschaften, während wav2vec 2.0 kontextualisierte Repräsentationen bereitstellt, die mithilfe eines Transformer-Encoders aus roher Sprache gelernt wurden. Anstatt ausschließlich auf manuell gestaltete akustische Deskriptoren oder eine einzelne tiefe Repräsentation zu setzen, führt VoiceNet-RAI eine Merkmalsfusion zeitlich aggregierter MFCC- und wav2vec-2.0-Repräsentationen durch und verfeinert die resultierende hybride Repräsentation anschließend mit EfficientNet-Lite. Die wissenschaftliche Neuheit liegt somit in der koordinierten Integration spektraler, selbstüberwachter kontextueller und leichtgewichtiger tiefer Repräsentationen zur Klassifizierung von Geschlecht und Alter, ergänzt durch eine mehrsprachige Evaluation, eine Validierung an unabhängigen Datensätzen sowie eine Fairness-Analyse für Untergruppen. Diese Kombination erweitert herkömmliche hybride Sprachklassifizierungs-Pipelines über eine rein akkurazitorientierte Merkmalsfusion hinaus hin zu einem Framework, das gleichzeitig Repräsentationskomplementarität, leichtgewichtigen Modellentwurf, Generalisierbarkeit und Verantwortungsvolle KI berücksichtigt.
Die Hauptbeiträge dieser Forschung umfassen die Entwicklung eines Ansatzes zur Identifizierung von Geschlecht und Alter anhand von Sprachdaten, bei dem MFCC- und wav2vec-2.0-Features mit EfficientNet-Lite kombiniert werden. Umfangreiche Experimente wurden an einem Datensatz mit Sprachaufnahmen aus 28 Sprachen durchgeführt, wobei ursprüngliche Merkmale, MFCC-Merkmale, wav2vec-2.0-Merkmale sowie deren Kombinationen mit ML- und DL-Modellen evaluiert wurden. Die Modellleistung wurde sowohl anhand des vollständigen mehrsprachigen Datensatzes als auch an einem englischsprachigen Teildatensatz bewertet. Der Ansatz wurde zudem aus mehrsprachiger und verantwortungsvoller KI-Perspektive durch geschlechts- und sprachspezifische Subgruppenanalysen, sprecherunabhängige Evaluierung und Validierung anhand des Mozilla-Common-Voice-Datensatzes überprüft. Zusätzlich wurde die Leistung des vorgeschlagenen Frameworks mit modernsten, in der bestehenden Literatur beschriebenen Ansätzen verglichen, und Kreuzvalidierungsergebnisse wurden bereitgestellt. Es wurde eine umfangreiche Menge an verwandten Forschungsarbeiten durchgeführt, und Tabelle 1 fasst diese Studien zusammen, einschließlich der verwendeten Modelle, Datensätze und berichteten Ergebnisse19,20,21,22,23,24,25,26,27,28,29,30,31.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Protokoll
In dieser Studie wurden öffentlich verfügbare Datensätze, und zwar der BVC Challenging Voice Set und der Mozilla Common Voice, ohne direkte Beteiligung von Teilnehmern verwendet. Daher war keine Genehmigung durch eine institutionelle Ethikkommission und keine zusätzliche informierte Einwilligung erforderlich. Es wurden lediglich Daten verarbeitet, die für die Klassifizierung von Geschlecht und Alter notwendig waren, und es wurde kein Versuch unternommen, einzelne Sprecher zu identifizieren. Die vollständige methodische Vorgehensweise des vorgeschlagenen Frameworks ist in Abbildung 1 dargestellt.
Datenerfassung
Der in dem vorgeschlagenen Ansatz verwendete Datensatz bestand aus .wav-Audiodateien, die aus dem BVC Challenging Voice Set stammen, einem öffentlich verfügbaren Sprachdatensatz der Biometrics Vision and Computing (BVC)-Gruppe, der auf GitHub32 gehostet wird. Der Datensatz enthielt Sprachaufnahmen von 526 Personen, darunter 336 männliche und 190 weibliche Sprecher. Er umfasste etwa 3.964 Aufnahmen, darunter Einzel- und Mehrsatzaufnahmen jedes Sprechers. Tabelle 2 fasst die demografischen Merkmale, die Sprachabdeckung, die Aufnahmebedingungen, die Strategie zur Datenaufteilung sowie die verwendeten Vorbereitungseinstellungen für die Sprachdatensätze im vorgeschlagenen VoiceNet-RAI-Framework zusammen.
Merkmalsextraktion
Audiodateien wurden verarbeitet, um wesentliche Eigenschaften zu extrahieren, die anschließend in einer CSV-Datei gespeichert wurden. Metadaten wie Alter, Geschlecht und Aussprache der Sprecher wurden aus den entsprechenden README-Dateien extrahiert. Zur Verarbeitung der WAV-Dateien und zur Extraktion relevanter Merkmale wurde Python zusammen mit dem SciPy-Paket verwendet. Für die Umwandlung der Audiosignale vom Zeitbereich in den Frequenzbereich kamen die Fast-Fourier-Transformation (FFT) und Frequenzfunktionen von NumPy zum Einsatz. Die WAV-Dateien stellten die Amplitude als Funktion der Zeit dar; für die Klassifizierungsaufgabe waren jedoch frequenzbezogene Merkmale, die männliche und weibliche Stimmen unterscheiden konnten, von größerem Interesse33.
Um die Audiosignale in Darstellungen im Frequenzbereich umzuwandeln, wurde die Diskrete Fourier-Transformation (DFT) unter Verwendung des FFT-Algorithmus implementiert. Die Fourier-Transformation wandelt ein Signal im Zeitbereich in ein Frequenzspektrum um. Da dieses Spektrum keine zeitlichen Informationen bewahrte, wurde das Audiosignal in überlappende Segmente unterteilt, und die Fourier-Transformation wurde mithilfe der Methode der Kurzzeit-Fourier-Transformation (STFT) auf jedes Segment angewendet. Die Funktion np.fft.fft erzeugte das komplexe Frequenzspektrum, während np.fft.fftfreq die entsprechenden Abtastfrequenzen bereitstellte. Im Beispielverzeichnis standen 10 Audiodateien für einen einzelnen Sprecher zur Verfügung. Jede WAV-Datei wurde mit 200 ms langen verschiebbaren Fenstern verarbeitet, um die dominierenden Frequenzen zu extrahieren. Beispielsweise ergab eine viersekündige Audioaufnahme eine Liste mit 20 Frequenzwerten. Für ein Verzeichnis mit 10 Aufnahmen wurden die 10 entsprechenden Listen, jede mit 20 Frequenzwerten, zu einer Liste von Listen zusammengefasst. Die Frequenzen wurden gefiltert, um Werte zwischen 20 Hz und 280 Hz beizubehalten, während potenzielles Rauschen bei etwa 50 Hz ausgeschlossen wurde.
Hybride MFCC- und wav2vec-2.0-Merkmalrepräsentation
Um sowohl kontextuelle Sprachdarstellungen auf hoher Ebene als auch akustische Merkmale auf niedriger Ebene zu erfassen, verwendete diese Studie eine hybride Strategie zur Merkmalsextraktion, die MFCC-Merkmale mit Transformer-basierten wav2vec-2.0-Embeddings kombinierte.
Extraktion von MFCC-Merkmalen
Mel-Frequenz-Cepstrum-Koeffizienten (MFCCs) sind weit verbreitete Merkmale in der Sprach- und Audiosignalverarbeitung, insbesondere für Anwendungen wie die Spracherkennung und Sprecheridentifikation34,35. In dieser Studie wurde durch die MFCC-Extraktion der Audiosignale Merkmalsvektoren erzeugt, die wahrnehmungsrelevante Eigenschaften der Sprache repräsentieren. Der Prozess begann mit einer Vorbetonung zur Verstärkung der hochfrequenten Anteile, gefolgt von einer Segmentierung und Fensterung, um das Signal in kurze, überlappende Abschnitte zu unterteilen. Jede Audiodatei wurde zunächst auf 16 kHz umgetastet und in 25-ms-Frames mit einer Überlappung von 10 ms segmentiert. Danach wurde die Schnelle Fourier-Transformation (FFT) auf jeden Frame angewendet, um das Signal vom Zeitbereich in den Frequenzbereich zu überführen.
Das resultierende Frequenzspektrum wurde durch eine Reihe von Mel-Filterbänken geleitet, die die nichtlineare Frequenzantwort der menschlichen auditorischen Wahrnehmung annäherten. Diese Filterbänke betonten stärker wahrnehmungsrelevante Frequenzen und verringerten den Beitrag weniger aussagekräftiger Frequenzen. Anschließend wurde der Logarithmus jedes Filterbankausgangs berechnet, um die logarithmische Empfindlichkeit des menschlichen Gehörs gegenüber Lautstärke zu approximieren. Danach wurde eine diskrete Kosinustransformation (DCT) auf die logarithmischen Filterbankenergien angewendet, um die Koeffizienten zu entkoppeln und eine kompakte Darstellung des Audiosignals zu erzeugen. Die resultierenden Koeffizienten, bekannt als MFCCs, erfassen wichtige spektrale Merkmale der Sprache. MFCCs wurden für die Klassifizierung nach Geschlecht und Alter verwendet, da sie akustische Merkmale erfassen, die Stimmen hinsichtlich dieser Attribute unterscheiden.
Extraktion von wav2vec 2.0-Embeddings
Das wav2vec-2.0-Base-Modell wurde auf umfangreichen, nicht gekennzeichneten Sprachkorpora vortrainiert. Das Modell bestand aus einem mehrschichtigen Transformer-Encoder, der Rohwellenform-Eingaben verarbeitete und kontextualisierte Sprach-Embeddings generierte36.
Bei gegebener Eingangswellenform x ∈ RT erzeugte das wav2vec 2.0-Modell eine Sequenz latenter Darstellungen:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
wobei jeder Embedding-Vektor eine Dimensionalität von 768 aufwies. Um eine Darstellung fester Länge zu erhalten, die für die Klassifizierung geeignet ist, wurde eine zeitliche Mittelwert-Pooling-Operation über alle Zeitschritte hinweg angewendet.
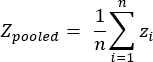 (2)
Mechanismus der Merkmalsfusion
Die MFCC- und wav2vec-2.0-Merkmale wurden durch Merkmalsverkettung auf Ebene der Merkmale fusioniert. Insbesondere wurden die MFCC-Merkmale zunächst durch zeitliche Mittelung aggregiert, um einen Vektor fester Länge zu erzeugen.
m ∈ R40 (3)
Der endgültige hybride Merkmalsvektor wurde wie folgt erhalten:
h = [m || zpooled] ∈ R808 (4)
wobei || die Verkettung bezeichnet. Diese Fusion kombinierte tiefe kontextuelle Einbettungen mit manuell erstellten spektralen Merkmalen und ermöglichte es dem Modell, sowohl semantische Informationen auf höherer Ebene als auch fein abgestimmte akustische Muster zu erfassen.
Alle Audiodaten wurden zunächst auf 16 kHz umgesampelt. MFCC-Merkmale wurden rahmenweise berechnet und zeitlich gemittelt, um einen festen 40-dimensionalen Vektor zu erzeugen, während wav2vec-2.0-Embeddings über die Zeit gemittelt wurden, um eine 768-dimensionale Repräsentation zu erzeugen. Da beide Merkmalsmengen vor der Fusion in Vektoren fester Länge umgewandelt wurden, war eine zeitliche Ausrichtung auf Rahmenebene nicht erforderlich. Die resultierenden MFCC- und wav2vec-Repräsentationen wurden anschließend zu einem 808-dimensionalen hybriden Merkmalsvektor konkateniert, bevor sie dem Klassifikationsmodell übergeben wurden.
Integration mit EfficientNet-Lite
Der fusionierte Merkmalsvektor h wurde in ein für das Merkmal-Lernen geeignetes Format umgeformt und als Eingabe für das EfficientNet-Lite-Modell zum Training bereitgestellt. Eine voll verbundene Projektionsschicht bildete zunächst den 808-dimensionalen Vektor auf einen höherdimensionalen latenten Raum ab, woraufhin die EfficientNet-Lite-Blöcke hierarchische Merkmale verfeinerten. Batch-Normalisierungs- und Dropout-Schichten kamen zum Einsatz, um Überanpassung zu verringern und die Generalisierungsfähigkeit des Modells zu verbessern. Die SoftMax-Aktivierungsfunktion diente der Erzeugung der endgültigen vorhergesagten Wahrscheinlichkeiten für die Geschlechts- und Altersklassen. Die fusionierte Darstellung h ∈ R808 wurde anfänglich als eindimensionaler Merkmalsvektor behandelt und durch eine voll verbundene Projektionsschicht geleitet, die sie auf 4.096 Dimensionen abbildete. Die projizierte Darstellung wurde anschließend in einen 1 × 64 × 64-Tensor umgeformt, bevor sie der EfficientNet-Lite-Architektur zugeführt wurde.
Um die einkanalige Sprachmerkmalsdarstellung anstelle der herkömmlichen dreikanaligen Bilddarstellung zu berücksichtigen, wurde die Eingangsfaltungsschicht des ursprünglichen EfficientNet-Lite von drei auf einen Eingangskanal modifiziert. Die übrigen EfficientNet-Lite-Merkmalextraktionsblöcke blieben ohne wesentliche architektonische Änderungen erhalten. Auf die endgültigen Merkmalskarten wurde eine adaptive globale Durchschnittspooling-Schicht angewendet, um eine Darstellung fester Länge zu erzeugen. Der ursprüngliche Klassifizierungskopf wurde durch eine aufgabenspezifische vollverknüpfte Schicht ersetzt, die zwei Ausgabeeinheiten für die Geschlechtsklassifizierung sowie die entsprechende Anzahl an Ausgabeeinheiten für die vordefinierten Altersgruppen enthielt. Abschließend wurde die SoftMax-Aktivierungsfunktion angewendet, um Klassenwahrscheinlichkeiten zu erzeugen. Die vorgeschlagene hybride Darstellung kombinierte moderne selbstüberwachte Sprachembeddings mit traditionellen signalverarbeitenden Merkmalen. Die wav2vec-2.0-Embeddings erfassten kontextuelle Informationen und langreichweitige Abhängigkeiten, während die MFCC-Merkmale komplementäre akustische Informationen auf niedriger Ebene lieferten. Die Integration dieser Darstellungen verbesserte die Klassifizierungsleistung, insbesondere unter verrauschten und mehrsprachigen Sprachbedingungen.
ML-Klassifikator
In dieser Studie wurde die Leistung mehrerer ML-Algorithmen für die stimmgestützte Klassifizierung von Geschlecht und Altersgruppe analysiert.
Random Forest
Random Forest (RF) wurde als robuster Machine-Learning-(ML)-Klassifikator verwendet, der mehrere Entscheidungsbäume (DTs) kombiniert, um die Vorhersagegenauigkeit zu verbessern und Überanpassung zu verringern. RF arbeitete mithilfe eines Ensemble-Lernverfahrens, bei dem Vorhersagen aus mehreren Bäumen aggregiert wurden, um die endgültige Vorhersage zu erzeugen37,38. Dieser Ansatz ermöglichte es RF, vielfältige Muster in den Daten zu erfassen, während gleichzeitig die Überanpassung, die häufig mit einzelnen DTs verbunden ist, reduziert wurde. Die Zufälligkeit, die während des Baumaufbaus eingeführt wurde, verbesserte die Generalisierbarkeit des Modells und machte RF für Klassifizierungsaufgaben wie Geschlechts- und Altersklassifizierung anhand von Sprachdaten geeignet.
Logistische Regression
Die logistische Regression (LR) wurde als statistisches ML-Modell für die Klassifizierung verwendet39. Bei der binären Klassifizierung schätzt die LR die Wahrscheinlichkeit eines Ergebnisses anhand der Eingabemerkmale unter Verwendung der logistischen (Sigmoid-)Funktion, und die resultierenden Wahrscheinlichkeiten werden zur Erzeugung von Klassenvorhersagen genutzt. Die LR war ebenfalls auf Mehrklassen-Klassifizierungsprobleme mit mehr als zwei Klassen anwendbar. Für die Mehrklassen-Klassifizierung kamen bei der LR Ansätze wie One-vs-Rest oder SoftMax-Regression zum Einsatz, abhängig von der jeweiligen Klassifizierungsaufgabe.
Extra-Tree-Klassifizierer
Der Extra-Trees-Klassifikator (ETC) wurde als Ensemble-Lernalgorithmus verwendet, der mehrere DTs kombinierte, um Vorhersagen zu generieren40,41. Im Gegensatz zu RF führt ETC eine zusätzliche Zufälligkeit ein, indem Kandidatenmerkmale und Aufteilungsschwellenwerte während der Baumkonstruktion zufällig ausgewählt werden. Dieses Verfahren erzeugte weniger korrelierte Bäume und verringerte die Empfindlichkeit des Modells gegenüber einzelnen Merkmalen, wodurch die Robustheit gegenüber Rauschen verbessert wurde. Der Gini-Index wurde als Kriterium für die Aufteilung verwendet, um die Wichtigkeit der Merkmale zu bewerten und die Daten zu partitionieren.
Stützvektormaschine
Die Support-Vektor-Maschine (SVM) wurde als ML-Klassifikator verwendet, um eine optimale Entscheidungsgrenze in einem hochdimensionalen Merkmalsraum zu identifizieren42. Ziel war es, eine Hyperebene zu bestimmen, die den Abstand zwischen den Klassen maximiert. Ein größerer Abstand zwischen der Entscheidungsgrenze und den nächstgelegenen Datenpunkten unterstützt in der Regel eine bessere Klassentrennung und Verallgemeinerung. Die SVM ist auf verschiedene ML-Aufgaben anwendbar, darunter Klassifikation, Regression und merkmalsbasierte Datenanalyse.
Faltungsneuronale Netze
Faltungsneuronale Netze (CNNs) wurden als Deep-Learning-(DL-)Modelle für Klassifizierungsaufgaben mit strukturierten Darstellungen von Bild- und Audiodaten verwendet. Eindimensionale CNNs (1D-CNNs) wurden ebenfalls häufig auf sequenzielle und textuelle Daten angewendet. CNN-Architekturen nutzten Faltungskerne und Pooling-Operationen, um diskriminative Merkmale aus den Eingabedaten zu extrahieren43,44. Zur Geschlechts- und Altersklassifizierung anhand von Sprachdaten wurden CNNs auf sprachbasierte Darstellungen angewendet, um Muster im Zusammenhang mit Tonhöhe, Frequenz, Klangfarbe und anderen stimmlichen Merkmalen zu lernen, die für die Unterscheidung von Geschlechts- und Altersgruppen relevant sind.
VGG19
VGG19 wurde als eine Deep-Learning-Architektur verwendet, die sich durch eine tiefe, relativ einheitliche hierarchische Struktur zur Merkmalsextraktion auszeichnet45. Die Architektur verwendet kleine 3 × 3-Faltungsfilter über 19 Schichten hinweg, wodurch eine schrittweise Extraktion diskriminativer Merkmale ermöglicht wird. Bei Anwendung auf aus Sprache abgeleitete Darstellungen erfasst VGG19 sowohl akustische Muster auf niedriger Ebene, wie Tonhöhe und Frequenzvariationen, als auch diskriminative Merkmale auf höherer Ebene. Die tiefe Architektur ermöglicht eine fortschreitende Abstraktion von Merkmalen zur Modellierung stimmlicher Eigenschaften, die mit Geschlecht und Alter assoziiert sind.
EfficientNet-Lite
EfficientNet-Lite wurde als recheneffiziente DL-Architektur verwendet46,47. Das Modell verwendete eine ausgewogene Skalierungsstrategie, um eine hohe Klassifizierungsleistung zu erzielen, während es weniger Rechenressourcen benötigte als schwerere DL-Architekturen. Sein verbundener Skalierungsansatz berücksichtigte gemeinsam die Modelltiefe, -breite und die Eingabeauflösung, um eine effiziente Merkmalsextraktion zu ermöglichen.
EfficientNet-Lite wurde für den vorgeschlagenen VoiceNet-RAI-Ansatz aufgrund seiner leichten Architektur und des günstigen Verhältnisses zwischen Klassifizierungsleistung und Modellkomplexität ausgewählt. Im Vergleich zu schwereren Architekturen verwendete es effiziente faltende Blöcke und verbundene Skalierung, um ein effektives Merkmalslernen mit weniger Parametern und geringeren Rechenanforderungen zu erreichen. Diese Eigenschaften machten EfficientNet-Lite für den vorgeschlagenen Sprachklassifizierungsansatz geeignet und boten das Potenzial für den Einsatz in ressourcenbeschränkten Umgebungen.
MobileNet
MobileNet wurde als leichtgewichtige DL-Architektur für Anwendungen mit begrenzten Rechenressourcen verwendet, einschließlich mobiler und Edge-Computing-Umgebungen48. Die hohe Recheneffizienz wurde hauptsächlich durch tiefenweise separable Faltungen erreicht, die die Anzahl der Parameter und Rechenoperationen im Vergleich zu herkömmlichen faltenden Architekturen verringerten. Diese Eigenschaften machten MobileNet geeignet, um Geschlechts- und Altersklassifizierung anhand von Sprachdaten zu bewerten, während gleichzeitig relativ geringe Rechenanforderungen beibehalten wurden.
InceptionV3
InceptionV3 wurde als tiefe Architektur verwendet, um hierarchische Merkmale aus sprachbasierten Darstellungen zu extrahieren49. Die Architektur enthielt konvolutionale, Pooling- und gemischte Operationen, um Merkmale auf unterschiedlichen Abstraktionsstufen zu extrahieren. Für die Klassifizierung von Geschlecht und Alter anhand von Stimmdaten wurde InceptionV3 eingesetzt, um komplexe akustische Muster und hierarchische Darstellungen zu lernen, die mit Variationen in den Stimmmerkmalen assoziiert sind.
Evaluationsparameter
Genauigkeit war eine der am häufigsten verwendeten Evaluierungsmetriken für Klassifizierungsaufgaben50. Obwohl die Genauigkeit eine nützliche Maßzahl für die Gesamtleistung der Klassifizierung darstellte, lieferte sie nicht immer eine umfassende Bewertung, insbesondere bei unausgeglichenen Datensätzen. Daher wurden zusätzliche Metriken wie Präzision, Sensitivität und F1-Score verwendet, um die Modellleistung zu bewerten. Diese Metriken ermöglichten eine umfassendere Beurteilung, indem sie korrekte und inkorrekte Vorhersagen für jede Klasse berücksichtigten.
Genauigkeit wurde definiert als das Verhältnis korrekt klassifizierter Beobachtungen zur Gesamtanzahl der Beobachtungen. Obwohl die Genauigkeit besonders aussagekräftig für ausgewogene Datensätze ist, war der in dieser Studie verwendete Datensatz unausgewogen. Daher wurden bei der Berechnung und Interpretation der Klassifizierungsmetriken Richtige Positive (TP), Falsch Positive (FP), Richtige Negative (TN) und Falsch Negative (FN) berücksichtigt. Die folgende Gleichung stellt die Standarddefinition der Genauigkeit dar:
Genauigkeit = (TP+TN)/(TP+TN+FP+FN)×100 (5)
Die Präzision bewertet die Fähigkeit des Klassifikators, nur relevante Instanzen zurückzugeben:
Präzision= TP/(TP+FP) ×100 (6)
Die Rückstellrate, auch Sensitivität genannt, misst die Fähigkeit des Klassifikators, alle relevanten Instanzen zu identifizieren:
Erinnerung= TP/(FN+TP) × 100 (7)
Der F1-Wert kombiniert Präzision und Sensitivität zu einer einzelnen Kennzahl und ist besonders nützlich zur Bewertung der Klassifikationsleistung bei unausgewogenen Datensätzen:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Ergebnisse
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Diskussion
Diese Studie entwickelte und evaluierte einen automatisierten Rahmen für die Geschlechts- und Altersklassifizierung anhand von Sprachdaten, indem MFCC-Merkmale und wav2vec-2.0-Embeddings mit EfficientNet-Lite kombiniert wurden. In den anfänglichen Experimenten erreichte EfficientNet-Lite eine Genauigkeit von 83,48 %, eine Präzision von 82,87 %, einen Rückruf von 84,28 % und einen F1-Score von 83,54 % unter Verwendung der ursprünglichen Merkmale. Nach der Integration der MFCC-Merkmale verbesserte sich die Leistung deutlic...
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Offenlegungen
Die Autoren haben keine Interessenkonflikte offenzulegen.
Danksagungen
Die Autoren möchten dem Princess Nourah bint Abdulrahman University Researchers Supporting Project Nummer (PNURSP2026R748), der Princess Nourah bint Abdulrahman University, Riad, Saudi-Arabien, für die Finanzierung dieser Forschung danken.
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.
Materialien
| Name | Unternehmen | Katalognummer | Kommentare |
|---|---|---|---|
| BVC Challenging Voice Set | Biometrics Vision and Computing Group / OgeNI | BVC Challenging Voice Set | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, verwendete genaue Variante | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Graphics Processing Unit | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Mozilla Common Voice Dataset | Mozilla Foundation | Common Voice, in den Experimenten verwendete Version | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | NumPy-Entwickler | Genau die in den Experimenten verwendete Version | https://numpy.org/ |
| Prozessor | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python Software Foundation | Genau die in den Experimenten verwendete Version | https://www.python.org/ |
| PyTorch | PyTorch Foundation | Genau die in den Experimenten verwendete Version | https://pytorch.org/ |
| Scikit-learn | Scikit-learn-Entwickler | Genau die in den Experimenten verwendete Version | https://scikit-learn.org/ |
| SciPy | SciPy-Entwickler | Genau die in den Experimenten verwendete Version | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, gegebenenfalls genaue Edition/Build | https://www.microsoft.com/windows/windows-11 |
Referenzen
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Zugriff eingeschränkt. Bitte melden Sie sich an oder starten Sie eine Testversion, um diesen Inhalt anzuzeigen.