Los ratones producen un complejo repertorio multisilábico de vocalizaciones ultrasónicas (USVs). Estos USVs son ampliamente utilizados como lecturas de trastornos neuropsiquiátricos. Este protocolo describe algunas de las prácticas que aprendimos y desarrollamos para inducir, recopilar y analizar consistentemente las características acústicas y la sintaxis de las canciones del ratón.
Artículo de método
Eliciando y analizando canciones masculinas de vocalización ultrasónica (USV)
En este artículo
Resumen
Resumen
Los ratones producen vocalizaciones ultrasónicas (USVs) en una variedad de contextos sociales durante el desarrollo y la edad adulta. Estos USVs se utilizan para la recuperación de madre-cachorro 1 , las interacciones juveniles 2 , opuesto e interacciones del mismo sexo 3 , 4 , 5 , y las interacciones territoriales [ 6] . Durante décadas, los USVs han sido utilizados por los investigadores como proxies para estudiar los trastornos neuropsiquiátricos y de desarrollo o conductuales 7 , 8 , 9 y, más recientemente, para comprender los mecanismos y la evolución de la comunicación vocal entre los vertebrados 10 . Dentro de las interacciones sexuales, los ratones machos adultos producen canciones de USV, que tienen algunas características similares a las canciones de cortejo de los pájaros cantores 11 . El uso de tal repertorio multisilábicoToires puede aumentar la flexibilidad potencial y la información que transportan, ya que pueden variar en la forma en que los elementos se organizan y recombinan, a saber, la sintaxis. En este protocolo se describe un método fiable para obtener canciones USV de ratones machos en diversos contextos sociales, tales como exposición a orina femenina fresca, animales anestesiados y mujeres de celo. Esto incluye condiciones para inducir una gran cantidad de sílabas de los ratones. Reducimos el registro de ruidos ambientales con cámaras de sonido de bajo costo y presentamos un método de cuantificación para detectar, clasificar y analizar automáticamente los USVs. Este último incluye la evaluación de la tasa de llamadas, el repertorio vocal, los parámetros acústicos y la sintaxis. Se describen diversos enfoques y conocimientos sobre el uso de reproducciones para estudiar la preferencia de un animal por tipos de canciones específicos. Estos métodos se utilizaron para describir los cambios acústicos y de sintaxis en diferentes contextos en ratones machos, y las preferencias de las canciones en ratones hembra.
Introducción
En relación con los seres humanos, los ratones producen vocalizaciones de baja y alta frecuencia, las más tarde conocidas como vocalizaciones ultrasónicas (USVs) por encima de nuestro rango auditivo. Los USVs se producen en una variedad de contextos, incluyendo de madre-cachorro de recuperación, las interacciones juveniles, a las interacciones de adultos opuestos o del mismo sexo [ 4 , 12] . Estos USVs se componen de un repertorio multisilábico diverso que se puede categorizar manualmente 9 o automáticamente 10 , 11 . El papel de estos USVs en la comunicación ha estado bajo creciente investigación en los últimos años. Estos incluyen el uso de los USVs como lecturas de modelos de ratones neuropsiquiátricos, el desarrollo o los trastornos del comportamiento [ 7 , 8] , y internos motivacionales / estados emocionales [ 13] . Se piensa que los USV transmiten información confiable sobre elQue es útil para el receptor 14 , 15 .
En 2005, Holy y Guo 11 , avanzaron la idea de que los ratones macho adultos USVs se organizaron como una sucesión de elementos de llamada multisilábico o sílabas similares a los pájaros cantores. En muchas especies, un repertorio multisilábico permite al emisor combinar y ordenar sílabas de diferentes maneras para aumentar la información potencial que lleva la canción. Se cree que la variación en esta sintaxis tiene una relevancia etológica para el comportamiento sexual y las preferencias de pareja 16 , 17 . Estudios posteriores mostraron que los ratones machos fueron capaces de cambiar la composición relativa de los tipos de sílabas que producen antes, durante y después de la presencia de una hembra 5 , 18 . Es decir, los ratones machos adultos usan sus USVs para el comportamiento de cortejo, ya sea para atraerO mantener un contacto estrecho con una hembra, o facilitar el apareamiento 19 , 20 , 21 . También se emiten en las interacciones hombre-varón, probablemente para transmitir información social durante las interacciones 4 . Para capturar estos cambios en los repertorios, los científicos suelen medir las características espectrales (parámetros acústicos, tales como amplitud, frecuencias, etc. ), el número de sílabas o llamadas de USV y la latencia del primer USV. Sin embargo, pocos realmente mirar a la dinámica de la secuencia de estos USVs en detalle [ 22] . Recientemente nuestro grupo desarrollado un nuevo método para medir los cambios dinámicos en el USV sílaba secuencias [ 23] . Hemos demostrado que el orden de la sílaba dentro de una canción acerca de (es decir, la sintaxis) no es aleatorio, que cambia dependiendo del contexto social, y que los animales que escuchan detectan estos cambios como pertinentes desde el punto de vista etológico.
NotamosEn muchos investigadores que estudian la comunicación animal no atribuyen al término "sintaxis" el mismo significado exacto que la sintaxis usada en el habla humana. Para los estudios de comunicación animal, significamos simplemente una secuencia ordenada, no aleatoria, de sonidos con algunas reglas. Para los seres humanos, además, se sabe que secuencias específicas tienen significados específicos. No sabemos si este es el caso de los ratones.
En este artículo y en el video asociado, nuestro objetivo es proporcionar protocolos fiables para registrar a los ratones machos en los tribunales a través de diversos contextos y realizar reproducciones. El uso de tres software utilizado secuencialmente para: 1) grabaciones automatizadas; 2) detección y codificación de sílabas; Y 3) análisis en profundidad de las características de la sílaba y la sintaxis se demuestra ( Figura 1 ]. Esto nos permite aprender más acerca de la estructura y la función de los ratones machos. Creemos que estos métodos facilitan el análisis de datos y pueden abrir nuevos horizontes en la caracterización de la comunicación vocal normal y anormalSe modelos de comunicación y trastornos neuropsiquiátricos, respectivamente.
Protocolo
Declaración ética: Todos los protocolos experimentales fueron aprobados por el Comité Institucional de Cuidado y Uso de Animales de la Universidad de Duke (IACUC) bajo el protocolo # A095-14-04. Nota: Consulte la Tabla 1 en la sección " Materiales y equipos " para obtener detalles sobre el software utilizado .
1. Estimulación y grabación de USVs de ratón
- Preparación de los machos antes de las sesiones de grabación
NOTA: Los resultados representativos se obtuvieron usando ratones machos adultos jóvenes B6D2F1 / J (7 - 8 semanas de edad). Este protocolo puede adaptarse a cualquier cepa.- Ajuste el ciclo de luz de la sala de animales en un ciclo de luz / oscuridad de 12 horas, a menos que se requiera otra cosa. Siga reglas estándar de la cubierta de 4 a 5 varones por jaula a menos que se requiera o necesite de otra manera. Tres días antes de la grabación, exponer a los machos individualmente a una hembra sexualmente madura y receptiva (hasta 3 machos con una hembra por jaula) de la misma cepa durante la noche.
- Al día siguiente quitarLa hembra de la jaula del macho y la casa de los machos sin las hembras por lo menos dos días antes de la primera sesión de grabación para aumentar la motivación social para cantar (basado en nuestros análisis anecdóticos de ensayo y error).
- Preparación de las cajas de grabación
- Utilice un refrigerador de playa (las dimensiones internas son L 27 x W 23 x H 47 cm) para actuar como un estudio de caja de atenuación de sonido ( Figura 2A ). Taladre un pequeño agujero en la parte superior de la caja para permitir que el cable del micrófono funcione.
NOTA: Es preferible registrar a los animales en un ambiente de sonido atenuado y visualmente aislado, para registrar docenas de ratones a la vez sin que éstos se oigan o se vean, impidan registrar el ruido contaminante del ambiente y las personas en la habitación y Grabaciones de sonido de los ratones ( Figura 2B ]. No hemos notado ecos de sonido o distorsiones al sonido cuando se comparan vocalizaciones del mismo ratón dentro versus fuera de tLa cámara de atenuación del sonido ( Figura 2C ); Más bien, allí los sonidos pueden ser más fuertes y tener menos armónicos dentro de la cámara. - Conecte el micrófono al cable, el cable a la tarjeta de sonido y la tarjeta de sonido al ordenador para trabajar con un software de grabación de sonido ( por ejemplo, el software A en la figura 1 y la tabla 1 ). Es necesario un software adecuado de grabación de sonido, como el software A que genera archivos de sonido .wav.
- Coloque una jaula vacía (58 x 33 x 40 cm) dentro de la caja insonorizada y ajuste la altura del micrófono para que la membrana del micrófono esté a 35 - 40 cm sobre el fondo de la jaula y que el micrófono esté centrado sobre la jaula ( Véase la figura 2A ).
- Utilice un refrigerador de playa (las dimensiones internas son L 27 x W 23 x H 47 cm) para actuar como un estudio de caja de atenuación de sonido ( Figura 2A ). Taladre un pequeño agujero en la parte superior de la caja para permitir que el cable del micrófono funcione.
- Configuración del software de grabación A ( Tabla 1 ) para grabación continua
- Haga doble clic y abra el software A. Haga clic y abra el menú "configuración" y seleccione el dispositivo denominado, Frecuencia de muestreo (250.000 Hz), formato (16 bits).
- Seleccione la opción "Trigger" y marque "Toggle".
NOTA: Este ajuste permite iniciar la grabación pulsando una tecla (F1, F2, etc. ) mientras coloca el estímulo en la jaula del ratón. - Introduzca el ID del ratón en el parámetro "Nombre".
- Establezca el tamaño máximo de archivo a los minutos de grabación deseados (por lo general se establece en 5 min).
NOTA: Cuanto más largos sean los minutos, se necesita la mayor cantidad de memoria de almacenamiento de la computadora. Si no se establece el modo continuo, el software corta los episodios de canciones al principio o al final de una secuencia basándose en parámetros establecidos, y por lo tanto no se puede cuantificar de forma fiable las secuencias.
- Registre USV usando los diferentes estímulos. Nota: Cada estímulo se puede utilizar independientemente dependiendo de las necesidades experimentales del usuario.
- Levante suavemente el animal para ser grabado por la cola, y colóquelo en una jaula sin ropa de cama (para evitar movRuido de ement en la ropa de cama) en el interior de la caja de insonorización, y poner la tapa de metal con cable abierto en la parte superior de la misma, con la tapa hacia arriba.
- Cerrar la caja atenuada y dejar que el animal se acostumbre a ello durante 15 min. Realizar la preparación de estímulos (1.4) en este momento.
- Preparación de los estímulos
- Preparación de muestras frescas de orina (UR) como estímulo
- Obtenga muestras de orina en un máximo de 5 minutos antes de la sesión de grabación para asegurar el máximo efecto en la inducción de la canción de los machos. NOTA: La orina que ha estado sentada alrededor más tiempo, y especialmente durante horas o durante la noche, no es tan efectiva 24 , 25 , que hemos verificado empíricamente 23 .
- Escoja una hembra o un varón (dependiendo del sexo del estímulo que va a usar) en una jaula, agarre la piel detrás del cuello y sujete el animal en una mano como para un procedimiento de inyección de drogas con el vientre expuesto.
- Con un par de pinzas, agarrar una punta de algodón (3 - 4 mm de largo x 2 mm de ancho). Frote suavemente y empuje la vejiga del animal para extraer una gota de orina fresca. Limpie la vagina de la hembra o el pene del macho para recoger la gota entera en la punta de algodón.
- Luego, seleccione otra jaula. Y repita el mismo procedimiento con otra hembra o macho pero con la misma punta de algodón utilizada anteriormente.
NOTA: Este procedimiento asegura mezclar la orina de al menos dos hembras o machos de dos jaulas independientes en la misma punta de algodón para asegurar contra cualquier estro u otros efectos individuales, ya que se sabe que el ciclo estral podría influir en el comportamiento del canto 18 , 26 . - Coloque la punta de algodón para ser utilizada en un plato de Petri o plástico limpio.
NOTA: Dado que la punta de algodón con orina necesitará ser usada dentro de los próximos 5 min, no hay necesidad de cubrirla para evitar la evaporación.
- PreparaciónSobre el estímulo de la hembra viva (FE) como estímulo
- Seleccione una o dos jaulas nuevas de hembras sexualmente maduras. Identifique a las hembras en la etapa de pro-estro o estro mediante inspección visual (apertura de la vagina ancha y envolvente rosa como se muestra en 27 , 28 ). Separarlos en una jaula diferente hasta su uso.
- Preparación de los animales anestesiados hembras (AF) o machos (AM) como estímulo
- Para la FA, seleccione una hembra de la piscina arriba (ya sea en pro-estro o estro). Para la AM, seleccione un macho de una jaula de ratones machos adultos.
- Anestesiar la hembra o el macho con una inyección intraperitoneal de una solución de Ketamina / Xilazina (100 y 10 mg / kg, respectivamente).
- Use un ungüento para prevenir la deshidratación de los ojos mientras el animal está anestesiado. Compruebe la anestesia adecuada probando el reflejo de retracción de la pata cuando se pellizca. Coloque el animal anestesiado en una jaula limpia sobre una toalla de papel,H la jaula de la almohadilla de calor ajustada en "calor mínimo" para asegurar el control de la temperatura corporal.
- Reutilice los mismos animales hasta 2 a 3 veces para sesiones de grabación diferentes si es necesario antes de que se despierten (por lo general alrededor de 45 minutos). Póngalos de nuevo en la almohadilla de calor después de cada sesión de grabación.
- Controlar la frecuencia respiratoria mediante inspección visual (~ 60 - 80 respiraciones por minuto) y la temperatura corporal tocando el animal cada 5 min (debe estar caliente al tacto).
- Cuando esté listo para grabar, haga clic en el botón "Grabar" del software A.
NOTA: Las grabaciones no se iniciarán a menos que el usuario haga clic en el botón de tecla asociado a cada canal; Supervisar la alimentación de audio en vivo de las jaulas en la pantalla del ordenador para asegurarse de que los animales cantan y las grabaciones se obtienen correctamente. - Pulse simultáneamente el botón correspondiente de la (s) caja (s) deseada (s) para grabar ( es decir, F1 para la casilla 1) e introduzca el estímulo deseado.
- Presente uno de los estímulos como sigue. Coloque la punta de algodón con muestras frescas de orina dentro de la jaula, o coloque la hembra viva dentro de la jaula, o coloque uno de los animales anestesiados (AF o AM) encima de la tapa de metal de la jaula.
- Cierre silenciosamente la caja de grabación y deje pasar la grabación por el número preestablecido de minutos ( por ejemplo, 5 min como se describe en la sección 1.3).
- Después de grabar, haga clic en el botón rojo para detener la grabación.
- Si se utiliza un animal anestesiado como estímulo, se abre la caja de registro a prueba de sonido, se saca el animal anestesiado de la tapa metálica de la jaula y se vuelve a colocar en la almohadilla antes de la siguiente sesión de grabación o si ya no se utiliza el animal como estimulador Cada 15 minutos hasta que haya recuperado suficiente conciencia para mantener la rectitud esternal.
- Abra la jaula y retire el animal de prueba consciente, y colóquelo de nuevo en su jaula de origen. Limpiar la jaula de prueba con alcohol al 70%Agua destilada.
- Preparación de muestras frescas de orina (UR) como estímulo
2. Procesamiento de archivos .wav y codificación de sílabas utilizando Mouse Song Analyzer v1.3
- Abra el software de codificación B ( Figura 1 , Tabla 1 ) y coloque la carpeta que contiene el Software Script C de "Analizador de Canciones de Ratón" ( Figura 1 , Tabla 1 ) en la ruta del software B haciendo clic en "set path" y agregue la carpeta en el software B. A continuación, cierre el software B para guardarlo.
- Configure los ajustes combinados de identificación de la sílaba del software B + C. NOTA: El código de programación de software C crea automáticamente una nueva carpeta llamada "sonogramas" con archivos en formato .sng en la misma carpeta donde se encuentran los archivos .wav. Por lo general, es mejor poner todos los archivos .wav de la misma sesión de grabación generada con el software A en la misma carpeta.
- Abra el software B configurado con C.
NOTA: Esta versión del software B es completamente cOmpatible con la secuencia de comandos de software C. No se puede garantizar que cualquier versión posterior acepte todas las funciones incluidas en el código actual. - Navegue hasta la carpeta de interés que contiene los archivos .wav de grabación para analizar utilizando la ventana "carpeta actual".
- En la "ventana de comandos", ingrese el comando "whis_gui".
- En la nueva ventana de whis-gui, observe varias secciones de sub-ventana con diferentes parámetros ( Figura 3 ), incluyendo "Sonogram Parameters", "Whistle Options" y todos los demás. Ajuste los parámetros para detectar USVs. Utilice los siguientes parámetros para detectar sílabas USV de ratones de laboratorio ( por ejemplo, cepas de ratón B6D2F1 / J y C57BL / 6J utilizadas en nuestros estudios):
- En la sección Parámetros de sonograma, ajuste la frecuencia mínima a 15.000 Hz, la frecuencia máxima a 125.000 Hz, la frecuencia de muestreo ( número de frecuencia ) tO 256 kHz, y el Umbral a 0,3.
- En la sección Opciones de silbato, ajuste el umbral de pureza a 0.075, la duración mínima de la sílaba a 3 ms, el barrido de frecuencia mínima a 20.000 Hz y la duración del filtro a 3 ms.
- En las otras secciones, ajuste la duración de la nota mínima a 3 ms y el recuento de la nota mínima a 1.
- Para el protocolo de categorización de sílabas, seleccione los cuadros en la sección central de la ventana whis_gui:
La categorización por defecto se basa en Holy y Guo 11 y Arriaga et al. 10 , que codifica la sílaba por el número de saltos de tono y la dirección del salto: S para la sílaba continua simple; D para un salto de paso hacia abajo; U para un salto de altura; DD para dos saltos descendentes secuenciales; DU por un dowN y un salto hacia arriba; Etc. Esto será predeterminado si el usuario no selecciona nada. El usuario tiene la opción de ejecutar el análisis de ciertos tipos de sílabas seleccionando cada uno de los cuadros representativos.
Para elegir la clasificación de sílabas según lo descrito por Scattoni, et al. 9 , además seleccione Split s category, que separa este tipo en más subcategorías basadas en la forma de la sílaba.
Seleccione Harmonics si el usuario desea ordenar las sílabas en aquellas con y sin armónicos.
- Abra el software B configurado con C.
- Clasificar las sílabas en los archivos .wav de interés
- Seleccione todos los archivos .wav de una sesión de grabación en la sección superior izquierda de la ventana whis_gui.
- Haga clic en "Obtener sonogramas" en el centro de la ventana whis_gui ( Figura 3 ). Se creará una nueva carpeta con los sonogramas, con formato de archivo .sng. Seleccione todos los sonogramas (archivos .sng) en la parte superiorEsquina izquierda de la ventana de whis-gui. Ingrese "ID de animal" y "ID de sesión" en los cuadros debajo de la ventana del archivo de sonograma. A continuación, haga clic en los sonogramas del proceso.
- Observe tres tipos de archivo en la carpeta del sonograma: "Animal ID-Session ID -Notes.csv" (contiene información sobre las notas extraídas de las sílabas), "Animal ID-Session ID -Syllables.csv" (contiene valores de todos los Incluyendo sus características espectrales y el número total de sílabas detectadas en los sonogramas), "Animal ID-Session ID -Traces.mat", (contiene representaciones gráficas de todas las sílabas).
NOTA: El archivo "Id. De sesión de ID de animal - Hileras" contiene a veces un pequeño porcentaje (2 - 16%) de sílabas USV no clasificadas que son más complejas que las seleccionadas o que tienen dos sílabas de animal superpuestas entre sí. Estos pueden ser examinados por separado del archivo de rastreo si es necesario.
- Observe tres tipos de archivo en la carpeta del sonograma: "Animal ID-Session ID -Notes.csv" (contiene información sobre las notas extraídas de las sílabas), "Animal ID-Session ID -Syllables.csv" (contiene valores de todos los Incluyendo sus características espectrales y el número total de sílabas detectadas en los sonogramas), "Animal ID-Session ID -Traces.mat", (contiene representaciones gráficas de todas las sílabas).
3. Cuantificación de la estructura y sintaxis acústica de la sílaba
NOTA: Las instrucciones para los pasos a seguir para los análisis de sintaxis iniciales se incluyen en la sección "READ ME!". Hoja de cálculo del archivo "Song Analysis Guide v1.1.xlsx", nuestra calculadora de hojas de cálculo personalizada E ( Figura 1 , Tabla 1 ).
- Abra la salida del programa de software C "ID-Sesión de identificación de animal ID -Syllables.csv" obtenido en la sección anterior con el software de hoja de cálculo D ( Figura 1 , Tabla 1 ). Contiene el número total de sílabas detectadas en todos los sonogramas, y todas sus características espectrales.
- Si aún no se ha convertido, dentro del software de hoja de cálculo D convierta este archivo .csv a separación de columnas en el software D para colocar cada valor en columnas individuales.
- Abra el archivo "Song Analysis Guide v1.1.xlsx" también en el software D. Luego haga clic enE plantilla de hoja de cálculo, y copiar y pegar los datos de archivo "Animal ID-Session ID -Syllables.csv" en esta hoja como se recomienda en las instrucciones de la hoja de plantilla. Elimine las filas con la categoría de sílabas "Sin clasificar".
- Después de quitar las filas "Sin clasificar", primero copie y recalcule los datos ISI (inter silábico intervalo) en la columna O en la columna E. En segundo lugar, copie todos los datos de la columna A a N en la hoja de cálculo 'Datos'.
- En la hoja de datos, ingrese los ID de los animales (columna AF) y la duración de la grabación (en minutos, columna AC).
NOTA: Los identificadores de los animales deben coincidir con los que se ingresaron en la configuración de grabación. El archivo detectará los caracteres introducidos y lo comparará con el nombre de los archivos .wav. - Determine el corte ISI para definir una secuencia utilizando la hoja de cálculo denominada "Density ISI", el resultado del "ISI plot".
NOTA: En nuestro estudio anterior 23 , establecimos el corte en dos standaRd desviaciones del centro del último pico. Consistió en largos intervalos (LI) de más de 250 ms, que separaron diferentes sesiones de canciones en una sesión de canto. - Ver los principales resultados en la hoja de cálculo 'Características' (que agrupa todas las características espectrales medidas de cada animal).
NOTA: Si el usuario utilizó la configuración de la categoría de sílaba por defecto en la secuencia de comandos de software C descrita en la sección 2.8.9, las sílabas se clasifican además en 4 categorías como se ha descrito anteriormente y en Chabout et al. 23 : 1) sílaba simple sin saltos de tono, «s»; 2) sílabas de dos notas separadas por un único salto ascendente («u»); 3) sílabas de dos notas separadas por un único salto descendente («d»); Y 4) sílabas más complejas con dos o más saltos de tono entre notas («m»). - Para valores de sintaxis, haga clic en la hoja de cálculo "Probabilidades globales" que calcula las probabilidades de cada par de sTipos de transición yllable independientemente de las sílabas iniciales, utilizando la siguiente ecuación 23 .
P (Ocurrencia de un tipo de transición) = Número total de ocurrencias de un tipo de transición / Número total de transiciones de todos los tipos - Haga clic en la hoja de cálculo 'Probabilidades Condicionales' para calcular las probabilidades condicionales para cada tipo de transición en relación con las sílabas iniciales, que utiliza la siguiente ecuación:
P (ocurrencia de un tipo de transición dada la sílaba inicial) = Número total de ocurrencias de un tipo de transición / Número total de ocurrencias de todos los tipos de transición con la misma sílaba de inicio - Para probar si y cuáles de las probabilidades de transición anteriores difieren de las no aleatorias, utilizando un modelo de Markov de primer orden, siguiendo el enfoque en 23 , para utilizar software personalizado F ( por ejemplo, sintaxis decorder en estudio R, Figura 1 ,Fuerte> Tabla 1) con los siguientes scripts R: Tests_For_Differences_In_Dynamics_Between_Contexts.R para dentro de los grupos en diferentes condiciones; O Tests_For_Differences_In_Dynamics_Between_Genotypes.R para entre grupos en las mismas condiciones.
- Realizar una prueba de Chi-cuadrado, u otra prueba de su preferencia, para probar las diferencias estadísticas en las probabilidades de transición del mismo animal a través de diferentes contextos (par-wise), siguiendo el enfoque en 23 .
NOTA: En 23 se encuentran más detalles sobre el modelo estadístico utilizado para comparar la sintaxis entre los grupos. Los investigadores pueden usar otros enfoques para analizar las probabilidades de transición global o condicional que ellos o otros desarrollaron. - Para mostrar gráficamente las secuencias como diagramas de sintaxis, ingrese los valores en un software de representación gráfica de red G (ver Figura 1 , Tabla 1 ), con nodos que designan diferentes códigos de sílabaGories y color de flecha y / o pixels de grosor que representan rangos de valores de probabilidad entre sílabas.
NOTA: Para mayor claridad, para los gráficos de probabilidades globales, sólo mostramos transiciones superiores a 0,005 (superior al 0,5% de ocurrencia fortuita). Para las probabilidades condicionales, usamos un umbral de 0.05 porque cada probabilidad en el "modelo global" es menor considerando que nos dividimos por el número total de sílabas y no sólo por un tipo de sílaba específico.
4. Edición de canciones y pruebas de preferencia para un tipo de canción
NOTA: Las reproducciones de USVs pueden usarse para probar experimentalmente la respuesta de comportamiento de un animal, incluyendo la preferencia por un tipo de canción específico. Debido a que las preferencias femeninas pueden cambiar dependiendo del estado de estro, para las mujeres asegúrese de que están en el mismo estado de estro antes de la prueba de la siguiente manera:
- Prepare a las hembras con experiencia sexual varios días antes del experimento de reproducción
- Exponer las hembras sexualmente maduras (> 7 semanas) a un macho durante 3 días antes de los experimentos para desencadenar el estro (efecto Whitten 28 ), colocándolas en una jaula de separación (plástico sólido transparente con orificios perforados) permitiendo a la hembra ver y El olor del macho, pero la prevención de las relaciones sexuales.
- Monitoree el ciclo del estro, y cuando el pro-estro o el estro son evidentes (abertura vaginal y rodean rosado como se muestra en 27 ), vuelva a poner a las hembras juntas en su propia jaula. Están listos para ser probados al día siguiente.
- Preparar los archivos de canciones para su reproducción
- Utilice las funciones de copiar y pegar en un software de procesamiento de sonido H ( por ejemplo, SASLap Pro, Figura 1 , Tabla 1 ) para crear dos archivos .wav editados con las condiciones deseadas para ser usados para estímulos. Para protegerse contra la cantidad de vocalizaciones como una variable, asegúrese de que los dos archivos de sonido contienen el mismo número de sYllables y longitud de secuencias (canciones) de los mismos o diferentes machos / hembras de los contextos deseados ( por ejemplo UR).
- Abra el primer archivo que contiene la canción de la condición 1 en el software H. A continuación, vaya a Archivo> Especiales> Agregar canal (es) del archivo y seleccione el segundo archivo de sonido para probar desde la condición 2. Esto crea 2 canales, uno para cada condición.
- Ajuste el volumen visualmente si es necesario para asegurarse de que los volúmenes de los dos archivos coincidan entre sí, en Edición> Volumen.
- A continuación, vaya a Edición> Formato> Conversión de frecuencia de muestreo y seleccione convertir de 250.000 Hz a 1.000.000 Hz para transformar los archivos .wav de una frecuencia de muestreo de 256 kHz a 1 MHz. Este paso es necesario para que el dispositivo de reproducción lea los archivos .wav.
- Guarde estos archivos nuevos como archivos de prueba para reproducirlos. Asegúrese de identificar qué canción es en qué canal (1 o 2). Para propósitos de claridad, denomínelo "nombre de archivo.wav".
- Ir a eXit> Formato> Cambiar Canales e intercambiar los dos canales. Guarde las versiones intercambiadas usando un nombre diferente. NOTA: Esta será la copia opuesta con los canales invertidos, denominados más tarde 'nombre de archivo_swapped.wav'.
- Preparar el aparato de reproducción
- Limpie el aparato de reproducción "Y-laberinto" con alcohol al 70% seguido de agua destilada. Seque con toallas de papel. Nuestro laberinto en Y es un aparato de plástico negro sólido, opaco, hecho en casa, con brazos de 30 cm de longitud y dos orificios perforados en los extremos del laberinto para permitir que el altavoz de ultrasonido se ajuste al nivel del piso de los brazos ( Figura 4A ).
- Asegúrese de que los altavoces estén en su posición correcta y conectados a la tarjeta de sonido, y la tarjeta esté conectada al ordenador.
- Abra el software A, seleccione Reproducir> Dispositivo y seleccione el dispositivo de tarjeta de sonido de reproducción. Seleccione "Utilizar la velocidad del encabezado del archivo". Vaya a Play> Playlist y cargue el archivo de interés que contiene los dos chaNnels ( es decir, "file.wav"). Seleccione "modo de bucle". Configure el grabador de vídeo por encima del laberinto para cubrir todo el laberinto.
- Realizar el experimento de reproducción
- Coloque a la hembra de prueba en el laberinto durante un período de habituación de 10 minutos. Después de 10 minutos, si la hembra no está en el brazo de arranque, empuje suavemente la hembra hacia el brazo de arranque y cierre la ventana de separación de plástico.
- Seleccione el archivo preparado ("file.wav") para reproducirlo y reproducirlo. Inicie la grabación de vídeo y asegúrese de identificar qué canal está situado en el brazo del laberinto Y ( es decir : UR a la izquierda o FE en el brazo derecho) con una nota de papel en el campo de visión de la grabación de vídeo.
- Permitir a la hembra para escuchar las canciones en modo de bucle y explorar el laberinto durante un número deseado de minutos ( es decir, 5 min): esta es una sesión. Devuelve la hembra de nuevo al brazo de arranque. Permítele descansar durante 1 minuto mientras prepara la siguiente sesión. Movimiento rápido del ojoOve cualquier trazas de orina y excrementos con agua destilada.
- Cargue el archivo "file_swapped.wav" Cambie la ubicación de las notas de papel para la grabación de vídeo Mueva la izquierda a la derecha y viceversa Después de 1 min, reproduzca el archivo Libere a la hembra para la segunda sesión .
- Repita los pasos 4.4.3 a 4.4.4 para un total de 4 sesiones x 5 minutos para controlar la detección de posibles sesgos laterales durante la prueba. Detenga la grabación de vídeo al final de todas las sesiones haciendo clic en el botón rojo de parada. Limpie el laberinto con alcohol al 70% y agua destilada entre las hembras.
- Repita todos los pasos con diferentes ejemplos de canciones una semana después con las mismas hembras para obtener resultados suficientes para probar la confiabilidad de los hallazgos.
- Luego observe los videos y use el temporizador en el video y un cronómetro para medir el tiempo que pasan las hembras en cada brazo para cada sesión. Analizar los datos resultantes estadísticamente para las posibles preferencias de canción.
Resultados
En el presente protocolo, se caracterizaron los cambios en el comportamiento vocal y la sintaxis de los ratones B6D2F1 / J machos. En general, utilizando este protocolo, pudimos registrar, en promedio por varón por sesión de 5 minutos, 675 ± 98,5 sílabas clasificadas en respuesta a UR femenina, 615,6 ± 72 en FE, 450 ± 134 en AF, 75,6 ± 38,9 en AM y 0,2 ± 0,1 en UR macho (n = 12 machos). Las tasas fueron ~ 130 sílabas / min para la mujer UR, ~ 120 sílabas / min para FE, o ~ 100 sílabas / min para AF contextos ( Figura 5A ]. Los machos producen una cantidad mucho mayor de sílabas en respuesta a la orina recién recogida relativa a la orina recolectada durante la noche 10 , 23 . Los varones también cantan considerablemente menos en presencia de una orina masculina o masculina anestesiada nueva Figura 5A ). Los varones también cambian su repertorio a través del contexto 23 . Por ejemplo, los machos B6D2F1 / J aumentan significativamente Producción de sílabas de salto múltiple de salto de "m" en la condición de orina femenina ( Figura 5B ). También cambian las características acústicas de las sílabas individuales a través del contexto. Por ejemplo, B6D2F1 / J machos cantan sílabas con una mayor amplitud y ancho de banda en el contexto de la orina femenina, y una mayor pureza espectral en el contexto de la mujer despierta en comparación con los otros ( Figura 6 ] [ 23] .
Este protocolo también proporciona un medio para medir las características dinámicas de la secuencia y, por tanto, los cambios de sintaxis. Utilizando un método adaptado de Ey, et al. 22 , se utiliza el ISI para definir los vacíos entre las secuencias ( Figura 7A ] [ 23] , y luego utilizar las brechas para distinguir y analizar los patrones temporales de secuencias de sílabas. Hemos demostrado longitudes más largas de secuencia se producen en el contexto femenino despierto ( Figura 7B ]F "> 23. Esta técnica nos permite calcular la relación de secuencias complejas (compuestas por al menos 2 apariciones del tipo" m "de la sílaba) frente a secuencias simples (compuestas de uno o ningún tipo" m "y, Se encontró que con los machos B6D2F1 / J el contexto de orina femenina desencadenó una proporción más alta en comparación con los otros ( Figura 7C ) 23 , indicando que produjeron sílabas más complejas en la condición de la orina femenina, pero también que dichas sílabas están distribuidas Sobre más secuencias.
También somos capaces de calcular las probabilidades de transición condicional de un tipo de sílaba a otro (24 tipos de transición total incluyendo las transiciones desde y hacia el estado de "silencio") [ 23] . Encontramos que en diferentes contextos, la elección de los ratones de los tipos de transición para las sílabas de inicio dado difiere, y que hay más sintaxis divEn la condición de la orina femenina ( Figura 8 ) 23 . Estas observaciones son consistentes con los informes anteriores que muestran que los varones pueden cambiar las características acústicas o la composición del repertorio de sus vocalizaciones en respuesta a diferentes estímulos y experiencias 4 , 5 , 24 .
Por último, el presente protocolo proporciona orientación para probar las preferencias femeninas con reproducciones. Encontramos que las hembras B6D2F1 / J prefieren canciones más complejas (que contienen 2 o más sílabas "m") en relación con canciones simples 23 . La mayoría de las mujeres eligieron permanecer más a menudo en el lado del Y-laberinto que jugó las canciones complejas ( Figura 4B ).
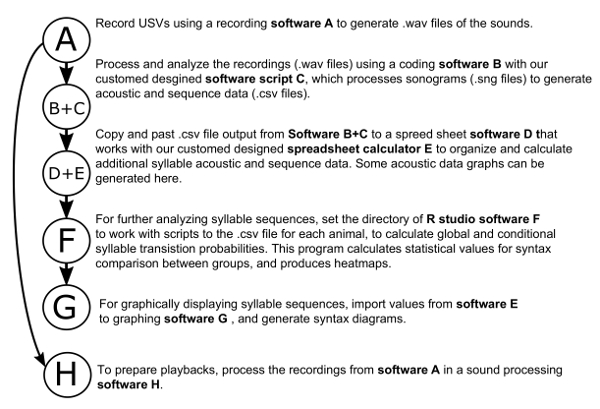
Figura 1: Diagrama de Flujo de SofUso y análisis. A cada programa y código asociado se le da un nombre de letra para ayudar a explicar su identidad y uso en el texto principal. In () son los programas específicos que utilizamos en nuestro protocolo. Haga clic aquí para ver una versión más grande de esta figura.
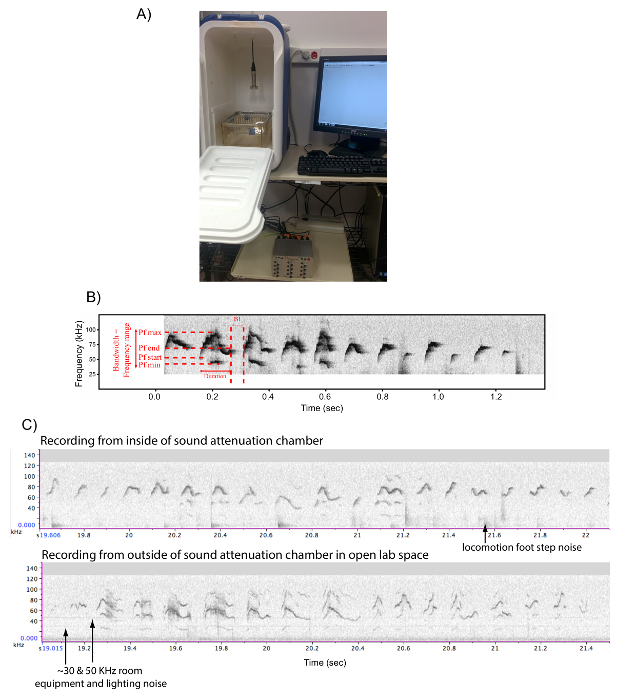
Figura 2: Configuración para la grabación de canciones de ratones masculinos. (A) Imagen de una caja de grabación de atenuación de sonido y configurada para grabar vocalizaciones de USV. (B) Ejemplo de sonograma de una grabación realizada con el Software A ( Tabla 1 ), incluyendo características espectrales detalladas calculadas por "Mouse Song Analyzer v1.3": duración, intervalo entre sílabas (ISI), frecuencia de pico min (Pf min) Frecuencia de pico máxima (Pf máx.), Inicio de frecuencia de pico (Pf inicio), frecuencia de pico (Fin Pf) y ancho de banda. (C) Sonogramas de otro macho cantando a una hembra viva, dentro de la caja de atenuación de sonido y fuera de la caja en el banco de laboratorio en la misma habitación. Nuestras observaciones anecdóticas indican que las grabaciones en la caja del mismo animal muestran mayor volumen (mayor intensidad) y menos armónicos, pero no hay evidencia de ecos en la caja sin espuma de sonido. Haga clic aquí para ver una versión más grande de esta figura.
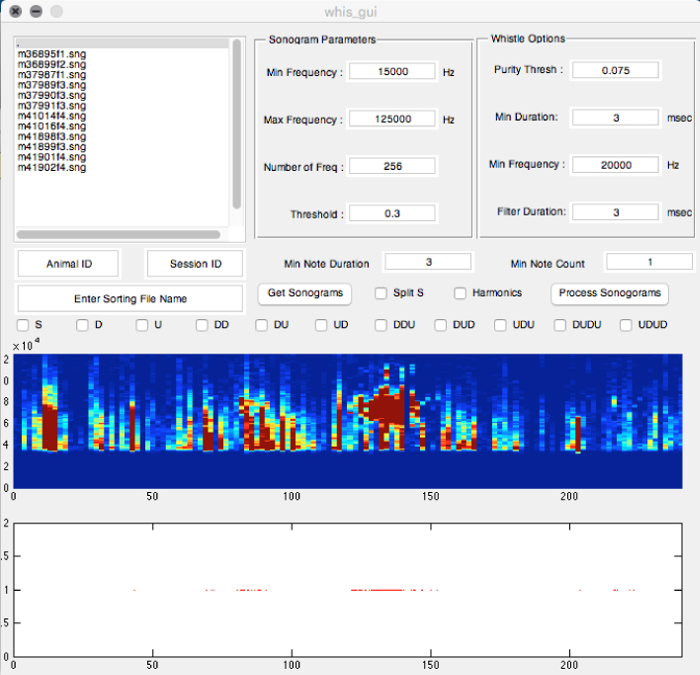
Figura 3: Captura de pantalla del "Mouse Song Analyzer v1.3" whis_gui Ventana que muestra las diferentes opciones disponibles para los análisis. Los parámetros mostrados son los que se usan para registrar USVs masculinos en las figuras y los análisis de datos presentados (excepto la duración de la nota mínima fue de 3 ms). .com / files / ftp_upload / 54137 / 54137fig3large.jpg "target =" _ blank "> Haga clic aquí para ver una versión más grande de esta figura.
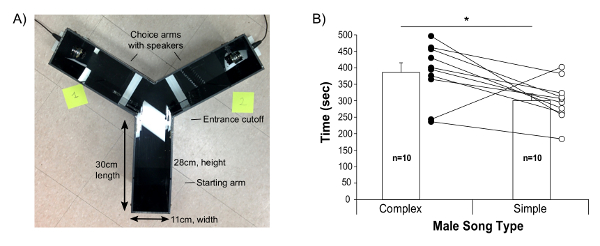
Figura 4: Selecciones femeninas entre reproducciones de canciones complejas y sencillas. (A) Imagen del aparato Y-laberinto utilizado y medidas de la dimensión. (B) Tiempo empleado por las hembras en cada brazo, jugando ya sea a partir de un complejo (orina femenina provocada) o más simple (desencadenada femenina elicited) canción del mismo macho. Se presentan datos para n = 10 ratones hembra B6D2F1J como media ± SE, con valores individuales también mostrados; 9 de las 10 mujeres mostraron preferencia por la sílaba / secuencia más compleja. * P <0,05 prueba de t de Student pareada. Figura modificada de Chabout, et al. 23 con permiso.Blank "> Haga clic aquí para ver una versión más grande de esta figura.
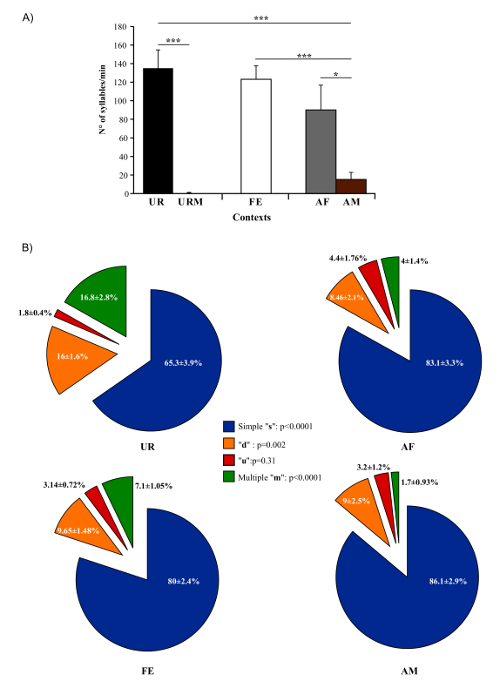
Figura 5: Número de sílabas emitidas y repertorio en condiciones diferentes . (A) Tasa de producción de sílaba de varones en diferentes contextos. (B) Composiciones del repertorio de los machos cuando están en presencia de los contextos de orina femenina (UR), hembra anestesiada (FA), hembra despierta (FE) y anestesiada (AM). Los datos se presentan como media ± SEM. P <0,03; ** p <0,005; *** p <0,0001 para la prueba post-hoc de t de Student pareada después de la corrección de Benjamini y Hochberg (n = 12 varones). La figura de Chabout, et al. 23 con permiso. Haga clic aquí para ver una versión más grande de esta figura.
Together.within-page = "1"> 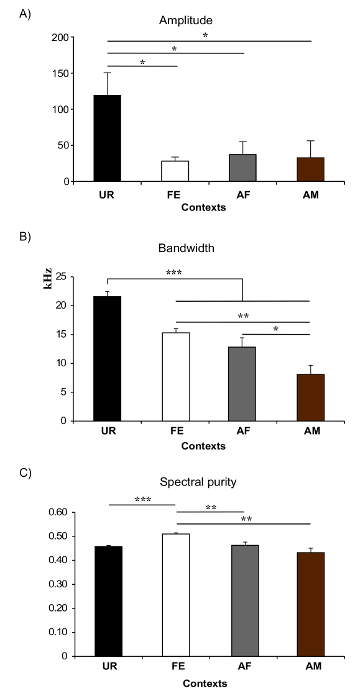
Figura 6: Ejemplos de características espectrales en diferentes contextos. (A) Amplitud. * P <0.025 para la prueba post-hoc de t de Student pareada después de la corrección. (B) Gama de frecuencia o ancho de banda. *: P & lt; 0,041; **: p & lt; 0,005; ***: p <0,0001 después de la corrección. (C) Pureza espectral de las sílabas. * P: & lt; 0,025; **: p & lt; 0,005; ***: p <0,0001 después de la corrección. Abreviaturas: orina femenina (UR), hembra anestesiada (AF), hembra despierta (FE), y anestesiada macho (AM). Las figuras modificadas de Chabout, et al. 23 con permiso. Haga clic aquí para ver una versión más grande de esta figura.
37fig7.jpg "/>
Figura 7: Mediciones de Secuencia. (A) Uso del ISI para separar la secuencia. El ISI corto (IS) y el ISI medio (MI) se utilizan para separar sílabas dentro de una secuencia, y ISI largo sobre 250 ms (LI) separa dos secuencias. (B) Longitud de las secuencias, medida como el número de sílabas por secuencia, producido por los machos en diferentes contextos. *: P & lt; 0,025; ** p <0,005; *** p <0,0001 después de la corrección. (C) Relación de canciones complejas sobre canciones simples producidas por varones en diferentes contextos. * P & lt; 0,041; ** p <0,005; *** p <0,0001 después de la corrección. Los datos se presentan como media ± SEM (n = 12 varones). La figura de Chabout, et al. 23 con permiso. Haga clic aquí para ver una versión más grande de esta figura.
Figura 8: Diagramas de sintaxis de la sílaba de secuencias basadas en probabilidades condicionales para cada contexto. El espesor de la flecha es proporcional a la probabilidad condicional de un tipo de transición en cada contexto promediado desde n = 12 machos: P (ocurrencia de una transición dada la sílaba de inicio). Para mayor claridad, no se muestran transiciones raras por debajo de una probabilidad de 0,05. La figura de Chabout, et al. 23 con permiso. Haga clic aquí para ver una versión más grande de esta figura.
Discusión
Este protocolo proporciona enfoques para recolectar, cuantificar y estudiar vocalizaciones de cortejo de ratones macho en el laboratorio a través de una variedad de estímulos relacionados principalmente con mujeres. Como se ha expuesto anteriormente en Chabout, et al. 23 y en los resultados representativos, el uso de este método nos permitió descubrir locuciones dependientes del contexto y sintaxis que importan para las hembras receptoras. La estandarización de estos estímulos proporcionará la colección de un número confiable de USVs y permitirá un análisis detallado de las canciones y repertorios masculinos de cortejo.
Cuando una hembra viva está presente con el macho, el protocolo no nos permite identificar claramente el emisor de las vocalizaciones. Sin embargo, estudios anteriores demostraron que la mayoría de las vocalizaciones emitidas en ese contexto fueron por los varones 26 , 29 . La mayoría de los estudios que usan un congénito (masculino o femenino)Como un estímulo para los hombres creen que la cantidad de vocalizaciones femeninas en estos contextos es despreciable 4 , 5 , 22 , 30 . Sin embargo, un trabajo reciente utilizó la triangulación para localizar la vocalización del emisor en condiciones de alojamiento en grupo 31 , y mostró que dentro de una díada, la hembra contribuye a ~ 10% de los USVs. En el presente protocolo el uso de la hembra anestesiada permite al usuario estudiar las vocalizaciones masculinas en presencia de una hembra sin su vocalización. En contraste con las expectativas de este estudio reciente [ 31] , no encontramos ninguna diferencia en el número de sílabas emitidas entre el FE y AF [ 23] . Es posible que las hembras vivas no contribuyeran de manera significativa a las grabaciones o que los machos vocalizaron menos en presencia de hembras vivas frente a fem anestesiadasCervezas Sin embargo, creemos que los experimentos futuros deberían considerar el uso de este método de triangulación para evaluar el efecto potencial de la contribución femenina.
Hay otro software disponible que puede hacer algunos de los pasos que hemos descrito, aunque no creemos en una manera suficiente para las preguntas que pedimos utilizando una combinación de tres programas: Software A, Mouse Song Software de análisis de sintaxis utilizando cálculos de D + E de cálculo de hoja de cálculo personalizado y descodificación de sintaxis utilizando R. Por ejemplo, un artículo reciente propuso un software denominado VoICE que permite al usuario extraer automáticamente las variables acústicas de los sonogramas o directamente sobre unidades que habían sido manualmente Seleccionado por el usuario 32 . Pero, los análisis automatizados o semiautomáticos de secuencias no son tan detallados como nuestro enfoque. Algunos programas comerciales pueden analizar automáticamente las características acústicas, pero noClasificación de las sílabas; El usuario tiene que ordenar las diferentes sílabas después. Grimsley, Gadziola, et al. 33 desarrolló un programa de órganos vocales de ratón virtual basado en tablas que agrupa sílabas basadas en características acústicas compartidas, pero no proporciona detección automática de las sílabas. Su programa 34 es único en que crea secuencias novedosas de canciones grabadas usando modelos de Markov, y por lo tanto tiene características más avanzadas que la simple edición.
La mayoría de los estudios previos de comunicación en ratones se han centrado en el lado del emisor 35 , 36 . Pocos estudios han explorado el lado del receptor 30 , 37 , 38 . Los protocolos de reproducción y discriminación proporcionan una prueba sencilla para estudiar el lado del receptor, como el descrito recientemente por Asaba, Kato, etAlabama. 39 . En ese estudio, los autores usaron una caja de prueba de dos opciones separada con espuma acústica en lugar de la caja de laberinto en Y descrita aquí. Ambas opciones tienen ventajas y desventajas. En primer lugar, el Y-laberinto no aísla el sonido de un brazo a otro, pero la caja de dos opciones sí. Sin embargo, al usar el diseño del laberinto en Y, el animal puede evaluar rápidamente las dos canciones que se tocan simultáneamente y avanzar hacia la preferida. Sin embargo, los experimentos de reproducción en general ayudan a los experimentadores a determinar el significado y por lo tanto las funciones de las vocalizaciones generadas para los animales conspécificos. En conclusión, después de dominar las técnicas de este protocolo y los análisis, los lectores deben ser capaces de abordar muchas preguntas que influyen en el contexto, la genética y la neurobiología de USV de ratón.
Utilizando los ratones B6D2F1 / J, los estímulos asociados femeninos casi siempre disparan los USV de los machos que hemos probado en nuestro laboratorio. Es crítico paraCt suficientes sílabas (> 100 en 5 min) para poder obtener un fuerte análisis estadístico. Para solucionar problemas, si no se registran USV (o no lo suficiente), compruebe la configuración para asegurarse de que se graban sonidos. Haga una inspección en vivo de lo que está sucediendo en la jaula durante la grabación mirando el sonograma en tiempo real en la pantalla del ordenador después de la introducción del estímulo. De lo contrario intentar volver a exponer al macho a una hembra sexualmente madura / receptiva durante la noche y luego alojarlos solo durante varios días o hasta una semana antes de grabar de nuevo. Basado en observaciones anecdóticas, encontramos que algunos machos cantan mucho en un día (durante casi los 5 minutos completos), y no mucho al día siguiente, y luego otra vez otro día. No sabemos la razón por la que ocurre tal variabilidad dentro del sujeto, pero suponemos que es probablemente una motivación o estacional para los varones, y el estado de estro para la orina femenina. Si no se registra ningún USV, intente registrar al animal en varios días para recoger estos efectos variables. NoComo en los pájaros cantores, no hemos notado diferencias manifiestas en la cantidad de canto en función del momento del día. Encontramos que los machos no cantan mucho (<100 sílabas en 5 min) antes de que tengan 7 semanas de edad.
Los métodos de detección presentados aquí pueden extraer miles de sílabas y todos los parámetros acústicos en pocos minutos. Pero como cualquier método de detección automática, es muy sensible al ruido de fondo. El uso del software de detección de Song Song con grabaciones ruidosas (por ejemplo, de animales registrados con lecho) puede requerir un ajuste del "umbral" de detección para permitir más flexibilidad. Sin embargo, esto también aumentará el número de sílabas falsas positivas y la detección automática podría fallar. En tales circunstancias, se puede usar la codificación manual.
Como se indicó anteriormente, el número, los repertorios y la latencia de las vocalizaciones son ampliamente variables dependiendo de la tensión, por lo que se puede tener que cambiar los parámetros (duración de la grabación,Estímulo, detección automatizada de sílabas, etc. ) para algunas cepas para asegurar grabaciones óptimas para análisis estadísticos.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Este trabajo fue apoyado por los fondos del Instituto Médico Howard Hughes a EDJ. Damos las gracias a Pr. Sylvie Granon (NeuroPSI - Universidad Paris sur XI - FRANCIA) por prestarnos el hardware del altavoz. También damos las gracias a los miembros del Laboratorio Jarvis por su apoyo, discusiones, correcciones y comentarios sobre este trabajo, especialmente Joshua Jones Macopson por su ayuda con figuras y pruebas. Damos las gracias al Dr. Gustavo Arriaga por su ayuda con el software Mouse Song Analyzer, actualizándolo para nosotros a V1.3, y otros aspectos de este protocolo. V1.0 del software fue desarrollado por Holy y Guo, y v1.1 y v1.3 por Arriaga.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Nevera de playa insonorizada | Ver Gus papel tiene más información sobre el tipo | Dimensiones interiores (L 27 x W 23 x H 47 cm): | |
| Micrófono de ultrasonido de condensador CM16/CMPA | Avisoft Bioacoustics, Berlín, Alemania | #40011 | Incluye cable de extensión |
| Tarjeta de sonido Ultrasound Gate 1216H | Avisoft Bioacoustics, Berlín, Alemania | #34175 | Tarjeta de sonido de 12 canales |
| Ultrasound Gate Player 216H | Avisoft Bioacoustics, Berlín, Alemania | #70117 | Reproductor de reproducción de 2 canales |
| Altavoz electrostático ultrasónico ESS polaroid | Avisoft Bioacoustics, Berlín, Alemania | #60103 | 2 altavoces de reproducción |
| Jaula de pruebas | Ace | #PC75J | 30 x 8 x 13 cm de altura; plexiglás |
| separación de plexiglás | hecho en | casa-4 | x 13 cm plexiglás con agujeros de 1 cm |
| Cámara de video | Logitech | C920 | logitech HD Pro webcam C920 |
| Almohadilla térmica | Rayo | de sol 722-810-000 | |
| Laberinto en Y | Hecho en | casa-Dimensiones | interiores (L 30 x W 11 x H 29 cm): |
| Pinzas | |||
| Software | |||
| Avisoft Recorder (Software A) | Avisoft Bioacoustics, Berlín, Alemania | #10101, #10111, #10102, #10112 | http://www.avisoft.com |
| MATLAB R2013a (Software B) | MathWorks | - | MATLAB R2013a (8.1.0.604) |
| Mouse Song Analyzer v1.3 (Software C) | Diseñado a medida por Holy, Guo, Arriaga & Jarvis; Se ejecuta con el software B | http://jarvislab.net/wp-content/uploads/2014/12/Mouse_Song_Analyzer_ v1.3-2015-03-23.zip | |
| Microsoft Office Excel 2013 (Software D) | Microsoft-Microsoft | Office | |
| Excel Song Analysis Guide v1.1 (Software E) | Diseñado a medida por Chabout & Jarvis. Hojas de calculadora de Excel, se ejecuta con el software D | http://jarvislab.net/wp-content/uploads/2014/12/Song-analysis_Guided.xlsx | |
| Decreto de sintaxis v1.1 (Software F) | Diseñado a medida por Sakar, Chabout, Dunson, Jarvis - en R studio | https://www.rstudio.com/products/rstudio/download/ | |
| Graphiz (Software G) | AT& T Investigación y otros | http://www.graphviz.org | |
| Avisoft SASLab (Software H) | Avisoft Bioacoustics, Berlín, Alemania | #10101, #10111, #10102, #10112 | http://www.avisoft.com |
| Reactivos | |||
| Xilacina (20 mg/mL) | anaseda | ||
| (100 mg/mL) | Henry Schein | #045822 | |
| agua | |||
| ungüento para los ojos | Puralube Ungüento Veterinario | NDC 17033-211-38 | |
| Placas | |||
| con puntas |
Referencias
- Amato, F. R., Scalera, E., Sarli, C., Moles, A. Pups call, mothers rush: does maternal responsiveness affect the amount of ultrasonic vocalizations in mouse pups. Behav. Genet. 35, 103-112 (2005).
- Panksepp, J. B., et al. Affiliative behavior, ultrasonic communication and social reward are influenced by genetic variation in adolescent mice. PloS ONE. 2, e351(2007).
- Moles, A., Costantini, F., Garbugino, L., Zanettini, C., D'Amato, F. R. Ultrasonic vocalizations emitted during dyadic interactions in female mice: a possible index of sociability. Behav. Brain Res. 182, 223-230 (2007).
- Chabout, J., et al. Adult male mice emit context-specific ultrasonic vocalizations that are modulated by prior isolation or group rearing environment. PloS ONE. 7, e29401(2012).
- Yang, M., Loureiro, D., Kalikhman, D., Crawley, J. N. Male mice emit distinct ultrasonic vocalizations when the female leaves the social interaction arena. Front. Behav. Neurosci. 7, (2013).
- Petric, R., Kalcounis-Rueppell, M. C. Female and male adult brush mice (Peromyscus boylii) use ultrasonic vocalizations in the wild. Behaviour. 150, 1747-1766 (2013).
- Bishop, S. L., Lahvis, G. P. The autism diagnosis in translation: shared affect in children and mouse models of ASD. Autism Res. 4, 317-335 (2011).
- Lahvis, G. P., Alleva, E., Scattoni, M. L. Translating mouse vocalizations: prosody and frequency modulation. Genes Brain & Behav. 10, 4-16 (2011).
- Scattoni, M. L., Gandhy, S. U., Ricceri, L., Crawley, J. N. Unusual repertoire of vocalizations in the BTBR T+tf/J mouse model of autism. PloS ONE. 3, (2008).
- Arriaga, G., Zhou, E. P., Jarvis, E. D. Of mice, birds, and men: the mouse ultrasonic song system has some features similar to humans and song-learning birds. PloS ONE. 7, (2012).
- Holy, T. E., Guo, Z. Ultrasonic songs of male mice. PLoS Biol. 3, 2177-2186 (2005).
- Portfors, C. V. Types and functions of ultrasonic vocalizations in laboratory rats and mice. J. Amer. Assoc. Lab. Anim. Science: JAALAS. 46, 28-28 (2007).
- Wohr, M., Schwarting, R. K. Affective communication in rodents: ultrasonic vocalizations as a tool for research on emotion and motivation. Cell Tissue Res. , 81-97 (2013).
- Pasch, B., George, A. S., Campbell, P., Phelps, S. M. Androgen-dependent male vocal performance influences female preference in Neotropical singing mice. Animal Behav. 82, 177-183 (2011).
- Asaba, A., Hattori, T., Mogi, K., Kikusui, T. Sexual attractiveness of male chemicals and vocalizations in mice. Front. Neurosci. 8, (2014).
- Balaban, E. Bird song syntax: learned intraspecific variation is meaningful. Proc. Natl. Acad. Sci. USA. 85, 3657-3660 (1988).
- Byers, B. E., Kroodsma, D. E. Female mate choice and songbird song repertoires. Animal Behav. 77, 13-22 (2009).
- Hanson, J. L., Hurley, L. M. Female presence and estrous state influence mouse ultrasonic courtship vocalizations. PloS ONE. 7, (2012).
- Pomerantz, S. M., Nunez, A. A., Bean, N. J. Female behavior is affected by male ultrasonic vocalizations in house mice. Physiol. & Behav. 31, 91-96 (1983).
- White, N. R., Prasad, M., Barfield, R. J., Nyby, J. G. 40- and 70-kHz Vocalizations of Mice (Mus musculus) during Copulation. Physiol. & Behav. 63, 467-473 (1998).
- Hammerschmidt, K., Radyushkin, K., Ehrenreich, H., Fischer, J. Female mice respond to male ultrasonic 'songs' with approach behaviour. Biology Letters. 5, 589-592 (2009).
- Ey, E., et al. The Autism ProSAP1/Shank2 mouse model displays quantitative and structural abnormalities in ultrasonic vocalisations. Behav. Brain Res. 256, 677-689 (2013).
- Chabout, J., Sarkar, A., Dunson, D. B., Jarvis, E. D. Male mice song syntax depends on social contexts and influences female preferences. Front. Behav. Neurosci. 9. 76, (2015).
- Hoffmann, F., Musolf, K., Penn, D. J. Freezing urine reduces its efficacy for eliciting ultrasonic vocalizations from male mice. Physiol. & Behav. 96, 602-605 (2009).
- Roullet, F. I., Wohr, M., Crawley, J. N. Female urine-induced male mice ultrasonic vocalizations, but not scent-marking, is modulated by social experience. Behav. Brain Res. 216, 19-28 (2011).
- Barthelemy, M., Gourbal, B. E., Gabrion, C., Petit, G. Influence of the female sexual cycle on BALB/c mouse calling behaviour during mating. Die Naturwissenschaften. 91, 135-138 (2004).
- Byers, S. L., Wiles, M. V., Dunn, S. L., Taft, R. A. Mouse estrous cycle identification tool and images. PloS ONE. 7, (2012).
- Whitten, W. K. Modification of the oestrous cycle of the mouse by external stimuli associated with the male. J. Endocrinol. 13, 399-404 (1956).
- Whitney, G., Coble, J. R., Stockton, M. D., Tilson, E. F. ULTRASONIC EMISSIONS: DO THEY FACILITATE COURTSHIP OF MICE. J. Comp. Physiolog. Psych. 84, 445-452 (1973).
- Asaba, A., et al. Developmental social environment imprints female preference for male song in mice. PloS ONE. 9, 87186(2014).
- Neunuebel, J. P., Taylor, A. L., Arthur, B. J., Egnor, S. E. Female mice ultrasonically interact with males during courtship displays. eLife. 4, (2015).
- Burkett, Z. D., Day, N. F., Penagarikano, O., Geschwind, D. H., White, S. A. VoICE: A semi-automated pipeline for standardizing vocal analysis across models. Scientific Reports. 5, 10237(2015).
- Grimsley, J. M., Gadziola, M. A., Wenstrup, J. J. Automated classification of mouse pup isolation syllables: from cluster analysis to an Excel-based "mouse pup syllable classification calculator". Front. Behav. Neurosci. 6, (2012).
- Grimsley, J. M. S., Monaghan, J. J. M., Wenstrup, J. J. Development of social vocalizations in mice. PloS ONE. 6, (2011).
- Portfors, C. V., Perkel, D. J. The role of ultrasonic vocalizations in mouse communication. Curr. Opin. Neurobiol. 28, 115-120 (2014).
- Merten, S., Hoier, S., Pfeifle, C., Tautz, D. A role for ultrasonic vocalisation in social communication and divergence of natural populations of the house mouse (Mus musculus domesticus). PloS ONE. 9, 97244(2014).
- Neilans, E. G., Holfoth, D. P., Radziwon, K. E., Portfors, C. V., Dent, M. L. Discrimination of ultrasonic vocalizations by CBA/CaJ mice (Mus musculus) is related to spectrotemporal dissimilarity of vocalizations. PloS ONE. 9, 85405(2014).
- Holfoth, D. P., Neilans, E. G., Dent, M. L. Discrimination of partial from whole ultrasonic vocalizations using a go/no-go task in mice. J. Acoust. Soc. Am. 136, 3401(2014).
- Asaba, A., Kato, M., Koshida, N., Kikusui, T. Determining Ultrasonic Vocalization Preferences in Mice using a Two-choice Playback. J Vis Exp. , (2015).
Reimpresiones y permisos
