Este protocolo guía a los principiantes en bioinformática a través de una línea de análisis introductoria de CUT&RUN que permite a los usuarios completar un análisis inicial y la validación de los datos de secuenciación de CUT&RUN. Completar los pasos de análisis descritos aquí, combinados con la anotación de picos aguas abajo, permitirá a los usuarios extraer información mecanicista sobre la regulación de la cromatina.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Análisis introductorio y validación de datos de secuenciación CUT&RUN
En este artículo
Resumen
Resumen
La técnica CUT&RUN facilita la detección de las interacciones proteína-ADN en todo el genoma. Las aplicaciones típicas de CUT&RUN incluyen la creación de perfiles de cambios en las modificaciones de la cola de histonas o el mapeo de la ocupación de la cromatina del factor de transcripción. La adopción generalizada de CUT&RUN está impulsada, en parte, por las ventajas técnicas sobre ChIP-seq convencional que incluyen menores requisitos de entrada de celdas, menores requisitos de profundidad de secuenciación y mayor sensibilidad con una señal de fondo reducida debido a la falta de agentes de reticulación que de otro modo enmascararían los epítopos de anticuerpos. La adopción generalizada de CUT&RUN también se ha logrado gracias al generoso intercambio de reactivos por parte del laboratorio de Henikoff y el desarrollo de kits comerciales para acelerar la adopción por parte de los principiantes. A medida que aumenta la adopción técnica de CUT&RUN, el análisis y la validación de la secuenciación de CUT&RUN se convierten en cuellos de botella críticos que deben superarse para permitir la adopción completa por parte de los equipos de laboratorio predominantemente húmedos. El análisis CUT&RUN suele comenzar con controles de calidad de las lecturas de secuenciación sin procesar para evaluar la profundidad de la secuenciación, la calidad de la lectura y los posibles sesgos. A continuación, las lecturas se alinean con un ensamblaje de secuencia genómica de referencia y, posteriormente, se emplean varias herramientas bioinformáticas para anotar las regiones genómicas del enriquecimiento de proteínas, confirmar la interpretabilidad de los datos y extraer conclusiones biológicas. Aunque se han desarrollado múltiples canales de análisis in silico para soportar el análisis de datos de CUT&RUN, su compleja estructura de múltiples módulos y el uso de múltiples lenguajes de programación hacen que las plataformas sean difíciles para los principiantes en bioinformática que pueden carecer de familiaridad con múltiples lenguajes de programación pero desean comprender el procedimiento de análisis de CUT&RUN y personalizar sus canales de análisis. Aquí, proporcionamos un protocolo de canalización de análisis CUT&RUN paso a paso en un solo idioma, diseñado para usuarios con cualquier nivel de experiencia en bioinformática. Este protocolo incluye la realización de controles de calidad críticos para validar que los datos de secuenciación son adecuados para la interpretación biológica. Esperamos que seguir el protocolo introductorio proporcionado en este artículo, combinado con la anotación de picos aguas abajo, permita a los usuarios extraer información biológica de sus propios conjuntos de datos de CUT&RUN.
Introducción
La capacidad de medir las interacciones entre las proteínas y el ADN genómico es fundamental para comprender la biología de la regulación de la cromatina. Los ensayos eficaces que miden la ocupación de la cromatina para una proteína determinada proporcionan al menos dos datos clave: i) la localización genómica y ii) la abundancia de proteínas en una región genómica determinada. El seguimiento de los cambios en el reclutamiento y la localización de una proteína de interés en la cromatina puede revelar loci diana directa de la proteína y revelar las funciones mecanicistas de esa proteína en los procesos biológicos basados en la cromatina, como la regulación de la transcripción, la reparación del ADN o la replicación del ADN. Las técnicas disponibles hoy en día para perfilar las interacciones proteína-ADN están permitiendo a los investigadores explorar la regulación con una resolución sin precedentes. Estos avances técnicos han sido posibles gracias a la introducción de nuevas técnicas de perfilado de cromatina que incluyen el desarrollo de la escisión bajo objetivos y la liberación mediante nucleasa (CUT&RUN) por parte del laboratorio Henikoff. CUT&RUN ofrece varias ventajas técnicas sobre la inmunoprecipitación de cromatina convencional (ChIP) que incluyen menores requisitos de entrada de células, menores requisitos de profundidad de secuenciación y una mayor sensibilidad con una señal de fondo reducida debido a la falta de agentes de reticulación que de otro modo enmascararían los epítopos de anticuerpos. La adopción de esta técnica para estudiar la regulación de la cromatina requiere una comprensión profunda del principio subyacente a la técnica y una comprensión de cómo analizar, validar e interpretar los datos de CUT&RUN.
El procedimiento CUT&RUN comienza con la unión de las células a la concanavalina A conjugada con perlas magnéticas para permitir la manipulación de números bajos de células durante todo el procedimiento. Las células aisladas se permeabilizan utilizando un detergente suave para facilitar la introducción de un anticuerpo que se dirige a la proteína de interés. A continuación, la nucleasa microcócica (MNasa) se recluta para el anticuerpo unido mediante una etiqueta de proteína A o proteína A/G unida a la enzima. El calcio se introduce para iniciar la actividad enzimática. La digestión de MNasa da lugar a complejos mononucleosomales de ADN-proteína. Posteriormente, el calcio se quela para finalizar la reacción de digestión, y los fragmentos cortos de ADN de la digestión de la MNasa se liberan de los núcleos, luego se someten a la purificación del ADN, la preparación de la biblioteca y la secuenciación de alto rendimiento1 (Figura 1).
Los enfoques in silico para mapear y cuantificar la ocupación de proteínas en todo el genoma se han desarrollado en paralelo con los enfoques de laboratorio húmedo utilizados para enriquecer esas interacciones ADN-proteína. La identificación de regiones de señales enriquecidas (picos) es uno de los pasos más críticos en el análisis bioinformático. Los métodos iniciales de análisis ChIP-seq utilizaron algoritmos como MACS2 y SICER3, que emplearon modelos estadísticos para distinguir los sitios de unión proteína-ADN de buena fe del ruido de fondo. Sin embargo, el menor ruido de fondo y la mayor resolución de los datos CUT&RUN hacen que algunos programas de llamadas máximas empleados en el análisis ChIP-seq no sean adecuados para el análisis CUT&RUN4. Este reto pone de manifiesto la necesidad de contar con nuevas herramientas más adecuadas para el análisis de los datos de CUT&RUN. SEACR4 representa una de esas herramientas desarrolladas recientemente para permitir la llamada máxima de los datos de CUT&RUN, al tiempo que supera las limitaciones asociadas con las herramientas que normalmente se emplean para el análisis ChIP-seq.
Las interpretaciones biológicas de los datos de secuenciación de CUT&RUN se extraen de las salidas posteriores a la llamada de picos en la canalización de análisis. Se pueden implementar varios programas de anotación funcional para predecir la relevancia biológica potencial de los picos llamados a partir de los datos de CUT&RUN. Por ejemplo, el proyecto Gene Ontology (GO) proporciona una identificación funcional bien establecida de genes de interés 5,6,7. Diversas herramientas y recursos de software facilitan el análisis de GO para revelar genes y conjuntos de genes enriquecidos entre los picos de CUT&RUN 8,9,10,11,12,13,14. Además, el software de visualización como Deeptools15, Integrative genomics viewer (IGV)16 y UCSC Genome Browser17 permiten la visualización de la distribución de señales y patrones en regiones de interés en todo el genoma.
La capacidad de extraer interpretaciones biológicas a partir de los datos de CUT&RUN depende fundamentalmente de la validación de la calidad de los datos. Los componentes críticos a validar incluyen la evaluación de: i) la calidad de la secuenciación de la biblioteca CUT&RUN, ii) la similitud replicada y iii) la distribución de la señal en los centros de picos. Completar la validación de los tres componentes es crucial para garantizar la fiabilidad de las muestras de la biblioteca CUT&RUN y los resultados de los análisis posteriores. Por lo tanto, es esencial establecer guías introductorias de análisis CUT&RUN para permitir que los principiantes en bioinformática y los investigadores de laboratorio húmedo realicen dichos pasos de validación como parte de sus canales de análisis CUT&RUN estándar.
Junto con el desarrollo del experimento CUT&RUN de laboratorio húmedo, se han desarrollado varias tuberías de análisis CUT&RUN in silico, como CUT&RUNTools 2.018,19, nf-core/cutandrun20 y CnRAP21, para respaldar el análisis de datos de CUT&RUN. Estas herramientas proporcionan enfoques potentes para analizar conjuntos de datos CUT&RUN y CUT&Tag de una sola celda y masivos. Sin embargo, la estructura relativamente compleja del programa modular y la familiaridad requerida con múltiples lenguajes de programación para llevar a cabo estas canalizaciones de análisis pueden dificultar la adopción por parte de los principiantes en bioinformática que buscan comprender a fondo los pasos de análisis de CUT&RUN y personalizar sus propias canalizaciones. La elusión de esta barrera requiere una nueva canalización de análisis CUT&RUN introductoria que se proporciona en scripts simples paso a paso codificados con un solo lenguaje de programación simple.
En este artículo, describimos un sencillo protocolo de canalización de análisis CUT&RUN de un solo idioma que proporciona scripts paso a paso compatibles con descripciones detalladas para permitir que los usuarios nuevos y novatos realicen análisis de secuenciación CUT&RUN. Los programas utilizados en esta canalización están disponibles públicamente por los grupos de desarrolladores originales. Los pasos principales descritos en este protocolo incluyen la alineación de lectura, la llamada de picos, el análisis funcional y, lo que es más importante, los pasos de validación para evaluar la calidad de la muestra y determinar la idoneidad y confiabilidad de los datos para la interpretación biológica (Figura 2). Además, esta canalización brinda a los usuarios la oportunidad de hacer referencias cruzadas de los resultados del análisis con los conjuntos de datos CUT&RUN disponibles públicamente. En última instancia, este protocolo de canalización de análisis CUT&RUN sirve como guía introductoria y referencia para los principiantes en análisis bioinformático y los investigadores de laboratorio húmedo.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
NOTA: La información sobre los archivos fastq de CUT&RUN en GSE126612 está disponible en la Tabla 1. La información relacionada con las aplicaciones de software utilizadas en este estudio se enumera en la Tabla de Materiales.
1. Descargar el pipeline de Easy-Shells_CUTnRUN desde su página de Github
- Abra el terminal desde el sistema operativo.
NOTA: Si el usuario no está seguro de cómo abrir el terminal en macOS y Windows, revise esta página web (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Para Linux, revise esta página web (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Descargue la canalización de análisis comprimido de Github escribiendo wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip en el terminal.
- Después de descargar el archivo zip, descomprima el archivo zip descargado escribiendo unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ en el terminal.
- Después de la descompresión, elimine el archivo zip escribiendo rm ~/Desktop/Easy-Shells_CUTnRUN.zip en el terminal y cambie el nombre de la carpeta escribiendo mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- Después de eliminar el archivo comprimido, escriba chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh en el terminal para establecer el permiso ejecutable para todos los scripts de shell dentro del directorio de trabajo. A partir de ahora, simplemente escriba la ruta y el nombre de estos scripts de shell en la terminal o arrastre los scripts a la terminal e ingrese para ejecutar estos scripts de shell en la terminal.
NOTA: El shell Bash suele estar preinstalado en la mayoría de las distribuciones de Linux. Sin embargo, las versiones recientes de macOS ya no proporcionan un shell Bash preinstalado. Si el sistema no tiene Bash, instale primero el shell de Bash. Visite los enlaces a continuación para obtener instrucciones que describen cómo instalar el shell Bash en el sistema operativo Linux (https://ioflood.com/blog/install-bash-shell-linux/) y macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:). Estos scripts de shell paso a paso se escriben para crear una carpeta ~/Desktop/GSE126612 para realizar la mayor parte de este análisis CUT&RUN dentro de este directorio sin necesidad de modificación. Si el usuario entiende cómo usar estos scripts de shell, los usuarios pueden revisar y personalizar estos scripts de shell para analizar otros conjuntos de datos de CUT&RUN y modificar las opciones según las necesidades específicas del proyecto. Para leer y editar estos scripts de shell, considere la posibilidad de usar Visual Studio Code (https://code.visualstudio.com/) como una opción para un programa fácil de usar disponible para los principales sistemas operativos.
2. Instalación de los programas necesarios para Easy Shells CUTnRUN
- Entre los scripts de shell con el nombre de Script_01_installation_***.sh, averigüe el script de shell cuyo nombre incluye el tipo de sistema operativo del sistema del usuario. Actualmente, Easy Shells CUTnRUN soporta el script de instalación para sistemas basados en macOS, Debian/Ubuntu y CentOS/RPM.
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- En el terminal, opere el script de shell de instalación escribiendo ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh o arrastre el archivo de script de shell al terminal e ingrese.
- Lea Test_README.md en la carpeta /path/to/SEACR-1.3/Testfiles. Siga las instrucciones dentro del archivo README para aclarar si el SEACR en el sistema del usuario funciona correctamente.
NOTA: Es crucial validar la función SEACR con los archivos de prueba proporcionados por la página de Github de SEACR para obtener resultados adecuados de llamadas máximas a partir de los datos de CUT&RUN. Por lo tanto, siga las instrucciones de Test_README.md en /path/to/SEACR-1.3/Testfiles inmediatamente después de la instalación de SEACR. Aunque Easy Shells CUTnRUN proporciona scripts de shell de instalación para algunos sistemas operativos, es posible que estos scripts no funcionen en el sistema de algunos usuarios para instalar todos los programas necesarios para Easy Shells CUTnRUN. Si hay algún problema en la instalación, revise el sitio web original del programa desinstalado o solicite ayuda utilizando la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
3. Descargar el conjunto de datos CUT&RUN disponible públicamente desde el Archivo de lectura de secuencias (SRA)
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script: (i) creará una carpeta (~/Desktop/GSE126612/fastq) y descargará una lista de archivos SRA escritos en un archivo de texto (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) dentro de la carpeta fastq. A modo de ejemplo, el SRR_list.txt incluye los archivos fastq de un subconjunto de muestras de CUT&RUN GSE126612. (ii) Descargue los archivos fastq sin procesar dentro de la carpeta fastq. (iii) Cree una carpeta (~/Desktop/GSE126612/log/fastq) y anote un archivo de registro (download-fastq_log.txt) y un archivo de información de muestra descargado (SRR_list_info.txt) dentro de esta carpeta de registro. - Después de ejecutar el script, compruebe el archivo de registro. Si hay algún mensaje de error en el archivo de registro, corrija el error y vuelva a intentar el paso 3.3. Si hay algún problema para resolverlo, pida ayuda en la página web de problemas de github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Para facilitar la práctica de esta línea de análisis CUT&RUN, se recuperan las siguientes muestras disponibles públicamente de SRA: una muestra de control simulado (IgG), tres muestras de una arquitectura de cromatina y proteína factor de transcripción (CTCF), cuatro muestras correspondientes a una marca de histonas "activa" (H3K27Ac) y tres muestras correspondientes a regiones de iniciación transcripcional marcadas por la ARN polimerasa II (RNAPII-S5P). La secuenciación se realizó en pareado, por lo que se emparejan dos archivos por muestra.
4. Control de calidad inicial de los archivos de secuenciación sin procesar
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh en el terminal o arrastre el script de shell al terminal e introduzca.
NOTA: Este script de shell: (i) Ejecutará el programa FastQC para todos los archivos fastq sin procesar en la carpeta ~/Desktop/GSE126612/fastq y guardará los archivos del informe de verificación de calidad en la carpeta ~/Desktop/GSE126612/fastqc.1st . (ii) Escriba un archivo de registro (fastqc.1st.log.SRR-number.txt) por ejecución de FastQC en una carpeta de registro (~/Desktop/GSE126612/log/fastqc.1st). - Una vez finalizada la ejecución del script de shell, revise el archivo de registro para aclarar el éxito de la ejecución. Si hay algún mensaje de error en el archivo de registro, corríjalo y repita el paso 4.3. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Entre los archivos de salida, los archivos fastqc.html incluyen resultados de control de calidad fáciles de usar. Si hay problemas graves de calidad, hable con sus colegas de bioinformática para determinar la idoneidad de los datos para el análisis posterior. Se utilizan informes de control de calidad similares para confirmar la mejora de la calidad de los datos después del recorte del adaptador. Para utilizar este script para otros conjuntos de datos, edite la ruta de los directorios de trabajo y de salida para satisfacer las necesidades del usuario. Una diferencia notable a la hora de interpretar el control de calidad de CUT&RUN en comparación con las lecturas de ChIP-seq es que las lecturas duplicadas en CUT&RUN no indican necesariamente duplicados de PCR. Esto se debe a que la MNase reclutada se digiere en el mismo lugar o en lugares similares dentro de los grupos experimentales.
5. Calidad y recorte del adaptador para archivos de secuenciación sin procesar
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh en el terminal o arrastre el script Script_04_trimming.sh al terminal e introduzca.
NOTA: Este script de shell: (i) Ejecutará el programa Trim-Galore para todos los archivos fastq sin procesar en ~/Desktop/GSE126612/fastq para realizar un recorte de adaptador y calidad. (ii) Cree una carpeta (~/Desktop/GSE126612/trimmed) y guarde los archivos de salida de Trim-Galore dentro de la carpeta recortada. (iii) Cree una carpeta de registro (~/Desktop/GSE126612/log/trim_galore) y anote un archivo de registro trim_galore_log_RSS-number.txt por cada ejecución de Trim-Galore. - Una vez finalizada la ejecución, revise detenidamente el archivo de registro. Si hay algún mensaje de error en el archivo de registro, corríjalo y repita el paso 5.3. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
- Una vez completado este proceso, compare los archivos de salida .html con los archivos fastqc.html creados en 4.3. Revise la ruta de los directorios de entrada y salida para realizar el paso de recorte de cualquier archivo fastq ubicado en otro lugar.
6. Descarga del índice bowtie2 para los genomas de referencia para muestras de control reales y con picos
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh en el terminal o arrastre el script de shell al terminal e introduzca.
NOTA: Este script: (i) Descargará los índices Bowtie2 para los genomas de referencia de muestras reales (humanos; hg19; utilizados en la publicación original22) y los genomas de referencia de control Spike-in (levadura en ciernes; R64-1-1) en la carpeta bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Escriba un archivo de registro (bowtie2-index-log.txt) en un directorio de registro (~/Desktop/GSE126612/log/bowtie2-index). - Una vez finalizada la ejecución, compruebe el archivo de registro. Si hay algún mensaje de error, corríjalo y repita el paso 6.3. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Actualmente, los índices de Bowtie2 para varios genomas de referencia se proporcionan en el sitio web de Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Los usuarios pueden editar Script_05_bowtie2-index.sh para descargar cualquier índice de Bowtie2 para cumplir con los requisitos del usuario. Si el usuario no puede localizar el índice Bowtie2 del genoma de referencia de interés, localice los archivos fasta de la secuencia del genoma de referencia de:- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- Página web de la UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- u otras bases de datos específicas de especies.
Después de localizar los archivos fasta de la secuencia del genoma de referencia, cree un índice Bowtie2 para el genoma de referencia descargado siguiendo la sección (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) "El indexador de construcción de bowtie2" del sitio web de Bowtie2.
7. Mapeo de lecturas de secuenciación CUT&RUN recortadas a los genomas de referencia
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script de shell: (1) Ejecutará el programa bowtie2 para mapear todos los archivos fastq recortados y del adaptador tanto para el experimental (humano; hg19) como para el control de picos (levadura en ciernes; R64-1-1) genomas de referencia de forma independiente. (ii) Ejecute la función de vista samtools para comprimir los archivos de pares de lectura asignados en formato bam. (iii) Cree una carpeta (~/Desktop/GSE126612/bowtie2-mapped) y guarde el archivo comprimido de pares de lectura mapeados dentro de la carpeta bowtie2-mapped. (iv) Cree una carpeta (~/Desktop/GSE126612/log/bowtie2-mapped) y anote el registro del proceso de mapeo como archivo de texto bowtie2_log_hg19_SRR-number.txt para pares de lectura mapeados en el genoma de referencia hg19 y bowtie2_log_R64-1-1_SRR-number.txt para pares de lectura mapeados en R64-1-1) para indicar la eficiencia del mapeo dentro de la carpeta de registro de mapeo bowtie2. - Una vez finalizada la ejecución, compruebe el archivo de registro. Si hay algún mensaje de error en el archivo de registro, corríjalo y vuelva a ejecutar el script de shell. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Este script de shell ejecuta bowtie2 con opciones para mapear archivos de secuenciación de extremos emparejados para encontrar pares de lectura mapeados concordantemente con longitudes de fragmento de 10 bp-700 bp. Descubra las descripciones de las opciones escribiendo bowtie2 --help en el terminal o visitando el sitio web de bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) para comprender y cambiar las opciones según sea necesario. Utilice este script de shell para asignar cualquier otro archivo fastq cambiando la ruta y el formato de nombre de los archivos fastq y los índices Bowtie2.
8. Ordenar y filtrar los archivos de pares de lectura asignados
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo "chsh -s $(which bash)" en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script: (i) Ejecutará la función de vista samtools para todos los archivos de pares de lectura mapeados comprimidos en la carpeta ~/Desktop/GSE126612/bowtie2-mapped para filtrar los pares de lectura mapeados en regiones de cromosomas no canónicos, listas negras anotadas públicamente y regiones de repetición de TA. (ii) Ejecute la función de ordenación samtools para ordenar los archivos bam filtrados por los nombres de los fragmentos o coordenadas dentro del mismo directorio. (iii) Anote un archivo de registro por un archivo bam de entrada en el directorio ~/Desktop/GSE126612/log/filter-sort-bam . - Una vez finalizada la ejecución, revise detenidamente los archivos de registro. Si hay algún mensaje de error en los archivos de registro, corríjalo e intente ejecutar el script de shell de nuevo. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Los archivos bam (salida) resultantes ordenados por los nombres de los fragmentos servirán como archivos de entrada para crear archivos BED de fragmentos y recuentos de lecturas sin procesar bedGraph. Los archivos bam ordenados por coordenadas servirán como archivos de entrada para generar archivos BEDPE de fragmentos. Todos los BED, bedGraph y BEDPE se utilizarán para la llamada de picos y la visualización en el análisis posterior. Todos los archivos de lecho de anotaciones para las regiones cromosómicas canónicas (chr1~22, chrX, chrY y chrM), las regiones de lista negraanotadas públicamente 23 y las regiones de repetición TA18 se encuentran en el directorio ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Si es necesario, use este directorio para agregar archivos de lista negra adicionales. Utilice este script de shell para realizar las mismas funciones para otros archivos bam de pares de lectura asignados cambiando la ruta y el nombre de los archivos bam. Escriba samtools view --help y samtools sort --help en el terminal para obtener más información sobre estas funciones.
9. Convierta pares de lecturas asignadas en fragmentos BEDPE, BED y recuentos de lecturas sin procesar archivos bedGraph
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script: (i) Ejecutará la función filterdup y awk de macs3 para convertir archivos bam ordenados por coordenadas en archivos BEDPE fragmentados cuyas longitudes de fragmento son inferiores a 1 kb, y guardará los archivos BEDPE en ~/Desktop/GSE126612/BEDPE. (ii) Cree un directorio de registro (~/Desktop/GSE126612/log/bam-to-BEDPE) y anote un archivo de registro por archivo de fragmentos de lecturas asignados. (iii) Ejecute las funciones bedtools bamtobed y awk, cut, sort para convertir archivos bam ordenados por los nombres de los fragmentos en archivos BED de fragmentos cuyas longitudes de fragmento son inferiores a 1 kb. (iv) Cree una carpeta (~/Desktop/GSE126612/bam-to-bed) y guarde los archivos BED de fragmentos dentro de la carpeta bam-to-bed. (v) Escriba un archivo de registro por archivo BED de fragmentos de lecturas mapeados en un directorio de registro (~/Desktop/GSE126612/log/bam-to-bed). (vi) Ejecute la función bedtools genomecov para generar archivos bedGraph de recuentos de lecturas sin procesar utilizando los archivos BED de fragmentos en una carpeta (~/Desktop/GSE126612/bedGraph). - Una vez finalizada la ejecución, compruebe detenidamente los archivos de registro. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Los archivos bedGraph de recuentos de lecturas sin procesar de salida se utilizarán como archivos de entrada para el programa de llamadas máximas SEACR con la opción de normalización en la sección 12 y la normalización de recuento de lecturas fraccional escalado (SFRC)22 en la sección 10. Los archivos BED de fragmentos servirán como archivos de entrada para lecturas mapeadas normalizadas por millón con picos en la normalización de control negativo (SRPMC) 24,25 en la sección10.To capturar fragmentos cortos (>100 bp) solo para datos CUT&RUN de factores asociados a la cromatina, cambie el paso de filtración de fragmentos en este script y continúe con el paso de normalización. Para comparar las señales CUT&RUN entre fragmentos de tamaño corto y regular dentro de la misma muestra, la normalización de SFRC puede ser útil para reducir el posible efecto de reducción de muestreo causado por la captura de fragmentos cortos solamente. Utilice este script de shell para realizar los mismos procesos para otros archivos bam ordenados secuenciados emparejados cambiando la ruta y el formato de nombre de los archivos bam y bed.
10. Conversión de archivos bedGraph de recuentos de lecturas sin procesar a archivos bedGraph y bigWig normalizados
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar el bucle for con la función awk para crear archivos bedGraph normalizados por SFRC utilizando archivos bedGraph de readcounts sin procesar dentro de ~/Desktop/GSE126612/bedGraph. (ii) Ejecute la función bedGraphToBigWig para crear un formato comprimido (.bw) de los archivos bedGraph normalizados de SFRC en ~/Desktop/GSE126612/bigWig. (iii) Anote un archivo de registro para registrar el factor de normalización utilizado para el cálculo de SFRC por ejecución y guarde el archivo de registro dentro de ~/Desktop/GSE126612/log/SFRC. - Una vez finalizada la ejecución, compruebe los archivos de registro. Si hay algún mensaje de error, corríjalo y vuelva a ejecutar el script de shell. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: La normalización de recuento de lecturas fraccional a escala se utilizó en la publicación original22 del conjunto de datos CUT&RUN GSE126612. La fórmula de la normalización en el bin i es la misma que se muestra a continuación: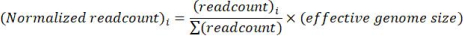
Dado que este método de normalización no incluye la normalización con control negativo (por ejemplo, muestra de IgG) ni el control de picos, este enfoque puede no ser ideal para observar la diferencia de señal en todo el genoma entre muestras. Sin embargo, dado que este método es teóricamente similar a otras normalizaciones basadas en recuentos totales de lecturas (por ejemplo, recuento por millón), sería suficiente observar la diferencia de señal local entre las muestras. - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script: (i) Ejecutará el bucle for con la función bedtools genomecov para crear archivos bedgraph normalizados SRPMC en ~/Desktop/GSE126612/bedGraph utilizando archivos BED de fragmentos en ~/Desktop/GSE126612/bam-to-bed. (ii) Anote un archivo de registro para registrar los factores de normalización utilizados para la normalización de SRPMC por una ejecución en ~/Desktop/GSE126612/log/SRPMC. (iii) Ejecute la función bedGraphToBigWig para crear un formato comprimido (.bw) de los archivos bedGraph normalizados y guarde los archivos bigWig normalizados en la carpeta ~/Desktop/GSE126612/bigWig . - Una vez finalizada la ejecución, revise detenidamente los archivos de registro. Si hay algún mensaje de error en los archivos de registro, corríjalo y vuelva a ejecutar el script de shell. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: La fórmula de normalización de SRPMC se desarrolló para normalizar los recuentos de lecturas de muestras reales con control negativo (muestra de IgG, por ejemplo) y control de pico mediante la combinación de RPM (lecturas por millón de lecturas asignadas), RPS (proporción de lecturas por pico de lectura) y relación de señal relativa para controlar24,25. La definición de RPS es la misma que la siguiente:
Al aplicar RPS tanto para la muestra real como para la muestra de control negativa, la relación de señal relativa (RS) para controlar la muestra real se puede calcular de la siguiente manera: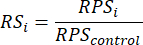
Y la definición del factor de normalización de RPM (RPM:NF) es la misma que se muestra a continuación: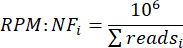
A partir de aquí, el factor de normalización SRPMC (SRPMC:NF) ha salido combinando el RS y el RPM:NF: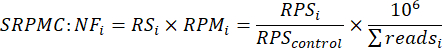
Y esta fórmula se puede simplificar de la siguiente manera:
Por lo tanto, el método SRPMC normaliza las lecturas por la (1) relación de lecturas de picos entre el control y la muestra, y (2) lecturas de control normalizadas RPM. Dado que este factor de normalización tiene en cuenta las lecturas de picos y hace que las lecturas de control sean comparables entre muestras juntas, este método sería apropiado para observar la diferencia en todo el genoma entre las muestras y reducir el efecto de lote en las lecturas totales de muestras reales y controles en diferentes experimentos con lotes. Estos archivos bedGraph normalizados se convertirán en archivos de entrada para llamar a los picos mediante SEACR en la sección 11. Y estos archivos bigWig normalizados se utilizarán en la visualización de loci a través de IGV y en la creación de mapas de calor y gráficos promedio a través de Deeptools. Se recomienda encarecidamente utilizar un navegador de genomas para visualizar el patrón de paisaje del conjunto de datos CUT&RUN utilizando los archivos bigWig normalizados en regiones genómicas representativas para evaluar la calidad de los datos. Es probable que sea apropiado omitir las muestras CUT&RUN que muestran patrones de señal de fondo ruidosos que se asemejan al control IgG para los análisis posteriores. Utilice estos scripts de shell para normalizar otros archivos de lecho de lecturas y recuentos de lecturas sin procesar archivos bedGraph cambiando la ruta y los nombres de archivo para los archivos bed y bedgraph de entrada y salida. Edite estos scripts para aplicar otros cálculos de normalización cambiando los factores y la fórmula dentro de este script.
11. Validación de la distribución del tamaño de los fragmentos
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script está escrito para: (i) Ejecutar picard.jar función CollectInsertSizeMetrics utilizando archivos bam de pares de lectura asignados en la carpeta ~/Desktop/GSE126612/filtered-bam para identificar la distribución del tamaño de inserción. (ii) Cree una carpeta (~/Desktop/GSE126612/insert-size-distribution) y guarde los resultados del análisis de distribución del tamaño de inserción en la carpeta creada. (iii) Escriba un archivo de registro por un archivo bam de entrada en la carpeta ~/Desktop/GSE126612/log/insert-size-distribution . - Una vez finalizada la ejecución, compruebe detenidamente los archivos de registro. Si hay algún mensaje de error en los archivos de registro, corrija el error e intente ejecutar el script de shell de nuevo. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: En general, el análisis del tamaño de la plaquita (salida) para muestras CUT&RUN muestra picos importantes en los rangos de tamaño nucleosomal mono- (100-300 pb) y di- (300-500 pb). Los errores/limitaciones técnicas (como la digestión excesiva o insuficiente de MNasa durante la preparación de la muestra CUT&RUN o la selección incorrecta del tamaño durante la preparación de la biblioteca) pueden causar el enriquecimiento de fragmentos iguales o más grandes que los trinucleosomales (500-700 pb) e iguales o más cortos que los subnucleosomales (<100 pb). A veces, la ausencia de picos de tamaño mononucleosómico con el enriquecimiento de los fragmentos largos (>500 pb) y cortos (<100 pb) puede deberse a los rangos de selección de tamaño de la biblioteca elegidos en la etapa de laboratorio húmedo o a la baja profundidad de secuenciación. Compare la profundidad de secuenciación ('bases secuenciadas totales' / 'tamaño total del genoma de referencia'), la descripción general del panorama genómico utilizando recuentos de lecturas normalizados, archivos bigWig en la sección 10 y el patrón de distribución del tamaño de las inserciones para aclarar la calidad de las muestras CUT&RUN procesadas. Las líneas discontinuas de los histogramas representan la "fracción acumulativa" de las lecturas con un tamaño de inserción mayor o igual que el valor del eje x. Esta línea discontinua permite identificar la distribución de los tamaños de inserción en el archivo de lecturas asignadas de entrada. La progresión a lo largo del eje x se asocia con el aumento del tamaño de la plaquita. La línea discontinua identifica la proporción de pares de lectura asignados en el archivo bam de entrada que tienen un tamaño de inserción al menos tan grande como el indicado en la posición del eje x de intersección. Por lo tanto, la interpretación comienza en 1 a la izquierda, lo que indica que todas las lecturas tienen un tamaño de inserción mayor o igual que el tamaño más pequeño, y disminuye hacia 0 a medida que aumenta el tamaño de inserción.
12. Picos de llamadas usando MACS2, MACS3 y SEACR
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar las funciones callpeak y callpeak de macs2 con y sin control IgG utilizando archivos BEDPE de fragmentos para llamar a los picos y guardar los resultados de las llamadas de picos en los directorios de salida (~/Desktop/GSE126612/MACS2 y ~/Desktop/GSE126612/MACS3). (ii) Anote el registro de estos picos de llamadas como archivo de texto en el directorio de registro (~/Desktop/GSE126612/log/MACS2 y ~/Desktop/GSE126612/log/MACS3) - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar SEACR_1.3.sh script con y sin control IgG, con opciones estrictas y relajadas utilizando archivos bedGraph y bedGraph normalizados y readcounts sin procesar para llamar a los picos. (ii) Cree un directorio de salida (~/Desktop/GSE126612/SEACR-peaks) y guarde los resultados de las llamadas máximas por SEACR. (iii) Anote el registro de estos picos de llamadas como archivo de texto en el directorio de registro (~/Desktop/GSE126612/log/SEACR). - Una vez finalizado la ejecución de los scripts de shell, compruebe detenidamente los archivos de registro. Si hay algún mensaje de error en los archivos de registro, corríjalo primero. Es posible que algunos programas no llamen los picos para la muestra de control de IgG con la opción de control de IgG juntos, por lo tanto, omitan el mensaje de error con respecto a la muestra de control de IgG con la opción de control de IgG. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Estos dos scripts de shell realizan llamadas de picos para muestras CUT&RUN utilizando tres llamadores de picos (MACS2, MACS3 y SEACR) con varias opciones: con/sin opción de control IgG, usando archivos bedGraph de recuentos de lecturas sin procesar con la opción de normalización del llamador máximo o archivos bedGraph de recuentos de lecturas normalizados sin la opción de normalización del llamador máximo, y opciones de llamada al pico SEACR estrictas y relajadas. Dado que los archivos de salida de llamada de picos no son suficientes para ser utilizados directamente en los análisis posteriores, Easy Shells CUTnRUN incluye un script para procesar estos archivos de salida llamados picos para crear nuevos archivos de picos que incluyen cromosoma, inicio, fin y nombre de picos. A través de enfoques intensivos de llamadas máximas, Easy Shells CUTnRUN ofrece la oportunidad de elegir el programa de llamadas máximas más adecuado para el proyecto CUT&RUN de un usuario comparando los picos llamados en tres llamadas máximas. Además, este canal de análisis de CUT&RUN también ofrece la oportunidad de seleccionar las opciones de llamadas máximas más adecuadas para el proyecto CUT&RUN de un usuario. Estas comparaciones se realizarán mediante diagrama de Venn, y la visualización en forma de mapa de calor y gráfico promedio.
13. Creación de archivos de lecho de pico llamados
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar la función awk utilizando archivos de cama en la carpeta ~/Desktop/GSE126612/SEACR para crear dos tipos de archivos de cama de pico SEACR ~/Desktop/GSE126612/bed_SEACR carpeta. Los archivos completos del lecho de picos incluyen el inicio y el final de cada pico, y los archivos del lecho de picos enfocados incluyen el inicio y el lecho del intervalo de señal más alto dentro de cada pico. (ii) Ejecute la función awk utilizando archivos _peaks.xls en las carpetas ~/Desktop/GSE126612/MACS2 y ~/Desktop/GSE126612/MACS3 para crear archivos de lecho de pico completos que incluyen el inicio y el final de cada pico llamado por MACS2 y MACS3 en las carpetas ~/Desktop/GSE126612/peak-bed_MACS2 y ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Ejecute la función awk utilizando archivos _summits.bed en las carpetas ~/Desktop/GSE126612/MACS2 y ~/Desktop/GSE126612/MACS3 para crear archivos de lecho de pico enfocados que incluyen el inicio y el final de la bandeja más significativa dentro de cada pico. (iv) Los archivos de registro se escriben en formato de archivo de texto en la carpeta ~/Desktop/GSE126612/log/peak-bed . - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar la función de intersección bedtools utilizando archivos de lecho de picos a los que se llama sin la opción de control de IgG para eliminar picos superpuestos con picos de control de IgG. (ii) Los archivos filtrados de peak bed se guardan en las carpetas ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 y ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Se crea un archivo de registro log_filter-peaks.txt en la carpeta ~/Desktop/GSE126612/log/filter-peaks . - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script está escrito para: (i) Ejecutar funciones cat y sort para concatenar los archivos de lecho de pico completo MACS2 y MACS3 de las réplicas como un archivo de lecho de pico y ordenar el archivo de lecho de pico concatenado en la carpeta ~/Desktop/GSE126612/bed-for-comparison . (ii) Ejecute la función de fusión de herramientas de cama utilizando los archivos de lecho de picos completos concatenados para fusionar picos que se superponen entre sí. (iii) Se escribe un archivo de registro log_cat-merged-peak-bed_MACS.txt en la carpeta de registro ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script está escrito para: (i) Ejecutar funciones cat y sort para concatenar los archivos de lecho de pico completo SEACR de las réplicas como un archivo de lecho de pico y ordenar el archivo de lecho de pico concatenado en la carpeta ~/Desktop/GSE126612/bed-for-comparison . (ii) Ejecute la función de fusión de herramientas de cama utilizando los archivos de lecho de picos completos concatenados para fusionar picos que se superponen entre sí. (iii) Un archivo de registro log_cat-merged-peak-bed_SEACR.txt se escribe en la carpeta de registro ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Una vez finalizada la ejecución de los scripts de shell, revise los archivos de registro cuidadosamente. Si hay algún mensaje de error en los archivos de registro, corríjalo y vuelva a ejecutar los scripts. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: Los archivos de lecho de pico de todas las regiones de pico se utilizarán como archivos de entrada del análisis del diagrama de Venn para comparar la similitud entre las opciones de llamada de picos, los métodos de llamada de picos, las réplicas y las observaciones del paisaje genómico cerca de las regiones de picos. Los archivos de lecho de pico de regiones de pico completas fusionadas se utilizarán para el análisis de componentes principales (PC) y el análisis de correlación de coeficiente de Pearson utilizando deeptools. Los archivos de lecho de picos enfocados se utilizarán para el mapa de calor y el análisis de gráficos promedio utilizando Deeptools.
14. Validar la similitud entre réplicas utilizando la correlación de Pearson y el análisis de componentes principales (PC).
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell de Bash es el shell predeterminado en el terminal actual, los usuarios pueden ver lo siguiente: /path/to/bash (o un mensaje similar como /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash de forma predeterminada, omita este paso.
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar la función de archivo BED multiBamSummary utilizando los archivos bam de las réplicas, que se ordenaron por coordenadas, y fusionaron archivos de lecho de pico completo para CTCF, H3K27Ac y RNAPII-S5P para generar archivos de matriz para el análisis de correlación de Pearson en la carpeta Desktop/GSE126612/deeptools_multiBamSummary . (ii) Ejecute la función plotCorrelation utilizando los archivos de matriz para realizar el cálculo del coeficiente de correlación de Pearson y la agrupación de mapas de calor y guarde el resultado en la carpeta ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Anote un archivo de registro log_plotCorrelation.txt en la carpeta ~/Desktop/GSE126612/log/correlation . - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar la función de archivo BED multiBamSummary utilizando los archivos bam, que se ordenaron por coordenadas, y fusionaron archivos de lecho de picos completos, que incluyen todos los picos CTCF, H3K27ac y RNAPII-S5P, para generar archivos de matriz para el análisis de componentes principales (PCA) en la carpeta Desktop/GSE126612/deeptools_multiBamSummary . (ii) Ejecute la función plotPCA utilizando los archivos de matriz para realizar PCA y guarde el resultado en la carpeta ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Anote un archivo de registro log_plotPCA.txt en la carpeta ~/Desktop/GSE126612/log/correlation . - Una vez finalizado la ejecución de los scripts de shell, compruebe los archivos de registro. Si hay algún mensaje de error, corríjalo y vuelva a ejecutar los scripts de shell. Si hay algún problema para resolverlo, solicite ayuda a través de la página web de problemas de github (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues) de Easy Shells CUTnRUN.
NOTA: En principio, las réplicas debidamente preparadas y procesadas muestran valores más altos del coeficiente de correlación de Pearson dentro del mismo grupo de agrupamiento y una posición cercana en el análisis de componentes principales. Cualquier réplica, que muestre un coeficiente de correlación de Pearson más bajo, y una larga distancia de otras réplicas en la gráfica de componentes principales, puede representar un valor atípico potencial entre las réplicas. Este script de shell es aplicable para cualquier dato de lectura asignado en formato bam. Cambie la ruta y el nombre de archivo de los archivos bigwig para cumplir con los requisitos específicos del proyecto.
15. Validar la similitud entre réplicas, métodos de llamada de picos y opciones usando el diagrama de Venn
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell Bash es el shell predeterminado en el terminal actual, puede haber algo como /path/to/bash (por ejemplo, /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash como predeterminado, considere omitir este paso
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script está escrito para: (i) Ejecutar la función venn de intervención utilizando archivos de lecho de picos de toda la región de picos para encontrar superposiciones entre los picos llamados por varias opciones (con / sin opción de control de IgG, con / sin normalización y opciones de llamada de pico estrictas / relajadas para SEACR). (ii) Cree una carpeta (~/Desktop/GSE126612/intervene_methods) y guarde los resultados del análisis del diagrama de Venn en esta carpeta. (iii) Anote un archivo de registro log_intervene_methods.txt en la carpeta ~/Desktop/GSE126612/log/intervene. - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
NOTA: Este script está escrito para: (i) Ejecutar la función venn de intervención utilizando archivos de lecho de picos de toda la región de picos para encontrar superposiciones entre los picos de las réplicas. (ii) Cree una carpeta (~/Desktop/GSE126612/intervene_replicates) y guarde los resultados del análisis del diagrama de Venn en esta carpeta. (iii) Anote un archivo de registro log_intervene_replicates.txt en la carpeta ~/Desktop/GSE126612/log/intervene . - Una vez finalizado el proceso de ejecución de los scripts de shell, revise los archivos de registro. Si hay algún mensaje de error, corríjalo y vuelva a ejecutar los scripts de shell. Si hay algún problema en el uso de la canalización de análisis de Easy Shells CUTnRUN, pida ayuda en la página web de problemas de Github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Estos resultados del análisis del diagrama de Venn brindan información para elegir las opciones, métodos y réplicas de llamada de picos más apropiados con alta reproducibilidad para el análisis posterior. Es preferible elegir las opciones y métodos de llamada pico que muestren los números pico más altos con buena superposición con otros métodos y opciones de llamada pico.
16. Analizar mapas de calor y gráficos de promedio para visualizar los picos llamados.
- Abra el terminal y escriba echo $SHELL para comprobar el shell predeterminado en el terminal activo. Si el shell Bash es el shell predeterminado en el terminal actual, puede haber algo como /path/to/bash (por ejemplo, /bin/bash) en el terminal.
- Si el shell predeterminado no es Bash, establezca Bash shell como shell predeterminado escribiendo chsh -s $(which bash) en el terminal. Si el terminal usa el shell Bash como predeterminado, considere omitir este paso
- Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh en el terminal o arrastre el archivo de script de shell al terminal e ingrese.
NOTA: Este script está escrito para: (i) Ejecutar la función de punto de referencia computeMatrix utilizando archivos bigWig normalizados y archivos de lecho de picos enfocados para hacer matrices de recuentos de lecturas normalizadas en el centro de los picos enfocados en la carpeta ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Ejecute la función plotHeatmap utilizando la matriz de recuentos de lecturas normalizados para generar mapas de calor y gráficos de promedios que visualicen el patrón de distribución de recuentos de lecturas normalizados en las ubicaciones de picos enfocadas. (iii) Cree una carpeta (~/Desktop/GSE126612/deeptools_plotHeatmap) y guarde los archivos de salida de plotHeatmap dentro de esta carpeta. (iv) Anote un archivo de registro log_plotHeatmap_focused.txt en la carpeta ~/Desktop/GSE126612/log/plotHeatmap . - Escriba ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh en el terminal o arrastre el archivo de script de shell al terminal e introduzca.
Este script está escrito para: (i) Ejecutar la función de punto de referencia computeMatrix utilizando archivos bigWig normalizados y archivos de lecho de picos completos para hacer matrices de recuentos de lecturas normalizadas en el centro de los picos enteros en la carpeta ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Ejecute la función plotHeatmap utilizando la matriz de recuentos de lecturas normalizados para generar mapas de calor y gráficos de promedios que visualicen el patrón de distribución de recuentos de lecturas normalizados en todas las ubicaciones de picos. (iii) Cree una carpeta (~/Desktop/GSE126612/deeptools_plotHeatmap) y guarde los archivos de salida de plotHeatmap dentro de esta carpeta. (iv) Anote un archivo de registro log_plotHeatmap_whole.txt en la carpeta ~/Desktop/GSE126612/log/plotHeatmap . - Una vez finalizado el proceso de ejecución de los scripts de shell, revise los archivos de registro. Si hay algún mensaje de error, corríjalo y vuelva a ejecutar los scripts de shell. Si hay algún problema en el uso de la canalización de análisis de Easy Shells CUTnRUN, pida ayuda en la página web de problemas de Github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Idealmente, las ubicaciones de las cumbres de los picos MACS2/3 y las ubicaciones de los picos focalizados de los SEACR exhiben una distribución de señal nítida y enfocada en el centro de los gráficos. Sin embargo, si el algoritmo de llamada de picos no funciona correctamente para los datos CUT&RUN, puede aparecer una distribución de señal "ruidosa" menos focalizada en los gráficos. Por lo tanto, el uso del número de picos llamados y los patrones de distribución de la señal de pico de los gráficos de salida guiará la determinación de la validez de pico para análisis CUT&RUN posteriores que incluyan la anotación de pico aguas abajo.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
La calidad y el recorte del adaptador conservan las lecturas con alta calidad de secuenciación
Las técnicas de secuenciación de alto rendimiento son propensas a generar errores de secuenciación, como "mutaciones" de secuencia en las lecturas. Además, los dímeros del adaptador de secuenciación se pueden enriquecer en conjuntos de datos de secuenciación debido a una mala extracción del adaptador durante la preparación de la biblioteca. Los errores de secuenciación excesivos, como las mutaciones de lectu...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
La capacidad de mapear la ocupación de proteínas en la cromatina es fundamental para realizar estudios mecanicistas en el campo de la biología de la cromatina. A medida que los laboratorios adoptan nuevas técnicas de laboratorio húmedo para perfilar la cromatina, la capacidad de analizar los datos de secuenciación de esos experimentos de laboratorio húmedo se convierte en un cuello de botella común para los científicos de laboratorio húmedo. Por lo tanto, describimos un protocolo introdu...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran no divulgar.
Agradecimientos
Todas las figuras ilustradas fueron creadas con BioRender.com. CAI reconoce el apoyo brindado a través de un Premio al Investigador de Carrera Temprana de la Alianza para la Investigación del Cáncer de Ovario, una Subvención Aceleradora de la Fundación Forbeck y el Premio Nacional de Investigación de Detección Temprana de la Alianza de Cáncer de Ovario de Minnestoa.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Software para comprimir y convertir recuentos de lecturas bedGraph a bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ la U. de Utah | https://bedtools.readthedocs.io/en/latest/index.html | Software para procesar archivos bam/bed/bedGraph |
| bowtie2 2.5.4 | Universidad | Johns Hopkinshttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Software para crear el índice de pajarita y realizar la alineación |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Software para realizar análisis de distribución de tamaño de plaquita |
| Software Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html para realizar el recorte de adaptadores | |
| Deeptoolsv3.5.1 | Max Planck Institute | https://deeptools.readthedocs.io/en/develop/index.html | Software para realizar análisis de correlación de coeficiente de Pearson, análisis de componentes principales y análisis de mapas de calor/gráficos promedio |
| FastQC versión 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC Software para verificar la calidad del archivo fastq | |
| Interventionv0.6.1 | Biología Computacional & Regulación génica - Grupo Mathelier | https://intervene.readthedocs.io/en/latest/index.html | Software para realizar análisis de diagramas de Venn utilizando archivos |
| de picos MACSv2.2.9.1 | Iniciativa de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/macs_v2 | Software para llamar picos |
| MACSv3.0.2 | Iniciativa de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/master | Software para llamar picos |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools Software para procesar archivos sam/bam | |
| SEACRv1.3 | Howard Hughes Medial Institute | https://github.com/FredHutch/SEACR | Software para llamar a los picos |
| SRA Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/sra-tools Software para descargar SRR de GEO | |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | Software para realizar un recorte de calidad y precisión |
Referencias
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Reimpresiones y permisos
