Se desarrollaron modelos de aprendizaje automático para predecir la recurrencia de la hernia discal L5-S1 después de la cirugía PEID, analizando datos de 309 pacientes. Los predictores clave incluyeron el IMC y el PDHI, con modelos de aumento de bosque aleatorio y gradiente extremo que mostraron el mejor rendimiento.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Predicción de la recurrencia de la hernia discal lumbar en L5-S1 mediante aprendizaje automático basado en la discectomía endoscópica mediante el abordaje interlaminar
En este artículo
Resumen
Resumen
Este estudio tuvo como objetivo desarrollar modelos de aprendizaje automático (ML) para predecir la hernia discal lumbar recurrente (rLDH) a nivel de L5-S1 después de una discectomía interlaminar endoscópica percutánea (PEID), un tratamiento mínimamente invasivo para la hernia discal lumbar L5-S1. Se analizaron los datos de 309 pacientes sometidos a PEID L5-S1 de nivel único entre enero de 2020 y junio de 2024, con al menos 6 meses de seguimiento. Se utilizaron las historias clínicas, las imágenes preoperatorias y las puntuaciones de la escala visual analógica (EVA). La regresión LASSO identificó predictores clave y se construyeron seis modelos de ML: máquina de vectores de soporte (SVM), árbol de decisión (DT), refuerzo adaptativo (ADA), máquina impulsora de gradiente de luz (LGBM), bosque aleatorio (RF) y aumento de gradiente extremo (XGB). Entre los pacientes, el 10,7% experimentó rLDH, definida como una reducción ≥60% de la EVA seguida de recurrencia de los síntomas y confirmación de las imágenes. Los predictores clave incluyeron el índice de masa corporal (IMC), el índice de altura del disco posterior (PDHI), la estenosis del canal espinal, la duración de la enfermedad, el entumecimiento o debilidad, los cambios módicos, el tipo de hernia y la diabetes. Los modelos RF y XGB tuvieron el mejor rendimiento. Un IMC más alto, un IHP más alto, estenosis del canal espinal, duración de la enfermedad de más de seis meses, cambios módicos, hernia no contenida y diabetes aumentaron el riesgo de rLDH. Se clasificó la importancia variable para ambos modelos. La predicción preoperatoria de rLDH puede mejorar la toma de decisiones y reducir el riesgo de recurrencia después de la PEID, con modelos de ML que mejoran la precisión e identifican los factores de riesgo críticos.
Introducción
La discectomía lumbar endoscópica percutánea (PELD) engloba diversas técnicas, como la discectomía transforaminal endoscópica percutánea (PETD) y la discectomía interlaminar endoscópica percutánea (PEID), con la elección del abordaje quirúrgico en función de la localización de la lesión y de las características anatómicas individuales del paciente1. La hernia discal lumbar recurrente (rLDH) es uno de los motivos más frecuentes de reintervención tras el PELD, con una incidencia que oscila entre el 0% y el 12,5%2,3. Como técnica mínimamente invasiva, la PEID se ha aplicado ampliamente en el tratamiento de afecciones lumbares como la hernia discal a nivel L5-S1. Sus ventajas, que incluyen un trauma mínimo, estancias hospitalarias cortas y una rápida recuperación postoperatoria, lo han hecho muy favorecido tanto por los médicos como por los pacientes4. Sin embargo, a pesar de los importantes beneficios de las técnicas endoscópicas para reducir el trauma quirúrgico y promover una recuperación rápida, algunos pacientes todavía enfrentan el problema de la hernia discal recurrente después de la cirugía5.
La recurrencia de la hernia discal lumbar está estrechamente asociada a múltiples factores, entre ellos el grado de degeneración discal, la altura posterior del disco, los cambios módicos (inflamación de la placa terminal) y las áreas en estrecho contacto con la placaterminal 6. Además, el IMC tiene un impacto significativo en la recuperación postoperatoria, con estudios que indican que los pacientes con un IMC más alto suelen enfrentarse a un mayor riesgo de recurrencia5. El índice de altura del disco intervertebral, como un indicador importante para evaluar el grado de degeneración del disco, ha sido ampliamente utilizado. Se define como la altura de los márgenes anterior y posterior del disco dividida por la distancia del centroide de los dos cuerpos vertebrales. Sin embargo, para la hernia discal y la recidiva postoperatoria, debido a la distribución del estrés en los márgenes anterior y posterior, el índice de altura del disco posterior es más crítico en la predicción de la rLDH7. La extirpación incompleta del núcleo pulposo durante la cirugía es una de las principales causas de los síntomas postoperatorios residuales, ya que parte del tejido del disco es difícil de extirpar por completo durante el procedimiento8. Los cambios módicos conducen a daño en la placa terminal y respuestas inflamatorias, lo que resulta en inestabilidad mecánica. Los componentes del núcleo pulposo y cartílago en las hernias discales no contenidas pueden exacerbar la degeneración de la placa terminal y del disco intervertebral 8,9. La estenosis del canal espinal se asocia con la incidencia de rLDH, particularmente en pacientes sometidos a cirugía de descompresión simple sin fusión10. Además, los hábitos de vida poco saludables, las enfermedades cardiovasculares y los trastornos metabólicos como la diabetes prolongan significativamente el tiempo de curación del disco, aumentando el riesgo de recurrencia y dolor11,12. Por lo tanto, el primer objetivo de este estudio es profundizar en la investigación de los factores de riesgo asociados a la rLDH tras la PEID en el segmento L5-S1.
En los últimos años, los avances en las tecnologías de inteligencia artificial (IA) y aprendizaje automático han abierto nuevas posibilidades para el análisis médico. La aplicación de la IA y el aprendizaje automático en la investigación relacionada con la columna vertebral ha aumentado significativamente13,14. Como el segmento lumbar más bajo que soporta el mayor peso de la parte superior del cuerpo y posee propiedades biomecánicas únicas, L5-S1 es un sitio común para la hernia de disco lumbar. Sobre la base de la secuencia de resonancia magnética lumbar T2 del paciente (debido a su alta sensibilidad para la obtención de imágenes de disco intervertebral, que sirve como la herramienta de evaluación más crítica), combinada con exámenes de TC y rayos X, se puede obtener más información fisiopatológica sobre los discos intervertebrales del paciente, lo que conduce a una comprensión más clara de rLDH15. En la práctica clínica, la predicción precisa de los factores de riesgo de recurrencia postoperatoria, considerando la estructura anatómica única de la región L5-S1 y las diversas complicaciones potenciales, sigue siendo un desafío importante16,17.
El aprendizaje automático se ha aplicado ampliamente en el campo de la medicina, con algoritmos como Random Forest y Gradient Boosting que desempeñan un papel importante en la predicción de enfermedades y la evaluación de riesgos18. La regresión LASSO, a través de su mecanismo de regularización L1 para la selección de variables y la contracción del coeficiente, se utiliza para abordar la selección de características y los problemas de sobreajuste en datos de alta dimensión19. El algoritmo de búsqueda en cuadrícula explora exhaustivamente el espacio de hiperparámetros, lo que facilita la identificación de la combinación óptima de hiperparámetros para cada modelo, mejorando así la capacidad de predicción y la estabilidad20. En este contexto, los algoritmos de aprendizaje automático implementados en los principales lenguajes de IA como Python y R, cuando se basan en un tamaño de muestra superior a 240 casos, pueden utilizarse para construir modelos de inteligencia artificial21. Mediante el empleo de técnicas como la regresión LASSO para la selección de variables y la construcción de modelos, se utilizan algoritmos de búsqueda de cuadrícula para minimizar los errores y maximizar la precisión de la predicción, mejorando así la estabilidad del modelo.
En este estudio, mediante el análisis estadístico y la medición de varios factores de riesgo en pacientes L5-S1, y la integración de datos multidimensionales, incluida la información clínica (p. ej., edad, IMC) y variables de imagen (p. ej., altura del disco, índice de altura del disco posterior), se pretende desarrollar un modelo predictivo más preciso. El segundo objetivo de este estudio es evaluar el riesgo de recurrencia preoperatoria de los pacientes, evaluar el rendimiento del modelo y destacar la importancia de diversos factores de riesgo.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio es un análisis retrospectivo aprobado por el Comité de Ética Institucional del Nantong First People's Hospital. El ensayo ha sido registrado en ClinicalTrials.gov (Número de registro: NCT06833099). Dado que toda la información de salud de los participantes fue anónima, no se requirió el consentimiento informado. Los consumibles y equipos utilizados se enumeran en la Tabla de Materiales.
1. Población de estudio
El estudio incluyó datos clínicos y registros de imágenes preoperatorias de 436 pacientes que se sometieron a discectomía interlaminar (PEID) endoscópica percutánea por dolor lumbar y dolor en las piernas debido a una hernia discal L5-S1 en el Nantong First People's Hospital entre el 1 de enero de 2020 y el 30 de junio de 2024. Con base en los criterios de exclusión, finalmente se incluyeron 309 pacientes, entre los cuales se confirmó la hernia discal lumbar recurrente (rLDH) mediante las puntuaciones postoperatorias de la Escala Visual Analógica (EVA) y las imágenes de seguimiento. De los 309 pacientes, 33 experimentaron rLDH después de la cirugía, mientras que los 276 restantes tuvieron un alivio significativo del dolor lumbar y de piernas, con puntuaciones de EVA reducidas en más del 60%. Las variables de imagen de todos los participantes se derivaron de exámenes preoperatorios de radiografías, tomografías computarizadas y resonancias magnéticas, combinados con información clínica detallada, como sexo, edad, altura, peso, IMC, puntuaciones de la EVA y otras variables relevantes (Figura 1).
2. Criterios de inclusión y exclusión
Criterios de inclusión para rLDH: (1) Pacientes con hernia discal lumbar L5-S1 sometidos a PEID de un solo segmento. (2) Exámenes de imagen completos completados dentro de un mes antes de la operación. (3) Reducción de la puntuación EVA postoperatoria ≥60%, seguida de un aumento de la puntuación y confirmación por imagen. (4) No se detectaron otras anomalías en las imágenes. (5) Periodo mínimo de seguimiento de 6 meses.
Criterios de inclusión para la no rLDH: (1) Pacientes con hernia discal lumbar L5-S1 sometidos a PEID de un solo segmento. (2) Exámenes de imagen completos completados dentro de un mes antes de la operación. (3) Reducción de la puntuación EVA postoperatoria ≥60%, sin recurrencia. (4) No se detectaron otras anomalías en las imágenes. (5) Periodo mínimo de seguimiento de 6 meses.
Criterios de exclusión: (1) Presencia de otras condiciones patológicas que causan dolor lumbar, como infección discal, tumores espinales, enfermedades óseas metabólicas u osteoporosis. (2) Antecedentes de cirugía de disco lumbar u otras cirugías de columna. (3) Mala calidad de las imágenes o datos de examen incompletos. (4) Pérdida de seguimiento.
3. Variables categóricas y continuas
Se analizaron y midieron estadísticamente las características clínicas preoperatorias y los datos imagenológicos de los pacientes (Tabla 1 y Tabla 2). Las variables categóricas se utilizaron para distinguir las características básicas de la enfermedad, los factores del estilo de vida y otras variables, mientras que las variables continuas representaron mediciones específicas que describían el estado fisiológico de los pacientes y los cambios en las imágenes preoperatorias. Para reducir el sesgo, se implementaron estrictas medidas de control de calidad. Dos radiólogos y cirujanos de columna vertebral con más de 10 años de experiencia clínica fueron responsables del análisis estadístico y la medición de los datos de imagen. En el caso de los casos complejos, los dos médicos resolvieron los problemas mediante consultas conjuntas para garantizar la precisión y la coherencia en el procesamiento de los datos.
Las variables categóricas incluyeron: sexo, diabetes, hipertensión, enfermedades cardiovasculares y cerebrovasculares (ECC), escoliosis, estenosis espinal, factores desencadenantes (p. ej., actividad extenuante, esguince, exposición al frío, impacto o ausencia de un desencadenante claro), duración de la enfermedad (más de 6 meses o menos de 6 meses), entumecimiento o debilidad, tipo de protrusión (contenida o no contenida), degeneración discal (grados I, II, III y IV, V), degeneración discal adyacente (grados I, II, III y IV, V), cambios módicos y calcificación discal.
Las variables continuas fueron: edad, duración quirúrgica, talla, peso, índice de masa corporal (IMC), diámetro máximo de la hernia discal (MDHD), altura del disco posterior (PDH), distancia entre dos centros de vértebras (DBTVC), ángulo de orientación de la articulación facetaria (FJOA), ángulo del disco (DA), ángulo de la pendiente sacra (SSA), ángulo de la lordosis lumbar (LLA) e índice de altura del disco posterior (PDHI, PDHI = PDH / DBTVC).
4. Limpieza de datos y selección de variables
En primer lugar, el archivo de datos "zjkj3" se leyó en R (versión 4.3.1, https://www.r-project.org/, Plataforma: x86_64-w64-mingw32/x64 (64 bits), Copyright (C) 2023 The R Foundation for Statistical Computing) utilizando la función read_excel y se almacenó en una variable de datos. La codificación de caracteres seleccionada fue UTF-8 (predeterminada del sistema), que es un método de codificación ampliamente utilizado capaz de soportar los idiomas escritos de la mayoría de los países del mundo. A continuación, se utilizó la función select para separar la variable objetivo de las variables de característica. Para garantizar la reproducibilidad de la división de datos, se estableció una semilla aleatoria fija de 3 y el conjunto de datos se dividió en un conjunto de entrenamiento (80 %) y un conjunto de prueba (20 %). Finalmente, se definió una función de regresión LASSO, y una parte de los datos de entrenamiento se muestreó aleatoriamente utilizando la función glmnet para ajustar la regresión LASSO. El parámetro de regularización óptimo λ se determinó mediante regularización L1 y validación cruzada (por defecto 10 veces), al tiempo que se garantizó que no se mezclaran datos de pacientes duplicados entre los conjuntos de entrenamiento y prueba. Se calculó el error de validación cruzada para cada valor λ para determinar el valor λ óptimo.
5. Desarrollo y evaluación de modelos
SVM (Support Vector Machine): Este modelo mapea los datos de entrenamiento a un hiperplano, maximizando el margen entre dos clases para predecir el objetivo. La configuración específica de hiperparámetros para el modelo SVM en este estudio es: kernel = "lineal", costo = 1. La Figura 1 complementaria muestra las matrices de confusión para SVM.
DT (Árbol de decisión): Este modelo divide los datos de forma recursiva para crear una estructura de árbol para predecir la variable objetivo. La configuración de hiperparámetros específica para el modelo DT en este estudio es: max_depth = 3. La Figura 2 suplementaria muestra las matrices de confusión para DT.
ADA (AdaBoost): Este modelo combina varios aprendices débiles (generalmente árboles de decisión) para crear un aprendiz fuerte, mejorando el rendimiento de la clasificación. Los ajustes de hiperparámetros específicos para el modelo ADA en este estudio son: n_estimators = 150, learning_rate = 0,1, seed = 80. La Figura 3 suplementaria muestra las matrices de confusión para ADA.
LGBM (Light Gradient Boosting Machine): Este modelo utiliza un algoritmo de histograma para dividir características continuas, lo que acelera el proceso de entrenamiento y reduce la carga de memoria, lo que lo convierte en un marco de aumento de gradiente eficiente y rápido, particularmente adecuado para conjuntos de datos a gran escala. Los ajustes de hiperparámetros específicos para el modelo LGBM en este estudio son: num_leaves = 5, learning_rate = 0,05, n_estimators = 50. La Figura 4 suplementaria muestra las matrices de confusión para LGBM.
RF (Random Forest): Este modelo construye múltiples árboles de decisión y combina sus predicciones para mejorar la precisión y controlar el sobreajuste. Los ajustes de hiperparámetros específicos para el modelo de RF en este estudio son: ntree = 310, mtry = 1, maxnodes = 10, max_depth = 1, seed = 80. La Figura 5 suplementaria muestra las matrices de confusión para RF.
XGB (Extreme Gradient Boosting): Este modelo es un algoritmo mejorado basado en árboles de decisión, que utiliza un nuevo algoritmo de árbol de decisión generalizado de aumento de gradiente para acelerar la construcción del modelo, con una fuerte aplicabilidad para tareas de clasificación y regresión. Los ajustes de hiperparámetros específicos para el modelo XGB en este estudio son: nrounds = 100, max_depth = 2, eta = 0,39, gamma = 0, colsample_bytree = 0,88, seed = 80. La Figura 6 complementaria muestra las matrices de confusión para XGB.
El rendimiento de los seis modelos se evaluó utilizando las siguientes métricas: AUC del ROC del conjunto de pruebas, precisión, sensibilidad, especificidad, valor predictivo positivo (PPV), valor predictivo negativo (NPV) y puntuación F1. La fórmula de cálculo es la siguiente22:
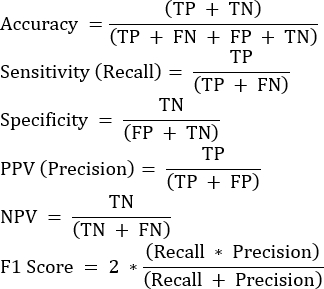
TP: Verdadero Positivo; TN: Verdadero negativo; FP: Falso positivo; FN: Falso negativo.
6. Búsqueda de cuadrícula y ajuste de hiperparámetros
Para optimizar el rendimiento del modelo, se utilizó la búsqueda en cuadrícula para explorar varias combinaciones de hiperparámetros. A través del ajuste y la evaluación iterativos, se identificó la combinación óptima de hiperparámetros para maximizar los valores de AUC de ROC tanto para el conjunto de entrenamiento como para el de prueba, mejorando así el rendimiento general del modelo. Los rangos de hiperparámetros ajustados se presentan en la Tabla 3. La búsqueda en la cuadrícula se proporciona en la Figura complementaria 7, la Figura complementaria 8 y la Tabla complementaria 1, la Tabla complementaria 2, la Tabla complementaria 3 y la Tabla complementaria 4.
7. Clasificación de importancia variable
Los modelos de mejor rendimiento, Random Forest (RF) y Extreme Gradient Boosting (XGB), fueron seleccionados para la clasificación de importancia variable. Estas clasificaciones ayudan a identificar los predictores más críticos de L5-S1 rLDH después de la PEID.
8. Análisis estadístico
Todos los análisis estadísticos se realizaron con el software R. Las variables categóricas se reportaron como porcentajes, mientras que las variables continuas se expresaron como media ± desviación estándar. Se compararon las características clínicas y los parámetros imagenológicos entre el grupo no recurrente (no rLDH, n=276) y el grupo recurrente (rLDH, n=33).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Se incluyeron en este estudio 309 pacientes con hernia discal lumbar L5-S1 que causó dolor lumbar y de piernas y que se sometieron a discectomía interlaminar endoscópica percutánea (PEID). Se recogieron los datos de imagen preoperatoria, las variables fisiológicas clínicas y las puntuaciones de la EVA, así como las imágenes postoperatorias y las puntuaciones de la EVA. Entre estos pacientes, 33 se clasificaron en el grupo de hernia discal lumbar recurrente (grupo rLDH) y 276 se clasificar...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
La discectomía intervertebral endoscópica percutánea (PEID) desempeña un papel importante en el tratamiento de la hernia discal L5-S1, por lo que es muy importante predecir la hernia discal lumbar recurrente (rLDH) postoperatoria1,2. En la fase de selección de imágenes y limpieza de datos, este estudio midió principalmente imágenes de resonancia magnética. Cuando la calidad de la imagen era deficiente o las imágenes estaban borro...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que la investigación se llevó a cabo en ausencia de relaciones comerciales o financieras que pudieran interpretarse como un posible conflicto de intereses.
Agradecimientos
Los autores desean agradecerles por su apoyo financiero (El trabajo fue apoyado por la Fundación de Ciencias del Colegio Kangda de la Universidad Médica de Nanjing (Subvención No. KD2024KYJJ292). El trabajo contó con el apoyo del Fondo Especial de Investigación para Medicina Clínica de la Universidad de Nantong (Subvención No. 2024JY002). Este trabajo fue apoyado por el Proyecto de Ciencia y Tecnología de la Comisión Municipal de Salud de Nantong (subvención no. MS2024045). Este trabajo fue apoyado por Proyectos de Ciencia y Tecnología en la Provincia de Jiangsu [BE2023742], Proyecto de la Administración de Medicina Tradicional China de Jiangsu (subvención no. MS2023113).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| GPU para portátil | NVIDIA Corporation | Máquina de | |
| resonancia magnética | Siemens Healthineers | 11672453 | Prisma 3.0T |
| Máquina de resonancia magnética | Siemens Healthineers | 10849662 | Ingenia CX 3.0T |
| Healthcare | 781341 | iCT Máquina de tomografía computarizada en espiral de 64 cortes | |
| Philips Healthcare | 728326 | Ysio | |
| Máquina de rayos X | Siemens Healthineers | 10092577 | 4.3.1 |
| R | The R Foundation | Software de código abierto; disponible en https://www.r-project.org/. | |
| readxl | RStudio (Posit) | Latest (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("readxl")). |
| tidyverse | RStudio (Posit) | Latest (CRAN) | Colección de paquetes de R; instalar a través de CRAN (install.packages("tidyverse")). |
| glmnet | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("glmnet")). |
| pROC | Colaboradores de CRAN | Último (CRAN) | Paquete de código abierto de R; instalar a través de CRAN (install.packages("pROC")). |
| zeallot | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("zeallot")). |
| reticulate | RStudio (Posit) | Latest (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("reticulate")). |
| showtext | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("showtext")). |
| e1071 | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("e1071")). |
| rms Colaboradores | de CRAN | Último (CRAN) | Paquete de R de código abierto; instalar a través de CRAN (install.packages("rms")). |
| rpart | Colaboradores de CRAN | Último (CRAN) | Paquete de R de código abierto; instalar a través de CRAN (install.packages("rpart")). |
| Colaboradores de CRAN | intercalación | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("caret")). |
| rpart.plot | Colaboradores de CRAN | Último (CRAN) | Paquete de R de código abierto; instalar a través de CRAN (install.packages("rpart.plot")). |
| randomForest | Colaboradores de CRAN | Último (CRAN) | Paquete de R de código abierto; instalar a través de CRAN (install.packages("randomForest")). |
| corrplot | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("corrplot")). |
| Colaboradores de CRAN | PRROC | paquete de R de código abierto (CRAN); instalar a través de CRAN (install.packages("PRROC")). | |
| Colaboradores | de Matrix | CRAN Último (CRAN) | Paquete de R de código abierto; instalar a través de CRAN (install.packages("Matrix")). |
| dplyr | RStudio (Posit) | Latest (CRAN)Parte | de tidyverse; instalar a través de CRAN (install.packages("dplyr")). |
| ggplot2 | RStudio (Posit) | Latest (CRAN)Parte | de tidyverse; instalar a través de CRAN (install.packages("ggplot2")). |
| class | CRAN contributors | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("class")). |
| Colaboradores | de ADRA CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("ada")). |
| lightgbm | Microsoft | Latest (CRAN/GitHub) | Paquete R de código abierto; instalar a través de CRAN (install.packages("lightgbm")) o GitHub. |
| xgboost | Colaboradores de CRAN | Último (CRAN) | Paquete R de código abierto; instalar a través de CRAN (install.packages("xgboost")). |
Referencias
- Chen, Z., et al. Transforaminal versus interlaminar approach of full-endoscopic lumbar discectomy under local anesthesia for L5/S1 disc herniation: A randomized controlled trial. Pain Physician. 25 (8), E1191-E1198 (2022).
- Cheng, J., et al. Reoperation after lumbar disc surgery in two hundred and seven patients. Int Orthop. 37 (8), 1511-1517 (2013).
- Yin, S., et al. Prevalence of recurrent herniation following percutaneous endoscopic lumbar discectomy: A meta-analysis. Pain Physician. 21 (4), 337-350 (2018).
- Pan, M., et al. Percutaneous endoscopic lumbar discectomy: Indications and complications. Pain Physician. 23 (1), 49-56 (2020).
- Ju, C. I., Lee, S. M. Complications and management of endoscopic spinal surgery. Neurospine. 20 (1), 56-77 (2023).
- Modic, M. T., Ross, J. S. Lumbar degenerative disk disease. Radiology. 245 (1), 43-61 (2007).
- Frobin, W., Brinckmann,, Kramer, M., Hartwig, E. Height of lumbar discs measured from radiographs compared with degeneration and height classified from MR images. Eur Radiol. 11 (2), 263-269 (2001).
- Li, H., Deng, W., Wei, F., Zhang, L., Chen, F. Factors related to the postoperative recurrence of lumbar disc herniation treated by percutaneous transforaminal endoscopy: A meta-analysis. Front Surg. 9, 1049779(2023).
- Hao, L., et al. Recurrent disc herniation following percutaneous endoscopic lumbar discectomy preferentially occurs when Modic changes are present. J Orthop Surg Res. 15 (1), 176(2020).
- Kim, C. H., et al. Reoperation rate after surgery for lumbar spinal stenosis without spondylolisthesis: a nationwide cohort study. Spine J. 13 (10), 1230-1237 (2013).
- Huang, W., Han, Z., Liu, J., Yu, L., Yu, X. Risk factors for recurrent lumbar disc herniatioN: A Systematic Review and meta-analysis. Medicine (Baltimore). 95 (2), e2378(2016).
- Wang, H., Zhou, Y., Li, C., Liu, J., Xiang, L. Risk factors for failure of single-level percutaneous endoscopic lumbar discectomy. J Neurosurg Spine. 23 (3), 320-325 (2015).
- Harada, G. K., et al. Artificial intelligence predicts disk re-herniation following lumbar microdiscectomy: development of the "RAD" risk profile. Eur Spine J. 30 (8), 2167-2175 (2021).
- Berg, B., et al. Machine learning models for predicting disability and pain following lumbar disc herniation surgery. JAMA Netw Open. 7 (2), e2355024(2024).
- Suthar, P., Patel, R., Mehta, C., Patel, N. MRI evaluation of lumbar disc degenerative disease. J Clin Diagn Res. 9 (4), TC04-9(2015).
- Li, R., et al. Comparative analysis of percutaneous endoscopic interlaminar discectomy for highly downward-migrated disc herniation. J Orthop Surg Res. 18 (1), 602(2023).
- Han, M., Liu, L., Hu, M., Liu, G., Li, P. Medical expert and machine learning analysis of lumbar disc herniation based on magnetic resonance imaging. Comput Methods Programs Biomed. 213, 106498(2022).
- Jordan, M. I., Mitchell, T. M. Machine learning: Trends, perspectives, and prospects. Science. 349 (6245), 255-260 (2015).
- Tibshirani, R., et al. Strong rules for discarding predictors in lasso-type problems. J R Stat Soc Series B Stat Methodol. 74 (2), 245-266 (2012).
- Panda, A., Datar, R., Deshpande, S., Bacher, G. Enhancing pH prediction accuracy in Al2O3 gated ISFET using XGBoost regressor and stacking ensemble learning. Sci Rep. 15 (1), 19197(2025).
- Balki, I., et al. Sample-size determination methodologies for machine learning in medical imaging research: A systematic review. Can Assoc Radiol J. 70 (4), 344-353 (2019).
- Chiu, P. F., et al. Machine learning assisting the prediction of clinical outcomes following nucleoplasty for lumbar degenerative disc disease. Diagnostics (Basel). 13 (11), 1863(2023).
- Jia, M., et al. Development and validation of a nomogram predicting the risk of recurrent lumbar disk herniation within 6 months after percutaneous endoscopic lumbar discectomy. J Orthop Surg Res. 16 (1), 274(2021).
- Li, Y., et al. Adjuvant surgical decision-making system for lumbar intervertebral disc herniation after percutaneous endoscopic lumbar discectomy: A retrospective nonlinear multiple logistic regression prediction model based on a large sample. Spine J. 21 (12), 2035-2048 (2021).
- Siemionow, K., An, H., Masuda, K., Andersson, G., Cs-Szabo, G. The effects of age, sex, ethnicity, and spinal level on the rate of intervertebral disc degeneration: a review of 1712 intervertebral discs. Spine (Phila Pa 1976). 36 (17), 1333-1339 (2011).
- Choi, G., Lee, S. H., Raiturker, P. P., Lee, S., Chae, Y. S. Percutaneous endoscopic interlaminar discectomy for intracanalicular disc herniations at L5-S1 using a rigid working channel endoscope. Neurosurgery. 58 (1 Suppl), ONS59-ONS68 (2006).
- Yu, C., et al. Risk factors for recurrent L5-S1 disc herniation after percutaneous endoscopic transforaminal discectomy: A Retrospective Study. Med Sci Monit. 26, e919888(2020).
- Shi, H., Zhu, L., Jiang, Z. L., Wu, X. T. Radiological risk factors for recurrent lumbar disc herniation after percutaneous transforaminal endoscopic discectomy: A retrospective matched case-control study. Eur Spine J. 30 (4), 886-892 (2021).
- Ren, G., et al. Machine learning predicts recurrent lumbar disc herniation following percutaneous endoscopic lumbar discectomy. Global Spine J. 14 (1), 146-152 (2024).
- Wilke, H. J., et al. ISSLS prize winner: A novel approach to determine trunk muscle forces during flexion and extension: A comparison of data from an in vitro experiment and in vivo measurements. Spine (Phila Pa 1976). 28 (23), 2585-2593 (2003).
- Schmidt, H., et al. Application of a new calibration method for a three-dimensional finite element model of a human lumbar annulus fibrosus. Clin Biomech (Bristol). 21 (4), 337-344 (2006).
- Leven, D., et al. Risk factors for reoperation in patients treated surgically for intervertebral disc herniation: A AR SPORT Data. J Bone Joint Surg Am. 97 (16), 1316-1325 (2015).
- Fritzell, P., Knutsson, B., Sanden, B., Strömqvist, B., Hägg, O., et al. Recurrent versus primary lumbar disc herniation surgery: Patient-reported outcomes in the Swedish Spine Register Swespine. Clin Orthop Relat Res. 473 (6), 1978-1984 (2015).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente