Aquí presentamos un protocolo para establecer un modelo celular de la enfermedad de Alzheimer inducida por ácido okádico en células SH-SY5Y y evaluar los efectos neuroprotectores de la gastrodina mediante el estrés oxidativo y el análisis de la vía AKT/GSK-3β.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Gastrodin alivia la hiperfosforilación de Tau asociada con los cambios de señalización AKT/GSK-3β en un modelo celular de la enfermedad de Alzheimer
* These authors contributed equally
En este artículo
Resumen
Resumen
La enfermedad de Alzheimer (EA) es una enfermedad neurodegenerativa común para la que actualmente existen medicamentos eficaces limitados. Como principal componente bioactivo derivado de Gastrodia elata, Gastrodin (GAS) ha mostrado un claro potencial terapéutico para tratar la EA; sin embargo, el mecanismo molecular de su acción aún está por esclarecerse. En este estudio, nuestro objetivo es investigar el mecanismo del efecto del SGA en las células modelo de EA. La farmacología de redes se emplea para analizar los objetivos y las vías de señalización afectadas por el SGA en la EA. Se construye un modelo celular de EA induciendo células neuroblastomas humanos SH-SY5Y con ácido okadaico (OA). La viabilidad celular se evaluó utilizando el ensayo CCK-8, mientras que se midieron los niveles de SOD, MDA y T-AOC. La tasa de apoptosis se determinó mediante doble tinción con Annexin V-FITC/PI, y la expresión de factores relacionados con la apoptosis, así como AKT, GSK-3β, p-Tau (Ser396) y p-Tau (Thr181), se analizó mediante técnicas RT-qPCR y Western bloting. El análisis de farmacología de redes sugiere que el GAS tiene el potencial de regular la apoptosis celular y las vías de señalización asociadas, incluyendo PI3K/AKT. Nuestros experimentos demuestran que el GAS puede inhibir los niveles de MDA, aumentar la T-AOC y la SOD en las células modelo de AD, y reducir la apoptosis celular. Los resultados del Western blot indican que el GAS mitiga los efectos inhibitorios de la OA sobre la expresión de p-AKT (Ser473) y p-GSK-3β (Ser9). Además, atenúa la sobreexpresión de p-Tau (Ser396) y p-Tau (Thr181), suprime la expresión de Bax y potencia la expresión de Bcl-2. El SGA demuestra la capacidad de mitigar la lesión por estrés oxidativo inducida por la OA y mitigar la apoptosis. El GAS puede suprimir la hiperfosforilación de Tau, que está asociada con cambios en la vía de señalización AKT/GSK-3β, ejerciendo así posibles efectos neuroprotectores.
Introducción
La enfermedad de Alzheimer (EA) es un trastorno neurodegenerativo progresivo caracterizado principalmente por pérdida de memoria y deterioro cognitivo, representando la forma más prevalente de demencia en todo el mundo, representando aproximadamente entre el 60% y el 80% de loscasos 1. La patogénesis subyacente de la EA sigue siendo compleja y aún no está completamenteesclarecida 2. Las principales características patológicas observadas en casos clínicos de EA incluyen la acumulación de placas seniles (SP) y enredos neurofibrilares (NFTs) en el cerebro 3,4. Se reconoce ampliamente que los dos eventos patológicos centrales en la EA son la deposición extracelular de la proteína β-amiloide (Aβ) para formar placas seniles y la agregación intracelular de la proteína Tau hiperfosforilada para formar enredosneurofibrilares 5,6,7. Además, el estrés oxidativo y la neuroinflamación son factores suplementarios que pueden contribuir al agravamiento de laDA 8,9,10,11.
A medida que se intensifica la tendencia de envejecimiento de la población global, el número de pacientes con demencia haaumentado significativamente en 12,13. Sin embargo, las opciones de tratamiento para la EA siguen siendo limitadas, comprendiendo principalmente fármacos de un solo objetivo como la memantina, donepezil ygalantamina 14. Sin embargo, sus efectos terapéuticos son principalmente paliativos más que modificadores de la enfermedad, y se han reportado ciertos efectos adversos como alteraciones gastrointestinales, mareos y bradicardia. Por lo tanto, el desarrollo de estrategias terapéuticas más seguras y efectivas sigue siendo una prioridad importantede investigación 15,16. Medicamentos monoclonales recientemente lanzados, como Lecanemab, han traído nueva esperanza a los pacientes con EA leve. Sin embargo, sus altos costes y limitaciones no satisfacen la considerable demanda terapéutica. La prevención y el tratamiento de la EA siguen suponiendo un desafío significativo 17,18. Los hallazgos de varios estudios han demostrado que las plantas medicinales, especialmente las medicinas tradicionales chinas, presentan efectos multicomponentes que actúan en múltiples vías implicadas en trastornos neurodegenerativos como la EA. Los estudios han demostrado que los compuestos activos de Ganoderma lucidum pueden aliviar el daño oxidativo en el tejido cerebral de ratones con EA, inhibir la apoptosis, reducir la necrosis neuronal del hipocampo y mejorar el deteriorocognitivo 19. En la investigación sobre la EA, Bao et al. utilizaron la farmacología de redes para identificar objetivos clave del Astragalosido IV en la inflamación relacionada con la EA. Sus hallazgos revelaron que el receptor del factor de crecimiento epidérmico (EGFR) y la interleucina-1β (IL-1β) son objetivos cruciales, proporcionando posibles candidatos terapéuticos y objetivos para enfermedades para el tratamiento clínico de enfermedadesneurodegenerativas 20. Dartigues et al.21 analizaron el extracto de Ginkgo biloba y demostraron que tiene efectos beneficiosos en la reducción del riesgo de demencia y mortalidad en personas mayores. Los pacientes tratados con extracto de Ginkgo biloba mostraron una tasa de mortalidad másbaja 22.
Gastrodia elata, perteneciente a la familia Orchidaceae, es una hierba tradicional china, comestible y medicinal. El rizoma de Gastrodia elata es abundante en Gastrodin (GAS), polisacáridos de Gastrodia y alcaloides. Investigaciones farmacológicas recientes han demostrado que estos compuestos activos poseen efectos para mejorar la memoria y la cognición, así como propiedades neuroprotectoras y eficacia en el tratamiento del insomnio y elmareo. El principal compuesto bioactivo de Gastrodia elata es el GAS, que se extrae del tubérculo y posee propiedades medicinales. El GAS, también conocido como alcohol 4-hidroxibencelílico 4-O-β-d-glucósido, pertenece a la clase de glucósidosfenólicos 24. La estructura química del GAS se ilustra en la Figura 1, que muestra un peso molecular de 286,278. La masa molecular relativamente baja de glucósidos y monoglucósidos facilita su penetración eficiente a través de la barrera hematoencefálica, sirviendo así como base fundamental para el papel neuroprotector deGAS 25. Además, su alta capacidad de absorción mejora aún más sueficacia 26. En los últimos años, numerosos estudios han demostrado el potencial del SGA en el tratamiento de diversos trastornos cerebrales, incluyendo la AD 27,28,29,30, la enfermedad de Parkinson (EP)31 y la isquemiacerebral 32. El GAS presenta una amplia gama de propiedades farmacológicas, incluyendo efectos antioxidantes, hipolipidémicos, antiinflamatorios y antienvejecimiento33,34. Su mecanismo de acción implica múltiples vías de señalización como Nrf2, NF-κB y AMPK35. El SAG ejerce efectos neuroprotectores en un modelo murino de lesión neurológica inducida por Pb al modular la víaWnt/Nrf2 36, y también exhibe un efecto antiapoptótico en el tratamiento de trastornos neurodegenerativos mediante la regulación de la vía de señalizaciónNrf2 37. El GAS también ejerció un efecto beneficioso sobre la EA al suprimir la expresión hipocampal de BACE1 a través de la vía de señalización38 de la proteína quinasa/factor de iniciación eucariota-2α (PKR/eIF2α). Además, el SGA mostró efectos inhibidores en la activación de la señalización de NF-κB inducida por TCDD, atenuando así la apoptosis de las neuronas PC12 y la activaciónde los astrocitos 39.
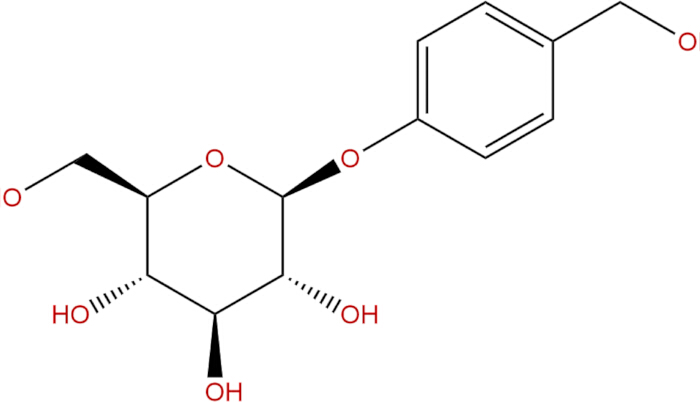
Figura 1: Fórmula estructural química del GAS. Haz clic aquí para ver una versión ampliada de esta figura.
La OA, derivada de la esponja negra del género Halichondria, pertenece a una clase de ácidos grasos de cadena larga y sirve como componente principal del Veneno Diarretico de Mariscos (DSP). Inhibe eficazmente las actividades de las fosfatasas proteicas, especialmente PP1A y PP2A, lo que conduce a la hiperfosforilación celular y a la alteración de la homeostasiscelular 40,41. Esta característica lo convierte en una herramienta valiosa para investigar enfermedades asociadas a la fosforilación de proteínas. Por ello, la utilización de la AA permite la construcción de modelos celulares de DA que presentan alteraciones en la fosforilación de la proteína Tau. Este estudio tiene como objetivo investigar el impacto y el mecanismo del GAS, el componente activo principal de Gastrodia elata, en el modelo de células de EA inducido por la OA, y aclarar su efecto neuroprotector en las células modelo de EA dirigiéndose a la vía de señalización AKT/GSK-3β.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Todas las operaciones de farmacología en redes se llevaron a cabo de acuerdo con las Directrices para Métodos de Evaluación de Farmacología en Red. Todos los procedimientos experimentales se realizaron cumpliendo con las normativas de gestión de laboratorios de la Universidad Sci-Tech de Zhejiang.
Farmacología de redes
Predicción de posibles objetivos de GAS: El SMILES canónico de GAS (PubChem CID: 1150) fue recuperado de la base de datosPubChem 42. La estructura SMILES fue subida a la base de datos SwissTargetPrediction (http://www.swisstargetprediction.ch/)43. El parámetro de especie se estableció en Homo sapiens. Se mantuvieron objetivos predichos con un valor de probabilidad > 0,1 para reducir las predicciones falsas positivas. Todos los objetivos proteicos predichos se estandarizaron a símbolos génicos oficiales utilizando la base de datosUniProt 43 (especie limitada a Homo sapiens), y se eliminaron entradas duplicadas.
Los genes relacionados con la EA se recogieron de la base de datos GeneCards (https://www.genecards.org/)44,45 y de la base de datos OMIM (https://www.omim.org/)46 utilizando "enfermedad de Alzheimer" como término de búsqueda. En GeneCards, se seleccionaron genes con una puntuación de relevancia > 10. Se fusionaron los objetivos obtenidos de GeneCards y OMIM, se eliminaron duplicados y se estandarizaron los nombres de genes usando UniProt.
Los objetivos predictos para el GAS y los genes relacionados con la EA se importaron a la plataforma online Venny 2.1 para obtener objetivos superpuestos. Un total de 52 genes intersectantes (véase Tabla Suplementaria 1) fueron identificados como posibles objetivos terapéuticos del SGA en la EA.
Los 52 objetivos que se intersectaban se subieron a la base de datos STRING (https://string-db.org/)47 para el análisis PPI. La especie se estableció en Homo sapiens, y la puntuación mínima requerida de interacción se estableció en 0,4 (confianza media). Los nodos desconectados estaban ocultos. Los datos de interacción resultantes se exportaron y visualizaron utilizando el software Cytoscape (versión 3.9.1).
Análisis de enriquecimiento GO y KEGG: Los 52 objetivos intersectantes se subieron a la base de datos Metascape (https://metascape.org/)48 para análisis de enriquecimiento de Ontología Génica (GO) y la Enciclopedia de Genes y Genomas de Kioto (KEGG). La especie se ajustó a Homo sapiens. Los criterios de enriquecimiento se definieron como valor p < 0,01, solapamiento mínimo ≥ 3 y factor de enriquecimiento > 1,5. Las vías KEGG se clasificaron según el valor p y se seleccionaron las 20 vías con mayor enriquecimiento significativo para su visualización. Los resultados del enriquecimiento se visualizaron utilizando una plataforma de bioinformática en línea.
El archivo de estructura proteica de GSK-3β se obtuvo de la base de datos RCSB PDB. El archivo de estructura de GAS en formato SDF se descargaba desde la base de datos PubChem y posteriormente se convertía al formato Mol2 usando el software Open Babel GUI. Los archivos mencionados anteriormente se procesaron usando el software AutoDock para añadir átomos de hidrógeno, eliminar moléculas de agua y asignar cargas. Los archivos procesados se guardaban posteriormente en formato PDBQT. Tras detectar y procesar enlaces de torsión en las moléculas de ligando, los archivos se almacenaron en formato PDBQT. La menor energía de unión entre las dos moléculas se obtuvo realizando acoplamiento molecular usando el software AutoDock Vina. Posteriormente, los resultados del acoplamiento se visualizaron y analizaron utilizando PyMOL.
Preparación de la solución de culo
El polvo OA (25 μg) se disolvió completamente en 1200 μL de dimetilsulfóxido al 10% (DMSO) preparado con solución salina estéril tamponada con fosfato (PBS) para generar una solución de stock de 25 μM. La solución de la serie fue alicotizada y almacenada a -80 °C. Antes de cada experimento, la OA se diluía frescamente con el Medio Águila Modificado (DMEM) completo de Dulbecco (véase Tabla de Materiales) hasta las concentraciones de trabajo deseadas. El polvo de GAS (20 mg) se disolvía en 1,4 mL de PBS estéril, se filtraba a través de una membrana de 0,22 μm para su esterilización y se preparaba como una solución de 50 mM, que se almacenaba a -20 °C. Antes de su uso, la solución original se diluyó con DMEM completo a las concentraciones de trabajo indicadas.
Construcción del modelo de celda AD
Se obtuvieron y utilizaron células SH-SY5Y para neuroblastoma humano en este estudio (véase Tabla de Materiales). Las células SH-SY5Y se indujeron con concentraciones de gradiente de OA (0, 10, 20, 40, 80, 160 nM) durante duraciones de 12, 24 y 36 horas, respectivamente, para establecer el modelo de células de AD.
Ensayo de viabilidad celular
Para determinar la concentración óptima y la duración de inducción de la AO para establecer el modelo de células de AD, se trataron las células SH-SY5Y con concentraciones de gradiente de OA (0, 10, 20, 40, 80 y 160 nM) durante diferentes periodos de tiempo (12, 24 y 36 h), y se evaluó la viabilidad celular utilizando el ensayoCCK-8 49. Las células SH-SY5Y se sembraron en placas de 96 pozos con una densidad de 7,5 × 10³ celdas por pozo en 100 μL de DMEM completo. Las placas se incubaron a 37 °C en una incubadora humidificada con un 5% de CO₂ durante 24 horas para permitir la unión celular. Tras 24 horas de acoplamiento, se añadieron 100 μL de solución de trabajo de OA a cada pozo para alcanzar concentraciones finales de 0, 10, 20, 40, 80 y 160 nM en un volumen total de 200 μL por pozo. El grupo control (CON) recibió un volumen igual de DMEM completo sin OA, mientras que el grupo OA recibió OA a las concentraciones indicadas. Las células se incubaron durante 12 horas, 24 horas o 36 horas bajo condiciones estándar de cultivo. Cada concentración y punto temporal se establecía con seis pozos replicados. Se incluyeron tres pozos en blanco (solo medio) para la corrección de fondo.
Determinación del índice de estrés oxidativo celular
Las células SH-SY5Y en la fase de crecimiento logarítmico se sembraron en una placa de 6 pozos. Tras el tratamiento celular, el medio anterior fue descartado de los pozos. Posteriormente, los pozos fueron lavados tres veces con PBS preenfriado a 4 °C. Después de eso, se añadió un buffer de lisis celular y las células se lisaron sobre hielo usando el método adecuado indicado por el kit. El contenido proteico de las muestras se cuantificó utilizando el kit de ensayos de proteínas BCA (véase Tabla de Materiales). Las actividades de T-AOC, SOD y MDA se determinaron según las instrucciones proporcionadas con los respectivos kits de ensayo (véase la Tabla de Materiales).
Detección de apoptosis celular
La apoptosis celular se evaluó utilizando un kit de tinción doble Annexin V-FITC/PI (véase la Tabla de Materiales) según las instrucciones del fabricante. Brevemente, se recogieron células flotantes y adherentes. Las células adherentes se digerieron usando tripsina sin EDTA para evitar daños en membranas artificiales y se combinaron con células flotantes. Las células se lavaron dos veces con PBS frío y se resuspendieron en 500 μL de tampón de unión 1× a una densidad de 0,5–1 × 10⁶ celdas.
Posteriormente, se añadieron 5 μL de Annexin V-FITC y 5 μL de yoduro propidio (PI) a cada muestra, se mezclaron suavemente e incubaron a temperatura ambiente en la oscuridad durante 10–20 minutos. Las muestras se colocaron sobre hielo y se analizaron en un plazo de 1 hora utilizando un citómetro de flujo.
Para el análisis citométrico de flujo, se utilizaron controles sin tinción y controles con una sola tinción (solo Annexin V-FITC y solo PI) para establecer parámetros de compensación y compuertas de cuadrantes. La compuerta de dispersión frontal y lateral (FSC/SSC) se aplicó primero para excluir residuos y agregados celulares. Se adquirieron un mínimo de 10.000 eventos por muestra. Los datos se analizaron utilizando el software FlowJo.
Análisis cuantitativo de PCR en tiempo real (RT-qPCR)
Según las instrucciones proporcionadas por el kit de transcripción inversa AG, el ARN extraído fue sometido a transcripción inversa para generar ADN complementario (ADNc), que posteriormente se diluyó diez veces con agua estéril para servir de plantilla. El sistema de reacción RT-qPCR se preparó siguiendo el protocolo del kit Green Master Mix (No Rox), y el análisis se realizó utilizando un instrumento fluorescente de PCR cuantitativa (véase Tabla de Materiales). Los valores de Ct obtenidos fueron procesados y analizados, y los niveles de expresión de los genes objetivo se calcularon utilizando el método 2-ΔΔCt, donde ΔCt representa la diferencia entre los valores de Ct en el grupo tratado y GAPDH, y ΔΔCt representa la diferencia entre los valores de ΔCt en el grupo de tratamiento y el grupo de control. La lista de cebadores se puede encontrar en la Tabla Suplementaria 2.
Análisis de Western blot
El tampón de lisis celular, junto con un inhibidor de proteasa y un inhibidor de fosfatasa, se combinaron en una proporción de 100:1:1. Las células se lisaron para extraer proteínas celulares. La concentración de proteínas se determinó utilizando el kit de ensayo BCA. Las proteínas (20–30 μg por carril) se separaron en geles SDS-PAGE al 10% a 80 V para el gel apilante y 120 V para el gel resolutivo. Las proteínas se transfirieron a las membranas PVDF (0,45 μm) a 300 mA durante 90 minutos mediante transferencia húmeda. La membrana se bloqueó con leche desnatada al 5% a temperatura ambiente durante 2 horas, seguida de una incubación nocturna con anticuerpo primario (véase Tabla de Materiales) a 4 °C. Tras incubar con el anticuerpo secundario a temperatura ambiente durante 1 hora, la membrana se lavó cuatro veces con TBST durante 5 minutos cada una. Las bandas se visualizaron utilizando reactivos de detección de quimioluminiscencia (ECL) mejorada (véase Tabla de Materiales), y la detección se realizó con un sistema de imagen en gel. Los valores en escala de grises se analizaron utilizando el software ImageJ para obtener información sobre los datos.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Cribado de objetivos relacionados con GAS para el tratamiento de la EA
La identificación de los objetivos de GAS para tratar la DA implicó búsquedas en bases de datos y análisis de software. La base de datos suiza de predicción de objetivos arrojó 100 objetivos potenciales, mientras que OMIM y GeneCards (con puntuación de Relevancia > 10) fueron consultados para objetivos relacionados con la EA, resultando en un total de 2376 objetivos potenciales. Posteriormente, el ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
En los últimos años, ha habido un aumento global en la prevalencia de la EA. Esta condición se caracteriza por un curso crónico, naturaleza irreversible, discapacidad y tasas elevadas de mortalidad, lo que la convierte en un desafío significativo en el contexto de una población mundial envejecida. A pesar de su prominencia, la etiología de la EA es intrincada y su patogénesis sigue siendo incompletamentecomprendida 51.
La medicina tradi...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Esta investigación fue financiada por el Fondo Abierto de la Universidad de Ciencia y Tecnología de Zhejiang, Academia de Biomedicina Shaoxing (SXAB202007).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Sistema de PCR en tiempo real 7500 | APExBIO | S0080 | Utilizado para detectar células apoptóticas |
| Instrumento de marcaje enzimático A450 | Proteintech | 50599-2-IG | Blanco blanco, dilución 1:1000 |
| Kit de detección de apoptosis Annexin V-FITC | Proteintech | 60178-1-IG | Blanco blanco, dilución 1:1000 |
| Anticuerpo anti-Bax | Proteintech | 10494-1-AP | Blanco blanco, dilución 1:1000 |
| Anticuerpo anti-Bcl-2 | Abcam | ab32057 | Blanco blanco, dilución 1:1000 |
| Anticuerpo anti-GAPDH | Proteintech | 28866-1-AP | Blanco blanco, dilución 1:1000 |
| Anticuerpo anti-p-Tau (Ser396) | Biofroxx | 1172 | Búfer de bloqueo para WB |
| Anticuerpo anti-p-Tau (Thr181) | Vazyme Biotech | A311-01/02 | Utilizado para ensayos de viabilidad celular |
| Biofroxx leche desnatada en polvo | Solarbio Ciencia y Ciencias Tecnología | D8371 | Disolvente para compuestos |
| Kit CCK-8 | Wisent Biotecnología | 319-105-CL | Para el cultivo celular |
| Dimetilsulfóxido (DMSO) | APExBIO (EE. UU.) | K1231 | Reactivo de detección WB |
| Medio DMEM de alta glucosa | Tecnología Bioquímica Aladdín | G111309 | Compuesto activo |
| Reactivo quimioluminiscente ECL | Promega | A6101 | Para amplificación qPCR |
| Citómetro de flujo | Solarbio Ciencia y Ciencias Tecnología | BC6410 | Ensayo de peroxidación lipídica |
| Polvo de Gastrodin (GAS), pureza y ge; 98% | MedChemExpress | HY-N6785 | Inductor de la hiperfosforilación de tau |
| Sistema de imagen en gel | Beyotime Biotecnología | C0221A | Lava las celdas |
| GoTaq qPCR Master Mix | Proteintech | SA00001-1 | Peso blanco, dilución 1:5000 |
| Kit de análisis MDA (malondialdehído) | Proteintech | SA00001-2 | Peso blanco, dilución 1:5000 |
| Ácido okadaico (OA) | ATCC | CRL-2266 | Celda |
| PBS | Beyotime Biotecnología | S0101M | Para el ensayo de estrés oxidativo |
| Anticuerpo secundario (IgG anti-ratón de cabra, conjugado con HRP) | Solarbio Ciencia y Ciencias Tecnología | 1315 a.C. | Detección de la capacidad antioxidante |
| Anticuerpo secundario (Anti-IgG de la cabra, conjugado con HRP) | Beyotime Biotechnology & nbsp; | R0016 | Extracción de ARN |
| SH-SY5Y | Sigma-Aldrich & nbsp; | 9002-07-7 | Digestión celular |
| Kit de ensayo SOD (dismutasa total de superóxido) | Thermo Fisher Scientific | A45072 | Lector multifuncional de microplacas para detección de absorbancia |
| Kit de capacidad antioxidante total (T-AOC) | Becton, Dickinson y Compañía | 661310 | Para análisis multiparámetro de celda única y ordenación de celdas. |
| Reactivo de Trizol | Thermo Fisher Scientific | 4351104 | Análisis de expresión génica |
| Tripsina | Bio Rad | 1708195 | Imagen en gel de ADN/ARN/proteínas |
Referencias
- Hu, X., Wang, T., Jin, F. Alzheimer's disease and gut microbiota. Sci China Life Sci. 59 (10), 1006-1023 (2016).
- Qiu, C., Du, Y. A call for action to strengthen research on population interventions against Alzheimer's disease and senile dementia. J Shandong Univ Health Sci. 55 (10), 1-6 (2017).
- Livingston, G., et al. Dementia prevention, intervention,and care: 2020 report of the Lancet Commission. Lancet. 396 (10248), 413-446 (2020).
- Li, T. F., Guo, Z. Q., Wang, Y. Abnormal ß-amyloid metabolism and Alzheimer disease. J Neurosci Ment Health. 22 (12), 904-908 (2022).
- Zheng, J., et al. Oral administration of a fusion protein between the cholera toxin B subunit and the 42-amino acid isoform of amyloid-β peptide produced in silkworm pupae protects against Alzheimer's disease in mice. PLoS One. 9 (12), e113585(2014).
- La Spada, A. R., et al. A Becn1 mutation mediates hyperactive autophagic sequestration of amyloid oligomers and improved cognition in Alzheimer's disease. PLoS Genet. 13 (8), e1006962(2017).
- Aboelwafa, H. R., El-Kott, A. F., Abd-Ella, E. M., Yousef, H. N. The possible neuroprotective effect of silymarin against aluminum chloride-prompted Alzheimer's-like disease in rats. Brain Sci. 10 (9), 628(2020).
- Tobore, T. O. On the central role of mitochondria dysfunction and oxidative stress in Alzheimer's disease. Neurol Sci. 40 (8), 1527-1540 (2019).
- Kawamoto, E. M., et al. Oxidative state in platelets and erythrocytes in aging and Alzheimer's disease. Neurobiol Aging. 26 (6), 857-864 (2005).
- Stancu, I. C., et al. Aggregated Tau activates NLRP3–ASC inflammasome exacerbating exogenously seeded and non-exogenously seeded Tau pathology in vivo. Acta Neuropathol. 137 (4), 599-617 (2019).
- Connolly, K., et al. Potential role of chitinase-3-like protein 1 (CHI3L1/YKL-40) in neurodegeneration and Alzheimer's disease. Alzheimers Dement. 19 (1), 9-24 (2022).
- Yingquan, W., Jing-Hong, L., Ruixia, J. Alzheimer disease in China (2015-2050) estimated using the 1% population sampling survey in 2015. China J Alzheimers Dis Relat Disord. 2 (1), 289-298 (2019).
- Amat-Ur-Rasool, H., Ahmed, M., Hasnain, S., Carter, W. G. Anti-cholinesterase combination drug therapy as a potential treatment for Alzheimer's disease. Brain Sci. 11 (2), 184(2021).
- Cummings, J., Lee, G., Mortsdorf, T., Ritter, A., Zhong, K. Alzheimer's disease drug development pipeline: 2017. Alzheimers Dement (N Y). 3 (3), 367-384 (2017).
- Birks, J. S., Harvey, R. J. Donepezil for dementia due to Alzheimer's disease. Cochrane Database Syst Rev. 6 (6), CD001190(2018).
- Knopman, D. S., et al. Alzheimer's disease. Nat Rev Dis Primers. 7 (1), 33(2021).
- Silva, T., Reis, J., Teixeira, J., Borges, F. Alzheimer's disease, enzyme targets and drug discovery struggles: from natural products to drug prototypes. Ageing Res Rev. 15, 116-145 (2014).
- Liu, X., Yi, W., Xi, B., Dai, Q., Lu, L. Identification of drug-disease associations using a random walk with restart method and supervised learning. Comput Math Methods Med. 2022 (1), 7035634(2022).
- Yu, N., et al. Ganoderma lucidum triterpenoids (GLTs) reduce neuronal apoptosis via inhibition of ROCK signal pathway in APP/PS1 transgenic Alzheimer's disease mice. Oxid Med Cell Longev. 2020 (1), 1-11 (2020).
- Bao, M., et al. Astragaloside IV against Alzheimer's disease via microglia-mediated neuroinflammation using network pharmacology and experimental validation. Eur J Pharmacol. 957, 175992(2023).
- Dartigues, J. F., et al. Ginkgo biloba extract consumption and long-term occurrence of death and dementia. J Prev Alzheimers Dis. 4 (1), 16-20 (2017).
- Savaskan, E., Mueller, H., Hoerr, R., von Gunten, A., Gauthier, S. Treatment effects of Ginkgo biloba extract EGb 761® on the spectrum of behavioral and psychological symptoms of dementia: meta-analysis of randomized controlled trials. Int Psychogeriatr. 30 (3), 285-293 (2017).
- Wang, D., Liu, W., Lu, M., Xu, Q. Neuropharmacological effects of Gastrodia elata Blume and its active ingredients. Front Neurol. 16, 1574277(2025).
- El Menyiy, N., et al. Chemistry, biological activities,and pharmacological properties of gastrodin: mechanism insights. Chem Biodivers. 21 (6), e202400402(2024).
- Yu, H., et al. Research progress on classification of chemical constituents from Gastrodia elata and their pharmacological effects. Chin Tradit Herbal Drugs. 53, 5553-5562 (2022).
- Tang, C., et al. Comparative pharmacokinetics of gastrodin in rats after intragastric administration of free gastrodin, parishin and Gastrodia elata extract. J Ethnopharmacol. 176, 49-54 (2015).
- Fu, X., et al. Antioxidation effects and mechanism of gastrodin in AD rat models. Acta Anat Sin. 41 (4), 485-490 (2010).
- Shi, R., et al. Gastrodin alleviates vascular dementia in a 2-VO vascular dementia rat model by altering amyloid and Tau levels. Pharmacology. 105 (7-8), 386-396 (2020).
- Fasina, O. B., et al. Gastrodin from Gastrodia elata enhances cognitive function and neuroprotection of AD mice via the regulation of gut microbiota composition and inhibition of neuron inflammation. Front Pharmacol. 13, 814271(2022).
- Zheng, Q., et al. MicroRNA-452 promotes tumorigenesis in hepatocellular carcinoma by targeting cyclin-dependent kinase inhibitor 1B. Mol Cell Biochem. 389 (1-2), 187-195 (2014).
- Yan, J., Yang, Z., Zhao, N., Li, Z., Cao, X. Gastrodin protects dopaminergic neurons via insulin-like pathway in a Parkinson's disease model. BMC Neurosci. 20 (1), 31(2019).
- Xiao, H., et al. Gastrodin promotes hippocampal neurogenesis via PDE9-cGMP-PKG pathway in mice following cerebral ischemia. Neurochem Int. 150, 105171(2021).
- Liu, Y., et al. A review on central nervous system effects of gastrodin. Front Pharmacol. 9, 24(2018).
- Fu, J., et al. Gastrodia elata specific miRNA attenuates neuroinflammation via modulating NF-κB signaling pathway. Int J Neurosci. 134 (12), 1652-1662 (2023).
- Wang, Y., et al. Gastrodin: a comprehensive pharmacological review. Naunyn Schmiedebergs Arch Pharmacol. 397 (6), 3781-3802 (2024).
- Liu, C. M., et al. Effects of gastrodin against lead-induced brain injury in mice associated with the Wnt/Nrf2 pathway. Nutrients. 12 (6), 1805(2020).
- De Oliveira, M. R., Brasil, F. B., Fürstenau, C. R. Nrf2 mediates the anti-apoptotic and anti-inflammatory effects induced by gastrodin in hydrogen peroxide-treated SH-SY5Y cells. J Mol Neurosci. 69 (1), 115-122 (2019).
- Zhang, J. S., et al. Gastrodin suppresses BACE1 expression under oxidative stress condition via inhibition of the PKR/eIF2α pathway in Alzheimer's disease. Neuroscience. 325, 1-9 (2016).
- Jiao, M., et al. Effect of the SSeCKS–TRAF6 interaction on gastrodin-mediated protection against 2,3,7,8-tetrachlorodibenzo-p-dioxin-induced astrocyte activation and neuronal death. Chemosphere. 226, 678-686 (2019).
- Cohen, P., Holmes, C. F., Tsukitani, Y. Okadaic acid: a new probe for the study of cellular regulation. Trends Biochem Sci. 15 (3), 98-102 (1990).
- Qin, Y., et al. Okadaic acid detection through a rapid and sensitive amplified luminescent proximity homogeneous assay. Toxins (Basel). 15 (8), 501(2023).
- Kim, S., et al. PubChem 2023 update. Nucleic Acids Res. 51 (D1), D1373-D1380 (2022).
- Daina, A., Michielin, O., Zoete, V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 47 (W1), W357-W364 (2019).
- Stelzer, G., et al. The GeneCards suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 54 (1), 1.30.31-1.30.33 (2016).
- Safran, M., et al. Practical guide to life science databases. , Springer Nature. Singapore. (2021).
- Amberger, J. S., Bocchini, C. A., Schiettecatte, F., Scott, A. F., Hamosh, A. OMIM.org: Online Mendelian Inheritance in Man (OMIM®), an online catalog of human genes and genetic disorders. Nucleic Acids Res. 43 (D1), D789-D798 (2014).
- Szklarczyk, D., et al. The STRING database in 2021: customizable protein–protein networks,and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 49 (D1), D605-D612 (2020).
- Zhou, Y., et al. Metascape provides a biologist-oriented resource for the analysis of systems-level datasets. Nat Commun. 10 (1), 1523(2019).
- Tominaga, H., et al. A water-soluble tetrazolium salt useful for colorimetric cell viability assay. Anal Commun. 36 (2), 47-50 (1999).
- Ton, A. M. M., et al. Oxidative stress and dementia in Alzheimer's patients: effects of synbiotic supplementation. Oxid Med Cell Longev. 2020 (1), 2638703(2020).
- Roth, K. A. Caspases, apoptosis,and Alzheimer disease: causation,correlation,and confusion. J Neuropathol Exp Neurol. 60 (9), 829-838 (2001).
- Cheng, M., et al. The effects of Porphyromonas gingivalis on the apoptosis of hippocampal cells in Sprague-Dawley rats and its underlying mechanisms. Int J Clin Exp Med. 13 (1), 300-309 (2020).
- Liu, H., et al. Development of chemical fingerprints for quality control of Xiong Ma Tang and its related preparations by high-performance liquid chromatography. J Chromatogr Sci. 54 (2), 206-215 (2016).
- Liu, S. J., et al. Gastrodin attenuates microglia activation through renin-angiotensin system and Sirtuin3 pathway. Neurochem Int. 120, 49-63 (2018).
- Hu, Y., Li, C., Shen, W. Gastrodin alleviates memory deficits and reduces neuropathology in a mouse model of Alzheimer's disease. Neuropathology. 34 (4), 370-377 (2014).
- Liu, J., et al. Systems pharmacology uncovers the multiple mechanisms of Xijiao Dihuang decoction for the treatment of viral hemorrhagic fever. Evid Based Complement Alternat Med. 2016 (1), 9025036(2016).
- Ran, B., et al. Drug-drug interactions prediction using fingerprint only. Comput Math Methods Med. 2022 (1), 7818480(2022).
- Sharma, V. K., Singh, T. G., Singh, S., Garg, N., Dhiman, S. Apoptotic pathways and Alzheimer's disease: probing therapeutic potential. Neurochem Res. 46 (12), 3103-3122 (2021).
- Zhou, W., Gao, Y., Xu, S., Yang, Z., Xu, T. Purification of a mannose-binding lectin Pinellia ternata agglutinin and its induction of apoptosis in Bel-7404 cells. Protein Expr Purif. 93, 11-17 (2014).
- Goedert, M., Spillantini, M. G., Jakes, R., Rutherford, D., Crowther, R. Multiple isoforms of human microtubule-associated protein tau: sequences and localization in neurofibrillary tangles of Alzheimer's disease. Neuron. 3 (4), 519-526 (1989).
- Hernández, F., Gómez De Barreda, E., Fuster-Matanzo, A., Lucas, J. J., Avila, J. GSK3: a possible link between beta amyloid peptide and tau protein. Exp Neurol. 223 (2), 322-325 (2010).
- Lu, Z., et al. Neuroprotection and mechanism of Gas-miR36-5p from Gastrodia elata in an Alzheimer's disease model by regulating glycogen synthase kinase-3β. Int J Mol Sci. 24 (24), 17295(2023).
- Vossel, K. A., et al. Tau reduction prevents Aβ-induced axonal transport deficits by blocking activation of GSK3β. J Cell Biol. 209 (3), 419-433 (2015).
- Singh, A. K., et al. Berberine: a plant-derived alkaloid with therapeutic potential to combat Alzheimer's disease. CNS Agents Med Chem. 19 (3), 154-170 (2019).
- Belsare, K. D., et al. Soluble TREM2 inhibits secondary nucleation of Aβ fibrillization and enhances cellular uptake of fibrillar Aβ. Proc Natl Acad Sci U S A. 119 (5), e2114486119(2022).
- Matsuda, S., et al. Roles of PI3K/AKT/GSK3 pathway involved in psychiatric illnesses. Diseases. 7 (1), 22(2019).
- Pan, S., et al. Oleanolic acid derivatives induce apoptosis in human leukemia K562 cell involved in inhibition of both Akt1 translocation and pAkt1 expression. Cytotechnology. 67 (5), 821-829 (2014).
- Zhou, F., et al. Network pharmacology-based strategy to investigate pharmacological mechanisms of Tinospora sinensis for treatment of Alzheimer's disease. J Ethnopharmacol. 259, 112940(2020).
- Liu, Z., Wang, Z. Protein tyrosine kinase 2 regulates tau phosphorylation through PI3K/AKT/Gsk3β signaling pathway. Labeled Immunoassays Clin Med. 29 (3), 464-470 (2022).
- Cope, P. J., Ourradi, K., Li, Y., Sharif, M. Models of osteoarthritis: the good, the bad and the promising. Osteoarthritis Cartilage. 27 (2), 230-239 (2019).
- Wang, X., Blanchard, J., Tung, Y. C., Grundke-Iqbal, I., Iqbal, K. Inhibition of protein phosphatase-2A (PP2A) by I1PP2A leads to hyperphosphorylation of tau, neurodegeneration,and cognitive impairment in rats. J Alzheimers Dis. 45 (2), 423-435 (2015).
- Liu, T. T., et al. Gastrodin alleviates Aβ25-35-induced glycolytic dysfunction via activating PI3K/AKT/BACH1 signaling in Alzheimer's disease models. Exp Neurol. 389, 115225(2025).
- Zuo, H. J., et al. Gastrodin regulates PI3K/AKT-Sirt3 signaling pathway and proinflammatory mediators in activated microglia. Mol Neurobiol. 61 (5), 2728-2744 (2024).
- Wang, Y. P., Mandelkow, E. Tau in physiology and pathology. Nat Rev Neurosci. 17, 22-35 (2015).
- Pardridge, W. M. Drug transport across the blood–brain barrier. J Cereb Blood Flow Metab. 32 (11), 1959-1972 (2012).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.