Este protocolo describe el desarrollo y la evaluación de un chatbot de generación aumentada basada en guías que recupera y resume contenido de guías clínicas de práctica oncológica basadas en la web para generar respuestas basadas en referencias a las consultas de los usuarios.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Desarrollo de un chatbot de generación aumentada basada en guías que referencian guías clínicas de práctica clínica del cáncer basadas en la web
En este artículo
Resumen
Resumen
La amplia disponibilidad de información médica en Internet ha mejorado el acceso al conocimiento relacionado con la salud para los pacientes; Sin embargo, también ha aumentado la exposición a información médica inexacta. El cuidado oncológico implica información compleja, lo que dificulta que los pacientes identifiquen fuentes precisas y basadas en la evidencia. Los grandes modelos de lenguaje permiten la interacción con el lenguaje natural, pero con frecuencia generan alucinaciones, limitando su aplicación en la entrega de información médica. La generación aumentada por recuperación (RAG) tiene el potencial de mitigar estos riesgos al fundamentar las respuestas en fuentes de referencia externas. Este estudio describe el desarrollo y la evaluación de un chatbot RAG basado en guías que utiliza guías de práctica clínica del cáncer disponibles públicamente en la web. El sistema extrae URLs de las páginas de índice de una guía, procesa el texto de las páginas mediante análisis morfológico y similitud coseno basada en la frecuencia de términos–frecuencia inversa del documento, y construye información de referencia a partir de páginas altamente relevantes. Un modelo de lenguaje grande utiliza estas referencias para generar respuestas limitadas al contenido directivo. La Guía JLCS para Pacientes y Familias con Cáncer de Pulmón se utilizó como guía de referencia. Los conjuntos de preguntas incluían tanto tipos de cáncer dentro del alcance cubiertos por la guía como tipos de cáncer fuera del alcance para evaluar el control de la respuesta. La información médica se extrajo con éxito de las páginas de índice, con el 98% de las URLs extraídas conteniendo contenido médico referenciable. Para las preguntas dentro del alcance, el chatbot generó respuestas resumiendo el contenido de las directrices, y no se identificaron alucinaciones durante la revisión manual bajo las condiciones de prueba definidas. Para las preguntas fuera de alcance, el chatbot se negó consistentemente a responder e indicó que la información disponible era insuficiente. La estructura web de la guía facilitó un scraping eficiente y la organización del contenido de referencia a nivel de URL. Este protocolo proporciona orientación práctica para construir sistemas de inteligencia artificial que proporcionen información médica utilizando guías de práctica clínica basadas en la web.
Introducción
El uso generalizado de internet y las redes sociales ha facilitado el acceso a la información médicade los pacientes 1,2. La información sobre el cuidado oncológico suele ser compleja y extensa, lo que dificulta especialmente que los pacientes identifiquen fuentes precisas, relevantes y basadas en evidenciacientífica 3. Aunque los recursos en línea pueden ayudar a comprender a los pacientes, también contienen una cantidad considerable de información médicaincorrecta 3, lo que puede afectar negativamente las decisiones de los pacientes respecto a suatención 4. Dado que la desinformación relacionada con el cáncer puede afectar a los resultados de los pacientes5, existe una necesidad creciente de sistemas de inteligencia artificial (IA) que ayuden a los usuarios individuales a buscar, resumir e interpretar informaciónmédica 6.
Los grandes modelos de lenguaje (LLM) permiten a los usuarios acceder a la información mediante conversaciones en lenguajenatural 7; Sin embargo, la generación de desinformación (es decir, alucinaciones) sigue siendo una preocupación seria en el ámbito médico 8,9,10,11. Una fuente clave de desinformación es la calidad y precisión de los datos de entrenamiento utilizados para desarrollar el chatbot. Además, la naturaleza estática del entrenamiento de modelos significa que el conocimiento puede quedar obsoleto con el tiempo, limitando la capacidad de los LLMs para proporcionar información actual ycontextualmente adecuada 12,13. Estas limitaciones ponen de manifiesto la importancia de estrategias efectivas de gestión del conocimiento para garantizar que las respuestas de los chatbots sigan siendo precisas, relevantes y actualizadas. En particular, los sistemas que puedan acceder y consultar fácilmente recursos actuales basados en la evidencia, como las guías de práctica clínica, son deseables en entornos médicos, donde las recomendaciones y los estándares de atención evolucionan continuamente. Para abordar este desafío, la generación aumentada por recuperación (RAG), que genera respuestas incorporando información de fuentes externas de conocimiento, ha recibido una atención creciente 10,13,14,15,16,17.
Aunque RAG se ha aplicado cada vez más a chatbots médicos, se ha prestado poca atención a cómo deben incorporarse sistemáticamente las guías de práctica clínica como fuentes de informaciónde referencia 18. Muchas guías de práctica clínica están disponibles públicamente en la web; sin embargo, sigue sin estar claro si su estructura web existente puede servir directamente como marco de recuperación para los sistemasRAG 18. Además, no se han establecido bien métodos prácticos para construir información de referencia sin desarrollo manual de bases de conocimiento.
En este estudio, nuestro objetivo fue establecer principios de diseño para sistemas de IA de referencia de guías en el ámbito sanitario mediante el desarrollo y evaluación de un chatbot RAG basado en guías que utilice directrices clínicas de oncología disponibles públicamente en la web, permitiendo así un acceso sencillo y oportuno a la información basada en directrices. Como prueba de concepto, evaluamos la viabilidad técnica de la recuperación de directrices, generación de respuestas y restricción de respuesta utilizando la estructura web existente de guías clínicas disponibles públicamente, con el objetivo de proponer un protocolo de desarrollo reproducible para sistemas RAG referenciados a guías.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio no involucra a sujetos humanos que requieran protección frente a los riesgos asociados a la investigación. Por lo tanto, no requiere revisión por parte de un comité de revisión institucional según las directrices éticas japonesas para la investigación médica que involucre a sujetoshumanos 19. Este estudio se presenta conforme a las directrices TRIPOD-LLM para la Transparencia de Reporte de un Modelo Multivariable para Pronóstico o Diagnóstico Individual(TRIPOD)-LLM 20.
Consulte la Figura 1 para una visión general esquemática del protocolo de chatbot RAG basado en directrices.
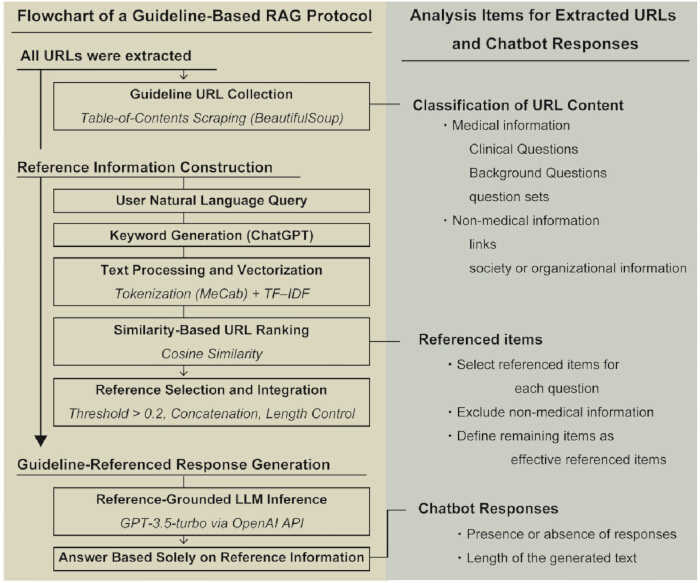
Figura 1. Flujo de trabajo del protocolo de chatbot Generación Aumentada por Recuperación Basada en Guías (RAG). Resumen esquemático del flujo de trabajo de chatbot RAG basado en guías. Las URLs se extraen de la página de índice de una guía de práctica clínica basada en la web y se utilizan para construir información de referencia. Las consultas de usuario se convierten en palabras clave y el contenido de la página web se procesa mediante tokenización, vectorización de frecuencia de términos–frecuencia inversa de documentos y análisis de similitud coseno para identificar páginas de directrices relevantes. La información de referencia seleccionada se integra y se proporciona a un modelo de lenguaje grande para generar respuestas basadas únicamente en el contenido de la guía referenciada. El panel derecho resume los elementos de evaluación utilizados para las URLs extraídas, la información de referencia y las respuestas de los chatbots. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
1. Preparación de información de referencia a partir de directrices basadas en la web
- Extrae todas las URLs de las páginas de índice de las guías de práctica clínica web objetivo utilizando BeautifulSoup 4 (biblioteca de análisis sintáctico HTML) implementada en el lenguaje de programación Python (versión 3.12).
NOTA: Implementa el script de extracción de URL usando el lenguaje de programación con los siguientes paquetes: biblioteca de análisis HTML (versión 4.12.3) y peticiones (biblioteca de recuperación de páginas web; versión 2.32.3). Instala paquetes usando pip. El código fuente completo para la extracción de URL se proporciona en el Archivo Suplementario 1. Consulta la Tabla de Materiales para detalles del software. - Revisa manualmente todas las URLs extraídas para confirmar el acceso exitoso y la relevancia para la guía de práctica clínica objetivo.
- Clasifica cada URL como conteniendo información médica o no médica. Realiza la clasificación de URL por un solo autor (S.N.).
NOTA: La información médica se definió como contenido de referencia de las directrices, incluyendo preguntas clínicas (CQ), preguntas de antecedentes y conjuntos de preguntas. La información no médica incluía enlaces, páginas de sociedades u organizaciones y otro contenido auxiliar que no era adecuado para consulta. - Compila las URLs validadas en un libro de trabajo de Microsoft Excel (formato .xlsx), registrando una URL por fila. Almacena la lista de URL resultante como conjunto de datos de entrada para la recuperación de texto, preprocesamiento y análisis de similitud posteriores.
2. Generación de palabras clave a partir de consultas de usuario
- Introduce la consulta en lenguaje natural en ChatGPT (Transformador Generativo Preentrenado, versión 4o; modelo de generación de palabras clave).
- Pide al modelo que extraiga dos palabras clave correspondientes a la consulta del usuario.
- Utiliza el siguiente prompt, escrito en japonés, para generar palabras clave:
"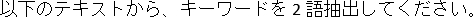 "
(Traducción al inglés: "Extract two keywords from the following text.") - Añade la consulta de lenguaje natural del usuario a esta instrucción y envíala al modelo de generación de palabras clave para la generación de palabras clave.
- No modifique manualmente ningún parámetro del modelo. Realizar la generación de palabras clave utilizando la configuración predeterminada del modelo de generación de palabras clave.
- Genera dos palabras clave para cada consulta de usuario. Conserva ambas palabras clave sin modificaciones, filtros o selección manual, y úsalas para cálculos posteriores de similitud.
- Guarda las palabras clave generadas en un libro de trabajo de Microsoft Excel (formato .xlsx). Para cada registro, almacena la consulta original del usuario y sus palabras clave generadas correspondientes para una recuperación posterior basada en similitud.
3. Procesamiento de texto y cálculo de similitud
- Recupera el texto completo de cada URL extraída usando la biblioteca de recuperación de páginas web y la biblioteca de análisis sintáctico HTML. Extrae contenido de texto del código fuente HTML usando la función BeautifulSoup get_text().
- Preprocesa el texto extraído de la página web y las palabras clave generadas eliminando etiquetas HTML y caracteres no japoneses.
- Realizar análisis morfológicos japoneses usando MeCab (versión 0.996; analizador morfológico japonés) con el diccionario por defecto. Conserva solo los sustantivos y concatena los nombres en una cadena de texto delimitada por el espacio.
- Combina las palabras clave generadas en una sola cadena de texto y aplica los mismos procedimientos de preprocesamiento y tokenización que se usan para el texto de páginas web.
- Genera vectores frecuencia–inversa de documento (TF–IDF) de términos a partir del texto procesado de la página web y del texto de palabras clave usando la implementación TfidfVectorizer en la biblioteca scikit-learn (versión 1.6.1) con la configuración de parámetros por defecto.
NOTA: Todos los parámetros de TfidfVectorizer se dejaron en sus valores predeterminados y no se aplicaron ajustes personalizados de parámetros. - Calcula la similitud coseno entre cada vector de página web y el vector de palabras clave usando la función de similitud coseno.
- Clasifica las URLs en orden descendente según las puntuaciones de similitud coseno. No aplique criterios adicionales de desempate.
- Selecciona páginas con una puntuación de similitud coseno de ≥0,2 como información de referencia de candidatos.
NOTA: El umbral de similitud coseno (0.2) fue seleccionado empíricamente durante el desarrollo del sistema para priorizar la recuperación de recuperación y evitar excluir contenido potencialmente relevante de las directrices. - Conserva todas las páginas de candidatos que cumplan con el umbral de similitud.
4. Construcción de la información de referencia
- Extrae secuencialmente el contenido de texto de las páginas seleccionadas desde la parte superior de la lista clasificada.
- Concatena los textos extraídos para formar un único documento de referencia.
- Antes de enviarlo al LLM, sustituye los caracteres de nueva línea y los caracteres en blanco consecutivos en el texto de referencia por un solo espacio.
- Trunque el texto de referencia concatenado a los primeros 4.096 caracteres antes de proporcionarlo al LLM.
NOTA: El límite de truncamiento se basaba en caracteres y no en fichas. Se seleccionó empíricamente un límite de 4.096 caracteres para asegurar que la información combinada de prompt y referencia permaneciera dentro de la capacidad de entrada del modelo de generación de respuesta GPT-3.5-turbo-16k.
5. Generación de respuestas basada en IA
- Proporciona la información de referencia construida y la consulta original del usuario al modelo de generación de respuestas a través de la interfaz de programación de aplicaciones (API).
- Instruye a la IA usando el siguiente prompt (escrito íntegramente en japonés) para asegurarse de que las respuestas se generen únicamente en base a la información de referencia proporcionada:
"Eres un asistente de información médica que ofrece orientación a pacientes con cáncer. Genera respuestas basándote únicamente en la siguiente información de referencia y no utilices tu propio conocimiento general ni razonamiento. Las respuestas deben ser detalladas y fáciles de entender, con aproximadamente 500 caracteres de longitud. Si la información de referencia no contiene suficiente información para responder a la pregunta, responde: 'No hay información suficiente en el texto', sin usar especulación ni conocimiento general." - Proporciona la información de referencia y la consulta del usuario juntas en un solo mensaje de usuario. Estructura la entrada como: "Información de referencia: [texto de referencia]" seguido de "Pregunta: [consulta del usuario]".
- Genera respuestas usando el modelo de generación de respuestas con los siguientes ajustes: temperatura = 0,1, longitud máxima de salida = 1.024 tokens, n = 1, y stop = ninguno.
- Obtén la respuesta generada por IA para su evaluación posterior.
NOTA: Envía la información de referencia y la consulta del usuario como un solo mensaje de usuario. Proporciona las instrucciones de generación de respuesta por separado como mensaje del sistema.
6. Directrices de referencia y formulación de preguntas
- Seleccione la Guía JLCS para Pacientes y Familias con Cáncer de Pulmón (Guía de Pulmón)21, que está disponible gratuitamente en línea, como información de referencia para el sistema de chatbots RAG basado en guías.
- Crea dos categorías de preguntas de evaluación basadas en el tipo de cáncer: tumores tímicos, que están dentro del alcance de la guía, y glioma pediátrico, que está fuera del alcance de la información referenciada.
- Formula cuatro preguntas que cubran el diagnóstico y tratamiento de cada tipo de cáncer:
"¿Qué métodos diagnósticos existen para tumores XX (por ejemplo, glioma tímico o pediátrico)?
"¿Cuáles son los enfoques diagnósticos patológicos para los tumores XX?"
"¿Qué opciones de tratamiento existen para los tumores XX?"
"¿Cuáles son las opciones de tratamiento quirúrgico para los tumores XX?" - Envía preguntas relacionadas con los tipos de cáncer cubiertos por la guía web referenciada al chatbot. Por ejemplo, envía una pregunta sobre el diagnóstico de tumores tímicos utilizando la Guía del Pulmón como información de referencia.
- Envía preguntas fuera del alcance de la guía de referencia al chatbot para evaluar su capacidad de abstenerse de usar información externa o no relacionada. Por ejemplo, envía una pregunta sobre el glioma pediátrico utilizando la Guía del Pulmón como información de referencia.
- Evalúa cada pregunta en una sesión de chat independiente. No traslades el historial de conversación entre preguntas.
- Registra las respuestas generadas por IA para su evaluación posterior.
7. Evaluación de la respuesta
- Realiza una revisión manual de todas las respuestas generadas.
- Evalúa si cada respuesta contiene alucinaciones.
- Evalúa si cada respuesta está respaldada por la información contenida en la guía de referencia.
NOTA: Las alucinaciones se definieron como respuestas que contenían eventos, nombres o términos inexistentes que podrían causar daño médico14. Todas las respuestas generadas fueron revisadas para comprobar su exactitud y ausencia de alucinaciones por un autor con 8 años de experiencia en un hospital universitario, incluyendo apoyo al paciente y comunicación médica para pacientes con cáncer. Cualquier incertidumbre sobre la clasificación de la respuesta se resolvió mediante una conversación con un médico coautor con más de 20 años de experiencia en servicios de información oncológica en el Centro Nacional de Cáncer de Japón. - Considera que una respuesta solo está respaldada cuando todas las afirmaciones clínicamente relevantes puedan ser confirmadas directamente a partir de la guía de referencia recuperada sin requerir conocimientos adicionales ni inferencias no respaldadas.
- Clasifica cada respuesta usando etiquetas de resultado predefinidas. Clasifica las respuestas que contienen solo información respaldada por la guía de referencia como "alucinación ausente". Clasifica las respuestas que contengan información sin fundamento o fabricada como "alucinaciones presentes".
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Recuperación de contenido médico mediante páginas de índice
La arquitectura de web-scraping recogía URLs de la página de índice de la guía. De la Guía Pulmonar, se extrajeron 106 URLs de la página de índice, de las cuales 104 (98%) contenían información médica (Tabla Suplementaria 1). La eficacia de las respuestas de los chatbots basadas en las páginas de contenido de las directrices se resume en la Tabla 1. E...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
En este estudio, examinamos la utilidad de un chatbot RAG basado en guías que utilizara una guía de práctica clínica en línea —la Guía JLCS para Pacientes y Familias con Cáncer de Pulmón— como fuente de información de referencia. El chatbot generaba respuestas basadas en el contenido de la guía explotando la estructura web de la guía y recuperando páginas basándose en su similitud con las consultas de los usuarios. Este enfoque demostró que la recuperación basada en similitudes combinada...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no declaran intereses en competencia.
Agradecimientos
Los autores agradecen a Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), por su amplio apoyo técnico en el desarrollo del chatbot de generación aumentada basada en guías. Los autores también agradecen a Chikako Yamaki, PhD, y a todos los miembros del equipo de investigación del Instituto para el Control del Cáncer, Centro Nacional de Cáncer de Japón (Tokio, Japón), por ofrecer valiosos consejos sobre el tema tratado en este artículo. Además, los autores agradecen a Editage la edición en inglés. Este trabajo fue apoyado por una subvención de investigación en Ciencias de la Salud y del Trabajo (R6–Cancer Control–23EA1026).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
```html
```
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Beautiful Soup 4 (versión 4.12.3) | Beautiful Soup Project | N/A | Biblioteca de Python utilizada para la extracción de URL y el análisis de HTML |
| ChatGPT versión 4o | OpenAI | N/A | Utilizado para la generación de palabras clave |
| GPT-3.5-turbo | OpenAI | N/A | Utilizado para la generación de respuestas |
| Libro de guía JLCS para pacientes con cáncer de pulmón y sus familias | Sociedad Japonesa de Cáncer de Pulmón | N/A | Directriz de práctica clínica basada en la web utilizada como información de referencia |
| MeCab (versión 0.996) | Proyecto MeCab | N/A | Analizador morfológico japonés |
| API de OpenAI | OpenAI | N/A | Utilizado para la generación de respuestas basadas en IA |
| Python (versión 3.12) | Fundación de Software Python | N/A | Entorno de programación |
| Requests (versión 2.32.3) | Proyecto Requests | N/A | Biblioteca de Python utilizada para la obtención de páginas web |
| scikit-learn (versión 1.6.1) | Desarrolladores de scikit-learn | N/A | Utilizado para la vectorización TF–IDF y el cálculo de similitud coseno. |
| urllib.parse | Fundación de Software Python | N/A | Biblioteca de Python utilizada para la normalización y unión de URL |
Referencias
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.