Este protocolo implementa una red de aprendizaje profundo en forma de U que integra convolución de molinete de viento, doble atención y fusión multiescala para segmentar pólipos colorrectales.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Red de segmentación de pólipos basada en convolución en molinete y doble atención para el diagnóstico de lesiones precancerosas colorrectales
* These authors contributed equally
En este artículo
Resumen
Resumen
La segmentación precisa de los pólipos colorrectales es crucial para la prevención y el diagnóstico temprano del cáncer colorrectal. Sin embargo, debido a la alta heterogeneidad de los pólipos en términos de forma, tamaño y textura, así como a la complejidad del entorno intestinal (como pliegues, reflejos especulares y residuos fecales), los métodos existentes aún enfrentan desafíos significativos en la localización de los límites y la detección de pólipos pequeños. Para abordar estos problemas, este artículo propone una Red de Segmentación de Pólipos basada en la Convolución en Molinete y la Doble Atención (PWD-Net). La red propuesta adopta una arquitectura codificador-decodificador en forma de U, donde se emplea un ResNet preentrenado como codificador para extraer características locales multinivel. Específicamente, se introduce un Módulo de Convolución Pinwheel (PCM) en la capa de cuello de botella para capturar la estructura geométrica global y la información contextual multidireccional de los pólipos mediante núcleos de convolución rotados en múltiples ángulos. Un Mecanismo de Doble Atención (DAM) que integra la atención del canal y la atención espacial está diseñado para suprimir de forma adaptativa el ruido de fondo y mejorar las características de la región de pólipos. Además, se emplea una estrategia de Fusión de Características Multiescala (MSF) para combinar información semántica profunda con detalles superficiales en los límites, asegurando tanto la completitud como la precisión de los resultados de segmentación. Los experimentos realizados con los conjuntos de datos Kvasir-SEG y CVC-ClinicDB demuestran que PWD-Net alcanza coeficientes medios de Dice de 0,865 y 0,944, y puntuaciones IoU de 0,765 y 0,892, respectivamente, superando significativamente a los métodos de última generación existentes. Los estudios de ablación verifican la efectividad de cada módulo, y las evaluaciones entre conjuntos de datos confirman la fuerte capacidad de generalización del modelo. Este estudio ofrece una solución de alta precisión y robusta para la segmentación clínica de pólipos, ofreciendo un valor significativo para el diagnóstico precoz de lesiones precancerosas colorrectales y apoyando la intervención asistida por ordenador.
Introducción
El cáncer colorrectal es uno de los tumores malignos más comunes en todo el mundo, con tasas de incidencia y mortalidad consistentemente altas. Los estudios han demostrado que la mayoría de los cánceres colorrectales se desarrollan a partir de pólipos adenomatosos, un proceso que normalmente dura entre 10 y 15 años, proporcionando una valiosa ventana temporal para la detección e intervención precoz. Un aumento del 1% en la tasa de detección de adenomas (ADR) puede reducir el riesgo de cáncer colorrectal en aproximadamente un 3%, disminuyendo significativamente la mortalidaddel paciente 1. La colonoscopia, considerada el estándar de oro para el cribado del cáncer colorrectal, permite la extirpación directa de pólipos durante el examen, reduciendo así eficazmente la incidencia y mortalidad por cáncer.
Sin embargo, la colonoscopia convencional depende en gran medida de la experiencia y el nivel de habilidad de los endoscopistas. Factores como el juicio subjetivo, la fatiga visual y la distracción pueden provocar una tasa de fallo del 20%–30%, lo que afecta directamente a la efectividad delcribado 2. Por ello, desarrollar sistemas de detección asistida por ordenador (CAD) para la segmentación automática de pólipos colorrectales tiene una importancia considerable para mejorar la ADR y reducir diagnósticos perdidos. Encuestas clínicas recientes han puesto de manifiesto aún más el interés en integrar la inteligencia artificial en los flujos de trabajo de evaluación endoscópica de lesiones, reforzando la necesidad de métodos de segmentación robustosy reproducibles.
En los últimos años, el aprendizaje profundo ha logrado avances notables en el análisis de imágenes médicas, especialmente en redes neuronales convolucionales (CNN), que demuestran una gran capacidad en la extracción de características y representación para tareas de segmentaciónde imágenes 4. Como modelo clásico de segmentación de imágenes médicas, U-Net emplea una arquitectura codificador-decodificador simétrica y conexiones de salto para lograr una segmentación precisa a nivel de píxel, convirtiéndose en un referente en estecampo 5. Basándose en U-Net, se han propuesto muchas arquitecturas mejoradas para abordar tareas complejas de segmentación de imágenes médicas. UNet++ reduce la brecha semántica entre los mapas de características del codificador y el decodificador introduciendo conexiones anidadas y de saltodenso 6. ResUNet++ integra bloques residuales, módulos de apretón y excitación, convoluciones dilatadas y mecanismos de atención, logrando un rendimiento sólido en segmentación depólipos 7. U2-Net adopta una estructura anidada en forma de U de dos niveles para capturar información de características a múltiplesescalas 8. Más recientemente, se ha propuesto una red de segmentación profunda de pólipos basada en codificador-decodificador dual, que aprovecha rutas de codificación y decodificación paralelas para mejorar aún más la precisión de lasegmentación 9.
Mientras tanto, la introducción de mecanismos de atención ofrece nuevas soluciones para la mejora de características y la supresión del ruido. Attention U-Net emplea puertas de atención para enfocarse en regiones objetivo mientras suprime información de fondo irrelevante10. La Red de Doble Atención (DANet) pondera adaptativamente características tanto de las dimensiones de canal comoespaciales 11, mejorando la percepción de características críticas. Las Redes de Triple Atención (TANet) mejoran aún más el rendimiento de la segmentación mediante la selección adaptativa de características multiescala12.
Con el éxito de las arquitecturas Transformer en procesamiento de lenguaje natural y visiónpor ordenador 13, los investigadores han comenzado a explorar su aplicación en la segmentación de imágenes médicas. TransUNet fue el primero en emplear un Transformador como codificador para modelar dependencias de largo alcance de formaefectiva 14. Swin-UNet adopta una arquitectura puramente Transformer y logra una agregación global eficiente de información mediante un mecanismo de ventanadesplazada 15. UTNet propone una arquitectura híbrida que combina la capacidad de extracción local de características de las CNN con la capacidad de modelado global de Transformers16.
En el campo de la segmentación de pólipos, Polyp-PVT utiliza un Transformer de visión piramidal para capturar información semántica globala escala múltiple 17, mientras que UNet anidado a escala múltiple mejora la comprensión contextual integrando Transformers18. Estudios recientes también han explorado estrategias de aprendizaje por correlación negativa para la segmentación de pólipos entredominios 19, la mejora de segmentación aumentada con Gompertz20 y arquitecturas basadas en la atención que incorporan guía delímites 21. Aunque estos enfoques mejoran en cierta medida el rendimiento de la segmentación, la segmentación de pólipos aún enfrenta varios desafíos. En primer lugar, los pólipos presentan una gran heterogeneidad en morfología, tamaño y textura, que van desde micropólipos de menos de 5 mm hasta pólipos grandes que superan los 30 mm, con formas que varían desde circulares y elípticas hasta formas muy irregulares. En segundo lugar, el entorno intestinal es complejo y variable, donde los pliegues mucosos, los reflejos especulares, los residuos fecales y los restos de comida introducen una interferencia de fondo severa. En tercer lugar, muchos pólipos tienen límites difusos, pueden estar parcialmente ocluidos por pliegues o sumergidos en fluidos intestinales, lo que hace que la localización precisa de los límites sea extremadamentedifícil 22.
Los métodos existentes aún presentan limitaciones claras para abordar estos desafíos. Las CNN tradicionales son eficaces para extraer texturas locales y características de bordes; sin embargo, los núcleos de convolución cuadrada fija no son adecuados para capturar diversas formas geométricas23, especialmente para pólipos muy irregulares, y no pueden modelar eficazmente características geométricas multidireccionales. Los métodos basados en transformadores pueden modelar dependencias globales, pero son menos efectivos para captar detalles locales finos e información de fronteras. Además, su alta complejidad computacional los hace menos adecuados para aplicaciones clínicas en tiemporeal 24. Enfoques recientes de segmentación de pólipos como PraNet, que utiliza módulos de atención inversa para refinar regiones clave25, redes de atención en cascada guiadas por límites que mejoran la extracción de característicasde límite 26, y CAFE-Net, que fusiona características codificadoras y decodificadoras mediante mecanismosde atención cruzada 27, aún encuentran una representación insuficiente de características y una localización inexacta de los límites al tratar con pólipospequeños 28, límites difuminados y fondos complejos. Además, la mayoría de los métodos descuidan la morfología geométrica y no aprovechan plenamente la información contextual multidireccional, lo que resulta en una segmentación subóptima de pólipos de forma irregular.
En resumen, los métodos actuales basados en CNN carecen de la capacidad de capturar características geométricas multidireccionales debido a su dependencia de núcleos de convolución cuadrada fija. Los enfoques basados en transformadores ofrecen modelado global pero sacrifican la precisión local en el límite e imponen altos costes computacionales. Mientras tanto, las estrategias de fusión actuales con atención mejorada y multiescala no se han optimizado conjuntamente dentro de un marco unificado específicamente adaptado para la segmentaciónde pólipos 29. Estas lagunas motivan el desarrollo de un método que aborda simultáneamente el modelado geométrico de características, la supresión adaptativa del ruido y la integración de características a escala cruzada.
Para abordar estos problemas, este protocolo presenta una Red de Segmentación de Pólipos basada en Convolución de Molinete y Doble Atención (PWD-Net). La red propuesta integra modelado geométrico de características, mejora de la atención multidimensional y fusión de características a múltiples escalas, permitiendo la segmentación precisa de pólipos complejos. Las principales contribuciones de este trabajo se resumen de la siguiente manera: el módulo de convolución en molinete (PCM), inspirado en la estructura de un molinillo, propone un novedoso diseño de núcleo de convolución rotado que captura características geométricas multidireccionales de los pólipos mediante operaciones de convolución en múltiples ángulos (0°, 45°, 90°, 135°, 180°, 225°, 270° y 315°). Este módulo sustituye la capa convencional de convolución en la etapa de cuello de botella, permitiendo una percepción efectiva de diversas orientaciones de bordes y mejorando significativamente la representación de pólipos de formas irregulares. El mecanismo de doble atención (DAM) aborda el ruido de fondo como pliegues, reflexiones y residuos fecales en las imágenes de colonoscopia. Se diseña un módulo de doble atención que integra la atención canalizada y la atención espacial. Integrado en conexiones de salto, este módulo suprime de forma adaptativa la interferencia de fondo y mejora las respuestas de características en regiones de pólipos al identificar conjuntamente "qué" es importante (dimensión del canal) y "dónde" se encuentra el objetivo (dimensión espacial), asegurando que solo las características refinadas estén involucradas en la fusión posterior. La estrategia de fusión de características multiescala (MSF) preserva tanto información semántica profunda como detalles superficiales de los límites mediante un mecanismo jerárquico introducido en el decodificador. Al integrar progresivamente características de codificadores mejorados con DAM con características de decodificador upamuestreado, esta estrategia compensa eficazmente la pérdida de detalle espacial causada por el muestreo descendente, permitiendo la detección precisa de pólipos pequeños y una delimitación precisa de los límites.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utiliza únicamente conjuntos de datos de imágenes de colonoscopia anonimizadas y disponibles públicamente (Kvasir-SEG). No se recogieron nuevos datos de sujetos humanos. No se requería la aprobación ética institucional ni el consentimiento informado del paciente, como confirman las políticas de revisión institucional para análisis retrospectivos de conjuntos de datos públicos desidentificados.
1. Preparación de datos
- Descarga el conjunto de datos Kvasir-SEG desde el repositorio oficial 33 (https://datasets.simula.no/kvasir-seg/). El conjunto de datos contiene 1.000 imágenes de pólipos con las correspondientes máscaras de verdad a nivel de píxel.
- Divide aleatoriamente el conjunto de datos en conjuntos de entrenamiento (800 imágenes), validación (100 imágenes) y test (100 imágenes) con una proporción de 8:1:1 usando una semilla aleatoria fija (semilla = 42). Verifica que no haya imágenes solapadas entre los tres subconjuntos para evitar fugas de datos.
- Redimensionar todas las imágenes y máscaras correspondientes a 352 x 352 píxeles usando interpolación bilineal para imágenes y interpolación de vecinos más cercanos para máscaras.
- Normaliza los valores de píxeles a [0, 1] dividiendo por 255, luego aplica la resta media de canal por canal de ImageNet (0,485, 0,456, 0,406) y la normalización por desviación estándar (0,229, 0,224, 0,225).
- Aplicar las siguientes transformaciones de aumento solo al conjunto de entrenamiento (no a los conjuntos de validación o prueba): giro horizontal aleatorio (probabilidad = 0,5); giro vertical aleatorio (probabilidad = 0,5); rotación aleatoria (rango: −30° a +30°, probabilidad = 0,5); Redimensionamiento aleatorio de múltiples escalas (factor de escala: 0,75 a 1,25, probabilidad = 0,5)
NOTA: Aplicar transformaciones espaciales idénticas tanto a la imagen como a su correspondiente máscara para mantener la alineación. Verifica la corrección de la mejora inspeccionando visualmente varios pares imagen-máscara aumentados antes de iniciar el entrenamiento.
2. Arquitectura general
NOTA: Consulte la Figura 1 para la columna vertebral codificador-decodificador a nivel macro de PWD-Net, y la Figura 2 para la integración e interacción de módulos centrales dentro del flujo de características. La arquitectura general sigue un diseño codificador-decodificador en forma de U para manejar variaciones de escala de pólipos e interferencias de fondo en imágenes de colonoscopia.
- Columna vertebral y camino de codificación (Figura 1)
- Emplea un ResNet-50 preentrenado en ImageNet (procedente del zoológico oficial de modelos PyTorch) como codificador de backbone 30. Ajusta finamente todas las capas de codificadores durante el entrenamiento.
- Introduce la imagen de colonoscopia de entrada (redimensionada a 352 x 352 píxeles) a través de cinco etapas de bloques convolucionales residuales para extraer características jerárquicas. La resolución espacial de los mapas de características se reduce progresivamente de a lo largo de las cinco etapas, mientras que las dimensiones del canal aumentan correspondientemente (64 → 128 → 256 → 512 → 1024).
- En el cuello de botella (la capa de codificador más profunda), sustituye la capa convolucional estándar por el Módulo de Convolución Pinwheel (PCM, descrito en la Sección 3) para capturar la morfología geométrica global e información contextual multidireccional a baja resolución.
NOTA: Las cinco etapas del codificador corresponden a los grupos estándar de capas ResNet-50: conv1, capa 1, capa 2, capa 3 y capa 4. Los pesos preentrenados proporcionan una inicialización robusta de características de bajo y medio nivel, reduciendo el tiempo de convergencia en conjuntos de datos médicos pequeños.
- Componentes clave e interacción de características (Figura 2 y Figura 3)
- Aplicar el Mecanismo de Doble Atención (DAM, descrito en la Sección 4) a la salida de cada etapa del codificador antes de transmitirlo al decodificador mediante conexiones de salto. Este paso suprime de forma adaptativa el ruido de fondo generado por los pliegues intestinales y las reflexiones especulares, mientras potencia la respuesta de características en las regiones de pólipos. Solo las características filtradas se pasan a la capa decodificadora correspondiente.
- En el decodificador, se restaura progresivamente la resolución espacial mediante muestreo bilineal. En cada capa de decodificador, concatenar las características upmuestreadas de la etapa anterior con las características del codificador mejorado por DAM de la misma resolución espacial.
- Aplicar dos capas convolucionales consecutivas (cada una seguida de normalización por lotes y activación de ReLU) para fusionar la información multiescala. Esto constituye la estrategia de Fusión de Características Multiescala (MSF) descrita en la Sección 5.
NOTA: El decodificador avanza de capas profundas a superficiales (etapa 5 → etapa 1), asegurando que la información de localización semántica profunda y la información de detalle superficial del límite se integren eficazmente en cada nivel.
- Generación de Producción
- Aplicar una capa convolucional seguida de una función de activación sigmoidea a la salida final del decodificador para generar la máscara de predicción.
- Binariza la máscara de predicción usando un umbral de 0,5 para obtener el resultado final de segmentación, donde los píxeles con probabilidad predicha ≥ 0,5 se clasifican como pólipos y los demás píxeles como fondo.
3. Módulo de convolución del molinete (Figura 3)
- El Módulo de Convolución Pinwheel (PCM) reemplaza la convolución estándar de cuello de botella para capturar características geométricas multidireccionales de los pólipos. Implementa este módulo de la siguiente manera:
- Definamos un núcleo de convolución base W de tamaño 3 x 3 con Cen los canales de entrada y C en los canalesde salida .
- Definamos el conjunto de ángulos de rotación Θ = {0°, 45°, 90°, ..., 315°}. Para cada ángulo θ ∈ Θ, se genera el núcleo rotado Wθ aplicando una rotación basada en interpolación bilineal a W. Los ocho núcleos rotados comparten los mismos parámetros base; solo difiere la disposición espacial de los pesos.
- Para cada ángulo θ, calcular el mapa de características específicas de dirección:

donde X es el mapa de características de entrada. - Agrega los ocho mapas de características direccionales mediante concatenación canal a canal a lo largo del eje del canal, produciendo un tensor de dimensión (8 xC hacia fuera) x H x W. Luego aplica una convolución 1 x 1 para reducir la dimensión del canal de nuevo a Cout, seguida de la normalización por lotes y la activaciónReLU 31:

NOTA: La rotación y la interpolación se realizan sobre los pesos del núcleo, no sobre el mapa de características de entrada. Este diseño permite la extracción de características multidireccionales eficiente en parámetros sin aumentar la resolución de entrada. En la implementación actual, Cin = 1024 y Cout = 1024 en la etapa de cuello de botella, coincidiendo con la dimensión del canal de salida de la capa ResNet-50 4. Consulte el paquete de código suplementario para la implementación completa.
4. Mecanismo de doble atención (Figura 4)
NOTA: El Mecanismo de Doble Atención (DAM) está integrado en cada conexión de salto para suprimir el ruido de fondo y realzar las características de la región de pólipos tanto en el canal como en las dimensiones espaciales.
- Atención al canal
La rama de atención de canales identifica qué canales de características son más informativos. Dada una característica de entrada F ∈ RC×H×W:- Comprime las dimensiones espaciales mediante Global Average Pooling para obtener un descriptor de canal z ∈ RC×1×1.
- Pasa z a través de una MLP de dos capas (capas totalmente conectadas) con una relación de reducción r = 16. La primera capa reduce la dimensión de C a C/16 con activación de ReLU; la segunda capa lo restaura de C/16 a C con activación sigmoide para producir el vector de peso del canal Ac:
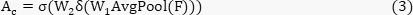
donde δ denota ReLU y σ denota Sigmoide.
- Atención espacial
La rama de atención espacial localiza dónde están las regiones objetivo:- Aplica tanto el agrupamiento máximo como el promedio a lo largo de la dimensión del canal para generar dos mapas de características 2D de tamaño 1 x H x W.
- Concatena los dos mapas a lo largo del eje del canal para formar un tensor de 2 x H x W. Aplicar una capa convolucional de 7 x 7 seguida de una activación sigmoide para producir el mapa de pesos espaciales As ∈ R1×H×W:
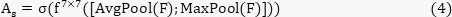
- Fusión de características
- Fusiona las salidas de canal y atención espacial con la característica de entrada mediante multiplicación elemento:

donde α y β son coeficientes de equilibrio aprendibles, ambos inicializados a 0,5 y actualizados conjuntamente con los parámetros de la red mediante optimización basada en gradientes durante el entrenamiento.
NOTA: Consulte el paquete de código suplementario (dam_module.py) para la implementación completa.
- Fusiona las salidas de canal y atención espacial con la característica de entrada mediante multiplicación elemento:
5. Fusión de características a escala múltiple
- Aplicar la estrategia de fusión de características multiescala (MSF) en el decodificador para abordar la pérdida de detalles espaciales en características profundas. En cada etapa del decodificador, realiza lo siguiente:
- Muestrea el mapa de características de la etapa decodificadora anterior por un factor de 2 usando interpolación bilineal.
- Concatena las características upmuestreadas con las características del codificador mejorado por DAM de la resolución espacial correspondiente a lo largo del eje del canal.
- Aplicar dos capas convolucionales consecutivas de 3 x 3 (cada una seguida de normalización por lotes y activaciónReLU 32) para fusionar las características concatenadas.
NOTA: Esta fusión entre niveles asegura que los detalles de los límites de los pólipos (proporcionados por las características superficiales del codificador) y la localización semántica (proporcionada por las características profundas) se preserven simultáneamente, generando resultados de segmentación de grano fino.
6. Función de pérdida y configuración de entrenamiento
- Función de pérdida
- Se adopta una función de pérdida híbrida L_total para optimizar conjuntamente la red, abordando el desequilibrio ubicuo entre primer plano y clase de fondo en la segmentación de pólipos.
La Pérdida de Entropía Cruzada Binaria (LBCE) mide la precisión de clasificación a nivel de píxel:
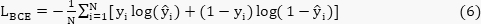
donde N es el número total de píxeles, yi ∈ {0,1} es la etiqueta de verdad fundamental, y ŷi ∈ [0,1] es la probabilidad predicha. - La pérdida de dados (LDice) cuantifica la similitud entre las regiones predichas y las regiones de verdad fundamental:


donde ε es un factor de suavizado (fijado a 1 x 10⁻5) para evitar la división por cero.
Fija λ = 0,5 para equilibrar las contribuciones de los dos términos de pérdida.
- Se adopta una función de pérdida híbrida L_total para optimizar conjuntamente la red, abordando el desequilibrio ubicuo entre primer plano y clase de fondo en la segmentación de pólipos.
- Configuración de entrenamiento
- Inicializa el codificador con pesos ResNet-50 preentrenados por ImageNet. Inicializar todas las capas de decodificador, PCM y parámetros DAM usando la inicialización uniforme de Kaiming.
- Configura el optimizador y el calendario de entrenamiento de la siguiente manera. Usa el optimizador de Adam con β₁ = 0,9 y β₂ = 0,999. Establece la tasa inicial de aprendizaje a 1 x 10⁻⁴. Aplica un programa de tasa de aprendizaje de recocido coseno conT máximo = 50 y ηmínimo = 1 x 10⁻⁶. Usa un lote de 16 y entrena el modelo para 50 épocas.
- Entrena el modelo durante 50 épocas en el conjunto de entrenamiento (800 imágenes). Al final de cada época, evalúa el modelo en el conjunto de validación (100 imágenes) usando el coeficiente de Dice como métrica principal de monitorización.
- Guarda el punto de control del modelo que alcanza el coeficiente de dados más alto en el conjunto de validación. Utiliza este punto de control como modelo final para todas las evaluaciones posteriores en el conjunto de pruebas.
NOTA: No se aplica explícitamente la detención anticipada. La estrategia de selección de puntos de control de los mejores dados de validación sirve como criterio de selección de modelo. Todos los experimentos se realizan utilizando el entorno de hardware y software especificado en la Tabla de Materiales. El entrenamiento para 50 épocas en 800 imágenes lleva aproximadamente 2 horas bajo la configuración descrita. Todos los resultados reportados se obtienen de una única partida de entrenamiento utilizando la semilla aleatoria especificada (semilla = 42). Consulte el paquete de código suplementario para el script completo de entrenamiento.
7. Pseudocódigo
- Utiliza el Algoritmo 1 como el mapa completo del flujo de trabajo para PWD Net. Compara los bloques PCM, DAM, arquitectura principal y pipeline de entrenamiento en el algoritmo con los archivos correspondientes en el paquete de código suplementario.
- Implementa el bloque PCM mostrado en las líneas 4 a 12. Definimos un núcleo de convolución base 3 x 3 y generamos ocho núcleos rotados a 0°, 45°, 90°, 135°, 180°, 225°, 270° y 315° usando interpolación bilineal.
- Mantén los mismos parámetros base aprendibles para todos los kernels PCM rotados. Para cada ángulo de rotación, calcular un mapa de características específico en la dirección.
- Concatena los ocho mapas de características PCM a lo largo de la dimensión del canal. Aplica una convolución 1 x 1, normalización por lotes y activación de ReLU para restaurar la dimensión original del canal.
- Implementa el bloque DAM mostrado en las líneas 14 a 19. Aplica Global Average Pooling para generar el descriptor de canal y luego pásalo a través de un MLP de dos capas con una relación de reducción de 16 para obtener los pesos del canal.
- Genera el mapa de atención espacial aplicando el pool promedio por canal y el pool máximo a la característica de entrada. Concatena ambos mapas y procesalos con una convolución de 7 x 7 seguida de una activación sigmoide.
- Fusiona el canal DAM y las salidas de atención espacial con la característica de entrada usando multiplicación elemento por elemento. Pondera los dos mapas de atención con coeficientes aprendibles α y β, ambos inicializados a 0,5.
- Construye la arquitectura principal de PWD Net mostrada en las líneas 21 a 32. Pasar la imagen de entrada por cinco etapas de un codificador ResNet 50 preentrenado para obtener de e1 a e5, con una resolución espacial que disminuye de H x W a H/32 x W/32.
- Aplica PCM a e5 en el cuello de botella. Aplica DAM a e1 a e4 antes de enviar estas características al decodificador a través de conexiones de salto.
- Descifra el mapa de características de capas profundas a superficiales. En cada nivel de decodificador, se utiliza un upsampling de la característica anterior, concatenala con la característica de codificador mejorado DAM correspondiente y se aplica DoubleConv para la fusión de características.
- Genera la salida de segmentación con una convolución 1 x 1 seguida de una activación sigmoide. Utiliza el mapa de probabilidad de píxel resultante como máscara predicha.
- Implementa el bucle de entrenamiento mostrado en las líneas 34 a 39. En cada época, ejecuta la propagación hacia adelante a través de PWD Net y calcula la máscara predicha.
- Calcula la pérdida de entrenamiento como 0,5 x pérdida BCE más 0,5 x pérdida de dados. Actualiza todos los parámetros aprendibles con el optimizador Adam mediante retropropagación.
Algoritmo 1: Segmentación de pólipos PWD-Net
1: Entrada: Imagen de colonoscopia I ∈R H×W×3
2: Salida: Máscara de segmentación M ∈ {0,1}(H×W)
3:
4: función Módulo de convolución PCM(X) ▷ Pinwheel
5: Definamos núcleo base W (3 x 3), ángulos Θ = {0°, 45°, ..., 315°}
6: para cada θ ∈ Θ do
7: Wθ ← BilinearRotate(W, θ) ▷ Rotate kernel
8: Yθ ← Conv2d(X,W θ) ▷ Características específicas de la dirección
9: fin para
10: Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ Aggregate
11: devuelve Yfuera
12: función final
13:
14: función DAM(F) ▷ Mecanismo de doble atención
15: Ac ← Sigmoide(MLP(AvgPool(F))) ▷ Atención de canal (r=16)
16: As ← Sigmoide(Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ Atención espacial
17: F' ← F ⊗ (α · Ac + β · As) ▷ Fusionar con α aprendible, β (init=0,5)
18: Regreso F'
19: función final
20:
21: función PWD-Net(I)
22: Codificador: e1,e 2,e 3,e 4,e 5 ← ResNet50_Stages(I) ▷ codificador preentrenado de 5 etapas
23: Cuello de botella: b ← PCM(e5) ▷ Aplicar PCM en cuello de botella
24: Saltar conexiones: si ← DAM(e i) para i = 1, 2, 3, 4 ▷ Características del codificador de filtro
25: Decodificador:
26: d 4 ← DoubleConv(Concat(Up(b),s 4))
27: d 3 ← DoubleConv(Concat(Up(d 4), s3))
28: d 2 ← DoubleConv(Concat(Up(d 3), s2))
29: d 1 ← DoubleConv(Concat(Up(d2), s1))
30: M ← Sigmoid (Conv1 x 1(d1))
31: regreso M
32: función final
33:
34: Entrenamiento:
35: para cada época haz
36: M̂ ← PWD-Net(I)
37: L ← 0,5 · A.C. (M̂,M gt) + 0,5 · Pérdida de dados (M̂,M gt) ▷ λ = 0,5
38: Actualizar parámetros mediante retropropagación (Adamoptimizar r)
39: fin para
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Montaje experimental
Conjunto de datos
El conjunto de datos Kvasir SEG se utilizó para evaluar el comportamiento de segmentación de PWD Net en imágenes de colonoscopia con apariencias heterogéneas de pólipos. El conjunto de datos contiene imágenes de pólipos anotadas de 1.000 píxeles e incluye variaciones en tamaño, forma, textura, iluminación y complejidad de fondo de pólipo, lo que lo hace adecuado para evaluar la detección de objetivos p...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Varias opciones de diseño en el protocolo PWD-Net son fundamentales para lograr resultados de segmentación fiables y merecen una atención cuidadosa durante la implementación. Primero, la selección e inicialización de la columna vertebral del codificador influye directamente en el comportamiento de convergencia y el rendimiento final. El protocolo emplea un codificador ResNet-50 preentrenado en ImageNet, que proporciona una inicialización robusta de características de bajo y nivel medio. ...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Este estudio fue financiado por el Programa Nacional de Investigación y Desarrollo de Claves de China (Números de Programa 2022YFC3500200 y 2022YFC3500204).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Adam Optimizer | — | — | Incluido en PyTorch |
| Albumentations | Albumentations Team | v1.0+ | Biblioteca de aumento de datos |
| CUDA Toolkit | NVIDIA | v11.3+ | Aceleración GPU |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Visualización de curvas de entrenamiento |
| NumPy | NumPy Community | v1.21+ | Cálculo numérico |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU para entrenamiento e inferencia |
| OpenCV | OpenCV Community | v4.5+ | Preprocesamiento de imágenes |
| Python | Python Software Foundation | v3.8+ | Lenguaje de programación |
| PyTorch | Meta Platforms | v1.12+ | Marco de aprendizaje profundo |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | Preentrenado ImageNet-1K |
| Ubuntu | Canonical | 18.04+ | Sistema operativo |