Aquí presentamos un protocolo para la conformación de cohortes, la armonización de laboratorio, el desarrollo de modelos penalizados, la validación y la construcción de una puntuación clínica para la estratificación temprana del riesgo de síndrome de disfunción orgánica múltiple en la pancreatitis aguda.
Artículo de investigación
Un protocolo reproducible de puntuación bioquímica-coagulatoria al ingreso para el síndrome de disfunción multiorgánica en la pancreatitis aguda
En este artículo
Resumen
Resumen
El reconocimiento temprano del síndrome de disfunción orgánica múltiple en la pancreatitis aguda sigue siendo difícil porque el deterioro orgánico puede ocurrir antes de que se completen las evaluaciones convencionales de gravedad. Este artículo describe un protocolo reproducible para desarrollar, validar y aplicar una puntuación compuesta de bioquímica y coagulación al ingreso, basada en pruebas de laboratorio de rutina obtenidas dentro de las 24 horas posteriores al ingreso hospitalario. Se seleccionó el síndrome de disfunción orgánica múltiple como resultado principal porque refleja una disfunción clínicamente significativa en más de un sistema orgánico e informa directamente sobre la intensidad del monitoreo temprano, la planificación de escalación y la asignación de recursos de cuidados críticos. El protocolo abarca la conformación de una cohorte multicéntrica, la selección de elegibilidad, la adjudicación de resultados, la armonización de unidades de laboratorio, el procesamiento de datos faltantes, la normalización de predictores, el desarrollo de modelos de regresión penalizada, la validación con conjunto reservado, la construcción de la puntuación, la comparación con puntuaciones de gravedad establecidas y análisis de sensibilidad. Las variables de laboratorio continuas se mantienen durante el desarrollo del modelo para reducir la pérdida de información, mientras que las categorías clínicamente interpretables se utilizan únicamente al traducir el modelo final en una puntuación práctica al pie del lecho. Los puntos de control del procedimiento incluyen la confirmación de la conformación de la cohorte, los umbrales de datos faltantes, las reglas fijas de preprocesamiento, los resultados de selección del modelo, los resultados de validación y la interpretación final de la puntuación. Mediante este flujo de trabajo, se pueden integrar marcadores bioquímicos y de coagulación medidos habitualmente en una herramienta estructurada de estratificación de riesgo al ingreso para el síndrome de disfunción orgánica múltiple asociado a la pancreatitis aguda. La puntuación tiene como finalidad apoyar una observación más estrecha, evaluaciones repetidas de laboratorio y la preparación para vías de soporte orgánico, pero debe complementar, y no sustituir, el juicio clínico ni los marcos de gravedad establecidos.
Introducción
La pancreatitis aguda es una emergencia digestiva común cuyo curso clínico varía desde una inflamación leve y autolimitada hasta una enfermedad rápidamente progresiva complicada por disfunción orgánica. La evaluación actual de la gravedad generalmente se guía por la clasificación revisada de Atlanta, que define la severidad de la enfermedad según complicaciones locales, complicaciones sistémicas y la presencia y duración de fallo orgánico1. También se utilizan sistemas de puntuación clínicos durante las primeras fases de la hospitalización para apoyar la evaluación del riesgo y las decisiones de escalación. El Índice Clínico para la Severidad en la Pancreatitis Aguda utiliza cinco variables disponibles dentro de las primeras 24 h y fue desarrollado para estimar el riesgo de mortalidad intrahospitalaria2. Las guías clínicas recientes continúan enfatizando el reconocimiento temprano de la enfermedad grave, la reevaluación repetida, la resucitación adecuada con líquidos, la planificación del soporte orgánico y la escalación oportuna de la atención3.
La evaluación temprana del riesgo sigue siendo difícil en la práctica habitual. La respuesta inflamatoria en la pancreatitis aguda cambia rápidamente, y algunos sistemas tradicionales de puntuación requieren mediciones repetidas, variables fisiológicas que evolucionan tras el ingreso o hallazgos por imágenes que pueden no estar disponibles en la primera consulta clínica4. Como resultado, la clasificación del riesgo puede variar según el momento del muestreo, el flujo de trabajo local y la vía de tratamiento. Estas incertidumbres pueden llevar a un monitoreo intensivo o intervenciones innecesarias en pacientes de bajo riesgo, mientras que los pacientes que empeoran rápidamente pueden experimentar retrasos en la escalada del tratamiento. Una revisión reciente sobre la predicción de la gravedad en la pancreatitis aguda señaló que el desempeño de las puntuaciones clínicas y de los biomarcadores individuales varía entre poblaciones de pacientes, distribuciones de gravedad de la enfermedad y ventanas de evaluación5.
La mayoría de los estudios recientes de predicción han intentado utilizar variables recopiladas dentro de las 24 horas posteriores al ingreso, a menudo con falla orgánica persistente o pancreatitis aguda grave como resultado objetivo. Este enfoque es clínicamente útil, pero muchos modelos publicados siguen limitados por un diseño monocéntrico, una validación incompleta y una descripción insuficiente de los métodos de preprocesamiento y de manejo de datos faltantes6. La presentación transparente es particularmente importante para los modelos de predicción porque los criterios de elegibilidad, las definiciones de los predictores, el tamaño de la muestra, el manejo de datos faltantes, las decisiones en la construcción del modelo y los procedimientos de validación afectan directamente la reproducibilidad y la interpretación clínica7. Para que un método basado en el ingreso sea utilizable en diferentes instituciones, debe basarse en pruebas de uso rutinario, definir procedimientos de conversión de unidades, explicar cómo se armonizan los valores de laboratorio y especificar cómo se manejan los valores predictores incompletos antes del ajuste del modelo.
Las alteraciones bioquímicas y de la coagulación son relevantes para el deterioro temprano en la pancreatitis aguda. La activación inflamatoria, la lesión endotelial, la hemoconcentración, la hipoperfusión renal y la alteración de la microcirculación pueden ocurrir precozmente y contribuir a la disfunción orgánica. La activación de la coagulación está estrechamente relacionada con la inflamación, y se ha descrito la coagulopatía asociada a la pancreatitis aguda como parte de la progresión hacia fallo orgánico persistente y resultados adversos8. También se ha informado que el dímero D es un marcador al ingreso asociado con fallo orgánico, complicaciones locales, ingreso en cuidados intensivos y mortalidad en la pancreatitis aguda9. Sin embargo, los indicadores de coagulación a menudo se interpretan por separado, en lugar de combinarse con variables bioquímicas de rutina en un flujo de trabajo estructurado al ingreso.
El síndrome de disfunción orgánica múltiple se seleccionó como el punto final primario en este protocolo porque representa una disfunción clínicamente significativa en más de un sistema orgánico. La falla orgánica persistente sigue siendo fundamental para la clasificación de la gravedad de la pancreatitis aguda, pero el síndrome de disfunción orgánica múltiple se acerca más a la pregunta práctica de admisión: si es probable que un paciente requiera vigilancia más estrecha, reevaluación repetida de laboratorio, preparación para soporte orgánico o recursos de cuidados intensivos. Este punto final también permite evaluar las señales bioquímicas y de coagulación en relación con un patrón más amplio de deterioro sistémico, en lugar de un resultado basado en un solo órgano.
El artículo de este método describe un protocolo reproducible de puntuación bioquímica-coagulación para la estratificación temprana del riesgo de síndrome de disfunción de múltiples órganos en la pancreatitis aguda. El protocolo utiliza variables de laboratorio de rutina obtenidas dentro de las 24 horas posteriores al ingreso, estandariza la armonización de unidades y el manejo de datos faltantes, aplica un desarrollo de modelo penalizado y traduce el modelo final en una puntuación compuesta clínicamente interpretable. El objetivo no es reemplazar el juicio clínico ni los marcos de gravedad establecidos, sino proporcionar un flujo de trabajo transparente y replicable que ayude a las instituciones a organizar los datos de laboratorio al ingreso en información de riesgo utilizable.
Protocolo
El protocolo del estudio fue aprobado por el Comité de Ética para la Investigación Biomédica que Involucra a Seres Humanos del Primer Hospital Popular de Jiashan, Hospital Afiliado a la Universidad de Jiaxing (número de aprobación: 2026 Research Approval No. 005; número de aceptación: LW2026004; fecha de aprobación: 13 de enero de 2026). Se dispensó el requisito de consentimiento informado individual porque este estudio retrospectivo utilizó datos clínicos con identificación eliminada. Antes del análisis, se eliminaron los identificadores directos, incluyendo nombre, número de identificación hospitalario, número de teléfono, dirección y número de identificación nacional. El manejo de los datos siguió los requisitos institucionales de protección de datos y la Declaración de Helsinki10.
Diseño del estudio y ensamblaje de la cohorte multicéntrica
Este estudio de cohorte retrospectivo multicéntrico utilizó datos bioquímicos y de coagulación al ingreso para construir un flujo de trabajo de puntuación reproducible para la estratificación temprana del riesgo de síndrome de disfunción orgánica múltiple (MODS) en pancreatitis aguda (AP). La AP se definió por al menos dos de los siguientes criterios: dolor abdominal típico, amilasa o lipasa sérica al menos tres veces por encima del límite superior normal, o hallazgos de imagen compatibles con AP. La ventana basal se definió como las primeras 24 horas tras el ingreso hospitalario. Para cada predictor de laboratorio, se utilizó el valor elegible más temprano dentro de esta ventana. No se utilizaron valores obtenidos tras el primer registro del inicio de MODS para la construcción de los predictores.
Se revisaron hospitalizaciones consecutivas por PA procedentes de los centros participantes desde el 1 de enero de 2023 hasta el 20 de diciembre de 2025, utilizando un registro unificado de cribado, una lista de elegibilidad, un diccionario de datos y un formulario de adjudicación de eventos finales. El registro de cribado registró el número total de ingresos revisados, ingresos duplicados, exclusiones por PA no confirmada, edad menor de 18 años, pancreatitis crónica, pancreatitis asociada a malignidad pancreática, hora de ingreso no fiable, datos de laboratorio a las 24 h no disponibles y registros de eventos finales incompletos, así como la cohorte analítica final. El registro de cribado bloqueado se utilizó para generar Figura 1. Los conteos de pacientes en la Figura 1 se verificaron frente al conjunto de datos analítico final antes del análisis.
Después de bloquear la cohorte analítica, los pacientes se asignaron a una cohorte de desarrollo y a una cohorte de validación reservada en una proporción de 7:3. La división se realizó en R versión 4.3.2 utilizando el paquete caret versión 6.0-94, con la semilla aleatoria fijada en 20260420. Se realizó un muestreo estratificado según el estado de MODS y el centro. Si la distribución por centro difería en más de 5 puntos porcentuales entre cohortes, se utilizaron estratos combinados de centro y MODS. La asignación de cohortes se guardó antes del ajuste del modelo y no se modificó posteriormente. Las reglas de preprocesamiento, configuraciones de imputación, ajuste del modelo, estimación de coeficientes, construcción del puntaje y selección del punto de corte se derivaron exclusivamente a partir de la cohorte de desarrollo. La cohorte de validación reservada se utilizó únicamente para la evaluación del modelo bloqueado.
Criterios de elegibilidad y procedimientos de inscripción
Los pacientes elegibles eran adultos de 18 años o más con diagnóstico confirmado de PA, tiempo de ingreso hospitalario rastreable, al menos un panel de laboratorio bioquímico o de coagulación dentro de las 24 horas posteriores al ingreso y registros hospitalarios completos para la adjudicación de los desenlaces. Se excluyeron a los pacientes si no se podía confirmar la PA, si presentaban pancreatitis por pancreatitis crónica o malignidad pancreática asociada, o si no se podía reconstruir de forma confiable el momento del primer ingreso hospitalario. Se excluyeron los casos de traslado cuando el momento del primer ingreso, el momento de la primera toma de laboratorio o el estado de disfunción orgánica temprana no eran rastreables entre instituciones. Para ingresos repetidos del mismo paciente durante el período del estudio, solo se conservó la primera hospitalización elegible. Para cada caso excluido se registró una causa principal de exclusión.
Resultados y adjudicación de los puntos finales
El resultado principal fue la SDOM durante la hospitalización, definida como disfunción de dos o más sistemas orgánicos durante la estancia hospitalaria. La disfunción orgánica se evaluó a partir de los registros respiratorios, cardiovasculares, renales, hepáticos, de coagulación y neurológicos en la historia clínica electrónica. Se aplicaron los mismos criterios preespecificados por sistema orgánico en todos los centros antes del desarrollo del modelo, y los criterios operativos utilizados para la adjudicación de los puntos finales se resumen en la Tabla Suplementaria 1.
Dos revisores capacitados evaluaron independientemente cada registro desidentificado utilizando notas de ingreso, notas de evolución, registros de unidad de cuidados intensivos, registros de procedimientos, informes de laboratorio, registros de signos vitales y resúmenes de alta. El formulario de adjudicación registró el código de estudio del paciente, el sistema orgánico afectado, el registro fuente, la fecha y hora de inicio, el valor de laboratorio o fisiológico de apoyo, la decisión del revisor y el estado final de adjudicación. Se aceptó como definitivo el acuerdo entre los revisores. Las discrepancias se resolvieron mediante un tercer revisor senior. Los resultados secundarios incluyeron ingreso a la unidad de cuidados intensivos, ventilación mecánica invasiva o no invasiva, terapia de reemplazo renal, mortalidad intrahospitalaria, necrosis infectada o procedimiento de drenaje y duración de la estancia hospitalaria. La duración de la estancia se calculó como la fecha de alta menos la fecha de ingreso más 1 día.
Predictores candidatos al momento del ingreso
Los predictores candidatos se limitaron a variables de rutina disponibles dentro de las 24 horas posteriores al ingreso. Para las pruebas repetidas dentro del período de 24 horas, se conservó el valor elegible más temprano. Las variables bioquímicas incluyeron recuento de glóbulos blancos, proteína C reactiva, procalcitonina cuando estuvo disponible, lactato, glucosa, calcio total, nitrógeno ureico en sangre, creatinina, alanina aminotransferasa, bilirrubina total, albúmina y deshidrogenasa láctica. Las variables de coagulación incluyeron recuento de plaquetas, tiempo de protrombina, relación normalizada internacional del tiempo de protrombina, tiempo de tromboplastina parcial activada, fibrinógeno y D-dímero.
Se recopilaron variables clínicas basales para la descripción del perfil de pacientes y el cálculo del puntaje de referencia. Estas variables incluyeron edad, sexo, índice de masa corporal, tiempo transcurrido desde el inicio de los síntomas hasta la admisión, etiología de la pancreatitis aguda, estado de tabaquismo, antecedentes de pancreatitis previa, comorbilidades, frecuencia cardíaca al ingreso, presión arterial media, estado de síndrome de respuesta inflamatoria sistémica, puntaje del Índice al Lado de la Cama para la Gravedad en la Pancreatitis Aguda, puntaje de Evaluación de la Fisiología Aguda y la Salud Crónica II y puntaje de Evaluación Secuencial de Insuficiencia Orgánica. Cuando tanto el tiempo de protrombina como el tiempo de protrombina con razón normalizada internacional estaban disponibles, se utilizó el tiempo de protrombina con razón normalizada internacional para la modelización, y se conservó el tiempo de protrombina para los informes descriptivos. El archivo de extracción contenía una fila por cada hospitalización y conservaba el código del centro, el código del paciente en el estudio, la hora de admisión, la hora de muestreo, el valor crudo, la unidad cruda, el valor armonizado, la unidad armonizada, la tabla de origen y el indicador de datos faltantes.
Armonización de laboratorios entre centros
Todas las variables de laboratorio se convirtieron a unidades objetivo preespecificadas antes del análisis: recuento de glóbulos blancos y recuento de plaquetas, 109/L; proteína C reactiva, mg/L; procalcitonina, ng/mL; lactato, glucosa, calcio total y nitrógeno ureico en sangre, mmol/L; creatinina y bilirrubina total, µmol/L; alanina aminotransferasa y deshidrogenasa láctica, U/L; albúmina y fibrinógeno, g/L; tiempo de protrombina y tiempo de tromboplastina parcial activada, segundos; relación internacional normalizada del tiempo de protrombina, relación adimensional; y D-dímero, mg/L de unidades equivalentes a fibrinógeno. Los valores de D-dímero reportados como µg/mL de unidades equivalentes a fibrinógeno se convirtieron a mg/L de unidades equivalentes a fibrinógeno mediante una conversión numérica 1:1. Los valores de D-dímero reportados como unidades de D-dímero se convirtieron únicamente cuando el laboratorio local proporcionó un factor de conversión validado. Los valores sin un factor de conversión validado se consideraron faltantes en el modelado.
Se revisaron las unidades de reporte, rangos de referencia, registros de ensayos y notas del analizador de cada centro antes de agruparlos. El archivo de armonización conservó la unidad original, la unidad objetivo, la regla de conversión y el revisor responsable de verificar la conversión. Los valores de laboratorio no se normalizaron según los rangos de referencia específicos de cada centro en el análisis principal, ya que la puntuación tenía la intención de utilizar valores clínicos absolutos. El código del centro se mantuvo durante la imputación y el análisis de sensibilidad. Se marcaron los valores negativos para pruebas que no pueden ser negativas, unidades incompatibles, marcas de tiempo fuera de la ventana de 24 horas y valores no respaldados por los registros originales. Solo se corrigió un valor cuando el registro fuente confirmó un error de transcripción o de conversión de unidades; de lo contrario, se estableció como faltante.
Preprocesamiento de datos y manejo de datos faltantes
La ausencia de datos se resumió por variable, centro y estado de MODS antes del ajuste del modelo. Los predictores candidatos se excluyeron del desarrollo del modelo si la ausencia general superaba el 30 % o si la ausencia superaba el 50 % en algún centro individual. Los pacientes se excluyeron del conjunto de datos de modelado si faltaba más del 40 % de los predictores candidatos o si no se podía determinar el resultado principal.
Los predictores continuos se ajustaron mediante winsorización en los percentiles 1.º y 99.º estimados en la cohorte de desarrollo. Los mismos umbrales se aplicaron a la cohorte de validación reservada. No se volvieron a estimar los umbrales en los datos de validación. Las variables con asimetría mayor a 2 tras la winsorización se transformaron utilizando el logaritmo natural; se usó log(x + 0,01) para variables que podían contener cero. Los predictores continuos se estandarizaron utilizando la media y la desviación estándar de la cohorte de desarrollo, y los mismos parámetros se aplicaron a los datos de validación.
Se realizó imputación múltiple utilizando ecuaciones encadenadas en R con el paquete mice versión 3.16.0. Se generaron veinte conjuntos de datos imputados con 20 iteraciones por conjunto de datos. Se utilizó el emparejamiento predictivo de medias para variables continuas, regresión logística para variables binarias y regresión logística politómica para variables categóricas nominales. El modelo de imputación incluyó predictores candidatos, código del centro, indicador de cohorte y estado de MODS para el desarrollo del modelo. Los resultados de validación no se utilizaron para modificar las reglas de preprocesamiento, la elegibilidad de variables ni los umbrales. Las estimaciones de regresión se combinaron utilizando las reglas de Rubin cuando se informaron. Las métricas de predicción se calcularon dentro de cada conjunto de datos imputados y se resumieron como estimaciones combinadas o medianas con rangos. Se prespecificaron dos análisis de sensibilidad: análisis de casos completos utilizando pacientes sin predictores del modelo final faltantes y análisis del valor basal utilizando el peor valor de laboratorio elegible dentro de las 24 horas en lugar del valor más temprano.
Análisis estadístico y desarrollo del modelo
Las características basales se resumieron por separado en las cohortes de desarrollo y de validación de retención. Las variables continuas se presentaron como media ± desviación estándar o mediana con rango intercuartílico, y las variables categóricas como n (%). Las variables bioquímicas y de coagulación al ingreso se compararon entre pacientes con y sin SDOM. Se utilizó la prueba t de Student o la prueba de suma de rangos de Wilcoxon para variables continuas, y la prueba de chi-cuadrado o la prueba exacta de Fisher para variables categóricas. Estos valores P fueron descriptivos y no se utilizaron por sí solos para la selección de predictores.
El desarrollo del modelo se limitó a la cohorte de desarrollo. Se utilizó la regresión logística penalizada como modelo principal para reducir el sobreajuste ante recuentos limitados de eventos y predictores de laboratorio correlacionados. El modelo se ajustó en R versión 4.3.2 utilizando el paquete glmnet versión 4.1-8 con familia binomial, predictores estandarizados y penalización mediante el operador de contracción absoluta mínima y selección (LASSO), especificada mediante alpha = 1. Para el ajuste de la penalización se empleó una validación cruzada de diez pliegues repetida 10 veces, con la semilla aleatoria fijada en 20260420. El parámetro de penalización se seleccionó utilizando la regla de un error estándar. Se guardaron la trayectoria de los coeficientes, los valores del error de validación cruzada, el parámetro de penalización seleccionado y los predictores retenidos. El flujo de trabajo del análisis se muestra en Figura 2. El software, los paquetes estadísticos, los sistemas de bases de datos y las plataformas de laboratorio utilizados en el protocolo se enumeran en la Tabla de Materiales.
No se utilizó la regresión logística sin penalización como modelo inferencial principal tras la selección con penalización. Si se informaron razones de momios para la interpretación clínica, se etiquetaron como estimaciones descriptivas posteriores a la selección. La discriminación se estimó mediante el área bajo la curva de característica operativa del receptor, con intervalos de confianza del 95 % calculados utilizando el método de DeLong en el paquete pROC versión 1.18.5. La calibración se evaluó mediante el intercepto de calibración, la pendiente de calibración, la puntuación de Brier y gráficos de calibración. Se empleó remuestreo bootstrap con 1 000 repeticiones en la cohorte de desarrollo para estimar el rendimiento corregido por optimismo. El análisis de curva de decisión no se mantuvo en el conjunto de análisis revisado; por lo tanto, las afirmaciones sobre beneficio clínico neto se eliminaron del manuscrito.
Derivación e interpretación del puntaje
El puntaje compuesto bioquímico-coagulación basado en puntos de admisión se derivó de los coeficientes del modelo penalizado bloqueado. Las variables continuas se utilizaron durante el ajuste del modelo. Las categorías con umbrales se introdujeron únicamente después de la finalización del modelo para facilitar el cálculo al pie del lecho. Los umbrales se seleccionaron según rangos de referencia clínicos establecidos, umbrales comúnmente utilizados para anormalidades de laboratorio o puntos de corte basados en coeficientes definidos en la cohorte de desarrollo antes de la validación. Los umbrales no se optimizaron en la cohorte de validación.
Se asignaron puntos enteros según la dirección y la magnitud relativa de los coeficientes fijos. Puntos más altos indicaban perfiles de laboratorio más adversos. La puntuación total se calculó sumando los puntos de los componentes retenidos. Las categorías de riesgo preespecificadas se utilizaron únicamente para la estratificación del riesgo; no se utilizaron para definir el SDMO. La puntuación tenía como objetivo identificar a los pacientes que podrían necesitar una observación más estrecha, evaluaciones de laboratorio repetidas o preparación para vías de soporte orgánico. No se utilizó como una regla diagnóstica independiente, un desencadenante de anticoagulación ni como sustituto de la reevaluación clínica.
Validación con conjunto de retención y evaluación comparativa
Se aplicaron al conjunto de validación con retención las reglas fijas de preprocesamiento, la estructura de imputación, los umbrales de winsorización, los parámetros de estandarización, los coeficientes del modelo, las reglas de puntuación y los puntos de corte preespecificados. No se realizó ninguna selección adicional de predictores, reajuste del modelo, recalibración de coeficientes ni optimización de umbrales. El desempeño de validación se resumió mediante indicadores de discriminación, calibración, puntuación de Brier, sensibilidad, especificidad, valor predictivo positivo y valor predictivo negativo.
Se calcularon herramientas de gravedad establecidas a partir de la misma ventana de ingreso cuando los datos estaban disponibles, incluyendo el Índice de Gravedad en Pancreatitis Aguda en la Cama, la puntuación de Evaluación de la Fisiología Aguda y la Salud Crónica II, la puntuación de Evaluación Secuencial de Insuficiencia Orgánica, la puntuación de Ranson, la Puntuación de Pancreatitis Aguda Inofensiva y los criterios del síndrome de respuesta inflamatoria sistémica. Las comparaciones utilizaron el mismo punto final, población de análisis y marco de validación. Se realizaron comparaciones pareadas del área bajo la curva utilizando las pruebas de DeLong.
Todos los gráficos de validación y los gráficos estratificados por puntuación se generaron a partir del conjunto de datos analíticos bloqueado. El tamaño de la muestra en cada panel de la figura se verificó en comparación con la cohorte analítica final, la cohorte de desarrollo, la cohorte de validación independiente o el estrato de puntuación preespecificado antes de la elaboración de las figuras. No se utilizaron métodos visuales diseñados para datos ómicos de alta dimensión, datos de conteo ecológicos o análisis de abundancia diferencial para datos de laboratorio clínico de rutina.
Resultados
Características de la cohorte y comparabilidad basal
Un total de 300 pacientes con pancreatitis aguda fueron incluidos en la cohorte analítica final. De acuerdo con la división estratificada prespecificada de 7:3 para validación independiente, 210 pacientes fueron asignados a la cohorte de desarrollo y 90 pacientes a la cohorte de validación independiente. Todos los pacientes incluidos tuvieron mediciones bioquímicas y de coagulación elegibles dentro de las 24 horas posteriores al ingreso hospitalario.
Las características basales se muestran en la Tabla 1. Los grupos de desarrollo y validación de reserva fueron similares en edad (54,0 años ± 16,4 años frente a 55,3 años ± 15,2 años, P = 0,486), distribución por sexo (hombres: 61,9 % frente a 61,1 %, P = 0,898), índice de masa corporal (25,0 [22,6–27,9] kg/m2 frente a 24,7 [22,2–27,5] kg/m2, P = 0,293), tiempo desde el inicio de los síntomas hasta la admisión (13,2 [7,1–22,6] h frente a 12,8 [6,8–21,7] h, P = 0,612) y etiología de la pancreatitis aguda (P = 0,931). Las comorbilidades, signos vitales al ingreso, estado de síndrome inflamatorio sistémico, puntuación del Índice al Pie de Cama para la Gravedad en la Pancreatitis Aguda, puntuación de Evaluación Secuencial de Insuficiencia Orgánica y las variables bioquímicas y de coagulación al ingreso enumeradas también estuvieron equilibradas entre ambos grupos. Estas comparaciones confirmaron que la división de reserva no introdujo un desequilibrio basal clínicamente significativo.
Perfiles bioquímicos y de coagulación al ingreso según el estado de SDOM
Entre los 300 pacientes, 50 desarrollaron síndrome de disfunción orgánica múltiple (SDOM) durante la hospitalización y 250 no lo desarrollaron. Los perfiles bioquímicos y de coagulación al ingreso según el estado de SDOM se resumen en la Tabla 2. En comparación con los pacientes sin SDOM, los pacientes que desarrollaron SDOM presentaron recuentos más altos de glóbulos blancos (14,4 × 10⁹/L ± 5,2 × 10⁹/L frente a 12,3 × 10⁹/L ± 4,6 × 10⁹/L, P = 0,008), una mayor relación neutrófilos-linfocitos (13,4 [9,1–21,3] frente a 9,0 [5,9–14,2], P < 0,001), proteína C reactiva (138,6 [86,9–226,7] mg/L frente a 61,4 [29,2–123,8] mg/L, P < 0,001), procalcitonina (1,25 [0,56–3,28] ng/mL frente a 0,43 [0,18–1,02] ng/mL, P < 0,001), lactato (2,7 [2,0–4,0] mmol/L frente a 1,7 [1,2–2,4] mmol/L, P = 0,004) y glucosa (11,2 [8,9–15,1] mmol/L frente a 8,9 [7,3–11,4] mmol/L, P = 0,010).
El grupo con SDOM también mostró niveles más bajos de calcio (1,96 mmol/L ± 0,21 mmol/L frente a 2,06 mmol/L ± 0,17 mmol/L, P = 0,013) y albúmina (32,5 g/L ± 5,6 g/L frente a 35,9 g/L ± 4,8 g/L, P < 0,001), junto con niveles más altos de nitrógeno ureico en sangre (9,4 [7,4–13,2] mmol/L frente a 6,6 [5,1–8,9] mmol/L, P < 0,001), creatinina (108,9 [84,7–163,4] µmol/L frente a 77,1 [62,4–97,6] µmol/L, P < 0,001), bilirrubina total (22,1 [14,2–38,9] µmol/L frente a 18,6 [12,3–31,7] µmol/L, P = 0,038) y deshidrogenasa láctica (372,4 [289,8–512,3] U/L frente a 254,6 [203,2–329,1] U/L, P < 0,001). El tiempo de protrombina, la relación internacional normalizada del tiempo de protrombina, el tiempo de tromboplastina parcial activada y el dímero D también fueron más altos en el grupo con SDOM. El recuento de plaquetas (P = 0,096) y el fibrinógeno (P = 0,268) no presentaron diferencias significativas entre los grupos. Estas comparaciones fueron descriptivas y no se utilizaron por sí solas para la selección de predictores.
Patrones tempranos de resultados y tendencias relacionadas con la puntuación
Los resultados clínicos brutos según el estado del síndrome de disfunción orgánica múltiple se presentan en la Figura 3. Los pacientes que desarrollaron el síndrome de disfunción orgánica múltiple tuvieron una estancia hospitalaria más prolongada que aquellos que no lo desarrollaron (Figura 3A). Asimismo, presentaron tasas más altas de ingreso a la unidad de cuidados intensivos (Figura 3B), ventilación mecánica (Figura 3C), terapia de reemplazo renal (Figura 3D), procedimientos por necrosis infectada o drenaje (Figura 3E) y mortalidad intrahospitalaria (Figura 3F). Todos los paneles se generaron a partir de la cohorte analítica bloqueada de 300 pacientes.
Los resultados clínicos observados en las estratificaciones previamente especificadas según el puntaje compuesto basado en puntos se presentan en la Figura 4. La incidencia del síndrome de disfunción orgánica múltiple aumentó progresivamente en los grupos de riesgo bajo, intermedio, alto y muy alto (Figura 4A). Aumentos ordenados similares se observaron en las admisiones a la unidad de cuidados intensivos (Figura 4B), la mortalidad intrahospitalaria (Figura 4C) y los procedimientos por necrosis infectada o drenaje (Figura 4D). La duración de la estancia hospitalaria también aumentó a través de las cuatro estratificaciones del puntaje (Figura 4E). Los gradientes fueron más pronunciados para la incidencia del síndrome de disfunción orgánica múltiple y las admisiones a la unidad de cuidados intensivos. Todos los gráficos se generaron a partir del conjunto de datos analíticos bloqueado, utilizando las categorías de puntaje previamente especificadas.
La distribución del puntaje compuesto basado en puntos entre las categorías de gravedad de Atlanta revisadas se muestra en la Figura 5. Los puntajes compuestos medianos aumentaron progresivamente en las categorías de pancreatitis aguda leve, moderadamente grave y grave, lo que indica concordancia entre el puntaje bioquímico–de coagulación al ingreso y las categorías clínicas establecidas de gravedad. La Figura 5 se generó a partir del mismo cohort analítico bloqueado de 300 pacientes. No se utilizó ninguna visualización de ordenación, de abundancia diferencial, de gráfico volcán, de valor q, de distancia de Bray–Curtis ni de análisis de coordenadas principales.
Desarrollo del modelo penalizado y predictores conservados
El desarrollo del modelo penalizado se realizó exclusivamente en la cohorte de desarrollo. Las trayectorias de los coeficientes de los predictores candidatos al ingreso se muestran en la Figura 6A, y la curva de validación cruzada repetida de 10 pliegues utilizada para seleccionar el parámetro de penalización se muestra en la Figura 6B. Con el parámetro de penalización seleccionado mediante la regla de un error estándar, la penalización mediante el operador de contracción y selección por mínima suma absoluta conservó nueve predictores al ingreso: albúmina, nitrógeno ureico en sangre, creatinina, calcio, deshidrogenasa láctica, tiempo de protrombina–relación internacional normalizada, D-dímero, recuento de plaquetas y glucosa.
Los predictores conservados y las estimaciones descriptivas posteriores a la selección se muestran en la Tabla 3. Estas estimaciones se presentaron para facilitar la interpretación clínica y no se consideraron como inferencia confirmatoria tras la selección penalizada. La dirección de la asociación fue clínicamente coherente: menor albúmina, mayor nitrógeno ureico en sangre, mayor creatinina, menor calcio, mayor deshidrogenasa láctica, mayor tiempo de protrombina-ratio normalizado internacional, mayor D-dímero, recuento menor de plaquetas y mayor glucosa se asociaron con un riesgo aumentado de SDMO. Las estimaciones descriptivas posteriores a la selección fueron las siguientes: por cada disminución de 5 g/L en albúmina, razón de momios 1,29 (intervalo de confianza del 95 %: 1,13–1,47); por cada aumento de 1 mmol/L en nitrógeno ureico en sangre, razón de momios 1,12 (1,06–1,18); por cada aumento de 10 µmol/L en creatinina, razón de momios 1,05 (1,02–1,09); por cada disminución de 0,1 mmol/L en calcio, razón de momios 1,18 (1,07–1,30); por cada aumento de 100 U/L en deshidrogenasa láctica, razón de momios 1,21 (1,07–1,37); por cada aumento de 0,1 en tiempo de protrombina-ratio normalizado internacional, razón de momios 1,14 (1,05–1,25); por cada aumento de 1,0 mg/L en unidades de fibrinógeno equivalentes de D-dímero, razón de momios 1,09 (1,02–1,17); por cada disminución de 50 × 109/L en el recuento de plaquetas, razón de momios 1,16 (1,01–1,34); y por cada aumento de 1 mmol/L en glucosa, razón de momios 1,05 (1,00–1,10).
Construcción del puntaje compuesto basado en puntos
Las reglas utilizadas para construir el puntaje compuesto bioquímico–de coagulación de admisión basado en puntos se presentan en Tabla 4. El puntaje se derivó de los coeficientes del modelo penalizado bloqueado y se tradujo en categorías clínicamente interpretables para su cálculo al pie de la cama. Ocho variables—albúmina, nitrógeno ureico en sangre, creatinina, calcio, deshidrogenasa láctica, tiempo de protrombina, ratio normalizado internacional, D-dímero y recuento de plaquetas—se incluyeron como componentes principales del puntaje. Se mantuvo la glucosa como un modificador opcional porque su contribución fue menor que la de las variables bioquímicas y de coagulación principales, aunque su dirección de asociación con el síndrome de disfunción orgánica múltiple permaneció consistente con el modelo bloqueado.
Se presenta un nomograma que incorpora los nueve predictores conservados por el modelo penalizado bloqueado en la Figura 7. El nomograma proporciona una estimación individualizada de la probabilidad de síndrome de disfunción orgánica múltiple basada en los valores al ingreso de albúmina, nitrógeno ureico en sangre, creatinina, calcio, deshidrogenasa láctica, tiempo de protrombina-ratio normalizado internacional, D-dímero, recuento de plaquetas y glucosa. Se incluyó como ayuda interpretativa, mientras que la puntuación compuesta basada en puntos siguió siendo la herramienta práctica principal al pie de cama, ya que puede calcularse directamente a partir de las mediciones de laboratorio de rutina disponibles al ingreso.
Rendimiento del modelo y validación interna
El rendimiento del modelo en las cohortes de desarrollo y de validación independiente se muestra en la Tabla 5. El modelo logístico penalizado con un término de penalización alcanzó un área bajo la curva de característica de operación del receptor de 0.873 (intervalo de confianza del 95 %: 0.820–0.926) en la cohorte de desarrollo y de 0.836 (0.751–0.921) en la cohorte de validación independiente. La puntuación de Brier fue de 0.117 en la cohorte de desarrollo y de 0.139 en la cohorte de validación independiente. La intersección y la pendiente de calibración fueron 0.04 (−0.08–0.16) y 0.97 (0.79–1.18) en la cohorte de desarrollo, y 0.08 (−0.14–0.30) y 0.91 (0.68–1.15) en la cohorte de validación independiente.
En el umbral predeterminado de riesgo predicho de 0,18, el modelo mostró sensibilidad y especificidad de 0,82 y 0,77 en la cohorte de desarrollo y de 0,75 y 0,74 en la cohorte de validación reservada. Los valores predictivos positivo y negativo fueron de 0,39 y 0,96 en la cohorte de desarrollo y de 0,39 y 0,93 en la cohorte de validación reservada. La puntuación compuesta basada en puntos mostró una menor discriminación que el modelo penalizado fijo, pero conservó un rendimiento útil para cribado, con valores del área bajo la curva de característica de operación del receptor de 0,823 en la cohorte de desarrollo y 0,783 en la cohorte de validación reservada. En el umbral predeterminado de ≥8 puntos, la puntuación mostró valores predictivos negativos de 0,93 y 0,91 en las cohortes de desarrollo y de validación reservada, respectivamente.
Comparación con puntajes de gravedad establecidos
Las comparaciones de referencia frente a herramientas de gravedad establecidas se muestran en Tabla 6. El modelo bioquímico-coagulación al ingreso bloqueado tuvo una mayor discriminación que el puntaje de Ranson, el puntaje de Pancreatitis Aguda Inofensiva y los criterios del síndrome de respuesta inflamatoria sistémica en ambos cohortes. En el cohorte de desarrollo, el modelo no difirió significativamente del puntaje de Evaluación Secuencial de Insuficiencia Orgánica según la prueba de DeLong (P = 0.12), pero mostró una discriminación mayor que el puntaje de Evaluación de la Fisiología Aguda y la Salud Crónica II (P = 0.03), el puntaje del Índice en la Cama para la Gravedad en la Pancreatitis Aguda (P = 0.01), el puntaje de Ranson (P < 0.001), el puntaje de Pancreatitis Aguda Inofensiva (P < 0.001) y los criterios del síndrome de respuesta inflamatoria sistémica (P < 0.001). En el cohorte de validación independiente, las diferencias no fueron significativas frente al puntaje de Evaluación Secuencial de Insuficiencia Orgánica (P = 0.34), el puntaje de Evaluación de la Fisiología Aguda y la Salud Crónica II (P = 0.08) ni el puntaje del Índice en la Cama para la Gravedad en la Pancreatitis Aguda (P = 0.05), pero se mantuvieron significativas frente al puntaje de Ranson (P = 0.02), el puntaje de Pancreatitis Aguda Inofensiva (P = 0.01) y los criterios del síndrome de respuesta inflamatoria sistémica (P = 0.02).
Estratificación del riesgo mediante puntuación basada en puntos
Los resultados de la estratificación del riesgo se muestran en Tabla 7. Los pacientes se clasificaron en grupos de puntuación baja (0–4 puntos), intermedia (5–8 puntos), alta (9–12 puntos) y muy alta (≥13 puntos). La incidencia de SDOM aumentó desde el 3,5 % (4/115) en el grupo de bajo riesgo hasta el 8,9 % (9/101), 33,3 % (20/60) y 70,8 % (17/24) en los grupos de riesgo intermedio, alto y muy alto, respectivamente. La admisión en la unidad de cuidados intensivos aumentó del 8,7 % al 23,8 %, 60,0 % y 83,3 % a través de los cuatro grupos. La mortalidad hospitalaria aumentó del 0,9 % al 2,0 %, 10,0 % y 25,0 %, y la necrosis infectada o drenaje aumentó del 2,6 % al 8,9 %, 23,3 % y 33,3 %. La estancia media aumentó de 7,6 (5,2–10,4) días en el grupo de bajo riesgo a 11,4 (8,0–16,5), 18,6 (13,0–26,8) y 24,9 (17,5–37,2) días en los grupos de mayor riesgo.
Análisis de sensibilidad
Los análisis de sensibilidad se resumen en la Tabla Suplementaria 2. Estos análisis evaluaron si los hallazgos principales dependían del manejo de datos faltantes o de la asignación del valor basal. En el análisis de casos completos, los predictores conservados y la dirección de la asociación fueron consistentes con el análisis principal con datos imputados. La capacidad de discriminación cambió solo ligeramente, con áreas bajo las curvas de característica operativa del receptor de 0,861 en la cohorte de desarrollo y 0,821 en la cohorte de validación independiente. En el análisis de sensibilidad del valor basal que utilizó el peor valor de laboratorio elegible dentro de las primeras 24 horas en lugar del valor más temprano, el modelo mostró valores del área bajo la curva de característica operativa del receptor de 0,879 en la cohorte de desarrollo y 0,829 en la cohorte de validación independiente. La incidencia de MODS estratificada por puntuación permaneció ordenada a través de los grupos de riesgo bajo, intermedio, alto y muy alto en ambos análisis de sensibilidad. Estos resultados indican que el flujo de trabajo bioquímico-coagulativo al ingreso no se alteró sustancialmente por las alternativas preespecificadas de preprocesamiento.
DISPONIBILIDAD DE LOS DATOS:
El conjunto de datos anonimizado utilizado para reproducir los principales análisis, junto con el diccionario de datos, la tabla de conversión de unidades y los scripts de análisis, ha sido depositado en Figshare con el identificador único de datos https://doi.org/10.6084/m9.figshare.32565768.v1. Los identificadores directos de los pacientes fueron eliminados antes del depósito de los datos, y los identificadores de los centros fueron codificados de acuerdo con los requisitos institucionales de protección de datos. El repositorio contiene los archivos necesarios para reproducir la descripción de la cohorte, el preprocesamiento de los predictores, el desarrollo del modelo, la construcción de la puntuación, la validación con conjunto reservado, los análisis comparativos, los análisis de sensibilidad y las salidas por figuras reportadas en este manuscrito.
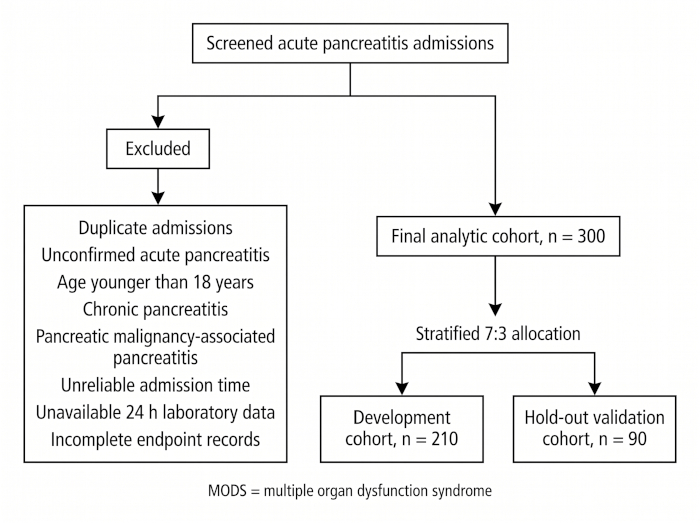
Figura 1: Cribado de pacientes y asignación de cohortes. El diagrama de flujo muestra los ingresos consecutivos por pancreatitis aguda que fueron evaluados en los centros participantes, las razones de exclusión, la cohorte analítica final y la asignación estratificada en proporción 7:3 en las cohortes de desarrollo y de validación independiente. La cohorte de desarrollo incluyó a 210 pacientes, y la cohorte de validación independiente incluyó a 90 pacientes. MODS indica síndrome de disfunción orgánica múltiple. Haga clic aquí para ver una versión más grande de esta figura.
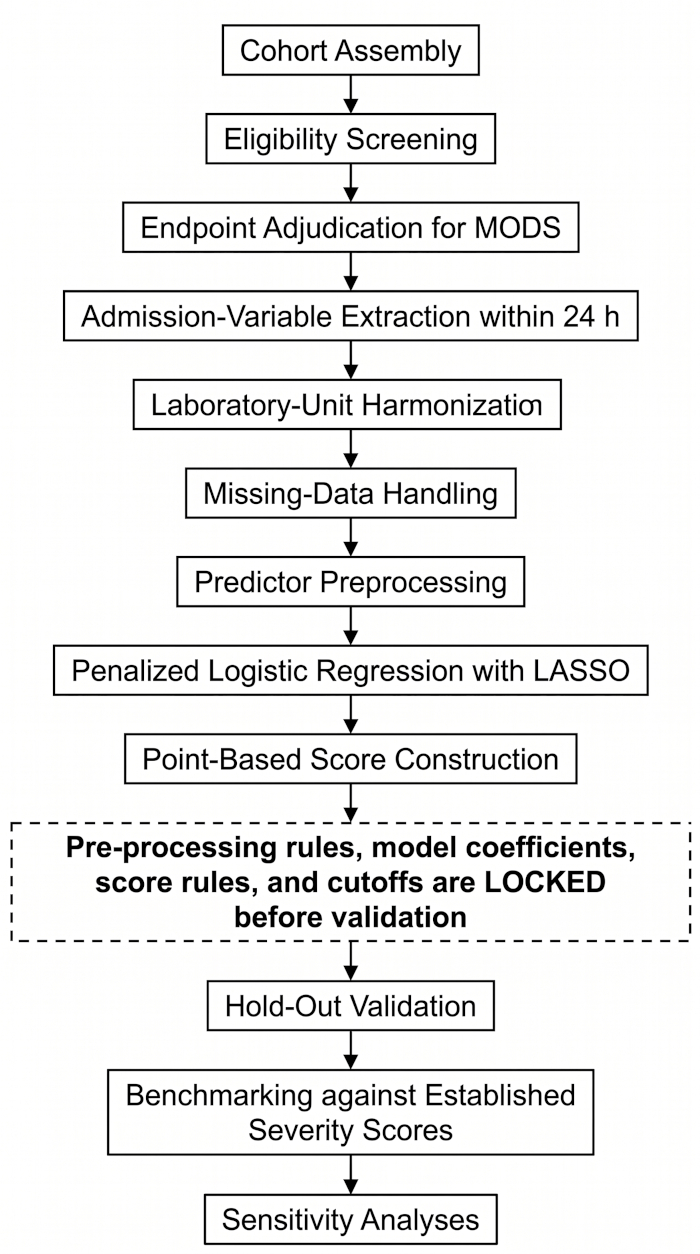
Figura 2: Flujo de trabajo analítico reproducible para el desarrollo de una puntuación bioquímica–de coagulación al ingreso. El esquema resume la conformación de la cohorte, la selección de elegibilidad, la adjudicación de los eventos finales, la extracción de variables al ingreso, la armonización de unidades de laboratorio, el manejo de datos faltantes, el preprocesamiento de predictores, el desarrollo del modelo penalizado, la construcción de una puntuación basada en puntos y la validación final con un conjunto de datos reservado. Todas las reglas de preprocesamiento, los coeficientes del modelo, los procedimientos de construcción de la puntuación y las definiciones de puntos de corte se establecieron en la cohorte de desarrollo antes de su evaluación en la cohorte de validación reservada. Haga clic aquí para ver una versión más grande de esta figura.
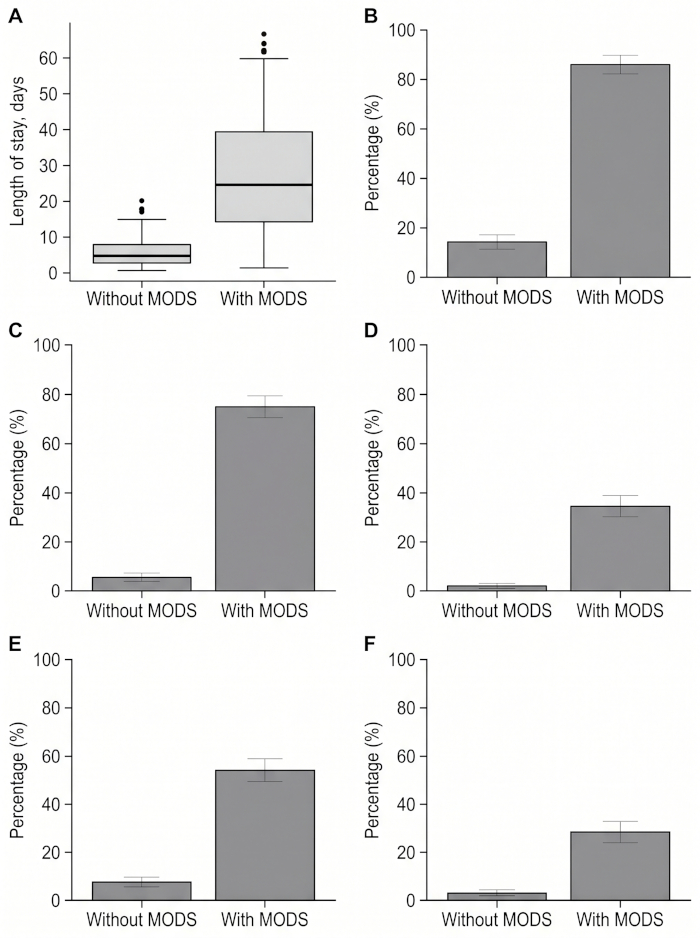
Figura 3: Resultados clínicos brutos según el estado del síndrome de disfunción orgánica múltiple. (A) Duración de la estancia hospitalaria en pacientes sin y con síndrome de disfunción orgánica múltiple. (B) Tasas de admisión en la unidad de cuidados intensivos según el estado del síndrome de disfunción orgánica múltiple. (C) Tasas de ventilación mecánica según el estado del síndrome de disfunción orgánica múltiple. (D) Tasas de terapia de reemplazo renal según el estado del síndrome de disfunción orgánica múltiple. (E) Tasas de necrosis infectada o procedimientos de drenaje según el estado del síndrome de disfunción orgánica múltiple. (F) Tasas de mortalidad intrahospitalaria según el estado del síndrome de disfunción orgánica múltiple. Todos los paneles se generaron a partir de la cohorte analítica bloqueada de 300 pacientes. MODS denota síndrome de disfunción orgánica múltiple; ICU, unidad de cuidados intensivos. Haga clic aquí para ver una versión más grande de esta figura.
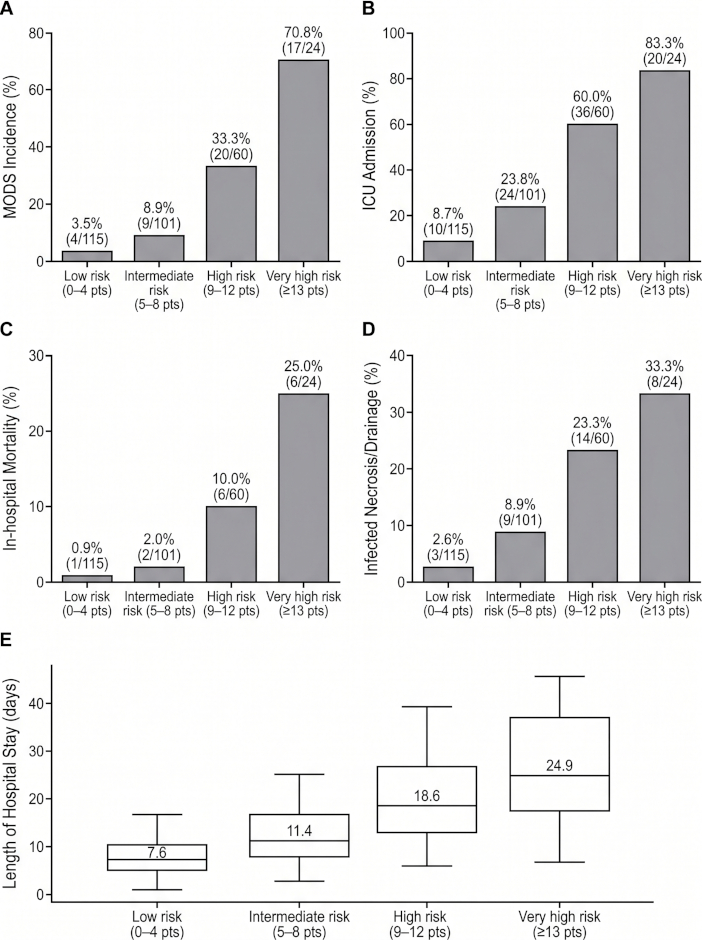
Figura 4: Tasas de resultados observados según los estratos del puntaje compuesto basado en puntos. (A) Incidencia del síndrome de disfunción orgánica múltiple en los grupos de bajo, intermedio, alto y muy alto riesgo. (B) Tasas de admisión a la unidad de cuidados intensivos en los cuatro estratos del puntaje. (C) Tasas de mortalidad intrahospitalaria en los cuatro estratos del puntaje. (D) Tasas de necrosis infectada o procedimientos de drenaje en los cuatro estratos del puntaje. (E) Duración de la estancia hospitalaria en los cuatro estratos del puntaje. Todos los paneles se generaron a partir del conjunto de datos analíticos bloqueado, utilizando las categorías preespecificadas del puntaje: bajo riesgo (0–4 puntos), riesgo intermedio (5–8 puntos), alto riesgo (9–12 puntos) y muy alto riesgo (≥13 puntos). MODS indica síndrome de disfunción orgánica múltiple; UCI, unidad de cuidados intensivos. Haga clic aquí para ver una versión más grande de esta figura.
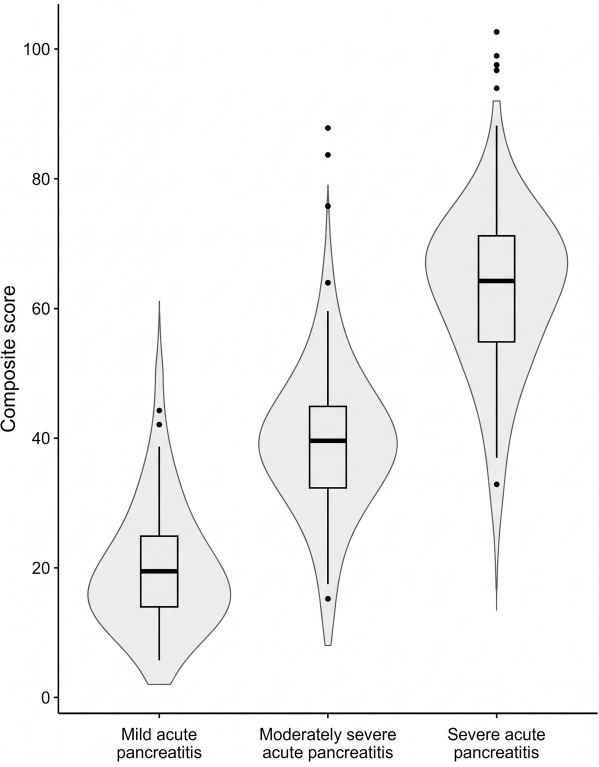
Figura 5: Distribución de la puntuación compuesta basada en puntos entre las categorías de gravedad según la clasificación de Atlanta revisada. Se muestra la distribución de las puntuaciones compuestas en pacientes con pancreatitis aguda leve, moderadamente grave y grave. Las puntuaciones compuestas aumentaron progresivamente a través de las tres categorías de gravedad, lo que indica concordancia entre la puntuación bioquímica–de coagulación al ingreso y la clasificación de gravedad de Atlanta revisada. La figura se generó a partir de la cohorte analítica bloqueada de 300 pacientes. AP denota pancreatitis aguda. Haga clic aquí para ver una versión más grande de esta figura.
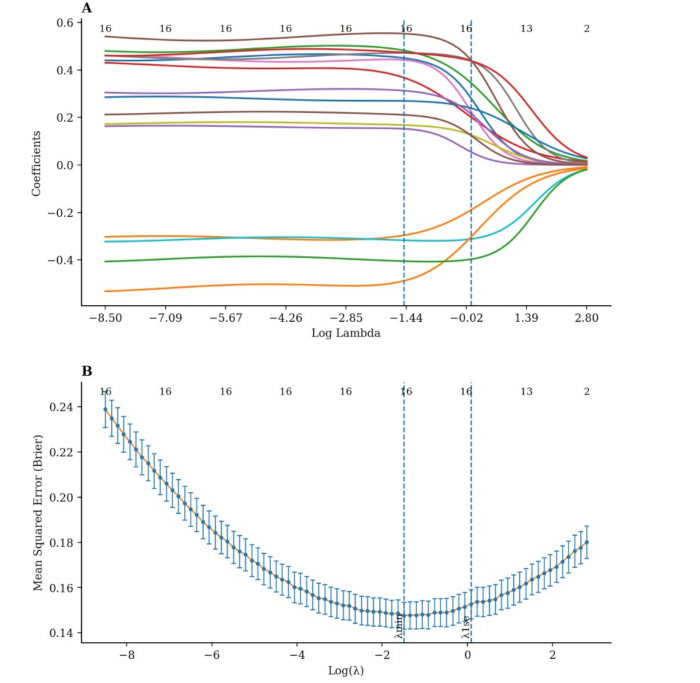
Figura 6: Desarrollo del modelo penalizado en la cohorte de desarrollo. (A) Trayectorias de los coeficientes del operador de contracción y selección por mínima suma de valores absolutos para los predictores bioquímicos y de coagulación candidatos al ingreso. (B) Se utilizaron los resultados de la validación cruzada repetida de 10 pliegues para seleccionar el parámetro de penalización. Se aplicó la regla del error estándar para obtener un modelo bloqueado parsimonioso para la construcción del puntaje y su validación en una muestra independiente. LASSO denota el operador de contracción y selección por mínima suma de valores absolutos; PT-INR, tiempo de protrombina-ratio internacional normalizado. Haga clic aquí para ver una versión más grande de esta figura.
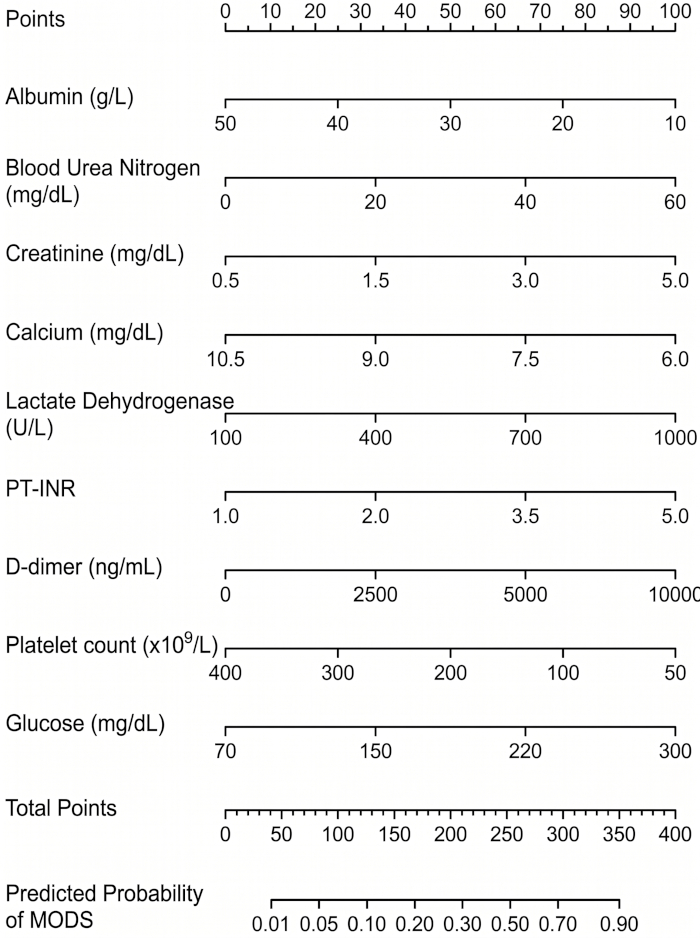
Figura 7: Nomograma basado en el modelo de predicción bloqueado para la estimación de riesgo individualizada. El nomograma incorpora los nueve predictores al ingreso conservados por el modelo penalizado bloqueado: albúmina, nitrógeno ureico en sangre, creatinina, calcio, deshidrogenasa láctica, tiempo de protrombina–relación internacional normalizada, D-dímero, recuento de plaquetas y glucosa. Cada predictor aporta puntos a una puntuación total que corresponde a la probabilidad estimada de síndrome de disfunción orgánica múltiple. El nomograma se incluyó como ayuda interpretativa, mientras que la puntuación compuesta basada en puntos siguió siendo la herramienta práctica principal al pie de cama. SDOM denota síndrome de disfunción orgánica múltiple; PT-INR, tiempo de protrombina–relación internacional normalizada; FEU, unidades equivalentes a fibrinógeno. Haga clic aquí para ver una versión más grande de esta figura.
| Variable | Cohorte de desarrollo n=210 | Cohorte de validación independiente n=90 | Valor p |
| Edad, años | 54,0 ± 16,4 | 55,3 ± 15,2 | 0,486 |
| Sexo masculino, n (%) | 130 (61,9) | 55 (61,1) | 0,898 |
| Índice de masa corporal, kg/m² | 25,0 (22,6–27,9) | 24,7 (22,2–27,5) | 0,293 |
| Tiempo desde el inicio de los síntomas hasta la admisión, h | 13,2 (7,1–22,6) | 12,8 (6,8–21,7) | 0,612 |
| Etiología, n (%) | 0,931 | ||
| Biliar | 89 (42,4) | 38 (42,2) | |
| Hipertrigliceridemia | 65 (31,0) | 29 (32,2) | |
| Relacionada con el alcohol | 19 (9,0) | 8 (8,9) | |
| Idiopática | 25 (11,9) | 11 (12,2) | |
| Otra | 12 (5,7) | 4 (4,4) | |
| Antecedente de pancreatitis previa, n (%) | 31 (14,8) | 12 (13,3) | 0,742 |
| Antecedente de tabaquismo, n (%) | 58 (27,6) | 24 (26,7) | 0,868 |
| Diabetes mellitus, n (%) | 37 (17,6) | 17 (18,9) | 0,795 |
| Hipertensión, n (%) | 62 (29,5) | 28 (31,1) | 0,784 |
| Enfermedad renal crónica, n (%) | 8 (3,8) | 4 (4,4) | 0,797 |
| Frecuencia cardíaca al ingreso, latidos/min | 92,4 ± 15,8 | 93,1 ± 16,2 | 0,726 |
| Presión arterial media, mmHg | 88,6 ± 12,4 | 87,9 ± 11,8 | 0,65 |
| Síndrome de respuesta inflamatoria sistémica, n (%) | 72 (34,3) | 30 (33,3) | 0,871 |
| Puntuación del Índice al Pie de Cama para la Gravedad en la Pancreatitis Aguda | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,842 |
| Puntuación de Evaluación Secuencial de Insuficiencia Orgánica | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,796 |
| Puntuación de Evaluación de la Fisiología Aguda y la Salud Crónica II | 7,0 (5,0–10,0) | 7,0 (5,0–10,0) | 0,884 |
| Síndrome de disfunción orgánica múltiple, n (%) | 35 (16,7) | 15 (16,7) | 1 |
| Recuento de glóbulos blancos, ×10⁹/L | 12,8 ± 4,7 | 12,9 ± 4,9 | 0,865 |
| Proteína C reactiva, mg/L | 70,6 (32,8–141,5) | 72,4 (35,1–145,9) | 0,778 |
| Glucosa, mmol/L | 9,1 (7,4–11,8) | 9,0 (7,2–11,6) | 0,691 |
| Calcio total, mmol/L | 2,05 ± 0,18 | 2,04 ± 0,19 | 0,672 |
| Nitrógeno ureico en sangre, mmol/L | 6,9 (5,2–9,4) | 7,1 (5,3–9,6) | 0,584 |
| Creatinina, μmol/L | 80,2 (64,5–104,8) | 81,1 (65,1–106,2) | 0,731 |
| Albúmina, g/L | 35,2 ± 5,1 | 35,0 ± 5,0 | 0,754 |
| Deshidrogenasa láctica, U/L | 270,8 (212,5–356,7) | 275,6 (216,2–361,4) | 0,637 |
| Tiempo de protrombina - ratio normalizado internacional | 1,09 (1,02–1,18) | 1,10 (1,03–1,19) | 0,694 |
| Dímero D, mg/L unidades equivalentes de fibrinógeno | 1,84 (0,92–3,82) | 1,91 (0,95–3,96) | 0,744 |
| Recuento de plaquetas, ×10⁹/L | 203,6 ± 68,4 | 201,8 ± 66,9 | 0,836 |
Tabla 1: Características basales de los pacientes en las cohortes de desarrollo y de validación reservada. Se comparan las variables demográficas, clínicas, de puntuación de gravedad, bioquímicas y de coagulación basales entre las cohortes de desarrollo y de validación reservada. Las variables continuas se presentan como media ± desviación estándar o mediana (rango intercuartílico), y las variables categóricas como n (%). Los valores de P se utilizan para comparaciones descriptivas entre cohortes.
| Variable | Grupo sin SDOM n = 250 | Grupo SDOM n = 50 | Valor p |
| Recuento de glóbulos blancos, ×10⁹/L | 12,3 ± 4,6 | 14,4 ± 5,2 | 0,008 |
| Relación neutrófilos-linfocitos | 9,0 (5,9–14,2) | 13,4 (9,1–21,3) | <0,001 |
| Proteína C reactiva, mg/L | 61,4 (29,2–123,8) | 138,6 (86,9–226,7) | <0,001 |
| Procalcitonina, ng/mL | 0,43 (0,18–1,02) | 1,25 (0,56–3,28) | <0,001 |
| Lactato, mmol/L | 1,7 (1,2–2,4) | 2,7 (2,0–4,0) | 0,004 |
| Glucosa, mmol/L | 8,9 (7,3–11,4) | 11,2 (8,9–15,1) | 0,01 |
| Calcio total, mmol/L | 2,06 ± 0,17 | 1,96 ± 0,21 | 0,013 |
| Nitrógeno ureico en sangre, mmol/L | 6,6 (5,1–8,9) | 9,4 (7,4–13,2) | <0,001 |
| Creatinina, μmol/L | 77,1 (62,4–97,6) | 108,9 (84,7–163,4) | <0,001 |
| Alanina aminotransferasa, U/L | 46,2 (25,6–93,8) | 58,7 (31,5–119,4) | 0,084 |
| Bilirrubina total, μmol/L | 18,6 (12,3–31,7) | 22,1 (14,2–38,9) | 0,038 |
| Albúmina, g/L | 35,9 ± 4,8 | 32,5 ± 5,6 | <0,001 |
| Lactato deshidrogenasa, U/L | 254,6 (203,2–329,1) | 372,4 (289,8–512,3) | <0,001 |
| Recuento de plaquetas, ×10⁹/L | 207,4 ± 67,2 | 190,3 ± 72,5 | 0,096 |
| Tiempo de protrombina, s | 12,7 (11,8–13,9) | 14,1 (12,9–15,7) | 0,002 |
| Razón normalizada internacional del tiempo de protrombina | 1,08 (1,02–1,16) | 1,22 (1,10–1,38) | 0,002 |
| Tiempo de tromboplastina parcial activada, s | 31,8 (28,4–36,5) | 36,9 (31,7–42,8) | 0,006 |
| Fibrinógeno, g/L | 4,12 ± 1,18 | 4,31 ± 1,29 | 0,268 |
| Dímero D, unidades equivalentes a fibrinógeno en mg/L | 1,48 (0,78–3,16) | 4,62 (2,10–8,95) | <0,001 |
Tabla 2: Perfiles bioquímicos y de coagulación al ingreso según el estado del síndrome de disfunción orgánica múltiple. Los índices de laboratorio representan la primera medición elegible obtenida dentro de las 24 horas posteriores al ingreso hospitalario. Las variables continuas se presentan como media ± desviación estándar o mediana (rango intercuartílico). Los valores de P corresponden a comparaciones descriptivas entre pacientes que desarrollaron síndrome de disfunción orgánica múltiple y aquellos que no lo desarrollaron. Estas comparaciones se utilizaron para caracterizar las diferencias al ingreso y no se emplearon por sí solas para la selección de predictores.
| Predictor retenido en el modelo bloqueado | Dirección asociada con mayor riesgo de MODS | Unidad escalada para interpretación | Razón de momios descriptiva | Intervalo de confianza del 95 % | Función en el modelo |
| Albúmina | Valor más bajo | Por cada disminución de 5 g/L | 1.29 | 1.13–1.47 | Componente principal del puntaje |
| Nitrógeno ureico en sangre | Valor más alto | Por cada aumento de 1 mmol/L | 1.12 | 1.06–1.18 | Componente principal del puntaje |
| Creatinina | Valor más alto | Por cada aumento de 10 μmol/L | 1.05 | 1.02–1.09 | Componente principal del puntaje |
| Calcio total | Valor más bajo | Por cada disminución de 0.1 mmol/L | 1.18 | 1.07–1.30 | Componente principal del puntaje |
| Deshidrogenasa láctica | Valor más alto | Por cada aumento de 100 U/L | 1.21 | 1.07–1.37 | Componente principal del puntaje |
| Tiempo de protrombina - relación internacional normalizada | Valor más alto | Por cada aumento de 0.1 | 1.14 | 1.05–1.25 | Componente principal del puntaje |
| Dímero D | Valor más alto | Por cada aumento de 1.0 mg/L en unidades equivalentes de fibrinógeno | 1.09 | 1.02–1.17 | Componente principal del puntaje |
| Recuento de plaquetas | Valor más bajo | Por cada disminución de 50 × 10⁹/L | 1.16 | 1.01–1.34 | Componente principal del puntaje |
| Glucosa | Valor más alto | Por cada aumento de 1 mmol/L | 1.05 | 1.00–1.10 | Modificador opcional |
Tabla 3: Predictores retenidos del modelo penalizado bloqueado y estimaciones descriptivas tras la selección. La tabla muestra los predictores retenidos por el modelo logístico penalizado con el operador de contracción y selección por mínima absoluta bloqueado, así como estimaciones descriptivas tras la selección para la interpretación clínica. Las razones de momios se presentan para las unidades escaladas indicadas. Estas estimaciones no se consideran inferencia confirmatoria tras la selección penalizada.
| Componente de la puntuación | Categoría | Puntos asignados |
| Albúmina, g/L | ≥38 | 0 |
| 34–37,9 | 1 | |
| 30–33,9 | 2 | |
| <30 | 3 | |
| Nitrógeno ureico en sangre, mmol/L | <6,5 | 0 |
| 6,5–8,9 | 1 | |
| 9,0–12,9 | 2 | |
| ≥13,0 | 3 | |
| Creatinina, μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| Calcio total, mmol/L | ≥2,10 | 0 |
| 2,00–2,09 | 1 | |
| 1,90–1,99 | 2 | |
| <1,90 | 3 | |
| Deshidrogenasa láctica, U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| Tiempo de protrombina - ratio normalizado internacional | <1,10 | 0 |
| 1,10–1,19 | 1 | |
| 1,20–1,39 | 2 | |
| ≥1,40 | 3 | |
| Dímero D, mg/L unidades equivalentes a fibrinógeno | <1,0 | 0 |
| 1,0–2,9 | 1 | |
| 3,0–5,9 | 2 | |
| ≥6,0 | 3 | |
| Recuento de plaquetas, ×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| Glucosa, mmol/L | <10,0 | 0 |
| ≥10,0 | 1 |
Tabla 4: Construcción del puntaje compuesto bioquímico–de coagulación al ingreso.
El puntaje compuesto basado en puntos se derivó del modelo penalizado bloqueado y se tradujo en categorías clínicas interpretables al pie de la cama. Los puntos se asignaron según la dirección y la contribución relativa de los predictores conservados. Los puntos totales se calculan sumando todos los componentes del puntaje conservados. Se mantuvo la glucosa como un modificador opcional porque su asociación era más débil que la de los componentes bioquímicos–coagulativos principales, pero permaneció direccionalmente consistente con un riesgo aumentado.
| Herramienta | Cohorte | AUC | Puntuación de Brier | Intercepto de calibración | Pendiente de calibración | Umbral | Sensibilidad | Especificidad | VPV | VNV |
| (IC 95 %) | (IC 95 %) | (IC 95 %) | ||||||||
| Modelo penalizado bloqueado | Cohorte de desarrollo | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 a 0.16) | 0.97 (0.79–1.18) | Riesgo predicho ≥0,18 | 0,82 | 0,77 | 0,39 | 0,96 |
| Modelo penalizado bloqueado | Cohorte de validación independiente | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0.14 a 0.30) | 0.91 (0.68–1.15) | Riesgo predicho ≥0,18 | 0,75 | 0,74 | 0,39 | 0,93 |
| Puntuación compuesta basada en puntos | Cohorte de desarrollo | 0.823 (0.758–0.888) | 0.132 | No aplicable | No aplicable | ≥8 puntos | 0,76 | 0,72 | 0,35 | 0,93 |
| Puntuación compuesta basada en puntos | Cohorte de validación independiente | 0.783 (0.684–0.882) | 0.151 | No aplicable | No aplicable | ≥8 puntos | 0,7 | 0,69 | 0,31 | 0,91 |
Tabla 5: Rendimiento del modelo penalizado bloqueado y del puntaje compuesto basado en puntos. Se muestra el rendimiento en cuanto a discriminación, calibración y umbral para las cohortes de desarrollo y validación independiente. La discriminación se informa como el área bajo la curva de característica operativa del receptor con intervalo de confianza del 95 %. La calibración se resume mediante el puntaje de Brier, la intersección de calibración y la pendiente de calibración. Las métricas de umbral se informan en puntos de corte preespecificados: riesgo predicho ≥0,18 para el modelo penalizado bloqueado y puntaje ≥8 puntos para el puntaje compuesto basado en puntos.
| Herramienta de predicción | Área bajo la curva de desarrollo | Valor P de DeLong frente al modelo bloqueado | AUC de validación por exclusión | Valor P de DeLong frente al modelo bloqueado |
| (IC 95 %) | (Desarrollo) | (IC 95 %) | (Validación) | |
| Modelo bloqueado de bioquímica–coagulación | 0.873 (0.820–0.926) | Referencia | 0.836 (0.751–0.921) | Referencia |
| Puntuación de Evaluación de Insuficiencia Orgánica Secuencial | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| Puntuación de Evaluación de la Fisiología Aguda y la Salud Crónica II | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| Puntuación del Índice Clínico de Severidad en Pancreatitis Aguda | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| Puntuación de Ranson | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| Puntuación de Pancreatitis Aguda Benigna | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| Criterios del síndrome de respuesta inflamatoria sistémica | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
Tabla 6: Comparación de referencia con herramientas establecidas de gravedad. Se compara el modelo bioquímico–coagulopático de ingreso fijado con herramientas establecidas de gravedad de pancreatitis aguda o disfunción orgánica, calculadas a partir de la misma ventana de ingreso cuando los datos estaban disponibles. Se muestran los valores del área bajo la curva de característica de operación del receptor con intervalos de confianza del 95 % para las cohortes de desarrollo y de validación independiente. Las pruebas de DeLong apareadas comparan cada herramienta de referencia con el modelo bioquímico–coagulopático fijado dentro de cada cohorte.
| Categoría de riesgo | Rango de puntuación | Pacientes, n | Incidencia de SDMO, n (%) | Admisión en UCI, n | Ventilación mecánica, n (%) | Terapia de reemplazo renal, n (%) | Mortalidad intrahospitalaria, n (%) | Necrosis infectada o drenaje, n (%) | Estancia hospitalaria, días |
| (%) | |||||||||
| Riesgo bajo | 0–4 | 115 | 4 (3,5) | 10 (8,7) | 3 (2,6) | 1 (0,9) | 1 (0,9) | 3 (2,6) | 7,6 (5,2–10,4) |
| Riesgo intermedio | 5–8 | 101 | 9 (8,9) | 24 (23,8) | 9 (8,9) | 4 (4,0) | 2 (2,0) | 9 (8,9) | 11,4 (8,0–16,5) |
| Riesgo alto | 9–12 | 60 | 20 (33,3) | 36 (60,0) | 18 (30,0) | 10 (16,7) | 6 (10,0) | 14 (23,3) | 18,6 (13,0–26,8) |
| Riesgo muy alto | ≥13 | 24 | 17 (70,8) | 20 (83,3) | 13 (54,2) | 7 (29,2) | 6 (25,0) | 8 (33,3) | 24,9 (17,5–37,2) |
Tabla 7: Estratificación del riesgo mediante puntuación compuesta basada en puntos. Los pacientes se clasifican en grupos de riesgo bajo, intermedio, alto y muy alto según los puntos totales de la puntuación. Se informa la incidencia observada del síndrome de disfunción orgánica múltiple y los resultados clínicos clave según las estratificaciones de la puntuación. Los resultados categóricos se presentan como n (%), y la duración de la estancia se presenta como mediana (rango intercuartílico).
Tabla suplementaria 1: Criterios operativos para la adjudicación del punto final del síndrome de disfunción orgánica múltiple. La tabla define los criterios preespecificados por sistema orgánico utilizados para adjudicar la disfunción respiratoria, cardiovascular, renal, hepática, de la coagulación y neurológica. El punto final definitivo se asignó cuando ocurrió disfunción de dos o más sistemas orgánicos durante la hospitalización. Dos revisores capacitados evaluaron independientemente cada caso, y las discrepancias se resolvieron mediante un tercer revisor senior.Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Análisis de sensibilidad para el manejo de datos faltantes y la asignación de valores basales. La tabla resume el análisis principal con datos imputados y los análisis de sensibilidad preespecificados, incluyendo el análisis de casos completos, la asignación del peor valor basal dentro de las primeras 24 h y la verificación del desempeño ajustado por centro. Los análisis evalúan si la discriminación del modelo, la puntuación de Brier, el patrón de predictores retenidos y los gradientes de riesgo estratificados por puntuación se alteraron sustancialmente por las distintas alternativas de preprocesamiento.Haga clic aquí para descargar este archivo.
Discusión
El síndrome de disfunción orgánica múltiple (MODS) asociado a pancreatitis aguda puede desarrollarse en un corto período después del ingreso hospitalario, especialmente en pacientes con inflamación sistémica temprana, lesión endotelial, perfusión tisular comprometida e inestabilidad metabólica. El presente protocolo se diseñó en torno a esta ventana de ingreso porque las primeras 24 h suelen determinar si un paciente permanece bajo observación rutinaria en la unidad de hospitalización o requiere una reevaluación más estrecha, un monitoreo aumentado o la preparación para vías de soporte orgánico. Los hallazgos mostraron que las variables bioquímicas y de coagulación disponibles de forma rutinaria, cuando se procesan mediante un flujo de trabajo de modelado fijo y reproducible, pueden organizarse en una puntuación interpretable para la estratificación temprana del riesgo de MODS en la pancreatitis aguda11. Este enfoque es coherente con la realidad clínica de que un solo biomarcador o clasificaciones de gravedad tardías podrían no captar completamente el patrón de deterioro sistémico temprano observado en la pancreatitis aguda de alto riesgo12.
La justificación biológica para combinar variables bioquímicas y de coagulación es clínicamente plausible. La pancreatitis aguda grave no está impulsada por una sola vía aislada; la inflamación sistémica, la activación endotelial, la fuga capilar, la hipoperfusión renal, la activación de la coagulación y la alteración microcirculatoria pueden reforzarse mutuamente durante la fase inicial de deterioro. Los predictores bioquímicos conservados reflejaron este proceso multifactorial. Una albúmina más baja puede indicar fuga vascular relacionada con la inflamación y una reserva fisiológica reducida, mientras que un nitrógeno ureico en sangre y una creatinina más elevados son compatibles con hipovolemia, hipoperfusión renal o lesión renal temprana. Un calcio más bajo, una deshidrogenasa láctica más alta y una glucosa más elevada pueden reflejar estrés metabólico, lesión tisular y una alteración inflamatoria sistémica más grave13. Los predictores de coagulación aportaron una señal complementaria: un tiempo de protrombina con razón internacional normalizada prolongado, un dímero D elevado y un recuento plaquetario más bajo pueden indicar activación de la coagulación, renovación de fibrina, consumo de plaquetas y deterioro microcirculatorio antes de que se establezca completamente una disfunción orgánica evidente14. Por lo tanto, el aumento progresivo en la incidencia de SDOM y en los resultados secundarios a través de las estratificaciones del puntaje sugiere que este último captó un patrón clínicamente coherente de deterioro sistémico temprano, más que anormalidades de laboratorio aisladas.
Una contribución metodológica clave de este estudio es el énfasis en la reproducibilidad. El protocolo revisado fijó la ventana de admisión, utilizó el valor de laboratorio elegible más temprano dentro de las 24 horas, aplicó reglas explícitas de armonización de unidades, definió umbrales de ausencia de datos, estandarizó el preprocesamiento y limitó el ajuste del modelo al grupo de desarrollo. Estos pasos afectan directamente si el puntaje puede reproducirse entre diferentes instituciones. Por ejemplo, la notificación del D-dímero varía entre laboratorios, y no pueden asumirse unidades equivalentes a fibrinógeno cuando los informes locales utilizan unidades de D-dímero sin un factor de conversión validado. De manera similar, la ausencia de valores de laboratorio puede reflejar las vías locales de pruebas más que una ausencia aleatoria de datos15. Por tanto, varios pasos del protocolo son fundamentales: la regla de la línea de base de 24 horas debe aplicarse de forma consistente, no deben usarse valores de laboratorio posteriores a la MODS para la construcción de predictores, la adjudicación del punto final debe seguir criterios prescritos por sistema orgánico, los valores de laboratorio deben convertirse a unidades objetivo comunes antes de agruparlos, y la cohorte de validación reservada no debe utilizarse para selección de características, recalibración de coeficientes ni ajuste de puntos de corte16.
El flujo de trabajo puede modificarse según diferentes entornos institucionales, pero dichas modificaciones deben permanecer preespecificadas. Si una variable candidata presenta una cantidad excesiva de datos faltantes porque no se mide rutinariamente al momento del ingreso, debe excluirse del desarrollo del modelo en lugar de imputarla más allá de un umbral defendible. Si no es posible armonizar las unidades del dímero D a unidades equivalentes de fibrinógeno, el valor debe considerarse no armonizable en lugar de convertirlo mediante suposiciones no respaldadas. Si los laboratorios locales utilizan plataformas de ensayo diferentes, el análisis principal puede mantener los valores clínicos absolutos, mientras que los análisis de sensibilidad incluyen el código del centro o la plataforma de ensayo como factores de ajuste. Si el número de eventos de SDOM es menor de lo esperado, la estrategia de modelado debe favorecer una contracción más fuerte, menos predictores retenidos o una estructura de puntuación más simple, en lugar de ampliar el modelo para ajustar señales inestables17. La resolución práctica de problemas también debe incluir verificar si los exámenes de coagulación se solicitan rutinariamente al ingreso, si las distribuciones de los predictores difieren inesperadamente entre centros, si los umbrales de validación se ajustaron inadvertidamente y si cada panel de las figuras coincide con el conjunto de datos analíticos bloqueado18.
Los hallazgos deben interpretarse con varias limitaciones. La cohorte de validación reservada se derivó del mismo conjunto de datos retrospectivo y multicéntrico, por lo tanto representa una validación interna reservada en lugar de una validación externa independiente. La cantidad de eventos fue limitada, lo que aumenta el riesgo de retención inestable de predictores incluso bajo modelado penalizado. Las razones de momios descriptivas tras la selección se incluyeron únicamente para apoyar la interpretación clínica y no deben considerarse como inferencia confirmatoria. Algunos componentes del punto final dependieron de la calidad de la documentación en los registros médicos electrónicos, y diferencias no medidas a nivel de centro en la práctica clínica podrían haber influido en las decisiones de soporte orgánico. El análisis de curva de decisión no se mantuvo en el conjunto de análisis revisado; por lo tanto, el manuscrito no afirma beneficio clínico neto a través de probabilidades umbral19. La puntuación tampoco debe reemplazar la evaluación establecida de gravedad, el examen clínico repetido, la realización de imágenes cuando esté indicado, ni el juicio clínico. Puntuaciones bajas pueden apoyar la observación rutinaria y la reevaluación estándar, pero no excluyen una posterior deterioración; las puntuaciones más altas deben interpretarse como indicaciones para un monitoreo más estrecho, evaluaciones de laboratorio repetidas y una preparación temprana para vías de soporte orgánico, más que como órdenes de tratamiento fijas20.
En general, este estudio presenta un flujo de trabajo reproducible basado en un puntaje bioquímico–coagulaciónico para la estratificación temprana del riesgo de SDOM en la pancreatitis aguda. El modelo penalizado bloqueado y el puntaje basado en puntos mostraron una discriminación consistente y gradientes de riesgo ordenados en las cohortes de desarrollo y de validación independiente, mientras que los análisis de sensibilidad sugirieron que los hallazgos principales no se alteraron sustancialmente por alternativas preespecificadas en datos faltantes o en valores basales. El valor principal del enfoque radica en organizar datos de laboratorio rutinarios disponibles al ingreso en una señal temprana interpretable de riesgo, que podría ayudar en la triage, ajustar la intensidad del monitoreo y preparar las vías de soporte orgánico21. Los trabajos futuros deberían priorizar la validación externa prospectiva en hospitales con plataformas de laboratorio diferentes, la evaluación de la calibración en tiempo real, la comparación con calculadoras electrónicas de riesgo derivadas del mismo modelo bloqueado, y la evaluación de si las vías de monitoreo guiadas por el puntaje reducen la escalada tardía sin aumentar el uso innecesario de cuidados intensivos22.
Divulgaciones
Los autores declaran que no tienen conflictos de intereses relevantes para este estudio.
Agradecimientos
Los autores desean agradecer a todos los clínicos y al personal de laboratorio involucrados en el diagnóstico, tratamiento y recolección de datos de pacientes con pancreatitis aguda. También estamos agradecidos a los pacientes cuyos datos clínicos permitieron este estudio. Su contribución es sinceramente apreciada.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Nombre | Nombre de la empresa | Número de catálogo / URL | Comentarios |
| Software estadístico R | Foundation for Statistical Computing | Version 4.3.2 https://www.r-project.org/ | Entorno de computación estadística utilizado para el preprocesamiento de datos, desarrollo de modelos, validación y generación de figuras. |
| Paquete caret para R | CRAN / Max Kuhn | Version 6.0-94 https://cran.r-project.org/package=caret | Utilizado para la división estratificada 7:3 entre conjunto de desarrollo y validación de exclusión mediante createDataPartition. |
| Paquete glmnet para R | CRAN / autores de glmnet | Version 4.1-8 https://cran.r-project.org/package=glmnet | Utilizado para regresión logística penalizada con LASSO, familia binomial y alpha = 1. |
| Paquete mice para R | CRAN / proyecto amices | Version 3.16.0 https://cran.r-project.org/package=mice | Utilizado para imputación múltiple mediante ecuaciones encadenadas con 20 conjuntos de datos imputados y 20 iteraciones. |
| Paquete pROC para R | CRAN / autores de pROC | Version 1.18.5 https://cran.r-project.org/package=pROC | Utilizado para análisis ROC, estimación del AUC, intervalos de confianza y comparaciones mediante el método de DeLong. |
| Serie de analizadores modulares cobas 8000 | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | Ensayos bioquímicos e inmunoquímicos. Verifique el modelo del analizador y la información del catálogo frente a los registros del laboratorio participante antes de la presentación. |
| Analizador hematológico automatizado XN-1000 | Sysmex Corporation | Modelo XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | Variables del hemograma completo, incluyendo recuentos de glóbulos blancos y plaquetas. Verifique frente a los registros del laboratorio participante antes de la presentación. |
| Analizador automatizado de coagulación sanguínea CS-5100 | Sysmex Corporation | Modelo CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | Variables de coagulación, incluyendo TP, TTPa, fibrinógeno y D-dímero. Verifique frente a los registros del laboratorio participante antes de la presentación. |
| Analizador de gases en sangre ABL90 FLEX PLUS | Radiometer Medical ApS | Modelo ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | Medición de lactato, si se utilizó esta plataforma. Verifique frente a los registros del laboratorio participante antes de la presentación. |
| Sistema de historial médico electrónico | Hospitales participantes | Específico de la institución; no aplicable | Utilizado para recuperar notas de ingreso, notas de evolución, registros de UCI, procedimientos, signos vitales y registros de alta. Reemplace con el nombre real del proveedor y del sistema cuando esté disponible. |
| Sistema de información de laboratorio | Hospitales participantes | Específico de la institución; no aplicable | Utilizado para recuperar marcas de tiempo de laboratorio, valores brutos, unidades y datos armonizados. Reemplace con el nombre real del proveedor y del sistema cuando esté disponible. |
| Formulario de adjudicación de eventos finales | Equipo del estudio | Documento personalizado del estudio; no aplicable | Formulario estandarizado utilizado por dos revisores y un tercer revisor senior para adjudicar el estado y el inicio de SDOM. |
| Diccionario de datos y tabla de conversión de unidades | Equipo del estudio | Documento personalizado del estudio; no aplicable | Define nombres de variables, unidades objetivo, reglas de conversión, indicadores de datos faltantes, códigos de centros y formatos listos para el análisis. |
Referencias
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.