Este estudio integró la farmacología de redes, el acoplamiento molecular, la dinámica molecular y el método MM-PBSA para priorizar posibles interacciones proteicas de profármacos que responden al glutatión y atrapan sitios apurínicos en el CPHN. Se priorizó el compuesto 5 para el seguimiento con MMP9 y SRC; sin embargo, estos siguen siendo candidatos computacionales. Los hallazgos generan hipótesis y requieren validación bioquímica y celular.
Artículo de investigación
Priorización in silico de interacciones proteicas potenciales para profármacos de atrapamiento de sitios abásicos sensibles al glutatión en cáncer de pulmón de células no pequeñas
En este artículo
Resumen
Resumen
El cáncer de pulmón de células no pequeñas (NSCLC) sigue siendo una causa importante de mortalidad relacionada con el cáncer, y la eficacia del tratamiento frecuentemente se ve limitada por la resistencia adquirida y la toxicidad sistémica. Los profármacos sensibles al glutatión que atrapan sitios apurínicos han mostrado actividad anticancerígena selectiva en estudios experimentales previos, pero aún no se ha establecido si sus metabolitos liberados también presentan interacciones significativas con proteínas relevantes para el cáncer. Aquí se utilizó un flujo de trabajo integrado in silico que combina farmacología de redes, acoplamiento molecular, dinámica molecular (MD) y análisis del área superficial de Poisson-Boltzmann por mecánica molecular (MM-PBSA) para priorizar hipótesis comprobables sobre interacciones proteína-compuesto para dos profármacos sensibles al glutatión (Compuesto 1 y Compuesto 2), sus productos que contienen aminooxi (Compuesto 4 y Compuesto 5) y un par control no atrapador emparejado (Compuesto 3 y Compuesto 6). Se identificaron veintiún dianas asociadas a compuestos y enfermedades que se superponen, y se priorizaron AKT serina/treonina quinasa 1 (AKT1), receptor del factor de crecimiento epidérmico (EGFR), factor de necrosis tumoral (TNF), metaloproteasa 9 de matriz (MMP9) y protooncogen SRC, tirosina quinasa no receptora (SRC), mediante la topología de interacción proteína-proteína. El Compuesto 5 produjo la puntuación más favorable en AutoDock Vina con MMP9 (-8,418 kcal·mol⁻1) y mostró poses derivadas del acoplamiento comparativamente persistentes a lo largo de las trayectorias de dinámica molecular de MMP9 y SRC. Sin embargo, la pose mejor clasificada con MMP9 no mostró coordinación directa con el ion Zn2⁺ catalítico ni interacción directa con His401, Glu402, His405 o His411, por lo que no puede asignársele un modo de unión inhibidor canónico de MMP9. Los análisis de dinámica molecular y MM-PBSA caracterizan únicamente el comportamiento de las trayectorias y la clasificación energética relativa de estos complejos; no demuestran la interacción intracelular con la diana, la inhibición enzimática ni la regulación de vías. Por lo tanto, la actividad establecida de atrapamiento de sitios apurínicos y las nuevas interacciones proteína-compuesto predichas se consideran hipótesis separadas y potencialmente paralelas, y no una cadena mecanicista demostrada. En conjunto, los resultados priorizan pares específicos compuesto-diana para pruebas futuras, pero no establecen un mecanismo multitarget contra el NSCLC.
Introducción
El cáncer de pulmón de células no pequeñas (NSCLC) es el subtipo histológico más común de cáncer de pulmón y sigue siendo una causa importante de mortalidad relacionada con el cáncer en todo el mundo1. Aunque se han logrado avances sustanciales en la terapia dirigida y la oncología de precisión, la eficacia del tratamiento a largo plazo sigue viéndose frecuentemente comprometida por la resistencia adquirida, la duración limitada de la respuesta y la toxicidad asociada al tratamiento2. Los agentes dirigidos al receptor del factor de crecimiento epidérmico (EGFR) han mejorado los resultados en pacientes seleccionados molecularmente, pero casi inevitablemente se desarrolla resistencia durante el tratamiento, lo que crea una necesidad urgente de estrategias terapéuticas que actúen mediante mecanismos alternativos o complementarios3,4. La quimioterapia convencional basada en platino sigue siendo un componente importante del tratamiento, pero su beneficio clínico está limitado por la toxicidad acumulativa y la resistencia durante el uso prolongado5,6. En conjunto, estas limitaciones subrayan la necesidad de identificar agentes antitumorales que sean tanto mecanísticamente distintos como selectivamente activados en el entorno tumoral.
Entre las lesiones del ADN endógenas, los sitios apurínicos o apirimidínicos son muy abundantes y tienen consecuencias biológicas importantes, generándose miles de lesiones en cada célula todos los días7. Cuando estas lesiones no se reparan eficientemente, pueden convertirse en roturas de cadena, lo que puede promover la inestabilidad genómica y la muerte celular8,9. La endonucleasa 1 apurínica/apirimidínica es una enzima central en la vía de reparación por escisión de bases, ya que escinde los sitios apurínicos y permite el procesamiento posterior de la reparación10,11. Esta dependencia en la reparación ha convertido al daño asociado con los sitios apurínicos en un blanco atractivo para el desarrollo de fármacos anticancerígenos12. Con base en este razonamiento, se desarrollaron previamente profármacos atrapadores de sitios apurínicos sensibles al glutatión, diseñados para aprovechar el entorno elevado de glutatión en las células tumorales. Sus productos activados por glutatión contienen una funcionalidad aminooxi capaz de atrapar los sitios apurínicos en forma de aldehído, y trabajos experimentales previos mostraron citotoxicidad selectiva, arresto del ciclo celular y apoptosis en células H129913. Estos datos respaldan el componente del diseño del compuesto relacionado con el atrapamiento de lesiones en el ADN. Sin embargo, no demuestran que MMP9, SRC, EGFR, AKT1 o TNF estén reguladas a continuación del atrapamiento de sitios apurínicos. Cualquier interacción proteína-diana identificada en el presente análisis computacional debe considerarse, por lo tanto, una hipótesis independiente, a menos que ambos procesos se demuestren en el mismo sistema biológico.
El presente estudio se diseñó en torno a esta distinción. El primer nivel de la justificación biológica es la química previamente establecida de liberación sensible al glutatión y captura de sitios apurínicos14. El segundo nivel, examinado aquí, es una pregunta exploratoria: si los profármacos parentales o sus productos liberados son computacionalmente compatibles con proteínas seleccionadas asociadas al cáncer. Se utilizó la farmacología de redes para priorizar proteínas candidatas, seguida de análisis de acoplamiento molecular, dinámica molecular (MD) y MM-PBSA para examinar complejos proteína-ligando seleccionados15,16. Estos cálculos no tenían como objetivo demostrar que las proteínas predichas median el fenotipo conocido de daño al ADN, ni establecer un vínculo causal entre la captura de sitios apurínicos y la señalización oncogénica. En cambio, el flujo de trabajo se utilizó para generar un conjunto ordenado de hipótesis comprobables experimentalmente que posteriormente podrán evaluarse mediante ensayos de unión directa, actividad enzimática, vías metabólicas, daño al ADN y fenotipo.
Protocolo
No se requirió la aprobación del comité de revisión institucional porque este estudio fue completamente computacional y no involucró participantes humanos, animales vertebrados, biospecímenes obtenidos de pacientes ni datos personales identificables. Por lo tanto, el consentimiento informado no era aplicable. Todas las bases de datos, paquetes de software, campos de fuerza y recursos computacionales utilizados en este protocolo se enumeran en la Tabla de Materiales.
Compuestos de estudio y flujo de trabajo analítico
Se utilizaron compuestos atrapadores de sitios apurínicos sensibles al glutatión previamente descritos como moléculas de estudio17. Se seleccionaron el Compuesto 1 y el Compuesto 2 como profármacos parentales porque la escisión inducida por glutatión genera los productos que contienen aminooxilo, el Compuesto 4 y el Compuesto 5, respectivamente. Se eligieron el Compuesto 4 y el Compuesto 5 para el análisis estructural porque representan las especies liberadas que conservan el grupo aminooxilo reactivo hacia sitios apurínicos. Se incluyó el Compuesto 3 como control estructural emparejado sensible al glutatión; su producto de escisión, el Compuesto 6, carece de la funcionalidad aminooxilo necesaria para el atrapamiento covalente de aldehídos de sitios apurínicos. Por consiguiente, se incluyeron los Compuestos 1–3 en la predicción inversa de dianas para comparar los esqueletos parentales, se evaluaron el Compuesto 4 y el Compuesto 5 frente a las proteínas priorizadas, y se utilizó el Compuesto 6 como ligando de control negativo en la comparación de dinámica molecular del SRC. Se incluyó la trayectoria SRC–Compuesto 6 para proporcionar un comparador estructural emparejado al sistema del Compuesto 5 que contiene aminooxilo, no como evidencia de que el grupo aminooxilo en sí determine la unión al SRC. Las estructuras químicas y las relaciones de activación de los Compuestos 1–6 se muestran en Figura 1. Este diseño mantiene intencionadamente separada la química establecida de atrapamiento de lesiones del ADN del presente análisis generador de hipótesis sobre posibles interacciones proteicas.
Predicción de dianas asociadas a compuestos
Las estructuras bidimensionales del Compuesto 1, el Compuesto 2 y el Compuesto 3 se guardaron en formato MDL MOL y se convirtieron en cadenas SMILES canónicas del sistema simplificado de entrada de líneas moleculares (simplified molecular-input line-entry system) mediante Open Babel versión 3.1.1, utilizando el formato de salida SMILES canónico18. Cada cadena exportada se volvió a importar, y la estructura regenerada se verificó visualmente comparándola con la estructura bidimensional correspondiente antes de enviarla a SwissTargetPrediction, restringiendo la especie a Homo sapiens19. Se conservaron los objetivos predichos con valores de probabilidad distintos de cero. Las listas de objetivos obtenidas para los tres compuestos se combinaron, se eliminaron las entradas duplicadas y los objetivos restantes se normalizaron a los símbolos oficiales de genes humanos antes del análisis posterior. Los pares normalizados compuesto-objetivo se importaron en un software de visualización y análisis de redes como una tabla de redes, representando a los compuestos y a los objetivos predichos como nodos, y las relaciones entre compuestos y objetivos como aristas, con el fin de visualizar las relaciones predichas entre objetivos20.
Recuperación de dianas relacionadas con la enfermedad e identificación de dianas comunes
Los blancos asociados con la enfermedad se recuperaron a partir de la base de datos GeneCards utilizando el término de búsqueda «lung cancer H1299»21. Se aplicó un umbral de puntuación de relevancia mayor a 0,27 para conservar los genes con mayor relevancia respecto a esta consulta. Se normalizaron los símbolos génicos y se eliminaron manualmente las entradas duplicadas. La intersección entre los blancos predichos por el compuesto y los blancos asociados con la enfermedad se identificó mediante una herramienta en línea de análisis de diagramas de Venn/intersección22. Solo se conservaron los blancos intersecados para los análisis posteriores de interacción proteína-proteína (PPI), enriquecimiento y priorización de blancos.
Análisis de interacción proteína-proteína y cribado de dianas centrales
Los objetivos interaccionantes se sometieron a la herramienta de búsqueda para la recuperación de genes/proteínas interaccionantes (STRING) versión 11.5, con la especie restringida a Homo sapiens y el puntaje mínimo de interacción requerido establecido en 0,40023. Los datos de PPI resultantes se importaron a Cytoscape versión 3.10.0 para su visualización y análisis de topología. Dentro de un análisis de topología de red el valor de plugin, grado, centralidad de intermediación y centralidad de cercanía se calculó para cada nodo en la red original de interacción de proteínas de 21 nodos; los valores resultantes se utilizaron posteriormente para el filtrado secuencial basado en la mediana descrito a continuación24. Se calcularon métricas de centralidad en la red original de interacción de proteínas (PPI) de 21 nodos y luego se utilizaron para un filtrado secuencial. El grado mediano de la red original fue 12, y se conservaron los nodos con grado ≥ 12, obteniendo 13 candidatos. Dentro de estos 13 candidatos, la centralidad de intermediación mediana fue 0,031293 y la centralidad de cercanía mediana fue 0,769231. El segundo filtro conservó los nodos con centralidad de intermediación ≥ 0,031293 y centralidad de cercanía ≥ 0,769231, > 0,769231, obteniendo cinco candidatos a nodos centrales: AKT1, EGFR, TNF, MMP9 y SRC. Los valores de centralidad informados se conservaron de la red original de 21 nodos, en lugar de recalcularse tras la selección del subconjunto. Los cinco candidatos finales a nodos centrales se utilizaron para el análisis estructural posterior. Las métricas de topología originales corresponden a una red de interacción proteína-proteína no dirigida que contiene 21 nodos y 116 enlaces.
Análisis de enriquecimiento de Gene Ontology y Kyoto Encyclopedia of Genes and Genomes
Los objetivos comunes se sometieron a un análisis de enriquecimiento de Ontología Genética (GO) y de la Enciclopedia de Kyoto de Genes y Genomas (KEGG) mediante el uso de la base de datos para Anotación, Visualización y Descubrimiento Integrado (DAVID), restringiendo la especie a Homo sapiens25. El enriquecimiento de GO se evaluó en los procesos biológicos (BP), componentes celulares (CC) y funciones moleculares (MF), así como en las vías de señalización KEGG. Para este análisis exploratorio, se utilizó un umbral de inclusión de p nominal < 0,10 para conservar las entradas de enriquecimiento; los valores de p ajustados por Benjamini, los valores de Bonferroni, las tasas de falsos descubrimientos y los valores del test exacto de Fisher se incluyeron en las tablas suplementarias, pero no se utilizaron para definir el conjunto conservado. Las entradas conservadas se ordenaron según el valor de p nominal. Para la visualización e interpretación posteriores, se conservaron las 20 principales vías KEGG y los 10 primeros términos de cada categoría GO. Los gráficos de barras y los gráficos de burbujas se generaron utilizando una herramienta en línea de visualización bioinformática.
Preparación de receptores y ligandos para el acoplamiento molecular
Las estructuras cristalinas de las proteínas priorizadas se obtuvieron del Banco de Datos de Proteínas RCSB (PDB, por sus siglas en inglés): AKT1, ID de PDB 3O96; EGFR, ID de PDB 5UWD; TNF, ID de PDB 2AZ5; MMP9, ID de PDB 1GKC; y SRC, ID de PDB 2H8H. Las estructuras proteicas utilizadas para el acoplamiento molecular se prepararon en software de visualización molecular eliminando ligandos co-cristalizados y moléculas de agua, seguido de su procesamiento en software de preparación para acoplamiento. Para MMP9, se conservó por separado una copia sin modificar del PDB 1GKC como referencia cristalográfica para el entorno del Zn2⁺ catalítico y el modo de unión del N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida (NFH). En la cadena A del 1GKC, el Zn2⁺ catalítico está coordinado por His401, His405 y His411 a distancias de 2,21, 2,23 y 2,22 Å, respectivamente, mientras que los dos átomos de oxígeno del NFH coordinan al Zn2⁺ a 2,07 y 2,38 Å; Glu402 es el residuo ácido/base catalítico. Estos contactos cristalográficos se utilizaron como referencia estructural positiva para evaluar el mapa de interacciones del acoplamiento del Compuesto 5. Para SRC, se utilizó el PDB 2H8H en los cálculos de dinámica molecular (MD) de SRC. Estas comparaciones estructurales se emplearon únicamente con fines interpretativos y no se consideraron evidencia de inhibición enzimática o interacción con el objetivo intracelular.
Las estructuras tridimensionales del Compuesto 4 y del Compuesto 5 se obtuvieron de PubChem y se optimizaron mediante minimización de energía en software de modelado molecular26. Los ligandos se protonaron en condiciones fisiológicas y se minimizaron utilizando el campo de fuerza molecular Merck 94 (MMFF94) hasta que el gradiente de energía fue inferior a 0,01 kcal·mol⁻1·Å⁻1. Se agregaron átomos de hidrógeno, se asignaron cargas de Gasteiger y se definieron los enlaces rotacionales en el software de preparación para acoplamiento molecular. El Compuesto 6, el producto de escisión de la glutatión del control Compuesto 3 no atrapador, se preparó utilizando el mismo procedimiento y se acopló a SRC únicamente para generar la pose inicial para la trayectoria de dinámica molecular de control emparejada. Por lo tanto, el Compuesto 6 no se introdujo como un ligando terapéutico predicho adicional ni se utilizó para respaldar un mecanismo de múltiples dianas.
Procedimiento de acoplamiento molecular
Se realizó el acoplamiento molecular utilizando software de acoplamiento molecular bajo un protocolo de acoplamiento semirrígido, manteniendo los receptores rígidos y permitiendo que los ligandos permanecieran flexibles27,28. Para cada receptor, la caja de acoplamiento se centró en la posición del ligando co-cristalizado de modo que la región de búsqueda correspondiera al bolsillo de unión definido experimentalmente. Las dimensiones de la caja de acoplamiento se establecieron en 24 Å × 24 Å × 24 Å para AKT1, EGFR y SRC, 26 Å × 26 Å × 26 Å para MMP9, y 28 Å × 28 Å × 28 Å para TNF. La exhaustividad se estableció en 32, el número de conformaciones de salida se fijó en 20, y el rango de energía se ajustó a 4 kcal·mol⁻1. Se conservó la conformación mejor clasificada de cada simulación de acoplamiento para el análisis de interacciones.
Para evaluar la fiabilidad interna del montaje de acoplamiento, cada ligando co-cristalizado se reacopló en su bolsillo receptor correspondiente utilizando los mismos parámetros, empleándose una desviación cuadrática media (RMSD) de átomos pesados inferior a 2,0 Å como criterio de aceptación. Las posiciones finales se examinaron mediante software de visualización molecular. Para el complejo MMP9–Compuesto 5, se analizó específicamente el mapa de interacciones conservado en busca de coordinación directa anotada del ligando con el ion catalítico Zn2⁺, así como contactos con His401, Glu402, His405 y His411, y se comparó la posición del ligando con la conformación cristalográfica NFH en el PDB 1GKC. Se informó una distancia cuantitativa de coordinación metálica únicamente cuando la coordinación directa ligando-Zn2⁺ era evidente en la posición conservada; de lo contrario, se indicó como no aplicable en lugar de inferirla. Por tanto, una posición de acoplamiento en MMP9 que careciera de estas características canónicas del sitio catalítico se clasificó como no canónica y no se interpretó como evidencia de inhibición enzimática de MMP9. En términos más generales, las puntuaciones de AutoDock Vina y las posiciones de acoplamiento se utilizaron para la priorización relativa y la generación de hipótesis, no como prueba de afinidad de unión o interacción con el objetivo intracelular.
Protocolo de dinámica molecular
Los complejos proteína-ligando seleccionados para el análisis de dinámica molecular se construyeron a partir de las conformaciones de unión obtenidas mediante acoplamiento molecular. Los cálculos de dinámica molecular se realizaron con GROMACS29. Las proteínas se parametrizaron utilizando el campo de fuerza CHARMM36, mientras que los tipos de átomos y parámetros del ligando se asignaron con el campo de fuerza Amber General de segunda generación (GAFF2)30,31. Las cargas parciales mediante corrección de carga de enlace del modelo Austin 1 (AM1-BCC) se generaron mediante herramientas de parametrización de moléculas pequeñas y generación de topología del ligando; posteriormente, un software de generación de topologías del ligando produjo los archivos de topología del ligando compatibles con GROMACS32,33,34. Cada complejo se colocó en una caja de agua TIP3P bajo condiciones de contorno periódicas, con una distancia mínima entre el soluto y la caja de 1,0 nm. Se añadieron iones de sodio y cloruro para neutralizar la carga neta de cada sistema, y se agregó NaCl adicional para alcanzar una fuerza iónica final de 0,15 M.
Se realizó la minimización de energía utilizando el algoritmo de descenso más pronunciado hasta que la fuerza máxima descendió por debajo de 1000 kJ·mol⁻1·nm⁻1. Los sistemas minimizados luego se equilibraron bajo condiciones constantes de número de partículas, presión y temperatura (NPT) a 310 K y 1 bar, aplicando restricciones posicionales al armazón del péptido. La temperatura se controló mediante el termostato V-rescale y la presión mediante el barostato de Parrinello-Rahman. Las interacciones electrostáticas de largo alcance se calcularon utilizando el método de Ewald en malla de partículas. Tanto el corte electrostático de corto alcance como el corte de van der Waals se establecieron en 1,0 nm, y todos los enlaces que involucraban átomos de hidrógeno se restringieron utilizando el algoritmo solucionador de restricciones lineales (LINCS). Se generaron trayectorias productivas durante 150 ns con un paso de integración de 2 fs, y las coordenadas se guardaron cada 10 ps para su posterior análisis.
Análisis de trayectoria
Se realizaron análisis de trayectorias sobre las porciones equilibradas de las trayectorias de producción. Se calcularon el RMSD del armazón proteico y el RMSD del ligando tras el ajuste por mínimos cuadrados a la conformación inicial de referencia. Los valores de fluctuación cuadrática media (RMSF) se calcularon por residuo utilizando los átomos Cα. El análisis de enlaces de hidrógeno entre cada ligando y su receptor se llevó a cabo empleando un umbral de distancia donador-aceptor de 3,5 Å y un umbral de ángulo donador-hidrógeno-aceptor de 30°. La ocupación del enlace de hidrógeno se definió como la proporción de cuadros analizados en los que un enlace de hidrógeno determinado estuvo presente. Estas métricas se utilizaron para caracterizar la estabilidad estructural, la flexibilidad a nivel de residuos y la persistencia de los contactos intermoleculares a lo largo de las tres trayectorias de dinámica molecular.
Cálculo de la energía libre de enlace mediante el área de superficie Poisson-Boltzmann de mecánica molecular (MM-PBSA)
La energía libre de enlace se calculó utilizando el método MM-PBSA implementado con el software de análisis MM-PBSA en los segmentos equilibrados de las trayectorias de dinámica molecular35. Para cada complejo proteína-ligando, los últimos 50 ns de la trayectoria de producción de 150 ns se utilizaron para el análisis de energía libre. Se tomaron un total de 500 fotogramas espaciados uniformemente a intervalos de 100 ps desde 100,0 ns hasta 149,9 ns; el punto final de 150,0 ns se excluyó del conjunto muestreado. La energía libre total de enlace se calculó como la suma de los términos de energía de van der Waals, energía electrostática, energía de solvatación polar y energía de solvatación no polar:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
No se aplicó corrección de entropía. Se calcularon las energías libres medias de unión y las desviaciones estándar en todos los fotogramas muestreados.
Controles de reproducibilidad y validación computacional
Todos los nombres de genes utilizados en los pasos de predicción de objetivos, recuperación de enfermedad-diana e intersección de análisis se estandarizaron a símbolos génicos humanos oficiales antes del análisis posterior. Se mantuvieron parámetros de acoplamiento idénticos en todos los pares receptor-ligando. La configuración de acoplamiento se verificó técnicamente mediante el reacoplamiento del ligando co-cristalizado correspondiente en cada bolsillo del receptor utilizando los mismos parámetros de búsqueda y el umbral preespecificado de RMSD de átomos pesados de aceptación de <2,0 Å. El complejo cristalográfico MMP9–NFH se conservó como referencia estructural positiva para el entorno del Zn2⁺ catalítico, mientras que SRC–Compuesto 6 sirvió como comparador no atrapador emparejado para el análisis de trayectoria de SRC. Las trayectorias de dinámica molecular (MD) se inspeccionaron para verificar la estabilidad de temperatura y presión, así como la ausencia de deriva anormal del volumen de la caja, antes de su inclusión en análisis posteriores. Todos los archivos de entrada, estructuras del receptor, archivos de topología del ligando, archivos de configuración de acoplamiento, archivos de parámetros de MD y registros de selección de cuadros MM-PBSA se archivaron para apoyar la reproducibilidad computacional.
Resultados
Predicción de dianas asociadas a compuestos e identificación de dianas comunes
La predicción inversa de dianas para los compuestos 1–3 arrojó 212 posibles dianas humanas. En paralelo, la recuperación de dianas asociadas a enfermedades desde GeneCards utilizando la palabra clave «cáncer de pulmón H1299» y un umbral de puntuación de relevancia mayor a 0,27 identificó 188 dianas asociadas al carcinoma de pulmón no microcítico (NSCLC). El análisis de intersección entre las dianas predichas para los compuestos y el conjunto de dianas asociadas a la enfermedad arrojó 21 dianas comunes, que se conservaron para todos los análisis posteriores. La superposición entre los dos conjuntos de dianas se muestra en Figura 2. Estos resultados indican que los compuestos estudiados convergieron en un subconjunto restringido de dianas relevantes para la enfermedad, en lugar de en un espacio de dianas difuso y no específico.
Análisis de interacción proteína-proteína y cribado de dianas centrales
Los 21 blancos intersecantes se importaron a STRING para construir una red de interacciones proteína-proteína (PPI). La red resultante contenía 21 nodos y 116 aristas. Los valores de grado de los nodos en Tabla suplementaria 1 suman 232, lo que es consistente con 116 enlaces no dirigidos. Se calcularon los valores de centralidad para esta red original. El grado mediano fue de 12; al aplicar un grado ≥ 12 se conservaron 13 candidatos. Entre estos 13 candidatos, la centralidad de intermediación mediana fue 0,031293 y la centralidad de cercanía mediana fue 0,769231. Al aplicar una centralidad de intermediación ≥ 0,031293 junto con una centralidad de cercanía > 0,769231 priorizó cinco candidatos centrales: AKT1, EGFR, TNF, MMP9 y SRC. Los valores mostrados para los subconjuntos retenidos corresponden a las métricas de centralidad de la red original de 21 nodos, trasladadas durante el filtrado; no se volvieron a calcular para subredes de 13 o 5 nodos. Su centralidad en la red se utilizó únicamente para ordenar los candidatos destinados a una evaluación estructural posterior y no debe interpretarse como evidencia de que sean dianas biológicas de los compuestos. Tabla suplementaria 1, Tabla suplementaria 2, y Tabla suplementaria 3 informan las métricas para la red inicial de 21 nodos, los 13 candidatos conservados tras la primera etapa de cribado y los cinco candidatos centrales finales, respectivamente. La selección secuencial de la red de interacciones proteína-proteína y los cinco candidatos centrales finales se muestran en Figura 3A, Figura 3B, Figura 3C, y Figura 3D.
Análisis de enriquecimiento de la Ontología Genética y de la Enciclopedia de Kyoto de Genes y Genomas
El análisis de enriquecimiento funcional de los 21 objetivos comunes identificó 121 vías KEGG que cumplían con los criterios nominales de inclusión de p < 0,10. Las 20 vías mejor clasificadas se muestran en la Figura 4A. Entre ellas, la resistencia endocrina, las vías del cáncer, los proteoglicanos en el cáncer, la resistencia a los inhibidores de la tirosina quinasa del EGFR y la vía de señalización ErbB fueron particularmente destacadas. Estas vías están estrechamente relacionadas con la proliferación tumoral, la supervivencia, la invasión y la resistencia al tratamiento en el CPHN. Las estadísticas completas de enriquecimiento para las 121 vías KEGG conservadas que cumplen con el valor nominal de p < 0,10 se proporcionan en la Tabla Suplementaria 4.
El análisis de enriquecimiento de GO identificó además 177 términos de procesos biológicos (BP), 29 términos de componentes celulares (CC) y 61 términos de funciones moleculares (MF) que cumplen con el mismo criterio nominal de inclusión de p < 0,10. Los 10 términos con mayor clasificación de cada categoría se muestran en Figura 4B, Figura 4C, y Figura 4D. Los procesos biológicos predominantes incluyeron la regulación positiva de la proliferación de células musculares lisas asociadas al sistema vascular, la transición G2/M del ciclo celular mitótico, la señalización del receptor del factor de crecimiento similar a la insulina, la fosforilación de proteínas, la regulación negativa de la apoptosis y la transducción de señales. Los principales términos de componentes celulares fueron núcleo, balsas de membrana, adhesión focal, membrana plasmática y región telomérica del cromosoma. En contraste, los principales términos de función molecular mostrados en Figura 4D incluyeron actividad de proteína quinasa, actividad de proteína serina quinasa, unión a ATP, actividad de proteína serina/treonina quinasa, actividad de proteína tirosina quinasa, actividad de quinasa de repeticiones heptapeptídicas CTD de la ARN polimerasa II, actividad de quinasa, actividad de quinasa de histona H2AXY142, actividad de quinasa de histona H3Y41 y unión a proteína idéntica. Las estadísticas completas de enriquecimiento para BP, CC y MF se proporcionan en Tabla Suplementaria 5, Tabla Suplementaria 6 y Tabla Suplementaria 7. En conjunto, estos resultados de enriquecimiento indican que el conjunto de dianas interseccionadas está concentrado en procesos de señalización, regulación de la supervivencia y respuesta oncogénica relevantes para la progresión del NSCLC.
Priorización basada en acoplamiento molecular de complejos metabolito-diana
Se realizó un acoplamiento molecular entre el Compuesto 4 y el Compuesto 5 y las cinco proteínas priorizadas mediante la topología de la red. Los valores indicados en la Tabla 1 corresponden a las puntuaciones de acoplamiento de AutoDock Vina y no representan energías libres de unión medidas experimentalmente. El Compuesto 5 produjo la puntuación individual más favorable con MMP9 (-8.418 kcal·mol⁻1), seguido por el Compuesto 4 con MMP9 (-7.840 kcal·mol⁻1). El Compuesto 5 también obtuvo puntuaciones más favorables que el Compuesto 4 para AKT1 y EGFR, mientras que el Compuesto 4 obtuvo puntuaciones ligeramente más favorables para SRC (-6.549 frente a -6.204 kcal·mol⁻1) y TNF (-5.436 frente a -5.299 kcal·mol⁻1). Por lo tanto, el Compuesto 5 no mostró una ventaja uniforme en las puntuaciones a través de las cinco proteínas. Los resultados del acoplamiento se utilizaron únicamente para priorizar complejos representativos para un análisis estructural adicional.
Se muestran conformaciones representativas de acoplamiento en la Figura 5. En el mapa de interacciones mejor clasificado entre MMP9 y el Compuesto 5, los contactos mostrados se localizaron cerca de Ala417 y Pro421, con distancias de aproximadamente 3,0 Å y 2,4 Å, respectivamente. No se anotó ninguna coordinación directa entre el Compuesto 5 y ZN2⁺ en el mapa de interacciones conservado de la mejor posición, y no se observaron contactos directos con His401, Glu402, His405 ni His411. Esto contrasta con el referente cristalográfico 1GKC, en el cual His401, His405 y His411 coordinan al ZN2⁺ catalítico a distancias de 2,21, 2,23 y 2,22 Å, y el inhibidor de hidroxamato inverso NFH coordina al mismo ZN2⁺ a través de dos átomos de oxígeno a 2,07 y 2,38 Å. Dado que no se anotó coordinación directa entre el Compuesto 5 y ZN2⁺ en el mapa de interacciones conservado, no se asignó ninguna distancia de coordinación entre el Compuesto 5 y ZN2⁺; esto se interpreta como la ausencia de coordinación directa demostrada en el mapa conservado, y no como un valor medido de separación metálica. Se muestra una comparación tridimensional con el referente cristalográfico MMP9–NFH en la Figura Suplementaria 1. Por lo tanto, la geometría difiere de un modo de unión inhibidor canónico dependiente de zinc, y el resultado actual de acoplamiento no respalda clasificar al Compuesto 5 como un inhibidor de MMP9. MMP9 se conservó únicamente para el análisis de dinámica molecular (MD) con el fin de determinar si esta geometría específica de acoplamiento no canónica persistía durante la trayectoria. Para los otros complejos, el Compuesto 5 mostró contactos predichos con AKT1 y SRC, mientras que el Compuesto 4 también formó interacciones definidas de acoplamiento con MMP9 y SRC. Coherente con la Figura 5F, estas observaciones describen interacciones predichas y puntuaciones relativas de acoplamiento, no afinidades verificadas experimentalmente.
Se seleccionaron tres complejos para el análisis de MD con fines comparativos, y no confirmatorios. Se eligió MMP9–Compuesto 5 porque tuvo la puntuación de acoplamiento individual más favorable, pero con una conformación no canónica de MMP9 que requirió un seguimiento estructural cauteloso. Se seleccionó SRC–Compuesto 5 como segundo complejo candidato, y se incluyó SRC–Compuesto 6 como la trayectoria de control no atrapante correspondiente. Las conformaciones iniciales correspondientes se muestran en Figura 6A, Figura 6B, y Figura 6C. Este diseño permitió comparar la persistencia de las geometrías de acoplamiento seleccionadas sin considerar la estabilidad en la dinámica molecular como evidencia de interacción con el blanco o regulación funcional.
Análisis de dinámica molecular
Para comparar la persistencia de geometrías seleccionadas derivadas del acoplamiento molecular bajo condiciones acuosas dinámicas, se generaron trayectorias de 150 ns de dinámica molecular (MD) para los complejos MMP9–Compuesto 5 y SRC (PDB 2H8H)–Compuesto 5, incluyéndose SRC (PDB 2H8H)–Compuesto 6 como trayectoria de control negativo emparejada. Las conformaciones iniciales se muestran en Figura 6A, Figura 6B, y Figura 6C. A lo largo de estas trayectorias, el Compuesto 5 mostró un RMSD del ligando menor (Figura 6D) en los sistemas MMP9 y SRC que el Compuesto 6 en SRC. La trayectoria de MMP9–Compuesto 5 alcanzó un régimen de fluctuación relativamente baja, la trayectoria de SRC–Compuesto 5 se estabilizó tras un período inicial de ajuste, y la trayectoria de SRC–Compuesto 6 mostró fluctuaciones mayores. Estas diferencias indican una mayor persistencia de las poses de acoplamiento seleccionadas del Compuesto 5 durante la dinámica molecular. No demuestran que el Compuesto 5 se una a MMP9 o SRC en células, y la trayectoria de MMP9 no supera la ausencia de una interacción canónica con el ZN2⁺ catalítico en la pose inicial.
El RMSD del armazón proteico mostró un patrón comparativo similar. La trayectoria de MMP9–Compuesto 5 entró en un régimen relativamente estable del armazón después de aproximadamente 30 ns, mientras que la trayectoria de SRC–Compuesto 5 mostró una meseta más tardía, y la trayectoria de SRC–Compuesto 6 presentó fluctuaciones mayores. Estas observaciones describen únicamente el comportamiento de las trayectorias. Un armazón proteico estable o una trayectoria del ligando no pueden confirmar la ocupación del blanco intracelular, la inhibición enzimática o la modulación de la señalización. Los perfiles de RMSD del armazón proteico para los tres sistemas se proporcionan en la Figura Suplementaria 2.
Análisis de trayectoria
Se utilizaron análisis de ocupación de enlaces de hidrógeno y fluctuación de residuos para describir la persistencia del contacto dentro de las trayectorias de dinámica molecular (MD) (Figura 7A). El compuesto 5 mostró un enlace de hidrógeno de alta ocupación con Arg95 en la trayectoria de MMP9 (>85 %) y una interacción recurrente con Leu325 en la trayectoria de SRC (>70 %), mientras que los contactos representativos en el control SRC–Compuesto 6 presentaron ocupaciones más bajas. Estos residuos no se presentan como evidencia de modulación funcional del blanco; los valores de ocupación solo indican con qué frecuencia ocurrieron los contactos especificados durante las trayectorias analizadas.
El análisis de RMSF de los residuos del bolsillo de unión mostró diferencias específicas del sistema en la flexibilidad local (Figura 7B). La trayectoria de SRC–Compuesto 6 presentó varias fluctuaciones locales más grandes que la trayectoria de SRC–Compuesto 5, mientras que la trayectoria de MMP9–Compuesto 5 mostró un perfil de fluctuación comparativamente restringido dentro de su propio conjunto de residuos del bolsillo de unión. Dado que MMP9 y SRC son proteínas diferentes, sus valores de RMSF a nivel de residuo no se interpretaron como una comparación directa residuo por residuo. Junto con la ocupación de enlaces de hidrógeno, estos resultados caracterizan la persistencia de los contactos y la flexibilidad local, ayudando a priorizar complejos para pruebas experimentales. Estos resultados no establecen a MMP9 ni a SRC como dianas intracelulares ni demuestran que alguna de las proteínas media el fenotipo anticancerígeno de los compuestos.
Cálculo de la energía libre de unión mediante mecánica molecular y área superficial de Poisson-Boltzmann
Las estimaciones de MM-PBSA calculadas a partir de los segmentos de trayectoria equilibrados se muestran en la Figura 8. El complejo MMP9–Compuesto 5 arrojó una estimación de ΔG_bind de -19,65 ± 6,43 kcal·mol⁻1, el complejo SRC–Compuesto 5 arrojó -17,72 ± 6,84 kcal·mol⁻1, y el control SRC–Compuesto 6 arrojó -10,37 ± 5,61 kcal·mol⁻1. Dentro de este protocolo computacional, el ordenamiento energético relativo fue por tanto MMP9–Compuesto 5, seguido de SRC–Compuesto 5 y SRC–Compuesto 6. Estos valores son estimaciones dependientes del método derivadas de un segmento finito de trayectoria, y no se aplicó ninguna corrección entrópica. Por lo tanto, se utilizaron únicamente para comparaciones internas del estudio y no deben interpretarse como afinidades de unión medidas experimentalmente ni como evidencia de modulación funcional de proteínas.
En los análisis de acoplamiento molecular, dinámica molecular, ocupación de contactos, fluctuación de residuos y MM-PBSA, el Compuesto 5 fue priorizado computacionalmente para su posterior evaluación en los complejos MMP9 y SRC. La convergencia entre estos cálculos refuerza el fundamento para seleccionar estos pares en experimentos posteriores, pero no valida a MMP9 ni a SRC como dianas intracelulares directas. En particular, la conformación no canónica de MMP9 y la ausencia de coordinación demostrada con el ZN2⁺ catalítico impiden inferir un mecanismo inhibidor canónico de MMP9 a partir de los datos estructurales actuales.
Conclusiones derivadas de los resultados
El flujo de trabajo computacional priorizó 21 dianas asociadas a enfermedades superpuestas e identificó AKT1, EGFR, TNF, MMP9 y SRC como candidatos principales de nodos topológicos. Los análisis basados en la estructura priorizaron además el Compuesto 5 para su seguimiento experimental en los complejos MMP9 y SRC. Estos hallazgos no demuestran un acoplamiento directo a la diana, la inhibición de MMP9 o SRC, la regulación de vías ni una conexión mecanicista causal entre las interacciones proteicas y el efecto previamente establecido de atrapamiento de sitios abásicos. Por lo tanto, el estudio respalda un conjunto de hipótesis computacionales comprobables, en lugar de un mecanismo anti-NSCLC multiancla establecido experimentalmente.
DISPONIBILIDAD DE LOS DATOS:
El conjunto de datos que respalda los hallazgos de este estudio está disponible públicamente en Wang X, Peng Z, Xing Y, Xue L. Priorización in silico de posibles interacciones proteicas para profármacos atrapadores de sitios apurínicos sensibles al glutatión en el cáncer de pulmón de células no pequeñas [conjunto de datos]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
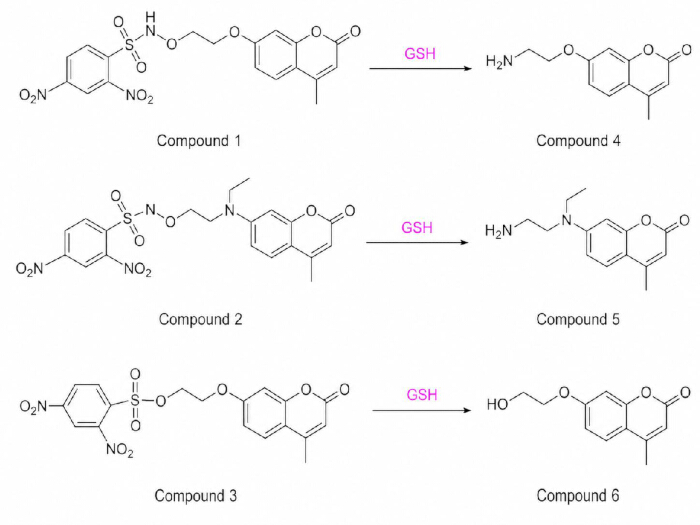
Figura 1: Estructuras químicas y relaciones de conversión inducida por glutatión de los compuestos estudiados. El compuesto 1 y el compuesto 2 son profármacos sensibles al glutatión que liberan los metabolitos que contienen aminooxi, el compuesto 4 y el compuesto 5, respectivamente. El compuesto 3 es un control estructural emparejado sensible al glutatión que genera el compuesto 6, el cual carece de la funcionalidad atrapadora de sitios abásicos que contiene aminooxi. Los compuestos 1–3 se utilizaron para la predicción inversa del blanco, los compuestos 4 y 5 para el acoplamiento molecular con el blanco central, y el compuesto 6 como ligando de control negativo en la comparación de dinámica molecular de SRC. Abreviaturas: SRC, protooncogén SRC, tirosina quinasa no receptora. Haga clic aquí para ver una versión más grande de esta figura.
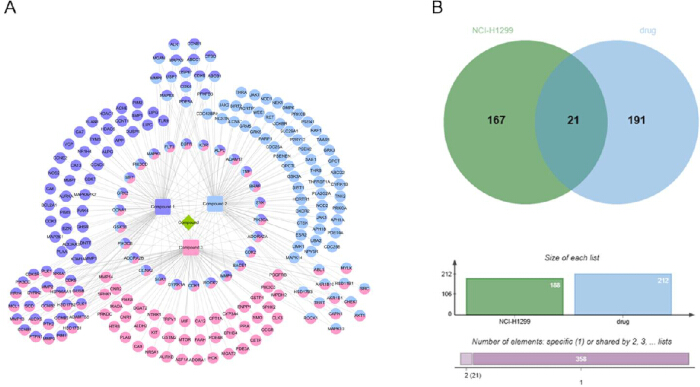
Figura 2: Intersección entre los blancos predichos por el compuesto y los blancos asociados al cáncer de pulmón de células no pequeñas. (A) Red compuesto-blanco generada a partir de los resultados de predicción inversa de blancos para los Compuestos 1–3. (B) Diagrama de Venn que muestra el solapamiento entre los blancos predichos por el compuesto y los blancos asociados a la enfermedad recuperados mediante la consulta de cáncer de pulmón H1299. Los 21 blancos intersecados se conservaron para el análisis de interacción proteína-proteína, el análisis de enriquecimiento y la posterior priorización basada en la estructura. Haga clic aquí para ver una versión más grande de esta figura.
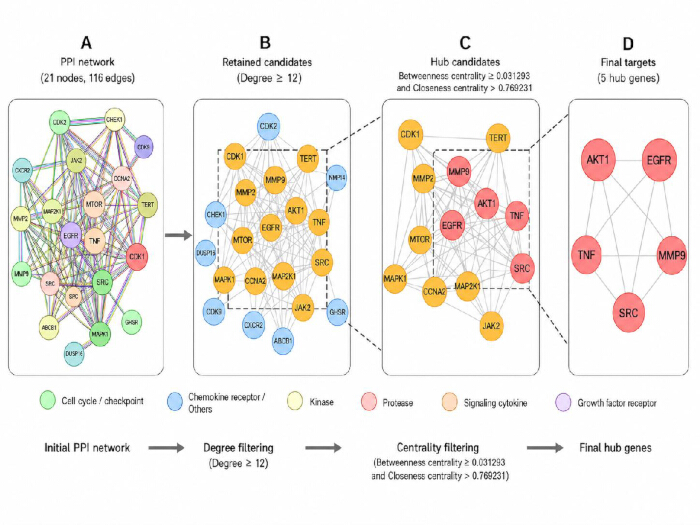
Figura 3: Red de interacciones proteína-proteína y selección de dianas centrales. (A) Red de interacciones proteína-proteína de los 21 blancos comunes (116 aristas). (B) Primera selección utilizando Grado ≥ 12, que conservó 13 candidatos. (C) Segunda selección de los 13 candidatos conservados utilizando centralidad de intermediación ≥ 0,031293 y centralidad de cercanía > 0,769231, lo que produjo cinco candidatos centrales. (D) Los cinco candidatos centrales finales: AKT1, EGFR, TNF, MMP9 y SRC. Los valores de centralidad utilizados para los filtros secuenciales se calcularon en la red original de 21 nodos y 116 aristas y se mantuvieron sin recalcular tras formar cada subconjunto. Abreviaturas: AKT1, quinasa serina/treonina AKT 1; EGFR, receptor del factor de crecimiento epidérmico; TNF, factor de necrosis tumoral; MMP9, metaloproteasa de matriz 9; SRC, protooncogen SRC, tirosina quinasa no receptora. Haga clic aquí para ver una versión más grande de esta figura.
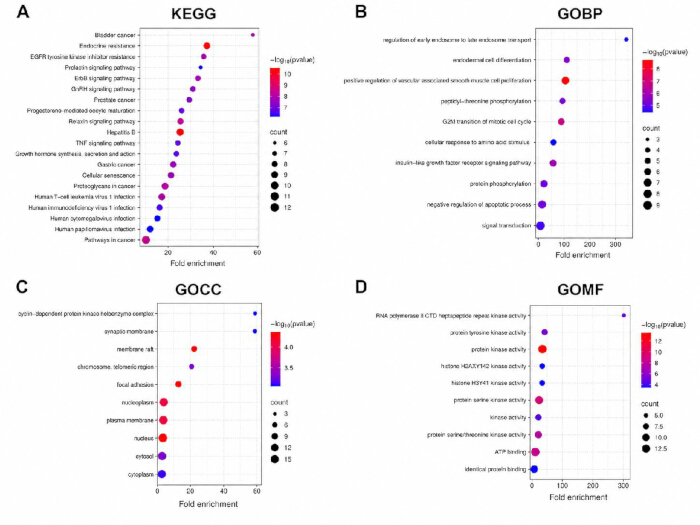
Figura 4: Análisis de enriquecimiento funcional de los objetivos comunes. (A) Gráfico de burbujas con las 20 vías más enriquecidas de la Enciclopedia de Kyoto de Genes y Genomas (KEGG). (B) Gráfico de barras con los 10 términos más enriquecidos del proceso biológico de la Ontología Genética (GO). (C) Gráfico de barras con los 10 términos más enriquecidos del componente celular de la Ontología Genética (GO). (D) Gráfico de barras con los 10 términos más enriquecidos de la función molecular de la Ontología Genética (GO). El eje x de la visualización final muestra el grado de enriquecimiento; el tamaño de las burbujas en el panel A refleja el número de genes. Todas las entradas de KEGG y GO incluidas en las Tablas Suplementarias 4–7 cumplieron con el criterio nominal de inclusión de p < 0,10; las vías/términos representados fueron los mejor clasificados según el valor p nominal. Los valores ajustados por comparaciones múltiples se indican en las tablas suplementarias, pero no se utilizaron para la inclusión. Haga clic aquí para ver una versión más grande de esta figura.
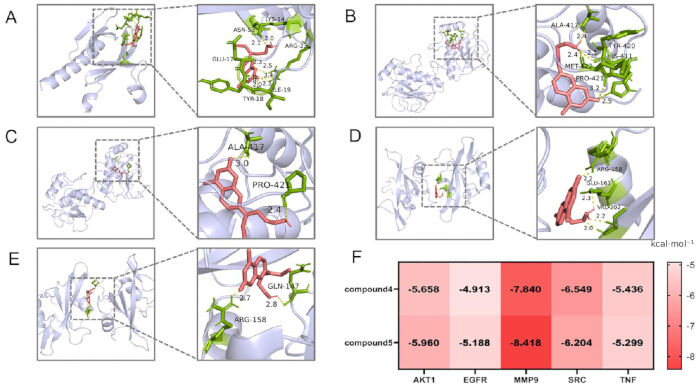
Figura 5: Posiciones de acoplamiento molecular y puntuaciones de AutoDock Vina del Compuesto 4 y el Compuesto 5 con las proteínas prioritarias. (A) Posición predicha de acoplamiento del Compuesto 5 con AKT1. (B) Posición predicha de acoplamiento del Compuesto 4 con MMP9. (C) Posición predicha mejor clasificada del Compuesto 5 con MMP9; los contactos mostrados están cerca de Ala417 y Pro421, mientras que no se anota ninguna coordinación directa con el ZN2⁺ catalítico ni contacto directo con His401, Glu402, His405 ni His411. Por lo tanto, esta posición no se presenta como un modo de unión inhibidor canónico de MMP9. Se proporciona una comparación de referencia del mapa de interacciones con la estructura cristalina de MMP9 unida a NFH (PDB 1GKC), incluyendo las distancias de coordinación del ZN2⁺ determinadas por cristalografía, en la Figura Suplementaria 3. (D) Posición predicha de acoplamiento del Compuesto 4 con SRC. (E) Posición predicha de acoplamiento del Compuesto 5 con SRC. (F) Mapa de calor de las puntuaciones de acoplamiento de AutoDock Vina (kcal·mol⁻1) del Compuesto 4 y el Compuesto 5 frente a las cinco proteínas prioritarias. Valores más negativos indican puntuaciones de Vina más favorables dentro de este protocolo de acoplamiento; no son afinidades de unión medidas experimentalmente. Abreviaturas: AKT1, quinasa de serina/treonina AKT 1; MMP9, metaloproteasa de matriz 9; NFH, N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida; SRC, protooncogen SRC, tirosina quinasa no receptora; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histidina; y Glu, glutamato. Haga clic aquí para ver una versión más grande de esta figura.
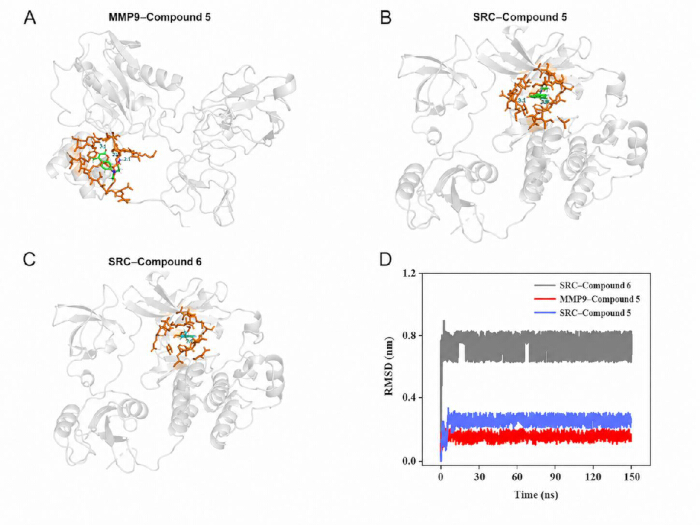
Figura 6: Vista general estructural y análisis de estabilidad del ligando en los complejos de dinámica molecular (MD). (A) Conformación inicial de acoplamiento del Compuesto 5 con MMP9 utilizada como estructura inicial para la dinámica molecular (MD). (B) Conformación inicial de acoplamiento del Compuesto 5 con SRC (PDB 2H8H). (C) Conformación inicial de acoplamiento del Compuesto 6 con SRC (PDB 2H8H); el Compuesto 6 es el producto de la escisión del glutatión del Compuesto 3 de control y carece de la funcionalidad atrapadora de sitios abásicos de tipo aminooxi. (D) Desviación cuadrática media del ligando con respecto a la pose inicial de acoplamiento a lo largo de las trayectorias de 150 ns para MMP9–Compuesto 5, SRC–Compuesto 5 y SRC–Compuesto 6. Este panel compara la persistencia de la pose durante la dinámica molecular (MD) y no demuestra la interacción con el objetivo intracelular. Abreviaturas: MD, dinámica molecular; MMP9, metaloproteasa 9 de la matriz; SRC, protooncogén SRC, tirosina quinasa no receptora; PDB, Protein Data Bank; RMSD, desviación cuadrática media. Haga clic aquí para ver una versión más grande de esta figura.
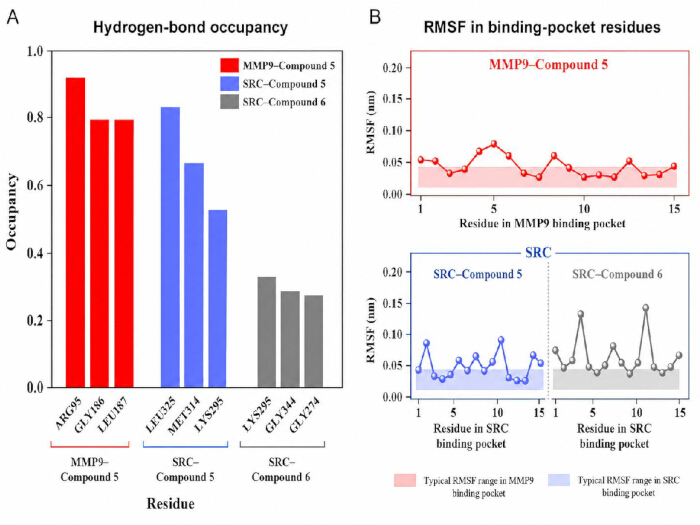
Figura 7: Características de interacción dinámica durante el análisis de dinámica molecular. (A) Ocupación de enlaces de hidrógeno representativos entre ligando y proteína durante las trayectorias de 150 ns para MMP9–Compuesto 5, SRC–Compuesto 5 y SRC–Compuesto 6. (B) Fluctuación cuadrática media de los residuos del bolsillo de unión. El perfil de MMP9 se interpreta dentro del sistema MMP9, mientras que los perfiles de SRC–Compuesto 5 y SRC–Compuesto 6 proporcionan una comparación directa y emparejada dentro de SRC. Estos análisis describen la persistencia de contactos y la flexibilidad local durante la dinámica molecular, pero no demuestran la interacción intracelular con el blanco ni la modulación funcional de MMP9 o SRC. Abreviaturas: MD, dinámica molecular; MMP9, metaloproteasa matricial 9; SRC, protooncogen SRC, tirosina quinasa no receptora; RMSF, fluctuación cuadrática media. Haga clic aquí para ver una versión más grande de esta figura.
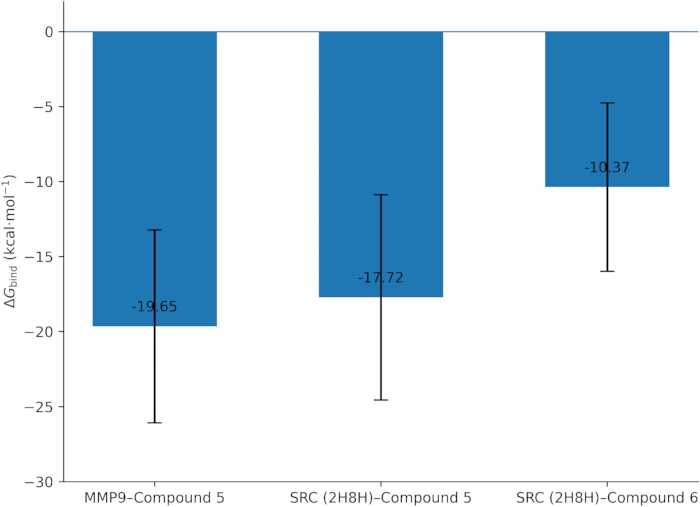
Figura 8: Estimaciones energéticas mediante mecánica molecular y área superficial de Poisson-Boltzmann para los complejos analizados. Estimado ΔValores de G_bind obtenidos mediante el método de área de superficie de Poisson-Boltzmann de mecánica molecular a partir de segmentos de trayectoria equilibrados de los complejos MMP9–Compuesto 5, SRC (PDB 2H8H)–Compuesto 5 y SRC (PDB 2H8H)–Compuesto 6. Los valores se presentan como media ± desviación estándar y se utilizan para comparaciones relativas dentro del estudio, más que como afinidades de unión medidas experimentalmente. La figura 8 utiliza la etiqueta del eje y ΔG_bind (kcal·mol⁻1), consistente con la ecuación y la terminología utilizadas en los Métodos y Resultados. Abreviaturas: MMP9, metaloproteasa 9 de la matriz; SRC, protooncogén SRC, tirosina quinasa no receptora; PDB, Protein Data Bank; ΔG_bind, energía libre de unión; MM-PBSA, área superficial Poisson–Boltzmann de mecánica molecular. Haga clic aquí para ver una versión más grande de esta figura.
| Compuesto | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Compuesto 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Compuesto 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabla 1: Puntuaciones de acoplamiento de AutoDock Vina para el Compuesto 4 y el Compuesto 5 frente a las cinco proteínas prioritarias. Puntuaciones de acoplamiento de AutoDock Vina (kcal·mol⁻1) para el Compuesto 4 y el Compuesto 5 con AKT1, EGFR, MMP9, SRC y TNF. Valores más negativos indican puntuaciones más favorables dentro del protocolo de acoplamiento especificado. Estos valores son puntuaciones computacionales y no deben describirse como energías libres de unión o afinidades medidas experimentalmente. Abreviaturas: AKT1, quinasa serina/treonina AKT 1; EGFR, receptor del factor de crecimiento epidérmico; MMP9, metaloproteasa de matriz 9; SRC, protooncogén SRC, tirosina quinasa no receptora; TNF, factor de necrosis tumoral.
Figura suplementaria 1: Comparación estructural de la referencia cristalográfica MMP9–NFH y la mejor posición predicha para MMP9–Compuesto 5 mediante acoplamiento molecular. (A) Entorno del ZN2⁺ catalítico del complejo de referencia MMP9–NFH (PDB 1GKC), que muestra los residuos His401, His405, His411, Glu402 y las distancias de coordinación del NFH indicadas. (B) Mejor posición predicha para el Compuesto 5, que muestra los contactos con Ala417 y Pro421 indicados. (C) Vista tridimensional alternativa de la misma posición predicha para el Compuesto 5. La comparación se proporciona como referencia estructural y no establece inhibición de MMP9. Abreviaturas: MMP9, metaloproteasa de matriz 9; NFH, N2-[(2R)-2-{[formil(hidroxi)amino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinamida; PDB, Banco de Datos de Proteínas; Ala, alanina; Pro, prolina; His, histidina; Glu, glutamato.Haga clic aquí para descargar este archivo.
Figura suplementaria 2: Desviación cuadrática media de la estructura proteica durante el análisis de dinámica molecular. Perfiles de desviación cuadrática media de la estructura proteica para los sistemas MMP9–Compuesto 5, SRC (PDB 2H8H)–Compuesto 5 y SRC (PDB 2H8H)–Compuesto 6 a lo largo de las trayectorias completas de dinámica molecular. El gráfico final utiliza las etiquetas estandarizadas MMP9–Compuesto 5, SRC–Compuesto 5 y SRC–Compuesto 6, con ejes expresados como RMSD (nm) y Tiempo (ns). Los perfiles describen el comportamiento conformacional dependiente del tiempo durante la dinámica molecular y no deben interpretarse como evidencia de unión celular o regulación proteica. Abreviaturas: MMP9, metaloproteasa matricial 9; SRC, protooncogen SRC, tirosina quinasa no receptora; PDB, Protein Data Bank; RMSD, desviación cuadrática media; MD, dinámica molecular.Haga clic aquí para descargar este archivo.
Figura suplementaria 3: Comparación del entorno del ZN2⁺ catalítico de MMP9 en el complejo de referencia 1GKC-NFH y en la mejor posición predicha para el Compuesto 5. En el complejo de referencia cristalográfico MMP9–NFH (PDB 1GKC), las histidinas 401, 405 y 411 coordinan al ZN2⁺ catalítico a distancias de 2,21, 2,23 y 2,22 Å, respectivamente, y dos átomos de oxígeno del NFH coordinan al ZN2⁺ a 2,07 y 2,38 Å; la Glu402 es el residuo ácido/base catalítico. En contraste, el mapa de interacciones conservado para el Compuesto 5 muestra contactos con Ala417 (3,0 Å) y Pro421 (2,4 Å), pero no presenta coordinación directa anotada con el ZN2⁺ ni contactos directos con His401, Glu402, His405 ni His411. Por consiguiente, no se asignó ninguna distancia de coordinación entre el Compuesto 5 y el ZN2⁺. Esta comparación respalda la clasificación de la posición del Compuesto 5 como una asociación predicha no canónica, en lugar de un modo de unión inhibidor canónico dependiente de zinc. Abreviaturas: MMP9, metaloproteasa de matriz 9; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histidina; Glu, glutamato.Haga clic aquí para descargar este archivo.
Tabla suplementaria 1: Métricas topológicas para la red inicial de interacción proteína-proteína de 21 nodos y 116 enlaces. Parámetros topológicos para los 21 nodos objetivo superpuestos antes del cribado basado en centralidad, incluyendo longitud promedio del camino más corto, centralidad de intermediación, centralidad de cercanía, coeficiente de agrupamiento, grado, excentricidad, conectividad del entorno, radialidad, estrés y coeficiente topológico. La suma de los grados de los nodos es 232, lo que corresponde a 116 enlaces no dirigidos.Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Métricas topológicas originales de la red para los 13 candidatos conservados tras el filtrado basado en el grado. Parámetros topológicos para los 13 nodos conservados tras aplicar el criterio de grado a la red inicial de 21 nodos y 116 enlaces. Estos valores corresponden a las métricas de la red original de 21 nodos y 116 enlaces, que se conservaron para el siguiente paso de filtrado basado en la centralidad de intermediación y proximidad; no se recalculó en una subred de 13 nodos.Haga clic aquí para descargar este archivo.
Tabla suplementaria 3: Métricas topológicas originales de la red para los cinco candidatos a nodo central finales conservados tras el filtrado secuencial. Parámetros topológicos originales de la red de 21 nodos y 116 enlaces para los cinco candidatos finales a nodo central, AKT1, EGFR, TNF, MMP9 y SRC, conservados tras el filtrado secuencial. Estos valores conservados sirven únicamente para la priorización basada en redes y no representan métricas recalculadas en una subred de cinco nodos ni establecen a las proteínas como dianas terapéuticas validadas experimentalmente. Abreviaturas: AKT1, quinasa serina/treonina AKT 1; EGFR, receptor del factor de crecimiento epidérmico; TNF, factor de necrosis tumoral; MMP9, metaloproteasa 9 de matriz; SRC, protooncogén SRC, tirosina quinasa no receptora.Haga clic aquí para descargar este archivo.
Tabla suplementaria 4: Resultados completos del enriquecimiento en la Enciclopedia de Kyoto de Genes y Genomas para 121 vías que cumplen con el criterio nominal de inclusión de p < 0,10. Estadísticas completas de enriquecimiento en la Enciclopedia de Kyoto de Genes y Genomas para las 121 vías conservadas entre los 21 objetivos intersecantes (valor p nominal < 0,10), incluyendo la proporción de genes, conteos de genes, totales en la lista, aciertos en la población, totales de la población, valores p, valores de Benjamini, enriquecimiento por factor, valores de Bonferroni, tasas de falsos descubrimientos y valores del test exacto de Fisher. Las 20 vías con mayor puntuación se muestran en la Figura 4A. El criterio de inclusión se definió según el valor p nominal; los valores de Benjamini, Bonferroni y de tasa de falsos descubrimientos se reportan por transparencia y no se utilizaron para definir el conjunto conservado.Haga clic aquí para descargar este archivo.
Tabla suplementaria 5: Resultados completos del enriquecimiento de procesos biológicos de la Ontología Genética (177 términos que cumplen con el valor nominal p < 0.10). Estadísticas completas de enriquecimiento para los 177 términos biológicos de proceso ontológico de genes retenidos (p nominal < 0.10), incluyendo proporción de genes, conteo de genes, total de la lista, aciertos en la población, total de la población, pvalor, valor de Benjamini, enriquecimiento por factor, valor de Bonferroni, tasa de falsos descubrimientos y valor de la prueba exacta de Fisher. Los 10 términos con mayor clasificación se muestran en la Figura 4B. El valor nominal pel criterio de valor definido incluyó; se informan los valores ajustados por transparencia y no se utilizaron para definir el conjunto retenidoHaga clic aquí para descargar este archivo.
Tabla Suplementaria 6: Resultados completos del enriquecimiento de componentes celulares de Gene Ontology (29 términos que cumplen con un valor p nominal < 0,10). Estadísticas completas de enriquecimiento para los 29 términos de componentes celulares de Gene Ontology retenidos (valor p nominal < 0,10), incluyendo la proporción de genes, recuento de genes, total de la lista, aciertos en la población, total de la población, valor p, valor de Benjamini, enriquecimiento por factor, valor de Bonferroni, tasa de falsos descubrimientos y valor de la prueba exacta de Fisher. Los 10 términos con mayor clasificación se visualizan en la Figura 4C. El criterio de valor p nominal determinó la inclusión; se reportan valores ajustados por transparencia, pero no se utilizaron para definir el conjunto retenido.Haga clic aquí para descargar este archivo.
Tabla suplementaria 7: Resultados completos del enriquecimiento de la función molecular de Gene Ontology (61 términos que cumplen con un valor p nominal < 0,10). Estadísticas completas de enriquecimiento para los 61 términos conservados de la función molecular de Gene Ontology (valor p nominal < 0,10), incluyendo la proporción de genes, recuento de genes, total de la lista, aciertos en la población, total de la población, valor p, valor de Benjamini, enriquecimiento por factor, valor de Bonferroni, tasa de falsos descubrimientos y valor de la prueba exacta de Fisher. Los 10 términos con mayor clasificación se visualizan en la Figura 4D. El criterio del valor p nominal determinó la inclusión; se informan valores ajustados por transparencia y no se utilizaron para definir el conjunto conservado.Haga clic aquí para descargar este archivo.
Discusión
El presente estudio debe interpretarse dentro de un marco mecanicista de dos niveles. El primer nivel se basa en trabajos experimentales previos: la activación sensible al glutatión libera una especie que contiene aminooxi y que puede atrapar sitios apurínicos aldehídicos, y se observó que esta clase de compuestos presenta citotoxicidad selectiva, efectos sobre el ciclo celular y apoptosis en células H1299. El segundo nivel es exploratorio y constituye el enfoque del trabajo actual: las predicciones computacionales de dianas y los análisis basados en la estructura sugieren que la misma serie química también podría ser compatible con ciertas proteínas asociadas al cáncer. Ningún experimento de este estudio demuestra que las interacciones proteicas predichas ocurran en las células o que sean consecuencias posteriores al atrapamiento de sitios apurínicos. Por lo tanto, los dos niveles se mantienen intencionadamente separados, en lugar de combinarse en un mecanismo multiancla demostrado.
A nivel de red, los 21 objetivos interseccionados se enriquecieron en vías relacionadas con el cáncer y la resistencia, y AKT1, EGFR, TNF, MMP9 y SRC ocuparon posiciones centrales en la red de interacción de proteínas (PPI). Estos resultados son útiles para la priorización de candidatos, pero la centralidad en la red y el enriquecimiento no pueden demostrar que un compuesto interactúe físicamente con una proteína o modifique una vía. Por lo tanto, las proteínas centrales deben considerarse candidatas para validación específica. Establecer un papel funcional requeriría experimentos de perturbación directa o de interacción con el blanco en la misma línea celular de NSCLC utilizada para medir el fenotipo celular.
MMP9 ilustra por qué esta distinción es importante. El compuesto 5 presentó la puntuación de acoplamiento individual más favorable con MMP9, pero el mapa de interacciones de la mejor conformación retenida no mostró la coordinación directa del ion Zn2+ catalítico ni la interacción directa con His401, Glu402, His405 o His411. En la referencia cristalográfica 1GKC, His401, His405 y His411 coordinan al Zn2+ a distancias de 2,21, 2,23 y 2,22 Å, respectivamente, mientras que los dos átomos de oxígeno de NFH coordinan al Zn2+ a 2,07 y 2,38 Å; Glu402 es el residuo ácido/base catalítico. En cambio, el mapa del compuesto 5 mostró contactos cercanos a Ala417 y Pro421. Figura suplementaria 3 presenta la comparación del mapa de interacciones de referencia. Dado que no se anotó la coordinación directa entre el compuesto 5 y el Zn2+, no se asignó ninguna distancia de coordinación entre el compuesto 5 y el Zn2+. Por consiguiente, el resultado estructural actual se describe mejor como una asociación predicha no canónica con MMP9, y no como evidencia de inhibición del sitio catalítico. La trayectoria subsiguiente de dinámica molecular solo evalúa si esa conformación específica de acoplamiento se mantiene estable en el tiempo; no puede convertir una geometría de acoplamiento no canónica en una prueba de inhibición enzimática36,37. Por lo tanto, MMP9 debe permanecer como un candidato para pruebas bioquímicas, y no como un objetivo principal o validado. MMP9 ha sido ampliamente discutida en relación con la invasión del cáncer, la remodelación del microambiente tumoral y las estrategias terapéuticas dirigidas a MMP938,39.
Se aplica el mismo límite de evidencia al SRC. La trayectoria del SRC con el Compuesto 5 mostró contactos más persistentes que el control del SRC con el Compuesto 6, pero la estabilidad en la dinámica molecular no equivale a la ocupación del blanco intracelular40,41. El uso del Compuesto 6 permite una comparación equiparada con el producto de escisión no atrapado y fortalece la comparación estructural interna, aunque no demuestra que la funcionalidad aminooxi sea responsable de la unión al SRC o que la señalización del SRC se modifique en las células. Sería necesario realizar una evaluación directa del SRC total, la relación p-SRC/SRC, los marcadores de señalización descendente y mediciones ortogonales de interacción con el blanco para respaldar tal afirmación.
MM-PBSA proporciona asimismo una estimación energética relativa para las trayectorias muestreadas en lugar de una medición experimental de afinidad. Las estimaciones más favorables para MMP9–Compuesto 5 y SRC–Compuesto 5 en comparación con SRC–Compuesto 6 son coherentes con las observaciones comparativas de las trayectorias, pero los cálculos son sensibles a las conformaciones muestreadas y a las aproximaciones metodológicas, y el presente análisis no incluyó una corrección entrópica. Por lo tanto, la concordancia entre el acoplamiento molecular, la dinámica molecular y MM-PBSA únicamente aumenta la consistencia computacional interna; no establece una modulación funcional de MMP9 o SRC.
La relación entre el atrapamiento de sitios apurínicos y las interacciones proteicas predichas sigue sin resolverse. Una posibilidad es que el esqueleto aminooxi liberado por la glutatión conserve su actividad establecida de atrapamiento de lesiones del ADN, al tiempo que presenta interacciones independientes y paralelas con proteínas seleccionadas. Otra posibilidad es que algunas interacciones proteicas predichas no ocurran a concentraciones biológicamente relevantes o no contribuyan al fenotipo. Los datos actuales no pueden distinguir entre estas posibilidades. Demostrar un vínculo mecanicista requeriría la medición simultánea de las respuestas al daño del ADN y de los cambios en las vías proteicas tras el tratamiento con el compuesto, seguido de experimentos de perturbación que demuestren que la alteración de un objetivo candidato modifica el fenotipo anticancerígeno.
La validación experimental futura debe realizarse en células H1299, el mismo modelo celular utilizado en la caracterización experimental previa de esta serie química. Una estrategia escalonada compararía primero el Compuesto 5 con el vehículo y el Compuesto 6 no atrapador emparejado, utilizando ensayos de viabilidad, apoptosis, ciclo celular, migración/invasión y γH2AX dependientes de la concentración para establecer el contexto fenotípico y de daño al ADN42. A continuación, se debería examinar MMP9 mediante zimografía con gelatina y análisis de expresión proteica, mientras que la señalización de SRC debería evaluarse mediante el análisis de SRC total y SRC fosforilado en Tyr416, utilizando la relación p-SRC/SRC como la lectura principal de señalización. La asociación directa entre el compuesto y la proteína debe evaluarse independientemente mediante un método ortogonal de interacción con el blanco, como la resonancia de plasmón de superficie43. Una interacción candidata solo debería considerarse respaldada experimentalmente cuando la evidencia de unión directa sea concordante con la lectura funcional celular correspondiente. La perturbación genética o farmacológica de MMP9 o SRC proporcionaría una prueba adicional para determinar si alguno de estos candidatos contribuye causalmente al fenotipo en H1299. Este marco escalonado mantiene la distinción entre la actividad de atrapamiento en sitios abásicos previamente establecida y las hipótesis de interacción MMP9/SRC priorizadas computacionalmente, al tiempo que define una ruta directa para pruebas experimentales posteriores.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos ni otros conflictos de interés relacionados con este trabajo. Los patrocinadores no tuvieron ningún papel en el diseño del estudio; en la recopilación, análisis o interpretación de los datos; en la redacción del manuscrito; ni en la decisión de publicar los resultados.
Agradecimientos
Este trabajo fue apoyado por el Proyecto Juvenil del Departamento de Educación de la Provincia de Liaoning (JYTQN2023441), el Proyecto de Inicio de Investigación Doctoral del Fondo Conjunto de la Provincia de Liaoning del Departamento de Ciencia y Tecnología (2023-BSBA-151) y el Proyecto de Apoyo a Jóvenes Talentos Científicos y Tecnológicos de la Universidad Médica de Jinzhou (JYQT202305). ChatGPT (OpenAI) se utilizó durante la revisión del manuscrito para edición del lenguaje, organización y apoyo en la revisión. Los autores revisaron y verificaron el contenido científico, la interpretación de los datos y el texto final, y asumen toda la responsabilidad sobre el manuscrito.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| ACPYPE | Desarrolladores de ACPYPE / Bio2Byte | Versión 2023.11.14 | Generación y conversión de archivos de topología de ligandos de moléculas pequeñas al formato compatible con GROMACS. |
| AmberTools (Antechamber) | Equipo de desarrollo de AMBER | AmberTools 23.3 | Asignación de cargas parciales AM1-BCC y generación de parámetros de ligandos con GAFF2. |
| AutoDock Vina | Laboratorio Forli, Scripps Research | Versión 1.2.5 | Acoplamiento molecular y generación de poses proteína-ligando ordenadas por puntuación. |
| AutoDockTools (MGLTools) | Centro de Biología Estructural Computacional, Scripps Research | Versión 1.5.7 | Preparación del receptor y del ligando, asignación de cargas de Gasteiger, definición de enlaces rotacionales y conversión a formato PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Versión 2025 | Visualización de poses de acoplamiento e inspección de interacciones proteína-ligando. |
| Campo de fuerza CHARMM36 | Laboratorio MacKerell / Desarrolladores del campo de fuerza CHARMM | CHARMM36 | Parametrización de proteínas para cálculos de dinámica molecular; se utilizó consistentemente CHARMM36 durante todo el estudio (no CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Versión 22.2 | Minimización de energía del ligando utilizando el campo de fuerza MMFF94. |
| Compuestos 1–6 | Sintetizados previamente según se describe en Li et al., ACS Chemical Biology (2022) | N/A | Profármacos parentales sensibles al glutatión, productos liberados y par control no atrapador emparejado utilizados en el flujo de trabajo computacional. |
| cytoHubba | Desarrolladores de cytoHubba / Tienda de aplicaciones de Cytoscape | Versión 0.1 | Análisis de grado, centralidad de intermediación y centralidad de cercanía para la priorización de dianas centrales. |
| Cytoscape | Consortium Cytoscape | Versión 3.10.0 | Visualización y análisis topológico de redes compuesto-diana e interacciones proteína-proteína (PPI). |
| Recursos Bioinformáticos DAVID | Laboratorio de Retrovirología Humana e Inmunoinformática, Laboratorio Nacional Frederick para la Investigación del Cáncer | Recurso web | Análisis de enriquecimiento de Ontología Genética y KEGG; se utilizó un valor p nominal < 0,10 como criterio exploratorio de inclusión; se informaron valores ajustados, pero no se utilizaron para definir el conjunto retenido. |
| GAFF2 | Equipo de desarrollo de AMBER | GAFF2 | Parametrización del campo de fuerza del ligando. |
| Base de datos de genes humanos GeneCards | Suite GeneCards / LifeMap Sciences, Inc. / Instituto Weizmann de Ciencia | Recurso web | Recuperación de dianas asociadas a enfermedades mediante la consulta 'cáncer de pulmón H1299'. |
| gmx_MMPBSA | Equipo de desarrollo de gmx_MMPBSA | Versión 1.6.3 | Cálculos de energía libre de unión MM-PBSA a partir de trayectorias de dinámica molecular de GROMACS; se muestrearon 500 fotogramas entre 100,0–149,9 ns a intervalos de 100 ps, excluyéndose el punto final a 150,0 ns; no se aplicó corrección de entropía. |
| GROMACS | Equipo de desarrollo de GROMACS | Versión 2024.4 | Generación y análisis de trayectorias de dinámica molecular. |
| Plataforma en línea de visualización Microbioinfo | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Recurso web | Generación de gráficos de barras de enriquecimiento y gráficos de burbujas. |
| Open Babel | Equipo de desarrollo de Open Babel | Versión 3.1.1 | Conversión de archivos de estructura a SMILES canónicos para entrada en SwissTargetPrediction. |
| PubChem | Centro Nacional de Información Biotecnológica, Biblioteca Nacional de Medicina de EE. UU., NIH | Recurso web | Recuperación de estructuras tridimensionales de ligandos. |
| Sistema de gráficos moleculares PyMOL | Schrödinger, LLC | Versión 2.5.4 | Preparación de proteínas, visualización estructural e inspección de poses de acoplamiento. |
| Banco de Datos de Proteínas RCSB | Colaboratorio de Investigación en Bioinformática Estructural (RCSB) | IDs PDB: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Recuperación de estructuras proteicas para AKT1, EGFR, TNF, MMP9 y SRC, respectivamente. |
| STRING | Consortium STRING | Versión 11.5 | Construcción de red de interacciones proteína-proteína; Homo sapiens; puntuación mínima de interacción requerida 0,400; las métricas topológicas originales corresponden a la red PPI no dirigida de 21 nodos y 116 aristas. |
| SwissTargetPrediction | Grupo de Modelado Molecular, Universidad de Lausana / Instituto Suizo de Bioinformática SIB | Recurso web | Predicción inversa de dianas para los compuestos 1–3; especie restringida a Homo sapiens. |
| Modelo de agua TIP3P | Implementado en GROMACS | TIP3P | Modelo de agua explícita de tres sitios utilizado para solvatar complejos proteína-ligando. |
| Venny | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Versión 2.1 | Intersección de listas de dianas predichas por compuestos y asociadas a enfermedades. |
Referencias
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.