Este estudio retrospectivo de un solo centro desarrolló y validó internamente un modelo de regresión logística para la isquemia cerebral tardía tras una hemorragia subaracnoidea aneurismática. En 680 pacientes, seis variables clínicas, de laboratorio y de imagen tempranas mostraron valor predictivo preliminar. Se requiere una validación externa adicional antes de su uso clínico.
Artículo de investigación
Validación interna de un modelo de predicción clínica para la isquemia cerebral retardada tras una hemorragia subaracnoidea aneurismática
En este artículo
Resumen
Resumen
La isquemia cerebral tardía (ICT) es una causa importante de lesión neurológica secundaria tras la hemorragia subaracnoidea aneurismática (HSAA). Este estudio retrospectivo de un solo centro desarrolló y evaluó modelos predictivos para la ICT utilizando datos de 680 pacientes adultos con HSAA tratados entre julio de 2022 y diciembre de 2024. Los pacientes se dividieron mediante una partición estratificada según el resultado, en una proporción de 8:2, en una cohorte de entrenamiento de 544 pacientes y una cohorte de validación interna independiente de 136 pacientes. La ICT ocurrió en 175 pacientes de la cohorte de entrenamiento y en 42 pacientes de la cohorte de validación interna. La selección de predictores se realizó en la cohorte de entrenamiento mediante regresión con operador de contracción y selección por mínimos absolutos con validación cruzada de 10 pliegues. Se conservaron seis variables: edad, edema cerebral, hipoalbuminemia, grado modificado de Fisher, grado de Hunt-Hess y grado de la Federación Mundial de Neurocirujanos. Se compararon modelos de regresión logística, incremento extremo del gradiente, máquina de incremento ligero del gradiente, máquina de vectores de soporte y vecino más cercano k. La regresión logística mostró un área bajo la curva característica de operación del receptor de 0,832 (intervalo de confianza del 95 %, 0,758–0,906) en la cohorte de validación interna. Su pendiente de calibración, intercepto de calibración y puntuación de Brier fueron 0,98, 0,02 y 0,168, respectivamente, aunque no se dispuso de intervalos de confianza para estas estimaciones de calibración. Los hallazgos representan un desempeño preliminar en una única cohorte de validación interna independiente. La falta de registros completos de reproductibilidad, la ausencia del intercepto del modelo, la falta de corrección del optimismo basada en remuestreo y la ausencia de validación externa impiden actualmente el cálculo de probabilidades a nivel individual del paciente y su implementación clínica.
Introducción
Se han propuesto varios modelos de predicción para la isquemia cerebral tardía (DCI) tras la HSAa, pero muchos se han visto limitados por tamaños muestrales pequeños, evaluación incompleta de la calibración, reporte insuficiente de los procedimientos de desarrollo del modelo y ausencia de validación externa. Muchos estudios se han centrado principalmente en la discriminación, mientras que la calibración, la reproducibilidad y la evaluación del impacto clínico se han reportado de forma menos consistente. Por lo tanto, el desempeño del modelo debe evaluarse mediante métodos transparentes e interpretarse con cautela cuando la validación se limite a un solo centro.
El presente estudio tuvo como objetivo desarrollar y evaluar internamente modelos predictivos para la isquemia cerebral tardía (DCI) utilizando variables clínicas, de laboratorio y de imágenes disponibles rutinariamente desde una etapa temprana. Se compararon cinco enfoques de modelado empleando el mismo conjunto de predictores seleccionados. El momento previsto para la predicción fue tras la evaluación inicial de admisión, de laboratorio y de imágenes, pero antes del período principal de riesgo de DCI. Los modelos se desarrollaron para estimación de riesgo con fines de investigación y no pretenden diagnosticar la DCI, sustituir el juicio clínico ni determinar de forma independiente el tratamiento. Se requiere una validación externa, recalibración y evaluación del impacto clínico antes de su uso en la práctica clínica.
La isquemia cerebral tardía (ICT) es uno de estos daños secundarios que ha sido una de las afecciones clínicamente más significativas y potencialmente prevenibles tras la HSAa. La ICT es una complicación que generalmente surge varios días después del ictus, típicamente entre los días 3 y 14, y se asocia con un nuevo deterioro neurológico focal, empeoramiento del nivel de conciencia y/o aparición de infarto cerebral en neuroimágenes posteriores. Aunque existen algunas diferencias en las prácticas diagnósticas entre distintas instituciones, la ICT siempre se relaciona con una estancia prolongada en la unidad de cuidados intensivos, un alto consumo de recursos y un pronóstico neurológico desfavorable. La incidencia informada de ICT es típicamente del 30–40 por ciento, lo que subraya su prevalencia y sus importantes implicaciones pronósticas1,2,3,4,5,6. Es importante destacar que la ICT no es un proceso de vía única. Aunque el enfoque siempre ha estado en la vasoespasmo cerebral de grandes vasos, evidencia acumulada también muestra que la lesión cerebral temprana, la despolarización cortical propagada, la neuroinflamación, la microtrombosis, la disfunción endotelial, la alteración de la autorregulación y el fallo de la microcirculación contribuyen todos al riesgo isquémico. Esta fisiopatología multifactorial ayuda a explicar por qué los tratamientos dirigidos al vasoespasmo podrían no prevenir completamente el infarto asociado a la ICT y por qué es difícil identificar a los pacientes de alto riesgo en el entorno clínico habitual.
La estratificación del riesgo de ICD tras una HSA es una prioridad porque, con la identificación rápida de pacientes de alto riesgo, podría ser posible monitorearlos más de cerca e intensificar de forma inmediata las medidas preventivas o de rescate7. Los planes de monitoreo en la práctica clínica pueden incluir pruebas neurológicas más frecuentes, ultrasonografía Doppler transcraneal, técnicas de imagen sofisticadas, como la perfusión con tomografía computarizada, optimización hemodinámica y del volumen intravascular, cumplimiento estricto con la terapia con nimodipino e identificación temprana del deterioro neurológico, como hidrocefalia, rehemorragia, convulsiones, infección o desequilibrio metabólico. Sin embargo, las decisiones clínicas suelen estar influidas por escalas de gravedad globales y por la experiencia de los médicos, más que por estimaciones personalizadas y basadas en datos de la probabilidad de ICD8,9,10. Una razón es que la literatura indica que los factores de riesgo son heterogéneos, y que la interacción entre los factores del paciente, la carga hemorrágica, las alteraciones fisiológicas y las escalas de clasificación neurológica puede ser no lineal y compleja. Investigadores previos han estudiado posibles predictores de ICD, incluyendo la edad, la hipertensión, el estado neurológico basal, las características del aneurisma, índices de laboratorio (como sodio sérico y albúmina), características de imagen indicativas de la carga hemorrágica y factores relacionados con el tratamiento o el período perioperatorio. Las técnicas convencionales de regresión han sido útiles, pero pueden tener limitaciones cuando los predictores están correlacionados, cuando la relación entre los predictores y el riesgo es no lineal, o cuando existen interacciones entre las variables11. Al mismo tiempo, se han propuesto múltiples instrumentos (muy frecuentemente nomogramas) para evaluar el riesgo de ICD. Aunque los nomogramas son factibles y visualmente atractivos, la mayoría se basan en muestras pequeñas, incluyen pocas variables y pueden estar sobreajustados o mal validados. Además, los modelos desarrollados y probados en un centro podrían no ser fácilmente trasladables a otras instituciones debido a diferencias en la composición de los pacientes, la interpretación de imágenes, el tratamiento y los umbrales diagnósticos para ICD.
Los métodos de aprendizaje automático pueden complementar los modelos tradicionales de predicción clínica, ya que permiten explorar más dimensiones de los datos clínicos y observar tendencias más complejas sin necesidad de hacer suposiciones lineales rígidas. En los últimos años, los modelos de predicción basados en aprendizaje automático han encontrado aplicaciones crecientes en el campo de las enfermedades cerebrovasculares, incluyendo la predicción de resultados y complicaciones, así como el apoyo a la toma de decisiones.12,13,14. Los algoritmos de aprendizaje automático comúnmente utilizados incluyen métodos de árboles conjuntistas como Extreme Gradient Boosting (XGBoost) y Light Gradient Boosting Machine (LightGBM), clasificadores basados en kernels como las máquinas de vectores de soporte (SVM) y clasificadores basados en distancias como k-vecinos más cercanos (KNN). Los modelos son, en principio, capaces de modelar no linealidades y las interacciones más de lo que lo hacen los enfoques tradicionales15Sin embargo, también existen consideraciones prácticas asociadas a los modelos de aprendizaje automático (ML), como el riesgo de sobreajuste, la reducida interpretabilidad y la necesidad de gestionar el preprocesamiento, ajuste, calibración, evaluación y validación. Vale la pena señalar que en una amplia variedad de escenarios clínicos, una regresión logística bien especificada puede desempeñarse tan bien como, o incluso más eficazmente que, algoritmos más complejos, especialmente cuando el número de predictores es pequeño y la relación señal-ruido es moderada. Por lo tanto, se requiere un análisis comparativo de diversos algoritmos utilizando predictores y métricas de evaluación similares para identificar un modelo que se correlacione con el rendimiento y la aplicabilidad clínica.16,17,18.
Se han propuesto previamente varios modelos de predicción para la isquemia cerebral tardía; sin embargo, muchos presentan limitaciones importantes, como tamaños de muestra pequeños, evaluación limitada de calibración, ausencia de comparación directa entre algoritmos e insuficiente validación. Además, estudios previos frecuentemente enfatizan la discriminación mientras subestiman la calibración y las métricas de utilidad clínica, que son esenciales para la aplicabilidad en la práctica real. El presente estudio aborda estas lagunas mediante el desarrollo de un modelo predictivo en una cohorte relativamente grande, la implementación de una selección sistemática de predictores utilizando la regresión por contracción y selección por mínimos absolutos (LASSO), la comparación de múltiples algoritmos de aprendizaje automático dentro de un marco de modelado unificado y la evaluación exhaustiva del desempeño en discriminación, calibración y análisis de decisiones.
Se han propuesto varios modelos de predicción para la isquemia cerebral tardía (DCI) después de la hemorragia subaracnoidea aneurismática (aSAH), pero muchos presentan limitaciones importantes, como cohortes pequeñas, evaluación limitada de la calibración, informes incompletos sobre el desarrollo del modelo y falta de validación externa o temporal. Además, muchos estudios solo informan la discriminación, mientras que la calibración y el análisis de la curva de decisión se presentan de forma menos consistente. El presente estudio no resuelve el problema de la validación externa. En cambio, proporciona un estudio de desarrollo y validación interna realizado en un solo centro, utilizando variables clínicas, de laboratorio y de imágenes disponibles habitualmente. El caso de uso previsto es la estratificación temprana del riesgo tras el ingreso y el tratamiento inicial del aneurisma, antes de la ventana principal de riesgo de DCI. El modelo podría ayudar a los médicos a identificar a los pacientes que necesitan un monitoreo neurológico más estrecho, vigilancia mediante imágenes vasculares, corrección de anomalías fisiológicas y una revisión temprana por parte del equipo de cuidados neurocríticos. No se pretende que sustituya al juicio clínico, que diagnostique la DCI ni que guíe el tratamiento sin una validación externa ni pruebas de impacto clínico. Estudios previos han propuesto varios modelos para predecir la DCI tras la aSAH, pero muchos han estado limitados por tamaños muestrales pequeños, informes incompletos sobre calibración, comparaciones limitadas entre métodos de modelado o la ausencia de validación externa. El presente estudio no pretende ofrecer una herramienta de decisión clínicamente validada. En cambio, su objetivo es desarrollar y validar internamente un modelo de predicción utilizando variables clínicas, de laboratorio y de imágenes tempranas disponibles rutinariamente, provenientes de una cohorte de un solo centro. El caso de uso previsto es la estratificación temprana del riesgo tras el ingreso y el tratamiento inicial del aneurisma, antes del período principal de riesgo de DCI. En este contexto, un riesgo predicho alto apoyaría una evaluación neurológica más estrecha, monitoreo vascular, corrección de anomalías fisiológicas y una revisión temprana por parte del equipo de cuidados neurocríticos. El modelo no está destinado a diagnosticar la DCI ni a sustituir el juicio del médico tratante.
Protocolo
The study was approved by the Institutional Ethics Committee of Yulin First Hospital, Shaanxi Province, China. Because this was a retrospective analysis of routinely collected hospital data, and because all data were anonymized before analysis, the requirement for written informed consent was waived. The study was conducted in accordance with institutional data-protection requirements and the principles of the Declaration of Helsinki.
Data and Methods
Study Population and Design
This was a retrospective single-center cohort study conducted at Yulin First Hospital, Shaanxi Province, China. The hospital records of patients admitted with aSAH between July 2022 and December 2024 were screened. Eligible patients were adults aged 18 years or older with a diagnosis of aSAH confirmed by cranial and intracranial vascular imaging. Patients were required to have been admitted within 72 h after symptom onset and to have undergone aneurysm treatment during the index hospitalization.
Patients were excluded if they had traumatic subarachnoid hemorrhage, non-aneurysmal subarachnoid hemorrhage, severe pre-existing hematological disease, other major intracranial disease affecting outcome assessment, insufficient records for DCI evaluation, or in-hospital death before an adequate DCI assessment period. Excluding early in-hospital deaths may introduce survivorship bias because the most severe cases may be removed from analysis. Therefore, the findings should be interpreted as applying mainly to patients who survived long enough for DCI evaluation.
Data Collection
Clinical, laboratory, imaging, and treatment-related variables were extracted from the electronic medical record using a predefined data-extraction form. The extracted variables included demographic factors, medical history, aneurysm features, early neurological grade, early imaging findings, laboratory results, treatment approach, and hospital complications. The intended prediction time point was after completion of the initial admission and perioperative assessment, but before the main DCI risk window.
Age, sex, body mass index, smoking status, alcohol use, hypertension, diabetes, aneurysm size, aneurysm location, modified Fisher grade, Hunt-Hess grade, World Federation of Neurological Surgeons grade, intraventricular hemorrhage, and rebleeding were taken from admission records and initial imaging. Laboratory variables, including hemoglobin, serum albumin, and serum sodium, were obtained from the earliest available blood test prior to the prediction time point. Cerebral edema was assessed using baseline or immediate post-treatment imaging available before DCI diagnosis. Variables recorded only after DCI onset were not used for model development to reduce information leakage.
Anemia was defined as hemoglobin <110 g/L in female patients and <120 g/L in male patients. Hypoalbuminemia was defined as serum albumin <35 g/L. Hyponatremia was defined as serum sodium <130 mmol/L.
Patients were managed according to the institutional aSAH care pathway. Standard management included early aneurysm securing, neurological observation, blood pressure control, fluid and electrolyte management, and surveillance for complications including hydrocephalus, rebleeding, seizure, infection, vasospasm, and DCI. Nimodipine was used unless contraindicated. Vasospasm monitoring was performed using neurological examination, vascular imaging, and transcranial Doppler ultrasonography when clinically indicated. Hydrocephalus was managed with cerebrospinal fluid diversion when required. Hemodynamic optimization and rescue therapy were applied according to the treating team’s assessment. Because treatment intensity and rescue-therapy details were not completely captured in the retrospective dataset, these factors could not be fully adjusted in the model and were considered a limitation.
Diagnosis of DCI
DCI was defined as a new focal neurological impairment, a decrease in level of consciousness, or a new cerebral infarction on follow-up computed tomography or magnetic resonance imaging occurring during the expected DCI risk window and not explained by another cause. The DCI risk window was defined as days 3–14 after the hemorrhage ictus. Alternative explanations, including rebleeding, hydrocephalus, seizure, infection, metabolic disturbance, sedative effect, and procedure-related infarction, were reviewed before classifying an event as DCI.
Outcome adjudication was performed by two clinicians with experience in the management of aSAH, including one neurosurgeon and one neurologist/neurocritical care physician. The adjudicators reviewed clinical notes, neurological examinations, imaging reports, and follow-up imaging. They were blinded to the final model output during outcome assessment. Disagreements were resolved through consensus discussion with review of the relevant imaging and clinical timeline. Formal inter-rater agreement was not measured, and this limitation was added because DCI classification may involve clinical judgment.
Sample Size Calculation
The sample size was estimated using the 10-events-per-variable (EPV) rule of thumb11. With 20 candidate predictor variables and an expected DCI incidence of approximately 35%, a minimum sample size of 20 × 10 / 0.35 ≈ 572 patients was required. Our final cohort of 680 patients exceeded this requirement. Although the events-per-variable (EPV) rule was applied as a general guideline, modern predictive modeling, particularly machine learning algorithms, may require more flexible sample-size considerations. The final cohort size was considered adequate to ensure model stability, minimize the risk of overfitting, and enable reliable estimation of model performance metrics.
Model development and validation
Patients were allocated to a training cohort of 544 patients and a hold-out internal validation cohort of 136 patients using an outcome-stratified 8:2 split. Outcome stratification was used to maintain a similar proportion of DCI events in the two cohorts. DCI occurred in 175 of 544 patients in the training cohort and 42 of 136 patients in the internal-validation cohort. The 8:2 hold-out design was retained because it was the prespecified model-development strategy and provided a separate cohort for preliminary internal performance assessment.
Predictor selection was performed only in the training cohort using least absolute shrinkage and selection operator regression with 10-fold cross-validation. The selected penalty parameter was λ = 0.031. Six predictors were retained: age, cerebral edema, hypoalbuminemia, modified Fisher grade, Hunt-Hess grade, and World Federation of Neurological Surgeons grade.
Logistic regression, extreme gradient boosting, light gradient boosting machine, support vector machine, and k-nearest neighbor models were developed using the same set of selected predictors. All preprocessing, predictor selection, and model-development procedures were restricted to the training cohort. The internal-validation cohort was not used during predictor selection or model tuning and was evaluated only after model development.
The numerical random seed used for the original cohort allocation was not retained in the archived analysis records and could not be retrospectively verified. Bootstrap optimism correction and repeated k-fold internal validation were also not available. Therefore, the present analysis is described as a single hold-out internal validation rather than an optimism-corrected or repeated cross-validated performance assessment.
Machine-learning reproducibility
LASSO predictor selection used 10-fold cross-validation within the training cohort. Continuous predictors were standardized when required by the modeling algorithm, and categorical predictors were represented using predefined binary clinical categories. The validation cohort was not used for tuning or model selection.
The archived analysis materials did not retain the final tuning grids, selected hyperparameters, complete package versions, original random seed, or a confirmed class-imbalance procedure for XGBoost, LightGBM, SVM, and KNN. These settings were therefore not reconstructed or estimated. The machine-learning comparisons should consequently be interpreted as exploratory comparisons of algorithms rather than fully reproducible model-development experiments. Reproducibility information, both available and unavailable, should be summarized in Supplementary Table 1.
Bias Control & Sensitivity Analysis
Consecutive eligible patients were included to reduce selection bias. Standardized variable definitions and a structured data-extraction form were used to reduce information bias. Predictors were restricted to information available before the intended DCI prediction time point to reduce information leakage. Predictor selection, preprocessing, and model development were performed only in the training cohort.
Modified Fisher grade, Hunt-Hess grade, and WFNS grade represent related aspects of hemorrhage burden and neurological severity. Although all three variables were retained after LASSO selection, the numerical variance inflation factor values and the results from a sensitivity model excluding overlapping severity scales were not included in the archived analysis output. These analyses could not be reconstructed from the aggregate tables because patient-level correlations and fitted model outputs are required. Therefore, the individual coefficients of these severity measures were not interpreted as independent or causal effects. They were retained only as components of the prediction model selected in the training cohort.
Model Interpretability
Clinical applicability was believed to require model interpretability as a crucial element. In the most effective model, the effects of predictors were considered to assess the clinical plausibility and conformity with existing pathophysiological knowledge of delayed cerebral ischemia. This method enabled a clear assessment of model behavior and improved the potential for clinical translation.
Missing Data
Variable-level missingness was assessed during data preparation. However, the original pre-imputation missing counts and percentages for each candidate variable were not retained in the archived analysis records and could not be accurately reconstructed from the aggregate tables. Consequently, no assumption of complete data was made, and no unverified missingness percentages were reported.
A verified supplementary missing-data table should be generated directly from the original deidentified patient-level dataset. Supplementary Table 2 should report, for every candidate variable, the number and percentage of missing observations before data handling, the method used to address missingness, and the number of observations included in the final analysis. The inability to recover the original variable-specific missingness pattern was considered a limitation of the present report.
Statistical Analysis
Predictor selection was performed in the training cohort using LASSO regression with 10-fold cross-validation. Discrimination was assessed using the area under the receiver operating characteristic curve with 95% confidence intervals. Calibration was described using calibration plots and point estimates of the calibration slope, calibration intercept, and Brier score. Bootstrap confidence intervals for calibration measures were not available.
Threshold-dependent classification measures were calculated from the available internal-validation confusion matrices. The exact numerical probability threshold used to generate the archived confusion matrices was not retained and could not be verified. Therefore, these measures were interpreted descriptively and were not used as the primary basis for model selection. Decision-curve analysis was also considered exploratory because the exact prespecified threshold range and patient-level net-benefit output were not retained. A two-sided P value below 0.05 was considered statistically significant.
Resultados
Comparación de las características basales entre las cohortes de entrenamiento y de validación interna
Se incluyó un total de 680 pacientes con SAH-a. La cohorte de entrenamiento contó con 544 pacientes, de los cuales 175 desarrollaron ICD, mientras que la cohorte de validación interna incluyó 136 pacientes, de los cuales 42 desarrollaron ICD. La tasa de eventos de ICD fue del 32,2 % en la cohorte de entrenamiento y del 30,9 % en la cohorte de validación interna. Las características basales se presentan en la Tabla 1. Dado que algunas entradas archivadas de la tabla contenían inconsistencias en los denominadores, se debe verificar la tabla frente al conjunto de datos original a nivel de paciente antes del envío final.
| Variable | Cohorte de entrenamiento (n = 544) | Cohorte de validación interna (n = 136) | t/χ²/Z | Valor P | DME | Nota de corrección |
| Edad, años | 62,88 ± 9,41 | 63,25 ± 9,52 | 0,409 | 0,693 | 0,039 | |
| Sexo | 0,429 | 0,512 | 0,063 | |||
| Hombre | 180 (33,09) | 41 (30,15) | ||||
| Mujer | 364 (66,91) | 95 (69,85) | ||||
| IMC, kg/m² | 23,46 ± 3,56 | 23,61 ± 3,65 | 0,437 | 0,662 | 0,042 | |
| Antecedentes de tabaquismo | 0,118 | 0,731 | 0,033 | |||
| Sí | 101 (18,57) | 27 (19,85) | ||||
| No | 443 (81,43) | 109 (80,15) | ||||
| Consumo de alcohol | 0,417 | 0,518 | 0,062 | |||
| Sí | 118 (21,69) | 33 (24,26) | ||||
| No | 426 (78,31) | 103 (75,74) | ||||
| Antecedentes de hipertensión | 0,348 | 0,555 | 0,057 | |||
| Sí | 329 (60,48) | 86 (63,24) | ||||
| No | 215 (39,52) | 50 (36,76) | ||||
| Antecedentes de diabetes | 0,116 | 0,733 | 0,033 | El recuento de "No" en la validación se corrigió para que sumara 136. | ||
| Sí | 70 (12,87) | 19 (13,97) | ||||
| No | 474 (87,13) | 117 (86,03) | ||||
| Diámetro del aneurisma, mm | 0,213 | 0,645 | 0,044 | |||
| >10 | 288 (52,94) | 75 (55,15) | ||||
| ≤10 | 256 (47,06) | 61 (44,85) | ||||
| Localización del aneurisma | 0,980 | 0,322 | 0,095 | |||
| Circulación anterior | 448 (82,35) | 107 (78,68) | ||||
| Circulación posterior | 96 (17,65) | 29 (21,32) | ||||
| Edema cerebral | 0,612 | 0,434 | 0,075 | |||
| Sí | 125 (22,98) | 27 (19,85) | ||||
| No | 419 (77,02) | 109 (80,15) | ||||
| Hemoglobina baja | 0,684 | 0,408 | 0,079 | El recuento de "No" en la validación se corrigió para que sumara 136. El recuento en entrenamiento no coincide con la Tabla 2; verifique con el conjunto de datos final. | ||
| Sí | 147 (27,02) | 32 (23,53) | ||||
| No | 397 (72,98) | 104 (76,47) | ||||
| Hipoalbuminemia | 0,367 | 0,545 | 0,058 | |||
| Sí | 115 (21,14) | 32 (23,53) | ||||
| No | 429 (78,86) | 104 (76,47) | ||||
| Hiponatremia | 0,186 | 0,666 | 0,041 | |||
| Sí | 331 (60,85) | 80 (58,82) | ||||
| No | 213 (39,15) | 56 (41,18) | ||||
| Grado modificado de Fisher | 0,249 | 0,618 | 0,048 | |||
| ≥III | 259 (47,61) | 68 (50,00) | ||||
| I–II | 285 (52,39) | 68 (50,00) | ||||
| Grado Hunt-Hess | 0,178 | 0,673 | 0,040 | El recuento de ≥III en la validación se corrigió de 53 a 63 para que sumara 136; verifique con el conjunto de datos final. | ||
| ≥III | 263 (48,35) | 63 (46,32) | ||||
| I–II | 281 (51,65) | 73 (53,68) | ||||
| Grado WFNS | 0,249 | 0,618 | 0,048 | |||
| ≥III | 277 (50,92) | 66 (48,53) | ||||
| I–II | 267 (49,08) | 70 (51,47) | ||||
| Enfoque quirúrgico | 0,717 | 0,397 | 0,081 | |||
| Tratamiento endovascular | 449 (82,54) | 108 (79,41) | ||||
| Clipaje | 95 (17,46) | 28 (20,59) | ||||
| Tiempo quirúrgico, h | 2,78 ± 0,81 | 2,81 ± 0,79 | 0,388 | 0,698 | 0,037 | |
| Hemorragia intraventricular | 0,383 | 0,536 | 0,059 | |||
| Sí | 134 (24,63) | 37 (27,21) | ||||
| No | 410 (75,37) | 99 (72,79) | ||||
| Rehemorragia | 0,784 | 0,376 | 0,085 | |||
| Sí | 98 (18,01) | 29 (21,32) | ||||
| No | 446 (81,99) | 107 (78,68) |
Tabla 1: Características basales de las cohortes de entrenamiento y validación interna. Las variables continuas se presentan como media ± desviación estándar, y las variables categóricas como n (%). Los valores de p y las diferencias medias estandarizadas comparan las dos cohortes. Abreviaturas: BMI, índice de masa corporal; SMD, diferencia media estandarizada. Haga clic aquí para descargar esta tabla.
Comparación de las características basales entre los grupos sin DCI y con DCI en el conjunto de entrenamiento
Dentro del conjunto de datos de entrenamiento, la isquemia cerebral tardía (ICT) ocurrió en 175 pacientes (32,17 %), mientras que 369 pacientes (67,83 %) no desarrollaron ICT. La incidencia de ICT en la cohorte de validación interna fue comparable, lo que indica una prevalencia estable de los resultados. Los análisis comparativos entre los grupos sin ICT y con ICT revelaron varias diferencias estadísticamente significativas (Tabla 2). Los pacientes que desarrollaron ICT eran significativamente mayores (P = 0,026), lo que sugiere una susceptibilidad asociada con la edad a lesiones isquémicas secundarias. La evidencia radiológica de lesión cerebral temprana, particularmente edema cerebral, fue notablemente más prevalente entre los pacientes con ICT (P = 0,001). Las alteraciones de laboratorio, incluyendo hipoalbuminemia (P = 0,007), hiponatremia (P = 0,048) y niveles bajos de hemoglobina (P < 0,001), se asociaron significativamente con la aparición de ICT. Los marcadores de gravedad neurológica mostraron las asociaciones más fuertes. El grado modificado de Fisher elevado (≥III) fue significativamente más frecuente entre los pacientes con ICT (P < 0,001), lo que indica una relación sólida entre la carga de hemorragia y las complicaciones isquémicas tardías. De manera similar, un grado más alto de Hunt–Hess y un grado más alto de la Federación Mundial de Cirujanos Neurológicos (WFNS) se asociaron fuertemente con el desarrollo de ICT (ambos P < 0,001). En contraste, las variables demográficas, los factores del estilo de vida, la morfología del aneurisma, el enfoque quirúrgico y la duración de la cirugía no mostraron diferencias estadísticamente significativas.
| Variable | Grupo sin CID (n = 369) | Grupo con CID (n = 175) | t/χ²/Z | Valor p | Nota de corrección |
| Edad, años | 62,25 ± 9,54 | 64,22 ± 9,75 | 2,234 | 0,026 | |
| Sexo | 0,638 | 0,424 | |||
| Hombre | 118 (31,98) | 62 (35,43) | |||
| Mujer | 251 (68,02) | 113 (64,57) | |||
| IMC, kg/m² | 23,43 ± 3,56 | 23,52 ± 3,72 | 0,271 | 0,786 | |
| Antecedentes de tabaquismo | 0,351 | 0,554 | |||
| Sí | 66 (17,89) | 35 (20,00) | |||
| No | 303 (82,11) | 140 (80,00) | |||
| Consumo de alcohol | 0,046 | 0,837 | |||
| Sí | 81 (21,95) | 37 (21,14) | |||
| No | 288 (78,05) | 138 (78,86) | |||
| Antecedentes de hipertensión | 2,960 | 0,085 | |||
| Sí | 214 (57,99) | 115 (65,71) | |||
| No | 155 (42,01) | 60 (34,29) | |||
| Antecedentes de diabetes | 0,463 | 0,496 | |||
| Sí | 45 (12,20) | 25 (14,29) | |||
| No | 324 (87,80) | 150 (85,71) | |||
| Diámetro del aneurisma, mm | 0,380 | 0,538 | |||
| >10 | 192 (52,03) | 96 (54,86) | |||
| ≤10 | 177 (47,97) | 79 (45,14) | |||
| Localización del aneurisma | 3,602 | 0,058 | |||
| Circulación anterior | 296 (80,22) | 152 (86,86) | |||
| Circulación posterior | 73 (19,78) | 23 (13,14) | |||
| Edema cerebral | 10,410 | 0,001 | |||
| Sí | 70 (18,97) | 55 (31,43) | |||
| No | 299 (81,03) | 120 (68,57) | |||
| Hemoglobina baja | 23,965 | <0,001 | El total difiere de la Tabla 1; verifíquese con el conjunto de datos final. | ||
| Sí | 122 (33,06) | 82 (46,86) | |||
| No | 247 (66,94) | 93 (53,14) | |||
| Hipoalbuminemia | 7,283 | 0,007 | |||
| Sí | 66 (17,89) | 49 (28,00) | |||
| No | 303 (82,11) | 126 (72,00) | |||
| Hiponatremia | 3,914 | 0,048 | |||
| Sí | 214 (57,99) | 117 (66,86) | |||
| No | 155 (42,01) | 58 (33,14) | |||
| Grado de Fisher modificado | 58,679 | <0,001 | |||
| ≥III | 134 (36,31) | 125 (71,43) | |||
| I–II | 235 (63,69) | 50 (28,57) | |||
| Grado Hunt-Hess | 39,909 | <0,001 | |||
| ≥III | 144 (39,02) | 119 (68,00) | |||
| I–II | 225 (60,98) | 56 (32,00) | |||
| Grado WFNS | 28,137 | <0,001 | |||
| ≥III | 159 (43,09) | 118 (67,43) | |||
| I–II | 210 (56,91) | 57 (32,57) | |||
| Enfoque quirúrgico | 0,691 | 0,406 | |||
| Tratamiento endovascular | 308 (83,47) | 141 (80,57) | |||
| Clipaje | 61 (16,53) | 34 (19,43) | |||
| Tiempo quirúrgico, h | 2,74 ± 0,82 | 2,85 ± 0,76 | 1,496 | 0,135 | |
| Hemorragia intraventricular | 0,163 | 0,687 | |||
| Sí | 89 (24,12) | 45 (25,71) | |||
| No | 280 (75,88) | 130 (74,29) | |||
| Rehemorragia | 1,168 | 0,280 | |||
| Sí | 71 (19,24) | 27 (15,43) | |||
| No | 298 (80,76) | 148 (84,57) |
Tabla 2: Características basales de los pacientes con y sin isquemia cerebral tardía en la cohorte de entrenamiento. Las variables continuas se presentan como media ± desviación estándar, y las variables categóricas como n (%). Los valores p comparan pacientes con y sin DCI. Abreviaturas: DCI, isquemia cerebral tardía; WFNS, Federación Mundial de Cirujanos Neurológicos. Haga clic aquí para descargar esta tabla.
Distribución de resultados en la cohorte de validación interna
En la cohorte de validación interna (n = 136), la isquemia cerebral tardía (DCI) ocurrió en 42 pacientes (30,9%), mientras que 94 pacientes (69,1%) no desarrollaron DCI. La prevalencia de los resultados fue comparable a la observada en el conjunto de datos de entrenamiento, lo que respalda la estabilidad de la distribución de eventos entre los conjuntos de datos.
Selección de características
La selección de predictores se realizó en la cohorte de entrenamiento mediante regresión LASSO con validación cruzada de 10 pliegues. El parámetro de penalización seleccionado fue λ = 0.031. Seis predictores conservaron coeficientes no nulos: edad, edema cerebral, hipoalbuminemia, grado de Fisher modificado, grado de Hunt-Hess y grado de WFNS. Todos los predictores seleccionados estaban disponibles antes del punto temporal previsto para la predicción. Figura 1A,B muestra las trayectorias de los coeficientes y la curva de validación cruzada utilizadas para la selección de predictores.
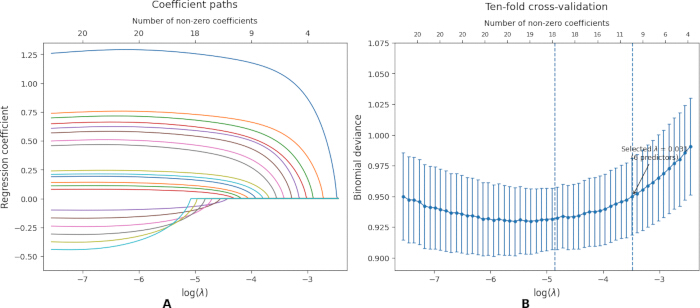
Figura 1: Selección basada en LASSO de predictores para la isquemia cerebral tardía tras hemorragia subaracnoidea aneurismática. (A) Trayectorias de los coeficientes de los predictores candidatos a través de los valores de log(λ). Cada curva representa un predictor candidato, y los números en el eje superior indican el número de coeficientes no nulos conservados en cada valor de penalización. (B) Curva de validación cruzada de diez pliegues para la desviación binomial. Los puntos indican la desviación media validada mediante validación cruzada, las barras de error indican los errores estándar, y las líneas verticales punteadas indican los valores de penalización con error mínimo y con un error estándar. El parámetro de penalización final seleccionado fue λ = 0.031. LASSO, operador de contracción y selección por norma L1; DCI, isquemia cerebral tardía. Haga clic aquí para ver una versión más grande de esta figura.
Desarrollo y evaluación del modelo
Los cinco modelos se desarrollaron utilizando los mismos seis predictores seleccionados. En la cohorte de validación interna, la regresión logística mostró un AUC de 0,832 (IC del 95 %, 0,758-0,906), SVM mostró un AUC de 0,811 (IC del 95 %, 0,729-0,893), XGBoost mostró un AUC de 0,777 (IC del 95 %, 0,690-0,864), LightGBM mostró un AUC de 0,755 (IC del 95 %, 0,672-0,838) y KNN mostró un AUC de 0,708 (IC del 95 %, 0,613-0,803) (Tabla 3).
| Conjunto de datos | Modelo | AUC | IC 95% | Precisión | Sensibilidad | Especificidad | Puntuación F1 | Nota de corrección |
| Entrenamiento | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| Entrenamiento | Regresión logística | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| Entrenamiento | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| Entrenamiento | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| Entrenamiento | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | La AUC de KNN se corrigió según la leyenda de la Figura 2 para que coincida con el valor de la tabla. |
| Validación | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| Validación | Regresión logística | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | Las métricas de clasificación se recalcularon a partir de la matriz de confusión de la Tabla 6. |
| Validación | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| Validación | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | Las métricas de clasificación se recalcularon a partir de la matriz de confusión de la Tabla 6. |
| Validación | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
Tabla 3: Rendimiento de discriminación y clasificación de los modelos de predicción en las cohortes de entrenamiento y validación interna. Los valores de AUC se informan con intervalos de confianza del 95 %. La exactitud, sensibilidad, especificidad y puntuación F1 se calcularon en el umbral de clasificación predeterminado. Abreviaturas: AUC, área bajo la curva característica de operación del receptor; CI, intervalo de confianza; KNN, k vecinos más cercanos; LightGBM, máquina ligera de incremento de gradiente; SVM, máquina de vectores de soporte; XGBoost, incremento extremo de gradiente. No se utilizaron medidas de clasificación dependientes del umbral como base principal para la comparación de modelos porque no se pudo verificar el umbral de probabilidad exacto utilizado en el análisis archivado. Haga clic aquí para descargar esta tabla.
Los intervalos de confianza se superpusieron, y la regresión logística no se interpretó como estadísticamente superior a los otros modelos. Se mantuvo la regresión logística como modelo principal porque proporcionó una discriminación interna estable y una estructura de modelo directamente interpretable. Los resultados representan el desempeño en una única cohorte interna de validación reservada y no constituyen una validación corregida por optimismo, temporal ni externa (Figura 2A–D).
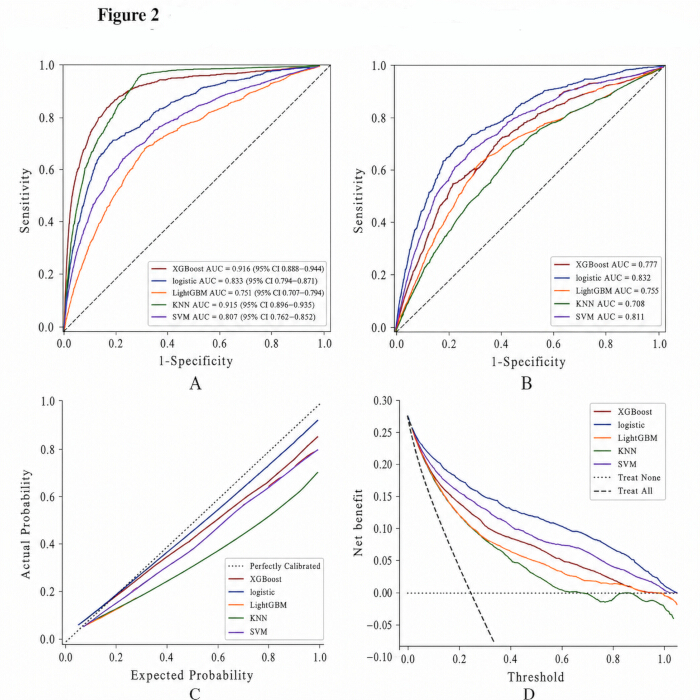
Figura 2: Desempeño de los modelos de predicción en cuanto a discriminación, calibración y curva de decisión.
(A) Curvas de característica operativa del receptor en la cohorte de entrenamiento. (B) Curvas de característica operativa del receptor en la cohorte de validación interna. Las etiquetas de las curvas muestran el área bajo la curva de característica operativa del receptor (AUC) con intervalos de confianza del 95 %. (C) Curvas de calibración que comparan las probabilidades predichas y observadas de isquemia cerebral tardía (DCI); la línea diagonal punteada indica una calibración perfecta. (D) Análisis de la curva de decisión que muestra el beneficio neto a través de las probabilidades umbral. La línea horizontal punteada representa la estrategia de no tratar a nadie, mientras que la línea de guiones representa la estrategia de tratar a todos. AUC, área bajo la curva de característica operativa del receptor; DCI, isquemia cerebral tardía; KNN, k vecinos más cercanos; LightGBM, máquina de incremento de gradiente ligera; SVM, máquina de vectores de soporte; XGBoost, incremento extremo de gradiente. Haga clic aquí para ver una versión más grande de esta figura.
Análisis exploratorio de curva de decisiones
Se realizó un análisis de curva de decisión como evaluación exploratoria del beneficio neto. Sin embargo, el rango exacto de probabilidad umbral preespecificado y los resultados individuales de beneficio neto por paciente no se conservaron en los registros archivados del análisis. Por consiguiente, los hallazgos del análisis de curva de decisión no pueden establecer la utilidad clínica ni definir un umbral de intervención clínicamente apropiado.
Cualquier ventaja aparente de beneficio neto frente a las estrategias de tratar a todos o tratar a ninguno debe interpretarse únicamente como un patrón preliminar dentro del conjunto de datos interno actual. Se requiere validación externa, selección prospectiva de umbrales, evaluación de las consecuencias clínicas y un estudio formal de impacto clínico antes de que el modelo pueda considerarse útil para las decisiones de manejo del paciente (Figura 3).
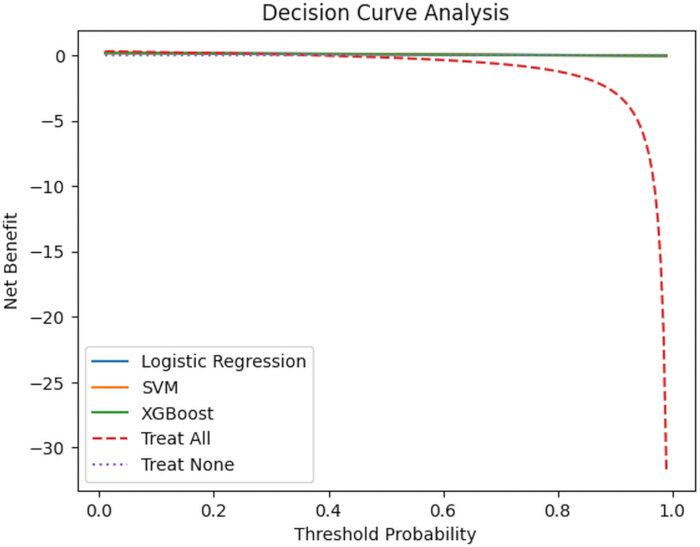
Figura 3: Análisis de curva de decisión de los modelos de predicción seleccionados en la cohorte de validación interna. El beneficio neto se representa frente a la probabilidad umbral para los modelos de regresión logística, SVM y XGBoost. La línea discontinua de "tratar a todos" representa la estrategia de monitorear a todos los pacientes, mientras que la línea punteada de "no tratar a ninguno" representa la estrategia de no monitorear a ningún paciente. Un modelo se considera clínicamente útil en aquellas probabilidades umbral donde su curva de beneficio neto se encuentra por encima de ambas estrategias de referencia. SVM, máquina de vectores de soporte; XGBoost, refuerzo de gradiente extremo. Haga clic aquí para ver una versión más grande de esta figura.
Modelo de regresión logística multivariable
El modelo final de regresión logística incluyó la edad, edema cerebral, hipoalbuminemia, grado de Fisher modificado, grado de Hunt-Hess y grado de la WFNS. Los coeficientes de regresión, las razones de momios, los intervalos de confianza del 95 % y los valores de P se presentan en Tabla 4La edad tuvo un coeficiente de 0,038, mientras que los coeficientes para edema cerebral, hipoalbuminemia, grado modificado de Fisher ≥ III, grado Hunt-Hess ≥ III y grado WFNS ≥ III fueron 0,842, 0,615, 1,274, 0,933 y 0,781, respectivamente.
| Predicción | Coeficiente β | Relación de momios (OR) | IC 95% | Valor P | Nota interpretativa |
| Intercepto | [insertar desde la salida del modelo final] | — | — | — | Requerido para el cálculo del riesgo a nivel individual del paciente. |
| Edad | 0.038 | 1.039 | 1.012–1.067 | 0.004 | Asociación predictiva únicamente; no causal. |
| Edema cerebral | 0.842 | 2.321 | 1.541–3.496 | <0.001 | Medido antes del diagnóstico de IDC. |
| Hipoalbuminemia | 0.615 | 1.85 | 1.206–2.837 | 0.005 | La albúmina más temprana disponible antes del punto de predicción. |
| Grado modificado de Fisher ≥III | 1.274 | 3.575 | 2.401–5.324 | <0.001 | Marcador de gravedad; interpretar con precaución por colinealidad. |
| Grado Hunt-Hess ≥III | 0.933 | 2.542 | 1.674–3.861 | <0.001 | Marcador de gravedad; interpretar con precaución por colinealidad. |
| Grado WFNS ≥III | 0.781 | 2.184 | 1.447–3.298 | <0.001 | Marcador de gravedad; interpretar con precaución por colinealidad. |
Tabla 4: Modelo final de regresión logística multivariable para predecir la isquemia cerebral tardía. Se muestran los coeficientes de regresión, las razones de momios, los intervalos de confianza del 95 % y los valores P para los predictores conservados tras la selección mediante LASSO. Todos los predictores se evaluaron antes del punto temporal previsto para la predicción. Abreviaturas: CI, intervalo de confianza; DCI, isquemia cerebral tardía; OR, razón de momios; WFNS, Federación Mundial de Cirujanos Neurológicos. El intercepto numérico de la regresión logística no estaba disponible en la salida archivada del modelo. Por lo tanto, los coeficientes informados no pueden utilizarse para calcular probabilidades predichas individuales. Los coeficientes representan asociaciones predictivas y no deben interpretarse como efectos causales independientes. Haga clic aquí para descargar esta tabla.
Estos coeficientes describen asociaciones predictivas dentro de la cohorte de desarrollo. No deben interpretarse como efectos causales independientes, ya que el grado de Fisher modificado, el grado de Hunt-Hess y el grado de la WFNS representan dimensiones superpuestas de la gravedad de la enfermedad, y no se dispuso de diagnósticos numéricos de colinealidad. Las variables se mantuvieron como componentes del modelo de predicción en lugar de factores de riesgo independientes confirmados.
Rendimiento de la calibración
La calibración se resumió en la cohorte de validación interna mediante estimaciones puntuales de la pendiente de calibración, el intercepto de calibración y la puntuación de Brier. La regresión logística tuvo una pendiente de calibración de 0,98, un intercepto de calibración de 0,02 y una puntuación de Brier de 0,168. Los valores correspondientes fueron 0,94, 0,05 y 0,182 para SVM; 0,88, 0,09 y 0,201 para XGBoost; 0,91, 0,07 y 0,194 para LightGBM; y 0,92, 0,06 y 0,190 para KNN (Tabla 5).
No se dispuso de intervalos de confianza bootstrap para estas medidas de calibración porque no se conservaron las probabilidades predichas individuales necesarias para el remuestreo en la salida de análisis archivada. Por lo tanto, los resultados de calibración se presentan como estimaciones puntuales preliminares dentro de la cohorte de validación interna y no deben interpretarse como evidencia de calibración en otras instituciones ni poblaciones de pacientes (Figura 4).
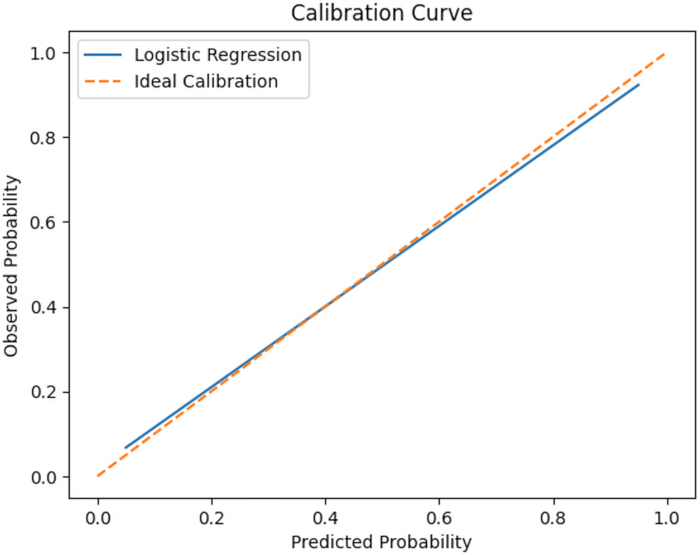
Figura 4: Calibración del modelo de regresión logística en la cohorte de validación interna. La línea continua muestra la relación entre las probabilidades predichas y observadas de isquemia cerebral tardía. La línea diagonal punteada representa una calibración perfecta; una mayor concordancia entre ambas líneas indica un mejor rendimiento de calibración. DCI, isquemia cerebral tardía. Haga clic aquí para ver una versión más grande de esta figura.
| Modelo | Pendiente de calibración | IC del 95 % para la pendiente de calibración | Intersección de calibración | IC del 95 % para la intersección de calibración | Puntuación de Brier | IC del 95 % para la puntuación de Brier | Nota de corrección |
| Regresión logística | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | Agregue los IC bootstrap del análisis final si están disponibles. |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
Tabla 5: Rendimiento de calibración de los modelos de predicción en la cohorte de validación interna. Una pendiente de calibración de 1,0 y un intercepto de calibración de 0 indican una calibración ideal. Puntuaciones de Brier más bajas indican una mayor precisión general de la predicción. Abreviaturas: KNN, vecino más cercano k; LightGBM, máquina ligera de impulso de gradiente; SVM, máquina de vectores de soporte; XGBoost, impulso extremo de gradiente. La pendiente de calibración, el intercepto de calibración y la puntuación de Brier se reportan como estimaciones puntuales. No se dispuso de intervalos de confianza por bootstrap. Estos resultados describen únicamente una calibración preliminar dentro de la cohorte de validación interna reservada. Haga clic aquí para descargar esta tabla.
Métricas derivadas de la matriz de confusión.
La matriz de confusión disponible para validación interna en la regresión logística contenía 30 verdaderos positivos, 80 verdaderos negativos, 14 falsos positivos y 12 falsos negativos. La exactitud recalculada fue de 0,809, la sensibilidad fue de 0,714, la especificidad fue de 0,851, el valor predictivo positivo fue de 0,682, el valor predictivo negativo fue de 0,870 y el puntaje F1 fue de 0,698.
Para SVM, la matriz de confusión contenía 29 verdaderos positivos, 77 verdaderos negativos, 17 falsos positivos y 13 falsos negativos. La exactitud recalculada fue de 0,779, la sensibilidad fue de 0,690, la especificidad fue de 0,819, el valor predictivo positivo fue de 0,630, el valor predictivo negativo fue de 0,856 y el puntaje F1 fue de 0,659 (Tabla 6).
| Métrica | Regresión logística | SVM | Nota del cálculo |
| Verdaderos positivos | 30 | 29 | Cohorte de validación |
| Verdaderos negativos | 80 | 77 | Cohorte de validación |
| Falsos positivos | 14 | 17 | Cohorte de validación |
| Falsos negativos | 12 | 13 | Cohorte de validación |
| Precisión | 0.809 | 0.779 | (VP + VN) / total |
| Sensibilidad | 0.714 | 0.69 | VP / (VP + FN) |
| Especificidad | 0.851 | 0.819 | VN / (VN + FP) |
| Valor predictivo positivo | 0.682 | 0.63 | VP / (VP + FP) |
| Valor predictivo negativo | 0.87 | 0.856 | VN / (VN + FN) |
| Puntuación F1 | 0.698 | 0.659 | 2VP / (2VP + FP + FN) |
Tabla 6: Medidas de desempeño derivadas de la matriz de confusión para la regresión logística y la SVM en la cohorte de validación interna. Las métricas se calcularon a partir de las matrices de confusión archivadas; sin embargo, el umbral exacto no se conservó. Indique el umbral exacto en la nota al pie de la tabla. Abreviaturas: NPV, valor predictivo negativo; PPV, valor predictivo positivo; SVM, máquina de vectores de soporte. Las matrices de confusión se obtuvieron de la cohorte de validación interna. La precisión, sensibilidad, especificidad, valor predictivo positivo, valor predictivo negativo y puntuación F1 recalculados para la regresión logística fueron 0,809, 0,714, 0,851, 0,682, 0,870 y 0,698, respectivamente. Los valores correspondientes para la SVM fueron 0,779, 0,690, 0,819, 0,630, 0,856 y 0,659. El umbral exacto de clasificación utilizado en el análisis original no se conservó y debe verificarse antes de la presentación final. Haga clic aquí para descargar esta tabla.
Estos valores se recalcularon directamente a partir de las mismas matrices de confusión para garantizar la coherencia numérica. Sin embargo, no se conservó el umbral de probabilidad exacto utilizado en el análisis de clasificación original. Por lo tanto, las medidas dependientes del umbral se informan de forma descriptiva y no deben utilizarse como base principal para la comparación de modelos hasta que el umbral se verifique a partir del código original del análisis (Tabla 7).
| Subgrupo | AUC (Regresión logística) |
| Edad ≥65 años | 0.821 |
| Edad <65 años | 0.836 |
| Índice de Fisher modificado ≥III | 0.844 |
| Índice de Fisher modificado I–II | 0.801 |
| Clipaje | 0.825 |
| Tratamiento endovascular | 0.835 |
Tabla 7: Análisis exploratorio de discriminación por subgrupos del modelo de regresión logística. Se informan los valores de AUC según edad, grado de Fisher modificado y subgrupo de tratamiento. Estos análisis son exploratorios y no deben interpretarse como evidencia de la generalización del modelo. Agregue el tamaño muestral del subgrupo, el número de eventos de ICM y el intervalo de confianza del 95 % para cada subgrupo.
Abreviaturas: AUC, área bajo la curva característica de operación del receptor; DCI, isquemia cerebral tardía. Haga clic aquí para descargar esta tabla.
Evaluación exploratoria de subgrupos
La salida del subgrupo archivado contenía estimaciones puntuales de AUC según la edad, el grado de Fisher modificado y el enfoque de tratamiento. Sin embargo, no estaban disponibles los tamaños muestrales de los subgrupos, los conteos de eventos de ICD por subgrupo, los intervalos de confianza del 95 % ni las pruebas formales de interacción o heterogeneidad. Por lo tanto, los hallazgos por subgrupos se consideraron incompletos y exploratorios. No se utilizaron para afirmar que el rendimiento del modelo fuera robusto, consistente o generalizable entre los subgrupos de pacientes.
Rendimiento en la estratificación de riesgo
La salida archivada de estratificación de riesgo informó porcentajes observados de ICD del 10,2 %, 33,6 % y 69,1 % para las categorías propuestas de bajo, intermedio y alto riesgo. Sin embargo, no estaban disponibles los denominadores de grupo correspondientes, los conteos de eventos de ICD, los intervalos de confianza ni una justificación clínica o estadística preespecificada para los puntos de corte de probabilidad. Por lo tanto, el análisis se consideró exploratorio y no se utilizó para respaldar afirmaciones de separación de riesgo validada ni aplicabilidad clínica (Tabla 8).
| Categoría de riesgo | Rango de probabilidad | Incidencia observada de ICD |
| Bajo riesgo | <0.20 | 10.2% |
| Riesgo intermedio | 0.20–0.50 | 33.6% |
| Alto riesgo | >0.50 | 69.1% |
Tabla 8: Incidencia observada de isquemia cerebral tardía según las categorías de riesgo derivadas del modelo en la cohorte de validación interna. Las categorías de riesgo se definieron utilizando las probabilidades predichas a partir del modelo final de regresión logística. Haga clic aquí para descargar esta tabla.
Modelo final de regresión logística
La salida de regresión archivada contenía los coeficientes para los seis predictores seleccionados, pero no incluía la intersección numérica del modelo. Dado que se requiere la intersección para calcular una probabilidad predicha individual, no pudo reportarse una ecuación de predicción completa a nivel individual. Por lo tanto, se eliminó la ecuación incompleta en lugar de completarla con un valor asumido o reconstruido.
Los coeficientes presentados en la Tabla 4 pueden utilizarse para describir la dirección y la magnitud relativa de las asociaciones de los predictores dentro del modelo ajustado, pero no deben usarse para calcular probabilidades de IAC a nivel individual del paciente. Una ecuación de predicción completa solo puede proporcionarse después de recuperar la intersección del modelo ajustado original o regenerarla mediante el reanálisis del conjunto de datos auténtico a nivel individual del paciente.
Logit(DCI) = [intercepto] + 0,038 × edad + 0,842 × edema cerebral + 0,615 × hipoalbuminemia + 1,274 × grado modificado de Fisher ≥III + 0,933 × grado Hunt-Hess ≥III + 0,781 × grado de la Federación Mundial de Cirujanos Neurológicos ≥III.
La probabilidad predicha de IVC se calculó como:
P(DCI) = 1 / [1 + exp(−Logit)].
Los predictores binarios se codificaron como 1 cuando la condición estaba presente y como 0 cuando estaba ausente. La escala modificada de Fisher ≥III, la escala de Hunt-Hess ≥III y la escala de la Federación Mundial de Neurocirujanos ≥III se codificaron como 1 cuando el paciente cumplía con el umbral y como 0 en caso contrario. No se informa la intersección porque es necesaria para el cálculo de la probabilidad a nivel individual del paciente. Esta ecuación debe utilizarse únicamente para la interpretación de investigaciones hasta que se complete la validación externa y la recalibración.
La escala modificada de Fisher, la escala de Hunt-Hess y la escala de la Federación Mundial de Cirujanos Neurológicos reflejan todas la gravedad de la enfermedad y pueden solaparse parcialmente en su significado clínico. Debido a que no estaban disponibles diagnósticos de colinealidad numérica ni un modelo de sensibilidad completo que excluyera escalas de gravedad superpuestas, el manuscrito no interpreta estas variables como predictores causales independientes. Se mantienen únicamente como componentes de un modelo de predicción seleccionado en la cohorte de entrenamiento. Esta limitación reduce la confianza en la contribución independiente de cada escala de gravedad y debería abordarse en futuros estudios de validación externa.
DISPONIBILIDAD DE LOS DATOS:
El conjunto completo de datos hospitalarios a nivel de paciente no está disponible públicamente porque contiene información clínica sensible y está sujeto a requisitos institucionales de ética y protección de datos. El Comité de Ética Institucional del Hospital Yulin First puede considerar el acceso a un conjunto de datos analíticos desidentificados tras la presentación de una propuesta de investigación justificada metodológicamente, evidencia de aprobación ética y un acuerdo adecuado de uso de datos. El conjunto de datos compartido excluye nombres, números de identificación hospitalaria, fechas exactas, información de contacto y otros identificadores directos o indirectos. Se proporciona un diccionario de variables verificado, scripts de análisis, Tabla Suplementaria 1 que describe la información sobre el desarrollo y la reproducibilidad del modelo, y Tabla Suplementaria 2 que informa sobre la ausencia específica de variables, según lo permitido por la política institucional. Los conjuntos de datos de demostración o sintéticos no representan los datos originales del estudio clínico.
Tabla suplementaria 1: Detalles de reproducibilidad y parámetros finales para el desarrollo del modelo. Esta tabla informa la semilla aleatoria, el software y las versiones de los paquetes, los pasos de preprocesamiento, el procedimiento de imputación, el enfoque de validación cruzada, la cuadrícula de ajuste y los parámetros finales para XGBoost, LightGBM, SVM y KNN.Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Resumen de datos faltantes y estrategia de manejo para los predictores candidatos. Para cada predictor candidato, se informa el número y porcentaje de observaciones faltantes, el método de imputación y si la variable se mantuvo para el análisis.Haga clic aquí para descargar este archivo.
Discusión
Este estudio desarrolló y validó internamente un modelo de predicción para la isquemia cerebral tardía (DCI) después de la hemorragia subaracnoidea aneurismática (aSAH) utilizando variables clínicas, de laboratorio y de imagen tempranas. Se mantuvieron seis variables tras la selección de predictores: edad, edema cerebral, hipoalbuminemia, grado modificado de Fisher, grado de Hunt-Hess y grado de la Federación Mundial de Neurocirujanos. Entre los modelos evaluados, la regresión logística mostró una discriminación interna estable y una calibración aceptable. Dado que la cohorte de validación se obtuvo del mismo centro y período que la cohorte de entrenamiento, los resultados deben interpretarse únicamente como una validación interna preliminar.
Los predictores seleccionados son clínicamente plausibles en el contexto de la HSA. Un grado de Fisher modificado más alto refleja una mayor carga hemorrágica, mientras que los grados Hunt-Hess y WFNS describen la gravedad neurológica al momento de la presentación14,15. El edema cerebral puede representar una lesión cerebral temprana, mientras que la edad avanzada puede indicar una reserva fisiológica reducida. La hipoalbuminemia puede reflejar enfermedad sistémica, inflamación, estado nutricional o vulnerabilidad endotelial19,20. Sin embargo, estas asociaciones se identificaron con fines predictivos y no deben interpretarse como causales. Además, los grados de Fisher modificado, Hunt-Hess y WFNS miden aspectos relacionados de la gravedad de la enfermedad. Dado que no estaban disponibles los valores de FIV ni los análisis numéricos de sensibilidad, no pudo establecerse la contribución independiente de cada escala de clasificación.
Métodos más complejos de aprendizaje automático no mostraron una ventaja clara frente a la regresión logística en la cohorte de validación interna con datos reservados. La regresión logística mostró el AUC de validación más alto, pero los intervalos de confianza se superpusieron con los de los otros modelos. Los algoritmos complejos pueden capturar patrones no lineales, pero también podrían sobreajustar cuando el conjunto de predictores es pequeño y los datos provienen de un único centro. Por lo tanto, se mantuvo la regresión logística como modelo principal debido a su interpretabilidad y discriminación interna estable. Sin embargo, la falta de registros completos de hiperparámetros y versiones de software limita la reproducibilidad de las comparaciones de aprendizaje automático.
El modelo actual no tiene un papel clínico establecido. Aunque un riesgo estimado más alto podría teóricamente justificar una observación neurológica más estrecha o una revisión especializada más temprana, actualmente no es posible calcular probabilidades a nivel del paciente porque no se dispone del intercepto del modelo. Además, el rango de umbral de la curva de decisión, el desempeño por subgrupos y los resultados por categorías de riesgo no fueron documentados completamente. Por lo tanto, el modelo no debe utilizarse como un instrumento diagnóstico independiente, una regla de monitoreo ni como base para decisiones terapéuticas. Se requiere la reconstrucción completa del modelo, su validación externa, recalibración y evaluación prospectiva de su impacto clínico antes de que pueda considerarse su implementación.
Este estudio tiene varias limitaciones. En primer lugar, fue retrospectivo y se realizó en un solo centro, lo que limita su generalización. En segundo lugar, el rendimiento del modelo se evaluó utilizando una división de exclusión estratificada por resultado de 8:2 única. No estuvieron disponibles la corrección de optimismo mediante bootstrap, la validación repetida por k particiones, la validación temporal ni la validación externa. En tercer lugar, no se conservaron la semilla aleatoria original, los hiperparámetros finales del aprendizaje automático, las cuadrículas de ajuste, el procedimiento para el desequilibrio de clases ni las versiones completas de los paquetes de software, lo que limita la reproducibilidad computacional. En cuarto lugar, no se disponía del intercepto numérico de la regresión logística, impidiendo así el cálculo de las probabilidades predichas individuales. En quinto lugar, la escala modificada de Fisher, la escala de Hunt-Hess y la escala de WFNS son medidas de gravedad relacionadas, mientras que no estuvieron disponibles los diagnósticos de VIF ni los análisis numéricos de sensibilidad, excluyendo escalas superpuestas. En sexto lugar, no se calcularon los intervalos de confianza para la pendiente de calibración, el intercepto de calibración ni la puntuación de Brier. En séptimo lugar, no pudo verificarse el umbral exacto de clasificación ni el rango de umbral del análisis de decisión clínica (DCA). En octavo lugar, los análisis de subgrupos y de estratificación de riesgo carecieron de denominadores completos, recuentos de eventos, intervalos de confianza y pruebas formales de interacción. En noveno lugar, no se conservó el patrón original de ausencia de datos específico por variable. Finalmente, se excluyeron las muertes tempranas en el hospital, lo que podría haber introducido un sesgo de supervivencia. Estas limitaciones implican que el modelo debe considerarse preliminar y que no debe utilizarse para la toma de decisiones clínicas antes de un reanálisis completo y una validación externa independiente.
Este estudio desarrolló y evaluó modelos de predicción de ICD tras aSAH utilizando variables clínicas, de laboratorio y de imágenes obtenidas tempranamente21. Se conservaron seis predictores tras la selección mediante LASSO: edad, edema cerebral, hipoalbuminemia, grado de Fisher modificado, grado de Hunt-Hess y grado de WFNS22,23,24,25,26,27,28,29. La regresión logística alcanzó un AUC de 0,832 (IC del 95 %) en la cohorte de validación interna reservada y produjo una estructura de modelo interpretable29,30. Sin embargo, el análisis dependió de una única división interna, y no se dispuso de validación completa basada en remuestreo, validación externa ni información sobre reproducibilidad computacional. Por lo tanto, los hallazgos deben interpretarse como resultados preliminares del desarrollo de un modelo, más que como evidencia de una herramienta de predicción clínicamente validada.
Este estudio retrospectivo de un solo centro desarrolló y evaluó modelos predictivos para la isquemia cerebral tardía (DCI) después de la hemorragia subaracnoidea aneurismática (aSAH), utilizando seis variables clínicas, de laboratorio y de imágenes tempranas. La regresión logística mostró una discriminación preliminar en una única cohorte de validación interna de reserva y produjo una estructura de modelo interpretable31,32,33,34. Sin embargo, registros incompletos de reproducibilidad, la ausencia de un intercepto numérico, la falta de validación basada en remuestreo, una evaluación incompleta de la incertidumbre y la ausencia de validación externa impiden el cálculo de probabilidades a nivel individual del paciente y su uso clínico. Se requiere un nuevo análisis utilizando el conjunto de datos auténtico a nivel de paciente, la presentación completa de los parámetros de desarrollo del modelo y una validación independiente multicéntrica.
Agradecimientos
Los autores reconocen el apoyo del personal de historias clínicas del Hospital Primero de Yulin en la recuperación de datos clínicos anonimizados. Estos miembros del personal no participaron en el diseño del estudio, la adjudicación de resultados, la modelización estadística, la interpretación de los resultados, la elaboración del manuscrito ni la aprobación del manuscrito final, y por lo tanto no cumplen los criterios para autoría.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Sistema electrónico de historias médicas | Yulin First Hospital | No aplicable | Origen de los datos clínicos retrospectivos; la plataforma comercial exacta no se conservó en los registros archivados. |
| IBM SPSS Statistics | IBM Corporation | Versión 25.0 | Análisis estadístico descriptivo e inferencial. |
| Implementación de k-vecinos más cercanos | Paquete/fuente no conservado | No disponible | Modelo exploratorio de aprendizaje automático; el paquete y la versión exactos deben recuperarse del entorno de código original. |
| LightGBM | Microsoft / proyecto de código abierto | Versión no disponible | Modelo exploratorio de aumento de gradiente; no se conservaron la versión exacta del paquete ni los hiperparámetros. |
| Software estadístico R | Foundation R para la Computación Estadística | Versión 4.3.2 | Modelado estadístico y evaluación interna del desempeño. |
| Implementación de máquina de vectores de soporte | Paquete/fuente no conservado | No disponible | Modelo exploratorio de aprendizaje automático; no se conservaron el paquete exacto, la configuración del kernel ni la versión. |
| XGBoost | Proyecto de código abierto | Versión no disponible | Modelo exploratorio de aumento de gradiente; no se conservaron la versión exacta del paquete ni los hiperparámetros. |
Referencias
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.