Este estudio presenta una tubería bioinformática reproducible que integra transcriptómica, aprendizaje automático y análisis de infiltración inmunitaria para identificar posibles biomarcadores diagnósticos y redes reguladoras en la enfermedad pulmonar obstructiva crónica (COPD).
Artículo de investigación
UPP1 como biomarcador diagnóstico: perspectivas a partir de análisis integrativos de bioinformática e infiltración inmunitaria en la EPOC
* These authors contributed equally
En este artículo
Resumen
Resumen
La EPOC es un trastorno respiratorio progresivo caracterizado por una limitación persistente del flujo de aire y una inflamación crónica, aunque el papel de la modificación del ARN por N4-acetilcitidina (ac4C) en su patogénesis sigue siendo poco explorado. Este estudio tuvo como objetivo realizar un cribado sistemático de genes relacionados con ac4C (ac4C-RGs) a partir de una base de datos publicada e investigar sus redes reguladoras en la EPOC, identificando así posibles biomarcadores para estudios mecanicistas posteriores, sin asumir una relación reguladora directa entre ningún gen específico y la modificación por ac4C. Se identificaron genes diferencialmente expresados (DEGs) a partir de perfiles transcriptómicos, y se aplicó un análisis de red de coexpresión génica ponderada (WGCNA) para descubrir módulos clave de coexpresión. Se realizó un análisis cruzado entre DEGs, módulos significativos y ac4C-RGs. Los genes clave se seleccionaron mediante regresión LASSO, algoritmos XGBoost y bosque aleatorio, seguido de la construcción de un modelo diagnóstico basado en regresión logística. El rendimiento del modelo se evaluó mediante análisis de la curva ROC (característica operativa del receptor), área bajo la curva (AUC) con intervalos de confianza del 95 %, evaluación de la curva de calibración y análisis de la curva de decisión (DCA). Se identificaron 160 genes superpuestos, y seis genes centrales (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B y B4GALT2) fueron seleccionados consistentemente por los tres algoritmos de aprendizaje automático. El modelo diagnóstico mostró un buen rendimiento discriminativo, con valores de AUC de 0,766, 0,759 y 0,723 en los conjuntos de entrenamiento, prueba interna y validación externa, respectivamente. El análisis de la red reguladora sugirió posibles ejes ceRNA e interacciones con factores de transcripción, mientras que el perfilado de infiltración inmunitaria reveló correlaciones significativas entre los genes clave y múltiples subconjuntos de células inmunitarias. El análisis de interacciones fármaco-gen y el acoplamiento molecular indicaron que el fluorouracilo, la capecitabina y la 5-bencilacilouridina podrían presentar afinidades de unión predichas favorables con UPP1. En conclusión, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B y B4GALT2 se identificaron como posibles biomarcadores relacionados con ac4C en la EPOC, posiblemente implicados en la regulación inmunitaria y metabólica, lo que proporciona una base para futuras investigaciones funcionales y exploraciones terapéuticas.
Introducción
La EPOC es un trastorno respiratorio crónico y heterogéneo caracterizado por una limitación progresiva del flujo de aire resultante de anomalías en las estructuras alveolares y de las vías respiratorias1,2. Un desequilibrio entre proteasas y antiproteasas, el estrés oxidativo, la inflamación crónica y la senescencia celular constituyen los mecanismos fisiopatológicos fundamentales de la EPOC, que conducen a la destrucción estructural y al deterioro funcional del tejido pulmonar3,4. Además, la EPOC está influenciada por múltiples factores de riesgo, incluyendo el tabaquismo prolongado, la contaminación ambiental, la exposición ocupacional, las infecciones respiratorias y la susceptibilidad genética5,6. La EPOC ha impuesto una carga significativa sobre la economía global. Se proyecta que represente el 0,111 % del PIB mundial anualmente entre 2020 y 20507. Aunque las estrategias terapéuticas actuales, como los broncodilatadores, los corticosteroides inhalados, la rehabilitación pulmonar y la oxigenoterapia a largo plazo, pueden aliviar los síntomas, detener la progresión de la enfermedad sigue siendo un desafío. Debido a la marcada heterogeneidad clínica, los resultados en los pacientes varían ampliamente8. Por lo tanto, se necesitan con urgencia nuevos biomarcadores diagnósticos e indicadores pronósticos para mejorar el manejo de la EPOC y aumentar la supervivencia de los pacientes.
La modificación del ARN se refiere a la alteración química de las moléculas de ARN, lo que puede cambiar la estructura y función del ARN para regular la expresión génica9,10. Las modificaciones comunes del ARN incluyen la N6-metiladenosina (m6A), la pseudouridina (Ψ), la 5-metilcitosina (m5C) y la ac4C11. La modificación ac4C desempeña un papel crucial en la preservación de la estabilidad del ARNm y en la promoción de su traducción12,13. NAT10 es la única enzima eucariota conocida que cataliza la modificación ac4C, y su actividad es esencial para la formación de esta modificación14. Estudios han demostrado una fuerte correlación entre el estrés oxidativo, la senescencia celular, la inflamación y la modificación ac4C. Por ejemplo, los linfocitos T CD4+ en tejidos del colon de individuos con enfermedad inflamatoria intestinal (EII) presentan niveles marcadamente elevados de NAT1015. NAT10 potencia la acetilación ac4C de las quimiocinas CCL2 y CXCL1, promoviendo así la infiltración de macrófagos y neutrófilos y exacerbando el daño inflamatorio16. La respuesta celular al estrés oxidativo podría implicar la modificación ac4C, como lo demuestra el aumento notable de los niveles de ac4C bajo estrés oxidativo. Además, NAT10 promueve la fibrosis pulmonar inducida por PM2.5 al estabilizar el ARNm de TGFB1 mediante la modificación ac4C, desencadenando así la transición epitelial-mesenquimatosa17. Sin embargo, el papel de la modificación ac4C en la EPOC sigue siendo poco explorado, lo que resalta la necesidad de investigaciones adicionales en este campo.
La base de datos GEO se utilizó en este estudio para identificar genes diferencialmente expresados (DEG) entre pacientes con EPOC y controles. A continuación, se integró una lista publicada de genes reguladores de ac4C, compilada a partir de datos multiómicos18, con los DEG para identificar candidatos superpuestos. Dado que se sabe que la modificación ac4C influye en la inflamación y el estrés oxidativo—procesos clave en la EPOC—, se planteó la hipótesis de que los genes asociados con la red reguladora de ac4C podrían estar desregulados en la EPOC. Sin embargo, los genes superpuestos no se consideraron sustratos directos de NAT10 ni genes regulados directamente por ac4C; más bien, se consideraron candidatos asociados con la red relacionada con ac4C. Los genes clave se seleccionaron mediante múltiples algoritmos de aprendizaje automático, seguido de la construcción y validación de un modelo diagnóstico. Posteriormente, se determinaron las vías relevantes implicadas en la patogénesis de la EPOC y se predijeron fármacos potencialmente dirigidos. Finalmente, se realizaron ensayos de RT-qPCR para confirmar los niveles de expresión de los genes clave, proporcionando así una visión preliminar de la fisiopatología de la EPOC y posibles vías para la exploración terapéutica.
Protocolo
Declaración del comité de revisión institucional
Este estudio se realizó de acuerdo con la Declaración de Helsinki. El protocolo fue aprobado por el Comité de Ética del Hospital Luohu de Medicina Tradicional China de Shenzhen (número de aprobación: 2024-LHQZYYYXLL-KY-039), y se obtuvo el consentimiento informado por escrito de todos los participantes antes de su inclusión. Los detalles de las herramientas y materiales de investigación utilizados en este protocolo se proporcionan en la Tabla de Materiales.
Origen y procesamiento de los datos
Los conjuntos de datos de expresión génica relacionados con la EPOC se obtuvieron del Gene Expression Omnibus (GEO). El conjunto de datos GSE54837 se utilizó como el conjunto de datos del transcriptoma, y el conjunto de datos GSE112811 sirvió como conjunto de validación (Tabla 1). Los genes relacionados con ac4C (ac4C-RGs) se recopilaron de la literatura18. Los genes diferencialmente expresados (DEG) entre los grupos de EPOC y control se identificaron utilizando el paquete limma de R. Se consideró que los DEG eran estadísticamente significativos si |log2FC| > 0 y p < 0,05. Se generaron gráficos de volcan para visualizar la distribución general de los cambios en la expresión génica.
Construcción de WGCNA
Se realizó un análisis de WGCNA sobre el conjunto de datos GSE54837 utilizando R para identificar módulos relacionados con la EPOC. Antes de la construcción de la red, se identificaron y eliminaron muestras atípicas mediante un análisis de agrupamiento jerárquico utilizando la función hclust con el método de enlace promedio y una métrica de distancia euclidiana. Se seleccionó la potencia óptima de umbralización suave (β = 10) para alcanzar un índice de ajuste a una topología libre de escala R2 ≥ 0,85, equilibrando la topología libre de escala y la conectividad media. Se construyó una matriz de adyacencia y se transformó en una matriz de superposición topológica (TOM). Los módulos génicos se identificaron utilizando el algoritmo dinámico de corte de árboles (deepSplit = 2, minClusterSize = 50). Posteriormente, los módulos con correlaciones de eigengenos > 0,75 se fusionaron utilizando la función mergeCloseModules. Luego, los eigengenos de los módulos se correlacionaron con rasgos clínicos (estado de EPOC, edad, sexo y estado de tabaquismo) mediante coeficientes de correlación de Pearson para identificar módulos asociados a la EPOC destinados a análisis posteriores.
Selección, análisis de enriquecimiento y análisis de la red PPI de genes superpuestos
Se generó un diagrama de Venn utilizando el paquete de R ggvenn para identificar los genes que se superponen entre los DEG, los genes del módulo MEsalmon y los ac4C-RG. Se realizó un análisis de enriquecimiento funcional de los genes superpuestos utilizando las bases de datos Gene Ontology (GO) y Kyoto Encyclopedia of Genes and Genomes (KEGG) con el paquete de R clusterProfiler. Se obtuvo información sobre interacciones proteína-proteína (PPI) a partir de la base de datos STRING (https://string-db.org/) para analizar las interacciones a nivel de proteínas entre los genes superpuestos. El software Cytoscape se utilizó para visualizar la red PPI resultante.
Identificación de genes clave mediante aprendizaje automático
Se aplicaron tres técnicas de aprendizaje automático: regresión con operador de contracción y selección por mínima absoluta (LASSO), potenciación extrema del gradiente (XGBoost) y bosque aleatorio (RF). La regresión LASSO se implementó utilizando el paquete glmnet con validación cruzada de 10 pliegues para determinar el parámetro óptimo de penalización λ. El parámetro type.measure se estableció en «deviance», y el parámetro family se fijó en «binomial». Se seleccionó el valor óptimo de λ mediante el criterio λmin, que minimiza la desviación validada mediante cross-validation, obteniendo 17 genes. XGBoost se realizó utilizando el paquete xgboost con los siguientes hiperparámetros: nrounds = 100, max_depth = 6, eta = 0.3, subsample = 0.8, colsample_bytree = 0.8, y eval_metric = «logloss». La importancia de las características se clasificó según la métrica de ganancia, y se seleccionaron los 30 genes principales. El bosque aleatorio se implementó utilizando el paquete randomForest con ntree = 200. La importancia de las características se ordenó por la disminución media del índice de Gini, y se seleccionaron los 30 genes principales. Los genes seleccionados por los tres métodos de aprendizaje automático se intersectaron para identificar los genes clave para los análisis posteriores.
Construcción y evaluación del modelo de regresión logística para la predicción de riesgo
El conjunto de datos GSE54837 se dividió aleatoriamente en un conjunto de entrenamiento (70 %) y un conjunto de prueba (30 %). Se construyó un modelo de regresión logística sobre el conjunto de entrenamiento utilizando la función glm del paquete MASS, con los niveles de expresión de los genes clave como características de entrada. El rendimiento del modelo se evaluó mediante curvas ROC generadas con el paquete pROC. Los intervalos de confianza del 95 % para el AUC se calcularon mediante 2.000 réplicas bootstrap. La calibración del modelo se evaluó utilizando curvas de calibración generadas con 1.000 remuestras bootstrap (paquete rms). Se realizó un DCA utilizando el paquete dca para evaluar el beneficio clínico neto a lo largo de un rango de probabilidades umbral. Se construyó un nomograma utilizando la función nomogram del paquete rms para facilitar la estimación individualizada del riesgo.
La ecuación de regresión fue:
logit(P) = 0,5823 + 0,6010 × UPP1 - 0,6563 × PTRF + 0,3853 × B4GALT2 - 0,3972 × FAM168B + 0,1848 × PRKCDBP - 0,4787 × TOR3A. (1)
Aquí, P representa la probabilidad predicha de EPOC, y cada coeficiente representa la contribución del valor correspondiente de expresión génica a las probabilidades logarítmicas de EPOC.
Análisis de expresión, red GeneMANIA y red reguladora molecular
Los niveles de expresión génica entre los grupos con EPOC y control en el conjunto de datos GSE54837 se compararon utilizando la prueba de suma de rangos de Wilcoxon. Se generaron gráficos de caja mediante el paquete ggplot2 para visualizar la distribución de los niveles de expresión, con la mediana, el rango intercuartílico (RIC) y los puntos de datos individuales superpuestos. Se utilizó GeneMANIA para construir redes génicas y predecir interacciones funcionales. La búsqueda se realizó con parámetros predeterminados: especie = Homo sapiens, número máximo de genes relacionados = 20. La red resultante se descargó y visualizó, con colores de los enlaces que indicaban los tipos de interacción. Se construyó una red de ARN endógeno competitivo (ceARN) para investigar los mecanismos reguladores postranscripcionales. Las miARN que dianan los seis genes clave se predijeron utilizando dos bases de datos independientes: DIANA-microT (puntuación ≥ 0,8) y miRanda (puntuación ≥ 140, energía ≤ −20 kcal/mol). Se utilizó la intersección de las miARN identificadas por ambas bases de datos para construir pares miARN-mARN. Posteriormente, se predijeron las lncARN que dianan estas miARN mediante la base de datos StarBase. Se construyó y visualizó una red reguladora lncARN-miARN-mARN utilizando Cytoscape. Las relaciones reguladoras transcripcionales se predijeron mediante el análisis de enriquecimiento ChIP-X versión 3 (ChEA3). Para cada gen clave con factores de transcripción predichos, se seleccionaron los 10 principales factores de transcripción con las puntuaciones de enriquecimiento más altas. Se construyó una red reguladora factor de transcripción-diana en Cytoscape.
Análisis de enriquecimiento de conjuntos de genes y evaluación de la infiltración de células inmunitarias
Se realizó un análisis de enriquecimiento de conjuntos de genes (GSEA) utilizando el paquete clusterProfiler para investigar las funciones biológicas de cada gen clave. Para cada gen clave, las muestras se dividieron en grupos de expresión alta y baja según el valor mediano. Se realizó un análisis de expresión diferencial entre los dos grupos utilizando limma, y la lista de genes resultante se ordenó según el cambio en el log₂ con signo. El GSEA se llevó a cabo utilizando la función gseGO para los términos del proceso biológico de GO y la función gseKEGG para las vías de KEGG, con los siguientes parámetros: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05 y nPerm = 1.000. La abundancia relativa de 28 tipos de células inmunitarias se estimó mediante el análisis de enriquecimiento de conjuntos de genes a partir de una única muestra (ssGSEA) implementado en el paquete GSVA. Se obtuvo de estudios previos una matriz de firmas de conjuntos de genes curada que comprende genes marcadores para 28 tipos de células inmunitarias19. Para cada muestra, se aplicó la función gsva con method = "ssgsea", ssgsea.norm = TRUE y kcdf = "Gaussian". Se calcularon los coeficientes de correlación de Spearman entre las puntuaciones de enriquecimiento de ssGSEA y los niveles de expresión de los seis genes clave utilizando la función cor.test. Los valores de p se ajustaron para pruebas múltiples mediante el método de Benjamini-Hochberg. La matriz de correlación se visualizó como un mapa de calor utilizando el paquete pheatmap.
Predicción de fármacos, acoplamiento molecular y análisis de asociación con enfermedades
Se identificaron compuestos terapéuticos potenciales que se dirigen a genes clave utilizando la base de datos DrugBank. Se construyó una red de interacciones «fármaco-dirigido a gen clave» en Cytoscape para visualizar las interacciones predichas entre fármacos y genes. Se realizó el acoplamiento molecular utilizando la plataforma CB-Dock2 para evaluar las afinidades de unión. La estructura tridimensional de la proteína humana UPP1 se obtuvo del Protein Data Bank (PDB ID: 7B8T). Las estructuras moleculares de los fármacos (formato SMILES) se obtuvieron de PubChem. El acoplamiento se realizó utilizando el motor AutoDock Vina, y los resultados se clasificaron según la energía libre de unión (ΔG, en kcal/mol). Los complejos de acoplamiento se visualizaron utilizando PyMOL. Se investigaron las asociaciones entre los genes clave y enfermedades humanas relacionadas con exposiciones ambientales utilizando la base de datos Comparative Toxicogenomics Database (CTD). Cada gen se consultó individualmente, y se extrajeron las diez enfermedades con mayor asociación, las cuales se visualizaron mediante gráficos de radar.
Protocolo de RT-qPCR
Se recogieron muestras de sangre venosa periférica de ocho pacientes con EPOC y ocho controles sanos en el Hospital Shenzhen Luohu de Medicina Tradicional China. El EPOC se diagnosticó según los criterios de la Iniciativa Global para la Enfermedad Pulmonar Obstructiva Crónica (GOLD), definido como una relación VEF1/CVF postbroncodilatador < 0,7. < 0,70. El grupo control estaba compuesto por voluntarios sanos apareados por edad y sexo, sin antecedentes de enfermedades respiratorias y con pruebas de función pulmonar normales (VFE1% predicho ≥ 80% y VFE1/CVF ≥ 0,70). La información basal de los pacientes se muestra en Tabla 2. Se extrajo ARN total de muestras de sangre de EPOC utilizando un kit de extracción de ARN de sangre. Para la síntesis de ADNc, se transcribió inversamente 500 ng de ARN total utilizando un kit de síntesis de ADNc con eliminación de ADN genómico, siguiendo el protocolo proporcionado. El ADNc resultante se diluyó a 150 ng/μL.
Se realizó RT-qPCR utilizando una mezcla maestra de qPCR basada en SYBR Green en un sistema de PCR en tiempo real. Cada reacción de 10 μL contenía 5 μL de mezcla maestra de SYBR Green 2x, 0,5 μL de cada cebador (directo e inverso) (10 μM), 1 μL de cADN diluido (15 ng/μL) y 3 μL de agua libre de nucleasas. Las condiciones de ciclado fueron una desnaturalización inicial a 95 °C durante 5 min, seguida de 40 ciclos de 95 °C durante 10 s y 60 °C durante 30 s, con un análisis final de curva de fusión desde 60 °C hasta 95 °C para verificar la especificidad de la amplificación. Todas las reacciones se realizaron por triplicado técnico. Se utilizó β-actina como gen de referencia interno. La eficiencia de los cebadores para cada gen diana se validó mediante series de dilución de curva estándar y osciló entre el 90 % y el 110 %. Los niveles de expresión génica se normalizaron respecto a β-actina, y la expresión relativa se calculó utilizando el método 2-ΔΔCt. Las comparaciones estadísticas entre los grupos con EPOC y los controles se realizaron utilizando la prueba U de Mann-Whitney.
Análisis estadístico
Las visualizaciones de redes se crearon utilizando Cytoscape, y los análisis estadísticos se realizaron utilizando el software R. A menos que se indique lo contrario, se utilizó la prueba U de Mann-Whitney para datos no normalmente distribuidos, y la prueba t de Student para datos normalmente distribuidos para comparar dos grupos. Un valor de p < 0,05 se consideró estadísticamente significativo.
Resultados
Identificación de genes superpuestos, análisis de enriquecimiento y construcción de la red de interacción de proteínas (PPI)
Del conjunto de datos GSE54837, se identificaron 3.371 genes diferencialmente expresados (DEG), incluyendo 1.675 DEG regulados hacia arriba y 1.696 DEG regulados hacia abajo. Los 10 genes con mayor regulación diferencial significativa, tanto hacia arriba como hacia abajo, se muestran en Figura 1A. Se realizó un agrupamiento jerárquico de los datos de GSE54837 (Figura Suplementaria 1A), y se aplicó una potencia de umbralización suave de 10 para asegurar una topología de red libre de escala (Figura 1B). Los módulos de coexpresión génica se construyeron utilizando el método de corte dinámico de árboles con un tamaño mínimo del módulo de 50 genes, y a cada módulo se le asignó un color distinto (Figura Suplementaria 1B). Los módulos con correlaciones de eigengenes > 0,75 se fusionaron posteriormente (Figura Suplementaria 1C, Figura 1C), lo que dio lugar a 14 módulos distintos. Basado en el análisis de correlación de Pearson entre los eigengenes de los módulos y las características clínicas, el módulo MEsalmon (compuesto por 5.226 genes) mostró la correlación positiva más significativa con la EPOC (r = 0,35, p = 7 x 10⁻8, Figura 1D). El análisis de Venn identificó 160 genes superpuestos entre los 3.371 DEG, los 5.226 genes del módulo MEsalmon y los 2.118 ac4C-RG (Figura 1E). El análisis de enriquecimiento funcional de estos 160 genes mostró que los términos GO significativos incluyeron unión a ARN de cadena sencilla, regulación del proceso metabólico del ARNm y vía de señalización RIG-I (Figura 1F). Además, el análisis KEGG demostró que estos genes se enriquecieron principalmente en la fagocitosis mediada por Fc gamma R, la vía de vigilancia del ARNm y la adhesión focal (Figura 1G). La red PPI de los genes superpuestos contenía 118 nodos y 196 enlaces (Figura 1H).
Identificación de seis genes clave en la EPOC
Para identificar aún más los posibles genes clave entre los 160 candidatos superpuestos, se aplicaron tres algoritmos de aprendizaje automático. Primero se aplicó la regresión LASSO, utilizando validación cruzada para determinar el parámetro de penalización óptimo (λ) ≈ 0,091 (Figura 2A). El gráfico del perfil de coeficientes indicó que se conservaron 17 genes en el valor óptimo de λ (Figura 2B). El análisis XGBoost identificó los 30 genes principales con la mayor ganancia, entre los cuales PTRF, WBP11 y LDOC1L mostraron un alto valor predictivo (Figura 2C). El algoritmo RF clasificó de manera similar los 30 genes principales según sus puntuaciones de importancia Gini, siendo PTRF, RFX5 y PRKCDBP los de mayor capacidad predictiva (Figura 2D). El análisis de intersección de los genes seleccionados por los tres métodos identificó seis genes clave superpuestos: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B y B4GALT2 (Figura 2E).
Construcción del modelo diagnóstico y análisis de expresión de genes clave
Utilizando el 70 % del conjunto de datos GSE54837 como conjunto de entrenamiento, se estableció un modelo de regresión logística que incorpora los seis genes clave. El análisis de la curva ROC indicó un rendimiento diagnóstico moderado, con AUC de 0,766 (IC del 95 %: 0,691–0,8417), 0,759 (IC del 95 %: 0,6368–0,8817) y 0,723 (IC del 95 %: 0,6085–0,8596) para los conjuntos de entrenamiento, prueba interna y validación externa, respectivamente (Figura 3A–C). El análisis de calibración confirmó una alta fiabilidad, y el DCA indicó un beneficio clínico neto claro en un amplio rango de probabilidades umbral tanto en los conjuntos de entrenamiento (Figura 3D–E) como de validación (Figura 3F–G). Se construyó un nomograma para visualizar la contribución de cada gen y facilitar la estimación individualizada del riesgo (Figura 3H). El análisis de expresión reveló que B4GALT2, PRKCDBP y UPP1 estaban significativamente sobreexpresados en muestras de EPOC, mientras que FAM168B, PTRF y TOR3A estaban subexpresados (Figura 3I).
Red reguladora y análisis funcional de los genes clave en la EPOC
Se construyó una red de interacciones funcionales que comprende los 20 genes principales más relacionados con los genes centrales identificados mediante análisis GeneMANIA (Figura 4A). Las interacciones físicas representaron la mayoría de las conexiones, seguidas por correlaciones de coexpresión y dominios proteicos compartidos. La anotación funcional indicó un enriquecimiento significativo en procesos como el proceso catabólico de moléculas pequeñas que contienen nucleobases, el proceso catabólico de nucleósidos y la balsa de membrana plasmática. Se investigó la regulación postranscripcional mediante la intersección de predicciones de miARN procedentes de las bases de datos DIANA-microT y miRanda, identificándose ocho miARN superpuestos (Figura 4B). Posteriormente, se construyó un eje regulador lncARN-miARN-mARN. Según el diagrama de Sankey, se predijo que dos de los miARN identificados, ambos asociados con la regulación de FAM168B, fueran diana de siete lncARN; no se identificaron interacciones reguladoras de este tipo para los cinco genes centrales restantes (Figura 4C). La regulación transcripcional se exploró además utilizando la plataforma ChEA3, que predijo factores de transcripción (TF) upstream para B4GALT2, UPP1, FAM168B y TOR3A. Se seleccionaron los diez principales TF para cada gen con el fin de construir una red reguladora de tipo TF-diana (Figura 4D). Se realizó un análisis GSEA para investigar las funciones biológicas de los seis genes clave. UPP1 mostró un enriquecimiento significativo en procesos biológicos como el proceso metabólico del diacilglicerol y el proceso biosintético del trifosfato de nucleósido de purina, así como en vías incluyendo el proteasoma y el metabolismo de xenoobióticos por citocromo P450 (Figura 4E–F). Los resultados de enriquecimiento para los cinco genes clave restantes se proporcionan en la Figura Suplementaria 2A–J.
Infiltración inmunitaria de UPP1 y predicción de dianas terapéuticas en la EPOC
Se evaluaron los niveles de infiltración inmunitaria de 28 tipos de células inmunitarias en los grupos control y EPOC mediante el algoritmo ssGSEA. En pacientes con EPOC, las células B de memoria, las células supresoras derivadas de la médula ósea y las células dendríticas activadas mostraron puntuaciones de enriquecimiento significativamente más altas. En contraste, las células T auxiliares tipo 1, las células B activadas y las células B inmaduras mostraron puntuaciones de enriquecimiento significativamente más bajas (Figura 5A). Cabe señalar que el ssGSEA proporciona estimaciones relativas de enriquecimiento de células inmunitarias basadas en datos transcriptómicos, en lugar de mediciones directas de las proporciones de células inmunitarias. El análisis de correlación reveló que los seis genes clave exhibieron patrones diferenciales de asociación con subconjuntos de células inmunitarias. Específicamente, UPP1, PRKCDBP y B4GALT2 mostraron correlación positiva con los niveles de infiltración de células B de memoria, células dendríticas activadas y células supresoras derivadas de la médula ósea (Spearman ρ > 0.4, p < 0.05), mientras que PTRF, TOR3A y FAM168B mostraron correlaciones negativas con las células T auxiliares tipo 1 y las células B activadas (Spearman ρ < −0.3, p < 0.05). La matriz completa de correlación se presenta en el mapa de calor (Figura 5B). El análisis de predicción de fármacos identificó a UPP1 como el único gen entre los seis candidatos con interacciones predichas con moléculas pequeñas. Tres compuestos, incluyendo fluorouracilo, capecitabina y 5-bencilacilouridina, se identificaron en la base de datos como compuestos potenciales que interactúan con UPP1 (Figura 5C). Estos compuestos se utilizan principalmente en oncología o en entornos experimentales, y su relevancia en la EPOC requiere una investigación adicional. Los cálculos de energía libre de enlace revelaron que la 5-bencilacilouridina exhibió la afinidad de enlace más fuerte, lo que sugiere una afinidad de enlace predicha relativamente más alta (Tabla 3). Las visualizaciones del acoplamiento molecular para los tres compuestos indicaron conformaciones de enlace predichas favorables con UPP1, consistentes con predicciones computacionales de acoplamiento, más que con validación experimental (Figura 5D–F). Además, el análisis CTD indicó que los seis genes clave estaban fuertemente asociados con diversos fenotipos de enfermedad, incluyendo efectos tardíos de la exposición prenatal, pérdida de peso, hepatomegalia e inflamación (Figura 5G–L).
Validación mediante RT-qPCR de genes diagnósticos clave en muestras clínicas
Para validar los niveles de expresión de genes clave, se recolectaron muestras de sangre de ocho pacientes con EPOC y ocho sujetos de control, y este análisis se consideró una validación preliminar debido al tamaño limitado de la muestra. Como se muestra en la Figura 6A–F, PTRF, TOR3A y FAM168B estuvieron significativamente subregulados, mientras que PRKCDBP y UPP1 estuvieron significativamente sobrerregulados en las muestras de EPOC, lo cual es consistente con las tendencias observadas en el análisis de bioinformática. En contraste, no se observó ninguna diferencia significativa en la expresión de B4GALT2 entre los dos grupos. Esta discrepancia podría atribuirse al tamaño limitado de la muestra o a diferencias en los tipos de muestra entre los conjuntos de datos y los especímenes clínicos.
DECLARACIÓN DE DISPONIBILIDAD DE DATOS:
Todos los datos de secuenciación de ARN se obtuvieron de la base de datos Gene Expression Omnibus (GEO, https://www.ncbi.nlm.nih.gov), seleccionándose GSE54837 como conjunto de entrenamiento y GSE112811 como conjunto de validación. El código utilizado en este análisis puede obtenerse desde https://doi.org/10.5281/zenodo.21771476.
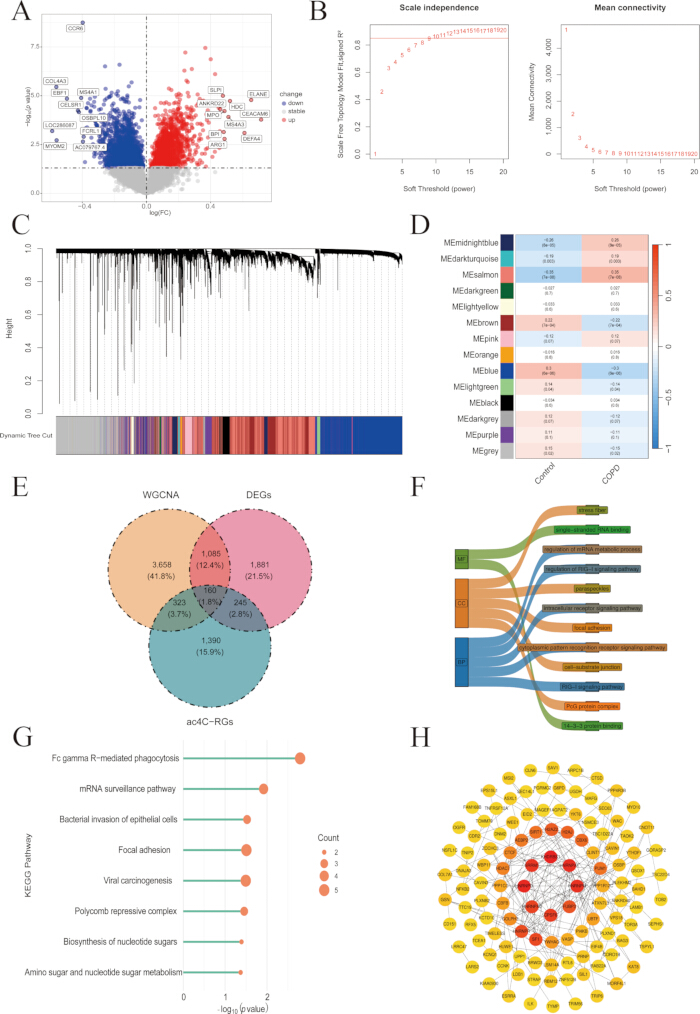
Figura 1: Identificación de genes superpuestos, análisis de enriquecimiento y construcción de la red PPI. (A) Gráfico de volcán de los genes diferencialmente expresados (DEGs) en el conjunto de datos GSE54837. (B) Selección del umbral suave. (C) Dendrograma de agrupamiento por módulos (tras la fusión). (D) Mapa de calor de la correlación entre módulos y rasgos. (E) Diagrama de Venn para identificar genes superpuestos. (F) Diagrama de morera del análisis de enriquecimiento GO, que muestra los principales resultados de enriquecimiento de los genes de intersección en MF, CC y BP. (G) Diagrama de paloteles del análisis de enriquecimiento de vías de señalización KEGG, donde el tamaño de la burbuja representa el número de genes enriquecidos. (H) Red PPI de los genes superpuestos; los nodos representan proteínas y los enlaces representan interacciones proteína-proteína. Abreviaturas: DEGs = genes diferencialmente expresados; PPI = interacción proteína-proteína; GO = Ontología Genética; MF = función molecular; CC = componente celular; BP = proceso biológico; KEGG = Enciclopedia de Genes y Genomas de Kioto; ac4C-RGs = genes relacionados con la N4-acetilcitosina. Haga clic aquí para ver una versión más grande de esta figura.
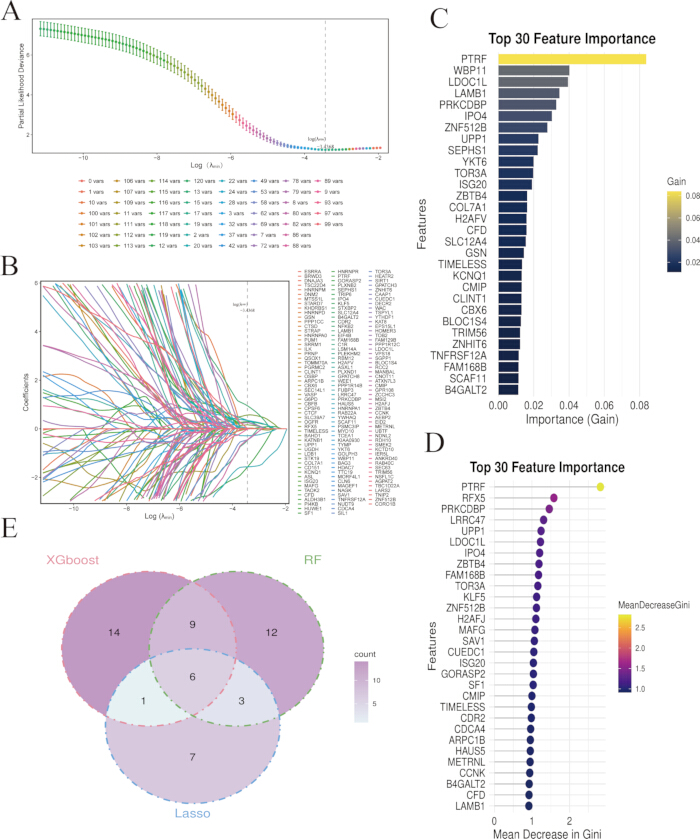
Figura 2: Identificación de seis genes clave en la EPOC. (A) Curva de validación cruzada de LASSO. (B) Diagrama de trayectoria de coeficientes de regresión LASSO. A medida que λ aumenta, los coeficientes de los genes no importantes convergen a 0. (C) Clasificación de importancia de características de XGBoost. El eje x representa el valor de ganancia, el eje y representa el nombre del gen, y la intensidad del color representa la importancia. (D) Clasificación de importancia de características de RF. El eje x representa la disminución media del índice de Gini. (E) Diagrama de Venn de los genes superpuestos obtenidos mediante el análisis cruzado de los tres algoritmos. Abreviaturas: LASSO = operador de contracción y selección por mínima absoluta; XGBoost = incremento de gradiente extremo; RF = bosque aleatorio. Haga clic aquí para ver una versión más grande de esta figura.
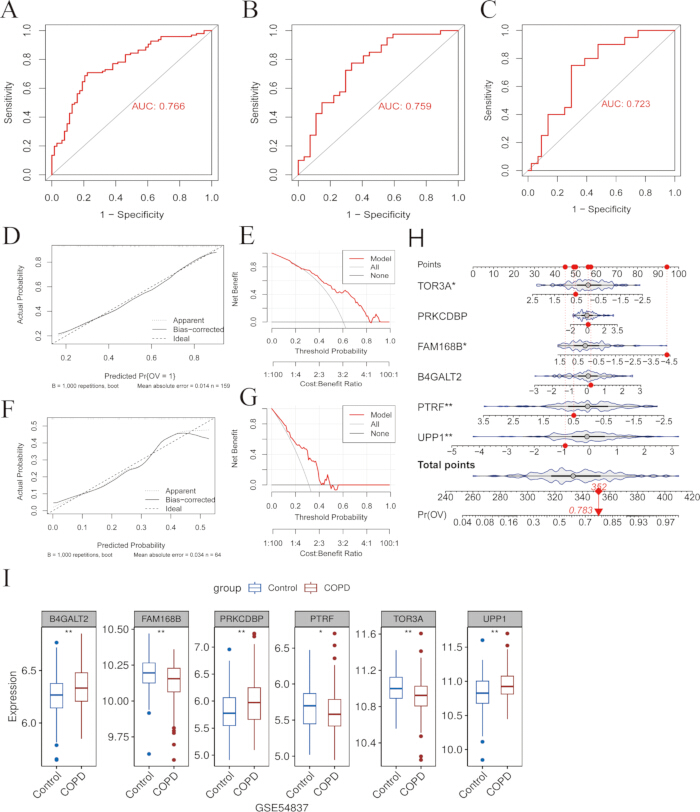
Figura 3: Construcción de un modelo diagnóstico y análisis de expresión de genes clave. (A) Curva ROC del conjunto de entrenamiento. (B) Curva ROC del conjunto de prueba interno. (C) Curva ROC del conjunto de validación externo. (D) Curva de calibración del conjunto de entrenamiento. (E) Análisis de curvas de decisión (DCA) del conjunto de entrenamiento. (F) Curva de calibración del conjunto de validación externo. (G) Análisis de curvas de decisión (DCA) del conjunto de validación externo. (H) Nomograma de seis genes clave. Para la predicción del riesgo individual de EPOC, a cada gen se le asigna una puntuación correspondiente. (I) Análisis de expresión de seis genes clave en muestras de EPOC y controles del conjunto de datos GSE54837. Abreviaturas: ROC = característica de operación del receptor; AUC = área bajo la curva; DCA = análisis de curvas de decisión; EPOC = enfermedad pulmonar obstructiva crónica. Haga clic aquí para ver una versión más grande de esta figura.
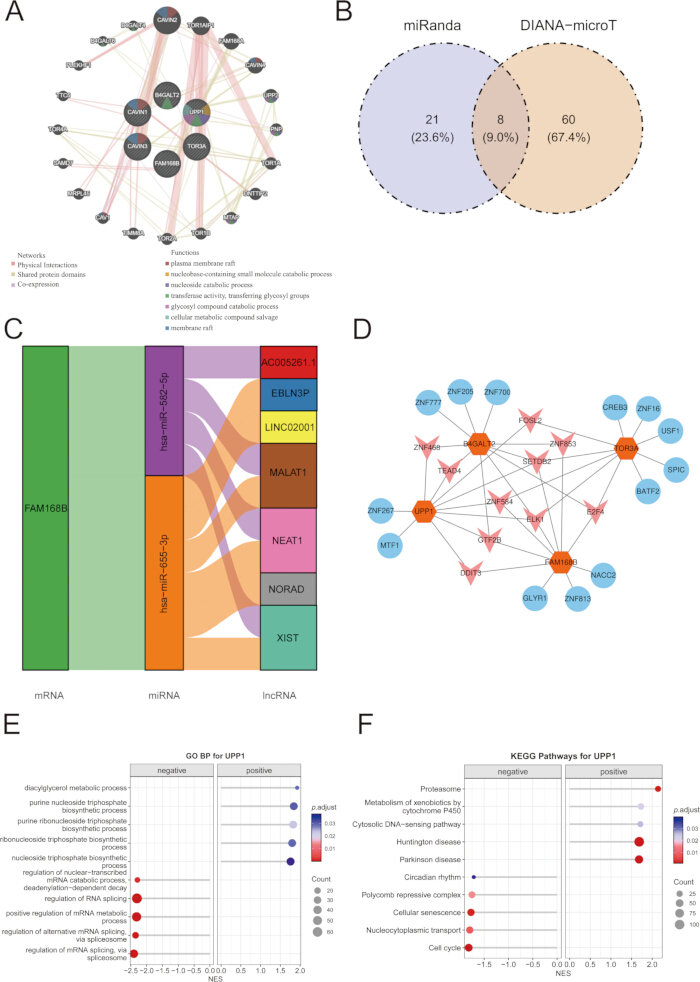
Figura 4: Red reguladora y significado funcional de los genes clave en la EPOC. (A) Resultados del análisis GeneMANIA de 6 genes clave. El color de las líneas indica la correlación entre genes, y el color de los nodos indica diferentes categorías funcionales. (B) Diagrama de Venn del análisis cruzado de las bases de datos DIANA-microT y miRanda. (C) Diagrama de morera de la red reguladora ceRNA. (D) Red reguladora de factores de transcripción potenciales. Los nodos azules representan factores de transcripción, y los nodos naranjas representan genes diana. (E) Análisis de enriquecimiento GSEA de un solo gen para UPP1, que incluye GO. (F) Análisis de enriquecimiento GSEA de un solo gen para UPP1, que incluye KEGG. Abreviaturas: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Haga clic aquí para ver una versión más grande de esta figura.
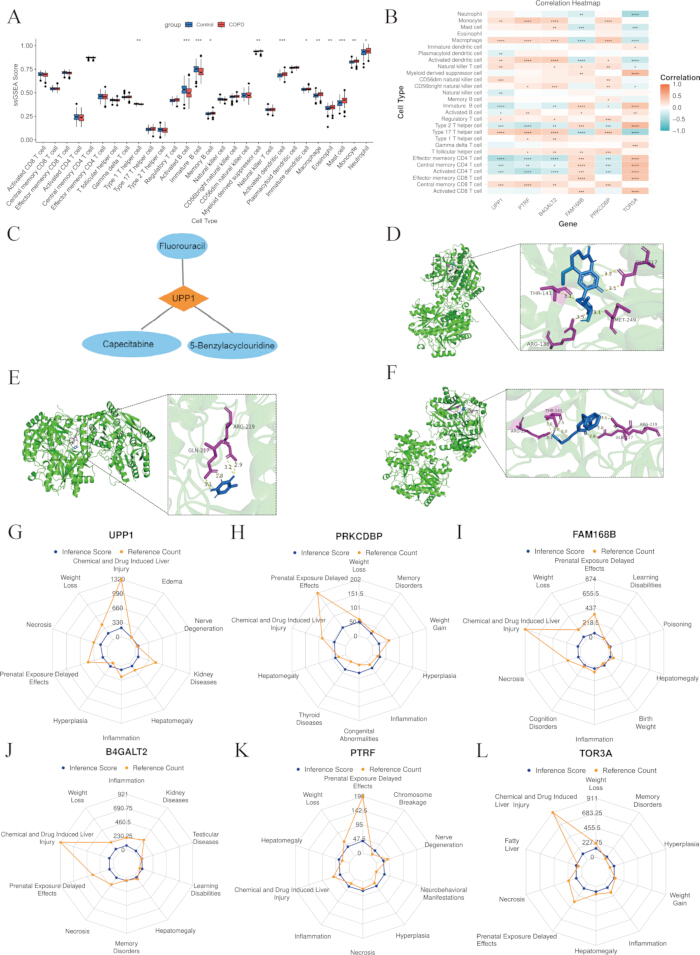
Figura 5: Infiltración inmunitaria de genes clave y predicción de dianas farmacológicas en la EPOC. (A) Diferencias en la abundancia de células inmunitarias entre grupos. (B) Mapa de calor de la correlación entre células inmunitarias y genes clave. (C) Red de interacción entre genes clave y fármacos predichos. (D) Acoplamiento molecular de fluorouracilo con UPP1. (E) Acoplamiento molecular de capecitabina con UPP1. (F) Acoplamiento molecular de 5-bencilacilouridina con UPP1. Para cada compuesto, la imagen izquierda muestra la conformación general del acoplamiento, y la imagen derecha muestra las interacciones locales de unión. (G) Análisis CTD de B4GALT2. (H) Análisis CTD de FAM168B. (I) Análisis CTD de PRKCDBP. (J) Análisis CTD de PTRF. (K) Análisis CTD de TOR3A. (L) Análisis CTD de UPP1. Haga clic aquí para ver una versión más grande de esta figura.
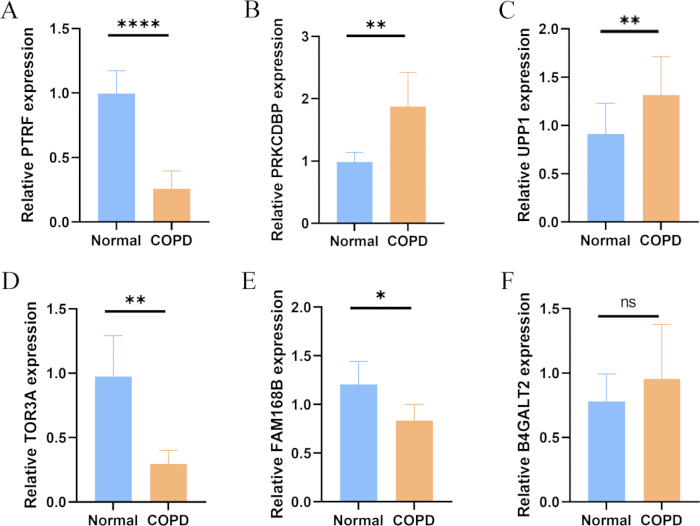
Figura 6: Validación mediante RT-qPCR de la expresión génica clave en muestras de EPOC y controles. (A) Expresión relativa de PTRF. (B) Expresión relativa de PRKCDBP. (C) Expresión relativa de UPP1. (D) Expresión relativa de TOR3A. (E) Expresión relativa de FAM168B. (F) Expresión relativa de B4GALT2. ns = no significativo, p > 0.05; * p < 0.05; ** p < 0.01; *** p < 0.001; **** p < 0.0001. Abreviatura: RT-qPCR = reacción en cadena de la polimerasa cuantitativa por transcripción inversa. Haga clic aquí para ver una versión más grande de esta figura.
Figura suplementaria 1: Muestras del conjunto de datos GSE54837 y agrupamiento de módulos genéticos. (A) Diagrama de agrupamiento de muestras del conjunto de datos GSE54837. (B) Dendrograma de agrupamiento de módulos antes de la fusión. Los genes se agruparon mediante el método de corte de árbol dinámico para identificar módulos distintos. (C) Dendrograma de agrupamiento jerárquico de eigengenes de módulos. Los módulos con patrones de expresión similares se agruparon según la similitud de sus eigengenes.Haga clic aquí para descargar este archivo.
Figura suplementaria 2: Análisis de enriquecimiento GSEA. (A) Análisis GO de PRKCDBP. (B) Análisis KEGG de PRKCDBP. (C) Análisis GO de PTRF. (D) Análisis KEGG de PTRF. (E) Análisis GO de TOR3A. (F) Análisis KEGG de TOR3A. (G) Análisis GO de FAM168B. (H) Análisis KEGG de FAM168B. (I) Análisis GO de B4GALT2. (J) Análisis KEGG de B4GALT2. Abreviaturas: GO = Ontología Genética; KEGG = Enciclopedia de Genes y Genomas de Kioto.Haga clic aquí para descargar este archivo.
| Conjunto de datos | Controles | Pacientes | Plataforma de secuenciación |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabla 1: Conjuntos de datos de expresión génica utilizados en el estudio. Características de los conjuntos de datos GSE54837 y GSE112811 utilizados para el desarrollo/prueba interna del modelo y la validación externa, respectivamente.
| Paciente | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Género (F/M) | M | M | M | F | M | M | M | M |
| Edad (años) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Estado de tabaquismo | Sí | Sí | Dejó de fumar (2 años) | No | Sí | Sí | Sí | Dejó de fumar (5 años) |
| Paquetes-año | 20 por día / 30 años | 15 por día / 35 años | 20 por día / 50 años | 20 por día / 40 años | 30 por día / 40 años | 15 por día / 40 años | 20 por día / 30 años | |
| Grupo de EPOC | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabla 2: Características basales de los participantes del estudio. Características demográficas y clínicas basales de los pacientes con EPOC y los controles sanos incluidos en la validación mediante RT-qPCR.
| Nombre molecular | Gen | Puntuación (kcal/mol) |
| 5-Benzilacilouridina | UPP1 | -9.6 |
| Capecitabina | UPP1 | -6.1 |
| Fluorouracilo | UPP1 | -5.5 |
Tabla 3: Resultados de acoplamiento molecular para UPP1 y compuestos candidatos.
Resultados predichos de acoplamiento molecular para la interacción de UPP1 con fluorouracilo, capecitabina y 5-bencilacilouridina, incluyendo sus afinidades de unión.
Discusión
La modificación conservada del ARN, ac4C, que ocurre predominantemente en el ARN mensajero (ARNm) y en el ARN de transferencia (ARNt), mejora la estabilidad del ARNm y la eficiencia de la traducción20. NAT10 es la única acetiltransferasa de ARN conocida que media la modificación ac4C21. Estudios han demostrado que NAT10 se encuentra sobreexpresado en células epiteliales pulmonares de pacientes con EPOC. La inhibición de NAT10 altera la función mitocondrial y las respuestas transcriptómicas22. Basándose en un análisis integrado de multi-ómicas, este estudio identificó seis genes clave estrechamente asociados con la EPOC y desarrolló un modelo diagnóstico, que mostró un rendimiento diagnóstico moderado y un valor potencial para investigaciones futuras. Un análisis adicional reveló los roles fundamentales de estos genes en la regulación transcripcional, redes ceARN y el microambiente inmunitario. Además, se predijeron fármacos dirigidos potenciales, lo que aporta información sobre la patogénesis de la EPOC y facilita el desarrollo de estrategias de tratamiento personalizadas y precisas. Identificamos genes que estaban diferencialmente expresados en la EPOC y que también estaban presentes en una lista previamente publicada de genes relacionados con ac4C, mediante análisis de WGCNA y de expresión diferencial. Es importante señalar que estos genes se seleccionaron en función de su asociación con la red reguladora de ac4C, y no por enlaces mecanicistas demostrados con NAT10 o la acetilación ac4C, obteniéndose un total de 160 genes candidatos. Seis genes clave (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B y B4GALT2) fueron identificados mediante algoritmos de aprendizaje automático. Entre ellos, PTRF desempeña un papel crítico en la inflamación de las vías respiratorias inducida por ácaros del polvo doméstico (HDM) al regular la necroptosis de macrófagos mediada por IL-33-ZBP1, lo que sugiere que podría estar implicado en enfermedades pulmonares inflamatorias crónicas como la EPOC23. Lai et al.24 demostraron que la administración exógena de uridina inhibe la ferroptosis en macrófagos a través de la vía Nrf2/SLC7A11/GPX4, aliviando así la lesión pulmonar aguda causada por sepsis. Aunque se observó una sobreexpresión de UPP1, una enzima clave en el metabolismo de la uridina, en tejido pulmonar de modelos de lesión pulmonar aguda, su función exacta—y si esta sobreexpresión representa una respuesta protectora o una consecuencia del daño tisular—queda por esclarecerse. Sin embargo, este hallazgo sugiere que UPP1 podría tener una asociación potencial con los procesos fisiopatológicos de enfermedades pulmonares inflamatorias como la EPOC, lo que justifica investigaciones adicionales. Los otros cuatro genes clave han sido menos estudiados en trastornos pulmonares, pero basándonos en sus funciones en otras enfermedades y en nuestros hallazgos actuales, planteamos hipótesis sobre vías potenciales mediante las cuales podrían contribuir a la patogénesis de la EPOC.
Basándonos en los seis genes clave, construimos un modelo diagnóstico para la EPOC y validamos su buen desempeño predictivo. El análisis de expresión mostró que UPP1, B4GALT2 y PRKCDBP estaban significativamente sobreexpresados, mientras que FAM168B, PTRF y TOR3A estaban marcadamente subexpresados en la EPOC. Aunque B4GALT2 fue identificado como sobreexpresado en el análisis de los conjuntos de datos, no se observó una diferencia significativa en la validación mediante RT-qPCR. Esta discrepancia podría atribuirse al tamaño limitado de la muestra, a la heterogeneidad de la cohorte y a las diferencias en los orígenes de las muestras entre los conjuntos de datos públicos y las muestras clínicas de sangre. El análisis de enriquecimiento de conjuntos de genes reveló que estos genes clave estaban significativamente enriquecidos en el empalme del ARN y el procesamiento del ARNm, así como en vías como el ciclo celular y la adicción a la nicotina. Se reconoce que la detención irreversible del ciclo celular es un mecanismo primario subyacente a la senescencia celular, lo cual podría contribuir sustancialmente a la fisiopatología de la EPOC25,26. Un análisis adicional indicó que el fenotipo secretor asociado a la senescencia (SASP) inducido por daño en el ADN podría promover la progresión persistente de la EPOC al mantener la inflamación crónica y agravar la lesión del tejido pulmonar27. Un estudio previo también revisó los vínculos genéticos subyacentes a la adicción a la nicotina y la EPOC28. Aunque el tabaquismo es el factor de riesgo principal para la EPOC, solo una pequeña proporción de fumadores desarrolla la enfermedad, lo que sugiere que los factores genéticos desempeñan un papel importante tanto en la EPOC como en la dependencia de la nicotina. Liu et al.29 resumieron los roles de las proteínas de unión al ARN (RBPs) en la EPOC y la hipertensión pulmonar (PH), destacando su participación en el remodelado vascular pulmonar y en las respuestas inflamatorias mediante la regulación del empalme del ARNm y la expresión génica postranscripcional, subrayando así su potencial como biomarcadores y dianas terapéuticas. En resumen, los genes clave y las vías asociadas identificadas en este estudio no solo profundizan nuestra comprensión de la patogénesis de la EPOC, sino que también proporcionan una base sólida para el desarrollo de biomarcadores diagnósticos futuros y estrategias terapéuticas dirigidas.
La red ceRNA implica diversas especies de ARN, incluyendo ARNlnc, ARNcirc y ARNm, que se unen competitivamente a ARNmi compartidos, formando así relaciones regulatorias mutuas e influyendo en la expresión génica30. Esta red compleja participa en numerosos procesos fisiológicos y patológicos y contribuye a esclarecer los mecanismos regulatorios génicos y la patogénesis de enfermedades como el cáncer y los trastornos inflamatorios crónicos. Por ejemplo, Wang et al. construyeron una red de coexpresión ceRNA compuesta por 11 ARNlnc, cinco ARNmi y 16 ARNm, en la cual la subred central se asoció con cambios en las proporciones de células inmunitarias y la función pulmonar en la EPOC31. De manera similar, Zhang et al.32 desarrollaron una red reguladora circRNA-miRNA-mRNA ceRNA basada en células mononucleares de sangre periférica de fumadores masculinos, identificando ARNcirc desregulados y vías clave relacionadas con la EPOC. Nuestro análisis de red de coexpresión reveló que los genes clave establecieron principalmente conexiones funcionales mediante interacciones físicas, coexpresión y dominios proteicos compartidos, y se enriquecieron significativamente en múltiples vías relacionadas con el metabolismo. Con base en estos hallazgos, construimos además una red reguladora de factores de transcripción (FT)-gen diana y un eje regulador miARN-ARNlnc-ARNm. Estos resultados sugieren que los genes clave podrían estar regulados cooperativamente mediante mecanismos multilaminales que involucran ARNlnc, factores de transcripción y ARNmi en la EPOC.
La infiltración inmunitaria refleja el estado inmunitario al indicar la distribución y actividad de las células inmunitarias dentro de los tejidos o la sangre. Basándose en esto, se predijeron fármacos candidatos potenciales mediante cribado computacional, seguido de simulaciones de acoplamiento molecular para evaluar la afinidad de unión y estabilidad con las proteínas diana. En conjunto, estos análisis facilitan la identificación de nuevos agentes terapéuticos y proporcionan una comprensión más profunda de los mecanismos de la enfermedad. En este estudio, seis genes clave mostraron correlación positiva con la mayoría de las infiltraciones de células inmunitarias. La predicción de fármacos identificó interacciones potenciales entre UPP1 y fluorouracilo, capecitabina y 5-bencilacilouridina, siendo esta última la que exhibió la mayor afinidad de unión, lo cual fue confirmado adicionalmente mediante acoplamiento molecular. Cabe destacar que el fluorouracilo y la capecitabina se utilizan principalmente como agentes antitumorales y fueron identificados en este estudio como compuestos que interactúan con UPP1 predichos por bases de datos, y no como opciones terapéuticas validadas para la EPOC. Estudios previos han reportado que la administración local de fluorouracilo puede mejorar la permeabilidad de las vías respiratorias en casos de obstrucción severa33. Sin embargo, otras evidencias indican que el fluorouracilo y la capecitabina podrían inducir toxicidad pulmonar, particularmente en pacientes con afecciones pulmonares preexistentes34. Por lo tanto, su posible relevancia en la EPOC requiere una verificación experimental y de seguridad adicional. Además, el análisis CTD indicó que los seis genes clave estaban asociados con múltiples procesos patológicos. En conjunto, el análisis integrado de infiltración inmunitaria, predicción de fármacos y acoplamiento molecular proporciona nuevas dianas moleculares y una base teórica para el tratamiento preciso de la EPOC, promoviendo así el desarrollo y la traducción clínica de fármacos relacionados.
Sin embargo, deben reconocerse varias limitaciones. El estudio se basó en conjuntos de datos públicos con fuentes de muestras relativamente limitadas, lo que podría introducir efectos de lote y un posible sobreajuste del modelo. La validación mediante RT-qPCR se realizó en una cohorte pequeña, y la inconsistencia observada en la expresión de B4GALT2 sugiere una posible heterogeneidad de la cohorte. Además, los análisis de infiltración inmunitaria y predicción de fármacos fueron de naturaleza computacional y requieren una validación experimental adicional. Asimismo, al tratarse de una investigación bioinformática en fase de descubrimiento, nuestro modelo diagnóstico se evaluó principalmente mediante valores de AUC con intervalos de confianza del 95 %. Métricas de rendimiento completas, como sensibilidad, especificidad, valores predictivos y estadísticas detalladas de calibración, no se evaluaron completamente debido a la naturaleza retrospectiva de los conjuntos de datos públicos y al tamaño limitado de las muestras. Por lo tanto, nuestro modelo debe considerarse una herramienta de prueba de concepto, y su utilidad clínica requiere una validación adicional en cohortes prospectivas más grandes.
Mediante análisis integrativos de bioinformática y aprendizaje automático, este estudio identificó seis genes clave asociados significativamente con la EPOC. Se estableció un modelo diagnóstico robusto que demostró un rendimiento predictivo confiable en múltiples cohortes. Los análisis funcionales revelaron que estos genes participan en redes reguladoras críticas relacionadas con la regulación transcripcional y post-transcripcional, la infiltración de células inmunitarias y vías asociadas a la adicción a la nicotina y al ciclo celular. Los análisis de predicción de fármacos y de acoplamiento molecular destacaron a UPP1 como un blanco terapéutico prometedor, con varios compuestos candidatos que exhiben fuertes afinidades de unión. En conjunto, estos hallazgos mejoran nuestra comprensión de la fisiopatología de la EPOC y proporcionan blancos moleculares valiosos para el desarrollo futuro de terapias y estrategias de medicina de precisión.
Divulgaciones
Los autores declaran que no tienen conflictos de interés. Se obtuvo consentimiento informado de todos los sujetos participantes en el estudio.
Agradecimientos
Agradecemos al Hospital de Medicina Tradicional China de Luohu en Shenzhen por proporcionar las instalaciones clínicas y el apoyo administrativo esenciales para este estudio. Finalmente, estamos agradecidos a todos los pacientes y voluntarios sanos que participaron en esta investigación; su contribución fue indispensable para este trabajo. Este trabajo fue financiado por el Proyecto Sanming de Medicina en Shenzhen (No. SZZYSM202401018), los Fondos de Especialidades Prioritarias del Distrito de Luohu (No. LX202402021) y los Fondos de Especialidades Prioritarias del Distrito de Luohu (No. LX202302064).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| β-actina cebadores | Tsingke | N/A | Directo: 5’-CATGTACGTTGCTATCCAGGC-3’ Reverso: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| Cebadores B4GALT2 | Tsingke | N/A | Directo: 5’-GGGCAGACTGCTGATCGAG-3’ Reverso: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | En línea | Acoplamiento molecular |
| clusterProfiler | Bioconductor | v4.14.6 | Análisis de enriquecimiento |
| Cytoscape | Consortium Cytoscape | v3.8.3 | Visualización de redes |
| DrugBank | Universidad de Alberta | En línea | Predicción de fármacos |
| Cebadores FAM168B | Tsingke | N/A | Directo: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Reverso: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | Regresión LASSO |
| GSVA | Bioconductor | v1.52.3 | Análisis ssGSEA |
| Supermix para síntesis de ADNc de primera cadena Hifair III | YEASEN | 11141ES | Síntesis de ADNc |
| Mezcla maestra Hieff RTPCR SYBR Green | YEASEN | 11201ES | Amplificación por qPCR |
| limma | Bioconductor | v3.54.0 | Expresión diferencial |
| Sistema LightCycler 480 II | Roche | LightCycler 480 II | PCR en tiempo real |
| Cebadores PTRF | Tsingke | N/A | Directo: 5’-GGGCCGTAGACCAGATCCA-3’ Reverso: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| Cebadores PRKCDBP | Tsingke | N/A | Directo: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Reverso: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| Software R | Foundation R | v4.4.2 | Computación estadística |
| randomForest | CRAN | v4.7 | Bosque aleatorio |
| Kit RNA isolater MolPure Blood RNA | YEASEN | 19241ES50 | Extracción de ARN |
| Base de datos STRING | EMBL | En línea | Red PPI |
| Cebadores TOR3A | Tsingke | N/A | Directo: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Reverso: 5’-CCCGTCCCGATACAGGTTC-3’ |
| Cebadores UPP1 | Tsingke | N/A | Directo: 5’-CTGTCAGTCATGGTATGGGCA-3’ Reverso: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | Red de coexpresión |
| xgboost | CRAN | v1.7 | Algoritmo XGBoost |
Referencias
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.