Este protocolo integra datos transcriptómicos multidimensionales con aprendizaje automático para identificar genes relacionados con el envejecimiento y las mitocondrias en la miocardiopatía dilatada, con el fin de descubrir biomarcadores y realizar subtipos moleculares.
Artículo de investigación
Identificación de genes centro relacionados con el envejecimiento y las mitocondrias en la miocardiopatía dilatada
En este artículo
Resumen
Resumen
La miocardiopatía dilatada (DCM) se caracteriza por la dilatación del ventrículo izquierdo y disfunción sistólica, y está asociada con disfunción mitocondrial y activación inmuno-inflamatoria. Sin embargo, las firmas moleculares relacionadas con el envejecimiento y las vías reguladoras mitocondriales en la DCM aún no se comprenden completamente. Este estudio analizó seis conjuntos de datos transcriptómicos masivos y un conjunto de datos de secuenciación de ARN de una sola célula procedentes de la base de datos Gene Expression Omnibus. Tras la normalización de los datos, la corrección por lotes y la anotación de tipos celulares, se identificaron genes candidatos relacionados con el envejecimiento y las mitocondrias mediante análisis de expresión diferencial, análisis de redes coexpresadas de genes ponderadas y construcción de redes de interacción proteína-proteína. Los genes centrales se seleccionaron posteriormente utilizando regresión por operador de contracción y selección absoluta mínima, bosque aleatorio y eliminación recursiva de características mediante máquina de vectores de soporte. Se realizaron análisis de infiltración de células inmunitarias, comunicación célula-célula y subtipificación molecular para caracterizar el microentorno inmunitario cardíaco en la DCM. Un total de 66 genes relacionados con el envejecimiento y 16 genes relacionados con mitocondrias se asociaron con la DCM y se enriquecieron principalmente en las vías de señalización del factor inducible por hipoxia-1, fosforilación oxidativa y óxido nítrico sintasa. Los análisis mediante aprendizaje automático y secuenciación de ARN de una sola célula identificaron SERPINE1, TGFB2, CYBB y TLR2 como genes centrales. CYBB y TLR2 se expresaron altamente en monocitos y macrófagos, mientras que SERPINE1 y TGFB2 se expresaron predominantemente en células estromales. El análisis del paisaje inmunitario mostró una activación aumentada de macrófagos proinflamatorios y una comunicación alterada entre células en muestras de DCM. Basándose en la expresión de los genes centrales, las muestras de DCM se dividieron en dos subtipos moleculares asociados con la señalización del factor de crecimiento endotelial vascular y la biosíntesis de ácidos biliares primarios, respectivamente. Este protocolo proporciona un marco integrado para identificar biomarcadores candidatos y subtipos moleculares en la DCM.
Introducción
La miocardiopatía dilatada (DCM) es un trastorno miocárdico caracterizado por la dilatación del ventrículo izquierdo y la alteración de la función sistólica. Es la tercera causa más común de insuficiencia cardíaca y la principal indicación para el trasplante cardíaco en todo el mundo1. Estudios basados en poblaciones estiman una prevalencia de aproximadamente 1 caso por cada 250 adultos, con una mayor prevalencia en hombres y una proporción sustancial de casos atribuibles a variantes monogénicas2. Estos hallazgos indican que tanto la predisposición genética como los factores ambientales contribuyen al inicio y progresión de la DCM.
La patogénesis de la miocardiopatía dilatada (DCM) implica procesos interconectados, como la activación inflamatoria, el estrés oxidativo, la apoptosis de los miocardiocitos y una señalización profibrótica desregulada. Se ha asociado polimorfismos genéticos inflamatorios, incluidas variantes del promotor del factor de necrosis tumoral-α, con la susceptibilidad a la DCM de origen viral3. Asimismo, se ha relacionado un mayor estrés oxidativo con la muerte de miocardiocitos y la disfunción del ventrículo izquierdo en subtipos humanos de DCM4. Además, la activación aberrante de las vías de señalización Wnt/β-catenina y calcineurina/factor nuclear de linfocitos T activados promueve la hipertrofia miocárdica y la fibrosis intersticial, contribuyendo así a la progresión de la enfermedad5,6. La disfunción mitocondrial es otro componente importante de la DCM debido a las elevadas demandas energéticas de los miocardiocitos. La alteración de la biogénesis mitocondrial, la homeostasis del calcio, la mitofagia y la integridad del ADN mitocondrial puede afectar la fosforilación oxidativa y contribuir a una disfunción cardíaca progresiva7,8,9,10.
A pesar de estos hallazgos mecanicistas, persisten importantes lagunas de conocimiento. En particular, las relaciones temporales y causales entre la remodelación estructural mitocondrial y la disfunción bioenergética durante la iniciación y progresión de la miocardiopatía dilatada no se han definido completamente11. Se han investigado varias estrategias terapéuticas. La terapia con células madre ha mostrado potencial regenerativo mediante efectos paracrinos, citoprotectores e inmunomoduladores, pero aún es necesario optimizar las fuentes celulares, las vías de administración y la supervivencia tras el trasplante12. Los enfoques de terapia génica, incluyendo la administración basada en virus asociados a adenovirus y la edición del genoma basada en repeticiones palindrómicas cortas agrupadas y regularmente intercaladas, también ofrecen estrategias de tratamiento de precisión. Sin embargo, limitaciones relacionadas con el tropismo cardíaco, la inmunogenicidad del vector y la seguridad a largo plazo aún no se han resuelto13.
Los conjuntos de datos transcriptómicos públicos procedentes de repositorios como el Gene Expression Omnibus (GEO) se utilizan ampliamente para el descubrimiento de biomarcadores en la miocardiopatía dilatada (DCM). Estos recursos proporcionan acceso a cohortes clínicas multicéntricas, apoyan investigaciones rentables y reproducibles, y pueden mejorar el poder estadístico mediante la integración cruzada de conjuntos de datos14. El perfilado transcriptómico también permite la selección de genes candidatos a nivel del genoma completo, la subtipificación molecular y el análisis a nivel de vías metabólicas15. Sin embargo, los conjuntos de datos públicos tienen limitaciones inherentes, incluyendo efectos técnicos por lotes, heterogeneidad clínica y etiológica, capacidad limitada para inferir causalidad e información longitudinal o pronóstica incompleta16. Por lo tanto, los hallazgos derivados de conjuntos de datos transcriptómicos públicos son más adecuados para la generación de hipótesis y la priorización de biomarcadores candidatos, y requieren validación en cohortes independientes y modelos experimentales.
Muchos estudios bioinformáticos de la miocardiopatía dilatada (DCM) dependen principalmente del análisis de expresión diferencial, el cual puede generar resultados falsos positivos y no caracteriza completamente las redes de coexpresión génica ni la heterogeneidad celular dentro del tejido cardíaco. Para abordar estas limitaciones, el presente estudio empleó una estrategia analítica integrada que combina métodos complementarios. El análisis transcriptómico masivo proporciona perfiles de expresión a nivel de tejido, adecuados para comparaciones entre casos y controles. El análisis de redes ponderadas de coexpresión génica (WGCNA) identifica módulos de genes asociados con rasgos fenotípicos y permite la priorización de conjuntos de genes funcionalmente relacionados en lugar de genes individualmente diferencialmente expresados. El análisis de redes de interacción proteína-proteína (PPI) identifica genes altamente conectados en función de la topología de la red. Tres algoritmos de aprendizaje automático —regresión mediante operador de contracción y selección absoluta (least absolute shrinkage and selection operator), bosque aleatorio (random forest) y máquina de vectores de soporte con eliminación recursiva de características (support vector machine-recursive feature elimination)— se utilizaron para identificar biomarcadores candidatos en los conjuntos de datos integrados¹⁷. Luego, se empleó la secuenciación de ARN a nivel de célula individual (scRNA-seq) para examinar los patrones de expresión específicos de tipo celular y las redes de comunicación intercelular18.
Aunque la disfunción mitocondrial y los cambios moleculares relacionados con el envejecimiento se han investigado por separado en la miocardiopatía dilatada, sus asociaciones combinadas con cambios transcripcionales relacionados con la enfermedad permanecen poco exploradas. El presente estudio integró múltiples conjuntos de datos transcriptómicos masivos y de secuenciación de ARN a nivel de célula individual para identificar genes centrales relacionados con el envejecimiento y las mitocondrias en la miocardiopatía dilatada, caracterizar el microambiente inmunitario cardíaco y examinar subtipos moleculares basados en los genes identificados. Este enfoque integrado se utilizó para priorizar biomarcadores candidatos y proporcionar una base para estudios mecanicistas y de validación posteriores.
Protocolo
Todos los procedimientos con animales fueron revisados y aprobados por el Comité de Ética en Animales de Laboratorio del Segundo Hospital Afiliado de la Universidad de Medicina China de Henan (Número de aprobación: HNSZYYYJS2023011150). Todos los procedimientos se llevaron a cabo de acuerdo con las Guías para la Revisión Ética del Bienestar de los Animales de Laboratorio (GB/T 35892-2018) y los principios 3R de Sustitución, Reducción y Refinamiento. Los reactivos, bases de datos, software y equipos utilizados en este estudio se enumeran en la Tabla de Materiales.
1. Recursos de datos y materiales experimentales
Se utilizaron ratones transgénicos machos de grado SPF CTNTR141W con un fenotipo espontáneo de miocardiopatía dilatada (DCM) y un peso corporal de 25 ± 2 g como grupo modelo. Se utilizaron ratones machos C57BL/6J de grado SPF, emparejados por edad, con un peso corporal de 25 ± 2 g como grupo control. Cada grupo incluyó 12 ratones. Todos los animales provinieron de instituciones que poseen licencias válidas de producción de animales de laboratorio y se mantuvieron en un ambiente de barrera de grado SPF a 22 ± 2 °C y una humedad relativa del 40%–60%, bajo un ciclo de 12 h luz/12 h oscuridad, con acceso libre a alimento y agua esterilizados. Después de una semana de aclimatación, todos los ratones se mantuvieron bajo las mismas condiciones durante 4 semanas adicionales antes de la evaluación de la función cardíaca y la recolección de muestras. Todos los ratones tenían entre 6 y 8 semanas de edad al inicio del experimento. Los ratones fueron anestesiados profundamente y sacrificados mediante dislocación cervical.
Se recuperaron siete conjuntos de datos transcriptómicos públicos de tejido miocárdico del ventrículo izquierdo de pacientes con miocardiopatía dilatada (DCM) desde la base de datos Gene Expression Omnibus (GEO)19. Estos conjuntos de datos incluyeron seis conjuntos de datos transcriptómicos masivos y un conjunto de datos de secuenciación de ARN a nivel de una sola célula (scRNA-seq), GSE145154. Tanto las fracciones positivas como negativas para CD45 se incluyeron en el análisis. Ambas fracciones celulares positivas y negativas para CD45 se combinaron antes del agrupamiento. La identidad de la muestra se utilizó como la principal variable de lote para la integración mediante Harmony. Se incluyeron muestras del ventrículo izquierdo normales y del ventrículo izquierdo con DCM del conjunto de datos GSE145154, específicamente GSM4307515, GSM4307516, GSM4307520 y GSM4307521. Los conjuntos de datos utilizados en este estudio fueron GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 y GSE141910. Se excluyeron todas las muestras que no correspondían a DCM, y solo se conservaron las muestras de control (grupo Control) y las muestras con DCM (grupo DCM). No se eliminó ninguna muestra tras el control de calidad. La información de las muestras de los conjuntos de datos GEO incluidos se resume a continuación: GSE5406 contenía 102 muestras (16 de control y 86 de DCM); GSE42955 contenía 17 muestras (5 de control y 12 de DCM); GSE57338 contenía 231 muestras (136 de control y 95 de DCM); GSE79962 contenía 20 muestras (11 de control y 9 de DCM); GSE116250 contenía 51 muestras (14 de control y 37 de DCM); y GSE141910 contenía 322 muestras (161 de control y 161 de DCM).
2. Preprocesamiento de datos de transcriptómica de conjunto
Las matrices de expresión en bruto y los archivos de anotación clínica para los seis conjuntos de datos de conjunto se descargaron utilizando el paquete GEOquery20. Se recuperaron los archivos CEL en bruto para los conjuntos de datos de microarreglos Affymetrix, y se obtuvieron las matrices de conteos en bruto para los conjuntos de datos de RNA-seq. La corrección de fondo, la normalización por cuantiles y el cálculo de expresión para los datos de microarreglos se realizaron utilizando el algoritmo de promedio robusto de microarreglos múltiples implementado en el paquete affy21.
Los datos de conteo de RNA-seq se normalizaron utilizando el método de la media recortada de valores M en el paquete edgeR22 y se convirtieron en valores de conteo por millón transformados con log₂. Los identificadores de sondas se convirtieron en símbolos génicos oficiales utilizando archivos de anotación específicos de la plataforma. Cuando múltiples sondas se asignaron al mismo gen, se calculó el valor medio de expresión.
Los efectos técnicos por lotes entre conjuntos de datos se eliminaron utilizando el algoritmo ComBat del paquete sva23. Se especificaron la fuente del conjunto de datos y la plataforma de detección como factores de lote. Se realizó un análisis de componentes principales antes y después de la corrección por lotes para evaluar la eficacia de la eliminación de los efectos por lotes.
3. Preprocesamiento de datos de transcriptómica de una sola célula y anotación celular
La matriz de expresión génica de GSE145154 se importó a Seurat para construir un objeto Seurat utilizando la versión 5 de Seurat24. Las células de baja calidad se excluyeron utilizando los siguientes umbrales: entre 200 y 6.000 genes detectados por célula, recuento total de identificadores moleculares únicos mayor a 500 y porcentaje de genes mitocondriales inferior al 25 %. Las células que se encontraban fuera de estos umbrales de control de calidad se excluyeron por considerarse de baja calidad o rotas. Excluimos las células de baja calidad únicamente mediante los umbrales de control de calidad descritos anteriormente.
Se realizó la normalización logarítmica utilizando la función NormalizeData con un factor de escala de 10,000. Se seleccionaron los 3,000 genes más variables mediante la función FindVariableFeatures con el método vst. Los datos se escalaron utilizando ScaleData, seguido de un análisis de componentes principales para la reducción lineal de dimensionalidad.
Los efectos por lotes se corrigieron utilizando el algoritmo Harmony25 mediante la función RunHarmony, especificando la identidad de la muestra como la variable de agrupamiento. Los primeros 15 componentes principales se utilizaron para agrupar las células mediante las funciones FindNeighbors y FindClusters. El agrupamiento se realizó utilizando el algoritmo Leiden con una resolución de 0,15. La reducción no lineal de dimensionalidad y la visualización se llevaron a cabo mediante la aproximación uniforme de variedades y proyección.
Los tipos de células se anotaron utilizando genes marcadores canónicos junto con la anotación automatizada mediante el paquete SingleR26. Los genes marcadores fueron los siguientes: células B, IGKC, MS4A1 y CD79A; cardiomiocitos, TNNI3, MYL2 y ACTC1; células endoteliales, VWF, PECAM1 y EGFL7; macrófagos, C1QC, C1QB y C1QA; monocitos, S100A8, S100A9 y G0S2; células asesinas naturales, NKG7, GNLY y CCL5; células musculares lisas, MYL9, TAGLN y ACTA2; células estromales, FBLN1, LUM y DCN; y células T, CD3E, CD3G y CD3D.
4. Análisis de expresión diferencial y puntuación de enriquecimiento de conjuntos de genes
Se construyó un modelo lineal utilizando el paquete limma27 para comparar la expresión génica entre los grupos con miocardiopatía dilatada y controles sanos. Se definieron como diferencialmente expresados de forma significativa los genes con un valor de P < 0,05 y un cambio de expresión absoluto mayor que 1,5, lo que corresponde a un cambio absoluto en el log₂ mayor que 0,58.
Se realizó un análisis de enriquecimiento de conjuntos de genes en una sola muestra para calcular las puntuaciones de enriquecimiento de los conjuntos de genes relacionados con el envejecimiento y con las mitocondrias en cada muestra28. Las diferencias en las puntuaciones de enriquecimiento entre los grupos de DCM y controles sanos se evaluaron mediante la prueba de suma de rangos de Wilcoxon, considerándose estadísticamente significativas las puntuaciones con un valor de P < 0,05.
A nivel de célula individual, los puntajes de los módulos relacionados con el envejecimiento y mitocondriales se calcularon utilizando la función AddModuleScore en Seurat. Las diferencias en los puntajes de los módulos entre grupos se evaluaron mediante la prueba de suma de rangos de Wilcoxon.
Las firmas génicas relacionadas con el envejecimiento se recuperaron de la base de datos CellAge (https://genomics.senescence.info/cells/), y los conjuntos de genes relacionados con las mitocondrias se obtuvieron de GeneCards (https://www.genecards.org/). Las listas completas de genes utilizadas para la puntuación se proporcionan en el Archivo Suplementario 1.
5. Construcción de la red de coexpresión génica ponderada
Se conservaron los 5000 genes codificadores de proteínas con la mayor varianza de expresión en los datos transcriptómicos de tipo masivo para la construcción de la red. Se aplicó la función pickSoftThreshold para calcular el índice de ajuste de la topología libre de escala bajo múltiples potencias de umbralización suave. El umbral óptimo se determinó como la potencia mínima que produce una red libre de escala con un valor de R2 superior a 0,9. Por consiguiente, se adoptó una potencia de umbralización suave de β = 5 para el análisis subsiguiente de la red.
Se construyó una red de coexpresión ponderada firmada utilizando la función blockwiseModules con un tamaño mínimo de módulo de 30. Se calcularon los coeficientes de correlación de Pearson entre cada eigengen de módulo y la puntuación de enriquecimiento relacionada con el envejecimiento o mitocondrial. Se consideraron módulos significativamente asociados aquellos con un coeficiente de correlación absoluto mayor que 0,4 y un valor de P < 0,001.
Los genes dentro de los módulos significativamente asociados se intersectaron con los genes diferencialmente expresados para identificar genes candidatos relacionados con el envejecimiento asociado a la MCD y genes candidatos mitocondriales asociados a la MCD.
6. Análisis de enriquecimiento funcional
Los análisis de enriquecimiento funcional, incluyendo los análisis de Ontología Genética (GO) y de rutas metabólicas del Kyoto Encyclopedia of Genes and Genomes (KEGG), se realizaron sobre los genes candidato utilizando el paquete clusterProfiler29. El enriquecimiento GO cubrió tres categorías estándar: proceso biológico, componente celular y función molecular.
Todos los análisis se realizaron con anotación de la especie humana, tasa de falsos descubrimientos (FDR) para la corrección del valor P y un umbral de valor q de 0,05. Los conjuntos de genes se limitaron a un rango de tamaño de 10 a 500 genes, y los términos con un FDR < 0,05 se definieron como estadísticamente significativos. Finalmente, los resultados de enriquecimiento de GO se visualizaron mediante gráficos de barras agrupadas, mientras que los resultados de enriquecimiento de KEGG se mostraron utilizando gráficos de burbujas.
7. Construcción de la red PPI y selección de genes centrales
Los genes candidatos se enviaron a la base de datos STRING versión 11.530, con el organismo establecido en Homo sapiens y el umbral de confianza de interacción definido como un puntaje combinado mayor a 0,7. Se ocultaron los nodos desconectados y los datos de interacción se exportaron en formato de valores separados por tabulaciones.
Los datos de interacción se importaron a Cytoscape versión 3.9.1 para su visualización31. Las puntuaciones topológicas de los nodos se calcularon utilizando el complemento CytoHubba32 con tres algoritmos: grado, componente máximo del vecindario y centralidad de la clique máxima.
Los módulos funcionales principales dentro de la red se identificaron utilizando el complemento MCODE33 con los siguientes parámetros predeterminados: umbral de grado, 2; k-core, 2; umbral de puntuación del nodo, 0,2; y profundidad máxima, 100. Los genes clasificados entre los 10 primeros por los tres algoritmos topológicos se intersectaron con los genes en la subred principal de MCODE para identificar los genes centrales finales de interacción proteína-proteína.
8. Selección de genes centrales basada en aprendizaje automático y construcción del modelo diagnóstico
Para garantizar la reproducibilidad y una representación equilibrada, el conjunto de datos transcriptómicos integrales se dividió aleatoriamente en conjuntos de entrenamiento y validación en una proporción de 7:3 utilizando una semilla aleatoria fija (semilla = 123456). Esta división se estratificó por grupo de enfermedad (miocardiopatía dilatada frente a control) para mantener proporciones de clases consistentes en ambos conjuntos. Antes de la división, los efectos de lote provenientes de diferentes fuentes de conjuntos de datos se corrigieron utilizando el paquete sva, y las muestras integradas se trataron como una cohorte unificada durante la asignación aleatoria.
Tres algoritmos de aprendizaje automático se aplicaron para seleccionar genes candidatos. Primero, se realizó una regresión logística LASSO mediante la función cv.glmnet en el paquete glmnet34Se construyó un modelo de clasificación binaria con validación cruzada de 5 pliegues, utilizando el AUC como métrica de evaluación. Los genes con coeficientes distintos de cero en lambda.min se reservaron como genes candidatos.
En segundo lugar, se construyó un modelo de clasificación de bosque aleatorio con 500 árboles de decisión utilizando el paquete randomForest35. El número de variables muestreadas para cada división se estableció en la raíz cuadrada del número total de características. La importancia de los genes se cuantificó en función del coeficiente de Gini, y se conservaron los 10 genes principales con las puntuaciones de importancia más altas.
Tercero, se implementó el análisis SVM-RFE utilizando la función rfe del paquete caret36. Se estableció un rango de números de características desde 1 hasta 10, y se utilizó una validación cruzada de 5 pliegues para el entrenamiento del modelo. Finalmente, se seleccionó el subconjunto de genes con la precisión óptima en la validación cruzada.
Los genes identificados por los tres algoritmos se definieron como los genes finales del núcleo relacionados con el envejecimiento y las mitocondrias en la MCD. Luego, se construyeron modelos diagnósticos utilizando 10 algoritmos de clasificación: árbol de decisiones, máquina de incremento de gradiente, modelo lineal generalizado potenciado, k vecinos más cercanos, regresión logística, red neuronal, mínimos cuadrados parciales, bosque aleatorio, máquina de vectores de soporte y potenciación extrema de gradiente.
Se generaron curvas de característica operativa del receptor utilizando el paquete pROC37. Se calculó el área bajo la curva, la exactitud, la sensibilidad y la especificidad para evaluar el rendimiento diagnóstico en los conjuntos de entrenamiento y validación.
Se realizó un análisis de SHapley Additive exPlanations para calcular la contribución de cada gen esencial a las predicciones del modelo38. Se generaron gráficos de resumen y gráficos de cascada por muestra. Se consideró que un modelo diagnóstico final con un área bajo la curva mayor a 0,8 en el conjunto de validación presentaba un buen rendimiento diagnóstico.
9. Inferencia de la comunicación entre células
Las redes de comunicación entre células en el microentorno cardíaco se infirieron utilizando el paquete CellChat39. Se construyó un objeto CellChat usando la base de datos CellChatDB.human. Se identificaron ligandos y receptores diferencialmente expresados mediante identifyOverExpressedGenes, y los pares de interacción significativos se filtraron utilizando identifyOverExpressedInteractions.
Las probabilidades de comunicación entre tipos celulares se calcularon utilizando computeCommunProb. La red global de comunicación a nivel de tipo celular se agrupó utilizando aggregateNet. El número de interacciones y la intensidad de la comunicación entre cada par de tipos celulares se cuantificaron y visualizaron mediante mapas de calor y gráficos de barras.
10. Cuantificación de la infiltración de células inmunitarias
Se calcularon puntuaciones de enriquecimiento para 28 tipos de células inmunitarias en cada muestra total mediante un análisis de enriquecimiento de conjuntos de genes de una sola muestra28 y un conjunto de genes de firma de células inmunitarias40. Se utilizó la prueba de suma de rangos de Wilcoxon para comparar los puntajes de enriquecimiento de células inmunitarias entre los grupos de miocardiopatía dilatada y controles sanos. P < Se consideró estadísticamente significativo un valor de 0,05.
Se realizó un análisis de correlación de Pearson para evaluar la asociación entre los niveles de expresión génica central y las puntuaciones de enriquecimiento de células inmunitarias. Todas las correlaciones con P < 0,05 se consideraron estadísticamente significativas.
11. Agrupamiento por consenso para subtipificación molecular
Se realizó una agrupación de consenso no supervisada de muestras de MCD utilizando perfiles de expresión génica principales vía el paquete ConsensusClusterPlus41Los parámetros de agrupamiento se establecieron como un número máximo de grupos de 6, 1000 iteraciones de remuestreo y una proporción de remuestreo de 0,8. Para la agrupación se utilizó el método de partición alrededor de medoides con distancia euclidiana, y se empleó una semilla aleatoria fija para garantizar la reproducibilidad.
El número óptimo de subtipos se determinó según la gráfica de área delta y las puntuaciones de estabilidad del agrupamiento por consenso, identificándose finalmente K = 2. Se realizó un análisis de componentes principales para verificar la separación clara de los dos subtipos moleculares.
Se aplicó un análisis de variación de conjuntos de genes42 para calcular las puntuaciones de enriquecimiento de vías KEGG específicas para cada muestra. Se utilizó el paquete limma27 para detectar la activación diferencial de vías entre subtipos, y se consideró estadísticamente significativo un valor de P inferior a 0,05.
12. Evaluación ecocardiográfica de la función cardíaca
Los ratones fueron anestesiados vía inyección intraperitoneal de pentobarbital sódico al 1% (30 mg/kg) y fijado en posición supina sobre una mesa de operaciones termoestática. Tras la eliminación del vello torácico, se aplicó uniformemente gel acoplante de ultrasonido en la zona precordial.
Se realizó ecocardiografía en modo M guiada por imagen bidimensional a nivel de los músculos papilares ventriculares izquierdos utilizando un sistema de ultrasonido para pequeños animales. Se capturaron tres ciclos cardíacos estables consecutivos para medir el diámetro diastólico final, el diámetro sistólico final, la fracción de eyección y el acortamiento fraccional del ventrículo izquierdo. Todas las evaluaciones ecocardiográficas se realizaron de forma ciega por un ultrasonógrafo profesional.
Se seleccionaron aleatoriamente tres ratones de cada grupo para el examen ecocardiográfico, y estos seis animales en total fueron posteriormente sacrificados para la recolección de tejido miocárdico y la medición mediante ELISA. Los animales experimentales restantes fueron sometidos a ensayos de laboratorio adicionales paralelos, y sus datos no se incluyeron en el presente estudio.
13. Recolección de tejido miocárdico, extracción de proteínas y ensayo inmunoenzimático (ELISA)
Tras la evaluación ecocardiográfica, los ratones fueron sacrificados bajo anestesia profunda. Los tejidos cardíacos se obtuvieron rápidamente mediante toracotomía mediana, y el miocardio del ventrículo izquierdo se disecó sobre hielo. Los tejidos aislados se enjuagaron exhaustivamente con solución salina tamponada con fosfato fría para eliminar la sangre intracardíaca residual. Tras eliminar el exceso de líquido con papel filtro estéril, las muestras se congelaron rápidamente en nitrógeno líquido y se almacenaron a −80 °C para extracción subsecuente de proteínas, evitando estrictamente ciclos repetidos de congelación-descongelación.
Los tejidos miocárdicos congelados se pesaron y cortaron en fragmentos de aproximadamente 1 mm3 sobre hielo. Los tejidos se lisaron en tampón de lisis RIPA frío que contenía inhibidores de proteasas y fosfatasas, en una proporción estandarizada de 100 µL de tampón por cada 10 mg de tejido. Las muestras se homogenizaron completamente mediante métodos mecánicos sobre hielo e incubadas durante 30 min para lograr la lisis celular completa.
Los lisados se centrifugaron a 12.000 × g durante 15 min a 4 °C. Los sobrenadantes resultantes se recogieron en tubos libres de enzimas, y la concentración total de proteína se cuantificó utilizando un kit de ensayo de proteína con ácido bicinconínico siguiendo los protocolos del fabricante. Todas las muestras se normalizaron a una concentración idéntica de proteína con tampón de lisis.
Los niveles de expresión proteica de los cuatro genes centrales en lisados miocárdicos se midieron utilizando los correspondientes kits de ensayo inmunoabsorbente ligado a enzimas (ELISA). Se añadieron en duplicado (100 µL por pocillo) estándares diluidos en serie y lisados tisulares normalizados a microplacas previamente recubiertas. Las placas se incubaron durante 2 h a temperatura ambiente y se lavaron exhaustivamente con el tampón de lavado suministrado con el kit.
A cada pocillo se le agregó anticuerpo conjugado con enzima y se incubó durante 1 h a temperatura ambiente, seguido de un lavado exhaustivo. Luego se añadió la solución cromógena de sustrato, y las placas se incubaron durante 20 min a temperatura ambiente en la oscuridad. La reacción de color se detuvo con la solución de parada, y los valores de absorbancia se midieron a 450 nm (longitud de onda de referencia: 570 nm) utilizando un lector de microplacas de longitud de onda completa.
14. Análisis estadístico
Todos los análisis estadísticos y visualizaciones de datos se realizaron utilizando la versión 4.2.3 de R. Para las mediciones de concentración por ELISA de cada gen diana (TGFB2, SERPINE1, CYBB, TLR2), primero se aplicó la prueba de normalidad de Shapiro-Wilk para evaluar la distribución normal de los datos en los grupos Control y CMID por separado. Posteriormente, se utilizó una prueba F para evaluar la homogeneidad de las varianzas entre ambos grupos. El método para la comparación entre grupos se determinó según los resultados de la prueba de homogeneidad de varianzas: si las varianzas eran homogéneas (P ≥ 0.05), se empleó una prueba t de Student no pareada para comparar los valores medios entre grupos; si las varianzas eran heterogéneas (P < 0.05), se utilizó la prueba t de Welch corregida para el análisis. Todas las pruebas fueron bilaterales y el umbral de significancia estadística se estableció en P < 0.05. Los datos se representaron mediante diagramas de caja superpuestos con puntos individuales dispersos. Los valores de P de todas las pruebas y el tipo de prueba t utilizada se indicaron detalladamente en cada gráfico.
Resultados
Preprocesamiento de datos y análisis de expresión diferencial
Los seis conjuntos de datos transcriptómicos de tipo masivo fueron sometidos a un preprocesamiento estandarizado y corrección de efectos por lotes antes del análisis posterior. Los datos de microarreglos se normalizaron utilizando el algoritmo de promedio robusto de microarreglos, mientras que los datos de conteo de RNA-seq se normalizaron mediante el método del promedio recortado de valores M. Se aplicó el algoritmo ComBat para eliminar los efectos técnicos por lotes asociados con la fuente del conjunto de datos y la plataforma de detección. El análisis de componentes principales mostró que las muestras se agrupaban según la fuente del conjunto de datos antes de la corrección, pero presentaron una distribución más uniforme tras la corrección, sin separación visible por lote.
Se realizó un análisis de expresión diferencial entre los grupos con miocardiopatía dilatada (DCM) y control sano (HC) utilizando el paquete limma. El mapa de calor de los 20 genes con mayor diferencia significativa en su expresión mostró una separación de los perfiles de expresión entre ambos grupos (Figura 1A). Se identificaron un total de 1.473 genes con expresión diferencial utilizando umbrales de valor de P < 0,05 y |cambio en el log₂ de la razón| > 0,58. De estos, 819 genes estuvieron sobreexpresados y 654 estuvieron subexpresados en las muestras miocárdicas de DCM (Figura 1B).
Luego se utilizó un análisis de enriquecimiento de conjuntos de genes de una sola muestra para calcular las puntuaciones de enriquecimiento de los conjuntos de genes relacionados con el envejecimiento y los relacionados con las mitocondrias en cada muestra. Ambas puntuaciones difirieron significativamente entre los grupos DCM y HC (Figura 1C).
Análisis de red de coexpresión génica ponderada
Se realizó un análisis de red de coexpresión génica ponderada para identificar módulos de genes asociados con las puntuaciones relacionadas con el envejecimiento y el enriquecimiento mitocondrial. Los 5.000 genes codificantes de proteínas con la mayor varianza de expresión en el conjunto de datos masivo se utilizaron para construir la red. Con una potencia de umbralización suave de β = 5, el índice de ajuste a la topología libre de escala superó R2 = 0,9, cumpliendo así el criterio de red libre de escala (Figura 1D).
La agrupación jerárquica y la fusión de módulos identificaron tres módulos génicos. Los tres módulos mostraron correlación significativa con la puntuación relacionada con el envejecimiento. El módulo turquesa mostró la correlación más fuerte con la puntuación relacionada con el envejecimiento (r = 0,69, P < 0,001). Para la puntuación mitocondrial, los módulos azul y gris mostraron correlación significativa, siendo el módulo azul el que presentó la asociación más fuerte (r = 0,56, P < 0,001; Figura 1E). Por lo tanto, se seleccionó el módulo turquesa para la selección de genes relacionados con el envejecimiento, y el módulo azul para la selección de genes relacionados con las mitocondrias.
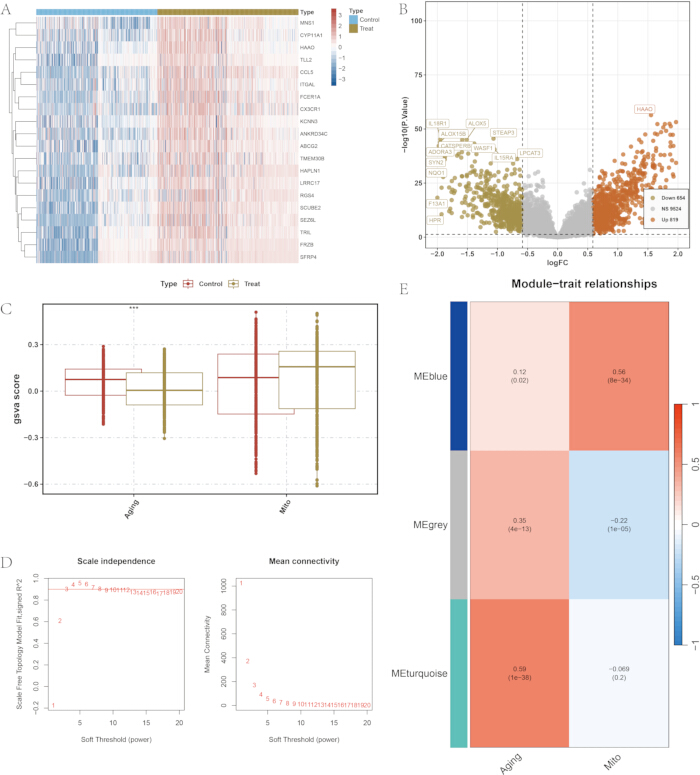
Figura 1: Análisis de expresión diferencial y construcción de la red de coexpresión génica ponderada. (A) Mapa de calor de los 20 genes con mayor expresión diferencial significativa entre los grupos con miocardiopatía dilatada (DCM) y controles sanos (HC). (B) Gráfico de volcán de todos los genes con expresión diferencial. El rojo indica genes sobreexpresados, el verde indica genes subexpresados y el gris indica genes no significativos. Los umbrales fueron valor de P < 0,05 y |cambio en el log₂ de la razón| > 0,58. (C) Gráficos de caja de los puntajes de enriquecimiento de conjuntos de genes mediante análisis de muestra individual para los conjuntos de genes relacionados con el envejecimiento y con las mitocondrias. (D) Selección del umbral suave para el análisis de red de coexpresión génica ponderada, que muestra el índice de ajuste a la topología libre de escala y la conectividad media a través de diferentes potencias de umbralización suave. (E) Mapa de calor de las correlaciones entre los eigengenes de los módulos y los puntajes relacionados con el envejecimiento y las mitocondrias. Haga clic aquí para ver una versión más grande de esta figura.
Identificación de genes candidatos relacionados con el envejecimiento y las mitocondrias
Los genes candidatos se identificaron mediante la intersección de los genes diferencialmente expresados, los genes en los módulos seleccionados del análisis de red de coexpresión génica ponderada y los conjuntos de genes de referencia correspondientes. Este análisis identificó 66 genes candidatos asociados al envejecimiento en la MCD (Figura 2A) y 16 genes candidatos asociados a las mitocondrias en la MCD (Figura 2B).
El análisis de enriquecimiento de la Ontología Genética mostró que los genes candidatos relacionados con el envejecimiento estaban enriquecidos en procesos biológicos, incluyendo la biosíntesis de óxido nítrico sintasa y la organización de la matriz extracelular que contiene colágeno (Figura 2C). Los genes candidatos relacionados con las mitocondrias estaban enriquecidos en términos asociados con el metabolismo energético mitocondrial, incluyendo la membrana interna mitocondrial y el complejo de la cadena respiratoria (Figura 2D).
El análisis del Kyoto Encyclopedia of Genes and Genomes mostró que los genes candidatos relacionados con el envejecimiento estaban enriquecidos en las vías de señalización del factor inducible por hipoxia-1, fosfoinositida 3-quinasa-proteína quinasa B y producto final de la glicación avanzada-receptor del producto final de la glicación avanzada (Figura 2E). Los genes candidatos relacionados con las mitocondrias estaban enriquecidos en vías que incluyen la fosforilación oxidativa (Figura 2F).
Los patrones de expresión diferencial de los 66 genes candidatos relacionados con el envejecimiento entre los grupos DCM y HC se visualizaron mediante un mapa de calor de expresión (Figura 2G). Los patrones de expresión de los 16 genes candidatos relacionados con las mitocondrias se visualizaron mediante diagramas de caja (Figura 2H).
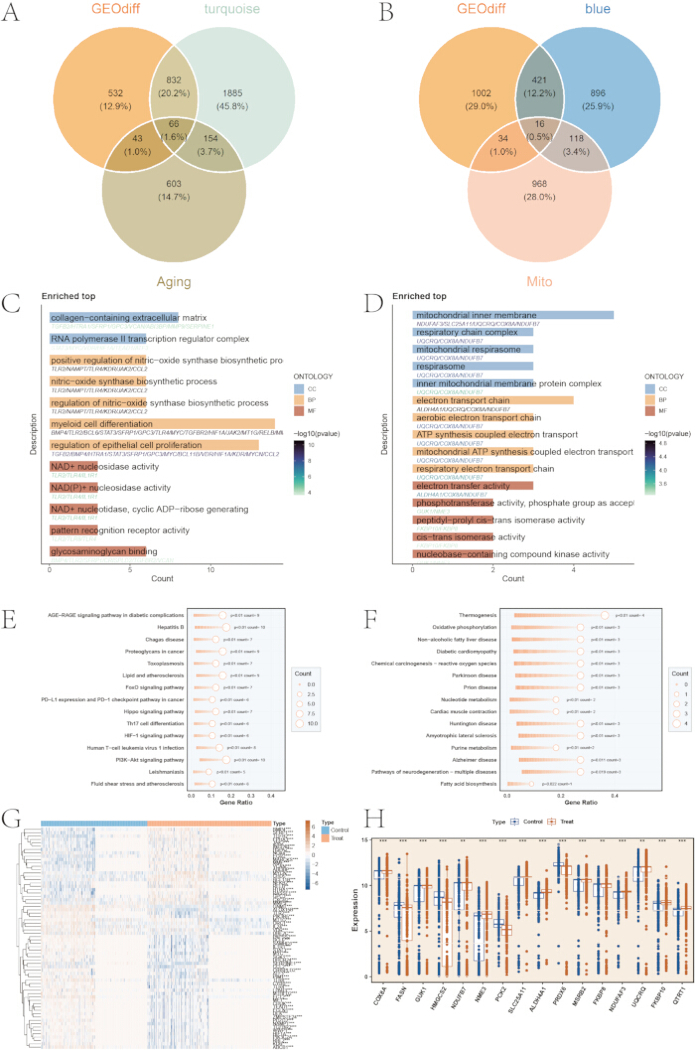
Figura 2: Análisis de cribado y enriquecimiento funcional de genes candidatos. (A) Diagrama de Venn que muestra la intersección de genes diferencialmente expresados, genes del módulo del análisis de red de coexpresión génica ponderada y el conjunto de referencia de genes relacionados con el envejecimiento. (B) Diagrama de Venn que muestra la intersección de genes diferencialmente expresados, genes del módulo del análisis de red de coexpresión génica ponderada y el conjunto de referencia de genes relacionados con las mitocondrias. (C) Análisis de enriquecimiento de la Ontología Genética de genes candidatos relacionados con el envejecimiento. (D) Análisis de enriquecimiento de la Ontología Genética de genes candidatos relacionados con las mitocondrias. (E) Análisis de enriquecimiento de vías de la Enciclopedia de Kyoto de Genes y Genomas de genes candidatos relacionados con el envejecimiento. (F) Análisis de enriquecimiento de vías de la Enciclopedia de Kyoto de Genes y Genomas de genes candidatos relacionados con las mitocondrias. (G) Mapa de calor de expresión de los 66 genes candidatos relacionados con el envejecimiento en los grupos DCM y HC. (H) Gráficos de caja de expresión de los 16 genes candidatos relacionados con las mitocondrias en los grupos DCM y HC. Haga clic aquí para ver una versión más grande de esta figura.
Anotación de tipos celulares del conjunto de datos de secuenciación de ARN unicelular
Se utilizó el conjunto de datos de secuenciación de ARN unicelular GSE145154 para la validación a resolución unicelular. Tras el filtrado de control de calidad, la normalización logarítmica y la corrección de lotes con Harmony, las células de diferentes muestras se distribuyeron en el espacio de proyección y aproximación de variedades uniformes sin separación específica por muestra visible. Utilizando los primeros 15 componentes principales y una resolución de agrupamiento de 0,15, las células se dividieron en 9 grupos (Figura 3A).
Genes marcadores canónicos y la anotación automatizada mediante SingleR identificaron 9 tipos celulares principales: macrófagos, células asesinas naturales, células T, células B, células endoteliales, células musculares lisas, monocitos, células estromales y cardiomiocitos (Figura 3B). Los patrones de expresión de los genes marcadores específicos de cada tipo celular respaldaron estas anotaciones (Figura 3C).
Los puntajes del módulo mitocondrial se calcularon para cada célula utilizando la función AddModuleScore y difirieron significativamente entre los grupos con miocardiopatía dilatada y controles sanos (P < 2.22 × 10⁻16; Figura 3D). Los puntajes del módulo relacionado con el envejecimiento también difirieron significativamente entre ambos grupos (P < 2.22 × 10⁻16; Figura 3E). La proyección de los puntajes mitocondriales en el espacio de proyección y aproximación de variedad uniforme mostró que los puntajes altos se observaron principalmente en cardiomiocitos (Figura 3F). En contraste, los puntajes altos relacionados con el envejecimiento se observaron predominantemente en macrófagos (Figura 3G).
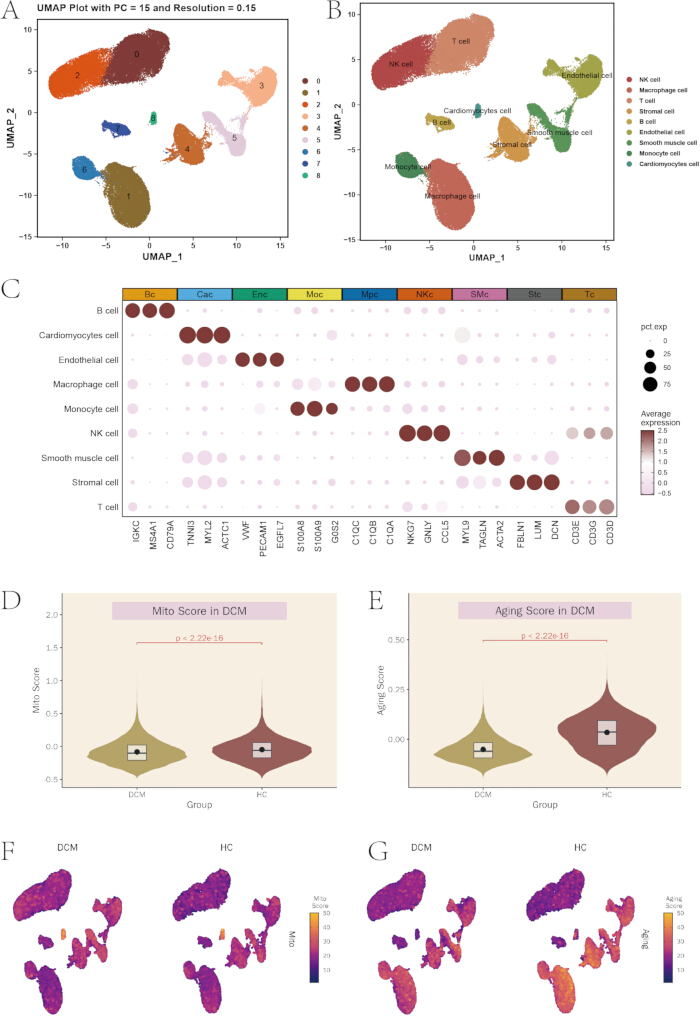
Figura 3: Anotación del transcriptoma a nivel de célula individual y análisis de puntuación de módulos. (A) Gráfico de proyección y aproximación de variedad uniforme de los grupos celulares generados utilizando los primeros 15 componentes principales y una resolución de agrupamiento de 0,15. (B) Gráfico de proyección y aproximación de variedad uniforme de los tipos celulares anotados. (C) Gráfico de burbujas que muestra la expresión de genes marcadores canónicos en los diferentes tipos celulares. (D) Gráfico de violín de las puntuaciones de los módulos mitocondriales en los grupos MCD y HC. (E) Gráfico de violín de las puntuaciones de los módulos relacionados con el envejecimiento en los grupos MCD y HC. (F) Gráfico de proyección y aproximación de variedad uniforme que muestra la distribución de las puntuaciones de los módulos mitocondriales en las células. (G) Gráfico de proyección y aproximación de variedad uniforme que muestra la distribución de las puntuaciones de los módulos relacionados con el envejecimiento en las células. Haga clic aquí para ver una versión más grande de esta figura.
Construcción de la red de interacciones proteína-proteína
El conjunto combinado de 66 genes candidatos relacionados con el envejecimiento y 16 relacionados con mitocondrias se sometió a la base de datos STRING versión 11.5 para construir una red de interacciones proteína-proteína utilizando un umbral de alta confianza con una puntuación combinada > 0,7. La red se importó en Cytoscape para su visualización y análisis topológico (Figura 4A).
Se utilizaron el grado, la centralidad de clique máxima, el componente máximo del vecindario y los análisis MCODE para identificar nodos altamente conectados y subredes centrales. Las subredes identificadas por estos métodos se muestran en Figura 4B–E.
Los 10 principales genes clasificados por grado, centralidad de clique máxima y componente de vecindad máxima se intersectaron con los genes en la subred principal MCODE. Este análisis identificó 10 genes candidatos: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 y CXCR2.
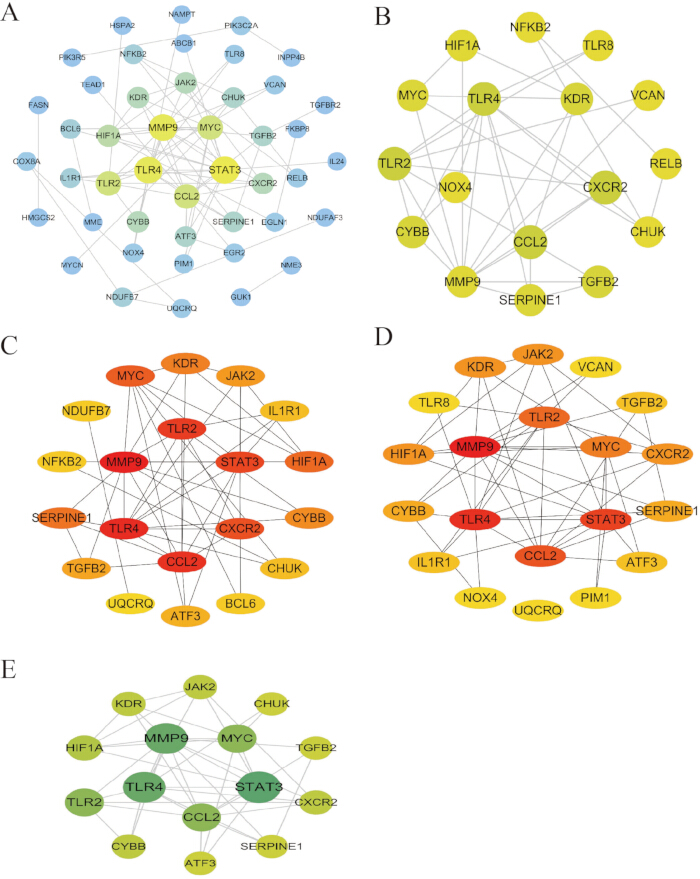
Figura 4Construcción de la red de interacciones proteína-proteína y selección de genes centrales
(A) Red general de interacciones proteína-proteína de los genes candidatos.B) Subred principal identificada mediante MCODE.C) Subred central identificada utilizando la centralidad de clique máxima. (D) Subred central identificada utilizando el componente de vecindad máxima. (E) Subred central identificada utilizando el grado. Haga clic aquí para ver una versión más grande de esta figura.
Selección de genes centrales mediante aprendizaje automático
Se aplicaron tres algoritmos de aprendizaje automático—regresión logística con operador de contracción y selección absoluta mínima (LASSO), bosque aleatorio y máquina de vectores de soporte con eliminación recursiva de características—para seleccionar genes centrales entre los 10 candidatos de interacción proteína-proteína. Todos los análisis se realizaron utilizando una semilla aleatoria fija (set.seed(12345)) y validación cruzada de 5 pliegues. En el modelo LASSO, se conservaron como candidatos los genes con coeficientes distintos de cero en el valor óptimo de lambda (lambda.min) (Figura 5A).
En el modelo de máquina de vectores de soporte con eliminación recursiva de características, se logró la mayor precisión de validación cruzada de 0.859 cuando se incluyeron 10 características (Figura 5B), con una tasa de error mínima correspondiente de 0.141 (Figura 5C). El modelo de bosque aleatorio con 500 árboles de decisión mostró una convergencia estable de la tasa de error fuera de la bolsa (Figura 5D). La clasificación de la importancia de los genes basada en el coeficiente de Gini situó a TGFB2, TLR2, SERPINE1 y CYBB entre los genes con mayor puntuación (Figura 5E). La intersección de los genes seleccionados por los tres algoritmos produjo cuatro genes centrales finales: CYBB, SERPINE1, TGFB2 y TLR2 (Figura 5F).
Se realizó un análisis de Explicaciones Aditivas SHapley para evaluar la contribución de cada gen central a las predicciones del modelo. TGFB2 presentó el valor medio absoluto de Explicaciones Aditivas SHapley más alto, con 0,249, seguido por SERPINE1 con 0,103, CYBB con 0,083 y TLR2 con 0,078 (Figura 6A). El gráfico resumen mostró la distribución y dirección de las contribuciones genéticas a través de las muestras (Figura 6B). Los gráficos de dependencia ilustraron la relación entre los valores individuales de los genes y las contribuciones del modelo (Figura 6C), mientras que los gráficos de cascada por muestra mostraron la contribución de cada gen a predicciones individuales (Figura 6D).
Posteriormente, se construyeron modelos de clasificación diagnóstica basados en los cuatro genes centrales utilizando 10 algoritmos de clasificación. En el conjunto de entrenamiento, la mayoría de los algoritmos alcanzaron valores del área bajo la curva superiores a 0,85 (Figura 6E). En el conjunto de validación interno, la mayoría de los algoritmos alcanzaron valores del área bajo la curva superiores a 0,78 (Figura 6F).
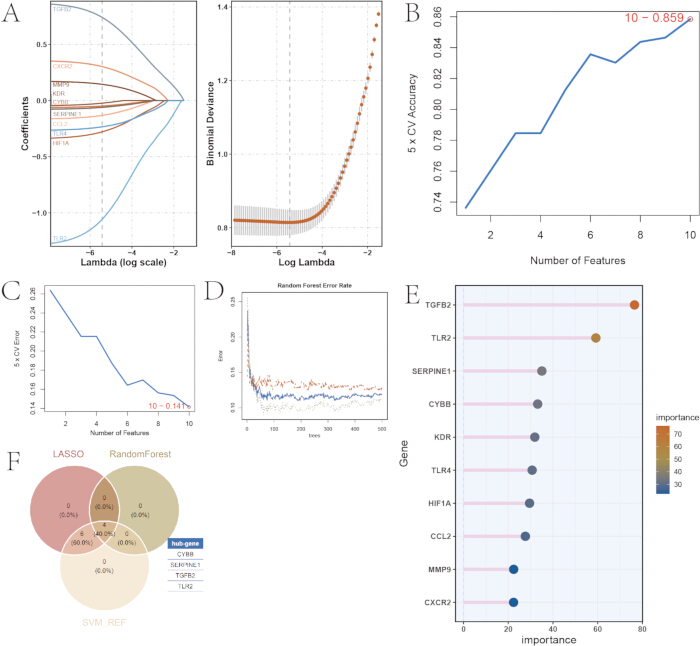
Figura 5: Selección basada en aprendizaje automático de genes centrales. (A) Trayectoria del coeficiente de regresión del operador de contracción y selección por mínimos absolutos y selección del lambda óptimo. (B) Curva de precisión de validación cruzada para el modelo de eliminación recursiva de características mediante máquina de vectores de soporte. (C) Curva de error de validación cruzada para el modelo de eliminación recursiva de características mediante máquina de vectores de soporte. (D) Curva de tasa de error fuera de bolsa para el modelo de bosque aleatorio. (E) Clasificación de importancia de genes según el coeficiente de Gini en el modelo de bosque aleatorio. (F) Diagrama de Venn que muestra los genes centrales identificados por los tres algoritmos de aprendizaje automático. Haga clic aquí para ver una versión más grande de esta figura.
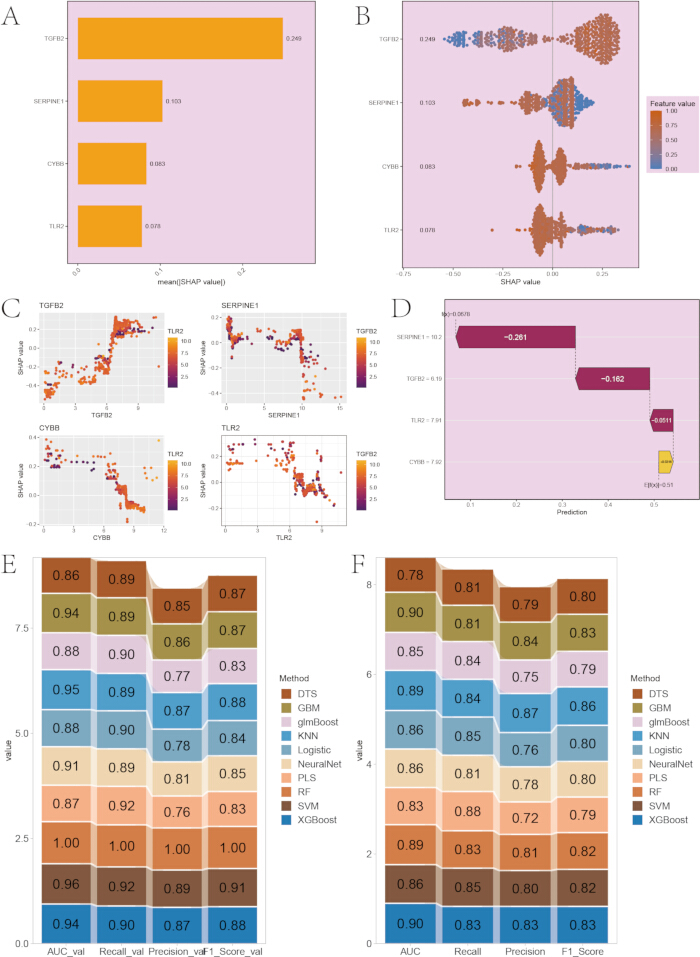
Figura 6: Evaluación del modelo diagnóstico y análisis de SHapley Additive exPlanations (SHAP). (A) Valores medios absolutos de SHapley Additive exPlanations para los cuatro genes centrales. (B) Gráfico resumen de SHapley Additive exPlanations que muestra la distribución y dirección de las contribuciones genéticas. (C) Gráficos de dependencia de SHapley Additive exPlanations para cada gen central. (D) Gráfico de cascada de SHapley Additive exPlanations para una muestra representativa. (E) Mapa de calor del rendimiento diagnóstico de 10 algoritmos de clasificación en el conjunto de entrenamiento. (F) Mapa de calor del rendimiento diagnóstico de 10 algoritmos de clasificación en el conjunto de validación. Haga clic aquí para ver una versión ampliada de esta figura.
Validación a nivel de célula individual y análisis de la comunicación entre células
Se evaluaron los patrones de expresión de los cuatro genes centrales a nivel de célula individual. El análisis de la distribución por tipos celulares mostró que CYBB y TLR2 se expresaban altamente en monocitos y macrófagos, mientras que SERPINE1 y TGFB2 se expresaban predominantemente en células estromales (Figura 7A).
Los gráficos de violín mostraron que la expresión de CYBB difería significativamente entre los grupos con miocardiopatía dilatada y controles sanos (Figura 7B). SERPINE1 (Figura 7C), TGFB2 (Figura 7D) y TLR2 (Figura 7E) también diferían significativamente entre los grupos. Los cuatro genes estuvieron significativamente sobreexpresados en el grupo con miocardiopatía dilatada en comparación con los controles sanos, con una P < 0,0001 en cada comparación.
Se infirieron las redes de comunicación entre células en el microentorno cardíaco mediante CellChat y una base de datos de ligandos y receptores. El número y la intensidad general de las interacciones entre células diferían entre los grupos con miocardiopatía dilatada y el grupo control (Figura 7F). También se observó una intensidad diferencial en la comunicación entre tipos celulares (Figura 7G). Los monocitos, macrófagos, cardiomiocitos y células estromales fueron participantes principales en la red de comunicación.
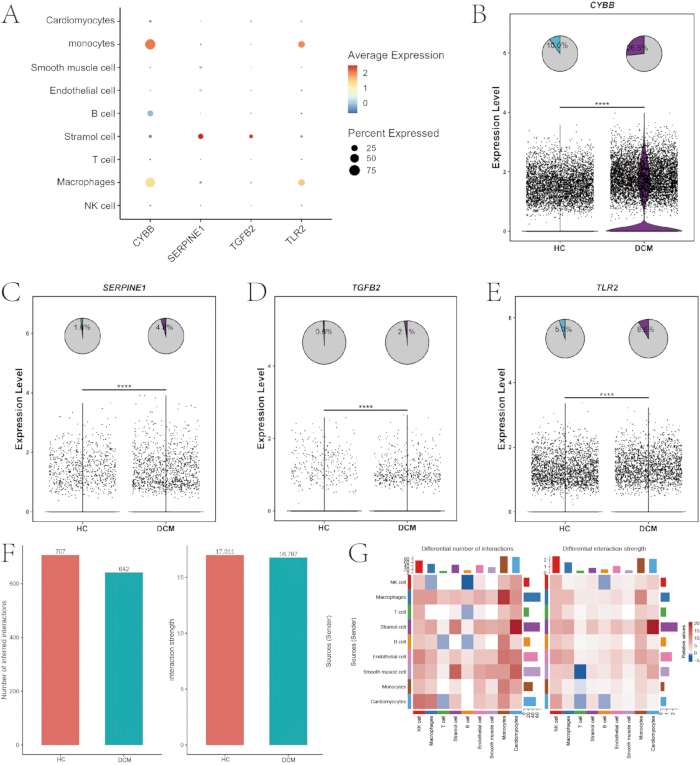
Figura 7: Validación a nivel de célula individual de los genes centrales y análisis de la comunicación entre células. (A) Gráfico de burbujas que muestra la expresión de los cuatro genes centrales en los diferentes tipos celulares. (B) Gráfico de violín de la expresión de CYBB en los grupos DCM y HC. (C) Gráfico de violín de la expresión de SERPINE1 en los grupos DCM y HC. (D) Gráfico de violín de la expresión de TGFB2 en los grupos DCM y HC. (E) Gráfico de violín de la expresión de TLR2 en los grupos DCM y HC. (F) Gráfico de barras que muestra el número y la intensidad total de las interacciones entre células. (G) Mapa de calor que muestra la intensidad diferencial de la comunicación entre células entre los grupos. Haga clic aquí para ver una versión más grande de esta figura.
Análisis de infiltración de células inmunitarias
Se calcularon puntajes de enriquecimiento para 28 subconjuntos de células inmunitarias en cada muestra masiva mediante el análisis de enriquecimiento de conjuntos de genes de una sola muestra. La abundancia de la mayoría de los tipos de células inmunitarias difirió significativamente entre los grupos con miocardiopatía dilatada y los controles sanos (Figura 8A).
Luego se realizó un análisis de correlación de Pearson para evaluar la relación entre la expresión de los genes centrales y los puntajes de enriquecimiento de células inmunitarias. La expresión de CYBB se correlacionó significativamente con la abundancia de múltiples tipos de células inmunitarias (Figura 8B). Se observaron correlaciones similares para SERPINE1 (Figura 8C), TGFB2 (Figura 8D) y TLR2 (Figura 8E). CYBB, SERPINE1 y TLR2 mostraron correlaciones positivas con varias poblaciones de células inmunitarias innatas, incluyendo monocitos y macrófagos.
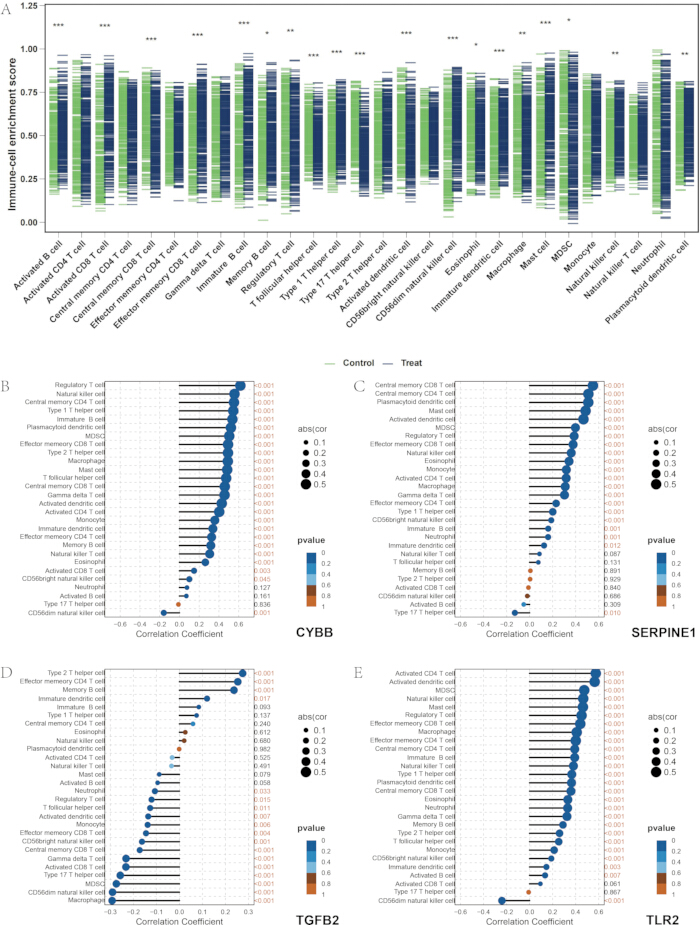
Figura 8: Infiltración de células inmunitarias y análisis de correlación. (A) Diagramas de caja de las puntuaciones de enriquecimiento para 28 tipos de células inmunitarias en los grupos DCM y HC. (B) Gráfico de barras con puntos que muestra las correlaciones entre la expresión de CYBB y la abundancia de células inmunitarias. (C) Gráfico de barras con puntos que muestra las correlaciones entre la expresión de SERPINE1 y la abundancia de células inmunitarias. (D) Gráfico de barras con puntos que muestra las correlaciones entre la expresión de TGFB2 y la abundancia de células inmunitarias. (E) Gráfico de barras con puntos que muestra las correlaciones entre la expresión de TLR2 y la abundancia de células inmunitarias. Haga clic aquí para ver una versión más grande de esta figura.
Subtipificación molecular de la miocardiopatía dilatada
Se realizó un agrupamiento por consenso no supervisado en muestras de miocardiopatía dilatada basado en los perfiles de expresión de los cuatro genes centrales. La matriz de agrupamiento por consenso respaldó la separación en K = 2 (Figura 9A). La gráfica del área delta respaldó además K = 2 como el número óptimo de grupos, dividiendo las muestras en dos subtipos moleculares, C1 y C2 (Figura 9B).
Los niveles de expresión de CYBB, SERPINE1 y TLR2 difirieron significativamente entre los dos subtipos (Figura 9C). La abundancia de múltiples subpoblaciones de células inmunitarias también difirió entre los subtipos (Figura 9D). El análisis de variación de conjuntos de genes mostró una activación relativa de la vía de señalización del factor de crecimiento endotelial vascular en el subtipo C1, mientras que la biosíntesis de ácidos biliares primarios y la biosíntesis de glicoesfingolípidos estuvieron enriquecidas en el subtipo C2 (Figura 9E). El análisis de componentes principales mostró una separación entre las muestras asignadas a los dos subtipos (Figura 9F).
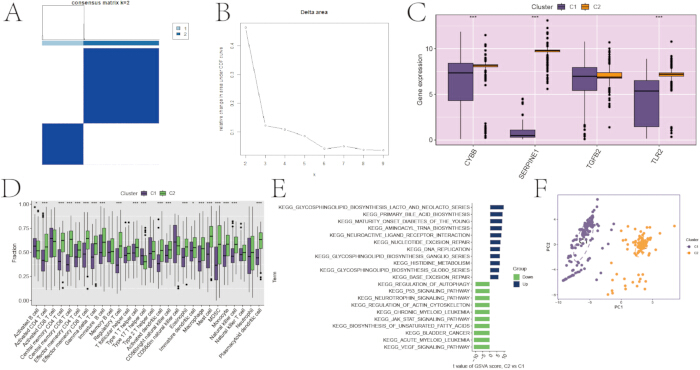
Figura 9: Agrupamiento por consenso para la subtipificación molecular de la miocardiopatía dilatada. (A) Matriz de agrupamiento por consenso en K = 2. (B) Gráfico de área delta utilizado para determinar el número óptimo de grupos. (C) Diagramas de caja de la expresión de genes centrales en los dos subtipos moleculares. (D) Diagramas de caja de la abundancia de células inmunitarias en los dos subtipos moleculares. (E) Mapa de calor de las vías del Enciclopedia de Genes y Genomas de Kioto (KEGG) diferencialmente enriquecidas entre los dos subtipos moleculares. (F) Gráfico de análisis de componentes principales que muestra la separación entre los dos subtipos moleculares. Haga clic aquí para ver una versión más grande de esta figura.
Validación in vivo en el modelo murino de miocardiopatía dilatada
Se utilizaron ratones transgénicos CTNTR141W con un fenotipo espontáneo de miocardiopatía dilatada para la validación in vivo. En comparación con ratones controles de tipo salvaje C57BL/6J emparejados por edad, los ratones transgénicos mostraron un diámetro diastólico final del ventrículo izquierdo significativamente aumentado y una fracción de eyección del ventrículo izquierdo disminuida, lo que es consistente con dilatación ventricular y disfunción sistólica (Figura 10A).
Se extrajo la proteína total del tejido miocárdico del ventrículo izquierdo, y las concentraciones de las cuatro proteínas codificadas por los genes centrales se midieron mediante ensayo inmunoenzimático (ELISA) tras la normalización de la proteína total basada en ácido bicinconínico. Todos los ensayos se realizaron por duplicado. Las curvas estándar tuvieron coeficientes de correlación (R2) ≥ 0,99, y los coeficientes de variación entre pozos duplicados fueron inferiores al 10 %. La significancia estadística entre los grupos Control y CMH se evaluó mediante la prueba t de Student o la prueba t de Welch, según la igualdad de varianzas evaluada mediante la prueba F (la normalidad se confirmó mediante la prueba de Shapiro-Wilk). Los niveles miocárdicos de proteína correspondientes a los cuatro genes centrales aumentaron significativamente en los ratones con miocardiopatía dilatada (CMH) en comparación con los controles (Figura 10B). Para la validación mediante ELISA, se incluyeron 3 réplicas biológicas (ratones individuales) en cada grupo. Para la validación mediante ELISA, se incluyeron tres réplicas biológicas independientes por grupo. Estos hallazgos deben considerarse preliminares y requieren confirmación en una cohorte más grande.
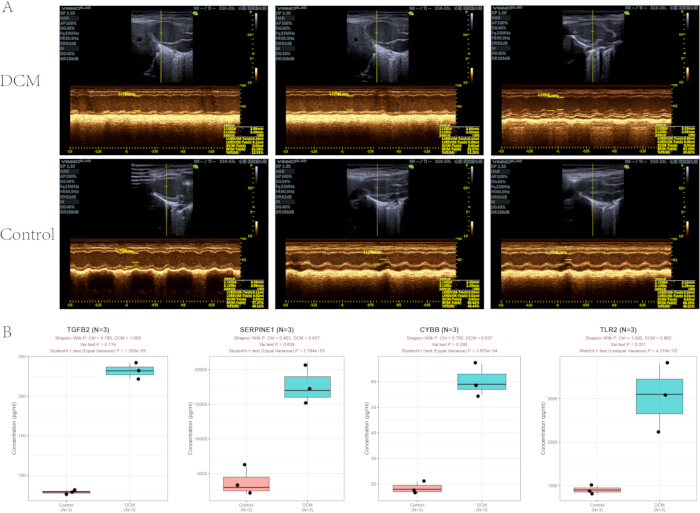
Figura 10: Validación in vivo en el modelo murino transgénico de miocardiopatía dilatada CTNTR141W. (A) Imágenes ecocardiográficas representativas en modo M de ratones transgénicos CTNTR141W con miocardiopatía dilatada (CMID) y ratones control de tipo silvestre. (B) Cuantificación mediante ELISA de cuatro proteínas derivadas de genes centrales en tejidos miocárdicos del ventrículo izquierdo de ratón. Los gráficos de caja y bigotes muestran las concentraciones proteicas para los grupos Control y CMID (n = 3 réplicas biológicas por grupo). En cada gráfico de caja: la línea horizontal continua dentro de la caja indica el valor mediano; los límites superior e inferior de la caja representan los percentiles 75 y 25 (rango intercuartílico, IQR); los bigotes superior e inferior se extienden hasta los puntos de datos no atípicos máximo y mínimo dentro de 1,5 × IQR; cada punto negro sólido individual corresponde a réplicas biológicas independientes provenientes de animales individuales. El eje Y indica la concentración proteica absoluta: pg/mL para TGFB2 y CYBB, ng/mL para TLR2 y SERPINE1. Las comparaciones estadísticas entre dos grupos se realizaron mediante la prueba t de Student (varianza igual) o la prueba t de Welch (varianza desigual), con normalidad verificada mediante la prueba de Shapiro-Wilk y homogeneidad de varianza evaluada mediante la prueba F. Declaración de limitaciones: los resultados de ELISA obtenidos a partir de n = 3 réplicas son hallazgos exploratorios preliminares, y se requiere una validación futura con un tamaño muestral mayor. Haga clic aquí para ver una versión más grande de esta figura.
Disponibilidad de datos:
Los seis conjuntos de datos de transcriptómica masiva y un conjunto de datos de secuenciación de ARN de una sola célula analizados en este estudio están disponibles públicamente en la base de datos Gene Expression Omnibus bajo los números de acceso GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 y GSE145154. El análisis a nivel de una sola célula incluyó las muestras GSM4307515, GSM4307516, GSM4307520 y GSM4307521 del conjunto GSE145154. Todos los demás datos generados o analizados durante este estudio, junto con el código computacional, se incluyen en este artículo publicado y sus archivos de información suplementaria. En concreto, el Archivo Suplementario 1 contiene las listas completas de genes relacionados con el envejecimiento y las mitocondrias, la firma inmunitaria de 28 células, los scripts analíticos personalizados, las matrices de datos transcriptómicos normalizados, los datos originales para los ensayos de ELISA y los datos brutos subyacentes a todas las figuras del manuscrito.
Archivo suplementario 1: Conjuntos de genes relacionados con el envejecimiento y las mitocondrias, firmas inmunitarias, secuencias de análisis, datos transcriptómicos normalizados y datos de origen de las figuras. Haga clic aquí para descargar este archivo.
Discusión
El flujo de trabajo integrado y multicapa combinó metaanálisis transcriptómico masivo, construcción de redes ponderadas de coexpresión génica, aprendizaje automático conjunto, validación transcriptómica a nivel de célula individual y verificación in vivo en modelos animales. Se identificaron cuatro genes centrales relacionados con el envejecimiento y las mitocondrias —CYBB, SERPINE1, TGFB2 y TLR2— como biomarcadores diagnósticos candidatos para la miocardiopatía dilatada (DCM). La integración de seis conjuntos de datos transcriptómicos independientes del ventrículo izquierdo procedentes del repositorio Gene Expression Omnibus, incluyendo plataformas de microarreglos y secuenciación de ARN, redujo el sesgo asociado a conjuntos de datos individuales y aumentó la base estadística del análisis43,44,45. El análisis de redes ponderadas de coexpresión génica, combinado con conjuntos de genes predefinidos relacionados con el envejecimiento y las mitocondrias, permitió identificar módulos funcionales asociados al rasgo, en lugar de depender únicamente del análisis de expresión diferencial46. El aprendizaje automático conjunto redujo el sesgo específico del algoritmo asociado a métodos individuales de selección de características47,48, mientras que el análisis SHapley Additive exPlanations cuantificó la contribución de cada gen central a las predicciones del modelo49. La validación a través de transcriptomas miocárdicos masivos, transcriptomas de célula única y un modelo de ratón transgénico caracterizó además la distribución celular y los niveles miocárdicos de proteína de los genes seleccionados50.
La corrección por lotes fue un paso crítico en el análisis integrado porque la variación residual específica del conjunto de datos podría afectar el análisis de expresión diferencial y las asociaciones entre módulos y rasgos. Por lo tanto, la fuente del conjunto de datos y la plataforma de detección se incluyeron como factores de lote en el modelo ComBat. La agrupación residual dependiente del conjunto de datos en los gráficos de análisis de componentes principales indicaría una corrección incompleta y un posible sesgo sistemático44. La potencia de umbralización suave también fue importante para la construcción de la red de coexpresión génica ponderada. Se seleccionó el valor mínimo que produjo un índice de ajuste a la topología libre de escala de R2 > 0.9, obteniendo β = 5. Un valor más bajo podría producir módulos fragmentados o funcionalmente poco informativos, mientras que un valor más alto podría debilitar la conectividad génica y reducir el poder estadístico del análisis de correlación entre módulos y rasgos46. Los umbrales de control de calidad para células individuales se adaptaron al tejido cardíaco porque los cardiomiocitos presentan una alta actividad metabólica. Se implementó una estrategia de filtrado estricta con un corte porcentual de genes mitocondriales por debajo del 25 % y un rango de genes detectados entre 200 y 6 000 para eliminar células rotas y de baja calidad, conservando al mismo tiempo los cardiomiocitos50. Se utilizó una semilla aleatoria fija, set.seed(12345), para la división del conjunto de datos, el entrenamiento del modelo y la validación cruzada, con el fin de reducir la variación entre análisis repetidos de aprendizaje automático47.
La confirmación del genotipo, el alojamiento estandarizado y la medición ecocardiográfica consistente fueron fundamentales para mantener la estabilidad fenotípica en los experimentos con animales. Los ratones transgénicos CTNTR141W desarrollan dilatación del ventrículo izquierdo y disfunción sistólica tras el período especificado de aclimatación y alimentación51. Es necesario verificar el genotipo antes de la agrupación para excluir animales no transgénicos y prevenir la clasificación errónea del fenotipo. Las mediciones ecocardiográficas deben obtenerse de forma consistente a nivel de los músculos papilares del ventrículo izquierdo, promediando las mediciones de tres ciclos cardíacos estables consecutivos. La variación en la posición de la imagen o en la profundidad de la anestesia puede aumentar la variabilidad en las mediciones de la fracción de eyección del ventrículo izquierdo51. La calidad del ensayo inmunoenzimático (ELISA) se evaluó mediante los coeficientes de correlación de la curva estándar, con valores de R2 ≥ 0,99, y coeficientes de variación < 10% entre pozos duplicados. Una linealidad deficiente de la curva estándar o mediciones duplicadas inconsistentes pueden introducir errores sistemáticos en las estimaciones de la concentración proteica.
Varios problemas analíticos pueden surgir durante la implementación del flujo de trabajo. La separación persistente por lotes tras la corrección con ComBat puede reflejar colinealidad entre las variables de lote y los factores clínicos, un filtrado insuficiente de genes de baja expresión o una variación técnica no modelada. Las covariables clínicas como la edad y el sexo pueden incluirse como variables protegidas cuando estén disponibles, y los genes con expresión cero en más del 70 % de las muestras pueden eliminarse para reducir el ruido44. Puede considerarse una corrección adicional con removeBatchEffect si persiste una separación residual. Un número inesperadamente alto o bajo de genes diferencialmente expresados puede requerir la evaluación de la heterogeneidad de las muestras, la normalización, los valores atípicos y la selección de umbrales27. Las bajas correlaciones entre módulos y rasgos pueden abordarse mediante la reevaluación del umbral de varianza, la potencia de umbralización suave y los valores extremos del rasgo. La ampliación del conjunto de los 5.000 a los 7.500 genes más variables o el reemplazo del análisis de enriquecimiento de conjuntos de genes para una sola muestra por el análisis de variación de conjuntos de genes puede mejorar la detección de módulos46. Un número excesivo de nodos aislados en la red de interacción proteína-proteína puede requerir el ajuste del umbral de confianza de STRING o la ampliación del conjunto de genes candidatos30. Un rendimiento deficiente del aprendizaje automático puede reflejar diferencias distribucionales entre los conjuntos de entrenamiento y validación, redundancia de características o desequilibrio entre grupos. El muestreo estratificado, la reducción de características redundantes o el sobremuestreo de la clase minoritaria pueden reducir estos efectos47. Una agrupación ambigua en análisis de célula individual puede requerir la reevaluación de la corrección con Harmony, la selección de componentes principales y la anotación de genes marcadores50.
Se deben considerar varias limitaciones. Los conjuntos de datos transcriptómicos se obtuvieron retrospectivamente de repositorios públicos, y no fue posible controlar los diseños originales de los estudios ni los factores de confusión clínicos. Las anotaciones clínicas eran incompletas en los distintos conjuntos de datos, y la mayoría carecían de información detallada sobre la etiología, la historia de medicación, la edad del paciente y los resultados a largo plazo. Estas limitaciones impidieron la evaluación de asociaciones entre los genes seleccionados y el pronóstico, la respuesta al tratamiento o el envejecimiento cronológico52. También podría persistir alguna variación técnica residual a pesar de la corrección por lotes. El análisis se basó principalmente en la expresión de ARN mensajero y no incluyó datos integrados de epigenómica, proteómica o metabolómica. En consecuencia, no fue posible determinar la actividad proteica, la regulación postraduccional ni los mecanismos upstream. Solo se incluyó un conjunto de datos de célula individual, lo que limitó la evaluación de la heterogeneidad celular entre las distintas etiologías de la miocardiopatía dilatada50. El modelo transgénico CTNTR141W representa principalmente la miocardiopatía dilatada hereditaria asociada con una mutación en la troponina T cardíaca y podría no reproducir las formas idiopáticas, virales o isquémicas de la enfermedad51. Las diferencias entre especies entre ratones y humanos también limitan la traducción clínica directa. La validación a nivel proteico se limitó al tejido miocárdico de ratones, y no se realizaron cohortes clínicas amplias ni comparaciones con biomarcadores establecidos. Los cuatro genes centrales no son específicos de la miocardiopatía dilatada y también podrían alterarse en otras condiciones cardiovasculares o inflamatorias. Además, la selección de candidatos se basó en conjuntos de genes predefinidos relacionados con el envejecimiento y las mitocondrias. Esta estrategia basada en hipótesis podría excluir genes que se encuentran fuera de los conjuntos de referencia seleccionados, mientras que la intersección entre tres algoritmos de aprendizaje automático podría omitir genes identificados por un solo método48.
El marco analítico podría apoyar futuros estudios de subtipificación molecular, validación de biomarcadores y estudios multi-ómicos en la miocardiopatía dilatada. El panel de cuatro genes podría evaluarse en cohortes independientes de sangre periférica o miocardio antes de su evaluación como herramienta diagnóstica o de subtipificación. Los subtipos C1 y C2 mostraron perfiles diferentes en las vías inmunitarias y metabólicas, proporcionando una base para la validación posterior de características biológicas específicas de cada subtipo15. Los genes seleccionados también podrían examinarse en estudios de acoplamiento molecular, celulares y funcionales. TLR2 y CYBB están asociados con la señalización inflamatoria y la producción de especies reactivas de oxígeno, mientras que TGFB2 y SERPINE1 están asociados con la fibrosis y la remodelación cardíaca53. La integración con datos proteómicos, metabolómicos, epigenómicos, de asociación de todo el genoma y de aleatorización mendeliana podría ayudar a evaluar relaciones regulatorias y posibles asociaciones causales54. El flujo de trabajo también podría adaptarse a estudios transcriptómicos de miocardiopatía hipertrófica, miocardiopatía isquémica e insuficiencia cardíaca, reemplazando los conjuntos de datos específicos de la enfermedad y los conjuntos de genes de referencia45. La futura incorporación de ensayos de una sola célula para la secuenciación del cromatina accesible a transposasa y la transcriptómica espacial podría proporcionar información adicional sobre la regulación celular y la expresión espacial. El enriquecimiento observado de firmas relacionadas con el envejecimiento en macrófagos y firmas mitocondriales en cardiomiocitos fue consistente con informes previos sobre procesos inflamatorios y mitocondriales en enfermedades cardíacas55,56,57.
Este estudio tiene varias limitaciones que deben reconocerse. En particular, los kits comerciales de ELISA utilizados para la cuantificación de proteínas fueron validados oficialmente para la detección de proteínas diana en muestras de suero. En el presente estudio, se utilizaron lisados de tejido miocárdico como matriz de detección en lugar de suero. Aunque se implementaron estrictamente procedimientos consistentes de pretratamiento de muestras y operaciones experimentales durante todo el ensayo para garantizar la fiabilidad y la comparabilidad de los datos experimentales, la falta de validación oficial por parte del fabricante de estos kits de ELISA para muestras de lisados de tejido miocárdico podría provocar posibles desviaciones sutiles en los resultados cuantitativos de las proteínas. Por lo tanto, la aplicación de kits de ELISA específicos para suero a lisados de tejido miocárdico constituye una limitación metodológica de este estudio.
Divulgaciones
El autor declara que no tiene intereses competidores.
Agradecimientos
Se agradece el acceso a los datos disponibles públicamente a través de la base de datos Gene Expression Omnibus. Asimismo, se agradecen a los revisores y editores sus comentarios constructivos sobre el manuscrito. Este trabajo fue financiado por el Proyecto Científico de Investigación a Nivel Provincial (n.º de beca 2021JDZX2026), «Mecanismo de la Fórmula Yiqi Huoxue en la Atenuación del Remodelado Vascular Aterosclerótico mediado por la Regulación Inflamatoria KLF2-Nrf2».
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Gel ultrasónico claro Aquasonic | Parker Laboratories, Inc. | Mar-34 | Utilizado para imágenes ecocardiográficas en pequeños animales. |
| Kit de ensayo de proteínas BCA | Thermo Fisher Scientific | 23227 | Detección a 562 nm; rango, 20–2,000 µg/mL; utilizado para la cuantificación de proteínas totales en lisados de corazón de ratón. |
| Base de datos CellAge | Recursos Genómicos sobre el Envejecimiento Humano | https://genomics.senescence.info/cells/ | Fuente de firmas génicas relacionadas con el envejecimiento. |
| CytoHubba, complemento de Cytoscape | Tienda de aplicaciones de Cytoscape | Versión 0.1 | Utilizado para la puntuación de topología de nodos en redes de interacción proteína-proteína. |
| Cytoscape | Consortium Cytoscape | Versión 3.9.1 | Utilizado para la visualización de redes de interacción proteína-proteína. |
| Lector de microplacas de longitud de onda completa | Thermo Fisher Scientific | Multiskan FC | Utilizado para medir la absorbancia en ensayos ELISA. |
| Gene Expression Omnibus | Centro Nacional de Información sobre Biotecnología | https://www.ncbi.nlm.nih.gov/geo/ | Repositorio público utilizado para obtener conjuntos de datos transcriptómicos. |
| GeneCards | Instituto Weizmann de Ciencia | https://www.genecards.org/ | Fuente de conjuntos de genes relacionados con mitocondrias. |
| Cóctel inhibidor de proteasas y fosfatasas Halt, 100×, libre de EDTA | Thermo Fisher Scientific | 78441 | Almacenado a 4 °C; se añade al tampón RIPA a 10 µL/mL inmediatamente antes de su uso. |
| Nitrógeno líquido | Proveedor local de gases de laboratorio | No aplicable | Utilizado para la congelación rápida de tejido miocárdico. |
| Ratones macho C57BL/6J de grado SPF, de 6–8 semanas de edad, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | No aplicable | Licencia de producción animal No. SCXK (Jing) 2021-0006; utilizados como controles normales. |
| Ratones macho transgénicos CTNTR141W de miocardiopatía dilatada (DCM), de grado SPF, de 6–8 semanas de edad, 25 ± 2 g | Instituto de Ciencias de Animales de Laboratorio, Academia China de Ciencias Médicas | No aplicable | Licencia de producción animal No. SCXK (Jing) 2021-0065; utilizados como modelo espontáneo de DCM. |
| MCODE, complemento de Cytoscape | Tienda de aplicaciones de Cytoscape | Versión 2.0.2 | Utilizado para identificar subredes funcionales centrales en redes de interacción proteína-proteína. |
| Kit ELISA de CYBB de ratón | Biogradetech | A-QEK09250-96wells | Utilizado en este estudio para medir CYBB en lisados de tejido miocárdico de ratón. |
| Kit ELISA de PAI-1 de ratón | EK-BIO | ML30970 | Utilizado en este estudio para medir PAI-1, la proteína codificada por SERPINE1, en lisados de tejido miocárdico de ratón. |
| Kit ELISA de TGF-β2 de ratón | ElaBoX | SEKM-0036 | Utilizado en este estudio para medir TGF-β2 en lisados de tejido miocárdico de ratón. |
| Kit ELISA de TLR-2 de ratón | Solarbio | SEKM-0163 | Utilizado en este estudio para medir TLR-2 en lisados de tejido miocárdico de ratón. |
| Solución salina tamponada con fosfato, pH 7.4, sin calcio ni magnesio | Biological Industries | 02-024-1ACS | Solución estéril 1×; almacenada a 4 °C; utilizada para lavado y dilución del tejido. |
| Paquete R: caret | CRAN | Versión 6.0-94 | Utilizado para la eliminación recursiva de características mediante máquinas de vectores de soporte. |
| Paquete R: CellChat | Desarrolladores de CellChat | Versión 1.6.1 | Utilizado para inferir la comunicación entre células a partir de datos de secuenciación de ARN de célula única. |
| Paquete R: clusterProfiler | Bioconductor | Versión 4.8.3 | Utilizado para análisis de enriquecimiento funcional. |
| Paquete R: ConsensusClusterPlus | Bioconductor | Versión 1.64.0 | Utilizado para agrupamiento por consenso no supervisado. |
| Paquete R: edgeR | Bioconductor | Versión 3.42.4 | Utilizado para la normalización de datos de secuenciación de ARN mediante el método de la media recortada de valores M. |
| Paquete R: GEOquery | Bioconductor | Versión 2.68.0 | Utilizado para descargar datos del Gene Expression Omnibus. |
| Paquete R: glmnet | CRAN | Versión 4.1-8 | Utilizado para regresión logística mediante el operador de contracción y selección absoluta mínima. |
| Paquete R: limma | Bioconductor | Versión 3.56.2 | Utilizado para análisis de expresión diferencial y modelado estadístico. |
| Paquete R: pROC | CRAN | Versión 1.18.5 | Utilizado para análisis de curvas ROC (característica operativa del receptor). |
| Paquete R: randomForest | CRAN | Versión 4.7-1.2 | Utilizado para aprendizaje automático mediante bosques aleatorios. |
| Paquete R: Seurat | CRAN | Versión 5.0.1 | Utilizado para el análisis de datos de secuenciación de ARN de célula única. |
| Paquete R: SingleR | Bioconductor | Versión 2.2.0 | Utilizado para anotación automatizada de tipos celulares. |
| Paquete R: sva | Bioconductor | Versión 3.48.0 | Utilizado para la corrección de efectos por lotes mediante ComBat. |
| Centrífuga refrigerada | Sigma-Aldrich | SIGMA 3-K | Utilizada para la centrifugación de lisados de tejido miocárdico. |
| Tampón de lisis y extracción RIPA | Thermo Fisher Scientific | 89900 | Solución lista para usar 1×; almacenada a 4 °C; suplementada con inhibidores de proteasas y fosfatasas antes de su uso. |
| Sistema de imagen por ultrasonido para pequeños animales | VINNO Technology Co., Ltd. | VINN06LAB | Utilizado para la evaluación ecocardiográfica de la función cardíaca. |
| Pentobarbital sódico | Sinopharm Chemical Reagent Co. | 20040428 | Preparado como solución al 1%, 10 mg/mL, en solución salina estéril; utilizado como anestesia intraperitoneal a 30 mg/kg. |
| Base de datos STRING | Consortium STRING | Versión 11.5 | Utilizada para la construcción de redes de interacción proteína-proteína. |
| Homogeneizador de tejidos TGrinder H24 | TIANGEN | OSE-TH-01 | Utilizado para homogeneizar tejido miocárdico de ratón en tampón RIPA a 6,0 m/s durante 30–60 s en 2–3 ciclos. |
| Plataforma animal termorregulada/mesa quirúrgica calefaccionada para pequeños animales | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Utilizada para mantener a los ratones a 37 °C durante la ecocardiografía; rango de funcionamiento, desde temperatura ambiente hasta 50 °C. |
Referencias
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740