Este protocolo describe cómo construir, entrenar y evaluar un marco multivista de la Red en forma de U de Vision Mamba para segmentación de imágenes médicas, permitiendo la segmentación reproducible de lesiones cutáneas y órganos abdominales mediante la preparación estandarizada de conjuntos de datos, la implementación de modelos y la evaluación del rendimiento.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
Marco de Red en forma de U de Visión Mamba Multi-View para la Segmentación de Imágenes Médicas
En este artículo
Resumen
Resumen
La segmentación de imágenes médicas requiere métodos computacionales que capturen con precisión el contexto global, los límites locales y las estructuras anatómicas multiescala, manteniéndose reproducibles en diferentes aplicaciones. Este artículo presenta un protocolo para construir, entrenar y evaluar un marco de red en forma de U Multi-View Vision Mamba para la segmentación bidimensional de imágenes médicas. El protocolo proporciona un flujo de trabajo reproducible que incluye la adquisición de conjuntos de datos públicos, el preprocesamiento de imágenes y máscaras, la construcción de redes, el entrenamiento de modelos, la selección de puntos de control y la evaluación cuantitativa y cualitativa del rendimiento. El marco incorpora el escaneo de características multivista para capturar información complementaria espacial, de contorno, escala y límites, y aplica fusión de características multietapa dentro de una arquitectura codificador-decodificador en forma de U para mejorar la integración de características durante la segmentación. El protocolo se demuestra utilizando conjuntos de datos de segmentación de lesiones cutáneas y órganos abdominales disponibles públicamente. Bajo el flujo de trabajo de implementación descrito, el marco logra un rendimiento competitivo en segmentación utilizando métricas estándar de evaluación. Siguiendo los procedimientos presentados en este protocolo, los investigadores pueden reproducir la implementación del modelo, entrenar la red usando configuraciones experimentales definidas, evaluar el rendimiento de la segmentación y adaptar el flujo de trabajo para tareas relacionadas de segmentación de imágenes médicas que requieren análisis reproducible basado en aprendizaje profundo.
Introducción
La segmentación de imágenes médicas es una tarea fundamental en los campos de la visión por ordenador y el análisis de imágenesmédicas 1,2,3. Consiste en particionar una imagen en múltiples regiones u objetos para su análisis y procesamiento posteriores. Esta tecnología es especialmente importante en la imagen médica porque ayuda a los clínicos a identificar y localizar regiones patológicas, mejorando así la precisión diagnóstica y la planificación del tratamiento. Con el avance de las tecnologías de imagen médica, como la resonancia magnética (IRM), la tomografía computarizada (TC) y la tomografía por emisión de positrones (PET), la demanda de técnicas precisas de segmentación de imágenes médicas ha seguido aumentando. Los métodos actuales para la segmentación de imágenes médicas pueden categorizarse en tres enfoques principales: métodos basados en redes neuronales convolucionales (CNN) 4, métodosbasados en transformadores 5 y métodos basados en modelos de espacio de estados (SSM) 6,7. Los métodos basados en CNN suelen emplear arquitecturas de red en forma de U para la segmentación de imágenes médicas. La arquitectura más utilizada en esta categoría esU-Net 8, que demostró la eficacia de una arquitectura codificador-decodificador en forma de U para la segmentación de imágenes biomédicas. U-Net3+ combina conexiones de salto denso de UNet++9 con conexiones de salto a escala real para mejorar la agregación de características multiescala. Sin embargo, los métodos basados en CNN tienen una capacidad limitada para capturar dependencias a largo plazo y, por tanto, pueden no modelar eficazmente la información contextual a largo plazo.
Los métodos basados en transformadores capturan eficazmente dependencias a largo alcance mediante el mecanismo de autoatención, que permite el cálculo paralelo y asigna diferentes pesos de atención a distintas regiones de interés. UNETR++10 introduce el módulo de Atención Eficiente en Pareja (EPA) para reducir el número de parámetros y el coste computacional. nnFormer11 combina operaciones convolucionales entrelazadas y de autoatención, e introduce un mecanismo de autoatención local–global basado en volumen para aprender representaciones volumétricas en segmentación de imágenes médicas tridimensionales (3D). H2Former12 propone un transformador de visión híbrido jerárquico eficiente que combina mecanismos de atención con la extracción de características basada en CNN en el codificador. Sin embargo, los métodos basados en transformadores presentan complejidad computacional cuadrática con el aumento de la longitud de la secuencia, lo que resulta en un coste computacional sustancialmente mayor. La Figura 1 ilustra la motivación para MVM-UNet y compara la estrategia propuesta de escaneo multivista con los marcos de segmentación basados en SSM existentes.
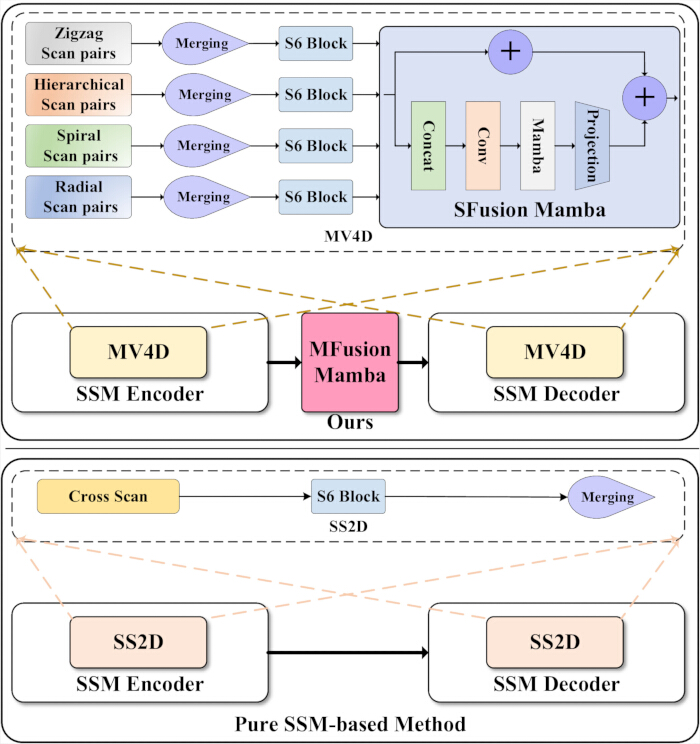
Figura 1. Comparación de MVM-UNet con las arquitecturas de segmentación basadas en modelos puros de espacio de estados (SSM) existentes. Comparación entre un marco convencional de segmentación basado en un modelo de espacio de estados puro (SSM) y la arquitectura propuesta Multi-View Mamba U-Net (MVM-UNet). El panel superior ilustra MVM-UNet, en el que el módulo Multi-View 4-Directional (MV4D) extrae características complementarias usando pares de escaneo en zigzag, jerárquico, espiral y radial que se integran mediante Spatial Fusion Mamba (SFusion Mamba), mientras que Multistage Fusion Mamba (MFusion Mamba) agrega características del codificador multiescala antes de decodificarlas. El panel inferior muestra una arquitectura representativa basada en SSM pura utilizando módulos de escaneo selectivo bidimensional (SS2D) con barrido cruzado. La figura destaca las diferencias arquitectónicas entre las redes de segmentación convencionales basadas en SSM y el MVM-UNet propuesto. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
Los métodos basados en SSM combinan la capacidad global de modelado de los Transformers con la complejidad computacional lineal. La arquitectura Mamba procesa selectivamente la información de entrada usando un modelo selectivo de espacio de estados (Selective-SSM), lo que permite al modelo ajustar dinámicamente sus parámetros según la entrada mientras filtra información irrelevante y enfatiza características informativas. Vim13 y VMamba14 adaptan la arquitectura Mamba para tareas de visión por ordenador. U-Mamba15 emplea una arquitectura híbrida CNN–SSM para explorar la aplicación de los SSM en la segmentación de imágenes médicas, mientras que Mamba-UNet16 adopta una arquitectura codificador-decodificador completamente basada en SSM para la segmentación de imágenes médicas. Estos métodos logran un rendimiento competitivo utilizando parámetros sustancialmente menores. Sin embargo, los métodos actuales basados en SSM/Mamba extraen principalmente características de imagen utilizando parches simples y estrategias de escaneo SS2D, lo que presenta varias limitaciones para la segmentación de imágenes médicas. En primer lugar, las técnicas SS2D y basadas en parches están diseñadas principalmente para tareas generales de visión por ordenador. Local Mamba17 y MotionMamba 18 han sugerido que la estrategia de escaneo SS2D es insuficiente para todas las tareas visuales porque diferentes estrategias capturan distintos tipos de información visual. En segundo lugar, la estrategia de escaneo SS2D es relativamente sencilla, basándose únicamente en direcciones de escaneo horizontales y verticales. En consecuencia, puede que no capture adecuadamente relaciones espaciales complejas ni detalles estructurales finos. La segmentación de imágenes médicas requiere modelado simultáneo tanto del contexto espacial global como de características anatómicas locales precisas. Además, los métodos actuales basados en SSM/Mamba proporcionan una fusión limitada de características entre el codificador y el decodificador. Arquitecturas como UNet++ y FATNet mejoran la precisión de la segmentación mediante una fusión de características mejorada, destacando la importancia de una integración eficaz de características para la segmentación de imágenes médicas.
Para abordar estas limitaciones, este artículo propone un novedoso marco de segmentación de imágenes médicas basado en Mamba, denominado MVM-UNet. Como se muestra en la Figura 1, el módulo propuesto Multi-View Four-Directional (MV4D) sirve como el componente central de extracción de características de MVM-UNet y está diseñado específicamente para la segmentación de imágenes médicas integrando información de cuatro estrategias de escaneo distintas. Cada estrategia de escaneo extrae características complementarias de la imagen y representa una vista diferente de la imagen de entrada. El escaneo en zigzag19 alterna la dirección de recorrido al final de cada fila o columna, equilibrando así la información espacial local y global. En cambio, los esquemas de escaneo espiral y radial20 proporcionan una cobertura integral extendiéndose hacia fuera desde el centro o hacia el interior desde la periferia. El escaneo jerárquico18 captura tanto características locales como globales a múltiples escalas. Para mejorar la robustez de cada estrategia de escaneo, se fusionan pares de escaneo antes de introducirse en el Bloque S6. El módulo Scan-view Fusion Mamba (SFusion Mamba) integra posteriormente las características extraídas de las cuatro modalidades de escaneo. Para utilizar eficazmente las características del codificador multiescala, este artículo propone además un módulo de fusión Mamba multiescala (MFusion Mamba), que acumula y fusiona las salidas de cada etapa del codificador antes de pasar las características fusionadas al decodificador. MVM-UNet fue evaluado en los conjuntos de datos ISIC 2017, ISIC 2018 y Synapse. Los resultados experimentales demuestran que MVM-UNet logra un rendimiento competitivo en segmentación en los conjuntos de datos ISIC 2017, ISIC 2018 y Synapse.
Las arquitecturas de segmentación representativa han avanzado aún más la segmentación de imágenes médicas. U-Net también se ha aplicado con éxito a tareas de análisis de imágenes biomédicas como el recuento celular, la detección y la morfometría21. Las arquitecturas CNN mejoradas por la atención, comoCA-Net 22, mejoran la representación de características mediante mecanismos de atención integrales. Los marcos representativos de segmentación basados en Transformers, incluyendo TransUNet23, Pyramid MedicalTransformer 24, SwinU-Net 25,TransAttUNet 26 yTransCUNet 27, demuestran aún más la eficacia del modelado global de características basado en atención para la segmentación de imágenes médicas.
El diseño de MVM-UNet está motivado por dos limitaciones de los métodos de segmentación basados en SSM/Mamba. En primer lugar, muchos modelos actuales de Vision Mamba dependen de estrategias de escaneo bidimensionales simples, que pueden ser insuficientes para imágenes médicas que contengan límites irregulares de lesiones, regiones objetivo pequeñas y estructuras anatómicas a escala multipla. En segundo lugar, las arquitecturas convencionales codificador-decodificador en forma de U transfieren principalmente características a través de conexiones de salto correspondientes, limitando el uso directo de información del codificador multietapa durante la decodificación. Por ello, MVM-UNet introduce MV4D para mejorar el modelado espacial multivista y MFusion Mamba para agregar explícitamente características del codificador multietapa. Este diseño está destinado a adaptar el modelado de largo alcance basado en Mamba a los requisitos específicos de la segmentación de imágenes médicas.
Aunque MVM-UNet se basa en el paradigma general codificador-decodificador y en el modelado de secuencias basado en Mamba, su novedad radica en cómo estos componentes se adaptan e integran para la segmentación de imágenes médicas. En lugar de simplemente incorporar un bloque Mamba estándar en una red troncal en forma de U, el marco propuesto rediseña el proceso de modelado espacial mediante múltiples ramas de pares de escaneo orientadas a tareas, introduce SFusion Mamba para integrar representaciones específicas de escaneo, mejora el bloque MVV con rutas residuales y de proyección, e inserta MFusion Mamba entre el codificador y el decodificador para agregar características del codificador multietapa antes de decodificar. Este diseño a nivel arquitectónico pretende abordar los límites irregulares, las pequeñas regiones objetivo y las estructuras anatómicas multiescala comúnmente observadas en imágenes médicas.
Este protocolo es más adecuado para tareas de segmentación que requieren modelado simultáneo de información contextual a largo alcance, límites irregulares de objetos y estructuras anatómicas multiescala en imágenes médicas bidimensionales. En comparación con los métodos de segmentación basados en CNN, el diseño codificador-decodificador basado en Mamba proporciona un mecanismo eficaz de modelado del contexto, manteniendo un flujo de trabajo en forma de U familiar para los investigadores de segmentación de imágenes médicas. En comparación con los métodos basados en Transformer, el marco propuesto evita el uso directo de la autoatención cuadrática y está destinado a investigadores que buscan modelado contextual global utilizando un mecanismo de modelado de secuencias relativamente eficiente. Por tanto, este protocolo es adecuado para la segmentación de lesiones cutáneas, segmentación de órganos abdominales y tareas médicas bidimensionales similares de segmentación de imágenes médicas en las que tanto la información estructural global como los detalles locales de los límites son importantes.
Este protocolo también tiene limitaciones que deben considerarse antes de su uso. Puede que no sea necesario para tareas de segmentación relativamente simples en las que una CNN ligera ya proporciona un rendimiento suficiente. Además, no está diseñado directamente para una segmentación volumétrica tridimensional completa sin una adaptación arquitectónica. Los investigadores con datos anotados muy limitados, recursos limitados de unidades de procesamiento gráfico (GPU) o un requisito de modelos clásicos altamente interpretables también deberían considerar estas restricciones antes de aplicar el protocolo. En general, este método está destinado a investigadores que buscan reproducir y evaluar un marco de segmentación en forma de U basado en Mamba, que equilibra el modelado de contexto a largo plazo, la representación local de fronteras y la fusión de características en varias etapas.
Las contribuciones clave son las siguientes:
1. Este artículo presenta un novedoso marco de segmentación de imágenes médicas basado en Mamba, denominado MVM-UNet. A diferencia de los enfoques que incorporan directamente bloques Mamba basados en SS2D o estándar, MVM-UNet introduce MV4D para modelar características de imagen médica a partir de cuatro vistas complementarias de pares de escaneo, incluyendo escaneo en zigzag, jerárquico, espiral y radial.
2. Este artículo diseña SFusion Mamba y el bloque MVV para integrar representaciones específicas de escaneo y mejorar la transformación de características. SFusion Mamba fusiona las características extraídas de diferentes ramas de par de escaneo, mientras que las ramas residual y de proyección arriba-abajo dentro del bloque MVV proporcionan vías de características complementarias que estabilizan y enriquecen las representaciones de características.
3. Este artículo introduce MFusion Mamba como un módulo de fusión multietapa intermedio entre el codificador y el decodificador. A diferencia de las conexiones de salto convencionales que transfieren principalmente características correspondientes de la etapa, MFusion Mamba agrega explícitamente características del codificador multietapa mediante fusión de grueso a fino y proporciona información enriquecida para la decodificación.
4. Numerosos resultados experimentales demuestran que el MVM-UNet propuesto logra un rendimiento de segmentación competitiva en los conjuntos de datos ISIC 2017 e ISIC 2018 y un rendimiento sólido en el conjunto de datos de segmentación multiórgano Synapse. Además, estudios exhaustivos de ablación validan la contribución de cada componente dentro del MVM-UNet.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utilizó únicamente conjuntos de datos de imágenes médicas disponibles públicamente y desidentificados, incluyendo ISIC 2017, ISIC 2018 y Synapse. No se recogieron nuevos participantes humanos, sujetos animales ni registros médicos privados identificables en este estudio. El conjunto de datos ISIC 2017 utilizado en este estudio fue el conjunto de datos de segmentación de lesiones cutáneas ISIC 2017 Challenge, obtenido del repositorio oficial de datos de la International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). La versión del conjunto de datos utilizada en este estudio corresponde a la tarea de segmentación de lesiones ISIC 2017, incluyendo las particiones oficiales de entrenamiento, validación y prueba. El conjunto de datos fue descargado el 15 de marzo de 2024. El conjunto de datos ISIC 2018 utilizado en este estudio fue el conjunto de datos de segmentación de límites de lesiones ISIC Challenge Task 1, obtenido del repositorio oficial de datos de desafíos de la International Imaging Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). La versión del conjunto de datos utilizada en este estudio corresponde a la Tarea 1 de ISIC 2018: Segmentación de Límites de Lesiones. El conjunto de datos se descargó el 8 de julio de 2024.
El conjunto de datos de Synapse utilizado en este estudio fue el conjunto de datos de tomografía abdominal Multi-Atlas Labeling Beyond the Cranial Vault, obtenido del repositorio Synapse bajo el identificador de acceso syn3193805 (https://www.synapse.org/Synapse:syn3193805). El conjunto de datos utilizado en este estudio corresponde al conjunto de datos de segmentación multiorganáctica de 30 casos para tomografía computarizada abdominal de 30 casos. El archivo descargado fue Abdomen/RawData.zip, disponible bajo la sinsina de acceso 3193805. El repositorio no proporcionó ningún número de versión, etiqueta de lanzamiento ni etiqueta fechada en el momento de la descarga. Siguiendo la división estándar adoptada en estudios previos, se utilizaron 18 casos para entrenamiento y 12 casos para pruebas. La división de datos siguió a la lista de casos utilizada por TransUNet23. Específicamente, los casos de formación fueron case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 y case0037, mientras que los casos de prueba fueron case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0003, case0001, case0004, case0025 y case0035. El conjunto de datos se descargó el 9 de julio de 2024. Dado que este estudio utilizó únicamente conjuntos de datos públicos y desidentificados y no implicó la recopilación de nuevos datos de sujetos humanos ni información privada identificable, no se requirió la aprobación del comité de revisión institucional para los experimentos computacionales descritos en este protocolo. No se obtuvo ninguna determinación formal por escrito sobre la exención institucional. Si la política institucional local lo requiere, los investigadores deberían obtener una determinación de exención institucional antes de realizar análisis secundarios de conjuntos de datos disponibles públicamente. No se disponía de número de referencia de exención ética institucional ni documentación formal de exención para este estudio.
1. Preparación de conjuntos de datos
- Descargue el conjunto de datos de segmentación de lesiones cutáneas ISIC 2017 desde el repositorio oficial de la Colaboración Internacional de Imagen Cutana. Utiliza las particiones oficiales de formación, validación y prueba. Verifica que el conjunto de datos contiene 2.000 imágenes de entrenamiento, 150 imágenes de validación y 600 imágenes de prueba.
- Descargue el conjunto de datos de segmentación de lesiones cutáneas ISIC 2018 desde el repositorio oficial de la Colaboración Internacional de Imagen Cutana. Utiliza las particiones oficiales de formación, validación y prueba. Verifica que el conjunto de datos de segmentación contiene 2.594 imágenes de entrenamiento, 100 imágenes de validación y 1.000 imágenes de prueba.
- Descarga el conjunto de datos de segmentación multiórgano Synapse. Utiliza la división estándar que consta de 18 cajas (2.212 cortes axiales) para entrenamiento y 12 cajas (1.567 cortes axiales) para pruebas. No introduzcas un conjunto de validación separado.
- Reserva los 12 casos de prueba exclusivamente para la evaluación final. No utilices los casos de prueba para entrenamiento de modelos, ajuste de hiperparámetros o selección de modelos. La tarea de segmentación incluye ocho órganos abdominales: aorta, vesícula biliar, bazo, riñón izquierdo, riñón derecho, hígado, páncreas y estómago.
- Utiliza la siguiente división del conjunto de datos de Synapse. Los 18 casos de formación fueron case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 y case0037. Los 12 casos de prueba fueron case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 y case0035.
- Organiza cada conjunto de datos en carpetas separadas de imágenes y máscaras. Asegúrate de que cada imagen tenga una máscara de segmentación correspondiente con el mismo identificador de mayúsculas.
- Convierte cada máscara de lesión cutánea en un mapa binario de segmentación de primer plano y fondo. Conservar las etiquetas originales de órganos multiclase para el conjunto de datos Synapse.
- Para los conjuntos de datos ISIC 2017 e ISIC 2018, asignar un valor de etiqueta de 0 a los píxeles de fondo y 1 a los píxeles de lesión (primer plano) tras la conversión binaria de máscaras. Los píxeles con valores de máscara originales superiores a 0 se tratan como primer plano y se convierten a 1, mientras que los píxeles con valores originales de máscara igual a 0 se consideran fondo y se mantienen como 0. Para el conjunto de datos Synapse, conservar los valores originales de etiquetas enteras, siendo 0 la clase de fondo y 1–8 las ocho clases de órgano en primer plano.
- Redimensionar las imágenes y máscaras ISIC 2017 e ISIC 2018 a 256 × 256 píxeles sin preservar la relación de aspecto original. No apliques recorte ni relleno.
- Redimensiona cada segmento de Synapse CT y el correspondiente mapa de etiquetas a 224 × 224 píxeles. Utiliza interpolación bilineal para imágenes RGB, interpolación spline de tercer orden para cortes CT y interpolación de vecinos más cercanos para máscaras de segmentación.
- Redimensiona imágenes en Python.
- Para los conjuntos de datos ISIC 2017 e ISIC 2018, utiliza la transformada personalizada myResize implementada en utils.py, que llama a torchvision.transforms.functional.resize para redimensionar tanto los tensores de imagen como de máscara a 256 × 256 píxeles. No especifique un modo de interpolación explícito ni un argumento de antialiasing en esta transformación.
- Para el conjunto de datos Synapse, usa scipy.ndimage.zoom en datasets/dataset.py. Redimensionar los cortes de imagen CT a 224 × 224 píxeles usando interpolación spline de tercer orden (orden = 3), y redimensionar mapas de etiquetas usando interpolación de vecinos más cercanos (orden = 0). No aplique una operación de antialiasing separada ni una configuración anti_aliasing=Verdadero durante el redimensionado.
- Normaliza cada imagen RGB ISIC antes de la conversión tensorial usando la media y desviación estándar (SD) específicas del conjunto de datos usando la Ecuación 1 de la siguiente manera:
 (1)
Luego reescala la imagen normalizada al rango de 0–255 usando la normalización min–max.- Utilice μ = 159,922 y σ = 28,871 para el conjunto de entrenamiento ISIC 2017 y μ = 148,429 y σ = 25,748 para los conjuntos de validación y prueba ISIC 2017. Utilice μ = 157,561 y σ = 26,706 para el conjunto de entrenamiento ISIC 2018 y μ = 149,034 y σ = 32,022 para los conjuntos de validación y prueba ISIC 2018.
- Convierta cada imagen normalizada en un tensor de forma 3 × 256 × 256. Convierte cada máscara binaria en un tensor de forma 1 × 256 × 256.
- Realizar la normalización min–max de forma independiente para cada imagen tras la normalización de media y desviación estándar específicas del conjunto de datos. Específicamente, resta la media específica del conjunto de datos de cada imagen y divide por la desviación estándar correspondiente.
- Calcula los valores de intensidad mínima y máxima de la imagen normalizada y reescala la imagen al rango 0–255 usando estos valores mínimos y máximos por imagen. No utilices valores mínimos y máximos a nivel de conjunto de datos para este paso de reescalado mínimo-máximo.
- Prepara cada corte de Synapse CT como una imagen bidimensional en escala de grises. Convierte cada corte CT a float32 y añade una dimensión de canal singleton para obtener un tensor de entrada con forma 1 × 224 × 224.
- Conserva cada mapa de etiquetas Synapse como una máscara entera de canal único con las formas 224 × 224. No aplique una normalización adicional de media-SD a nivel de conjunto de datos en el cargador de datos.
- Utiliza los archivos Synapse preprocesados proporcionados en formato .npz para los slices de entrenamiento y en formato .npy.h5 para probar volúmenes. Carga los arrays de imagen y etiquetas directamente desde cada archivo .npz durante el entrenamiento y directamente desde cada archivo .npy.h5 durante las pruebas. No aplique recorte de intensidad adicional, ventanas CT, normalización a nivel de conjunto de datos ni remuestreo de volumen bruto en el cargador de datos liberado.
- Durante el entrenamiento del modelo, convierte cada segmento bidimensional cargado a float32, redimensionarlo al tamaño espacial objetivo usando scipy.ndimage.zoom con orden = 3 para cortes de imagen y orden = 0 para mapas de etiquetas, y luego convierte los arrays redimensionados a tensores con dimensión de canal único.
- Aplica la aumentación de datos solo al conjunto de entrenamiento. Para ISIC 2017 e ISIC 2018, aplica volteamiento horizontal aleatorio (p = 0,5), volteo vertical aleatorio (p = 0,5) y rotación aleatoria (p = 0,5) con un ángulo muestreado de 0° a 360°.
- Aplica la misma transformación geométrica a cada par imagen-máscara. Durante la validación y prueba, aplica solo redimensionamiento, normalización y conversión de tensores.
- Para el conjunto de datos Synapse, aplica rotación aleatoria y cambios aleatorios durante el entrenamiento. Gira aleatoriamente cada par imagen-etiqueta en k × 90°, donde k ∈ {0,1,2,3}, invierte aleatoriamente el par imagen-etiqueta a lo largo de un eje espacial, o rota aleatoriamente el par imagen-etiqueta en un ángulo muestreado de −20° a 20°.
- No apliques aumentos estocásticos durante las pruebas.
- Aplicar la ampliación de datos al conjunto de datos Synapse utilizando las ramas mutuamente excluyentes implementadas en la transformación RandomGenerator.
- Para cada muestra de entrenamiento, primero evalúa la condición random.random() > 0,5. Si se cumple esta condición, se aplica random_rot_flip, que consiste en una rotación aleatoria de 90° (k = 0, 1, 2 o 3) seguida de un giro aleatorio a lo largo de un eje espacial.
- Si no se selecciona la primera rama, evalúa una segunda condición, random.random() > 0,5. Si se cumple esta condición, se aplica random_rotate usando un ángulo de rotación seleccionado aleatoriamente entre −20° y 20°. Si ninguna de las dos condiciones se cumple, no se aplique aumento estocástico a la muestra.
- Aplica la misma transformación tanto a la imagen de entrada como al correspondiente mapa de etiquetas.
- Establece la semilla aleatoria antes de cargar el conjunto de datos, preprocesar y entrenar. Utiliza semillas aleatorias 1, 52 y 100 para los experimentos principales de comparación y usa semilla 100 para estudios de ablación, salvo que se especifique lo contrario.
- Inicializa los generadores aleatorios de Python, NumPy, CPU PyTorch, CUDA y cuDNN antes de construir el cargador de datos. Mantén sin cambios las particiones de conjuntos de datos, los procedimientos de preprocesamiento, los ajustes de aumento, los parámetros de normalización, la estrategia de redimensionamiento y el preprocesamiento de evaluación en todas las ejecuciones semilla.
- Fija num_workers = 0 tanto para los experimentos ISIC como Synapse para realizar la carga de datos en el proceso principal. Antes de construir el conjunto de datos y crear el DataLoader, inicializa la semilla aleatoria global usando la función set_seed para iniciar los generadores de números aleatorios en Python, NumPy, CPU PyTorch, CUDA y cuDNN. No definas un worker_init_fn separado ni un generador aleatorio específico de DataLoader, ya que estos no se utilizan en la implementación publicada.
2. Construcción de la arquitectura MVM-UNet
- Construye la propuesta Multi-view Vision Mamba UNet (MVM-UNet) utilizando una arquitectura codificador-decodificador en forma de U.
- Configura la dimensión de la imagen de entrada en H × W × 3. Pasa la imagen de entrada a través de la capa de incrustación de parches.
- Implementa la capa de incrustación de parches usando una convolución 2D con un tamaño de kernel de 4 × 4, paso de 4, tres canales de entrada y 96 canales de salida.
- Transforma el mapa de características de entrada a una resolución espacial de H/4 × W/4 con C = 96 canales de salida.
- Construye cuatro etapas codificadoras y cuatro etapas decodificadoras. Reduce la resolución espacial a la mitad y duplica la dimensión del canal tras cada etapa del codificador.
- Utiliza una configuración codificador-decodificador simétrica. Establece el número de bloques MVV tanto en el codificador como en el decodificador a {2, 2, 2, 2}.
- Coloca dos bloques MVV en cada etapa codificadora y dos bloques MVV en cada etapa del decodificador.
- Inserta un bloque MVV en cada etapa del codificador y decodificador. Utiliza el módulo MV4D como módulo principal de extracción de características dentro de cada bloque MVV.
- Inserta el módulo MFusion Mamba entre el codificador y el decodificador. Utiliza este módulo para fusionar las características del codificador multietapa antes de decodificar.
- Configura el flujo de trabajo general de MVM-UNet. Usa MV4D para la extracción de características a lo largo del codificador.
- Conserva las salidas del codificador como conexiones de salto. Pasa las salidas del codificador a las etapas correspondientes del decodificador.
- Pasa las funciones del codificador a MFusion Mamba antes de decodificar. Incrementar progresivamente la representación fusionada a través del decodificador y generar el mapa final de segmentación usando la cabeza de segmentación.
- Pasa la imagen de entrada I ∈ RB×H×W×3 a través de la capa de incrustación de parches para obtener
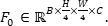 Aquí, C = 96.
- Generar mapas de características del codificador: E1 ∈ RB×H/4×W/4×C, E2 ∈R B×H/8×W/8×2C, E 3 ∈R B×H/16×W/16×4C y E4 ∈R B×H/32×W/32×8C. Utiliza bloques MVV que contienen MV4D en cada etapa del codificador.
- Conserva todas las funciones del codificador para la conexión de salto correspondiente. Pasa todas las características del codificador a MFusion Mamba para la fusión de características multietapa.
- Alinear las características del codificador con un espacio común de características antes de la fusión gruesa y fina dentro de MFusion Mamba. Pasa la representación fusionada al decodificador.
- Muestreo progresivamente en la representación del decodificador. Fusiona las características del decodificador con E3 en H/16 × W/16, E2 en H/8 × W/8 y E1 en H/4 × W/4.
- Muestrea la función final del decodificador a la resolución original de la imagen. Genera el mapa
 de predicción ∈R B×H×W×K. Aquí, K = 1 para la segmentación binaria de lesiones y K = 8 para la segmentación multiorgano de sinapsis.
- Consulte la Figura 2 para la arquitectura general de red y la Tabla Suplementaria 1 para la especificación completa de la arquitectura capa por capa, incluyendo las operaciones, parámetros principales y dimensiones de las características de salida para cada etapa
- Capas de transición codificador–decodificador
- Reducir las características del codificador usando capas de transición con fusión de parches. Para cada transición, muestrear cuatro grupos de características espacialmente entrelazados de un vecindario 2 × 2, concatenarlos a lo largo de la dimensión del canal, aplicar la Normalización de Capa (LayerNorm) y proyectar la característica resultante de dimensión 4C en canales 2C usando una capa lineal libre de sesgo. Esta operación reduce la resolución espacial en un factor de 2 mientras duplica la dimensión del canal.
- Upmuestrear características del decodificador usando capas de transición que expanden parches. Aplicar una proyección lineal libre de sesgos, reorganizar las características ampliadas espacialmente para aumentar la resolución por un factor de 2, y aplicar LayerNorm tras la expansión espacial. Repita esta operación para reconstruir progresivamente los mapas de características desde H/32 × W/32 hasta H/16 × W/16, H/8 × W/8 y H/4 × W/4.
- Alinea las características del codificador dentro del módulo MFusion Mamba redimensionándolas a la resolución espacial objetivo mediante interpolación bilineal (align_corners = Falso) y luego aplicando una proyección lineal de canal aprendible antes de la fusión de características.
- Cabezal de segmentación
- Upsampliza el mapa final de características del decodificador desde H/4 × W/4 hasta la resolución original de imagen (H × W) usando la capa final de expansión de parches. Aplicar proyección lineal, realizar reordenaciones espaciales con un factor de expansión de 4 y aplicar LayerNorm.
- Proyecta el mapa de características reconstruido a K canales de salida usando una convolución 1 × 1 después de convertir el tensor a formato canal primero.
- Generar la predicción final durante la evaluación aplicando una función de activación sigmoide para la segmentación binaria de lesiones o una activación softmax seguida de argmax para la segmentación multiorgánica de sinapsis. No apliques una función de activación dentro del propio cabezal de segmentación.
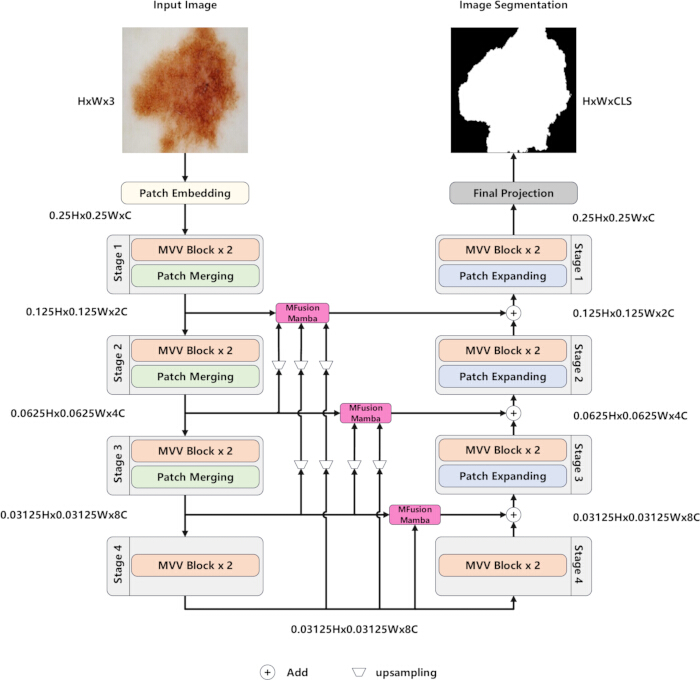
Figura 2. Arquitectura general de Multi-View Mamba U-Net (MVM-UNet). Visión general de la arquitectura propuesta Multi-View Mamba U-Net (MVM-UNet). La imagen de entrada se convierte en incrustaciones de parches y se procesa a través de cuatro etapas de codificador compuestas por bloques Multi-View Vision (MVV) separados por operaciones de fusión de parches. Las características del codificador se agregan mediante Multi-stage Fusion Mamba (MFusion Mamba) y se propagan al decodificador mediante conexiones de salto. El decodificador restaura progresivamente la resolución espacial mediante operaciones de expansión de parches y genera el mapa final de segmentación a través de la capa de proyección. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
3. Construcción del módulo MV4D
- Utiliza el módulo MV4D como la unidad básica de extracción de características en el bloque MVV. Alimenta los parches de características de entrada en cuatro ramas de pares de escaneo. Consulte el Algoritmo 1, Archivo Suplementario 1 para el pseudocódigo completo de aplanamiento espacial, construcción de índices de pares de escaneo, recopilación de secuencias, procesamiento S6/Mamba, reordenación espacial inversa, fusión de pares de barrido, fusión SFusion Mamba, proyección y remodelado de salida.
- Utiliza los procedimientos exactos de generación de índices de escaneo en zigzag, jerárquicos, espirales y radiales implementados en modelos/mvmunet/core.py. Para cada estrategia de escaneo, utiliza el orden de escaneo directo y su orden inverso como un par de escaneo bidireccional.
- Construye el par de escaneo en zigzag. Recorre las características de la imagen en direcciones alternas al final de cada fila o columna. Utiliza este patrón de escaneo para equilibrar la información espacial local y global.
- Construye el par jerárquico de escaneo. Captura características a múltiples escalas espaciales. Utiliza este patrón de escaneo para reforzar la extracción tanto de representaciones locales como globales.
- Construye el par de escaneo en espiral. Escanea las características de la imagen desde el centro hacia el límite o desde el límite hacia el centro. Utiliza este patrón de escaneo para mejorar la extracción de información global de contornos.
- Construye el par de escaneo radial. Escanea las características de imagen en múltiples direcciones radiales. Utiliza este patrón de escaneo para mejorar la extracción de detalles locales de límites y bordes.
- Fusiona cada par de escaneo antes de introducir la secuencia fusionada en el bloque S6. Utiliza el diseño emparejado para mejorar la robustez de cada estrategia de escaneo preservando la eficiencia computacional.
- Alimenta la secuencia de salida de cada rama de par de escaneo en un bloque S6. Obtén cuatro representaciones de características correspondientes a las vistas en zigzag, jerárquica, espiral y radial de escaneo.
- Fusiona las cuatro representaciones de características extraídas usando el módulo SFusion Mamba. Utiliza dos vías de fusión paralelas. En la primera ruta, integra las cuatro características mediante una adición elemento a elemento.
- En la segunda vía SFusion Mamba, concatena las cuatro características. Procesa la representación concatenada usando Conv1d y Mamba. Reduce la dimensión del canal usando una capa de proyección para que coincida con la dimensión de salida del bloque S6.
- Configura el bloque S6/Mamba usando la dimensión de característica C como dimensión del modelo. Utiliza una capa de proyección para mapear cada característica de par de escaneo fusionada de vuelta a la dimensión del canal C antes de la fusión.
- En SFusion Mamba, realiza la suma elemento por elemento en la primera vía. Concatena las cuatro características de vista de escaneo en la segunda vía antes de Conv1d, Mamba y proyección lineal. Utiliza las operaciones de normalización, proyección lineal, convolución separable en profundidad y activación que rodean MV4D como se describe en el Paso 4.
- Sumar las salidas de las dos vías de fusión para obtener la salida final del módulo MV4D.
- Construir cuatro ramas complementarias de par de escaneo en lugar de usar solo direcciones de escaneo horizontales y verticales. Utiliza el escaneo en zigzag para enfatizar la travesía espacial continua, el escaneo jerárquico para reforzar la representación multiescala, el escaneo en espiral para capturar información de contorno de centro a frontera y el escaneo radial para mejorar la extracción de detalles locales orientados a fronteras.
- Procesa cada rama de par de escaneo de forma independiente. Fusiona las características resultantes usando SFusion Mamba. Mapea cada secuencia procesada de vuelta a su orden espacial original antes de la fusión.
- Dado un mapa de características de entrada X ∈ RB×H×W×C, aplanarla en Xseq ∈ RB×L×C, donde L = H × W.
- Reordenar la secuencia aplanada según los índices de escaneo de cada rama de par de barrido. Procesa cada secuencia reordenada usando el bloque S6. Restaura la secuencia procesada al orden espacial original.
- Fusiona las cuatro características de vista de escaneo a través de la vía aditiva y la vía SFusion Mamba para obtener la salida final MV4D. Consulte la Figura 3 para la arquitectura MV4D y el Algoritmo 1, Archivo Suplementario 1 para el flujo de trabajo completo de implementación a nivel de tensor.
- Utiliza toda la implementación de software en models/mvmunet/core.py. Este archivo contiene los generadores de índices de escaneo, PairwiseScanMamba, SequenceS6, SFusion Mamba y el módulo envolvente MV4D.
- Generar índices de escaneo multivista
- Genera los índices de escaneo siguiendo la implementación publicada en models/mvmunet/core.py. Para un mapa de características de entrada de tamaño espacial H × W, aplanar cada ubicación de píxel en un índice unidimensional usando: índice = r × W + c, donde r y c denotan las coordenadas de fila y columna, respectivamente.
- Genera el escaneo en zigzag recorriendo diagonales de imagen con r + c constante. Recoge los índices de píxeles válidos para cada diagonal y alterna la dirección de recorrido invirtiendo el orden de cada diagonal par.
- Genera el escaneo jerárquico dividiendo recursivamente la imagen en cuatro cuadrantes. Visita los cuadrantes superior izquierdo, superior derecho, inferior izquierdo e inferior derecho secuencialmente hasta que la altura o ancho de la subregión no supere 2 píxeles, y luego recorre los píxeles restantes en orden de fila mayor.
- Genera el escaneo en espiral recorriendo el límite exterior de la imagen de izquierda a derecha a lo largo de la fila superior, hacia abajo por la columna derecha, de derecha a izquierda por la fila inferior y hacia arriba por la columna izquierda mientras se va reduciendo progresivamente el límite hacia el centro de la imagen.
- Genera el escaneo radial ordenando cada píxel según su distancia cuadrada desde el centro de la imagen y luego según su ángulo polar calculado usando la función atan2.
- Genera el escaneo inverso para cada estrategia de escaneo invirtiendo el orden correspondiente de escaneo hacia adelante. Combina las secuencias de escaneo hacia adelante e inverso para formar un par de escaneo para cada estrategia de escaneo antes de pasar los pares de escaneo al módulo MV4D.
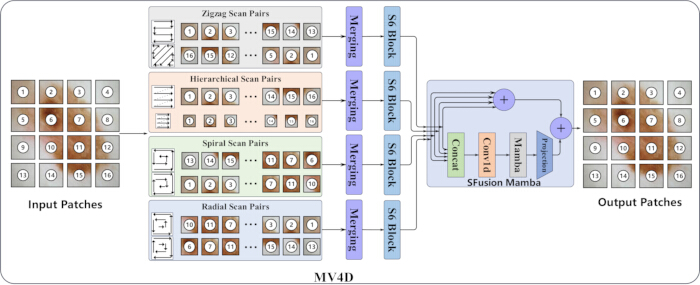
Figura 3. Arquitectura del módulo Multi-View 4-Directional (MV4D). Estructura del módulo de extracción de características Multi-View 4-Directional (MV4D). Los parches de entrada se procesan a través de cuatro ramas complementarias de pares de escaneo, incluyendo escaneo en zigzag, jerárquico, espiral y radial. Las características extraídas de las cuatro ramas se fusionan, se procesan usando bloques de espacio de estados e integran Spatial Fusion Mamba (SFusion Mamba) para generar la representación de características de salida. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
4. Construcción del bloque MVV
- Construye el bloque MVV usando una rama principal y dos ramas auxiliares. Utiliza la estructura general mostrada en la Figura 4.
- Aplica la normalización de capas a la característica de entrada en la rama principal. Alimenta la característica normalizada en una capa lineal. Pasa la característica transformada a la convolución separable en profundidad.
- Procesa la característica transformada usando la convolución separable en profundidad. Aplica la función de activación GELU. Introduce la función activada en el módulo MV4D.
- Construye la primera rama auxiliar como una conexión residual de identidad. Conecta la función de entrada directamente a la salida final. Utiliza esta rama para preservar la representación original y estabilizar la formación.
- Construye la segunda rama auxiliar como una rama de proyección descendente-ascendente. Comprime la característica de entrada usando una capa de proyección hacia abajo. Restaura la dimensión de la característica usando una capa de proyección hacia arriba.
- Fusiona las salidas de la rama principal y de ambas ramas auxiliares. Obtén la salida final del bloque MVV. Consulte la Figura 4 para la arquitectura completa.
- Establezca la dimensión oculta de la rama principal igual a la dimensión del canal de entrada Cs. Aplica LayerNorm(Cs) antes de la proyección lineal principal y utiliza una capa lineal con dimensiones Cs→Cs. Utiliza una convolución separable en profundidad que consiste en una convolución 3×3 por profundidad con relleno 1, grupos = Cs y sin sesgo, seguida de una convolución punto a punto 1×1 sin sesgo.
- Aplica la función de activación GELU después de la convolución separable en profundidad. Introduce la característica activada en MV4D y aplica una proyección lineal de salida con dimensiones Cs→C s. Configura la rama de proyección descendente-ascendente usando LayerNorm(Cs), una proporción de proyección de 4, una proyección descendente Cs→Cs/4, activación GELU y una proyección ascendente Cs/4→Cs.
- Combina la rama identidad, la rama de proyección descendente-ascendente y la rama principal procesada por rutas de caída usando la suma elemento por elemento para obtener la salida final del bloque MVV.
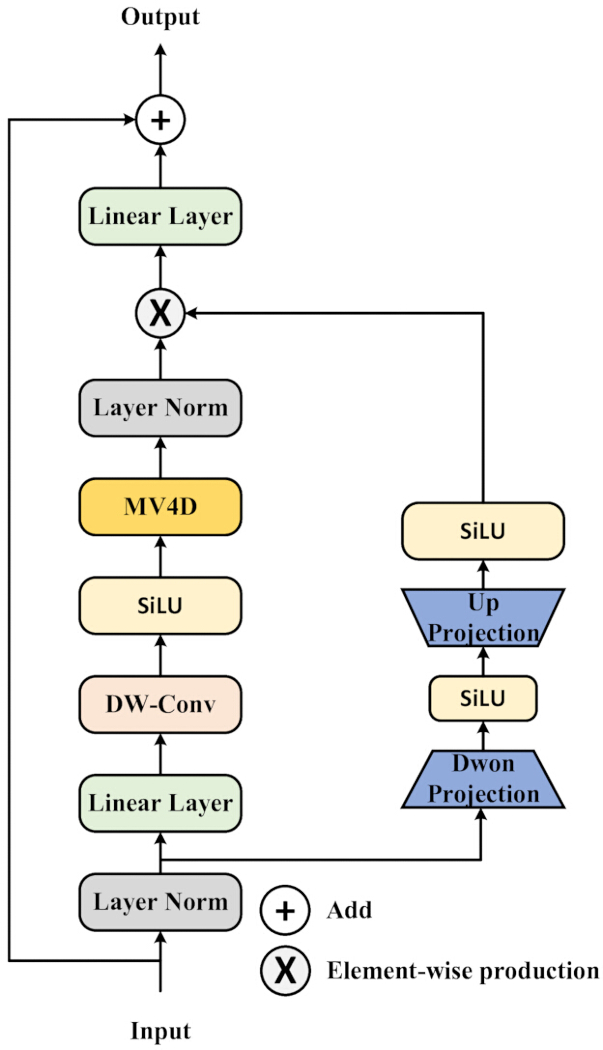
Figura 4. Arquitectura del bloque Multi-View Vision (MVV). Estructura del bloque Multi-View Vision (MVV). El bloque consiste en una rama principal de extracción de características que contiene el módulo Multi-View 4-Directional (MV4D) junto con capas de convolución en profundidad, normalización y proyección lineal. Una rama auxiliar de proyección arriba-abajo proporciona modulación de características con puertas mediante multiplicación elemento por elemento antes de la suma residual para generar la representación de características de salida. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
5. Construcción de MFusion Mamba
- Recoge los mapas de características de todas las etapas del codificador. Alinea las características del codificador a un espacio de representación unificado redimensionándolas o proyectándolas cuando sea necesario. Consulte el Algoritmo 2, Archivo Suplementario 1 para el flujo de trabajo completo de implementación a nivel de tensor.
- Redimensionar las características del codificador a la resolución espacial objetivo cuando sea necesario. Características del proyecto con diferentes dimensiones de canal dentro de la misma dimensión de canal. Alinea todas las características del codificador antes de la fusión multietapa.
- Introduce las características del codificador alineado en el componente de fusión gruesa. Realizar fusión gruesa usando el producto de Hadamard. Genera la representación fundida gruesa.
- Introduce la representación fusionada gruesa en el componente de fusión fina. Construye dos vías paralelas de fusión fina. Procesa ambas vías de forma independiente.
- Procesa la primera vía de fusión fina usando una capa lineal. Procesa la segunda vía de fusión fina usando proyección hacia arriba, Conv1d, Mamba y proyección hacia abajo. Restaura la dimensión de la característica tras la proyección hacia abajo.
- Fusiona las salidas de las dos vías de fusión fina usando el producto de Hadamard. Aplica la capa lineal final. Obtén la salida MFusion Mamba.
- Introduce la salida MFusion Mamba en el decodificador. Decodifica la representación multietapa fusionada junto con las características de salto codificador-decodificador. Genera el mapa final de segmentación.
- Alinear las características del codificador de diferentes etapas en un espacio unificado de características antes de la fusión gruesa. Procesa las representaciones de características alineadas usando las etapas de fusión gruesa y fina. Consulte la Figura 5 para la arquitectura MFusion Mamba y el Algoritmo Suplementario 2 para el flujo de trabajo completo de implementación a nivel de tensor.
- Utiliza los parámetros de implementación de MFusion Mamba de la siguiente manera. Para cada característica del codificador Ei, proyecta la dimensión del canal de Ci a Ct. Redimensionar las características proyectadas al tamaño espacial objetivo usando interpolación bilineal con align_corners=False cuando sea necesario.
- Aplicar el producto de Hadamard para realizar fusión gruesa a través de las características del codificador alineado. Configura la primera vía de fusión fina usando una capa lineal con dimensiones Ct → Ct. Configura la segunda vía de fusión fina usando una proyección ascendente Ct → 2Ct, Conv1d, un bloque Mamba/S6 con dimensión de modelo 2Ct, una dirección de barrido, dimensión de estado 16 y una proyección descendente 2Ct → Ct.
- Fusiona las salidas de las vías de fusión fina usando el producto de Hadamard. Aplica una proyección lineal final con dimensiones Ct a Ct. Introduce la representación multietapa fusionada en el decodificador.
- Características del codificador multietapa de fusibles usando MFusion Mamba
- Recoge las características del codificador de las cuatro etapas del codificador (E1, E2, E3 y E4) y úsalas como entrada al módulo MFusion Mamba. No seleccione solo la característica del codificador de etapa correspondiente para la fusión del decodificador.
- Alinear todas las características del codificador con la resolución espacial requerida para la etapa actual del decodificador. Redimensiona las características del codificador a la resolución objetivo y projéctalas a la dimensión del canal requerida antes de la fusión de características.
- Repite el procedimiento de alineación de características para cada etapa del decodificador. Cuando el decodificador opera en H/16 × W/16, H/8 × W/8 y H/4 × W/4, redimensiona y proyecta E1, E2,E 3 y E4 al espacio de características objetivo correspondiente.
- Fusiona las características alineadas del codificador multietapa usando las operaciones de fusión gruesa y fusión fina del módulo MFusion Mamba, y combina la representación fusionada con las características del decodificador a la escala correspondiente.
- Realiza las operaciones de proyección de características, redimensionamiento y fusión según la implementación publicada en models/mvmunet/core.py.
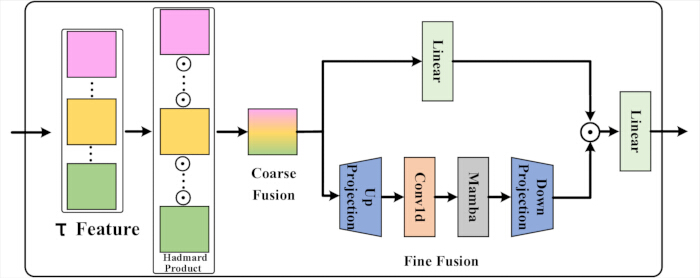
Figura 5. Arquitectura del módulo Multi-stage Fusion Mamba (MFusion Mamba). Estructura del módulo Multi-stage Fusion Mamba (MFusion Mamba). Las características del codificador multiescala se combinan primero mediante fusión gruesa y posteriormente se refinan mediante el módulo de fusión fina, que consiste en proyección lineal, convolución unidimensional (Conv1d), un bloque Mamba y capas de proyección de características antes de la generación de la representación fusionada utilizada por el decodificador. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
6. Entrenamiento con modelos
- Entrena MVM-UNet en Ubuntu 22.04.1 con la versión 6.8.0 del núcleo de Linux. Utiliza una estación de trabajo equipada con un procesador Intel Core i9-13900K de 13ª generación y una GPU NVIDIA A800. Utiliza la misma configuración de hardware durante toda la formación y la evaluación.
- Implementa y entrena el modelo usando PyTorch 2.0.1 con CUDA 11.8. Instala todas las dependencias de software necesarias antes de entrenar.
- Utiliza el optimizador AdamW con una tasa de aprendizaje inicial de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ y una decaída en peso de 0,01. Configura el tamaño del lote en 32 salvo que se especifique lo contrario.
- Entrena cada modelo durante 300 épocas. Utiliza un calendario de tasa de aprendizaje de recocido coseno con ηmin = 1 × 10⁻⁵. Establece el tamaño de la imagen de entrada a 256 × 256 para ISIC 2017 e ISIC 2018, y a 224 × 224 para Synapse.
- Utiliza tres semillas aleatorias independientes (1, 52 y 100) para los experimentos principales de comparación. Repite todo el proceso de entrenamiento y evaluación para cada semilla. Informa los resultados cuantitativos finales como media ± SD a lo largo de las tres partidas.
- Usa una semilla aleatoria fija de 100 para todos los estudios de ablación, salvo que se especifique lo contrario. Mantén las particiones de conjuntos de datos, la estrategia de preprocesamiento, la arquitectura de red, el optimizador, la tasa de aprendizaje, el tamaño del lote y el número de épocas de entrenamiento sin cambios en todos los experimentos de ablación.
- Utiliza la pérdida BCE-Dice para segmentación binaria de lesiones en ISIC 2017 e ISIC 2018. Establece los pesos de pérdida de BCE y Dice a 1.0. Usa la pérdida de dados de CE para Sinapsis y establece tanto los pesos de entropía cruzada como de pérdida de dados en 1.0.
- Redimensionar, normalizar e ampliar las imágenes de entrenamiento ISIC 2017 e ISIC 2018 utilizando el procedimiento de preprocesamiento descrito en el Paso 1. Aplica el redimensionamiento, la rotación aleatoria y el cambio aleatorio a las imágenes de entrenamiento de Synapse como se describe en el Paso 1. Usa los mismos ajustes de preprocesamiento durante todas las sesiones de entrenamiento.
- Selecciona los puntos de control del modelo según el protocolo de validación específico del conjunto de datos. Guarda el punto de control con el mejor rendimiento de validación para ISIC 2017 e ISIC 2018, y realiza validaciones cada 30 épocas. Entrena Synapse durante 300 épocas sin un conjunto de validación y utiliza el punto de control final de entrenamiento para las pruebas.
- Utiliza el conjunto oficial de validación solo para la selección de modelos en ISIC 2017 e ISIC 2018. No utilices el conjunto de pruebas Synapse para entrenamiento, ajuste de hiperparámetros o selección de puntos de control. Reserva todos los datos de las pruebas exclusivamente para la evaluación final.
- Utiliza los siguientes parámetros de entrenamiento para la reproducibilidad. Establece el tamaño del lote en 32 para todos los conjuntos de datos. Utiliza AdamW con una tasa de aprendizaje inicial de 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, y una disminución de peso de 1 × 10⁻².
- Configura el planificador de tasa de aprendizaje de recocido coseno con Tmax = 50 y ηmin = 1×10⁻⁵ para ISIC 2017 e ISIC 2018. Configura el planificador con Tmax = 100 y ηmin = 1×10⁻⁵ para Synapse. Mantén la configuración del planificador sin cambios para todos los experimentos repetidos.
- Entrena todos los modelos usando aritmética FP32 de máxima precisión. Desactiva el entrenamiento automático de precisión mixta. No apliques recorte de gradiente durante la optimización.
- Mantén sin cambios los ajustes de precisión, la estrategia de actualización de gradientes, la configuración del optimizador, el calendario de tasa de aprendizaje y el protocolo de semilla aleatoria sin cambios en todos los experimentos de comparación, estudios de ablación y ejecuciones de reproducibilidad.
- Selecciona el mejor modelo de punto de control
- Evalúa el modelo en el conjunto de validación tras cada época de entrenamiento para los conjuntos de datos ISIC 2017 e ISIC 2018.
- Calcula la pérdida de dados de Binary Cross-Entropy (BCE)-Dice para cada lote de validación y calcula la pérdida media de validación en todo el conjunto de validación.
- Guarda el modelo actual como mejor punto de control cuando la pérdida media de validación sea menor que la pérdida mínima de validación registrada previamente.
- Registrar la intersección media sobre la unión (mIoU), el coeficiente de similitud de dados (DSC), la precisión (Acc), la especificidad (Spe) y la sensibilidad (Sen) durante la validación solo para monitorización del rendimiento. No utilices estas métricas como criterio de selección de puntos de control.
7. Evaluación del modelo
- Evalúa el modelo entrenado usando el conjunto oficial de pruebas para cada conjunto de datos. Usa el conjunto de pruebas solo para la evaluación final del rendimiento.
- Para ISIC 2017 e ISIC 2018, calcula el mIoU, DSC, Acc, Sen y Spe. Utiliza los verdaderos positivos (TP), falsos positivos (FP), negativos verdaderos (TN) y falsos negativos (FN) para todos los cálculos.
- Aplicar una función de activación sigmoide a la salida del modelo para ISIC 2017 e ISIC 2018. Convierte el mapa de probabilidad en una máscara de segmentación binaria usando un umbral de 0,5. Calcula las métricas de evaluación usando las Ecuaciones 2–6:
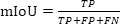 (2)
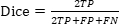 (3)
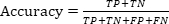 (4)
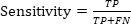 (5)
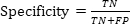 (6)
- Para Synapse, aplica la función de activación softmax a la salida del modelo. Asigna cada píxel o vóxel a la clase con mayor probabilidad usando la operación argmax. Calcula el DSC y la distancia de Hausdorff del percentil 95 (HD95) para cada órgano de primer plano y reporta los valores medios en todos los casos de prueba.
- Compare MVM-UNet con métodos de segmentación representativos basados en CNN, Transformer y modelos de espacio de estados (SSM). Utiliza particiones de conjuntos de datos, procedimientos de preprocesamiento, resoluciones de entrada y métricas de evaluación idénticas para todos los métodos.
- Utiliza las particiones oficiales de formación, validación y pruebas para ISIC 2017 e ISIC 2018. Utiliza la división estándar de 18 casos de entrenamiento y 12 casos de prueba para Synapse. Establece la resolución de entrada en para conjuntos de datos ISIC y para Synapse.
- Reproduce métodos de referencia usando sus implementaciones oficiales siempre que estén disponibles. Informa los resultados como media ± SD a lo largo de repetidas ejecuciones. Conservar los valores reportados por la literatura tal como se publicaron originalmente y distinguirlos en las notas correspondientes de la tabla.
- Realiza estudios de ablación usando la semilla aleatoria fija de 100, salvo que se especifique lo contrario. Mantén sin cambios las particiones de conjuntos de datos, el procedimiento de preprocesamiento, la resolución de entrada, el optimizador, el calendario de tasa de aprendizaje, el tamaño del lote, el número de épocas, la función de pérdida y las métricas de evaluación sin cambios en todos los experimentos de ablación.
- Evalúa las contribuciones de MV4D, SFusion Mamba, la rama de proyección Up-Down en el bloque MVV, MFusion Mamba, el tamaño de la imagen de entrada, el valor de dropout y la configuración de la capa codificador-decodificador. Modificar solo el componente o parámetro objetivo en cada experimento de ablación.
- Realizar la prueba de rango por signos de Wilcoxon utilizando resultados por imagen emparejados para ISIC 2017 e ISIC 2018 y resultados por caso pareados para Synapse. Consideremos un valor p menor que 0,05 para indicar significación estadística.
- Evalúa la eficiencia computacional utilizando el mismo entorno de hardware y resolución de entrada para todos los métodos. Mide el tiempo de entrenamiento por época, el tiempo de inferencia por imagen, el uso máximo de memoria de la GPU durante el entrenamiento, el número de parámetros del modelo y las operaciones de coma flotante (FLOPs). Calcula los FLOPs usando un solo pase hacia adelante.
- Selecciona ejemplos cualitativos representativos solo del conjunto de pruebas tras completar la evaluación del modelo. Compara la imagen original, la máscara de la verdad en el terreno y la máscara predicha usando casos de prueba idénticos en todos los métodos. Selecciona ejemplos representativos que incluyan objetivos pequeños, límites irregulares, límites ambiguos y estructuras representativas de múltiples órganos.
- Calcular métricas de evaluación y realizar análisis estadísticos
- Calcula las métricas de segmentación para los conjuntos de datos ISIC 2017 e ISIC 2018 en Python usando NumPy y sklearn.metrics.confusion_matrix. Limita el mapa de probabilidad predicha en 0,5, obtén los TP, FP, TN y FN a nivel de píxel, y calcula el mIoU, DSC, Acc, Sen y Spe a partir de estos valores.
- Calcula el DSC y el HD95 para el conjunto de datos de Synapse usando medpy.metric.binary.dc y medpy.metric.binary.hd95, respectivamente. Aplica softmax seguido de argmax a la salida del modelo antes de calcular las métricas de evaluación.
- Calcula el número de FLOPs y parámetros entreenables usando thop.profile con un solo pase hacia adelante.
- Realiza la prueba de rango con signos de Wilcoxon en Python usando scipy.stats.wilcoxon. Utiliza valores de métrica por imagen emparejada para los conjuntos de datos ISIC 2017 e ISIC 2018 y valores métricos por caso emparejados para el conjunto de datos Synapse.
8. Definición de la función de pérdida
- Utiliza la pérdida estándar de Entropía Cruzada (CE) para segmentación multiclase y la pérdida estándar BCE para segmentación binaria. Utiliza la fórmula estándar de pérdida de dados para segmentación. Las ecuaciones 7–11 definen las funciones de pérdida utilizadas en este protocolo.
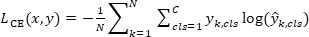 (7)
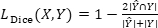 (8)
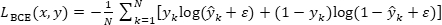 (9)
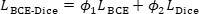 (10)
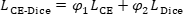 (11)
- Establece los pesos de pérdida BCE y Dice a 1.0 para ISIC 2017 e ISIC 2018, de modo que
 1 = 1.0 y 2 = 1.0. Establece los pesos de pérdida de CE y Dados a 1,0 para Synapse, φ1 = 1,0 y φ2 = 1,0.
- Implementa las funciones de pérdida en utils.py. Usa nn. BCELoss para el término BCE y nn. CrossEntropyLoss para el término CE. Calcula la pérdida binaria de dados aplanando cada máscara predicha y máscara de verdad en el terreno, calculando la pérdida de dados para cada muestra y promediando la pérdida a lo largo del lote. Calcula la pérdida de dados multiclase convirtiendo el mapa de etiquetas objetivo a formato de un solo hot, aplicando softmax a la salida del modelo, calculando la pérdida de dados para cada clase y promediando la pérdida entre todas las clases.
- Establece la constante de suavizado en 1 para la pérdida binaria de dados y en 1×10⁻⁵ para la pérdida multiclase de dados. Implementa la pérdida de BCE-Dice usando la clase BceDiceLoss con wb = 1 y wd = 1. Implementa la pérdida CE-Dice usando la clase CeDiceLoss con loss_weight = [1, 1]. Mantén las constantes de suavizado, la estrategia de reducción y la implementación del software sin cambios para todos los conjuntos de datos, semillas aleatorias y experimentos.
- Configurar la reducción de pérdidas
- Instanciar nn. BCELoss() y nn. PérdidaCruzEntropía() sin especificar explícitamente el argumento de reducción.
- Utiliza la configuración predeterminada de reducción de pérdidas de PyTorch (reducción = "media") para ambas funciones de pérdida. No use reducción = "suma" o una salida de pérdida no reducida.
9. Ajustes de reproducibilidad y ejecución
- Descarga la implementación publicada desde https://github.com/LIXUEGUANG002/MVM-UNet. Utiliza el repositorio junto con los paquetes de software, conjuntos de datos, especificaciones de hardware y recursos computacionales listados en la Tabla de Materiales.
- Clona el repositorio y accede al directorio del proyecto ejecutando git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, seguido de cd MVM-Unet.
- Configura el experimento ISIC 2017 o ISIC 2018 estableciendo el nombre del conjunto de datos, la ruta del conjunto, el tamaño de entrada, el tamaño del lote, el número de épocas, la función de pérdida, el optimizador, el planificador de tasa de aprendizaje y la semilla aleatoria en configuraciones/config_setting.py. Ejecuta el script de entrenamiento desde la raíz del repositorio usando train.py de Python.
- Configura el experimento Synapse estableciendo el nombre del conjunto de datos, la ruta de datos de entrenamiento, la ruta del volumen de pruebas, el directorio de listas, el tamaño de entrada, el número de clases, el tamaño del lote, el número de épocas, la función de pérdida, el optimizador, el planificador de tasa de aprendizaje y la semilla aleatoria en configuraciones/config_setting_synapse.py. Ejecuta el script de entrenamiento desde la raíz del repositorio usando train_synapse.py en python.
- Realiza una evaluación solo por inferencia estableciendo only_test_and_save_figs = True, best_ckpt_path al punto de control entrenado y img_save_path al directorio de salida en el archivo de configuración correspondiente. Ejecuta train.py de Python para ISIC 2017 o ISIC 2018, o ejecuta train_synapse.py de Python para Synapse para generar resultados de predicción y cifras cualitativas.
- Utiliza la versión publicada del código fuente
- Clona el repositorio de GitHub publicado y consulta el commit ee891b42c2f083c4990eed72f1dd4463adc5e103e en la rama maestra antes de configurar los conjuntos de datos, scripts de entrenamiento y ajustes de evaluación.
- Utiliza este compromiso para reproducir los experimentos reportados en este estudio. No había ninguna versión de lanzamiento etiquetada disponible para el repositorio en el momento de la revisión del manuscrito.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Resultados esperados e interpretación
Cuando este protocolo se implementa correctamente, se espera que el modelo entrenado MVM-UNet produzca un rendimiento de segmentación estable a lo largo de ejecuciones repetidas, con solo pequeñas variaciones entre diferentes semillas aleatorias para la mayoría de las métricas de evaluación. Para ISIC 2017 e ISIC 2018, los resultados exitosos se reflejan en valores altos de DSC, mIoU, Acc, Sen y Spe, junto con mascarillas de lesió...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este protocolo describe MVM-UNet, un marco de segmentación de imágenes médicas basado en Mamba. El método fue diseñado para abordar dos limitaciones de los modelos de segmentación existentes. En primer lugar, los métodos convencionales basados en CNN tienen una capacidad limitada para modelar dependencias a largo alcance e información contextual jerárquica en imágenes médicascomplejas 43. En segundo lugar, los métodos basados en transformadores pueden modelar el c...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen intereses financieros en competencia.
Agradecimientos
Esta investigación no recibió financiación externa.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 con kernel de Linux 6.8.0; CPU Intel Core i9-13900K; GPU NVIDIA A800; 128 GB de RAM; 512 GB de almacenamiento local. | Plataforma computacional para entrenamiento, validación, pruebas, ablación y experimentos solo de inferencia. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | GPU NVIDIA A800 (80 GB de memoria). | Entrenamiento e inferencia acelerados por GPU. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | CPU Intel Core i9-13900K de 13.ª generación. | Procesador host para carga de datos, preprocesamiento y ejecución de experimentos. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB de RAM del sistema | Memoria para carga de conjuntos de datos, preprocesamiento y entrenamiento. |
| Hardware - Storage | Institutional computing platform / local workstation | Unidad de estado sólido NVMe de 2 TB. | Almacenamiento para conjuntos de datos, puntos de control, registros y figuras de predicción generadas. |
| Software environment - Operating system | Canonical Ltd. | Recomendado: Ubuntu 22.04.1 LTS | Sistema operativo para el entorno computacional. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Nombre del entorno: mvmunet | Entorno de Python utilizado para instalar y aislar dependencias. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Lenguaje de programación utilizado para la implementación y ejecución de experimentos. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | Backend de computación GPU requerido por PyTorch y paquetes relacionados con Mamba. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | Primitivas de aprendizaje profundo aceleradas por GPU utilizadas a través de PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Marco de aprendizaje profundo para entrenamiento de modelos, cálculo de pérdidas, optimización e inferencia. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Utilidades de transformación de imágenes utilizadas en preprocesamiento y aumento. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Instalado con el entorno recomendado de PyTorch. |
| Python package - timm | timm developers | timm == 0.4.12 | Dependencia de componentes de modelo o utilidad listada en las instrucciones de entorno del repositorio. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependencia utilizada por componentes de modelado de secuencias acelerados por GPU. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Dependencia de convolución causal eficiente requerida por la implementación de Mamba. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Paquete de modelado de secuencias de espacio de estados utilizado para componentes relacionados con Mamba/S6. |
| Python package - NumPy | NumPy developers | Versión de NumPy 1.24.3. | Cálculo numérico y operaciones de matrices. |
| Python package - SciPy | SciPy developers | Versión de SciPy 1.10.1. | Cálculo científico; scipy.ndimage.zoom se importa en utils.py. |
| Python package - SimpleITK | Insight Software Consortium | Versión de SimpleITK 2.2.1. | Utilidad de entrada/salida e imagen médica preprocesada importada en utils.py. |
| Python package - MedPy | MedPy developers | Versión de MedPy 0.4.0. | Paquete de cálculo de métricas de imágenes médicas importado en utils.py. |
| Python package - scikit-image | scikit-image developers | Versión de scikit-image 0.21.0. | Dependencia de procesamiento de imágenes listada en README. |
| Python package - scikit-learn | scikit-learn developers | Versión de scikit-learn 1.3.2. | Paquete de utilidades de aprendizaje automático listado en README. |
| Python package - matplotlib | Matplotlib developers | Versión de Matplotlib 3.7.2. | Utilizado para guardar figuras de visualización cualitativa. |
| Python package - h5py | h5py developers | Versión de h5py 3.9.0. | Soporte de archivo HDF5 para volúmenes de prueba de Synapse. |
| Python package - thop | THOP developers | Versión de THOP 0.1.1.post2209072238. | Utilizado al calcular FLOPs y costo computacional relacionado con parámetros. |
| Python package - packaging | Python Packaging Authority | Versión de packaging 23.1. | Dependencia listada en README. |
| Python package - pytest | pytest developers | Versión de pytest 7.4.0. | Dependencia listada en README. |
| Python package - chardet | chardet developers | Versión de chardet 5.2.0. | Dependencia listada en README. |
| Python package - yacs | YACS developers | Versión de yacs 0.1.8. | Dependencia de utilidad de configuración listada en README. |
| Python package - termcolor | termcolor developers | Versión de termcolor 2.3.0. | Dependencia de utilidad de registro/terminal listada en README. |
| Python package - submitit | submitit developers | Versión de submitit 1.4.5. | Dependencia de utilidad de experimento/trabajo listada en README. |
| Python package - tensorboardX | tensorboardX developers | Versión de tensorboardX 2.6.2.2. | Utilidad de visualización de registro de entrenamiento listada en README. |
| Python package - ml-collections | ml_collections developers | Versión de ml-collections 0.1.1. | Importado por configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | Conjunto de datos de segmentación de lesiones cutáneas ISIC 2017 | Imágenes y máscaras de lesiones cutáneas dermatoscópicas públicas y anónimas utilizadas para segmentación binaria. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Tarea 1: Segmentación de límites de lesiones | Imágenes y máscaras de lesiones cutáneas dermatoscópicas públicas y anónimas utilizadas para segmentación binaria. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Identificador de acceso: syn3193805 | Conjunto de datos público de segmentación multiorgánica de TC abdominal. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Carpeta local esperada que contiene imágenes/máscaras de entrenamiento y validación. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Carpeta local esperada que contiene imágenes/máscaras de entrenamiento y validación. |
| Data organization - Synapse data folder | Author |
Referencias
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.