Este artículo presenta un marco basado en CNN explicable para la clasificación de lesiones cutáneas que combina una alta precisión diagnóstica con interpretabilidad del modelo. Clasifica imágenes de lesiones y genera explicaciones visuales para sus predicciones. Los resultados demuestran un rendimiento sólido y una transparencia mejorada, lo que apoya la toma de decisiones clínicas y ayuda a los dermatólogos en la detección temprana de enfermedades de la piel.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Un marco informático explicable para la clasificación de lesiones cutáneas mediante aprendizaje profundo
En este artículo
Resumen
Resumen
La utilización de redes neuronales convolucionales profundas con fines de diagnosticar enfermedades en el área de la piel ha demostrado alcanzar niveles de precisión similares a los obtenidos por dermatólogos en diversos estudios. Sin embargo, aún persisten muchos desafíos, incluyendo bajo rendimiento y mala generalización en algunos casos, así como baja interpretabilidad relacionada con el uso de modelos de caja negra. Esto crea obstáculos importantes para la implementación práctica, ya que se requiere explicabilidad además de diagnósticos precisos, lo que hace necesario encontrar una solución. Para superar las dificultades mencionadas, se desarrolla en este estudio un marco de aprendizaje profundo interpretable para la clasificación de lesiones cutáneas (EDLF-SLC). El marco utiliza diversos enfoques de aprendizaje automático e inteligencia artificial interpretable (XAI) para garantizar mejoras tanto en precisión como en interpretabilidad, mediante un proceso de tres etapas. En la primera etapa, se fusionan representaciones profundas extraídas de múltiples arquitecturas de CNN preentrenadas para preservar información discriminativa complementaria aprendida por diferentes arquitecturas de red antes de la clasificación mediante un SVM con kernel de función de base radial. A continuación, se emplean clasificadores de Máquina de Vectores de Soporte (SVM) con kernel de función de base radial para clasificar las características obtenidas. Finalmente, las predicciones realizadas por el modelo se interpretan mediante explicaciones locales interpretables agnósticas de modelos (LIME). Los resultados experimentales muestran que EDLF-SLC alcanza un 88,0 % de precisión, un 89,0 % de exactitud, un 87,0 % de recuperación y un 88,0 % de puntuación F1, demostrando un rendimiento competitivo en comparación con varios métodos recientemente reportados bajo las condiciones experimentales consideradas en este estudio.
Introducción
Las lesiones cutáneas son una preocupación importante en dermatología y oncología porque abarcan desde anomalías benignas hasta cánceres malignos como el melanoma, la forma más letal de cáncer de piel. En 2020, el melanoma representó aproximadamente 325.000 casos nuevos y más de 57.000 muertes en todo el mundo1. Aunque los avances en detección y tratamiento han mejorado los resultados en pacientes, el diagnóstico tardío y el acceso limitado a la atención médica siguen contribuyendo a una alta mortalidad y a la pérdida de años de vida, particularmente entre las poblaciones más jóvenes2,3.
El diagnóstico tradicional depende principalmente del examen visual y la dermatoscopia, lo que hace que el proceso dependa de la experiencia de los clínicos y sea propenso a subjetividad, variabilidad entre observadores, biopsias innecesarias y tiempos prolongados de examen4,5,6. Para abordar estas limitaciones, el aprendizaje profundo, particularmente las CNN, ha surgido como una solución efectiva para la clasificación automatizada de lesiones cutáneas. Los modelos basados en CNN, incluyendo DDCNN-F7, YOLOv7-XAI8 y varias otras arquitecturas9,10,11,12,13, han demostrado una alta precisión diagnóstica mediante el aprendizaje automático de características discriminativas de las imágenes. A pesar de su éxito, la mayoría de los modelos de aprendizaje profundo funcionan como "cajas negras", lo que limita la confianza de los clínicos y dificulta su adopción en la práctica médica habitual. Por ello, se han introducido técnicas de inteligencia artificial explicable para mejorar la transparencia del modelo proporcionando explicaciones visuales de las predicciones. Entre estos métodos, las Explicaciones Locales Model-Agnósticas e Interpretables generan explicaciones locales interpretables al identificar las regiones de la imagen que más influyen en las decisiones del modelo14.
La clasificación de lesiones cutáneas ha evolucionado desde la evaluación clínica tradicional hasta sistemas diagnósticos avanzados basados en inteligencia artificial, impulsada por la necesidad de una detección precisa, confiable y temprana del cáncer de piel. Esta evolución ha avanzado a través de cinco etapas principales: métodos diagnósticos tradicionales, diagnóstico asistido por computadora (CAD), aprendizaje automático (ML), aprendizaje profundo (DL) y, más recientemente, inteligencia artificial explicable (XAI) y aprendizaje federado (FL), reflejando esfuerzos continuos por mejorar la precisión diagnóstica, la consistencia, la escalabilidad y la confiabilidad clínica, al tiempo que se superan las limitaciones del examen convencional. Los primeros métodos computacionales intentaron emular el razonamiento clínico mediante descriptores de imagen manualmente diseñados derivados de la regla ABCD, que incluye asimetría, irregularidad del borde, variación del color y diámetro de la lesión. Estas características se combinaron con redes bayesianas, árboles de decisión, sistemas expertos y modelos de inferencia difusa para apoyar el diagnóstico de melanoma, con varios estudios que informaron exactitudes de clasificación superiores al 90%15,16,17. A pesar de proporcionar una base importante para el diagnóstico asistido por computadora, estos métodos dependían completamente de características manualmente diseñadas y reglas diagnósticas predefinidas. En consecuencia, mostraron una robustez limitada frente a variaciones en la calidad de la imagen, la morfología de la lesión, la iluminación y las condiciones de adquisición.
Para abordar estas limitaciones, surgieron los sistemas clásicos de CAD como una etapa intermedia entre el análisis de imágenes convencional y los marcos modernos basados en inteligencia artificial. Los sistemas de CAD combinaron la extracción manual de características con clasificadores convencionales para mejorar la consistencia diagnóstica y asistir en la toma de decisiones clínicas. Varios enfoques híbridos integraron agrupamiento jerárquico con redes neuronales recurrentes y arquitecturas de memoria a corto y largo plazo, logrando precisión en la clasificación cercana al 99,5 %18. Otros marcos basados en CAD incorporaron clasificadores de potenciación del gradiente con explicaciones basadas en SHAP, demostrando una precisión diagnóstica competitiva mientras mejoraban la transparencia del modelo19. Aunque estos sistemas representaron una mejora significativa respecto a los enfoques puramente basados en reglas, continuaron dependiendo en gran medida de la extracción manual de características, un preprocesamiento extenso, conjuntos de datos cuidadosamente anotados y tuberías de procesamiento de múltiples etapas.
Las técnicas de aprendizaje automático avanzaron aún más en la clasificación automatizada de lesiones cutáneas al permitir un aprendizaje basado en datos en lugar de un diseño explícito de reglas. Los marcos híbridos que combinan redes neuronales convolucionales con clasificadores convencionales de aprendizaje automático, incluyendo regresión logística y vecinos más cercanos (k-nearest neighbors), demostraron un alto rendimiento en la clasificación utilizando conjuntos de datos de referencia, alcanzando precisiones superiores al 95%9. El aprendizaje multimodal auto-supervisado mejoró aún más la representación de características al aprovechar conjuntamente imágenes dermatoscópicas y clínicas, reduciendo así la dependencia de anotaciones manuales extensas y mejorando al mismo tiempo el rendimiento de clasificación20. Otros estudios combinaron redes CNN con análisis discriminante generalizado, descriptores SURF y algoritmos de optimización para mejorar la discriminación de características y la precisión de clasificación21. Técnicas de selección automática de características que emplean DenseNet-201, InceptionV3 y algoritmos de optimización basados en árboles binarios mejoraron adicionalmente la representación de características manteniendo un rendimiento diagnóstico competitivo22. Los enfoques de aprendizaje por transferencia que utilizan arquitecturas preentrenadas, como AlexNet y GoogLeNet, también mostraron una capacidad prometedora de clasificación a pesar de contar con datos de entrenamiento limitados23. Sin embargo, la mayoría de los métodos de aprendizaje automático siguieron dependiendo de procedimientos de preprocesamiento cuidadosamente diseñados, estrategias de optimización manual, conjuntos de datos equilibrados y ajustes extensos de hiperparámetros. Su limitada validación externa y sensibilidad al desequilibrio de clases restringieron aún más su aplicabilidad práctica en diversos entornos clínicos.
La introducción del aprendizaje profundo transformó fundamentalmente la clasificación automatizada de lesiones cutáneas al permitir el aprendizaje directo a partir de datos de imágenes en bruto. Las CNN eliminaron la necesidad de ingeniería manual de características y mejoraron sustancialmente el rendimiento diagnóstico en múltiples conjuntos de datos de referencia. La mayoría de los enfoques basados en CNN demostraron mejoras significativas en la clasificación de lesiones mediante arquitecturas cada vez más sofisticadas. Los modelos de CNN sensibles a la simetría exploraron características clínicamente relevantes de las lesiones, pero lograron solo una precisión equilibrada moderada24. Otros integraron arquitecturas EfficientNet con explicaciones LIME y SHAP para mejorar la interpretabilidad, introduciendo al mismo tiempo medidas cuantitativas de confiabilidad25. Sistemas híbridos de aprendizaje profundo que combinan segmentación de lesiones, aprendizaje en conjunto y CNN lograron un excelente rendimiento en múltiples conjuntos de datos ISIC, pero siguieron siendo sensibles a la calidad de la segmentación y al desequilibrio de clases26.
Más recientemente, arquitecturas híbridas cada vez más sofisticadas han mejorado aún más la precisión de clasificación mediante la integración de técnicas complementarias de aprendizaje profundo (DL). Las redes generativas antagónicas condicionales combinadas con YOLOv5 y el análisis de componentes independientes lograron precisiones de clasificación superiores al 99 %, aunque su complejidad computacional limitó su implementación práctica27. De manera similar, las arquitecturas híbridas LSTM–ResNet aprendieron eficazmente representaciones espacio-temporales, pero requirieron recursos computacionales considerablemente mayores28. Los modelos basados en transformadores, incluido Sap-Former, aprovecharon la información contextual global para mejorar la representación de características, pero necesitaron un preprocesamiento extenso, conjuntos de datos anotados a gran escala y una potencia computacional significativa29. Alternativas ligeras como S-MobileNet intentaron equilibrar la eficiencia computacional con la precisión diagnóstica30, mientras que los métodos de adaptación de dominio no supervisados mejoraron la generalización entre dominios, a pesar de su menor eficacia cuando solo se disponía de un número limitado de muestras de entrenamiento31. Las redes híbridas mejoradas con mecanismos de atención que incorporan módulos de atención convolucionales modificados y el aprendizaje por conjuntos en instantes (snapshot ensemble learning) también mostraron un rendimiento prometedor para la clasificación de lesiones cutáneas por viruela del mono, aunque persistieron desafíos relacionados con el desequilibrio de clases, la diversidad de imágenes y la escasa explicabilidad32. Arquitecturas residuales personalizadas que emplean diseños de redes más profundas y funciones de pérdida híbridas mejoraron aún más la precisión de clasificación por encima del 99 %, pero conllevan un costo computacional considerablemente mayor y tiempos de entrenamiento más largos33. Estudios de revisión exhaustivos concluyeron consistentemente que el aprendizaje profundo supera ampliamente a los enfoques tradicionales basados en características manualmente diseñadas, al aprender automáticamente representaciones discriminativas de imágenes, identificando simultáneamente desafíos persistentes asociados con artefactos de imagen, variabilidad de iluminación, complejidad computacional y limitada generalización clínica34.
Aunque el aprendizaje profundo (DL) ha mejorado notablemente la precisión diagnóstica, las preocupaciones sobre la transparencia del modelo, la estimación de incertidumbre y la implementación clínica confiable han estimulado un creciente interés en el aprendizaje federado y en la inteligencia artificial explicable (XAI). Varios estudios han investigado técnicas de cuantificación de incertidumbre, incluyendo la predicción conforme, el dropout de Monte Carlo y el aprendizaje profundo basado en evidencia, demostrando que una estimación de confianza confiable puede mejorar sustancialmente la toma de decisiones, a pesar de imponer restricciones adicionales computacionales y relacionadas con los datos35. También se han propuesto marcos de aprendizaje mutuo basados en transformadores para abordar el desequilibrio de clases mientras se mejora la eficiencia del aprendizaje de características36. Otros enfoques combinaron CNN con resolución completa con técnicas de optimización basadas en grafos para mejorar la segmentación y clasificación de lesiones37, mientras que marcos híbridos de aprendizaje profundo que integran múltiples representaciones complementarias de características lograron precisión de clasificación cercanas al 99,5 %, a pesar de requerir un procesamiento previo extenso38.
Investigaciones recientes se han centrado cada vez más en integrar la explicabilidad directamente en los marcos de aprendizaje profundo (DL) para aumentar la confianza de los clínicos y facilitar la adopción clínica práctica. Los sistemas explicables que emplean múltiples arquitecturas de redes neuronales convolucionales junto con Grad-CAM y Score-CAM localizaron con éxito regiones de lesiones diagnósticamente relevantes, manteniendo al mismo tiempo un rendimiento competitivo en clasificación tanto en conjuntos de datos internos como externos39. Los marcos híbridos CNN–Transformador que combinan imágenes dermatoscópicas con metadatos clínicos mejoraron aún más el rendimiento predictivo, utilizando al mismo tiempo SHAP y Grad-CAM para generar explicaciones visuales clínicamente significativas40. Otras arquitecturas híbridas basadas en transformadores, que integran EfficientNetV2S, Transformadores Swin, redes Xception modificadas y mecanismos de atención en grafos, capturaron eficazmente características complementarias globales y locales de las lesiones, aunque sus grandes cantidades de parámetros y rendimiento limitado en clases minoritarias restringieron su implementación práctica41. De manera similar, los marcos híbridos YOLOv8–Transformador de Visión demostraron una mejor localización de lesiones, clasificación multiclase e interpretabilidad visual mediante aumentación adaptativa junto con explicaciones SHAP y Grad-CAM; sin embargo, estos métodos continuaron dependiendo principalmente de conjuntos de datos de referencia y mostraron robustez limitada para categorías minoritarias de lesiones42. Varios artículos de revisión han resumido estos avances, destacando tanto el progreso notable logrado por las técnicas modernas de aprendizaje profundo como los desafíos persistentes relacionados con la eficiencia computacional, la explicabilidad, la dependencia de los conjuntos de datos y la validación clínica43,44,45. Tabla 1 resume algunos trabajos publicados recientemente que utilizan algoritmos de aprendizaje profundo para la clasificación de lesiones cutáneas.
A pesar de los notables avances logrados por los recientes métodos de aprendizaje profundo en la clasificación de lesiones cutáneas, la mayoría de los enfoques existentes siguen limitados por una alta complejidad computacional, dependencia de grandes conjuntos de datos anotados, escasa interpretabilidad del modelo y validación insuficiente en diversos entornos clínicos del mundo real. Para superar estas limitaciones, este artículo propone el marco EDLF-SLC, que integra características complementarias extraídas de múltiples arquitecturas CNN con un clasificador SVM para una clasificación robusta y precisa. El marco emplea además un preprocesamiento mejorado para aumentar la calidad de las imágenes y abordar el desequilibrio de clases, e incorpora la técnica LIME para proporcionar explicaciones visuales de predicciones individuales, mejorando así la transparencia del modelo y su confiabilidad clínica.
Las contribuciones de este estudio son triples. En primer lugar, los autores proponen un marco robusto, EDLF-SLC, que integra redes neuronales convolucionales avanzadas (CNN) con un clasificador de máquinas de vectores de soporte (SVM) para lograr una clasificación precisa y confiable de lesiones cutáneas. En segundo lugar, los autores implementan técnicas mejoradas de preprocesamiento para abordar el desequilibrio entre clases y reducir el ruido en las imágenes, mejorando así la calidad de las imágenes de entrada y el rendimiento general del modelo de clasificación. En tercer lugar, los autores incorporan el método de Explicaciones Locales Modelo-agnósticas (LIME) para visualizar e interpretar predicciones individuales del modelo, resaltando las regiones de la imagen que influyen más fuertemente en las decisiones de clasificación, mejorando así la transparencia y la interpretabilidad del marco propuesto.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio no implicó la reclutación de participantes humanos ni la recopilación de datos identificables de pacientes. Todos los experimentos se realizaron utilizando el conjunto de datos público de lesiones cutáneas ISIC 2020 obtenido del repositorio de Kaggle; por lo tanto, no se requirió la aprobación del comité de ética institucional ni el consentimiento informado. Todos los materiales utilizados en este estudio se encuentran en la Tabla de Materiales.
Extracción y fusión de características
Las imágenes de lesiones cutáneas se procesaron utilizando múltiples modelos CNN preentrenados. Los vectores de características profundas extraídos de las arquitecturas CNN preentrenadas seleccionadas se concatenan para construir una representación unificada de características para cada imagen de lesión cutánea. La estrategia de fusión adoptada conserva la información visual complementaria aprendida por diferentes arquitecturas CNN, permitiendo que el clasificador SVM subsiguiente aproveche tanto las características texturales de bajo nivel como las representaciones semánticas de nivel superior. Aunque técnicas de reducción de dimensionalidad, como el análisis de componentes principales o la selección de características basada en información mutua, podrían reducir la dimensionalidad de las características, se mantuvo intencionadamente la representación completa fusionada porque el espacio de características fusionado sigue siendo computacionalmente tratable para el clasificador RBF-SVM empleado, a la vez que preserva la información diagnóstica complementaria extraída de los diferentes modelos CNN base.
Clasificación
Los vectores de características fusionados se utilizaron para entrenar un clasificador SVM con un kernel RBF. Se emplearon técnicas de optimización de hiperparámetros para determinar la configuración óptima de clasificación. Luego, el clasificador categorizó las lesiones cutáneas en sus clases respectivas.
Explicabilidad
Para mejorar la interpretabilidad, se aplicó LIME para generar explicaciones visuales que resaltan las regiones de la imagen que contribuyen de manera más significativa a los resultados de clasificación. Estas explicaciones ayudarían a los clínicos a comprender y validar las decisiones del modelo.
Plan de evaluación
El marco propuesto se evaluó utilizando un conjunto de datos de referencia de lesiones cutáneas. El rendimiento se evaluó mediante Exactitud, Precisión, Exhaustividad y Puntaje F1. Se realizaron experimentos comparativos frente a enfoques existentes de aprendizaje automático y aprendizaje profundo para demostrar la eficacia del marco propuesto.
Resultados esperados
Se esperaba que el estudio produjera un sistema preciso e interpretable de clasificación de lesiones cutáneas. Los resultados experimentales preliminares indican que EDLF-SLC alcanza una exactitud del 88,0 %, una precisión del 89,0 %, una recuperación del 87,0 % y una puntuación F1 del 88,0 %, superando a varios métodos competidores. Se anticipó que la integración de explicaciones LIME mejoraría la confiabilidad y facilitaría la adopción de sistemas de diagnóstico asistidos por inteligencia artificial en la práctica clínica.
Importancia
Esta investigación contribuye al creciente campo de la inteligencia artificial explicativa en atención médica al abordar tanto los desafíos de rendimiento como los de transparencia en el diagnóstico de lesiones cutáneas. El marco propuesto tiene el potencial de ayudar a los dermatólogos a tomar decisiones diagnósticas más confiables e interpretables, mejorando así la atención al paciente. Además, en esta sección, los autores proporcionaron información sobre los materiales y la metodología aplicada en este estudio de investigación. En concreto, los autores comenzaron con la descripción del conjunto de datos utilizado para los experimentos y continuaron con la discusión detallada del marco de aprendizaje profundo explicativo para la clasificación de lesiones cutáneas.
Conjunto de datos
El trabajo presentado se basa en el conjunto de datos ISIC 2020 (Colaboración Internacional de Imágenes Dermatológicas), disponible públicamente, al que se puede acceder en el sitio web de Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). El repositorio ISIC ha sido reconocido como uno de los mejores recursos en el campo de la imagenología dermatológica, ya que proporciona una gran variedad de imágenes dermatoscópicas de diferentes tipos de lesiones cutáneas, como se muestra en Figura 1. Es importante destacar que el conjunto de datos incluye imágenes tanto de condiciones benignas como malignas, lo que lo hace útil para realizar tareas de clasificación binaria en cáncer de piel 46. En el conjunto de datos actual hay 3.297 imágenes, de las cuales 1.800 son benignas y 1.497 son malignas. Para experimentos más eficientes, fue necesario dividir los datos en un conjunto de entrenamiento y un conjunto de prueba. En particular, hay 2.637 imágenes de entrenamiento, incluyendo 1.440 benignas y 1.197 malignas, mientras que el conjunto de prueba consta de 660 imágenes, de las cuales 360 son benignas y 300 son malignas. Un resumen del conjunto de datos se muestra en Tabla 2.
El modelo propuesto EDLF-SLC
En este artículo se propone una solución eficiente y comprensible para clasificar lesiones cutáneas en categorías benignas y malignas, utilizando una técnica novedosa de aprendizaje profundo interpretable basada en un enfoque híbrido que combina las ventajas de múltiples modelos de redes neuronales convolucionales preentrenados. Las redes neuronales convolucionales han demostrado ser altamente efectivas para extraer características semánticas de alto nivel a partir de imágenes médicas. Aprovechando esta capacidad, el marco de aprendizaje profundo interpretable propuesto para la clasificación de lesiones cutáneas (EDLF-SLC) utiliza múltiples modelos CNN preentrenados para lograr un rendimiento superior. Para garantizar la transparencia necesaria en el proceso de toma de decisiones médicas, se ha adoptado LIME en el enfoque propuesto para generar explicaciones locales comprensibles para los resultados obtenidos. El marco completo puede dividirse en tres etapas principales, como se ilustra en Figura 2, a saber, (1) preprocesamiento de datos, (2) extracción de características y clasificación, y (3) interpretabilidad.
Arquitectura del modelo e integración
Como paso preliminar, se seleccionaron y evaluaron siete modelos populares de aprendizaje profundo (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge y MobileNet) en el conjunto de datos de validación de forma independiente, y se eligieron los cuatro modelos más efectivos (ResNet50, EfficientNetB0, MobileNet y Xception) para la etapa de extracción de características. En el marco propuesto, cada imagen de entrada x se procesa de manera independiente a través de los modelos preentrenados seleccionados. Se ha eliminado la última capa completamente conectada de cada uno de estos modelos, y se han obtenido vectores de características a partir de las capas anteriores. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) y fXception(x) hacen referencia a los vectores de características de salida de cada uno de los modelos mencionados anteriormente. Al concatenar esos vectores de características, se obtiene un nuevo vector de características agregado F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Posteriormente, F(xi) se introdujo en un clasificador SVM con un kernel de función de base radial (RBF) para obtener el resultado de clasificación. Todo el algoritmo del marco propuesto se presenta en el Archivo Suplementario 1.
El marco propuesto adopta la fusión directa a nivel de características porque cada arquitectura de CNN preentrenada captura características discriminativas diferentes de las lesiones cutáneas mediante su arquitectura de red y jerarquía de características aprendida. En consecuencia, la concatenación de estas representaciones de características heterogéneas conserva información complementaria que contribuye a una caracterización más completa de la lesión antes de la clasificación. Aunque técnicas de reducción de dimensionalidad, como el análisis de componentes principales (PCA) o la selección de características basada en información mutua, pueden reducir la dimensionalidad de la representación fusionada, se mantuvo intencionalmente el vector completo de características fusionadas porque su dimensionalidad sigue siendo computacionalmente tratable para el clasificador RBF-SVM adoptado, a la vez que preserva la información diagnóstica complementaria extraída por los diferentes modelos de CNN. Por lo tanto, este diseño prioriza la retención de representaciones profundas complementarias en lugar de eliminar características potencialmente informativas antes de la clasificación.
Preparación de los datos
La preparación de los datos ha incluido el preprocesamiento y la división del conjunto de datos en conjuntos de entrenamiento y prueba. El preprocesamiento tiene como objetivo mejorar la calidad de los datos eliminando inconsistencias, suprimiendo elementos duplicados, formateando las imágenes de entrada y realizando una normalización de características para un entrenamiento estable de un buen modelo. Todas las imágenes se han normalizado al rango [−1, 1] mediante la normalización por puntuación Z:
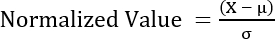 (2)
donde µ y σ representan el valor medio y la desviación estándar de la imagen correspondiente, respectivamente. El conjunto de datos se ha dividido en dos subconjuntos, es decir, un conjunto de entrenamiento (70,0 %) y un conjunto de prueba (30,0 %).
Aumento de datos
Para evitar el sobreajuste y aumentar la capacidad de generalización del modelo, se han utilizado algunas ampliaciones para el conjunto de entrenamiento. Las ampliaciones de imágenes implican modificar las imágenes para expandir artificialmente el conjunto de datos sin alterar las características esenciales de las afecciones médicas. La canalización de ampliación se ha construido utilizando la API secuencial de Keras. Se han empleado transformaciones como volteo horizontal aleatorio, rotación dentro de un ángulo pequeño, cambio de tamaño, escalado, ajuste de brillo y contraste, zoom y algunos movimientos menores. En Figura 3 se ilustran ejemplos representativos de imágenes aumentadas.
Modelos preentrenados
Varios modelos de aprendizaje profundo preentrenados se han adoptado en el marco propuesto para extraer características de imágenes de entrada. Dichos modelos incluyen MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 y MobileNetV2. MobileNet y MobileNetV2 son modelos de aprendizaje profundo ligeros diseñados para realizar cálculos eficientes mediante convoluciones separables por profundidad. ResNet50 emplea el mecanismo de conexiones residuales para entrenar el modelo, evitando así el problema del gradiente que desaparece durante el entrenamiento. EfficientNetB0 logra un equilibrio entre eficiencia y precisión mediante el enfoque de escalado compuesto. Xception extiende la red Inception utilizando convoluciones separables por profundidad. NASNetLarge implica el uso de búsqueda de arquitectura neuronal para construir estructuras óptimas de redes neuronales profundas, e Inception-ResNet-v2 crea una hibridación del modelo Inception y el mecanismo de conexiones residuales. Los vectores de características extraídos de ResNet50 (1.024 características), EfficientNetB0 (1.280 características), MobileNet (1.024 características) y Xception (2.048 características) se concatenan para producir una representación unificada de 5.376 dimensiones. Esta estrategia de fusión se seleccionó para preservar las representaciones complementarias aprendidas por las diferentes arquitecturas de CNN, en lugar de reducir la representación antes de la clasificación. El vector de características resultante se proporciona posteriormente al clasificador RBF-SVM, que determina el límite de decisión no lineal óptimo dentro del espacio de características fusionado.
Modelo de IA interpretable (LIME)
Con el fin de proporcionar cierta interpretabilidad local de las predicciones del modelo, los autores adoptan el método de generar explicaciones localizadas y comprensibles para el ser humano para cada predicción particular del modelo, denominado LIME47. Para cualquier imagen de entrada, LIME primero la divide en unidades más pequeñas llamadas superpíxeles. Luego se generan perturbaciones a partir de la imagen original, y se estiman las predicciones del modelo neuronal profundo para cada una de estas perturbaciones. A continuación, se ajusta un modelo lineal ponderado sobre las perturbaciones, utilizando pesos que dependen de su proximidad a la instancia original de entrada. Tras ajustar el modelo lineal, se estiman las puntuaciones de importancia de las características, lo que indica el papel de cada superpíxel en la predicción de la etiqueta final. Estas puntuaciones de importancia se resaltan visualmente en la imagen final de explicación. El algoritmo LIME se muestra en Archivo Suplementario 2.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
La evaluación del rendimiento del marco de clasificación desarrollado se basa en medidas tradicionales de evaluación derivadas de la matriz de confusión. Una matriz de confusión permite obtener una comprensión completa del rendimiento del clasificador mediante la representación del número de clasificaciones correctas e incorrectas realizadas para cada clase definida. De este modo, se pueden analizar todos los tipos de errores. Por ejemplo, tanto los falsos positivos como los falsos negativos son especialmente importantes...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
El marco propuesto de aprendizaje profundo interpretable para la clasificación de lesiones cutáneas (EDLF-SLC) demuestra que combinar representaciones complementarias de características profundas con inteligencia artificial interpretable puede mejorar tanto el rendimiento de clasificación como la transparencia del modelo. Al integrar múltiples arquitecturas de CNN preentrenadas (ResNet50, EfficientNetB0, MobileNet y Xception) para la extracción de características y emplear una máquina de vectores de soporte (SVM) para la...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no existe ningún conflicto de intereses.
Agradecimientos
Los autores desean expresar su sincero agradecimiento a la Universidad de Taif por proporcionar el entorno de investigación y el apoyo institucional que facilitaron la realización de este trabajo.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de datos de lesiones cutáneas ISIC 2020 | Colaboración Internacional de Imágenes Cutáneas (ISIC) | Conjunto de datos del desafío ISIC 2020 | Conjunto de imágenes dermatoscópicas utilizado para el desarrollo y evaluación del modelo. |
| Keras | Equipo de Keras | Integrado con TensorFlow | Construcción y entrenamiento de modelos de aprendizaje profundo. |
| LIME (Explicaciones Locales Interpretables Independientes del Modelo) | Ribeiro et al. | Paquete de Python | Generación de explicaciones visuales locales para las predicciones del modelo. |
| Matplotlib | Desarrolladores de Matplotlib | Última versión compatible | Visualización de curvas de aprendizaje, matrices de confusión y gráficos de evaluación. |
| NumPy | Desarrolladores de NumPy | Última versión compatible | Cálculo numérico y manipulación de matrices. |
| GPU NVIDIA Tesla T4 | Corporación NVIDIA | 16 GB de VRAM | Aceleración del entrenamiento del modelo y la inferencia. |
| Pandas | Equipo de desarrollo de Pandas | Última versión compatible | Procesamiento de datos y gestión de resultados experimentales. |
| Modelos CNN preentrenados | Aplicaciones de TensorFlow/Keras | ResNet50, EfficientNetB0, MobileNet, Xception | Extracción de características profundas a partir de imágenes dermatoscópicas. |
| Python | Fundación del Software Python | Versión 3.9 | Lenguaje de programación utilizado para la implementación. |
| PyTorch | Fundación PyTorch | Versión 2.3.1 | Entorno de aprendizaje profundo utilizado para la extracción de características y la implementación del modelo. |
| Scikit-learn | Desarrolladores de Scikit-learn | Última versión compatible | Máquina de vectores de soporte (SVM), métricas de evaluación y preprocesamiento de datos. |
| Máquina de vectores de soporte (kernel RBF) | Scikit-learn | SVC | Clasificación de representaciones de características profundas fusionadas. |
| TensorFlow | Google LLC | Versión 2.x | Entorno de aprendizaje profundo para el entrenamiento y la inferencia del modelo. |
| Sistema operativo Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Entorno operativo experimental. |
Referencias
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.