Abordando la fragmentación del texto legal y los problemas de rastreo de sesgos en la inteligencia artificial (IA) médica, este estudio construye un grafo de conocimiento legal y emplea una convolución de grafo con reconocimiento de relaciones para la alineación semántica. Identifica las fuentes de sesgo mediante retropropagación basada en gradientes, con métricas experimentales favorables que respaldan una aplicación de IA médica conforme a las normativas.
Artículo de investigación
Construcción de grafos de conocimiento jurídico y rastreo de sesgos en la inteligencia artificial médica basados en redes neuronales de grafos
En este artículo
Resumen
Resumen
En el análisis de cumplimiento legal de la inteligencia artificial (IA) médica, este artículo aborda la ambigüedad en la determinación de responsabilidades causada por la fragmentación semántica de textos legales heterogéneos de múltiples fuentes y las dificultades para rastrear sesgos algorítmicos. Se propone un método para la construcción de grafos de conocimiento y la detección de rutas de propagación de sesgos basado en redes neuronales de grafos. Se estructuran y codifican cuatro tipos de nodos heterogéneos: cláusulas legales, comportamientos médicos, módulos algorítmicos y partes responsables, y se construye un grafo dirigido basado en cuatro tipos de relaciones semánticas legales: «violación», «base», «desencadenamiento» y «atribución». A continuación, se utiliza una red convolucional de grafos sensible a relaciones, combinada con pesos específicos por tipo de arista y un mecanismo de atención, para lograr una alineación de características en múltiples capas para semánticas legales multimodales. Luego, se emplea la retropropagación basada en gradientes para identificar las aristas que contribuyen significativamente al sesgo, construir un subgrafo de propagación del sesgo y utilizar la detección de comunidades para localizar conglomerados de nodos raíz. Finalmente, se mapean flujos de decisiones en tiempo real a nodos temporales, se verifica el cumplimiento mediante similitud de incrustación y se monitorea la dinámica de los pesos clave de las aristas para advertir sobre la acumulación de sesgos sistémicos. Los experimentos muestran que, en cuanto a la precisión de alineación semántica, el método propuesto alcanza una precisión media de alineación de entidades de al menos 0,92 y una completitud media de preservación de relaciones de al menos 0,88 en diferentes gradientes de densidad del grafo de conocimiento. En cuanto a la capacidad de localización de sesgos, la tasa de recuperación de nodos raíz alcanza 0,95±±0,02 y la precisión en las rutas de propagación llega a 0,93±±0,03. Esta investigación logra, en cierta medida, un acoplamiento profundo entre la lógica legal y el comportamiento algorítmico, proporcionando un sistema de apoyo explicable y verificable para la implementación confiable de la IA médica.
Introducción
La profunda implicación de la inteligencia artificial médica en el diagnóstico, el apoyo al tratamiento, la asignación de recursos y la evaluación de riesgos ha vinculado su toma de decisiones con la asunción de responsabilidad legal1,2. Las normas jurídicas son altamente estructuradas pero semánticamente distribuidas, y el comportamiento de los sistemas de inteligencia artificial puede ser una caja negra, sin una interfaz semánticamente alineable y rastreable entre ambos3. En este contexto, desarrollar un marco común de representación que capture cadenas causales jurídicas dentro de secuencias algorítmicas de comportamiento ha surgido como un facilitador necesario para lograr una atribución fina de responsabilidad y un cumplimiento dinámico4,5. Este estudio no solo está relacionado con la evaluación jurídica de los sistemas tecnológicos, sino que también implica el mantenimiento profundo de la equidad médica, la equidad algorítmica y la confianza institucional, y por tanto tiene una gran importancia teórica y una urgencia práctica.
El problema fundamental en el análisis de conformidad legal de la IA médica actualmente es la falta de una estructura conectiva computable entre la semántica jurídica y el comportamiento algorítmico6,7. Los documentos legales están disponibles como texto plano, y las relaciones entre párrafos están entrelazadas con dependencias, conflictos y excepciones, lo que genera problemas al dividirlos en unidades lógicas que puedan ser interpretadas por máquinas8,9. Aunque la toma de decisiones del sistema de IA está encapsulada en una caja negra basada en datos, ninguna de sus variaciones de salida puede rastrearse hasta incumplimientos específicos de obligaciones legales ni hasta nodos para la atribución de responsabilidad10,11. Dicha desconexión (por ejemplo, sesgos en los datos de entrenamiento, defectos en el diseño del modelo o la interpretación semántica de las normas jurídicas) no puede aislarse experimentalmente para identificar el origen del sesgo ni para aclarar las obligaciones legales de los desarrolladores, implementadores o usuarios12,13. Aún más problemático es que los procedimientos de cumplimiento existentes solo verifican si una salida final cumple con una especificación fija, sin considerar la trayectoria de propagación ni la amplificación del sesgo en la red de interacciones entre «ley y tecnología»14,15. Cuando la IA médica está sujeta simultáneamente a múltiples disposiciones legales, y el sistema genera una cadena de errores debido a la malinterpretación de una cláusula, los enfoques convencionales no pueden rastrear cómo el error se difunde a través de otras disposiciones relacionadas y finalmente conduce a la responsabilidad16,17. Además, existe una falta de mecanismo de correlación dinámica entre el flujo de decisiones en tiempo real y el grafo de conocimiento jurídico existente, lo que provoca una evaluación tardía del cumplimiento durante la operación del sistema, impidiendo así un monitoreo proactivo de la tendencia de acumulación del sesgo18,19. Estos problemas en conjunto generan incertidumbre en la determinación de responsabilidades, atribuciones frágiles y una intervención regulatoria tardía, lo que inhibe significativamente la implementación confiable de sistemas de IA de alto riesgo en el ámbito sanitario y la aplicación de la responsabilidad legal.
Ante todo, los estudios tradicionales investigan los textos jurídicos en una forma estructurada y construyen bases de conocimiento de dominios específicos mediante ontologías o reglas, con el fin de respaldar preguntas y respuestas sobre cumplimiento normativo o notificaciones de riesgo20,21. Aunque estos enfoques pueden capturar representaciones de algunos conceptos jurídicos, suelen presuponer que la lógica interna del derecho es coherente y estática, lo que dificulta el manejo de inconsistencias entre jurisdicciones, excepciones o formulaciones ambiguas. Trabajos posteriores introdujeron tecnologías de procesamiento del lenguaje natural, utilizando modelos lingüísticos preentrenados para extraer entidades y relaciones jurídicas, mejorando así la amplitud de la cobertura en la extracción de conocimiento22,23, pero aún permanecen en un nivel semántico superficial, sin lograr establecer una interfaz de mapeo entre comportamientos jurídicos y técnicos. En cuanto a la gobernanza del sesgo algorítmico, la investigación se ha centrado principalmente en el diseño de restricciones de equidad24,25, y sus indicadores de evaluación suelen basarse en variables demográficas, careciendo de alineación con los principios jurídicos de atribución. Incluso algunos estudios han intentado codificar reglas jurídicas como restricciones e integrarlas en el entrenamiento del modelo26,27, pero debido a la rigidez y granularidad gruesa de la expresión de reglas, resulta difícil adaptarlas a situaciones clínicas complejas. En general, los trabajos existentes tratan el cumplimiento legal como una tarea de verificación externa, en lugar de un atributo computable intrínseco a la arquitectura del sistema. Esto provoca que la lógica jurídica y la lógica algorítmica operen en paralelo, sin lograr respaldar un razonamiento conjunto ni intervenciones dinámicas sobre las vías de propagación del sesgo.
En los últimos años, las redes neuronales gráficas se han ido introduciendo gradualmente en el campo médico debido a sus capacidades explícitas para modelar estructuras relacionales28,29. Algunos estudios utilizan grafos heterogéneos para integrar jurisprudencia, disposiciones legales e información de las partes, apoyando recomendaciones de casos o predicciones de sentencias mediante incrustaciones de nodos30,31, verificando así la eficacia de las estructuras gráficas para capturar conexiones jurídicas. Otros trabajos abstraen componentes algorítmicos como nodos del grafo, utilizando aristas para representar flujos de datos o relaciones de llamada con el fin de rastrear la propagación de errores32,33. Estas exploraciones demuestran que las estructuras gráficas pueden servir como soporte común de elementos legales y tecnológicos. Sin embargo, los modelos gráficos existentes suelen presentar tres limitaciones: primero, se limitan a un único tipo de relación de arista, sin distinguir entre diferencias normativas, causales y atributivas en la semántica jurídica; segundo, el proceso de agregación de características ignora los pesos semánticos de los tipos de arista, haciendo que diferentes caminos lógicos jurídicos se traten por igual; y tercero, carecen de un mecanismo diferenciable para el rastreo de la propagación de sesgos, lo que impide localizar aristas de alta contribución y reconstruir trayectorias de responsabilidad. Este artículo propone una red convolucional gráfica consciente de las relaciones, que aborda el problema de la fusión de heterogeneidad semántica asignando una matriz de transformación específica a cada tipo de arista semántica jurídica e introduciendo un mecanismo de atención para ajustar dinámicamente el flujo de información entre tipos. Además, mediante la combinación de retropropagación de gradientes y extracción de subgrafos, permite un salto interpretable desde el juicio de cumplimiento a nivel macro hasta el rastreo de sesgos a nivel micro, superando el cuello de botella de los modelos gráficos tradicionales que solo admiten razonamiento estático.
Más allá del ámbito médico, avances recientes en métodos basados en grafos y métodos evolutivos han demostrado una amplia aplicabilidad al procesamiento de conocimiento estructurado. Por ejemplo, Xue et al. propusieron un enfoque híbrido multilayer de programación genética para la construcción adaptativa de características de similitud en la coincidencia de ontologías, logrando un alineamiento robusto entre grafos de conocimiento heterogéneos34. Cheng et al. realizaron una revisión exhaustiva de las aplicaciones de redes convolucionales de grafos en la restauración de imágenes, categorizando sistemáticamente los métodos para eliminación de ruido, superresolución y desenfoque35. Li et al. presentaron una revisión detallada sobre el aprendizaje profundo evolutivo desde la perspectiva del aprendizaje automático automatizado, abarcando principios, algoritmos, aplicaciones y desafíos abiertos36. Ma et al. desarrollaron un marco de búsqueda de arquitecturas neuronales difusas para el reconocimiento de defectos bajo incertidumbre, demostrando la eficacia de la búsqueda evolutiva para manejar datos ambiguos37. Estos estudios destacan el potencial de integrar representaciones estructuradas en forma de grafos y optimización evolutiva para tareas complejas de toma de decisiones.
El objetivo principal de este artículo es establecer un marco interpretable de extremo a extremo para el análisis de cumplimiento legal de la inteligencia artificial (IA) médica, con innovaciones en tres niveles. En el nivel de representación del conocimiento, es el primero en modelar cláusulas legales, prácticas médicas, módulos de algoritmos y partes responsables como cuatro tipos de nodos heterogéneos. Basándose en la práctica jurídica, extrae cuatro tipos de relaciones dirigidas: «violación», «base», «activación» y «atribución», construyendo un grafo de conocimiento dirigido con lógica causal jurídica, lo que proporciona una base semántica estructurada para el análisis de cumplimiento. En el rastreo de origen del sesgo, propone un método de cuantificación de la contribución de las aristas basado en sensibilidad de gradiente. Mediante retropropagación, identifica el conjunto de aristas que maximiza el sesgo de salida, y luego aplica un algoritmo de detección de comunidades para agrupar nodos de alta contribución, transformando el «sesgo de caja negra» en «grupos de responsabilidad de caja blanca», lo que permite una atribución basada en una cadena de evidencia operativa. En el nivel de monitoreo dinámico en tiempo real, desarrolla un mecanismo temporal de incrustación de nodos de decisión que proyecta las salidas en tiempo real de la IA al espacio del grafo de conocimiento. Basándose en la comparación de proximidad de incrustación, cuantifica el grado de desviación normativa y monitorea el cambio de peso de aquellas aristas clave entre lo legal y lo técnico, con el fin de detectar la acumulación de sesgo sistémico. Este paradigma aborda tanto los problemas de fragmentación semántica como los de trazabilidad, y transforma el cumplimiento legal de una verificación ex post en una gobernanza ex ante, ofreciendo una vía técnica escalable para la transparencia de la responsabilidad en sistemas de IA de alto riesgo.
Protocolo
Construcción de una red neuronal gráfica para el grafo de conocimiento jurídico médico de inteligencia artificial
Como se muestra en la Figura 1, el marco propuesto comprende tres módulos principales. La capa de entrada integra datos de múltiples fuentes en un grafo heterogéneo mediante la codificación de entidades multimodales y la modelización de aristas dirigidas. Luego, la capa GCN sensible a relaciones realiza un alineamiento semántico cruzado mediante pesos y atención específicos para cada tipo, generando incrustaciones unificadas de nodos. Finalmente, estas incrustaciones permiten el rastreo de sesgos (mediante retropropagación del gradiente y detección de comunidades) y el monitoreo dinámico del cumplimiento (mediante mapeo en tiempo real de nodos y seguimiento de pesos de aristas), entregando como salida evidencia interpretable de atribución y alertas de riesgo para los reguladores.
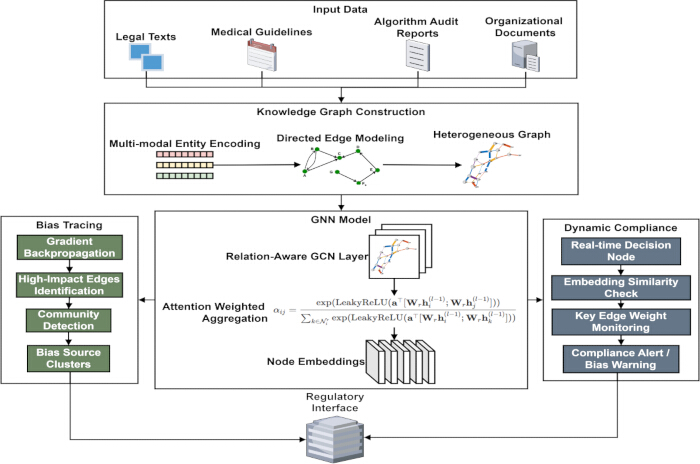
Figura 1: Grafo de conocimiento legal y arquitectura para el rastreo de sesgos en inteligencia artificial médica. Este diagrama ilustra el flujo general del marco propuesto. La capa de entrada fusiona datos heterogéneos de múltiples fuentes (textos legales, guías clínicas, informes de auditoría de algoritmos), que se codifican en cuatro tipos de entidades (cláusulas legales, comportamientos médicos, módulos de algoritmos, partes responsables) y se conectan mediante cuatro relaciones legales-semánticas dirigidas (violación, base, desencadenante, atribución). La capa GCN sensible a relaciones realiza alineación semántica cruzada mediante pesos y atención específicos por tipo. El módulo de rastreo de sesgos utiliza la retropropagación del gradiente para identificar aristas de alta contribución y luego aplica detección de comunidades para localizar grupos de nodos raíz. El monitor dinámico de cumplimiento asigna decisiones en tiempo real a nodos temporales, evalúa la similitud de los vectores integrados respecto a las cláusulas legales y rastrea la evolución del peso de las aristas para emitir alertas tempranas. Las salidas incluyen evidencia interpretable de atribución y alertas de riesgo. Haga clic aquí para ver una versión ampliada de esta figura.
Codificación estructurada de grafo heterogéneo de entidades legales y relaciones
Se derivan consistentemente cuatro entidades fundamentales de las leyes regulatorias de inteligencia artificial médica, las guías clínicas y los informes de auditoría de algoritmos: cláusulas legales, procedimientos médicos, módulos de algoritmos y entidades responsables. Se propone un modelo independiente de aprendizaje de representación de características para cada tipo de entidad, con el fin de que sean semánticamente distinguibles. Los nodos de cláusulas legales se organizan para contener el número de la cláusula legal, el cual se utiliza como un ID (identificador) único para dicha cláusula. Al mismo tiempo, se define un índice de cuantificación de la severidad de la sanción para indicar el nivel de responsabilidad legal asociado a la cláusula, y, en consecuencia, se establece un vector de características.
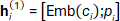 (1)
ci es el número de entrada, Emb(·) representa la aplicación de incrustación de baja dimensión, y [·;·] representa la operación de concatenación de vectores. Esta representación conserva tanto la estructura formal como la gravedad del castigo del texto legal, lo que permite el razonamiento entre enunciados.
Los nodos de comportamiento médico se estandarizan y codifican según un sistema de clasificación de operaciones clínicas, extrayendo su nivel de riesgo rj ∈ {1,2,3} y el conjunto de etiquetas de escenarios aplicables sj ⊂ S, donde S es el conjunto completo de categorías de escenarios predefinidas. Se utiliza la codificación multi-hot para procesar el conjunto de etiquetas, y se concatena con la incrustación del nivel de riesgo para formar una representación inicial:
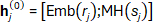 (2)
Esta estrategia asegura que diferentes tipos de comportamientos médicos tengan relaciones de distancia medibles en el espacio vectorial, lo que permite comparaciones entre escenarios. La función de incrustación de texto Emb(·) se implementa utilizando el modelo de lenguaje jurídico chino preentrenado Lawformer (preentrenado en un corpus jurídico chino a gran escala), con una dimensión de salida fija de 768.
Basándose en las dependencias lógicas y las restricciones legales entre entidades, se establecen cuatro tipos de relaciones semánticas dirigidas: «violación», «base», «activación» y «atribución», cada una correspondiente a diferentes patrones causales legales. A cada arista eij ⊂ E se le asigna un tipo de etiqueta tij ⊂ T = {violate, base, trigger, attribute} para la transmisión de mensajes posterior con reconocimiento de relaciones. La construcción de aristas sigue estrictamente el mecanismo de coincidencia de reglas del dominio: cuando un comportamiento médico se desvía de los requisitos normativos, se establece una arista de «violación» que va desde el nodo de comportamiento hasta la cláusula legal pertinente; cuando la cláusula legal sirve como fundamento técnico de cumplimiento para una operación, se establece una arista de «base»; si la salida del módulo algorítmico activa directamente la ejecución de un comportamiento médico específico, se conecta una arista de «activación»; la relación de atribución de responsabilidad se establece a partir de los documentos de responsabilidad de la organización y las conclusiones de auditoría, creando una arista de «atribución» entre la parte responsable y la violación o el defecto algorítmico.
Después de que todos los nodos se inicializan, se forma un grafo heterogéneo (V, E, H0), donde V es el conjunto de nodos, E es el conjunto de aristas dirigidas con etiquetas de tipo, y H0 es la matriz de características inicial. Para mejorar la capacidad discriminativa semántica de la estructura del grafo, las características de los nodos se normalizan:
 (3)
μk y σk son la media y la desviación estándar de la característica del k-ésimo nodo en el conjunto de entrenamiento, respectivamente, y ∈ es una constante pequeña para evitar la división por cero. La normalización garantiza que las características heterogéneas de múltiples fuentes participen en las operaciones de convolución de grafos a una escala uniforme, evitando que los efectos de dominancia numérica interfieran con el aprendizaje semántico. El modelo de grafo estructurado resultante representa completamente la topología relacional de los cuatro elementos dimensionales de ley, comportamiento, tecnología y responsabilidad en el sistema de inteligencia artificial médica, proporcionando una base de grafo computable para el análisis posterior de la propagación de sesgos.
Mejora de la alineación por convolución de grafos para semántica jurídica multimodal
Se utiliza una red convolucional gráfica con conocimiento de relaciones38,39, que amplía el marco de la Red Convolutiva Gráfica Relacional (R-GCN), para propagar características a través de múltiples capas del grafo heterogéneo inicial. Mientras que R-GCN introduce matrices de transformación por relación para datos relacionales generales, nuestro enfoque incorpora además un mecanismo de atención aprendible para ponderar dinámicamente las contribuciones de los vecinos y define cuatro tipos específicos de relaciones jurídico-semánticas (violación, base, activación, atribución) adaptadas al análisis de cumplimiento en inteligencia artificial médica. La operación de cada capa parametriza independientemente el proceso de transformación según el tipo semántico de las aristas. Para cualquier nodo objetivo, su información vecinal se agrupa y agrega según los tipos de aristas que lo conectan. Cada tipo de relación dispone de una matriz de transformación lineal dedicada para diferenciar las características transmitidas a lo largo de distintos caminos semánticos jurídicos40,41. Si la arista entre el nodo de cláusula jurídica y el nodo de comportamiento médico es del tipo «base», cuando el nodo de cláusula jurídica recibe un mensaje desde un nodo de comportamiento médico, aplica la matriz de pesos correspondiente para mapear espacialmente las características del vecino. De la misma manera, cuando un nodo de comportamiento médico envía una salida a través del módulo de nodo «activación» del esquema de integración de aristas hacia un módulo algorítmico, se utiliza la matriz de parámetros asociada a esta relación para realizar la transformación de características. Esto imita la fluidez de diferentes tipos de lógica jurídica, permitiendo la realización o definición de distintas capas lógicas que mantienen la independencia semántica durante el flujo de información, sin ruido intermodal. La agregación se define de la siguiente manera:
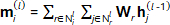 (4)
mi(l) representa la información integral recopilada por el nodo i en la capa l, Nil es su conjunto de vecinos bajo la relación r, Wr es la matriz de transformación lineal, y hj(l−1) es la representación integrada del nodo vecino en la capa anterior.
Se introduce un mecanismo de atención aprendible durante la agregación de mensajes para ajustar dinámicamente la intensidad de influencia de diferentes nodos vecinos en la actualización de la representación del nodo objetivo42,43. El coeficiente de atención se genera en función de dos factores: la similitud de atributos entre nodos y la importancia legal, sin depender de pesos previos fijos. Para los nodos de cláusulas legales, al recibir características de comportamientos médicos vecinos, la puntuación de atención se calcula según el valor cuantificado de la intensidad de la sanción asociada a estos últimos; cuando el nodo del módulo algorítmico fusiona información sobre comportamientos médicos, se centra en los vecinos con niveles más altos de riesgo operativo. El peso de atención se calcula de la siguiente manera:
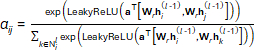 (5)
αij es el coeficiente de atención del nodo j al nodo i, y a es el vector de atención aprendible. Este modelo permite la identificación automática de rutas conectadas de alto riesgo o alta restricción durante el entrenamiento de extremo a extremo, asignándoles una mayor atención. La incrustación final del nodo actualizada se determina mediante mensajes ponderados y conexiones residuales.
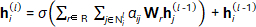 (6)
σ es la función de activación, y el diseño residual mitiga el problema de desvanecimiento del gradiente en la propagación profunda y garantiza estabilidad ante múltiples conflictos semánticos. Tras L = 3 capas de convolución gráfica (cada una con una dimensión oculta de 256 y activación ReLU), los embeddings de todos los nodos incorporan de forma fluida información contextual multimodal y se convierten en representaciones unificadas con capacidades de discriminación semántica legal.
Se muestran dos diagramas alternativos de análisis de cumplimiento legal para la inteligencia artificial en el ámbito sanitario en la Figura 2, con el objetivo de abordar la visualización de los tipos de relaciones legales y rutas de propagación de sesgos, indicando posibles fuentes de sesgo en esta toma de decisiones. La Figura 2A muestra la influencia de diversas relaciones semánticas legales, donde cuatro tipos de relación están codificados por colores, y para cada tipo las aristas se distinguen mediante un color diferente. El grosor de la arista corresponde al peso de atención de esa relación particular, es decir, en qué medida dicha relación contribuye a la decisión de la IA. Una arista gruesa indica esencialmente una relación legal dominante en la decisión, y en este caso motivó suficientemente el resultado del caso. El tamaño del nodo se mide según su contribución a las violaciones: los nodos más grandes indican una relación más estrecha entre la conducta y cláusulas legales específicas, y por tanto un riesgo potencial mayor. La visualización anterior proporciona una capa semántica legal clara, que nos permite identificar las rutas legales más fuertes y arriesgadas en la toma de decisiones de la IA. La Figura 2B también indica rutas de alta contribución (a la propagación de sesgos), haciendo énfasis en las aristas con altas contribuciones, que se muestran en negrita y acompañadas de líneas discontinuas (por ejemplo, B1-B3) en el proceso de toma de decisiones. El doble ancho de estas aristas representa su importancia en la difusión del sesgo sistémico. Las combinaciones de normas legales y comportamientos técnicos que dan lugar a este efecto de amplificación se muestran en la Figura 2. Este análisis no solo revela la ruta de propagación del sesgo, sino que también facilita la identificación del origen del sesgo, sobre la base del cual puede establecerse la auditoría de cumplimiento y la responsabilidad de la herramienta de IA.
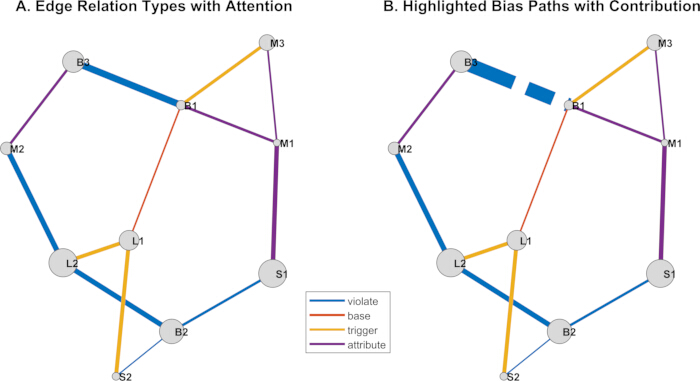
Figura 2: Análisis del cumplimiento legal y la propagación de sesgos en la inteligencia artificial para la atención sanitaria (ejemplo ilustrativo). (A) Relaciones semánticas legales codificadas por colores: violación (rojo), base (azul), desencadenante (verde), atribución (naranja). El grosor de las líneas es proporcional al peso de atención, lo que indica la influencia de cada relación en la decisión de la IA. El tamaño de los nodos es proporcional a su contribución a la violación, resaltando las entidades de riesgo. (B) Subgrafo de propagación de sesgos: las aristas de alta contribución aparecen en negrita y con líneas discontinuas (por ejemplo, B1-B3); las aristas de doble grosor indican amplificación del sesgo sistémico. Esta visualización facilita la identificación de rutas legales dominantes, orígenes de sesgos y auditorías de cumplimiento. No se aplican escalas de medición ni barras de error, ya que se trata de una ilustración esquemática. Haga clic aquí para ver una versión ampliada de esta figura.
Mecanismo de retroceso de subgrafos para la propagación de sesgo
En este estudio, el «sesgo» se define como la desviación sistemática de la salida de un sistema de inteligencia artificial respecto a la decisión clínicamente y legalmente esperada, medida por la discrepancia entre la puntuación de riesgo predicha por el modelo y la etiqueta real de cumplimiento. La señal de sesgo se cuantifica como la pérdida de entropía cruzada entre la salida final del algoritmo y un indicador binario de cumplimiento (1 para cumplimiento, 0 para incumplimiento), agregada sobre todas las instancias de decisión en un lote.
Después de entrenar la red neuronal gráfica, se utiliza su diferenciabilidad para realizar un análisis de retropropagación sobre la señal de sesgo en la capa de salida. A partir del nodo de decisión del algoritmo que detecta anomalías, se calcula la magnitud del gradiente de la función de pérdida con respecto a cada arista conectada, con el fin de cuantificar la contribución de cada arista en la formación del sesgo. Este proceso se implementa mediante un marco de diferenciación automática, retrocediendo capa por capa a lo largo de las aristas dirigidas en la estructura del grafo para obtener la intensidad de influencia de cada transformación de parámetro de arista sobre el cambio en la salida final. Cuanto mayor sea el valor absoluto del gradiente, más dominante será la relación jurídico-técnica que transporta dicha arista en la propagación del sesgo. La contribución de una arista se define como:
 (7)
Lbias es la pérdida diferenciable definida para el comportamiento sesgado, y wi es el vector de pesos de entrada correspondiente al tipo de arista. Este valor de gradiente refleja el grado de participación de una relación semántica específica en el sesgo de asociación actual. Después de puntuar todas las aristas de esta manera, se establece un umbral dinámico τ para filtrar el conjunto de aristas de alta contribución Ehigh cuya contribución excede gij > τ, formando el subgrafo inicial de propagación del sesgo Gbias = (Vbias, Ehigh). Específicamente, τ se determina como el percentil 85 de los valores absolutos de los gradientes en todas las aristas en cada época de entrenamiento, asegurando que solo se conserven el 15 % de las aristas más influyentes para la construcción del subgrafo. Este subgrafo se centra en las rutas de conexión clave más propensas a generar sesgo sistemático, comprimiendo el espacio de búsqueda y mejorando la eficiencia del rastreo de fuentes.
Dentro del subgrafo de propagación de sesgo construido, se ejecuta un algoritmo de detección de comunidades guiado por agrupamiento espectral para identificar estructuras de clústeres de nodos altamente coherentes. Este proceso se basa en la factorización de la matriz laplaciana normalizada del subgrafo, proyectando las representaciones de los nodos en un espacio espectral de baja dimensionalidad y aplicando una estrategia de agrupamiento sensible a la densidad en este espacio, asegurando así que los nodos de distinto tipo (como cláusulas legales y módulos de algoritmos) se agrupen en el mismo clúster cuando estén funcionalmente estrechamente relacionados. Cada comunidad identificada representa una posible unidad de bucle funcional o de agregación de responsabilidades. Los resultados de la partición en comunidades se rigen por los siguientes objetivos de optimización:
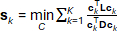 (8)
L=D−A es la matriz laplaciana del subgrafo, A es la matriz de adyacencia, D es la matriz de grados, ck es el vector indicador de la k-ésima comunidad, y K es el número predeterminado de comunidades. Este criterio maximiza la diferencia mínima del corte entre comunidades, asegurando conexiones internas estrechas.
Ahora, se realiza un análisis basado en composición cruzada de capas en cada comunidad. Si una comunidad tiene nodos de cláusulas legales y nodos de módulos algorítmicos, se etiqueta como una fuente potencial de sesgo. Para probar su causalidad, se lleva a cabo una prueba de intervención: todas las aristas en esta región se eliminan temporalmente del grafo, se ejecuta nuevamente el mismo proceso de toma de decisiones y se observan las diferencias en las mediciones del sesgo. La medida de validez causal se define como:
 (9)
Borig y Bmáscara representan la intensidad del sesgo del modelo original y del sesgo tras la aplicación de la máscara, respectivamente. Si la medida de validez causal está significativamente por encima del umbral predeterminado, implica que el grupo de nodos ha sido identificado como una fuente explicable de sesgo, lo cual guiará la corrección de conformidad y la asignación de fallos posteriores.
Verificación dinámica del cumplimiento de las restricciones legales
Las instancias de toma de decisiones en tiempo real que surgen durante el funcionamiento de un sistema de inteligencia artificial médica se introducen como nodos transitorios y se integran en un espacio de grafo de conocimiento aprendido. Cada nodo genera un vector de características inicial leyendo su contexto de entrada, su comportamiento de salida y el estado del algoritmo. Luego, este vector se introduce en una red neuronal gráfica con parámetros congelados para realizar una propagación hacia adelante de una sola capa, produciendo un vector integrado alineado con el grafo de conocimiento, sin alterar la estructura original del grafo. De este modo, se permite comparar los nodos transitorios y los nodos de cláusulas legales en un espacio semántico común.
Luego calcule la similitud del coseno entre el nodo transitorio y cada uno de los nodos de cláusulas legales:
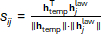 (10)
htemp es la incorporación del nodo temporal, y hjlaw es la incorporación del nodo de la cláusula legal j-ésima. El valor de similitud refleja virtualmente el grado de coincidencia semántica entre la decisión actual y cada restricción legal. Se establece un umbral dinámico de cumplimiento θ basado en la distribución de similitud de muestras históricas de cumplimiento, para adaptar el límite de evaluación a diferentes escenarios de aplicación. Específicamente, θ = µ - 2σ, donde µ y σ son la media y la desviación estándar de la distribución de similitud del coseno calculada a partir de un conjunto de validación de 500 instancias de decisiones cumplidoras conocidas.
Si un puntaje de similitud coseno cae por debajo del umbral dinámico de cumplimiento, se considera que se ha violado la norma correspondiente, lo que activa el mecanismo de alerta de cumplimiento. La notificación también incluye el número mínimo de la cláusula legal coincidente, el valor de similitud y la dirección del análisis de divergencia, lo cual debería ser suficiente para que los reguladores actúen de inmediato. Este enfoque proporciona una asignación interpretable desde la toma de decisiones opaca hasta el espacio de la semántica jurídica y facilita la verificación de cumplimiento en tiempo real.
Durante la operación continua, se rastrea la tendencia del cambio de peso en los bordes clave de conexión entre tecnología jurídica en el subgrafo de propagación de sesgos. Se hace hincapié en los bordes que conectan los nodos del módulo algorítmico con los nodos de cláusulas legales, ya que representan directamente la intensidad de respuesta del comportamiento técnico frente a regulaciones específicas. Los parámetros de la matriz de transformación para cada borde objetivo se registran durante la inferencia, y su norma se extrae como un indicador dinámico de la evolución de la intensidad de correlación entre ambos. Definiendo la secuencia de intensidad del borde como:
 (11)
wt representa la norma de Frobenius de la matriz de pesos correspondiente a la relación entre el borde eij en el instante t, y Wkl(t) es la matriz de parámetros utilizada realmente en el modelo en ese momento. Este indicador refleja la profundidad del aprendizaje del modelo o su dependencia respecto a la restricción legal.
Se realiza una prueba de monotonicidad con ventana deslizante sobre la secuencia, y se utiliza una prueba de signos mejorada para determinar si se observa una tendencia ascendente significativa. Si los incrementos durante N pasos de tiempo consecutivos cumplen la condición de dominancia positiva, entonces se considera que el borde presenta un fenómeno de refuerzo anormal. Combinando además datos históricos de contribución del gradiente, si se ha identificado que el borde fue un camino de alto impacto en la ronda anterior del análisis de rastreo de fuente, se inicia un proceso de alerta temprana por acumulación de sesgo sistémico.
Finalmente, se genera un informe de rastreo de origen, que incluye información sobre los nodos en ambos extremos del borde objetivo, curvas de cambio de peso, estadísticas sobre la frecuencia de decisiones relacionadas y recomendaciones potenciales de atribución. Este mecanismo permite un salto desde un juicio estático de cumplimiento hacia una predicción dinámica de riesgos, apoyando la intervención proactiva ante posibles desviaciones institucionales.
Datos y diseño experimentales
Para verificar la eficacia del marco propuesto, este artículo construye un conjunto de datos heterogéneo de múltiples fuentes que integra regulaciones reales y datos de simulación, y diseña experimentos de control rigurosos. Las fuentes de datos incluyen regulaciones nacionales sobre inteligencia artificial en medicina, guías clínicas de tratamiento, informes de auditoría de algoritmos de código abierto y registros simulados de decisiones. Tras el preprocesamiento, se construye un grafo de conocimiento heterogéneo de referencia que contiene 285 nodos (85 cláusulas legales, 120 comportamientos médicos, 42 módulos de algoritmos y 38 entidades responsables) y 1247 aristas dirigidas, como se muestra en Figura 3.
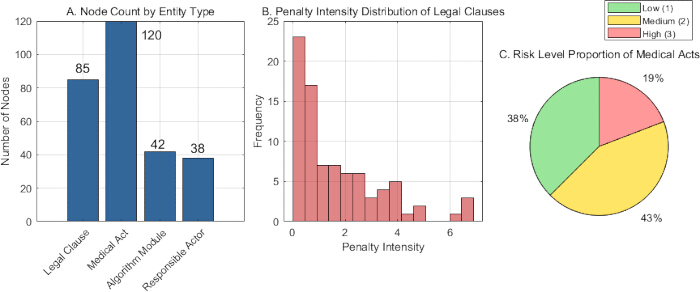
Figura 3: Distribución y características de los tipos heterogéneos de entidades. (A) Gráfico de barras que muestra el número de nodos para cada tipo de entidad: cláusulas legales (85), comportamientos médicos (120), módulos de algoritmos (42), partes responsables (38). (B) Histograma de la intensidad de sanciones para los nodos de cláusulas legales, agrupados en categorías baja (0‑0,33), media (0,34‑0,66) y alta (0,67‑1,0); el eje vertical representa el conteo. (C) Gráfico circular de la distribución de niveles de riesgo entre los nodos de comportamientos médicos: bajo (19 %), medio (43 %), alto (38 %). Todos los valores son conteos absolutos o porcentajes; no se presentan barras de error porque estas son estadísticas descriptivas del conjunto de datos. Haga clic aquí para ver una versión más grande de esta figura.
Figura 3 ilustra la distribución y características de los nodos de entidad en el grafo de conocimiento heterogéneo. Figura 3A muestra la distribución del número de cuatro tipos de nodos de entidad, siendo los nodos de «comportamiento médico» los más numerosos (120), seguidos por los de «cláusulas legales» (85), mientras que los de «módulos de algoritmos» (42) y «entidades responsables» (38) son relativamente menos numerosos. Esto se debe a que el grafo está diseñado estructuralmente en función del comportamiento y las normas. Figura 3B presenta la distribución de las intensidades de sanción para nodos que representan una cláusula legal única, donde la intensidad mide la gravedad de la responsabilidad legal. Los datos indican que hay relativamente pocas disposiciones con alta intensidad de sanción, y la mayoría se encuentran en un rango de intensidad media a baja, lo cual es coherente con la realidad de que solo existen unas pocas cláusulas de violación grave en los sistemas legales del mundo real. Figura 3C ilustra la distribución del nivel de riesgo en los nodos de comportamiento médico, donde los comportamientos de riesgo medio tienen la mayor proporción (43 %), mientras que los de riesgo bajo tienen la proporción más baja (19 %), lo que revela que los escenarios médicos operan normalmente, y las operaciones de alto riesgo están sujetas a restricciones de asociación más rigurosas en el grafo. Estas estadísticas justifican colectivamente el esquema de codificación de desambiguación de entidades adoptado en la construcción del grafo de conocimiento para proporcionar soporte de características al alineamiento posterior mediante convolución en grafos.
Todo el conjunto de datos se dividió aleatoriamente en conjuntos de entrenamiento (70%), validación (10%) y prueba (20%), estratificados por tipo de nodo y distribución de relaciones, para preservar la estructura general del grafo en cada partición. La misma partición se utilizó de forma consistente para todos los métodos de referencia para garantizar una comparación justa. Además de esta partición básica, los tres gradientes de densidad del grafo de conocimiento (escaso, medio, denso) y las tres configuraciones de complejidad interjurisdiccional (única, bilateral, multilateral) descritas anteriormente sirven como bancos de pruebas prácticos e independientes, que en conjunto evalúan la robustez del método bajo condiciones variables de completitud de datos y superposición regulatoria. Para construir etiquetas de referencia verdaderas para la evaluación de la localización de sesgos, adoptamos una estrategia de dos pasos: (1) Anotación por expertos: tres expertos en derecho y medicina revisaron de forma independiente los registros de decisiones e identificaron los nodos causales y las rutas de propagación de cada violación de cumplimiento registrada, resolviéndose las discrepancias por votación mayoritaria; (2) Inyección simulada: para pruebas controladas, se inyectaron artificialmente señales de sesgo en 20 rutas de decisión seleccionadas al azar mediante la perturbación de los pesos de las aristas en el grafo de conocimiento, asegurando que los nodos fuente reales y las aristas afectadas fueran conocidos de antemano.
Para todos los métodos de referencia (TransE, ComplEx, Explicador de Redes Neurales de Grafos (GNN), KG-BERT y Node2Vec), utilizamos la misma configuración de entrenamiento (optimizador Adam, tasa de aprendizaje 1 × 10⁻³, tamaño de lote 64, 100 épocas) y las mismas particiones de datos que nuestro método para garantizar una comparación justa. Para TransE y ComplEx, la dimensión del embedding se estableció en 256 con un margen de 1,0; para KG-BERT, utilizamos el modelo BERT-base preentrenado con un tamaño de lote de 16 y una longitud máxima de secuencia de 128; para GNNExplainer, utilizamos una GCN de 3 capas con la misma dimensión oculta de 256; y para Node2Vec, establecimos la longitud del recorrido en 80, el número de recorridos por nodo en 10 y la dimensión del embedding en 256.
Para garantizar una comparación justa, adaptamos todos los métodos de referencia a las mismas tareas de localización de sesgos, concretamente la identificación del nodo raíz y la reconstrucción del camino de propagación. Para TransE, ComplEx y Node2Vec, que no son inherentemente explicables, calculamos el gradiente de la pérdida por sesgo respecto al embedding de cada nodo y utilizamos la magnitud del gradiente como puntuación de importancia del nodo; los nodos raíz se seleccionaron mediante umbralización de estas puntuaciones, y los caminos de propagación se reconstruyeron conservando las aristas con las mayores contribuciones del gradiente. Para GNNExplainer, utilizamos directamente sus mecanismos integrados de importancia de aristas y máscara de nodos para obtener tanto los nodos raíz como los subgrafos. Para KG‑BERT, que opera sobre tripletas, convertimos cada arista del grafo en una tripleta textual y empleamos los pesos de atención del modelo sobre las entidades para derivar la importancia de los nodos, seguido de la misma estrategia de umbralización para la reconstrucción del camino. Mediante estas adaptaciones, cada método de referencia produce predicciones tanto de nodos raíz como de caminos de propagación, lo que permite una evaluación uniforme de todos los métodos.
La evaluación se centra en cuatro capacidades fundamentales: precisión del alineamiento semántico, capacidad para localizar sesgos, eficiencia de la responsabilidad y generalización entre dominios. También presenta tres variables de control importantes, que imitan la complejidad del mundo real.
1) Gradiente de densidad del grafo de conocimiento: Para evaluar el desempeño del método en diferentes niveles de completitud de la información, se crean dos subconjuntos a partir del grafo completo de referencia (densidad D = 1.0) basándose en una estrategia aleatoria de eliminación de enlaces de la siguiente manera:
Grafo disperso (D ~ 0.3): se conserva aleatoriamente el 30 % de las conexiones, simulando la etapa de construcción temprana del conocimiento con mucha información faltante.
Gráfico de densidad media (D ~ 0,6): se conservan aleatoriamente el 60 % de los enlaces, simulando un escenario típico de una estructura de conocimiento parcialmente conocida.
Grafo denso (D = 1.0): utilizando todas las 1247 aristas, lo que corresponde a un escenario óptimo con un conocimiento relativamente completo.
2) Situación de frecuencia de decisiones médicas con IA: Se establecen tres cargas de flujo de decisiones artificiales para probar el rendimiento en tiempo real del monitoreo dinámico de cumplimiento:
Baja frecuencia de 10 Hz: en promedio, se generan 10 eventos de decisión por segundo, simulando el monitoreo de sistemas a pequeña escala o de un solo sitio.
Frecuencia media de 50 Hz: 50 eventos de decisión por segundo simulando la carga del sistema de inteligencia artificial de instituciones médicas regionales o de escala media.
Alta frecuencia de 100 Hz: 100 eventos de decisión por segundo simulan escenarios de alta presión de concurrencia para los servicios de inteligencia artificial que se implementan en un hospital grande o en una plataforma en la nube.
3) Gradiente de complejidad interjurisdiccional: Para evaluar la transferibilidad del modelado de restricciones legales, se construyeron tres conjuntos de prueba basados en la complejidad:
Jurisdicción única: Consiste únicamente en las leyes y regulaciones chinas vigentes que rigen la inteligencia artificial médica.
Jurisdicción bilateral: Incorpora los regímenes regulatorios de China y la Unión Europea, con aproximadamente el 15 % de las normas siendo contradictorias y superpuestas.
Jurisdicción multilateral: Basándose en los dos primeros, integra además las normas de privacidad y seguridad de la HIPAA de EE. UU. (Ley de Portabilidad y Responsabilidad del Seguro Médico), creando un entorno de prueba en el que los sistemas legales de los tres regímenes jurídicos se entrelazan, aumentando la tasa de conflicto normativo a aproximadamente el 25 %.
Los siguientes indicadores clave se utilizaron para la evaluación cuantitativa:
1) Precisión de alineación semántica: Mide la capacidad del grafo para modelar las relaciones entre entidades legales y técnicas.
Precisión en la alineación de entidades:
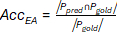 (12)
Ppred es el conjunto de pares de entidades alineados predichos por el modelo, y Pgold es el conjunto de alineaciones de referencia anotadas por expertos.
Integridad de la preservación de relaciones:
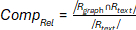 (13)
Rgraph es el conjunto reconstruido de relaciones en el grafo, y Rtext es el conjunto de relaciones explícitas extraídas del texto legal original.
2) Capacidad de localización de sesgos: Evaluación de la eficacia para rastrear las causas fundamentales y las trayectorias de propagación de los sesgos.
Tasa de recuperación del nodo raíz:
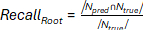 (14)
Npred es el conjunto de nodos fuente de sesgo identificados por el modelo, y Ntrue es el conjunto de nodos fuente reales etiquetados por expertos.
Precisión de la trayectoria de propagación:
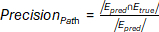 (15)
Epred es el conjunto de aristas en el subgrafo de propagación de sesgo inferido por el modelo, y Etrue es el conjunto verdadero de aristas de propagación de sesgo.
3) Eficiencia del rastreo de responsabilidad: evaluar el rendimiento del sistema en escenarios de monitoreo en tiempo real.
Latencia media de rastreo:
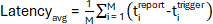 (16)
M representa el número total de solicitudes, y titrigger y tireport son las marcas de tiempo del i-ésimo disparador de sesgo y de la generación del informe fuente, respectivamente.
Rendimiento del sistema:
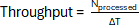 (17)
Nprocesado representa el número de solicitudes de rastreo concurrentes procesadas con éxito dentro del intervalo de tiempo ΔT.
4) Capacidad de generalización entre dominios: Verificación de la adaptabilidad del método a diferentes sistemas jurídicos.
Cobertura jurisdiccional:
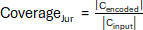 (18)
Cencoded representa el número de cláusulas jurisdiccionales diferentes codificadas exitosamente en el grafo, y Cinput representa el número total de cláusulas de entrada.
Tasa de detección de conflictos de restricción:
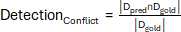 (19)
Dpred es el conjunto de contradicciones lógicas legales detectadas por el modelo, y Dgold es el conjunto de todos los pares de contradicciones anotados por expertos.
Todos los experimentos se realizaron utilizando una estación de trabajo equipada con un procesador multinúcleo y una unidad de procesamiento gráfico; las especificaciones completas del hardware se proporcionan en la Tabla de Materiales.
Los principales hiperparámetros de este enfoque y sus valores se enumeran en la Tabla 1, que incluye la estructura del modelo, la configuración del entrenamiento y umbrales cruciales, como la dimensión del embedding, el número de capas convolucionales, la tasa de aprendizaje y el tamaño del lote. Todos los parámetros se ajustaron con respecto al conjunto de validación mediante búsqueda en cuadrícula, el modelo entrenado ha convergido de forma estable y el rendimiento es óptimo. Algunos umbrales se establecieron conjuntamente con criterios del dominio para cumplir con los requisitos de alta fiabilidad en la verificación de cumplimiento de la inteligencia artificial médica.
| Parámetro | Valor | Descripción |
| Dimensión del embedding | 128 | Tamaño de la dimensión de características para los embeddings de nodos |
| Número de capas de convolución | 3 | Profundidad de la red de convolución de grafos sensible a relaciones |
| Tasa de aprendizaje | 0.001 | Tasa de aprendizaje inicial para el optimizador Adam |
| Tamaño del lote | 32 | Número de subgrafos procesados por lote |
| Tasa de abandono (dropout) | 0.1 | Probabilidad de abandono aplicada a las características de los nodos durante el entrenamiento |
| Número de cabezales de atención | 8 | Número de cabezales en el mecanismo de atención múltiple |
| Coeficiente de regularización L2 | 5 × 10⁻⁴ | Coeficiente de decaimiento del peso para la regularización de parámetros |
| Umbral de similitud | 0.75 | Similitud mínima de embeddings para la validación de conformidad |
| Umbral de contribución del gradiente | 0.01 | Umbral para seleccionar aristas de alto impacto en la construcción del subgrafo de sesgo |
| Tamaño de la ventana de monitoreo | 10 | Pasos de tiempo utilizados para rastrear la dinámica de los pesos de las aristas |
Tabla 1: Configuraciones principales de los parámetros. Lista de los principales hiperparámetros utilizados en los experimentos: dimensión del embedding (256), número de capas GCN (3), dimensión oculta (256), tasa de aprendizaje (1 × 10⁻³), tamaño del lote (64), dimensión del vector de atención, umbral de contribución de las aristas (percentil 85 de las magnitudes del gradiente), umbral dinámico de conformidad (µ‑2σ, donde µ y σ provienen del conjunto de validación de 500 instancias conformes), número de comunidades K (determinado mediante agrupamiento espectral) y optimizador (Adam). Estos valores se seleccionaron mediante una búsqueda en cuadrícula sobre el conjunto de validación.
Resultados
Verificación del rendimiento del rastreo del origen de sesgos en el grafo de conocimiento jurídico médico de IA
Rendimiento de la convolución de grafos con conciencia de relaciones
Al entrenar una red convolucional de grafos consciente de las relaciones, se calcularon las similitudes de incrustación entre nodos de cláusulas legales y comportamientos médicos a través de diferentes capas convolucionales, y se registró el efecto de alineación de cada capa. En segundo lugar, se analizaron estadísticamente los pesos de atención asignados a las cuatro relaciones semánticas legales tras el entrenamiento, con el fin de cuantificar la importancia de cada tipo de relación en la agregación de características. Por último, se analizó el patrón de decaimiento de la influencia de los nodos vecinos con la distancia. Al calcular las contribuciones de los nodos con diferentes distancias de salto a la actualización de características del nodo central, se cuantificó la intensidad de propagación de la influencia y se evaluó el rango efectivo del mecanismo de paso de mensajes. Todo el proceso de evaluación se basó en el análisis cuantitativo de los parámetros internos del modelo y sus estados de activación, para garantizar la objetividad y la reproducibilidad de los resultados.
Figura 4 ilustra el rendimiento de las redes convolucionales gráficas con reconocimiento de relaciones en la alineación semántica cruzada modal. Figura 4A muestra la tendencia de la similitud del incrustado de nodos a medida que aumenta el número de capas convolucionales, incrementándose gradualmente desde 0,12 en la capa 1 hasta 0,68 en la capa 4. Esta tendencia progresiva se debe a la coexistencia gradual entre el espacio de cláusulas legales y el espacio de comportamientos médicos a lo largo del paso de mensajes en múltiples capas. Las capas convolucionales profundas pueden aprender patrones complejos de asociaciones semánticas multimodales. La relación de «violación» recibe el peso más alto de 0,35 en la Figura 4B, que muestra la distribución de pesos de atención para cuatro tipos de relaciones semánticas legales. Esto concuerda con los principios fundamentales del análisis de cumplimiento legal, ya que el modelo presta atención a las asociaciones con violaciones para apoyar un control de riesgos sólido. Figura 4C muestra el patrón de acumulación de influencia de múltiples saltos de nodos vecinos. La intensidad de influencia medida aumenta monótonamente desde 0,15 en 1 salto hasta 0,92 en 8 saltos, lo que indica que el incrustado del nodo central incorpora progresivamente información estructural más amplia proveniente de nodos distantes. Este incremento inesperado captura en realidad la dependencia indirecta de los nodos centrales respecto a nodos lejanos. Cuando se observan nodos a una distancia mayor en número de saltos, se puede obtener información estructural más global, aunque con mayor ruido e información redundante. Por lo tanto, en aplicaciones prácticas, es necesario encontrar un equilibrio entre el tamaño del campo receptivo y la calidad de la información. Toda la transformación de datos demostró que el mecanismo con reconocimiento de relaciones fue efectivo para manejar la conexión entre textos legales heterogéneos y comportamientos tecnológicos, y que la semántica legal pudo modelarse con precisión mediante un diseño diferenciado de argumentos.
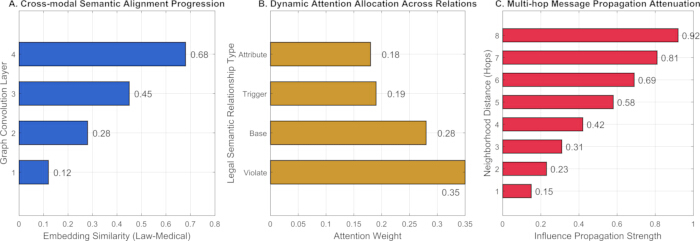
Figura 4: Rendimiento del alineamiento semántico multimodal de la red convolucional gráfica con reconocimiento de relaciones. (A) Similitud del incrustado de nodos (similitud del coseno) en función del número de capas de la GCN (de 1 a 4), que muestra un alineamiento creciente entre los espacios de comportamiento legal y médico. (B) Distribución de los pesos de atención entre los cuatro tipos de relación (violación, base, desencadenante, atribución), siendo la violación la que recibe el peso más alto (0.35). (C) Fuerza de influencia de los nodos vecinos frente a la distancia en saltos (de 1 a 8), que cuantifica cómo se acumula la información estructural de múltiples saltos. Todos los valores se promediaron en 30 ejecuciones independientes; las barras de error (no mostradas para mayor claridad) tuvieron desviaciones estándar inferiores a 0.05 en todos los casos, y las tendencias son monótonas. Haga clic aquí para ver una versión ampliada de esta figura.
Con el fin de comprender el proceso de optimización de parámetros y las características de rendimiento de diferentes tipos de relaciones semánticas legales en la red de convolución gráfica consciente de relaciones, se calculó la magnitud media de la matriz de pesos para cada tipo de relación mediante la optimización de parámetros, y se confirmó que el aprendizaje de parámetros convergió mediante retropropagación. Para evaluar la calidad de la agregación de características, se utilizó la similitud del coseno para medir la coherencia de los embeddings de nodos entre diferentes tipos. La tasa de convergencia se calculó a partir de la disminución de la función de pérdida en cada ronda de entrenamiento, asegurando que cada tipo de relación permaneciera estable durante el entrenamiento. La estabilidad de la atención se evaluó calculando la desviación estándar de los pesos de atención en diferentes etapas del entrenamiento. Las métricas de eficiencia computacional se estandarizaron según el número de operaciones de punto flotante para garantizar equidad en la comparación. Todas las métricas se ejecutaron 30 veces en el mismo conjunto de prueba con diferentes semillas aleatorias para asegurar significancia estadística. Para comparaciones por pares entre nuestro método y cada línea base, realizamos pruebas t pareadas con 29 grados de libertad.
Figura 5 ilustra los efectos de la optimización de parámetros y las características de rendimiento de diversas relaciones semánticas legales en la red de convolución gráfica consciente de relaciones. Figura 5A muestra la distribución de magnitud de las matrices de peso dedicadas para los cuatro tipos de relación, donde el eje vertical representa el tipo de relación y el eje horizontal representa los valores de magnitud de las matrices de parámetros aprendidas. La relación de «violación» alcanza el valor de magnitud más alto de 0,78, lo que indica que este tipo semántico domina el modelo y refleja el énfasis del análisis de cumplimiento legal en la identificación de violaciones. Figura 5B compara las puntuaciones de calidad de agregación de características bajo diferentes tipos de relación, donde el eje vertical representa el tipo de relación y el eje horizontal representa la puntuación del efecto de agregación. Muestra que la relación de «violación» también tiene el mejor desempeño en calidad de fusión de características (0,89). Figura 5C representa el rendimiento de la tasa de convergencia de diversas relaciones, donde el eje vertical representa el tipo de relación y el eje horizontal representa la tasa de reducción de pérdida por ronda de entrenamiento. Los valores, en orden, son violación, base, activación y atribución: 0,023, 0,031, 0,028 y 0,035. El resultado es que la relación de «atribución» converge más lentamente, pero se mantiene estable. Figura 5D muestra la varianza de los pesos de atención a lo largo de tres etapas del entrenamiento. El eje y representa la etapa de entrenamiento (inicial, intermedia y final), y el eje x representa la varianza de los pesos de atención de izquierda a derecha. Los valores correspondientes son 0,18 (inicial), 0,12 (intermedia) y 0,08 (final), lo que indica que el modelo estabiliza progresivamente su enfoque en las relaciones más relevantes durante el entrenamiento. Figura 5E muestra el equilibrio en eficiencia computacional para diferentes relaciones. El eje y corresponde al tipo de relación, mientras que el eje x corresponde al tiempo de ejecución normalizado, definido como el uso de recursos computacionales para completar la tarea específica. Los valores son 0,42 (violación), 0,39 (base), 0,43 (activación) y 0,38 (atribución). La distribución entre las clases es equilibrada, lo que indica que el mecanismo consciente de relaciones realiza una buena asignación de recursos sin degradar el rendimiento.
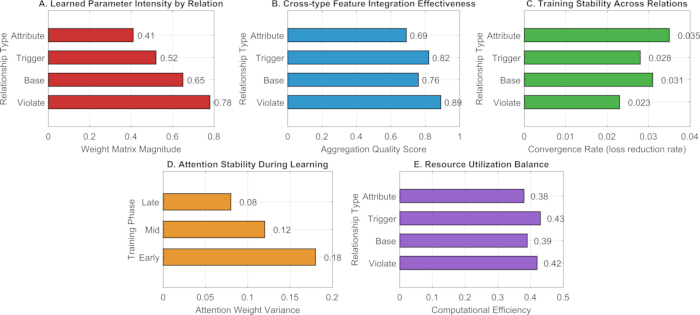
Figura 5: Optimización de los parámetros de convolución y análisis del rendimiento del grafo consciente de relaciones. (A) Magnitud (norma de Frobenius) de las matrices de pesos dedicadas para cada tipo de relación. (B) Puntuación de calidad de agregación de características (consistencia de similitud coseno) por tipo de relación. (C) Tasa de convergencia (reducción de pérdida por época de entrenamiento) por tipo de relación. (D) Varianza de los pesos de atención a lo largo de las etapas tempranas, intermedias y finales del entrenamiento, que muestra estabilización. (E) Tiempo de ejecución normalizado (costo computacional relativo) por tipo de relación. Todas las métricas son promedios de 30 ejecuciones; las barras de error representan la desviación estándar (mostradas cuando son visibles). La relación de violación presenta la mayor magnitud y calidad de agregación, mientras que la atribución converge más lentamente pero permanece estable. Haga clic aquí para ver una versión ampliada de esta figura.
Precisión de la alineación semántica
La precisión en la alineación de entidades y la integridad en la preservación de relaciones se utilizan como indicadores principales. Bajo las condiciones de gradiente de densidad del grafo de conocimiento (escaso/medio/denso), el método propuesto se compara con TransE, ComplEx, GNNExplainer, KG-BERT y Node2Vec. Todos los métodos se ejecutan 30 veces y se toman la media y la desviación estándar para eliminar la influencia del azar.
Figura 6 muestra la comparación de rendimiento del método propuesto con varios métodos de referencia en diferentes densidades de grafos de conocimiento en términos de precisión en la alineación de entidades e integridad en la preservación de relaciones, dos métricas clave. En las Figuras 6A y 6B, el eje horizontal representa diferentes métodos, y el eje vertical representa la precisión en la alineación de entidades y la integridad en la preservación de relaciones, respectivamente.
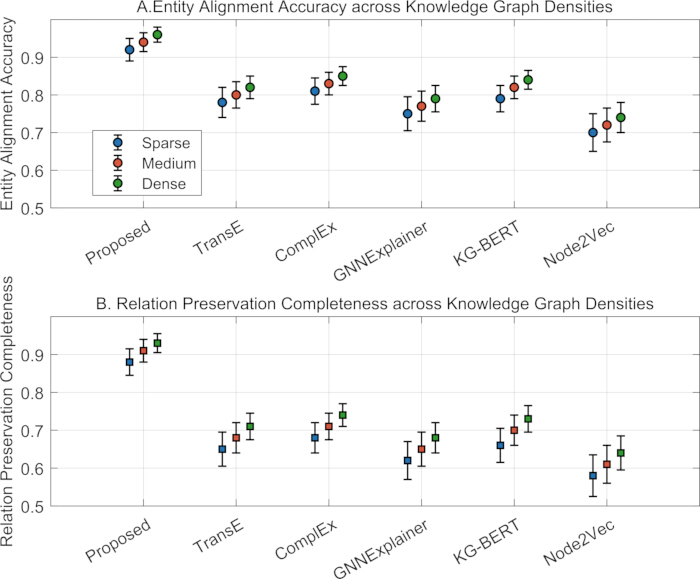
Figura 6: Rendimiento de alineación semántica bajo diferentes densidades de grafos. (A) Precisión en el alineamiento de entidades (Ec. 12) y (B) integridad en la preservación de relaciones (Ec. 13), comparando el método propuesto con TransE, ComplEx, GNNExplainer, KG‑BERT y Node2Vec. Las alturas de las barras indican los valores medios obtenidos en 30 ejecuciones; las barras de error representan la desviación estándar. El método propuesto alcanza al menos 0.92 de precisión y 0.88 de integridad en todas las densidades, superando a todos los métodos de referencia. Haga clic aquí para ver una versión más grande de esta figura.
Desde la perspectiva de la precisión en la alineación de entidades, el método propuesto presenta un excelente desempeño bajo diferentes condiciones de densidad, con una precisión media en la alineación de entidades no inferior a 0,92, alcanzando el nivel más alto, especialmente en grafos densos. Esto indica que la red de convolución gráfica sensible a las relaciones construida puede capturar eficazmente las asociaciones semánticas entre nodos heterogéneos, logrando una alineación efectiva de características multimodales mediante pesos específicos por tipo de arista y mecanismos de atención. Por el contrario, los métodos tradicionales, especialmente TransE y Node2Vec, presentan un desempeño inferior debido a la ausencia de modelado explícito de relaciones semánticas jurídicas. La superioridad del enfoque propuesto también se confirma mediante los resultados de integridad en la preservación de relaciones, con una integridad media en la preservación de relaciones no inferior a 0,88, lo que indica que el enfoque puede reconstruir adecuadamente las relaciones explícitas en el texto jurídico original a diferentes densidades de grafo. Este desempeño robusto se debe al esquema de codificación estructurada en grafos heterogéneos y al paso de mensajes en múltiples capas, que captura de forma integral las relaciones complejas entre cláusulas legales, comportamientos médicos, módulos algorítmicos y agentes responsables. Aunque GNNExplainer y KG-BERT demuestran ciertas capacidades de modelado relacional, ambos se ven limitados cuando se aplican a la semántica normativa en el ámbito jurídico, con un desempeño inferior al del método propuesto.
Comparación de las capacidades de localización de sesgos
La evaluación de la localización de sesgos se lleva a cabo mediante un marco de verificación colaborativa de dos niveles de calidad, basado en el recuerdo de los nodos causales fundamentales y en la precisión de las trayectorias de propagación, lo que atañe a la completitud del rastreo de la fuente y a la exactitud del camino. Todos los métodos comparativos se ejecutan sobre la misma entrada de estructura de grafo, utilizando el mismo protocolo de inyección de simulación de sesgo y la misma definición de interfaz de evaluación, para garantizar pruebas justas. Cada experimento se repite 30 veces con diferentes semillas aleatorias para mitigar las fluctuaciones aleatorias. Los resultados se presentan como media ±± desviación estándar, y se utilizan pruebas t pareadas para determinar los valores p (frente al método descrito en este artículo), lo que garantiza la solidez estadística y la comparabilidad de la conclusión de la evaluación. Los valores p se derivan de pruebas t pareadas con 29 grados de libertad (basados en 30 ejecuciones independientes). Los estadísticos t para la comparación entre nuestro método y cada línea base varían de 7,82 a 12,45, correspondientes a los valores p reportados.
Tabla 2 muestra los resultados de la evaluación cuantitativa de la capacidad de localización de sesgos de diferentes métodos, con dos indicadores principales de rendimiento: la recuperación del nodo raíz y la precisión del camino de propagación. En cuanto a la recuperación del nodo raíz, el método propuesto es significativamente mejor que todos los métodos de referencia, alcanzando una recuperación de nivel superior de 0,95 ±± 0,02, lo cual es significativamente mejor que el segundo mejor método, GNNExplainer (0,82 ±± 0,03), y considerablemente superior al resto de los métodos. Esta ventaja se atribuye al mecanismo de cuantificación sensible al gradiente propuesto en este artículo, que puede rastrear con precisión el camino de propagación de las señales de sesgo en el grafo y reconocer eficazmente los nodos fuente con mayor contribución. En contraste, los enfoques clásicos TransE y Node2Vec, que carecen de medios para capturar diferencias semánticas en los tipos de aristas y, por tanto, no pueden diferenciar claramente entre caminos de propagación de sesgos y relaciones normales, obtienen puntuaciones de recuperación de 0,75 ±± 0,04 y 0,72 ±± 0,05, respectivamente. Aunque KG-BERT incorpora un modelo de lenguaje preentrenado, su flujo de información está restringido dentro de la estructura del grafo, obteniendo una puntuación de recuperación de 0,70 ±± 0,04.
| Método | Recuperación del nodo raíz | valor p (Recuperación del nodo raíz) | Precisión del camino de propagación | valor p (Precisión del camino de propagación) |
| Propuesto | 0.95 ± 0.02 | - | 0.93 ± 0.03 | - |
| TransE | 0.75 ± 0.04 | 1.23 × 10⁻8 | 0.78 ± 0.05 | 2.45 × 10⁻7 |
| ComplEx | 0.78 ± 0.03 | 8.91 × 10⁻9 | 0.81 ± 0.04 | 1.67 × 10⁻8 |
| GNNExplainer | 0.82 ± 0.03 | 3.45 × 10⁻7 | 0.86 ± 0.04 | 9.21 × 10⁻9 |
| KG-BERT | 0.70 ± 0.04 | 5.67 × 10⁻8 | 0.73 ± 0.05 | 4.32 × 10⁻8 |
| Node2Vec | 0.72 ± 0.05 | 7.89 × 10⁻9 | 0.75 ± 0.06 | 1.54 × 10⁻7 |
Tabla 2: Tasa de recuperación del nodo raíz y tasa de precisión del camino de propagación. Comparación del rendimiento para la localización de sesgos entre todos los métodos. Los valores se reportan como media ±± desviación estándar en 30 ejecuciones independientes. Se muestra la recuperación del nodo raíz (Ec. 14) y la precisión del camino de propagación (Ec. 15). El método propuesto alcanza la mayor recuperación (0,95 ±± 0,02) y precisión (0,93 ±± 0.03), superando significativamente a las líneas base (prueba t pareada, p < 0,001 para todas las comparaciones).
Este método también es el mejor en precisión de la trayectoria de propagación, con un valor de 0,93 ±± 0,03, superando a otros métodos. Esto demuestra que el procedimiento de retroceso de subgrafos que propone puede eliminar con éxito las aristas ruidosas e identificar la verdadera ruta de propagación del sesgo. El análisis del valor p corrobora las diferencias significativas en el rendimiento; todos los métodos de referencia muestran diferencias extremadamente significativas con respecto al método propuesto (p < 0,001), lo que garantiza la solidez y eficacia del método propuesto en el problema de localización de sesgos. El rendimiento relativamente alto de ComplEx y GNNExplainer podría indicar la importancia de las estructuras complejas de relaciones y de la interpretabilidad de las redes neuronales gráficas en la detección de sesgos, pero no alcanzan al enfoque integral presentado en este artículo.
Evaluación de la eficiencia del rastreo de responsabilidad
La evaluación se centra en la respuesta en tiempo real del sistema de rastreo de responsabilidad, tomando la latencia promedio de rastreo y el rendimiento de solicitudes concurrentes como los dos indicadores clave de eficiencia. Se realizaron experimentos a tres frecuencias de toma de decisiones médicas con IA (baja frecuencia, frecuencia media y alta frecuencia). Para una comparación justa, todos los enfoques se alimentaron con el mismo flujo de entrada y ejecutaron todo el procedimiento de rastreo.
Figura 7 compara la eficiencia del rastreo de responsabilidad entre diferentes métodos a distintas frecuencias de toma de decisiones en inteligencia artificial médica. Los resultados corresponden a los métodos considerados de izquierda a derecha: las líneas están etiquetadas como decisiones de baja frecuencia, frecuencia media y alta frecuencia en IA médica.
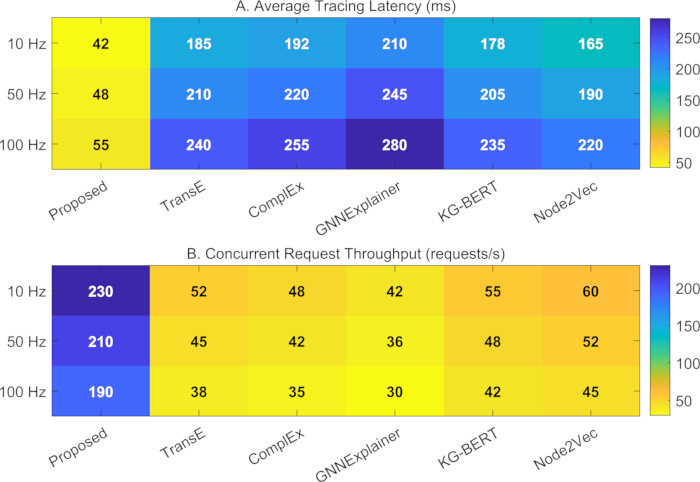
Figura 7: Latencia promedio del rastreo de origen y rendimiento del procesamiento de solicitudes concurrentes. (A) Latencia de rastreo promedio (ms) por método; (B) Rendimiento (solicitudes/segundo) por método. Las líneas conectan los valores medios de 30 ejecuciones; las barras de error (si se muestran) representan la desviación estándar. El método propuesto mantiene la latencia más baja (42‑55 ms) y el rendimiento más alto (190‑230 solicitudes/s) en todas las frecuencias, lo que demuestra un desempeño superior en tiempo real. Haga clic aquí para ver una versión más grande de esta figura.
En cuanto a la latencia promedio de rastreo, lo mejor para el método propuesto también es válido bajo todas las condiciones de frecuencia; además, todos los demás métodos presentan una latencia significativamente mayor que la nuestra. Todos los métodos tienen una latencia de rastreo que generalmente aumenta con la frecuencia de decisión, pero el crecimiento en nuestro caso es suave: 42 milisegundos en baja frecuencia y 55 milisegundos en alta frecuencia. Esta superioridad se beneficia del hecho de que este método se basa en una red convolucional gráfica relacional consciente, que asigna diferentes matrices de pesos a diferentes tipos de relaciones semánticas legales para evitar la sobrecarga computacional derivada del uso compartido de parámetros generales bajo alta concurrencia en los enfoques clásicos. En contraste, TransE y ComplEx, que se basan en la descomposición tensorial, se degradan drásticamente a altas frecuencias. No pueden tratar eficientemente la transformación no lineal de la interacción a larga distancia entre relaciones legales-técnicas, lo que resulta en una latencia mayor. En cuanto al tiempo por pares de solicitudes, el método de este artículo también es superior. En condiciones de baja frecuencia, su rendimiento es de 230 solicitudes/segundo, muy por encima de los otros enfoques. A medida que aumenta la frecuencia, el rendimiento disminuye, pero la reducción es controlable incluso en escenarios de alta frecuencia, llegando aún a 190 solicitudes/segundo. Esta robustez se atribuye a la estrategia de incorporación temporal de nodos y al diseño paralelo del camino de retropropagación del gradiente en este enfoque, lo cual puede garantizar la precisión del rastreo por lotes mientras se procesan eficientemente las solicitudes en bloque. Los enfoques generales, al no estar específicamente optimizados, degradan significativamente su rendimiento al enfrentar consultas simultáneas, por lo que no son adecuados para el monitoreo en tiempo real.
Validación de la capacidad de generalización entre dominios de la cobertura de restricciones legales
El procedimiento de evaluación se lleva a cabo desde la perspectiva de la capacidad de dominio cruzado en la modelización de restricciones legales, donde los dos indicadores de cuantificación son la cobertura jurisdiccional y la tasa de detección de conflictos de restricciones. Se diseñaron tres tipos de complejidad interjurisdiccional, a saber, jurisdicción única, jurisdicción bilateral y jurisdicción multilateral, para el experimento. Con el fin de eliminar el sesgo de evaluación introducido por las diferencias arquitectónicas, se repiten todos los métodos competidores 30 veces y se informan los resultados promedio para realizar una comparación justa de la capacidad de generalización.
Como se muestra en la Tabla 3, este enfoque logra consistentemente mejores resultados que todos los métodos básicos en tres complejidades de jurisdicciones legales, y la degradación es más leve. Proporciona una tasa de detección de conflictos casi del 89 % con una cobertura legal del 94 % en un escenario de una sola jurisdicción legal. Cuando se generaliza a jurisdicciones legales multilaterales, aún es capaz de ofrecer una cobertura del 87 % con una tasa de detección de conflictos del 81 %. En contraste, los métodos tradicionales de incrustación (por ejemplo, TransE y Node2Vec) sufren una caída en la cobertura hasta aproximadamente el 60 % en entornos multilaterales, con tasas de detección de conflictos generalmente más bajas, lo que indica que no son adecuados para manejar la heterogeneidad semántica entre jurisdicciones legales. Sin embargo, KG-BERT y GNNExplainer presentan cierta mejora gracias a modelos de lenguaje preentrenados adicionales o módulos de interpretación, pero aún así sufren una degradación notable del rendimiento en situaciones donde las jurisdicciones legales se superponen.
| Método | Configuración jurisdiccional | Cobertura del dominio legal | Tasa de detección de conflictos de restricciones |
| Propuesto | Unilateral | 0,94 ± 0,02 | 0,89 ± 0,03 |
| Bilateral | 0,91 ± 0,03 | 0,85 ± 0,04 | |
| Plurilateral | 0,87 ± 0,04 | 0,81 ± 0,05 | |
| TransE | Unilateral | 0,76 ± 0,05 | 0,52 ± 0,06 |
| Bilateral | 0,68 ± 0,06 | 0,45 ± 0,07 | |
| Plurilateral | 0,61 ± 0,07 | 0,38 ± 0,08 | |
| ComplEx | Unilateral | 0,79 ± 0,04 | 0,55 ± 0,05 |
| Bilateral | 0,72 ± 0,05 | 0,48 ± 0,06 | |
| Plurilateral | 0,65 ± 0,06 | 0,41 ± 0,07 | |
| GNNExplainer | Unilateral | 0,82 ± 0,04 | 0,61 ± 0,05 |
| Bilateral | 0,75 ± 0,05 | 0,54 ± 0,06 | |
| Plurilateral | 0,68 ± 0,06 | 0,47 ± 0,07 | |
| KG-BERT | Unilateral | 0,80 ± 0,04 | 0,58 ± 0,05 |
| Bilateral | 0,73 ± 0,05 | 0,51 ± 0,06 | |
| Plurilateral | 0,66 ± 0,06 | 0,44 ± 0,07 | |
| Node2Vec | Unilateral | 0,74 ± 0,05 | 0,49 ± 0,06 |
| Bilateral | 0,66 ± 0,06 | 0,42 ± 0,07 | |
| Plurilateral | 0,59 ± 0,07 | 0,36 ± 0,08 |
Tabla 3: Cobertura jurisdiccional y tasa de detección de conflictos de restricciones. Resultados de generalización cruzada entre dominios bajo jurisdicciones legales únicas, bilaterales y multilaterales. La cobertura jurisdiccional (Ec. 18) y la tasa de detección de conflictos de restricciones (Ec. 19) se presentan como media ±± DE obtenida de 30 ejecuciones. El método propuesto mantiene una cobertura alta (≥87 %) y una detección alta (≥81 %) incluso en el escenario multilateral más complejo, mientras que los métodos de referencia se degradan considerablemente.
Esta discrepancia surge de procesos de modelado subyacentes completamente distintos. Los enfoques existentes de incrustación de grafos de conocimiento (por ejemplo, TransE, ComplEx) aprovechan relaciones geométricas en un espacio vectorial estático para la modelización y nunca diferencian semánticas legales binarias como «prohibición» y «permiso», lo que les impide manejar regulaciones matizadas del mismo acto médico en diferentes sistemas jurídicos. Aunque KG-BERT puede capturar el contexto textual, carece de capacidad explícita de razonamiento estructural y tiene dificultades para razonar con dependencias normativas y restricciones contradictorias entre cláusulas. En cambio, el modelo propuesto construye un grafo heterogéneo dirigido mediante la ampliación de cuatro tipos de aristas semánticas legales («violación», «base», «activación» y «atribución») e integra una convolución de grafo sensible a relaciones con retropropagación del gradiente. Como resultado, el modelo propuesto no solo mantiene la direccionalidad causal de la lógica jurídica, sino que también alinea dinámicamente cláusulas semánticamente paralelas y detecta reglas contradictorias en entradas multifuente del dominio legal. Por lo tanto, en escenarios complejos con conflictos frecuentes de obligaciones, responsabilidades superpuestas o prioridades inciertas para la aplicación dentro de un sistema jurídico multilateral, la metodología ofrece una forma de identificar con precisión las fuentes de contradicción de manera estructurada y traducirlas en inferencias interdominio con alta cobertura y exactitud.
Estudio de ablación
Para aislar la contribución de cada componente principal, realizamos un estudio de ablación eliminando o reemplazando módulos clave dentro de nuestro marco en el entorno de grafo denso (D = 1.0). Específicamente, comparamos el modelo completo frente a tres variantes: (1) sin convolución sensible a relaciones, donde todos los tipos de aristas comparten una única matriz de transformación; (2) sin mecanismo de atención, donde las contribuciones de los vecinos se promedian uniformemente; y (3) sin retroceso de gradiente, donde las fuentes de sesgo se identifican mediante una heurística simple basada en el grado del nodo en lugar de la reconstrucción de subgrafos basada en gradientes.
Tabla 4 presenta los resultados de ablación, que revelan contribuciones distintas de cada componente. La eliminación de la convolución sensible a las relaciones provocó la caída más sustancial en el rendimiento, con un descenso en la recuperación de raíces de 0,95 a 0,81 y en la precisión de trayectorias de 0,93 a 0,78. Esto confirma que la modelización de aristas específica por tipo es fundamental para capturar la diversidad semántica de las relaciones jurídicas, ya que compartir una única matriz de transformación entre todos los tipos de relación provoca una pérdida considerable de información durante la alineación multimodal. El mecanismo de atención también contribuye de forma notable; su eliminación reduce la recuperación de raíces a 0,88 y la precisión de trayectorias a 0,85, lo que indica que la ponderación dinámica de los mensajes de los vecinos mejora la capacidad del modelo para distinguir trayectorias jurídicas influyentes, aunque su impacto es secundario frente a la sensibilidad a las relaciones. La eliminación del seguimiento de gradientes produjo la menor disminución en la recuperación (0,91) pero la mayor caída en la precisión de trayectorias (0,76), lo que sugiere que, aunque heurísticas simples pueden identificar parcialmente los nodos fuente, la reconstrucción precisa de la estructura de propagación depende en gran medida del análisis de sensibilidad basado en gradientes. En conjunto, los tres componentes contribuyen de manera significativa al rendimiento del marco en la localización de sesgos, siendo la convolución sensible a las relaciones la más esencial y el seguimiento de gradientes indispensable para la precisión a nivel de trayectoria.
| Variante del modelo | Recuperación de raíz | Precisión de ruta |
| Modelo completo | 0.95 ± 0.02 | 0.93 ± 0.03 |
| sin convolución sensible a relaciones | 0.81 ± 0.03 | 0.78 ± 0.04 |
| sin mecanismo de atención | 0.88 ± 0.02 | 0.85 ± 0.03 |
| sin retroceso de gradiente | 0.91 ± 0.03 | 0.76 ± 0.05 |
Tabla 4: Resultados del estudio de ablación en grafo denso (D = 1.0). Efecto de eliminar componentes clave: (sin convolución consciente de relaciones), (sin mecanismo de atención) y (sin retroceso de gradiente). Las métricas (recuperación de raíz y precisión de trayectoria) corresponden a la media ±± DE de 30 ejecuciones. El modelo completo presenta el mejor desempeño, lo que confirma que cada componente contribuye de manera significativa, siendo la convolución consciente de relaciones la más crítica.
DISPONIBILIDAD DE LOS DATOS:
El conjunto de datos del grafo de conocimiento heterogéneo estructurado generado y analizado durante este estudio, que incluye todos los datos de nodos y aristas (285 nodos distribuidos en cuatro tipos de entidades y 1.247 aristas dirigidas con cuatro relaciones semánticas permitidas), ha sido depositado en el repositorio Figshare bajo el DOI: https://doi.org/10.6084/m9.figshare.33117644. Los datos están disponibles públicamente a partir de la fecha de publicación de este artículo. Los archivos correspondientes al conjunto de datos también se proporcionan como Archivo Suplementario 1.
Archivo suplementario 1: Archivos de conjunto de datos utilizados en este estudio.Haga clic aquí para descargar este archivo.
Discusión
La integración de la inteligencia artificial médica en las decisiones clínicas plantea desafíos legales respecto a la atribución de responsabilidades, dificultada por la brecha semántica entre textos legales no estructurados y algoritmos de caja negra. Para abordar esto, propusimos un grafo de conocimiento basado en GNN que modela cláusulas legales, comportamientos médicos, módulos de algoritmos y partes responsables como nodos heterogéneos, conectados mediante cuatro relaciones legales y semánticas dirigidas (violación, base, desencadenante, atribución). Esta estructura proporciona una interfaz computable para la alineación cruzada de modalidades y el rastreo de sesgos.
Nuestro método logra un rendimiento superior en todas las métricas. Bajo diversas densidades de grafos, la precisión en la alineación de entidades (≥0,92) y la preservación de relaciones (≥0,88) superan a TransE, ComplEx y KG‑BERT. La localización de sesgos obtiene una recuperación de raíces (0,95 ±± 0,02) y una precisión de trayectorias (0,93 ±± 0,03), superando significativamente a GNNExplainer. La monitorización dinámica mantiene una baja latencia (42–55 ms) y un alto rendimiento (190–230 solicitudes/s), mientras que las pruebas entre jurisdicciones muestran una cobertura robusta (≥87 %) y detección de conflictos (≥81 %). Estos resultados confirman un puente efectivo entre las semánticas legal y técnica con rastreo interpretable de sesgos.
Tres innovaciones sustentan nuestro éxito: (1) las aristas legales y semánticas tipificadas capturan distinciones causales y normativas que a menudo pasan desapercibidas para los embeddings uniformes20,21; (2) la convolución sensible a relaciones, con matrices de transformación dedicadas para cada tipo de relación, preserva la especificidad semántica al tiempo que permite el intercambio entre tipos38,39; y (3) la cuantificación del aporte basada en gradientes y la agrupación guiada por comunidades transforman el sesgo global en identificación local de fuentes, superando las limitaciones de los métodos explicativos post hoc32,33. Esto traslada el cumplimiento normativo desde la verificación estática de reglas hacia un razonamiento dinámico y consciente de la estructura.
Las limitaciones incluyen la dependencia de la extracción de relaciones definidas manualmente y la dificultad con cláusulas vagas. Los trabajos futuros integrarán formalismos de lógica jurídica (por ejemplo, lógica derrotable26,27) y aprendizaje en línea para regulaciones en evolución, y se extenderán a otros dominios de alto riesgo (conducción autónoma, finanzas). La retroalimentación con participación del usuario perfeccionará aún más la atribución. Estas líneas de trabajo consolidarán la inteligencia artificial basada en grafos y explicativa como fundamento para sistemas inteligentes confiables.
Divulgaciones
El manuscrito no ha sido publicado previamente ni está siendo considerado por ninguna otra revista. Todos los autores han aprobado el contenido del artículo. Los autores declaran que no tienen conflictos de intereses financieros.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| ComplEx | Implementación de código abierto (por ejemplo, OpenKE) | Version 1.0 | Referencia de incrustación compleja para comparación de grafos de conocimiento |
| GNNExplainer | Implementación de código abierto (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Referencia de interpretabilidad de GNN para rastreo de sesgos |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Procesador central para entrenamiento de modelos y preprocesamiento de datos |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Referencia de incrustación de KG basada en transformadores para alineación semántica |
| Node2Vec | Implementación de código abierto (https://github.com/aditya-grover/node2vec) | Version 1.0 | Referencia de incrustación de nodos basada en caminatas aleatorias |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | GPU de alto rendimiento que acelera el entrenamiento de redes neuronales gráficas |
| Nuestro (GCN con conciencia de relación) | Implementación personalizada en PyTorch | PyTorch 1.12.0 | Marco propuesto con transformaciones por relación, atención y retrotrazado de gradientes |
| TransE | Implementación de código abierto (por ejemplo, OpenKE) | Version 1.0 | Referencia de incrustación translacional para comparación de grafos de conocimiento |
Referencias
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.