Este protocolo longitudinal combina evaluaciones repetidas de la Escala de Dependencia de Cuidados con modelado de mezcla de crecimiento para identificar trayectorias distintas de dependencia de enfermería tras un infarto agudo de miocardio y evaluar los factores demográficos, clínicos y psicosociales asociados con la pertenencia a clases de trayectoria.
Artículo de investigación
Clases latentes de trayectorias de dependencia de enfermería y factores asociados en pacientes con infarto agudo de miocardio
* These authors contributed equally
En este artículo
Resumen
Resumen
Este estudio tuvo como objetivo identificar clases latentes de trayectorias de dependencia en enfermería en pacientes con infarto agudo de miocardio (IAM) y examinar los factores asociados con la pertenencia a cada clase de trayectoria. Este estudio observacional longitudinal de un solo centro incluyó a 260 pacientes con IAM admitidos en el Hospital Popular del Condado de Linquan entre enero de 2024 y enero de 2026. Se definió como punto basal del estudio el momento posterior al tratamiento de emergencia exitoso y recuperación de la conciencia. La dependencia en enfermería se evaluó mediante la Escala de Dependencia en Cuidados (CDS) en el momento basal (T1), el día 3 después del ingreso (T2), al momento del alta (T3) y un mes después del alta (T4). Se utilizó un modelo de mezcla de crecimiento para identificar clases distintas de trayectorias longitudinales. Posteriormente, se evaluaron las características clínicas y psicosociales mediante regresión logística multinomial para identificar factores asociados de forma independiente con la pertenencia a cada clase de trayectoria. Se identificaron cuatro trayectorias distintas de dependencia en enfermería: tipo de alta independencia-mejoría lenta (C1, n = 66, 25,4%), tipo de dependencia moderada-deterioro rápido (C2, n = 54, 20,8%), tipo de alta dependencia-mejoría significativa (C3, n = 90, 34,6%) y tipo de alta dependencia-agravamiento lento (C4, n = 50, 19,2%). La edad, el estado civil, los síntomas depresivos y de ansiedad, el apoyo social y el antecedente de enfermedades subyacentes mostraron asociaciones específicas e independientes según la clase con la pertenencia a la trayectoria. La dependencia en enfermería mostró una heterogeneidad sustancial entre individuos en pacientes con IAM, identificándose cuatro trayectorias longitudinales distintas. Los factores asociados con la pertenencia a cada clase de trayectoria podrían ayudar a identificar a los pacientes que requieren una evaluación de enfermería más estrecha y un seguimiento individualizado; sin embargo, la eficacia de las intervenciones dirigidas a estos factores requiere una evaluación prospectiva.
Introducción
El infarto agudo de miocardio (IAM) es comúnmente causado por la oclusión repentina de una arteria coronaria, lo que resulta en una reducción marcada o interrupción del flujo sanguíneo miocárdico y en la subsiguiente necrosis miocárdica. El IAM sigue siendo una afección cardiovascular grave y potencialmente mortal, ya que la disfunción miocárdica y las complicaciones agudas pueden afectar sustancialmente los resultados a corto y largo plazo1. Las estrategias de reperfusión, incluyendo la intervención coronaria percutánea y la terapia trombolítica, pueden restablecer el flujo sanguíneo coronario y han mejorado considerablemente el manejo agudo del IAM. Sin embargo, incluso después de un tratamiento agudo exitoso, algunos pacientes continúan experimentando limitaciones en el autocuidado y en las actividades de la vida diaria, y en consecuencia requieren distintos niveles de apoyo de enfermería2.
La dependencia de enfermería puede afectar la calidad de vida de los pacientes, la participación social, la recuperación funcional y el proceso general de rehabilitación3. La investigación previa sobre IAM se ha centrado principalmente en estrategias diagnósticas y terapéuticas, prevención y manejo de complicaciones, y factores pronósticos. Investigaciones transversales previas en pacientes con enfermedad coronaria después de una intervención coronaria percutánea han identificado la fragilidad, la autoeficacia y el estado psicológico como factores asociados con la dependencia de cuidados; sin embargo, una evaluación en un solo momento no puede caracterizar los cambios intra-pacientes en la dependencia ni distinguir patrones heterogéneos de recuperación a lo largo del tiempo4. Al evaluar repetidamente la dependencia de enfermería en cuatro momentos y aplicar un modelo de mezcla de crecimiento, el presente estudio amplía los análisis estáticos previos al identificar subgrupos latentes de pacientes con trayectorias longitudinales distintas. La identificación de estos patrones heterogéneos puede ayudar a los clínicos a reconocer pacientes con perfiles de rehabilitación diferentes y proporcionar una base para la evaluación individualizada de enfermería, el seguimiento y la atención de apoyo.
Por consiguiente, este estudio tuvo como objetivo identificar clases longitudinales distintas de dependencia de enfermería desde la línea base posterior al tratamiento de emergencia hasta un mes después del alta en pacientes con IAM, y examinar los factores demográficos, clínicos y psicosociales asociados con la pertenencia a las clases de trayectoria. Dado el carácter exploratorio del estudio, no se establecieron hipótesis direccionales previas respecto a clases específicas de trayectoria.
Protocolo
El estudio se realizó en el Departamento de Medicina de Emergencias del Hospital Popular del Condado de Linquan, Fuyang, Anhui, China. El protocolo del estudio fue revisado y aprobado por el Comité de Ética del Hospital Popular del Condado de Linquan (número de aprobación: 24XNLC-HL1015). Se obtuvo el consentimiento informado por escrito de todos los participantes antes de su inclusión. Todos los procedimientos que involucraron a participantes humanos se llevaron a cabo de acuerdo con los requisitos éticos institucionales y los principios éticos aplicables.
Configuración del estudio e identificación de los participantes
El estudio se realizó como una investigación observacional longitudinal monocéntrica en el Departamento de Medicina de Emergencias del Hospital Popular del Condado de Linquan, Fuyang, Anhui, China. Los participantes fueron reclutados entre enero de 2024 y enero de 2026 y se les hizo seguimiento desde la línea base posterior al tratamiento de emergencia hasta 1 mes después del alta.
Se utilizó muestreo por conveniencia para identificar pacientes elegibles ingresados con infarto agudo de miocardio (AMI). Se aplicaron los mismos criterios de elegibilidad y procedimientos de selección a todos los participantes potenciales. Dado que el muestreo por conveniencia puede introducir sesgo de selección, esta posible fuente de sesgo se tuvo en cuenta al interpretar la generalización de los hallazgos.
Se evaluaron un total de 287 pacientes, de los cuales 27 no fueron incluidos. Ocho pacientes habían sufrido un infarto de miocardio previo, seis no pudieron completar las evaluaciones del estudio debido a alteraciones en la conciencia o función cognitiva, cinco tenían otras enfermedades cardíacas orgánicas, cuatro presentaban tumores malignos, fallo multivisceral u otras enfermedades sistémicas graves, y cuatro rechazaron participar. Los 260 pacientes restantes fueron incluidos en el estudio.
Criterios de elegibilidad y definición de la línea base
Se incluyeron a los pacientes si tenían un diagnóstico clínico establecido de IAM, estaban experimentando su primer episodio de infarto de miocardio, tenían una edad ≥18 años, tenían conciencia y función cognitiva intactas suficientes para comprender y completar las evaluaciones del estudio, y proporcionaron consentimiento informado por escrito. Se excluyeron a los pacientes con otras enfermedades cardíacas orgánicas, tumores malignos, insuficiencia múltiple de órganos u otras enfermedades sistémicas orgánicas graves.
La inclusión se limitó a pacientes con infarto de miocardio de primer episodio para reducir la heterogeneidad asociada con infartos previos, revascularizaciones anteriores, deterioro funcional crónico post-infarto y adaptaciones preexistentes en el autocuidado o la rehabilitación, todos los cuales podrían influir independientemente en la dependencia de enfermería basal y en los patrones subsiguientes de evolución.
T1 se definió como el punto temporal posterior al tratamiento de emergencia exitoso y recuperación de la conciencia, cuando el participante fue capaz de completar las evaluaciones requeridas de manera confiable.
Recolección de datos demográficos y clínicos relacionados con enfermedades cardiovasculares
Se utilizó un cuestionario específico del estudio para recopilar información general sobre edad, sexo, índice de masa corporal (IMC), estado civil, clasificación de la función cardíaca, tipo de infarto de miocardio, estrategia de tratamiento de reperfusión e historial de enfermedades subyacentes. La información demográfica y psicosocial se obtuvo mediante evaluación del cuestionario y revisión de los registros médicos, según correspondiera. Las características clínicas relacionadas con enfermedades cardiovasculares, incluyendo la clasificación de la función cardíaca, el tipo de infarto de miocardio, la estrategia de reperfusión y el historial de enfermedades subyacentes, se extrajeron de los registros médicos correspondientes a la hospitalización índice utilizando definiciones preestablecidas. La clasificación de la función cardíaca se extrajo del registro médico de la hospitalización índice y se agrupó como Clase I-II o Clase III-IV para el análisis. El tipo de infarto de miocardio se clasificó como infarto de miocardio con elevación del segmento ST (STEMI) o infarto de miocardio sin elevación del segmento ST (NSTEMI), según el diagnóstico registrado durante la hospitalización índice. El historial de enfermedades subyacentes se codificó de forma dicotómica como no (0) o sí (1), donde «sí» indicaba que al menos una condición crónica comórbida predefinida estaba documentada en el historial médico.
La intervención coronaria percutánea (PCI) y la terapia trombolítica se registraron según el tratamiento realmente recibido durante la hospitalización índice, y no según el plan de tratamiento previsto. Los valores continuos originales de edad e IMC se mantuvieron para el análisis estadístico.
Evaluación repetida de la dependencia de enfermería
Se aplicó la Escala de Dependencia de Cuidados (CDS5) en T1. La escala contiene 15 ítems. Cada ítem se calificó de 1 (totalmente dependiente) a 5 (casi independiente), lo que arroja una puntuación total comprendida entre 15 y 75. Puntuaciones más altas indicaron mayor independencia y menor dependencia de enfermería. Según la clasificación establecida de la CDS, las puntuaciones de 60 a 69 indican un grado limitado de dependencia de cuidados, mientras que las puntuaciones de 70 a 75 indican una independencia casi total; por lo tanto, en el presente estudio se consideró que una puntuación total en la CDS <70 indicaba dependencia de enfermería4,5.
La evaluación del CDS se repitió el día 3 después del ingreso (T2), al momento del alta (T3) y un mes después del alta (T4). Se utilizaron las mismas instrucciones, orden de los ítems, reglas de puntuación y procedimientos de asistencia en todas las evaluaciones para minimizar la inconsistencia en la medición. La evaluación en T4 se realizó durante la consulta de seguimiento programada a un mes del alta, ya sea en persona en la clínica ambulatoria o por teléfono cuando no era factible una visita presencial. En ambos casos, un miembro capacitado del equipo de investigación administró todos los ítems del CDS utilizando las mismas instrucciones estandarizadas, orden de los ítems y criterios de puntuación.
Todos los 260 participantes inscritos completaron el CDS en los cuatro momentos temporales, y ningún participante se perdió durante el seguimiento en el período de observación de 1 mes.
Evaluación psicosocial inicial
Se aplicó una vez la Escala de Evaluación de la Depresión de Hamilton de 17 ítems (HAMD-17)6 en T1. Los ítems 1–3, 7–11, 15 y 17 se puntuaron de 0 a 4, mientras que los ítems 4–6, 12–14 y 16 se puntuaron de 0 a 2. Las puntuaciones de los ítems se sumaron para obtener una puntuación total que oscila entre 0 y 54, siendo las puntuaciones más altas indicativas de síntomas depresivos más graves.
Se aplicó el Trastorno de Ansiedad Generalizada-7 (GAD-7)7 una vez en T1. Cada uno de los siete ítems se puntuó de 0 (nada de eso) a 3 (casi todos los días), lo que dio como resultado una puntuación total comprendida entre 0 y 21. Las puntuaciones más altas indicaban síntomas de ansiedad más graves.
Se aplicó una vez la Escala de Calificación del Apoyo Social (SSRS)8 en T1. La escala constaba de 10 ítems. Los ítems 1–4 y 8–10 se calificaron en una escala de 4 puntos, del 1 al 4; el ítem 5 se puntuó del 1 al 4 según el nivel de apoyo declarado; y los ítems 6 y 7 se puntuaron según el número de fuentes de apoyo disponibles. La puntuación total oscilaba entre 12 y 66, siendo las puntuaciones más altas indicativas de un mayor apoyo social.
Todas las evaluaciones del CDS y de índole psicosocial fueron administradas o supervisadas por miembros capacitados del equipo de investigación. Antes del reclutamiento de los participantes, los evaluadores recibieron una formación estandarizada sobre la administración de cuestionarios, interpretación de ítems, asistencia permitida y procedimientos de puntuación. Se utilizaron las mismas instrucciones estandarizadas, orden de los ítems y criterios de puntuación durante todo el estudio. No se requirió que el mismo evaluador examinara a un participante determinado en todos los momentos evaluados; la coherencia entre evaluadores se mantuvo mediante la formación estandarizada y los procedimientos uniformes de evaluación. Se solicitó a los participantes que completaran los cuestionarios de forma independiente siempre que fuera posible. Cuando los participantes tuvieran dificultades con la lectura, comprensión o escritura, se ofreció asistencia individual estandarizada sin sugerir respuestas, interpretar los ítems en nombre del participante ni alterar sus respuestas.
Control de calidad de los datos y manejo de datos faltantes
Antes de la administración del cuestionario, se informó a los participantes sobre el propósito del estudio, los procedimientos de cumplimentación y los requisitos de confidencialidad. Se utilizaron instrucciones estandarizadas y procedimientos de evaluación idénticos para todos los participantes. Los cuestionarios cumplimentados se revisaron inmediatamente en busca de ítems omitidos o respuestas claramente inválidas. Cuando un ítem quedaba sin responder, se pedía al participante que revisara el ítem omitido y, si estaba dispuesto, que proporcionara una respuesta. Cuando se requería ayuda para cumplimentar el cuestionario, el personal del estudio no sugería, interpretaba ni proporcionaba respuestas en nombre del participante. Las variables clínicas se extrajeron utilizando definiciones preestablecidas, y los formularios cumplimentados se verificaron antes de la introducción de datos.
Los 260 participantes completaron las evaluaciones del CDS en T1-T4, sin ninguna pérdida en el seguimiento. Los datos longitudinales del CDS y las variables demográficas, clínicas y psicosociales incluidas en los análisis reportados estuvieron completos. Por lo tanto, los 260 participantes fueron incluidos en los análisis, y no se requirió imputación de datos.
Modelado de mezcla de crecimiento de puntuaciones CDS longitudinales
Se realizó un modelado de mezcla de crecimiento (GMM) utilizando la versión 8.3 de Mplus. Se ajustó un GMM incondicional sin covariables, con CDS_T1, CDS_T2, CDS_T3 y CDS_T4 incluidos como variables manifiestas continuas.
Se ajustaron secuencialmente soluciones de una a cinco clases utilizando estimación robusta de máxima verosimilitud (MLR). Para reducir el riesgo de convergencia hacia un máximo local, se generaron 1.000 conjuntos aleatorios de valores iniciales, y se conservaron los mejores 200 para la optimización en la etapa final. Para cada solución, se confirmó la finalización normal, la replicación del mejor logaritmo de verosimilitud a través de arranques aleatorios y la ausencia de estimaciones de parámetros inadmisibles.
Se registraron el Criterio de Información de Akaike (AIC), el Criterio de Información Bayesiano (BIC), el BIC ajustado por tamaño de muestra (aBIC), la entropía, la prueba de razón de verosimilitud ajustada de Lo-Mendell-Rubin (LMR-LRT) y la prueba de razón de verosimilitud con arranque (BLRT) para cada solución. Se interpretó que valores más bajos de AIC, BIC y aBIC indicaban un ajuste de modelo relativo mejor, mientras que valores de entropía más cercanos a 1 indicaban una separación de clases más clara.
Cada solución de k clases se comparó con la solución correspondiente de k − 1 clases utilizando la prueba de razón de verosimilitud de Lo-Mendell-Rubin (LMR-LRT) y la prueba de razón de verosimilitud de arranque (BLRT). El modelo final no se seleccionó únicamente con base en la disminución de los criterios de información; también se consideraron la estabilidad de la convergencia, el tamaño de las clases, las probabilidades posteriores de pertenencia, la parsimonia y la interpretabilidad clínica. A cada participante se le asignó la clase con la probabilidad posterior más alta de pertenencia, y se calcularon las probabilidades posteriores promedio específicas de cada clase como una medida adicional de la calidad de la clasificación.
Análisis de mediciones repetidas de CDS
Para evaluar los cambios intra-participantes en las puntuaciones de CDS a lo largo de T1, T2, T3 y T4 en la cohorte general, se realizó un análisis de varianza unifactorial con medidas repetidas (RM-ANOVA) utilizando el momento de la evaluación como factor intra-sujetos. Se evaluaron los supuestos de normalidad aproximada y esfericidad. La esfericidad se analizó mediante la prueba de Mauchly, y se utilizaron los resultados corregidos mediante Greenhouse–Geisser cuando se violó el supuesto de esfericidad. Todas las pruebas fueron bilaterales, y se consideró estadísticamente significativo un valor de P < 0,05.
Comparaciones univariantes entre clases de trayectoria
Los análisis distintos de GMM se realizaron utilizando IBM SPSS Statistics versión 26.0. La edad, el IMC, los puntajes de HAMD-17, SSRS y GAD-7 se analizaron como variables continuas sin categorización.
Las variables continuas con distribución aproximadamente normal se expresaron como media ± desviación estándar y se compararon entre las cuatro clases de trayectoria mediante análisis de varianza de un factor. Las variables categóricas se expresaron como conteos de participantes y se compararon utilizando la prueba chi-cuadrado de Pearson. Todos los valores de P fueron bilaterales, y se utilizó P < 0,05 como umbral para identificar las variables que se incluirían en el modelo multivariable inicial.
En el análisis univariado, la edad, el estado civil, la clasificación de la función cardíaca, el tipo de infarto de miocardio, la PCI, la terapia trombolítica, la puntuación del HAMD-17, la puntuación del SSRS, la puntuación del GAD-7 y la historia de enfermedades subyacentes cumplieron con el criterio de P < 0,05 y, por lo tanto, se incluyeron en el modelo multivariable inicial. El sexo y el IMC no cumplieron con este criterio.
Regresión logística multinomial y diagnósticos del modelo
Las cuatro clases de trayectoria se consideraron un resultado nominal, y se realizó una regresión logística multinomial en lugar de una regresión logística binaria. Se designó a C1 (Alta Independencia-Mejora Lenta) como la categoría de resultado de referencia.
Todas las variables con P < 0,05 en los análisis univariantes se incluyeron en el modelo inicial. Luego se aplicó una selección hacia atrás por razón de verosimilitud, eliminando secuencialmente las variables con P > 0,10. Los efectos principales estadísticamente significativos se mantuvieron en el modelo final.
Se evaluó la multicolinealidad utilizando los valores de tolerancia y del factor de inflación de la varianza (VIF). En el análisis final, los valores de tolerancia oscilaron aproximadamente entre 0,81 y 0,97, y los valores de VIF entre 1,03 y 1,24, lo que indica ausencia de multicolinealidad sustancial.
La prueba de interacciones se limitó a términos clínicamente plausibles preespecificados para reducir el riesgo de sobreajuste. Se evaluaron individualmente tres interacciones preespecificadas—edad × antecedente de enfermedades subyacentes, estado civil × puntuación SSRS y puntuación HAMD-17 × puntuación GAD-7—mediante pruebas de razón de verosimilitud. Los valores de P correspondientes fueron 0,655, 0,301 y 0,908, respectivamente; por lo tanto, no se mantuvo ninguna de las interacciones.
El rendimiento general del modelo se evaluó utilizando la prueba de razón de verosimilitud frente al modelo con solo intercepto; pruebas de bondad de ajuste de Pearson y de desviación; estadísticas pseudo-R2 de Cox-Snell, Nagelkerke y McFadden; precisión de clasificación; convergencia; y evaluación de separación completa o cuasi-completa.
Se informaron las razones de momios ajustadas (OR) con intervalos de confianza del 95 % (IC) para todos los predictores finales en las comparaciones de C2 frente a C1, C3 frente a C1 y C4 frente a C1. Los IC amplios se interpretaron como indicadores de una precisión limitada, más que como evidencia definitiva de tamaños del efecto grandes.
Consideraciones y presentación del tamaño de la muestra
No se aplicó un umbral universal único de tamaño de muestra al GMM. La adecuación de la muestra se consideró en relación con la complejidad del modelo, las proporciones de las clases, la separación entre clases, los patrones de datos faltantes, la entropía, las probabilidades a posteriori y la convergencia9.
No se realizó un cálculo formal de potencia basado en simulaciones a priori porque el estudio fue una investigación longitudinal exploratoria basada en la población elegible disponible durante el período predeterminado de reclutamiento. La solución final de cuatro clases incluyó 66, 54, 90 y 50 participantes y produjo un valor de entropía de 0,879, con probabilidades posteriores promedio que oscilaron entre 0,871 y 0,927.
Para la regresión logística multinomial, se evaluó la adecuación de la muestra en función del número de participantes en cada categoría de resultado y del número de parámetros predictores candidatos10. Dado que algunas clases de trayectoria eran relativamente pequeñas, el análisis de regresión se interpretó como un análisis exploratorio de asociación más que como el desarrollo de un modelo de predicción definitivo.
El estudio observacional se informó de acuerdo con el marco de Fortalecimiento de la Presentación de Estudios Observacionales en Epidemiología (STROBE), incluyendo el diseño del estudio, el entorno, el flujo de participantes, las fuentes de datos, las posibles fuentes de sesgo, el tamaño del estudio, los métodos estadísticos, el manejo de datos faltantes, los resultados principales, las limitaciones y la generalizabilidad.
Resultados
Flujo de participantes y completitud
Durante el período de reclutamiento, se evaluó la elegibilidad de 287 pacientes con IAM. Veintisiete pacientes no fueron incluidos: ocho habían sufrido un infarto de miocardio previo, seis no pudieron completar las evaluaciones del estudio debido a alteración de la conciencia o función cognitiva, cinco presentaban otras cardiopatías orgánicas, cuatro tenían tumores malignos, fallo multivisceral u otras enfermedades sistémicas graves, y cuatro rechazaron participar. Los 260 participantes restantes ingresaron al estudio, completaron las cuatro evaluaciones del CDS durante el mes posterior al alta y fueron incluidos en el análisis final de GMM y en los análisis posteriores. No hubo valores longitudinales del CDS faltantes, ninguna pérdida en el seguimiento ni datos demográficos, clínicos o psicosociales faltantes que requirieran imputación en los análisis reportados.
Selección del GMM de cuatro clases
Los índices de ajuste mejoraron progresivamente desde la solución de una clase hasta la solución de cuatro clases (Tabla 1). La solución de cuatro clases arrojó AIC = 6978.826, BIC = 7047.822, aBIC = 6978.741, entropía = 0.879, LMR-LRT P = 0.027 y BLRT P < 0.001. Las proporciones estimadas por el modelo para cada clase fueron 25,8 %, 21,0 %, 34,1 % y 19,1 %. Cuando se añadió una quinta clase, el AIC, el BIC y el aBIC disminuyeron ligeramente a 6963.213, 7038.208 y 6962.613, respectivamente, y la entropía aumentó a 0.912. Sin embargo, ni el LMR-LRT (P = 0.128) ni el BLRT (P = 0.063) indicaron una mejora estadísticamente significativa. Además, la quinta clase representaba solo el 6,4 % de la muestra. Por lo tanto, se mantuvo el modelo de cuatro clases porque ofrecía el equilibrio preferido entre bondad de ajuste, estabilidad, parsimonia, tamaño de las clases e interpretación clínica.
Convergencia y calidad de la clasificación
La solución de cuatro clases finalizó normalmente, y el logaritmo de verosimilitud óptimo se replicó 18 veces a través de arranques aleatorios. No se observaron estimaciones de parámetros inadmisibles. Las probabilidades posteriores promedio para la pertenencia más probable a la clase fueron 0,914 para C1, 0,889 para C2, 0,927 para C3 y 0,871 para C4, lo que indica una separación aceptable entre clases.
Dependencia total de enfermería a lo largo del tiempo
Las puntuaciones medias generales del CDS fueron 48,28 ± 10,25 en T1, 54,16 ± 14,33 en T2, 52,82 ± 12,17 en T3 y 56,58 ± 15,15 en T4. Un ANOVA unifactorial de medidas repetidas mostró una diferencia general significativa en las puntuaciones del CDS entre los cuatro momentos de evaluación (F = 13,692, P < 0,001). A nivel grupal, las puntuaciones del CDS aumentaron al día 3, disminuyeron ligeramente al momento del alta y volvieron a aumentar a los 1 mes después del alta. La mayor variabilidad observada en los momentos posteriores sugiere que el patrón medio general enmascara una heterogeneidad considerable entre los participantes.
Patrones de trayectoria
Lo más probable es que la asignación de clases identificara cuatro trayectorias: C1, Alta Independencia-Mejora Lenta (n = 66, 25,4 %); C2, Dependencia Moderada-Deterioro Rápido (n = 54, 20,8 %); C3, Alta Dependencia-Mejora Significativa (n = 90, 34,6 %); y C4, Alta Dependencia-Agravamiento Lento (n = 50, 19,2 %; Figura 1). Las puntuaciones medias del CDS para C1 fueron 55,50, 59,00, 60,00 y 64,00 en T1-T4, respectivamente; las de C2 fueron 50,00, 49,00, 39,00 y 39,00; las de C3 fueron 43,22, 59,35, 61,86 y 70,90; y las de C4 fueron 46,00, 44,00, 42,00 y 40,00.
Comparaciones de clases univariantes
La edad difirió significativamente entre las clases C1–C4 (58,20 ± 7,80, 61,50 ± 7,40, 55,80 ± 7,60 y 63,10 ± 7,20 años, respectivamente; F = 12,572, P < 0,001; Tabla 2). El IMC no presentó diferencias significativas entre las clases (23,60 ± 2,70, 23,40 ± 2,80, 23,80 ± 2,90 y 23,50 ± 2,60 kg/m2, respectivamente; F = 0,270, P = 0,847), y la distribución por sexo también fue similar (χ2 = 0,142, P = 0,986). Se observaron diferencias significativas en cuanto al estado civil (χ2 = 14,749, P = 0,002), la clasificación de la función cardíaca (χ2 = 15,283, P = 0,002), el tipo de infarto de miocardio (χ2 = 15,035, P = 0,002), la ICQ (χ2 = 12,863, P = 0,005), la terapia trombolítica (χ2 = 15,622, P = 0,001) y la historia de enfermedades subyacentes (χ2 = 27,903, P < 0,001).
Las puntuaciones medias del HAMD-17 fueron 10.80 ± 2.70, 13.10 ± 2.90, 11.20 ± 2.60 y 14.10 ± 3.00 en C1–C4, respectivamente (F = 19.040, P < 0.001). Las puntuaciones medias del SSRS fueron 43.00 ± 4.80, 38.50 ± 5.00, 42.00 ± 4.90 y 36.80 ± 5.10, respectivamente (F = 20.742, P < 0.001), y las puntuaciones medias del GAD-7 fueron 9.50 ± 2.50, 12.10 ± 2.80, 10.00 ± 2.60 y 13.70 ± 3.00, respectivamente (F = 30.585, P < 0.001).
Regresión multinomial final
Los predictores candidatos se codificaron como se muestra en Tabla 3. La selección hacia atrás mediante razón de verosimilitud conservó la edad, el estado civil, HAMD-17, SSRS, GAD-7 y la historia de enfermedades subyacentes en el modelo final de regresión logística multinomial (Tabla 4). Para C2 frente a C1, estar casado se asoció con menores probabilidades de pertenecer a C2 (OR ajustada = 0,241, IC del 95% = 0,095–0,612, P = 0,003), mientras que puntuaciones más altas en HAMD-17 (OR = 1,324, IC del 95% = 1,121–1,564), puntuaciones más altas en GAD-7 (OR = 1,374, IC del 95% = 1,160–1,626), puntuaciones más bajas en SSRS (OR = 0,787, IC del 95% = 0,711–0,871) y antecedentes de enfermedades subyacentes (OR = 3,107, IC del 95% = 1,212–7,968) se asociaron con la pertenencia a C2. La edad no fue estadísticamente significativa en esta comparación (P = 0,089). Para C3 frente a C1, la edad fue el único predictor conservado que resultó estadísticamente significativo (OR = 0,954, IC del 95% = 0,912–0,997, P = 0,036).
En comparación con C1, la pertenencia a C4 se asoció con mayor edad (OR = 1.077, IC 95% = 1.005–1.154), estado civil no casado (casado: OR = 0.248, IC 95% = 0.085–0.720), puntuaciones más altas en la HAMD-17 (OR = 1.466, IC 95% = 1.214–1.772), puntuaciones más bajas en la SSRS (OR = 0.727, IC 95% = 0.646–0.819), puntuaciones más altas en la GAD-7 (OR = 1.605, IC 95% = 1.318–1.955) y antecedentes de enfermedades subyacentes (OR = 4.454, IC 95% = 1.511–13.134).
Diagnóstico del modelo
El modelo multinomial final proporcionó una mejora significativa respecto al modelo solo con intercepto (χ2 de razón de verosimilitud = 190,966, gl = 18, P < 0,001). Las pruebas de bondad de ajuste de Pearson (χ2 = 745,020, gl = 759, P = 0,635) y de desviación (χ2 = 515,576, gl = 759, P > 0,999) no indicaron un ajuste deficiente del modelo. Los valores de pseudo-R2 de Cox-Snell, Nagelkerke y McFadden fueron 0,520, 0,557 y 0,270, respectivamente, y la precisión de clasificación fue del 53,1 %. El modelo convergió tras siete iteraciones, sin evidencia de separación completa ni cuasi-completa. Algunas estimaciones para la historia de enfermedades subyacentes presentaron intervalos de confianza del 95 % relativamente amplios, lo que indica una precisión limitada y respalda una interpretación cautelosa de estas asociaciones.
DISPONIBILIDAD DE LOS DATOS:
Los datos brutos que respaldan los hallazgos de este estudio se proporcionan con el artículo como Archivo Suplementario 1.
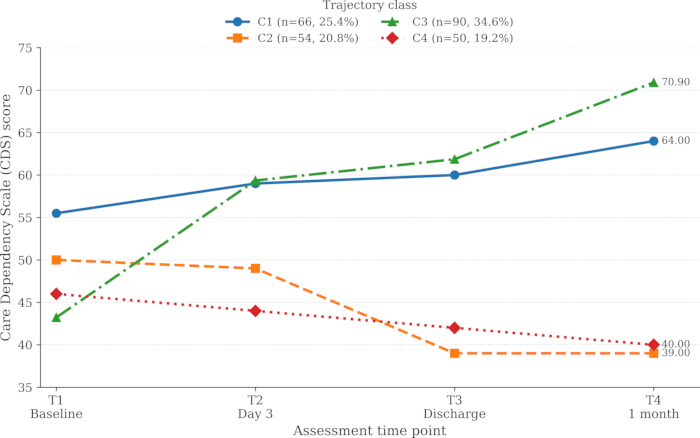
Figura 1: Trayectorias longitudinales de la dependencia de enfermería en pacientes con infarto agudo de miocardio. Las cuatro clases de trayectoria latente identificadas mediante el modelado de mezcla de crecimiento (GMM) fueron Alta Independencia-Mejora Lenta (C1, n = 66, 25,4%), Dependencia Moderada-Deterioro Rápido (C2, n = 54, 20,8%), Alta Dependencia-Mejora Significativa (C3, n = 90, 34,6%) y Alta Dependencia-Agravamiento Lento (C4, n = 50, 19,2%). T1 representa el momento basal tras el tratamiento de emergencia exitoso y recuperación de la conciencia; T2 representa el día 3 tras el ingreso; T3 representa el alta; y T4 representa 1 mes tras el alta. El eje y representa la puntuación media específica de cada clase en la escala CDS, donde puntuaciones más altas indican mayor independencia y menor dependencia de cuidados de enfermería. Abreviaturas: AMI = infarto agudo de miocardio; CDS = Escala de Dependencia de Cuidados; GMM = modelado de mezcla de crecimiento. Haga clic aquí para ver una versión más grande de esta figura.
| Modelo | AIC | BIC | aBIC | Entropía | Valor p de LMR-LRT | Valor p de BLRT | Proporción de clases (%) |
| 1 | 7353.11 | 7384.108 | 7355.567 | — | — | — | — |
| 2 | 7141.412 | 7184.409 | 7156.355 | 0.726 | 0.002 | <0.001 | 48.2/51.8 |
| 3 | 7032.275 | 7086.271 | 7049.704 | 0.813 | 0.015 | <0.001 | 35.1/42.7/22.2 |
| 4 | 6978.826 | 7047.822 | 6978.741 | 0.879 | 0.027 | <0.001 | 25.8/21.0/34.1/19.1 |
| 5 | 6963.213 | 7038.208 | 6962.613 | 0.912 | 0.128 | 0.063 | 29.7/31.2/20.4/12.3/6.4 |
Tabla 1: Índices de ajuste para modelos de mezcla de crecimiento de una a cinco clases de trayectorias de dependencia de enfermería. Valores más bajos de los criterios de información indican un ajuste de modelo relativo mejor, mientras que valores de entropía más cercanos a 1 indican una separación de clases más clara. La prueba LMR-LRT y la BLRT comparan un modelo de k clases con el modelo correspondiente de k − 1 clases. Las proporciones de clases son proporciones estimadas por el modelo; los conteos finales de participantes y porcentajes se basan en la asignación de clase posterior más probable. Abreviaturas: AIC = Criterio de Información de Akaike; BIC = Criterio de Información Bayesiano; aBIC = Criterio de Información Bayesiano ajustado por tamaño de muestra; LMR-LRT = prueba de razón de verosimilitud ajustada de Lo-Mendell-Rubin; BLRT = prueba de razón de verosimilitud con bootstrap.
| Elemento | Clasificación | Alta independencia-Mejora lenta (C1) (n = 66) | Dependencia moderada-Deterioro rápido (C2) (n = 54) | Alta dependencia-Mejora significativa (C3) (n = 90) | Alta dependencia-Agravamiento lento (C4) (n = 50) | Estadístico | Valor P |
| Edad (años) | − | 58.20 ± 7.80 | 61.50 ± 7.40 | 55.80 ± 7.60 | 63.10 ± 7.20 | 12.572 | <0.001 |
| Sexo | Masculino | 43 | 35 | 58 | 31 | 0.142 | 0.986 |
| Femenino | 23 | 19 | 32 | 19 | |||
| IMC (kg/m²) | — | 23.60 ± 2.70 | 23.40 ± 2.80 | 23.80 ± 2.90 | 23.50 ± 2.60 | 0.27 | 0.847 |
| Estado civil | Casado | 46 | 24 | 64 | 25 | 14.749 | 0.002 |
| Soltero / Divorciado / Viudo | 20 | 30 | 26 | 25 | |||
| Clasificación de la función cardíaca | Clase I–II | 41 | 22 | 60 | 20 | 15.283 | 0.002 |
| Clase III–IV | 25 | 32 | 30 | 30 | |||
| Tipo de infarto de miocardio | Elevación del segmento ST | 50 | 35 | 44 | 37 | 15.035 | 0.002 |
| Sin elevación del segmento ST | 16 | 19 | 46 | 13 | |||
| Intervención coronaria percutánea | Sí | 45 | 38 | 62 | 21 | 12.863 | 0.005 |
| No | 21 | 16 | 28 | 29 | |||
| Terapia trombolítica | Sí | 52 | 49 | 66 | 29 | 15.622 | 0.001 |
| No | 14 | 5 | 24 | 21 | |||
| Puntuación HAMD | − | 10.80 ± 2.70 | 13.10 ± 2.90 | 11.20 ± 2.60 | 14.10 ± 3.00 | 19.04 | <0.001 |
| Puntuación SSRS | − | 43.00 ± 4.80 | 38.50 ± 5.00 | 42.00 ± 4.90 | 36.80 ± 5.10 | 20.742 | <0.001 |
| Puntuación GAD-7 | - | 9.50 ± 2.50 | 12.10 ± 2.80 | 10.00 ± 2.60 | 13.70 ± 3.00 | 30.585 | <0.001 |
| Antecedentes de enfermedades subyacentes | Sí | 20 | 32 | 28 | 34 | 27.903 | <0.001 |
| No | 46 | 22 | 62 | 16 |
Tabla 2: Análisis univariado de las características según las clases de trayectoria de dependencia en enfermería. Las variables continuas se presentan como media ± desviación estándar y se compararon mediante análisis de varianza de un factor. Las variables categóricas se presentan como conteos de participantes y se compararon mediante pruebas chi-cuadrado de Pearson. Todos los valores de P son comparaciones generales bilaterales entre las cuatro clases de trayectoria. Abreviaturas: BMI = índice de masa corporal; HAMD-17 = Escala de Evaluación de la Depresión de Hamilton de 17 ítems; SSRS = Escala de Evaluación del Apoyo Social; GAD-7 = Trastorno de Ansiedad Generalizada-7; PCI = intervención coronaria percutánea.
| Variable | Descripción de la asignación |
| Edad | Introducida como valor original |
| Estado civil | Soltero/Divorciado/Viudo = 0; Casado = 1 |
| Clasificación de la función cardíaca | Clase Ⅰ, Ⅱ = 0; Clase Ⅲ, Ⅳ = 1 |
| Tipo de infarto | Elevación no segmento ST = 0; Elevación segmento ST = 1 |
| Terapia intervencionista | No = 0; Sí = 1 |
| Terapia trombolítica | No = 0; Sí = 1 |
| Puntuación HAMD | Introducida como valor original |
| Puntuación SSRS | Introducida como valor original |
| Puntuación GAD-7 | Introducida como valor original |
| Antecedentes de enfermedades subyacentes | No = 0; Sí = 1 |
Tabla 3: Codificación de los predictores candidatos para la regresión logística multinomial. La edad, HAMD-17, SSRS y GAD-7 se introdujeron utilizando sus valores continuos originales. Para las variables dicotómicas, la categoría codificada como 0 sirvió como categoría de referencia: soltero/divorciado/viudo para el estado civil; función cardíaca Clase I–II; NSTEMI; sin PCI; sin terapia trombolítica; y sin antecedentes de enfermedades subyacentes. Abreviaturas: HAMD-17 = escala de evaluación de la depresión de Hamilton de 17 ítems; SSRS = escala de evaluación del apoyo social; GAD-7 = trastorno de ansiedad generalizada-7; NSTEMI = infarto agudo de miocardio sin elevación del segmento ST; PCI = intervención coronaria percutánea.
| Comparación de grupos | Variable | β | SE | Wald χ² | P | OR ajustada (IC del 95 %) |
| C2 frente a C1 | Edad | 0.052 | 0.03 | 2.885 | 0.089 | 1.053 (0.992–1.118) |
| Casado | −1.422 | 0.475 | 8.951 | 0.003 | 0.241 (0.095–0.612) | |
| HAMD-17 | 0.281 | 0.085 | 10.893 | <0.001 | 1.324 (1.121–1.564) | |
| SSRS | −0.240 | 0.052 | 21.236 | <0.001 | 0.787 (0.711–0.871) | |
| GAD-7 | 0.317 | 0.086 | 13.607 | <0.001 | 1.374 (1.160–1.626) | |
| Enfermedades subyacentes | 1.134 | 0.48 | 5.567 | 0.018 | 3.107 (1.212–7.968) | |
| C3 frente a C1 | Edad | −0.047 | 0.023 | 4.389 | 0.036 | 0.954 (0.912–0.997) |
| Casado | 0.085 | 0.367 | 0.054 | 0.817 | 1.088 (0.531–2.233) | |
| HAMD-17 | 0.053 | 0.064 | 0.682 | 0.409 | 1.054 (0.930–1.195) | |
| SSRS | −0.048 | 0.034 | 1.982 | 0.159 | 0.953 (0.891–1.019) | |
| GAD-7 | 0.078 | 0.066 | 1.375 | 0.241 | 1.081 (0.949–1.231) | |
| Enfermedades subyacentes | 0.019 | 0.374 | 0.003 | 0.959 | 1.020 (0.490–2.123) | |
| C4 frente a C1 | Edad | 0.074 | 0.035 | 4.438 | 0.035 | 1.077 (1.005–1.154) |
| Casado | −1.394 | 0.544 | 6.574 | 0.01 | 0.248 (0.085–0.720) | |
| HAMD-17 | 0.383 | 0.097 | 15.733 | <0.001 | 1.466 (1.214–1.772) | |
| SSRS | −0.318 | 0.06 | 27.91 | <0.001 | 0.727 (0.646–0.819) | |
| GAD-7 | 0.473 | 0.101 | 22.111 | <0.001 | 1.605 (1.318–1.955) | |
| Enfermedades subyacentes | 1.494 | 0.552 | 7.332 | 0.007 | 4.454 (1.511–13.134) |
Tabla 4: Análisis de regresión logística multinomial de los factores asociados con la pertenencia a la trayectoria de dependencia en enfermería. C1, Alta independencia-mejoría lenta, se especificó como la categoría de resultado de referencia. Se informan OR ajustadas e IC del 95 % para C2 frente a C1, C3 frente a C1 y C4 frente a C1. El modelo final de efectos principales se obtuvo mediante selección hacia atrás por razón de verosimilitud. El modelo final mejoró significativamente respecto al modelo solo con el intercepto (razón de verosimilitud χ2 = 190,966, gl = 18, P < 0,001), con una pseudo-R2 de Nagelkerke de 0,557 y una precisión general de clasificación del 53,1 %. Abreviaturas: OR = razón de momios; IC = intervalo de confianza; HAMD-17 = Escala de Evaluación de la Depresión de Hamilton de 17 ítems; SSRS = Escala de Evaluación del Apoyo Social; GAD-7 = Trastorno de Ansiedad Generalizada-7.
Archivo suplementario 1: Datos brutos que respaldan los hallazgos de este estudio.Haga clic aquí para descargar este archivo.
Discusión
Los cambios longitudinales en la dependencia de enfermería deben interpretarse de forma descriptiva. A nivel de la cohorte completa, la puntuación media del CDS fue de 48,28 ± 10,25 en T1, lo que indica necesidades sustanciales de atención de enfermería en la fase temprana tras el IAM11. La puntuación del CDS aumentó a 54,16 ± 14,33 en T2 durante el tratamiento agudo y la recuperación temprana12, disminuyó ligeramente a 52,82 ± 12,17 al momento del alta y volvió a aumentar a 56,58 ± 15,15 a un mes después del alta. Investigaciones previas han destacado las dificultades relacionadas con la participación en la rehabilitación cardíaca tras el IAM13; sin embargo, el presente estudio no evaluó directamente si la participación en rehabilitación u otros factores específicos explicaron los cambios temporales observados. Un análisis de clases latentes mostró además que el patrón medio general ocultaba cuatro trayectorias sustancialmente diferentes. Esta heterogeneidad es ampliamente coherente con investigaciones previas sobre trayectorias cardiovasculares, incluyendo las trayectorias de calidad de vida relacionada con la salud tras el IAM14 y las trayectorias de autocuidado en pacientes con enfermedad coronaria15. Las diferencias en el número y la forma de las clases entre estudios pueden reflejar diferencias en los constructos medidos, los calendarios de evaluación, las poblaciones de pacientes, la duración del seguimiento y los enfoques de modelado de clases latentes.
Varios pasos del protocolo son fundamentales para la reproducibilidad. Primero, T1 debe definirse de manera consistente. La evaluación basal debe realizarse tras el tratamiento de emergencia exitoso y la recuperación de la conciencia, ya que una evaluación anterior podría captar inestabilidad clínica transitoria en lugar de un estado funcional confiable. Segundo, la administración del CDS debe estandarizarse en los cuatro puntos temporales, porque cambios en las instrucciones o en los procedimientos de asistencia podrían introducir diferencias longitudinales artificiales. Tercero, las evaluaciones psicosociales basales deben distinguirse claramente de las evaluaciones repetidas del CDS. HAMD-17, GAD-7 y SSRS se administraron una sola vez en T1, mientras que el CDS se administró repetidamente en T1–T4. Por último, el modelo de mezcla de crecimiento (GMM) debe ajustarse con suficientes inicios aleatorios y evaluarse mediante la replicación de la verosimilitud logarítmica óptima, estimaciones de parámetros admisibles, probabilidades posteriores y tamaños de clase clínicamente significativos, en lugar de seleccionarlo únicamente por la disminución de los valores de AIC o BIC.
La selección de la solución de cuatro clases ilustra una consideración importante en los modelos de mezcla. Añadir una quinta clase redujo ligeramente los criterios de información y aumentó la entropía; sin embargo, la solución de cinco clases no mostró una mejora estadísticamente significativa según el LMR-LRT (P = 0.128) ni el BLRT (P = 0.063), y además introdujo un subgrupo pequeño que comprendía solo el 6,4 % de la muestra, con una diferenciación clínica adicional limitada. En aplicaciones similares, por lo tanto, no debe interpretarse automáticamente cada clase adicional como un subgrupo biológico o clínico significativo. Debe reconsiderarse una solución más sencilla cuando un modelo produce una clase muy pequeña, presenta convergencia inestable, genera un logaritmo de verosimilitud óptimo no replicado, produce trayectorias poco verosímiles o muestra cambios sustanciales en la composición de las clases en respuesta a pequeños cambios en los valores iniciales. Por el contrario, un modelo estadísticamente más simple puede ser inadecuado si combina patrones longitudinales clínicamente distintos y bien diferenciados.
El análisis de factores asociados debe interpretarse como exploratorio, no como predictivo ni causal. La edad mostró asociaciones específicas según la clase con la pertenencia a las trayectorias. Estudios prospectivos previos en pacientes con IAM han identificado la edad avanzada como un correlato importante del deterioro posterior en el estado de salud y en las actividades de la vida diaria16,17. El estado civil también se asoció con la pertenencia a las trayectorias, y una revisión sistemática y metaanálisis han reportado asociaciones entre el estado civil o de pareja y los resultados autoinformados por los pacientes tras un infarto de miocardio18. Se ha asociado un menor apoyo social percibido con un peor estado de salud y síntomas depresivos tras un IAM19, mientras que la angustia psicológica tras el infarto de miocardio también es clínicamente relevante20. Evidencia prospectiva ha relacionado además un bajo apoyo social percibido con peores resultados en salud física y mental tras un IAM21. En el presente estudio, la historia de enfermedades subyacentes se asoció con varias comparaciones de trayectorias, y evidencia previa ha vinculado la multimorbilidad con el deterioro funcional en pacientes con antecedentes de IAM22. No obstante, el presente análisis no evaluó los mecanismos fisiológicos, conductuales o psicosociales subyacentes a estas asociaciones. Por lo tanto, los hallazgos no deben interpretarse como evidencia de que modificar estos factores necesariamente alteraría la pertenencia a las clases de trayectoria.
Este método tiene varias limitaciones. El estudio se realizó en un solo centro utilizando un muestreo por conveniencia, lo cual podría haber introducido un sesgo de selección y limitado la validez externa. Solo se incluyeron pacientes que experimentaron un primer infarto de miocardio; por lo tanto, la estructura de trayectoria identificada podría no generalizarse a pacientes con eventos recurrentes. El seguimiento finalizó un mes después del alta, lo que impide evaluar si las cuatro clases de trayectoria permanecen estables durante períodos más largos. Variables cardiovasculares importantes, incluyendo la fracción de eyección del ventrículo izquierdo, la clase de Killip, las características del vaso culpable, el éxito del procedimiento, las complicaciones durante la hospitalización, la terapia médica detallada, el péptido natriurético tipo B, la tolerancia al ejercicio y la participación en rehabilitación cardíaca estructurada, no se incorporaron de forma sistemática. Por lo tanto, no puede descartarse un posible confundimiento residual relacionado con la gravedad de la enfermedad, la intensidad del tratamiento y el estado de rehabilitación.
Una limitación adicional concierne a la precisión de algunas estimaciones de regresión específicas de clase. No se realizó ningún cálculo formal a priori del tamaño de la muestra basado en simulaciones. Aunque el GMM de cuatro clases demostró una convergencia estable y una calidad de clasificación satisfactoria, algunos grupos de trayectoria fueron relativamente pequeños. Por lo tanto, los intervalos de confianza amplios para estimaciones seleccionadas, particularmente aquellas relacionadas con antecedentes de enfermedades subyacentes, deben interpretarse con cautela. Se necesitan cohortes prospectivas multicéntricas más grandes, con períodos de seguimiento más largos, fenotipificación cardiovascular más exhaustiva y replicación independiente para confirmar la estructura de clases identificada y sus factores asociados. A pesar de estas limitaciones, el marco combinado de CDS repetidas y GMM proporciona un enfoque práctico para identificar patrones heterogéneos de recuperación temprana y podría facilitar evaluaciones de enfermería y seguimientos más individualizados en poblaciones con IAM.
Divulgaciones
Los autores declaran que no tienen intereses competidores. No se utilizaron herramientas de inteligencia artificial (IA) en la preparación, redacción, edición o generación de figuras para este manuscrito.
APORTES DE LOS AUTORES:
Todos los autores contribuyeron a la concepción y diseño del estudio, a la recopilación e interpretación de los datos, y a la elaboración y revisión del manuscrito. Todos los autores revisaron y aprobaron la versión final del manuscrito y aceptan ser responsables de todos los aspectos del trabajo
Agradecimientos
Los autores agradecen a los pacientes que participaron en el estudio y al personal clínico que ayudó con la administración de los cuestionarios, la recopilación de datos y el seguimiento. Esta investigación no recibió ninguna subvención específica de ninguna agencia financiera en los sectores público, comercial o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Escala de Dependencia en Atención (CDS) | Dijkstra A, Buist G, Dassen T | N/A | Escala original de evaluación de dependencia en cuidados de enfermería con 15 ítems; puntuaciones más altas indican mayor independencia. |
| Escala de Dependencia para Cuidados, versión china | Zhang SQ, Zhu YM, Li L, et al. | N/A | Versión en chino/fuente de validación citada en el manuscrito y utilizada para respaldar la solicitud de CDS en este estudio. |
| Cuestionario de Información General | Equipo de estudio, Pueblo del condado de Linquan’s Hospital | Desarrollado por el estudio; sin número de catálogo | Formulario específico del estudio utilizado para recopilar edad, sexo, IMC, estado civil, clasificación de la función cardíaca, tipo de IM, estrategia de reperfusión y antecedentes de enfermedades subyacentes. |
| Trastorno de Ansiedad Generalizada-7 (GAD-7) | Spitzer RL, Kroenke K, Williams JBW, Lönosotros B | N/A | Escala de ansiedad publicada de 7 ítems administrada una vez en el momento basal (T1). |
| Escala de Depresión de Hamilton, de 17 ítems (HAMD-17) | Hamilton M | N/A | Escala de depresión valorada por clínicos publicada; se utilizó el enfoque de puntuación de 17 ítems en el momento basal (T1). |
| IBM SPSS Statistics | IBM Corp. | Versión 26.0 | Software estadístico utilizado para estadísticas descriptivas, ANOVA de un factor, pruebas de chi-cuadrado y regresión logística multinomial. |
| Documentación de IBM SPSS Statistics 26 | IBM Corp. | Documentación de la versión 26 | Recurso oficial de documentación para IBM SPSS Statistics 26 |
| Mplus | Muthén & Muthén | Versión 8.3 | Software estadístico utilizado para ajustar modelos de mezcla de crecimiento de una a cinco clases; la versión 8.3 fue lanzada el 30 de abril de 2019. |
| Guía del usuario de Mplus | Muthén & Muthén | Octava edición / Versión 8 | Documentación oficial del usuario de Mplus versión 8 utilizada como recurso metodológico de software. |
| Escala de Calificación de Apoyo Social (SSRS) | Xiao SY | N/A | Escala china de apoyo social publicada de 10 ítems administrada una vez en la línea base (T1). |
| Lista de verificación STROBE para estudios de cohorte | Iniciativa STROBE | Lista de verificación para estudios de cohorte | Lista de verificación utilizada para revisar la completitud del informe de un estudio observacional longitudinal. |
| Declaración STROBE | Iniciativa STROBE | directriz de 2007 | Guía de informe para estudios observacionales; utilizada como recurso para informar sobre el diseño del estudio, los participantes, el sesgo, los métodos estadísticos, los resultados y las limitaciones. |
Referencias
- Cai D, et al. Sex differences in outcomes in patients with acute myocardial infarction. BMC Cardiovasc Disord. 2025;25(1):272.
- Liu M, et al. A patient with acute myocardial infarction with electrocardiogram Aslanger's pattern. BMC Cardiovasc Disord. 2024;24(1):3.
- Yu F, Yuan X, Fu S. Optimizing emergency nursing protocols to enhance outcomes in patients with acute myocardial infarction: a retrospective study. Medicine (Baltimore). 2025;104(23):e41412.
- Guo J, Chen Y, Dai Y, Chen Q, Wang X. Influencing factors of care dependence in patients with coronary heart disease after percutaneous coronary intervention: a cross-sectional study. Nurs Open. 2023;10(1):241-251.
- Zhang SQ, Zhu YS, Li L, Ye WQ. Reliability and validity analysis of the Chinese version of the Care Dependency Scale for elderly patients. J Nurs Sci. 2014;29(3):7-9. [in Chinese].
- Li CQ, Zhong GK. Application of several commonly used mental health rating scales in psychiatry. Chin J Clin Rehabil. 2005;(12):34. [in Chinese].
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-1097.
- Xiao SY. The theoretical basis and research application of the Social Support Rating Scale. J Clin Psychiatry. 1994;4(2):98-100. [in Chinese].
- Muthén LK, Muthén BO. How to use a Monte Carlo study to decide on sample size and determine power. Struct Equ Modeling. 2002;9(4):599-620.
- Pate A, et al. Minimum sample size for developing a multivariable prediction model using multinomial logistic regression. Stat Methods Med Res. 2023;32(3):555-571.
- Shen Y, et al. Observation on the application effect of stressor perception and response meticulous nursing in the perioperative period of acute myocardial infarction. Altern Ther Health Med. 2024;30(1):63-67.
- Nakamura K, Ohbe H, Uda K, Fushimi K, Yasunaga H. Early rehabilitation after acute myocardial infarction: a nationwide inpatient database study. J Cardiol. 2021;78(5):456-462.
- Wang L, Liu J, Fang H, Wang X. Factors associated with participation in cardiac rehabilitation in patients with acute myocardial infarction: a systematic review and meta-analysis. Clin Cardiol. 2023;46(11):1450-1457.
- Munyombwe T, et al. Quality of life trajectories in survivors of acute myocardial infarction: a national longitudinal study. Heart. 2020;106(1):33-39.
- Ingadóttir B, Svavarsdóttir MH, Jurgens CY, Lee CS. Self-care trajectories of patients with coronary heart disease: a longitudinal, observational study. Eur J Cardiovasc Nurs. 2024;23(7):780-788.
- Hajduk AM, Dodson JA, Murphy TE, Chaudhry SI. A risk model for decline in health status after acute myocardial infarction among older adults. J Am Geriatr Soc. 2023;71(4):1228-1235.
- Hajduk AM, et al. Risk model for decline in activities of daily living among older adults hospitalized with acute myocardial infarction: the SILVER-AMI study. J Am Heart Assoc. 2020;9(19):e015555.
- Zhu C, Tran PM, Leifheit EC. Association of marital/partner status and patient-reported outcomes following myocardial infarction: a systematic review and meta-analysis. Eur Heart J Open. 2023;3(2):oead018.
- Leifheit-Limson EC, et al. The role of social support in health status and depressive symptoms after acute myocardial infarction: evidence for a stronger relationship among women. Circ Cardiovasc Qual Outcomes. 2010;3(2):143-150.
- Levine GN, et al. Post-myocardial infarction psychological distress: a scientific statement from the American Heart Association. Circulation. 2025;152(16):e298-e310.
- Bucholz EM, et al. Effect of low perceived social support on health outcomes in young patients with acute myocardial infarction: results from the VIRGO (Variation in Recovery: Role of Gender on Outcomes of Young AMI Patients) study. J Am Heart Assoc. 2014;3(5):e001252.
- Bagai A, et al. Multimorbidity, functional impairment, and mortality in older patients stable after prior acute myocardial infarction: insights from the TIGRIS registry. Clin Cardiol. 2022;45(12):1277-1286.