Este protocolo presenta la Red Tri-estrato Desacoplada (TDE-Net), un marco de trabajo para la reconstrucción de imágenes a partir de EEG que combina representaciones complementarias de EEG, alineación visual en espacio dual y decodificación mediante difusión.
Artículo de método
Red desenredada de tres flujos con fusión adaptativa de espacio dual para la reconstrucción de imágenes basada en electroencefalografía en THINGS-EEG2
En este artículo
Resumen
Resumen
La reconstrucción de estímulos visuales a partir de la electroencefalografía (EEG) no invasiva requiere mapear respuestas neuronales breves y ruidosas a representaciones visuales significativas, a pesar del muestreo espacial limitado. Los enfoques actuales de EEG a imagen emplean diversas representaciones neuronales y estrategias generativas, lo que exige flujos de trabajo reproducibles que separen las contribuciones estructurales y semánticas. Este protocolo presenta la Red Tri-secuencial Desacoplada (TDE-Net), un marco computacional para la reconstrucción de imágenes basada en EEG. El protocolo utiliza grabaciones preprocesadas de THINGS-EEG2 y organiza la información de EEG en un ancla de EEG bruto, un flujo de grafo funcional específico de la muestra y un flujo semántico temporal multiescala. El flujo de grafo captura las relaciones en el dominio de la frecuencia entre los canales de EEG mediante convolución en grafos y aprendizaje contrastivo cruzado entre ensayos, mientras que el flujo semántico extrae características relevantes para la tarea mediante ponderación espacial adaptativa y convoluciones temporales multiescala. Las características estructurales y semánticas se mapean por separado a espacios latentes de codificador automático variacional (VAE) y de preentrenamiento contrastivo de lenguaje-imagen (CLIP), se combinan utilizando pesos de fusión seleccionados mediante un conjunto de desarrollo y se decodifican usando Stable UnCLIP. En 10 participantes, TDE-Net alcanzó una precisión media de identificación por pares CLIP de 0,8135, con métricas complementarias que demuestran la correspondencia estructural y en el espacio de características. Análisis de ablación y a nivel de representación caracterizaron además las contribuciones de cada flujo individual. Este protocolo proporciona un marco reproducible para investigar representaciones complementarias de EEG y la reconstrucción visual basada en difusión.
Introducción
La decodificación de la percepción visual es un área de investigación interdisciplinaria en interfaces cerebro-computadora (BCI) y neurociencia cognitiva. La imagen por resonancia magnética funcional (fMRI) ha permitido la reconstrucción realista de imágenes1,2,3,4, pero su costo, portabilidad limitada y retraso hemodinámico restringen algunas aplicaciones. La electroencefalografía (EEG) proporciona mediciones temporales a escala de milisegundos con instrumentación comparativamente accesible, pero su baja relación señal-ruido y muestreo espacial limitado dificultan la reconstrucción de imágenes a partir de EEG.
La complejidad del método debe interpretarse a la luz del compromiso general entre sesgo y varianza5. Los primeros métodos de decodificación visual utilizaron representaciones poco profundas o lineales, mientras que estudios posteriores introdujeron codificadores compactos basados en convoluciones, en grafos y en mecanismos de atención6,7,8,9,10,11. La alineación cruzada de modalidades también ha avanzado desde el aprendizaje de características multimodales12,13 hasta modelos de difusión latente y grandes codificadores de visión14,15,16. Estos enfoques establecen referencias útiles, pero sus representaciones de entrada, objetivos latentes y decodificadores difieren, por lo que los resultados deben interpretarse dentro de sus respectivos entornos experimentales.
El objetivo de TDE-Net es proporcionar un marco modular para la reconstrucción de imágenes a partir de EEG que separe las representaciones estructurales y semánticas del EEG, las alinee con espacios latentes visuales complementarios e integre estas predicciones para la reconstrucción de imágenes basada en difusión. Estudios recientes sobre decodificación visual a partir de EEG han introducido la generación guiada por transformadores en EEG-CLIP17, el alineamiento sensible al primer plano con redes cerebrales dinámicas en FSDBN18, el desenfoque adaptativo guiado por la cognición con alineamiento restringido por información19 y el aprendizaje biomimético bidireccional multinivel20. Las tuberías relacionadas de EEG a imagen, incluyendo Perceptogram y la difusión guiada basada en incrustaciones de EEG, proporcionan referencias adicionales para la predicción latente21,22. TDE-Net difiere en su organización del modelo: separa explícitamente un ancla de EEG en bruto, una representación funcional específica de la muestra mediante grafos y una representación semántica temporal, y luego realiza un alineamiento asimétrico con los espacios VAE y CLIP antes de la fusión. Esta organización permite examinar por separado las contribuciones estructurales y semánticas mediante análisis en el espacio latente y a nivel de imagen. En comparación con enfoques de una sola representación o de alineación directa de EEG a imagen, este diseño modular proporciona rutas estructurales y semánticas independientes, conserva una referencia lineal del EEG durante la predicción latente y permite evaluar de forma independiente la contribución de cada representación mediante análisis de ablación y del espacio latente.
TDE-Net está diseñado para experimentos con respuestas EEG apareadas y estímulos visuales, condiciones suficientes de entrenamiento y una ventana postestímulo corta en la que la reconstrucción semántica es el objetivo principal. Su organización por etapas permite el examen independiente de la extracción de características, alineación latente, fusión y decodificación mediante difusión. Las transformaciones lineales siguen siendo adecuadas para conjuntos de datos muy pequeños o entornos que priorizan la complejidad mínima del modelo, mientras que los decodificadores neuronales de extremo a extremo pueden ser preferibles cuando se dispone de grandes conjuntos de datos específicos de la tarea y despliegue en tiempo real.
El presente protocolo evalúa la configuración propuesta en el entorno de presentación rápida de estímulos visuales (RSVP) THINGS-EEG2. Las principales contribuciones incluyen un esquema de representación triplemente en EEG que comprende un ancla lineal cruda, un flujo de grafo funcional específico por muestra y un flujo semántico temporal multiescala. Estas representaciones complementarias se proyectan en espacios latentes VAE y CLIP, y las predicciones correspondientes se combinan antes de la decodificación mediante difusión. El marco se evalúa en los 10 sujetos de THINGS-EEG2 utilizando medidas de reconstrucción a nivel de sujeto, análisis de ablación y de ventanas temporales, y visualizaciones a nivel de representación, con mapas de atención espacial interpretados como análisis topográficos de canales del cuero cabelludo.
Protocolo
El protocolo consta de seis etapas secuenciales: preparación de los ensayos de EEG y latentes de imágenes; construcción del flujo estructural de grafos; entrenamiento del codificador de EEG semántico; ajuste de las asignaciones CLIP/VAE; fusión de las predicciones latentes, seguida de la decodificación de imágenes; y evaluación de los resultados a nivel de imagen y a nivel de representación (Figura 1).
1. Preparar los ensayos de EEG y los embeddings de imágenes
- Documente la cohorte de origen y el protocolo de adquisición.
NOTA: La cohorte de origen constó de 10 adultos sanos (edad media de 28,5 años, DE 4,0; ocho mujeres y dos hombres) con visión normal o corregida a la normalidad. Los participantes proporcionaron consentimiento informado por escrito, recibieron compensación monetaria y completaron el protocolo original con la aprobación del comité de ética del Departamento de Educación y Psicología de la Freie Universität Berlin, de acuerdo con la Declaración de Helsinki23.- Utilice el conjunto de datos THINGS-EEG2 disponible públicamente como recurso para análisis secundarios.
- Utilice la partición de origen de 1.654 conceptos de entrenamiento y 200 conceptos de prueba no superpuestos extraídos de THINGS, con las proporciones de 27 categorías de nivel superior equilibradas entre las particiones. Seleccione diez imágenes con fondo natural para cada concepto de entrenamiento y una imagen para cada concepto de prueba, obteniendo así 16.540 condiciones de entrenamiento y 200 condiciones de prueba reservadas.
NOTA: En el presente estudio, la tarea de detección de objetivos utilizó imágenes separadas de control con Buzz Lightyear que fueron excluidas del análisis actual de reconstrucción23. - Siga la cronología del protocolo original de presentación visual en serie rápida al interpretar las épocas.
NOTA: Cada secuencia comenzó con un intervalo en blanco de 750 ms, seguido por 20 imágenes presentadas en el centro. Cada imagen abarcaba 7 grados de ángulo visual, permanecía en pantalla durante 100 ms y tenía una asincronía de inicio del estímulo de 200 ms, lo que corresponde a 5 imágenes/s. Un segundo intervalo en blanco de 750 ms precedía a un período de respuesta de hasta 2 s, durante el cual los participantes primero parpadeaban y luego informaban si había aparecido una imagen objetivo. Un objetivo de fijación central en forma de diana permanecía visible durante toda la secuencia23. - Tenga en cuenta la estructura original de las sesiones de grabación al organizar el conjunto de datos. Utilice los datos de las cuatro sesiones de grabación completadas por cada participante, siendo cada sesión de cuatro ejecuciones de prueba y 15 ejecuciones de entrenamiento de aproximadamente 5 minutos cada una. Mantenga cuatro repeticiones para cada condición de entrenamiento y 80 repeticiones para cada condición de prueba, lo que equivale a 82.160 ensayos de imágenes no objetivo analizados por participante23.
- Utilice los datos de EEG adquiridos con la configuración original de grabación THINGS-EEG2. Estas grabaciones se obtuvieron a 1.000 Hz usando un EASYCAP de 64 electrodos dispuesto según el sistema internacional 10-10 y un amplificador BrainVision actiCHamp, con Fz como referencia en línea y un filtro pasa-banda en línea de 0,1–100 Hz.
- Utilice los datos preprocesados publicados, que fueron segmentados desde -200 hasta 800 ms con respecto al inicio de la imagen, corregidos por línea base usando el intervalo previo al estímulo, submuestreados a 100 Hz, restringidos a 17 canales parieto-occipitales, libres de ensayos objetivo y sometidos a normalización multivariante del ruido de forma independiente dentro de cada sesión de grabación23.
- Prepare los tensores de ensayos de EEG
- Cargue los tensores preprocesados publicados de THINGS-EEG2 para los 10 participantes. A partir de cada época de origen, seleccione el intervalo postestímulo de 0–800 ms y los 17 canales parieto-occipitales, manteniendo la frecuencia de muestreo de 100 Hz para obtener 80 puntos temporales por ensayo. Mantenga la partición de origen de 16.540 condiciones de imagen de entrenamiento y 200 condiciones de prueba reservadas para cada participante23 (Figura 2).
- Para el preentrenamiento del flujo gráfico, mantenga las cuatro repeticiones independientes de entrenamiento para cada condición de imagen y seleccione dos repeticiones para formar un par positivo. Para los flujos crudo y semántico, promedie las cuatro repeticiones de entrenamiento y promedie las 80 repeticiones de prueba disponibles para cada condición.
- Utilice los tensores preprocesados de THINGS-EEG2 producidos por la canalización original MVNN; dentro de cada extractor de características implementado, aplique la puntuación Z a nivel de archivo documentada antes del cálculo de características.
NOTA: Este uso asimétrico de repeticiones es intencional: los ensayos repetidos proporcionan pares positivos para el preentrenamiento contrastivo del flujo gráfico, mientras que los flujos crudo y semántico utilizan promedios a nivel de condición para la asignación supervisada. El diseño resultante combina el aprendizaje de invariancia a nivel de repetición en el flujo estructural con la predicción latente a nivel de condición en los flujos crudo y semántico.
- Prepare los latentes de imagen emparejados
- Utilice el codificador de visión CLIP de 1.024 dimensiones y el codificador VAE asociado con sd2-community/stable-diffusion-2-1-unclip para extraer objetivos de imagen emparejados. Redimensione las imágenes de entrada del VAE a 768 x 768 píxeles, almacene el modo posterior del VAE como un vector de 36.864 dimensiones (4 x 96 x 96) y mantenga el orden de las condiciones de imagen.
- Guarde tres formas de entrada: tensores de ensayos repetidos para el aprendizaje contrastivo gráfico, tensores promediados de EEG para los flujos crudo y semántico, y latentes de imagen CLIP/VAE emparejados para la asignación supervisada.
- Normalice y almacene en caché las entradas
- Almacene en caché los tensores de EEG preprocesados, las características gráficas y semánticas extraídas y los latentes de imagen emparejados con un orden fijo de condiciones.
- Durante la asignación ridge, estime los parámetros de estandarización por característica a partir de las entradas de entrenamiento y aplique esos parámetros a las entradas de desarrollo y prueba.
2. Construir el flujo estructural del grafo
- Construya el flujo de grafos a partir de ensayos de entrenamiento repetidos y exporte las características a nivel de nodo tras el preentrenamiento contrastivo. Utilice la misma regla de construcción de grafos para la extracción de características en la prueba, sin emplear latentes de imágenes de prueba durante el cálculo de características.
- Transforme los ensayos de EEG en entradas de grafos en el dominio de la frecuencia
- Transforme cada ensayo mediante una transformada rápida de Fourier (FFT) de 80 puntos y conserve los primeros 40 bins de frecuencia no negativa, que abarcan de 0 Hz a 48,75 Hz con una tasa de muestreo de 100 Hz. Utilice el espectro de amplitud logarítmica como una matriz de características de nodos de 17 × 40, X. Para cada muestra de EEG, calcule C_ij = |corr(X_i, X_j)| entre cada par de los 17 vectores de características de canal.
- En cada fila, conserve la autocorrelación diagonal y las tres correlaciones más fuertes fuera de la diagonal (k = 4 entradas conservadas, incluida la autocorrelación) y luego simetrice la matriz conservada para definir la matriz de adyacencia funcional ponderada específica para la muestra, A. Aplique normalización simétrica por grado antes de la convolución de grafo.
- Utilice esta construcción durante el entrenamiento y la prueba; no se emplean las coordenadas físicas de los electrodos para definir un grafo fijo.
NOTA: Conservar la conectividad propia preserva la señal de cada nodo, mientras que limitar las conexiones entre canales a tres por fila controla la densidad del grafo antes de la simetrización. La representación en el dominio de la frecuencia proporciona una descripción compacta basada en amplitud para la construcción del grafo, pero no conserva la fase ni todos los detalles temporales de los potenciales relacionados con eventos (ERP) sincronizados; estos aspectos temporales permanecen disponibles en los flujos temporales brutos de anclaje y semánticos.
- Agregue la topología de electrodos con convolución espectral de grafos
- Aplique una red de convolución de grafos (GCN) de cinco capas24 con 80 unidades ocultas por capa, activaciones ReLU, dropout de 0,3, normalización simétrica por grado y agrupamiento medio de grafos.
- Utilice una cabeza de proyección de dos capas con dimensión 80 para el objetivo contrastivo y exporte la representación a nivel de nodo de 17 × 80 para la fusión estructural. Aplique la convolución espectral de grafos sobre la matriz de adyacencia dependiente de la entrada; no introduzca un operador de convolución dinámica separado.
- Entrene el flujo de grafos con aprendizaje contrastivo entre ensayos
- Dentro de la partición de entrenamiento, seleccione aleatoriamente dos repeticiones de la misma condición de imagen como par positivo y trate las representaciones de otras condiciones en el lote como negativas. Optimice el objetivo contrastivo InfoNCE25 con temperatura τ = 0,5, tamaño de lote 32, Adam con tasa de aprendizaje 5 × 10⁻⁴, 20 épocas, recocido coseno hasta eta_min = 10–6 y semilla aleatoria 42.
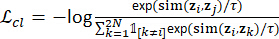 (1)
- Defina la similitud coseno en el objetivo contrastivo y utilice la función indicadora para identificar repeticiones emparejadas. Mantenga la dimensión de proyección en 80 y aplique la misma temperatura en ambas direcciones de la pérdida contrastiva.
- Dentro de la partición de entrenamiento, seleccione aleatoriamente dos repeticiones de la misma condición de imagen como par positivo y trate las representaciones de otras condiciones en el lote como negativas. Optimice el objetivo contrastivo InfoNCE25 con temperatura τ = 0,5, tamaño de lote 32, Adam con tasa de aprendizaje 5 × 10⁻⁴, 20 épocas, recocido coseno hasta eta_min = 10–6 y semilla aleatoria 42.
- Exporte características de grafo a nivel de nodo para fusión temprana
- Congele el codificador de grafos tras el preentrenamiento y exporte las características de nodos de 17 canales con 80 dimensiones por nodo. Concatene estas características con el EEG bruto promediado a lo largo de la dimensión de características para obtener la entrada estructural combinada bruta-más-grafo para la asignación mediante VAE.
- Guarde el tensor de características resultante bruto-más-grafo y utilícelo únicamente como entrada estructural para la rama de regresión VAE.
3. Entrenar el codificador semántico de EEG
- Entrene el codificador semántico de EEG con los tensores de EEG promediados de 17 canales y 80 puntos.
- Optimice la pérdida de incrustación del coseno con AdamW (tasa de aprendizaje 5 x 10⁻⁴; decaimiento del peso 0,01), tamaño de lote 64, 50 épocas, recocido coseno hasta eta_min = 10–6, semilla aleatoria 42 y una salida de 1.024 dimensiones.
- Aplique un filtrado espacial adaptativo basado en datos
- Aplique una operación ponderada de producto tensorial aprendible al tensor de entrada de EEG y amplíe la representación hasta una profundidad de 9. Trate esta operación como una capa de ponderación de canales basada en datos, en lugar de una implementación del filtro espacial clásico de Patrón Espacial Común (CSP)26.
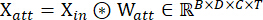 (2)
- Utilice la operación de ponderación de canales aprendida para producir nueve mapas de características, luego páselos al bloque de convolución temporal multi-escala.
- Aplique una operación ponderada de producto tensorial aprendible al tensor de entrada de EEG y amplíe la representación hasta una profundidad de 9. Trate esta operación como una capa de ponderación de canales basada en datos, en lugar de una implementación del filtro espacial clásico de Patrón Espacial Común (CSP)26.
- Modele campos receptivos temporales a múltiples escalas
- Aplique tres convoluciones temporales en paralelo con tamaños de kernel de 5, 15 y 31 muestras, utilizando relleno de longitud igual. Concatene las tres salidas para obtener 24 canales de características temporales y aplique normalización por lotes y activación GELU.
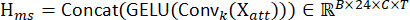 (3)
NOTA: Las convoluciones proporcionan campos receptivos temporales multi-escala dentro del marco más amplio de modelado convolucional temporal27. - Utilice los tres tamaños de kernel como filtros temporales multi-escala; interprete su salida como representaciones de señal aprendidas, en lugar de asignaciones directas a componentes ERP específicos.
- Aplique tres convoluciones temporales en paralelo con tamaños de kernel de 5, 15 y 31 muestras, utilizando relleno de longitud igual. Concatene las tres salidas para obtener 24 canales de características temporales y aplique normalización por lotes y activación GELU.
- Recalibre los canales de características relevantes para la tarea
- Aplique atención de profundidad con agrupamiento promedio adaptativo a la dimensión temporal y una convolución con kernel de tamaño 7 seguida de normalización Softmax, de acuerdo con los principios de recalibración de canales28. Multiplique los pesos de atención resultantes elemento a elemento con el tensor de características multi-escala.
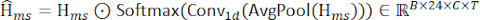 (4)
- Utilice la salida de atención como entrada al bloque de convolución espacial y no interprete los pesos aprendidos como localización neural causal.
- Aplique atención de profundidad con agrupamiento promedio adaptativo a la dimensión temporal y una convolución con kernel de tamaño 7 seguida de normalización Softmax, de acuerdo con los principios de recalibración de canales28. Multiplique los pesos de atención resultantes elemento a elemento con el tensor de características multi-escala.
- Exporte la característica semántica global de EEG
- Aplique una convolución 1 x 1 seguida de una convolución por profundidad que abarque los 17 canales de electrodos, normalización por lotes, activación GELU, agrupamiento promedio con factor 2 y abandono aleatorio p = 0,5. Aplane el resultado y proyéctelo hacia un vector de características semánticas de 1.024 dimensiones.
- Guarde un vector de características semánticas de 1.024 dimensiones para cada muestra promediada de EEG.
4. Asignar características del EEG a los espacios latentes de CLIP y VAE
- Asocie cada tensor de características de EEG con el latente de la imagen que tenga el mismo índice de condición. Ajuste mapeos separados para los objetivos CLIP y VAE, y mantenga todas las condiciones de imagen en la partición de entrenamiento disjuntas de las de la partición de prueba reservada.
- Ajuste una regresión ridge29 con un término independiente y un máximo de 50.000 iteraciones. Utilice λCLIP = 1.000 para los mapeos de datos crudos a CLIP y de semántica a CLIP, λVAE = 0 para el anclaje de datos crudos a VAE, y λVAE, struct = 1.000 para el mapeo del flujo estructural a VAE. Estandarice las entradas del mapeo utilizando las estadísticas de la partición de ajuste.
NOTA: El flujo estructural es la concatenación de las características de EEG crudas y las características de grafo; el flujo semántico contiene la salida del codificador semántico sin concatenación de características crudas. - Mapee las características estructurales al espacio latente de VAE
- Ajuste el mapeo ridge del flujo estructural al VAE con λVAE,struct = 1.000 y prediga el latente de VAE de 36.864 dimensiones. Esta rama recibe las representaciones concatenadas de EEG crudo y de grafo; es la única rama no lineal que concatena explícitamente características crudas.
- Mapee las características semánticas al espacio latente de CLIP
- Ajuste el mapeo ridge del flujo semántico a CLIP con λCLIP = 1.000 y prediga la representación de CLIP de 1.024 dimensiones. La entrada semántica no se concatena con el EEG crudo.
NOTA: En este artículo, λ denota la regularización ridge y α denota un peso de fusión latente. - Evalúe el alineamiento del espacio latente mediante el coeficiente de correlación de Pearson (PCC) por muestra. Utilice condiciones de desarrollo para la selección del peso de fusión y evalúe las 200 condiciones de prueba reservadas únicamente después de que los mapeos y los pesos de fusión hayan sido fijados.
- Ajuste el mapeo ridge del flujo semántico a CLIP con λCLIP = 1.000 y prediga la representación de CLIP de 1.024 dimensiones. La entrada semántica no se concatena con el EEG crudo.
5. Fusionar predicciones latentes y ejecutar la reconstrucción por difusión
- Seleccione αVAE y αCLIP utilizando una división de desarrollo a nivel de condición derivada únicamente de las 16.540 condiciones de entrenamiento. Con la semilla aleatoria 42, utilice los mismos índices de ajuste (90%) y los índices de desarrollo (10%) para los 10 sujetos; las 200 condiciones de prueba reservadas permanecen fuera de este procedimiento.
NOTA: Las penalizaciones de ridge y el coeficiente de preservación estructural se fijaron como valores de configuración antes de la evaluación final con datos reservados y no se ajustaron utilizando las 200 condiciones de prueba. - Para cada sujeto y cada valor candidato de α en {0,00, 0,05, ..., 1,00}, ajuste el codificador supervisado por la variable objetivo y las transformaciones ridge en el subconjunto de ajuste y calcule la correlación intraclase (PCC) promedio a nivel de muestra en el subconjunto de desarrollo.
- Promedie los valores de PCC a nivel de sujeto con igual ponderación entre los 10 sujetos, y seleccione los pesos en el espacio CLIP y en el espacio VAE de forma independiente según el máximo promedio entre sujetos. Congele ambos valores antes de reajustar los modelos finales de entrenamiento y evaluar las condiciones de prueba reservadas.
NOTA: Este procedimiento seleccionó αCLIP = 0,55 y αVAE = 0,65. - Para el espacio VAE, defina la predicción combinada como la suma ponderada del anclaje de bruto-a-VAE y la predicción VAE del flujo estructural:
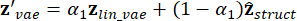 (5)
- Establezca αVAE = 0,65, de modo que el anclaje de bruto-a-VAE contribuya con 0,65 y la predicción del flujo estructural contribuya con 0,35. Mantenga este valor fijo para cada sujeto y cada condición de prueba.
- Para el espacio CLIP, defina la predicción combinada como la suma ponderada del anclaje de bruto-a-CLIP y la predicción CLIP del flujo semántico:
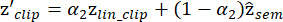 (6)
- Establezca αCLIP = 0,55, de modo que el anclaje de bruto-a-CLIP contribuya con 0,55 y la predicción del flujo semántico contribuya con 0,45. Mantenga este valor fijo para cada sujeto y cada condición de prueba.
NOTA: Interprete la operación de combinación como un conjunto ponderado fijo de predicciones latentes en el sentido general de combinación de modelos30. No la describa como una reducción garantizada del sobreajuste ni como una solución uniformemente óptima en todos los indicadores. - Cargue la tubería fija de imagen-a-imagen Stable UnCLIP desde sd2-community/stable-diffusion-2-1-unclip con pesos de variación en precisión media (fp16). Utilice el vector integrado CLIP combinado como condición semántica y el latente VAE combinado como inicialización estructural.
NOTA: El decodificador sigue los principios de difusión con eliminación de ruido y guía sin clasificador31,32. - Aplique inicialización estructural con ruido a los latentes de difusión. Reformule cada predicción VAE de 36.864 dimensiones a 4 x 96 x 96, siguiendo la formulación del latente del autoencoder variacional33, y añada ruido gaussiano tras multiplicar el latente estructural por el coeficiente de escala estructural gamma = 0,02. Utilice los pasos de tiempo de entrenamiento de difusión T_diff = 1.000 y una semilla fija de difusión de 0 para el procedimiento de reconstrucción reportado.
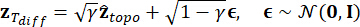 (7)
- Establezca el coeficiente de preservación estructural gamma en 0,02 durante la inicialización con ruido y mantenga este valor fijo para todas las condiciones de prueba. Pase el latente resultante al decodificador sin utilizar información de la imagen real.
- Aplique guía mediante atención cruzada y decodifique el latente de la imagen. Concatene el vector CLIP combinado de 1.024 dimensiones con el vector de condicionamiento adicional de 1.024 dimensiones utilizado por la tubería, anteponga un vector de condición negativa cero para la guía sin clasificador (CFG) y decodifique con una escala de guía de 7,5. Utilice el valor predeterminado de la tubería de 20 pasos de eliminación de ruido y guarde una imagen PNG por cada condición de prueba.
- Guarde la imagen reconstruida con el índice original de la condición de prueba y mantenga el mismo índice para todos los cálculos posteriores de indicadores.
NOTA: Tabla 1 resume la partición de datos, preprocesamiento, construcción del grafo, entrenamiento del modelo, mapeo latente, combinación y configuraciones de decodificación utilizadas en el flujo de trabajo descrito. La hoja de cálculo adjunta proporciona el mismo resumen de parámetros en formato legible por máquina.
6. Evaluar la reconstrucción y la alineación a nivel de representación
- Calcule la fidelidad de bajo nivel mediante la correlación de píxeles (PixCorr) y la similitud estructural (SSIM). Calcule las precisiones de identificación por pares para AlexNet Capa 2, AlexNet Capa 5, Inception-v3 y OpenAI CLIP ViT-L/14; calcule las distancias de correlación de EfficientNet (EffNet) y SwAV, para las cuales valores más bajos indican representaciones de características más cercanas.
- Para el análisis CLIP, forme la matriz de correlación entre las características extraídas de 200 imágenes reconstruidas y las 200 imágenes reales correspondientes. Para cada reconstrucción, compare la correlación con la imagen correcta frente a las correlaciones con las otras 199 imágenes, y promedie las 200 × 199 comparaciones binarias resultantes para obtener la precisión de identificación por pares CLIP.
- Para ventanas en expansión que terminan en 8, 16, ..., 80 puntos temporales, ajuste las proyecciones de EEG en bruto con regularización tipo ridge y calcule la correlación media por muestra (PCC) entre los latentes CLIP y VAE predichos y reales en las 200 condiciones de prueba sub-01. Utilice las predicciones CLIP y VAE solo con secuencia semántica en ventana completa como niveles de referencia punteados.
- Construya matrices de similitud representacional (RSM) a partir de características CLIP normalizadas con norma L2, utilizando similitud coseno. Ordene ambas matrices mediante agrupamiento jerárquico tipo Ward de las incrustaciones CLIP reales, usando distancia euclidiana.
- Para la visualización en dos dimensiones, derive cinco clústeres mediante k-medias a partir de las incrustaciones reales y aplique una proyección conjunta de PCA-50 más incrustación estocástica t-distribuida de vecinos cercanos (t-SNE) a las características reales y predichas; utilice t-SNE únicamente para visualización cualitativa.
- Visualice los patrones de EEG blanqueados y los pesos del modelo por canal del cuero cabelludo con canales etiquetados, escalas de color explícitas y reglas reproducibles de ordenamiento. Interprete estos gráficos como análisis auxiliares de las señales medidas en el cuero cabelludo y de los parámetros del modelo, no como evidencia de localización de fuentes corticales, activación anatómica o causalidad.
Resultados
TDE-Net se evaluó desde seis perspectivas complementarias: rendimiento de reconstrucción, resultados visuales representativos, contribución de componentes, dependencia temporal, estructura representacional semántica y atención en canales del cuero cabelludo. La fidelidad de bajo nivel se evaluó utilizando PixCorr y SSIM, la alineación en el espacio de características mediante AlexNet, Inception-v3, CLIP, EffNet y medidas SwAV, y el rendimiento a nivel individual mediante los resultados de los 10 sujetos de THINGS-EEG2. A menos que se indique lo contrario, cada figura cualitativa identifica al sujeto correspondiente y al subconjunto de condiciones de prueba.
Rendimiento de la reconstrucción y resultados representativos
Como modelo de referencia interno, implementamos adicionalmente una línea base ligera con un codificador EEG basado en convolución y atención. Este modelo extrae una única representación EEG de 1024 dimensiones de cada ensayo y la proyecta de forma independiente a los espacios latentes CLIP y VAE, utilizando el mismo protocolo de regresión ridge y decodificación por difusión que el método propuesto. En las siguientes secciones, este modelo se denomina Línea Base. El codificador corresponde al modelo de referencia semántica con convolución y atención tipo LMDA utilizado en la implementación local, con 373.950 parámetros entrenables y una salida de 1.024 dimensiones.
Tabla 2 compara TDE-Net con la línea base interna basada en convolución y atención, y con métodos representativos de reconstrucción de imágenes basados en EEG, según las métricas reportadas. Para una evaluación consistente, los métodos se implementaron dentro de un marco experimental unificado utilizando la misma partición THINGS-EEG2, entrada de 17 canales, preprocesamiento, condiciones de prueba reservadas y definiciones de métricas, manteniendo al mismo tiempo sus arquitecturas específicas de cada método. En el resumen de diez sujetos, TDE-Net alcanzó valores medios ± DE de 0,2531 ± 0,0138 para PixCorr, 0,3388 ± 0,0025 para SSIM, 0,8777 ± 0,0115 para la Capa 2 de AlexNet, 0,9153 ± 0,0116 para la Capa 5 de AlexNet, 0,7606 ± 0,0213 para Inception-v3, 0,8135 ± 0,0074 para la precisión de identificación por pares de CLIP, 0,8285 ± 0,0122 para la distancia EffNet y 0,5085 ± 0,0101 para la distancia SwAV. El resumen por sujeto complementa los ejemplos cualitativos de un solo sujeto.
El valor CLIP indica la precisión de identificación por pares, no la similitud coseno ni una puntuación genérica de características CLIP. Dado que la secuencia semántica se entrena hacia un objetivo en el espacio CLIP, esta medida refleja tanto la reconstrucción semántica como la alineación con el objetivo de una rama. Por lo tanto, se considera junto con PixCorr, SSIM, AlexNet, Inception-v3, EffNet y SwAV, que caracterizan aspectos complementarios de fidelidad de bajo nivel y concordancia en el espacio de características.
Para caracterizar el rendimiento a nivel individual, aplicamos el procedimiento completo de prueba TDE-Net a los sujetos sub-01 hasta sub-10, utilizando las mismas 200 condiciones de imágenes reservadas para cada sujeto. Tabla 3 informa las ocho medidas de evaluación para cada sujeto, junto con la media entre sujetos y la desviación estándar muestral. La precisión media de identificación por pares CLIP fue de 0,8135 (DE, 0,0074). Los valores medios de PixCorr y SSIM fueron 0,2531 y 0,3388, respectivamente. Las precisiones medias en la Capa 2 y la Capa 5 de AlexNet fueron 0,8777 y 0,9153, y la precisión media de Inception-v3 fue 0,7606. Las distancias EffNet y SwAV, donde valores más bajos son mejores, tuvieron un promedio de 0,8285 y 0,5085, respectivamente. La dispersión limitada a nivel individual en estas medidas indica un comportamiento cuantitativo comparable en la reconstrucción entre los 10 sujetos de THINGS-EEG2.
Figura 3 presenta reconstrucciones para los mismos siete índices de condiciones excluidos (1, 32, 62, 86, 87, 108 y 175; numeración de archivos con índice cero) en todos los 10 sujetos. La fila superior muestra los estímulos reales, y las filas siguientes muestran las reconstrucciones correspondientes para sub-01 hasta sub-10. Las reconstrucciones conservan categorías semánticas compartidas y atributos visuales característicos de los estímulos, mientras que la identidad específica del objeto, la forma y la textura local varían entre sujetos. Este diseño proporciona una contraparte cualitativa a los resultados entre sujetos resumidos en Tabla 3.
Figura 4 presenta reconstrucciones cualitativas para seis condiciones de prueba sub-01 especificadas. Las filas muestran el estímulo real, un comparador Perceptogram generado por nuestra implementación local21 y la reconstrucción del TDE-Net. Los ejemplos destacan la conservación de las categorías de objetos, formas, colores y atributos del fondo, mientras que la identidad fina y los detalles del fondo varían entre los métodos.
Figura suplementaria 1 presenta los grupos de mejor, mediana y peor reconstrucción seleccionados entre las 200 condiciones de prueba sub-01 en THINGS-EEG223. Las condiciones se clasifican según el acuerdo del coseno entre la incrustación CLIP predicha por EEG fusionado congelado y la incrustación CLIP de la imagen real correspondiente. Los grupos mostrados ilustran el rango de acuerdo semántico observado para este sujeto.
Contribución del componente y comportamiento de fusión
Tabla 4 presenta una ablación paso a paso de los flujos estructural y semántico basada en valores promedio entre sujetos obtenidos bajo el mismo procedimiento de evaluación. El Ancla Lineal predice directamente los latentes CLIP y VAE a partir de datos de EEG preprocesados utilizando regresión ridge, y sirve como punto de partida controlado para el estudio de ablación. Este enfoque sigue el principio lineal general de mapeo latente utilizado en estudios previos de EEG a imagen, incluyendo Perceptogram21, empleando al mismo tiempo la preprocesamiento, regularización, decodificación y configuraciones de evaluación de la presente canalización. Este diseño permite examinar el flujo estructural, el flujo semántico y la fusión en espacio dual en relación con una referencia lineal común.
A partir del anclaje lineal, la adición del flujo estructural aumentó el SSIM de 0.331 a 0.339 y la precisión de la capa 5 de AlexNet de 0.913 a 0.932, aunque la precisión de la capa 2 de AlexNet disminuyó ligeramente de 0.889 a 0.886. Agregar en su lugar el flujo semántico produjo el PixCorr más alto (0.237), manteniendo al mismo tiempo una alta precisión en la capa 2 de AlexNet (0.888) y reduciendo las distancias de EffNet y SwAV a 0.865 y 0.531, respectivamente. Cuando ambos flujos se incorporaron mediante la fusión en espacio dual, TDE-Net alcanzó las mayores precisiones de identificación por pares de Inception-v3 (0.761) y CLIP (0.814), junto con las distancias más bajas de EffNet (0.829) y SwAV (0.509). Su precisión en la capa 2 de AlexNet (0.878) permaneció por debajo de la del anclaje lineal, y su SSIM (0.339) permaneció ligeramente por debajo de la configuración con flujo estructural. En general, los resultados del ablandamiento entre sujetos muestran que los flujos estructural y semántico influyen en diferentes aspectos de la reconstrucción, mientras que su fusión fortalece principalmente la identificación semántica y la coherencia en el espacio de características profundas.
Figura 5 muestra la sensibilidad en el conjunto de desarrollo respecto a los dos pesos de fusión en el rango α = 0,00–1,00 en incrementos de 0,05. La curva en el espacio CLIP alcanza su máximo en αCLIP = 0,55, mientras que la curva en el espacio VAE alcanza su máximo en αVAE = 0,65. Se observaron valores de PCC similares para candidatos adyacentes, mientras que los máximos ocurrieron en pesos diferentes para los dos espacios latentes.
Contribución temporal de las señales de EEG
Figura 6 muestra el PCC latente promedio por condición para ventanas EEG crudas que finalizan en 8, 16, ..., 80 puntos temporales en sub-01 (n = 200 condiciones de prueba). Las curvas CLIP y VAE aumentan a medida que se amplía la ventana de análisis y se estabilizan en ventanas posteriores. Las líneas punteadas indican los valores de referencia correspondientes solo para el flujo semántico de la ventana completa. Este análisis caracteriza la dependencia respecto a la ventana temporal bajo el protocolo de mapeo descrito.
Alineamiento semántico y análisis a nivel de representación
Figura 7 compara el coeficiente de correlación de Pearson (PCC) latente a nivel de muestra para el ancla CLIP original y la predicción CLIP fusionada congelada en 200 condiciones de prueba sub-01. Las estimaciones de densidad de kernel gaussiano utilizan el ancho de banda de Scott, y las líneas verticales discontinuas indican las medias de las muestras. La distribución fusionada muestra un aumento medio en el PCC de aproximadamente 0,013 en relación con el ancla original. La precisión de identificación por pares a nivel de imagen con CLIP se informa por separado en Tabla 2.
Figura 8 compara las matrices de similitud por coseno para los embeddings CLIP de imágenes reales y los embeddings CLIP predichos por EEG fusionados. Ambas matrices comparten un rango de datos común y un ordenamiento Ward derivado de las distancias euclidianas entre los embeddings CLIP reales. El panel residual muestra la matriz de similitud predicha menos la matriz de similitud real en una escala simétrica definida por el residual absoluto máximo, proporcionando una visualización del acuerdo representacional.
Figura suplementaria 2 presenta una proyección conjunta de 200 embeddings CLIP reales y 200 embeddings CLIP predichos por EEG. Cinco etiquetas se obtienen mediante agrupamiento k-means de embeddings reales normalizados por L2 (n_init = 50; semilla = 7). Las características reales y predichas concatenadas se reducen a 50 dimensiones mediante PCA y se proyectan conjuntamente mediante t-SNE con perplejidad 28, distancia euclidiana y semilla 12. La proyección ofrece una visión cualitativa de la organización de los dos conjuntos de representaciones.
Patrón de EEG e interpretación de la atención espacial
Figura suplementaria 3 agrupa los conceptos de prueba en Animales, Conceptos relacionados con alimentos/plantas y Otros objetos mediante una asignación explícita de concepto-etiqueta. Dentro de cada grupo, las filas se ordenan mediante agrupamiento Ward de embeddings CLIP reales blanqueados y se muestrean uniformemente hasta un máximo de 30 conceptos para mejorar la legibilidad. El mapa de calor muestra amplitudes EEG blanqueadas normalizadas y recortadas en una escala de -1 a 1; los embeddings CLIP se utilizan únicamente para determinar el orden dentro de cada grupo.
Figura suplementaria 4 muestra una topografía estándar del cuero cabelludo 10-20 de los pesos normalizados absolutos de los canales de la corriente semántica en los 17 electrodos seleccionados. El mapa resume el ponderado relativo del modelo a través de los canales del cuero cabelludo medidos y se interpreta como una visualización del peso del modelo a nivel de canal.
Este estudio es un análisis computacional secundario del conjunto de datos THINGS-EEG2 con identificación eliminada. Las grabaciones originales de EEG, matrices de EEG preprocesadas, metadatos e imágenes de estímulos, y archivos de estado de reposo están disponibles a través del proyecto THINGS-EEG2 en https://osf.io/3jk45/ y Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). El software original para la adquisición y el preprocesamiento está disponible en https://github.com/gifale95/eeg_encoding. El acceso y reutilización de los datos de EEG y las imágenes de estímulo están sujetos a las licencias y requisitos de atribución especificados por los repositorios originales.
La implementación de TDE-Net, que incluye secuencias de comandos para alineación, fusión, reconstrucción, evaluación y visualización, está disponible en https://github.com/Yuan-ui198/TDE-Net. La versión correspondiente a este manuscrito se encuentra fijada en el commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). No se recopilaron nuevos datos identificables de participantes para el presente estudio.
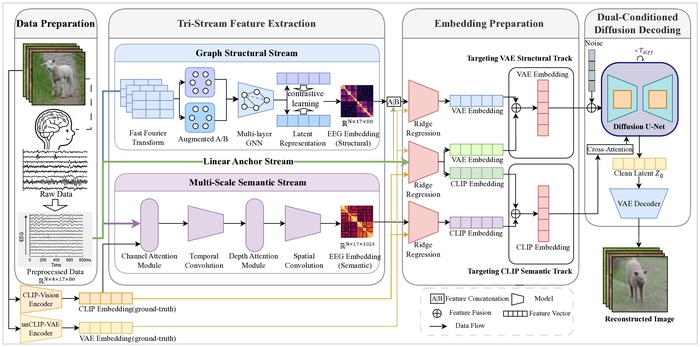
Figura 1: Esquema de TDE-Net. El diagrama muestra el ancla de EEG en bruto, el flujo de gráficos funcionales específico para la muestra, el flujo temporal semántico, la asignación en doble espacio a VAE y CLIP, la fusión ponderada y la decodificación estable dualmente condicionada de UnCLIP. Las dimensiones de los tensores se indican cuando corresponde. Haga clic aquí para ver una versión más grande de esta figura.
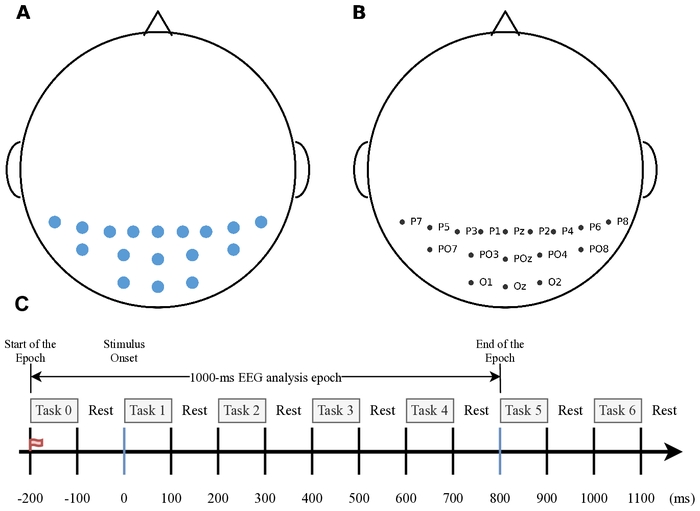
Figura 2: Selección de electrodos EEG y cronometraje experimental. (A) Distribución espacial de los 17 electrodos parieto-occipitales seleccionados de la adquisición original de 64 canales. (B) Etiquetas de los electrodos: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 y P2. (C) Esquema del cronometraje del RSVP y definición del período EEG. En el esquema, «Tarea» denota un intervalo de presentación de imagen, mientras que «Descanso» denota el intervalo entre imágenes; los bloques de Tarea numerados indican intervalos de presentación sucesivos y no diferentes condiciones experimentales. Cada imagen se presentó durante 100 ms con una asincronía de inicio del estímulo de 200 ms. El período EEG se extendió desde -200 hasta 800 ms con respecto al inicio del estímulo, correspondiente a un período de análisis EEG de 1000 ms. Haga clic aquí para ver una versión más grande de esta figura.
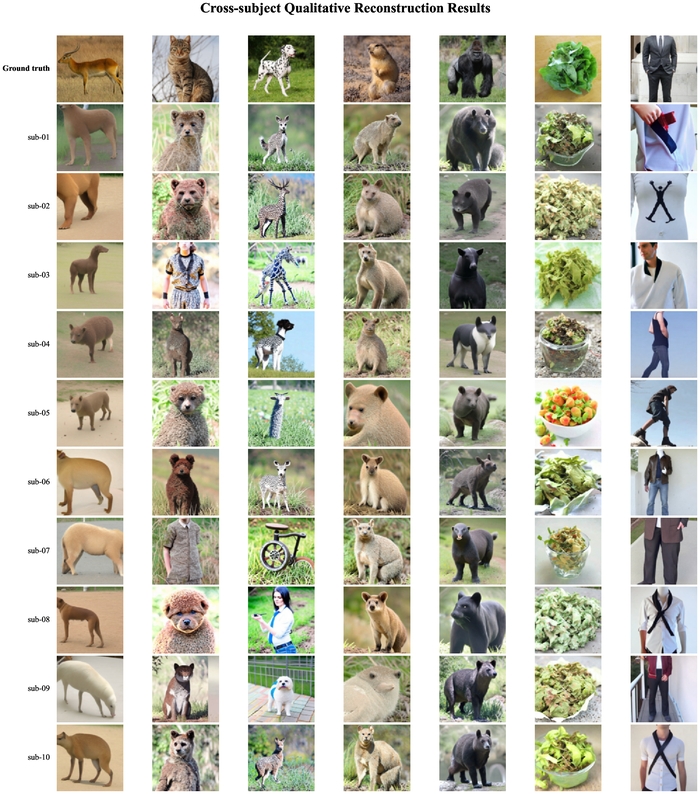
Figura 3: Resultados cualitativos de reconstrucción entre sujetos para siete condiciones de imagen excluidas. Se utilizaron los mismos índices de condición basados en cero (1, 32, 62, 86, 87, 108 y 175) para los sujetos del sub-01 al sub-10. La fila superior muestra las muestras correspondientes de imágenes reales del conjunto de prueba THINGS-EEG2, cuyas imágenes se extrajeron de la base de datos de imágenes THINGS34, mientras que las filas restantes muestran las reconstrucciones de TDE-Net para cada sujeto. La figura ilustra el contenido semántico común y la variación a nivel individual; los resultados cuantitativos entre sujetos se presentan en la Tabla 3. Haga clic aquí para ver una versión más grande de esta figura.
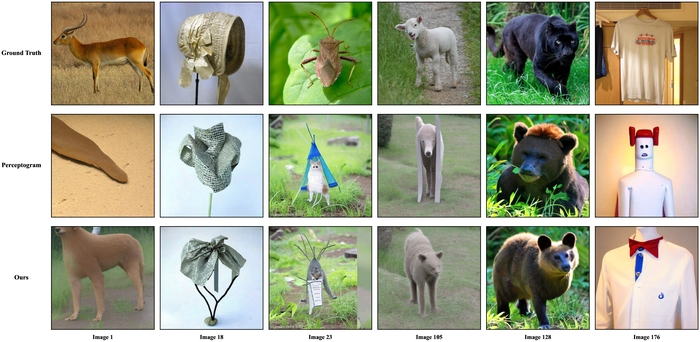
Figura 4: Comparación de reconstrucción cualitativa para seis condiciones de prueba sub-01 especificadas. Las filas muestran el estímulo real, una reconstrucción comparadora generada por la implementación local y la reconstrucción de TDE-Net; las columnas corresponden a índices individuales de condiciones. Las muestras de imágenes reales se tomaron de la base de datos de imágenes THINGS34. Haga clic aquí para ver una versión más grande de esta figura.
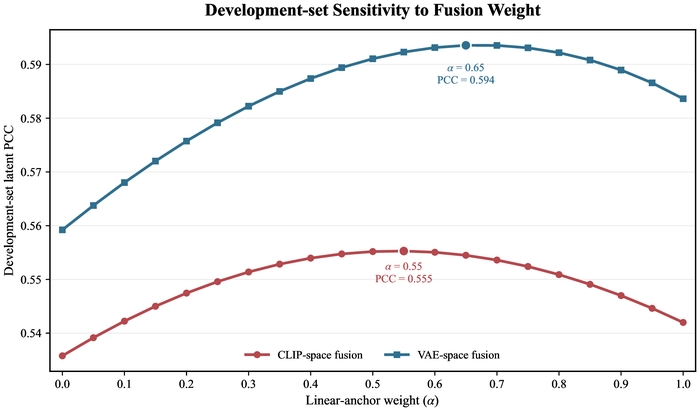
Figura 5: Sensibilidad del conjunto de desarrollo respecto a los pesos de fusión latente. El eje horizontal denota el peso lineal del ancla α, el peso del flujo complementario es 1 - α, y el eje vertical denota la PCC latente del conjunto de desarrollo. Los valores candidatos oscilan entre 0,00 y 1,00 en incrementos de 0,05. Los pesos en el espacio CLIP y VAE se seleccionan independientemente según la media máxima de PCC a nivel de sujeto con pesos iguales en 10 sujetos, obteniendo αCLIP = 0,55 y αVAE = 0,65. PCC, coeficiente de correlación de Pearson. Haga clic aquí para ver una versión más grande de esta figura.
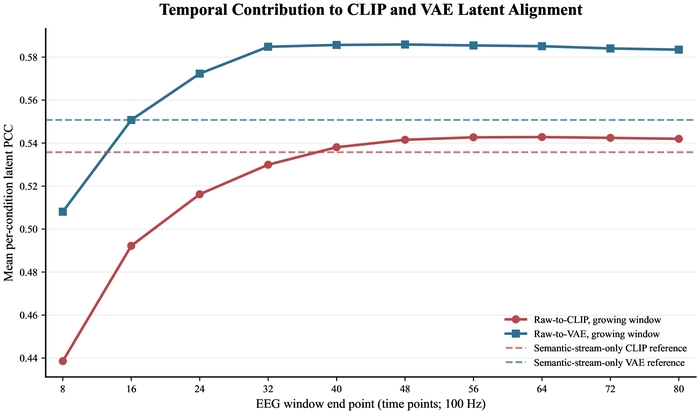
Figura 6: Análisis de la ventana temporal de alineación latente en sub-01 (n = 200 condiciones excluidas). Las curvas continuas muestran el coeficiente de correlación de Pearson (PCC) promedio por muestra para las predicciones de cresta de datos crudos a CLIP y de datos crudos a VAE a medida que el punto final de la ventana de EEG se expande de 8 a 80 puntos temporales a 100 Hz. Las líneas discontinuas indican los valores de referencia completos de CLIP y VAE solo para la corriente semántica. PCC, coeficiente de correlación de Pearson. Haga clic aquí para ver una versión más grande de esta figura.
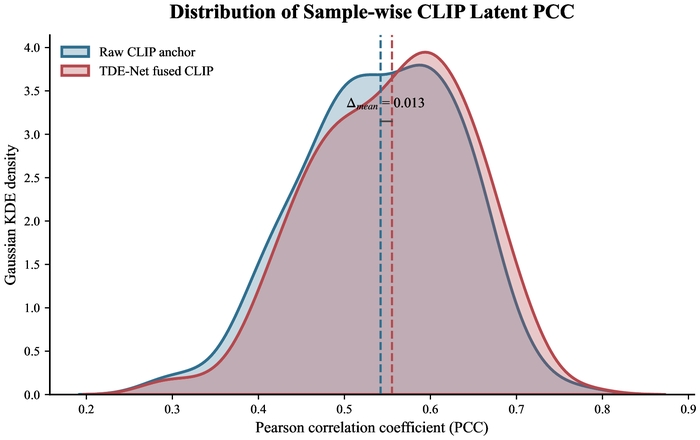
Figura 7: Distribución del alineamiento latente de CLIP por muestra en sub-01 (n = 200 condiciones excluidas). Las curvas son estimaciones de densidad de kernel gaussiano con ancho de banda de Scott para el ancla CLIP original y la predicción CLIP fusionada con TDE-Net congelada. Las líneas verticales discontinuas indican las medias de las muestras, y la anotación muestra su diferencia. PCC, coeficiente de correlación de Pearson; KDE, estimación de densidad de kernel. Haga clic aquí para ver una versión más grande de esta figura.
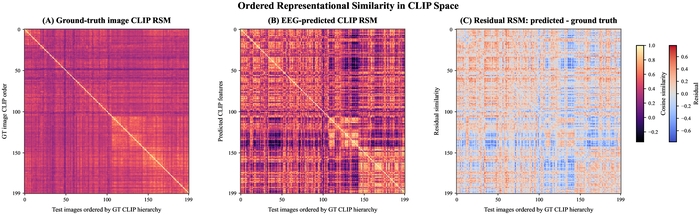
Figura 8: Similitud representacional ordenada en el espacio CLIP para sub-01 (n = 200 condiciones excluidas). (A) Matriz RSM de similitud coseno de los embeddings CLIP de imágenes reales normalizados con norma L2. (B) Matriz RSM de similitud coseno de los embeddings CLIP predichos a partir de EEG fusionados, mostrados con el mismo orden y escala de color que en el panel A. (C) Matriz RSM residual, calculada como predicción menos valor real, mostrada en una escala simétrica definida por el residual absoluto máximo. El ordenamiento se obtuvo mediante la distancia euclidiana y el enlace de Ward de los embeddings CLIP reales. RSM, matriz de similitud representacional. Haga clic aquí para ver una versión más grande de esta figura.
| Componente | Parámetro | Configuración |
| Datos y preprocesamiento | Partición del conjunto de datos | 16.540 condiciones de entrenamiento y 200 condiciones de prueba reservadas; división 90%/10% para ajuste/desarrollo (semilla 42) |
| Entrada de EEG | 17 canales parieto-occipitales; 0-800 ms; 100 Hz; 80 puntos temporales | |
| Representación espectral | FFT de 80 puntos; 40 bins de frecuencia positiva; espectro de amplitud logarítmica de 0-50 Hz | |
| Flujo estructural | Construcción del grafo | Correlación de Pearson absoluta específica por muestra; k = 4 vecinos ponderados superiores por nodo; simetrización y bucles propios |
| Arquitectura GCN | 5 capas; 80 unidades ocultas; ReLU; dropout 0,3; normalización simétrica por grado; agrupamiento promedio | |
| Objetivo contrastivo | Cabezal de proyección de 80 dimensiones; temperatura InfoNCE τ = 0,5 | |
| Entrenamiento | Adam; tasa de aprendizaje 5 × 10⁻⁴; tamaño de lote 32; 20 épocas; recocido coseno; tasa de aprendizaje mínima 10⁻⁶; semilla 42 | |
| Flujo semántico | Arquitectura | Núcleos temporales 5/15/31; profundidad 9; 24 canales de características; dropout 0,5; dimensión de salida 1.024 |
| Entrenamiento | AdamW; tasa de aprendizaje 5 × 10⁻⁴; decaimiento de peso 0,01; tamaño de lote 64; 50 épocas; recocido coseno; tasa de aprendizaje mínima 10⁻⁶; semilla 42 | |
| Mapeo latente | Regresión ridge | Intercepto ajustado; máximo de 50.000 iteraciones; entradas estandarizadas usando estadísticas de la partición de ajuste |
| Regularización | Penalización CLIP λ = 1.000; penalización VAE cruda λ = 0; penalización VAE estructural λ = 1.000 | |
| Dimensiones objetivo | CLIP: 1.024; VAE: 36.864 | |
| Fusión y decodificación | Pesos de fusión | Peso del anclaje CLIP α = 0,55; peso del anclaje VAE α = 0,65; seleccionados en los datos de desarrollo y fijos antes de la prueba |
| Modelo de difusión | sd2-community/stable-diffusion-2-1-unclip; escala estructural γ = 0,02; pasos temporales de difusión T = 1.000 | |
| Muestreo | 20 pasos de eliminación de ruido; escala de guía 7,5; semilla de difusión 0 |
Tabla 1: Resumen consolidado de parámetros para TDE-Net. La tabla enumera la partición de datos, el preprocesamiento, la construcción de la adjacencia funcional, los ajustes del grafo y del codificador semántico, las penalizaciones de mapeo latente, los pesos de fusión y los ajustes de decodificación mediante difusión utilizados en todos los experimentos descritos.
| Método | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Línea base | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| EEGImageDecode | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| Perceptograma (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (nuestro) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
Tabla 2: Resultados cuantitativos de la reconstrucción. Los métodos de comparación, la línea base con convolución-atención interna y TDE-Net se evaluaron dentro de un marco experimental común utilizando la misma partición THINGS-EEG2, entrada de 17 canales, preprocesamiento, condiciones de prueba reservadas y definiciones de métricas, manteniendo al mismo tiempo las arquitecturas específicas de cada método. El modelo actual se resume como media ± DE a lo largo de 10 sujetos. PixCorr, SSIM, AlexNet Capa 2, AlexNet Capa 5, Inception-v3 y CLIP son medidas en las que valores más altos son mejores; EffNet y SwAV son distancias de correlación, para las cuales valores más bajos son mejores. La columna CLIP informa la precisión de identificación por pares utilizando el modelo OpenAI CLIP ViT-L/14.
| Sujeto | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0,2260 | 0,3361 | 0,8831 | 0,9203 | 0,7533 | 0,8120 | 0,8567 | 0,5285 |
| sub-02 | 0,2488 | 0,3378 | 0,8699 | 0,9053 | 0,7268 | 0,8074 | 0,8335 | 0,5167 |
| sub-03 | 0,2564 | 0,3397 | 0,8728 | 0,9070 | 0,7658 | 0,8143 | 0,8268 | 0,5096 |
| sub-04 | 0,2420 | 0,3356 | 0,8598 | 0,9034 | 0,7854 | 0,8112 | 0,8255 | 0,5091 |
| sub-05 | 0,2499 | 0,3385 | 0,8760 | 0,8963 | 0,7251 | 0,8016 | 0,8394 | 0,5189 |
| sub-06 | 0,2621 | 0,3395 | 0,8910 | 0,9331 | 0,7818 | 0,8215 | 0,8202 | 0,5009 |
| sub-07 | 0,2489 | 0,3378 | 0,8643 | 0,9185 | 0,7704 | 0,8200 | 0,8222 | 0,5017 |
| sub-08 | 0,2786 | 0,3425 | 0,8951 | 0,9216 | 0,7524 | 0,8245 | 0,8214 | 0,5010 |
| sub-09 | 0,2609 | 0,3370 | 0,8775 | 0,9238 | 0,7662 | 0,8055 | 0,8250 | 0,5009 |
| sub-10 | 0,2571 | 0,3433 | 0,8871 | 0,9240 | 0,7792 | 0,8175 | 0,8140 | 0,4977 |
| Media | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7606 | 0,8135 | 0,8285 | 0,5085 |
| Media ± DE | 0,2531 ± 0,0138 | 0,3388 ± 0,0025 | 0,8777 ± 0,0115 | 0,9153 ± 0,0116 | 0,7606 ± 0,0213 | 0,8135 ± 0,0074 | 0,8285 ± 0,0122 | 0,5085 ± 0,0101 |
| IC 95% | 0,2432-0,2630 | 0,3370-0,3406 | 0,8695-0,8859 | 0,9070-0,9236 | 0,7454-0,7759 | 0,8082-0,8189 | 0,8198-0,8372 | 0,5013-0,5157 |
Tabla 3: Resultados cuantitativos entre sujetos para TDE-Net. Cada sujeto aporta 200 condiciones de prueba reservadas. La tabla muestra las ocho métricas para sub-01 hasta sub-10, seguidas por la media entre sujetos, la desviación estándar muestral y el IC del 95 %. CLIP denota la precisión de identificación por pares de OpenAI CLIP ViT-L/14; EffNet y SwAV son distancias de correlación donde valores más bajos indican mejor desempeño.
| Método | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Ancla lineal | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Lineal + Secuencia estructural | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Lineal + Secuencia semántica | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (nuestro método) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tabla 4: Resultados de ablación reportados como valores medios entre sujetos bajo el procedimiento de evaluación descrito en la Sección 6 del Protocolo. El Ancla Lineal es una referencia interna local de mapeo directo de crestas; las configuraciones estructural, semántica y completa utilizan los mismos índices de condición y definiciones de métricas. PixCorr, SSIM, Capa 2 de AlexNet, Capa 5 de AlexNet, Inception-v3 y CLIP son medidas en las que un valor mayor es mejor; EffNet y SwAV son distancias de correlación en las que un valor menor es mejor. Los valores se muestran con tres decimales.
Figura suplementaria 1: Casos representativos de reconstrucción que abarcan el rango de acuerdo CLIP para el sujeto-01. Las 200 condiciones excluidas se ordenan según la similitud del coseno entre los embeddings CLIP predichos por EEG fusionados y los embeddings reales; se muestran los seis mejores, seis casos medianos y seis peores. Cada columna empareja una muestra de imagen real del conjunto de prueba THINGS-EEG2 con su reconstrucción mediante TDE-Net. Las imágenes reales se obtuvieron de la base de datos de imágenes THINGS34. Haga clic aquí para descargar este archivo.
Figura suplementaria 2: Visualización conjunta de las representaciones CLIP de referencia y predichas por EEG en sub-01 (n = 200 condiciones por representación). (A) Representaciones CLIP de referencia. (B) Representaciones CLIP predichas por EEG. Los colores indican cinco grupos obtenidos mediante k-means ajustados a los embeddings CLIP de referencia normalizados por L2 (k = 5, n_init = 50, semilla = 7). Los grupos son de origen empírico y no corresponden a categorías semánticas predefinidas. Los embeddings de referencia y predichos se concatenan, se reducen a 50 dimensiones mediante PCA y se proyectan conjuntamente mediante t-SNE (perplejidad = 28, tasa de aprendizaje = automática, métrica euclidiana, semilla = 12). PCA, análisis de componentes principales; t-SNE, incrustación estocástica t-distribuida. Haga clic aquí para descargar este archivo.
Figura suplementaria 3: Patrones de EEG agrupados por categoría amplia de concepto de imagen para el sujeto-01. Los conceptos se asignan a Animales, conceptos relacionados con alimentos/plantas u Otros objetos. Dentro de cada categoría, las filas siguen el ordenamiento jerárquico de Ward de las incrustaciones CLIP de referencia blanqueadas y se muestrean uniformemente hasta un máximo de 30 conceptos para mejorar la legibilidad. Las columnas muestran 17 canales de EEG, con 80 puntos temporales por canal. La escala de colores (-1 a 1) representa la amplitud de EEG blanqueada, normalizada y recortada. Haga clic aquí para descargar este archivo.
Figura suplementaria 4: Topografía de la atención en los canales del cuero cabelludo del flujo semántico. Los colores muestran las magnitudes relativas normalizadas de los parámetros de ponderación de canales aprendidos en los 17 electrodos seleccionados en una proyección estándar del cuero cabelludo 10–20; los puntos y etiquetas de los electrodos identifican las posiciones de medición. La escala varía de 0 a 1 y resume la ponderación relativa de canales aprendida por el modelo. Haga clic aquí para descargar este archivo.
Discusión
Este estudio presenta un flujo de trabajo computacional modular que separa el preprocesamiento de EEG, el aprendizaje de representaciones estructurales y semánticas, la asignación latente de CLIP/VAE, la fusión y la decodificación por difusión. Esta organización por etapas permite examinar por separado las salidas intermedias de las imágenes generadas y sigue la progresión más amplia desde codificadores compactos de EEG hasta métodos de reconstrucción basados en multimodalidad y difusión6,11,12,13,14,15,16,,17,18,19,20,21,22. El análisis entre sujetos informa valores a nivel individual junto con la media entre sujetos y la desviación estándar muestral para la evaluación reservada de diez sujetos. Junto con la ablación paso a paso en Tabla 4, este análisis cuantifica los efectos específicos de cada flujo y la variación entre sujetos dentro de la canalización reportada.
Pasos críticos y solución de problemas
Los controles de implementación más importantes son el aislamiento de particiones, la normalización consistente, la preservación del índice de condiciones y los mapeos separados de CLIP/VAE. Los pesos de fusión deben seleccionarse según las condiciones de desarrollo y congelarse antes de la reconstrucción de prueba. Cuando el rendimiento sea inesperadamente bajo, primero verifique el orden y las dimensiones del arreglo, luego revise el PCC latente en bruto y específico por rama, los metadatos de fusión y las salidas de métricas a nivel de imagen. Un fallo en la alineación latente indica un problema de mapeo en etapas anteriores, mientras que imágenes variables con latentes estables pueden reflejar un comportamiento estocástico o dependiente del decodificador14,21,22,29.
Cambiar la montura de los electrodos, la frecuencia de muestreo o la ventana temporal requiere cambios correspondientes en la construcción del grafo, las características espectrales y los núcleos temporales. La calidad de la reconstrucción debe evaluarse mediante medidas complementarias de bajo nivel y semánticas, ya que ninguna puntuación única captura la fidelidad de píxeles, la estructura y el acuerdo a nivel de objeto6,11,21,22,23. La medida CLIP utilizada aquí es la precisión de identificación por pares, mientras que Figura 7 y Figura 8 utilizan el CCP a nivel latente; estas cantidades no son intercambiables.
La organización modular de TDE-Net proporciona un marco para examinar si las representaciones complementarias de EEG contribuyen de manera diferente a los aspectos estructurales y semánticos de la reconstrucción visual. Este enfoque podría facilitar la comparación sistemática de representaciones de características de EEG, objetivos latentes y decodificadores generativos, sin depender únicamente de las imágenes reconstruidas finales. Los enfoques alternativos incluyen la asignación lineal directa de EEG a variables latentes, codificadores de una sola secuencia basados en convoluciones o atención, representaciones basadas en grafos, y marcos de decodificación neuronal de extremo a extremo6,7,8,9,10,11,17,18,19,20,21,22. El presente flujo de trabajo podría ser particularmente útil para la investigación sobre decodificación de la percepción visual, análisis de representaciones neuronales e interfaces cerebro-computadora no invasivas, en las que separar las predicciones intermedias de EEG a variables latentes puede ayudar a caracterizar qué componentes contribuyen al rendimiento de la reconstrucción.
Limitaciones
Las principales limitaciones son la adquisición fija de RSVP THINGS-EEG2, los 17 canales parieto-occipitales seleccionados, las asignaciones específicas por sujeto, un único decodificador de difusión y análisis de interpretabilidad cualitativa21,22,23. El resumen de 10 sujetos aborda la variabilidad entre sujetos dentro del conjunto de datos, pero no establece transferencia entre conjuntos de datos ni entre paradigmas. Las imágenes generadas pueden contener detalles plausibles que no están respaldados por la entrada de EEG, y las visualizaciones de RSM, t-SNE, patrones de EEG y atención no establecen mecanismos neuronales causales. La ablación por etapas caracteriza las contribuciones del flujo estructural, el flujo semántico y la fusión en espacio dual bajo un anclaje compartido de EEG crudo, objetivos latentes, decodificador de difusión y protocolo de evaluación.
Directrices futuras
Dentro de estas limitaciones, los resultados apoyan la evaluación de representaciones complementarias de EEG en espacios semánticos y latentes de imágenes separados antes de la decodificación mediante difusión. Futuros trabajos deben probar conjuntos de datos independientes, adaptación a sujetos, estimaciones de incertidumbre, montajes alternativos de canales y decodificadores con controles más estrictos sobre detalles visuales no respaldados14,15,16,17,18,19,20,21,22,23. Dichos estudios son necesarios antes de extender los hallazgos actuales a contextos más amplios de neurociencia o interfaces cerebro-computadora.
Conclusión:
TDE-Net combina un ancla de EEG crudo con representaciones estructurales y semánticas del EEG, las alinea por separado con los espacios latentes VAE y CLIP, e integra las predicciones resultantes antes de la decodificación por difusión. En 10 participantes de THINGS-EEG2, las imágenes reconstruidas conservaron una correspondencia medible a nivel de píxeles, estructural y semántica con los estímulos observados, mientras que la ablación progresiva diferenció los efectos del flujo estructural, el flujo semántico y la fusión en espacio dual. Al exponer características intermedias del EEG, predicciones latentes, salidas de fusión y reconstrucciones finales, el protocolo proporciona un marco reproducible para investigar la reconstrucción visual basada en EEG y para evaluar su futura extensión a conjuntos de datos independientes y configuraciones de adquisición.
Divulgaciones
Los autores declaran que no existen intereses financieros competitivos ni relaciones personales que pudieran haber influido en este trabajo. Los autores declaran que no se utilizaron herramientas de inteligencia artificial generativa en la redacción del manuscrito, el código, el análisis de datos ni la preparación de figuras.
Agradecimientos
Esta investigación fue financiada por la Fundación Nacional de Ciencias Naturales de China (número de concesión 62433002) y (número de concesión 62476014), el Proyecto Nacional Clave de Ciencia y Tecnología (número 2021ZD0113703), el Proyecto Anual de Planificación de la Fundación Municipal de Ciencias Sociales de Beijing (número 23GLB014), el Proyecto de Construcción y Apoyo para Equipos Innovadores de Alto Nivel de las Instituciones Municipales de Beijing (número de concesión BPHR20220104), y el Programa Beijing Scholars (número de concesión 099).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Acelerar | Hugging Face | 0.30.1 | Administración del dispositivo en la canalización de difusión; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | Codificador de características de imagen utilizado para objetivos semánticos y la identificación por pares CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | Implementación de la canalización Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Equipo de Desarrollo de Matplotlib | 3.10.6 | Generación de figuras científicas; https://matplotlib.org/ |
| MNE-Python | Desarrolladores de MNE | 1.11.0 | Montaje estándar 10-20 y topografía de canales del cuero cabelludo; https://mne.tools/ |
| NumPy | Desarrolladores de NumPy | 2.3.4 | Arrays EEG, incorporaciones latentes, fusión y agregación de métricas; https://numpy.org/ |
| GPU NVIDIA GeForce RTX 4070 para portátil | NVIDIA | 8 GB; controlador 595.97 | GPU utilizada para el entrenamiento local del codificador y la reconstrucción por difusión. |
| Pillow | Bifurcación de la Biblioteca de Imágenes en Python | 11.1.0 | Carga, redimensionamiento y exportación de imágenes; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | Entorno de ejecución principal; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | Entrenamiento del codificador EEG e inferencia de redes neuronales; https://pytorch.org/ |
| scikit-image | Desarrolladores de scikit-image | 0.25.2 | Utilidades para SSIM y procesamiento de imágenes; https://scikit-image.org/ |
| scikit-learn | Desarrolladores de scikit-learn | 1.7.2 | Regresión ridge, k-means, PCA y t-SNE; https://scikit-learn.org/ |
| SciPy | Desarrolladores de SciPy | 1.16.3 | Correlación, distancia estadística y agrupamiento jerárquico; https://scipy.org/ |
| Seaborn | Desarrolladores de Seaborn | 0.13.2 | Visualización de densidad de kernel gaussiano; https://seaborn.pydata.org/ |
| Codificador EEG de flujo semántico | Autores de TDE-Net; adaptado de LMDA-Net | Commit del repositorio c99325d | Representación semántica temporal multiescala; la implementación y los metadatos del punto de control se proporcionan en el repositorio de código. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / Comunidad SD2 | sd2-community/stable-diffusion-2-1-unclip | Decodificador de difusión congelado; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Codificador EEG de flujo estructural | Autores de TDE-Net | Commit del repositorio c99325d | Representación gráfica auto-supervisada; las señales EEG crudas y las características gráficas se concatenan únicamente para la asignación estructural en el espacio VAE. |
| Scripts de alineación, fusión, evaluación y visualización de TDE-Net | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| Base de datos THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Fuente de estímulos naturales de objetos; https://things-initiative.org/ |
| Conjunto de datos THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | EEG de 64 canales de 10 sujetos; este estudio selecciona 17 canales parieto-occipitales; https://osf.io/anp5v/ |
| timm | Ross Wightman y colaboradores | 1.0.22 | Utilidades de modelos de visión preentrenados usadas en la evaluación de características; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | Backbones de evaluación AlexNet, Inception-v3 y EfficientNet; https://pytorch.org/vision/ |
| tqdm | Desarrolladores de tqdm | 4.67.1 | Informe de progreso para extracción de características, reconstrucción y evaluación; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfaces para componentes de modelos preentrenados; https://github.com/huggingface/transformers |
Referencias
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente