Este estudio integra el mapeo de dianas basado en redes, datos de expresión de GEO y acoplamiento molecular para clasificar candidatos relacionados con la combinación Zhenwu-Wuling en la insuficiencia cardíaca crónica.
Artículo de investigación
Farmacología de redes, transcriptómica de GEO y acoplamiento molecular de la decocción Zhenwu con el polvo Wuling para la insuficiencia cardíaca crónica
36 visualizaciones
⸱
11 de septiembre de 2026
En este artículo
Resumen
Resumen
Se utiliza la Decocción Zhenwu combinada con el Polvo Wuling en la insuficiencia cardíaca crónica (CHF), pero su base molecular no está completamente definida. Integraremos la identificación de objetivos basada en redes, datos transcriptómicos del Gene Expression Omnibus (GEO) y el acoplamiento molecular para priorizar objetivos y vías candidatas. Los registros de compuestos para las ocho hierbas se obtuvieron a partir de bases de datos farmacológicas y químicas y se sometieron a cribado de compuestos y objetivos. Los genes asociados a CHF se recopilaron a partir de seis recursos de enfermedades, y se examinó su superposición con los objetivos relacionados con la fórmula mediante análisis de redes de interacción de proteínas (PPI) y enriquecimiento funcional. GSE5406 proporcionó datos de expresión miocárdica para muestras con insuficiencia y sin insuficiencia. El flujo de trabajo produjo 89 compuestos seleccionados, 314 objetivos no redundantes de compuestos y 2.515 objetivos relacionados con CHF, con 143 genes compartidos. AKT1, IL6, TNF, SRC y ESR1 ocuparon los primeros lugares en la red de enfermedad-objetivo. El análisis de expresión arrojó 1.348 genes expresados diferencialmente (DEG) y seleccionó HSP90AA1 y STAT1 como candidatos principales transcriptómicos. Los términos enriquecidos se agruparon en torno a hipoxia, circulación, señalización relacionada con TNF, vías PI3K-Akt y MAPK. El acoplamiento produjo puntuaciones predichas negativas para pares representativos de constituyentes-objetivos; la puntuación más negativa se observó para STAT1 y alisol C (-9,2 kcal/mol). Estos hallazgos generan una hipótesis computacional comprobable y priorizan candidatos para validación experimental.
Introducción
La IC abarca un síndrome heterogéneo que surge a partir de anomalías miocárdicas estructurales o funcionales. Dichos cambios pueden comprometer el llenado ventricular o la eyección sistólica y a menudo se acompañan de congestión pulmonar o sistémica. Los síntomas típicos incluyen disnea, fatiga y retención de líquidos1. Un análisis retrospectivo de los datos chinos del Estudio de la Carga Global de Enfermedades desde 1990 hasta 2023 mostró que la prevalencia nacional de casos recién diagnosticados de IC aumentó en un 208,4 % durante tres décadas2.
En la medicina tradicional china (MTCh), la IC corresponde al edema cardíaco, el síndrome de disnea y el edema generalizado. Su patogénesis se describe comúnmente como deficiencia en la raíz y exceso en la rama. La deficiencia de yin, yang y qi constituye la base patológica subyacente, mientras que la acumulación interna de líquidos y la estasis sanguínea representan el exceso manifiesto. Por consiguiente, el tratamiento en la MTCh hace hincapié en calentar el yang, eliminar los líquidos retenidos, promover la circulación y resolver la estasis.
El uso combinado de la Decocción Zhenwu y el Polvo Wuling es una estrategia herbaria clásica para el manejo clínico de la IC. La Decocción Zhenwu calienta el yang y promueve la diuresis, mientras que el Polvo Wuling apoya el qi yang y regula el metabolismo de líquidos. Juntas, las dos fórmulas pueden reforzar el yang y eliminar la humedad interna. Evidencia clínica sugiere que esta combinación puede aliviar los síntomas, mejorar los indicadores de función cardíaca y ralentizar el deterioro de la IC3. Primero mapeamos los constituyentes de las fórmulas y los objetivos candidatos para la IC mediante farmacología de redes, luego utilizamos acoplamiento molecular para clasificar los pares seleccionados constituyente-objetivo. Posteriormente, se utilizaron perfiles de expresión derivados de GEO para situar los candidatos de la red en un contexto de enfermedad miocárdica y examinar las vías descendentes. El estudio proporciona un marco computacional generador de hipótesis para priorizar candidatos destinados a validación experimental posterior; sin embargo, no establece eficacia clínica ni un mecanismo validado.
Protocolo
This study analyzed public database resources and did not involve new human participants, human specimens, or animal experiments. All databases, web-based resources, software, analysis packages, visualization tools, molecular docking tools, and other computational resources used in this study, together with their details, are listed in the Table of Materials.
Formula composition and botanical provenance
The eight distinct crude drugs were aligned to current botanical and pharmacopoeial naming as follows: Aconiti Lateralis Radix Praeparata, the processed lateral root of Aconitum carmichaelii Debeaux; Poria, the sclerotium of Wolfiporia cocos (F.A.Wolf) Ryvarden & Gilb.; Atractylodis Macrocephalae Rhizoma, the rhizome of Atractylodes macrocephala Koidz.; Paeoniae Radix Alba, the root of Paeonia lactiflora Pall.; Zingiberis Rhizoma Recens, the fresh rhizome of Zingiber officinale Roscoe; Alismatis Rhizoma, the rhizome of Alisma orientale (Sam.) Juzep.; Polyporus, the sclerotium of Polyporus umbellatus (Pers.) Fr.; and Cinnamomi Ramulus, the young twig of Cinnamomum cassia (L.) J.Presl. The prescription comprised 9 g Aconiti Lateralis Radix Praeparata, 12 g Poria, 9 g Paeoniae Radix Alba, 12 g Atractylodis Macrocephalae Rhizoma (stir-fried Atractylodes), 9 g Zingiberis Rhizoma Recens, 9 g Polyporus, 15 g Alismatis Rhizoma, and 6 g Cinnamomi Ramulus; the corresponding ratio was 3:4:3:4:3:3:5:2. Aconiti Lateralis Radix Praeparata was treated as processed material. This was an entirely in silico study: no decoction batch was prepared, purchased, chemically assayed, or administered. Manufacturer, lot number, batch-specific processing records, and voucher specimens are therefore not applicable; the gram amounts define the formula composition and relative ratio, not experimental exposure. Poria and Atractylodis Macrocephalae Rhizoma are shared by the two formulae. Botanical names and medicinal-part terminology were checked against the 2025 Pharmacopoeia of the People’s Republic of China4.
Screening and target prediction of active ingredients in Zhenwu Decoction and Wuling Powder
TCMSP was queried separately for compounds recorded for Zhenwu Decoction and Wuling Powder, including Aconiti Lateralis Radix Praeparata, Poria, Atractylodis Macrocephalae Rhizoma, Paeoniae Radix Alba, Zingiberis Rhizoma Recens, Alismatis Rhizoma, Polyporus, and Cinnamomi Ramulus. Initial filtering required oral bioavailability (OB) of at least 30% and drug-likeness (DL) of at least 0.18. When a simplified molecular-input line-entry system (SMILES) record was unavailable, the corresponding structure was retrieved from a public chemical database. SMILES records were evaluated for physicochemical and drug-likeness properties. A compound passed the secondary filter when its molecular weight was ≤500, lipophilicity ≤5, hydrogen-bond donors ≤5, hydrogen-bond acceptors ≤10, at least three of the Lipinski, Ghose, Veber, Egan, and Muegge rule sets were positive, and predicted gastrointestinal absorption was high5. Eligible structures were subjected to target prediction, and only predictions with probability >0.02 were included in the target list. TCMSP and target-prediction records were combined at the herb-compound-target level, duplicate identifiers were collapsed, and gene names were standardized to official gene symbols.
Deduplication produced 646 candidate associations; 71 rows without a mapped official gene symbol were excluded, leaving 575 standardized associations. The independent herb-level integration yielded 314 nonredundant target genes. The compound and target screening criteria are supported by the TCMSP and SwissTargetPrediction source papers6,7.
Screening of disease targets for CHF
CHF-related gene entries were downloaded from GeneCards, OMIM, TTD, DisGeNET, DrugBank, and PharmGKB. The disease search used four phrases: heart failure, congestive heart failure, diastolic heart failure, and systolic heart failure. For GeneCards, entries with relevance scores below 0.20 were excluded. The six database-derived target sets were integrated after duplicate identifiers were removed, while preserving the source database for each record. All screened gene names were standardized to official gene symbols. The overlap between the formula and CHF target lists was visualized using a Venn diagram. The shared identifiers were treated as candidate formula-related targets for CHF.
TCMSP was searched on 7 February 2026; SwissTargetPrediction, GeneCards, OMIM, and DisGeNET on 10 February 2026; and PharmGKB, TTD, and DrugBank on 12 February 2026. Disease queries were entered as heart failure, congestive heart failure, heart failure, diastolic, and heart failure, systolic; the search was restricted to Homo sapiens where supported. Retrieved entries were standardized to official gene symbols before deduplication.
Construction of the protein-protein interaction (PPI) network and screening of core targets
The shared target identifiers were queried in STRING for PPI analysis. The query used Homo sapiens interactions and a confidence cutoff above 0.9. Isolated nodes were omitted, and the resulting STRING interaction data were used for network visualization and topological analysis. Candidate hubs were ranked by network topology. Betweenness, closeness, degree, and eigenvector centralities were calculated as network descriptors. Degree was the primary ranking variable, and the five highest-degree targets were retained as candidate hubs.
Official gene symbols were used for gene-level analyses, including AKT1, IL6, TNF, SRC, ESR1, BCL2, CASP3, PPARG, PTGS2, and MMP9; protein names are written in full only when needed for clarity. The initial PPI network contained 143 nodes and 584 interaction records before visualization-specific filtering; after network processing, the graph contained 143 nodes and 292 edges.
Construction of the drug-disease-component-target network
Once names were standardized, the network data were assembled and used to construct the drug-disease-component-target graph.
GO and KEGG enrichment analyses
The candidate CHF target list was submitted to Metascape for functional annotation and pathway enrichment analysis. The analysis was run for Homo sapiens. The raw p-value cutoff was set at 0.01, a minimum overlap of 3, and a minimum enrichment score of 1.5. GO bar charts and KEGG bubble plots were generated for visualization. The 143-gene input set was used for Gene Ontology biological-process (GO-BP), molecular-function (GO-MF), and KEGG enrichment analyses. The analysis thresholds were raw p < 0.01, minimum overlap 3, and minimum enrichment 1.58. The GO-CC analysis was based on a 60-gene hit list against a 30,230-gene library. Because this input differed from the 143-gene input used for the BP, MF, and KEGG analyses, the GO-CC results were reported separately and were not quantitatively pooled with the other categories.
Screening of heart failure-related targets based on the GEO database
The GSE5406 dataset9 was used for differential-expression analysis. The series included 210 myocardial samples: 108 with ischemic cardiomyopathy, 86 with idiopathic dilated cardiomyopathy, and 16 nonfailing donor controls. The GEO record identifies the platform as GPL96, the Affymetrix Human Genome U133A Array. The series matrix was already robust multi-array average (RMA)-normalized. Probes without matched SYMBOL annotations were removed after matching to the platform annotation, and rowSums(expression > 0.5) ≥ 3 was applied before limma fitting. Group levels were defined as Control, DCM, and ICM, with a no-intercept design matrix (~0 + group) and the contrasts (DCM+ICM)/2-Control, DCM-Control, and ICM-Control. Differential expression was defined as adjusted p value < 0.05 and |log2(Fold Change)| > 0.3. Because all samples were processed within one GEO series and no separate batch variable was available, no batch-correction term was introduced. Differential-expression results were visualized using heatmaps and volcano plots. DEGs were subjected to PPI analysis followed by network-based hub ranking. Docking and pose visualization were conducted for the selected targets and prescription compounds.
The GEO record identifies the platform as GPL96, the Affymetrix Human Genome U133A Array. Group levels were defined as Control, DCM, and ICM, with a no-intercept design matrix (~0 + group) and the contrasts (DCM+ICM)/2-Control, DCM-Control, and ICM-Control. The series matrix was already robust multi-array average (RMA)-normalized; probes with missing SYMBOL annotations were removed after matching to the platform annotation, and the code applies rowSums(expression > 0.5) ≥ 3 before limma fitting. Because all samples were processed within one GEO series and no separate batch variable was available, no batch-correction term was introduced.
Molecular docking verification
A three-dimensional PDB structure for each receptor was obtained from the RCSB Protein Data Bank. Protein structures were prepared by removing crystallographic waters and non-receptor ligands. Structure-data file (SDF) structures for the five highest-degree compounds were obtained from a public chemical database.
The receptor structures used for docking were AKT1/1H10 (chain A, 1.40 Å, 4IP), IL6/1ALU (chain A, 1.90 Å, TLA), TNF/1A8M (chain A, 2.30 Å, no co-crystallized ligand), SRC/1A09 (chain A, 2.00 Å, no ligand), ESR1/1A52 (chain A, 2.80 Å, EST), STAT1/1BF5 (chain A, 2.90 Å, no ligand), and HSP90AA1/3OWB (chain A, 2.05 Å, BSM). The center, box dimensions, and random seed were specified for each tested pair. The search boxes were defined to encompass the receptor for exploratory global docking.
Receptor and ligand files were prepared with the docking-preparation tools. Waters were deleted and polar hydrogens were added to receptor structures. SDF ligands were converted to PDB, then dehydrated and hydrogenated before PDBQT export. The prepared receptor-ligand files were assigned to the docking models. PDBQT files were loaded into AutoDock Vina. Vina runs were executed and scores were recorded. Scores below -5 kcal/mol were treated as comparatively more favorable and scores below -7 kcal/mol as more strongly predicted interactions10; these are not experimental thresholds. The three complexes with the best predicted scores were selected for visualization.
No search-depth or output-mode override was specified; therefore, the documented command-line defaults were used: exhaustiveness 8 and at most 9 modes. Pair-specific random seeds were used, and mode 1 (the best-scoring returned pose) was selected for representative visualization. The HSP90AA1 output-file assignment was confirmed because each mode-1 score matched the corresponding HSP90AA1 value in the docking-score matrix. Molecular dynamics simulations were not performed, so the scores are exploratory computational predictions only.
Resultados
Ingredientes activos y dianas de la Decocción Zhenwu combinada con el Polvo Wuling
Se obtuvieron registros de componentes-dianas para cada hierba. Las cantidades correspondientes de dianas por hierba fueron: Aconiti Lateralis Radix Praeparata, 178; Poria, 21; Atractylodis Macrocephalae Rhizoma, 18; Paeoniae Radix Alba, 86; Zingiberis Rhizoma Recens, 127; Alismatis Rhizoma, 96; Polyporus, 4; y Cinnamomi Ramulus, 45. Tras la normalización de símbolos y la eliminación de duplicados, el conjunto integrado relacionado con la fórmula contenía 314 genes diana no redundantes. La asignación de la dihidrocapsaicina a una hierba se informa como una asignación de base de datos y no como confirmación del origen botánico.
Adquisición de dianas terapéuticas relacionadas con la IC
A partir de las seis fuentes de datos sobre enfermedades, se recopilaron 3.563 registros brutos de dianas terapéuticas para la IC. La distribución fue la siguiente: 2.000 dianas procedentes de GeneCards, 973 de OMIM, 17 de PharmGKB, 83 de TTD, 459 de DisGeNET y 31 de DrugBank. Tras la eliminación de duplicados, la lista se redujo a 2.515 dianas únicas asociadas a la IC. La comparación entre las dos listas de dianas identificó 143 dianas comunes entre los genes relacionados con la IC y las dianas de la Decocción Zhenwu combinada con el Polvo Wuling, como se muestra en la Figura 1.
Construcción de la red de interacción de proteínas (PPI)
El grafo resultante de PPI constaba de 143 nodos y 292 aristas (grado medio, 4,08). Los cinco nodos con mayor grado fueron AKT1, TNF, IL6, SRC y ESR1. Estos nodos se conservaron como centros candidatos para el análisis de fórmula-IC (CHF) (Figura 2). En este análisis, los candidatos a centro se priorizaron según su grado dentro de la red especificada. Se utilizó la alta conectividad para la selección de candidatos y no se interpretó como prueba de importancia causal o eficacia terapéutica.
Análisis de la red fármaco-enfermedad-componente-diana
El grafo finalizado constaba de 384 nodos y 615 aristas. Aquí, el grado del nodo se definió como el número de aristas directamente conectadas. Tabla 1 informa las diez principales dianas ordenadas por valor de grado en la red de fármaco-enfermedad-componente-diana de 384 nodos y 615 aristas; la red de interacción proteína-proteína (PPI) de 143 nodos y 292 aristas se presenta por separado en la Figura 2. La Figura 3 muestra el grafo correspondiente de fármaco-enfermedad-componente-diana. En el grafo de la red, los hexágonos regulares representan los componentes activos de medicamentos herbales individuales, mientras que los rombos representan las dianas terapéuticas de los fármacos.
Análisis de enriquecimiento de GO
Se realizó un análisis de Ontología Genética (GO) sobre los 143 objetivos compartidos. El análisis identificó 1.647 términos de proceso biológico (BP) y 188 términos de función molecular (MF); el panel de componente celular (CC) se conserva de forma descriptiva, como se explica más adelante. Todos los términos enriquecidos se ordenaron por -log10(p) en orden descendente, y se seleccionaron los diez primeros términos de cada categoría de GO para su visualización. Los términos BP se enriquecieron principalmente en respuesta celular a la hipoxia, respuesta a niveles disminuidos de oxígeno, circulación sanguínea, respuesta a niveles alterados de oxígeno y procesos del sistema circulatorio. El panel descriptivo de CC mostró caveolas, lúmenes de gránulos ricos en ficolina-1, balsas lipídicas de la membrana plasmática, microdominios de membrana y lúmenes endocrinos; no se presentan estadísticas de CC a nivel de fila. Los términos MF incluyeron principalmente unión a proteínas de andamiaje, regulación de la actividad de tirosina quinasa proteica, unión al grupo hemo y regulación de la actividad de quinasa proteica. Los diez términos más enriquecidos de cada categoría de GO se visualizaron en Figura 4. Dado que el análisis de GO-CC utilizó un tamaño de entrada diferente al del análisis BP/MF/KEGG de 143 genes, las categorías se informaron por separado y no se agruparon cuantitativamente.
Análisis de enriquecimiento KEGG
Se realizó un análisis KEGG en los 143 genes diana compartidos. Las vías más enriquecidas fueron MAPK, PI3K-Akt, vías relacionadas con el cáncer, vías de infección viral, tuberculosis, influenza A, AGE-RAGE, lípidos/aterosclerosis y sarampión (Figura 5).
Selección de genes diferencialmente expresados para la insuficiencia cardíaca basada en la base de datos GEO
Se realizó una consulta en GEO utilizando el término «insuficiencia cardíaca» y se empleó el paquete limma en R para comparar los grupos con insuficiencia y sin insuficiencia. Los umbrales de selección se establecieron como valor p ajustado < 0,05 y |log2(Cambio de expresión)| > 0,3. El análisis identificó 1.348 genes diferencialmente expresados, de los cuales 568 estaban sobreexpresados y 780 estaban subexpresados. Un gráfico de volcan plot mostró los resultados de expresión diferencial, mientras que un mapa de calor ilustró el patrón de expresión en ambos grupos (Figura 6, Figura 7).
Primero, los genes diferencialmente expresados se intersecaron con genes relacionados con enfermedades obtenidos de bases de datos de enfermedades, lo que produjo 407 genes de enfermedad superpuestos. Luego, estos genes se intersecaron con genes diana de fármacos, resultando en 18 genes comunes. El análisis de interacciones proteína-proteína de los 18 genes generó una red con 18 nodos y 10 interacciones. Entre todos los nodos, HSP90AA1 y STAT1 presentaron los valores de grado más altos. Los dos candidatos centrales transcriptómicos se acoplaron a cinco compuestos prioritarios: β-sitosterol, alisol C, benzoylnapelline, dihidrocapsaicina y kaempferol. Las puntuaciones de Vina resultantes fueron negativas en todos los pares evaluados; STAT1 con alisol C produjo el valor más negativo (-9,2 kcal/mol), y cada par derivado de GEO obtuvo una puntuación inferior a -5 kcal/mol. Estos valores son predicciones comparativas de acoplamiento y no establecen afinidad, actividad ni efecto biológico.
Resultados del acoplamiento molecular
Se utilizó el acoplamiento molecular para comparar los constituyentes prioritarios con los nodos centrales relacionados con la IC desde los análisis de redes y GEO. Estos incluyeron AKT1, IL6, TNF, SRC y ESR1 obtenidos del análisis de bases de datos de enfermedades, así como los genes centrales derivados de GEO HSP90AA1 y STAT1. El procedimiento de acoplamiento se describe en la sección de Protocolo. Tabla 2 resume la matriz de puntuaciones predichas para los compuestos prioritarios y los blancos relacionados con la IC provenientes de ambas fuentes analíticas. El alisol C obtuvo puntuaciones más negativas que -7 kcal/mol con AKT1 y SRC, mientras que la benzoilnapelina superó este umbral descriptivo para TNF, AKT1 y SRC. Todos los pares compuesto-nodo derivados de GEO obtuvieron puntuaciones por debajo de -5 kcal/mol. Entre todos los pares ligando-blanco, STAT1 mostró las puntuaciones más negativas con alisol C (-9,2 kcal/mol) y benzoilnapelina (-8,7 kcal/mol), lo que indica las puntuaciones predichas más negativas entre los complejos evaluados, no la afinidad experimental.
DISPONIBILIDAD DE LOS DATOS:
En este estudio se analizaron datos de acceso público. La serie transcriptómica GSE5406 está disponible en el Gene Expression Omnibus (GEO) del NCBI bajo el número de acceso GSE5406. Todos los datos generados y conservados en el estudio, junto con los registros de análisis, se proporcionan en la carpeta de datos brutos suplementarios (Archivo Suplementario 1). Esta contiene la auditoría de compuestos y dianas, los datos originales de las dianas, archivos de redes de interacción proteína-proteína (PPI), datos de enriquecimiento verificados, el código de análisis de GSE5406, entradas, salidas, configuraciones y registros de acoplamiento molecular, visualizaciones del acoplamiento, y el manifiesto de archivos con sus leyendas.
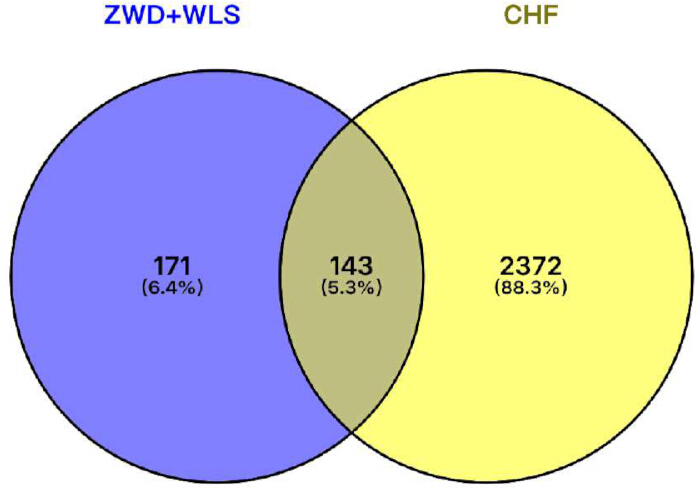
Figura 1: Diagrama de Venn de los blancos de fármacos y enfermedades. La región azul representa los blancos de la Decocción Zhenwu combinada con el Polvo Wuling, la región amarilla representa los blancos relacionados con la ICC, y la región superpuesta representa los 143 blancos compartidos. Los números indican las cantidades y porcentajes de blancos. Haga clic aquí para ver una versión más grande de esta figura.
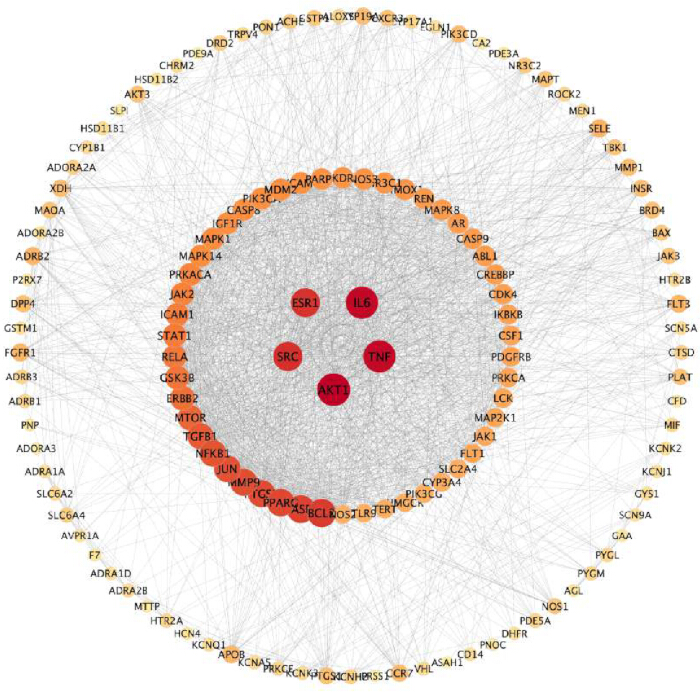
Figura 2: Red de interacciones proteína-proteína (PPI). El color y tamaño de los nodos representan el grado, donde los nodos más grandes y de color rojo más oscuro indican blancos con mayor grado. Las aristas grises representan enlaces de PPI de alta confianza. No se muestran los nodos aislados. Haga clic aquí para ver una versión más grande de esta figura.
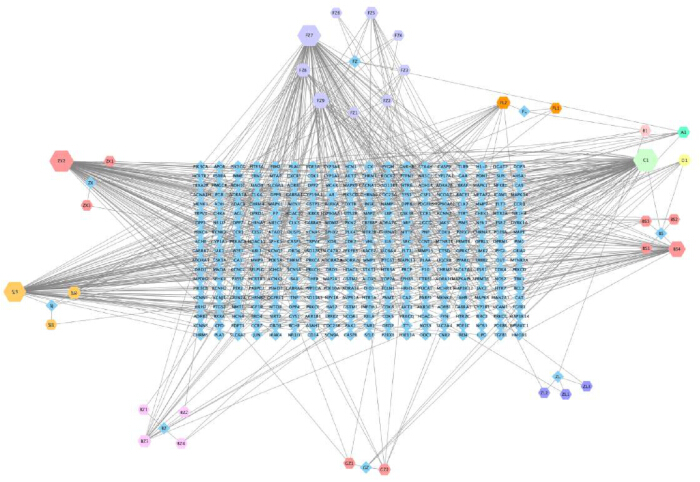
Figura 3: Red de interacciones fármaco-enfermedad-componente-diana. Los colores de los nodos identifican los ocho grupos de hierbas; las formas de los nodos distinguen hierbas, componentes y dianas; el tamaño de los nodos representa el grado; las líneas grises representan asociaciones entre hierba-componente y componente-diana. Haga clic aquí para ver una versión más grande de esta figura.
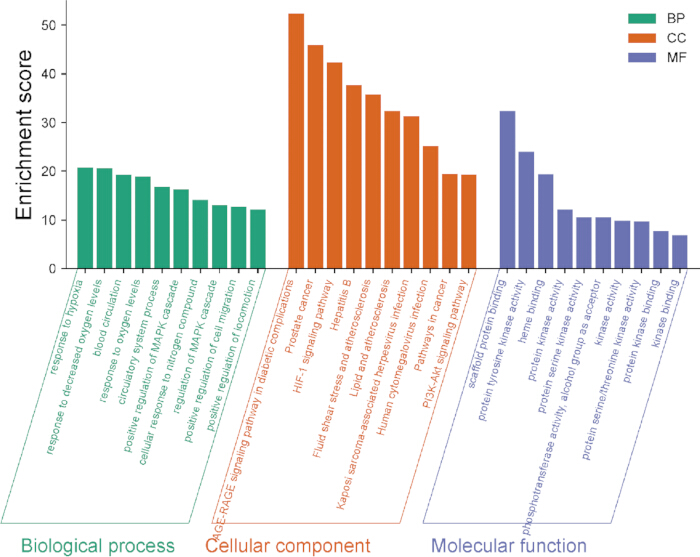
Figura 4: Análisis de enriquecimiento GO. Las barras verdes, naranjas y moradas representan proceso biológico (BP), componente celular (CC) y función molecular (MF), respectivamente. La altura de las barras indica el puntaje de enriquecimiento, y se muestran los diez primeros términos en cada categoría. El análisis de CC utilizó una lista de 60 genes detectados, mientras que los análisis de BP y MF utilizaron la entrada compartida de 143 genes; por lo tanto, las categorías se muestran de forma descriptiva y no se agrupan cuantitativamente. Haga clic aquí para ver una versión más grande de esta figura.
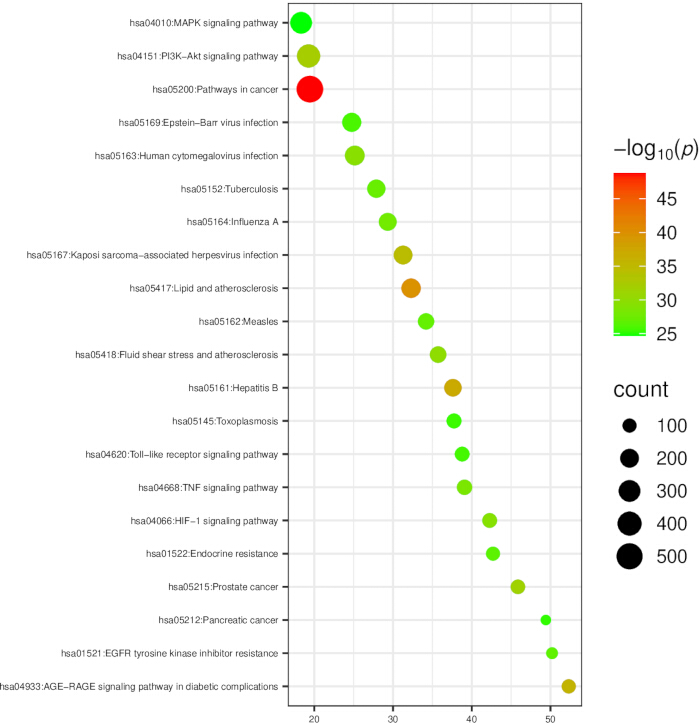
Figura 5: Análisis de enriquecimiento KEGG. La posición del punto indica la relación de enriquecimiento, el tamaño del punto muestra el número de genes y el color codifica -log10(p), donde colores más cálidos indican valores de p más pequeños. Haga clic aquí para ver una versión más grande de esta figura.
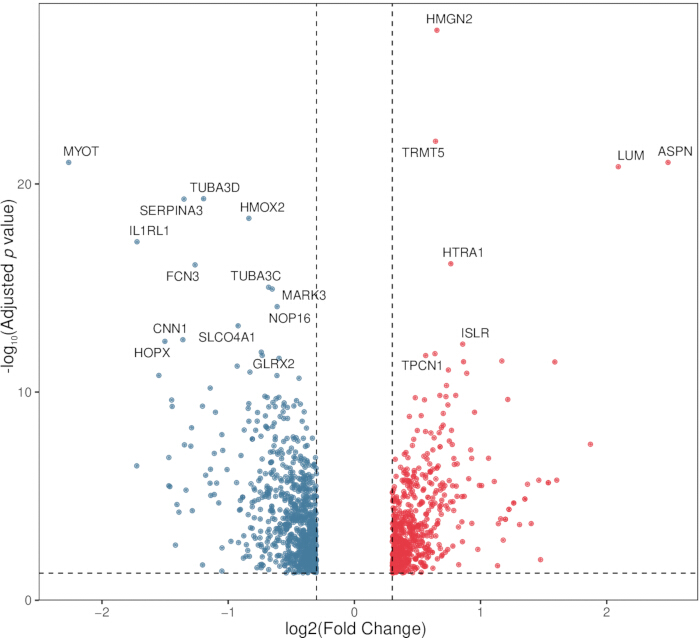
Figura 6: Gráfico de volcan de genes diferencialmente expresados. Los puntos rojos representan genes sobreexpresados y los puntos azules representan genes subexpresados en los umbrales indicados. El eje vertical es -log10(valor p ajustado), el eje horizontal es log2(Cambio de proporción) y las líneas discontinuas indican un valor p ajustado < 0,05 y |log2(Cambio de proporción)| > 0,3. Haga clic aquí para ver una versión más grande de esta figura.
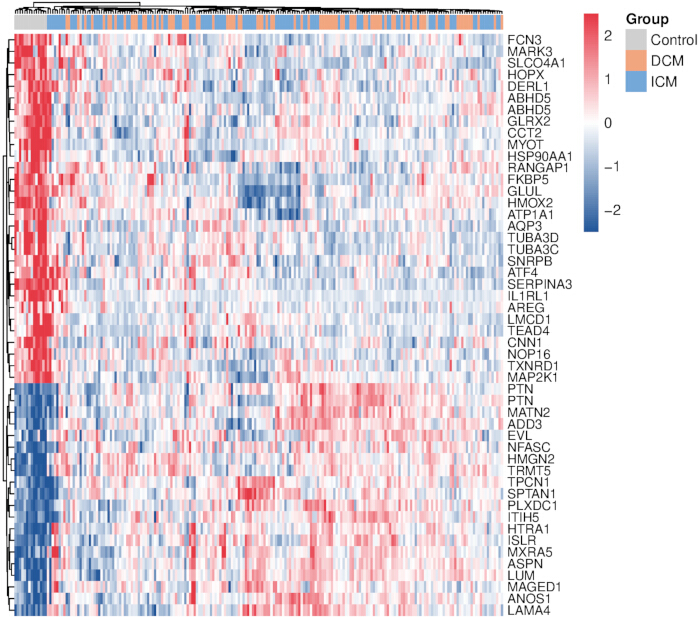
Figura 7: Mapa de calor de los genes diferencialmente expresados (DEG). El mapa de calor muestra los 50 principales DEG; el rojo y el azul indican expresión relativamente mayor y menor, respectivamente, tras la normalización por filas. La anotación superior identifica los grupos control, miocardiopatía idiopática y miocardiopatía isquémica. Haga clic aquí para ver una versión más grande de esta figura.
| Nombre de la proteína | Símbolo del gen | Grado |
| Quinasa 1 de serina/treonina AKT | AKT1 | 94 |
| Interleucina-6 | IL6 | 91 |
| Factor de necrosis tumoral | TNF | 91 |
| Protooncogén SRC, tirosina quinasa no receptora | SRC | 78 |
| Receptor de estrógeno 1 | ESR1 | 77 |
| Linfoma/leucemia de células B 2 | BCL2 | 74 |
| Caspasa 3 | CASP3 | 72 |
| Receptor gamma activado por proliferadores de peroxisomas | PPARG | 70 |
| Sintasa 2 de prostaglandina-endoperoxido | PTGS2 | 69 |
| Matrix metaloproteasa 9 | MMP9 | 68 |
Tabla 1: Genes centrales y valores de grado. Los valores de grado provienen de la red de 384 nodos y 615 enlaces de fármaco-enfermedad-componente-diana, no de la red independiente de interacción de proteínas (PPI) de 143 nodos y 292 enlaces. Se utilizan los símbolos oficiales de los genes.
| Gen diana | β-sitosterol | Alisol C | Benzoylnapelline | Dihidrocapsaicina | Kaempferol |
| AKT1 | -6.2 | -7.0 | -7.2 | -4.8 | -5.9 |
| IL6 | -5.7 | -6.6 | -6.1 | -4.0 | -4.6 |
| TNF | -5.5 | -6.8 | -7.6 | -5.0 | -6.3 |
| SRC | -5.2 | -8.0 | -8.0 | -5.6 | -6.9 |
| ESR1 | -3.2 | -6.7 | -7.9 | -4.3 | -3.2 |
| STAT1 | -6.1 | -9.2 | -8.7 | -5.3 | -8.6 |
| HSP90AA1 | -6.4 | -6.9 | -7.1 | -5.4 | -7.3 |
Tabla 2: Puntuaciones de acoplamiento molecular. Los valores son puntuaciones predichas de acoplamiento en kcal/mol; valores más negativos indican poses predichas más favorables dentro de esta ejecución y no establecen afinidad biológica ni actividad.
Archivo complementario 1: Carpeta de datos brutos complementarios. Haga clic aquí para descargar este archivo.
Discusión
La IC requiere un manejo clínico a largo plazo y a menudo implica regímenes medicamentosos complejos. Estudios realizados por Wang JX y Zhang S11 y otros estudios indican que la farmacoterapia convencional combinada a largo plazo puede reducir la adherencia al tratamiento. Una mala adherencia puede aumentar el riesgo de reingresos y de resultados emocionales adversos. Los medicamentos disponibles se centran principalmente en el control de los síntomas y en la desaceleración del remodelado ventricular. Las Guías Nacionales de 2023 para el Manejo de la Insuficiencia Cardíaca en China12 recomiendan añadir el estimulador del ciclasa guanilato soluble vericiguat al tratamiento médico óptimo (GDMT) en pacientes con insuficiencia cardíaca recientemente empeorada. Sin embargo, aún persisten varios desafíos en el manejo de la insuficiencia cardíaca. Los cardiomiocitos están terminalmente diferenciados y tienen una capacidad regenerativa limitada, por lo que la lesión miocárdica a menudo progresa de forma irreversible. Los medicamentos existentes ralentizan principalmente la fibrosis miocárdica y el remodelado ventricular, en lugar de revertir completamente el daño estructural ya establecido.
En la teoría de la MTC, la patogénesis de la IC está estrechamente asociada con la disregulación del qi y la sangre. El Consenso de Expertos sobre la Nomenclatura en MTC de la Insuficiencia Cardíaca13 define «Xin Shui» (edema cardíaco) y «Fei Yin» (retención de líquidos en el pulmón) como términos estandarizados de enfermedad en MTC para la IC. Ambas fórmulas calientan el yang y promueven la excreción de líquidos, aunque sus indicaciones tradicionales enfatizan diferentes localizaciones y patrones de enfermedad. Tradicionalmente, la Decocción Zhenwu se utiliza para calentar el yang y eliminar la humedad retenida en el déficit de yang del bazo y riñón. Registrada por primera vez en los apartados 82 y 316 del Tratado sobre Enfermedades Febriles14, la fórmula se usó originalmente en enfermedades del estadio yang complicadas por el deterioro del yang inducido por sudoración excesiva, y en el síndrome shaoyin caracterizado por déficit de yang y acumulación de agua. La patogénesis fundamental tratada por la Decocción Zhenwu es la insuficiencia del yang renal con retención difusa de líquidos. Sus acciones tradicionales se describen como calentar el riñón, fortalecer el yang, regular el qi y promover la eliminación de líquidos. El Compendio de Fórmulas del Gabinete Dorado14 también registra el uso de la Decocción Zhenwu en casos de retención de líquidos difusa, ya que la pesadez y el dolor en las extremidades en esta condición coinciden con el alcance terapéutico de la fórmula. El Polvo Wuling se registra en los apartados 71, 72, 73, 74 y 141 del Tratado sobre Enfermedades Febriles. Principalmente se utiliza en el síndrome de retención de líquidos en la vejiga del Taiyang. Su patogénesis implica factores patógenos externos no resueltos en el estadio Taiyang, acumulación de agua en el jiao inferior, transformación alterada del qi en el triple jiao y distribución desordenada de los líquidos corporales. Clínicamente, estos cambios se manifiestan como sed con deseo de beber y disuria. En casos graves, la acumulación excesiva de líquidos obstruye el triple jiao y rebosa, produciendo reflujo de líquidos con vómitos tras beber. Por consiguiente, el Polvo Wuling se utiliza para restablecer la transformación del qi y facilitar la excreción del agua.
La investigación farmacológica de Zheng Minghao et al. sobre la Decocción Zhenwu para la IC grave15 informó un mayor PVS y un menor PEDI después de la exposición a aconitina/mesaconitina, hallazgos interpretados como una mejora en el desempeño sistólico y diastólico. En ratas con IC grave, la paeoniflorina se asoció con la modulación de la señalización TGF-β1/Smad, menor remodelación y mejor función cardíaca. Se ha relacionado el atractilenólido III y la kaempferol con la reducción de la apoptosis de los cardiomiocitos, mientras que se ha reportado que el ácido poricoico y el gingerol presentan acciones antiinflamatorias y antioxidantes. La higenamina y la paeoniflorina también podrían mejorar el ciclo anormal del calcio al reducir la concentración intracelular de calcio. Chen Jiye et al.16 informaron que los principales componentes bioactivos del Polvo Wuling, la hederaegenina y el β-sitosterol, confieren protección cardiovascular al reducir el colesterol, regular la función endotelial, aumentar la capacidad antioxidante y disminuir la inflamación. Los pacientes con IC grave en estadio terminal a menudo presentan patrones mixtos de deficiencia y exceso. La deficiencia de yang del corazón y riñón representa la patogénesis fundamental, mientras que la retención severa de líquidos representa la manifestación secundaria. Cuando el líquido retenido se extiende a través del triple calentador, la invasión del calentador superior, el corazón y el pulmón provoca palpitaciones, tos y disnea. En casos graves, el líquido que afecta al corazón y al pulmón conduce a ortopnea. La acumulación de líquido en el calentador medio altera el transporte y la transformación del bazo y el estómago, causando anorexia y distensión gástrica. La retención de líquidos en el calentador inferior provoca edema de tobillo y disuria. Este patrón proporciona la justificación de la MTC para considerar que la combinación aborda tanto la deficiencia fundamental como la retención secundaria de líquidos. Evidencias crecientes sugieren que las fórmulas herbales chinas podrían tratar la IC grave mediante la regulación de múltiples vías y dianas, incluyendo la función mitocondrial y el metabolismo energético miocárdico16, así como las vías de señalización TGF-β17 y NF-κB18.
La justificación de la compatibilidad de la fórmula es farmacológica y teórica según la MTC. El presente flujo de trabajo computacional no evaluó la sinergia, estableció nuevos efectos farmacológicos de la combinación ni comparó la fórmula con la terapia médica dirigida por guías. Tampoco evaluó las interacciones hierba-fármaco, las relaciones exposición-respuesta ni la toxicidad fuera del blanco. Estos límites impiden que los resultados actuales respalden recomendaciones de sustitución o combinación de tratamientos.
El presente estudio sugiere que la Decocción Zhenwu combinada con el Polvo Wuling podría influir en procesos relacionados con la ICAG a través de los efectos coordinados predichos de múltiples constituyentes bioactivos, incluyendo β-sitosterol (BS), alisol C, benzoylnapellina, dihidrocapsaicina (DHC) y kaempferol (KAE). El BS es un fitoesteroide ampliamente distribuido en hierbas medicinales y se deriva en esta fórmula de Paeoniae Radix Alba, Zingiberis Rhizoma Recens y Cinnamomi Ramulus19. Debido a que su estructura se asemeja al colesterol, el BS compite con el colesterol por sitios de unión, reduce el colesterol libre sérico y promueve la lipólisis20. También posee actividades antiaterosclerótica, antioxidante, antiinflamatoria y antibacteriana21. El registro en la base de datos asignó la dihidrocapsaicina a Zingiberis Rhizoma Recens, y estudios previos22,23 respaldan sus propiedades antiinflamatorias, antiapoptóticas y de mitigación de lesiones por isquemia-reperfusión. Chen YM et al.24 identificaron Raf-1 como un blanco directo de la dihidrocapsaicina y relacionaron la formación del complejo Raf-1/ASK1 con una menor estrés oxidativo y apoptosis de cardiomiocitos tras un infarto agudo de miocardio. El kaempferol es un ingrediente bioactivo principal de Paeoniae Radix Alba. Estudios existentes sugieren que el KAE protege a los cardiomiocitos contra la autofagia excesiva mediante la regulación positiva de la cascada PI3K/Akt/mTOR25, la supresión de la expresión de proteínas de canales de calcio intracelulares26 y la inhibición de la vía de señalización MAPK/ERK27. MOL002410 fue identificado como benzoylnapellina. El estudio citado sobre la benzoilaconina28 no respalda experimentalmente el registro distinto de benzoylnapellina obtenido por acoplamiento molecular. En conjunto, estos componentes podrían contribuir al tratamiento de la ICAG mediante mecanismos antiinflamatorios, antioxidantes y reductores de lípidos. Esto respalda el perfil regulador multivía y multitarget de la Decocción Zhenwu combinada con el Polvo Wuling.
La raíz de aconito procesada puede contener alcaloides del tipo aconitina, pero este estudio no cuantificó la exposición a los componentes, las relaciones dosis-respuesta ni la toxicidad. Por consiguiente, la red terapéutica predicha no puede interpretarse como una evaluación de seguridad, y los posibles efectos fuera del blanco permanecen sin resolver.
La clasificación por grado en la red de interacción de proteínas (PPI) colocó a estos cinco candidatos en los primeros lugares: AKT1, IL6, TNF, SRC y ESR1. AKT1, un nodo central en la cascada PI3K/Akt/mTOR, se encontraba entre los candidatos con mayor grado. Esta cascada participa en la proliferación, la angiogénesis y el metabolismo de glucolípidos29. Wang X et al.30 detectaron una expresión más alta de AKT1 en ratas con insuficiencia cardíaca en comparación con ratones controles sanos. Lou WZ et al.31 informaron que la kaempferol y sus componentes relacionados suprimen la vía PI3K/Akt a través del nodo clave AKT1, inhibiendo así la proliferación de fibroblastos cardíacos y retrasando la progresión de la insuficiencia cardíaca congestiva (CHF) y el remodelado ventricular. IL-6 y TNF son citocinas inflamatorias clásicas. Investigaciones previas32 han asociado citocinas y quimiocinas inflamatorias con el remodelado ventricular y la disfunción miocárdica en diversos fenotipos de insuficiencia cardíaca. En una cohorte de 1.086 pacientes, Berger et al.33 relacionaron concentraciones más altas de IL-6 con resultados cardiovasculares adversos y niveles elevados de NT-proBNP. TNF está estrechamente relacionado con la angiogénesis y la trombosis, ambos procesos que contribuyen al remodelado cardíaco y ventricular. TNF podría servir como marcador biológico del inicio de la CHF34, y su sobreexpresión se asocia con eventos cardiovasculares adversos, estratificación del riesgo de lesión miocárdica y pronóstico. SRC participa en la adhesión celular, la proliferación y la generación de especies reactivas de oxígeno35. Hay evidencia de que la sobreexpresión de SRC amplifica la señalización del receptor beta-adrenérgico (β-AR), activa la cascada β-AR/Src/ERK y media el remodelado ventricular36. Otros estudios han propuesto a SRC como un objetivo potencial para la intervención en enfermedades cardiovasculares37. Se reconoce ampliamente que el estrógeno es un factor cardioprotector con propiedades antiinflamatorias, antioxidantes y antiateroscleróticas38. Por lo tanto, ESR1, que codifica el receptor de estrógeno alfa, es un objetivo terapéutico potencial para la protección cardíaca. Fukuma N et al.39 aclararon los efectos cardioprotectores de los receptores de estrógeno mediante la inhibición selectiva de la señalización no genómica del receptor de estrógeno alfa en ratones. A diferencia de estudios centrados en un solo compuesto o vía, el flujo de trabajo actual cruzó la cobertura de objetivos derivada de la fórmula con una red PPI de la enfermedad y el contexto transcriptómico miocárdico. Esta integración reduce las prioridades de los candidatos, pero sigue siendo de tipo asociativo. El criterio de gen central identifica candidatos altamente conectados para estudios posteriores, sin demostrar su importancia causal.
El perfil compartido de KEGG estuvo dominado por las vías MAPK, PI3K-Akt, lípidos/aterosclerosis, TNF, receptor tipo Toll y señalización AGE-RAGE. Conjuntamente, estas vías se relacionan con procesos centrales en la IC, incluyendo hipertrofia, fibrosis, inflamación, estrés oxidativo y remodelación ventricular. La señalización MAPK coordina respuestas proliferativas, apoptóticas, inflamatorias y fibroticas40. Una actividad excesiva de MAPK puede promover la fibrosis miocárdica y acelerar la remodelación ventricular41, empeorando así la insuficiencia cardíaca. La señalización PI3K-Akt participa en el crecimiento celular, apoptosis, migración y angiogénesis. Su papel en la remodelación del citoesqueleto también ha convertido a esta vía en un objetivo candidato en biología del cáncer42. Bajo condiciones fisiológicas, la vía PI3K-Akt protege al corazón al mejorar la función mitocondrial, reducir el estrés oxidativo e inhibir la apoptosis de los cardiomiocitos. Estudios publicados43 han reportado una actividad suprimida de PI3K-Akt en cardiomiocitos durante la insuficiencia cardíaca, lo cual podría desencadenar disfunción mitocondrial y alteraciones en el metabolismo energético. La inhibición de esta vía también puede activar cascadas profibróticas como la señalización TGF-β y las vías de caspasas relacionadas con la apoptosis, promoviendo así la remodelación ventricular y la pérdida de cardiomiocitos. La dislipidemia está asociada con la enfermedad coronaria, una causa subyacente frecuente de insuficiencia cardíaca clínica. La guía china de 2024 sobre insuficiencia cardíaca incluye tanto la dislipidemia como la enfermedad coronaria entre los factores de riesgo compartidos de IC44. Esta guía otorga a la terapia temprana de reducción de lípidos una recomendación Clase IA para la prevención. Estudios posteriores realizados por Li Tingting y Zhou Li et al.45,46, que incluyeron 70 y 150 pacientes con insuficiencia cardíaca respectivamente, reportaron una disminución progresiva del HDL-C sérico conforme empeoraba la función cardíaca. Sin embargo, la variación de los lípidos séricos no se correlacionó significativamente con el pronóstico. Esto sugiere que la dislipidemia podría no dañar directamente a los cardiomiocitos ni alterar la función cardíaca. Por lo tanto, la vía de lípidos y aterosclerosis podría ser más relevante para la prevención e interpretación etiológica de la IC que para la lesión miocárdica directa. El TNF-α es una citocina inflamatoria pivotal y un impulsor clave en la iniciación y progresión de la IC34. Concentraciones elevadas de TNF-α suprimen la contractilidad miocárdica y se asocian positivamente con la mortalidad por todas las causas47. El sistema nervioso simpático es un mediador neurohumoral importante en la remodelación ventricular. Una regulación excesiva del TNF-α puede alterar la función del nervio simpático, inducir disfunción de los receptores β, estimular la liberación de catecolaminas48 y agravar la remodelación ventricular. Las vías de los receptores tipo Toll detectan PAMPs y DAMPs, iniciando así la señalización inmune innata49. La activación persistente puede promover inflamación y lesión miocárdica. Ye S et al.50 reportaron que la deficiencia de TLR2 en cardiomiocitos atenuó la inflamación, hipertrofia y fibrosis intersticial inducidas por Ang II. La mejora coincidió con una activación más débil de NF-κB/MAPK en la vía descendente y una menor lesión miocárdica. La biología AGE-RAGE también es relevante fuera del contexto de la diabetes. Bajo condiciones de envejecimiento, isquemia, sobrecarga de presión o estrés cardíaco inflamatorio, los AGE pueden acumularse y activar RAGE, amplificando el estrés oxidativo, la inflamación y la fibrosis que contribuyen a la remodelación ventricular y a la IC51. La farmacología de redes capta la amplitud de la cobertura componente-diana derivada de fórmulas, mientras que GEO proporciona el contexto del tejido enfermo. Por lo tanto, su intersección es útil para la priorización de hipótesis en investigaciones complejas de fórmulas de MTC, aunque no debe describirse como una validación transcriptómica o farmacológica.
Limitaciones: Además de la ausencia de validación in vitro e in vivo, este estudio utilizó un único conjunto de datos de microarrays de descubrimiento y dependió de anotaciones de bases de datos y umbrales de cribado. Las cuadrículas de acoplamiento que abarcan receptores amplios apoyan la clasificación exploratoria en lugar de la confirmación de sitios de unión, y no se conservaron las versiones exactas de los parches del paquete. Además, se conservaron archivos PDBQT de poses de salida solo para cinco pares compuesto-HSP90AA1; no se conservaron los archivos de poses de salida para los 30 pares restantes de diana-compuesto. El análisis de GO-CC utilizó una lista de 60 genes detectados en lugar de los 143 genes de entrada usados para BP/MF/KEGG; por lo tanto, estas categorías no se agruparon cuantitativamente. No se contó con un conjunto independiente de validación transcriptómica ni con una simulación de dinámica molecular.
Direcciones futuras: Los trabajos futuros deben validar HSP90AA1, STAT1 y los compuestos priorizados en modelos de hipoxia/reoxigenación de cardiomiocitos y en modelos animales apropiados, comparar la fórmula con terapias dirigidas por guías clínicas, evaluar las interacciones entre hierbas y fármacos y la toxicidad relacionada con el acónito, y comprobar las predicciones de acoplamiento mediante ensayos bioquímicos o celulares ortogonales.
En resumen, la integración de la farmacología de redes, datos transcriptómicos del miocardio, análisis de enriquecimiento y acoplamiento molecular permitió priorizar constituyentes, dianas y vías candidatas potencialmente asociadas con la Decocción Zhenwu combinada con el Polvo Wuling en la IC. La convergencia entre predicciones de dianas relacionadas con la fórmula y cambios expresivos asociados a la enfermedad identificó a HSP90AA1 y STAT1 como candidatos para investigaciones posteriores, mientras que el análisis de acoplamiento priorizó pares seleccionados de constituyente-diana para pruebas experimentales. Estos hallazgos proporcionan un marco generador de hipótesis, más que evidencia de eficacia clínica o un mecanismo molecular validado, y requieren confirmación en sistemas experimentales independientes.
Divulgaciones
Los autores no declaran intereses competitivos relacionados con este estudio.
Agradecimientos
No aplicable.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| AutoDock Vina | CCSB-Scripps | v1.2.6 | Versión de línea de comandos utilizada; versión oficial actual v1.2.7; las configuraciones usaron los valores predeterminados de exhaustividad 8 y num_modes 9. https://github.com/ccsb-scripps/AutoDock-Vina/releases |
| AutoDockTools | The Scripps Research Institute | v1.5.7 | Preparación de receptor/ligando; versión utilizada en el análisis. https://autodock.scripps.edu/ |
| Bioconductor | Bioconductor Project | versión compatible 3.16 | Ambiente compatible con R 4.2; versión actual 3.23. https://bioconductor.org/about/release-announcements/ |
| Cytoscape Desktop | Cytoscape Consortium | v3.7.1 | Versión utilizada para visualización y análisis de redes; versión actual v3.10.4. https://cytoscape.org/download.html |
| DisGeNET | MedBioinformatics Solutions | v25.4 | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-10. https://disgenet.com/ |
| DrugBank | OMx Personal Health Analytics | v6.0 | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-12. https://go.drugbank.com/ |
| GeneCards | Weizmann Institute of Science | Base de datos web | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-10. https://www.genecards.org/ |
| GEO / GSE5406 | NCBI | GSE5406; GPL96 | Serie de microarreglos normalizada por RMA del ventrículo izquierdo humano. https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE5406 |
| hgu133a.db | Bioconductor | Ambiente Bioconductor 3.16 | Anotación de sondas del genoma humano Affymetrix U133A; la versión exacta del parche no se conservó. https://bioconductor.org/packages/hgu133a.db/ |
| limma | Bioconductor | Ambiente Bioconductor 3.16 | Análisis de expresión diferencial; la versión exacta del parche no se conservó. https://bioconductor.org/packages/limma/ |
| MacBook | Apple | Procesador M4 | Estación de trabajo computacional local; la especificación de memoria no se conservó. https://www.apple.com/mac/ |
| Metascape | Metascape | v3.5 | Enriquecimiento GO/KEGG; la marca de tiempo exacta de acceso no se conservó. https://metascape.org/ |
| Microsoft Excel | Microsoft | Aplicación de escritorio | Curación/exportación de datos; la versión de la aplicación no se conservó. https://www.microsoft.com/microsoft-365/excel |
| OMIM | Johns Hopkins University | Base de datos web | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-10. https://www.omim.org/ |
| Open Babel | Open Babel Project | Versión no conservada | Conversión de estructuras en el flujo de trabajo de acoplamiento molecular. https://openbabel.org/ |
| PharmGKB | PharmGKB | Base de datos web | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-12. https://www.pharmgkb.org/ |
| PubChem | NCBI | Base de datos web | SMILES y completación de estructuras. https://pubchem.ncbi.nlm.nih.gov/ |
| PyMOL | Schrödinger | Versión no conservada | Preprocesamiento de proteínas y visualización de conformaciones. https://www.pymol.org/ |
| R | R Foundation | 4.2.0+ | Familia de versiones registrada para el análisis; versión actual 4.6. https://www.r-project.org/ |
| RCSB Protein Data Bank | RCSB PDB | Archivo web | Estructuras cristalinas de proteínas. https://www.rcsb.org/ |
| RStudio | Posit | 2026.04.0+526 | IDE de análisis registrado en la nota de revisión. https://posit.co/download/rstudio-desktop/ |
| STRING | STRING Consortium | Servicio web | Homo sapiens; confianza >0.9; metadatos de versión/sesión no conservados. https://string-db.org/ |
| SwissADME | SIB Swiss Institute of Bioinformatics | Servicio web | Examen de ADME y reglas de Lipinski; versión local no aplicable. https://www.swissadme.ch/ |
| SwissTargetPrediction | SIB Swiss Institute of Bioinformatics | Actualización principal de 2019 | Homo sapiens; probabilidad >0.02; búsqueda realizada el 2026-02-10. https://www.swisstargetprediction.ch/ |
| TCMSP | Northwest A&F University | v2.3 | Recuperación de compuestos; búsqueda realizada el 2026-02-07. https://tcmsp-e.com/ |
| TTD | Therapeutic Target Database | versión 2026 | Recuperación de genes asociados a ICC; búsqueda realizada el 2026-02-12. https://ttd.idrblab.cn/ |
| UniProtKB | UniProt Consortium | versión 2026_01 | Normalización revisada de símbolos génicos de Homo sapiens. https://www.uniprot.org/ |
| Venny | CNB-CSIC | v2.1.0 | Visualización de intersección de conjuntos de dianas. https://bioinfogp.cnb.csic.es/tools/venny/ |
Referencias
- McDonagh TA, et al. 2021 ESC Guidelines for the diagnosis and treatment of acute and chronic heart failure. Eur Heart J. 2021;42(36):3599-3726.
- Yang X, et al. The evolving burden of heart failure in China: a 34-year subnational analysis of trends and causes from the Global Burden of Disease Study 2023. Mil Med Res. 2025;12(1):65.
- Tang KH. Study on Zhenwu Decoction combined with Wuling Powder in the treatment of heart failure with yang deficiency and water flooding syndrome. Chin Med Guide. 2024;22(14):153-155.
- National Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science Press; Beijing; 2025.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717.
- Ru J, et al. TCMSP: a database of systems pharmacology for drug discovery from herbal medicines. J Cheminform. 2014;6:13.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47(W1):W357-W364.
- Zhou Y, et al. Metascape provides a biologist-oriented resource for the analysis of systems-level datasets. Nat Commun. 2019;10:1523.
- Hannenhalli S, et al. Transcriptional genomics associates FOX transcription factors with human heart failure. Circulation. 2006;114(12):1269-1276.
- Shahzadi Z, et al. Network pharmacology and molecular docking: combined computational approaches to explore the antihypertensive potential of Fabaceae species. Bioresour Bioprocess. 2024;11:53.
- Wang JX, Zhang S. Correlation between medication adherence, coping styles and depression in patients with chronic heart failure. J Int Psychiatry. 2026;53(1):225-228.
- National Center for Cardiovascular Diseases, Heart Failure Professional Committee of National Cardiovascular Experts Committee, Heart Failure Committee of Chinese Medical Doctor Association, et al. 2023 National guidelines for heart failure. Chin J Heart Fail Cardiomyopathies. 2023;7(4):215-311.
- Dong GJ, Wei Y. Expert consensus on TCM disease nomenclature of heart failure. Chin Arch Tradit Chin Med. 2025;43(7):253-258.
- Zhang ZJ. Treatise on Febrile Diseases. Qian CC, collator. People's Medical Publishing House; Beijing; 2005. p. 22-23.
- Zheng MH, Guo D. Research progress on active ingredients and mechanism of Zhenwu Decoction in the treatment of chronic heart failure. China J Tradit Chin Med Pharm. 2024;39(11):6007-6011.
- Chen L, Yu D, Ling S, Xu JW. Mechanism of tonifying-kidney Chinese herbal medicine in the treatment of chronic heart failure. Front Cardiovasc Med. 2022;9:988360.
- Wang Y, et al. A review of Chinese herbal medicine for the treatment of chronic heart failure. Curr Pharm Des. 2017;23(34):5115-5124.
- He Y, et al. Clinical evidence and potential mechanisms of traditional Chinese medicine for the treatment of chronic gastritis: an updated systematic review and meta-analysis. J Herb Med. 2023;42:100761.
- Wang H, et al. β-Sitosterol as a promising anticancer agent for chemoprevention and chemotherapy: mechanisms of action and future prospects. Adv Nutr. 2023;14(5):1085-1110.
- Dwivedi J, et al. Aspects of β-sitosterol's pharmacology, nutrition and analysis. Curr Pharm Biotechnol. 2025;26(14):2234-2256.
- Khan Z, et al. Multifunctional roles and pharmacological potential of β-sitosterol: emerging evidence toward clinical applications. Chem Biol Interact. 2022;365:110117.
- Jittiwat J, Suksamrarn A, Tocharus C, Tocharus J. Dihydrocapsaicin effectively mitigates cerebral ischemia-induced pathological changes in vivo, partly via antioxidant and anti-apoptotic pathways. Life Sci. 2021;283:119842.
- Lai Y, et al. Dihydrocapsaicin suppresses the STING-mediated accumulation of ROS and NLRP3 inflammasome and alleviates apoptosis after ischemia-reperfusion injury of perforator skin flap. Phytother Res. 2024;38(5):2539-2559.
- Chen Y, et al. Dihydrocapsaicin attenuates oxidative stress and apoptosis in acute myocardial infarction via promoting Raf-1/ASK1 complex formation. Phytomedicine. 2025;146:157126.
- Li YX, Liu SY. Kaempferol alleviates myocardial injury in rats with coronary heart disease via regulating the PI3K/AKT/mTOR pathway. Chin J Histochem Cytochem. 2025;34(5):439-445.
- Wu JP, Chen JJ, Yuan Q, et al. Effects and mechanisms of kaempferol on cardiomyocyte apoptosis induced by hypoxia/reoxygenation injury. Shaanxi Med J. 2024;53(1):3-7,18.
- Chen MJ, Li XD, Wang NN. Effects and mechanisms of kaempferol on cardiac function in rat models of chronic heart failure. Prog Anat Sci. 2023;29(1):18-20,24.
- Zhou WM, Lang SK, Ge X, et al. Benzoylaconine alleviates oxygen-glucose deprivation/reoxygenation-induced cardiomyocyte injury via the phosphatidylinositol 3-kinase/protein kinase B pathway. Chin J Geriatr Heart Brain Vessel Dis. 2025;27(2):211-216.
- Brand CS, Lighthouse JK, Trembley MA. Protective transcriptional mechanisms in cardiomyocytes and cardiac fibroblasts. J Mol Cell Cardiol. 2019;132:1-12.
- Wang X, Chen ZQ, Li L, et al. Effects of Zhenwu Decoction on cardiomyocyte apoptosis and PI3K-AKT pathway in heart failure rats. Chin J Comp Med. 2022;32(7):27-33,57.
- Lou WZ, Huang SS, Chen BS. Mechanism analysis of Ginkgo biloba leaves against chronic heart failure. Zhejiang Clin Med J. 2026;28(1):32-37.
- Hanna A, Frangogiannis NG. Inflammatory cytokines and chemokines as therapeutic targets in heart failure. Cardiovasc Drugs Ther. 2020;34(6):849-863.
- Berger M, et al. IL-6 and hsCRP predict cardiovascular mortality in patients with heart failure with preserved ejection fraction. ESC Heart Fail. 2024;11(6):3607-3615.
- Zhang H, Dhalla NS. The role of pro-inflammatory cytokines in the pathogenesis of cardiovascular disease. Int J Mol Sci. 2024;25(2):1082.
- Wu PL, Wei M, Zhu W. Src signaling pathway and its role in the pathophysiology of heart failure. Int J Cardiovasc Dis. 2013;40(1):6-8,15.
- Li W, et al. Src tyrosine kinase promotes cardiac remodeling induced by chronic sympathetic activation. Biosci Rep. 2023;43(10):BSR20231097.
- Zhai Y, et al. Src-family protein tyrosine kinases: a promising target for treating cardiovascular diseases. Int J Med Sci. 2021;18(5):1216-1224.
- Qian C, Liu J, Liu H. Targeting estrogen receptor signaling for treating heart failure. Heart Fail Rev. 2024;29(1):125-131.
- Fukuma N, et al. Estrogen receptor-α non-nuclear signaling confers cardioprotection and is essential to cGMP-PDE5 inhibition efficacy. JACC Basic Transl Sci. 2020;5(3):282-295.
- Sun Y, et al. Signaling pathway of MAPK/ERK in cell proliferation, differentiation, migration, senescence and apoptosis. J Recept Signal Transduct Res. 2015;35(6):600-604.
- Zhang Z, et al. Targeting MAPK-ERK/JNK pathway: a potential intervention mechanism of myocardial fibrosis in heart failure. Biomed Pharmacother. 2024;173:116413.
- Deng S, et al. PI3K/AKT signaling tips the balance of cytoskeletal forces for cancer progression. Cancers (Basel). 2022;14(7):1652.
- Ghafouri-Fard S, et al. Interplay between PI3K/AKT pathway and heart disorders. Mol Biol Rep. 2022;49(10):9767-9781.
- Cardiovascular Branch of Chinese Medical Association, Cardiovascular Physicians Branch of Chinese Medical Doctor Association, Heart Failure Professional Committee of Chinese Medical Doctor Association, et al. 2024 Chinese guidelines for the diagnosis and treatment of heart failure. Chin J Cardiovasc Dis. 2024;52(3):235-275.
- Li TT, et al. Correlations of BNP, Hcy and blood lipid levels with cardiac function and prognosis in elderly patients with chronic heart failure. Chin J Evid Based Cardiovasc Med. 2021;13(9):1050-1053.
- Zhou L. Clinical study on TCM syndrome types, blood lipid levels and cardiac function in 150 patients with chronic heart failure. Guide China Med. 2024;22(12):77-79.
- Müller-Ehmsen J, Schwinger RH. TNF and congestive heart failure: therapeutic possibilities. Expert Opin Ther Targets. 2004;8(3):203-209.
- Arvunescu AM, et al. Inflammation in heart failure—future perspectives. J Clin Med. 2023;12(24):7738.
- Yu L, Feng Z. The role of Toll-like receptor signaling in the progression of heart failure. Mediators Inflamm. 2018;2018:9874109.
- Ye S, et al. Toll-like receptor 2 signaling deficiency in cardiac cells ameliorates Ang II-induced cardiac inflammation and remodeling. Transl Res. 2021;233:62-76.
- Vianello E, et al. The advanced glycation end-products (AGE)-receptor for AGE system (RAGE): an inflammatory pathway linking obesity and cardiovascular diseases. Int J Mol Sci. 2025;26(8):3707.