Este protocolo integra la desidentificación, la normalización de la terminología, la verificación de la fuente y la visualización reproducible para generar salidas agregadas auditables a partir de registros reales de pacientes ambulatorios de medicina tradicional china.
Artículo de método
Minería y visualización auditadas por fuentes de registros de casos reales de medicina tradicional china utilizando la fórmula Hegan Jianpi
* These authors contributed equally
En este artículo
Resumen
Resumen
Los registros ambulatorios reales de medicina tradicional china (MTC) contienen información longitudinal sobre diagnósticos, elementos del síndrome, narrativas de síntomas y prescripciones individualizadas, pero su formato semiestructurado complica el análisis reproducible. Este artículo presenta un protocolo auditado por la fuente para convertir registros de casos desidentificados en tablas agregadas trazables y visualizaciones listas para publicación. El flujo de trabajo define criterios de elegibilidad y unidades de análisis, conserva las correspondencias entre la terminología original y la normalizada, verifica todos los numeradores y denominadores reportados, y regenera figuras a partir de tablas fuente con control de versiones. Aplicado a registros desde enero de 2015 hasta junio de 2024, el protocolo identificó 555 visitas con prescripción elegibles de 396 pacientes. El conjunto de datos final contenía 324 etiquetas normalizadas de hierbas y 9.339 ocurrencias de uso de hierbas. El flujo de trabajo generó espectros paralelos de enfermedades de la medicina occidental y de la MTC, un espectro explícito de elementos del síndrome y una matriz de coocurrencia, perfiles de frecuencia de hierbas y de materias médicas, un espectro de síntomas derivado del historial compuesto por 37 términos, 15 reglas de asociación dirigidas, agrupamiento jerárquico y mapas de calor de uso de hierbas estratificados por diagnóstico. Se detectó al menos una palabra clave preespecificada del historial en 474 visitas (85,41 %). Cuando lo permita la política institucional, una opción de inteligencia artificial (IA) supervisada por humanos puede ayudar en la verificación de terminología, revisión de coherencia entre archivos y alineación de leyendas con figuras. Todo uso de IA debe documentarse en un registro de auditoría independiente y no debe sustituir la revisión de los datos originales. Al integrar gobernanza, normalización, computación, interpretación clínica y salida visual en un único flujo de trabajo reproducible, este método transforma la documentación clínica dispersa en un recurso de investigación revisable. El protocolo puede adaptarse a otros conjuntos de datos de práctica experta, proyectos multicéntricos de terminología y plataformas prospectivas de datos clínicos.
Introducción
Los registros ambulatorios reales de medicina tradicional china (MTC) preservan el razonamiento clínico longitudinal mediante síntomas narrativos, sistemas diagnósticos paralelos, descripciones de síndromes y prescripciones individualizadas. Trabajos iniciales de descubrimiento de conocimiento reconocieron que los registros de casos constituyen datos complejos de experiencia clínica que requieren métodos informáticos específicos antes de que sus patrones puedan estudiarse de manera confiable1. Investigaciones posteriores han demostrado que las expresiones sinónimas de síntomas, entidades de gran detalle y términos diagnósticos documentados localmente deben normalizarse sin borrar la redacción original2,3,4,5,6. Los datos de historias clínicas electrónicas (HCE) también pueden apoyar la investigación computacional de prescripciones y el uso de herramientas analíticas reutilizables cuando el contexto clínico y el origen de los datos permanecen visibles7,8. Por tanto, se necesitan referencias autorizadas de materias médicas para estandarizar los nombres de hierbas, formas de procesamiento, propiedades, sabores y asignaciones a meridianos9,10. A nivel de informe, las declaraciones RECORD y STROBE exigen descripciones transparentes de las fuentes de datos, reglas de elegibilidad, variables y decisiones analíticas, mientras que los principios FAIR enfatizan objetos de investigación rastreables y reutilizables11,12,13. Estas consideraciones son especialmente importantes cuando los registros contienen visitas repetidas, campos incompletos, terminología solapada y texto libre. La evaluación de idoneidad para el uso debe abordar la completitud, conformidad, verosimilitud y concordancia entre fuentes14,15. La desidentificación de texto libre también requiere procedimientos explícitos y revisión humana, ya que los métodos automatizados pueden preservar contenido clínico útil mientras dejan riesgos residuales de privacidad16,17,18.
Una vez establecidas la gobernanza y la terminología, el perfilado de frecuencias, la minería de reglas de asociación y el agrupamiento jerárquico pueden ofrecer visiones complementarias de la estructura de las prescripciones19,20,21. Los métodos de redes y cartografía científica demuestran además cómo representaciones visuales coordinadas pueden revelar relaciones que una simple lista ordenada no puede captar22,23,24,25. Estudios recientes sobre artritis reumatoide con depresión, inhibidores de la quinasa Janus en colitis ulcerosa y artritis reumatoide con fibromialgia ilustran el valor de criterios de recuperación bloqueados por versión, redes de coocurrencia, agrupamiento, interpretación temporal y declaraciones explícitas de limitaciones analíticas26,27,28. El presente estudio adapta estos principios de diseño transferibles a la minería de registros clínicos, en lugar de a la bibliometría de la literatura. En los registros fuente, Hegan Jianpi Formula hace referencia a una fórmula basada en la experiencia asociada a la práctica del profesor Nai-li Yao29,30. Publicaciones relacionadas describen su enfoque clínico más amplio de armonización hígado-bazo y bazo-estómago29,30. En este artículo metodológico, el nombre de la fórmula identifica únicamente el contexto del registro fuente y no establece una composición fija, dosis, indicación terapéutica ni afirmación de eficacia. El flujo de trabajo computacional utiliza reglas deterministas y métodos estadísticos de propósito general. La práctica computacional reproducible requiere además la conservación de las entradas, la documentación de los parámetros, las transformaciones mediante secuencias de comandos y resultados revisables31,32. Una opción de inteligencia artificial (IA) supervisada por humanos puede ayudar en verificaciones terminológicas, revisiones de coherencia entre archivos y control visual de calidad, siempre que su uso quede documentado. La experiencia clínica, las salvaguardas de privacidad y la toma de decisiones humanas responsables deben permanecer como elementos primordiales (Tabla Suplementaria 1)33,34. El objetivo general de este método es convertir registros de casos de MTC desidentificados en una cadena auditada por la fuente de resultados estratificados por enfermedad, síndrome, síntoma, uso de hierbas, asociaciones, agrupamientos y diagnósticos. El ejemplo desarrollado utiliza 555 visitas con prescripciones elegibles de 396 pacientes para demostrar cómo se pueden integrar la gobernanza, la normalización, el cálculo, la interpretación clínica y la publicación visual sin revelar registros a nivel de paciente, detalles exactos de formulaciones, proporciones de dosis ni instrucciones prescriptivas.
Protocolo
Este análisis retrospectivo de registros clínicos desidentificados fue revisado y aprobado por el Comité de Ética Médica del Hospital Guang'anmen, Academia de Ciencias Médicas Chinas de China (número de aprobación: 2026-108-KY; 13 de julio de 2026). El Comité eximió el requisito de consentimiento informado.
1. Establecer la ética, la gobernanza y la seguridad de los datos
- Asigne un custodio de datos, un analista de datos originales, un revisor de terminología clínica, un revisor cuantitativo y un investigador autorizado para aprobar la publicación de datos agregados. Registre cada rol en el registro del proyecto.
- Elabore un plan de gestión de datos que especifique el sistema fuente permitido, el período del estudio, los campos, la ubicación de almacenamiento, los permisos de acceso, el procedimiento de copia de seguridad, el período de retención y las restricciones sobre las claves de vinculación.
- Exporte únicamente las variables mínimas necesarias para el análisis previamente especificado. Incluya un identificador local del paciente, la fecha de la visita, la edad o la fecha de nacimiento cuando esté permitido, el sexo, el diagnóstico occidental, el nombre de la enfermedad según la MTC, el texto del historial desidentificado, el texto de la lengua, el texto del pulso, el texto del síndrome y los campos de prescripción de hierbas.
- Elimine los nombres, números de identificación nacional, números de teléfono, direcciones detalladas, identificadores de seguros, información de contacto y otros identificadores directos dentro del entorno institucional controlado. Sustituya cada número de historial médico por un identificador de paciente específico del proyecto.
- Revise los campos de texto libre en busca de identificadores residuales y enmascare cada elemento detectado. Almacene cualquier clave de vinculación por separado del conjunto de datos analítico y exclúyala de las carpetas de trabajo, colaboración y envío.
- Conservar la exportación inicial desidentificada como una instantánea de origen de solo lectura. Registre su nombre de archivo, fecha de creación, número de filas, número de columnas, tamaño del archivo y suma de verificación en un manifiesto de origen.
- Cree directorios separados para archivos de origen, archivos de trabajo, diccionarios, tablas agregadas, figuras, guiones y registros de auditoría.
- Restrinja los materiales publicados o compartidos a tablas agregadas, diccionarios desidentificados aprobados, guiones y figuras para publicación. No cargue registros identificables o potencialmente reidentificables en sistemas públicos de inteligencia artificial generativa, servicios en la nube no autorizados ni repositorios públicos.
NOTA: Cuando la política institucional permita la asistencia de inteligencia artificial supervisada por humanos, proporcione únicamente extractos de texto desidentificados o tablas agregadas. Registre en el registro de auditoría la finalidad, la salida revisada, la corrección aceptada, el revisor y la fecha.
2. Definir la regla de identificación de registros y las unidades de análisis
- Defina la institución, el entorno ambulatorio, el equipo clínico responsable, el sistema de historial médico electrónico y el período de origen antes del cribado. Para el ejemplo desarrollado, utilice registros con fechas comprendidas entre enero de 2015 y junio de 2024.
- Almacene la regla de identificación de la cohorte en un archivo restringido y controlado por versiones antes de examinar los resultados analíticos. Registre las variantes de terminología aceptadas y todas las condiciones de inclusión y exclusión sin revelar detalles confidenciales de la formulación en el manuscrito.
- Aplicar la regla de identificación de registros con versión bloqueada al nivel de prescripción-visita tras la normalización del nombre de la hierba. Finalizar los archivos fuente, diccionarios, regla de cohorte y parámetros de análisis como un conjunto único de lanzamiento.
- Cree una versión nueva y regenere todas las salidas dependientes cada vez que un componente bloqueado por versión cambie. No modifique la regla de identificación de la cohorte después de examinar las distribuciones de enfermedades, las frecuencias de hierbas, las reglas de asociación o los grupos.
- Incluya una visita ambulatoria cuando esta se encuentre dentro del período de estudio bloqueado por versión, se asocie a un identificador válido de paciente del proyecto, contenga un registro de prescripción interpretable y cumpla con la regla restringida de identificación de registros.
- Excluya exportaciones duplicadas exactas, registros fuera del período de estudio, registros sin una receta interpretable y filas que no cumplan la regla de identificación bloqueada por versión. Asigne una razón principal de exclusión a cada fila excluida.
- Distinga las exportaciones repetidas de las visitas de seguimiento genuinas. Elimine únicamente los duplicados exactos del sistema o de exportación y conserve las visitas repetidas genuinas.
- Asigne identificadores estables para el paciente y la visita de receta. Cree un manifiesto de cohorte que contenga la versión de origen, la versión de las reglas, el estado de cribado, el motivo de inclusión o exclusión, el identificador del paciente, el identificador de la visita y el estado del revisor.
- Utilice un registro por paciente único para resúmenes fijos de datos demográficos, incluyendo edad y sexo. Utilice la visita de prescripción como unidad de análisis para las enfermedades, síndromes, palabras clave del historial clínico, lengua, pulso, hierbas, reglas de asociación y análisis de agrupamiento.
- Separe la elegibilidad de la cohorte de la disponibilidad de variables. Mantenga una visita que sea de otro modo elegible cuando falte un campo específico de una variable y reporte el denominador evaluable para cada análisis.
- Congele el manifiesto de la cohorte antes del análisis descriptivo. Registre el número de visitas con prescripción elegibles y de pacientes únicos, y regenere todas las salidas dependientes si cambia una decisión de elegibilidad.
3. Normalizar la terminología y preservar el historial de auditoría
- Cree diccionarios separados con control de versiones para hierbas, diagnósticos occidentales, nombres de enfermedades de la MTC, elementos del síndrome, palabras clave del historial, términos de lengua, términos de pulso y atributos de la materia médica.
- Incluya en cada diccionario el término original, el término normalizado, la categoría del término, el campo de origen, la regla, la fuente de referencia, la versión del diccionario, el revisor, la fecha de revisión y los comentarios. Mantenga todos los términos originales tras la normalización.
- Normalice los nombres de los materiales medicinales chinos (CMM) utilizando referencias autorizadas de nomenclatura9,10. Corrija las variantes tipográficas y abreviaturas del sistema, preservando al mismo tiempo las formas de procesamiento clínicamente significativas.
- Mantenga los calificativos de procesamiento, incluyendo salteados, procesados con vinagre, dorados con miel, procesados con jengibre, procesados con vino, carbonizados y crudos, como etiquetas independientes.
- Mantenga separadas las hierbas que difieran ortográfica o clínicamente. No combine Bai Shao con Bai Zhu ni infiera una hierba a partir de una abreviatura ambigua sin revisar la fuente.
- Conservar la dosis original y la unidad en campos separados cuando estén disponibles. Elimine el texto de la dosis únicamente al construir variables de presencia de hierbas a nivel de visita.
- No interprete la frecuencia de aparición como dosis acumulada o intensidad del tratamiento.
- Normalice los nombres de enfermedades occidentales y de la MTC de forma independiente. Mantenga el sistema diagnóstico y el estado de diagnóstico principal, y no traduzca una etiqueta de enfermedad de la MTC en un diagnóstico occidental a menos que ambos estén explícitamente registrados.
- Defina una etiqueta de enfermedad de la MTC transliterada en su primera aparición cuando sea necesario para orientar al lector. Mantenga la etiqueta original de la fuente.
- Divida el texto explícito de síndromes con múltiples valores utilizando delimitadores bloqueados por versión y asocie las expresiones de origen a elementos de síndrome normalizados. Elimine duplicados de cada elemento normalizado dentro de una visita.
- Mantenga el texto explícito del síndrome separado de las columnas de indicadores heredados o derivados de puntuaciones.
- Mantenga los campos originales de lengua, pulso, síntomas estructurados e historial desidentificado como productos de datos independientes. No considere que una coincidencia con una palabra clave del historial equivale a un síntoma estructurado introducido por un clínico.
- Solicite a un revisor que proponga cada asignación ambigua o de muchos a uno, y haga que un segundo revisor clínico la verifique. Excluya las asignaciones inciertas de los análisis publicados hasta que una revisión de la fuente las resuelva.
- Revise la presencia de etiquetas normalizadas vacías, asignaciones de uno a muchos, asignaciones de muchos a uno, entradas duplicadas en el diccionario, términos sin revisar y pérdida accidental de etiquetas de procesamiento. Congele las versiones de los diccionarios antes de generar tablas agregadas.
4. Verificar los campos de origen y bloquear las salidas reportables
- Cree un libro de evidencias con una fila para cada afirmación del manuscrito, tabla y panel de figura. Registre la unidad de análisis, campo fuente, versión fuente, versión del diccionario, versión del script, numerador, denominador, archivo de salida, revisor y redacción aprobada.
- Recalcule directamente a partir de los archivos con versión bloqueada los conteos de visitas elegibles y pacientes únicos, resúmenes demográficos, conteos de enfermedades, conteos explícitos de síndromes, conteos de palabras clave en antecedentes, frecuencias de hierbas combinadas y totales de uso de hierbas.
- Compare cada valor recalculado con el valor correspondiente en el manuscrito, hoja de cálculo o figura. Corrija el manuscrito y regenere las salidas dependientes cada vez que se confirme una discrepancia.
- Resuelva cada discrepancia a nivel del campo fuente. Registre la razón, corrección, revisor y fecha en el libro de evidencias antes de publicar el resultado afectado.
- Verifique que cada tabla agregada contenga la etiqueta normalizada, numerador, denominador, definición del porcentaje, unidad de análisis e identificador fuente necesarios para reproducir la afirmación correspondiente.
- Verifique el denominador utilizado para cada porcentaje. Utilice pacientes únicos para características demográficas fijas y visitas de prescripción para variables clínicas y de prescripción dinámicas.
- Compare las etiquetas, valores, orden y definiciones de los paneles de las figuras con sus tablas agregadas con versión bloqueada. Regenere cada figura tras una corrección en la tabla, en lugar de editar manualmente los valores representados.
- Solicite a un revisor clínico que verifique las correspondencias terminológicas. Solicite a un revisor cuantitativo que verifique los conteos, tasas, métricas de reglas y denominadores de mapas de calor.
- Bloquee el libro de evidencias, las tablas agregadas y las fuentes de figuras bajo un único identificador de versión antes del ensamblaje del manuscrito.
5. Generar espectros descriptivos y resultados de coocurrencia
- Generar resúmenes por paciente de edad y sexo a partir de una fila por paciente único. Conservar y reportar explícitamente las categorías desconocidas.
- Generar por separado los espectros de enfermedades occidentales y de medicina tradicional china a nivel de prescripción-visita. Conservar el sistema diagnóstico original y calcular las etiquetas normalizadas principales utilizando un denominador común de visitas.
- Generar el espectro de elementos del síndrome a partir del campo de texto de síndrome normalizado explícito. Dividir los términos usando delimitadores bloqueados por versión, eliminar duplicados de cada término dentro de una visita y calcular las frecuencias a nivel de visita.
- Construir la matriz de coocurrencia de síndromes a partir de los mismos conjuntos de tokens dentro de la visita. Codificar el tamaño del nodo según la frecuencia de visitas y el ancho del enlace o la intensidad del mapa de calor según el conteo de coocurrencia por pares.
- Preespecificar un diccionario exacto de palabras clave de antecedentes cuando la información de síntomas sea principalmente narrativa. Analizar únicamente el campo de antecedentes desidentificado y contar cada concepto no más de una vez dentro de una visita.
- Calcular la proporción de visitas elegibles que contienen al menos una palabra clave de antecedentes y ordenar todos los conteos de palabras clave. Exportar la tabla completa y el subconjunto graficado.
- Generar frecuencias de hierbas combinadas a partir de datos de prescripción normalizados. Contar cada etiqueta de hierba normalizada no más de una vez por visita y conservar las formas de procesamiento clínicamente relevantes como etiquetas separadas.
- Generar perfiles de Cuatro-Qi, cinco sabores y tropismo de meridianos a partir del diccionario de materias médicas bloqueado por versión. Tratar el Cuatro-Qi como una categoría de valor único para cada ocurrencia de hierba codificada por propiedad.
- Tratar los cinco sabores y el tropismo de meridianos como atributos multietiqueta. Indicar el denominador codificado por propiedad y conservar la unidad de análisis separada.
- Exportar una tabla agregada legible por máquina para cada dominio descriptivo antes de generar las figuras finales.
6. Realice análisis de reglas de asociación y agrupamiento jerárquico
- Construya una matriz binaria de prescripción-visita-por-hierba a partir de la tabla de prescripciones normalizada con versión fija. Utilice una fila por visita elegible y una columna por etiqueta normalizada de hierba.
- Calcule el soporte, la confianza y el lift para reglas de asociación dirigidas de una sola hierba19. Mantenga la dirección de cada regla porque la confianza depende del antecedente.
- Aplique los umbrales preespecificados de soporte ≥ 0.30, confianza ≥ 0.70 y lift > 1.0. Exporte cada regla conservada con su conteo de co-ocurrencia y las tres métricas.
- Represente gráficamente el conjunto completo de reglas conservadas como una red bipartita dirigida de reglas y un perfil ordenado de fuerza de reglas. Codifique el ancho del borde de la red mediante el soporte y el color del borde mediante el lift.
- Codifique el tamaño del punto mediante el soporte y anote la confianza en el perfil ordenado.
- Verifique que ambas representaciones de reglas contengan el mismo conjunto de reglas conservadas y preserven la dirección de cada regla. Compare cada discrepancia con la tabla de reglas exportada antes de su publicación.
- Seleccione las 20 variables de presencia de hierbas con mayor frecuencia para el agrupamiento jerárquico. Calcule las distancias de Jaccard por pares y aplique enlace promedio.
- Etiquete el dendrograma con los nombres normalizados de las hierbas. Interprete la proximidad entre ramas únicamente como similitud en los patrones de aparición a nivel de visita.
- Exporte la especificación de la matriz binaria, la tabla de reglas, la lista de enlaces de la red, el orden de entrada para el agrupamiento, la matriz de distancias y la matriz de enlaces antes de generar las figuras.
- Solicite a un revisor cuantitativo que reproduzca manualmente una métrica de regla. Compare cada enlace de la red con la tabla de reglas.
- Vuelva a ejecutar completamente el flujo de trabajo de reglas y agrupamiento cada vez que cambie la cohorte, el diccionario de terminología o la matriz de presencia de hierbas.
- Para el ejemplo desarrollado, realice un análisis de sensibilidad determinista de una visita por paciente conservando el registro más temprano según el orden original para cada paciente. Compare las 12 reglas resultantes con las 15 reglas del análisis a nivel de visita.
- Informe el cambio como un resultado descriptivo de robustez, no como una validación a nivel de paciente. Utilice la recálculo determinista proporcionado en Supplementary File 1.
7. Generar patrones estratificados por diagnóstico y el marco de interpretación clínica
- Seleccione estratos principales de diagnóstico occidental clínicamente relevantes antes de examinar las distribuciones de hierbas específicas del diagnóstico.
- Contabilice cada etiqueta normalizada de hierba no más de una vez por visita dentro de cada estrato de diagnóstico. Calcule la prevalencia como el número de visitas que contienen la etiqueta dividido por el número total de visitas elegibles en ese estrato.
- Utilice el mismo conjunto de hierbas mostrado y una escala de color fija del 0 % al 100 % en todos los estratos de diagnóstico. Muestre los valores de las celdas para preservar una interpretación exacta.
- Informe el numerador y el denominador de cada celda mostrada en una tabla agregada independiente.
- Elabore un panel separado de interpretación clínica tras completar el mapa de calor descriptivo. Mantenga visualmente distintos los resultados calculados y la interpretación experta.
- Rellene la capa de indicaciones únicamente con términos rastreables a la tabla de palabras clave históricas bloqueada por versión o al texto explícito del síndrome normalizado.
- Solicite a dos revisores clínicos que acuerden interpretaciones contextuales concisas de las indicaciones seleccionadas. Registre los revisores y la redacción final en el registro de evidencia.
- Vincule cada interpretación contextual a un uso en investigación, como selección de variables, validación prospectiva o generación de hipótesis.
- Utilice conectores discontinuos y no direccionales para la capa de interpretación. Omita el contenido relacionado con dosis, composición fija y recomendaciones de tratamiento.
- Revise conjuntamente el mapa de calor y el panel de interpretación. Asegúrese de que la prevalencia calculada, el contexto experto y el uso futuro en investigación permanezcan claramente separados.
8. Armar y verificar el paquete de reproducibilidad
- Exporte el manifiesto de origen, el manifiesto de cohorte, las versiones del diccionario, el registro de evidencia, los scripts de análisis, las tablas agregadas, las fuentes de las figuras y las figuras finales a directorios separados.
- Asigne a cada archivo un número estable de figura o tabla y la fecha de versión. Mantenga una versión actual autorizada única y archive por separado las versiones reemplazadas.
- Genere cada figura como un archivo de imagen con múltiples paneles. Exporte un PDF de alta resolución y un PNG de 300 ppp para revisión.
- Coloque las leyendas de las figuras en el manuscrito y manténgalas fuera de los archivos de imagen. Describa cada panel, unidad de análisis, denominador y codificación visual.
- Prepare un archivo XLSX independiente para cada tabla.
- Solicite a un revisor independiente que compare los números del manuscrito con las tablas agregadas y los porcentajes con sus numeradores y denominadores.
- Compare los bordes de las reglas con la tabla de reglas y las celdas del mapa de calor con la matriz de origen.
- Ejecute verificaciones automatizadas para comprobar la consistencia de los nombres de archivo, las secciones requeridas, las dimensiones de las figuras, el número de tablas, el número de referencias, los residuos de plantilla y el uso de términos restringidos.
- Solicite al equipo de autores clínicos que revise la terminología, la interpretación, los límites de propiedad intelectual, los datos de los autores, el orden de financiación, la redacción ética y el conjunto final de figuras.
- Elimine del paquete de envío los archivos a nivel de paciente, las claves de vinculación, el texto libre sin restricciones, la correspondencia interna y los artefactos temporales de revisión.
- Congele el paquete publicado y registre su versión, fecha, suma de verificación, versión del manuscrito y estado de aprobación por los autores. Cree una versión nueva y un registro de cambios para cada corrección subsiguiente.
Resultados
La aplicación exitosa del protocolo produjo una cadena rastreable que conecta la instantánea de origen desidentificada, el manifiesto de la cohorte, los diccionarios de terminología, las tablas agregadas, los scripts y las figuras finales. El procedimiento de cribado con versión bloqueada identificó 555 visitas por prescripción elegibles procedentes de 396 pacientes únicos. Figura 1 resume las tres etapas coordinadas del método: gobernanza, normalización de la terminología y análisis con revisión clínica. La documentación correspondiente sobre transparencia y auditoría, incluyendo el límite basado únicamente en datos agregados para la revisión asistida por inteligencia artificial, se proporciona en Tabla Suplementaria 1.
La cohorte final comprendió 555 visitas de prescripción elegibles aportadas por 396 pacientes únicos (Figura 2 y Tabla 1). Se mantuvieron las visitas repetidas genuinas para las variables clínicas y de prescripción dinámicas, mientras que la edad y el sexo se resumieron tras la desduplicación a nivel de paciente. La edad de los pacientes osciló entre 13 y 94 años, con una media de 47,11 años y una desviación estándar de 14,88 años. La cohorte incluyó 228 pacientes mujeres (57,58 %), 167 pacientes hombres (42,17 %) y 1 paciente con sexo desconocido (0,25 %). Esta separación de unidades de análisis preservó los encuentros longitudinales sin inflar el denominador demográfico.
Los espectros de enfermedades occidentales y de la MTC se resumen en la Figura 3. Los diagnósticos occidentales se concentraron en trastornos gastrointestinales, hepatobiliares y pancreáticos. La agrupación jerárquica asignó 271 visitas a trastornos gastrointestinales, 222 a trastornos hepatobiliares o pancreáticos y 62 a otros sistemas (Figura 3A). Los principales diagnósticos individuales fueron gastritis crónica en 133 visitas (23,96 %), hígado graso en 77 visitas (13,87 %) y cirrosis hepática en 46 visitas (8,29 %), seguidos por gastritis atrófica crónica, dolor abdominal, hepatitis B crónica, dispepsia, esofagitis por reflujo, gastritis superficial crónica y pancreatitis crónica (Figura 3C y Tabla 2).
El espectro correspondiente de nombres de enfermedades de la MTC organizó las mismas visitas según un sistema diagnóstico paralelo. Los nombres de enfermedades del bazo-estómago o intestinales representaron 280 visitas, los nombres de enfermedades del hígado-vésicula biliar 223, los trastornos de qi-sangre-fluidos 26, los trastornos de mente-pecho-cabeza 12, los trastornos de canales o extremidades 5, los trastornos ginecológicos 4, y otras categorías 5 visitas (Figura 3B). Wei pi, una etiqueta de enfermedad de la MTC conservada para plenitud o molestia epigástrica, se registró en 163 visitas (29,37 %). Ji disease (una etiqueta de origen de la MTC de tipo acumulativo), Gan zhuo (literalmente, fijación del hígado; una etiqueta de enfermedad clásica de la MTC conservada), Bi disease (enfermedad de obstrucción) y Xiao ke (consumo-sed) se mantuvieron como etiquetas originales de la MTC y no se convirtieron en diagnósticos biomédicos modernos. Gan pi, una etiqueta de enfermedad de la MTC utilizada en el consenso chino contemporáneo para trastornos de hígado graso, se registró en 77 visitas (13,87 %)35. Los campos originales de la medicina occidental y de la MTC permanecieron independientes y no se sustituyeron mutuamente (Figura 3D y Tabla 3). Xie xie (heces sueltas o acuosas) y Fu xie (diarrea) eran etiquetas originales distintas de enfermedades de la MTC, registradas 6 y 2 veces, respectivamente, y ninguna de ellas se equiparó con un diagnóstico biomédico moderno. Mostrar ambos espectros lado a lado preservó la lógica de cada sistema diagnóstico al tiempo que demostraba la amplitud clínica de los registros originales.
El campo de texto de síndrome normalizado explícito contenía 555 filas de visitas elegibles. Después de la desduplicación dentro de cada visita, los elementos principales fueron bazo en 362 visitas (65,23 %), hígado en 304 (54,77 %), deficiencia de qi en 295 (53,15 %), estómago en 171 (30,81 %), humedad en 151 (27,21 %) y estancamiento de qi en 109 (19,64 %; Figura 4A y Tabla 4). Calor, retención de agua, sangre, estasis de sangre, canales, riñón, corazón y deficiencia de yin comprendieron el resto del espectro mostrado. Los porcentajes no eran excluyentes porque podían ocurrir múltiples elementos de síndrome durante una sola visita.
La red y la matriz de conteo se generaron a partir de los mismos conjuntos de tokens a nivel de visita (Figura 4B,C). La co-ocurrencia frecuente se centró en deficiencia del bazo, hígado y qi, con conexiones adicionales al estómago, humedad, estancamiento de qi, calor y retención de agua. El uso de una matriz bloqueada por versión para el gráfico de frecuencias, la red y el mapa de calor aseguró que los tres paneles representaran la misma evidencia subyacente a diferentes niveles de detalle. La auditoría recuperada identificó 0 coincidencias exactas entre síndromes-texto e indicadores entre 555 filas y una similitud media de Jaccard texto-indicador de 0,1806. Por lo tanto, las columnas de indicadores se excluyeron del informe sustantivo. Los materiales retenidos no contenían vectores de distribución reconstruibles previos a la limpieza; en consecuencia, no se estimó la estabilidad distribucional entre versiones. En cambio, el análisis de sensibilidad de una visita por paciente abordó el efecto de las visitas repetidas. Los resultados de la auditoría de origen y de la calidad de los datos se resumen en la Tabla Suplementaria 2.
Después de la normalización terminológica y la retención de formas de procesamiento clínicamente significativas, las 555 visitas incluían 324 etiquetas distintas de hierbas fusionadas y 9.339 ocurrencias de uso de hierbas. Bai Shao se registró en 531 visitas (95,68 %), seguido por Fu Ling en 520 (93,69 %), Dang Gui en 510 (91,89 %), Chi Shao en 467 (84,14 %) y Bai Zhu tostado en 361 (65,05 %; Figura 5A y Tabla 5). La curva de frecuencia por rango de las 36 principales etiquetas mostró un segmento empinado de alta frecuencia seguido por una cola progresivamente más amplia (Figura 5B), lo que proporciona una representación compacta de los componentes de fondo común y de prescripciones individualizadas. Las correspondencias de origen a normalizado, los calificadores de procesamiento, los nombres estándar de MTC, las especies de origen y los límites de evidencia subyacentes a la nomenclatura de hierbas se documentan en la Tabla Suplementaria 3.
El diccionario auxiliar de materias medicas contenía 9.115 ocurrencias de usos de hierbas codificadas por propiedades. Las principales categorías de Cuatro Qi fueron cálidas (2.588, 28,39 %), ligeramente frías (2.339, 25,66 %), neutras (2.330, 25,56 %) y frías (1.221, 13,40 %; Figura 5C). Tras la normalización de la terminología de sabores de los compuestos, las cinco categorías principales de sabores fueron amargo (4.488, 49,24 %), dulce (4.377, 48,02 %) y picante (2.893, 31,74 %; Figura 5D). La codificación de tropismo meridiano estuvo encabezada por bazo (5.541, 60,79 %), hígado (4.801, 52,67 %), pulmón (3.358, 36,84 %), estómago (2.988, 32,78 %) y corazón (2.702, 29,64 %; Figura 5E). La Figura 5F registra las unidades de análisis distintas por nivel de visita y codificadas por propiedades, así como su vínculo de reproducibilidad. En conjunto, estos paneles demuestran cómo se pueden resumir la frecuencia de prescripción y los descriptores estandarizados de materias medicas sin colapsar la terminología específica del procesamiento.
El diccionario de antecedentes preespecificado contenía 37 conceptos exactos de síntomas. Se detectó al menos un concepto en 474 de las 555 visitas elegibles (85,41 %). Los términos principales fueron sequedad de garganta en 178 visitas (32,07 %), fatiga en 151 (27,21 %), mal sueño en 139 (25,05 %), distensión abdominal en 115 (20,72 %), reflujo ácido en 100 (18,02 %), sabor amargo en 99 (17,84 %), acidez en 90 (16,22 %), hipo en 87 (15,68 %), eructos en 87 (15,68 %) y heces sueltas en 77 (13,87 %; Figura 6A,B y Tabla 6).
La curva completa de rango-frecuencia mostró la distribución total de 37 términos, mientras que la línea acumulativa resumió la concentración de todas las detecciones de palabras clave a través de los rangos (Figura 6C). Figura 6D registra la secuencia reproducible utilizada para generar el espectro: bloquear el diccionario, escanear el texto histórico desidentificado, deduplicar conceptos dentro de cada visita y exportar recuentos y tasas agregadas.
La minería de reglas de asociación utilizó la matriz de presencia de hierbas por visita y prescripción, bloqueada en versión, de 555 filas. Quince reglas dirigidas de una sola hierba cumplieron con un soporte ≥ 0,30, una confianza ≥ 0,70 y un lift > 1,0 (Figura 7A,B y Tabla 7). Los valores de soporte conservados oscilaron entre 0,3009 y 0,7892, los valores de confianza entre 0,7302 y 0,9748, y los valores de lift entre 1,0010 y 1,1226.
El par dirigido más frecuentemente coregistrado fue Chi Shao > Fu Ling, basado en 438 visitas, con un soporte de 0,7892, una confianza de 0,9379 y un elevación (lift) de 1,0010. La regla inversa tuvo el mismo soporte y una confianza de 0,8423, lo que demuestra por qué debe conservarse la dirección de la regla. La sensibilidad al umbral conservó 18, 11, 21, 14, 7 y 4 reglas bajo soporte ≥ 0,25 o ≥ 0,35, confianza ≥ 0,65 o ≥ 0,75, o elevación (lift) > 1,02 o > 1,05, respectivamente. En el análisis de una visita por paciente, el mismo par ocurrió en 316 visitas, con un soporte de 0,7980, una confianza de 0,9489 y un elevación (lift) de 0,9994; por lo tanto, no se conservó bajo el criterio de elevación (lift) > 1,0. Los resultados de las perturbaciones del umbral y la sensibilidad a visitas repetidas se proporcionan en Supplementary Table 4, y el recálculo determinista se proporciona en Supplementary File 1. Por consiguiente, un soporte alto a nivel de visita no debe interpretarse como validación a nivel de paciente.
Los valores de elevación más altos se observaron para Gan Cao > Bai Zhu frito (1.1226) y Gan Cao > Chi Shao (1.1200). Figura 7A integra las 15 reglas conservadas en una red bipartita dirigida, donde el ancho de las aristas codifica el soporte y el color de las aristas codifica la elevación. Figura 7B ordena las mismas reglas por elevación, escala cada punto según el soporte y anota el nivel de confianza. Por lo tanto, los dos paneles distinguen la topología de la red de la intensidad cuantitativa de las reglas, en lugar de duplicar la misma representación visual.
El agrupamiento jerárquico de las 20 variables de hierbas con mayor frecuencia utilizó la distancia de Jaccard y el enlace promedio (Figura 7C). El dendrograma proporciona una representación global de la similitud en los patrones de presencia a nivel de visita, lo que complementa la información direccional local proporcionada por las reglas de asociación. Juntos, los paneles demuestran cómo se pueden alinear vistas analíticas complementarias a una única matriz binaria con versión fija.
Se calculó la prevalencia estratificada por diagnóstico para hígado graso (77 visitas), cirrosis hepática (46 visitas) y gastritis crónica (133 visitas; Figura 8A y Tabla 8). Bai Shao, Fu Ling y Dang Gui mostraron alta prevalencia en las tres estratificaciones. Las visitas por cirrosis hepática mostraron una documentación destacada de Dan Shen (95,65 %), E Zhu procesado con vinagre (86,96 %), Bie Jia procesado con vinagre (84,78 %) y Sheng Huang Qi (60,87 %). Las visitas por hígado graso mostraron una mayor prevalencia de Yin Chen (41,56 %) y Ze Xie (31,17 %) en comparación con las otras estratificaciones, mientras que las visitas por gastritis crónica mostraron una frecuencia recurrente de Huang Lian (44,36 %), Mu Xiang (34,59 %) y Chai Hu (36,09 %). Por lo tanto, el mapa de calor proporciona una comparación descriptiva compacta de los patrones agregados de prescripción en los principales contextos clínicos.
Figura 8B separa el cálculo de la interpretación. Las señales verificadas del historial se vinculan con contextos expertos concisos y luego con usos de investigación, incluyendo la contextualización de los elementos del síndrome, la comparación de patrones estratificados por diagnóstico, la selección de variables para validación prospectiva y la generación de preguntas de seguimiento. Este panel final demuestra cómo la experiencia clínica puede enriquecer los resultados analíticos manteniéndose claramente diferenciada de la prevalencia calculada.
Figura 8C resume la reproducibilidad y los límites de liberación al distinguir los componentes verificados por la fuente o reanalizados de aquellos elementos que requieren precaución o confirmación adicional. Esta capa final de auditoría evita que productos analíticos no resueltos o no reconstruibles se presenten como resultados validados.
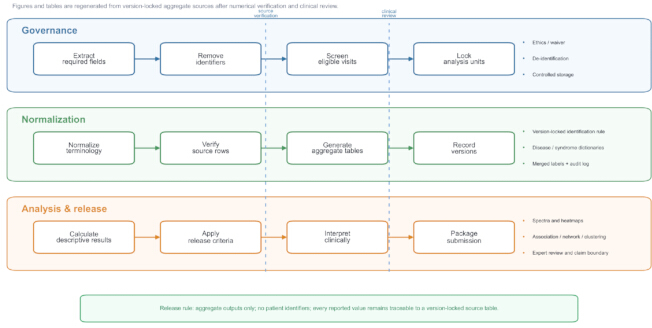
Figura 1: Flujo de trabajo para la extracción de registros de casos auditados por la fuente. Se muestran la gobernanza, la normalización de la terminología, el análisis agregado, la revisión clínica y el empaquetado para liberación como etapas secuenciales del flujo de trabajo. Las bandas azules, verdes y naranjas distinguen los dominios del flujo de trabajo, y las líneas verticales discontinuas indican puntos de control de auditoría. Las flechas indican la secuencia del flujo de trabajo y no implican causalidad biológica. La regla de liberación especifica que solo se liberan resultados agregados, que se excluyen los identificadores de pacientes y que cada valor informado permanece rastreable hasta una tabla fuente con versión bloqueada. No se aplican barras de error. Haga clic aquí para ver una versión más grande de esta figura.
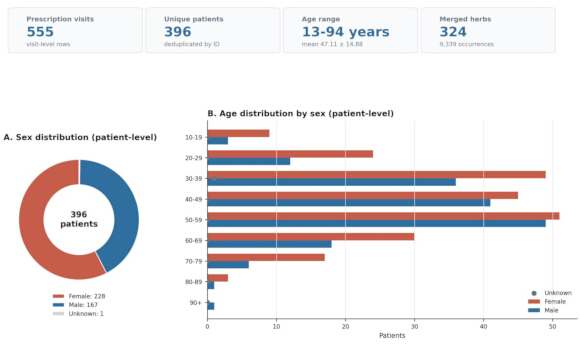
Figura 2: Perfil del conjunto de datos y datos demográficos por paciente. Los cuadros resumen 555 visitas por prescripción, 396 pacientes únicos, un rango de edad a nivel de paciente de 13 a 94 años con una edad media de 47,11 ± 14,88 años, y 324 etiquetas de hierbas fusionadas que representan 9.339 ocurrencias de uso de hierbas. (A) Distribución por sexo a nivel de paciente entre 396 pacientes únicos, incluyendo las categorías femenino, masculino y desconocido. (B) Distribución por edad a nivel de paciente según el sexo entre los mismos 396 pacientes. Los cuadros resumen utilizan los denominadores a nivel de visita o a nivel de paciente, según corresponda. Los colores distinguen las categorías de sexo y los elementos resumen, y no tienen significado inferencial. Haga clic aquí para ver una versión más grande de esta figura.
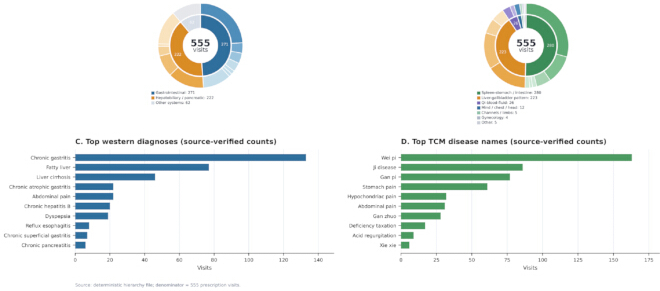
Figura 3: Espectros de enfermedades recuperados de las visitas por receta. (A) Grupos jerárquicos de enfermedades occidentales y (B) grupos jerárquicos de enfermedades de la MTC derivados de 555 visitas por receta elegibles. (C) Principales diagnósticos occidentales normalizados y (D) principales nombres normalizados de enfermedades de la MTC a partir del mismo denominador por visita. Los segmentos anulares y las barras representan el número de visitas; los colores distinguen los sistemas o categorías diagnósticas y no representan efectos terapéuticos. Las etiquetas originales conservadas de la MTC se definen en Tabla 3: Wei pi (plenitud o molestia epigástrica), Ji disease (etiqueta original de la MTC de tipo acumulación), Gan pi (una etiqueta de enfermedad de la MTC utilizada para trastornos hepáticos grasos), Gan zhuo (literalmente, fijación hepática; una etiqueta clásica conservada de enfermedad de la MTC), Bi disease (enfermedad de obstrucción), Xiao ke (consumo-sed), Xie xie (heces sueltas o acuosas) y Fu xie (diarrea). Estas aclaraciones no convierten las etiquetas originales en diagnósticos biomédicos modernos. Haga clic aquí para ver una versión más grande de esta figura.
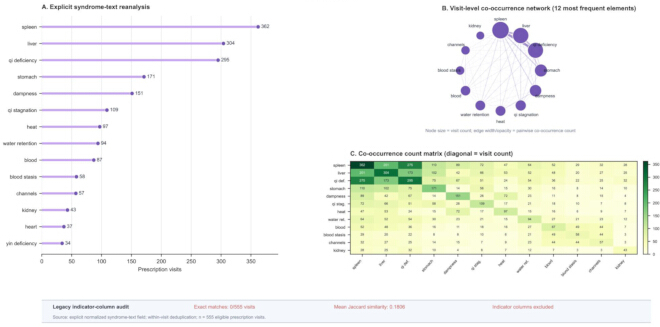
Figura 4: Espectro explícito de síndromes y texto, y estructura de co-ocurrencia. (A) Frecuencias por visita de 14 elementos normalizados de síndrome tras la eliminación de duplicados dentro de cada visita, utilizando 555 visitas de prescripción elegibles como denominador. (B) Red de co-ocurrencia de los 12 elementos de síndrome más frecuentes; el tamaño de los nodos representa la frecuencia de visitas, y el ancho y la opacidad de los enlaces representan los conteos de co-ocurrencia por pares. (C) Matriz simétrica correspondiente de conteos de co-ocurrencia; las celdas diagonales representan frecuencias individuales de visitas, y las celdas fuera de la diagonal representan conteos de co-ocurrencia por pares. La banda de auditoría indica 0 coincidencias exactas entre texto de síndrome e indicador en 555 filas y una similitud media de Jaccard texto-indicador de 0.1806; por lo tanto, las columnas de indicadores antiguas se excluyeron del informe sustantivo. En la matriz, Qi def. denota deficiencia de qi, Qi stag. denota estancamiento de qi y Water ret. denota retención de agua. La paleta de colores es descriptiva. No se aplican barras de error. Haga clic aquí para ver una versión más grande de esta figura.
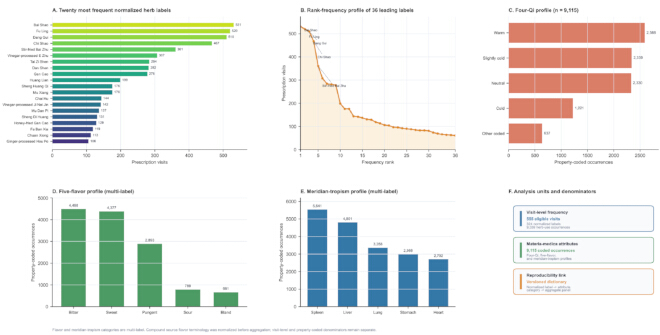
Figura 5: Hierbas de alta frecuencia y perfiles normalizados de atributos de materia médica. (A) Las veinte etiquetas de hierbas normalizadas más frecuentes entre 555 visitas con prescripción elegibles. (B) Perfil de frecuencia por rango de las 36 principales etiquetas de hierbas normalizadas. (C) Distribución de los Cuatro Qi basada en 9.115 ocurrencias codificadas de uso de hierbas; el Cuatro Qi tiene un valor único para cada ocurrencia codificada. (D) Distribución de los Cinco Sabores y (E) distribución de la tropismo meridiano basadas en el mismo denominador codificado por propiedades; ambos son atributos de múltiples etiquetas, por lo que los conteos de categorías no son excluyentes. (F) Unidades de análisis por visita y por codificación de propiedades, y su vínculo de reproducibilidad. Las longitudes de las barras representan los conteos, y los colores distinguen los paneles. No se aplican barras de error. Haga clic aquí para ver una versión más grande de esta figura.
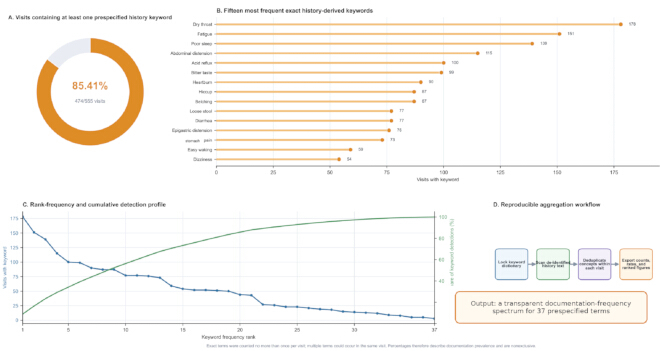
Figura 6: Espectro de palabras clave de síntomas derivadas del historial y flujo de trabajo reproductible de agregación. (A) Proporción de 555 visitas médicas elegibles con receta que contenían al menos una palabra clave preespecificada del historial; 474 visitas (85,41 %) contenían al menos una palabra clave. (B) Los quince conceptos exactos de síntomas derivados del historial más frecuentes. (C) Distribución completa de frecuencia por rango de 37 términos y participación acumulada de detecciones de palabras clave. (D) Flujo de trabajo con versión fija, desde el diccionario preespecificado hasta las salidas agregadas. Cada concepto se contó no más de una vez por visita, aunque podían aparecer múltiples conceptos en una misma visita. Las barras naranjas representan los conteos de palabras clave, y los colores del flujo de trabajo distinguen las etapas de procesamiento. No se aplican barras de error. Haga clic aquí para ver una versión más grande de esta figura.
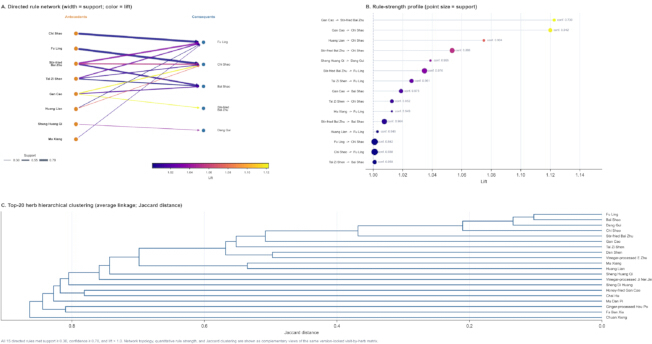
Figura 7: Reglas de asociación dirigidas de hierbas y agrupamiento jerárquico. (A) Red bipartita dirigida de las 15 reglas de asociación individuales de hierbas que cumplen con los umbrales preespecificados de soporte ≥ 0,30, confianza ≥ 0,70 y elevación > 1,0. El ancho de la arista representa el soporte, y el color de la arista representa la elevación. (B) Perfil de intensidad de la regla para las mismas 15 reglas ordenadas por elevación; el tamaño del punto representa el soporte, y las etiquetas adyacentes indican la confianza (conf.). (C) Agrupamiento jerárquico con enlace promedio de las 20 variables de presencia de hierbas con mayor frecuencia, utilizando la distancia de Jaccard. Todos los paneles utilizan las visitas con receta como unidad de análisis y describen patrones de registro conjunto, no eficacia, sinergia ni una combinación fija recomendada. No se aplican barras de error. Haga clic aquí para ver una versión más grande de esta figura.
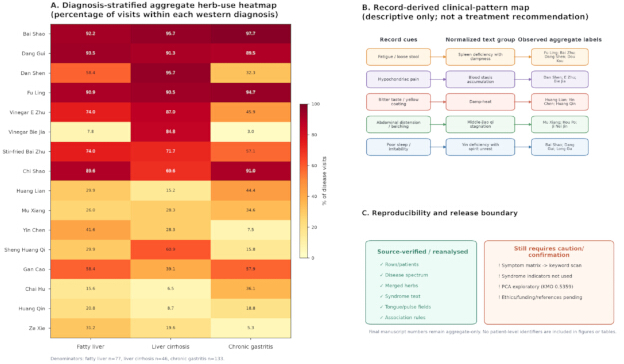
Figura 8: Patrones agregados de hierbas estratificados por diagnóstico, mapa de patrones clínicos y límite de publicación. (A) Mapa de calor estratificado por diagnóstico que muestra la prevalencia a nivel de visita de 16 etiquetas normalizadas de hierbas en hígado graso (n = 77), cirrosis hepática (n = 46) y gastritis crónica (n = 133). Cada celda representa el porcentaje de visitas elegibles dentro del estrato correspondiente al diagnóstico occidental, utilizando una escala de color fija del 0 % al 100 %. (B) Mapa de patrones clínicos derivado de registros que vincula las señales verificadas en los registros con grupos de texto normalizados y las etiquetas observadas de hierbas agregadas. Los conectores discontinuos y no direccionales distinguen esta capa interpretativa descriptiva de la prevalencia calculada; el panel no constituye una recomendación de tratamiento. (C) Reproducibilidad y límite de publicación que distingue los componentes verificados en la fuente o reanalizados de aquellos elementos que requieren precaución o confirmación. Haga clic aquí para ver una versión más grande de esta figura.
| Métrica | Valor | Unidad/denominador | Estado |
| Visitas con receta | 555 | 555 visitas con receta | verificado a partir del archivo XLSX recuperado |
| Pacientes únicos | 396 | 396 pacientes únicos | verificado a partir del archivo XLSX recuperado |
| Rango de edad por paciente | 13-94 | años | verificado |
| Edad media ± DE por paciente | 47.11 ± 14.88 | años | verificado |
| Edad media ± DE por visita | 48.22 ± 15.82 | años | verificado |
| Sexo por paciente | Femenino 228; masculino 167; desconocido 1 | 396 pacientes | verificado |
| Sexo por visita | Femenino 327; masculino 227; desconocido 1 | 555 visitas | verificado |
| Plantas medicinales combinadas | 324 | nombres combinados distintos | verificado |
| Ocurrencias combinadas de uso de plantas medicinales | 9339 | 555 visitas con receta | verificado |
Tabla 1: Perfil del conjunto de datos. Se presentan las características demográficas a nivel de paciente y las variables a nivel de consulta-prescripción utilizando sus respectivos denominadores. También se proporcionan los totales normalizados de hierbas.
| Nombre de la enfermedad | Conteo | Porcentaje de visitas |
| Gastritis crónica | 133 | 24 |
| Hígado graso | 77 | 13,9 |
| Cirrosis hepática | 46 | 8,3 |
| Gastritis atrófica crónica | 22 | 4 |
| Dolor abdominal | 22 | 4 |
| Hepatitis B crónica | 20 | 3,6 |
| Dispepsia | 19 | 3,4 |
| Esofagitis por reflujo | 8 | 1,4 |
| Gastritis superficial crónica | 7 | 1,3 |
| Pancreatitis crónica | 6 | 1,1 |
| Colitis ulcerosa | 6 | 1,1 |
| Pólipo de vesícula biliar | 6 | 1,1 |
| Síndrome poscolecistectomía | 6 | 1,1 |
| Disfunción intestinal | 6 | 1,1 |
| Piedras en la vesícula biliar | 6 | 1,1 |
| Hepatitis crónica | 5 | 0,9 |
| Fatiga | 5 | 0,9 |
| Disfunción gastrointestinal (etiqueta original incierta) | 5 | 0,9 |
| Gastritis crónica (etiqueta original incierta) | 5 | 0,9 |
| Cirrosis hepática autoinmune | 4 | 0,7 |
Tabla 2: Principales diagnósticos occidentales normalizados. Recuentos y porcentajes de los principales diagnósticos occidentales normalizados registrados en 555 visitas elegibles para receta. Los porcentajes utilizan las visitas elegibles para receta como denominador.
| Nombre de la enfermedad en la MTC | Recuento | Porcentaje de visitas |
| Wei pi (plenitud o molestia epigástrica) | 163 | 29,4 |
| Enfermedad Ji (etiqueta de MTC de tipo acumulación) | 86 | 15,5 |
| Gan pi (etiqueta de enfermedad de la MTC utilizada para trastornos de hígado graso) | 77 | 13,9 |
| Dolor de estómago | 61 | 11 |
| Dolor hipcondríaco | 32 | 5,8 |
| Dolor abdominal | 31 | 5,6 |
| Gan zhuo (literalmente, fijación hepática; una etiqueta clásica retenida de enfermedad en la MTC) | 28 | 5 |
| Debilidad por agotamiento | 17 | 3,1 |
| Regurgitación ácida | 9 | 1,6 |
| Xie xie (heces sueltas o acuosas) | 6 | 1,1 |
| Insomnio | 4 | 0,7 |
| Disentería | 4 | 0,7 |
| Dolor de cabeza | 4 | 0,7 |
| Enfermedad Bi (enfermedad de impedimento) | 4 | 0,7 |
| Trastorno menstrual | 3 | 0,5 |
| Obstrucción torácica | 3 | 0,5 |
| Trastorno del sudor | 3 | 0,5 |
| Estreñimiento | 3 | 0,5 |
| Fu xie (diarrea) | 2 | 0,4 |
| Xiao ke (desequilibrio por sed y emaciación) | 2 | 0,4 |
Tabla 3: Nombres principales de enfermedades de la MTC normalizadas. Recuentos y porcentajes de los principales nombres de enfermedades de la MTC normalizadas registradas en 555 visitas con prescripción elegibles. Los porcentajes utilizan las visitas con prescripción elegibles como denominador. Las etiquetas fuente retenidas y las aclaraciones explicativas no implican equivalencia con diagnósticos biomédicos modernos.
| Clasificación | Elemento del síndrome | Consultas con prescripción | Consultas elegibles | Porcentaje de consultas |
| 1 | bazo | 362 | 555 | 65.23% |
| 2 | hígado | 304 | 555 | 54.77% |
| 3 | déficit de qi | 295 | 555 | 53.15% |
| 4 | estómago | 171 | 555 | 30.81% |
| 5 | humedad | 151 | 555 | 27.21% |
| 6 | estancamiento de qi | 109 | 555 | 19.64% |
| 7 | calor | 97 | 555 | 17.48% |
| 8 | retención de agua | 94 | 555 | 16.94% |
| 9 | sangre | 87 | 555 | 15.68% |
| 10 | estasis sanguínea | 58 | 555 | 10.45% |
| 11 | canales | 57 | 555 | 10.27% |
| 12 | riñón | 43 | 555 | 7.75% |
| 13 | corazón | 37 | 555 | 6.67% |
| 14 | déficit de yin | 34 | 555 | 6.13% |
Tabla 4: Elementos principales del síndrome normalizados. Los elementos del síndrome se extrajeron del texto explícito del síndrome normalizado y se eliminaron los duplicados dentro de cada visita de receta. Los conteos utilizan 555 visitas de receta elegibles como denominador; los porcentajes no son excluyentes porque pueden ocurrir múltiples elementos del síndrome dentro de una misma visita.
| Etiqueta combinada de hierba | Recuento | Porcentaje de visitas |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| Bai Zhu salteado | 361 | 65 |
| E Zhu procesado con vinagre | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| Sheng Huang Qi | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| Ji Nei Jin procesado con vinagre | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| Sheng Di Huang | 131 | 23.6 |
| Gan Cao frito con miel | 129 | 23.2 |
| Fa Ban Xia | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| Hou Po procesado con jengibre | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| Sheng Bai Zhu | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| Sheng Long Gu | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| Bie Jia procesado con vinagre | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14.6 |
| Jiao Zhi Zi | 74 | 13.3 |
| He Huan Hua | 69 | 12.4 |
| Huang Jing procesado con vino | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| Ze Xie | 63 | 11.4 |
| Jin Qian Cao | 61 | 11 |
Tabla 5: Etiquetas principales de hierbas normalizadas según la frecuencia de prescripción-visita. Cada etiqueta de hierba normalizada se contó una vez como máximo por visita con prescripción. Los conteos y porcentajes utilizan 555 visitas con prescripción elegibles como denominador, y las formas de procesamiento clínicamente significativas se conservan como etiquetas separadas.
| Clasificación | Palabra clave derivada de la historia clínica | Consultas con receta | Consultas elegibles | Porcentaje de consultas |
| 1 | Garganta seca | 178 | 555 | 32,07% |
| 2 | Cansancio | 151 | 555 | 27,21% |
| 3 | Sueño deficiente | 139 | 555 | 25,05% |
| 4 | Dolor abdominal | 115 | 555 | 20,72% |
| 5 | Reflujo ácido | 100 | 555 | 18,02% |
| 6 | Sabor amargo | 99 | 555 | 17,84% |
| 7 | Piroxia | 90 | 555 | 16,22% |
| 8 | Hipo | 87 | 555 | 15,68% |
| 9 | Eructos | 87 | 555 | 15,68% |
| 10 | Deposiciones sueltas | 77 | 555 | 13,87% |
| 11 | Diarrea | 77 | 555 | 13,87% |
| 12 | Dolor epigástrico | 76 | 555 | 13,69% |
| 13 | Dolor de estómago | 73 | 555 | 13,15% |
| 14 | Despertar fácil | 59 | 555 | 10,63% |
| 15 | Mareo | 54 | 555 | 9,73% |
| 16 | Vómitos | 52 | 555 | 9,37% |
| 17 | Náuseas | 52 | 555 | 9,37% |
| 18 | Dolor sordo | 51 | 555 | 9,19% |
| 19 | Dolor distendente | 50 | 555 | 9,01% |
| 20 | Pérdida de apetito | 44 | 555 | 7,93% |
| 21 | Dolor abdominal | 43 | 555 | 7,75% |
| 22 | Oprimido en el pecho | 27 | 555 | 4,86% |
| 23 | Irritabilidad | 26 | 555 | 4,68% |
| 24 | Dolor de cabeza | 23 | 555 | 4,14% |
| 25 | Borborigmos | 23 | 555 | 4,14% |
| 26 | Molestia epigástrica | 21 | 555 | 3,78% |
| 27 | Palpitaciones | 19 | 555 | 3,42% |
| 28 | Orina amarilla | 18 | 555 | 3,24% |
| 29 | Sensación de cuerpo extraño | 15 | 555 | 2,70% |
| 30 | Dolor punzante | 14 | 555 | 2,52% |
| 31 | Estreñimiento | 13 | 555 | 2,34% |
| 32 | Somnolencia | 12 | 555 | 2,16% |
| 33 | Sensación de cuerpo extraño en faringe | 9 | 555 | 1,62% |
| 34 | Sudoración excesiva | 8 | 555 | 1,44% |
| 35 | Dolor hipcondríaco | 5 | 555 | 0,90% |
| 36 | Tenesmo | 5 | 555 | 0,90% |
| 37 | Deposiciones secas | 3 | 555 | 0,54% |
Tabla 6: Palabras clave principales de síntomas derivadas de la historia clínica. Conceptos exactos de síntomas detectados en el texto de la historia clínica desidentificado. Cada concepto se contó no más de una vez dentro de una visita de receta, aunque varios conceptos pudieron ocurrir en la misma visita. Los conteos y porcentajes utilizan 555 visitas de receta elegibles como denominador.
| Antecedente | Consecuente | Visitas coocurrentes | Soporte | Confianza | Elevación |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Bai Zhu salteado | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Bai Zhu salteado | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Bai Zhu salteado | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Bai Zhu salteado | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Tabla 7: Reglas de asociación dirigidas entre hierbas que cumplen los umbrales preespecificados. Las reglas se generaron a partir de 555 filas binarias de prescripción-visita utilizando un soporte ≥ 0,30, una confianza ≥ 0,70 y un lift > 1,0. El soporte utiliza 555 visitas de prescripción como denominador, y se mantiene la dirección de la regla porque la confianza es direccional.
| Etiqueta de hierba | Hígado graso (n) | Hígado graso (N) | Hígado graso (%) | Cirrosis hepática (n) | Cirrosis hepática (N) | Cirrosis hepática (%) | Gastritis crónica (n) | Gastritis crónica (N) | Gastritis crónica (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| Vinegar-processed E Zhu | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Vinegar-processed Bie Jia | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Stir-fried Bai Zhu | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Tabla 8: Prevalencia del uso de hierbas estratificada por diagnóstico. Numeradores, denominadores y prevalencia a nivel de visita de 16 etiquetas normalizadas de hierbas en hígado graso (n = 77), cirrosis hepática (n = 46) y gastritis crónica (n = 133). Cada etiqueta de hierba se contó no más de una vez por visita de prescripción elegible.
Tabla suplementaria 1: Registro de transparencia y auditoría asistido por IA. Documentación que distingue el registro de análisis original de la revisión de coherencia realizada en la etapa de revisión el 21 de agosto de 2026. La tabla registra la herramienta/modelo/versión, el alcance de la entrada, el propósito, la discrepancia identificada en la cardinalidad de los Cuatro Qi, la corrección humana, las limitaciones de uso, la información del revisor, la disposición final y la plantilla del prompt. No se proporcionaron al sistema de IA filas con datos brutos a nivel de paciente. Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Resultados de la calidad de los datos del auditoría de fuentes. Se informa la exhaustividad de los campos recuperados, los hallazgos de la auditoría, las acciones analíticas y los estados publicados para los campos clínicos de origen y las estructuras analíticas heredadas. La tabla documenta la exclusión de indicadores de síndrome heredados no conciliados, la corrección de totales anteriores de hierbas, la ausencia de vectores de distribución reconstruibles anteriores a la limpieza para la estimación de estabilidad entre versiones, y las cantidades que no pudieron reconstruirse. Haga clic aquí para descargar este archivo.
Tabla suplementaria 3: Correlación de la nomenclatura de hierbas. Las etiquetas controladas para la visualización de hierbas se vinculan a calificadores de procesamiento, nombres estándar de materiales medicinales chinos (MMC), terminología de origen, fuentes botánicas, zoológicas o minerales, versiones de referencia, localizadores de evidencia y límites de evidencia. Las etiquetas específicas del procesamiento se mantienen cuando tienen relevancia clínica. Haga clic aquí para descargar este archivo.
Tabla suplementaria 4: Análisis de sensibilidad de umbrales y visitas repetidas. Se presentan perturbaciones en los umbrales de las reglas de asociación, comparaciones de conjuntos de reglas con una visita por paciente, métricas de sensibilidad de Chi Shao > Fu Ling y la comparación de distancias de entrada para agrupamiento de 190 pares. Haga clic aquí para descargar este archivo.
Archivo complementario 1: Script del umbral determinista y sensibilidad por visita repetida. Script determinista utilizado para reproducir las métricas agregadas de umbral y sensibilidad por visita repetida a partir del conjunto de datos fuente con versión fija. El archivo no contiene datos a nivel de paciente. Haga clic aquí para descargar este archivo.
Discusión
La contribución principal de este protocolo es una ruta completa y verificable desde registros de casos de MTC desidentificados hasta figuras agregadas para investigación. Los pasos más críticos consisten en congelar la regla de identificación de la cohorte antes de inspeccionar los resultados analíticos, distinguir pacientes únicos de visitas por prescripción, conservar cada mapeo original-a-normalizado de términos y verificar cada numerador y denominador antes de la visualización. Estos controles transforman la limpieza de datos de una actividad preliminar invisible en un componente documentado del método. También alinean el flujo de trabajo con las normas RECORD, STROBE, FAIR y los marcos establecidos de calidad de datos de HCE11,12,13,14,15. Un resultado se considera listo para su publicación solo cuando su campo fuente, unidad de análisis, versión del diccionario, regla de cálculo, denominador, tabla, figura y decisión del revisor pueden rastrearse en el registro de evidencia.
El método es innovador porque integra gobernanza, ingeniería terminológica, computación, visualización y revisión clínica en lugar de tratarlas como tareas separadas. Una única matriz explícita de síndromes genera el espectro de frecuencias, la red de coocurrencia y el mapa de calor. Una única matriz de prescripción-visita-por-hierba respalda resúmenes de frecuencia, reglas de asociación dirigidas y agrupamiento jerárquico19,20,21. Una única tabla estratificada por diagnóstico permite tanto porcentajes exactos como el mapa de calor final. El flujo de trabajo analítico utiliza herramientas de código abierto reproducibles mediante scripts36,37,38,39,40, lo que permite que una corrección en un diccionario inicial o en una decisión de cohorte se propague a todas las salidas dependientes. Trabajos previos sobre almacenes clínicos de datos también demuestran la importancia del preprocesamiento vinculado a la fuente y la reutilización de datos estructurados41,42. Esta arquitectura reduce la transcripción manual, mantiene la alineación entre los códigos gráficos y las tablas originales, y facilita la auditoría, la enseñanza y la transferencia a otros equipos de investigación.
Tres estudios recientes de minería de bases de datos proporcionan principios útiles de diseño, aunque su unidad de análisis es una publicación y no una consulta clínica. El estudio sobre artritis reumatoide y depresión combina una estrategia de búsqueda predefinida con análisis por país, institución, autor, revista, palabras clave y cronología26. El estudio sobre colitis ulcerosa e inhibidores de la quinasa Janus utiliza colaboración coordinada, análisis de co-citación, agrupamiento y detección de brotes para distinguir temas persistentes de frentes emergentes de investigación27. El estudio sobre artritis reumatoide y fibromialgia amplía el mapeo bibliométrico con bioinformática, manteniendo al mismo tiempo una distinción entre las dos capas de evidencia28. El presente protocolo aplica el mismo principio de vistas analíticas coordinadas pero no intercambiables. La transferencia a ginecología, medicina respiratoria, reumatología u otra especialidad requiere la reconstrucción de campos específicos de la especialidad, diccionarios de terminología, reglas de inclusión y exclusión, resultados y procedimientos de revisión clínica antes de reutilizar el conjunto de reglas. Los espectros de enfermedades, redes de síndromes, palabras clave de síntomas, reglas de asociación, agrupamientos y patrones estratificados por diagnóstico surgen todos de fuentes con versión bloqueada, pero cada uno aborda una pregunta distinta y mantiene su propio denominador y límite interpretativo.
La inteligencia artificial supervisada por humanos puede proporcionar una capa adicional de control de calidad cuando se limita a extractos desidentificados aprobados o materiales agregados. Dentro de este flujo de trabajo, la IA puede comparar la terminología entre archivos, señalar inconsistencias entre leyendas y tablas, identificar etiquetas que se extienden más allá de los límites de las figuras, verificar que cada nodo de red mostrado tenga una conexión válida y sugerir redacciones más claras. La IA no determina la elegibilidad de la cohorte, no inventa mapeos de terminología, no infiere efectos del tratamiento ni sustituye la revisión de los datos originales. Esta división de responsabilidades es coherente con la visión más amplia de que la IA médica debe complementar el juicio humano en lugar de ocultar la responsabilidad33. También refleja el énfasis de DECIDE-AI en factores humanos transparentes, manejo de errores y evaluación responsable34. Por lo tanto, con cada uso de asistencia mediante IA, se debe conservar en el registro de auditoría el propósito de cada indicación, la salida revisada, la corrección aceptada, el revisor y la fecha.
La solución de problemas es particularmente importante cuando un resultado parece clínicamente plausible pero no supera la verificación de la fuente. En tales casos, debe suspenderse la interpretación posterior hasta que la discrepancia se rastree hasta la determinación de elegibilidad, la eliminación de duplicados, la asignación de terminología, la selección de campos, la elección del denominador o la elaboración de la figura. Luego, todos los resultados dependientes deben regenerarse tras la corrección. El ejemplo desarrollado sigue siendo un conjunto de datos retrospectivo de pacientes externos expertos de un solo centro, en el que las visitas repetidas no son independientes entre sí. El análisis de sensibilidad de una visita por paciente redujo el conjunto de reglas conservadas de 15 a 12, manteniendo la pertenencia de las 20 hierbas principales. Entre todos los 190 pares no ordenados entre estas 20 variables compartidas, la correlación de Pearson fue de 0,9944, la rho de Spearman fue de 0,9836, el cambio absoluto medio en la distancia de Jaccard fue de 0,0146 y el cambio máximo fue de 0,0528 (Supplementary Table 4). Por consiguiente, un alto soporte a nivel de visita no debe interpretarse como una validación a nivel de paciente. El espectro de palabras clave en la historia clínica refleja documentación literal y no una escala de síntomas validada. Los resúmenes de materia médica están ponderados por frecuencia de aparición y no por dosis. Las reglas de asociación describen co-registro y no causalidad. Los mapas de calor estratificados por diagnóstico son descriptivos y no establecen eficacia comparativa, especificidad de la enfermedad ni necesidad del tratamiento.
El protocolo puede aplicarse a la investigación sobre la herencia de la experiencia clínica experta, la descripción de cohortes especializadas de pacientes ambulatorios, la armonización de terminologías en múltiples centros, la revisión de la calidad de la documentación, la selección de variables para registros prospectivos y la preparación consciente de la privacidad de conjuntos de datos agregados para colaboraciones. Trabajos futuros podrían incorporar la recopilación prospectiva y estructurada de síntomas, modelos agrupados por paciente, variables de dosis explícitas, hipótesis comparativas preespecificadas, validación externa, servicios de terminología con versiones controladas, cálculos que preserven la privacidad y registros de evidencia interactivos. El procesamiento de lenguaje natural y la revisión asistida por inteligencia artificial podrían reducir aún más la curación repetitiva cuando se rigen por reglas bloqueadas por versiones y verificación humana. Más ampliamente, el protocolo permite transformar la experiencia clínica dispersa en un objeto de investigación transparente que puede ser inspeccionado, reproducido, cuestionado y ampliado. El método no convierte la frecuencia en eficacia; más bien, convierte decisiones analíticas no documentadas en evidencia visible, proporcionando una base para preguntas clínicas más rigurosas e investigaciones en medicina tradicional china más duraderas en el mundo real.
Divulgaciones
Los autores declaran que no tienen intereses en competencia.
Agradecimientos
OpenAI Codex (gpt-5.6-luna y gpt-5.6-sol) se utilizó exclusivamente durante la revisión del manuscrito para verificaciones de coherencia entre archivos a nivel agregado y sugerencias de redacción. No se proporcionaron al sistema de inteligencia artificial registros a nivel de paciente. Todos los resultados asistidos por inteligencia artificial fueron verificados independientemente frente a los materiales originales por Tian Xia el 21 de agosto de 2026. Los autores revisaron y aprobaron el contenido final y asumen toda la responsabilidad sobre el manuscrito. Este proyecto fue financiado por el Programa Nacional Clave de Investigación y Desarrollo de China, Proyecto Especial Clave sobre la Modernización de la Medicina Tradicional China (No. 2025YFC3512800); el Proyecto Nacional Clave de Ciencia y Tecnología de China (Proyecto No. 2026ZD0554100; Subproyecto No. 2026ZD0554101); el Proyecto de Mejora de la Capacidad de Investigación Clínica y Traducción de Resultados del Hospital de Alta Especialización en Medicina Tradicional China, Proyecto Especial para la Transmisión de la Experiencia Académica de Expertos Renombrados en Medicina Tradicional China (No. HLCMHPP2023016); y la Fundación de Ciencias Naturales de la Región Autónoma de Xinjiang Uygur (No. 2025D01C213).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Consolidar hojas de cálculo de reanálisis | Archivos locales generados por el autor | No aplicable | Utilizado para conteos agregados, tablas y generación de figuras. |
| Exportación de registros de casos ambulatorios desidentificados | Sistema institucional de historiales médicos electrónicos | No aplicable | Utilizado únicamente en el entorno institucional controlado; los registros a nivel de paciente no son materiales de envío. |
| lxml | Proyecto lxml | 6.1.1 | Versión del software utilizada para la serialización que conserva los espacios de nombres durante la regeneración en la etapa de revisión; no es la versión original histórica de análisis. |
| Matplotlib | Proyecto Matplotlib (matplotlib.org) | 3.11.1 | Versión observada en el entorno de regeneración en la etapa de revisión y en los metadatos SVG de la Figura 3; no es la versión original histórica de análisis. |
| NetworkX | Proyecto NetworkX | Paquete PyPI: networkx | Identificador del paquete registrado; no se verificó la versión exacta en la etapa de revisión en el entorno heredado. |
| NumPy | Proyecto NumPy | 2.3.5 | Versión del software utilizada para regenerar las salidas agregadas revisadas; no es la versión original histórica de análisis. |
| openpyxl | Proyecto openpyxl | 3.1.5 | Versión del software utilizada para escribir las salidas XLSX agregadas revisadas; no es la versión original histórica de análisis. |
| pandas | Proyecto pandas | 3.0.1 | Versión del software utilizada para regenerar las salidas agregadas revisadas; no es la versión original histórica de análisis. |
| PyMuPDF | Proyecto PyMuPDF | 1.28.2 | Versión del software utilizada para la regeneración en la etapa de revisión de las salidas de figuras revisadas; no es la versión original histórica de análisis. |
| Python | Python Software Foundation | 3.13.15 | Versión del software utilizada para regenerar las salidas agregadas revisadas; no es la versión original histórica de análisis. |
| SciPy | Proyecto SciPy | Paquete PyPI: scipy | Identificador del paquete registrado; no se verificó la versión exacta en la etapa de revisión en el entorno heredado. |
Referencias
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.