Análisis transcriptómicos integrados, tanto masivos como de célula individual, identificaron seis biomarcadores diagnósticos relacionados con el metabolismo del hemo para los queloides. La validación experimental respaldó la desregulación del receptor 1 del virus de la leucemia felina del subgrupo C (FLVCR1) en fibroblastos queloides, mientras que el acoplamiento molecular identificó a la (+)-galocatequina como un compuesto potencialmente interactuante con FLVCR1 que requiere una investigación funcional adicional.
Artículo de investigación
Identificación de biomarcadores relacionados con el metabolismo del hemo en queloides mediante análisis transcriptómico y fibroblastos humanos cultivados
En este artículo
Resumen
Resumen
El queloides es un trastorno fibroproliferativo con alta recurrencia y patogénesis poco clara, que carece de dianas terapéuticas efectivas. Evidencias recientes sugieren que la reprogramación metabólica, particularmente en el metabolismo del hemo, podría impulsar la fibrosis. Este estudio investiga el papel del metabolismo del hemo, centrándose en el receptor 1 del virus de la leucemia felina del subgrupo C (FLVCR1), en la patogénesis del queloides y explora su potencial diagnóstico y terapéutico. Analizamos conjuntos de datos de RNA-seq masivo y datos de RNA-seq de célula individual (scRNA-seq). Mediante expresión diferencial, modelos de selección y contracción absoluta mínima (LASSO) y bosque aleatorio (RF), se identificaron biomarcadores diagnósticos relacionados con el metabolismo del hemo. Se realizaron análisis de infiltración inmunitaria, mapeo a nivel de célula individual, construcción de redes de microARN (miARN) y acoplamiento molecular con compuestos de medicina tradicional china. Se identificaron seis biomarcadores relacionados con el metabolismo del hemo, que forman un nomograma diagnóstico con alta precisión. FLVCR1, enriquecido en células endoteliales y melanocitos, mostró correlación negativa con las células auxiliares foliculares T, lo que sugiere una interacción inmuno-metabólica. El análisis de la red reguladora de miARN reveló cinco miARN que tienen como diana común los seis biomarcadores. El acoplamiento molecular identificó a la (+)-galocatequina como un ligando de FLVCR1 con alta afinidad. Estos hallazgos sugieren una asociación entre el metabolismo del hemo relacionado con FLVCR1 y las alteraciones inmunitarias en la patogénesis del queloides. El panel de biomarcadores mostró un potencial diagnóstico exploratorio, y la (+)-galocatequina fue identificada como un compuesto candidato que interactúa con FLVCR1 y que requiere validación adicional. Este estudio replantea el queloides dentro del espectro metábolo-fibrótico y propone la intervención metabólico-inmunitaria como una estrategia terapéutica novedosa.
Introducción
El queloides, un trastorno fibroproliferativo caracterizado por la deposición excesiva de matriz extracelular que se extiende más allá de los límites de la lesión cutánea original, afecta al 4–16 % de la población mundial, con una prevalencia notablemente mayor entre individuos de ascendencia africana, asiática e hispana1,2. A pesar de su naturaleza histológicamente benigna, el queloides impone una carga física y psicosocial sustancial debido a prurito persistente, dolor, contractura funcional y deformidad estética. Las modalidades terapéuticas actuales, incluidos corticosteroides intralesionales, escisión quirúrgica, radioterapia y terapia láser, siguen siendo subóptimas, con tasas de recurrencia superiores al 50 % tras la monoterapia3,4,5. Este estancamiento terapéutico subraya una brecha fundamental en nuestra comprensión de la patogénesis del queloides, particularmente en lo que respecta a los factores iniciales que desencadenan y mantienen la cascada fibrosa más allá de la señalización profibrótica canónica.
La investigación contemporánea se ha centrado predominantemente en vías canónicas como la señalización TGF-β/Smad y la activación aberrante de fibroblastos6,7,8. Aunque se ha documentado la infiltración de células inmunitarias, particularmente macrófagos polarizados hacia el fenotipo M2, células T reguladoras y células dendríticas desreguladas, en tejidos queloides9,10, estas investigaciones tratan en gran medida las alteraciones inmunitarias como consecuencias tardías de la disfunción de los fibroblastos, más que como reguladores iniciales. De forma crítica, los programas metabólicos que podrían moldear activamente esta interacción inmuno-fibrotica permanecen completamente inexplorados en la patogénesis de los queloides11,12,13. Esta laguna de conocimiento es notable, dadas las nuevas perspectivas emergentes en los trastornos fibroticos, en las que la reprogramación metabólica actúa como regulador maestro del remodelado tisular.
La reprogramación metabólica ha surgido recientemente como un nodo central en la fibrogénesis en múltiples sistemas orgánicos. En la fibrosis pulmonar y hepática, la homeostasis alterada del hemo—mediante la expresión disregulada de transportadores, captadores o enzimas biosintéticas—desencadena estrés oxidativo, ferroptosis e inflamación estéril que promueven directamente la deposición de colágeno14. La acumulación de hemo activa el inflamasoma NLRP3, impulsando la activación de los fibroblastos, mientras que la deficiencia del receptor 1 del virus de la leucemia felina del subgrupo C (FLVCR1) agrava la fibrosis tisular debido a la toxicidad persistente del hemo. Estos hallazgos sitúan el metabolismo del hemo no solo como un proceso de mantenimiento, sino como un centro de señalización dinámico capaz de iniciar cascadas fibróticas, un paradigma aún no evaluado en los trastornos cutáneos fibroproliferativos.
La plausibilidad de la inmunomodulación mediada por el hemo se ve reforzada por evidencia mecanicista procedente de modelos de cáncer y de inflamación crónica. El hemo actúa como una molécula señalizadora que modula directamente el destino de las células inmunitarias: promueve la polarización de macrófagos de fenotipo M1 a M2 mediante la señalización TLR4/NF-κB15, influye en la diferenciación de linfocitos T a través de la represión transcripcional mediada por Bach216, y regula críticamente la maduración de las células dendríticas mediante la exportación de hemo dependiente de FLVCR117,18. Cabe destacar que FLVCR1, un transportador de hemo en la membrana plasmática esencial para la homeostasis celular del hemo, recientemente se ha implicado en el desarrollo de células inmunitarias y en la disfunción endotelial19. Estas líneas convergentes de evidencia sitúan a FLVCR1 como un nexo molecular plausible que vincula la alteración del metabolismo del hemo con la remodelación inmunitaria patológica, una hipótesis con profundas implicaciones para la patogénesis de los queloides dada su microambiente característicamente rico en componentes inmunitarios.
A pesar de los avances significativos en la comprensión de la interacción entre el hemo y el sistema inmunitario en otros contextos patológicos, aún no se ha explorado si el metabolismo disregulado del hemo actúa como un impulsor inicial que desencadena o amplifica el paisaje inmunitario patológico en los queloides. Esta importante brecha de conocimiento requiere una investigación urgente por varias razones interrelacionadas: los queloides comparten características patológicas clave, como la inflamación persistente y el estrés oxidativo, con trastornos fibróticos impulsados metabólicamente, tales como la fibrosis pulmonar y hepática, lo que sugiere una posible similitud en los mecanismos reguladores subyacentes. El sistema de exportación del hemo centrado en FLVCR1 ha sido validado mecanísticamente en tejidos no cutáneos como regulador directo de funciones inmunitarias clave, como la polarización de macrófagos y la maduración de células dendríticas, proporcionando una base teórica sólida para su extrapolación a la inmunopatología del queloides20. Lo más importante es que el enfoque en este eje metabólico-inmunitario ofrece una oportunidad transformadora para ir más allá de las terapias sintomáticas actuales, que simplemente suprimen los efectos fibróticos posteriores, posibilitando así una intervención temprana en el origen metabólico de la progresión de la enfermedad21.
Sobre la base de este razonamiento, planteamos la hipótesis de que la disregulación centrada en FLVCR1 del metabolismo del hemo remodela activamente el microambiente inmunitario para impulsar la patogénesis de los queloides. Para validar sistemáticamente esta hipótesis, integramos análisis transcriptómicos de conjunto y de célula individual en un enfoque multinivel: primero identificamos y validamos biomarcadores diagnósticos asociados al metabolismo del hemo en tejidos queloides mediante algoritmos de aprendizaje automático y verificación en una cohorte independiente; luego determinamos los patrones espaciales de expresión de estos biomarcadores en compartimentos celulares distintos —incluyendo células endoteliales, fibroblastos, melanocitos y subpoblaciones inmunitarias— mediante mapeo a resolución de célula única; posteriormente, definimos sus correlaciones cuantitativas con poblaciones específicas de células inmunitarias para establecer conexiones funcionales entre inmunidad y metabolismo; y finalmente, construimos una red reguladora de microARN (miARN) centrada en FLVCR1 y realizamos acoplamiento molecular con compuestos de medicina tradicional china para identificar puntos de intervención farmacológicamente abordables. Esta investigación exhaustiva no solo revela un eje inmuno-metabólico del hemo previamente desconocido en la patogénesis de los queloides, sino que también proporciona un panel de biomarcadores con relevancia traslacional y potencial dual diagnóstico y terapéutico para este trastorno fibroproliferativo de difícil manejo.
Protocolo
La aprobación ética y el consentimiento informado no fueron aplicables para este estudio porque todos los datos se obtuvieron de bases de datos de acceso público, incluido el Gene Expression Omnibus (GEO), y no se involucraron directamente participantes humanos identificables ni sujetos animales.
Adquisición y preprocesamiento de datos
Los genes asociados al metabolismo del hemo se obtuvieron de la Base de Datos de Firmas Moleculares (MSigDB; véase la Tabla de Materiales y la Tabla Suplementaria S1), incluyendo conjuntos de genes de REACTOME_Heme_Biosynthesis, REACTOME_Heme_Degradation, Wikipathway_Heme_Biosynthesis, REACTOME_Scavenging_Heme_from_Plasma y HALLMARK_Heme_Metabolism. Todos los conjuntos de datos analizados en este estudio se obtuvieron de fuentes públicamente disponibles. Se recuperaron dos conjuntos de datos de microarrays de expresión génica masiva desde la base de datos Gene Expression Omnibus (GEO): GSE44270, que comprende 18 muestras de queloides y 14 muestras de piel normal, y GSE7890, que comprende 10 muestras de queloides y 9 muestras de piel normal. GSE44270 y GSE7890 fueron generados en las plataformas GPL6244 y GPL570, respectivamente. Los archivos de matriz de series y la información correspondiente de las muestras se descargaron e importaron al entorno R. Dado que los valores de expresión en los archivos de matriz de series ya habían sido preprocesados y normalizados por los autores originales de los datos, no se realizó ninguna transformación adicional con log2 ni normalización entre muestras. Los dos conjuntos de datos se procesaron de forma independiente y no se combinaron, ya que fueron generados en plataformas de microarrays diferentes. Los conjuntos de datos se preprocesaron como se describe a continuación (véase la Tabla de Materiales). Las sondas génicas se asignaron a sus símbolos génicos correspondientes, y se excluyeron aquellas sondas que carecían de anotaciones génicas o que coincidían con múltiples genes. Para los genes con múltiples conjuntos de sondas, el valor de expresión se asignó según el nivel de expresión más alto detectado. Además, se descargaron y procesaron datos de secuenciación de ARN de una sola célula (scRNA-seq) de GSE163973, que contiene tres muestras de queloides, siguiendo los estándares de control de calidad definidos en el estudio original.
Identificación y validación de marcadores diagnósticos relacionados con el metabolismo del hemo en queloides
Para identificar genes asociados al metabolismo del hemo diferencialmente expresados en queloides, se aplicó la prueba de suma de rangos de Wilcoxon a GSE44270 utilizando la función de R wilcox.test, con un umbral de significancia de P < 0,05. Para identificar marcadores diagnósticos potenciales para queloides, se emplearon dos modelos de aprendizaje automático: bosque aleatorio (RF) y regresión logística con operador de contracción y selección por mínimos absolutos (LASSO). El análisis de bosque aleatorio se realizó con una semilla aleatoria de 1 para garantizar la reproducibilidad (véase la Tabla de materiales). El modelo se construyó utilizando 500 árboles (ntree = 500), y la importancia de los genes se evaluó según la disminución media de la impureza del nodo (IncNodePurity). Los genes con valores de importancia superiores a 0,3 se seleccionaron como biomarcadores candidatos derivados del bosque aleatorio. La regresión logística LASSO se realizó con α = 1, y se evaluaron 50 valores de lambda durante el entrenamiento del modelo (véase la Tabla de materiales). El parámetro de penalización óptimo se determinó mediante validación cruzada de cinco pliegues con la función cv.glmnet, con una respuesta binomial. Se conservaron los genes con coeficientes de regresión distintos de cero como candidatos seleccionados por LASSO. Finalmente, la intersección de los genes identificados por el bosque aleatorio y la regresión LASSO se consideró como la firma génica diagnóstica final. La firma génica diagnóstica final se evaluó utilizando un modelo basado en un nomograma. Toda la selección de características y la estimación de parámetros del modelo se realizaron exclusivamente en la cohorte de descubrimiento (GSE44270), y la firma final de seis genes se evaluó posteriormente en la cohorte de validación independiente (GSE7890). El rendimiento diagnóstico del nomograma se evaluó calculando el área bajo la curva de característica de operación del receptor (AUC). Para examinar la estabilidad del modelo, el análisis incluyó validación cruzada de cinco pliegues y 1.000 iteraciones de remuestreo bootstrap, a partir de las cuales se derivó una AUC corregida por optimismo. Posteriormente, se utilizó el análisis de curva de decisión (DCA) para estimar el beneficio neto potencial del nomograma; sin embargo, este resultado se interpretó con precaución debido al tamaño reducido de la muestra.
Infiltración de células inmunitarias y análisis de correlación
El enriquecimiento de células inmunitarias se evaluó mediante un análisis de enriquecimiento de conjuntos de genes a partir de una sola muestra (ssGSEA) (véase la Tabla de materiales). La matriz de firmas de células inmunitarias se obtuvo de un estudio publicado previamente por Charoentong et al.22 y contenía 782 genes marcadores que representan 28 poblaciones de células inmunitarias innatas y adaptativas. El análisis se realizó utilizando un kernel gaussiano sobre los valores de expresión normalizados y continuos de la matriz de microarrays. Se requirió un tamaño mínimo del conjunto de genes de 10 tras emparejar los genes marcadores con la matriz de expresión, y las puntuaciones resultantes de ssGSEA se normalizaron. Todos los demás parámetros se mantuvieron en sus valores predeterminados. Posteriormente, se calcularon los coeficientes de correlación de Pearson para evaluar las relaciones entre las puntuaciones de enriquecimiento de células inmunitarias y la expresión génica diagnóstica. La matriz de correlación resultante se visualizó como un gráfico de correlación, y algunas asociaciones seleccionadas se mostraron adicionalmente como gráficos de caramelo (véase la Tabla de materiales).
Procesamiento y análisis de datos de secuenciación de ARN a nivel de célula individual
Los datos de secuenciación de ARN de una sola célula se obtuvieron de GSE163973, y solo se incluyeron en el presente análisis las tres muestras de queloides, KF1, KF2 y KF3. Los datos de expresión se importaron y procesaron como se describe a continuación (véase la Tabla de materiales). Se excluyeron las células con menos de 200 o más de 6.000 conteos totales de identificadores moleculares únicos (UMI), y se eliminaron los dobletes predichos. Los conteos de expresión génica para cada célula se normalizaron respecto a la expresión celular total, se multiplicaron por un factor de escala de 10.000 y se transformaron mediante logaritmo. La variación asociada al lote se eliminó mediante regresión durante la normalización de los datos, y los residuos normalizados resultantes se utilizaron para el análisis posterior. Se seleccionaron los 2.000 genes más variables según su expresión media y dispersión, y se realizó un análisis de componentes principales sobre ellos. Los primeros 15 componentes principales se utilizaron para construir un grafo de k vecinos más cercanos basado en distancias euclidianas, que posteriormente se convirtió en un grafo de vecinos más cercanos compartidos. Las células se agruparon mediante el algoritmo Louvain con una resolución de 0,8, y se realizó una proyección mediante aproximación uniforme de variedades utilizando los mismos 15 componentes principales. Las células se anotaron según las definiciones de tipos celulares reportadas en el estudio original, y las anotaciones resultantes se registraron en el campo de metadatos. Las anotaciones de tipos celulares y las asignaciones de grupos se visualizaron sobre las coordenadas de la proyección mediante aproximación uniforme de variedades, y se mostró la expresión de genes diagnósticos a través de las poblaciones celulares anotadas.
Construcción de la red reguladora de miARN–mARN
Se construyó la red reguladora de miARN–ARNm como se describe a continuación (véase la Tabla de materiales). Se seleccionó Homo sapiens como el organismo, y los identificadores génicos se proporcionaron como símbolos génicos oficiales. Los genes candidatos se enviaron al módulo de interacciones gen–miARN, y se seleccionó TarBase v9.0 como la base de datos de interacciones. TarBase contiene interacciones reguladoras entre miARN y genes validadas experimentalmente. Solo se conservaron para la construcción de la red las interacciones miARN–ARNm respaldadas experimentalmente que involucraban los genes candidatos de entrada, mientras que se excluyeron las interacciones predichas sin evidencia experimental. No se estableció ningún umbral adicional de puntuación de confianza.
Selección virtual basada en la estructura y análisis de acoplamiento molecular
Se realizó una selección virtual para priorizar ligandos candidatos a partir de la biblioteca de compuestos frente a la FLVCR1 humana (proteína relacionada con el receptor del virus de la leucemia felina, subgrupo C, 1; véase la Tabla de materiales) utilizando un flujo de trabajo de selección virtual basado en estructura (SBVS). La estructura tridimensional de la FLVCR1 humana se obtuvo del Protein Data Bank (PDB ID: 8UBZ). Esta estructura representa la FLVCR1 humana unida a colina, determinada mediante microscopía electrónica criogénica de partículas individuales a una resolución global de 3,02 Å (acceso EMDB: EMD-42110). Se seleccionó la estructura determinada experimentalmente porque contiene la conformación de FLVCR1 con sustrato unido, proporcionando así información estructural para definir la cavidad de unión al ligando fisiológicamente relevante. Durante la preparación del receptor, se mantuvieron las moléculas de colina (CHT) y hemisuccinato de colesterol (Y01) resueltas conjuntamente, con el fin de preservar el entorno estructural que rodea la región de entrada del sustrato y unión del ligando. El espacio de búsqueda para el acoplamiento se definió alrededor de la cavidad de unión al sustrato/ligando de FLVCR1, incluyendo la región de unión a colina resuelta conjuntamente. La caja de rejilla se centró en x = 160,587 Å, y = 160,613 Å y z = 160,484 Å. Las dimensiones de la caja de acoplamiento se establecieron en [X × Y × Z Å] para asegurar una cobertura adecuada de la cavidad de unión al sustrato y los residuos circundantes. Posteriormente, se acoplaron los compuestos candidatos en esta región de unión predeterminada. Las posiciones de acoplamiento se clasificaron según sus afinidades de unión predichas, siendo las puntuaciones de acoplamiento más negativas indicativas de interacciones predichas más favorables entre el ligando y FLVCR1. Los compuestos mejor clasificados se seleccionaron para análisis posteriores del modo de unión y de las interacciones proteína-ligando.
Simulación de dinámica molecular y cálculo de la energía libre de unión mediante MM/GBSA
Se utilizó una simulación de dinámica molecular (MD) para examinar más a fondo el complejo proteína–ligando predicho (véase la Tabla de materiales). La topología del ligando se preparó asignando parámetros del campo de fuerza General Amber (GAFF) e incorporando cargas de potencial electrostático restringido (RESP). Luego, el complejo se describió con el campo de fuerza Amber99SB-ILDN, se colocó en un modelo de agua transferible intermolecular con 3 puntos y se neutralizó con tres iones Na⁺. Tras la minimización de energía por el método del descenso más pronunciado, el sistema se equilibró durante 100 ps bajo el conjunto canónico con número constante de partículas, volumen y temperatura, y durante otros 100 ps bajo el conjunto canónico con número constante de partículas, presión y temperatura, con 100.000 pasos en cada fase. Posteriormente, se realizó una simulación productiva de 100 ns a 300 K y 1 bar utilizando un paso de tiempo de 2 fs. La trayectoria resultante se analizó en cuanto a desviación cuadrática media (RMSD), fluctuación cuadrática media (RMSF), radio de giro (Rg), área de superficie accesible al solvente (SASA), persistencia de enlaces de hidrógeno y energía libre de unión mediante mecánica molecular/área de superficie con modelo dieléctrico generalizado de Born (MM/GBSA).
Cultivo celular
Las líneas celulares de fibroblastos dérmicos humanos normales NHDF y de fibroblastos primarios de queloides PKF se cultivaron en medio de crecimiento para fibroblastos suplementado con 2% de suero bovino fetal, factor de crecimiento fibroblástico básico recombinante humano (1 ng/mL) e insulina (5 µg/mL). Ambas líneas celulares se mantuvieron en un incubador humedecido a 37 °C con 5% de CO₂ y se pasajearon al alcanzar una confluencia del 80–90%.
Análisis de inmunotransferencia
Se aisló la proteína total de células NHDF y PKF con un tampón de lisis compuesto por ensayo de inmunoprecipitación con radioinmunoensayo, fluoruro de fenilmetilsulfonilo, un cóctel de inhibidores de proteasas e inhibidores de fosfatasas. La concentración de proteína se determinó mediante un ensayo de ácido bicinconínico, tras lo cual se separaron cantidades iguales de proteína mediante electroforesis en gel de poliacrilamida con dodecilsulfato de sodio y se transfirieron a una membrana de fluoruro de polivinilideno. La membrana se bloqueó durante 90 minutos a temperatura ambiente con leche descremada al 5 % preparada en solución salina tamponada con Tween/Tris, y luego se incubó durante la noche a 4 °C con anticuerpos primarios contra FLVCR1 (policlonal de conejo, 1:1.000) y GAPDH (monoclonal de ratón, 1:20.000). Al día siguiente, se realizó la incubación con el anticuerpo secundario durante 90 minutos a temperatura ambiente. Las intensidades de las bandas se midieron con ImageJ, y los niveles relativos de proteína se normalizaron respecto al control interno GAPDH. Se utilizaron al menos tres réplicas biológicas independientes para cada ensayo de inmunotransferencia western.
Análisis de PCR cuantitativa en tiempo real con transcripción inversa (qRT-PCR) con fluorescencia
Se preparó ARN total a partir de células NHDF y PKF con el kit referenciado. Luego, se generó ADNc con la Mezcla de Síntesis de ADNc referenciada para qPCR (con dsDNasa). La qRT-PCR se realizó en un sistema de PCR en tiempo real, y la expresión de FLVCR1 se midió con la Mezcla Rápida de SYBR Verde referenciada. El ARNm de GAPDH sirvió como referencia interna para la normalización. Cada reacción de qRT-PCR se realizó por triplicado técnico, y los niveles relativos de ARNm se calcularon mediante el método 2−ΔΔCt. Cada experimento se realizó de forma independiente al menos tres veces, y las secuencias de los cebadores se proporcionan en la Tabla Suplementaria S2.
Análisis estadístico
Las diferencias entre grupos se evaluaron mediante la prueba de suma de rangos de Wilcoxon, y los valores se expresan como media ± desviación estándar (DE). Las asociaciones entre variables continuas se examinaron utilizando el coeficiente de correlación de Pearson. Los resultados con P < 0,05 se consideraron estadísticamente significativos. Los niveles de significancia se indicaron como ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; y ****, P < 0,0001.
Resultados
Identificación de biomarcadores diagnósticos candidatos para el queloide mediante un algoritmo de aprendizaje automático
Un total de 283 genes relacionados con el metabolismo del hemo se incluyeron en este estudio. El análisis de expresión diferencial del conjunto de datos GSE44270, que compara tejidos de cicatrices queloides y piel normal, identificó 25 genes expresados de manera significativamente diferente (Figura 1A y Tabla Suplementaria S3). Para seleccionar más exhaustivamente biomarcadores asociados a la enfermedad, la regresión LASSO identificó 9 genes candidatos (Figura 1B,C y Tabla Suplementaria S3), mientras que el algoritmo de bosque aleatorio (RF) seleccionó 11 genes con alta importancia predictiva (Figura 1D y Tabla Suplementaria S3). La intersección entre los resultados de LASSO y RF se visualizó mediante un diagrama de Venn, obteniéndose seis biomarcadores centrales, a saber, FLVCR1, TMCC2, EIF2AK1, XK, HPX y KEL (Figura 1E y Tabla Suplementaria S3). El análisis de la característica operativa del receptor (ROC) en la cohorte GSE44270 demostró un desempeño diagnóstico favorable para los seis biomarcadores, con valores de AUC de 0.8016 para FLVCR1, 0.7063 para TMCC2, 0.7817 para EIF2AK1, 0.7460 para XK, 0.7500 para HPX y 0.7857 para KEL (Figura 1F). Basándose en estos seis biomarcadores, se construyó posteriormente un nomograma diagnóstico para queloides utilizando el paquete rms en R (Figura 1G).
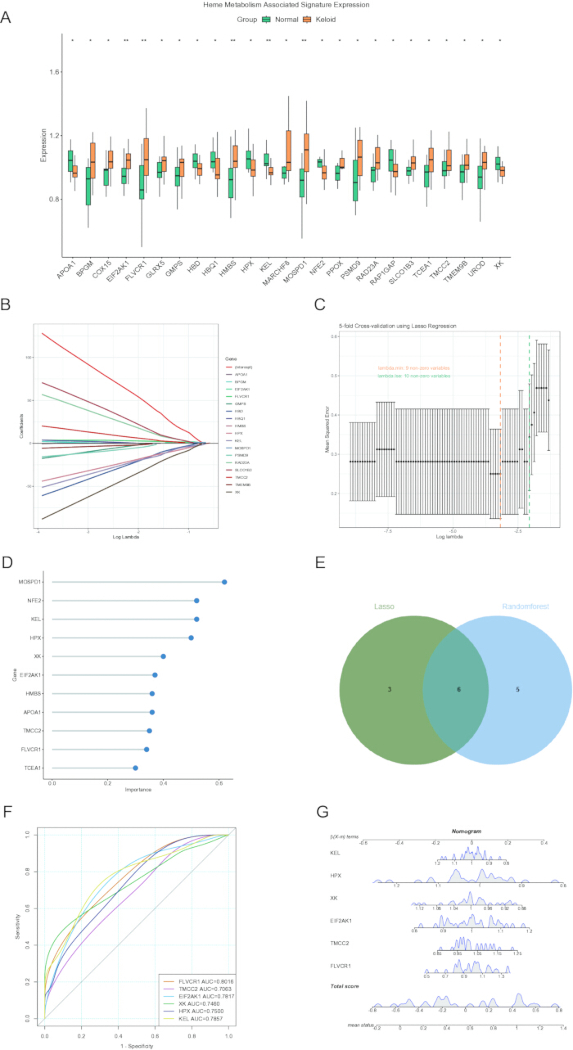
Figura 1: Identificación de genes candidatos relacionados con el metabolismo del hemo asociados al queloide mediante algoritmos de aprendizaje automático. (A) Gráfico de cajas que muestra la expresión diferencial de genes relacionados con el metabolismo del hemo entre tejidos queloides y normales. (B,C) Análisis de regresión logística LASSO para la selección de marcadores diagnósticos candidatos. (D) Biomarcadores candidatos seleccionados por el algoritmo RF. (E) Diagrama de Venn que muestra los genes superpuestos identificados por los dos algoritmos de aprendizaje automático. (F) Análisis de la curva ROC para evaluar el rendimiento diagnóstico de los biomarcadores candidatos. (G) Nomograma para la predicción del queloide basado en la firma de seis genes. Abreviaturas: LASSO, operador de contracción y selección absoluto mínima; RF, bosque aleatorio; ROC, característica de operación del receptor. Significancia estadística: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; y ****, P < 0,0001. Haga clic aquí para ver una versión más grande de esta figura.
El rendimiento predictivo del nomograma diagnóstico se evaluó tanto en la cohorte de entrenamiento (GSE44270) como en la cohorte de validación (GSE7890). El modelo mostró una excelente precisión diagnóstica, alcanzando valores de AUC de 0,984 (IC del 95 %: 0,950–1,000) y 0,922 (IC del 95 %: 0,806–1,000), respectivamente (Figura 2A,D). Para evaluar más a fondo la solidez y el posible sobreajuste de la firma diagnóstica de seis genes, se realizaron análisis adicionales de validación interna en la cohorte de descubrimiento (GSE44270). La validación cruzada de cinco particiones mostró un rendimiento discriminativo consistente en los subconjuntos, con una AUC media de 0,925, lo que indica que el modelo mantuvo un rendimiento estable de clasificación a pesar de las variaciones en las muestras de entrenamiento. Además, la validación mediante bootstrap con 1 000 iteraciones de remuestreo arrojó una AUC media de 0,930 (IC del 95 %: 0,794–1,000). Tras ajustar el posible optimismo causado por el tamaño limitado de la muestra, la AUC corregida por optimismo permaneció en 0,930, lo que sugiere que el rendimiento diagnóstico de la firma de seis genes fue relativamente estable tras la validación interna. Asimismo, el análisis de curva de decisión (DCA) indicó que el nomograma presentaba un beneficio neto potencial mayor que otras estrategias diagnósticas en un rango de probabilidades umbral, aunque estos hallazgos deben interpretarse con precaución debido al tamaño limitado de la muestra (Figura 2B,E). Además, las muestras de queloides mostraron puntuaciones de riesgo significativamente más altas que los controles sanos tanto en la cohorte de entrenamiento como en la de validación (Figura 2C,F), lo que demuestra aún más la estabilidad y fiabilidad del modelo diagnóstico.
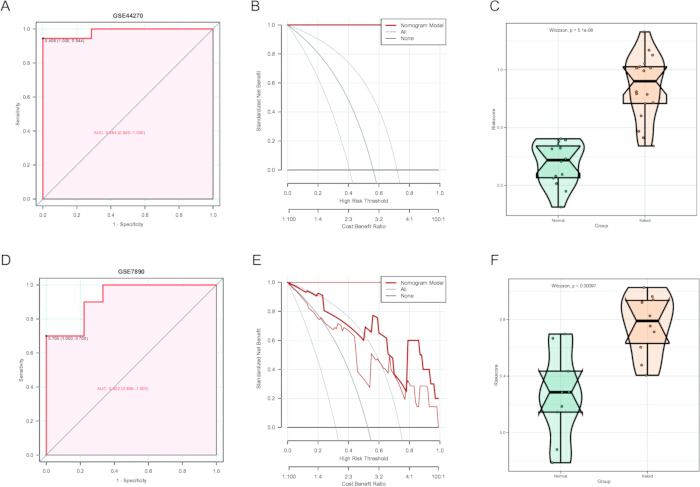
Figura 2: Validación del nomograma para la predicción de queloides. (A) Curva ROC que evalúa el rendimiento predictivo del nomograma en el conjunto de datos GSE44270. (B) ACD que evalúa la utilidad clínica del nomograma en GSE44270. (C) Distribución del puntaje de riesgo comparando muestras con queloide y muestras sanas en GSE44270. (D) Curva ROC que evalúa el rendimiento predictivo del nomograma en el conjunto de datos independiente GSE7890. (E) ACD que evalúa la utilidad clínica del nomograma en GSE7890. (F) Distribución del puntaje de riesgo comparando muestras con queloide y muestras sanas en GSE7890. Abreviaturas: ROC = característica operativa del receptor; ACD = análisis de la curva de decisión. Haga clic aquí para ver una versión más grande de esta figura.
Los biomarcadores diagnósticos están asociados con las características inmunitarias del queloides
Para explorar la relación entre los seis biomarcadores diagnósticos y el microambiente inmunitario, se realizó un análisis de correlación para evaluar las asociaciones entre la expresión de los biomarcadores y la infiltración de células inmunitarias. Los resultados revelaron que los seis biomarcadores estuvieron significativamente asociados con múltiples poblaciones de células inmunitarias infiltrantes (Figura 3A). Específicamente, la expresión de FLVCR1 se asoció negativamente con las células T foliculares helper (Figura 3B). TMCC2 mostró correlaciones positivas con las células asesinas naturales y las células dendríticas activadas, mientras que se correlacionó negativamente con las células dendríticas inmaduras y las células B inmaduras (Figura 3C–F). Además, la expresión de EIF2AK1 se asoció negativamente con las células asesinas naturales CD56dim (Figura 3G), mientras que XK se asoció negativamente con los eosinófilos (Figura 3H).
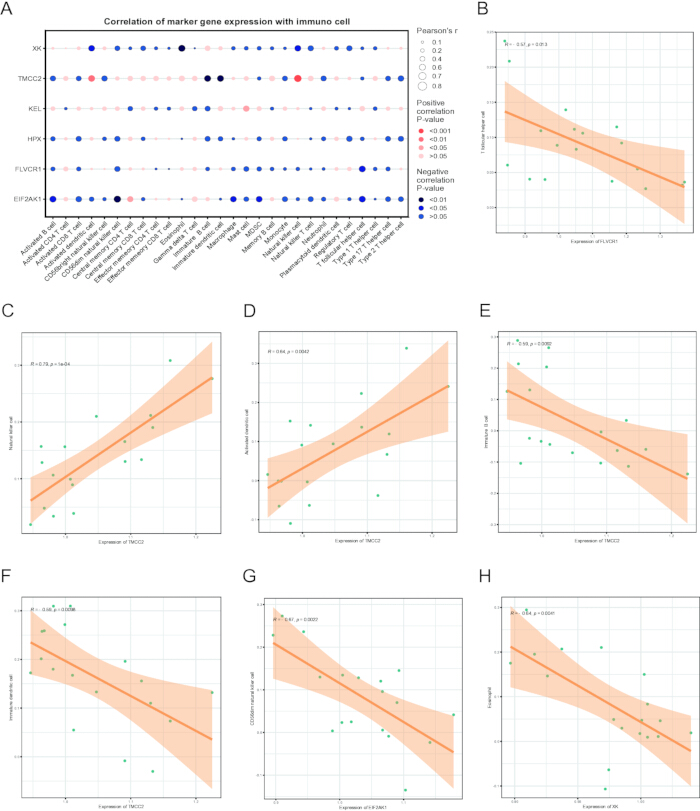
Figura 3: Correlación entre genes candidatos relacionados con el metabolismo del hemo y la infiltración de células inmunitarias. (A) Mapa de calor que muestra las correlaciones entre los genes candidato y las poblaciones de células inmunitarias. El rojo indica correlaciones positivas, mientras que el azul indica correlaciones negativas. (B). Correlación entre FLVCR1 expresión y células T foliculares auxiliares.C-F) Correlaciones entre TMCC2 expresión y células asesinas naturales, células dendríticas activadas, células dendríticas inmaduras y células B inmaduras, respectivamente. (G) Correlación entre EIF2AK1 expresión y células asesinas naturales CD56dim. (H). Correlación entre XK expresión y eosinófilos. Abreviaturas: FLVCR1 = receptor del virus de la leucemia felina del subgrupo C 1; TMCC2 = transmembrana y dominios de hélice alfa enrollada 2; EIF2AK1 = quinasa 1 del factor de inicio de la traducción en eucariotas 2 alfa; CD56oscuro = cluster de diferenciación 56 débil Haga clic aquí para ver una versión más grande de esta figura.
Análisis de datos de transcriptómica de una sola célula
Para caracterizar los patrones de expresión de los biomarcadores diagnósticos identificados dentro del microentorno del queloides, analizamos el conjunto de datos de secuenciación de ARN a nivel de célula individual GSE163973. Tras el control de calidad y la integración de los datos, se conservaron 21.488 células de alta calidad para los análisis posteriores. Se excluyeron células con menos de 200 o más de 6.000 recuentos totales de identificadores moleculares únicos (UMI), y se identificaron y eliminaron los dobletes potenciales mediante el paquete DoubletDetection. Se seleccionaron los 2.000 genes que mostraron la mayor variabilidad de expresión, seguido de la reducción de dimensionalidad y la visualización mediante la proyección de aproximación uniforme de variedades (UMAP). Se identificó un total de 10 poblaciones celulares principales, incluyendo células endoteliales, fibroblastos, fibras musculares, queratinocitos, células inmunitarias, células endoteliales linfáticas, células glandulares, células nerviosas, melanocitos y una población celular no clasificada (Figura 4A,B). El perfil de expresión reveló patrones de distribución específicos según el tipo celular de los biomarcadores diagnósticos. FLVCR1 se expresó predominantemente en células endoteliales y melanocitos, mientras que EIF2AK1 mostró una expresión relativamente alta en células nerviosas, células glandulares y fibroblastos. HPX se enriqueció principalmente en melanocitos, mientras que KEL exhibió una expresión predominante en células glandulares (Figura 4C,D).
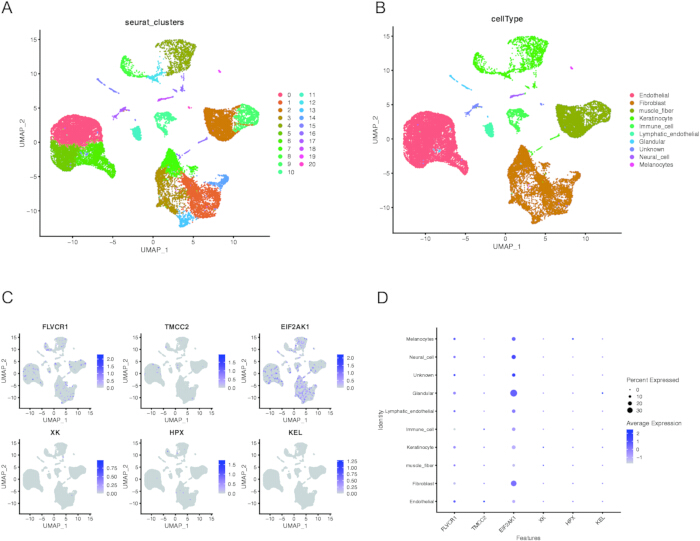
Figura 4: Distribución de biomarcadores diagnósticos relacionados con el metabolismo del hemo en el transcriptoma unicelular de queloides. (A) Gráfico UMAP que muestra 21 agrupaciones celulares que comprenden 21.488 células de muestras de queloides. (B) Anotaciones de tipos celulares basadas en las anotaciones reportadas en el estudio original. (C) Gráficos de características que muestran la expresión de biomarcadores diagnósticos relacionados con el metabolismo del hemo en diferentes tipos celulares. (D) Gráfico de burbujas que muestra los niveles promedio de expresión y los porcentajes de células que expresan los biomarcadores diagnósticos relacionados con el metabolismo del hemo en diferentes tipos celulares. Abreviatura: UMAP = aproximación y proyección uniforme de variedades. Haga clic aquí para ver una versión más grande de esta figura.
Identificación y análisis de la red de interacciones de biomarcadores diagnósticos candidatos
Para explorar los mecanismos reguladores subyacentes a los biomarcadores diagnósticos candidatos, se construyó una red reguladora de miARN–mARN. Para mejorar la fiabilidad de las interacciones predichas, se identificaron miARNs superpuestos que dirigen a los biomarcadores candidatos. Se obtuvieron un total de 282 miARNs que interactúan con los seis biomarcadores diagnósticos, y la red reguladora resultante se muestra en la Figura 5. Destacablemente, se predijo que hsa-miR-34a-5p, hsa-let-7a-5p, hsa-let-7d-5p, hsa-let-7e-5p y hsa-miR-26b-5p regulan simultáneamente los seis biomarcadores candidatos.
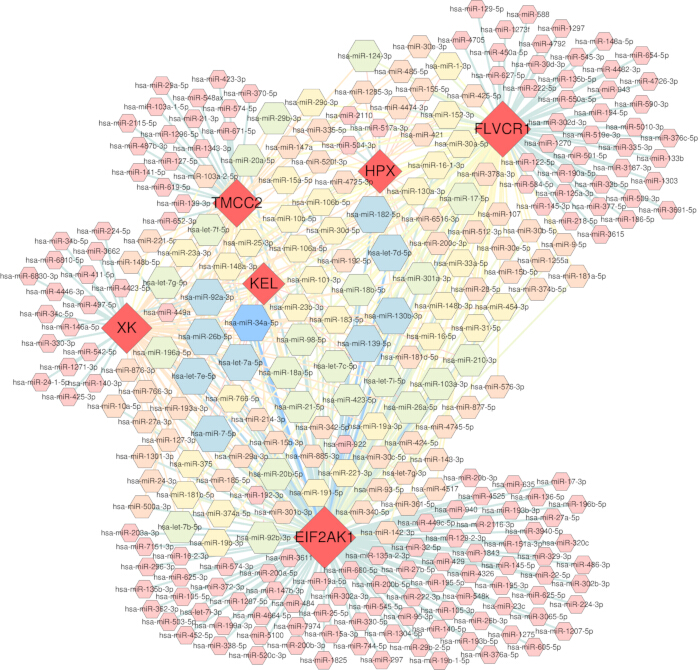
Figura 5: Red reguladora de miARN de biomarcadores diagnósticos relacionados con el metabolismo del hemo. La red ilustra las relaciones reguladoras entre los seis genes biomarcadores diagnósticos (FLVCR1, HPX, TMCC2, KEL, XK y EIF2AK1) y sus miARN asociados. Los nodos génicos representan los biomarcadores diagnósticos, mientras que los nodos circundantes representan los miARN. Las aristas indican interacciones miARN–mARN respaldadas experimentalmente. Abreviaturas: FLVCR1 = receptor del virus de la leucemia felina del subgrupo C 1; HPX = hemopexina; TMCC2 = dominios transmembrana y de hélice enrollada 2; KEL = metaloendopeptidasa Kell; XK = grupo sanguíneo X-ligado Kx; EIF2AK1 = quinasa 1 del factor de inicio de la traducción eucariota 2 alfa; miARN = ARN micro; ARNm = ARN mensajero. Haga clic aquí para ver una versión más grande de esta figura.
Validación experimental de la expresión de FLVCR1 y análisis de acoplamiento molecular de compuestos terapéuticos potenciales
Para validar los hallazgos bioinformáticos y confirmar la relevancia funcional del gen central identificado, evaluamos experimentalmente la expresión de FLVCR1 en PKF y NHDF. Tanto el análisis de qRT-PCR como el de inmunotransferencia mostraron de forma consistente que FLVCR1 estaba significativamente sobreexpresado en los fibroblastos queloides en comparación con los controles normales (Figura 6A–C, Figura suplementaria S1 y Tabla suplementaria S4). Esta expresión celular elevada respalda la posible participación de la disregulación metabólica del hemo asociada a FLVCR1 en la patogénesis del queloide.
Dado el posible papel de FLVCR1 en los cambios inmunitarios asociados al metabolismo del hemo, a continuación se buscó identificar compuestos terapéuticos potenciales que pudieran dirigirse directamente a FLVCR1 para interrumpir este eje patógeno. Se realizó una selección virtual de alta capacidad utilizando una biblioteca de compuestos de medicina tradicional china (MTC) y la estructura proteica preparada. Se seleccionaron los 20 compuestos con las puntuaciones de acoplamiento más favorables para una evaluación adicional (Tabla Suplementaria S5). En general, una energía de unión más baja indica una afinidad de unión más fuerte, y energías de acoplamiento por debajo de −5 kcal/mol se consideran indicativas de interacciones estables entre ligando y proteína. Entre los compuestos analizados, (+)-galocatequina, (−)-epicatequina, (−)-galocatequina y cianidina (cloruro) mostraron afinidades de unión favorables hacia FLVCR1. Notablemente, la (+)-galocatequina mostró la interacción más fuerte con FLVCR1 al formar cuatro enlaces de hidrógeno con GLU214, ASN245, GLN246 y GLN471, lo que sugiere un modo de unión estable entre el ligando y la proteína (Figura 6D–G). Estos hallazgos destacan a la (+)-galocatequina como un candidato prometedor para una intervención terapéutica basada en mecanismos dirigidos a FLVCR1.
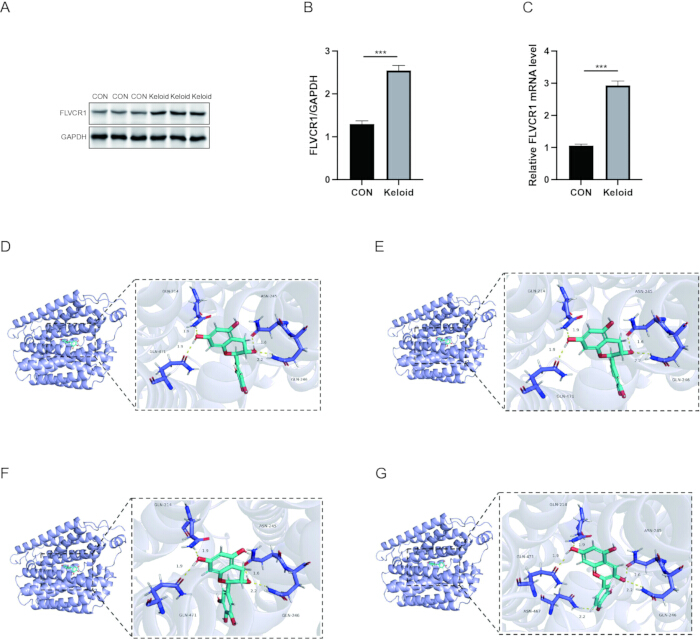
Figura 6: Validación experimental de la expresión de FLVCR1 y acoplamiento molecular de compuestos potenciales que dirigen a FLVCR1. (A) Imágenes representativas de inmunotransferencia que muestran la expresión proteica de FLVCR1 en CON y queloides. GAPDH sirvió como control de carga. (B) Cuantificación de los niveles proteicos de FLVCR1 normalizados respecto a GAPDH. (C) Los niveles relativos de expresión de ARNm de FLVCR1 en fibroblastos de CON y queloides se determinaron mediante qRT-PCR. GAPDH se utilizó como referencia interna. (D–G) Representaciones tridimensionales de los modos de unión predichos entre FLVCR1 y compuestos seleccionados de bajo peso molecular: (D) (+)-Galocatequina. (E) (-)-Epicatequina. (F) (-)-Galocatequina. (G) Cianidina (Cloruro). Abreviaturas: FLVCR1 = receptor del virus de la leucemia felina del subgrupo C 1; CON, control; GAPDH, deshidrogenasa de gliceraldehído-3-fosfato; qRT-PCR, reacción en cadena de la polimerasa con transcripción inversa cuantitativa; SD, desviación estándar. Los datos se presentan como media ± SD. Significancia estadística: ns, P > 0,05; *, P < 0,05; **, P < 0,01; ***, P < 0,001; y ****, P < 0,0001. Haga clic aquí para ver una versión ampliada de esta figura.
Confirmación de la estabilidad del complejo FLVCR1–(+)-galocatequina mediante simulación de dinámica molecular
Para examinar la fiabilidad del modo de unión predicho entre el ligando y la proteína, se realizó una simulación de dinámica molecular (MD) para el complejo FLVCR1–(+)-gallocatequina. El análisis se centró en determinar si el complejo permaneció estructuralmente estable a lo largo del tiempo y si la unión del ligando alteró el comportamiento conformacional de la proteína, utilizando análisis de RMSD, RMSF, radio de giro (Rg), SASA, análisis de enlaces de hidrógeno y cálculos MM/GBSA. El análisis de RMSD (Figura 7A) mostró que tanto la proteína en estado apó como el complejo unido al ligando experimentaron fluctuaciones iniciales durante los primeros 20 ns, seguidas de una estabilización gradual, lo que indica que los sistemas alcanzaron el equilibrio durante la simulación. Tras la equilibración, el valor de RMSD del complejo FLVCR1–(+)-gallocatequina permaneció por debajo de 0,2 nm, lo que sugiere que la unión del ligando contribuyó a mantener la estabilidad estructural de FLVCR1. El análisis de RMSF (Figura 7B) demostró que la mayoría de los residuos presentaron fluctuaciones limitadas a lo largo de la simulación, indicando la preservación de la integridad general de la proteína, mientras que varias regiones flexibles podrían representar regiones en bucle implicadas en la acomodación del ligando. Además, los perfiles estables de Rg y SASA (Figura 7C,D) indicaron que el complejo mantuvo una conformación compacta, sin expansión estructural evidente ni cambios en la exposición al disolvente. El análisis de enlaces de hidrógeno (Figura 7E) reveló que el complejo FLVCR1–(+)-gallocatequina mantuvo interacciones intermoleculares persistentes, formándose aproximadamente entre 3 y 4 enlaces de hidrógeno durante la simulación, lo que respalda la estabilidad de la asociación entre el ligando y la proteína. El análisis MM/GBSA mostró además que el complejo FLVCR1–(+)-gallocatequina exhibió una energía libre de unión favorable (ΔGtotal = −34,87 ± 4,13 kcal/mol) (Tabla suplementaria S6). El análisis de descomposición energética indicó que las interacciones de van der Waals (ΔVDWAALS = −46,34 ± 2,16 kcal/mol) y las interacciones electrostáticas (ΔEelec = −14,09 ± 3,45 kcal/mol) fueron las principales contribuciones favorables a la unión, a pesar de la contribución desfavorable de la energía de solvatación polar (ΔGsolvation = 25,55 ± 0,74 kcal/mol) (Tabla suplementaria S6). En conjunto, estos resultados de la simulación de dinámica molecular demostraron que la (+)-gallocatequina formó un complejo estable con FLVCR1 y respaldaron además la fiabilidad del modo de unión predicho por acoplamiento molecular.
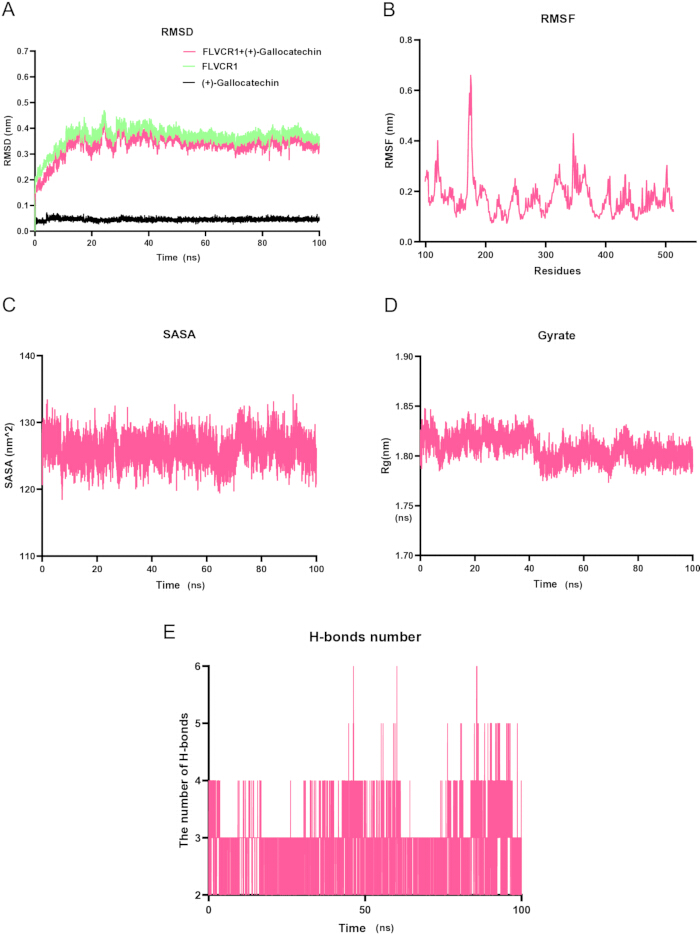
Figura 7: Análisis mediante simulación de dinámica molecular del complejo FLVCR1–(+)-Galocatequina. (A) Perfiles de RMSD de FLVCR1 en estado apó y del complejo FLVCR1–(+)-Galocatequina durante la simulación de dinámica molecular de 100 ns. (B) Perfil de RMSF que muestra las fluctuaciones a nivel de residuos de FLVCR1 durante la simulación. (C) Perfil de SASA que muestra los cambios en el área de superficie accesible al disolvente del complejo FLVCR1–(+)-Galocatequina. (D) Perfil de Rg que evalúa la compacidad del complejo FLVCR1–(+)-Galocatequina durante la simulación. (E) Análisis de enlaces de hidrógeno que muestra las interacciones intermoleculares dinámicas entre FLVCR1 y (+)-Galocatequina a lo largo de la simulación. Abreviaturas: FLVCR1 = receptor de leucemia felina del subgrupo C 1; RMSD = desviación cuadrática media; RMSF = fluctuación cuadrática media; SASA = área de superficie accesible al disolvente; Rg = radio de giro. Haga clic aquí para ver una versión más grande de esta figura.
Disponibilidad de datos:
Los conjuntos de datos transcriptómicos disponibles públicamente analizados en este estudio pueden accederse a través del Gene Expression Omnibus (GEO) con los números de acceso GSE44270, GSE7890 y GSE163973. Los datos originales generados en este estudio y que sustentan la validación experimental, incluyendo mediciones de qRT-PCR, imágenes originales de inmunoensayos tipo western blot y datos de cuantificación de western blot, se proporcionan como Figura Suplementaria S1, Tabla Suplementaria S1, Tabla Suplementaria S2, Tabla Suplementaria S3 y Tabla Suplementaria S4. Los resultados de acoplamiento molecular y los datos de energía libre de unión MM/GBSA también se proporcionan en la Tabla Suplementaria S5 y la Tabla Suplementaria S6.
Figura suplementaria S1: Datos originales del inmunotransferencia.Haga clic aquí para descargar este archivo.
Tabla suplementaria S1: Genes relacionados con el metabolismo del hemo.Haga clic aquí para descargar este archivo.
Tabla suplementaria S2: Secuencias de cebadores de genes seleccionados. Haga clic aquí para descargar este archivo.
Tabla suplementaria S3: Enfoques de aprendizaje automático para la identificación de posibles biomarcadores diagnósticos en queloides. Haga clic aquí para descargar este archivo.
Tabla suplementaria S4: Datos brutos que respaldan la validación experimental de la expresión de FLVCR1. Haga clic aquí para descargar este archivo.
Tabla suplementaria S5: Los 20 principales compuestos candidatos identificados mediante acoplamiento molecular con FLVCR1.Haga clic aquí para descargar este archivo.
Tabla suplementaria S6: Análisis de la energía libre de enlace MM/GBSA del complejo FLVCR1–(+)-galocatequina.Haga clic aquí para descargar este archivo.
Discusión
Este estudio identifica una asociación potencial entre el metabolismo disregulado del hemo, la expresión de FLVCR1 y los cambios en el microambiente inmunitario en la formación de queloides. Mediante la integración de transcriptómica masiva y de célula individual, establecimos a FLVCR1 como un nexo molecular que vincula la deficiencia en la exportación de hemo con la reprogramación inmunitaria patológica, situando al queloide dentro del espectro emergente de trastornos «metabo-fibróticos»23,24,25. La importancia potencial de FLVCR1 se ve respaldada por evidencia convergente proveniente de múltiples niveles analíticos. La transcriptómica masiva reveló su regulación positiva significativa en tejidos queloides con una capacidad diagnóstica robusta, mientras que el mapeo a resolución de célula individual localizó su expresión predominantemente en células endoteliales y melanocitos, dos tipos celulares implicados críticamente en la patogénesis del queloide mediante angiogénesis aberrante e hiperpigmentación, respectivamente26,27. Más convincentemente, la expresión de FLVCR1 mostró una fuerte correlación negativa con las células T foliculares auxiliares (Tfh), un subconjunto de linfocitos cuya participación en la promoción de una inmunidad polarizada hacia Th2 y en la deposición de colágeno en microambientes fibróticos es cada vez más reconocida28. Estudios previos han demostrado que la exportación de hemo mediada por FLVCR1 participa en la maduración de células dendríticas y en la presentación de antígenos29, lo que sugiere un vínculo potencial entre la homeostasis del hemo asociada a FLVCR1 y la regulación inmunitaria. Por lo tanto, la regulación positiva observada de FLVCR1 y su correlación negativa con la infiltración de células Tfh podrían reflejar alteraciones en la homeostasis inmunitaria, posiblemente implicando citoquinas profibróticas asociadas a Tfh, como IL-4 e IL-1329,30,31.
Además, la acumulación intracelular de hemo como resultado de la disfunción de FLVCR1 probablemente active el inflamasoma NLRP3, un mecanismo bien documentado en la fibrosis hepática, donde el hemo actúa como un patrón molecular asociado al daño (DAMP, por sus siglas en inglés) que desencadena una inflamación estéril32,33,34. Esta activación del inflamasoma promovería la liberación de IL-1β/IL-18, impulsando la polarización de macrófagos hacia el fenotipo M2 mediante la señalización TLR4/NF-κB y creando un bucle autosostenido de estrés oxidativo y activación de fibroblastos35,36. En conjunto, estos datos respaldan a FLVCR1 como un biomarcador candidato y un posible contribuyente a las interacciones entre el metabolismo del hemo y el sistema inmunitario en el queloide; sin embargo, la cascada mecanicista propuesta requiere validación funcional directa. La retención intracelular de hemo induce primero daño oxidativo y activa el inflamasoma, lo que posteriormente conduce a la disfunción de las células dendríticas, promoviendo así una desviación hacia linfocitos T auxiliares foliculares y respuestas inmunitarias de tipo Th2; esta desviación inmunitaria impulsa adicionalmente la polarización de macrófagos hacia el fenotipo M2, resultando finalmente en la activación de fibroblastos y la progresión de la fibrogénesis.
Más allá del papel aislado de FLVCR1, la disregulación sinérgica de los seis biomarcadores revela un colapso coordinado de la homeostasis del hemo en múltiples nodos reguladores. TMCC2, que se correlaciona positivamente con células dendríticas activadas pero negativamente con subconjuntos inmaduros, podría representar un mecanismo compensatorio que intenta restaurar la competencia inmunitaria en medio del estrés por hemo37,38. EIF2AK1, altamente expresado en fibroblastos queloides y células glandulares, actúa como un sensor molecular directo del exceso de hemo que fosforila eIF2α para suprimir globalmente la síntesis de proteínas mientras aumenta selectivamente la expresión de genes de respuesta al estrés39,40,41. Esto sitúa a EIF2AK1 como el eslabón crítico que traduce la acumulación de hemo en un cambio fenotípico de los fibroblastos, lo que podría explicar por qué los fibroblastos queloides presentan una resistencia aumentada a la apoptosis y una producción exagerada de colágeno42,43,44. HPX, el principal captador plasmático de hemo, mostró una expresión restringida en melanocitos, lo que sugiere un intento autónomo de la célula para amortiguar la toxicidad del hemo dentro de compartimentos ricos en pigmento45,46,47. La disregulación simultánea de XK y KEL implica además al sistema de manejo del hemo de la línea eritroide en la patogénesis del queloide, un hallazgo con implicaciones interesantes para comprender por qué los queloides surgen frecuentemente en sitios de trauma con microhemorragias. En lugar de considerar estos seis genes como marcadores independientes, interpretamos su disregulación colectiva como evidencia de un fallo generalizado en la compartimentación del hemo, en el cual la exportación deficiente (FLVCR1), la detección (EIF2AK1), la captación (HPX) y el tráfico de membrana (XK, KEL) convergen para crear un microentorno rico en hemo y pro-fibrótico.
Este modelo metabólico-inmune se ve reforzado además por una capa epigenética convincente: identificamos una red de ceARN en la cual la regulación negativa de miARN específicos (por ejemplo, la familia let-7 y miR-34a-5p) podría desrepresar simultáneamente vías relacionadas con el metabolismo del hemo y vías fibróticas, aunque este modelo regulador requiere una validación adicional23. La resolución espacial que proporciona el análisis a nivel de célula individual ilumina la coreografía celular subyacente a este proceso, demostrando cómo la disfunción metabólica en células estructurales siembra activamente un microambiente rico en componentes inmunitarios mediante la señalización paracrina del hemo, transformando así nuestra comprensión desde una perspectiva de "tejido total" hacia un modelo dinámico de ecosistema celular48,49,50. La acumulación de hemo en células endoteliales podría promover la fuga vascular y la extravasación de leucocitos mediante la inducción de la hemo oxigenasa-1 y la regulación positiva de moléculas de adhesión, siembra así el microambiente rico en componentes inmunitarios observado en el queloides51,52,53. Al mismo tiempo, la expresión de FLVCR1 en melanocitos concuerda con las observaciones clínicas de hiperpigmentación en queloides y sugiere vulnerabilidades metabólicas compartidas entre las vías pigmentarias y fibróticas, posiblemente mediadas por respuestas al estrés oxidativo54,55. Esta cartografía espacial transforma nuestra comprensión desde una perspectiva de "tejido total" hacia un modelo de ecosistema celular en el que la disfunción metabólica en células estructurales (endotelio, melanocitos) moldea activamente el comportamiento de las células inmunitarias mediante la señalización paracrina del hemo.
Desde un punto de vista traslacional, nuestro nomograma que integra los seis biomarcadores alcanzó una precisión diagnóstica casi perfecta, superando sustancialmente a cualquier marcador individual y demostrando un beneficio clínico neto claro mediante el análisis de curvas de decisión. Más provocativamente, el acoplamiento molecular identificó a la (+)-galocatequina, un polifenol bioactivo abundante en el té verde y en hierbas medicinales tradicionales chinas, como un ligando de alta afinidad para FLVCR1 que forma enlaces de hidrógeno estables con GLU-214, ASN-245, GLN-246 y GLN-471. Este hallazgo es particularmente convincente dada la evidencia previa de que las catequinas suprimen la síntesis de colágeno, inhiben la secreción del factor de crecimiento transformante beta 1 y atenúan el estrés oxidativo en fibroblastos de queloides56,57,58. Planteamos la hipótesis de que la (+)-galocatequina podría estabilizar la conformación de FLVCR1 para aumentar la capacidad de exportación de hem, interrumpiendo así el desencadenante metabólico de la fibrosis en su origen, una estrategia fundamentalmente distinta de las terapias actuales que simplemente suprimen la producción de colágeno en etapas posteriores. Si este tipo de intervención metabólica podría afectar la recurrencia de queloides requiere una validación experimental y clínica adicional.
Por supuesto, este estudio también tiene limitaciones. En primer lugar, nuestros análisis siguen siendo principalmente computacionales, y la asociación observada entre la expresión de FLVCR1 y la infiltración de células T foliculares helper (Tfh) no establece una relación causal directa. Se requieren validación mediante citometría de flujo de las células Tfh y estudios funcionales que impliquen la inhibición o sobreexpresión de FLVCR1 en fibroblastos queloides, junto con ensayos de interacción entre fibroblastos y células inmunitarias o ensayos con medio condicionado, para aclarar el posible papel de FLVCR1 en la regulación inmunitaria. En segundo lugar, el tamaño relativamente pequeño de la muestra puede introducir incertidumbre y optimismo en la estimación del rendimiento de la firma de seis genes. Aunque se realizó una validación interna, la evaluación confiable del rendimiento diagnóstico y la calibración sigue siendo limitada. Por lo tanto, el panel de seis genes debe considerarse una firma molecular exploratoria que requiere validación adicional en cohortes más grandes e independientes. En tercer lugar, el conjunto de datos de célula única requiere ampliación para captar mejor la heterogeneidad interpaciente y las poblaciones celulares raras. En cuarto lugar, la validación a nivel proteico de la expresión del biomarcador y su localización espacial mediante inmunohistoquímica reforzaría la relevancia clínica de nuestros hallazgos. Finalmente, aunque el acoplamiento molecular sugiere una posible unión entre la (+)-galocatequina y FLVCR1, se necesitan ensayos in vitro de unión y estudios de eficacia in vivo antes de la traducción clínica. A pesar de estas limitaciones, nuestros hallazgos proporcionan un marco multidimensional que vincula el metabolismo del hemo asociado a FLVCR1 con alteraciones inmunitarias en el queloides e identifican posibles biomarcadores moleculares y candidatos terapéuticos para investigaciones futuras.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Contribuciones de los autores
Qiuyan Yang contribuyó al diseño del estudio. Jianping Zhang contribuyó a la recopilación de datos. Qiuyan Yang y Xiaofang Sun contribuyeron al análisis estadístico. Qiuyan Yang y Jing Wang contribuyeron a la elaboración de diagramas y a la finalización del manuscrito. Todos los autores leyeron y aprobaron la versión final del manuscrito.
Agradecimientos
Agradecemos a los investigadores que generaron y compartieron públicamente los conjuntos de datos GSE44270, GSE7890 y GSE163973 a través de la base de datos Gene Expression Omnibus (GEO).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| AmberTools | Amber Project | https://ambermd.org/AmberTools.php | Versión 22; Generación de parámetros del ligando utilizando el campo de fuerza GAFF |
| Anti-FLVCR1 | Proteintech | 26841-1-AP | |
| Anti-GAPDH | Proteintech | 60004-1-Ig | |
| AutoDock Vina | The Scripps Research Institute | https://vina.scripps.edu/ | Versión 1.2.3; Acoplamiento molecular y predicción de afinidad de unión del ligando |
| AutoDockTools | The Scripps Research Institute | https://ccsb.scripps.edu/autodocksuite/adt/ | Versión 1.5.6; Preparación del ligando y del receptor para el acoplamiento molecular |
| Kit de ensayo de proteína BCA | Servicebio | G2026 | |
| Mezcla de síntesis de ADNc para qPCR con dsDNasa | UnionScript | Transcripción inversa para qRT-PCR | |
| ChemBio3D | PerkinElmer | https://revvitysignals.com/products/research/chemdraw | Versión 14.0; Optimización conformacional 3D y minimización de energía de ligandos |
| Sistema de imagen quimioluminiscente | Visualización de bandas de inmunotransferencia | ||
| Paquete DoubletDetection | GitHub / JonathanShor | https://github.com/JonathanShor/DoubletDetection | Detección y eliminación de dobletes predichos en el análisis de scRNA-seq |
| Sustrato quimioluminiscente ECL | Detección de señal en inmunotransferencia | ||
| Suero de ternera fetal | Concentración final del 2%; Suplemento para medio de cultivo de fibroblastos | ||
| Medio de crecimiento para fibroblastos 2 | PromoCell | C-23020 | |
| Primers FLVCR1 y GAPDH | Tabla suplementaria S2 | Amplificación por qRT-PCR de genes diana y de referencia | |
| Gaussian | Gaussian, Inc. | https://gaussian.com/ | Gaussian 16W; Cálculo de cargas atómicas RESP para la parametrización del ligando |
| Aparato de electroforesis en gel | Separación de proteínas por SDS-PAGE | ||
| Paquete GEOquery | Bioconductor | https://bioconductor.org/packages/GEOquery/ | Versión 2.68.0; Recuperación de expresión génica y metadatos desde la base de datos GEO |
| Paquete ggplot2 | CRAN | https://cran.r-project.org/package=ggplot2 | Versión 4.0.2; Visualización de datos |
| Paquete glmnet | CRAN | https://cran.r-project.org/package=glmnet | Versión 4.1.10; Selección de características mediante LASSO |
| GROMACS | Equipo de desarrollo de GROMACS | https://www.gromacs.org/ | Versión 2022.3; Simulaciones de dinámica molecular y análisis de trayectorias |
| GS AntiQ qPCR SYBR Green Fast Mix (Universal) | Genesand | SQ410 | |
| GSE163973 | Base de datos GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE163973 | 3 muestras de queloides; Análisis de expresión a nivel de célula individual |
| GSE44270 | Base de datos GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE44270 | 18 muestras de queloides y 14 normales; Expresión diferencial y cribado de biomarcadores |
| GSE7890 | Base de datos GEO | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE7890 | 10 muestras de queloides y 9 normales; Validación independiente de biomarcadores diagnósticos |
| Paquete GSVA | Bioconductor | https://bioconductor.org/packages/GSVA/ | Versión 1.48.3; Análisis de infiltración de células inmunitarias basado en ssGSEA |
| Anticuerpo secundario de cabra anti-IgG de ratón conjugado con HRP | Abcam | ab97040 | |
| Anticuerpo secundario de cabra anti-IgG de conejo conjugado con HRP | Abcam | ab97051 | |
| Incubadora con atmósfera húmeda de CO2 | 37 °C, 5% CO2; Mantenimiento de células NHDF y PKF | ||
| ImageJ | National Institutes of Health | https://imagej.nih.gov/ij/ | Cuantificación de la intensidad de bandas en inmunotransferencia |
| Insulina | Concentración final de 5 μg/mL; Suplemento para medio de cultivo de fibroblastos | ||
| Base de datos de firmas moleculares (MSigDB) | Broad Institute | https://www.gsea-msigdb.org/gsea/msigdb | Versión 2024.1.Hs; Fuente de conjuntos de genes asociados al metabolismo del hemo |
| NetworkAnalyst | NetworkAnalyst | https://www.networkanalyst.ca/ | Versión 3.0; Construcción de la red de interacción miARN-mARN |
| NHDF | Procell | CP-H106 | |
| Leche descremada en polvo | Solución al 5%; Bloqueo de membranas para análisis por inmunotransferencia | ||
| Película o tapones de sellado óptico | Sellado de reacciones de qRT-PCR | ||
| PBS | Procell | PB180327 | |
| PDB ID: 8UBZ | RCSB PDB | https://www.rcsb.org/structure/8UBZ | Estructura humana de FLVCR1; Fuente de la estructura proteica FLVCR1 para cribado virtual basado en estructura |
| Inhibidores de fosfatasas | Suplemento para tampón de lisis de proteínas | ||
| PKF | Procell | GCP-H235 | |
| PMSF | Servicebio | G2008-1ML | |
| Paquete pROC | CRAN | https://cran.r-project.org/package=pROC | Versión 1.19.0.1; Análisis de curvas ROC y AUC |
| Cóctel de inhibidores de proteasas | Roche | 4693124001 | |
| Aparato de transferencia de proteínas | Transferencia de proteínas a membrana de PVDF | ||
| Membrana de PVDF | Millipore | IPVH08100 | |
| PyMOL | Schrödinger, LLC | https://pymol.org/ | Versión 2.6.1; Visualización y análisis de posiciones de acoplamiento proteína-ligando e interacciones moleculares |
| Placas o tubos para qRT-PCR | Preparación de reacciones de qRT-PCR | ||
| R | Foundation for Statistical Computing | https://www.r-project.org/ | Versión 4.3.1; Análisis estadísticos y bioinformáticos |
| Paquete randomForest | CRAN | https://cran.r-project.org/package=randomForest | Versión 4.7.1.2; Selección de características mediante bosque aleatorio |
| REACTOME_HEME_BIOSYNTHESIS; REACTOME_HEME_DEGRADATION; WIKIPATHWAYS_HEME_BIOSYNTHESIS; REACTOME_SCAVENGING_HEME_FROM_PLASMA; HALLMARK_HEME_METABOLISM | Base de datos de firmas moleculares (MSigDB) | https://www.gsea-msigdb.org/gsea/msigdb | Versión 2024.1.Hs; 283 genes únicos tras la fusión; Definición de genes asociados al metabolismo del hemo |
| Sistema de PCR en tiempo real | Amplificación y detección por qRT-PCR | ||
| Factor de crecimiento fibroblástico básico recombinante humano | Concentración final de 1 ng/mL; Suplemento para medio de cultivo de fibroblastos | ||
| Tampón RIPA | Servicebio | G2002 | |
| Paquete rms | CRAN | https://cran.r-project.org/package=rms | Versión 6.7.1; Construcción de nomogramas |
| Reactivos o geles precargados para SDS-PAGE | Separación de proteínas mediante SDS-PAGE | ||
| Paquete Seurat | CRAN | https://satijalab.org/seurat/ | Versión 5.4.0; Preprocesamiento, agrupamiento y visualización de scRNA-seq |
| TarBase | DIANA Tools | https://carolina.imis.athena-innovation.gr/diana_tools/ | Versión 9.0; Fuente de interacciones miARN-mARN respaldadas experimentalmente |
| Kit Total RNA II | Omega | R6934-01 | |
| Biblioteca de compuestos activos de medicina tradicional china | Fuente de compuestos candidatos para cribado virtual | ||
| Solución salina tamponada con Tween/Tris | Preparación del tampón de bloqueo y lavado de membranas | ||
| UnionScript First-strand cDNA Synthesis Mix for qPCR (with dsDNase) | Genesand | SR511 |
Referencias
- Dirand Z, et al. Macrophage phenotype is determinant for fibrosis development in keloid disease. Matrix Biol. 2024;128:79-92.
- Fang X, et al. Hypertrophic scarring and keloids: epidemiology, molecular pathogenesis, and therapeutic interventions. MedComm (2020). 2025;6(10):e70381.
- Adler R, et al. Pentoxifylline and long-term risk of keloid formation: a real-world 10-year outcomes study using TriNetX. J Am Acad Dermatol. 2026;94(5):1561-3.
- Banerjee P, et al. Anti-fibrotic properties of a decellularized extracellular matrix scaffold from porcine small intestinal submucosa in normal human and keloid fibroblasts. Int J Mol Sci. 2025;26(24):11764.
- Chang YH, McGrath JA, Hsu CK. Regression of extensive keloids during imatinib therapy for gastrointestinal stromal tumor. JAMA Dermatol. 2025;161(12):1293-4.
- Wang QR, et al. CCL17 drives fibroblast activation in the progression of pulmonary fibrosis by enhancing the TGF-β/Smad signaling. Biochem Pharmacol. 2023;210:115475.
- Higuchi Y, et al. Cavin-2 promotes fibroblast-to-myofibroblast trans-differentiation and aggravates cardiac fibrosis. ESC Heart Fail. 2024;11(1):167-78.
- Zhang H, et al. Plasma apolipoprotein E protein attenuates pulmonary fibrosis through LRP1 and PLAU dual receptor-mediated TGF-β/Smad inhibition. J Adv Res. 2025. doi:10.1016/j.jare.2025.12.045.
- Chen Q, et al. Immune imbalance drives keloid pathogenesis: emerging targets for precision immunotherapy. Adv Wound Care (New Rochelle). 2026:21621918261417702.
- Deng CC, et al. Single-cell RNA-seq reveals immune cell heterogeneity and increased Th17 cells in human fibrotic skin diseases. Front Immunol. 2024;15:1522076.
- Wang Q, et al. Weighted gene co-expression network analysis and machine learning identified the lipid metabolism-related gene LGMN as a novel biomarker for keloid. Exp Dermatol. 2024;33(1):e14974.
- Zhang W, et al. New insights into keloid pathogenesis: biomarker potential for CDK7 and DDB2. Front Cell Dev Biol. 2025;13:1718189.
- Li W, et al. Altered arginine metabolism affects proliferation and radiosensitivity of keloids. Exp Dermatol. 2025;34(3):e70077.
- Jiang J, et al. Ambient fine particulate matter induces cardiac fibrosis through triggering ferroptosis by heme degradation induced-iron overload. Ecotoxicol Environ Saf. 2025;297:118227.
- Lin W, et al. Heme oxygenase-1 overexpression activates the IRF1/DRP1 signaling pathway to promote M2-type polarization of spinal cord microglia. Drug Dev Res. 2024;85(8):e70033.
- Knez J, Kovačič B, Goropevšek A. The role of regulatory T-cells in the development of endometriosis. Hum Reprod. 2024;39(7):1367-80.
- Voltarelli VA, et al. Heme: the lord of the iron ring. Antioxidants (Basel). 2023;12(5):1074.
- Wilks A, Egoshi R. Heme trafficking and the importance of handling nature's most versatile cofactor. Chem Rev. 2025;125(23):11358-78.
- Bertino F, et al. Dysregulation of FLVCR1a-dependent mitochondrial calcium handling in neural progenitors causes congenital hydrocephalus. Cell Rep Med. 2024;5(7):101647.
- Kumar A, et al. Iron regulates the quiescence of naive CD4 T cells by controlling mitochondria and cellular metabolism. Proc Natl Acad Sci U S A. 2024;121(17):e2318420121.
- Jiang H, et al. Gut microbiota dysbiosis in diabetic nephropathy: mechanisms and therapeutic targeting via the gut-kidney axis. Front Endocrinol (Lausanne). 2025;16:1661037.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-62.
- Chen Y, et al. 5-ALA photodynamic metabolite-powered zero-waste ferroptosis amplifier for enhanced hypertrophic scar therapy. Nat Commun. 2025;16(1):8321.
- Li X, et al. Hypericin-mediated photodynamic therapy promotes apoptosis and inhibits fibrosis by inducing HMOX1-mediated ferroptosis in hypertrophic scar fibroblasts. J Photochem Photobiol B. 2025;273:113303.
- Chen Y, et al. Functional transdermal nanoethosomes enhance photodynamic therapy of hypertrophic scars via self-generating oxygen. ACS Appl Mater Interfaces. 2021;13(7):7955-65.
- Oh S, et al. Revealing the pathogenesis of keloids based on the status: active vs inactive. Exp Dermatol. 2024;33(5):e15088.
- Zhao S, et al. New anti-fibrotic strategies for keloids: insights from single-cell multi-omics. Cell Prolif. 2025;58(6):e13818.
- Yasujima T, et al. The role of FLVCR1 and FLVCR2 in choline transport in the Caco-2 intestinal epithelial cell model and rat small intestine. Biochim Biophys Acta Mol Basis Dis. 2025;1871(6):167883.
- Zhang M, Chen H, Qian H, Wang C. Characterization of the skin keloid microenvironment. Cell Commun Signal. 2023;21(1):207.
- Wang Y, et al. FoxC1 activates Notch3 signaling to promote the inflammatory phenotype of keloid fibroblasts and aggravates keloid. Exp Cell Res. 2025;444(2):114402.
- Zhang J, et al. ERG transcriptionally activates SFRP1 to promote apoptosis of keloid fibroblasts and inhibit epithelial-mesenchymal transition and fibrosis through the Wnt3a/β-catenin pathway. Arch Dermatol Res. 2025;317(1):467.
- Ramos-Tovar E, Muriel P. NLRP3 inflammasome in hepatic diseases: a pharmacological target. Biochem Pharmacol. 2023;217:115861.
- Brahadeeswaran S, et al. NLRP3: a new therapeutic target in alcoholic liver disease. Front Immunol. 2023;14:1215333.
- Xiao Y, et al. STING mediates hepatocyte pyroptosis in liver fibrosis by epigenetically activating the NLRP3 inflammasome. Redox Biol. 2023;62:102691.
- Paolucci T, et al. Quantum molecular resonance inhibits NLRP3 inflammasome/nitrosative stress and promotes M1 to M2 macrophage polarization: potential therapeutic effect in osteoarthritis model in vitro. Antioxidants (Basel). 2023;12(7):1358.
- Wei J, et al. FERM domain containing kindlin 1 knockdown attenuates inflammation induced by intracerebral hemorrhage in rats via NLR family pyrin domain containing 3/nuclear factor kappa B pathway. Exp Anim. 2023;72(3):324-35.
- Tao L, Zhou Y, Wu L, Liu J. Comprehensive analysis of sialylation-related genes and construct the prognostic model in sepsis. Sci Rep. 2024;14(1):18110.
- Sun Q, et al. Identification of hub genes and key pathways associated with sepsis progression using weighted gene co-expression network analysis and machine learning. Int J Mol Sci. 2025;26(9):4433.
- Chen JJ. HRI protein kinase in cytoplasmic heme sensing and mitochondrial stress response: relevance to hematological and mitochondrial diseases. J Biol Chem. 2025;301(5):108494.
- Chakrabarty Y, Yang Z, Chen H, Chan DC. The HRI branch of the integrated stress response selectively triggers mitophagy. Mol Cell. 2024;84(6):1090-100.e6.
- Bora P, et al. Drug repurposing screen identifies an HRI activating compound that promotes adaptive mitochondrial remodeling in MFN2-deficient cells. Proc Natl Acad Sci U S A. 2025;122(48):e2517552122.
- Zhang C, et al. CaMKII suppresses proteotoxicity by phosphorylating BAG3 in response to proteasomal dysfunction. EMBO Rep. 2024;25(10):4488-514.
- Chaabani H, et al. Trifloxystrobin induces oxidative stress-dependent activation of the OMA1-DELE1-HRI integrated stress response leading to apoptosis in human neuroblastoma cells. Environ Pollut. 2026;390:127562.
- Das R, et al. CMT2A-linked MFN2 mutation, T206I promotes mitochondrial hyperfusion and predisposes cells towards mitophagy. Mitochondrion. 2024;74:101825.
- De Simone G, et al. Heme scavenging and delivery: the role of human serum albumin. Biomolecules. 2023;13(3):575.
- Turilli-Ghisolfi ES, Lualdi M, Fasano M. Ligand-based regulation of dynamics and reactivity of hemoproteins. Biomolecules. 2023;13(4):683.
- Zhang P, et al. Risk factors and prediction models for cardiotoxicity induced by anthracyclines in malignant chemotherapy. Cancer Chemother Pharmacol. 2025;95(1):73.
- Petrillo S, et al. Endothelial cells require functional FLVCR1a during developmental and adult angiogenesis. Angiogenesis. 2023;26(3):365-84.
- Fiorito V, Tolosano E. Unearthing FLVCR1a: tracing the path to a vital cellular transporter. Cell Mol Life Sci. 2024;81(1):166.
- Manco M, et al. FLVCR1a controls cellular cholesterol levels through the regulation of heme biosynthesis and tricarboxylic acid cycle flux in endothelial cells. Biomolecules. 2024;14(2):149.
- Shi X, et al. Increased melanin induces aberrant keratinocyte-melanocyte-basal-fibroblast cell communication and fibrogenesis by inducing iron overload and ferroptosis resistance in keloids. Cell Commun Signal. 2025;23(1):141.
- Khunger N, Dash A. Impact of air pollution on skin pigmentation: mechanisms and protective strategies. Int J Dermatol. 2025;64(10):1788-801.
- Ahuja K, Raju S, Dahiya S, Motiani RK. ROS and calcium signaling are critical determinant of skin pigmentation. Cell Calcium. 2025;125:102987.
- Dutta A, Chakraborty S, Roy A, Mittal A, et al. Tissue fibrosis in cardiorenal syndrome: crosstalk between heart and kidneys. Nephrol Dial Transplant. 2025;40(7):1273-83.
- Noah AA, et al. Reversal of fibrosis and portal hypertension by empagliflozin treatment of CCl4-induced liver fibrosis: emphasis on gal-1/NRP-1/TGF-β and gal-1/NRP-1/VEGFR2 pathways. Eur J Pharmacol. 2023;959:176066.
- Murakami T, Shigeki S. Pharmacotherapy for keloids and hypertrophic scars. Int J Mol Sci. 2024;25(9):4674.
- Jin J, Zheng Z. Gut microbiota-derived metabolites in keloid and hypertrophic scarring. Front Microbiol. 2025;16:1644758.
- Aubert A, et al. Potential implications of granzyme B in keloids and hypertrophic scars through extracellular matrix remodeling and latent TGF-β activation. Front Immunol. 2024;15:1484462.