Este flujo de trabajo integra la transcriptómica masiva y de célula individual con ensayos preliminares de tejido de pacientes para priorizar MMP1 en la úlcera del pie diabético. MMP1 mostró un patrón de expresión centrado en los fibroblastos y una mayor abundancia tisular, lo que respalda una asociación con la remodelación de la matriz, aunque no se resuelve la causalidad ni la utilidad clínica.
Artículo de investigación
Transcriptómica Integrativa Masiva y de Célula Individual con Validación Tisular Prioriza MMP1 en la Úlcera del Pie Diabético
* These authors contributed equally
En este artículo
Resumen
Resumen
Las fuentes celulares de cambios transcriptómicos reproducibles en la úlcera del pie diabético (DFU) aún no están completamente definidas. Este estudio integró análisis de expresión diferencial, análisis de red de coexpresión génica ponderada (WGCNA), cribado de genes de neuropatía periférica diabética (DPN), selección exploratoria de características mediante aprendizaje automático, dos conjuntos de datos transcriptómicos masivos externos, análisis de célula individual, análisis de red de medicina tradicional china (TCM) y reacciones de PCR cuantitativa (qPCR) y transferencia de western en tejidos de pacientes. En GSE199939 (10 muestras de DFU y 11 controles), se identificaron 3.691 genes expresados diferencialmente, y el módulo azul del WGCNA mostró una fuerte asociación con DFU (r = 0,97, p = 5 × 10-13). La intersección entre los genes expresados diferencialmente, los genes centrales del módulo azul y 1.062 genes relacionados con DPN produjo 77 candidatos. CCL7, CHEK1, MKI67, MMP1, MMP13 y TRPV2 fueron respaldados por al menos dos métodos de selección de características; la separación completa en la eliminación recursiva de características mediante máquina de vectores de soporte generó preocupaciones sobre sobreajuste en la cohorte de descubrimiento. MMP1 mostró el mayor cambio de expresión en la cohorte de descubrimiento (cambio log2 = 9,854; p ajustado = 1,24 × 10⁻²⁹). En la matriz combinada GSE68183/GSE80178, MMP1 presentó un valor p ajustado de 0,0159 y un área bajo la curva ROC (AUC) de 0,981. En GSE134431, la expresión de MMP1 fue nominalmente mayor en DFU que en piel diabética sin úlcera (p = 0,0225; p ajustado = 0,135; AUC = 0,808). El análisis de 69.944 células procedentes de 24 muestras mostró la expresión media más alta de MMP1 en fibroblastos, con mayor expresión a nivel de muestra en fibroblastos, queratinocitos y células endoteliales de DFU. Los ensayos en tejidos de pacientes mostraron mayor abundancia de ARNm de MMP1 en cuatro pares emparejados (prueba pareada sobre ΔCq, p = 3,04 × 10⁻⁵) y mayor abundancia proteica en tres pares emparejados (prueba pareada p = 0,0107). La replicación estadística fue incompleta. Los hallazgos sugieren una asociación centrada en el fibroblasto con la remodelación de la matriz, sujeta a limitaciones derivadas del uso de transcripciones por millón (TPM) como entrada en el análisis de descubrimiento basado en conteos, registros incompletos de preprocesamiento de datos de célula individual y cohortes pequeñas en los ensayos con tejidos. La causalidad y la utilidad clínica aún no han sido establecidas.
Introducción
La úlcera del pie diabético es una complicación grave y recurrente de la diabetes que surge de la convergencia de neuropatía, carga mecánica repetitiva, enfermedad arterial periférica, susceptibilidad a infecciones y reparación tisular deficiente. Las estimaciones actuales indican que millones de personas se ven afectadas en todo el mundo cada año, y la cicatrización suele ser prolongada, con riesgos considerables de recurrencia, hospitalización, amputación de extremidades inferiores y muerte1. Por tanto, la prevención y el manejo dependen no solo del cuidado local de la herida, sino también de la identificación de la pérdida de sensibilidad protectora, la reducción de la presión plantar, el tratamiento de la infección y la isquemia, y la corrección de factores de riesgo sistémicos1,2. La neuropatía periférica diabética es particularmente relevante porque la disfunción sensorial progresiva puede reducir la percepción de la presión, el trauma y la degradación tisular, mientras que las alteraciones motoras y autonómicas pueden modificar aún más la biomecánica del pie y la integridad de la piel2,3. A nivel tisular, la lesión neuropática puede coexistir con neuroinflamación, disfunción microvascular, estrés metabólico y reparación defectuosa, creando un entorno de herida en el que la lesión persiste a pesar del tratamiento convencional1,3.
La cicatrización cutánea exitosa requiere una inflamación coordinada, reepitelialización, angiogénesis, activación de fibroblastos, deposición de la matriz extracelular (ECM) y remodelado subsiguiente de la matriz. En la diabetes, estos procesos pueden volverse temporalmente desorganizados: las señales inflamatorias pueden permanecer activas, la migración de queratinocitos puede estar alterada, las respuestas endoteliales pueden ser insuficientes y los fibroblastos pueden producir u organizar una matriz anormal. Los fibroblastos son centrales en la fase estromal de la reparación porque sintetizan proteínas de la matriz, regulan la arquitectura del colágeno, comunican con células inmunitarias y epiteliales y contribuyen a la contracción de la herida. Estudios que utilizan fibroblastos de úlceras del pie diabético (DFU) derivados de pacientes han mostrado anormalidades persistentes en la transcripción relacionada con la ECM y en el ensamblaje de la matriz, lo que respalda la idea de que el estado de los fibroblastos es un componente importante de la biología de heridas crónicas4. Las metaloproteinasas de matriz (MMPs) participan en este proceso al escindir sustratos de la ECM y permitir la migración celular, el recambio tisular y la remodelación; sin embargo, sus efectos dependen de la ubicación, el momento, la disponibilidad de sustratos y la regulación por inhibidores tisulares de metaloproteinasas (TIMPs)5. Un desequilibrio entre la proteólisis y el reemplazo de la matriz puede, por tanto, ser compatible con una reparación deficiente, pero el aumento en la expresión de una MMP individual no establece por sí solo un papel perjudicial o beneficioso. La metaloproteinasas de matriz 1 (MMP1), una colagenasa intersticial capaz de participar en el recambio de colágeno fibrilar, se ha reportado alterada en tejido de DFU, y estudios clínicos previos han relacionado los perfiles de MMP/TIMP con el estado de la herida o las trayectorias de cicatrización6,7. Estas observaciones respaldan una mayor investigación de la MMP1 en DFU.
El perfilado transcriptómico proporciona un enfoque sistemático para identificar los programas moleculares asociados con las úlceras del pie diabético (DFU), pero varias limitaciones metodológicas complican su interpretación. Los conjuntos de datos de tejido total promedian las señales procedentes de queratinocitos, fibroblastos, células endoteliales, células inmunitarias y otros compartimentos, lo que dificulta determinar si un candidato refleja una expresión alterada dentro de un tipo celular, cambios en la composición celular, o ambas cosas. La comparabilidad entre conjuntos de datos también puede verse reducida por diferencias en plataformas, estrategias de normalización, localizaciones del muestreo tisular, gravedad de la úlcera, estado de infección, etapa de la enfermedad y tejido de referencia. Es importante destacar que la piel diabética del pie sin úlcera representa un comparador tisular clínicamente relevante en el contexto diabético, pero no es intercambiable con piel sana. La secuenciación de ARN a nivel de célula individual puede abordar parcialmente el problema del origen celular al resolver poblaciones celulares heterogéneas y sus estados transcripcionales. Un estudio previo basado en transcriptómica de célula individual y transcriptómica espacial de la DFU identificó poblaciones distintas de fibroblastos y demostró que los programas de los fibroblastos varían según el contexto de la herida y el estado de curación8. Estos hallazgos respaldan el uso de análisis a resolución celular para complementar los datos transcriptómicos de tejido total.
Los métodos de selección de características pueden ayudar a priorizar candidatos a partir de datos de expresión de alta dimensionalidad, aunque los estudios biomédicos con muestras pequeñas son particularmente vulnerables a estimaciones optimistas y a una selección inestable de genes. Cuando el número de variables medidas supera ampliamente al número de muestras biológicas, puede ocurrir una separación aparentemente perfecta incluso cuando la información predictiva generalizable es limitada. Reutilizar las mismas observaciones para la selección de características, ajuste y evaluación del rendimiento infla aún más el AUC, por lo que la validación cruzada anidada, los modelos bloqueados y cohortes de prueba genuinamente independientes son esenciales para evaluar el rendimiento predictivo9,10. Estas consideraciones son relevantes para los estudios de UDM, ya que las cohortes disponibles públicamente suelen ser pequeñas y heterogéneas. Las bases de datos de ingredientes, dianas y hierbas de la medicina tradicional china se utilizaron adicionalmente únicamente para la generación de hipótesis.
Este estudio integró transcriptómica masiva, WGCNA, cribado de genes relacionados con DPN, selección de características mediante aprendizaje automático, evaluación en conjuntos de datos externos, análisis de célula individual, análisis de red de medicina tradicional china y validación en tejidos de pacientes. Los genes candidatos identificados en la cohorte de descubrimiento se evaluaron en conjuntos adicionales de datos transcriptómicos, y el candidato principal se localizó en tipos celulares específicos mediante datos de célula individual. Luego, MMP1 se analizó a nivel de ARNm y de proteína en tejido de pacientes mediante qPCR e inmunotransferencia. Este marco se diseñó para identificar un candidato asociado a DFU reproducible y caracterizar su contexto celular y biológico.
Protocolo
Diseño del estudio y fuentes de datos
El estudio, incluida la recopilación y el uso de muestras de tejido de pacientes para la validación mediante qPCR y western blot, fue revisado y aprobado por el Comité de Ética del Hospital Cuarto de Wuhan (número de aprobación: KY2024-161-01). Todos los procedimientos que involucraron tejido humano se realizaron de acuerdo con el protocolo aprobado y los principios éticos aplicables. El componente transcriptómico del estudio utilizó conjuntos de datos de acceso público y desidentificados. Se obtuvo el consentimiento informado por escrito de todos los participantes cuyas muestras de tejido se utilizaron para la validación experimental. Los conjuntos de datos transcriptómicos de acceso público se analizaron en forma desidentificada, y los procedimientos de consentimiento para los estudios originales que generaron los datos fueron gestionados por las instituciones respectivas.
Este estudio integró la transcriptómica masiva, el análisis de redes, la selección de características, el análisis unicelular, la predicción de redes de medicina tradicional china (TCM) y la validación en tejidos de pacientes. La cohorte de descubrimiento fue el conjunto de datos Gene Expression Omnibus (GEO) GSE199939 (10 muestras de úlceras del pie diabético [DFU] y 11 muestras de control). La evaluación externa mediante transcriptómica masiva incluyó una matriz combinada GSE68183/GSE80178 (9 muestras de DFU y 6 de control) y GSE134431 (13 muestras de DFU y 8 muestras de piel diabética sin ulceración [DFS]). El análisis unicelular utilizó un objeto Seurat preprocesado y anotado con SingleR derivado de GSE165816, que comprendía 69.944 células de 24 muestras (14 de DFU y 10 de control). La evaluación en tejidos incluyó cuatro pares apareados de pacientes con tejido de úlcera del pie diabético y tejido perilesional para qPCR y tres pares apareados para inmunotransferencia (western blotting), según registros de ensayos recuperados y emparejamientos confirmados por los autores. Todos los materiales y equipos utilizados en este estudio se enumeran en la Tabla de Materiales.
Construcción del conjunto de genes relacionados con DPN
Los genes relacionados con la neuropatía periférica diabética (DPN) se recuperaron de la base de datos Gene del Centro Nacional de Información Biotecnológica (NCBI) utilizando rentrez. Los términos de búsqueda incluyeron «neuropatía periférica diabética», «neuropatía diabética», «polineuropatía diabética», «neuropatía diabética dolorosa» y «polineuropatía sensitivomotora diabética», restringidos a Homo sapiens. Los identificadores obtenidos se asignaron a los símbolos oficiales de los genes, se convirtieron a mayúsculas, se limpiaron y se eliminaron duplicados. Los genes obtenidos de la base de datos se combinaron con una lista de genes DPN curada de la literatura y se eliminaron duplicados, obteniendo un total de 1.062 genes relacionados con DPN. Las cadenas completas de búsqueda y el código para la limpieza de identificadores se incluyen en los scripts adjuntos; estos también incluyen neuropatías diabéticas, diabetes combinada con polineuropatía distal simétrica o neuropatía periférica, y el término MeSH «Neuropatías Diabéticas». El componente derivado de la literatura aún requiere el respaldo de citas específicas.
Preprocesamiento del cohorte de descubrimiento y análisis de expresión diferencial
La matriz de expresión GSE199939 se alineó con la tabla de fenotipos mediante el identificador de muestras. Los identificadores de genes duplicados se hicieron únicos. El análisis de descubrimiento archivado redondeó los valores de expresión y ajustó un modelo binomial negativo utilizando DESeq2 (versión 1.48.2), con el grupo como factor de diseño y úlcera del pie diabético (DFU) frente a control como contraste. Se excluyeron los genes con valores de p ajustados faltantes. El control de pruebas múltiples se realizó mediante el procedimiento de Benjamini–Hochberg (BH). La lista archivada de genes diferencialmente expresados (DEG) utilizó un cambio absoluto en el log2 mayor a 1 y un valor de p ajustado por BH < 0,05. La comparación con la fuente pública GEO confirmó que la entrada era TPM, en lugar de recuentos brutos de lecturas. Redondear los valores de TPM no cumple con el requisito de recuentos brutos de DESeq2. Se conservan las estimaciones originales, pero la validez de las estadísticas de descubrimiento y los resultados dependientes de WGCNA y selección de características permanece sin resolver hasta que se realice un reanálisis adecuado. La comparación con la fuente se documenta en el archivo suplementario.
Para la visualización, se aplicó la transformación estabilizadora de varianza de DESeq2 (VST) con blind = FALSE. Se realizó un análisis de componentes principales (PCA) sobre la matriz de expresión VST. El mapa de calor utilizó puntuaciones z por filas para los 50 genes con los valores de p ajustados más bajos. La implementación de PCA centró y escaló los valores transformados por gen utilizando prcomp con scale. = TRUE.
Análisis de red de coexpresión génica ponderada
Para el WGCNA, se conservaron los genes con recuentos mayores a 5 en al menos tres muestras de GSE199939. Los factores de tamaño se estimaron con DESeq2, se aplicó la transformación VST con blind = TRUE, y se seleccionaron los 5.000 genes con mayor varianza entre muestras. La calidad de las muestras y los genes se evaluó utilizando goodSamplesGenes, y se empleó agrupamiento jerárquico por enlace promedio para la evaluación de calidad a nivel de muestra.
Se construyó una red firmada con WGCNA (versión 1.74). Se evaluaron potencias candidatas de 1 a 10 y de 12 a 30 en incrementos de 2 mediante pickSoftThreshold; se utilizó un objetivo de ajuste a una topología libre de escala de 0,85, y la potencia de umbralización suave seleccionada fue 18. Los módulos se identificaron con blockwiseModules utilizando una adyacencia firmada y una matriz de superposición topológica firmada, correlación de Pearson, tamaño mínimo del módulo de 30, altura de corte para fusión de 0,25, umbral de reasignación de 1 × 10⁻⁶, pamRespectsDendro = FALSE y tamaño máximo de bloque de 10 000.
Los eigengenes de los módulos se correlacionaron con un rasgo binario de UDM. Se consideraron asociados a la UDM los módulos no grises con |r| > 0,5 y p < 0,05. Para cada módulo asociado, la significancia génica (GS) se definió como la correlación de Pearson entre la expresión génica y el estado de UDM, y la pertenencia al módulo (MM) como la correlación de Pearson entre la expresión génica y el eigengene correspondiente del módulo. Los genes centrales (hub genes) se definieron por |MM| > 0,8 y |GS| > 0,5. Se seleccionó el módulo azul, que mostró la asociación positiva más fuerte con la UDM. Sus genes centrales se intersectaron con los genes diferencialmente expresados (DEG) y con el conjunto de genes relacionados con la NDP. Por lo tanto, el umbral de centralidad (hub) reportado utiliza los valores absolutos tanto de MM como de GS, independientemente del signo de la correlación.
Jerarquización de características basada en aprendizaje automático
Los 77 genes compartidos por los conjuntos de genes DEG, genes centrales del módulo azul y genes relacionados con DPN se evaluaron en GSE199939. Los símbolos de genes duplicados se fusionaron mediante su expresión media. La matriz de genes candidatos se transformó con log2; cuando el valor máximo superaba 50, se eliminaron las características con varianza cero y las características conservadas se estandarizaron. Se utilizó una semilla aleatoria de 123. La secuencia implementada incluyó cribado de candidatos en toda la cohorte, fusión de símbolos duplicados, transformación logarítmica condicional, filtrado por varianza cero, centrado y escalado para toda la cohorte, y selección específica de características según el algoritmo. El cribado de DEG y WGCNA utilizó toda la cohorte de descubrimiento antes de la validación cruzada a nivel de algoritmo. Por lo tanto, el flujo de trabajo descrito no establece una validación anidada libre de fugas, y sus AUC internas no pueden utilizarse como estimaciones imparciales del rendimiento predictivo.
Se aplicaron tres procedimientos de selección de características. Primero, se ajustó una regresión logística con el operador de contracción y selección por mínima absoluta (LASSO) mediante glmnet (versión 5.0), familia binomial, alpha = 1, error de clasificación como medida de validación cruzada, sin estandarización adicional y validación cruzada de cinco pliegues restringida por el tamaño de la clase más pequeña. Se seleccionaron las características en lambda.1se; lambda.min se utilizó únicamente si lambda.1se no seleccionaba ningún gen. Segundo, se ajustó un bosque aleatorio con 1.000 árboles utilizando randomForest (versión 4.7-1.2); se conservaron los genes con una disminución media en el índice de Gini al menos tan grande como la importancia media entre los genes candidatos. Tercero, se implementó la eliminación recursiva de características mediante máquina de vectores de soporte lineal (SVM-RFE) con e1071 (versión 1.7-17), clasificando las características según el peso lineal al cuadrado en la cohorte completa antes de evaluar subconjuntos progresivamente más pequeños mediante el área bajo la curva (AUC) de validación cruzada dejando uno fuera (LOOCV). La clasificación no se volvió a calcular dentro de cada pliegue de entrenamiento. El ajuste de la SVM lineal utilizó scale = FALSE y probability = TRUE sin una cuadrícula explícita de ajuste de costos. La selección de la penalización LASSO utilizó su validación cruzada interna sin un bucle externo de evaluación separado, y la importancia del bosque aleatorio se calculó a partir de la cohorte completa.
Ningún gen fue seleccionado por los tres métodos; por lo tanto, se conservaron los genes respaldados por al menos dos métodos. SVM-RFE produjo un AUC de 1.00 en todos los tamaños de subconjunto evaluados, y se seleccionó el subconjunto más pequeño empatado. Dado que esta separación completa generó preocupaciones sobre sobreajuste y una evaluación demasiado optimista en la cohorte de descubrimiento pequeña, no se interpretó el AUC de SVM-RFE como una estimación del desempeño clínico. Ningún modelo multigénico bloqueado fue probado en una cohorte externa; los análisis externos de la curva característica de operación del receptor (ROC) evaluaron la expresión individual de los genes candidatos. La inspección del script de análisis confirmó que el preprocesamiento y la clasificación de características mediante SVM no se limitaron a los pliegues de entrenamiento. Se utilizaron los mismos resultados de LOOCV para elegir el tamaño del subconjunto, sin un bucle externo de evaluación. En consecuencia, este flujo de trabajo presenta fuga de información y solo permite la priorización exploratoria de características.
Análisis de enriquecimiento funcional
Se realizaron análisis de sobre-representación de Ontología Genética (GO) y del Kyoto Encyclopedia of Genes and Genomes (KEGG) en el panel de seis genes. Los símbolos génicos se asociaron a identificadores Entrez mediante org.Hs.eg.db (versión 3.21.0). El análisis de GO se llevó a cabo con clusterProfiler (versión 4.16.0) a través de las ontologías de proceso biológico, componente celular y función molecular. La enriquecimiento de KEGG utilizó el código del organismo humano (hsa). Los términos significativos se definieron como p nominal < 0,05 y p ajustado por BH < 0,05. Dado que solo se incluyeron seis genes, el análisis de enriquecimiento se utilizó principalmente para la anotación funcional. El script de KEGG empleó anotaciones locales de KEGG.db con enrichKEGG(use_internal_data = TRUE); debe documentarse la versión de la anotación. Los scripts de GO y KEGG no proporcionaron un universo personalizado, por lo que las bases de datos de anotación definieron los fondos predeterminados.
Evaluación externa de transcriptómica de conjunto
Para la matriz combinada GSE68183/GSE80178, los símbolos génicos se estandarizaron y los símbolos duplicados se redujeron mediante la expresión media en las filas coincidentes. Los seis genes candidatos se alinearon al archivo de fenotipo. Dado que los archivos disponibles no documentaron completamente el procedimiento de combinación previa y corrección por lotes, este conjunto de datos se analizó tal como se proporcionó y se interpretó con cautela. En consecuencia, no puede establecerse, a partir del registro de procesamiento suministrado, ni la eliminación de efectos de lote ni la independencia de la señal del grupo respecto a los efectos del estudio. Esta matriz ofrece apoyo exploratorio entre conjuntos de datos, más que una replicación definitiva.
Para GSE134431, los seis genes candidatos se extrajeron de la matriz de lecturas por kilobase por millón de lecturas mapeadas (RPKM) y se transformaron como log2(RPKM + 1). DFS se utilizó como grupo de referencia y DFU como grupo de comparación. DFS representa la piel de pie diabético sin úlcera. El Figura 4C originalmente presentada mostraba valores RPKM brutos; el panel revisado utiliza la escala log2(RPKM + 1) indicada. Se verificaron pruebas de Wilcoxon bilaterales con aproximación normal y corrección por continuidad, así como análisis ROC orientados automáticamente, en ambas escalas, y arrojaron valores p e índices AUC idénticos porque la transformación es estrictamente monótona.
En cada conjunto de datos de validación masiva, las diferencias de expresión entre grupos se evaluaron mediante pruebas de suma de rangos de Wilcoxon bilaterales, y se aplicó la corrección de BH en los seis genes. Las curvas ROC se calcularon con pROC (versión 1.19.0.1), utilizando la dirección seleccionada automáticamente por el paquete. Se calcularon las AUC y los intervalos de confianza del 95 % (IC) correspondientes para comparar los patrones discriminatorios entre conjuntos de datos. La selección automática de la dirección de la ROC a partir de cada conjunto de datos de evaluación puede dar lugar a una discriminación optimista; estas AUC de un solo gen son descriptivas y no validan un modelo de predicción clínica preespecificado.
Localización a nivel de célula individual y análisis a nivel de muestra
El análisis a nivel de célula individual utilizó el objeto Seurat guardado biofsci_SingleR_annotated_MMP1_analyzed.rds del conjunto de datos GSE165816, que contiene 22.889 genes y 69.944 células en el ensayo de ARN. El ensayo de ARN conservó una capa de conteos de enteros no negativos y una capa de datos generada mediante LogNormalize con un factor de escala de 10.000, seguida de una transformación log1p; esta última no correspondía a TPM. El objeto contenía 2.000 genes variables seleccionados mediante el método vst (loess.span = 0,3; 20 intervalos de igual anchura), expresión escalada para todos los genes conservados (centrado y escalado activados; scale.max = 10) y 50 componentes principales calculados a partir de las características variables con semilla 42. El historial de comandos guardado utilizó las dimensiones 1–20 de Harmony para la construcción de vecinos más cercanos y la proyección uniforme de variedades mediante aproximación de vecindad (UMAP). Los parámetros de vecindad incluyeron k = 20, Annoy con 50 árboles y distancia euclidiana, y un umbral de poda de vecinos más cercanos compartidos (SNN) de 1/15. La agrupación en clusters utilizó una resolución de 0,8, algoritmo 1, n.start = 10, n.iter = 10 y random.seed = 0. UMAP utilizó la implementación uwot, 30 vecinos, dos dimensiones de salida, una métrica de distancia coseno, min.dist = 0,3, spread = 1, learning.rate = 1 y semilla 42. El objeto conservó una reducción mediante Harmony, pero no fue posible recuperar los criterios originales de control de calidad, la llamada completa a RunHarmony incluyendo las covariables por lote, ni la referencia y configuración de anotación de SingleR para este objeto analizado. Las etiquetas de tipo celular, etiquetas de grupo e identificadores de muestras se almacenaron en SingleR_label, Group y orig.ident, respectivamente. Se conservaron diez tipos de células anotados: linfocitos B, linfocitos T CD8+, células endoteliales, células epiteliales, fibroblastos, células madre hematopoyéticas, queratinocitos, macrófagos, monocitos y neuronas.
La expresión de MMP1 se resumió por tipo celular. Las células con expresión normalizada de MMP1 mayor que cero se clasificaron como positivas para MMP1. Para el análisis a nivel de muestra, se calculó la expresión normalizada media para cada combinación de muestra y tipo celular. Las muestras de UCP y las controles se compararon dentro de cada tipo celular mediante pruebas de suma de rangos de Wilcoxon bilaterales, seguidas de corrección BH en todos los tipos celulares analizados. El acceso a la muestra en GEO, y no la célula individual, fue la unidad utilizada en estas comparaciones reportadas. Los 24 accesos no se consideraron prueba de 24 donantes independientes. El objeto guardado no contenía un identificador de donante verificado, y no se modeló el muestreo repetido de tejido dentro de los mismos donantes; por lo tanto, las pruebas a nivel de muestra se interpretan como exploratorias. Estos resúmenes promedian la expresión normalizada dentro de cada muestra y tipo celular; no son modelos pseudobulk de diferencias en expresión basados en suma de conteos.
Se puntuaron diez conjuntos de genes funcionales con Seurat AddModuleScore. Se calcularon las correlaciones de Spearman entre la expresión de MMP1 por célula y las puntuaciones de módulo, y se corrigieron mediante BH. Para el análisis exploratorio de MMP1-alto, se seleccionaron los tres tipos celulares con la expresión media más alta de MMP1 entre los tipos celulares que contenían al menos 50 células. Se definió un umbral global como la expresión mediana entre las células positivas para MMP1 cuando había más de 10 células positivas disponibles; en caso contrario, el script utilizó el percentil 75 general. Las células por encima de este umbral se asignaron al grupo MMP1-alto y las células restantes al grupo MMP1-bajo. FindMarkers utilizó una prueba de Wilcoxon, logfc.threshold = 0.25 y min.pct = 0.1. Los genes sobreexpresados con p ajustado < 0.05 se sometieron a enriquecimiento de procesos biológicos GO. Dado que los grupos se definieron por la expresión de MMP1, este análisis se utilizó para describir las vías asociadas con el estado MMP1-alto. Las correlaciones por célula, sus valores p ajustados y el enriquecimiento de MMP1-alto frente a MMP1-bajo son descriptivos porque no se modeló la dependencia dentro de la muestra. Las células individuales no se interpretaron como réplicas biológicas independientes.
Predicción de ingredientes, dianas y hierbas en la MTC
Los seis genes priorizados se asociaron con la columna 4 de la tabla local de interacciones químico-gen del Comparative Toxicogenomics Database (CTD). Los registros se restringieron a Homo sapiens en la columna 7. Los nombres de los ingredientes se recortaron y normalizaron a minúsculas para la coincidencia, y se eliminaron los ingredientes duplicados y las asociaciones hierba-ingrediente duplicadas. Los ingredientes se vincularon con las hierbas utilizando la tabla de referencia hierba-ingrediente. El enriquecimiento de la base de datos utilizó un valor p nominal < 0,05 y un valor p ajustado < 0,05. Se eliminaron los registros duplicados de hierba-ingrediente-blanco antes del resumen basado en cobertura. El enriquecimiento de hierbas utilizó clusterProfiler::enricher con la asociación hierba-ingrediente como TERM2GENE, minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 y qvalueCutoff = 1, antes de aplicar los umbrales de significancia nominal y ajustados por BH. Estos enlaces de base de datos pueden describir cambios en la expresión o actividad, pero no establecen unión directa ni una dirección uniforme del efecto.
Las hierbas se clasificaron utilizando la siguiente puntuación de cobertura:
S = 3R + 5L +2T + 3C + 2I + N (1)
Aquí, R es el número de registros de MMP1, L es la cantidad de ingredientes asociados a MMP1, T es el número de dianas cubiertas, C es la cantidad de ingredientes principales, I es el indicador del eje de la matriz, y N es el número total de ingredientes.
Los ingredientes principales fueron quercetina, luteolina y berberina. El indicador del eje matriz se estableció en 1 cuando una hierba cubría tanto MMP1 como MMP13, y en 0 en los demás casos. Se requirió que las hierbas candidatas contuvieran al menos un registro vinculado a MMP1 y, además, al menos dos ingredientes vinculados a MMP1 o al menos cuatro dianas más un ingrediente principal. La puntuación se utilizó para resumir la cobertura de la base de datos y no se consideró una medida de eficacia farmacológica. Los coeficientes definen una regla personalizada y heurística de cobertura que enfatiza los registros e ingredientes vinculados a MMP1, una cobertura más amplia de dianas, los tres ingredientes designados y la cobertura conjunta de MMP1/MMP13. Estos coeficientes no se ajustaron según resultados clínicos ni se validaron experimentalmente, y pesos alternativos podrían modificar el ordenamiento de las hierbas.
Recolección de tejido de pacientes y evaluación preliminar mediante qPCR e inmunotransferencia
Los pacientes con úlceras del pie diabético diagnosticadas clínicamente que se sometieron a desbridamiento o cirugía indicados clínicamente en el Hospital Cuarto de Wuhan fueron elegibles cuando había tejido del pie disponible y se había obtenido consentimiento informado por escrito. Los criterios de exclusión fueron la presencia de malignidad en el sitio de muestreo, una causa no diabética de la úlcera o una cantidad o calidad insuficiente de tejido para los ensayos previstos. Se obtuvieron tejido de la UEP y tejido no ulcerado que rodeaba la herida del mismo paciente según el protocolo de estudio aprobado. Este último sirvió como comparador emparejado perilesional; no se trataba de piel sana no diabética. La evaluación mediante qPCR incluyó cuatro pares emparejados (cuatro muestras de UEP y cuatro muestras perilesionales correspondientes), y la transferencia Western incluyó tres pares emparejados. Los autores confirmaron el emparejamiento para cada ensayo; no se utilizó identidad cruzada entre ensayos en las comparaciones estadísticas. Cada paciente fue la unidad biológica, y los pocillos técnicos de PCR fueron mediciones repetidas dentro de una misma muestra. Estos ensayos preliminares tenían como objetivo evaluar la expresión a nivel tisular de MMP1 y no estaban diseñados para establecer el rendimiento diagnóstico, la causalidad o la generalización entre los fenotipos de UEP.
Para la validación mediante qPCR, se extrajo ARN total de especímenes de tejido derivados de pacientes utilizando un reactivo de extracción de ARN total según las instrucciones del fabricante. La concentración y pureza del ARN se evaluaron espectrofotométricamente, y se utilizaron muestras con una relación A260/A280 de 1,8 a 2,1 para los análisis posteriores. Se transcribió reversamente 1 µg de ARN total utilizando un kit de transcripción reversa del virus de la leucemia murina de Moloney (M-MLV) en un volumen final de reacción de 20 µL. El proyecto del instrumento disponible identifica un sistema de PCR en tiempo real. La PCR cuantitativa se realizó utilizando una mezcla maestra de PCR con SYBR Green 2x en una reacción de 20 µL que contenía 10 µL de mezcla maestra de SYBR Green 2x, 0,4 µL de cada cebador (directo e inverso), 2 µL de ADN complementario (cADN) y 7,2 µL de agua libre de nucleasas. El programa de amplificación consistió en una desnaturalización inicial a 95 °C durante 30 s, seguido de 40 ciclos de 95 °C durante 5 s y 60 °C durante 30 s. Se realizó un análisis de la curva de disociación para verificar la especificidad de la amplificación. La abundancia de transcritos de MMP1 se midió utilizando β-actina (ACTB) como gen de referencia. Las secuencias de los cebadores se listan en la Tabla 1. Para el análisis emparejado revisado, se promediaron las cinco réplicas técnicas por blanco dentro de cada espécimen antes del cálculo de ΔCq, y se calculó la expresión relativa de MMP1 mediante el método 2-ΔΔCq , utilizando el grupo de tejido perilesional no ulcerado como calibrador. Los pares de muestras recuperados fueron NC–DFU, NC1–DFU1, NC2–DFU2 y NC3–DFU3, confirmados por los autores como cuatro pares emparejados de pacientes. El gráfico anterior de qPCR utilizó valores de cinco réplicas técnicas provenientes únicamente de NC y DFU; el gráfico revisado muestra un valor por espécimen tras promediar las réplicas técnicas para cada uno de los cuatro pares. La inferencia emparejada utilizó ΔCq = Cq medio(MMP1) − Cq medio(ACTB), en lugar de valores de cambio de expresión por pocillo. El proyecto archivado del instrumento también difiere del volumen de reacción y del programa de ciclado reportados, y su correspondencia con el experimento graficado permanece sin resolver.
Para la validación mediante inmunotransferencia (WB), las muestras de tejido se homogenizaron en tampón de ensayo para inmunoprecipitación con detergente (RIPA) frío suplementado con inhibidores de proteasas. Los lisados se incubaron en hielo durante 30 min y se centrifugaron a 12.000 x g durante 15 min a 4 °C. Se recolectaron los sobrenadantes y se determinaron las concentraciones de proteína mediante un ensayo de ácido bicinconínico. Se separaron cantidades iguales de proteína (20 µg por pocillo) en geles de gradiente de dodecilsulfato de sodio-poliacrilamida al 4%–20% y se transfirieron a membranas de difluoruro de polivinilideno de 0,22 µm. Las membranas se bloquearon con leche descremada al 5% en solución salina tamponada con Tris que contenía Tween-20 al 0,1% durante 1 h a temperatura ambiente y se incubaron toda la noche a 4 °C con un anticuerpo policlonal contra MMP1 (1:1.000) y un anticuerpo policlonal contra cofilina (1:6.000). Después de tres lavados con solución salina tamponada con Tris que contenía Tween-20 al 0,1%, las membranas se incubaron con inmunoglobulina G (IgG) de cabra anti-conejo conjugada con peroxidasa de rábano picante (1:5.000) durante 1 h a temperatura ambiente. Las bandas proteicas se visualizaron mediante un sustrato quimioluminiscente mejorado y se capturaron con un sistema de imagen quimioluminiscente utilizando el software operativo asociado (versión 1.2.0), tal como se registró en los metadatos de la imagen. Las bandas se cuantificaron utilizando el software ImageJ. Se utilizó la cofilina como control de carga y la abundancia de la proteína MMP1 se normalizó respecto a la cofilina para la comparación entre grupos.
Análisis estadístico y software
Todas las pruebas fueron bilaterales, salvo que se indique lo contrario. Se utilizó un valor de p ajustado por BH < 0,05 como umbral principal para la corrección por múltiples comparaciones. Los tamaños exactos de las muestras variaron según el conjunto de datos y, para el análisis a nivel de muestra de células individuales, según la presencia de un tipo celular determinado en cada muestra. Los resúmenes de expresión continua se muestran como observaciones individuales, con diagramas de caja que indican la mediana y el rango intercuartílico; los bigotes se extienden hasta 1,5 veces el rango intercuartílico. Para la inmunotransferencia, las seis relaciones recuperadas de MMP1 respecto a cofilina se analizaron mediante una prueba t pareada bilateral en tres pares de pacientes confirmados por los autores (df = 2; p = 0,0107). Para la qPCR, cinco valores de Cq de ACTB y cinco de MMP1 se promediaron por separado dentro de cada espécimen antes del cálculo de ΔCq. Una prueba t pareada bilateral comparó los valores de ΔCq de las úlceras del pie diabético (DFU) y de los tejidos perilesionales emparejados en cuatro pares de pacientes confirmados por los autores (df = 3; p = 3,04 × 10⁻⁵). El valor medio de ΔCq perilesional se utilizó como calibrador común para la representación de la expresión relativa. El cambio medio en el número de copias dentro del paciente y su intervalo de confianza del 95 % se obtuvieron mediante la transformación inversa de la diferencia media de ΔCq pareado y su intervalo de confianza basado en t. Las observaciones biológicas individuales se muestran con líneas que unen los tejidos emparejados; los pocillos técnicos no aumentan el tamaño de la muestra biológica. Los valores de p para los ensayos con tejidos son nominales y exploratorios. Con tres o cuatro pacientes, no es posible evaluar de forma fiable la normalidad de las diferencias pareadas, por lo que los ensayos siguen siendo preliminares. Los análisis bioinformáticos y la generación de figuras se realizaron en R 4.5.2 sobre Windows 11. Las versiones de los paquetes principales incluyeron DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 y ggplot2 4.0.3. Un inventario consolidado del software, bases de datos y parámetros se proporciona en la Tabla Suplementaria 1.
Resultados
La transcriptómica de descubrimiento identifica un amplio programa de expresión asociado a las úlceras del pie diabético
GSE199939 sirvió como cohorte de descubrimiento e incluyó 10 muestras de UDM y 11 muestras control (Figura 1A). El análisis de componentes principales de la expresión normalizada con VST mostró una clara separación entre grupos; los componentes principales 1 y 2 explicaron el 34,8 % y el 15,1 % de la varianza total, respectivamente (Figura 1B).
Utilizando |cambio en la expresión log2| > 1 y p ajustado por BH < 0,05, el análisis de expresión diferencial identificó 3.691 genes diferencialmente expresados (GDE), incluyendo 1.247 genes regulados positivamente en la UDF y 2.444 genes regulados negativamente en la UDF (Figura 1C). Los 50 principales GDE formaron un patrón de expresión fuertemente estructurado por grupos (Figura 1D). Entre los seis genes seleccionados posteriormente, MMP1 mostró el mayor cambio en la cohorte de descubrimiento (cambio en la expresión log2 = 9,854; p ajustado = 1,24 × 10⁻²⁹).
Un módulo de coexpresión asociado a UDM converge con los DEG y los genes relacionados con NPD
Se realizó un análisis de WGCNA sobre los 5.000 genes con mayor variabilidad transformados mediante VST. Se seleccionó una potencia de umbralización suave de 18 para la red con signo, equilibrando el ajuste a la topología libre de escala y la conectividad (Figura 2A). El agrupamiento jerárquico y la detección dinámica de módulos identificaron múltiples módulos de coexpresión (Figura 2B). El módulo azul mostró la asociación positiva más fuerte con la UDM (Pearson r = 0,97, p = 5 × 10-13; Figura 2C). Los resúmenes correspondientes del agrupamiento de muestras y del control de calidad del tamaño de los módulos se proporcionan en la Figura suplementaria 1A,B.
Dentro del módulo azul, 689 genes cumplieron con los criterios de centralidad |MM| > 0,8 y |GS| > 0,5 (Figura 2D). La intersección entre los 3.691 genes diferencialmente expresados, los 689 genes centrales del módulo azul y los 1.062 genes relacionados con DPN produjo 77 genes candidatos compartidos (Figura 2E). Se muestra una vista simplificada de la red de genes centrales del módulo azul y las estadísticas más altas de centralidad en la Figura suplementaria 2A,B.
La selección de características mediante múltiples métodos prioriza seis genes pero muestra sobreajuste en la cohorte de descubrimiento
Los 77 genes intersecantes se analizaron mediante LASSO, bosque aleatorio y SVM-RFE. LASSO conservó siete genes en la penalización seleccionada: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 y CHEK1 (Figura 3A). El filtrado mediante bosque aleatorio conservó 41 genes con una importancia igual o superior a la media, incluyendo cinco miembros del panel final entre las características más altamente clasificadas (Figura 3B). SVM-RFE produjo un AUC de 1,00 para cada subconjunto anidado evaluado; según la regla del tamaño mínimo en caso de empate, CHEK1 fue seleccionado como el subconjunto de un solo gen (Figura 3C), lo que plantea preocupaciones sobre sobreajuste y una evaluación demasiado optimista en la cohorte de descubrimiento. En la Figura Suplementaria 3A–C se muestran la expresión correspondiente en la cohorte de descubrimiento, el mapa de calor y las curvas ROC.
Ningún gen fue seleccionado por los tres métodos. La retención de genes respaldados por al menos dos métodos produjo CCL7, CHEK1, MKI67, MMP1, MMP13 y TRPV2 (Figura 3D). La anotación GO de estos seis genes destacó el desensamblaje de la matriz extracelular, los procesos catabólicos y metabólicos del colágeno, el cromosoma condensado y las funciones relacionadas con metaloendopeptidasas (todos con p ajustado por BH < 0,05; Figura 3E). El análisis KEGG identificó la señalización de interleucina-17 (IL-17) (CCL7/MMP1/MMP13; p ajustado = 1,81 × 10⁻⁴) y la señalización de relaxina (MMP1/MMP13; p ajustado = 0,0175; Figura 3F). Estos resultados de enriquecimiento se utilizaron para caracterizar las funciones biológicas representadas por el panel de seis genes.
La evaluación entre conjuntos de datos muestra un apoyo heterogéneo para MMP1
En la matriz combinada GSE68183/GSE80178 (9 úlceras del pie diabético y 6 controles), CCL7, MMP1 y MMP13 mostraron diferencias entre los grupos tras la corrección de BH en los seis genes (valores de p ajustados = 0,0168, 0,0159 y 0,0431, respectivamente; Figura 4A). CHEK1, MKI67 y TRPV2 no alcanzaron el umbral de significación ajustado (valores de p ajustados = 0,259, 0,680 y 0,259). El análisis ROC de un solo gen produjo valores de AUC de 0,944 para CCL7 (IC del 95 %, 0,825–1,000), 0,704 para CHEK1 (0,403–1,000), 0,574 para MKI67 (0,243–0,905), 0,981 para MMP1 (0,930–1,000), 0,870 para MMP13 (0,686–1,000) y 0,722 para TRPV2 (0,447–0,997; Figura 4B). Estos valores ROC se consideraron exploratorios porque el procedimiento previo de combinación y corrección por lotes no fue completamente documentado.
En GSE134431 (13 muestras de UDM y 8 muestras de SDS sin úlcera), la expresión de MMP1 fue mayor en UDM que en SDS según la prueba de Wilcoxon al nivel de significancia nominal (p = 0,0225), aunque esta asociación no se mantuvo significativa tras la corrección de BH (p ajustado = 0,135; Figura 4C). Las otras cinco genes no mostraron diferencias significativas entre grupos. MMP1 también presentó el AUC descriptivo más alto, con un AUC de 0,808 (IC del 95 %, 0,589–1,000), mientras que los AUC de los otros candidatos oscilaron entre 0,529 y 0,635 (Figura 4D). En general, MMP1 mostró el patrón descriptivo más consistente entre los seis candidatos, pero la replicación estadística fue incompleta.
El análisis a nivel de célula individual localiza MMP1 predominantemente en fibroblastos
El conjunto de datos de célula individual contenía 69.944 células de 24 muestras (14 úlceras del pie diabético y 10 controles) y comprendía 10 tipos celulares anotados (Figura 5A). La visualización de características UMAP localizó la expresión de MMP1 en regiones celulares restringidas, en lugar de mostrar una expresión uniforme a través del atlas (Figura 5B). En general, 3.799 células (5,43 %) presentaron expresión normalizada de MMP1 mayor que cero. Los fibroblastos tuvieron la expresión normalizada media más alta (0,181) y la fracción más grande de células positivas para MMP1 (7,88 %; Figura 5C).
A nivel de muestra, la expresión media de MMP1 fue mayor en las muestras de UPM que en las muestras de control en queratinocitos, fibroblastos y células endoteliales. Tras la corrección de BH en todos los tipos celulares analizados, cada una de estas comparaciones tuvo un valor p ajustado de 0,0214 (queratinocitos: 9 muestras de control y 14 de UPM; fibroblastos: 10 y 14; células endoteliales: 10 y 14; Figura 5D). La fracción positiva para MMP1 aumentó del 5,86 % al 9,29 % en fibroblastos, del 0,026 % al 6,68 % en queratinocitos y del 0,29 % al 2,67 % en células endoteliales (Figura 5E).
Las correlaciones entre puntajes por módulos por célula fueron modestas. La mayor correlación positiva se observó para el puntaje del módulo de senescencia/fenotipo secretorio asociado a la senescencia (SASP) (rho de Spearman = 0,274), seguida por la remodelación de la matriz extracelular (rho = 0,240), ferroptosis (rho = 0,197) y activación de fibroblastos (rho = 0,170; Figura 5F). Comparación de MMP1-alto y MMP1-los fibroblastos de bajo contenido mostraron enriquecimiento en términos relacionados con la organización de la matriz extracelular, organización de la estructura extracelular, organización del fibril de colágeno, procesamiento de glucoproteínas y plegamiento de proteínas (Figura 5G). Estos hallazgos descriptivos vincularon el MMP1-estado de fibroblastos alto hacia procesos relacionados con la remodelación de la matriz. Se proporcionan UMAP a nivel de grupo, resúmenes de muestras de todos los tipos celulares y contexto de puntuación funcional en Figura suplementaria 4A–C. Las asociaciones a nivel celular individual no se consideraron como evidencia independiente del donante.
La cobertura de la red prioriza los ingredientes vinculados a MMP1 y las hierbas candidatas
La tabla filtrada de relaciones hierba-ingrediente-diana contenía 561 registros únicos que vinculaban 99 hierbas, 14 ingredientes y cinco de los seis objetivos candidatos. MMP1 fue el objetivo más frecuente, con 156 registros, seguido por CHEK1 (120), MMP13 (102), MKI67 (100) y TRPV2 (83; Figura 6A). Entre los ingredientes, la quercetina y la luteolina tuvieron la mayor cobertura de hierbas y se asociaron con 83 y 62 hierbas, respectivamente. La berberina se asoció con 10 hierbas; estos tres ingredientes se utilizaron como ingredientes principales en la regla de priorización (Figura 6B).
El puntaje de cobertura ubicó conjuntamente a Guanhuangbo, Mahuang y Niuxi en el primer lugar (puntaje = 38 cada uno; Figura 6C). Cada uno cubrió los cinco blancos disponibles y contenía dos ingredientes vinculados a MMP1. La matriz ingrediente-blanco mostró que la quercetina ofreció la cobertura más amplia entre el panel de blancos, mientras que la luteolina y la berberina aportaron conectividad adicional centrada en MMP1 (Figura 6D). Una red enfocada conectó las hierbas principales con ingredientes representativos y los cinco blancos disponibles (Figura 6E). Estos resultados identificaron combinaciones hierba-ingrediente-blanco con alta cobertura en la base de datos para su evaluación posterior. Las matrices de cobertura complementarias de hierba-blanco e ingrediente principal se muestran en la Figura Suplementaria 5A,B.
Los ensayos preliminares con tejidos apareados muestran una mayor abundancia de ARNm y proteína de MMP1
La evaluación mediante inmunotransferencia mostró una mayor abundancia de MMP1 en las muestras de UEP que en las muestras emparejadas de tejido perilesional no ulcerado (Figura 7A,B). Las tres parejas emparejadas presentaron una diferencia media en la relación MMP1/cofilina (UEP menos perilesional) de 0,3553 (IC del 95 %, 0,1959–0,5147; prueba t pareada bilateral, t(2) = 9,592, p = 0,0107). Las mediciones pareadas de cada paciente se muestran en la Figura 7B. Tras promediar cinco réplicas técnicas por gen por muestra, la qPCR mostró una mayor abundancia normalizada de ARNm de MMP1 en cada una de las cuatro muestras de UEP en comparación con la muestra perilesional emparejada (Figura 7C). La diferencia media dentro del paciente (UEP menos perilesional) en el valor ΔCq fue de −2,6035 (IC del 95 %, −2,8024 a −2,4046; prueba t pareada bilateral, t(3) = −41,663, p = 3,04 × 10⁻⁵), lo que corresponde a un aumento promedio geométrico de 6,08 veces (IC del 95 %, 5,30–6,98). Estas observaciones, basadas en muestras pequeñas, son preliminares y no establecen un efecto funcional.
En los conjuntos de datos de descubrimiento y externos a granel, MMP1 presentó el patrón descriptivo más consistente entre los seis genes priorizados, aunque la replicación estadística fue incompleta. Los resúmenes a nivel de célula individual mostraron la expresión media más alta en fibroblastos, y las mediciones emparejadas de WB de tres pacientes y las mediciones emparejadas de qPCR de cuatro pacientes mostraron una mayor abundancia de MMP1. Estas observaciones respaldan a MMP1 como un candidato asociado a las UDD para investigaciones posteriores. El flujo de trabajo general de evaluación computacional a tisular se resume en la Figura Suplementaria 6.
DISPONIBILIDAD DE LOS DATOS:
Los conjuntos de datos transcriptómicos públicos están disponibles en el NCBI Gene Expression Omnibus bajo los números de acceso GSE199939, GSE68183, GSE80178, GSE134431 y GSE165816. En el Archivo Suplementario 1 se incluyen los scripts disponibles para el análisis y la generación de figuras, tablas procesadas de expresión y resultados, tablas fuente cuantitativas para figuras, tablas de resultados estadísticos, el cuaderno original de qPCR y el proyecto del instrumento, así como las imágenes suministradas de inmunotransferencias sin recortar. El archivo también contiene metadatos celulares extraídos e historial de comandos del objeto de célula individual recuperado, informes de verificación del tipo de matriz y un manifiesto de archivos. El Archivo Suplementario 1 conserva archivos fuente históricos e incluye una carpeta R2_Updates que contiene las tablas fuente revisadas para los ensayos pareados, salidas estadísticas, código para la generación de figuras e inventario corregido de parámetros. El archivo RDS completo analizado de Seurat se identifica en la documentación del archivo, pero no está integrado en este archivo ZIP suplementario. No están completamente disponibles la historia completa de fusión de datos masivos (bulk), los ajustes originales de filtrado y anotación de células individuales, ni los detalles completos sobre la sustracción del fondo original en las inmunotransferencias y la cuantificación por bandas; estas limitaciones se describen en el protocolo y la discusión. El archivo RDS recuperado localmente no ha sido depositado en un repositorio público.
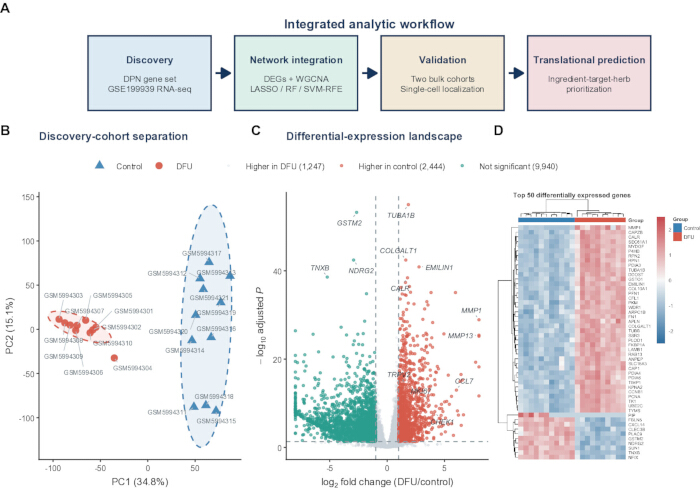
Figura 1: La transcriptómica de descubrimiento identifica un programa de expresión asociado a la UPM. (A) Resumen del flujo de trabajo computacional, que comprende la construcción del conjunto de genes de NPD, el análisis de descubrimiento GSE199939, la integración de redes y aprendizaje automático, la evaluación en muestras masivas y de célula individual, y la predicción de ingredientes-dianas-hierbas en MTC. (B) Análisis de componentes principales de los perfiles de expresión GSE199939 con transformación estabilizadora de varianza procedentes de 10 muestras de UPM y 11 controles. Las elipses indican regiones del grupo al 90 %; los porcentajes indican la varianza explicada por cada componente. (C) Gráfico de volcan del análisis diferencial de expresión con DESeq2 para UPM frente a control. Los puntos rojos y turquesa indican genes regulados positivamente en UPM y control, respectivamente, utilizando |cambio de expresión log2| > 1 y p ajustado con BH < 0,05; los puntos grises no cumplieron ambos umbrales. (D) Mapa de calor de puntuaciones z normalizadas por filas para los 50 genes con los valores de p ajustados más bajos. Las columnas corresponden a muestras biológicas y la barra de anotación indica el grupo. DEGs, genes con expresión diferencial; UPM, úlcera del pie diabético; NPD, neuropatía periférica diabética; VST, transformación estabilizadora de varianza. La evaluación experimental final se describe en el protocolo y en la Figura 7. qPCR, reacción en cadena de la polimerasa cuantitativa; MTC, medicina tradicional china; RF, bosque aleatorio; LASSO, operador de contracción y selección por mínimos absolutos; SVM-RFE, eliminación recursiva de características mediante máquina de vectores de soporte. Haga clic aquí para ver una versión ampliada de esta figura.
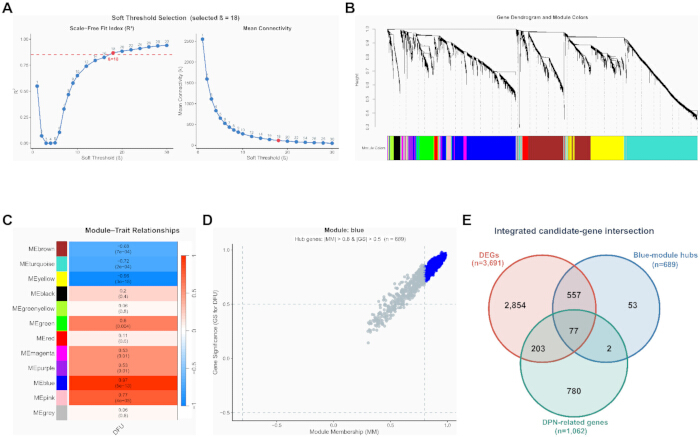
Figura 2: La WGCNA y el conocimiento previo sobre la DPN convergen en 77 genes candidatos. (A) Evaluación del umbral suave de red con signo para los 5.000 genes más variables transformados mediante VST. La potencia seleccionada fue beta = 18; la línea discontinua marca el ajuste objetivo a la topología libre de escala de 0,85. (B) Dendrograma genético de enlace promedio con asignaciones dinámicas de colores por módulo. (C) Correlaciones de Pearson entre los eigengenes de los módulos y el rasgo binario de la UPM. Cada celda muestra el coeficiente de correlación y el valor p bilateral correspondiente; el color indica la dirección y magnitud. (D) Significancia génica para la UPM frente a la pertenencia al módulo en el módulo azul. Los puntos azules cumplen con |pertenencia al módulo| > 0,8 y |significancia génica| > 0,5; n = 689 genes centrales. (E) Intersección de tres conjuntos: 3.691 genes diferencialmente expresados (DEG), 689 genes centrales del módulo azul y 1.062 genes relacionados con la DPN, lo que da como resultado 77 candidatos compartidos. UPM, úlcera del pie diabético; DPN, neuropatía periférica diabética; GS, significancia génica; MM, pertenencia al módulo; WGCNA, análisis de red de coexpresión génica ponderada. La cohorte de descubrimiento incluyó 21 muestras (10 con UPM y 11 controles). La anotación de la Figura 2D utiliza |MM| > 0,8 y |GS| > 0,5, coincidiendo con el criterio de valor absoluto verificado en el código original de selección. Haga clic aquí para ver una versión ampliada de esta figura.
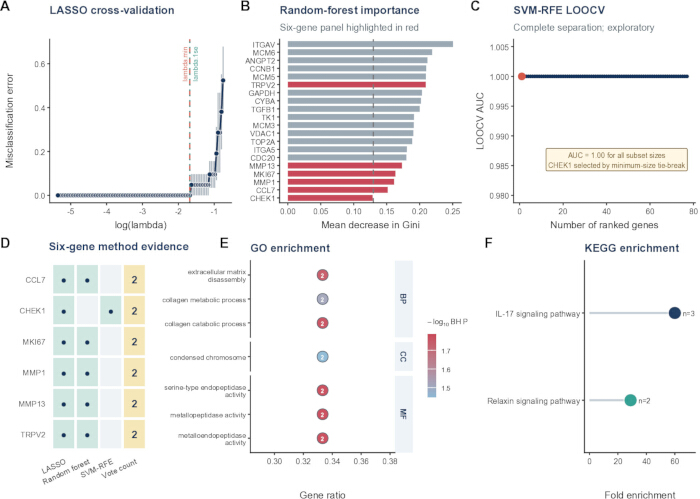
Figura 3: La priorización de características mediante múltiples métodos produce un panel de seis genes. (A) Curva de validación cruzada de cinco pliegues para regresión LASSO binomial. Las líneas verticales discontinuas indican lambda.min y lambda.1se; las características no nulas seleccionadas se tomaron en lambda.1se, a menos que esa penalización no produjera ninguna característica. (B) Disminución media del índice de Gini en el bosque aleatorio para los 20 genes con mayor clasificación en un modelo de 1.000 árboles. Las barras rojas identifican los miembros del panel final de seis genes; la línea discontinua marca la importancia media utilizada como umbral de retención en todo el conjunto de candidatos. (C) AUC de LOOCV mediante SVM-RFE lineal en subconjuntos anidados de características. Todos los tamaños de subconjunto produjeron AUC = 1,00; CHEK1 fue seleccionado por la regla del tamaño mínimo en caso de empate, lo que indica sobreajuste en la cohorte de descubrimiento. (D) Matriz de apoyo de métodos para CCL7, CHEK1, MKI67, MMP1, MMP13 y TRPV2. Los puntos indican selección por LASSO, bosque aleatorio o SVM-RFE; la última columna muestra el número de métodos que respaldan cada gen. (E) Términos seleccionados de Gene Ontology enriquecidos entre los seis genes. La posición de los puntos muestra la razón génica, las etiquetas indican el número de genes asignados, el color representa -log10 del valor p ajustado por BH y la franja lateral denota la ontología. (F) Vías de KEGG enriquecidas entre los genes asignados. La posición de los puntos muestra el enriquecimiento por factor, el tamaño de las etiquetas indica el número de genes asignados y el color distingue las vías. El enriquecimiento requirió un valor p nominal < 0,05 y un valor p ajustado por BH < 0,05. AUC, área bajo la curva característica de operación del receptor; BH, Benjamini-Hochberg; BP, proceso biológico; CC, componente celular; KEGG, Enciclopedia de Kioto de Genes y Genomas; LOOCV, validación cruzada dejando uno fuera; MF, función molecular; SVM-RFE, eliminación recursiva de características mediante máquina de vectores de soporte. LASSO, operador de contracción y selección por mínima absoluta. Los paneles A–D utilizan las 21 muestras de descubrimiento (10 úlceras del pie diabético y 11 controles). En el panel A, las barras de error indican el error estándar del error de validación cruzada. Haga clic aquí para ver una versión más grande de esta figura.
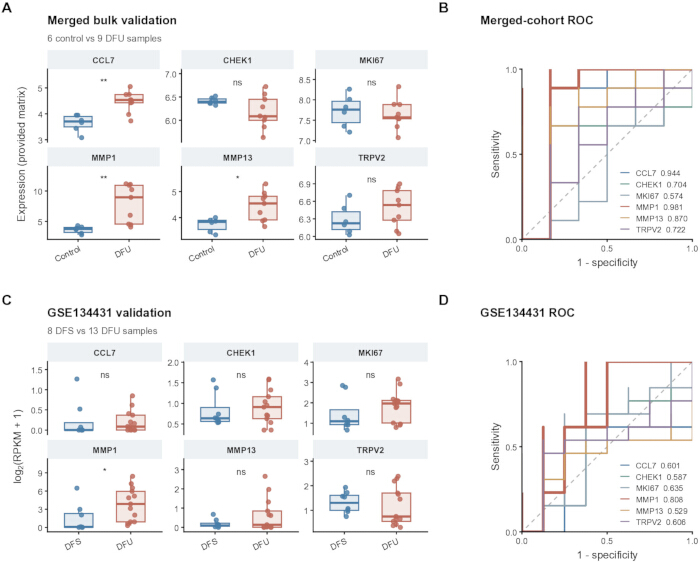
Figura 4: Evaluación transcriptómica masiva entre conjuntos de datos del panel de seis genes. (A) Expresión de los seis genes en la matriz combinada GSE68183/GSE80178 (6 controles y 9 muestras de UPM). (B) Curvas ROC individuales correspondientes con valores de AUC; los intervalos de confianza del 95 % se proporcionan en la tabla de datos fuente. Debido a que la combinación previa y la corrección por lotes no se documentaron completamente, estos resultados se interpretaron como exploratorios. (C) Expresión log2(RPKM + 1) en GSE134431 (8 muestras de PPD no ulceradas y 13 muestras de UPM). (D) Curvas ROC y valores de AUC correspondientes. En (A) y (C), los cuadros muestran la mediana y el rango intercuartílico, los bigotes se extienden hasta 1,5 veces el rango intercuartílico, y los puntos representan muestras biológicas. Los asteriscos indican significancia nominal según las pruebas de suma de rangos de Wilcoxon bilaterales (*p < 0,05, **p < 0,01); los valores de p ajustados por BH en los seis genes se reportan en el texto y en la tabla de datos fuente. La dirección ROC fue seleccionada automáticamente por pROC. AUC, área bajo la curva característica de operación del receptor; DFS, piel diabética del pie sin úlcera; DFU, úlcera del pie diabético; RPKM, lecturas por kilobase por millón de lecturas mapeadas; ROC, característica de operación del receptor. Haga clic aquí para ver una versión más grande de esta figura.
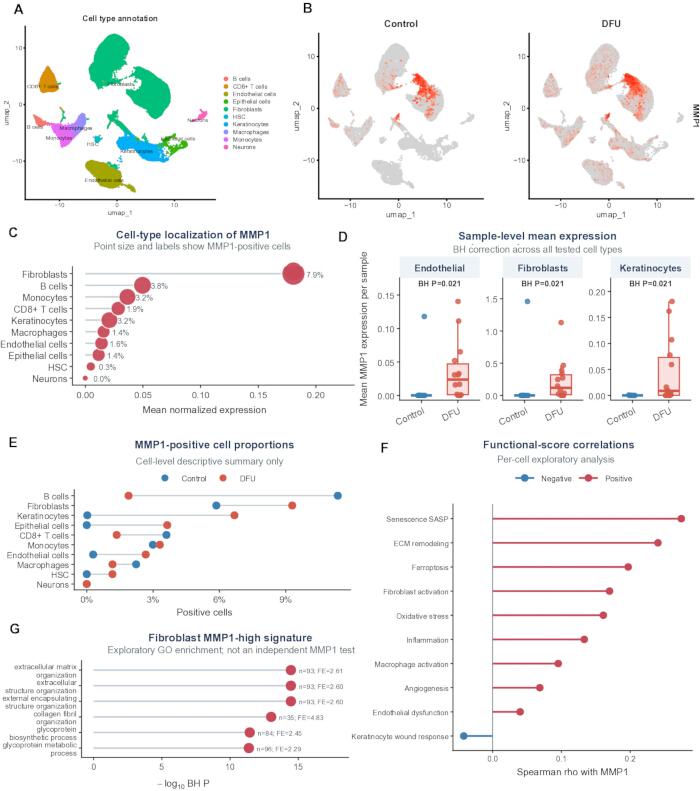
Figura 5: La localización a nivel de célula individual vincula MMP1 con señales de remodelación de fibroblastos y de la matriz. (A) UMAP de 69.944 células procedentes de 24 muestras (10 controles y 14 muestras de UPM) coloreadas según las 10 anotaciones de tipos celulares derivadas de SingleR. (B) Gráficos de características UMAP que muestran la expresión normalizada de MMP1 en células control y UPM. (C) Resumen por tipo celular de la expresión media normalizada de MMP1; el tamaño de los puntos y las etiquetas indican la fracción total de células positivas para MMP1, definida como expresión normalizada > 0. (D) Expresión media de MMP1 a nivel de muestra en células endoteliales, fibroblastos y queratinocitos. Los cuadros muestran la mediana y el rango intercuartílico; los puntos representan muestras biológicas. Se realizaron pruebas de suma de rangos de Wilcoxon bilaterales seguidas de corrección BH en todos los tipos celulares analizados. Los conteos de muestras disponibles fueron 10 controles y 14 UPM para células endoteliales y fibroblastos, y 9 controles y 14 UPM para queratinocitos. (E) Fracciones de células positivas para MMP1 según grupo y tipo celular. (F) Correlaciones de Spearman por célula entre la expresión de MMP1 y las puntuaciones de módulos funcionales. (G) Enriquecimiento en procesos biológicos de Gene Ontology (GO) entre los genes sobreexpresados en fibroblastos con alto nivel de MMP1 frente a fibroblastos con bajo nivel de MMP1. BH, Benjamini-Hochberg; UPM, úlcera del pie diabético; ECM, matriz extracelular; GO, Gene Ontology; HSC, células madre hematopoyéticas; UMAP, aproximación y proyección uniforme de variedades. Las correlaciones por célula y el enriquecimiento condicionado a la expresión en los paneles F y G son descripciones exploratorias, sin inferencia confirmatoria que considere el donante. Se requiere verificación de los identificadores de donante para establecer independencia a nivel de muestra. Haga clic aquí para ver una versión más grande de esta figura.
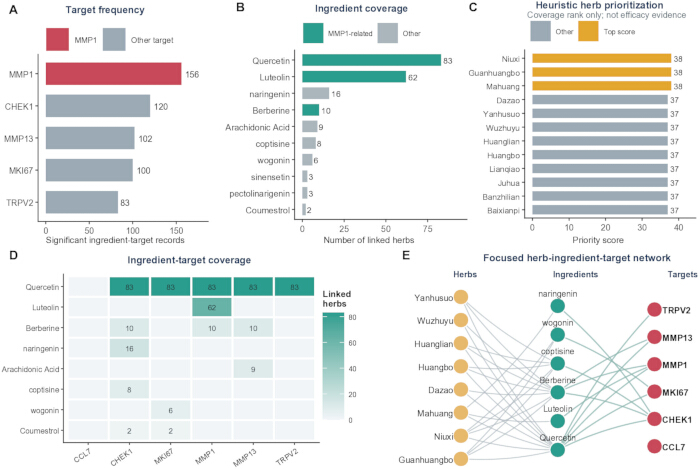
Figura 6: Predicción basada en cobertura de ingredientes, dianas y hierbas de la MTC centrada en MMP1. (A) Número de registros filtrados de hierbas, ingredientes y dianas del banco de datos para cada diana candidata disponible. (B) Número de hierbas vinculadas para los ingredientes más frecuentes; el tono verde azulado indica ingredientes asociados a MMP1. (C) Principales hierbas ordenadas según la puntuación de cobertura; las barras doradas indican las tres puntuaciones más altas compartidas. (D) Matriz de ingredientes-dianas para ingredientes representativos con alta cobertura. Los valores en las celdas muestran el número de hierbas vinculadas; las celdas vacías indican ausencia de registro en la tabla de relaciones filtradas. (E) Red enfocada que conecta hierbas, ingredientes y dianas candidatas representativas altamente clasificadas. El color de los nodos indica el tipo de entidad; las aristas grises entre hierbas e ingredientes indican contención, y las aristas verde azulado entre ingredientes y dianas indican vínculos en la base de datos. La tabla de relaciones filtradas contenía 561 registros únicos, 99 hierbas, 14 ingredientes y cinco dianas con vínculos válidos; CCL7 se muestra como un nodo candidato aislado adicional. MTC, medicina tradicional china. Haga clic aquí para ver una versión más grande de esta figura.
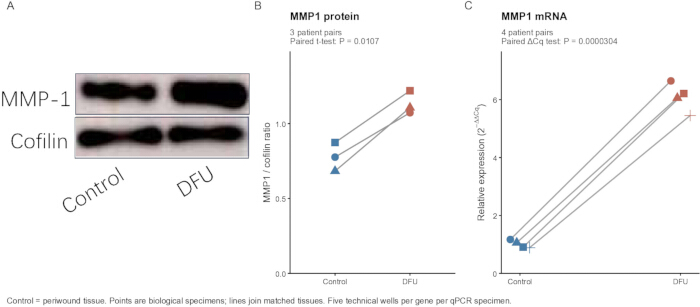
Figura 7: Evaluación preliminar mediante qPCR y western blot de la expresión de MMP1 en tejido de pacientes con UDM. (A) Western blot representativo previamente proporcionado que muestra la abundancia de la proteína MMP1 en tejido perilesional no ulcerado y en tejido de UDM, con cofilina como control de carga. (B) Proporciones de MMP1 respecto a cofilina recuperadas del proyecto original de graficación. Los símbolos indican mediciones biológicas individuales de tres pares de pacientes; las líneas unen especímenes perilesionales y de UDM emparejados. La prueba t pareada bilateral arrojó t(2) = 9,592 y p = 0,0107. (C) Abundancia relativa de ARNm de MMP1 en cuatro pares de pacientes emparejados confirmados por los autores: NC–UDM, NC1–UDM1, NC2–UDM2 y NC3–UDM3. Se promediaron por separado cinco pocillos técnicos de ACTB y cinco pocillos técnicos de MMP1 dentro de cada espécimen antes del cálculo de ΔCq. La expresión relativa se calculó mediante el método 2−ΔΔCq, utilizando el valor medio de ΔCq del tejido perilesional como calibrador común. Cada símbolo representa un espécimen biológico; las líneas conectan tejidos emparejados. La prueba t pareada bilateral utilizó valores de ΔCq a nivel de espécimen (t(3) = −41,663; p = 3,04 × 10⁻⁵), no cambios en la expresión promedio de los pocillos técnicos. No se utilizan asteriscos para indicar significancia. Los pocillos técnicos no son réplicas biológicas. Control denota tejido perilesional no ulcerado. Cq, ciclo de cuantificación. Los valores p del ensayo en tejido son nominales y exploratorios. Haga clic aquí para ver una versión más grande de esta figura.
| Gen | Acceso RefSeq | Primer directo de 5 prima a 3 prima | Primer inverso de 5 prima a 3 prima |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Tabla 1: Secuencias de cebadores para la validación mediante PCR cuantitativa de MMP1. Se indican las secuencias de oligonucleótidos directo e inverso (5′–3′) y los accesos de transcritos RefSeq de NCBI para MMP1 humano (NM_002421) y ACTB (NM_001101.5). ACTB (β-actina) se utilizó como gen de referencia para la expresión relativa de MMP1.
Figura suplementaria 1: Resúmenes del control de calidad de WGCNA. (A) Agrupamiento jerárquico por enlace promedio de las muestras de GSE199939 basado en los 5.000 genes con mayor variabilidad tras la transformación estabilizadora de la varianza. Las etiquetas de las muestras están coloreadas según el grupo; la línea horizontal discontinua indica la altura del dendrograma correspondiente al percentil 95, utilizada como guía para la evaluación visual de valores atípicos. (B) Número de genes asignados a cada módulo de WGCNA. Las barras turquesa indican los ocho módulos no grises que cumplen el criterio de asociación con la úlcera del pie diabético; las barras grises indican los demás módulos. DFU, úlcera del pie diabético; VST, transformación estabilizadora de la varianza; WGCNA, análisis de red de coexpresión génica ponderado. Haga clic aquí para descargar este archivo.
Figura suplementaria 2: Apoyo para la coexpresión del módulo azul. (A) Red simplificada de coexpresión de los 25 genes centrales del módulo azul con mayor clasificación. Entre las correlaciones por pares con |r| > 0,70, la red mostrada contiene la unión de los dos enlaces más fuertes de cada gen. El tamaño del nodo indica el grado dentro de esta red mostrada y simplificada, y el relleno del nodo indica la significancia del gen para la úlcera del pie diabético (DFU). (B) Significancia del gen y pertenencia al módulo azul para los 15 principales genes centrales. El subconjunto de enlaces se seleccionó para mejorar la legibilidad y no representa todas las correlaciones que cumplen los criterios. DFU, úlcera del pie diabético; GS, significancia del gen; MM, pertenencia al módulo. Haga clic aquí para descargar este archivo.
Figura suplementaria 3: Representaciones del aprendizaje automático en la cohorte de descubrimiento interna. (A) Expresión normalizada de CCL7, CHEK1, MKI67, MMP1, MMP13 y TRPV2 en la cohorte de descubrimiento GSE199939. Los cuadros muestran la mediana y el rango intercuartílico, y los puntos representan muestras biológicas. (B) Mapa de calor por filas con puntuaciones z a nivel de muestra para los mismos seis genes. Las etiquetas cortas de las muestras se corresponden con los identificadores GEO en la clave de datos fuente. (C) Curva ROC del modelo multigénico ajustado en la cohorte de descubrimiento. El valor de AUC de 1,00 se obtuvo ajustando y evaluando el modelo en las mismas 21 muestras, lo que indica sobreajuste en la cohorte de descubrimiento. AUC, área bajo la curva característica de operación del receptor; ROC, característica de operación del receptor. La cohorte de descubrimiento incluyó 21 muestras (10 úlceras del pie diabético y 11 controles). Haga clic aquí para descargar este archivo.
Figura suplementaria 4: Contexto de expresión a nivel de célula individual. (A) UMAP de 69.944 células coloreadas según el grupo control y el grupo DFU.BMedia a nivel de muestra biológica MMP1 expresión en todas las 10 anotaciones de tipos celulares; los puntos representan muestras, y el eje x utiliza una transformación de raíz cuadrada para su representación. (C) Mapa de calor de las puntuaciones de los módulos funcionales resumidas en las células de cada tipo celular anotado y estandarizadas dentro de cada módulo. DFU, úlcera del pie diabético; UMAP, aproximación y proyección uniforme de variedades. Haga clic aquí para descargar este archivo.
Figura suplementaria 5: Matrices de cobertura de la MTC que respaldan los resultados. (A) Recuentos de registros de hierbas y dianas en la base de datos para las 18 hierbas con mayor clasificación que presentan cobertura relacionada con MMP1 y las cinco dianas candidatas representadas en la tabla de relaciones filtrada. (B) Recuentos de registros en la base de datos que vinculan las mismas hierbas con los ingredientes principales quercetina, luteolina y berberina. Los valores en las celdas indican registros únicos de la base de datos tras la eliminación de duplicados. MTC, medicina tradicional china. Haga clic aquí para descargar este archivo.
Figura suplementaria 6: Flujo de trabajo computacional y evaluación de tejidos. El esquema resume la entrada de descubrimiento, la intersección DEG/WGCNA, la selección exploratoria de características, la evaluación externa en masa, el contexto de célula única, la extensión TCM y la evaluación de expresión en tejidos emparejados. La qPCR utilizó cuatro pares de pacientes emparejados y el inmunotransferencia se realizó con tres pares de pacientes emparejados. Las cantidades de candidatos y los resultados computacionales informados se conservan del análisis original. La entrada de TPM en el flujo de trabajo de descubrimiento basado en conteo, los registros incompletos de preprocesamiento originales de célula única y los pequeños cohortes para los ensayos de tejido siguen siendo limitaciones. El esquema no implica que los análisis de descubrimiento hayan sido revalidados. Haga clic aquí para descargar este archivo.
Tabla suplementaria 1: Inventario de software de análisis, bases de datos, parámetros y limitaciones. Este libro de trabajo documenta 26 pasos de análisis, con el paso de análisis, herramienta o base de datos, versión reportada, entrada, parámetros principales, salida e información faltante o limitaciones. Cubre transcriptómica de descubrimiento, WGCNA, selección de genes y selección de características, enriquecimiento, análisis externos de tipo masivo y de célula individual, análisis de red de medicina tradicional china y reporte de ensayos tisulares. La tabla registra la información metodológica disponible y no establece por sí misma una reproducibilidad independiente. Haga clic aquí para descargar este archivo.
Archivo suplementario 1: Archivo de datos, código de análisis, fuentes de figuras y fuentes de ensayos. Este archivo contiene los scripts disponibles de análisis y generación de figuras, tablas de expresión y resultados procesados, figuras cuantitativas y datos fuente estadísticos, el libro de trabajo original de qPCR y el proyecto del instrumento, las imágenes completas sin recortar de los inmunoensayos tipo western blot proporcionadas, los metadatos y el historial de comandos de célula individual extraídos, informes de verificación en formato matricial y un manifiesto de archivos. Se han conservado los archivos históricos; la carpeta R2_Updates proporciona el análisis corregido de ensayos pareados, las fuentes actualizadas de las figuras y el inventario revisado de parámetros. Haga clic aquí para descargar este archivo.
Discusión
Este flujo de trabajo integrador priorizó MMP1 a partir de la transcriptómica masiva, el análisis WGCNA, la selección de genes relacionados con DPN y la selección exploratoria de características, y luego examinó su contexto celular y expresión tisular. Seis genes fueron respaldados por al menos dos métodos de selección, y MMP1 mostró el mayor cambio de expresión en la cohorte de descubrimiento. La evidencia externa fue heterogénea: MMP1 permaneció significativo en la matriz combinada GSE68183/GSE80178, mientras que su asociación en GSE134431 fue nominal (p = 0,0225) y no sobrevivió a la corrección de BH (ajustado p = 0,135). El AUC de 0,808 en GSE134431 es descriptivo, particularmente porque la dirección de la curva ROC se seleccionó dentro del conjunto de datos de evaluación. Por lo tanto, «más consistente» describe el patrón observado entre los seis candidatos y no implica una réplica estadística completa ni un biomarcador diagnóstico validado.
El panel de candidatos se anotó en relación con el recambio del colágeno, la descomposición de la matriz extracelular (ECM), la actividad de metaloendopeptidasas y la señalización de IL-17 y relaxina. Estas anotaciones son compatibles con la biología de heridas crónicas, pero solo implican unos pocos genes. Estudios previos en humanos informaron perfiles alterados de MMP e inhibidores en heridas diabéticas6, mientras que un estudio prospectivo sobre úlceras del pie diabético (DFU) asoció una mayor relación entre MMP1 e inhibidor tisular de metaloproteinasas 1 (TIMP1) con la cicatrización7. Por lo tanto, un aumento en la expresión de MMP1 no necesariamente indica un efecto perjudicial uniforme; su relevancia puede depender de la etapa de reparación, la disponibilidad de sustratos y el equilibrio de inhibidores. Observaciones experimentales sobre MMP13, CCL7 e IL-17 proporcionan contexto adicional11,12,13,14, pero no se puede asumir que sus funciones sean equivalentes en las DFU humanas.
Los resúmenes a nivel de célula individual localizaron la expresión media más alta de MMP1 en fibroblastos, con una expresión a nivel de muestra mayor en fibroblastos de UPM, queratinocitos y células endoteliales. Este patrón concuerda con informes sobre la organización alterada de la MEC en fibroblastos derivados de UPM4, estados heterogéneos de fibroblastos en estudios espaciales y a nivel de célula individual8, y programas de fibroblastos asociados a curación mediados por macrófagos15. Sin embargo, los identificadores de muestras requieren verificación a nivel del donante, y las correlaciones entre puntajes modulares a nivel celular y el enriquecimiento condicionado por la expresión siguen siendo descriptivos porque no se modeló la dependencia dentro del donante. Las contribuciones de poblaciones epiteliales y endoteliales también argumentan en contra de un mecanismo exclusivamente autónomo en los fibroblastos. La transcriptómica espacial, la hibridación in situ de ARN o la inmunotinción ofrecerían una localización complementaria16.
El valor metodológico radica en combinar la expresión diferencial, la coexpresión, el conocimiento previo de genes, resúmenes resueltos por célula y modalidades de ensayo independientes para priorizar candidatos. No radica en la precisión predictiva del cohorte de descubrimiento. El cribado a nivel del cohorte precedió a la validación cruzada a nivel del algoritmo, y el AUC uniforme de SVM-RFE de 1,00 plantea preocupaciones sobre fugas, sobreajuste y evaluación optimista. Por lo tanto, el panel debe permanecer como un resultado de priorización de características. Sería necesario un preprocesamiento, selección y ajuste completamente anidados, seguido de una prueba independiente bloqueada, para una evaluación predictiva9,10. La entrada del descubrimiento fue verificada como TPM a pesar de su uso en un modelo basado en conteos; por lo tanto, las estadísticas de descubrimiento resultantes y la selección posterior permanecen sin verificar hasta un reanálisis adecuado. La matriz combinada de muestras no presenta su historial completo de preprocesamiento. El objeto Seurat recuperado proporciona normalización, selección de características variables, PCA, vecinos, agrupamiento y configuraciones de UMAP, aunque su filtrado original, la llamada completa a Harmony y la referencia de anotación permanecen documentadas de forma incompleta. El reprocesamiento armonizado a partir de los datos originales, la evaluación documentada del efecto de lote y los análisis de pseudobulk o modelos mixtos con consideración del donante son enfoques alternativos para una evaluación adicional.
Los ensayos con tejido de pacientes proporcionan evidencia preliminar y ortogonal de una mayor abundancia de MMP1. El comparador fue tejido perilesional no ulcerado de los mismos pacientes, por lo que el contraste refleja diferencias locales asociadas a la úlcera dentro del tejido diabético, y no una comparación con piel sana. Las mediciones de WB recuperadas de tres pares de pacientes emparejados y las mediciones de qPCR de cuatro pares emparejados confirmados por los autores se analizaron mediante pruebas pareadas, mostrándose las observaciones biológicas individuales. Para la qPCR, los pocillos técnicos se promediaron dentro de cada espécimen y se utilizó ΔCq para la inferencia; los pocillos técnicos no aumentaron el tamaño de la muestra biológica. La dirección consistente de las observaciones pareadas respalda una comparación preliminar de expresión, pero las cohortes pequeñas no permiten establecer generalizabilidad ni evaluar de forma confiable los supuestos distribucionales. La abundancia en tejido total no establece la localización celular de la proteína, la actividad enzimática ni un efecto causal sobre la cicatrización. Se necesitan cohortes más grandes y mejor caracterizadas clínicamente. Otras limitaciones incluyen covariables clínicas incompletas, tejidos comparadores distintos, un conjunto de genes de NPD derivado de la literatura y documentado de forma incompleta, y registros incompletos de sustracción del fondo original en las transferencias. No deben considerarse como intercambiables el tejido sano, el tejido control definido por el estudio y la piel diabética no ulcerada del pie.
La red de MTC es una extensión generadora de hipótesis. Sus pesos personalizados resumen la cobertura de la base de datos en lugar de la interacción con el blanco o la eficacia, y los rankings pueden cambiar según el contenido de la base de datos y las elecciones de pesos. La exposición sistémica de la quercetina y la berberina también es variable o limitada17,18. Por lo tanto, los ingredientes y hierbas candidatos requieren pruebas directas de interacción con el blanco, respuesta a la dosis, farmacocinética, toxicidad y pruebas funcionales. Los trabajos futuros deberían combinar cohortes independientes bien documentadas con localización espacial y perturbación de MMP1 en fibroblastos primarios o modelos multicelulares de heridas. Los hallazgos actuales respaldan a MMP1 como un candidato asociado a UDM en un contexto de remodelación de la matriz centrado en el fibroblasto, sin establecer causalidad ni utilidad clínica.
Divulgaciones
Los autores declaran que no tienen conflictos de interés.
Agradecimientos
Esta investigación fue respaldada por el Proyecto Municipal de Investigación Científica Médica de Wuhan (Proyecto de Orientación, número de subvención WX23Z77), administrado por la Comisión Municipal de Salud de Wuhan.
Los autores agradecen a los participantes que proporcionaron muestras de tejido para este estudio y a los investigadores que generaron y depositaron los conjuntos de datos de acceso público en el NCBI Gene Expression Omnibus.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Tiras de tubos PCR transparentes de pared delgada de 0,2 mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Puntas estériles de pipeta con filtro de 1.000 μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Tubos microcentrífugos estériles de 1,5 mL, libres de DNasa/RNasa | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| Puntas estériles de pipeta con filtro de 10 μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| Mezcla maestra PCR SYBR Green 2× | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| Solución salina tamponada con Tris 20× | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| Puntas estériles de pipeta con filtro de 200 μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Par de cebadores qPCR para ACTB | Solarbio Life Sciences (síntesis personalizada de oligonucleótidos) | Personalizado | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Suecia | Amersham Imager 600 | Modelo registrado en los 22 archivos TIFF proporcionados; software de operación Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Kit de ensayo de proteína por ácido bicinconínico | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Versión 4.16.0 |
| Anticuerpo policlonal contra Cofilina (conejo anti-Cofilina) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | Dilución para WB utilizada en este estudio: 1:6.000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Base de datos Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Recurso de ingredientes-dianas |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Versión 1.48.2 |
| Agua libre de DNasa/RNasa | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / autores de e1071 | https://cran.r-project.org/package=e1071 | Versión 1.7-17 |
| Sustrato quimioluminiscente ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | Centro Nacional de Información Biotecnológica | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | Centro Nacional de Información Biotecnológica | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | Centro Nacional de Información Biotecnológica | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | Centro Nacional de Información Biotecnológica | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | Centro Nacional de Información Biotecnológica | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Consortium de Gene Ontology | https://geneontology.org/ | GO |
| ggplot2 | Desarrolladores de ggplot2 | https://ggplot2.tidyverse.org/ | Versión 4.0.3 |
| glmnet | CRAN / autores de glmnet | https://cran.r-project.org/package=glmnet | Versión 5.0 |
| Tabla de referencia de hierbas-ingrediente | Fuente no reportada en el manuscrito | No reportado | No documentado: nombre exacto de la base de datos/archivo, versión/fecha y URL de acceso público |
| Anticuerpo secundario conjugado con HRP, cabra anti-IgG de conejo (H+L) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | Dilución para WB utilizada en este estudio: 1:5.000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Espécimenes de tejido de úlcera del pie diabético humano | Hospital Cuarto de Wuhan, Wuhan, China | N/A | Espécimenes de DFU emparejados por paciente; qPCR n=4 espécimenes; WB n=3 espécimenes; protocolo aprobado KY2024-161-01 |
| Espécimenes de tejido perilesional no ulcerado humano | Hospital Cuarto de Wuhan, Wuhan, China | N/A | Comparador perilesional emparejado por paciente; qPCR n=4 espécimenes; WB n=3 espécimenes; protocolo aprobado KY2024-161-01 |
| ImageJ | Institutos Nacionales de Salud | https://imagej.net/ij/ | Versión no documentada |
| Enciclopedia de Kyoto de Genes y Genomas | KEGG | https://www.genome.jp/kegg/ | Código del organismo humano hsa |
| Lista de genes DPN curada a partir de la literatura | Componente derivado de la literatura; tabla fuente a nivel de genes no completamente documentada | No reportado | Procedencia a nivel de genes no completamente documentada |
| Espectrofotómetro UV-visible de microvolumen | Fabricante/modelo no reportado en el manuscrito | No reportado | No documentado: fabricante exacto, modelo y URL del producto; uso reportado: concentración de ARN y evaluación de A260/A280 |
| Anticuerpo policlonal contra MMP1 (conejo anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | Dilución para WB utilizada en este estudio: 1:1.000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| Par de cebadores qPCR para MMP1 | Solarbio Life Sciences (síntesis personalizada de oligonucleótidos) | Personalizado | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | Centro Nacional de Información Biotecnológica | https://www.ncbi.nlm.nih.gov/gene/ | Base de datos de genes humanos |
| Leche en polvo descremada, reactivo bloqueante | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Versión 3.21.0 |
| Gel SDS-PAGE precolado, gradiente 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / autores de pROC | https://cran.r-project.org/package=pROC | Versión 1.19.0.1 |
| Mezcla de inhibidores de proteasas, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Sistema de transferencia de proteínas | Fabricante/modelo no reportado en el manuscrito | No reportado | No documentado: fabricante exacto, modelo y URL del producto; uso reportado: transferencia a membrana PVDF de 0,22 μm |
| Membrana PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | Foundation R para Computación Estadística | https://www.r-project.org/ | Versión 4.5.2 |
| randomForest | CRAN / autores de randomForest | https://cran.r-project.org/package=randomForest | Versión 4.7-1.2 |
| Instrumento de PCR en tiempo real | Roche Diagnostics | LightCycler 96 | versión del software no confirmada. El volumen del proyecto/ciclos difiere del protocolo reportado; el enlace exacto con el experimento aún debe verificarse. |
| Microcentrífuga refrigerada | Fabricante/modelo no reportado en el manuscrito | No reportado | No documentado: fabricante exacto, modelo y URL del producto; uso reportado: 12.000 × g durante 15 min a 4 °C |
| rentrez | CRAN / autores de rentrez | https://cran.r-project.org/package=rentrez | Versión 1.2.4 |
| Tampón de lisis RIPA, alta concentración | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| Sistema de electroforesis SDS-PAGE | Fabricante/modelo no reportado en el manuscrito | No reportado | No documentado: fabricante exacto, modelo y URL del producto; uso reportado: separación de proteínas en geles de gradiente 4%–20% |
| Seurat | Satija Lab / desarrolladores de Seurat | https://satijalab.org/seurat/ | Versión 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Versión 2.10.0 |
| Homogeneizador de tejidos | Fabricante/modelo no reportado en el manuscrito | No reportado | No documentado: fabricante exacto, modelo y URL del producto; uso reportado: homogeneización de tejidos en tampón de lisis frío |
| Reactivo TriQuick para extracción de ARN total | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Tapas planas ultraclaras para tiras de tubos PCR de 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Kit RT-PCR universal (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / autores de WGCNA | https://cran.r-project.org/package=WGCNA | Versión 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Referencias
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.