En réponse à la fragmentation des textes juridiques et aux problèmes de traçage des biais dans l'intelligence artificielle (IA) médicale, cette étude construit un graphe de connaissances juridiques et utilise une convolution de graphe tenant compte des relations pour l'alignement sémantique. Elle identifie les sources de biais au moyen d'une rétropropagation basée sur le gradient, avec des métriques expérimentales favorables appuyant une application médicale d'IA conforme.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Construction de graphes de connaissances juridiques et traçage des biais dans l'intelligence artificielle médicale basés sur les réseaux de neurones graphiques
Dans cet article
Résumé
Résumé
Dans l'analyse de la conformité juridique en intelligence artificielle (IA) médicale, cet article aborde l'ambiguïté dans la détermination de la responsabilité, causée par la fragmentation sémantique de textes juridiques hétérogènes provenant de multiples sources et par les difficultés à tracer les biais algorithmiques. Il propose une méthode de construction de graphe de connaissances et de détection des chemins de propagation des biais fondée sur des réseaux neuronaux graphiques. Quatre types de nœuds hétérogènes — clauses juridiques, comportements médicaux, modules algorithmiques et parties responsables — sont structurés et encodés, et un graphe orienté est construit à partir de quatre types de relations sémantiques juridiques : « violation », « base », « déclenchement » et « attribution ». Ensuite, un réseau de convolution sur graphe sensible aux relations, combinant des poids spécifiques à chaque type d'arête et un mécanisme d'attention, est utilisé afin d'assurer un alignement multi-niveau des caractéristiques pour les sémantiques juridiques inter-modales. Puis, une rétropropagation basée sur le gradient permet d'identifier les arêtes contribuant significativement aux biais, de construire un sous-graphe de propagation des biais et de localiser les grappes de nœuds racines par détection de communautés. Enfin, les flux de décision en temps réel sont mappés sur des nœuds temporaires, la conformité est vérifiée par similarité d'incorporation (embedding), et la dynamique des poids des arêtes clés est surveillée afin de détecter l'accumulation systémique de biais. Les expériences montrent que, en termes de précision d'alignement sémantique, la méthode proposée atteint une précision moyenne d'alignement des entités d'au moins 0,92 et un taux moyen de préservation complet des relations d'au moins 0,88, et ce, sur différents gradients de densité de graphe de connaissances. En ce qui concerne la capacité de localisation des biais, le taux de rappel des nœuds racines atteint 0,95±±0,02, et la précision du chemin de propagation atteint 0,93±±0,03. Cette recherche parvient, dans une certaine mesure, à coupler profondément la logique juridique et le comportement algorithmique, offrant ainsi un système d'appui à la conformité explicite et vérifiable pour un déploiement fiable de l'IA médicale.
Introduction
L'implication profonde de l'IA médicale dans le diagnostic, l'aide au traitement, l'allocation des ressources et l'évaluation des risques a lié sa prise de décision à l'attribution de responsabilités juridiques1,2. Les normes juridiques sont fortement structurées mais sémantiquement distribuées, tandis que le comportement des systèmes d'IA peut être opaque, sans interface sémantiquement alignable et traçable entre les deux3. Dans ce contexte, le développement d'un cadre de représentation commun permettant de capturer les chaînes causales juridiques au sein des séquences comportementales algorithmiques s'est imposé comme un prérequis indispensable pour assurer une attribution fine des responsabilités et une conformité dynamique4,5. Cette étude ne concerne pas seulement les tests juridiques des systèmes technologiques, mais implique également le maintien approfondi de l'équité médicale, de l'équité algorithmique et de la confiance institutionnelle, revêtant ainsi une grande importance théorique et une urgence pratique.
Le problème fondamental de l'analyse de conformité juridique de l'IA médicale aujourd'hui réside dans l'absence de structure connective calculable entre la sémantique juridique et le comportement algorithmique6,7. Les documents juridiques sont disponibles sous forme de texte brut, et les relations entre les paragraphes s'entrecroisent de dépendances, de conflits et d'exceptions, ce qui pose des difficultés lorsqu'il s'agit de les diviser en unités logiques interprétables par des machines8,9. Bien que le processus de prise de décision du système d'IA soit encapsulé dans une boîte noire pilotée par les données, aucune des variations de ses sorties ne peut être reliée à des violations spécifiques des obligations juridiques ou à des nœuds permettant l'imputation de responsabilité10,11. Une telle disconnexion (par exemple, les biais dans les données d'entraînement, les défauts de conception du modèle ou l'interprétation sémantique des normes juridiques) ne peut être isolée expérimentalement afin d'identifier l'origine du biais ou de clarifier les obligations juridiques incombant aux développeurs, aux déploieurs ou aux utilisateurs12,13. Plus problématique encore, les procédures de conformité existantes ne vérifient que si une sortie finale satisfait à une spécification fixe, sans tenir compte du chemin de propagation ou de l'amplification du biais au sein du réseau d'interactions « droit-technologie »14,15. Lorsque l'IA médicale est soumise simultanément à plusieurs dispositions juridiques, et que le système produit une chaîne d'erreurs due à une mauvaise interprétation d'une clause, les approches conventionnelles sont incapables de suivre la manière dont l'erreur se diffuse à travers d'autres dispositions connexes avant d'aboutir à une responsabilité16,17. En outre, il manque un mécanisme de corrélation dynamique entre le flux de décisions en temps réel et le graphe de connaissances juridiques existant, ce qui entraîne un retard dans l'évaluation de la conformité pendant le fonctionnement du système, empêchant ainsi une surveillance proactive de l'accumulation progressive des biais18,19. Ces problèmes combinés entraînent une incertitude dans la détermination de la responsabilité, une imputation fragile et une intervention réglementaire tardive, ce qui freine fortement le déploiement fiable des systèmes d'IA à haut risque dans le domaine de la santé ainsi que l'application de la responsabilité juridique.
Avant tout, les études traditionnelles de recherche analysent les textes juridiques sous une forme structurée et construisent des bases de connaissances dans des domaines spécifiques à l’aide d’ontologies ou de règles, afin de soutenir les questions et réponses relatives à la conformité ou à la notification des risques20,21. Bien que ces approches puissent capturer certaines représentations de concepts juridiques, elles supposent généralement que la logique interne du droit est cohérente et statique, ce qui rend difficile la gestion des incohérences entre les juridictions, des exceptions ou des formulations imprécises. Des travaux ultérieurs ont introduit des technologies de traitement du langage naturel, utilisant des modèles linguistiques pré-entraînés pour extraire des entités et des relations juridiques, améliorant ainsi la couverture de l’extraction des connaissances22,23, mais restent toutefois à un niveau sémantique superficiel, sans parvenir à établir une interface de correspondance entre les comportements juridiques et techniques. En ce qui concerne la gouvernance des biais algorithmiques, les recherches se sont principalement concentrées sur la conception de contraintes d’équité24,25, dont les indicateurs d’évaluation reposent généralement sur des variables démographiques, sans alignement avec les principes d’attribution juridique. Même si certaines études ont tenté de coder des règles juridiques sous forme de contraintes et de les intégrer dans l’entraînement des modèles26,27, en raison de la rigidité et de la granularité grossière de l’expression des règles, celles-ci peinent à s’adapter à des situations cliniques complexes. De manière générale, les travaux existants considèrent la conformité juridique comme une tâche de vérification externe plutôt que comme un attribut intrinsèquement calculable de l’architecture du système. Cela conduit à une exécution parallèle de la logique juridique et de la logique algorithmique, sans permettre un raisonnement conjoint ni une intervention dynamique sur les voies de propagation des biais.
Ces dernières années, les réseaux neuronaux graphiques ont progressivement été introduits dans le domaine médical en raison de leurs capacités explicites de modélisation des structures relationnelles28,29. Certaines études utilisent des graphes hétérogènes pour intégrer la jurisprudence, les dispositions légales et les informations sur les parties, en appuyant les recommandations de décisions ou les prévisions de peines par le biais d'incorporations de nœuds30,31, confirmant ainsi l'efficacité des structures de graphes à capturer les liens juridiques. D'autres travaux modélisent les composants algorithmiques comme des nœuds de graphe, utilisant des arêtes pour représenter les flux de données ou les relations d'appel afin de suivre la propagation des erreurs32,33. Ces recherches montrent que les structures de graphe peuvent servir de support commun aux éléments juridiques et technologiques. Toutefois, les modèles de graphe existants souffrent généralement de trois limites : premièrement, ils se limitent à un seul type de relation d'arête, sans distinguer les différences sémantiques juridiques entre relations normatives, causales et d'attribution ; deuxièmement, le processus d'agrégation des caractéristiques ignore les poids sémantiques des types d'arêtes, ce qui conduit à traiter de façon équivalente différents chemins de logique juridique ; troisièmement, ils manquent d'un mécanisme différentiable de suivi de la propagation des biais, rendant impossible l'identification des arêtes à forte contribution et la reconstruction des chemins de responsabilité. Cet article propose un réseau de convolution graphique sensible aux relations, qui résout le problème de la fusion d'hétérogénéité sémantique en attribuant une matrice de transformation dédiée à chaque type de relation sémantique juridique et en introduisant un mécanisme d'attention permettant d'ajuster dynamiquement le flux d'information entre types. En outre, en combinant la rétropropagation des gradients et l'extraction de sous-graphes, il permet un passage interprétable du jugement de conformité à l'échelle macroscopique au traçage des biais à l'échelle microscopique, surmontant ainsi l'obstacle des modèles de graphe traditionnels qui ne permettent qu'un raisonnement statique.
Au-delà du domaine médical, les récents progrès réalisés dans les méthodes évolutives et basées sur les graphes ont démontré une applicabilité étendue au traitement des connaissances structurées. Par exemple, Xue et al. ont proposé une approche hybride multilayer de programmation génétique pour la construction adaptative de caractéristiques de similarité dans l'appariement d'ontologies, permettant un alignement robuste entre des graphes de connaissances hétérogènes34. Cheng et al. ont fourni une analyse complète des applications des réseaux de convolution sur graphes en restauration d'images, en catégorisant systématiquement les méthodes de débruitage, de super-résolution et de suppression de flou35. Li et al. ont présenté une revue approfondie de l'apprentissage profond évolutif dans la perspective de l'apprentissage automatique automatisé, couvrant les principes, algorithmes, applications et défis ouverts36. Ma et al. ont développé un cadre de recherche d'architecture neuronale floue pour la reconnaissance de défauts en situation d'incertitude, démontrant l'efficacité de la recherche évolutionnaire pour traiter des données ambiguës37. Ces études mettent en évidence le potentiel de l'intégration des représentations structurées en graphes et de l'optimisation évolutionnaire pour des tâches complexes de prise de décision.
L'objectif principal de cet article est d'établir un cadre entièrement interprétable pour l'analyse de la conformité juridique de l'intelligence artificielle (IA) médicale, avec des innovations à trois niveaux. Au niveau de la représentation des connaissances, il s'agit de la première approche à modéliser les clauses juridiques, les pratiques médicales, les modules d'algorithmes et les parties responsables comme quatre types de nœuds hétérogènes. En se fondant sur la pratique juridique, elle extrait quatre types de relations orientées : « violation », « base », « déclenchement » et « attribution », permettant ainsi de construire un graphe de connaissances orienté intégrant une logique causale juridique, fournissant une base sémantique structurée pour l'analyse de conformité. Au niveau du traçage des sources de biais, elle propose une méthode de quantification de la contribution des arêtes fondée sur la sensibilité aux gradients. Par rétropropagation, elle identifie l'ensemble des arêtes maximisant le biais en sortie, puis applique un algorithme de découverte de communautés afin de regrouper les nœuds à forte contribution, transformant ainsi le « biais boîte noire » en « clusters de responsabilité boîte blanche », ce qui permet une imputation fondée sur une chaîne de preuves exploitable. Au niveau de la surveillance dynamique en temps réel, elle développe un mécanisme d'encodage temporel des décisions et des nœuds, qui projette les sorties en temps réel de l'IA dans l'espace du graphe de connaissances. En comparant la proximité des encodages, elle quantifie le degré d'écart par rapport aux normes et surveille l'évolution du poids des arêtes essentielles de type juridique-technique, permettant ainsi de détecter l'accumulation de biais systémiques. Ce paradigme résout à la fois les problèmes de fragmentation sémantique et de traçabilité, et transforme la conformité juridique d'une vérification a posteriori en une gouvernance a priori, offrant une voie technique évolutive pour assurer la transparence de la responsabilité dans les systèmes d'IA à haut risque.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Construction d'un réseau neuronal graphique pour un graphe de connaissances juridiques en intelligence artificielle médicale
Comme illustré dans la Figure 1, le cadre proposé comprend trois modules principaux. La couche d'entrée intègre des données provenant de multiples sources dans un graphe hétérogène grâce à un encodage d'entités multimodal et une modélisation d'arêtes orientées. La couche GCN sensible aux relations effectue ensuite un alignement sémantique intermodal à l'aide de poids et d'attention spécifiques aux types, produisant des intégrations nodales unifiées. Enfin, ces intégrations permettent le traçage des biais (par rétropropagation du gradient et détection de communautés) et la surveillance dynamique de la conformité (par mappage en temps réel des nœuds et suivi des poids des arêtes), la sortie fournissant des preuves d'attribution interprétables et des alertes de risque destinées aux régulateurs.
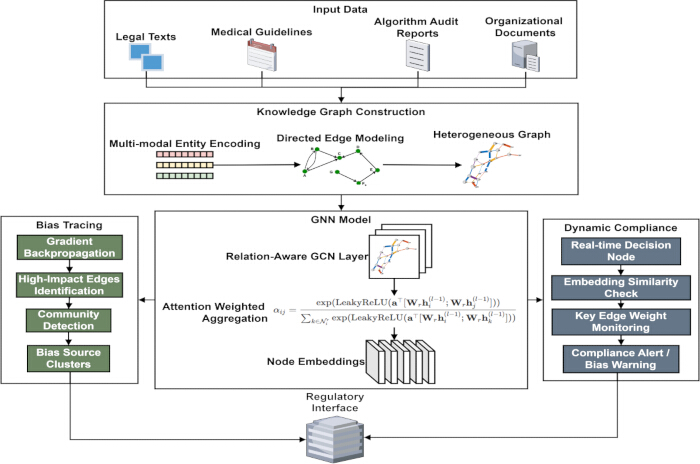
Figure 1 : Graphe de connaissances juridiques et architecture de traçage des biais pour l'IA médicale. Ce schéma illustre le flux opérationnel global du cadre proposé. La couche d'entrée fusionne des données hétérogènes provenant de multiples sources (textes juridiques, lignes directrices cliniques, rapports d'audit d'algorithmes), qui sont encodées en quatre types d'entités (dispositions juridiques, comportements médicaux, modules d'algorithmes, parties responsables) et reliées par quatre relations juridico-sémantiques orientées (violation, fondement, déclenchement, attribution). La couche GCN sensible aux relations effectue un alignement sémantique intermodal à l'aide de poids et d'attention spécifiques aux types. Le module de traçage des biais utilise la rétropropagation du gradient pour identifier les arêtes à forte contribution, puis applique une détection de communautés afin de localiser les groupes de nœuds racines. Le moniteur dynamique de conformité associe les décisions en temps réel à des nœuds temporaires, évalue la similarité des plongements par rapport aux dispositions juridiques et suit l'évolution des poids des arêtes pour une alerte précoce. Les sorties comprennent des preuves d'attribution interprétables et des alertes de risque. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Codage structuré de graphes hétérogènes d'entités juridiques et de relations
Quatre entités fondamentales sont systématiquement extraites des lois réglementaires sur l'intelligence artificielle médicale, des lignes directrices de pratique clinique et des rapports d'audit d'algorithmes : les clauses juridiques, les procédures médicales, les modules d'algorithme et les entités responsables. Un modèle distinct d'apprentissage de représentation de caractéristiques est proposé pour chaque type d'entité afin qu'il soit sémantiquement distinguable. Les nœuds correspondant aux clauses juridiques sont organisés de manière à contenir le numéro de la clause juridique, utilisé comme identifiant (ID) unique pour cette clause. Parallèlement, un indice de quantification de la gravité de la sanction est défini afin d'indiquer le niveau de responsabilité juridique associé à la clause, et par conséquent, un vecteur de caractéristiques est établi.
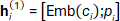 (1)
ci est le numéro d'entrée, Emb(·) représente l'application de plongement en basse dimension, et [·;·] représente l'opération de concaténation vectorielle. Cette représentation préserve à la fois la structure formelle et la gravité de la sanction du texte juridique, ce qui permet un raisonnement transversal entre énoncés.
Les nœuds de comportement médical sont normalisés et codés selon un système de classification des opérations cliniques, extrayant leur niveau de risque rj ∈ {1,2,3} et l'ensemble des étiquettes de scénario applicables sj ⊂ S, où S est l'ensemble complet des catégories de scénario prédéfinies. Un encodage multi-hot est utilisé pour traiter l'ensemble des étiquettes, puis est concaténé à l'intégration du niveau de risque afin de former une représentation initiale :
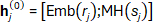 (2)
Cette stratégie garantit que différents types de comportements médicaux présentent des relations de distance mesurables dans l'espace vectoriel, permettant des comparaisons inter-scénarios. La fonction d'incorporation de texte Emb(·) est mise en œuvre à l'aide du modèle linguistique juridique chinois pré-entraîné Lawformer (pré-entraîné sur un vaste corpus juridique chinois), la dimension de sortie étant fixée à 768.
En se basant sur les dépendances logiques et les contraintes juridiques entre les entités, quatre types de relations sémantiques orientées sont établies : « violation », « base », « déclenchement » et « attribution », chacune correspondant à différents schémas causaux juridiques. Chaque arête eij ⊂ E se voit attribuer un type d'étiquette tij ⊂ T = {violate, base, trigger, attribute} afin de permettre la transmission de messages ultérieurs assurant la prise en compte des relations. La construction des arêtes suit strictement le mécanisme d'appariement selon les règles du domaine : lorsqu'un comportement médical s'écarte des exigences normatives, une arête de type « violation » est établie, orientée du nœud du comportement vers la clause juridique pertinente ; lorsque la clause juridique constitue la base normative justifiant une opération, une arête de type « base » est créée ; si la sortie du module d'algorithme déclenche directement l'exécution d'un comportement médical spécifique, une arête de type « déclenchement » est reliée ; la relation d'attribution de responsabilité est établie à partir des documents de responsabilité organisationnelle et des conclusions d'audit, en créant une arête de type « attribution » entre la partie responsable et la violation ou le défaut d'algorithme.
Une fois que tous les nœuds sont initialisés, un graphe hétérogène (V, E, H0) est formé, où V représente l'ensemble des nœuds, E l'ensemble des arêtes dirigées munies d'étiquettes de type, et H0 la matrice de caractéristiques initiale. Afin d'améliorer la capacité discriminative sémantique de la structure du graphe, les caractéristiques des nœuds sont normalisées :
 (3)
μk et σk sont respectivement la moyenne et l'écart type de la caractéristique du k-ième nœud sur l'ensemble d'apprentissage, et ∈ est une petite constante destinée à éviter la division par zéro. La normalisation garantit que les caractéristiques hétérogènes provenant de multiples sources participent aux opérations de convolution sur graphe à une échelle uniforme, empêchant ainsi les effets de domination numérique d'interférer avec l'apprentissage sémantique. Le modèle de graphe structuré obtenu reflète intégralement la topologie relationnelle des quatre dimensions que sont le droit, le comportement, la technologie et la responsabilité dans le système d'IA médicale, fournissant une base de graphe calculable pour l'analyse ultérieure de la propagation des biais.
Amélioration de l'alignement par convolution de graphes pour la sémantique juridique transmodale
Un réseau de convolution graphique sensible aux relations38,39, qui étend le cadre du Réseau de Convolution Graphique Relationnel (R-GCN), est utilisé pour propager les caractéristiques à travers plusieurs couches du graphe hétérogène initial. Alors que le R-GCN introduit des matrices de transformation spécifiques à chaque relation pour des données relationnelles générales, notre approche intègre en outre un mécanisme d'attention apprenable afin de pondérer dynamiquement les contributions des voisins, et définit quatre types spécifiques de relations sémantiques juridiques (violation, base, déclenchement, attribution), adaptés à l'analyse de conformité en intelligence artificielle médicale. L'opération de chaque couche paramétrise indépendamment le processus de transformation selon le type sémantique des arêtes. Pour tout nœud cible, les informations de son voisinage sont regroupées et agrégées selon les types des arêtes les reliant. Chaque type de relation est doté d'une matrice de transformation linéaire dédiée, permettant de différencier les caractéristiques transmises le long de différents chemins sémantiques juridiques40,41. Si l'arête entre le nœud de clause juridique et le nœud de comportement médical est de type « base », lorsque le nœud de clause juridique reçoit un message d'un nœud de comportement médical, il applique la matrice de poids correspondante pour projeter spatialement les caractéristiques du voisin. De la même manière, lorsqu'un nœud de comportement médical envoie une sortie via le module d'intégration d'arête de type « déclenchement » vers un module d'algorithme, la matrice de paramètres associée à cette relation est activée et effectue la transformation des caractéristiques. Ce mécanisme imite la fluidité des différents types de logique juridique, permettant ainsi de distinguer différentes couches logiques afin de préserver l'indépendance sémantique durant le flux d'information, sans bruit inter-modal. L'agrégation est définie comme suit :
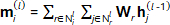 (4)
mi(l) représente l'ensemble des informations recueillies par le nœud i dans la couche l, Nil est son ensemble de nœuds voisins selon la relation r, Wr est la matrice de transformation linéaire, et hj(l−1) est la représentation intégrée du nœud voisin dans la couche précédente.
Un mécanisme d'attention apprenable est introduit lors de l'agrégation des messages afin d'ajuster dynamiquement l'intensité d'influence des différents nœuds voisins sur la mise à jour de la représentation du nœud cible42,43. Le coefficient d'attention est généré à partir de deux facteurs combinés : la similarité des attributs des nœuds et leur importance juridique, sans dépendre de poids a priori fixes. Pour les nœuds correspondant à des clauses juridiques, lorsqu'ils reçoivent des caractéristiques de comportements médicaux voisins, le score d'attention est calculé selon la valeur quantifiée de l'intensité de la sanction associée à ce dernier ; lorsque le nœud du module algorithmique fusionne des informations sur les comportements médicaux, il se concentre sur les voisins présentant des niveaux de risque opérationnel plus élevés. Le poids d'attention est calculé de la manière suivante :
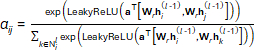 (5)
αij est le coefficient d'attention du nœud j vers le nœud i, et a est le vecteur d'attention apprenable. Ce modèle permet l'identification automatique des chemins connectés à risque élevé ou à contraintes élevées durant l'entraînement de bout en bout, en leur attribuant une attention plus importante. L'incorporation finale mise à jour du nœud est déterminée par les messages pondérés et les connexions résiduelles.
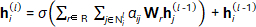 (6)
σ est la fonction d'activation, et la conception résiduelle atténue le problème de disparition du gradient lors de la propagation profonde et garantit la stabilité en présence de conflits sémantiques multiples. Après L = 3 couches de convolution sur graphes (chacune ayant une dimension cachée de 256 et une activation ReLU), les plongements de tous les nœuds intègrent de manière fluide l'information contextuelle multi-modale et deviennent des représentations unifiées dotées de capacités de discrimination sémantique juridique.
Deux diagrammes alternatifs d'analyse de conformité juridique pour l'intelligence artificielle en santé sont représentés dans la Figure 2, dans le but de visualiser les types de relations juridiques et les voies de propagation des biais, indiquant ainsi les sources potentielles de biais dans cette prise de décision. La Figure 2A illustre l'influence de diverses relations sémantiques juridiques, où quatre types de relations sont codés par couleur, chaque type étant représenté par une couleur d'arête différente. L'épaisseur de l'arête correspond au poids d'attention de la relation considérée, c'est-à-dire à l'importance de cette relation dans la décision de l'IA. Une arête épaisse indique essentiellement une relation juridique dominante dans la décision, et dans ce cas, elle justifie suffisamment l'issue du cas. La taille des nœuds reflète leur contribution aux violations : des nœuds plus grands indiquent une relation plus forte entre le comportement et des clauses juridiques spécifiques, et donc un risque potentiel plus élevé. La visualisation ci-dessus fournit une couche sémantique juridique claire, qui nous permet d'identifier les voies juridiques les plus fortes et les plus risquées dans la prise de décision par l'IA. La Figure 2B met également en évidence les chemins à forte contribution (à la propagation des biais), en soulignant les arêtes à forte contribution, qui sont en gras et accompagnées de lignes en pointillés (par exemple B1-B3) dans le processus de décision. Le doublement de la largeur de ces arêtes représente leur importance dans la diffusion d'un biais systémique. Les combinaisons de règles juridiques et de comportements techniques entraînant cet effet d'amplification du biais sont illustrées dans la Figure 2. Cette analyse révèle non seulement le parcours de propagation des biais, mais facilite également l'identification de l'origine de ces biais, sur la base desquels peuvent être établis le contrôle de conformité et la responsabilité de l'outil d'IA.
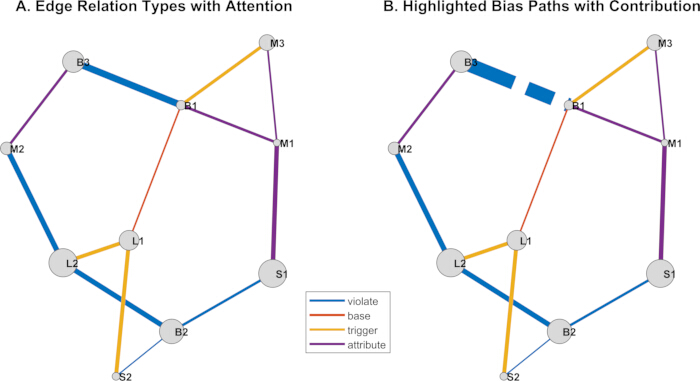
Figure 2 : Analyse de la conformité juridique et de la propagation des biais dans l'intelligence artificielle en santé (exemple illustratif). (A) Relations sémantiques juridiques codées par couleurs : violation (rouge), fondement (bleu), déclencheur (vert), attribution (orange). L'épaisseur des arêtes est proportionnelle au poids d'attention, indiquant l'influence de chaque relation sur la décision de l'IA. La taille des nœuds est proportionnelle à leur contribution à la violation, mettant en évidence les entités à risque. (B) Sous-graphe de propagation des biais : les arêtes à forte contribution sont en gras et en pointillés (par exemple, B1‑B3) ; les arêtes de largeur double indiquent une amplification du biais systémique. Cette visualisation facilite l'identification des chemins juridiques dominants, des origines des biais et de l'audit de conformité. Aucune échelle de mesure ni barre d'erreur n'est applicable, car il s'agit d'une illustration schématique. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Mécanisme de retour arrière sur sous-graphe pour le chemin de propagation du biais
Dans cette étude, le « biais » est défini comme l'écart systématique entre la sortie d'un système d'intelligence artificielle et la décision attendue sur le plan clinique et juridique, mesuré par la différence entre le score de risque prédit par le modèle et l'étiquette de conformité réelle. Le signal de biais est quantifié par la perte logarithmique (cross-entropy) entre la sortie finale de l'algorithme et un indicateur binaire de conformité (1 pour conforme, 0 pour non conforme), agrégé sur l'ensemble des instances de décision d'un lot.
Une fois le réseau neuronal graphique entraîné, sa différentiabilité est utilisée pour effectuer une analyse de rétropropagation du signal de biais dans la couche de sortie. À partir du nœud de décision de l'algorithme qui détecte les anomalies, l'amplitude du gradient de la fonction de perte par rapport à chaque arête connectée est calculée afin de quantifier la contribution de chaque arête à la formation du biais. Ce processus est mis en œuvre à l'aide d'un cadre de différentiation automatique, qui remonte couche par couche le long des arêtes orientées de la structure du graphe pour obtenir l'intensité d'influence de chaque transformation de paramètre d'arête sur la variation de la sortie finale. Plus la valeur absolue du gradient est élevée, plus la relation juridico-technique véhiculée par cette arête joue un rôle dominant dans la propagation du biais. La contribution d'une arête est définie comme suit :
 (7)
Lbiais est la perte différentiable définie pour un comportement biaisé, et wi est le vecteur de poids d'entrée correspondant au type d'arête. Cette valeur de gradient reflète le degré de participation d'une relation sémantique spécifique au biais d'association actuel. Une fois que toutes les arêtes ont été notées de cette manière, un seuil dynamique τ est défini pour filtrer l'ensemble des arêtes à forte contribution. Eélevé dont la contribution dépasse gij > τ, formant le sous-graphe initial de propagation du biais Gbiais = (Vbiais, Eélevé). Plus précisément, τ est déterminé comme le 85e centile des valeurs absolues du gradient sur l'ensemble des arêtes à chaque époque d'apprentissage, garantissant ainsi que seules les 15 % des arêtes les plus influentes sont conservées pour la construction du sous-graphe. Ce sous-graphe met l'accent sur les chemins de connexion clés les plus susceptibles d'induire un biais systématique, réduisant l'espace de recherche et améliorant l'efficacité du traçage des sources.
Au sein du sous-graphe de propagation de biais construit, un algorithme de détection de communautés guidé par une segmentation spectrale est exécuté afin d'identifier des structures de grappes de nœuds fortement cohérentes. Ce processus repose sur la factorisation de la matrice de Laplace normalisée du sous-graphe, qui projette les intégrations des nœuds dans un espace spectral de faible dimension et applique une stratégie de regroupement sensible à la densité dans cet espace, garantissant ainsi que les nœuds de types différents (tels que des clauses juridiques et des modules d'algorithme) soient regroupés dans la même grappe lorsqu'ils sont fonctionnellement étroitement liés. Chaque communauté identifiée représente une boucle fonctionnelle potentielle ou une unité d'agrégation de responsabilités. Les résultats de partitionnement en communautés sont déterminés par les objectifs d'optimisation suivants :
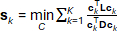 (8)
L=D−A est la matrice laplacienne du sous-graphe, A est la matrice d'adjacence, D est la matrice de degré, ck est le vecteur indicateur de la k-ième communauté, et K est le nombre prédéfini de communautés. Ce critère maximise la différence de coupe minimale entre les communautés, assurant des connexions internes étroites.
Une analyse basée sur la composition croisée des couches est désormais effectuée pour chaque communauté. Si une communauté contient des nœuds correspondant à des clauses juridiques et des nœuds de modules algorithmiques, elle est marquée comme une source potentielle de biais. Pour tester sa causalité, un test d'intervention est réalisé : toutes les arêtes de cette région sont temporairement supprimées du graphe, le même processus de prise de décision est exécuté à nouveau, et les différences observées dans les mesures de biais sont notées. La mesure de validité causale est définie comme suit :
 (9)
Borig et Bmask représentent respectivement l'intensité du biais du modèle d'origine et celle du biais après masquage. Si la mesure de validité causale est nettement supérieure au seuil prédéterminé, cela implique que le regroupement de nœuds a été identifié comme une source explicative de biais, ce qui guidera ultérieurement la correction de conformité et l'attribution des défaillances.
Vérification dynamique de la conformité aux contraintes juridiques
Les instances de décision en temps réel apparaissant lors du fonctionnement d'un système d'intelligence artificielle médical sont introduites comme des nœuds transitoires et intégrées dans un espace de graphe de connaissances appris. Chaque nœud produit un vecteur de caractéristiques initial en lisant son contexte d'entrée, son comportement de sortie et l'état de l'algorithme. Ensuite, ce vecteur est transmis à un réseau neuronal graphique aux paramètres figés afin d'effectuer une propagation avant en une couche, produisant un vecteur intégré aligné sur le graphe de connaissances sans modifier la structure originale du graphe. Cela permet ainsi de comparer les nœuds transitoires et les nœuds correspondant à des clauses juridiques dans un espace sémantique commun.
Ensuite, calculez la similarité cosinus entre le nœud transitoire et chacun des nœuds correspondant aux clauses légales :
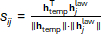 (10)
htemp est l'incorporation du nœud temporaire, et hjlaw est l'incorporation du nœud de la j-ième clause juridique. La valeur de similarité reflète virtuellement le degré de correspondance sémantique entre la décision actuelle et chaque contrainte juridique. Un seuil de conformité dynamique θ est défini à partir de la distribution de similarité d'échantillons historiques de conformité, afin d'adapter la limite de jugement à différents scénarios d'application. Plus précisément, θ = µ - 2σ, où µ et σ représentent respectivement la moyenne et l'écart type de la distribution de similarité cosinus calculée à partir d'un jeu de validation composé de 500 décisions conformes connues.
Si un score de similarité cosinus est inférieur au seuil de conformité dynamique, la règle de droit correspondante est considérée comme violée, ce qui déclenche le mécanisme d'alerte de conformité. La notification inclut également le numéro minimal de la clause juridique correspondante, la valeur de similarité et la direction de l'analyse de divergence, ce qui devrait permettre aux régulateurs d'agir rapidement. Cette approche fournit une cartographie interprétable allant d'une prise de décision opaque vers l'espace de la sémantique juridique et facilite la vérification de la conformité en temps réel.
Pendant le fonctionnement continu, on suit l'évolution du poids des arêtes clés du sous-graphe de propagation des biais, qui représentent les connexions entre le droit et la technologie. L'accent est mis sur les arêtes reliant les nœuds des modules algorithmiques aux nœuds des clauses juridiques, car elles représentent directement l'intensité de la réponse du comportement technique à des réglementations spécifiques. Les paramètres de la matrice de transformation pour chaque arête cible sont enregistrés pendant l'inférence, et leur norme est extraite comme indicateur dynamique de l'évolution de la force de corrélation entre les deux. On définit la séquence de force d'arête comme suit :
 (11)
wt représente la norme de Frobenius de la matrice de poids correspondant à la relation entre l'arête eij au temps t, et Wkl(t) est la matrice de paramètres effectivement utilisée dans le modèle à ce moment. Cet indicateur reflète la profondeur d'apprentissage du modèle ou sa dépendance vis-à-vis de la contrainte légale.
Un test de monotonie à fenêtre glissante est effectué sur la séquence, et un test des signes amélioré est utilisé pour déterminer si une tendance croissante significative est observée. Si les accroissements sur N pas de temps consécutifs satisfont la condition de dominance positive, alors l'arête est considérée comme présentant un phénomène de renforcement anormal. En combinant davantage les données historiques de contribution du gradient, si l'arête a été identifiée comme un chemin à fort impact lors du tour précédent de l'analyse de traçage de source, un processus précoce d'alerte d'accumulation de biais systémique est initié.
Enfin, un rapport de traçage de la source est généré, incluant des informations sur les nœuds situés aux deux extrémités de l'arête cible, les courbes d'évolution des poids, des statistiques sur la fréquence des décisions associées, ainsi que des recommandations d'attribution potentielles. Ce mécanisme permet un saut allant du jugement statique de conformité à la prédiction dynamique des risques, en soutenant une intervention proactive face aux écarts institutionnels potentiels.
Données expérimentales et conception
Afin de vérifier l'efficacité du cadre proposé, cet article construit un jeu de données hétérogène multi-source intégrant des réglementations réelles et des données de simulation, et conçoit des expériences de contrôle rigoureuses. Les sources de données comprennent les réglementations nationales sur l'intelligence artificielle en milieu médical, les lignes directrices de traitement clinique, les rapports d'audit d'algorithmes open source et les journaux de décisions simulées. Après prétraitement, un graphe de connaissances hétérogène de référence contenant 285 noeuds (85 clauses juridiques, 120 comportements médicaux, 42 modules d'algorithme et 38 entités responsables) et 1247 arcs orientés est construit, comme illustré dans la Figure 3.
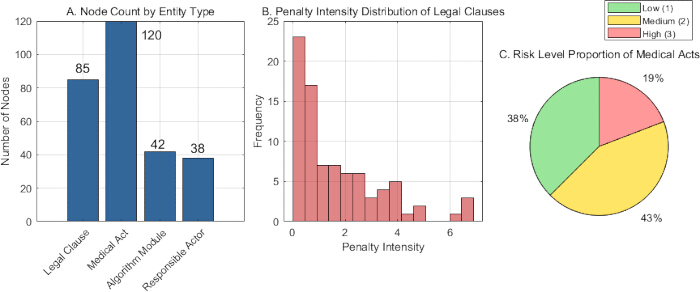
Figure 3 : Répartition et caractéristiques des types d'entités hétérogènes. (A) Graphique en barres montrant le nombre de nœuds pour chaque type d'entité : clauses juridiques (85), comportements médicaux (120), modules d'algorithme (42), parties responsables (38). (B) Histogramme de l'intensité des pénalités pour les nœuds correspondant aux clauses juridiques, regroupés en catégories faible (0‑0,33), moyenne (0,34‑0,66) et élevée (0,67‑1,0) ; l'axe vertical représente le nombre d'occurrences. (C) Camembert de la répartition des niveaux de risque parmi les nœuds de comportements médicaux : faible (19 %), moyen (43 %), élevé (38 %). Toutes les valeurs sont des effectifs absolus ou des pourcentages ; aucune barre d'erreur n'est indiquée car il s'agit de statistiques descriptives du jeu de données. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Figure 3 illustre la répartition et les caractéristiques des nœuds d'entité dans le graphe de connaissances hétérogène. Figure 3A présente la répartition du nombre de quatre types de nœuds d'entité, les nœuds « comportement médical » étant les plus nombreux (120), suivis des « clauses juridiques » (85), tandis que les « modules d'algorithme » (42) et les « entités responsables » (38) sont relativement moins nombreux. Cela s'explique par le fait que le graphe est structurellement conçu sur la base des comportements et des règles. Figure 3B montre la répartition des intensités de sanctions pour les nœuds représentant une clause juridique unique, l'intensité mesurant la gravité de la responsabilité juridique. Les données indiquent qu'il existe relativement peu de dispositions à forte intensité de sanction, la majorité se situant dans une fourchette d'intensité moyenne à faible, ce qui est conforme à la réalité selon laquelle seules quelques clauses de violation grave existent dans les systèmes juridiques réels. Figure 3C illustre la répartition du niveau de risque parmi les nœuds de comportement médical, les comportements à risque modéré représentant la plus grande proportion (43 %), tandis que les comportements à faible risque ont la proportion la plus faible (19 %), ce qui révèle que les scénarios médicaux fonctionnent généralement de manière normale, et que les opérations à haut risque sont soumises à des contraintes d'association plus rigoureuses dans le graphe. Ces statistiques justifient collectivement le schéma de codage d'ambiguïté des entités adopté lors de la construction du graphe de connaissances, afin de fournir un soutien en caractéristiques pour l'alignement ultérieur par convolution sur graphe.
L'ensemble complet des données a été divisé aléatoirement en ensembles d'apprentissage (70 %), de validation (10 %) et de test (20 %), en stratifiant selon le type de nœud et la distribution des relations afin de préserver la structure globale du graphe dans chaque sous-ensemble. La même répartition a été utilisée de manière cohérente pour toutes les méthodes de référence afin d'assurer une comparaison équitable. En complément de cette répartition de base, les trois gradients de densité du graphe de connaissances (faible, moyenne, élevée) et les trois niveaux de complexité interjuridictionnelle (unique, bilatérale, multilatérale) décrits ci-dessus servent de bancs d'essai pratiques indépendants, qui évaluent collectivement la robustesse de la méthode dans des conditions variables de complétude des données et de chevauchement réglementaire. Pour construire les étiquettes de référence permettant l'évaluation de la localisation des biais, nous avons adopté une stratégie en deux étapes : (1) Annotation par des experts — trois experts en droit et en médecine ont examiné indépendamment les journaux de décisions et identifié les nœuds à l'origine des biais ainsi que les chemins de propagation pour chaque violation de conformité enregistrée, les divergences ayant été résolues par vote majoritaire ; (2) Injection simulée — pour des tests contrôlés, nous avons artificiellement injecté des signaux de biais dans 20 chemins de décision sélectionnés aléatoirement en perturbant les poids des arêtes dans le graphe de connaissances, en veillant à ce que les nœuds sources réels et les arêtes affectées soient connus a priori.
Pour toutes les méthodes de référence (TransE, ComplEx, GNNExplainer, KG-BERT et Node2Vec), nous avons utilisé la même configuration d'apprentissage (optimiseur Adam, taux d'apprentissage de 1 × 10⁻³, taille de lot de 64, 100 époques) et les mêmes partitions de données que celles de notre méthode afin d'assurer une comparaison équitable. Pour TransE et ComplEx, la dimension d'incorporation a été fixée à 256 avec une marge de 1,0 ; pour KG-BERT, nous avons utilisé le modèle BERT-base pré-entraîné avec une taille de lot de 16 et une longueur maximale de séquence de 128 ; pour GNNExplainer, nous avons utilisé un GCN à 3 couches avec la même dimension cachée de 256 ; et pour Node2Vec, nous avons défini la longueur de marche à 80, le nombre de marches par nœud à 10 et la dimension d'incorporation à 256.
Afin d'assurer une comparaison équitable, nous avons adapté toutes les méthodes de base aux mêmes tâches de localisation des biais, à savoir l'identification du nœud racine et la reconstruction du chemin de propagation. Pour TransE, ComplEx et Node2Vec, qui ne sont pas intrinsèquement explicables, nous avons calculé le gradient de la perte liée au biais par rapport à l'incorporation de chaque nœud et utilisé l'amplitude du gradient comme score d'importance du nœud ; les nœuds racines ont été sélectionnés en appliquant un seuil à ces scores, et les chemins de propagation ont été reconstruits en conservant les arêtes ayant les contributions de gradient les plus élevées. Pour GNNExplainer, nous avons utilisé directement ses mécanismes intégrés d'importance des arêtes et de masquage des nœuds afin d'obtenir à la fois les nœuds racines et les sous-graphes. Pour KG-BERT, qui opère sur des triplets, nous avons converti chaque arête du graphe en un triplet textuel et utilisé les poids d'attention du modèle sur les entités pour déterminer l'importance des nœuds, suivis de la même stratégie de seuil pour la reconstruction du chemin. Grâce à ces adaptations, chaque méthode de base produit des prédictions de nœuds racines et des prédictions de chemins de propagation, permettant ainsi une évaluation uniforme de toutes les méthodes.
L'évaluation est centrée sur quatre capacités fondamentales : la précision de l'alignement sémantique, la capacité à localiser les biais, l'efficacité de la traçabilité et la généralisation à travers différents domaines. Elle présente également trois variables de contrôle importantes, imitant la complexité du monde réel.
1) Gradient de densité du graphe de connaissances : Pour évaluer la performance de la méthode à différents niveaux de complétude des informations, deux sous-ensembles sont créés à partir du graphe complet de référence (densité D = 1,0) selon une stratégie aléatoire de suppression d'arêtes, comme suit :
Graphe clairsemé (D ~ 0,3) : 30 % des arêtes sont conservées aléatoirement, ce qui simule l'étape de construction précoce des connaissances où de nombreuses informations sont manquantes.
Graphe de densité moyenne (D ~ 0,6) : 60 % des arêtes sont conservées aléatoirement, simulant un scénario typique de structure de connaissances partiellement connue.
Graphe dense (D = 1,0) : utilisation des 1247 arêtes, correspondant à un scénario idéal de connaissance relativement complète.
2) Situation de la fréquence des décisions médicales par intelligence artificielle : Trois charges de flux de décision artificiels sont définies pour tester les performances en temps réel de la surveillance dynamique de la conformité :
Basse fréquence de 10 Hz : en moyenne, 10 événements de décision sont générés par seconde, simulant la surveillance de systèmes à petite échelle ou de sites uniques.
Fréquence moyenne de 50 Hz : 50 événements de décision par seconde, simulant la charge du système d'intelligence artificielle d'établissements médicaux régionaux ou de taille moyenne.
Haute fréquence à 100 Hz : 100 événements de décision par seconde simulent des scénarios de forte pression de concurrence pour les services d'intelligence artificielle déployés dans un grand hôpital ou sur une plateforme cloud.
3) Gradient de complexité interjuridictionnel : Afin de tester la transférabilité de la modélisation des contraintes juridiques, trois jeux de données expérimentaux fondés sur la complexité ont été établis :
Juridiction unique : se compose exclusivement des lois et réglementations chinoises actuelles régissant l'intelligence artificielle médicale.
Juridiction bilatérale : intègre les régimes réglementaires de la Chine et de l'Union européenne, environ 15 % des règles étant contradictoires et superposées.
Juridiction multilatérale : S'appuyant sur les deux premières, elle intègre en outre les règles de confidentialité et de sécurité issues du HIPAA des États-Unis (Health Insurance Portability and Accountability Act), créant un environnement d'essai dans lequel les systèmes juridiques des trois régimes juridiques s'entrecroisent, augmentant ainsi le taux de conflit de règles à environ 25 %.
Les indicateurs clés suivants ont été utilisés pour l'évaluation quantitative :
1) Précision de l'alignement sémantique : mesure la capacité du graphe à modéliser les relations entre les entités juridiques et techniques.
Précision du rapprochement d'entités :
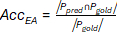 (12)
Ppred est l'ensemble des paires d'entités alignées prédites par le modèle, et Pgold est l'ensemble des alignements de référence annotés par des experts.
Intégrité de la préservation des relations :
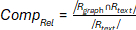 (13)
Rgraph est l'ensemble reconstruit des relations dans le graphe, et Rtext est l'ensemble des relations explicites extraites du texte juridique d'origine.
2) Capacité de localisation des biais : Évaluer l'efficacité du traçage des causes profondes et des chemins de propagation des biais.
Taux de rappel du nœud racine :
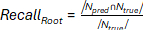 (14)
Npred est l'ensemble des nœuds sources de biais identifiés par le modèle, et Ntrue est l'ensemble des nœuds sources réels étiquetés par des experts.
Précision du trajet de propagation :
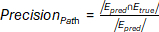 (15)
Epred est l'ensemble des arêtes dans le sous-graphe de propagation des biais déduit par le modèle, et Etrue est l'ensemble réel des arêtes de propagation des biais.
3) Efficacité du suivi de la responsabilité : Tester les performances du système dans des scénarios de surveillance en temps réel.
Latence moyenne de traçage :
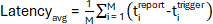 (16)
M représente le nombre total de demandes, et titrigger et tireport sont les horodatages respectifs du i-ième déclenchement de biais et de la génération du rapport source.
Débit du système :
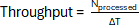 (17)
Nprocessed représente le nombre de demandes de traçage simultanées traitées avec succès dans l'intervalle de temps ΔT.
4) Capacité de généralisation interdomaines : vérification de l'adaptabilité de la méthode à différents systèmes juridiques.
Couverture juridictionnelle :
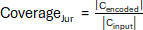 (18)
Cencoded représente le nombre de clauses juridictionnelles différentes correctement encodées dans le graphe, et Cinput représente le nombre total de clauses d'entrée.
Taux de détection des conflits de contrainte :
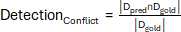 (19)
Dpred est l'ensemble des contradictions logiques légales détectées par le modèle, et Dgold est l'ensemble de toutes les paires de contradictions annotées par des experts.
Toutes les expériences ont été réalisées à l'aide d'une station de travail équipée d'un processeur multicœur et d'une unité de traitement graphique ; les spécifications complètes du matériel sont fournies dans le tableau des matériaux.
Les principaux hyperparamètres de cette approche et leurs valeurs sont indiqués dans Tableau 1, incluant la structure du modèle, la configuration de l'apprentissage ainsi que des seuils essentiels tels que la dimension de l'incorporation, le nombre de couches convolutionnelles, le taux d'apprentissage et la taille du lot. Tous les paramètres ont été ajustés par rapport à l'ensemble de validation à l'aide d'une recherche en grille, le modèle entraîné a convergé de façon stable, et les performances sont optimales. Certains seuils ont été définis conjointement avec des critères spécialisés afin de satisfaire aux exigences de haute fiabilité du contrôle de conformité en intelligence artificielle médicale.
| Paramètre | Valeur | Description |
| Dimension de l'incorporation | 128 | Taille de la dimension des caractéristiques pour les incorporations de nœuds |
| Nombre de couches de convolution | 3 | Profondeur du réseau de convolution sur graphes sensible aux relations |
| Taux d'apprentissage | 0.001 | Taux d'apprentissage initial pour l'optimiseur Adam |
| Taille du lot | 32 | Nombre de sous-graphes traités par lot |
| Taux de dropout | 0.1 | Probabilité de dropout appliquée aux caractéristiques des nœuds pendant l'entraînement |
| Nombre de têtes d'attention | 8 | Nombre de têtes dans le mécanisme d'attention multi-têtes |
| Coefficient de régularisation L2 | 5 × 10⁻⁴ | Coefficient de décroissance du poids pour la régularisation des paramètres |
| Seuil de similarité | 0.75 | Similarité minimale des incorporations pour la validation de conformité |
| Seuil de contribution du gradient | 0.01 | Seuil pour sélectionner les arêtes à fort impact dans la construction du sous-graphe biaisé |
| Taille de la fenêtre de surveillance | 10 | Pas de temps utilisés pour suivre la dynamique des poids des arêtes |
Tableau 1 : Paramètres principaux. Liste des principaux hyperparamètres utilisés dans les expériences : dimension de l'incorporation (256), nombre de couches GCN (3), dimension cachée (256), taux d'apprentissage (1 × 10⁻³), taille du lot (64), dimension du vecteur d'attention, seuil de contribution des arêtes (95e centile des amplitudes du gradient), seuil de conformité dynamique (µ‑2σ, où µ et σ proviennent de l'ensemble de validation composé de 500 instances conformes), nombre de communautés K (déterminé par regroupement spectral) et optimiseur (Adam). Ces valeurs ont été sélectionnées par recherche en grille sur l'ensemble de validation.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Vérification des performances de la traçabilité de l'origine des biais dans le graphe de connaissances juridiques de l'IA médicale
Performance de la convolution de graphes tenant compte des relations
En entraînant un réseau de convolution graphique sensible aux relations, les similarités d'encodage entre les clauses juridiques et les nœuds de comportement médical à travers différentes couches de convolution ont été calculées, et l'e...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
L'intégration de l'intelligence artificielle médicale dans les décisions cliniques soulève des défis juridiques en matière d'attribution de responsabilité, compliqués par l'écart sémantique entre les textes juridiques non structurés et les algorithmes de type « boîte noire ». Pour combler ce fossé, nous proposons un graphe de connaissances fondé sur un réseau de neurones graphiques (GNN) qui modélise les clauses juridiques, les comportements médicaux, les modules d'algorithmes et les parties responsables comme des nœuds ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Le manuscrit n'a été ni publié précédemment ni soumis à l'examen d'une autre revue. Tous les auteurs ont approuvé le contenu de l'article. Les auteurs déclarent ne pas avoir de conflits d'intérêts financiers.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| ComplEx | Réalisation open source (par exemple, OpenKE) | Version 1.0 | Référence d'intégration complexe pour la comparaison de graphes de connaissances |
| GNNExplainer | Réalisation open source (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Référence d'interprétabilité des GNN pour le traçage des biais |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Processeur central pour l'entraînement du modèle et le prétraitement des données |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Référence d'intégration de graphe de connaissances basée sur un transformeur pour l'alignement sémantique |
| Node2Vec | Réalisation open source (https://github.com/aditya-grover/node2vec) | Version 1.0 | Référence d'intégration de nœuds basée sur des marches aléatoires |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | GPU haute performance accélérant l'entraînement des réseaux de neurones sur graphes |
| Nôtre (GCN sensible aux relations) | Réalisation personnalisée en PyTorch | PyTorch 1.12.0 | Cadre proposé avec transformations spécifiques aux relations, attention et rétropropagation des gradients |
| TransE | Réalisation open source (par exemple, OpenKE) | Version 1.0 | Référence d'intégration translationnelle pour la comparaison de graphes de connaissances |
Références
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.