פרוטוקול זה מתאר פיתוח והערכה של מודל למידת מכונה מבוסס עץ קבוצתי שניתן לפענח, המשתמש בנתונים קליניים שנאספים באופן שגרתי לחיזוי סיכון לאוסטאופורוזיס בחולי סוכרת.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
למידת מכונה ניתנת לפירוש רב-מודלי לחיזוי אוסטאופורוזיס בסוכרת באמצעות מאגר נתונים גדול של רשומות בריאות אלקטרוניות לטיפול נמרץ
במאמר זה
סיכום
תקציר
סוכרת קשורה לעלייה בשבריריות השלדית ולסיכון מוגבר לשברים; עם זאת, זיהוי מוקדם של אוסטאופורוזיס (OP) באוכלוסיות סוכרתיות נותר מאתגר. מחקר זה נועד לפתח ולהשוות מודלים מרובים של למידת מכונה (ML) לחיזוי OP בקרב חולי סוכרת, תוך הערכת התועלת הקלינית שלהם והגברת שקיפות המודל באמצעות SHapley Additive exPlanations (SHAP). באמצעות נתונים דמוגרפיים ומעבדתיים שנאספו באופן שגרתי ממאגר MIMIC-IV, אומנו ואומצו אלגוריתמים שונים של למידת מכונה, כולל אנסמבלים של עצים, הגברת גרדיאנטים וקווי בסיס ליניאריים. ביצועי המודל הוערכו באופן מקיף באמצעות מדדי הבחנה, כולל השטח מתחת לעקומת המאפיין התפעולית של המקלט (AUC) וניתוח דיוק–זיכרון, וכן עקומות כיול הסתברות וניתוח עקומת החלטה (DCA) להערכת התועלת הקלינית נטו. המודל הטוב ביותר פורש בהמשך באמצעות SHAP לכימות והמחשה של תרומות תכונות ברמה הגלובלית והאישית. מבין כל המודלים שנבדקו, שיטות מבוססות עץ קבוצה הראו שיפור בביצועים. מסווג ExtraTrees השיג את ביצועי האימות הגבוהים ביותר (AUC = 0.862; דיוק ממוצע = 0.866). יתרה מזאת, המודל הנבחר הציג כיול הסתברות מצוין (ציון ברייר = 0.154) והראה תועלת קלינית נטו משמעותית בטווח רחב של ספי סיכון ב-DCA. ניתוח SHAP זיהה את המגדר והגיל כמנבאים המשפיעים ביותר, ואחריהם מדדים המטולוגיים ומעבדתיים שגרתיים. הסברים מקומיים סיפקו תובנות ניתנות לפרשנות קלינית לגבי תחזיות אישיות. מודל מבוסס עץ אנסמבל ניתן לפרשנות מנבא ביעילות את הסיכון ל-OP בחולי סוכרת באמצעות משתנים קליניים זמינים באופן שגרתי. השילוב של SHAP משפר את השקיפות הקלינית, וכיול חזק יחד עם תועלת קלינית נטו חיובית תומכים ביישומו הפוטנציאלי ככלי אמין לתמיכה בהחלטות לצורך הדרגה מוקדמת של סיכוני OP באוכלוסיות סוכרתיות.
מבוא
סוכרת ואוסטאופורוזיס (OP) הן מחלות כרוניות נפוצות מאוד שמתקיימות במקביל יותר ויותר, ויצרות עומס משמעותי בשל שברים שבריריים, נכות ועלויות בריאות. אצל חולי סוכרת סוג 2 (T2D), הסיכון לשבר גבוה באופן פרדוקסלי גם כאשר צפיפות המינרלים האזורית של עצם (BMD) הנמדדת באמצעות ספיגת רנטגן דו-אנרגטית (DXA) נשמרת או גבוהה מהצפוי, מה שמדגיש כי "איכות" העצם והגורמים המטבוליים המערכתיים תורמים באופן משמעותי לשבריריות השלדית 1,2. למרות ש-DXA הוא הסטנדרט הקליני לאבחון OP, הנגישות והקליטה שלו מוגבלות במגוון מצבים, והערכה מבוססת DXA עלולה להמעיט בסיכון השלד הקשור לסוכרת. ברמת האוכלוסייה, ראיות מטא-אנליטיות מצביעות על כך ש-OP נפוץ בקרב אנשים עם סוכרת, אם כי הערכות השכיחות משתנות בין קבוצות והקשרים קליניים3. לכן, יש צורך קליני קריטי ומוטיבציה חזקה לפתח כלים פרגמטיים וניתנים להרחבה לחיזוי סיכון, המנצלים נתונים קליניים שנאספים באופן שגרתי כדי לזהות מטופלים בסיכון גבוה מוקדם יותר, ובכך להנחות סקר ממוקד ואסטרטגיות מניעה מותאמות אישית.
בשנים האחרונות, שיטות למידת מכונה (ML) משמשות יותר ויותר למידול קשרים מורכבים ולא ליניאריים בנתונים קליניים ולבניית חיזוי סיכון OP עבור חולי סוכרת. מחקרים קודמים הראו הבחנה מבטיחה באמצעות אלגוריתמים כמו הגברת גרדיאנט, מכונות וקטוריות תמיכה, רשתות עצביות וכלים בסגנון נומוגרמה. במיוחד, התקדמויות אחרונות חקרו אסטרטגיות מודל חדשניות, כמו מיזוג של ML עם לוגיקה מטושטשת, כדי לחזות סיכונים הקשורים ל-OP ולסוכרת בהתבסס על גורמים ניתנים לשינוי 4,5,6. עם זאת, נותר פער מחקר משמעותי: מודלים קיימים רבים פותחו בקבוצות מוגבלות (למשל, נשים לאחר גיל המעבר בלבד או חולי סוכרת סוג 2 מבוגרים) והוערכו במסגרת מערך מוגבל של אלגוריתמים מועמדים, מה שמשאיר אי-ודאות לגבי אילו אפשרויות מודלים אופטימליות לאוכלוסיות סוכרתיות רחבות יותר ונתוני רשומות בריאות אלקטרוניות (EHR) הטרוגניות. יתרה מזאת, מחסום קריטי לאימוץ קליני של מודלים למידת מכונה בעלי ביצועים גבוהים הוא אופיים ה"קופסה השחורה", שמגביל את אמון הרופאים ומקשה על תרגום לתמיכה בהחלטות מעשית. SHapley Additive ExPlanations (SHAP) מספק פתרון על ידי הצגת הסברים ברמת מקרה, ומייחס כל תחזית לתכונות בודדות באמצעות ערכי Shapley, ובכך מאפשר לרופאים לאמת האם ההיגיון של המודל תואם את הסבירות הקלינית.
כדי להתמודד עם פערים אלו, פיתחנו ואימתנו מסגרת חיזוי סיכונים OP עבור חולי סוכרת באמצעות מאגר המידע הרפואי Medical Information Mart for Intensive Care IV (MIMIC-IV) לטיפול קריטיEHR 7. החידוש במחקר זה טמון בהשוואת ביצועים מקיפה בין משפחות מודלים מרובות של ML בשילוב עם פרשנות שקופה מבוססת SHAP בתוך קבוצת סוכרת גדולה ומורכבת קלינית. בניגוד למחקרים המתמקדים באלגוריתם יחיד, הגישה שלנו מקצה לקצה בוחרת באופן שיטתי את המודל הביצועי הטוב ביותר בהתבסס על אימות קפדני ומספקת הסברים שקופים ברמת המטופל. מסגרת זו שואפת לספק הן ביצועים חיזויים חזקים והן תובנות קליניות ניתנות לפעולה, ולתמוך בשיטת סיכון מוקדמת יותר עבור OP בקרב חולי סוכרת.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
מקור הנתונים והצהרת אתיקה
מחקר רטרואקטיבי זה השתמש בנתונים מ-MIMIC-IV (גרסה 3.1), מאגר מידע אלקטרוני לטיפול קריטי שאינו מזוהה לציבור, המאוחסן ב-PhysioNet. המאגר כולל מידע דמוגרפי, סימני חיים, בדיקות מעבדה, אבחנות, פרוצדורות ותרופות.
הגישה ל-MIMIC-IV דורשת אישור מוסמכת ועמידה בהסכם השימוש בנתונים ובדרישות ההכשרה של PhysioNet. החוקרים השלימו את ההכשרה הנדרשת וקיבלו גישה (מספר תעודה: 68351548). מכיוון שמאגר הנתונים אינו מזוהה, מחקר זה ניתח נתונים אנונימיים ולא כלל מגע ישיר עם מטופלים; לכן, לא נדרשה הסכמה מדעת. תהליך המידול הביצועי המלא שלב אחר שלב מוצג באיור 1.
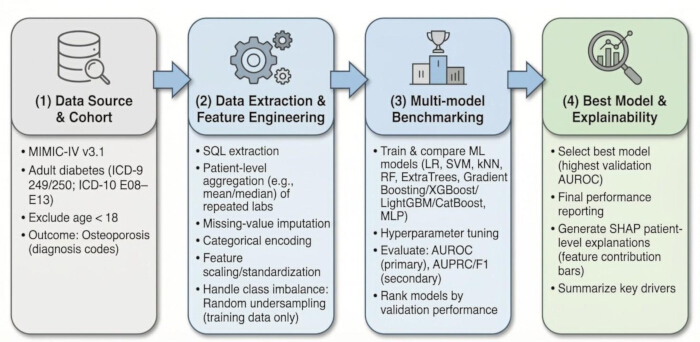
איור 1. תהליך המידול הכולל לחיזוי סיכון לאוסטאופורוזיס (OP) אצל חולי סוכרת. ייצוג סכמטי של צינור המחקר, כולל זיהוי קוהורטים, חילוץ נתונים, הנדסת תכונות, בנצ'מרקינג מרובי מודלים, בחירת מודלים על בסיס ביצועי אימות, ופרשנות מבוססת SHAP של המודל הסופי. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
מחקר אוכלוסייה וחילוץ נתונים
הנתונים הופקו ממאגר Medical Information Mart for Intensive Care IV (MIMIC-IV) באמצעות כלי ניהול מסדי נתונים. כדי להבטיח שחזוריות, שאילתות SQL מדויקות, כולל שמות טבלאות ולוגיקת סינון המשמשת לשליפת קוהורטים, מסופקות בקובץ המשלים 1. מטופלים בוגרים (≥18) שאובחנו עם סוכרת זוהו באמצעות קודי ICD-9 (249, 250) וקודי ICD-10 (E08–E13). התוצאה העיקרית, OP, הוגדרה באמצעות קודי ICD-9 (733.x) וקודי ICD-10 (M80, M81, M82). בתוך קבוצת הסוכרת הראשונית הזכאית (n = 46,226), זוהו 3,672 אירועים חיוביים (מטופלים עם OP) ו-42,554 אירועים שליליים (מטופלים ללא OP). תרשים זרימה מפורט של בחירת מטופלים ופרישה מוצג באיור 2.
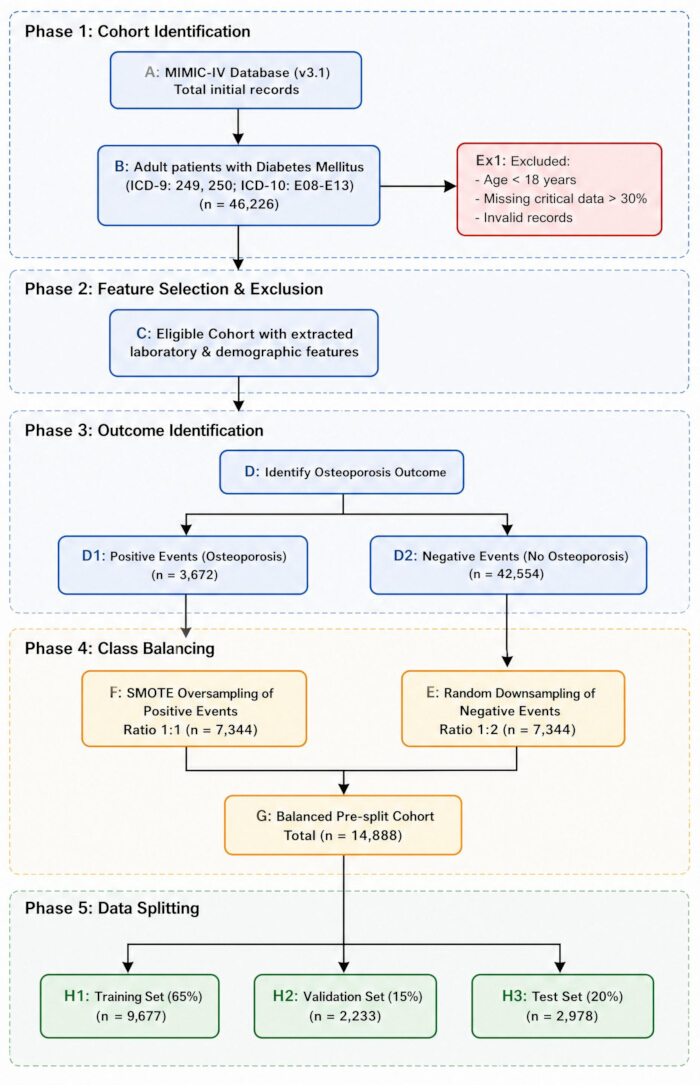
איור 2. תרשים זרימה של בחירת מטופלים ובניית קבוצה. תרשים הזרימה ממחיש את ההסקה ההדרגתית של הקוהורט מתוך מאגר MIMIC-IV (v3.1). מטופלים מבוגרים עם סוכרת זוהו באמצעות קודי ICD, ואחריהם הוצאה ממטופלים בגיל ובגיל סגן; 18 שנים, חסרים נתונים קריטיים gt; 30%, או רשומות לא תקפות. הקבוצה האחרונה חולקה ל-OP (אירועים חיוביים) ולא-OP (אירועים שליליים). אי-איזון מחלקתי טופל באמצעות דגימה תת-אקראית ו-SMOTE שהחלה על נתוני האימון לפני חלוקת מערכי הנתונים בשכבות. אנא לחצו כאן כדי לצפות בגרסה מוגדלת של הדמות הזו.
הנדסת תכונות
כדי להבטיח בנצ'מרקינג הוגן בין אלגוריתמי למידת מכונה ויכולת שחזור מדויקת, הוחל רצף זהה של שלבי קדם-עיבוד: בחירת תכונות, אימפוטציה של ערכים חסרים, קנה מידה מתמשך של תכונות, איזון מחלקות וחלוקת מערכי נתונים. הרשימה המלאה של תכונות הקלט, כולל שמות משתנים, יחידות ומקורות נתונים, מפורטת בטבלה 1.
| מאפיינים | סך הכל (n = 14,688) | סט אימונים (n = 9,546) | קבוצת האימות (n = 2,204) | סט מבחן (n = 2,938) | ערך P |
| מגדר | 0.345 | ||||
| זכר | 6222 (42.36%) | 4045 (42.37%) | 935 (42.42%) | 1242 (42.27%) | |
| נקבה | 8466 (57.64%) | 5501 (57.63%) | 1269 (57.58%) | 1696 (57.73%) | |
| גיל | 0.28 (−0.40, 0.94) | 0.28 (−0.43, 0.94) | 0.23 (−0.46, 0.89) | 0.28 (−0.39, 0.95) | 0.1655 |
| תאי דם אדומים | −0.14 (−0.79, 0.49) | −0.13 (−0.79, 0.49) | −0.17 (−0.83, 0.48) | −0.14 (−0.76, 0.49) | 0.3641 |
| המטוקריט | −0.14 (−0.81, 0.52) | −0.13 (−0.80, 0.52) | −0.14 (−0.87, 0.51) | −0.16 (−0.81, 0.52) | 0.3709 |
| המוגלובין | −0.12 (−0.79, 0.52) | −0.12 (−0.79, 0.51) | −0.15 (−0.86, 0.53) | −0.13 (−0.78, 0.52) | 0.3616 |
| RDW | −0.16 (−0.59, 0.45) | −0.17 (−0.59, 0.46) | −0.14 (−0.59, 0.45) | −0.17 (−0.60, 0.42) | 0.5803 |
| פוספט | −0.14 (−0.60, 0.38) | −0.15 (−0.61, 0.38) | −0.11 (−0.57, 0.38) | −0.13 (−0.56, 0.34) | 0.415 |
| MCV | 0.05 (−0.50, 0.63) | 0.06 (−0.50, 0.65) | 0.03 (−0.49, 0.65) | 0.02 (−0.50, 0.59) | 0.5408 |
| מגנזיום | −0.10 (−0.52, 0.37) | −0.10 (−0.52, 0.37) | −0.10 (−0.52, 0.37) | −0.09 (−0.50, 0.37) | 0.7797 |
| תאי דם לבנים | −0.16 (−0.47, 0.21) | −0.16 (−0.47, 0.20) | −0.15 (−0.48, 0.25) | −0.16 (−0.46, 0.20) | 0.6856 |
| מעבר אניון | −0.12 (−0.64, 0.45) | −0.13 (−0.64, 0.45) | −0.07 (−0.61, 0.48) | −0.13 (−0.64, 0.45) | 0.1217 |
| קריאטינין | −0.30 (−0.48, 0.01) | −0.30 (−0.48, 0.01) | −0.30 (−0.46, 0.01) | −0.30 (−0.48, −0.00) | 0.3323 |
| MCH | 0.11 (−0.48, 0.62) | 0.12 (−0.48, 0.62) | 0.11 (−0.47, 0.62) | 0.09 (−0.48, 0.61) | 0.5195 |
| ספירת טסיות | −0.09 (−0.61, 0.49) | −0.09 (−0.61, 0.49) | −0.08 (−0.62, 0.47) | −0.10 (−0.62, 0.48) | 0.9709 |
| MCHC | −0.00 (−0.59, 0.59) | −0.00 (−0.60, 0.59) | −0.00 (−0.57, 0.58) | 0.00 (−0.57, 0.60) | 0.9263 |
| כלוריד | 0.05 (−0.54, 0.64) | 0.05 (−0.52, 0.65) | 0.03 (−0.59, 0.62) | 0.07 (−0.52, 0.62) | 0.4675 |
| אשלגן | −0.07 (−0.67, 0.53) | −0.09 (−0.67, 0.53) | −0.07 (−0.67, 0.53) | −0.07 (−0.62, 0.53) | 0.3071 |
| נתרן | 0.05 (−0.56, 0.60) | 0.05 (−0.55, 0.60) | −0.00 (−0.60, 0.60) | 0.07 (−0.57, 0.61) | 0.3492 |
| חנקן אוריאה | −0.28 (−0.60, 0.29) | −0.28 (−0.60, 0.29) | −0.26 (−0.59, 0.31) | −0.28 (−0.59, 0.25) | 0.6826 |
| סך הסידן | 0.02 (−0.61, 0.59) | 0.02 (−0.61, 0.59) | −0.01 (−0.59, 0.56) | 0.01 (−0.61, 0.60) | 0.8203 |
טבלה 1. מאפייני בסיס ותכונות מהונדסות של קבוצת המחקר. משתנים קטגוריים מוצגים כ-n (%). משתנים רציפים מוצגים כחציון (טווח בין-רבעוני) של ערכים סטנדרטיים. ערכי P חושבו כדי להשוות התפלגויות בין מערכות האימון, האימות והבדיקות באמצעות מבחנים סטטיסטיים מתאימים.
משתנים רציפים עם מדידות חוזרות אוגדו באמצעות הממוצע האריתמטי בתוך כל חלון התצפית בטיפול נמרץ כדי לקבל וקטור תכונה יחיד לכל מטופל. משתנים עם שיעור היעדרות העולה על 30% הוצאו. עבור המשתנים המספריים הנותרים, ערכים חסרים הועברו באמצעות אלגוריתם K-Nearest Neighbors (KNN) (n_neighbors = 5, משקלים = 'אחידים'). משתנים קטגוריים הועברו באמצעות הקטגוריה השכיחה ביותר ולאחר מכן הועברו לשינוי באמצעות מיפוי בינארי, כאשר כל קטגוריה שלא נראית קיבלו וקטור של אפסים.
משתנים רציפים תוקנו באמצעות נוסחת קנה המידה של ציון z (). תכונות עם אפס שונות הוסרו במפורש לפני הסקיילינג. כל פרמטרי הקדם-עיבוד (μ ו-σ.) הוערכו אך ורק על סט האימון והוחלו בעקביות על מערכות האימות והבדיקה.
בהינתן חוסר האיזון החמור בין המחלקות (3,672 לעומת 42,554), שימשה אסטרטגיית איזון היברידית אך ורק על נתוני האימון כדי למנוע ניפוח הערכות ביצועים. ראשית, נעשה שימוש בדגימה תת-אקראית כדי להפחית את רוב הקטגוריה השלילית ולהשיג יחס של 1:2 (חיובי-שלילי) (הניב 7,344 דגימות שליליות). לאחר מכן, טכניקת דגימת היתר של מיעוט סינתטי (SMOTE) יושמה על המחלקה החיובית כדי להשיג יחס מאוזן סופי של 1:1 (7,344 לעומת 7,344)8.
לבסוף, הקבוצה חולקה ברמת המטופל לקבוצות הכשרה (65%), אימות (15%) ובדיקות (20%) באמצעות דגימה שכבתית. כדי לשלוט בקפדנות בכל התהליכים האקראיים בכל סוגי ההשערה, האיזון והפיצול, הוטל זרע אקראי גלובלי (random_state = 42).
ארכיטקטורת מודלים
כדי לזהות את המודל החיזוי המתאים ביותר לסיכון OP בחולי סוכרת, נעשה שימוש במסגרת השוואות בקנה מידה רחב להשוואת 70 וריאנטים של אלגוריתם ML תחת פרוטוקול ייצוג והערכה זהה. משפחות המודלים המועמדות כללו מסווגים ליניאריים רגולריזציה, מכונות וקטוריות תמיכה (SVMs), kNN, אנסמבלים של עצים, ארכיטקטורות הגברת גרדיאנט, ופרספטרונים רב-שכבתיים 9,10,11,12,13,14,15,16,17.
במקום שימוש בחיפוש רשת מסורתי, אופטימיזציה של היפרפרמטרים בוצעה על ידי הערכת תצורות מוגדרות מראש וחזקות לאורך 70 וריאנטים אלו של מודלים בחלוקת האימון. הבחירה התבססה אך ורק על מקסום השטח מתחת לעקומת מאפיין הפעולה של המקלט (ROC) (AUC) בקבוצת האישור. המודל הסופי עם הביצועים הטובים ביותר הוגדר עם n_estimators = 200, כאשר פרמטרים אחרים נשארו בהגדרות ברירת המחדל של חבילת התוכנה המופיעה בטבלת החומרים. מדדי הערכה, כולל AUC, דיוק, ציון F1, דיוק וזיכרון, חושבו באמצעות סף הסתברות ברירת מחדל של 0.5.
כדי לתמוך בשקיפות קלינית, SHAP יושם על המודל הנבחר באמצעות שיטת TreeExplainer. בהינתן האופי המבוסס על עץ של המודל הסופי, נעשה שימוש בערכים צפויים תלויי מסלול עץ בדיוק כתצורת הרקע.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
השוואת ביצועי מודלים
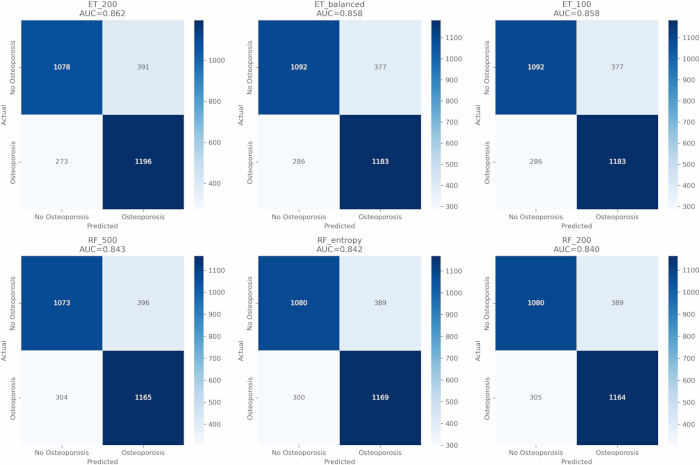
כדי לזהות את הגישה החיזוי האופטימלית ל-OP אצל חולי סוכרת, הושוו באופן שיטתי מספר מודלים של למידת מכונה שונים. מסווג ליניארי מסודר (רגרסיה לוגיסטית) נכלל כמודל בקרה בסיסי. השוואת הביצועים הכוללת מסוכמת באיורים 3–6. בכל המודלים שהוערכו, שיטות מבוססות עץ קבוצתי עלו על קו הבסיס הליניארי מבחינת ביצועים מובחנים.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
במחקר זה, מספר אלגוריתמים של למידת מכונה הושוו באופן שיטתי כדי לזהות מודל חיזוי אופטימלי ל-OP בקרב חולי סוכרת. שיטות מבוססות עצי אנסמבל, במיוחד מודל ExtraTree, הראו שיפור בהבחנה, כיול הסתברות אמין ותועלת קלינית נטו גבוהה יותר בהשוואה לקווי בסיס ליניאריים ולמשפחות אלגוריתמים אחרות. ממצאים אלו מצביעים על כך שאינטראקציות לא ליניאריות ויחסי תכונות מורכבות חשובים ללכידה מדויקת של סיכון OP באוכלוסיות סוכרתיות.
כדי לשפר את השקיפות הקלינית, שימשו SHAP לפרשנות המודל הנ...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
המחברים מצהירים כי המחקר נערך בהיעדר קשרים מסחריים או פיננסיים שיכולים להיחשב כניגוד עניינים פוטנציאלי.
תודות
המחברים מודים בהכרת תודה על התמיכה הכספית מפרויקט המדע והטכנולוגיה העירוני של ננטונג (מענק מס' JC2023039) ותוכנית ההכוונה לפיתוח חברתי של לשכת המדע והטכנולוגיה של ננטונג (מענק מס' MSZ2023054).
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| CatBoost | Yandex | v1.2 (או רלוונטי) | אלגוריתם בווסטינג משולב מותאם למאפיינים קטגוריים |
| imbalanced-learn (SMOTE) | Scikit-learn Contrib | v0.11 (או רלוונטי) | ספריה המשמשת לביצוע טכניקת Over-sampling סינתטית של מיעוט לאיזון מחלקות |
| LightGBM | Microsoft Corporation | v4.0 (או רלוונטי) | מסגרת בווסטינג משולב המבוססת על עצי החלטה |
| Matplotlib | Matplotlib Development Team | v3.7 (או רלוונטי) | ספריית הדמיה המשמשת לשרטוט איור וגרפי ביצוע |
| MIMIC-IV Clinical Database | PhysioNet | v3.1 | מקור נתונים של רשומות בריאות אלקטרוניות זמין לציבור לטיפול נמרץ המשמש כמקור נתונים |
| Navicat Premium | PremiumSoft CyberTech Ltd. | v17.0 | כלי ניהול מסד נתונים המשמש לחילוץ נתונים מבוסס SQL |
| NumPy | NumPy Developers | v1.24 (או רלוונטי) | ספריית מחשוב מספרי המשמשת לפעולות מערכים ועיבוד נתונים |
| OpenPyXL | Eric Gazoni, Charlie Clark | v3.1 (או רלוונטי) | ספריה המשמשת לקריאה וכתיבה של קבצי Excel |
| Pandas | Pandas Development Team | v2.0 (או רלוונטי) | ספריית מניפולציה וניתוח נתונים עבור מערכי נתונים מובנים |
| PostgreSQL | PostgreSQL Global Development Group | v14 (או רלוונטי) | מערכת מסד נתונים רלציונית המשמשת לשאילתה וניהול נתוני MIMIC-IV |
| Python | Python Software Foundation | v3.8+ (או רלוונטי) | שפת תכנות המשמשת לעיבוד נתונים, מידול וניתוח |
| Scikit-learn | Scikit-learn Developers | v1.3 (או רלוונטי) | ספריית למידת מכונה המשמשת לפיתוח מודל, עיבוד מוקדם וערכה |
| SciPy | SciPy Developers | v1.10 (או רלוונטי) | ספריית חישוב מדעי המשמשת לניתוח סטטיסטי |
| Seaborn | Michael Waskom | v0.12 (או רלוונטי) | ספריית הדמיה נתונים סטטיסטית לתפוקות גרפיות משופרות |
| SHAP (SHapley Additive exPlanations) | Scott Lundberg | v0.42 (או רלוונטי) | מסגרת המשמשת לפרשנות תחזיות מודל באמצעות ערכי ייחוס תכונות |
| XGBoost | DMLC (Distributed Machine Learning Community) | v2.0 (או רלוונטי) | אלגוריתם בווסטינג משולב המשמש באופן נרחב למידול נתונים מובנים |