本プロトコルは、日常的に収集される臨床データを用いて、糖尿病患者の骨粗鬆症リスクを予測するための解釈可能なアンサンブルツリーベース機械学習モデルの開発と評価を説明しています。
このコンテンツを表示するには、JoVEへの購読が必要です。 または、無料トライアルをお申し込みください。
この記事について
サマリー
要約
糖尿病は骨格の脆弱性の増加と骨折リスクの増加と関連しています。しかし、糖尿病患者における骨粗鬆症(OP)の早期発見は依然として困難です。本研究は、糖尿病患者のOPを予測するための複数の機械学習(ML)モデルを開発・比較し、その臨床的有用性を評価し、SHapley加法説明(SHAP)を用いてモデルの透明性を高めることを目的としています。MIMIC-IVデータベースから通常収集された人口統計および実験室データを用いて、ツリーアンサンブル、勾配ブースティング、線形ベースラインを含む複数のMLアルゴリズムを訓練・検証しました。モデルの性能は、受信者動作特性曲線(AUC)下面積、精度・リコール解析、さらに確率較正曲線および意思決定曲線解析(DCA)を用いた識別指標を用いて包括的に評価され、純臨床的利益を評価しました。最も性能の良いモデルは、SHAPを用いて、全体レベルおよび個別レベルでの特徴寄与を定量化・可視化するためにさらに解釈されました。評価されたすべてのモデルの中で、アンサンブルツリーベースの手法は性能の向上を示しました。ExtraTrees分類器は最高の検証性能を達成しました(AUC = 0.862;平均精度=0.866)。さらに、選定モデルは優れた確率校正(Brierスコア=0.154)を示し、DCAの幅広いリスク閾値で顕著な純臨床的利益を示しました。SHAP分析では、性別と年齢が最も影響力のある予測因子であり、その次に定期的な血液学的および代謝検査の指標が挙げられました。局所的な説明は、個々の予測について臨床的に解釈可能な洞察を提供しました。解釈可能なアンサンブルツリーベースモデルは、日常的に利用可能な臨床変数を用いて糖尿病患者のOPリスクを効果的に予測します。SHAPの統合により臨床的透明性が向上し、強力な校正と正の臨床利益が、糖尿病集団における早期OPリスク層別化の信頼できる意思決定支援ツールとしての導入を支持します。
概要
糖尿病と骨粗鬆症(OP)は非常に一般的な慢性疾患であり、ますます共存しており、脆弱性骨折、障害、医療費などの大きな負担となっています。2型糖尿病(T2D)患者では、デュアルエネルギーX線吸収計(DXA)で測定される面的骨密度(BMD)が保持または予想より高くなっても、骨折リスクは逆説的に上昇しており、骨の「質」や全身代謝因子が骨格の脆弱性に大きく寄与していることを示しています1,2。DXAはOP診断の臨床標準であるにもかかわらず、多くの場面でその利用や利用が限られており、DXAベースの評価は糖尿病関連の骨格リスクを過小評価する恐れがあります。集団レベルでは、メタ分析的証拠によりOPは糖尿病患者の間で一般的であることが示唆されていますが、有病率の推定値はコホートや臨床文脈によって異なります。3.したがって、日常的に収集される臨床データを活用して高リスク患者を早期に特定し、標的を絞ったスクリーニングや個別化された予防戦略を導く実用的で拡張可能なリスク予測ツールの開発には、臨床的な必要性と強い動機があります。
近年、機械学習(ML)手法は、臨床データにおける複雑で非線形な関係性のモデル化や、糖尿病患者のOPリスク予測因子の構築にますます活用されています。これまでの研究では、勾配ブースティング、サポートベクターマシン、ニューラルネットワーク、ノモグラムスタイルのツールなどのアルゴリズムを用いた有望な識別が示されています。特に、最近の進展では、機械学習とファジィ論理の融合など、修正可能な因子4,5,6に基づいてOPおよび糖尿病関連リスクを予測する革新的なモデリング戦略が探求されています。しかし、多くの既存のモデルは、閉経後の女性や高齢のT2D患者など限定的なサブグループで開発され、候補アルゴリズムのセット内で評価されていたため、より広範な糖尿病集団や異質な電子カルテ(EHR)データに最適なモデル選択について不確実性が生じています。さらに、これらの高性能機器学習モデルの臨床採用における重大な障壁は「ブラックボックス」的な性質であり、臨床医の信頼を制限し、実行可能な意思決定支援への翻訳を妨げています。SHapley加法説明(SHAP)は、症例レベルの説明を提供し、各予測をシェイプリー値で個別の特徴に帰属させることで、臨床医がモデルの推論が臨床的妥当性に合致しているかを検証できるようにします。
これらのギャップを補うため、私たちはMedical Information Mart for Intensive Care IV(MIMIC-IV)の重症診療EHRデータベースを用いて、糖尿病患者向けのOPリスク予測フレームワークを開発・検証しました7。本研究の新規性は、複数のMLモデルファミリーにわたる包括的なベンチマーキングと、大規模で臨床的に複雑な糖尿病コホート内での透明なSHAPベースの解釈可能性にあります。単一のアルゴリズムに焦点を当てた研究とは異なり、当社のエンドツーエンドアプローチは厳密な検証に基づき最も性能の高いモデルを体系的に選定し、透明で患者レベルの説明を提供します。このフレームワークは、強固な予測性能と臨床的に実行可能な洞察を提供し、糖尿病患者におけるOPのリスク階層化を早期に支援することを目指しています。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
プロトコル
データソースと倫理声明
この回顧的研究は、PhysioNet上でホストされている公開された非識別化の集中治療EHRデータベースMIMIC-IV(バージョン3.1)のデータを用いました。このデータベースには、人口統計情報、バイタルサイン、検査結果、診断、処置、薬剤が含まれています。
MIMIC-IVへのアクセスには、資格取得済みの承認とPhysioNetのデータ使用契約およびトレーニング要件の遵守が必要です。調査員は必要な訓練を修了し、アクセス権(証明書番号:68351548)を授与されました。データベースが非識別化されているため、本研究は匿名化されたデータを分析し、患者との直接接触は含みませんでした。したがって、インフォームド・コンセントは必要ありませんでした。完全なステップバイステップの実行可能モデリングワークフローは 図1に示されています。
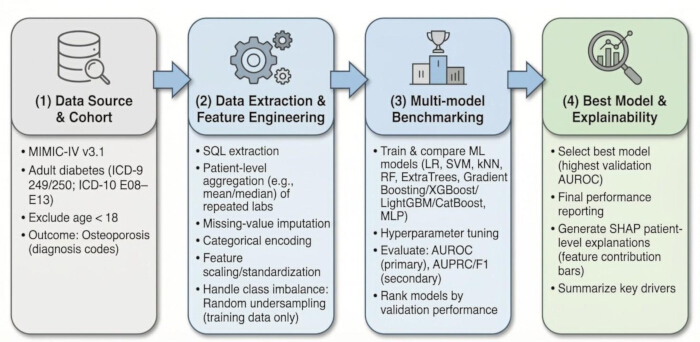
図1。糖尿病患者における骨粗鬆症(OP)リスク予測の全体モデリングワークフロー。 研究パイプラインの概略的表現、コホートの特定、データ抽出、特徴工学、マルチモデルベンチマーキング、検証性能に基づくモデル選択、最終モデルのSHAPベースの解釈可能性などが含まれます。 この図の拡大版はこちらをクリックしてご覧ください。
研究対象集団とデータ抽出
データは、データベース管理ツールを用いて、Medical Information Mart(MIMIC-IV)データベースから抽出されました。再現性を確保するため、テーブル名やコホート検索に用いるフィルタリングロジックを含む正確なSQLクエリが補 足ファイル1に記載されています。糖尿病と診断された成人患者(≥18歳)は、ICD-9コード(249,250)およびICD-10コード(E08–E13)を用いて識別されました。主要アウトカムOPは、ICD-9コード(733.x)およびICD-10コード(M80、M81、M82)を用いて定義されました。初期の適格な糖尿病コホート(n = 46,226)では、3,672件の陽性事象(OP患者)および42,554件の陰性事象(非OP患者)が確認されました。詳細な患者選択および離脱のフローチャートは 図2に示されています。
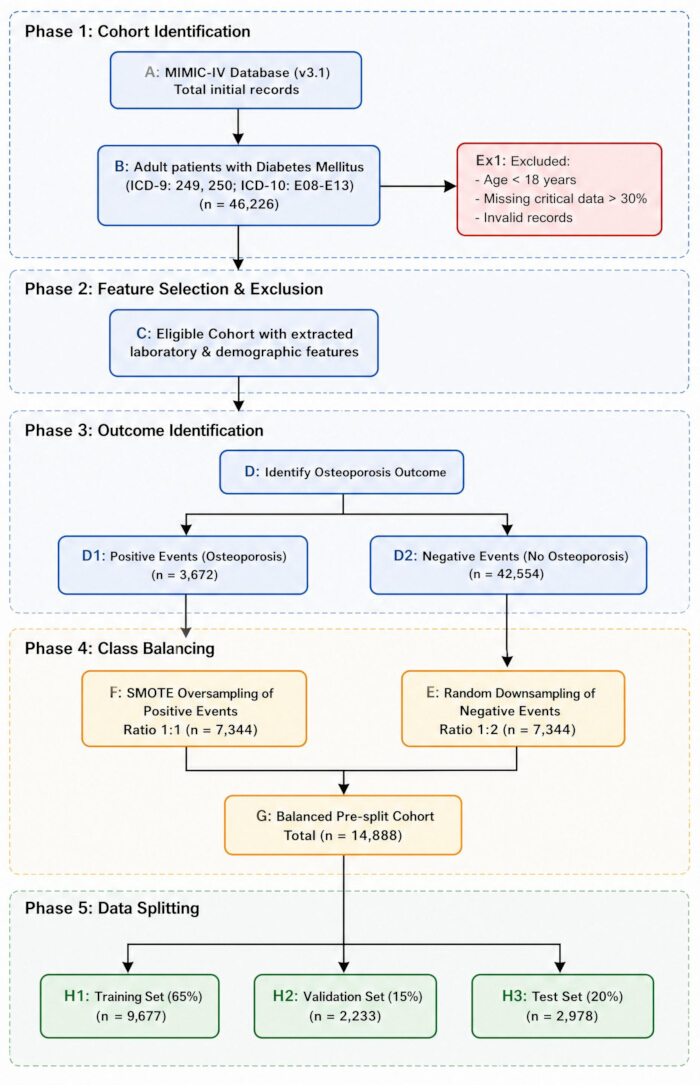
図2。患者選択およびコホート構築のフローチャート。 フローチャートはMIMIC-IV(v3.1)データベースからの段階的なコホート導出を示しています。成人糖尿病患者はICDコードを用いて特定され、その後、年齢および以下の患者は除外されました。lt;18年、重要なデータが欠落しているgt;30%か無効な記録。最終コホートはOP(ポジティブイベント)とノンOP(ネガティブイベント)に分けられました。クラス不均衡は、ランダムなアンダーサンプリングとSMOTEを用いて、層別化されたデータセット分割前に訓練データに適用しました。 この図の拡大版はこちらをクリックしてご覧ください。
特徴解析
複数のMLアルゴリズム間で公正なベンチマーキングと正確な再現性を確保するため、特徴選択、欠損値補完、連続特徴スケーリング、クラスバランシング、データセット分割といった同じ前処理ステップの順序が適用されました。変数名、単位、データソースを含む入力特徴の全リストは表 1に詳述されています。
| 特徴 | 合計 (n = 14,688) | トレーニングセット (n = 9,546) | 検証セット (n = 2,204) | テストセット (n = 2,938) | P値 |
| 性別 | 0.345 | ||||
| 男性 | 6222 (42.36%) | 4045 (42.37%) | 935 (42.42%) | 1242 (42.27%) | |
| 女性 | 8466 (57.64%) | 5501 (57.63%) | 1269 (57.58%) | 1696 (57.73%) | |
| 年代 | 0.28(−0.40, 0.94) | 0.28(−0.43, 0.94) | 0.23(−0.46, 0.89) | 0.28(−0.39, 0.95) | 0.1655 |
| 赤血球 | −0.14(−0.79, 0.49) | −0.13(−0.79, 0.49) | −0.17(−0.83, 0.48) | −0.14(−0.76, 0.49) | 0.3641 |
| ヘマトクリット | −0.14(−0.81, 0.52) | −0.13(−0.80, 0.52) | −0.14(−0.87, 0.51) | −0.16(−0.81, 0.52) | 0.3709 |
| ヘモグロビン | −0.12(−0.79, 0.52) | −0.12(−0.79, 0.51) | −0.15(−0.86, 0.53) | −0.13(−0.78, 0.52) | 0.3616 |
| RDW | −0.16(−0.59, 0.45) | −0.17(−0.59, 0.46) | −0.14(−0.59, 0.45) | −0.17(−0.60, 0.42) | 0.5803 |
| リン酸塩 | −0.14(−0.60, 0.38) | −0.15(−0.61, 0.38) | −0.11(−0.57, 0.38) | −0.13(−0.56, 0.34) | 0.415 |
| MCV | 0.05(−0.50, 0.63) | 0.06(−0.50, 0.65) | 0.03(−0.49, 0.65) | 0.02(−0.50, 0.59) | 0.5408 |
| マグネシウム | −0.10(−0.52, 0.37) | −0.10(−0.52, 0.37) | −0.10(−0.52, 0.37) | −0.09(−0.50, 0.37) | 0.7797 |
| 白血球 | −0.16(−0.47, 0.21) | −0.16(−0.47, 0.20) | −0.15(−0.48, 0.25) | −0.16(−0.46, 0.20) | 0.6856 |
| アニオンギャップ | −0.12(−0.64, 0.45) | −0.13(−0.64, 0.45) | −0.07(−0.61, 0.48) | −0.13(−0.64, 0.45) | 0.1217 |
| クレアチニン | −0.30(−0.48, 0.01) | −0.30(−0.48, 0.01) | −0.30(−0.46, 0.01) | −0.30(−0.48, −0.00) | 0.3323 |
| MCH | 0.11(−0.48, 0.62) | 0.12(−0.48, 0.62) | 0.11(−0.47, 0.62) | 0.09(−0.48, 0.61) | 0.5195 |
| 血小板数 | −0.09(−0.61, 0.49) | −0.09(−0.61, 0.49) | −0.08(−0.62, 0.47) | −0.10(−0.62, 0.48) | 0.9709 |
| MCHC | −0.00(−0.59, 0.59) | −0.00(−0.60, 0.59) | −0.00(−0.57, 0.58) | 0.00(−0.57, 0.60) | 0.9263 |
| 塩化物 | 0.05(−0.54, 0.64) | 0.05(−0.52, 0.65) | 0.03(−0.59, 0.62) | 0.07(−0.52, 0.62) | 0.4675 |
| カリウム | −0.07(−0.67, 0.53) | −0.09(−0.67, 0.53) | −0.07(−0.67, 0.53) | −0.07(−0.62, 0.53) | 0.3071 |
| ナトリウム | 0.05(−0.56, 0.60) | 0.05(−0.55, 0.60) | −0.00(−0.60, 0.60) | 0.07(−0.57, 0.61) | 0.3492 |
| 尿素窒素 | −0.28(−0.60, 0.29) | −0.28(−0.60, 0.29) | −0.26(−0.59, 0.31) | −0.28(−0.59, 0.25) | 0.6826 |
| 総カルシウム | 0.02(−0.61, 0.59) | 0.02(−0.61, 0.59) | −0.01(−0.59, 0.56) | 0.01(−0.61, 0.60) | 0.8203 |
表1。研究コホートの基準特性および人工的特徴。カテゴリ変数はn(%)で表されます。連続変数は標準化された値の中央値(四分位範囲)として提示されます。適切な統計検定を用いて、訓練、検証、テストセット間の分布を比較するためにP値を計算しました。
繰り返し測定された連続変数は、ICU滞在期間の観察ウィンドウ全体内で算術平均を用いて集約し、患者ごとに単一の特徴ベクトルを算出しました。欠損率が30%を超える変数は除外しました。残りの数値変数については、K近傍法(KNN)アルゴリズム(n_neighbors = 5、重み=「一様」)を用いて欠損值を代帰しました。カテゴリ変数は最も頻繁なカテゴリを用いて帰帰り付け、その後二値写像で変換され、見えないカテゴリにはゼロのベクトルが割り当てられました。
連続変数はzスコアスケーリング式()を用いて標準化されました。分散ゼロの特徴はスケーリング前に明示的に除去されました。すべての前処理パラメータ(μおよびσ)は訓練セット上で厳密に推定され、検証セットおよびテストセットに一貫して適用されました。
深刻なクラスの不均衡(3,672人対42,554人)を考慮し、パフォーマンス推定値の過大化を避けるため、トレーニングデータにのみハイブリッドバランス戦略が適用されました。まず、ランダムアンダーサンプリングを用いて過半数の否定クラスを1:2(正:負)比率に落とし、7,344件の陰性サンプルを得ました。次に、合成少数派過量サンプリング技術(SMOTE)を正のクラスに適用し、最終的な1:1のバランス比(7,344対7,344)を達成しました8。
最後に、コホートは患者レベルでトレーニング(65%)、検証(15%)、テスト(20%)に分けられ、層別抽出を用いました。補完、バランス、分割のすべてのランダム過程を厳密に制御するために、グローバルランダムシード(random_state = 42)が強制されました。
モデルアーキテクチャ
糖尿病患者におけるOPリスクの最適な予測モデルを特定するため、大規模なベンチマーキングフレームワークを用いて、同一のデータ表現と評価プロトコルの下で70のMLアルゴリズムバリアントを比較しました。候補モデルファミリーには、正則化された線形分類器、サポートベクターマシン(SVM)、kNN、ツリーアンサンブル、勾配ブースティングアーキテクチャ、そして多層パーセプトロン9,10,11,12,13,14,15,16,17が含まれていました。
従来のグリッド探索を用いる代わりに、これら70のモデルバリアントに対する事前定義された堅牢な構成を評価することでハイパーパラメータ最適化が行われました。選択は検証セット上の受信機動作特性(ROC)曲線(AUC)下面積を最大化することに厳密に基づいていました。最終的に最も性能の良いモデルはn_estimators = 200に設定され、その他のパラメータは 材料表に記載されたソフトウェアパッケージのデフォルト設定のまま設定されました。評価指標(AUC)、精度、F1スコア、正確さ、想起率などの指標は、デフォルトの0.5確率閾値を用いて算出されました。
臨床的透明性を支持するため、TreeExplainer手法を用いて選択モデルにSHAPを適用しました。最終モデルの木構造構造を踏まえ、正確な木経路依存の期待値が背景構成として用いられました。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
結果
モデル性能比較
糖尿病患者におけるOPの最適な予測アプローチを特定するため、複数のMLモデルを体系的に比較しました。基準制御モデルとして正則化された線形分類器(ロジスティック回帰)が含まれていました。全体的な性能比較は 図3–6にまとめられています。評価されたすべてのモデルにおいて、アンサンブルツリーベースの手法は判別性能の面で線形ベースラインを上回る成果を示しました。
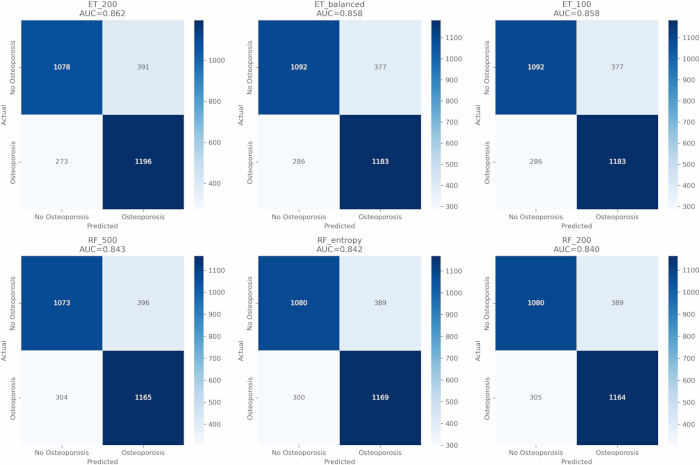
図3。トップパフォーマンスモデルの混乱行列。 検証セット上で評価された代表モデルの混同行列(ET_200、ET_balanced、ET_100、RF_500、RF_entropy、RF_200が含まれます。各行列は真...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
ディスカッション
本研究では、複数のMLアルゴリズムを体系的に比較し、糖尿病患者のOPに対する最適な予測モデルを特定しました。特にExtraTreesモデルを用いたアンサンブルツリー手法は、線形ベースラインや他のアルゴリズムファミリーと比較して識別力の向上、信頼性の高い確率キャリブレーション、そして臨床的利益の拡大を示しました。これらの発見は、非線形相互作用と複雑な特徴関係が糖尿病集団におけるOPリスクを正確に捉える上で重要であることを示しています。
臨床的透明性を高めるため、選択されたモデルの解釈にSHAPを適用しました。分析では、性別と年齢が最も影響力のある予測因子であると特定し、加わったことやホルモン変化(例:エストロゲン欠乏や相対的低性腺機能)が骨の微小構造の劣化に結びついているという確立された生物学的証拠と一致しています。人口統計学的要因に加え、血液学的指標(例:ヘモグロビンや赤血球分布幅)や定期的な代謝化学指標もリスク予測に寄与しました。これらのマーカーは、慢性炎症、腎機能障害、酸塩基バランスの乱れといった累積的な生理的...
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
開示事項
著者らは、この研究は潜在的な利益相反と解釈される可能性のある商業的または財務的関係が一切ない状態で行われたと述べています。
謝辞
著者らは南通市科学技術プロジェクト(助成金番号)からの財政支援に感謝の意を表します。 JC2023039)南通科学技術局の社会開発指導プログラム(助成金番号) MSZ2023054)。
アクセスが制限されています。このコンテンツを表示するにはログインするか、トライアルを開始してください。
材料
```html
```
| 名前 | 会社 | カタログ番号 | コメント |
|---|---|---|---|
| CatBoost | Yandex | v1.2(または該当するバージョン) | カテゴリカル特徴に最適化されたグラディエントブースティングアルゴリズム |
| imbalanced-learn(SMOTE) | Scikit-learn Contrib | v0.11(または該当するバージョン) | クラスの調整に使用される合成少数超サンプリング技術を実行するために使用されるライブラリ |
| LightGBM | Microsoft Corporation | v4.0(または該当するバージョン) | 決定木に基づくグラディエントブースティングフレームワーク |
| Matplotlib | Matplotlib Development Team | v3.7(または該当するバージョン) | 図や性能曲線を描画するために使用される可視化ライブラリ |
| MIMIC-IV Clinical Database | PhysioNet | v3.1 | データソースとして使用される公開されている重症患者電子健康記録データセット |
| Navicat Premium | PremiumSoft CyberTech Ltd. | v17.0 | SQLベースのデータ抽出に使用されるデータベース管理ツール |
| NumPy | NumPy Developers | v1.24(または該当するバージョン) | 配列操作とデータ処理に使用される数値計算ライブラリ |
| OpenPyXL | Eric Gazoni, Charlie Clark | v3.1(または該当するバージョン) | Excelファイルの読み書きに使用されるライブラリ |
| Pandas | Pandas Development Team | v2.0(または該当するバージョン) | 構造化データセットのデータ操作と分析に使用されるライブラリ |
| PostgreSQL | PostgreSQL Global Development Group | v14(または該当するバージョン) | MIMIC-IVデータの照会と管理に使用される関係データベースシステム |
| Python | Python Software Foundation | v3.8+(または該当するバージョン) | データ処理、モデリング、分析に使用されるプログラミング言語 |
| Scikit-learn | Scikit-learn Developers | v1.3(または該当するバージョン) | モデル開発、前処理、評価に使用される機械学習ライブラリ |
| SciPy | SciPy Developers | v1.10(または該当するバージョン) | 統計分析に使用される科学計算ライブラリ |
| Seaborn | Michael Waskom | v0.12(または該当するバージョン) | 強化されたグラフィカル出力のための統計データ可視化ライブラリ |
| SHAP(SHapley Additive exPlanations) | Scott Lundberg | v0.42(または該当するバージョン) | 特徴帰属値を使用してモデル予測を解釈するために使用されるフレームワーク |
| XGBoost | DMLC(Distributed Machine Learning Community) | v2.0(または該当するバージョン) | 構造化データモデリングに広く使用されているグラディエントブースティングアルゴリズム |