유전자 리포터 분석은 DNA 염기서열과 유전자 조절 활동 사이의 관계를 해부하기 위한 잘 정립되고 강력한 도구입니다. 후보 조절 요소를 식별 염기서열 태그를 운반하는 리포터 유전자에 결합하면 이러한 분석의 대규모 병렬화가 가능합니다.
이 논문에서
정오 공지
Important: There has been an erratum issued for this article. View Erratum Notice
요약
초록
유전자 리포터 분석은 DNA 염기서열과 유전자 조절 활동 사이의 관계를 해부하기 위한 잘 정립되고 강력한 도구입니다. 그러나 이 분석의 잠재적 처리량은 단백질 형광 또는 효소 활성을 조절 활성의 대용물로 사용하여 관심 있는 각 염기서열의 활성을 개별적으로 복제하고 분석해야 하는 필요성에 의해 제한되었습니다. 최근 high-throughput DNA synthesis 및 sequencing 기술의 발전으로 인해 reporter constructs의 대규모 라이브러리의 구성 및 심문을 다중화하여 이러한 한계를 극복할 수 있게 되었습니다. 이 프로토콜은 단일 세포 배양 접시에서 수십만 개의 추정 조절 서열을 직접 비교할 수 있는 MPRA(Massively Parallel Reporter Assay)의 구현을 설명합니다.
서론
대규모 병렬 리포터 분석 실험은 (MPRA)는 DNA 서열 1 (7)을 수천 수백 수천의 전사 규제 활동의 다중 측정을 할 수 있습니다. 자신의 가장 일반적인 실시 예에서, 다중화는 오픈 리딩 프레임의 하류 서열 식별 태그가 포함되어 합성 리포터 유전자를 관심있는 각각의 시퀀스를 연결함으로써 달성된다 (ORF를,도 1). 형질 감염, RNA 분리 및 리포터 유전자 전 사체의 3 '말단의 깊이 순서화에 따라, 결합 된 서열의 상대적인 활동은 식별 태그의 상대적인 풍부로부터 추론 될 수있다.

MPRA의 그림 1 개요. MPRA 기자의 라이브러리는 합성으로 추정 조절 서열을 결합하여 구성되어 구축서열 식별 태그 뒤에 (예로서 루시페라아제 또는 GFP) "불활성"ORF로 구성 리포터 유전자. 도서관은 배양 된 세포의 인구에 대거 형질 전환하고, 전사 리포터 mRNA를 연속적으로 회수한다. 깊은 순서는 기자의 mRNA와 형질 전환 된 플라스미드 중 각 태그의 발생 수를 계산하는 데 사용됩니다. 플라스미드 카운트 대응하는 조절 서열의 활성을 추정하는 데 사용될 수있는 동안의 mRNA의 비를 계산. 멜린 니코의 허가를 적응, 등 2.
MPRA은 관심 궤적 걸쳐 신규 조절 요소에 대해 개별 유전자 조절 요소는 1) 광범위한 돌연변이 유발, 2) 주사를 포함하여, 실험 다양한 설계에 적용 할 수 있으며, 3) 추정의 세트 천연 유전 적 변이의 효과를 테스트 프로모터, 인핸서 또는 소음기, 합성 규제 요소 사) 반 합리적인 엔지니어링. 리시퀀스 변종 braries은 퇴화 올리고 1,4, 조합 결찰 8 게놈 DNA 5의 조각화 올리고 뉴클레오티드 라이브러리 프로그램 마이크로 어레이 2,3,6,7-에 합성 (OLS), 조립 등 다양한 방법을 사용하여 생성 할 수 있습니다.
이 프로토콜은 프로모터의 라이브러리의 구조를 설명 변종 OLS와 pMPRA1 및 pMPRAdonor1 벡터 (각각 Addgene ID를 49349 및 49352; http://www.addgene.org)를 사용하여, 배양 된 포유류 세포 및 후속 정량에이 라이브러리의 일시 발현을 관련 태그의 깊은 시퀀싱 (태그-SEQ)에 의해 프로모터 활동. 이 프로토콜의 이전 버전 (2013) 연구 23, 800-811 멜린 니코 등. 자연 생명 공학 30, 271-277 (2012)과 Kheradpour 등. 게놈에보고 된 연구에 사용되었다.
프로토콜
1 시퀀스 설계 및 합성
- 시퀀스의 설계 및 합성에 MPRA 시작은 규제 활동을 분석합니다. pMPRA 벡터 시리즈와의 호환성을 위해 다음과 같은 템플릿을 사용하여 각 시퀀스를 설계 : 5'-ACTGGCCGCTTCACTG- var에 -GGTACCTCTAGA- 태그 -AGATCGGAAGAGCGTCG-3 var에 정량 할 수있는 순서를 나타내며, 태그는 하나 이상의 식별 태그를 의미한다 '.
- 이 가변 영역 (VAR 및 태그) 사이 리포터 유전자 단편의 방향을 용이하게 결찰를 KpnI (GGTACC)과를 XbaI (TCTAGA) 제한 부위의 쌍에 의해 분리된다. 또한, 두 가지 SfiI (GGCCNNNNNGGCC) 사이트는 pMPRA 백본으로 방향 결찰 할 수 있도록 PCR에 의해 추가됩니다. 변수 영역이 제한 부위의 사본을 추가로 포함 할 수 없습니다. 필요한 경우, 이들 제한 효소 중 하나 이상을 대체 할 수있다만큼 대체품으로서 1) 주변 DNA 분자의 말단에 효율적인 절단을 허용하고, 2) 벡터 시퀀스의 다른 곳에서 절단되지 않는다. 자세한 내용에 대한 설명을 참조하십시오.
- 상용 공급 업체에서 표 1에 필요한 프라이머를 얻습니다.
| MPRA_SfiI_F | GCTAAGGGCCTAACTGGCCGCTTCACTG |
| MPRA_SfiI_R | GTTTAAGGCCTCCGTGGCCGACGCTCTTC |
| TAGseq_P1 | AATGATACGGCGACCACCGAGATCTACACT CTTTCCCTACACGACGCTCTTCCGATCT |
| TAGseq_P2 | CAAGCAGAAGACGGCATACGAGAT [인덱스] GT GACTGGAGTTCAGACGTGTGCTCTTCCGATCTCGAGG |
표 1 프라이머 서열. [색인] 다중화 시퀀싱에 사용될 6-8 NT 인덱스 시퀀스를 나타낸다. 다른 인덱스 적어도 8 TagSeq-P2 프라이머를 얻습니다. 모든프라이머의 HPLC 또는 PAGE로 정제해야한다.
- 올리고 뉴클레오티드 라이브러리는 상업적 공급 업체 또는 코어 설비로부터 얻어진, 또는 제조자에 의해 설명 된 바와 같이 프로그램 가능한 마이크로 어레이 계 올리고 뉴클레오티드 합성기를 사용하여 생성 될 수있다. 100 ㎕의 TE 0.1 버퍼에 OLS 제품을 재현 탁.
- 폴리 아크릴 아미드 겔을 변성 10 % TBE-우레아에 올리고 뉴클레오티드 라이브러리를 실행. 품질 (그림 2A)를 평가하는 ssDNA의 민감한 형광 얼룩 차선 얼룩 당 약 1 pmol의를 넣습니다.
- 전체 길이의 올리고 뉴클레오티드에 대응 이산 밴드 시각화 할 수있는 경우 (도 2a, 레인 1과 2), 대응 아크릴 아미드 겔 슬라이스를 절제하고 진탕하면서 실온에서 밤새 100 ㎕의 TE 0.1로 올리고 뉴클레오티드를 용출. 그렇지 않으면, 원시 OLS 서스펜션을 사용하여 진행합니다.
- PCR 증폭 9 에멀젼을 이용한 올리고 뉴클레오티드 라이브러리 SfiI 꼬리를 추가 > SUP.
- 표 2에 설명 된대로 50 ㎕의 PCR 반응 혼합물을 설정합니다. 다음 4 ℃에서 5 분 동안 300 ㎕의 Micellula DNA 에멀젼에서 오일과 계면 활성제 혼합물의 정제 키트와 소용돌이와 결합.
| 시약 | 1X 볼륨 (μL) |
| Herculase II 퓨전 DNA 중합 효소 | 0.5 |
| 5 배 Herculase II 반응 버퍼 | 10 |
| 의 dNTP (10 mM의 각) | 1.25 |
| BSA (20 ㎎ / ㎖) | 1.25 |
| 프라이머 MPRA_SfiI_F (25 μM) | 0.25 |
| 프라이머 MPRA_SfiI_R (25 μM) | 0.25 |
| OLS 템플릿 (1-10 attomol) | 변화 |
| 핵산 분해 효소가없는 물 | 50 |
- 생성물의 외관없이 증폭 생성물의 최대 수율을 제공 농도를 사용하여 (섹션 1.12 참조).
- PCR 튜브에 생성 된 에멀젼을 분배하고 95 ° C에서 (2 분 PCR의 20주기를 수행, 20 × 95 ° C에서 20 초, 55 ° C, 72 ° C에서 30 초에서 20 초], 95시 3 분 ° C).
- 풀 텍싱 간단히 1 ㎖의 이소 부탄올을 첨가하여 각각의 350 μL 에멀젼 PCR 반응을 중단 한 후 DNA 정제 컬럼을 사용하여 증폭 산물을 정제하고.
- 유물없는 증폭 (그림 2B)를 확인하기 위해 2 % 또는 4 % 아가로 오스 겔에 나누어를 실행합니다.

올리고 뉴클레오티드 합성 라이브러리의 그림 2 준비.) 세 가지 다른 원료 올리고 뉴클레오티드 합성 라이브러리 (OLS)은 10 % TBE-우레아 폴리 아크릴 아마이드 젤을 변성에서 실행됩니다. 전체 길이 올리고 뉴클레오티드 (*)에 해당하는 밴드 시각화 라이브러리 1에서 절제과 2 도서관 3 페이지 정화 방해 오염 물질을 포함 할 수 있습니다. 이러한 경우, 아가로 오스 겔상에서 동일한 올리고 뉴클레오티드 라이브러리 런의 개방 및 에멀젼 PCR 증폭 PCR 증폭. B)로 직접 이동 제품. 복잡한 올리고 뉴클레오티드 라이브러리의 PCR 증폭 자주 키메라 제품과 상한 및 하한 밴드로 나타날 수 있습니다 다른 아티팩트를 생성합니다. 에멀젼 PCR은 이러한 아티팩트를 최소화 할 수 있습니다.
2 라이브러리 생성
- , 1 % 아가 로스 겔상에서 실행 2 시간, 50 ° C에서 SfiI으로 분해 벡터 pMPRA1 의해 선형화 된 플라스미드 백본을 준비한다 (이 경우, 2.5 KB 단위) 백본 밴드를 절제하고, 겔 정제 스핀 컬럼을 사용하여 정제.
- 다이제스트2 시간 동안 50 ° C에서 SfiI와 단계 1.4에서 에멀젼 PCR 제품과는 DNA 정제 컬럼을 사용하여 정제.
- , 선형화 된 벡터 백본에 프로모터 태그 라이브러리를 결찰하기 위해 소화 PCR 제품의 100 NG, 선형화 된 벡터 백본 및 T4 DNA 리가 아제의 50 NG를 포함하는 반응을 설정합니다. 20 분 리가을 비활성화하는 65 ° C에서 다음 열을 16 ° C에서 밤새 품어.
- E. 변환 연결 반응으로 대장균. 라이브러리 복잡성을 유지하기 위해, 설계 라이브러리에있는 개별의 프로모터 태그 조합이보다 적어도 10 배 더 CFU를 획득하는 것을 목표로하고 있습니다.
- 태그의 총 개수가 약 10 인 경우, 타겟은 전형적으로 도서관 CFU 당 6-8 병렬 변환을 수행함으로써 달성 될 수있다.
- 각 변환의 경우, E. electrocompetent 50 μl를 결합 얼음에 결찰 믹스의 2 μL와 대장균 세포. 800 μL의 SOC에 세포를 전기 천공에 의해 변형 복구병렬 변환에서 세포를 결합 후 1 시간 동안 37 ° C에서 흔들어, 그리고에 의해 매체.
- 변환 효율을 평가하기 위해 50 ~ 100 μg / ml의 카르 베니 실린와 LB 아가 플레이트에 복구 된 세포의 alinquot에서 순차적으로 희석 플레이트 하룻밤에 37 ° C를 품어. / V, V 복구 세포와 V의 전체 볼륨 시리얼 희석 걸리는 나누어의 볼륨 - 총 CFU로 (관찰 CFU) × (희석 계수) × (V V)를 추정한다.
- 동시에, 회수 된 세포의 나머지가 100 μg / ml의 카르 베니 실린이 보충 된 200 ㎖의 LB에 접종하는 데 사용. 진탕 배양기에서 하룻밤 37 ° C에서 세포를 성장하고 표준 절차에 따라 플라스미드 DNA를 분리.
- 2 시간 동안 50 ° C에서 SfiI으로 절연 플라스미드 라이브러리의 분취 다이제스트와 삽입물의 존재를 확인하는 1 % 아가 로스 겔상에서 실행.
- C에 의해 플라스미드 라이브러리를 선형화를 KpnI과 XbaI로를 사용하여 프로모터 변종와 태그 사이에 utting. 소화 효율을 극대화하기 위해, 일련 digestions를 수행
- 첫째, 1 시간 동안 37 ° C에서 KpnI에서 다이제스트 및 자기 구슬을 사용하여 정제. 둘째, 2 시간 동안 37 ° C에서 1 U 새우 알칼리 포스 파타 아제의 첨가를 XbaI으로 소화, 열은 5 분 동안 65 ° C에서 비활성화 한 다음 자석 구슬을 사용하여 정제.
- 완전한 선형화를 확인하는 1 % 아가 로스 겔상에서 분취 액을 실행. 미가공 플라스미드가 보이면, 선형화 된 단편을 겔 정제한다.
- 포유 동물 세포에 형질 전환에 적합한 MPRA 라이브러리를 생성하기 위해, 선형화 된 중간 라이브러리에 KpnI으로 절단 / XbaI으로 호환 끝으로 ORF를 결찰.
- pMPRAdonor1에서 호환 luc2 ORF 부분을 준비하려면 1 시간 동안 37 ° C에서를 KpnI과 XbaI으로이 플라스미드를 소화하고 1 % 아가 로스 젤에서 실행됩니다. ORF 부분을 절제 (1.7 K이 경우, b) 및 겔 정제 스핀 컬럼을 사용하여 정제.
- 단계 2.3-2.8에서 설명한 바와 같이 선형화 된 라이브러리에 중간 ORF 단편을 복제.
- 1 시간 동안 37 ° C에서 KpnI으로 절단과 MPRA 라이브러리 (1-2 μg에 해당) 나누어지는 다이제스트와 1 % 아가 로스 젤에서 실행됩니다. 소화 라이브러리가 하나의 밴드로 실행하면 추가 밴드가 (일반적으로 중간 구조의 이월에 해당), 라이브러리는 다음과 같이 추가로 정제 할 수있다 관찰하는 경우, 섹션 3으로 진행합니다 :
- 1 시간 동안 37 ° C에서 KpnI으로 절단으로 오염 된 라이브러리의 3-5 μg을 소화하고 4 ℃에서 하룻밤 0.8 % 아가로 오스 겔에서 실행됩니다.
- 올바른 라이브러리 밴드를 절제 겔 정제 스핀 컬럼을 사용하여 DNA를 정제하고, 1 시간 동안 37 ° C에서 고농도의 T4 DNA 리가 아제를 이용하여자가 결찰을 수행한다. 단계 2.8에 설명 된대로 그런 다음 변환 및 최종 라이브러리 DNA 분리를 반복합니다.
3 Transfection, 동요 및 RNA 분리
- 각각의 독립적 인 형질 감염, 적절한 배양 배지에서 세포를 필요 매수 (MPRA 라이브러리의 복잡성에 의해 결정된 바와 같이, 논의 참조). 예를 들어, DMEM에서 배양 HEK293T / 17 세포를 10 % FBS 및 L-글루타민 / 페니실린 / 스트렙토 마이신이 보충. 각 라이브러리 및 실험 조건에 대한 적어도 두 개의 독립적 인 형질 감염을위한 세포를 배양.
- MPRA 플라스미드와 함께 배양 된 세포를 형질. 형질 전환 방법 및 조건은 각 세포 유형에 맞게 최적화해야합니다. 각 형질 샘플 들어, 정합 제어로서 플라스미드 DNA의 분취 액 (50-100 NG)를 유지한다.
- 예를 들어, 0.5 × 10 7 HEK293T / 성장 17 세포를 형질에 ~ 나는 30 ㎕의 리포 펙 타민 LTX 10 μL 플러스 시약을 사용하여 혈청 중 감소 된 1 ml의 옵티-MEM에서 10 μg 플라스미드 DNA와 10cm 배양 접시에 50 %의 합류. 5시간 후 형질 전환 혼합물을 제거하고 허용세포는 24 ~ 48 시간 동안 복구 할 수 있습니다.
- 선택적으로, 설계 라이브러리의 상황에 또는 신호에 의존하는 조절 서열을 활성화하는 데 필요한 교란을 수행합니다.
- 세포를 수확과 제조업체의 지침을 사용하여 표준 올리고 (DT) 셀룰로오스 열 또는 구슬을 사용하여 폴리 (A) + mRNA를을 격리 할 것.
- 열 또는 구슬의 최대 결합 용량이 수확 한 세포에서 mRNA의 예상 총 금액을 초과 할 수 있는지 확인합니다. 예를 들어, 3.3에서 기대 수익률은 약 0.5 내지 2.5 μg의 mRNA이다.
4 태그-SEQ
- 형질 세포 용 해물에서 벡터 DNA의 이월을 제거하기 위해 2.4 ㎕의 터보 DNase의 불 활성화 시약을 1 시간 동안 37 ° C에서 1 μL 터보 DNase의 (2 U) 및 2.3 ㎕의 10 배 터보 DNase의 버퍼 각 20 μL mRNA의 샘플을 처리 추가 RT 후 5 분간 혼합과 90 초간 원심 분리기에 10,000그램 및 위해 신선한 용액 튜브에 옮긴다.
- 확인 아가로 오스 겔상에서의 제품을 각각의 mRNA 시료 60-100 ng의 섹션 4.6에 설명 된 바와 같이 PCR을 수행하고 실행하여 순도. (luc2와 pMPRA1를 사용하는 경우 0.25 킬로바이트) 특정 증폭 산물을 볼 수있는 경우, 열은 치료의 mRNA를 정제 한 후 DNase를 처리를 반복합니다.
- , 태그-SEQ 시퀀싱 라이브러리를 생성하는 cDNA에 기자의 mRNA를 변환 PCR에 의해 시퀀싱 어댑터를 추가합니다.
- 표 3에 설명 된대로의 mRNA / RT 프라이머 혼합물을 설정합니다. 다음 얼음에 놓고 5 분 동안 65 ° C에서 품어. 표 4에 설명 된대로 병행하여, cDNA 합성 반응을 설정합니다.
| 시약 | 1X 볼륨 (μL) |
| mRNA의 샘플 (400-700 NG 전체) | 8 |
| 올리고 0dT (50 μM) | 1 |
| 의 dNTP (10 mM의 각) | 1 |
| 시약 | 1X 볼륨 (μL) |
| 10 배 첨자 III RT 버퍼 | 이 |
| MgCl2를 (25 밀리미터) | 4 |
| DTT (0.1 M) | 이 |
| RNaseOut (40 U / μL) | 1 |
| 첨자 III (200 U / μL) | 1 |
표 4의 cDNA 합성 반응 믹스.
- 조심스럽게 mRNA의 / RT 프라이머 cDNA 합성 믹스와 혼합 결합한다. 50 분, 5 분, 85 ° C, 50 ° C에서 부화 한 후 얼음에 배치합니다. 마지막으로, 20 분 동안 37 ° C에서 2 U 리보 뉴 클레아 제의 H와 부화.
- 4-6 μL와 표 5에 설명 된대로 PCR 반응을 설정cDNA의 반응 혼합물 또는 템플릿으로 50 ng의 리포터 플라스미드. 그런 다음 PCR 증폭 (2 분 95 ° C, 26 X [30 초 동안 95 ° C, 30 초 30 초 동안 55 ° C, 72 ° C], 3 분 동안 72 ° C)를 수행합니다.
| 시약 | 1X 볼륨 (μL) |
| 배 PfuUltra II HotStart PCR 마스터 믹스 | 25 |
| 프라이머 TagSeq_P1 (25 μM) | 0.5 |
| 프라이머 TagSeq_P2 (25 μM) | 0.5 |
| 템플릿 (mRNA를 cDNA를 혼합 또는 플라스미드 DNA) | 변화 |
| 핵산 분해 효소가없는 물 | 50 |
표 5 태그-SEQ PCR 반응 혼합물.
- 2 % 아가 로스 젤 PCR 제품을 실행 태그-SEQ 라이브러리 증폭 산물에 해당하는 소비세 밴드 (0.25 킬로바이트 사용하는 경우luc2와 pMPRA1) 및 이들의 겔 정화 스핀 열을 정화.
- 수영장, 변성 및 Illumina의 시퀀싱 기기와 직접 정제 된 태그-SEQ 증폭 산물을 시퀀싱.
- 필터 저품질는 시퀀스 태그 내에 30 개 미만의 점수 또는 b) 정확하게 설계된 태그가 일치하지 않는 Phred 품질로 하나 이상의 위치를 포함) 모두를 제거하여 판독한다. 나머지 각 태그는 각 도서관에 나타나는 횟수를 계산합니다. TPM에 (백만 시퀀싱 태그 당 태그) 태그 카운트를 정규화 한 후 시퀀싱 라이브러리의 각 쌍에 대한 플라스미드 유래 태그 카운트 위에 유래의 mRNA 태그 카운트의 비율을 계산한다. 서로 다른 여러 태그를 각 시퀀스 변종에 연결 한 경우, 다운 스트림 분석을 위해 자신의 평균 비율을 사용합니다.
결과
MPRA 고해상도, 전사 조절 요소의 시퀀스 - 활성 관계를 정량적으로 절개를 용이하게한다. 성공적인 MPRA 실험은 전형적으로 형질 라이브러리 (도 3a)에서 서열의 대부분 고도로 재현 가능한 측정 값을 수득한다. 나쁨 재현성 (도 3b)이 관찰되는 경우, 이는 정량 서열 중 하나) 낮은 절대 활성, 또는 2) 낮은 형질 감염 효율 하나에, 회수 된 RNA 샘플에서 리포터의 mRNA 너무 낮은 농도를 나타낸다.
도 4는 시금 생성 대표적인 "공간 정보"를 보여준다 ~ 1,2 또는 센다이 바이러스에의 노출없이 HEK293 세포에서 인간 IFNB 유전자의 상류에 145 bp의 서열의 임의의 변형 37000. 발기인 TATA 박스 알려진 근위 증강 (10)는 명확하게 정보가 풍부한 REGI으로 식별 할 수 있습니다바이러스 의존적으로 기능.
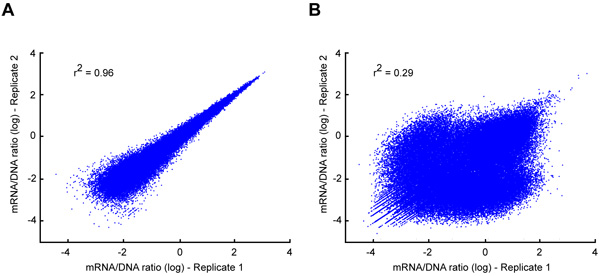
그림 3 태그-SEQ 재현성. 고 (A)과 낮은 (B) 재현성이 독립적 인 복제 형질에서 태그-SEQ 데이터의 예를 나타내는 산포도. 후자의 플롯은 반복에의 한 높은 mRNA의 수가 많은 아웃 라이어의 태그를 보여줍니다. 이러한 유물은 일반적으로 기자의 mRNA의 농도 인해 기자의 구조 중 낮은 절대 활동, 또는 낮은 형질 전환 효율에 하나, 정량적 PCR 증폭 너무 낮았다을 나타냅니다.
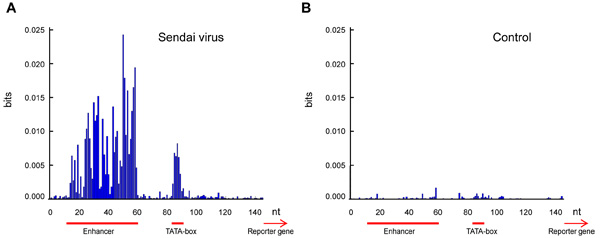
인간의 IFNB 전사 시작 사이트와 근위 증강의 그림 4 정보 배출량 측정. 상류 IFNB 인간 유전자의 뉴클레오티드 145 (NT) 영역의 약 37,000 랜덤 변형 (A)로 및 센다이 바이러스 (B)의 노출없이 HEK293 세포를 사용 MPRA 분석 하였다. 파란색 막대는 각 위치에서 리포터 출력 및 뉴클레오타이드 간의 상호 정보를 나타낸다. 근위 증강 및 TATA 박스는 바이러스 감염시 높은 정보 콘텐츠의 영역으로 눈에 띄는.
토론
MPRA는 유전자 조절 요소의 서열-활성 관계를 분석하기 위한 유연하고 강력한 도구입니다. MPRA 실험의 성공 여부는 적어도 세 가지 요인에 달려 있습니다: 1) 서열 라이브러리의 신중한 설계, 2) 증폭 및 클로닝 중 아티팩트 최소화, 3) 높은 형질감염 효율.
리포터 구조에서 가변 영역의 가능한 길이는 주로 사용된 합성 또는 복제 기술에 의해 결정됩니다. 표준 OLS는 일반적으로 약 200nt로 제한되지만 이 프로토콜은 최소 1,000nt의 인서트와 호환됩니다. 반복성이 높거나 강력한 2차 구조를 포함하는 가변 영역은 PCR 및 복제 편향으로 인해 과소 대표될 수 있습니다. 각 가변 영역을 식별하는 태그의 길이는 10-20nt여야 하며 태그 모음은 임의의 쌍 사이에 적어도 2개의 뉴클레오티드 차이가 있도록 이상적으로 설계되어야 합니다. 알려진 microRNA의 시드 서열 또는 mRNA 안정성에 영향을 미칠 수 있는 기타 인자를 포함하는 태그도 가능하면 피해야 합니다.
MPRA 실험 설계의 핵심 매개변수는 라이브러리에 포함될 개별 리포터 구조의 총 수입니다(설계 복잡성, CD로 표시됨). 실제로 CD는 형질감염될 수 있는 배양 세포의 수에 의해 제한됩니다. 일반적으로 형질감염된 세포의 총 수는 CD보다 최소 50-100배 많아야 합니다. 예를 들어, 50%의 형질감염 효율로 2천만 개의 세포를 형질감염할 수 있는 경우 C-D는 ~200,000을 넘지 않아야 합니다. CD는 고유한 조절 서열 변이체의 수에 서열당 고유한 태그의 수를 곱한 것과 같습니다. 각 조절 서열에 더 많은 고유한 태그가 연결될수록 해당 서열의 활성을 더 정확하게 추정할 수 있지만(서로 다른 태그의 측정값을 평균화할 수 있기 때문에) 한 실험에서 분석할 수 있는 별개의 변이체는 더 적습니다. 최적의 선택은 실험 설계에 따라 다릅니다. 집계된 측정값에 수학적 모델이 장착되는 간단한 "프로모터 배싱" 실험에서는 일반적으로 변형당 단일 태그로 충분합니다. 조절 활동의 변화를 일으키는 단일 뉴클레오티드 다형성에 대한 스크리닝에서, 각 대립유전자 쌍을 비교하려면 별도의 가설 검정이 필요하기 때문에 통계적으로 강력한 결과를 얻기 위해 대립유전자당 20개 이상의 태그를 사용해야 할 수도 있습니다.
분석할 서열이 전사 시작 부위를 포함할 것으로 예상되지 않는 경우, 동일한 단편에 상수 프로모터를 추가할 수도 있습니다. 예를 들어, pMPRAdonor2 (Addgene ID 49353)는 업스트림 가변 영역이 상당한 인핸서 활성을 가질 것으로 예상될 때 유용한 최소 TATA-box 프로모터를 포함하는 반면, pMPRAdonor3 (Addgene ID 49354)는 가변 영역이 소음기 활성 또는 기타 음성 조절 요소를 포함할 것으로 예상될 때 유용한 변형된 강력한 SV40 바이러스 프로모터를 포함한다.
원시 OLS 제품에는 잘린 올리고뉴클레오티드가 상당 부분 포함되어 있는 경우가 많습니다. 이는 특히 서열 사이에 상당한 상동성이 있는 경우 설계된 서열의 정확한 PCR 증폭을 방해할 수 있습니다. PAGE 정제를 사용하여 잘린 합성 산물을 제거하고 에멀젼 PCR을 사용하여 증폭 아티팩트를 최소화하는 것은 높은 라이브러리 품질을 보장하는 효과적인 기술입니다. 두 단계 중 하나가 실용적이지 않은 경우 각 증폭 단계에서 사용되는 PCR 주기 수를 최소화하는 것이 필수적입니다. 액체 배양에서 클론화된 라이브러리의 선택 및 확장은 일반적으로 설계 복잡성을 유지하기에 충분하지만, 재조합이 발생하기 쉬운 벡터를 사용하거나 상당한 표현 편향이 관찰되는 경우 회수된 세포를 대신 큰 LB 한천 플레이트에 직접 도금하고 개별 콜로니로 확장한 다음 DNA 분리를 위해 긁어낼 수 있습니다. 일반적으로 OLS에서 1:100-500의 비율로 발견되는 합성 오류의 잠재적 영향을 고려하는 것도 중요합니다. 이러한 오류를 식별하고 수정하기 위해 형질감염 전에 리포터 구조물의 전체 길이 시퀀싱이 권장됩니다.
형질감염된 배양의 모든 세포에 리포터 구조물을 도입할 필요는 없지만 형질감염 효율이 ~50% 미만이면 신호 대 잡음비가 낮아질 수 있습니다. 새로운 세포 유형에서 MPRA 실험을 수행하기 전에 형질감염 조건을 최적화하는 것이 좋습니다. 형질감염이 어려운 세포 유형으로 작업할 때 형질감염된 세포를 미리 선택하여 MPRA 신호를 증폭할 수 있습니다. pMPRA 벡터 시리즈에는 RNA 분리 전에 형질감염된 세포를 물리적으로 농축하는 데 사용할 수 있는 잘린 세포 표면 마커를 구성적으로 발현하는 변이체(예: Addgene ID 49350 및 49351)가 포함되어 있습니다.
공개 사항
저자는 그들이 더 경쟁 금전적 이해 관계가 없다고 선언합니다.
감사의 글
이 작품은 상을 수 R01HG006785에서 국립 보건원 (NIH)의 국립 인간 게놈 연구소에 의해 지원되었다.
재료
| 이름 | 회사 | 카탈로그 번호 | 댓글 |
|---|---|---|---|
| 올리고뉴클레오티드 라이브러리 합성 | Agilent, CustomArray 또는 기타 OLS 공급업체 | 사용자 정의 | OLS 구성 방법을 사용하는 경우 |
| pMPRA1 | Addgene | 49349 | MPRA 플라스미드 백본 |
| pMPRAdonor1 | Addgene | 49352 | luc2 ORF 공여체 플라스미드 |
| TE 0.1 Buffer (10 mM Tris-HCl, 0.1 mM EDTA, pH 8.0) | Generic | n/a | OLS buffer |
| Novex TBE-Urea Gels, 10% | Life Technologies | EC6875BOX | OLS 제품의 PAGE 정제 |
| Novex TBA-Urea 샘플 버퍼 | Life Technologies | LC6876 | OLS 제품의 PAGE 정제 |
| SYBR Gold Nucleic Acid Gel Stain | Life Technologies | S-11494 | PAGE OLS 제품의 정제 |
| Micellula DNA Emulsion & 정제 키트 | EURx/CHIMERx | 3600-01 | 에멀젼에 의한 라이브러리 증폭 |
| PCR Herculase II Fusion DNA 중합효소 | 애질런트 | 600675 | 중합효소 PCR |
| SfiI | New England Biolabs | R0123S | pMPRA 벡터를 사용한 라이브러리 클로닝 |
| KpnI-HF | New England Biolabs | R3142S | pMPRA 벡터를 사용한 라이브러리 클로닝 |
| XbaI | New England Biolabs | R0145S | pMPRA 벡터를 사용한 라이브러리 클로닝 |
| T4 DNA 리가아제(2,000,000 단위/ml) | New England Biolabs | M0202T | pMPRA 벡터를 사용한 라이브러리 클로닝 |
| One Shot TOP10 Electrocomp E. coli | Life Technologies | C4040-50 | pMPRA 벡터를 사용한 라이브러리 클로닝 |
| LB 한천 및 카르베니클린을 사용한 액체 배지 | 일반 | n/a | 성장 배지 클로닝 |
| E-Gel EX 겔 1% | Life Technologies | G4010-01 | 라이브러리 검증 및 정제 |
| E-Gel EX Gel, 2% | Life Technologies | G4010-02 | 라이브러리 검증 및 정제 |
| MinElute Gel Extraction Kit | Qiagen | 28604 | 라이브러리 및 백본 정제 |
| EndoFree Plasmid Maxi Kit | Qiagen | 12362 | 라이브러리 DNA 분리 |
| 세포 배양 배지 | n/a | 없음 | 실험별 |
| 형질주입 시약 | 해당 | 없음 | 해당 없음 실험별 |
| MicroPoly(A)Purist Kit | Life | Technologies AM1919 | mRNA 분리 |
| TURBO DNA-free 키트 | Life Technologies | AM1907 | 플라스미드 DNA 제거 |
| SuperScript III First-Strand Synthesis System | Life Technologies | 18080-051 | cDNA 합성 |
| PfuUltra II 핫스타트 PCR 마스터 믹스 | Agilent | 600850 | Tag-Seq PCR 프라이머용 중합효소 |
| (텍스트 참조) | IDT | 맞춤형 | PAGE 정제 Tag-Seq 프라이머 |
참고문헌
- Kinney, J., Murugan, A., Callan, C. G., Cox, E. C. Using deep sequencing to characterize the biophysical mechanism of a transcriptional regulatory sequence. Proceedings of the National Academy of Sciences USA. 107 (20), 9158-9163 (2010).
- Melnikov, A., et al. Systematic dissection and optimization of inducible enhancers in human cells using a massively parallel reporter assay. Nature Biotechnology. 30 (3), 271-277 (2012).
- Patwardhan, R. P., Lee, C., Litvin, O., Young, D. L., Pe’er, D., Shendure, J. High-resolution analysis of DNA regulatory elements by synthetic saturation mutagenesis. Nature Biotechnology. 27 (12), 1173-1175 (2009).
- Patwardhan, R. P., et al. Massively parallel functional dissection of mammalian enhancers in vivo. Nature Biotechnology. 30 (3), 265-270 (2012).
- Arnold, C. D., Gerlach, D., Stelzer, C., Boryń, ŁM., Rath, M., Stark, A. Genome-wide quantitative enhancer activity maps identified by STARR-seq. Science (New York, N. Y.). 339 (6123), 1074-1077 (2013).
- Kheradpour, P., et al. Systematic dissection of regulatory motifs in 2000 predicted human enhancers using a massively parallel reporter assay. Genome Research. 23 (5), 800-811 (2013).
- White, M. A., Myers, C. A., Corbo, J. C., Cohen, B. A. Massively parallel in vivo enhancer assay reveals that highly local features determine the cis -regulatory function of ChIP-seq peaks. Proceedings of the National Academy of Sciences USA. 110 (29), 11952-11957 (2013).
- Mogno, I., Kwasnieski, J. C., Cohen, B. A. Massively parallel synthetic promoter assays reveal the in vivo effects of binding site variants. Genome Research. 23 (11), 1908-1915 (2013).
- Schütze, T., et al. A streamlined protocol for emulsion polymerase chain reaction and subsequent purification. Analytical Biochemistry. 410 (1), 155-157 (2011).
- Panne, D., Maniatis, T., Harrison, S. C. An atomic model of the interferon-beta enhanceosome. Cell. 129 (6), 1111-1123 (2007).
재인쇄 및 허가
정오
Formal Correction: Erratum: Massively Parallel Reporter Assays in Cultured Mammalian Cells
Posted by JoVE Editors on 3/01/2015. Citeable Link.
null
