Korzystając z przykładu dróg oddechowych mukowiscydozy, manuskrypt przedstawia kompleksowy przepływ pracy obejmujący kombinację podejść metagenomicznych i metatranskryptomicznych w celu scharakteryzowania społeczności mikrobiologicznych i wirusowych w próbkach związanych ze zwierzętami.
Artykuł metodologiczny
Oczyszczanie nieczystości: sekwencjonowanie metagenomów i metatranskryptomów ze złożonych próbek związanych ze zwierzętami
W tym artykule
Podsumowanie
Streszczenie
Dostępność sekwencjonowania o wysokiej przepustowości zrewolucjonizowała wiele dziedzin biologii. Aby lepiej zrozumieć społeczności wirusowe i mikrobiologiczne związane z gospodarzem, opracowano kompleksowy proces ekstrakcji DNA i RNA. Przepływ pracy jednocześnie generuje metagenomy wirusowe i mikrobiologiczne, a także metatranskryptomy, z pojedynczej próbki do sekwencjonowania nowej generacji. Sprzężenie tych podejść zapewnia przegląd zarówno cech taksonomicznych, jak i funkcji kodowanych w społeczności. W prezentowanych metodach wykorzystuje się plwocinę mukowiscydozy (CF), która jest problematycznym typem próbki, ponieważ jest wyjątkowo lepka i zawiera dużą ilość mucyn, wolnego DNA neutrofili i innych nieznanych zanieczyszczeń. Opisane tutaj protokoły są ukierunkowane na te problemy i skutecznie odzyskują wirusowe i mikrobiologiczne DNA przy minimalnym zanieczyszczeniu ludzkiego DNA. Aby uzupełnić badania metagenomiczne, zoptymalizowano protokół metatranskryptomiczny w celu odzyskania mRNA zarówno drobnoustrojów, jak i gospodarza, które zawiera stosunkowo niewiele sekwencji rybosomalnego RNA (rRNA). Przedstawiono przegląd charakterystyki danych, który ma służyć jako punkt odniesienia do oceny skuteczności metod. Pobrano również dodatkowe próbki plwociny CF w celu (i) oceny spójności profili mikrobiomu przez siedem kolejnych dni w obrębie jednego pacjenta oraz (ii) porównania spójności podejścia metagenomicznego z sekwencjonowaniem opartym na genie rybosomalnego RNA 16S. Wyniki wykazały, że dzienne wahania profili mikrobiologicznych bez zaburzeń antybiotyków były minimalne, a profile taksonomiczne powszechnych bakterii związanych z mukowiscydozą były bardzo podobne między bibliotekami 16S rDNA a metagenomami wygenerowanymi z DNA pochodzącego z lizy hipotonicznej (HL). Jednak różnice między profilami taksonomicznymi 16S rDNA wygenerowanymi z całkowitego DNA i DNA pochodzącego z HL sugerują, że hipotoniczna liza i etapy płukania korzystnie wpływają nie tylko na usunięcie DNA pochodzącego od człowieka, ale także zewnątrzkomórkowego DNA pochodzącego z drobnoustrojów, które może fałszywie przedstawiać rzeczywiste profile mikrobiologiczne.
Wprowadzenie
Wirusowe i mikrobiologiczne społeczności związane z ludzkim ciałem były intensywnie badane w ciągu ostatniej dekady za pomocą technologii sekwencjonowania1,2. Wyniki doprowadziły do uznania znaczenia mikroorganizmów w zdrowiu i chorobach człowieka. Główna inicjatywa pochodzi z projektu Human Microbiome Project, który opisuje bakterie (i niektóre archeony) żyjące na ludzkiej skórze oraz w jamach ustnych, drogach oddechowych, drogach moczowych i przewodzie pokarmowym3. Dalsze badania mikrobiomu zdrowych ludzkich dróg oddechowych poprzez płukanie oskrzelowo-pęcherzykowe (BAL)4,5 i wymazy z nosogardzieli4 wykazały, że płuca mogą służyć jako urządzenie do pobierania próbek środowiskowych, powodując przejściową kolonizację mikrobiologiczną dróg oddechowych. Jednak wpływ kolonizacji mikrobiologicznej na upośledzone powierzchnie dróg oddechowych może prowadzić do ciężkich i przewlekłych infekcji płuc, takich jak te obserwowane u pacjentów z mukowiscydozą (CF).
mukowiscydoza jest śmiertelną chorobą genetyczną spowodowaną mutacją w genie6 regulatora transbłonowego mukowiscydozy (CFTR). Mutacje te powodują powstawanie wadliwych białek CFTR, które z kolei wpływają na transepiteliczny transport jonów przez wierzchołkową powierzchnię nabłonka. Choroba atakuje wiele układów narządowych, ale większość śmiertelności i zachorowalności można przypisać chorobie płuc związanej z mukowiscydozą7. Płuco mukowiscydozy zapewnia unikalny ekosystem do kolonizacji drobnoustrojów. Defekt transportu jonów powoduje gromadzenie się śluzu w drogach oddechowych mukowiscydozy, tworząc mikrośrodowiska składające się z przedziałów tlenowych, mikroaerofilowych i beztlenowych zakotwiczonych w statycznej, bogatej w składniki odżywcze powierzchni błony śluzowej. Środowisko to ułatwia kolonizację i namnażanie drobnoustrojów, w tym wirusów, bakterii i grzybów. Ostre i przewlekłe infekcje bakteryjne płuc prowadzą do stałych, ale nieskutecznych odpowiedzi immunologicznych, co skutkuje rozległą przebudową dróg oddechowych, utratą pojemności płuc i ostatecznie niewydolnością płuc.
Społeczności bakteryjne związane z płucami z mukowiscydozą zostały dobrze opisane przy użyciu zarówno metod zależnych, jak i niezależnych od hodowli, które obejmują sekwencjonowanie genu 16S rybosomalnego RNA (rRNA)8 i metagenomikę shotgun9,10. Podejście oparte na 16S rRNA jest w stanie scharakteryzować szeroki zakres gatunków drobnoustrojów i uchwycić szerokie zmiany w różnorodności społeczności. Jest jednak ograniczony w swojej rozdzielczości w definiowaniu zbiorowisk (podsumowany w Claesson et al. 201011), a przewidywania potencjałów metabolicznych są ograniczone do tych ogólnych funkcji znanych dla zidentyfikowanych taksonów. W związku z tym metody sekwencjonowania genu 16S rRNA są niewystarczające do uzyskania niezbędnej taksonomicznej i funkcjonalnej dokładności analitycznej różnych społeczności drobnoustrojów obecnych w płucach mukowiscydozy. Opisane tutaj podejście metagenomiczne uzupełnia podejście oparte na 16S rRNA, pokonuje jego ograniczenia i umożliwia stosunkowo skuteczny sposób analizy zarówno taksonomii społeczności drobnoustrojów, jak i zawartości genetycznej w płucach z mukowiscydozą.
Mikrobiologiczne DNA wyizolowane z próbek zwierzęcych często zawiera dużą ilość DNA gospodarza. Próbki plwociny lub tkanki płucnej mukowiscydozy zwykle zawierają dużą ilość ludzkiego DNA uwalnianego przez neutrofile w odpowiedzi immunologicznej, często większą niż 99% całkowitego DNA12-14. Chociaż niektóre nienaruszone komórki ludzkie mogą być obecne, większość tego DNA jest wolna w roztworze lub zaadsorbowana na powierzchni drobnoustrojów. Ponadto obecność wyjątkowo lepkich czopów śluzowych, szczątków komórkowych i innych nieznanych zanieczyszczeń dodatkowo komplikuje izolację komórek drobnoustrojów. Przetestowano kilka metod w celu zubożenia tych próbek ludzkiego DNA, w tym gradienty Percoll do oddzielania komórek ludzkich od mikrobiologicznych15, leczenie DNazą I, monoazydkiem bromku etydyny w celu selektywnej degradacji ludzkiego DNA16 oraz zestaw MolYsis, wszystkie z ograniczonym sukcesem. Do tej pory najskuteczniejszą procedurą oczyszczania mikrobiologicznego DNA z plwociny z mukowiscydozą była modyfikacja procesu opisanego przez Breitensteina i in. (1995)17. Podejście to, znane tutaj jako metoda lizy hipotonicznej (HL), wykorzystuje kombinację β-merkaptoetanolu w celu zmniejszenia wiązań dwusiarczkowych mucyny, hipotonicznej lizy komórek eukariotycznych i leczenia rozpuszczalnego DNA za pomocą DNazyI 9. Pomimo braku alternatyw, metoda HL wzbudziła pewne obawy ze względu na (i) możliwe błędy systematyczne wynikające z niepożądanej lizy drobnoustrojów oraz (ii) to, czy zaobserwowane fluktuacje w składzie społeczności9,10 są artefaktem zmian związanych z przetwarzaniem próbki. Oprócz generowania metagenomów typu shotgun, rozwiązujemy te problemy, porównując profile genów 16S rRNA całkowitego DNA i DNA drobnoustrojów wyekstrahowanych metodą HL przy użyciu tego samego zestawu próbek plwociny pobranych od jednego pacjenta przez siedem kolejnych dni.
W porównaniu do społeczności mikroorganizmów, charakterystyka społeczności wirusowych związanych ze zwierzętami jest ograniczona18,19. Społeczności wirusowe w drogach oddechowych mukowiscydozy zostały scharakteryzowane tylko minimalnie20–22. Pierwsze badanie metagenomiczne charakteryzujące DNA społeczności wirusów w drogach oddechowych mukowiscydozy wykazało, że większość wirusów związanych z płucami mukowiscydozy to fagi20. Potencjał metaboliczny faga u osób z mukowiscydozą i bez mukowiscydozy był znacząco różny. W szczególności społeczności fagów u osób z mukowiscydozą były nosicielami genów odzwierciedlających adaptacje gospodarza bakteryjnego do fizjologii dróg oddechowych mukowiscydozy i zjadliwość bakterii20. Późniejsze badania metagenomiczne wirusów w tkance płucnej mukowiscydozy wykazały wyraźną niejednorodność przestrzenną społeczności wirusowych między regionami anatomicznymi22. Ponadto tkanka płucna mukowiscydozy zawierała najmniejszą różnorodność wirusową zaobserwowaną do tej pory w jakimkolwiek ekosystemie22. Większość zidentyfikowanych wirusów to fagi, które mogą infekować patogeny mukowiscydozy. Jednak wykryto również wirusy eukariotyczne, takie jak herpeswirusy, adenowirusy i wirusy brodawczaka ludzkiego (HPV). W jednym przypadku, w którym podczas sekcji zaobserwowano torbiele w tkance płucnej, odzyskano ponad 99% genomu wirusa brodawczaka ludzkiego, mimo że u pacjenta nigdy nie zdiagnozowano brodawczaka płucnego ani raka. Wskazuje to, że obecna różnorodność wirusów nie tylko odzwierciedla stopień uszkodzenia tkanek, ale może również ujawniać i wyjaśniać leżącą u podstaw niescharakteryzowaną chorobę. Opisane tutaj protokoły zapewniają prosty, ale skuteczny sposób izolowania cząstek wirusopodobnych (VLP) z próbek składających się z dużych ilości gęstego śluzu, komórek gospodarza i drobnoustrojów, wolnego DNA, a także szczątków komórkowych.
Uzupełniając metagenomikę, metatranskryptomika służy do monitorowania dynamiki ekspresji genów w społeczności mikrobiologicznej i gospodarzu9,23. W takim przypadku należy preferencyjnie wybrać mRNA drobnoustrojów, jak i gospodarza. Ponieważ bakteryjne mRNA nie są poliadenylowane, nie można zastosować metody ściągania mRNA opartej na oligo-dT. Amplifikacja RNA zależna od poliadenylacji nie może być stosowana w próbkach związanych z gospodarzem, jeśli wiadomo, że próbki zawierają duże ilości eukariotycznego mRNA. Wiele próbek związanych ze zwierzętami, w tym plwocina mukowiscydoza, zawiera dużą gęstość komórek, a także duże ilości szczątków komórkowych i nukleaz, które zawierają RNazy. Dlatego kolejnym trudnym zadaniem jest zapobieganie nadmiernej degradacji RNA podczas przetwarzania metatranskryptomu. W większości przypadków całkowite RNA wyekstrahowane z plwociny mukowiscydozy ulega częściowej degradacji, co ogranicza dalsze zastosowania i użyteczność uzyskanego RNA. W ostatnich latach opracowano kilka podejść do zubożenia rRNA, które zaadaptowano do dostępnych na rynku zestawów. Skuteczność tych podejść jest jednak ograniczona, zwłaszcza w przypadku pracy z częściowo zdegradowanym rRNA9,24. Zastosowane tu metody pozwoliły na odzyskanie częściowo zdegradowanego całkowitego RNA, nadającego się do skutecznego usuwania całkowitego rRNA w dalszej części procesu. Bezpośrednie porównanie skuteczności usuwania rRNA z częściowo zdegradowanego całkowitego RNA porównującego dwa różne zestawy zostało zilustrowane przez Lim i wsp. (2012)Rozdział 9.
Ogólnie rzecz biorąc, celem tego manuskryptu jest dostarczenie kompletnego zestawu protokołów (Rysunek 1) do generowania wirusowych i mikrobiologicznych metagenomów typu shotgun oraz metatranskryptomu z pojedynczej próbki związanej ze zwierzęciem, na przykładzie próbki indukowanej plwociny. Przepływ pracy w laboratorium molekularnym powinien obejmować oddzielne obszary przed i po amplifikacji, aby zminimalizować zanieczyszczenie krzyżowe. Metody te można łatwo dostosować do innych typów próbek, takich jak tkanki22, wymazy z nosogardzieli i jamy ustneji gardła 25, płukanie oskrzelowo-pęcherzykowe (BAL) i koralowce (dane niepublikowane). Każda próbka powinna być przetworzona natychmiast po pobraniu, zwłaszcza gdy pożądane są badania metagenomiki drobnoustrojów i metatranskryptomiki. Jeśli próbki zostały zamrożone, ogranicza to izolację nienaruszonych komórek drobnoustrojów dla metagenomów drobnoustrojów, ponieważ zamrożenie potencjalnie zakłóciłoby integralność komórki. Zamrażanie nie wyklucza jednak metatranskryptomiki i izolacji wirusa, ale proces zamrażania i rozmrażania może mieć wpływ na jakość RNA i ilość odzyskanych cząstek wirusa. Ważne jest, aby zauważyć, że indukowana plwocina służyła jako główne źródło próbek w wielu badaniach związanych z dorosłymi pacjentami z mukowiscydozą i innymi przewlekłymi chorobami płuc26,27, ponieważ BAL może być zbyt inwazyjny. W naszych badaniach próbki plwociny pobrano staranną i spójną metodą pobierania próbek, tj. po płukaniu jamy ustnej i płukaniu jamy ustnej sterylnym roztworem soli fizjologicznej, aby ograniczyć do minimum zanieczyszczenie mikroorganizmami jamy ustnej w próbkach plwociny.
Protokół
UWAGA: Próbki indukowanej plwociny zostały pobrane zgodnie z Instytucjonalną Komisją Rewizyjną Uniwersytetu Kalifornijskiego (HRPP 081500) i Instytucjonalną Komisją Rewizyjną Uniwersytetu Stanowego San Diego (SDSU IRB#2121), przez koordynatora badań kliniki mukowiscydozy dla dorosłych Uniwersytetu Kalifornijskiego w San Diego (UCSD).
1. Pobieranie próbek i obróbka wstępna (wstępna obróbka próbek w ciągu 30 minut po pobraniu)
- Przed pobraniem próbki oznacz cztery probówki o pojemności 15 ml jako: (i) metagenom wirusa, (ii) metagenom drobnoustrojów, (iii) metatranskryptom i (iv) dodatkowa plwocina. Powtórzyć te czynności dla każdej próbki. Dodać 2 ml kulek krzemionki o średnicy 0,1 mm do probówki z napisem "Metatranskryptom", a następnie 6 ml buforu do lizy RNA na bazie izotiocyjanianu guanidyny (bufor do lizy GITC).
- Podczas pobierania próbek należy używać sterylnego roztworu soli fizjologicznej (60 ml) jako płynu do płukania jamy ustnej, aby zminimalizować zanieczyszczenie drobnoustrojami jamy ustnej. Próbki plwociny pobierać w ciągu 30 minut po wdychaniu 4 ml 7% hipertonicznego roztworu soli fizjologicznej za pomocą nebulizatora. Próbki należy przetwarzać natychmiast, jak opisano poniżej.
- Rozcieńczyć próbkę do całkowitej objętości 8 ml.
- Oszacuj objętość próbki, ważąc pusty kubek na plwocinę przed i po pobraniu próbki.
- Jeżeli objętość próbki jest mniejsza niż 8 ml, należy dodać odpowiednią ilość 1 PBS z filtrem 0,02 μm, aby uzyskać całkowitą objętość próbki wynoszącą co najmniej 8 ml.
- Natychmiast homogenizować próbkę za pomocą strzykawki o pojemności 3 ml do momentu, aż w plwocinie nie pozostaną żadne widoczne grudki
- Za pomocą tej samej strzykawki pobrać 2 ml plwociny i natychmiast przejść do kroku 1.4.
- Zachowanie całkowitego RNA z próbki plwociny
- Wstrzyknąć 2 ml próbki plwociny z kroku 1.3.4 do probówki "metatranskryptomu" zawierającej kulki krzemionkowe i bufor do lizy GITC.
- Zamknij pokrywę i szczelnie uszczelnij tubę za pomocą Parafilm, aby uniknąć wycieku.
- Natychmiast homogenizować plwocinę ze średnią prędkością przez 10 minut. W zależności od dostępnego wirownika, umieść rurkę poziomo i w razie potrzeby zabezpiecz taśmą.
- Przechowywać probówkę w temperaturze 4 °C lub w pojemniku na lód i w razie potrzeby przetransportować do laboratorium.
- Za pomocą tej samej strzykawki wlej po 2 ml plwociny do probówek oznaczonych jako "metagenom wirusa" i "metagenom drobnoustrojów" i przenieś pozostałą plwocinę z kubka na plwocinę do probówki z napisem "dodatkowa plwocina".
- Przechowywać wszystkie probówki w temperaturze 4 °C lub w pojemniku na lód i w razie potrzeby przetransportować do laboratorium.
2. Generowanie metagenomu wirusowego
- Przygotowanie i roztworów
- Przygotować wcześniej 50 mM ditiotreitolu (DTT) i przechowywać w temperaturze 4 °C. Jest to stabilne przez 2 tygodnie.
- Przygotować bufor soli fizjologicznej i magnezowej (SM) (250 ml): 1 M NaCl, 10 mM MgSO4, 50 mM Tris-HCl; dostosować pH do 7,4. Filtrować, sterylizować (pory o wielkości 0,02 μm) i przechowywać w temperaturze pokojowej.
- Przygotować enzym DNazę I do 100 U/μl (w wodzie o czystości cząsteczkowej) z liofilizowanej trzustki bydlęcej DNazy I zgodnie z aktywnością określoną jednostką Dornazy/mg suchej masy.
- Przygotować 10x bufor DNazy I (50 ml): 100 mM MgCl2, 20 mM CaCl2; dostosować pH do 6,5. Filtrować, sterylizować (pory o wielkości 0,02 μm) i przechowywać w temperaturze pokojowej.
- Przygotować 4% paraformaldehydu.
- Przygotuj 200x bufor TE: 2 M Tris-HCl (pH 8,5), 0,2 M EDTA. Filtrować, sterylizować (pory o wielkości 0,02 μm) i przechowywać w temperaturze pokojowej.
- Przygotuj 10 ml 10% dodecylosiarczanu sodu (SDS) przy użyciu wody molekularnej.
- Przygotować 50 ml CTAB/NaCl (10% CTAB. 700 mM NaCl) używając wody molekularnej. Rozpuść CTAB przez noc. Jeśli osady utrzymują się, podgrzać roztwór w temperaturze 65 °C. Roztwór ma wysoką lepkość w temperaturze pokojowej.
UWAGA: Filtracja za pomocą filtra 0,02 μm pozwala na usunięcie cząstek wirusopodobnych w roztworze, ale nie zanieczyszczenia wolnymi kwasami nukleinowymi.
- Obróbka wstępna próbki
- Przygotuj odpowiednią ilość świeżego 6,5 mM ditiotreitolu (DTT).
- Rozcieńczyć homogenat przez dodanie buforu SM przefiltrowanego przez 0,02 μm, aby uzyskać całkowitą objętość 6 ml.
- Aby wspomóc rozpuszczanie śluzu, dodać równą objętość (6 ml) 6,5 mM ditiotreitolu (DTT) do próbki, energicznie wirować w celu wymieszania i inkubować przez 1 godzinę w temperaturze 37 °C.
- Energicznie wirować badaną próbkę i wirować w temperaturze 10 °C, 3,056 x g przez 15-20 minut.
- Zebrać sklarowany osad do nowej probówki o pojemności 15 ml.
- Powtórzyć kroki 2.2.3 i 2.2.5 dla następnej próbki.
- Przenieść i przefiltrować supernatant za pomocą filtra 0,45 μm zamontowanego na strzykawce do nowej probówki o pojemności 15 ml.
UWAGA: Jeśli filtr się zatka, wyjmij próbki ze strzykawki i pomiń etap filtracji. - Pobrać podpróbkę o objętości 100 μl z próbki przefiltrowanej 0,45 μm, przeprowadzić obróbkę chloroformem i DNazą I (patrz sekcja 2.3.12-2.3.15) i dodać równą objętość 4% paraformaldehydu w celu utrwalenia próbki do mikroskopii epifluorescencyjnej (rysunek 2A).
- Aby zapoznać się z kompleksowym podejściem do wzbogacania cząstek wirusa (patrz Dyskusja), przejdź do kroku 2.3.12, aby pominąć selekcję cząstek wirusa na podstawie ultrawirowania w gradiacji chlorku cezu. Może to jednak skutkować zanieczyszczeniem bakteryjnym odpornym na chloroform i większą ilością DNA gospodarza w lizacie wirusa.
- Wzbogacanie i oczyszczanie cząstek wirusopodobnych (VLP)
- Przygotować poszczególne roztwory chlorku cezu (CsCl), rozpuszczając odpowiednią ilość CsCl w niefiltrowanym buforze SM do pożądanej gęstości (1,7 g/ml, 1,5 g/ml, 1,35 g/ml i 1,2 g/ml). Przed użyciem przefiltruj każdy roztwór przez filtr 0,02 μm.
- Ustaw gradient CsCl, jak pokazano na rysunku 2B.
- Załaduj 1 ml 1,7 g/ml do każdej probówki, załaduj 1 ml 1,5 g/ml do każdej probówki, załaduj 1 ml 1,35 g/ml do każdej probówki, załaduj 1,2 g/ml do każdej probówki (opcjonalnie), a na koniec załaduj 6-8 ml próbki do odpowiedniej probówki. Zaznacz poszczególne warstwy, aby wskazać położenie każdej frakcji.
- Zrównoważyć każdą przeciwstawną parę probówek z dokładnością do 1 mg.
- Ostrożnie załaduj każdą rurkę do wiadra wirowego. Zakręć wszystkie wiadra, nawet jeśli są puste. Załaduj wiadro wirowe na wirnik.
- Wirować przy 82,844 x g w temperaturze 4 °C przez 2 godziny.
- Po odwirowaniu ostrożnie wyjmij probówki z uchwytu, nie naruszając gradientów gęstości.
- Za pomocą strzykawki o pojemności 3 ml z igłą 18 G przekłuć probówkę tuż poniżej warstwy o gęstości 1,5 g/ml (Rysunek 2, czerwona strzałka) i wciągnąć ~1,5 ml do strzykawki.
- Zebrać górną frakcję, powoli wyjmując igłę i pozwalając, aby pozostała frakcja w probówce spłynęła do nowej probówki o pojemności 15 ml przez nakłucie. Oznacz to jako "odpad górnej frakcji".
- Pobrać frakcję 1,5 g/ml (zawierającą VLP) ze strzykawki, wyrzucając zawartość do dwóch nowych probówek do mikrofuge.
- Powtórzyć kroki 2.3.8-2.3.10 dla wszystkich próbek.
- Dodać 0,2 objętości chloroformu do koncentratu wirusowego, energicznie wstrząsnąć, inkubować w temperaturze pokojowej przez 10 minut, wirować z maksymalną prędkością przez 5 minut i zebrać fazę wodną.
- Dodać 10x bufor DNazy i DNazę I (stężenie końcowe = 2,5 U/μl) do koncentratu wirusa potraktowanego chloroformem i inkubować w temperaturze 37 °C przez 1,5-2 godziny.
- Dezaktywować aktywność DNazy w temperaturze 65 °C przez 15 min.
- Usunąć 15 μl frakcji wirusowej poddanej działaniu chloroformu i DNazy I do nowej probówki i dodać 15 μl 4% paraformaldehydu w celu utrwalenia próbki do mikroskopii epifluorescencyjnej.
- Ekstrakcja DNA
- Koncentraty wirusowe z każdej próbki należy umieścić w oczyszczonej i autoklawizowanej probówce wirówki o pojemności 50 ml Oak Ridge.
- Dodać następujące elementy: 0,1 objętości 200x bufor TE, 10 μl 0,5 M EDTA na ml próbki, 1 objętość formamidu i 10 μl glikogenu. Dobrze wymieszaj i inkubuj w temperaturze pokojowej przez 30 minut.
- Korzystając z nowych objętości, dodaj 2 objętości 100% etanolu o temperaturze pokojowej. Dobrze wymieszać i inkubować w temperaturze 4 °C przez co najmniej 30 minut.
- Osadzać DNA, obracając probówkę o masie 17,226 x g przez 20 minut, w temperaturze 4 °C przy użyciu rotora SS-34.
- Szwadron należy ostrożnie wyrzucić za pomocą pipety serologicznej. Umyj granulat dwukrotnie lodowatym 70% etanolem.
- Usuń jak najwięcej płynu i pozostaw granulkę do wyschnięcia na powietrzu w temperaturze pokojowej przez 15 minut.
- Zawiesić osad DNA w 567 μl 1x buforu TE (pH 8,0).
UWAGA: Odczekać co najmniej 15 minut do całkowitego zamieszania w temperaturze pokojowej. Zawieszone DNA należy przechowywać przez noc w temperaturze 4 °C do czasu dalszego przetwarzania. - Przenieś całe 567 μl zawieszonego roztworu DNA do nowej probówki o pojemności 1,5 ml. Dodać 30 μl wstępnie podgrzanego 10% SDS i 3 μl proteinazy K (20 μg/ml), dokładnie wymieszać i inkubować przez 1 godzinę w temperaturze 56 °C. Wstępnie podgrzać CTAB/NaCl w temperaturze 65 °C.
- Dodać 100 μl 5 M NaCl i dokładnie wymieszać. Dodać 80 μl wstępnie podgrzanego roztworu CTAB/NaCl, odwirować i inkubować przez 10 minut w temperaturze 65 °C.
- Dodać równą objętość chloroformu, zmieszać i wirować w temperaturze 16 100 x g przez 5 minut.
- Przenieść supernatant do nowej probówki do mikrofiltrów o pojemności 1,5 ml. Dodać równą objętość fenolu/chloroformu, wirować do wymieszania i wirować w temperaturze 16 100 x g przez 5 minut.
- Przenieść supernatant do nowej probówki do mikrofiltrów o pojemności 1,5 ml. Dodać równą objętość chloroformu, wymieszać i wirować w temperaturze 16 100 x g przez 5 minut.
- Przenieść supernatant do nowej probówki do mikrofiltrów o pojemności 1,5 ml. Dodać równą objętość izopropanolu do frakcji sklarowanej nad osadem, wymieszać i inkubować w temperaturze -20 °C przez co najmniej 30 minut.
- Osadzać DNA, wirować w temperaturze 16 100 x g przez 15 minut w temperaturze 4 °C. Ostrożnie odpipetować supernatant i dwukrotnie przemyć osad lodowatym 70% etanolem.
- Wykonaj krótkie wirowanie i usuń pozostały etanol z rurki. Suszyć pelety na powietrzu przez 15 minut.
- Zawiesić osad DNA za pomocą 50 μl buforu elucyjnego (5 mM Tris, pH 8,5). Pozostaw granulkę do ponownego nawodnienia przez co najmniej 5 minut w temperaturze pokojowej.
- Określ ilościowo DNA za pomocą testu opartego na fluorescencji o wysokiej czułości.
- Amplifikacja przy użyciu polimerazy Phi29 (opcjonalnie)
- Przygotować 2x bufor do wyżarzania: 80 mM Tris-HCl (pH 8,0), 20 mM MgCl2.
- Rozcieńczyć polimerazę DNA Phi29 do 5 U/μl.
- Bufor próbki do wstępnego mieszania, składający się z 50 μl losowego startera heksamerowego (100 μM), 125 μl 2x buforu do wyżarzania i 25 μl wody. Podwielokrotność porcji i przechowywać w temperaturze -20 °C.
- Bufor reakcyjny do wstępnego mieszania, składający się ze 100 μl 10-krotnego buforu Phi29, 40 μl 10 mM dNTP i 560 μl wody. Podwielokrotność porcji i przechowywać w temperaturze -20 °C.
- Dodać 1 μl matrycy DNA do 4 μl buforu próbki.
- Inkubować mieszaninę w temperaturze 95 °C przez 3 minuty i schłodzić na lodzie.
- Dodać 14 μl buforu reakcyjnego do mieszaniny z 2.4.4, mieszać pipetując w górę i w dół.
- Dodać 1 μl polimerazy DNA Phi29, mieszać pipetując w górę i w dół, i inkubować w temperaturze 30 °C przez 18 godzin, a następnie w temperaturze 65 °C przez 10 minut.
- Oczyść reakcje za pomocą kolumn genomowego DNA lub wytrącania fenolu/chloroformu i etanolu.
- Mikroskopia epifluorescencyjna (patrz Haas i wsp. 201428 do konfiguracji systemu filtracji)
UWAGA: Po izolacji i oczyszczeniu, mikroskopia epifluorescencyjna z barwnikami kwasów nukleinowych może być wykorzystana do sprawdzenia obecności i czystości cząstek wirusa w próbkach (ryc. 2A i 2C). Wolne DNA w próbce może powodować wysoką fluorescencję tła. Dlatego próbka powinna być poddana działaniu DNazy I przed utrwaleniem i barwieniem w celu uzyskania mikrofotografii.- Przygotować roztwór montażowy (0,1% kwas askorbinowy, 50% glicerol). Dodać 100 μl 10% kwasu askorbinowego do 4,9 ml 1x soli fizjologicznej buforowanej fosforanem (PBS), dokładnie wymieszać. Dodać 5 ml 100% glicerolu do mieszanki, dokładnie wymieszać i oznaczyć probówkę jako "mount".
- Zamontuj filtr za pomocą jednorazowego filtra strzykawkowego z matrycą tlenku glinu 0,02 μm, podziel na porcję do probówek do mikrofuge i przechowuj w temperaturze -20 °C.
- Podzielić 100 μl próbki do nowej probówki do mikrofuge i dodać równą objętość 4% paraformaldehydu w celu utrwalenia VLPs. Inkubować mieszaninę w temperaturze pokojowej przez co najmniej 10 minut.
- Uzupełnić objętość do objętości 1 ml, dodając 800 μl przefiltrowanej wody o stężeniu 0,02 μm. Dodać 1 μl barwnika SYBR Gold do probówki i inkubować w temperaturze pokojowej przez 10 minut.
- Skonfiguruj system filtracji, włączając pompę próżniową w zakresie od -9 do -10 psi (od -62,1 do -68,9 kPa).
- Umyj cokół wodą i umieść w cokole filtra filtr z tlenku glinu 0,02 μm z pierścieniowym polipropylenowym pierścieniem nośnym.
- Umieść wieżę filtracyjną na szczycie cokołu filtra z filtrem i zabezpiecz zaciskiem.
- Odpipetować zawartość z probówki o pojemności 1,5 ml do mikrofugi do wieży filtracyjnej i odczekać kilka minut, aż próbka zostanie przefiltrowana.
- Oznaczyć etykietą i odpipetować 10 μl odczynnika do mikroskopijnego szkiełka.
- Pozostaw odkurzacz włączony podczas wyjmowania wieży filtra i clamp.
- Ostrożnie zdejmij filtr z cokołu filtra i osusz spód filtra chusteczką Kimwipe, a następnie umieść filtr bezpośrednio na uchwycie na szkiełku mikroskopijnym.
- Odpipetować kolejne 10 μl odczynnika do montażu na filtrze i nałożyć szkiełko nakrywkowe na filtr.
3. Generowanie metagenomu mikrobiologicznego
- Przygotowanie i roztworów
- Przygotować 50 ml 1x buforu DNazy: 50 mM NaAc, 10 mM MgCl2, 2 mM CaCl2; dostosować pH do 6,5. Filtr, sterylizować (0,22 μm) i przechowywać w temperaturze pokojowej.
- Przygotować enzym DNazy I do 1000 U/μl (w wodzie o czystości cząsteczkowej) z liofilizowanej trzustki bydlęcej DNazy I zgodnie z aktywnością określoną jednostką Dornazy/mg suchej masy.
- Przygotować 100 ml buforu SE: 75 mM NaCl, 25 mM EDTA; dostosować pH do 7,5. Filtr, sterylizować (0,22 μm) i przechowywać w temperaturze pokojowej.
- Wstępna obróbka próbki przed ekstrakcją DNA
- Rozcieńczyć homogenat, dodając 5 objętości 1x PBS przefiltrowanych przez 0,22 μm. Na przykład dodać 10 ml 1x PBS do 2 ml próbki.
- Dodać β-merkaptoetanol do końcowego stężenia 2% (v/v). Ubijaj mieszaninę (w kapturze chemicznym) w temperaturze pokojowej przez 2 godziny.
- Wirować próbkę w temperaturze 10 °C i 3,056 x g przez 15 minut i odrzucić supernatant.
- Zawiesić osad w 10 ml wody molekularnej (lub 0,22 μm przefiltrowanej wody) i inkubować w temperaturze pokojowej przez 15 minut.
- Powtórz kroki 3.2.3 i 3.2.4 jeden raz.
- Wirować w temperaturze 10 °C i ciśnieniu 3,056 x g przez 15 minut i odrzucić supernatant.
- Zawiesić osad w 5 ml 1x bufor DNazy i dodać 15 μl DNazy I (1,000 U/μl) na ml próbki.
- Inkubować w temperaturze 37 °C z wielokrotnym mieszaniem przez 2 godziny.
- Dezaktywować aktywność DNazy w temperaturze 65 °C przez 15 min.
- Wirować w temperaturze 10 °C i ciśnieniu 3,056 x g przez 15 minut i odrzucić supernatant. Zawiesić osad w 10 ml buforu SE.
- Powtórz krok 3.2.10.
- Wirować w temperaturze 10 °C i ciśnieniu 3,056 x g przez 15 minut i odrzucić supernatant.
- Zawiesić osad w 2 ml buforu SE i przenieść do dwóch probówek do mikrofuge.
- Granuluj komórki w probówkach do mikrofuge. Wirować probówki o wymiarach 16 100 x g w temperaturze pokojowej przez 15 minut.
- Usuń supernatant i wyekstrahuj DNA z granulowanych komórek za pomocą zestawu do ekstrakcji genomowego DNA, protokół zmienności Gram-dodatniej.
4. Generowanie metatranskryptomu
- Obróbka wstępna próbki
- Przeprowadzić mechaniczną lizę komórek poprzez ubijanie kulek w buforze do lizy GITC natychmiast po pobraniu próbki i homogenizacji. Patrz krok 1.4.
- Wirować mieszaninę w temperaturze 4 °C i 600 x g przez 5 minut, aby osadzać kulki krzemionkowe.
- Przenieść supernatant do nowej probówki.
- Dodać 200 μl chloroformu na każde 750 μl użytego buforu do lizy GITC, energicznie wstrząsać ręcznie przez 15 sekund, inkubować w temperaturze pokojowej przez 10 minut i wirować w temperaturze 4 °C i 3,056 x g przez 15 min. Podczas tego 15-minutowego wirowania przygotuj się do kroku 4.2.
- Po 15 minutowym wirowaniu (wyraźne oddzielenie form fazy wodnej-interfazy-fazy organicznej), wyekstrahuj fazę wodną (bez przerywania interfazy) do nowej probówki (probówek) wolnej od RNaz.
UWAGA: Faza wodna zawiera RNA. Trzymaj probówki na lodzie do następnego kroku.
- Przeprowadzić ekstrakcję i oczyszczanie całkowitego RNA przy użyciu dostępnych na rynku zestawów do oczyszczania RNA opartych na kolumnach lub konwencjonalnego wytrącania RNA na bazie izopropanolu.
- Oczyszczanie RNA za pomocą kolumny krzemionkowej
- Zmierzyć całkowitą objętość otrzymanej frakcji wodnej.
- Dodać odpowiednią objętość buforu wiążącego RNA do próbki i dobrze wymieszać.
- Dostosować mieszaninę do odpowiednich warunków wiązania zgodnie z protokołem producenta. Dobrze wymieszaj i zrób krótki wir.
- Załaduj mieszaninę do kolumny RNA. W przypadku próbki o dużej objętości należy użyć wielokrotnego ładowania i załadować każdą kolumnę do 4 razy. W przeciwnym razie rozważ użycie wielu kolumn dla każdej próbki.
- Odpowiednio umyć kolumnę zgodnie z protokołem producenta.
- Eluować RNA za pomocą co najmniej 30 μl wody wolnej od RNaz. Podwójna elucja nieznacznie zwiększy wydajność RNA. Spowoduje to jednak rozcieńczenie stężenia RNA.
- Zmierz stężenie RNA i przejdź bezpośrednio do leczenia DNazą I. Użyj Bioanalyzera, aby sprawdzić jakość RNA (zalecane).
- Wytrącanie RNA
- Dodać równą objętość izopropanolu (np. 500 μl izopropanolu do 500 μl frakcji wodnej) i 2 μl 10 μg/μl glikogenu wolnego od RNaz do próbki.
- Inkubować mieszaninę w temperaturze pokojowej przez 10 minut.
- Wirować w temperaturze 12 000 x g i temperaturze 4 °C przez 15 min.
- Ostrożnie usunąć supernatant, dodać 1 ml 75% etanolu wolnego od RNaz. Wirować mieszaninę w temperaturze 7 500 x g i 4 °C przez 5 minut, aby upewnić się, że granulka jest nienaruszona.
- Ostrożnie usuń etanol.
- Powtórz kroki 4.2.2.4 i 4.2.2.5 jeden raz.
- Suszyć pellet na powietrzu przez 10 minut.
- Ponownie uwodnić osad w 50 μl wody wolnej od RNaz, inkubować w temperaturze 55 °C przez 5 minut i przejść bezpośrednio do obróbki DNazą. Użyj Bioanalyzera, aby sprawdzić jakość RNA (zalecane).
- Przechowywać RNA w podwielokrotnościach w temperaturze -20 °C lub -80 °C w celu długotrwałego przechowywania.
- Oczyszczanie RNA za pomocą kolumny krzemionkowej
Wyniki
Wiralne metagenomy
Plwocina w przypadku mukowiscydozy (CF) jest wyjątkowo lepka i zawiera dużą ilość mucyn oraz wolnego DNA (Rysunek 2A); ultrawirowanie w gradiencie gęstości ułatwia eliminację DNA pochodzenia gospodarza (Rysunek 2B). Wyniki z poprzedniego badania9, przedstawiające osiem wiromów wygenerowanych zgodnie z opisanym schematem postępowania, podsumowano tutaj (Tabela 1). Siedem próbek (CF1-D, CF1-E, CF1-F, CF4-B, CF4-C, CF5-A oraz CF5-B; Tabela 1) przetworzono zgodnie z opisem w Sekcji 2. Wygenerowane wiromy zawierały niewielką ilość (0,02%-3,7%) sekwencji pochodzenia ludzkiego z jednym wyjątkiem (70%). Próbka CF4-A została pominięta w kroku ultrawirowania w gradiencie gęstości (CF4-A), a wirom wygenerowany z tej konkretnej próbki zawierał >97% sekwencji pochodzenia ludzkiego (Tabela 1). Rysunek 2 przedstawia przykład obrazu z mikroskopii epifluorescencyjnej typowej próbki plwociny CF przed (Rysunek 2A) i po (Rysunek 2C) ultrawirowaniu w gradiencie gęstości. Na mikrografiach zaobserwowano wyraźne cząstki przypominające wirusy (VLPs), przy braku dużych cząstek po separacji w gradiencie gęstości. Po ekstrakcji DNA z VLPs często przeprowadza się test na zanieczyszczenie bakteryjne przy użyciu amplifikacji 16S rDNA przed sekwencjonowaniem DNA VLPs.
Mikrobialne metagenomy
Siedem próbek plwociny przedstawionych w tej pracy pobrano od jednego pacjenta z mukowiscydozą (CF) przez siedem kolejnych dni. Pacjent rozpoczął przyjmowanie doustnych antybiotyków (cyprofloksacyny i doksycykliny) w 3. dniu, po pobraniu plwociny. Objętość każdej próbki plwociny pobranej od tego pacjenta wynosiła 15 ml przez cały okres 7 dni; w związku z tym do próbek nie dodawano PBS. Celem tego etapu pobierania próbek była ocena protokołów przedstawionych w tym schemacie postępowania poprzez (i) ocenę codziennych wahań struktury społeczności mikrobiologicznej oraz (ii) porównanie struktury i rozdzielczości społeczności mikrobiologicznej w metagenomice oraz sekwencjonowaniu 16S rDNA. W związku z tym z każdej próbki wyizolowano całkowite DNA oraz HL-DNA.
Stężenie HL-DNA w każdej próbce plwociny po ekstrakcji DNA przedstawiono w Tabeli 2. Całkowita wydajność HL-DNA wynosiła od 210 ng do >5 μg. Biblioteki do sekwencjonowania Illumina przygotowano z całkowitej ilości materiału początkowego wynoszącej 1 ng dla każdej próbki (Rysunek 3). Charakterystyka danych metagenomicznych została przedstawiona w Tabeli 2. Wszystkie biblioteki, z wyjątkiem jednej, pozwoliły na uzyskanie ponad 1 miliona sekwencji, a po wstępnym przetwarzaniu danych za pomocą oprogramowania PRINSEQ29 zachowano ponad 85% sekwencji wysokiej jakości. Wszystkie zestawy danych poddano najpierw wstępnemu przetwarzaniu w celu usunięcia duplikatów i sekwencji niskiej jakości (minimalna wartość jakości 25), a następnie dalszemu przesiewowi i usunięciu sekwencji pochodzenia ludzkiego przy użyciu DeconSeq30. Ilość zanieczyszczeń sekwencjami pochodzenia ludzkiego jest w dużym stopniu zależna od właściwości próbki. W tym przypadku całkowita ilość sekwencji pochodzenia ludzkiego wynosiła od 14-46% (Tabela 2). Przetworzone sekwencje zaadnotowano następnie przy użyciu potoku Metaphlan31 oraz serwera MG-RAST32.
Oprócz metagenomów, biblioteki amplikonów 16S rDNA zostały wygenerowane zarówno z całkowitego DNA, jak i z HL-DNA przy użyciu starterów celujących w około 300 bp zmiennego regionu V1-V2 w genie 16S rRNA33,34. Produkty PCR z poszczególnych próbek zostały znormalizowane i połączone w celu sekwencjonowania z wykorzystaniem 500-cyklowego sekwencjonowania par końcowych (paired-end) Illumina na platformie MiSeq. Sekwencje amplikonów 16S rDNA par końcowych zostały posortowane według próbek za pomocą kodów kreskowych przy użyciu skryptu python, a odczyty parzyste zostały złożone za pomocą phrap35,36. Końce złożonych sekwencji były przycinane, aż średni wynik jakości wyniósł ≥20, przy zastosowaniu okna 5 nt. Potencjalne chimery zostały następnie usunięte za pomocą Uchime37 w odniesieniu do wolnego od chimer podzbioru referencyjnych sekwencji SILVA38. Taksonomia została przypisana do wysokiej jakości odczytów za pomocą SINA39 (wersja 1.2.11) przy użyciu 418 497 sekwencji bakteryjnych z bazy danych SILVA38. Sekwencje o identycznych przypisaniach taksonomicznych zostały zgrupowane w celu utworzenia jednostek taksonomicznych operacyjnych (OTU). Proces ten wygenerował 1 655 278 sekwencji dla 16 próbek (średnia wielkość: 103 455 sekwencji/próbka; min: 72 603; max: 127 113). Mediana wskaźnika pokrycia Goods, będącego miarą kompletności sekwencjonowania, wyniosła ≥ 99,9%. Do analiz i generowania wykresów wykorzystano pakiet oprogramowania Explicet40 (v2.9.4, www.explicet.org). Różnorodność alfa (wewnątrzpróbkowa) i beta (międzypróbkowa) zostały obliczone w programie Explicet w punkcie rarefakcji wynoszącym 72 603 sekwencje przy 100 ponownych próbkach bootstrapowych.
Pierwszym pytaniem badawczym w niniejszym opracowaniu było ustalenie, czy liza hipotoniczna preferencyjnie selekcjonuje (t.j. preferencyjnie zatrzymuje lub lize) określone grupy drobnoustrojów. Po pierwszej lizie hipotonicznej pobrano próby z resuspendowanego osadu komórkowego z dwóch pierwszych próbek (CF1-1A* i CF1-2A*), aby porównać je z tymi samymi próbkami po drugiej lizie hipotonicznej (CF1-1 i CF1-2). Wszystkie próbki traktowano w ten sam sposób, t.j. poddano działaniu DNazy I przed ekstrakcją DNA, a następnie przeprowadzono ekstrakcję DNA oraz procedurę sekwencjonowania. Jak pokazano na Rysunku 4, profile mikrobiologiczne podpróbek są wysoce podobne do próbek po dwóch zabiegach lizy hipotonicznej. Ponadto druga liza hipotoniczna zwiększa frakcję sekwencji niepochodzących od ludzi o 6-17% w obrębie metagenomów (Tabela 2).
Aby przetestować różnice w składzie mikrobiologicznym pomiędzy profilowaniem opartym na metagenomice a profilowaniem 16S rDNA, a także zmiany przed i po lizie hipotonicznej, które mogłyby wyjaśnić różnice zaobserwowane wcześniej między naszymi badaniami a innymi, przygotowano biblioteki sekwencjonowania 16S rDNA bakterii zarówno z całkowitego DNA, jak i DNA pochodzącego z HL (Rysunek 4B). Na poziomie rodzaju profile taksonomiczne powszechnych bakterii związanych z CF, takich jak Pseudomonas, Stenotrophomonas, Prevotella, Veillonella i Streptococcus, były bardzo podobne pomiędzy bibliotekami 16S rDNA a metagenomami wygenerowanymi z DNA pochodzącego z HL. Jednakże detekcja Rothia w bibliotekach 16S rDNA nie była tak obfita jak w bibliotekach metagenomicznych. Porównując profile taksonomiczne 16S rDNA wygenerowane z całkowitego DNA i DNA pochodzącego z HL, wykazano, że Pseudomonas była różnie reprezentowana w całkowitym DNA w porównaniu z DNA pochodzącym z HL, począwszy od 3. dnia.
Metatranskryptomy
Zazwyczaj całkowity RNA wyekstrahowany z plwociny pacjentów z mukowiscydozą (CF) jest częściowo zdegradowany, a jego wielkość mieści się w zakresie 25-4,000 bps (Rycina 5A oraz 5C). Tutaj zaprezentowano reprezentatywne wyniki, które zostały wcześniej opublikowane w pracy Lim et al. 20129. Ułamek rRNA w metatranskryptomach bez usuwania rRNA wynosi od 27-83%, a względna zawartość rRNA różniła się między próbkami (Tabela 3; dane zaczerpnięte z Lim et al.9). Jednakże usunięcie z zastosowaniem zestawu Ribo-Zero zmniejszyło względną zawartość rRNA do 1-5%, z wyjątkiem próbki CF1-F. Zmienność w skuteczności usuwania rRNA może odzwierciedlać jakość wyekstrahowanego RNA lub różnice w obecnej społeczności mikrobiologicznej, a tym samym dostępność rRNA do hybrydyzacji z sondami9. Różnią się elektroferogramy z udanej (Rycina 5B) i nieudanej (Rycina 5D) procedury usuwania rRNA przy użyciu zestawu Ribo-Zero rRNA removal kit, przy czym w przypadku nieudolnego usunięcia widoczne są piki rRNA.
Zakres wielkości generowanych bibliotek cDNA często odzwierciedla zakres wielkości wyjściowej próbki RNA. Biblioteki cDNA przedstawione w niniejszym opracowaniu zostały wytworzone przy użyciu zestawu do amplifikacji całego transkryptomu (WTA2) po usunięciu rRNA, a następnie poprzez przygotowanie biblioteki do sekwencjonowania Roche-4549. Wygenerowane cDNA zawiera fragmenty o długości od 50-4,000 bps (Rysunki 5E i 5F) i wykazuje wysoką spójność pomiędzy próbkami (Lim et al. 2012)9. Dostępność innych zestawów do przygotowania bibliotek RNA-Seq specyficznych dla danej platformy zapewnia obecnie więcej alternatywnych opcji łączenia syntezy cDNA i przygotowania biblioteki do sekwencjonowania w optymalnych warunkach. Jedną z rekomendowanych obecnie opcji jest ScriptSeq Complete Gold Kit, który łączy zalecane powyżej odczynniki do usuwania rRNA oraz zestaw do przygotowania biblioteki RNA-Seq.

Rycina 1: Schemat przepływu pracy dla przygotowania próbek związanych z gospodarzem, takich jak próbki plwociny, do sekwencjonowania viromu, mikrobiomu i metatranskryptomu.
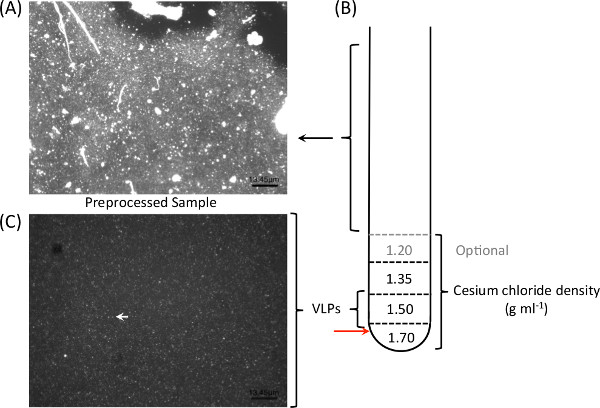
Rycina 2: Ultrawirowanie w gradientach gęstości chlorku cezu ułatwia eliminację zewnątrzkomórkowego DNA oraz dużych cząsteczek (A) i pozwala na optymalną izolację cząsteczek wirusopodobnych z plwociny pacjentów z CF. Przed nałożeniem wstępnie przetworzonej próbki (B), jeden mililitr każdego gradientu nakłada się warstwowo jeden na drugi. Po izolacji i oczyszczeniu cząsteczek, do weryfikacji obecności i czystości cząsteczek wirusowych w próbkach wykorzystuje się mikroskopię epifluorescencyjną z barwnikami kwasów nukleinowych, takimi jak SYBR Gold. Po separacji gradientem gęstości próbki plwociny z CF zaobserwowano wyraźne cząsteczki wirusopodobne (C; biała strzałka).
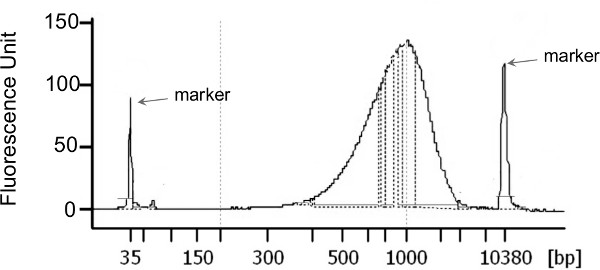
Rysunek 3: Przykład rozkładu wielkości bibliotek Nextera XT wygenerowanych z 1 ng HL-DNA, które posłużyły do analizy mikrobiomów plwociny w przypadku CF. Normalizacja bibliotek, łączenie próbek oraz ilość materiału nałożonego zostały wykonane zgodnie z protokołem producenta, bez żadnych odstępstw.
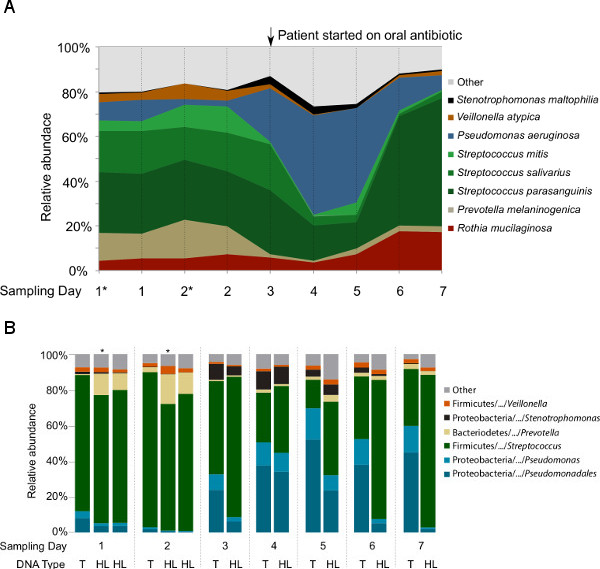
Rysunek 4: Analiza taksonomiczna społeczności mikrobiologicznych w dziewięciu próbkach pobranych wzdłużnie od jednego pacjenta z CF. (A) Profile mikrobiologiczne oparte na bibliotekach metagenomicznych wygenerowanych z DNA uzyskanego metodą lizy hipotonicznej. Przypisanie gatunkowe oparto na potoku Metaphlan po wstępnym przetwarzaniu danych w celu usunięcia duplikatów oraz sekwencji o niskiej jakości i homologii do sekwencji ludzkich. Aby wykazać, że dwuetapowa liza hipotoniczna nie selekcjonuje preferencyjnie określonych grup mikroorganizmów, uwzględniono podpróbki (*) po pierwszej lizie hipotonicznej. (B) Profile mikrobiologiczne oparte na sekwencjonowaniu regionu V1V2 genu 16S rRNA z całkowitego DNA (T) oraz DNA uzyskanego metodą lizy hipotonicznej (HL). Dane te nie były wcześniej publikowane.
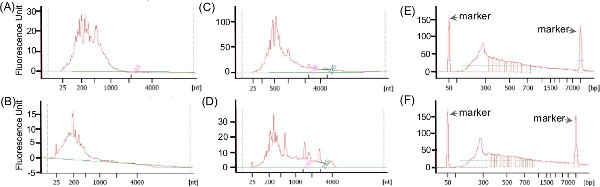
Rysunek 5: Przykłady elektroferogramów RNA (A-D) i cDNA (E-F) z analizatora Agilent 2100 Bioanalyzer, wygenerowane dla bibliotek metatranskryptomicznych przy użyciu odpowiednio chipów RNA pico oraz high-sensitivity dsDNA. (A) oraz (C) przedstawiają przykłady elektroferogramów przed procedurą usuwania rRNA. Elektroferogramy z poprawnej (B) oraz nieudanej (D) procedury usuwania rRNA z zastosowaniem zestawu total rRNA Removal kit różnią się nieznacznie; w przypadku nieudowanego usuwania widoczne są piki rRNA. Zakres wielkości cDNA (E-F) wygenerowanego przy użyciu zestawu do amplifikacji całego transkryptomu (Sigma-Aldrich) jest zbliżony do zakresu wielkości początkowego RNA pozbawionego rRNA i jest wysoce spójny dla dwóch różnych próbek. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| CF1-D | CF1-E | CF1-F | CF4-A | CF4-B | CF4-C | CF5-A | CF5-B | |
| Całkowita liczba odczytów | 224,859 | 87,891 | 106,189 | 93,301 | 140,020 | 1,558 | 272,552 | 217,438 |
| Odczyty po wstępnym przetwarzaniua | 109,389 | 73,624 | 67,070 | 82,011 | 68,617 | 1,137 | 215,808 | 158,432 |
| 49% | 84% | 63% | 88% | 49% | 73% | 79% | 73% | |
| Liczba zasad | 47,239,573 | 33,351,525 | 28,922,479 | 27,667,695 | 29,386,841 | 243,986 | 95,205,805 | 69,581,811 |
| Średnia długość odczytu | 432 | 453 | 431 | 337 | 428 | 215 | 441 | 439 |
| Sekwencje gospodarzab | 240 | 526 | 28 | 79,774 | 13 | 797 | 585 | 5,859 |
| 0.21% | 0.71% | 0.04% | 97.27% | 0.02% | 70.10% | 0.27% | 3.70% | |
| Trafienia wirusowec | 7,214 | 23,550 | 4,070 | 737 | 4,642 | 22 | 6,466 | 5,981 |
| 6.59% | 31.99% | 6.07% | 0.90% | 6.77% | 1.93% | 3.00% | 3.78% | |
| Odczyty nieprzypisaned | 103,888 | 60,490 | 32,780 | 1,935 | 68,440 | 311 | 105,612 | 119,551 |
| 94.97% | 82.16% | 48.87% | 2.36% | 99.74% | 27.35% | 48.94% | 75.46% | |
| a Odczyty po wstępnym przetwarzaniu danych za pomocą PRINSEQ29. | ||||||||
| b Ludzkie odczyty zidentyfikowane przez DeconSeq30 oraz odczyty z najlepszym trafieniem BLASTn (baza nukleotydowa NCBI) do typu Chordata. | ||||||||
| c Trafienia tBLASTx w wewnętrznej bazie genomów wirusowych. Procent obliczono na podstawie całkowitej liczby odczytów po wstępnym przetwarzaniu. | ||||||||
| d Odczyty bez trafień BLASTn w bazie nukleotydowej NCBI. Procent obliczono na podstawie całkowitej liczby odczytów po wstępnym przetwarzaniu. Niektóre odczyty bez trafień BLASTn w bazie nukleotydowej NCBI zostały zidentyfikowane jako wirusowe na poziomie białkowym w analizie tBLASTx. | ||||||||
Tabela 1: Charakterystyka bibliotek ośmiu wiromów wygenerowanych z próbek plwociny przy użyciu przedstawionego schematu postępowania. Tabela ta została wyodrębniona z pracy Lim et al. (2012)9. Siedem próbek (CF1-D, CF1-E, CF1-F, CF4-B, CF4-C, CF5-A oraz CF5-B) przetworzono zgodnie z opisem w Sekcji 2, co pozwoliło na wygenerowanie wiromów zawierających niewielką ilość (0,02% - 3,7%) sekwencji pochodzenia ludzkiego, z jednym wyjątkiem (70%). Próbkę CF4-A pominięto w etapie ultrawirowania w gradiencie gęstości (CF4-A), co doprowadziło do wygenerowania wiromu zawierającego > 97% sekwencji pochodzenia ludzkiego.
| Próbka | Stężenie | Wydajność całkowita | Całkowita liczba odczytów | Całkowita liczba odczytów (Przetworzoneb) | Sekwencje nie-ludzkie |
| (ng/μl) | (ng) | (Surowe)a) | (%) | ||
| CF1-1A* | 2.3 | 230 | 1,098,454 | 937,688 | 691,541 |
| 74% | |||||
| CF1-1 | 13 | 1,300 | 2,212,756 | 1,958,910 | 1,574,520 |
| 80% | |||||
| CF1-2A* | 2.1 | 210 | 672,878 | 588,106 | 407,530 |
| 69% | |||||
| CF1-2 | 5.2 | 520 | 1,944,012 | 1,697,010 | 1,455,174 |
| 86% | |||||
| CF1-3 | 28.8 | 2,880 | 1,048,304 | 896,756 | 560,852 |
| 63% | |||||
| CF1-4 | 24.1 | 2,410 | 1,154,922 | 984,702 | 621,098 |
| 63% | |||||
| CF1-5 | 33.6 | 3,360 | 1,029,622 | 888,630 | 481,548 |
| 54% | |||||
| CF1-6 | 43.2 | 4,320 | 1,434,016 | 1,256,504 | 725,858 |
| 58% | |||||
| CF1-7 | 57.8 | 5,780 | 1,000,174 | 872,036 | 565,376 |
| 65% | |||||
| * Pobrano 1 ml próbki z CF1-1 i CF1-2 po pierwszym etapie lizy hipotonicznej (Krok 3.1.5), przed drugą procedurą lizy hipotonicznej. Komórki odwirowano zgodnie z opisem w punkcie 3.1.7, a następnie kontynuowano pozostałą część protokołu bez żadnych modyfikacji. | |||||
| a Nieprzetworzone odczyty Illumina z sekwencjonowania na platformie MiSeq w formacie 2 x 300 bp. | |||||
| b Odczyty zostały ocenione, przycięte i usunięte na podstawie jakości i długości, zgodnie z opisem w dyskusji. | |||||
Tabela 2: Charakterystyka mikrobiomów wygenerowanych z próbek plwocy przy użyciu przedstawionego schematu postępowania. Przedstawiono stężenie DNA każdej próbki w 100 μl buforu elucyjnego (5 mM Tris/HCl, pH 8.5) oraz charakterystykę danych sekwencyjnych. Do wygenerowania poszczególnych bibliotek przy użyciu zestawu do przygotowania bibliotek Nextera XT wykorzystano łącznie 1 ng DNA.
| Próbka | CF1-D | CF1-F | CF4-B | CF4-C | ||||
| Opracowanie | Brak | Ribo-Zero | Brak | Ribo-Zero | Brak | Ribo-Zero | Brak | Ribo-Zero |
| Przetworzone odczyty | 2,088 | 1,991 | 40,876 | 25,238 | 19,728 | 32,737 | 31,791 | 36,172 |
| Średnia długość odczytu | 275 | 245 | 262 | 270 | 233 | 259 | 240 | 267 |
| Całkowita liczba odczytów rRNA | 1,737 | 91 | 29,499 | 17,267 | 5,285 | 291 | 16,371 | 1,761 |
| 83.20% | 4.60% | 72.20% | 68.40% | 26.80% | 0.90% | 51.50% | 4.90% | |
| Mikrobiologiczne rRNA | 1,414 | 32 | 19,978 | 12,035 | 23 | 227 | 6,916 | 1,076 |
| 67.70% | 1.60% | 48.90% | 47.70% | 0.10% | 0.70% | 21.80% | 3.00% | |
| Eukariotyczne rRNA | 323 | 59 | 9,520 | 5,232 | 5,262 | 64 | 9,455 | 683 |
| 15.50% | 3.00% | 23.30% | 20.70% | 26.70% | 0.20% | 29.70% | 1.90% | |
| % usuniętego rRNA* | 0% | 95% | 0% | 5% | 0% | 97% | 0% | 91% |
| Odczyty nie-rRNA | 351 (16.8%) | 1,900 (95.4%) | 11,377 (27.8%) | 7,971 (31.6%) | 14,443 (73.2%) | 32,446 (99.1%) | 15,420 (48.5%) | 34,411 (95.1%) |
| Całkowita liczba trafień NR | 102 (4.9%) | 691 (34.7%) | 3,327 (8.1%) | 2,857 (11.3%) | 4,938 (25.0%) | 10,751 (32.8%) | 5,905 (18.6%) | 15,766 (43.6%) |
| Eukariotyczne | 74 | 407 | 2,790 | 2,524 | 4,614 | 10,227 | 4,553 | 8,274 |
| Bakterialne | 26 | 283 | 520 | 312 | 287 | 471 | 1,326 | 7,442 |
| Odczyty nieprzypisane | 249 (11.9%) | 1,209 (60.7%) | 8,050 (19.7%) | 5,114 (20.3%) | 9,505 (48.2%) | 21,695 (66.3%) | 9,515 (29.9%) | 18,645 (51.5%) |
| *Ilość usuniętego rRNA wyrażona jako procent ilości obecnej w nieoddeplecyjnej alikwocie. | ||||||||
Tabela 3: Charakterystyka bibliotek metatranskryptomów z i bez usuwania rRNA.Dane zostały wyodrębnione z pracy Lim et al. (2012)9, która zawiera dodatkowe porównanie innych zestawów do usuwania rRNA oraz analizę wpływu nebulizacji cDNA przed przygotowaniem biblioteki do sekwencjonowania.
Dyskusja
Metagenomika wirusowa
Cząsteczki wirusa są zagęszczane za pomocą wytrącania glikolu polietylenowego (PEG) lub koncentratorów o małej objętości. W niektórych przypadkach zatężanie może nie być potrzebne, ale do usunięcia komórek eukariotycznych i drobnoustrojów stosuje się etapy filtracji wstępnej lub wirowania z niską prędkością. Lizaty wirusowe będą dalej wzbogacane i oczyszczane za pomocą ultrawirowania w gradiencie gęstości9,41 lub filtrów o małych rozmiarach (np. 0,45 μm) w celu usunięcia komórek eukariotycznych i dużych komórek drobnoustrojów25. Ultrawirowanie w gradiencie gęstości jest zwykle wykonywane przy użyciu gęstych, ale obojętnych roztworów, takich jak sacharoza lub chlorek cezu, w celu wyizolowania i zagęszczenia cząstek wirusa41. Separacja fizyczna opiera się na wielkości i gęstości wyporu cząstek wirusa. W związku z tym właściwy dobór wielkości porów filtra i rygorystyczne przygotowanie gradientów są niezbędne do wyizolowania określonych społeczności wirusów, ponieważ powodzenie fizycznego odzyskania VLP określa społeczność wyizolowaną41 (tj. cząsteczki wirusa, które nie przechodzą przez filtr lub nie mieszczą się w gęstości ekstrakcji, nie zostaną wykryte w metagenomie). Po wyizolowaniu i zagęszczeniu wirusa w próbce może znajdować się zanieczyszczający niewirusowy materiał genomowy zarówno w postaci wolnych kwasów nukleinowych, jak i komórek drobnoustrojów i komórek eukariotycznych. Dlatego tak ważne jest sprawdzenie czystości cząstek wirusa w próbkach (ryc. 1A i 1B). Leczenie chloroformem jest powszechnie stosowane do lizy pozostałych komórek, a następnie traktowanie nukleazą w celu degradacji wolnych kwasów nukleinowych przed ekstrakcją kwasów nukleinowych.
Zastrzeżeniem do przedstawionego przepływu pracy było zastosowanie separacji gradientu gęstości do izolacji cząstek wirusa, ponieważ może to wykluczyć otoczkowe cząstki wirusa, które mogą być zbyt wyporne, aby dostać się do gradientu CsCl. Alternatywną metodą typu "catch-all" jest pominięcie separacji gradientu gęstości i wyizolowanie DNA zbiorowiska z 0,45 μm – filtratów potraktowanych chloroformem i DNazą I. Takie podejście jest również odpowiednie do uwzględnienia małych objętości próbek, takich jak te z wymazów lub osocza krwi. Może to jednak skutkować zanieczyszczeniem bakteryjnym odpornym na chloroform i większą ilością zewnątrzkomórkowego DNA opornego na DNazę I.
Obecne protokoły sekwencjonowania wymagają od 1 ng do 1 μg kwasów nukleinowych do przygotowania biblioteki sekwencjonowania, przy czym wyższa wydajność DNA zapewnia szerszy wybór opcji sekwencjonowania. Stężenie DNA w generowanych wiromach często waha się od poniżej granicy wykrywalności do ponad 200 ng/μl. Ilość odzyskanych wirusowych kwasów nukleinowych może być niewystarczająca do przygotowania biblioteki sekwencjonowania bezpośredniego. W takich przypadkach niezbędna jest amplifikacja kwasów nukleinowych. Biblioteki amplifikacji linkerowej (LASL)2,42,43 i amplifikacja całego genomu oparta na amplifikacji z wielokrotnym przemieszczeniem (MDA) to dwie metody najczęściej stosowane do generowania wystarczającej ilości DNA do sekwencjonowania. Wiadomo, że metody MDA, takie jak te oparte na polimerazie DNA Phi29, cierpią na błędy amplifikacji i mogą preferencyjnie amplifikować ssDNA i koliste DNA, co skutkuje nieilościową charakterystyką taksonomiczną i funkcjonalną44,45. Wykazano, że zoptymalizowana wersja podejścia LASL wprowadza jedynie minimalne odchylenia, promuje wyższą czułość (dla niewielkich ilości materiału wyjściowego) i jest łatwa do dostosowania do różnych platform sekwencjonowania43. Jednak podejście to składa się z wielu etapów, wymaga specjalistycznego sprzętu w celu zminimalizowania utraty DNA i ogranicza się do matryc dsDNA. W naszym laboratorium podejście to zostało z powodzeniem zaadaptowane do amplifikacji wykrywalnej i niewykrywalnej ilości DNA wyekstrahowanego z VLP pochodzących z płukania oskrzelowo-pęcherzykowego, koralowców i wody morskiej (niepublikowane i Hurwitz i wsp.Tamże, s. 46).
Opracowywanie potoków analizy danych było klasycznie jednym z najtrudniejszych aspektów analizy metagenomiki wirusów ze względu na bardzo zróżnicowany i w dużej mierze nieznany charakter społeczności wirusowych. Chociaż szacuje się, że w biosferze występuje 108 genotypów wirusów, do tej pory obecne bazy danych wirusów zawierają ~ 4 000 genomów wirusowych, co stanowi około 1/100 000 tej przybliżonej całkowitej różnorodności wirusów. W związku z tym poszukiwania oparte na podobieństwie (takie jak BLAST47) w celu przypisania taksonomicznego i funkcjonalnego w metagenomach wirusowych wiążą się z nieodłącznymi wyzwaniami. Wiele sekwencji nie wykazuje znaczących podobieństw do genomów w bazie danych i dlatego są klasyfikowane jako nieznane. Mimo że wyszukiwania oparte na homologii są najważniejszymi zastosowaniami do przypisywania taksonomii i funkcji do danych sekwencji, opracowano alternatywne podejścia oparte na analizie niezależnej od bazy danych48-50. Fancello i wsp.51 zawierają pełny przegląd narzędzi obliczeniowych i algorytmów stosowanych w metagenomice wirusów.
Metagenomika mikrobiologiczna
Zazwyczaj całkowita ilość DNA wyekstrahowanego ze zbiorowisk drobnoustrojów poddanych hipotonicznej lizie (HL-DNA) waha się od 20 ng do 5 μg. Wydajność jest w dużym stopniu zależna od stanu zdrowia pacjenta i ilości pobranej próbki plwociny, co wyjaśnia różnice obserwowane w całkowitej wydajności HL-DNA wyekstrahowanego w tym badaniu (Tabela 2). Krytyczne kroki generowania dobrej jakości danych sekwencyjnych zależą od jakości generowanych bibliotek sekwencjonowania. Rysunek 2 przedstawia typowy zakres rozmiarów bibliotek sekwencjonowania wygenerowanych z DNA drobnoustrojów pochodzących z plwociny CF przy użyciu procedury fragmentacji DNA opartej na enzymatyce. Optymalna wielkość biblioteki zależy od wyboru platformy sekwencjonowania i aplikacji, dlatego procedurę fragmentacji można w razie potrzeby zoptymalizować za pomocą alternatywnych podejść, takich jak sonikacja i nebulizacja. Oprócz przedstawionych reprezentatywnych wyników, sukces przedstawionej metody na plwocinie mukowiscydozy pobranej od wielu pacjentów w wielu punktach czasowych zilustrowano również w Lim i wsp. (2012)9 oraz Lim i wsp. (2014)Rozdział 10.
Poprzednie badania9,10 sugerują, że każdy pacjent jest nosicielem unikalnego zestawu społeczności drobnoustrojów, który zmienia się w czasie, odzwierciedlając w ten sposób trwałość głównych graczy w społeczności, podczas gdy wahania są prawdopodobnie spowodowane zaburzeniami, takimi jak leczenie antybiotykami. To, czy fluktuacje te występują codziennie, nawet bez zewnętrznych zakłóceń, czy też z powodu procedury pobierania próbek i przetwarzania próbek, jest nadal wątpliwe. Na podstawie analizy metagenomicznej HL-DNA i amplikonu 16S rDNA, 7-dniowe pobieranie próbek podłużnych pokazuje, że dzienne wahania profili mikrobiologicznych bez zaburzeń antybiotykowych (dzień 1, 2 i 3) były minimalne (ryc. 3A i 3B). Po wprowadzeniu doustnych antybiotyków natychmiast po pobraniu próbek w dniu 3, zmiany w profilu społeczności stały się widoczne w dniu 4. Podczas gdy antybiotyk cyprofloksacyna jest ukierunkowany na szerokie spektrum znanych patogenów bakteryjnych, takich jak P. aeruginosa, Staphylococcus aureus i Streptococcus pneumonia, leczenie zwiększyło względną liczebność P. aeruginosa, jednocześnie zmniejszając Streptococcus spp. i P. melaninogenica. Do dnia 6 społeczność powoli wracała do początkowej struktury społeczności. Wyniki sugerują, że wahania profili mikrobiologicznych u jednego pacjenta są bardziej prawdopodobne z powodu zaburzeń środowiskowych w drogach oddechowych.
Biorąc pod uwagę spójność między profilami mikrobiologicznymi bibliotek 16S rDNA a metagenomami z DNA pochodzącego z HL, wykluczyliśmy odchylenia pochodzące ze starterów 16S rRNA użytych w tym badaniu. Jednym z możliwych wyjaśnień różnic obserwowanych w profilach taksonomicznych 16S rDNA wygenerowanych z całkowitego DNA i DNA pochodzącego z HL (Figura 3B) może być obecność dużych ilości zewnątrzkomórkowego DNA Pseudomonas spp. po leczeniu antybiotykami. Potwierdzają to wyniki, że różnice te były najbardziej widoczne w dniu 7, trzy dni po leczeniu antybiotykami, które są skierowane przeciwko Pseudomonas spp. oprócz innych. Ciprofloksacyna jest powszechnie stosowana jako lek pierwszego rzutu u pacjentów z mukowiscydozą i przewlekłym zakażeniem P. aeruginosa, mimo że jej spektrum działania obejmuje większość patogenów związanych z mukowiscydozą. Postawiliśmy hipotezę, że antybiotykoterapia eliminuje podatne społeczności, w tym Streptococcus spp., tworząc w ten sposób niszę wypełnioną przez oporny P. aeruginosa. Pseudomonas aeruginosa może uzyskać odporność poprzez zwiększenie swoich zbiorowisk biofilmu, a zewnątrzkomórkowe DNA okazało się być głównym wsparciem strukturalnym architektury biofilmu52. Nawet gdy struktura społeczności się odbudowała, zewnątrzkomórkowe DNA mogło pozostać w plwocinie mukowiscydozy. Dlatego dane te sugerują, że hipotoniczna liza i etapy mycia przedstawione w tym przepływie pracy potencjalnie przynoszą korzyści nie tylko w usuwaniu DNA pochodzącego od człowieka, ale także zewnątrzkomórkowego DNA pochodzącego z drobnoustrojów, które może błędnie przedstawiać rzeczywiste profile mikrobiologiczne.
Metatranskryptomika
Metatranskryptom wysokiej jakości powinien zawierać stosunkowo niewiele sekwencji rybosomalnego RNA (rRNA) i reprezentować bezstronną próbkę transkryptów społeczności (mRNA). Ze względu na krótki okres półtrwania i ograniczoną ilość mRNA, bardzo ważne jest, aby przedstawiony tutaj protokół minimalizował obsługę próbek, aby zmaksymalizować liczbę odzyskanych transkryptów.
W ostatnich latach opracowano kilka podejść do zubożenia rRNA, które zaadaptowano do dostępnych na rynku zestawów. Należą do nich MICROBEnrich, Ribo-Zero i specyficzne dla próbki hybrydyzacjesubtraktywne 53 , które są oparte na hybrydyzacji oligonukleotydowej, oraz zestaw mRNA-ONLY, który opiera się na aktywności enzymatycznej egzonukleazy ukierunkowanej na RNA zawierającą monofosforan 5'. Ponadto dostępnych jest również kilka podejść do wzbogacania mRNA, takich jak zestaw MessageAmp II-Bacteria Kit, który preferencyjnie poliadenyluje i amplifikuje liniowe RNA. Niektóre z tych metod (np. mRNA-ONLY, MICROBExpress i MessageAmp) są stosowane jednocześnie w celu uzyskania optymalnej wydajności. Jednak skuteczność wszystkich tych podejść jest ograniczona, zwłaszcza podczas pracy z częściowo zdegradowanym rRNA, co często obserwuje się w całkowitym RNA wyekstrahowanym z próbek mukowiscydozy. Amplifikacja RNA zależna od poliadenylacji nie może być stosowana do generowania metatranskryptomów składających się zarówno z eukariotycznego, jak i prokariotycznego mRNA. Ponadto, ogon poli(A) dodany do sekwencji może zmniejszyć ilość użytecznych danych sekwencji. Regiony z rozciągnięciem homopolimeru będą miały tendencję do uzyskiwania niższych wyników jakości, co spowoduje, że znaczna liczba odczytów zostanie odfiltrowana przez oprogramowanie do sekwencjonowania i sekwencjonowania, a średnia użyteczna długość odczytu po odcięciu ogonów poli (A) zostanie znacznie zmniejszona54.
Mając do czynienia ze złożonymi zbiorowiskami drobnoustrojów mukowiscydozy i częściowo zdegradowanym RNA (ryc. 4A i 4C), nasze poprzednie badanie wykazało, że metoda hybrydyzacji-wychwytywania za pomocą zestawu Ribo-Zero Gold była bardziej skuteczna w usuwaniu zarówno ludzkiego, jak i mikrobiologicznego rRNA w porównaniu z łączonymi zabiegami przy użyciu innych zestawów9 (Tabela 3). Uzyskane w ten sposób dane pozwalają na jednoczesną analizę zarówno transkryptów ludzkiego gospodarza, jak i mikrobiologicznych. W zależności od wydajności i jakości RNA, a także ostatecznego wyboru platformy sekwencjonowania, wiele z tych procesów, w tym etap syntezy cDNA, można usprawnić dzięki generowaniu biblioteki sekwencjonowania. Na przykład RNA traktowane Ribo-Zero można wykorzystać do tworzenia bibliotek sekwencjonowania metatranskryptomu przy użyciu zestawu ScriptSeq RNA-Seq Library Preparation Kit.
Analiza metagenomiczna społeczności związanych ze zwierzętami zapewnia kompleksową reprezentację ogólnej jednostki funkcjonalnej, która obejmuje gospodarza i powiązane z nim społeczności. Przedstawiony tutaj przepływ pracy można dostosować do różnych złożonych próbek związanych ze zwierzętami, zwłaszcza tych, które zawierają gęsty śluz, duże ilości szczątków komórkowych, zewnątrzkomórkowe DNA, kompleksy białkowe i glikoproteinowe, a także komórki gospodarza oprócz pożądanych cząstek wirusowych i mikrobiologicznych. Mimo że cząsteczki wirusów i drobnoustrojów mogą zostać utracone na każdym kroku, izolacja i oczyszczanie cząstek są niezbędne, aby zminimalizować ilość DNA gospodarza. Podczas gdy dane metagenomiczne dostarczają potencjałów metabolicznych badanych społeczności, metatranskryptomika uzupełnia je, ujawniając różnicową ekspresję zakodowanych funkcji9. Kompleksowa ocena danych genomicznych i transkryptów dostarczyła nowych informacji na temat dynamiki interakcji społeczności i ułatwia opracowanie ulepszonych terapii9,10,55.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Ta praca została wsparta przez Narodowy Instytut Zdrowia (1 R01 GM095384-01) przyznany Forestowi Rohwerowi. Dziękujemy Epicentre, firmie należącej do Illumina, za zapewnienie wczesnego dostępu do zestawów epidemiologicznych Ribo-Zero. Dziękujemy Markowi Hatayowi za zaprojektowanie i wyprodukowanie uchwytu na probówkę do ultrawirówki. Dziękujemy Andreasowi Haasowi i Benjaminowi Knowlesowi za krytyczną lekturę i dyskusję na temat rękopisu, a także Lauren Paul za pomoc w procesie filmowania.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Bufor do lizy RNA na bazie izotiocyjanianu guanidyny | Life Technologies | 10296-028 | TRIzol LS Odczynnik został użyty w tym badaniu |
| Kulki krzemionkowe; 0,1 do 0,15 mm | Cole-Parmer | YO-36270-62 | W tym badaniu użyto kulek cyrkonowo-krzemianowych |
| Ditiothreitol, klasa cząsteczkowa (suchy proszek) | Promega | V3155 | Można kupić w dowolnej innej firmie |
| Sterylny filtr strzykawkowy; 0,45 &mikro; m wielkość porów hydrofilowa membrana PVDF | Milipore | SLHV033RS | |
| enzym DNazy I | Calbiochem | 260913 | |
| Sterylny filtr strzykawkowy; 0,02 &mikro; m wielkość porów | FisherScientific | 09-926-13 | Średnica: 25 mm |
| Ultra-przezroczyste probówki wirówkowe | Beckman | 344059 | 9/16 x 3 & frac12; in. (14 x 90 mm), nadaje się do wirnika SW41 Ti i ultrawirowania gradientu gęstości VLP |
| SW41 Ti Rotor | Beckman | 333790 | |
| SS-34 wirnik o stałym kącie | Thermo Scientific | 28020 | |
| Phi29 polimeraza DNA | Monserate Biotech | 4001 | 10 U/µ l |
| Phi29 Losowy heksamer | Thermo Scientific | S0181 | Wcześniej zakupiony od Fidelity Systems |
| Filtr matrycowy z tlenku glinu z pierścieniowym polipropylenowym pierścieniem nośnym; 0,02 i mikro; m wielkość porów | FisherScientific | 09-926-34 | W pracy wykorzystano membrany filtracyjne Whatman Anodisc; średnica 25 mm |
| SYBR Złota plama w żelu kwasu nukleinowego | Life Technologies | S-11494 | |
| 2-merkaptoetanol | Sigma-Aldrich | M6250-100ML | |
| DNaza wolna od RNaz I | NEB | M0303S | Można kupić w dowolnej innej firmie |
| Glikogen, klasa RNA | FisherScientific | FERR0551 | Można kupić w dowolnej innej firmie |
| Szybkie probówki wirówkowe Oak Ridge | FisherScientific | 05-562-16B | Do procedury ekstrakcji DNA o dużej objętości, odpowiednia do wirnika SS-34 o stałym kącie działania |
| Zestaw do usuwania całkowitego rRNA | Epicentrum | MRZE724 | ScriptSeq Complete Gold Kit (Epidemiologia) może być używany do łączenia usuwania rRNA z przygotowaniem biblioteki sekwencjonowania |
| Chlorek cezu | FisherScientific | BP1595-500 | |
| Bromek heksadecytrimetyloamoniowy (CTAB) | Sigma-Aldrich | H5882-100G |
Bibliografia
- Suau, A., et al. Direct analysis of genes encoding 16S rRNA from complex communities reveals many novel molecular species within the human gut. Applied and Environmental Microbiology. 65 (11), 4799-4807 (1999).
- Breitbart, M., et al. Genomic analysis of uncultured marine viral communities. Proceedings of the National Academy of Sciences. 99 (22), 14250-14255 (2002).
- Proctor, L. M. The human microbiome project in 2011 and beyond. Cell Hos., & Microbe. 10 (4), 287-291 (2011).
- Charlson, E. S., et al. Topographical continuity of bacterial populations in the healthy human respiratory tract. American Journal of Respiratory and Critical Care Medicine. 184 (8), 957-963 (2011).
- Pragman, A. A., Kim, H. B., Reilly, C. S., Wendt, C., Isaacson, R. E. The lung microbiome in moderate and severe chronic obstructive pulmonary disease. PLoS ONE. 7 (10), e47305(2012).
- Kerem, B., et al. Identification of the Cystic Fibrosis gene: Genetic analysis. Science. 245 (4922), 1073-1080 (1989).
- Kleven, D., McCudden, C., Willis, M. Cystic Fibrosis: Newborn screening in America. Medical Laboratory Observer. 40 (7), 16-27 (2008).
- Fodor, A. A., et al. The adult cystic fibrosis airway microbiota is stable over time and infection type, and highly resilient to antibiotic treatment of exacerbations. PLoS ONE. 7 (9), e45001(2012).
- Lim, Y. W., et al. Metagenomics and metatranscriptomics: Windows on CF-associated viral and microbial communities. Journal of Cystic Fibrosis: Official Journal of the European Cystic Fibrosis Society. 12 (2), 154-164 (2012).
- Lim, Y. W., et al. Clinical insights from metagenomic analysis of sputum samples from patients with cystic fibrosis. Journal of Clinical Microbiology. 52 (2), 425-437 (2014).
- Claesson, M. J., et al. Comparison of two next-generation sequencing technologies for resolving highly complex microbiota composition using tandem variable 16S rRNA gene regions. Nucleic Acids Research. 38 (22), e200(2010).
- Breitenstein, S., Tümmler, B., Römling, U. Pulsed field gel electrophoresis of bacterial DNA isolated directly from patients’ sputa. Nucleic Acids Research. 23 (4), 722-723 (1995).
- Shak, S., Capon, D. J., Hellmiss, R., Marsters, S. A., Baker, C. L. Recombinant human DNase I reduces the viscosity of Cystic Fibrosis sputum. Proceedings of the National Academy of Sciences. 87 (23), 9188-9192 (1990).
- Lethem, M., James, S., Marriott, C., Burke, J. The origin of DNA associated with mucus glycoproteins in Cystic Fibrosis sputum. European Respiratory Journal. 3 (1), 19-23 (1990).
- Childs, W. C., Gibbons, R. J. Use of percoll density gradients for studying the attachment of bacteria to oral epithelial cells. Journal of Dental Research. 67 (5), 826-830 (1988).
- Lee, J. -L., Levin, R. E. Use of ethidium bromide monoazide for quantification of viable and dead mixed bacterial flora from fish fillets by polymerase chain reaction. Journal of Microbiological Methods. 67 (3), 456-462 (2006).
- Breitenstein, S., Tümmler, B., Römling, U. Pulsed field gel electrophoresis of bacterial DNA isolated directly from patients’ sputa. Nucleic Acids Research. 23 (4), 722-723 (1995).
- Mokili, J. L., Rohwer, F., Dutilh, B. E. Metagenomics and future perspectives in virus discovery. Current Opinion in Virology. 2 (1), 63-77 (2012).
- Bibby, K. Improved bacteriophage genome data is necessary for integrating viral and bacterial ecology. Microbial Ecology. 67 (2), 242-244 (2014).
- Willner, D., et al. Metagenomic analysis of respiratory tract DNA viral communities in Cystic Fibrosis and non-Cystic Fibrosis individuals. PloS One. 4 (10), e7370(2009).
- Willner, D., Furlan, M. Deciphering the role of phage in the cystic fibrosis airway. Virulence. 1 (4), 309-313 (2010).
- Willner, D., et al. Case studies of the spatial heterogeneity of DNA viruses in the cystic fibrosis lung. American Journal of Respiratory Cell and Molecular Biology. 46 (2), 127-131 (2012).
- Bomar, L., Maltz, M., Colston, S., Graf, J. Directed culturing of microorganisms using metatranscriptomics. mBio. 2 (2), e00012-e00011 (2011).
- He, S., et al. Metatranscriptomic array analysis of “Candidatus Accumulibacter phosphatis”-enriched enhanced biological phosphorus removal sludge. Environmental Microbiology. 12 (5), 1205-1217 (2010).
- Mokili, J. L., et al. Identification of a novel Human Papillomavirus by metagenomic analysis of samples from patients with febrile respiratory illness. PLOS ONE. 8 (3), e58404(2013).
- Henig, N. R., Tonelli, M. R., Pier, M. V., Burns, J. L., Aitken, M. L. Sputum induction as a research tool for sampling the airways of subjects with Cystic Fibrosis. Thorax. 56 (4), 306-311 (2001).
- Rogers, G. B., et al. Use of 16S rRNA gene profiling by terminal restriction fragment length polymorphism analysis to compare bacterial communities in sputum and mouthwash samples from patients with Cystic Fibrosis. J. Clin. Microbiol. 44 (7), 2601-2604 (2006).
- Haas, A., et al. Unraveling the unseen players in the ocean - a field guide to water chemistry and marine microbiology. Journal of Visualized Experiments. In press, Forthcoming.
- Schmieder, R., Edwards, R. Quality control and preprocessing of metagenomic datasets. Bioinformatics. 27 (6), 863-864 (2011).
- Schmieder, R., Edwards, R. Fast identification and removal of sequence contamination from genomic and metagenomic datasets. PLOS ONE. 6 (3), e17288(2011).
- Segata, N., et al. Metagenomic microbial community profiling using unique clade-specific marker genes. Nature Methods. 9 (8), 811-814 (2012).
- Meyer, F., et al. The metagenomics RAST server - a public resource for the automatic phylogenetic and functional analysis of metagenomes. BMC Bioinformatics. 9 (1), 386(2008).
- Hara, N., et al. Prevention of virus-induced type 1 diabetes with antibiotic therapy. Journal of Immunology (Baltimore, Md.: 1950). 189 (8), 3805-3814 (2012).
- Markle, J. G. M., et al. Sex differences in the gut microbiome drive hormone-dependent regulation of autoimmunity. Science (New York, N.Y.). 339 (6123), 1084-1088 (2013).
- Ewing, B., Green, P. Base-calling of automated sequencer traces using phred. II. Error probabilities. Genome Research. 8 (3), 186-194 (1998).
- Ewing, B., Hillier, L., Wendl, M. C., Green, P. Base-calling of automated sequencer traces using phred. I. Accuracy assessment. Genome Research. 8 (3), 175-185 (1998).
- Edgar, R. C., Haas, B. J., Clemente, J. C., Quince, C., Knight, R. UCHIME improves sensitivity and speed of chimera detection. Bioinformatics (Oxford, England). 27 (16), 2194-2200 (2011).
- Quast, C., et al. The SILVA ribosomal RNA gene database project: improved data processing and web-based tools. Nucleic Acids Research. 41 (Database issue), D590-D596 (2013).
- Pruesse, E., Peplies, J., Glöckner, F. O. SINA: accurate high-throughput multiple sequence alignment of ribosomal RNA genes. Bioinformatics (Oxford, England). 28 (14), 1823-1829 (2012).
- Robertson, C. E., et al. Explicet: graphical user interface software for metadata-driven management, analysis and visualization of microbiome data. Bioinformatics (Oxford, England). 29 (23), 3100-3101 (2013).
- Thurber, R. V., Haynes, M., Breitbart, M., Wegley, L., Rohwer, F. Laboratory procedures to generate viral metagenomes. Nat. Protocols. 4 (4), 470-483 (2009).
- Henn, M. R., et al. Analysis of high-throughput sequencing and annotation strategies for phage genomes. PLoS ONE. 5 (2), e9083(2010).
- Duhaime, M. B., Deng, L., Poulos, B. T., Sullivan, M. B. Towards quantitative metagenomics of wild viruses and other ultra-low concentration DNA samples: a rigorous assessment and optimization of the linker amplification method. Environmental Microbiology. 14 (9), 2526-2537 (2012).
- Yilmaz, S., Allgaier, M., Hugenholtz, P. Multiple displacement amplification compromises quantitative analysis of metagenomes. Nat Meth. 7 (12), 943-944 (2010).
- Kim, K. -H., Bae, J. -W. Amplification methods bias metagenomic libraries of uncultured single-stranded and double-stranded DNA viruses. Applied and Environmental Microbiology. 77 (21), 7663-7668 (2011).
- Hurwitz, B. L., Deng, L., Poulos, B. T., Sullivan, M. B. Evaluation of methods to concentrate and purify ocean virus communities through comparative, replicated metagenomics. Environmental Microbiology. 15 (5), 1428-1440 (2013).
- Altschul, S. F., Gish, W., Miller, W., Myers, E. W., Lipman, D. J. Basic local alignment search tool. Journal of Molecular Biology. 215, 403-410 (1990).
- Angly, F., et al. PHACCS, an online tool for estimating the structure and diversity of uncultured viral communities using metagenomic information. BMC Bioinformatics. 6 (1), 41(2005).
- Angly, F. E., et al. The GAAS Metagenomic Tool and Its Estimations of Viral and Microbial Average Genome Size in Four Major Biomes. PLoS Comput Biol. 5 (12), (2009).
- Dutilh, B. E., et al. Reference-independent comparative metagenomics using cross-assembly: crAss. Bioinformatics (Oxford, England). 28 (24), 3225-3231 (2012).
- Fancello, L., Raoult, D., Desnues, C. Computational tools for viral metagenomics and their application in clinical research. Virology. 434 (2), 162-174 (2012).
- Allesen-Holm, M., et al. A characterization of DNA release in Pseudomonas aeruginosa cultures and biofilms. Molecular Microbiology. 59 (4), 1114-1128 (2006).
- Stewart, F. J., Ottesen, E. A., DeLong, E. F. Development and quantitative analyses of a universal rRNA-subtraction protocol for microbial metatranscriptomics. ISME J. 4 (7), 896-907 (2010).
- Frias-Lopez, J., et al. Microbial community gene expression in ocean surface waters. Proceedings of the National Academy of Sciences. 105 (10), 3805-3810 (2008).
- Lim, Y. W., et al. Mechanistic model of Rothia mucilaginosa adaptation toward persistence in the CF lung, based on a genome reconstructed from metagenomic data. PLOS ONE. 8 (5), e64285(2013).
Przedruki i uprawnienia
