Tutaj prezentujemy protokół śledzenia zanieczyszczenia genomowym DNA (gDNA) w próbkach RNA. W prezentowanej metodzie wykorzystuje się startery specyficzne dla wewnętrznego transkrybowanego regionu dystansowego (ITS) genów rybosomalnego DNA (rDNA). Metoda ta nadaje się do niezawodnego i czułego wykrywania zanieczyszczenia DNA u większości eukariontów i prokariontów.
Artykuł metodologiczny
Ocena zanieczyszczenia DNA w próbkach RNA na podstawie rybosomalnego DNA
W tym artykule
Podsumowanie
Streszczenie
Jedną z metod szeroko stosowanych do ilościowego oznaczania zmian ekspresji genów i obfitości transkryptów jest ilościowy PCR w czasie rzeczywistym z odwrotną transkrypcją (RT-qPCR). Zapewnia dokładne, czułe, wiarygodne i powtarzalne wyniki. Na czułość i swoistość RT-qPCR może wpływać kilka czynników. Jednym z nich jest resztkowe genomowe DNA (gDNA) zanieczyszczające próbki RNA. W analizie ekspresji genów niespecyficzna amplifikacja spowodowana zanieczyszczeniem gDNA spowoduje przeszacowanie obfitości poziomów transkryptów i może wpłynąć na wyniki RT-qPCR. Ogólnie rzecz biorąc, gDNA jest wykrywane za pomocą qRT-PCR przy użyciu par starterów wyżarzających się do regionów międzygenowych lub intronu genu będącego przedmiotem zainteresowania. Niestety, adnotacje intronów/eksonów nie są jeszcze znane dla wszystkich genów kręgowców, bakterii, protistów, grzybów, roślin i bezkręgowców z gatunków metazoan.
Tutaj prezentujemy protokół wykrywania zanieczyszczenia gDNA w próbkach RNA za pomocą starterów opartych na rybosomalnym DNA (rDNA). Metoda opiera się na unikalnych cechach rDNA: ich wielogenowym charakterze, wysoce konserwatywnych sekwencjach i wysokiej częstotliwości w genomie. Również w ramach studium przypadku zaprojektowano unikalny zestaw starterów w oparciu o konserwatywny region rybosomalnego DNA (rDNA) w rodzinie Poaceae. Uniwersalność tych par starterów przetestowano za pomocą analizy krzywej topnienia i elektroforezy w żelu agarozowym. Chociaż nasza metoda wyjaśnia, w jaki sposób startery na bazie rDNA można zastosować do testu zanieczyszczenia gDNA w rodzinie Poaceae, można ją łatwo zastosować do innych gatunków prokariontów i eukariontów
Wprowadzenie
Badanie regulacji transkrypcji interesujących zestawów genów lub sieci sygnałowych jest niezbędne do zrozumienia złożonych mechanizmów molekularnych związanych ze zdarzeniami biologicznymi1. Obecnie analiza qPCR jest najpowszechniej stosowanym podejściem do badań ekspresji genów, które mogą być ukierunkowane na DNA (genom) lub RNA (transkryptom), które umożliwiają odpowiednio analizę metylomu i transkryptomu. Odwrotna transkrypcja (RT), a następnie qPCR, jest szeroko stosowana do analizy transkryptomu, która mierzy poziomy ekspresji genów w różnych obszarach badań biologicznych2. W porównaniu z innymi metodami, takimi jak tradycyjna hybrydyzacja północna, wykrywanie specyficzne dla tkanek za pomocą hybrydyzacji in situ, testy ochrony rybonukleazy (RPA) i semi-RT-PCR, dokładność, wygoda, szybkość i szeroki zakres dynamiczny testów opartych na qPCR są bardzo niezwykłe3,4. Istnieje kilka ważnych czynników, które należy wziąć pod uwagę w celu wiarygodnego określenia ilościowego informacyjnego RNA (mRNA), w tym jakość i ilość materiału wyjściowego RNA. Ponadto należy wziąć pod uwagę amplifikację niespecyficzną, skuteczność RT-qPCR i wydajność PCR5,6.
Obecność gDNA jest nieodłącznym problemem podczas ekstrakcji RNA, częściowo ze względu na podobne właściwości fizyczne i chemiczne DNA i RNA7. Ze względu na identyczność sekwencji gDNA i komplementarnego DNA (cDNA) pochodzącego z próbek mRNA, może wystąpić niespecyficzna amplifikacja, która wpłynie na dokładność wyników RT-qPCR. Pozostałe gDNA doprowadzi do przeszacowania obfitości docelowego mRNA w analizie ekspresji genów8.
Zasadniczo, niespecyficzny amplikon najczęściej powstaje w wyniku tworzenia starterów-dimerów lub niespecyficznej amplifikacji tła spowodowanej gDNA, które można ocenić za pomocą odpowiednich próbek kontrolnych. Takie próbki nie są odpowiednio kontrolne bez matrycy (NTC) i bez kontroli odwrotnej transkryptazy (NRT). Ponieważ poziomy zanieczyszczenia gDNA w badanych próbkach są różne, a wrażliwość na gDNA różni się znacznie między analizowanymi genami, dla każdej pary próbka/test wymagane są kontrole NRT. Chociaż znacznie zwiększa to koszty i nakład pracy w badaniach profilowania RT-qPCR, te kontrole są wymagane7,9.
Alternatywne metody radzenia sobie z zanieczyszczeniem gDNA obejmują użycie par starterów wyżarzających do regionów międzygenowych lub intronu interesującego genu10, oraz użycie starterów, które albo flankują duży intron, albo obejmują połączenie ekson-ekson, tzn. miejsca wyżarzania są nieobecne w dojrzałej sekwencji mRNA1,4. Jednak adnotacje intronów/eksonów dla wszystkich genów wielu gatunków kręgowców, bakterii, protistów, grzybów, roślin i bezkręgowców są jeszcze znane. Ponadto wiele organizmów eukariotycznych ma pseudogeny pochodzące ze zdarzeń duplikacji. Co więcej, konstrukcja starterów w intronach nie gwarantuje braku amplifikacji gDNA. Ponieważ dostępność chromatyny w regionach genomu dla DNazy I jest różna, zaleca się projektowanie różnych par starterów ukierunkowanych na różne chromosomy10.
Genomy organizmów eukariotycznych mogą zawierać do tysiąca kopii genów rDNA kodujących podjednostki rybosomalne niezbędne do tworzenia rybosomów. Te geny rDNA są często zorganizowane w pojedyncze lub tandemowe powtarzające się tablice11. Policistroniczne rRNA (Rysunek 1), w tym duża podjednostka (LSU) i mała podjednostka (SSU) są transkrybowane przez polimerazę RNA I (RNA POL I). Powstałe w ten sposób pre-rRNA są dalej przetwarzane poprzez eliminację dwóch wewnętrznych transkrybowanych regionów dystansowych ITS1 i ITS2. Jako produkty końcowe generowane są trzy dojrzałe rRNA, 17-18S rRNA (SSU), 5.8S i 25-28S rRNA (LSU) 12. Geny rDNA są typowymi przedstawicielami rodziny wielogenowej o wysoce konserwatywnych sekwencjach. Występują one z dużą częstotliwością w genomie i są potencjalnie obecne w więcej niż jednej lokalizacji chromosomalnej13. Przetwarzanie rRNA i degradacja transkrybowanych przekładek jest szybkim procesem w jąderku. Ze względu na wysoki stopień powtarzalności, stosunek liczby kopii genomu do wykrywalnych nieprzetworzonych precząsteczek RNA jest niższy w porównaniu z sekwencjami intronów o niskiej liczbie kopii i prekursorami niesplicowanymi. Te cechy sprawiają, że geny rDNA dobrze nadają się do niezawodnego i bardzo czułego wykrywania zanieczyszczenia gDNA u większości eukariontów i prokariontów3.
Tutaj opisana jest nowatorska procedura wykrywania zanieczyszczenia gDNA w próbkach RNA. Zestaw uniwersalnych starterów opartych na konserwatywnej sekwencji rDNA przedstawiono do testów gDNA u kilku gatunków Poaceae. Specyficzność i uniwersalność proponowanych starterów badano za pomocą analizy krzywej topnienia z wykorzystaniem DNA jako matrycy. Nasz protokół ma zastosowanie nie tylko do Poaceae, ale może być również łatwo dostosowany do innych gatunków eukariotycznych i prokariotycznych.
Protokół
UWAGA: Można użyć dowolnej tkanki.
1. Ekstrakcja kwasów nukleinowych
- Umieść 100 mg próbek tkanek w probówce o pojemności 2,0 ml, dodaj dwa kulki ze stali nierdzewnej o średnicy 5 mm i homogenizuj tkankę pod częstotliwością 25 - 30 Hz przez 30 s (czas trwania i częstotliwość homogenizacji w zależności od typu tkanki) zarówno dla RNA, jak i DNA.
- Wyizoluj całkowite RNA zgodnie z instrukcjami producenta.
- Wyizoluj całkowite DNA zgodnie z instrukcjami producenta.
- Kontrolować czystość i ilość próbek RNA, mierząc absorbancję przy 260 i 280 nm.
- Kontrolować czystość i ilość próbek DNA, mierząc absorbancję przy 260 i 280 nm.
UWAGA: Podczas gdy kwasy nukleinowe absorbują światło o długości fali 260 nm (A260), absorbancja światła o długości fali 280 (A280) może być wykorzystana do ilościowego określenia ilości białek i fenoli obecnych w próbce. Dlatego stosunek A260/A280 nm można wykorzystać do oceny czystości DNA i RNA wyekstrahowanego z próbki. Wartości A260/280 w zakresie ≥1,8 i >2,0 są ogólnie uważane za "czyste" odpowiednio dla DNA i RNA. Niższe wartości A260/280 mogą wskazywać na zanieczyszczenie białkiem lub organicznymi chemikaliami. - Przetestuj jakość DNA, przeprowadzając elektroforezę w żelu agarozowym o stężeniu 0,7%. Przygotować żel i uruchomić w 1x TRIS-borowym buforze EDTA (TBE: 89 mM Tris, 89 mM kwas borowy i 2 mM EDTA) pod napięciem 100 V przez 30 minut. Wysokiej jakości gDNA ma postać ostrego pasma o dużej masie cząsteczkowej (HMW) bez rozmazów w zakresie cząsteczek o niskiej masie cząsteczkowej (LMW).
- Sprawdź wyizolowane RNA pod kątem ilości, czystości i integralności w warunkach denaturacji za pomocą elektroforezy w żelu agarozowym z tiocyjanianu guanidyny (GTC) lub za pomocą chipa do elektroforezy kapilarnej, zgodnie z instrukcjami producenta.
- Przygotować żel GTC, dodając 5 mM GTC do standardowego żelu agarozowego 1x TBE 1% po schłodzeniu agaru do 60 °C.
UWAGA: GTC jest toksyczne, dlatego należy je dozować do dygestorium i nosić odpowiednie środki ochrony osobistej. - Przygotować bufor ładujący denaturujący RNA: 95% formamidu, 10 mM EDTA pH 8,0, 0,1% błękitu bromofenolowego, 0,1% cyjanolu ksylenu i 10 μl bromku etydyny.
UWAGA: Formamid i bromek etydyny są toksyczne i powinny być dozowane w dygestorium. - Załadować 1 - 5 μg całkowitego RNA do buforu ładującego denaturującego RNA, podgrzewać mieszaninę przez 5 minut w temperaturze 70 °C, umieścić ją na lodzie przed załadowaniem do żelu, a następnie oddzielić RNA od żelu GTC przy napięciu 100 V przez 45 minut. Załadować marker masy cząsteczkowej DNA lub RNA jako wzorzec obok próbki RNA.
- Zabarwić żele bromkiem etydyny i uwidocznić pasma za pomocą systemów przechwytywania obrazu w świetle ultrafioletowym. U eukariontów nienaruszony całkowity przebieg RNA w warunkach denaturacji pokaże co najmniej dwa ostre i wyraźne pasma rRNA (28S i 18S) o stosunku intensywności 2:1.
- Przygotować żel GTC, dodając 5 mM GTC do standardowego żelu agarozowego 1x TBE 1% po schłodzeniu agaru do 60 °C.
- Usuń ślady gDNA przez traktowanie DNazą (bez RNazy DNazy I). Dodać do probówki wolnej od RNaz w 10 μl objętości całkowitej: 0,1 - 1 μg całkowitego RNA, jedną jednostkę DNazy I i 1 μl 10x buforu reakcyjnego z MgCl2. Inkubować mieszaninę przez 30 minut w temperaturze 37 °C. Zakończyć reakcję przez dodanie 1 μl 50 mM EDTA i inkubację w temperaturze 65 °C przez 10 minut.
- Usuń ślady RNA z ekstraktów gDNA za pomocą RNazy A wolnej od DNazy, zgodnie z protokołem producenta. Dodać 5 μl RNazy 10 mg/ml do całkowitego DNA i inkubować w temperaturze 37 °C przez 1 godzinę. Ekstrakty RNA i DNA należy przechowywać w temperaturze -80 °C.
2. Projekt startera z regionu rDNA do oznaczania gDNA
UWAGA: Pełna długość sekwencji rDNA zawiera dwa regiony (ITS1 i ITS2), które są usuwane w dojrzałej cząsteczce rRNA przez szereg endonukleolitycznych rozszczepień, a następnie degradowane (Rysunek 1).
- Pobierz sekwencję nukleotydów rDNA z NCBI (http://www.ncbi.nlm.nih.gov) dla interesujących gatunków. Najlepszym słowem kluczowym do przeszukiwania bazy danych jest "wewnętrzny transkrybowany odstęp".
- Wprowadź docelową sekwencję nukleotydów do wyszukiwania BLASTn, aby znaleźć wewnętrzne transkrybowane regiony dystansowe (ITS), SSU i konserwatywne regiony LSU.
- Wybierz startery, które albo otaczają sekwencję ITSs, albo wzmacniają sekwencje ITSs, które nie są obecne w dojrzałym rRNA.
- Projektowanie starterów flankujących sekwencje ITS1 lub ITS2: Wyrównaj konserwatywne regiony z różnych gatunków za pomocą ClustalW. Zaprojektuj startery specyficzne dla regionu flankującego ITS po analizie specyficznych/międzygatunkowych taksonów za pomocą oprogramowania AlleleID. Dwie pary starterów wzmacniające amplikony SSU-5.8S i 5.8S-LSU mogą być zaprojektowane w oparciu o obszary flankujące odpowiednio ITS1 i ITS2. Ponieważ amplikony te rozciągają się na cały obszar ITS, długość amplikonu zostanie zwiększona o co najmniej 300 pz w amplikonach z gDNA. Ten wzrost zmniejsza czułość.
- Flankowanie ITS1: Wybierz sekwencję SSU i 5.8S rRNA. Wybrane startery dla Poaceae to: SSU, SF: CGTAACAAGGTTTCCGTAGGTG, R: GGTTCACGGGATTCTGCAAT. Ta para starterów (SF: do przodu i R: do tyłu) wzmacnia częściowy region SSU, pełną długość ITS1 i częściowy region 5.8S rDNA.
- Flankowanie ITS2: Wybierz sekwencję 5.8S i LSU. Wybrane startery dla Poaceae to: F: ATTGCAGAATCCCGTGAACC LSU sekwencja konsensusu, LR: TGCTTAAAYTCAGCGGGTAGYC. Ta para starterów wzmacnia częściowy region 5.8S, pełną długość ITS2 i częściowy region LSU (Rysunek 1).
UWAGA: W przypadku projektu spłonki opartego na regionie flankującym ITS, zidentyfikowano wysoce zachowane obszary SSU, 5.8S i LSU. Startery do przodu i do tyłu 5.8S rRNA zostały zaprojektowane w oparciu o konserwatywny motyw roślin kwitnących14. Startery do przodu i do tyłu zostały zaprojektowane w oparciu o konserwatywne regiony SSU i LSU w Poaceae. Rozbieżność starterów SSU i LSU dla każdego gatunku podano w tabeli 1.
- Startery wzmacniające sekwencję ITSs: W tym protokole zaprojektuj startery ITS1 w oparciu o sekwencję Aeluropus ITS (numer taxid NCBI: 110873). W przypadku podkładów użyj: Do przodu: GGTATGGCGTCAAGGAACACT, Do tyłu: ATAGCATCGCTGCAAGAGGT. W zależności od amplikonów generowanych przez pary starterów in silico, wielkość powinna wynosić od 60 do 200 pz. Jest to również zalecany rozmiar do analizy qPCR.
- Projektowanie starterów flankujących sekwencje ITS1 lub ITS2: Wyrównaj konserwatywne regiony z różnych gatunków za pomocą ClustalW. Zaprojektuj startery specyficzne dla regionu flankującego ITS po analizie specyficznych/międzygatunkowych taksonów za pomocą oprogramowania AlleleID. Dwie pary starterów wzmacniające amplikony SSU-5.8S i 5.8S-LSU mogą być zaprojektowane w oparciu o obszary flankujące odpowiednio ITS1 i ITS2. Ponieważ amplikony te rozciągają się na cały obszar ITS, długość amplikonu zostanie zwiększona o co najmniej 300 pz w amplikonach z gDNA. Ten wzrost zmniejsza czułość.
- Wybierz podkłady, biorąc pod uwagę następujące zalecenia: zawartość GC: 40 - 60%, długość podkładu: 18 - 23 bazy, długość produktu PCR: 60 - 160 pz (specjalnie dla podkładu ITS), temperatura topnienia (Tm): 60 °C, końcowa Tm dla obu podkładów nie różni się o więcej niż 5 °C, a podkłady nie są komplementarne względem siebie ani starterów partnerskich.
- Sprawdź specyficzność podkładu i numer kopii. Wykonaj analizę in-silico wybranej sekwencji starterów za pomocą programu primer-blast (https://www.ncbi.nlm.nih.gov/tools/primer-blast/).
- Otwórz stronę zgłoszeniową Primer-BLAST. Wprowadź obie sekwencje starterów w sekcji parametrów startera formularza. W sekcji parametrów sprawdzania swoistości par starterów wprowadź nazwę organizmu (lub nazwę grupy organizmów) i wybierz bazę danych genomu. Te ustawienia dostarczają informacji o swoistości dotyczącej sekwencji docelowej i parametrów startera, w tym długości produktu, pozycji na chromosomie i liczby kopii.
3. Wykonaj krok qPCR w celu walidacji starterów opartych na rDNA z szablonami DNA
UWAGA: Funkcjonalność zaprojektowanych starterów powinna zostać zweryfikowana poprzez wykonanie qPCR przy użyciu gDNA jako szablonu. Aby przeprowadzić kilka równoległych reakcji i zmniejszyć liczbę błędów pipetowania, zaleca się przygotowanie mieszanki wzorcowej. W przypadku mieszaniny wzorcowej należy przygotować objętość równą całkowitej liczbie mieszaniny reakcyjnej plus ~10%.
- Przygotować mieszankę wzorcową, mieszając wszystkie składniki reakcji z wyjątkiem matrycy DNA w probówce reakcyjnej PCR. W razie potrzeby przeskaluj z jednej reakcji, aby przygotować mieszankę główną: 5 μl zielonej SYBR (SYBR) mieszanki głównej (2x), 0,3 μl startera (po 0,3 μM startera do przodu i do tyłu) i dostosuj końcową objętość do 10 μl wodą wolną od RNaz. Do analizy należy użyć około ≤200 ng w 1 μl matrycy gDNA.
UWAGA: Rozmrozić, zmontować i przechowywać wszystkie odczynniki, składniki i mieszaniny reakcyjne na lodzie. - Porcjować mieszankę wzorcową na optyczną płytkę 96-dołkową. Odpipetować 1 μl gDNA do każdego dołka, a następnie przykryć go folią uszczelniającą płytkę optyczną. Zakręć i umieść w cyklerze.
- Przeprowadzić test qPCR na termocyklerze działającym w czasie rzeczywistym w następujących warunkach: 10 min w temperaturze 95 °C, a następnie 40 cykli w temperaturze 95 °C przez 15 s i 60 °C przez 1 minutę. Przeprowadzić akwizycję danych na etapie wyżarzania/wydłużania w temperaturze 60 °C.
- Po procedurze amplifikacji wszystkie reakcje PCR należy poddać analizie krzywej topnienia z ciągłym pomiarem fluorescencji w zakresie od 55 °C do 95 °C. Zazwyczaj zbiera się jeden punkt danych w każdym cyklu poprzez stopniowy wzrost temperatury o 0,5 °C na cykl.
UWAGA: Dołącz co najmniej 2 kontrolki bez szablonu (NTC) dla każdej mieszanki głównej pary starterów. Wykonaj wszystkie testy w co najmniej trzech powtórzeniach. - Potwierdzić specyficzność gruntu za pomocą analizy krzywej topnienia. Analizuj krzywe za pomocą cyklu pojedynczego progu i metody dopasowania krzywej odjętej.
UWAGA: Pojawienie się ostrego pojedynczego piku wskazuje na jednolity indywidualny amplikon. Produkty z dimerami podkładowymi mogą pojawiać się jako pojedyncze piki w niższych temperaturach. - Sprawdzić rozmiar każdego amplikonu za pomocą elektroforezy w żelu agarozowym.
- Przygotuj 3% żel agarozowy, mieszając 3 g agarozy ze 100 ml buforu TBE (TBE: 89 mM Tris, 89 mM kwasu borowego i 2 mM EDTA).
- Wymieszaj 5 - 10 μl produktu PCR z DNA i 1 - 2 μl 6x buforu ładującego. Załaduj produkt PCR wraz z drabinką DNA na 3% żelu agarozowym. Przeprowadzić separację elektroforetyczną w 1x TRIS-borowym buforze EDTA przy 100 V przez 45 minut.
- Zabarwić żele bromkiem etydyny lub innym środkiem interkalacyjnym i uwidocznić pasma za pomocą systemów przechwytywania obrazu w świetle ultrafioletowym.
UWAGA: Czynniki interkalujące DNA (np. bromek etydyny) są rakotwórcze i należy obchodzić się z nimi ostrożnie oraz oddzielnie je dozować. Pojawienie się unikalnego ostrego pasma (pod względem wielkości i bez startera-dimeru czy sztucznego wzmocnienia tła) potwierdza specyfikę wzmacniacza.
4. Procedura oznaczania zanieczyszczenia gDNA za pomocą szablonów RNA
UWAGA: Po leczeniu DNazą, oczyszczona próbka RNA jest testowana za pomocą starterów specyficznych dla rDNA. Ze względu na przetwarzanie cechy podobnej do intronu ITS, gdy te regiony są używane do amplifikacji, w próbkach RNA wolnych od DNA nie powinien być wykrywany żaden sygnał amplifikacji. Na tej podstawie, jeśli zostanie wykryty sygnał amplifikacji w qPCR lub zaobserwowane prążki w żelu agarozowym o oczekiwanej wielkości (oszacowanej za pomocą analizy in silico), powinno to być spowodowane zanieczyszczeniem gDNA. Kroki wykonane w tej sekcji są podobne do sekcji 3, z wyjątkiem tego, że cDNA wszystkich próbek jest używane jako matryca zamiast gDNA.
- Przygotować mieszankę wzorcową, mieszając wszystkie składniki reakcji z wyjątkiem matrycy RNA w probówce reakcyjnej PCR. Kombinacja mieszanki głównej dla jednej reakcji: 5 μL mieszanki głównej SYBR (2x), 0,3 μl startera (po 0,3 μM mieszanki startera do przodu i wstecznego) i dostosować końcową objętość do 10 μl wodą wolną od RNaz. Do analizy użyć około 500 ng matrycowego RNA w objętości 1 μl.
- Porcję mieszanki wzorcowej przeznaczyć na optyczną płytkę 96-dołkową. Odpipetować 1 μl RNA do każdego dołka, a następnie przykryć go folią uszczelniającą płytkę optyczną. Odwirować i umieścić w cyklirze.
UWAGA: Do każdego testu należy dołączyć co najmniej dwie kontrole NTC i dwie dodatnie kontrole gDNA. Wykonaj wszystkie testy w trzech replikacjach technicznych. - Uruchom test qPCR na termocyklerze w czasie rzeczywistym w następujących warunkach: 10 minut w temperaturze 95 °C, a następnie 40 cykli w temperaturze 95 °C przez 15 s i 60 °C przez 1 minutę. Przeprowadzić akwizycję danych na etapie wyżarzania/wydłużania w temperaturze 60 °C.
- Po procedurze amplifikacji wszystkie reakcje PCR należy poddać analizie krzywej topnienia z ciągłym pomiarem fluorescencji w zakresie od 55 °C do 95 °C. Zazwyczaj zbiera się jeden punkt danych w każdym cyklu poprzez stopniowy wzrost temperatury o 0,5 °C na cykl.
- Sprawdź wszystkie produkty PCR, uruchamiając elektroforezę w 3% żelu agarozowym.
UWAGA: Pojawienie się jakiegokolwiek pasma lub piku w reakcji NTC jest prawdopodobnie związane z tworzeniem się starterów-dimerów, które są zwykle obserwowane w niskich temperaturach na krzywej topnienia, podczas gdy obecność jakiegokolwiek pasma lub piku w próbkach RNA jest wynikiem zanieczyszczenia gDNA. Zaleca się, aby najpierw przetestować wszystkie próbki RNA za pomocą starterów na bazie rDNA, a następnie próbki niezanieczyszczone DNA są wykorzystywane do dalszych zastosowań, takich jak synteza cDNA, analiza ekspresji genów itp.
5. Etap RT-PCR do syntezy cDNA i analizy qPCR
- Rozmrozić RNA poddane działaniu DNazy i odczynniki do syntezy cDNA w temperaturze pokojowej. Po rozmrożeniu odwiruj odczynniki. Dodać 1 μg RNA i 1 μl startera Oligo (dT)18 do probówki bez nukleaz. Dostosuj całkowitą objętość 12 μl wodą wolną od RNaz, delikatnie wymieszaj, a następnie przechowuj na lodzie.
- Stopić drugorzędowe struktury matrycy RNA przez inkubację reakcji w temperaturze 65 °C przez 5 minut. Odkręcić i schłodzić fiolkę na lodzie.
- Przygotować główną mieszaninę reakcji (końcowa objętość 20 μl dla każdej reakcji) w następujący sposób: 1 μl odwrotnej transkryptazy (200 U/μL), 4 μl buforu reakcyjnego (5x), 1 μl inhibitora RNazy (20 U/μL) i 2 μl mieszanki dNTP (10 mM). Delikatnie wymieszać i schłodzić fiolkę na lodzie. Dodać 19 μl do przygotowanej probówki zawierającej RNA.
- Inkubować reakcję przez 60 minut w temperaturze 42 °C, a następnie inkubować w temperaturze 70 °C przez 5 minut, aby zakończyć aktywność odwrotnej transkryptazy. Umieścić reakcje RT na lodzie i przystąpić do analizy ekspresji genów za pomocą rutynowej procedury qPCR (jak wyjaśniono w sekcjach 3 i 4).
Wyniki
Proponujemy zastosowanie starterów opartych na rDNA w celu potwierdzenia braku kontaminacji gDNA w próbkach RNA z tkanki liściowej. Schemat analizy qPCR oraz testu na kontaminację gDNA przedstawiono w Rycina 2W przedstawionym protokole w projektowaniu starterów opartym na rDNA zastosowano dwie komplementarne strategie: 1) wybrano startery gatunkowo swoiste na podstawie sekwencji ITS oraz 2) wybrano startery uniwersalne na podstawie regionów flankujących ITS. W ramach dowodu koncepcji zaprojektowano startery swoiste dla Aeluropus littoralis, or uniwersalne primery opracowane dla gatunków z rodziny Poaceae, zgodnie z protokołem. Primery dla 5.8S (forward i reverse) wybrano na podstawie zakonserwowanego motywu o długości 14 par zasad (bp), który wykazuje podobieństwo pomiędzy roślinami kwiatowymi, mszakami oraz kilkoma rzędami glonów i grzybów14Charakterystyka zaprojektowanych starterów została przedstawiona w Tabela 2Uniwersalność starterów SSU, 5,8S i LSU została zweryfikowana za pomocą BLASTn, a wyniki homologii starterów przedstawiono w Rysunek 3 jako logo motywu. Lista gatunków uwzględnionych w analizie homologii, a także specyficzne startery dla każdego gatunku, zostały podane w Tabela 1. Specyficzność starterów sprawdzono za pomocą narzędzia Primer-BLAST. W przypadku gatunków, dla których dostępna jest sekwencja całego genomu, oszacowano chromosomalną lokalizację genów rDNA. Na przykład w Oryza sativa i Arabidopsis thaliana, geny rDNA znajdują się na dwóch różnych chromosomach, a w Zea mays na trzech różnych chromosomach.
Walidacja qPCR starterów opartych na rDNA została przeprowadzona za pomocą analizy krzywej topnienia amplikonów flankujących ITS1 i ITS2 z wykorzystaniem DNA jako matrycy. Jak przedstawiono na Ryc. 4 oraz Ryc. 5, specyficzność starterów została potwierdzona eksperymentalnie poprzez obserwację pojedynczego, wąskiego piku bez tworzenia dimerów starterów u różnych gatunków z rodziny Poaceae, w tym Triticum aestivum, Hordeum vulgare, Oryza sativa, a także u dwuliściennych: Medicago sativa, Cucumis sativus, Nicotiana tabacum, Trifolium alexandrinum, Vicia faba i Arabidopsis thaliana. Dalsza analiza produktów amplifikacji za pomocą elektroforetycznego rozdziału wielkości wykazała obecność pojedynczego prążka. Zgodnie z oczekiwaniami, prążki pochodzące z próbek różnych gatunków różniły się wielkością (Ryc. 6A i 6B). Co ciekawe, zastosowanie starterów uniwersalnych, zaprojektowanych specjalnie dla trzech gatunków Poaceae, okazuje się użyteczne nie tylko dla innych gatunków Poaceae, ale także dla innych gatunków roślin, takich jak A. thaliana, oraz dla grzyba endofitycznego, tj. Piriformospora indica.
Poprawność zaprojektowanego specyficznego primera (ITS1) potwierdzono również za pomocą qPCR u A. littoralis, wykorzystując gDNA jako matrycę. Zaobserwowano pojedynczy pik bez tworzenia dimerów primerów. Co zaskakujące, primer ITS1 A. littoralis (jako primer specyficzny) wygenerował pojedynczy wyraźny prążek nie tylko u A. littoralis, ale także u wszystkich pozostałych badanych gatunków z wyjątkiem Nicotiana tabacum oraz Trifolium alexandrinum, które wytworzyły dwa prążki (Rycina 6C). Analizę zanieczyszczenia gDNA przeprowadzono we wszystkich próbkach RNA przy użyciu primerów ITS lub primerów flankujących ITS. Schematyczny obraz płytki amplifikacyjnej w analizie zanieczyszczenia gDNA oraz interpretacja wyników przedstawione są na Rycynie 7.

Rysunek 1: Ogólny schemat organizacji sekwencji rDNA eukariotów.
Eukariotyczny segment rDNA zawiera 17-18S (czerwony), 5,8S (niebieski) oraz 25-28S rRNA (różowy). Wewnętrzne sekwencje odstępowe (ITS) zaznaczono czarnymi liniami. 5´ i 3´ wskazują orientację cząsteczki DNA. Prosimy o kliknięcie tutaj, aby wyświetlić powiększoną wersję tego rysunku.
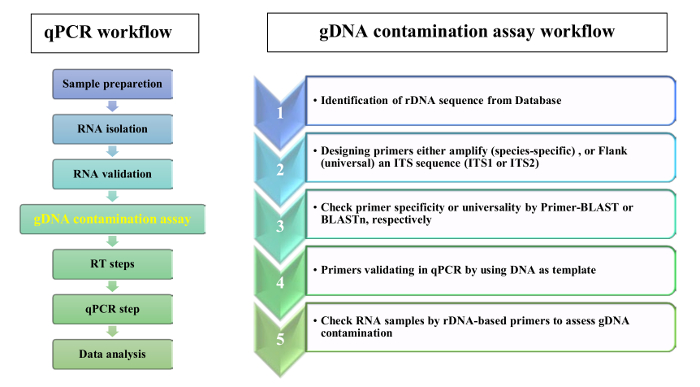
Rysunek 2: Schemat postępowania dla analizy RT-qPCR i badania zanieczyszczenia gDNA. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
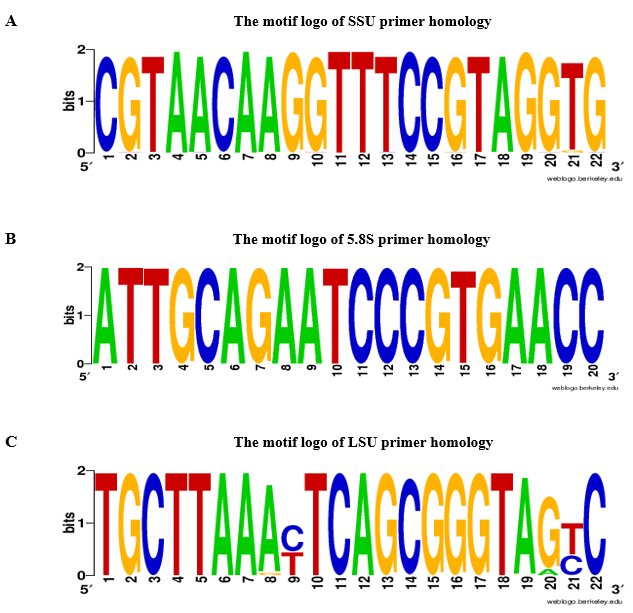
Rysunek 3: Logo motywu dla homologii starterów A. SSU, B. 5,8S oraz C. LSU. W przypadku starterów SSU, 5,8S i LSU logo motywu zostało skonstruowane za pomocą programu BLASTn na podstawie 200 rekordów roślin zielonych (numer taxid NCBI: 3090) z wartością graniczną e-value ≤10.-10A-adenina, T-tymina, G-guanina, C-cytozyna. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
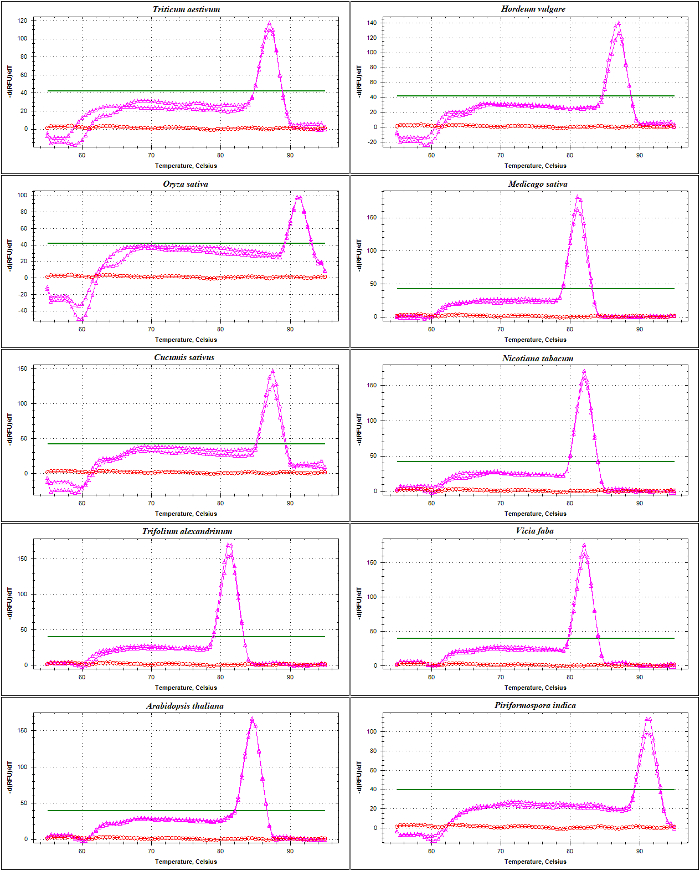
Rysunek 4: Analiza krzywej topnienia amplikonu flankującego region ITS1 u różnych gatunków.
Ten amplikon, namnożony za pomocą starterów SSU i 5.8S-R, zawiera fragment sekwencji z regionu kodującego 17-18S, pełną sekwencję ITS1 oraz częściową sekwencję 5.8S. Przedstawiono krzywe topnienia wygenerowanych amplikonów (różowe) oraz kontroli NTC (czerwone) z Triticum aestivum, Hordeum vulgare, Oryza sativa, Medicago truncatula, Cucumis sativus, Nicotiana tabacum, Trifolium alexandrinum, Vicia faba, Arabidopsis thaliana, i Piriformospora indicaPłaska pogrubiona linia oznacza próg bazowy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
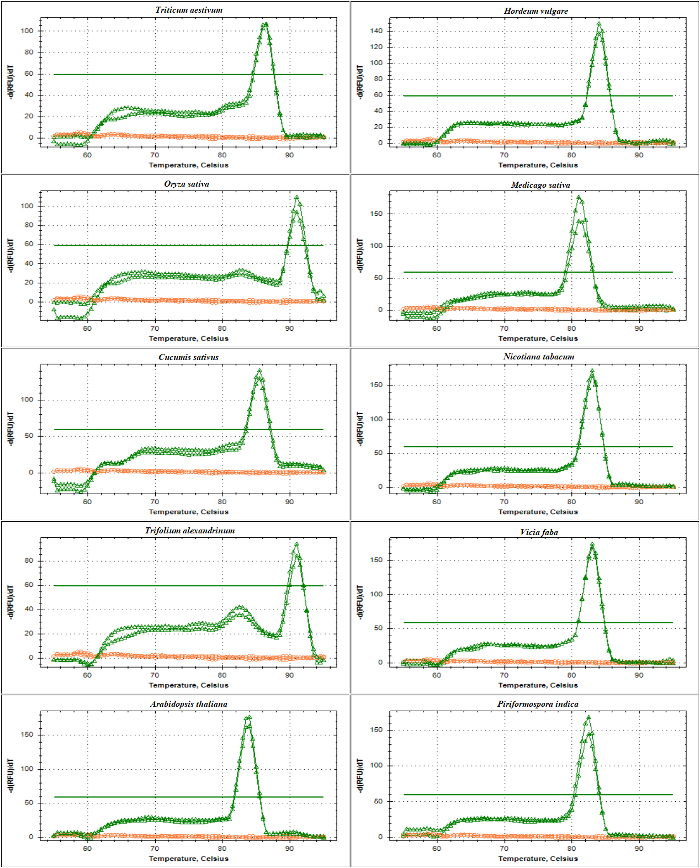
Rysunek 5: Analiza krzywych topnienia amplikonów flankujących region ITS2 u różnych gatunków.
Ten amplikon jest generowany przy użyciu starterów 5.8S-F oraz LSU. Opisany amplikon zawiera sekwencje fragmentu 5.8 S, pełną sekwencję ITS2 oraz częściową sekwencję 25-28S. Przedstawiono krzywe topnienia amplikonów (kolor zielony) oraz NTC (kolor czerwony) uzyskane z Triticum aestivum, Hordeum vulgare, Oryza sativa, Medicago truncatula, Cucumis sativus, Nicotiana tabacum, Trifolium alexandrinum, *Vicia faba*, Arabidopsis thaliana i Piriformospora indica. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
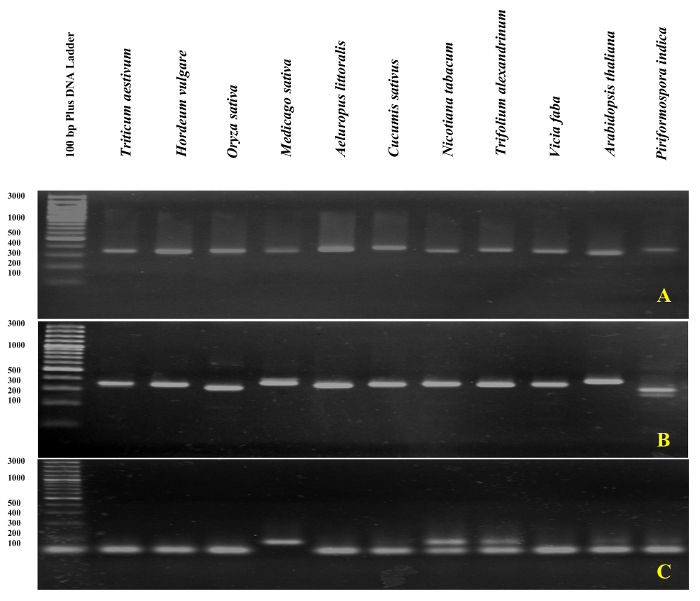
Rysunek 6: Analiza produktów PCR opartych na rDNA w żelu agarozowym.
Amplikon flankujący region ITS1 (A), flanki ITS2 (B), oraz ITS1 (C) przeprowadzono w 3% żelu agarozowym. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.

Rycina 7: Cechy ITS przypominające introny mogą być wykorzystane do zaprojektowania starterów umożliwiających wykrycie kontaminacji gDNA.
Każdy piki lub prążek o oczekiwanym rozmiarze w analizie qPCR wskazuje na kontaminację gDNA w próbce RNA. Unk: próbka nieznana, pos: kontrola pozytywna, NTC: kontrola bez matrycy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Starter | Rodzaj | Identyfikator Taxid | Gatunki | Starter divergentny | ||
| SSU | Arabidopsis | 3701 | kamchatica, thaliana i lyrata | - | ||
| Vicia | 3904 | villosa, americana, unijuga, amoenane, amurensis, craccamal, pseudo-orobus, multicaulis, japonica, ramuliflora i bób | ||||
| Koniczyna | 3898 | alexandrinum, montanum, resupinatum i repens | - | |||
| Nicotiana | 4085 | tabacum, benthamiana, otophora, picilla, bigelovii, palmeri, tomentosiformis, tomentosa, digluta, kawakamii, clevelandii, nesophila, solanifolia, cordifolia, debneyi, arentsii, thyrsiflora, wigandioides, undulata, glutinosa, noctiflora, petunioides, obtusifolia, miersii, pauciflora, attenuate, acuminata, linearis, alata, sylvestris, rustica i suaveolens | - | |||
| Cucumis | 3655 | arbuz, melon i sativus | CGTAACAAGGTTTCCGTAGGKG | |||
| Aeluropus | 110873 | - | Nie znaleziono startera | |||
| Łubianka | 3877 | sativa, lupulina, pamphylica, lunata, rostrate, plicata i truncatula | - | |||
| Oryza | 4597 | sativa, glumipatula, rufipogon barthii glaberrima punctate, longistaminata, meridionalis, nivara, meridionalis i longistaminata | - | |||
| Triticum | 4564 | aestivum, urartu i monococcum | - | |||
| Jęczmień | 4512 | vulgare, bulbosum, marinum, brevisubulatum i bogdanii | - | |||
| LSU | Arabidopsis | 3701 | petraea, thaliana i lyrata | TGCTTAAACTCAGCGGGTAATC | ||
| Vicia | 3904 | sylvatica, tetrasperma, sativa, owłosiony, sepium, drobnokwiatowa, cracca, lathyroides, orobus, orobus, Bithynica i bób | TGCTTAAATTCAGCGGGTAGCC | |||
| Koniczyna | 3898 | pretense, nigrescens, resupinatum, occidentale, podziemny, ścisłe, ochroleucon, glomeratum, squamosum, ornithopodioides i repens | TGCTTAAATTCAGCGGGTAGCC | |||
| Nicotiana | 4085 | tabacum, benthamiana, otophora, picilla, bigelovii, palmeri, tomentosiformis, tomentosa, digluta, kawakamii, clevelandii, nesophila, solanifolia, cordifolia, debneyi, arentsii, thyrsiflora, wigandioides, undulata, glutinosa, noctiflora, petunioides, obtusifolia, miersii, pauciflora, attenuate, acuminata, linearis, alata, sylvestris i suaveolens | TGCTTAAACTCAGCGGGTAGTC | |||
| Cucumis | 3655 | melo, ritchiei i javanica | TGCTTAAACTCAGCGGGTAGTC | |||
| Aeluropus | 110873 | lagopoide, pungens i littoralis | TGCTTAAATTCAGCGGGTAATC | |||
| Łubianka | 3877 | ruthenica, sativa, lupulina, arabica, polymorpha i minima | TGCTTAAATTCAGCGGGTAGCC | |||
| pamphylica, lunata, rostrate i plicata | TGCTTAAACTCAGCGGGTAGTC | |||||
| Oryza | 4597 | sativa, glumipatula, rufipogon, barthiial, glaberrima, australiensis, officinalis, australiensis, ridleyi, malampuzhaensis, alta, nivara, rufipogon, meridionalis i longistaminata | TGCTTAAACTCAGCGGGTAGTC | |||
| Triticum | 4564 | aestivum, spelta, turgidum, dicoccoides, petropavlovskyi, urartu i monococcum | TGCTTAAACTCAGCGGGTAGTC | |||
| Jęczmień | 4512 | vulgare, bulbosum, murinum, secalinum, brevisubulatum i bogdanii | TGCTTAAACTCAGCGGGTAGTC | |||
| Starter zdegenerowany definiuje się zgodnie z systemem IUPAC dotyczącym nazewnictwa nukleotydów | ||||||
Tabela 1: Lista gatunków rozważanych przy wyborze starterów opartych na rDNA.
Miejsce wiązania SSU w porównaniu z miejscem wiązania LSU wykazało wyższą homologię sekwencji w obrębie danego rodzaju.
| Długość amplikonu | Obszar amplifikacji | Sekwencja | Nazwa primera | Amplikon | |
| 32 - 405 bp | Częściowa sekwencja SSU, pełna sekwencja ITS1 i częściowa sekwencja 5.8S | CGTAACAAGGTTTCCGTAGGTG | SSU | ITS1-flanks | |
| GGTTCACGGGATTCTGCAAT | 5.8S-R | ||||
| 318 - 361 bp | Częściowa sekwencja 5.8S, pełna sekwencja ITS2 i częściowa sekwencja LSU | ATTGCAGAATCCCGTGAACC | 5.8S-F | ITS2-flanks | |
| TGCTTAAAYTCAGCGGGTAGYC | LSU | ||||
| 10 - 20 bp | ITS1 | GGTATGGCGTCAAGGAACACT | ITS1-F | ITS1 | |
| ATAGCATCGCTGCAAGGT | ITS1-R | ||||
Tabela 2: Sekwencje starterów.
Dyskusja
Analiza ekspresji genów metodą ilościowego PCR jest szeroko stosowana w ostatnich latach. Główną zaletą tej szybkiej, opłacalnej i zautomatyzowanej metody jest jej precyzyjny i dokładny wynik. Jednak uzyskanie optymalnych korzyści z tych zalet wymaga jasnego zrozumienia konfiguracji parametrów stosowanych w eksperymencie qPCR. Aby uzyskać wiarygodny wynik w analizie ekspresji genu qPCR, konieczne jest uniknięcie niespecyficznej amplifikacji, która powstaje w wyniku zanieczyszczenia starterem-dimerem lub gDNA w próbce RNA 3,15. Oczekuje się, że poziomy transkryptów RNA będą przeszacowane w przypadku zanieczyszczenia gDNA8. W tym przypadku unikalne cechy genu rDNA zostały wzięte pod uwagę w teście zanieczyszczenia gDNA w próbkach RNA.
Podstawowe właściwości rDNA użyte w tym protokole: Geny rybosomalne składają się z dwóch ITS, a mianowicie ITS1 i ITS2, oraz trzech genów kodujących rRNA, podjednostki 17-18S, 5,8S i 25-28S12. Dwa regiony ITS nie są częścią sekwencji kodującej podjednostek rybosomalnych. Są one usuwane przez co najmniej trzy działania enzymatyczne w celu przetworzenia prekursora dojrzałego rRNA: aktywność endonukleazy, helikazy i egzonukleazy. Ponieważ rybosomalny RNA jest transkrybowany jako transkrypt polistroniczny, z pewnością obecny jest pierwotny produkt zawierający ITS. Przetwarzanie jest bardzo szybkie i odbywa się w jąderku, a ilość wykrywalnych cząsteczek prekursorowych zawierających ITS jest poniżej granicy wykrywalności metody qPCR. Dlatego, gdy ITS1 lub ITS2 są amplifikowane przez startery flankujące ITS, nie można wykryć amplifikacji w próbkach RNA, chyba że występuje zanieczyszczenie gDNA. Liczbę genów rDNA w genomie organizmów eukariotycznych oszacowano na nawet tysiąc kopii, które są ułożone w pojedyncze lub tandemowe układy na chromosomach11. W tym protokole proponujemy alternatywny sposób, zamiast NTZ, wykrywania zanieczyszczenia gDNA, który jest stosowany w każdej reakcji/teście.
Korzyści i ograniczenia w stosunku do istniejących metod: NTZ jest zwykle stosowana do testowania, czy przygotowana próbka RNA jest czysta lub zanieczyszczona gDNA. Ponieważ zanieczyszczenie gDNA nie jest równomiernie rozłożone między różnymi próbkami RNA, a na wrażliwość reakcji na gDNA znaczący wpływ mają analizowane geny, wymagane są kontrole NRT dla każdej pary próbka/test 7,15. Spowoduje to znaczne zwiększenie kosztów i nakładu pracy przy jednoczesnej obsłudze wielu próbek 3,9. Inne alternatywne metody udokumentowane w literaturze obejmują zastosowanie starterów specyficznych dla intronów do wykrywania gDNA lub projektowanie starterów, które albo flankują intron, albo obejmują połączenie ekson-ekson. Ograniczenia tych metod wynikają z niedostępności informacji o sekwencji intronów, niekompletnej adnotacji struktury intronu/eksonu oraz braku intronów w genach lub pseudogenach będących przedmiotem zainteresowania 1,4,10. Ze względu na ewolucję geny rDNA istnieją jako wielogenowe i wysoce konserwatywne rodziny genów. Są one bardzo obfite w genomie i obecne na różnych chromosomach13. W porównaniu z innymi genami kodującymi lub niekodującymi, geny rDNA najlepiej nadają się do wykrywania zanieczyszczenia gDNA. W porównawczych analizach transkryptomicznych normalizacja danych qPCR przez kalibrator rRNA nie jest zalecana w przypadku niektórych problemów, takich jak różnice w przygotowaniu cDNA (priming polyA vs. losowe priming heksamerowe), duże różnice w obfitości między rRNA i mRNA oraz różna biogeneza, która może generować mylące wyniki10,16. Jednak problemy, o których właśnie wspomnieliśmy, są zaletą dla testu zanieczyszczenia gDNA. Na przykład, w odniesieniu do większej liczebności miejsc docelowych w genomie i lokalizacji na różnych chromosomach, startery oparte na rDNA znacznie poprawiają czułość wykrywania gDNA w porównaniu z istniejącymi metodami.
Uniwersalność rDNA w stosunku do innych organizmów: Geny rDNA to dobrze zbadana rodzina genów zidentyfikowana w większości organizmów. Proponowana metoda oparta na rDNA stanowi prosty, wysoce czuły i ekonomiczny system do oznaczania zanieczyszczenia gDNA, który można łatwo dostosować do innych organizmów eukariotycznych i prokariotycznych (Protokół 2 - 5). Jako studium przypadku wykazaliśmy tutaj użyteczność tej metody u niektórych gatunków Poceae (ryc. 4 i ryc. 5). Zastosowane startery wykazują wysoką szybkość przenoszenia do innych gatunków Poceae ze względu na wysoce konserwatywną strukturę podjednostek rDNA wśród gatunków. Problem ten staje się jeszcze ważniejszy, gdy nie są dostępne wystarczające informacje o sekwencji genomu do zaprojektowania starterów. W ten sposób spłonki flankujące ITS przeznaczone dla jednego gatunku mogą być stosowane u gatunków pokrewnych. Ponadto startery 5.8S-F/R zostały wybrane w oparciu o zachowany motyw, który wykazuje duże podobieństwo u większości roślin kwitnących14. Chociaż techniki sekwencjonowania o wysokiej przepustowości trwale zwiększają liczbę znanych genomów, adnotacja egzon-intron większości organizmów nie jest zakończona, a zatem często nie jest możliwe zaprojektowanie starterów obejmujących granicę ekson-ekson. Nasza metoda wyjaśnia, w jaki sposób startery na bazie rDNA mogą być stosowane do testu zanieczyszczenia gDNA w analizie qPCR prokariontów i eukariontów w celu wyeliminowania kosztownych kontroli NRT w każdej kombinacji testu / startera.
Oświadczenia
Autorzy nie mają konkurencyjnych interesów finansowych.
Podziękowania
Te badania były wspierane przez Instytut Biotechnologii Genetycznej i Rolniczej w Tabarestanie (GABIT), Uniwersytet Nauk Rolniczych i Zasobów Naturalnych Sari (SANRU). Młodsza grupa badawcza Abiotic Stress Genomics została sfinansowana przez IZN (Interdyscyplinarne Centrum Badań nad Roślinami Uprawnymi, Halle (Saale), Niemcy. Dziękujemy Rhondzie Meyer za krytyczną lekturę manuskryptu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Maxima SYBR Green / ROX qPCR Master Mix (2X) | Thermo Scientific | K0221 | |
| TissueLyser II | QIAGEN | 85300 | |
| Zestaw do syntezy pierwszej nici cDNA RevertAid H Minus | Thermo Scientific | K1631 | |
| GeneRuler 100 bp Plus DNA | Ladder Thermo Scientific | SM0321 | |
| 96 well WHT/CLR | Bio-Rad | HSP9601 | |
| Folia Microseal B | Bio-Rad | MJ-0558 | |
| Niska taśma rurkowa CLR | Bio-Rad | TLS0801 | |
| Paski płaskie | Bio-Rad | TCS0803 | |
| NanoDrop 2000 | Peqlab | ND-2000 | |
| RNaseZAP | Wirówka Ambion | 9780 | |
| Eppendorf | 5810 R | ||
| Agilent RNA 6000 Nano Kit | Agilent Technologies | 5067-1511 | |
| 2100 Bioanalizator do elektroforezy | Agilent Technologies | G2939AA | |
| RNaza A, bez DNaz i proteaz | Thermo Scientific | EN0531 | |
| DNaza I, bez RNaz | Thermo Scientific | EN0523 | |
| TRIZOL | Odczynnik Ambion | ||
| CFX96 Dotykowy system wykrywania PCR w czasie rzeczywistym BIO | RAD | 1855195 | |
| probówka do PCR, 0,2 ml, bez RNaz | Tiocyjanian fortaginu | Z376426 | |
| guanidyny do biologii molekularnej | Sigma-Aldrich | G9277 | |
| Agaroza - elektroforeza kwasów nukleinowych | Sigma-Aldrich | A9414 | |
| Kwas borowy do biologii molekularnej | AppliChem | A2940 | |
| błękit bromofenolowy | AppliChem | A2331 | |
| bromek etydyny | AppliChem | A1151 | |
| System dokumentacji żelu | BIO RAD | Gel Doc 2000 |
Bibliografia
- Bustin, S. A., Nolan, T. Pitfalls of quantitative real-time reverse-transcription polymerase chain reaction. J Biomol Tech. 15 (3), 155-166 (2004).
- Gutierrez, L., Mauriat, M., Pelloux, J., Bellini, C., Van Wuytswinkel, O. Towards a systematic validation of references in real-time RT-PCR. Plant Cell. 20 (7), 1734-1735 (2008).
- Hashemi, S. H., Nematzadeh, G., Ahmadian, G., Yamchi, A., Kuhlmann, M. Identification and validation of Aeluropus littoralis reference genes for Quantitative Real-Time PCR Normalization. J Biol Res (Thessalon). 23 (1), 18(2016).
- Bustin, S. A. Absolute quantification of mRNA using real-time reverse transcription polymerase chain reaction assays. J. Mol. Endocrinol. 25 (2), 169-193 (2000).
- Andersen, C. L., Jensen, J. L., Orntoft, T. F. Normalization of real-time quantitative reverse transcription-PCR data: a model-based variance estimation approach to identify genes suited for normalization, applied to bladder and colon cancer data sets. Cancer Res. 64 (15), 5245-5250 (2004).
- Bustin, S. A., et al. The MIQE guidelines: minimum information for publication of quantitative real-time PCR experiments. Clin Chem. 55 (4), 611-622 (2009).
- Laurell, H., et al. Correction of RT-qPCR data for genomic DNA-derived signals with ValidPrime. Nucleic Acids Res. 40 (7), e51(2012).
- Galiveti, C. R., Rozhdestvensky, T. S., Brosius, J., Lehrach, H., Konthur, Z. Application of housekeeping npcRNAs for quantitative expression analysis of human transcriptome by real-time PCR. RNA. 16 (2), 450-461 (2010).
- Laurell, H., et al. Correction of RT-qPCR data for genomic DNA-derived signals with ValidPrime. Nucleic Acids Res. 40, e51(2012).
- Caldana, C., Scheible, W. R., Mueller-Roeber, B., Ruzicic, S. A quantitative RT-PCR platform for high-throughput expression profiling of 2500 rice transcription factors. Plant Methods. 3 (1), 7(2007).
- Lawrence, R. J., Pikaard, C. S. Perspectives Chromatin Turn Ons and Turn Offs of Ribosomal RNA Genes. Cell Cycle. 3 (7), 880(2004).
- Boisvert, F. M., van Koningsbruggen, S., Navascues, J., Lamond, A. I. The multifunctional nucleolus. Nat Rev Mol Cell Biol. 8 (7), 574-585 (2007).
- Alvarez, I., Wendel, J. F. Ribosomal ITS sequences and plant phylogenetic inference. Mol Phylogenet Evol. 29 (3), 417-434 (2003).
- Jobes, D. V., Thien, L. B. A conserved motif in the 5.8 S ribosomal RNA (rRNA) gene is a useful diagnostic marker for plant internal transcribed spacer (ITS) sequences. Plant Mol Biol Report. 15 (4), 326-334 (1997).
- Padhi, B. K., Singh, M., Huang, N., Pelletier, G. A PCR-based approach to assess genomic DNA contamination in RNA: Application to rat RNA samples. Anal Biochem. 494, 49-51 (2016).
- Dheda, K., et al. Validation of housekeeping genes for normalizing RNA expression in real-time PCR. Biotechniques. 37 (1), 112-114 (2004).
Przedruki i uprawnienia
